S3の大量オブジェクトから条件に合うものだけを一括処理する
目的
S3バケット上に大量のオブジェクトが配置されている場合、その整理が大変なことがあります。
- 一部のオブジェクトを抽出してコピーしたい
- タグをつけてライフサイクルポリシーの条件にしたい
- Lambdaに読み込ませて処理したい
といった、条件に合致したものを一括処理したい場合が出てきます。
今回はAthenaで条件に合致した一覧を作成し、S3バッチオペレーションで操作を行う方法を記載します。
S3バッチオペレーションとは
S3バッチオペレーションは、S3上の大量のオブジェクトに対して、同じ操作を一括で実行するマネージドな機能です。1つのジョブで数十億のオブジェクトを処理でき、進捗の管理や完了レポートの出力もS3側で行われます。サーバーレスなので、実行用の環境を用意する必要はありません。
主な用語は次の4つです。
| 用語 | 内容 |
|---|---|
| マニフェスト | 操作対象のオブジェクトの一覧。バケット名とオブジェクトキー(任意でバージョンID)を記載したCSV、またはS3インベントリのレポートを指定する |
| オペレーション | オブジェクトに対して実行する操作。1つのジョブで実行できる操作は1種類 |
| ジョブ | マニフェストとオペレーションなどの設定をまとめた、作業の基本単位 |
| タスク | ジョブの実行単位。マニフェストのオブジェクト1つにつき1つ作られる |
実行できる操作には、オブジェクトのコピー、暗号化の更新、タグやACLの設定、S3 Glacier Flexible Retrievalからの復元、Lambda関数の呼び出しなどがあります。削除は専用の操作がないため、タグを付与してライフサイクルルールで期限切れにするか、Lambda関数を呼び出して削除するかのどちらかで実現します。
ジョブは次の流れで動きます。
- 対象オブジェクトの一覧(マニフェスト)を用意する
- 実行する操作を選んでジョブを作成する
- ジョブを実行する(既定では、実行前に確認の待機状態になる)
- 完了レポートで、オブジェクトごとの結果を確認する
つまりマニフェストをどう作るかが、使いこなすうえでの要点になります。
対象をどう絞り込むか
バッチオペレーションには、マニフェストをフィルタで絞り込んで自動生成する機能があります。条件が単純であれば、これだけで足ります。
一方で、次のような条件はフィルタでは表現できません。
- キーの途中に含まれる日付で範囲を絞りたい(例:
2026/11/01〜2026/11/03) - 特定の条件に合致しないものを対象にしたい(例: 特定のプレフィックスを除外する)
- プレフィックスが特定の正規表現に合致するものを対象にしたい
そこで、S3インベントリのレポートをAthenaで好きな条件に絞り込み、その結果をバッチオペレーションのマニフェストとして渡す方法を試しました。
今回は、操作の一例としてオブジェクトのコピーを実行します。マニフェストの作り方は、操作の種類によらず共通です。
全体構成
- S3インベントリが、ソースバケットのオブジェクト一覧を日次で送信先バケットへ出力します。
- Athenaでインベントリを検索し、対象を絞り込みます。
- 絞り込んだ結果を、CTASでCSVとしてS3に出力します。これをマニフェストにします。
- バッチオペレーションがマニフェストを読み、対象のオブジェクトに操作を実行します(今回はコピー先バケットへのコピー)。
前提
- ソースバケットにS3インベントリが設定されていること(次の「事前準備」で設定します)
- Athenaのクエリ結果の出力先が設定されていること
事前準備: S3インベントリを設定する
本記事の方法は、S3インベントリのレポートをもとに対象を抽出します。S3インベントリは、バケット内のオブジェクトの一覧(キー、サイズなど)を日次または週次でS3へ出力する機能です。
ソースバケットを開き、「管理」タブの「インベントリ設定」から「インベントリ設定の作成」をクリックします。設定値は次のとおりです。
| 項目 | 設定値 |
|---|---|
| インベントリ設定名 | 任意(例: cloudtrail-log-inventory)。出力先のパスに使われる |
| インベントリスコープ(プレフィックス) | 空欄でバケット全体が対象。特定の階層だけが対象なら指定する |
| 送信先 | レポート用のバケット(s3://バケット名 の形式) |
| 頻度 | 日別 |
| 出力形式 | Apache Parquet |
| 追加のメタデータフィールド | サイズ(今回の条件で使うため) |
| オブジェクトバージョン | 現行バージョンのみ |
設定後、送信先バケットには次の構成でレポートが出力されます。
s3://<送信先バケット>/<ソースバケット名>/<インベントリ設定名>/
├── data/                       … レポート本体(Parquetファイル)
├── hive/dt=2026-11-15-01-00/   … 日付ごとの構成ファイル(symlink.txt)
└── 2026-11-15T01-00Z/          … 日付ごとのmanifest.json
Athenaからは、この中の hive/ を参照します。
1. Athenaでインベントリのテーブルを作成する
インベントリのレポートを検索するためのテーブルを作成します。
カラム定義はレポートのスキーマと一致させます。今回は追加フィールドに「サイズ」のみを選んだので、bucket、key、size の3つです。
LOCATION は、インベントリの出力先にある hive/ を指します(data/ ではありません)。hive/ 配下には日付ごとに、レポートを構成するParquetファイルのパスを記載した symlink.txt が置かれており、SymlinkTextInputFormat で読むことで、dt パーティションごとに必要なファイルだけがスキャンされます。さらに Partition Projection を有効にしているので、パーティションの追加作業は不要です。
CREATE EXTERNAL TABLE s3_inventory_demo.cloudtrail_inventory (
    bucket string,
    key    string,
    size   bigint
) PARTITIONED BY (dt string)
ROW FORMAT SERDE 'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe'
STORED AS INPUTFORMAT 'org.apache.hadoop.hive.ql.io.SymlinkTextInputFormat'
OUTPUTFORMAT 'org.apache.hadoop.hive.ql.io.IgnoreKeyTextOutputFormat'
LOCATION 's3://<送信先バケット>/<ソースバケット名>/<インベントリ設定名>/hive/'
TBLPROPERTIES (
  'projection.enabled'          = 'true',
  'projection.dt.type'          = 'date',
  'projection.dt.format'        = 'yyyy-MM-dd-HH-mm',
  'projection.dt.range'         = '2026-09-24-01-00,NOW',
  'projection.dt.interval'      = '1',
  'projection.dt.interval.unit' = 'HOURS'
);
projection.dt.range には、出力先の hive/dt=... で最も古い値を指定します。
2. 抽出条件を決める
今回の対象は、CloudTrailのログです。キーは次の構造です。
AWSLogs/123456789012/CloudTrail/ap-northeast-1/2026/11/01/....json.gz
   ↑第1層      ↑第2層      ↑第3層   ↑第4層    ↑5〜7層(年/月/日)
次の3つの条件をすべて満たすものを、操作の対象にします。
- リージョンが
ap-northeast-1 - キーに含まれる日付が
2026/11/01〜2026/11/03 - サイズが20KB以上
まず件数と容量を確認します。
SELECT COUNT(*)                              AS objects,
       ROUND(SUM(size) / 1024.0 / 1024.0, 2) AS size_mb
FROM s3_inventory_demo.cloudtrail_inventory
WHERE dt = '2026-11-15-01-00'
  AND key LIKE 'AWSLogs/%/CloudTrail/ap-northeast-1/2026/11/0%'
  AND CAST(split_part(key, '/', 7) AS integer) BETWEEN 1 AND 3
  AND size >= 20000;
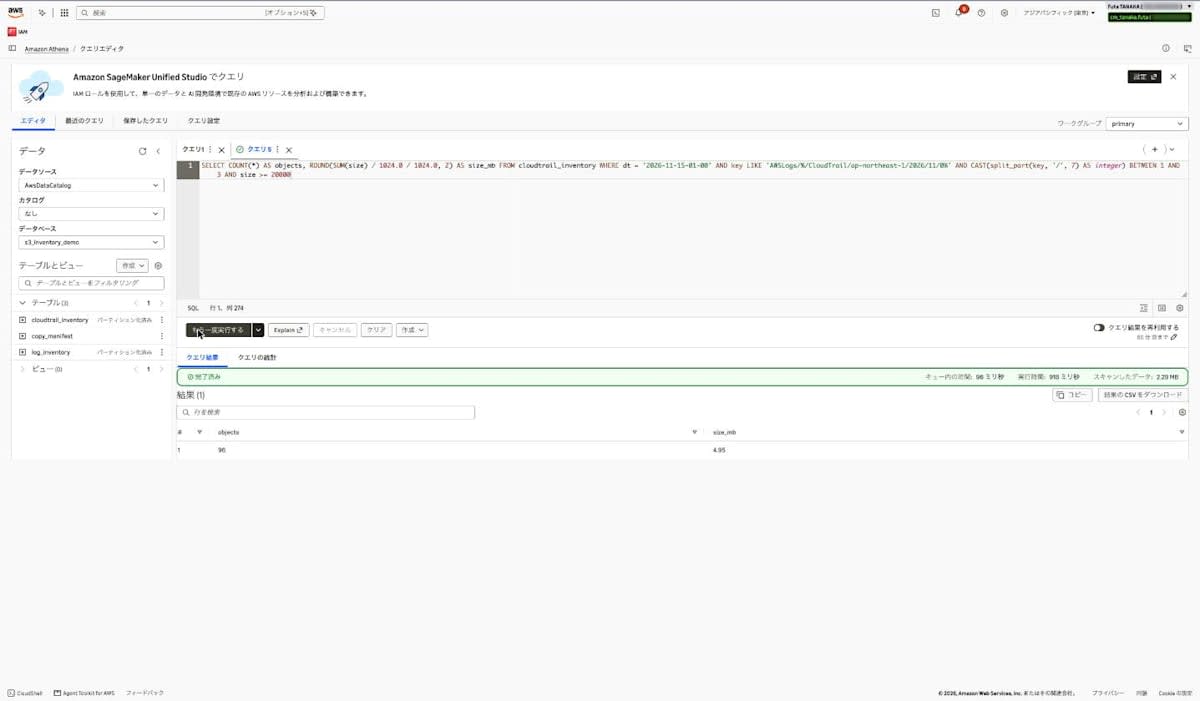
96件、約4.95MBでした。
3. CTASでマニフェストを作成する
バッチオペレーションのマニフェストには、次の条件があります。
- CSV形式で、
バケット名,キーの列(バージョンIDは任意) - ヘッダー行があるとエラーになる
- キーはURLエンコードされている必要がある
Athenaのクエリ結果をそのままダウンロードしたCSVには、ヘッダー行が付きます。公式ドキュメントでは、ダウンロード後にヘッダーを削除して再アップロードする手順が紹介されています。
この方法では、CSVファイルを編集する環境が必要です。
そこで今回は、CTAS(CREATE TABLE AS SELECT) を使って、最初からヘッダーなしで出力しました。CTASはSELECTの結果を新しいテーブルとして作り、データファイルをS3に書き出す機能です。テーブルのデータとして書き出されるため、ヘッダー行は付きません。
CREATE TABLE s3_inventory_demo.copy_manifest
WITH (
  format            = 'TEXTFILE',
  field_delimiter   = ',',
  write_compression = 'NONE',
  external_location = 's3://<Athena結果バケット>/manifest/20261116/'
) AS
SELECT bucket, key
FROM s3_inventory_demo.cloudtrail_inventory
WHERE dt = '2026-11-15-01-00'
  AND key LIKE 'AWSLogs/%/CloudTrail/ap-northeast-1/2026/11/0%'
  AND CAST(split_part(key, '/', 7) AS integer) BETWEEN 1 AND 3
  AND size >= 20000;
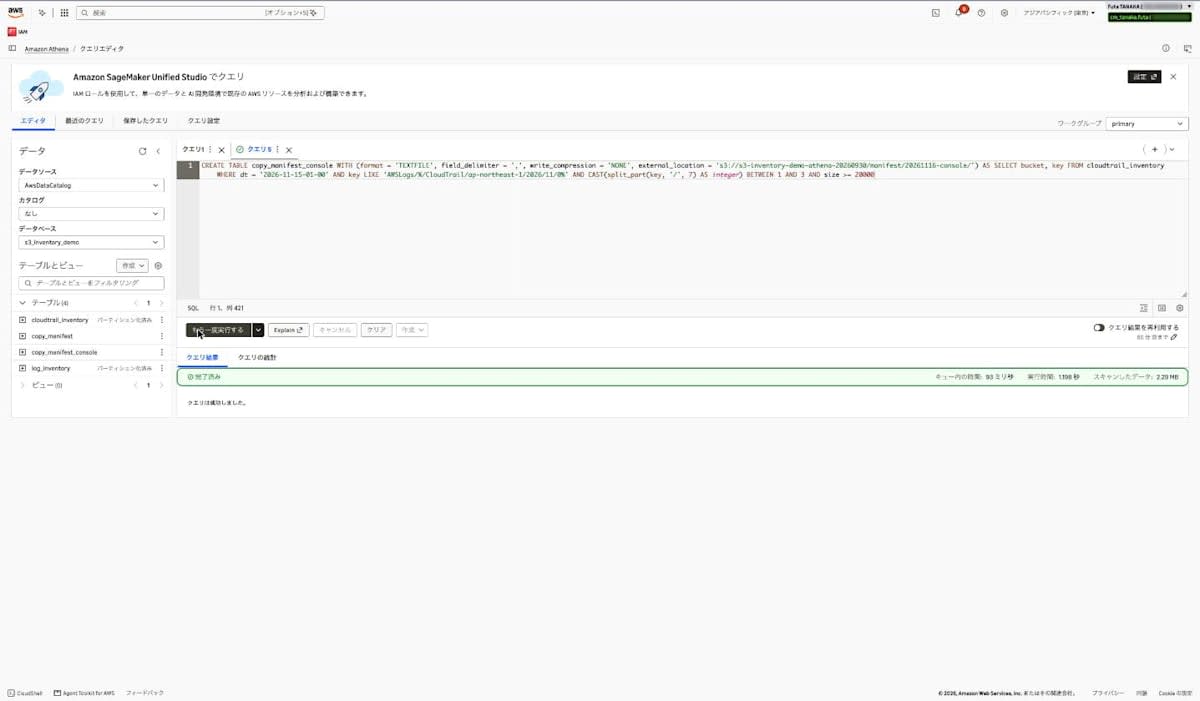
ポイントは次の3つです。
format = 'TEXTFILE'とfield_delimiter = ','でCSV形式になります。write_compression = 'NONE'を指定します。UNLOADでTEXTFILEを出力する場合はgzip圧縮が固定ですが、CTASなら無圧縮にできます。external_location(出力先)は空である必要があります。 Athenaは既存データを上書きも削除もしません。やり直すときは、出力先を変えるか、手動で削除します。
出力されたファイルを確認します。
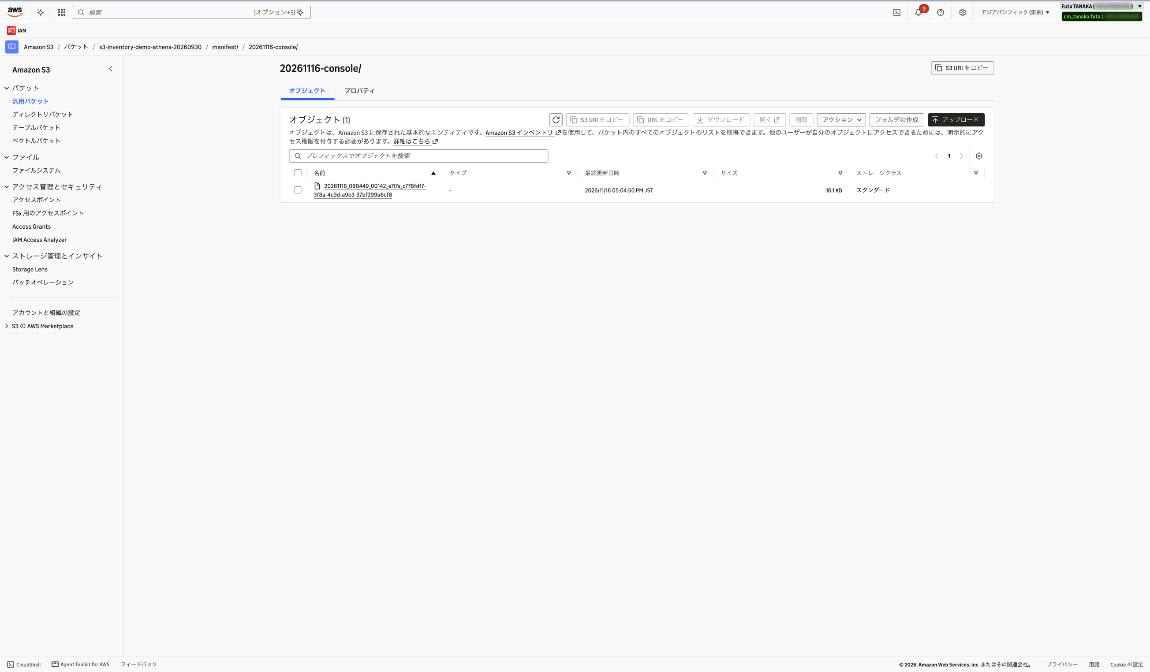
今回は、ファイルが1つにまとまり、ヘッダー行はなく、96行でした。拡張子はありません。中身は次のとおりです。
<ソースバケット名>,AWSLogs/123456789012/CloudTrail/ap-northeast-1/2026/11/01/123456789012_CloudTrail_ap-northeast-1_20261101T0010Z_xxxxxxxxxxxxxxxx.json.gz
...
4. コピー先バケットとIAMロールを作成する
ここからは、操作の一例としてコピーを実行します。コピー先のバケットを作成し、バッチオペレーション用のIAMロールを用意します。
IAMロールに必要な権限は、実行する操作によって変わります。タグ付けや削除など、別の操作を行う場合は、公式ドキュメントのGranting permissions for Batch Operationsを参照してください。
信頼ポリシー
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": { "Service": "batchoperations.s3.amazonaws.com" },
      "Action": "sts:AssumeRole"
    }
  ]
}
権限ポリシー
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": ["s3:GetObject", "s3:GetObjectVersion"],
      "Resource": ["arn:aws:s3:::<ソースバケット>/*"]
    },
    {
      "Effect": "Allow",
      "Action": ["s3:PutObject"],
      "Resource": ["arn:aws:s3:::<コピー先バケット>/*"]
    },
    {
      "Effect": "Allow",
      "Action": ["s3:GetObject", "s3:GetObjectVersion"],
      "Resource": ["arn:aws:s3:::<Athena結果バケット>/manifest/*"]
    },
    {
      "Effect": "Allow",
      "Action": ["s3:PutObject"],
      "Resource": ["arn:aws:s3:::<Athena結果バケット>/report/*"]
    }
  ]
}
必要なのは、ソースの読み取り、コピー先の書き込み、マニフェストの読み取り、完了レポートの書き込みの4つです。
5. バッチオペレーションのジョブを作成する
S3コンソールの「バッチオペレーション」から「ジョブの作成」を開きます。
スコープを選択
オブジェクトリストは「既存のマニフェストファイルを使用」を選びます。
マニフェスト形式は「CSV」を選びます。「マニフェストにはバージョンID列が含まれています」はオフのままにします。マニフェストオブジェクトに、CTASで出力されたファイルのS3パスを入力します。
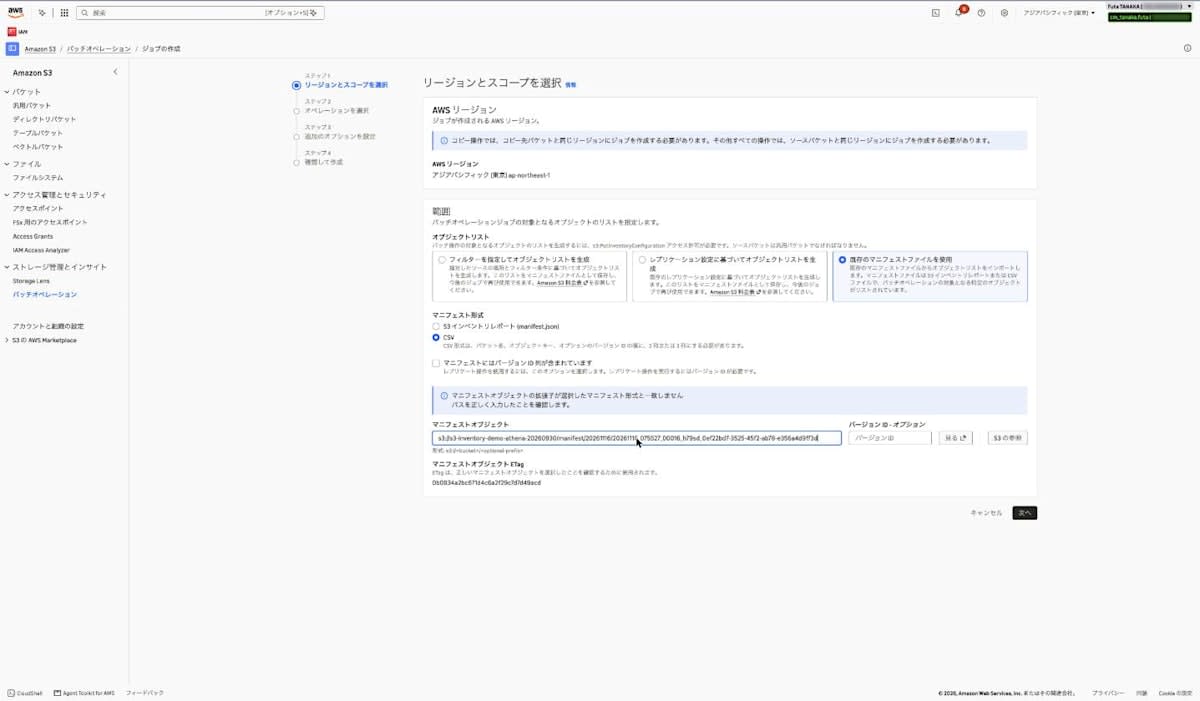
パスを入力すると、ETagが自動で取得されます。「マニフェストオブジェクトの拡張子が選択したマニフェスト形式と一致しません」という案内が表示されますが、これは案内のみで、そのまま進めることができました。
オペレーションを選択
オペレーションは「コピー」を選び、送信先にコピー先バケットを入力します。
コピー先のバケットでバージョニングが有効でない場合は、「同じ名前の既存のオブジェクトは上書きされます」のチェックが必要です。
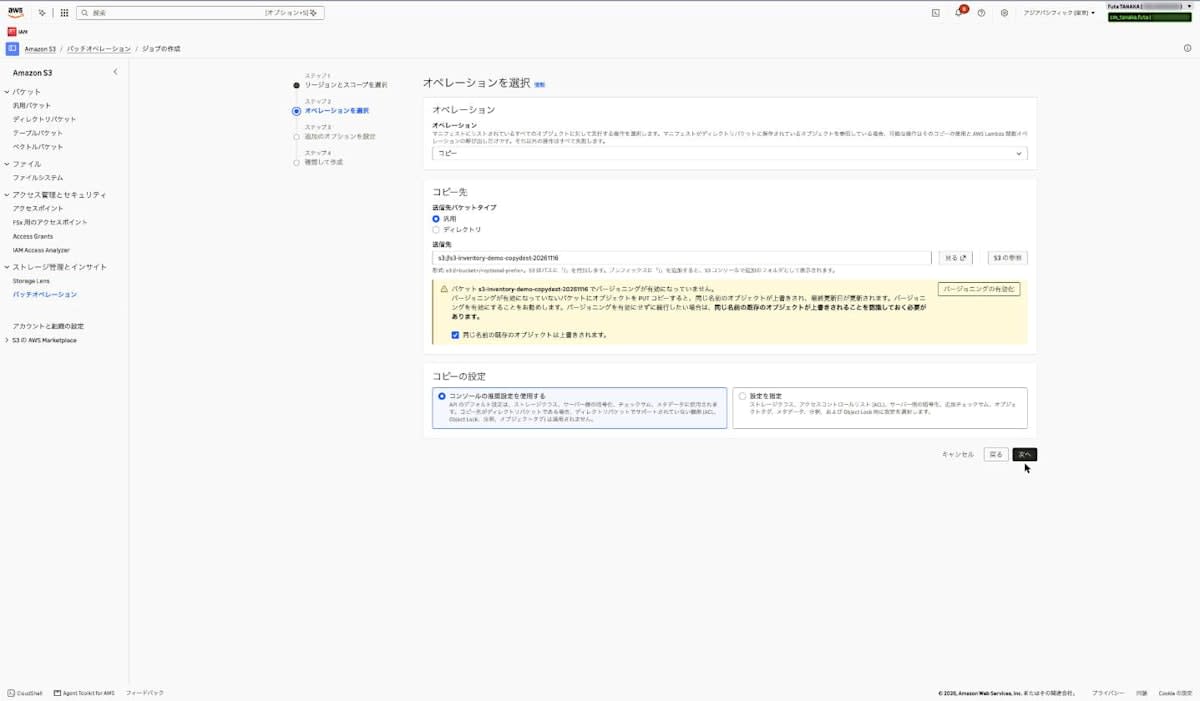
コピーの設定は、既定の「コンソールの推奨設定を使用する」のままにします。
追加のオプションを設定
ジョブの実行方法は、既定の「実行前に確認」のままにします。完了レポートは「すべてのタスク」を選び、出力先を入力します。
IAMロールは、先ほど作成したロールを選びます。
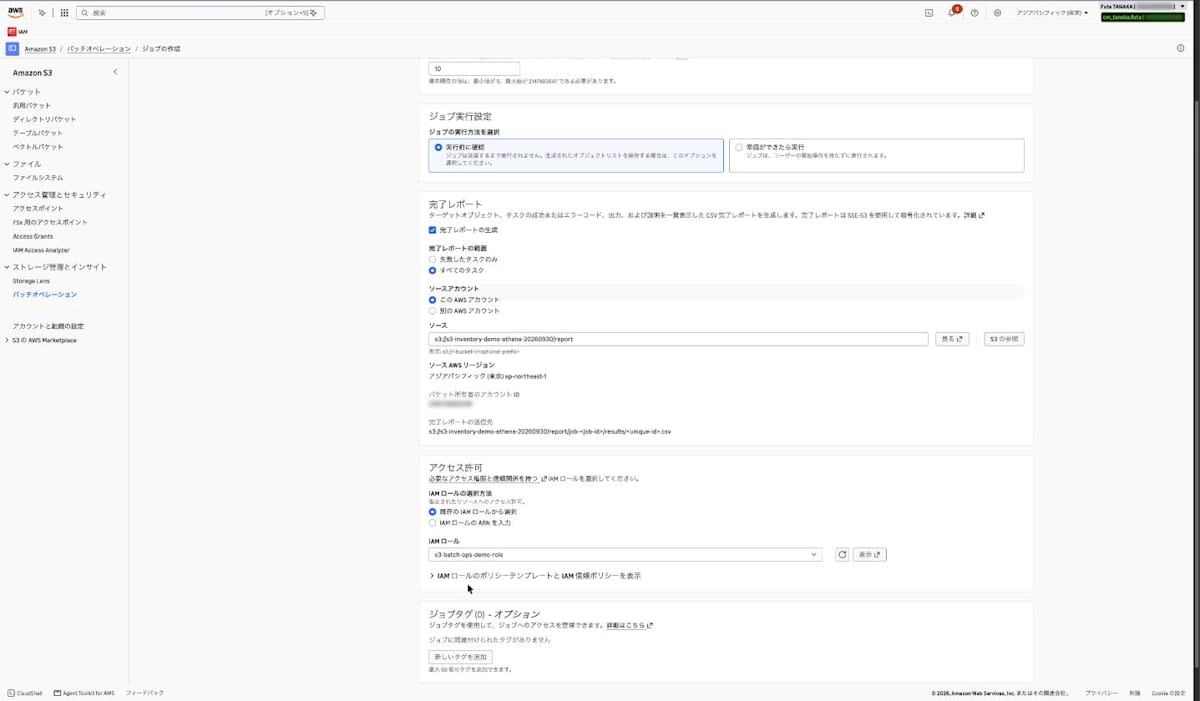
確認して作成
設定内容を確認し、「送信」でジョブを作成します。
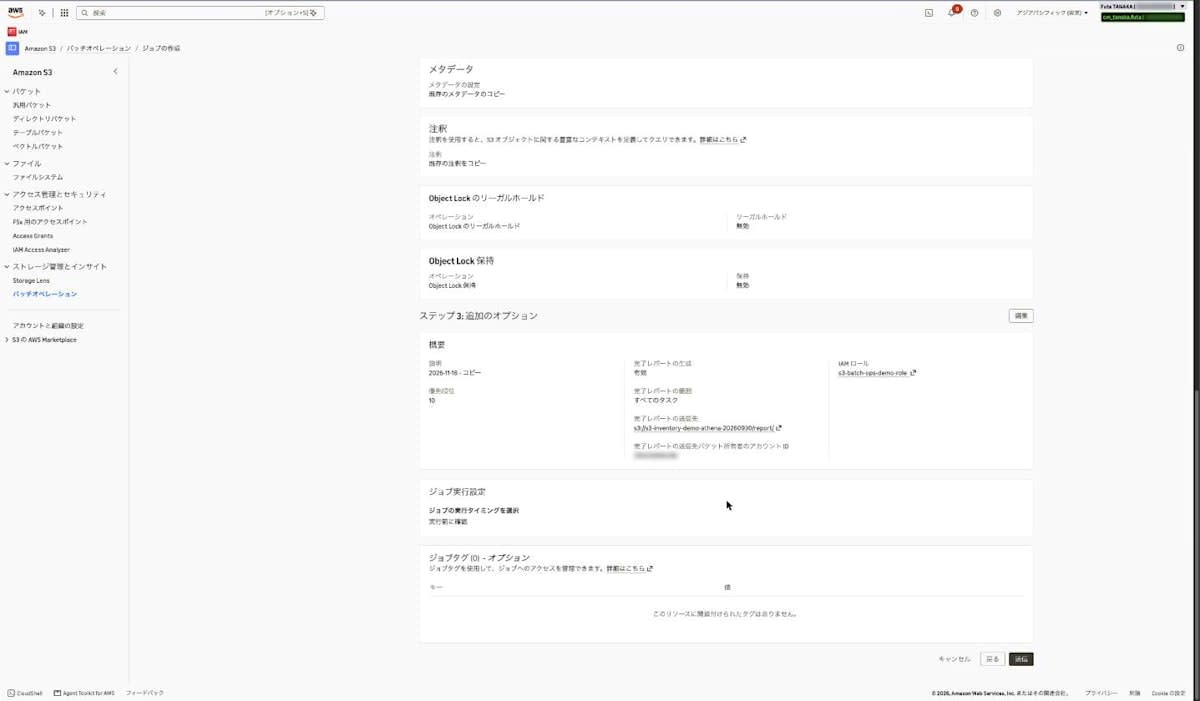
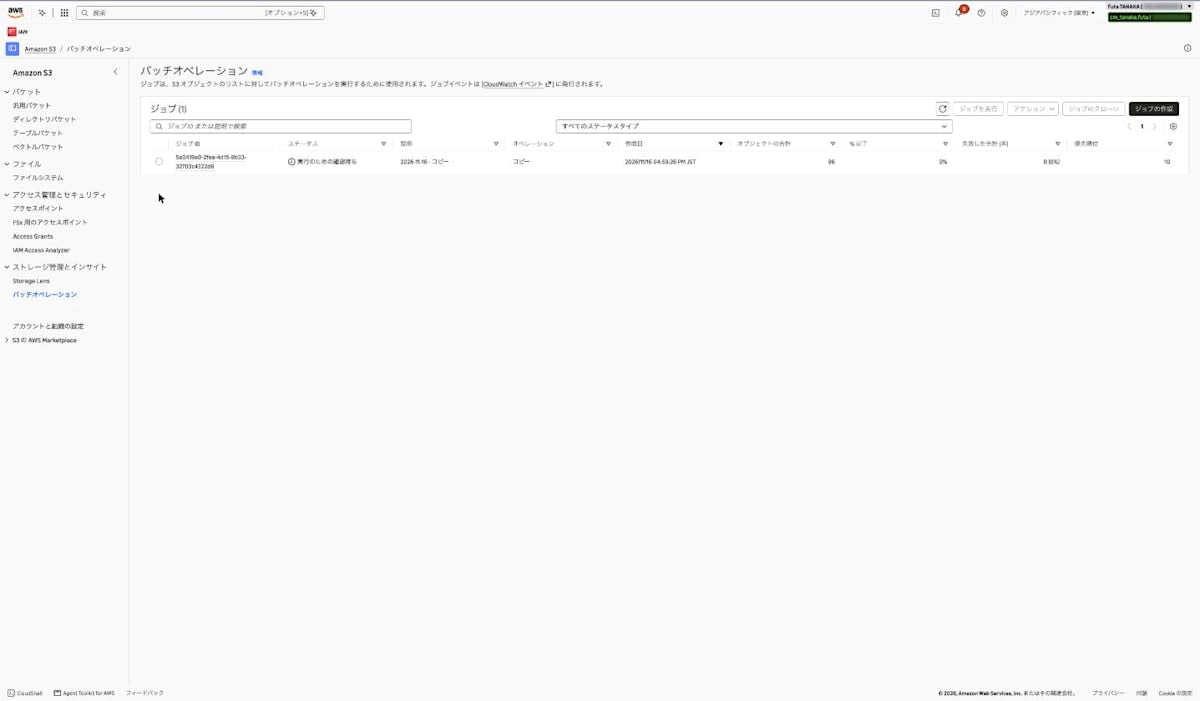
作成直後のステータスは「新規」で、マニフェストを解析しています。
しばらくすると「実行のための確認待ち」になります。マニフェストに記載されたオブジェクトの合計が96と、Athenaで確認した件数と一致していることを確認できます。
6. ジョブを実行する
ジョブを選択して「ジョブを実行」をクリックし、内容を確認して実行します。
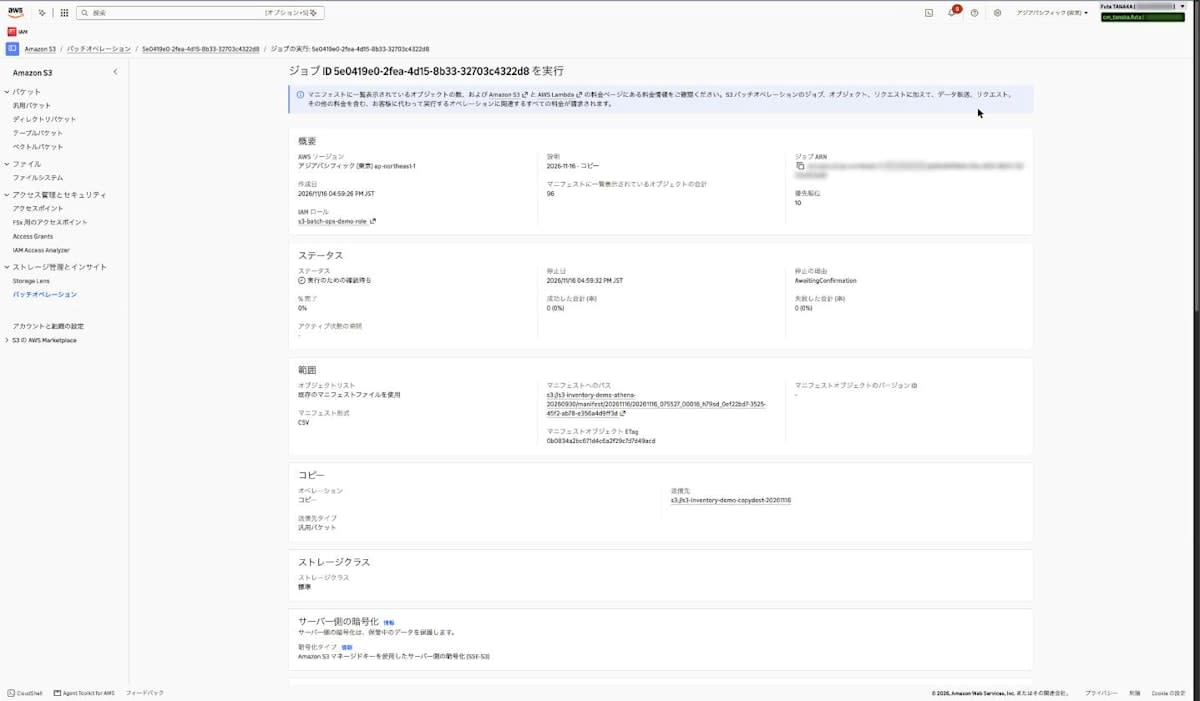
実行を受け付けると、ステータスが変わっていきます。
完了するとステータスが完了済みになります。
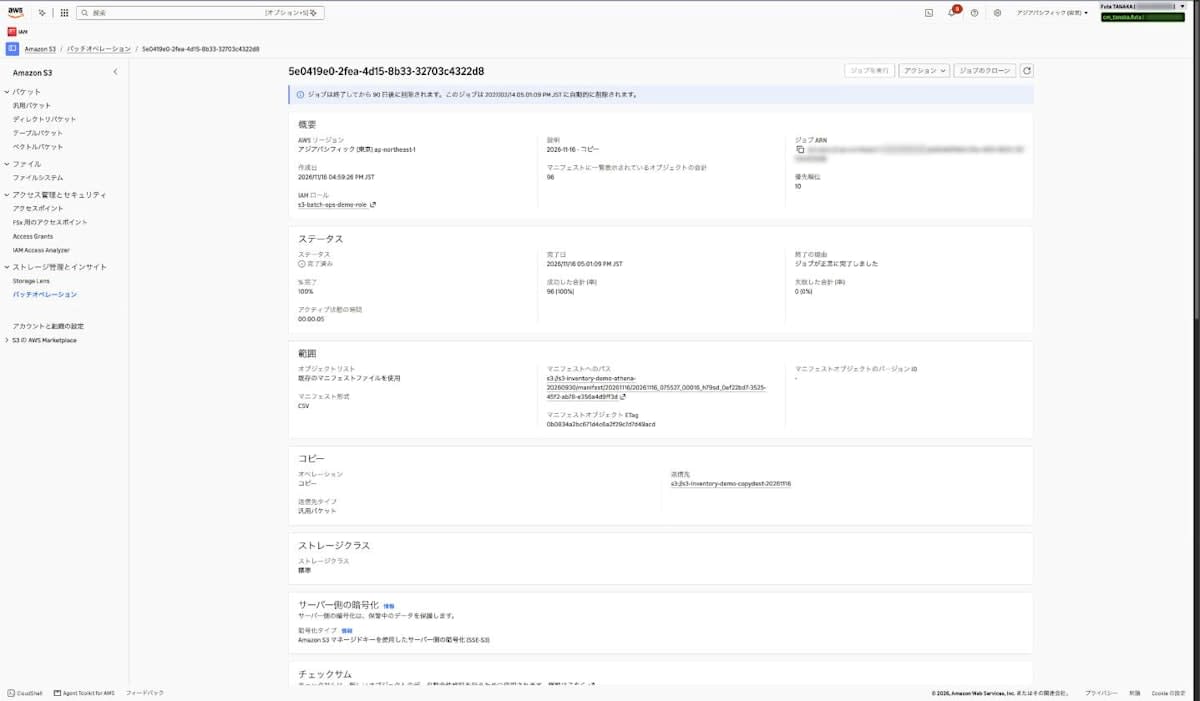
7. 結果を確認する
コピー先バケットを確認すると、対象のオブジェクトがコピーされています。
完了レポートは、指定したプレフィックスの job-<ジョブID>/results/ 配下にCSVとして出力されます。今回は96行すべてが succeeded(Successful)でした。
<ソースバケット名>,AWSLogs/123456789012/CloudTrail/ap-northeast-1/2026/11/01/...json.gz,,succeeded,200,,Successful
補足: S3 Metadataという選択肢
インベントリ以外に、S3 Metadata でもオブジェクトの一覧を取得できます。S3 Metadataは、バケット内のオブジェクトのメタデータをAWS管理のIcebergテーブルに保持し、Athenaで問い合わせられる機能です。ライブインベントリテーブルは、オブジェクトの更新が通常1時間以内に反映されるとされています。
インベントリと比較した特徴は、次のとおりです(公式ドキュメントの記載に基づきます)。
| 観点 | S3インベントリ | S3 Metadata(ライブインベントリテーブル) |
|---|---|---|
| 鮮度 | 日次スナップショット | 通常1時間以内に反映 |
| 履歴 | 日付ごとのスナップショットが残る | 最新状態のみ(履歴はジャーナルテーブル) |
| タグでの絞り込み | 項目に含まれない | object_tags カラムで可能 |
| 範囲 | プレフィックスで絞れる | バケット全体のみ |
| 追加の課金 | レポート出力、ストレージ、Athenaのスキャン | バックフィル課金、10億件超の場合は月額、ジャーナルの更新課金、Athenaのスキャンなど |
「最新の状態に対して処理したい」「タグを条件にしたい」場合は、S3 Metadataが向いています。「日々の推移も追いたい」「プレフィックスで絞りたい」場合や、コストを抑えたい場合は、インベントリが向いています。
料金について
Athenaの料金
スキャンしたデータ量に対する従量課金です。東京リージョンでは1TBあたり$5です(1クエリあたり最小10MB)。今回のクエリは2〜3MB程度のスキャンだったため、1クエリあたりの料金は最小課金の10MB分(約$0.00005)です。
バッチオペレーションの料金
バッチオペレーションには、ジョブ自体の料金がかかります。これに加えて、ジョブで実行した操作に対する料金が別途かかります。
東京リージョン(ap-northeast-1)の単価は次のとおりです(2026年11月時点)。
| 区分 | 項目 | 単価 |
|---|---|---|
| ジョブの料金 | ジョブの作成 | $0.25 / ジョブ |
| ジョブの料金 | 処理したオブジェクト数 | $1.00 / 100万オブジェクト |
| 操作の料金(今回はコピー) | COPYリクエスト | $0.0047 / 1,000リクエスト |
- ジョブの作成料金は、完了前にキャンセルしたジョブにもかかります。
- 本記事ではCTASで作成したマニフェストを使いましたが、ジョブ作成時のフィルタでマニフェストを自動生成する場合は、これに加えてソースバケットのオブジェクト100万件あたり$0.015のマニフェスト生成料金がかかります。
- ほかの操作(タグ付け、復元、Lambda関数の呼び出しなど)を実行する場合は、その操作のリクエスト料金やLambdaの料金が別途かかります。
最後に
S3インベントリ+Athenaで対象を絞り込み、CTASでヘッダーなしのマニフェストを作り、バッチオペレーションに渡すことで、フィルタでは表現しにくい条件でも、サーバーレスで大量のオブジェクトを処理できます。
今回は操作の一例としてコピーを実行しましたが、タグ付けや復元、Lambda関数を使った削除などにも、同じ方法で作ったマニフェストを使えます。条件のSQLを差し替えれば、さまざまな抽出に応用できます。
S3オブジェクトの一括処理をされる方の一助になれば幸いです。