S3バケット上のオブジェクトのサイズをS3インベントリとAthenaを使って集計してみた
目的
S3バケット上のオブジェクトのサイズ集計に関してお客様から相談を受けました。
特に目的のプレフィックス単位に日々の集計をしようとした場合、S3の標準機能だけでは難しいです。
aws s3 ls --recursive --summarize で数える方法もありますが、オブジェクトが数万個を超えると時間がかかり、何より「日々の推移」は取れません。
そこでS3インベントリでオブジェクト一覧を日次で出力し、AthenaからSQLで分析できるようにしてみました。
S3インベントリは、バケット内のオブジェクト一覧を出力してくれる機能です。日次または週次で自動実行され、サイズなどのメタデータを任意で追加できます。日付付きのスナップショットが積み上がるため、過去に遡って増加傾向を追えます。
今回は、CloudTrailのログ出力先バケットを利用し、S3インベントリの設定とAthenaによる日次集計をやってみます。
全体構成
バケットを3つ使います。
| バケット | 役割 |
|---|---|
s3-inventory-demo-source-20260930 |
分析対象。CloudTrailログの格納先 |
s3-inventory-demo-report-20260930 |
インベントリレポートの出力先 |
s3-inventory-demo-athena-20260930 |
Athenaのクエリ結果の出力先 |
インベントリの出力先とクエリ結果の出力先を同じバケットにまとめると、ライフサイクル設定が煩雑になるので分けておくことをおすすめします。
1. バケットを作成する
S3コンソールから「バケットを作成」を開き、バケット名を入力します。
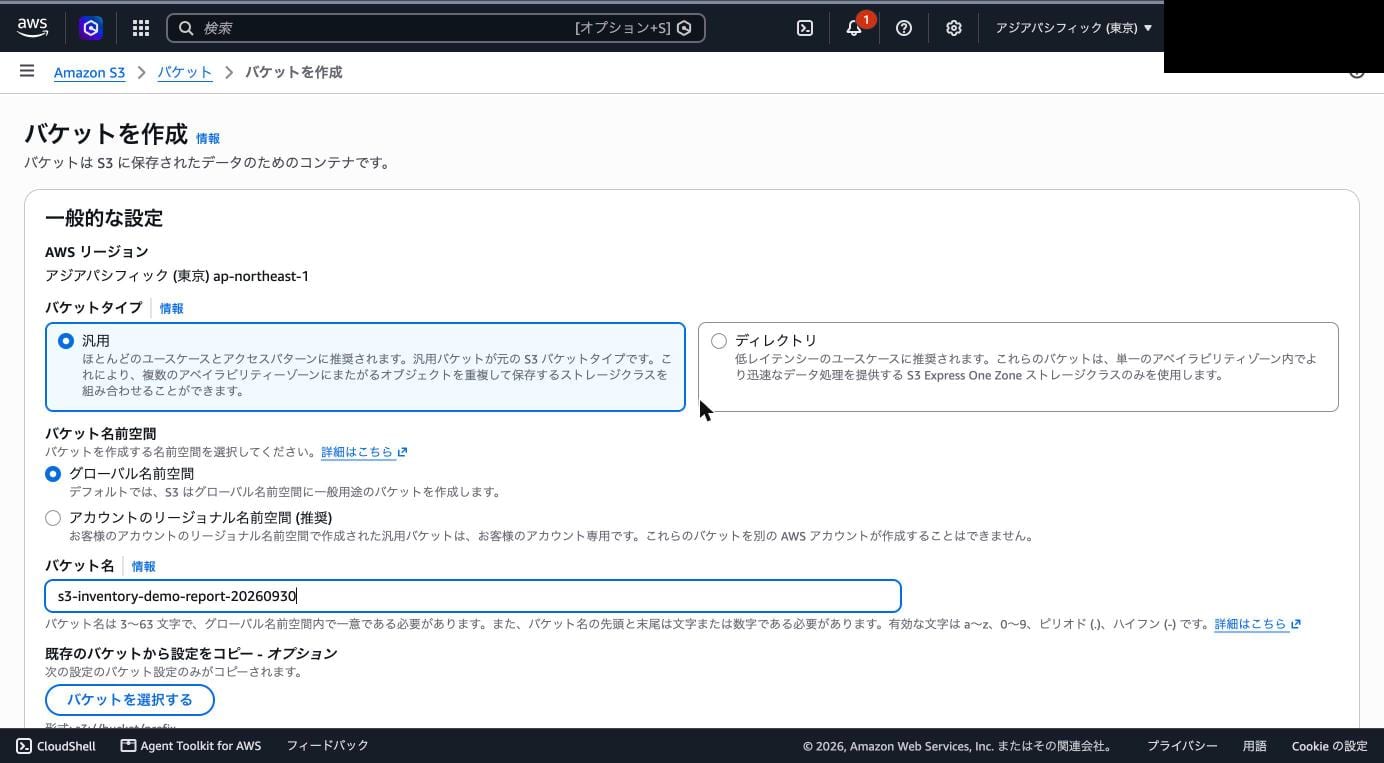
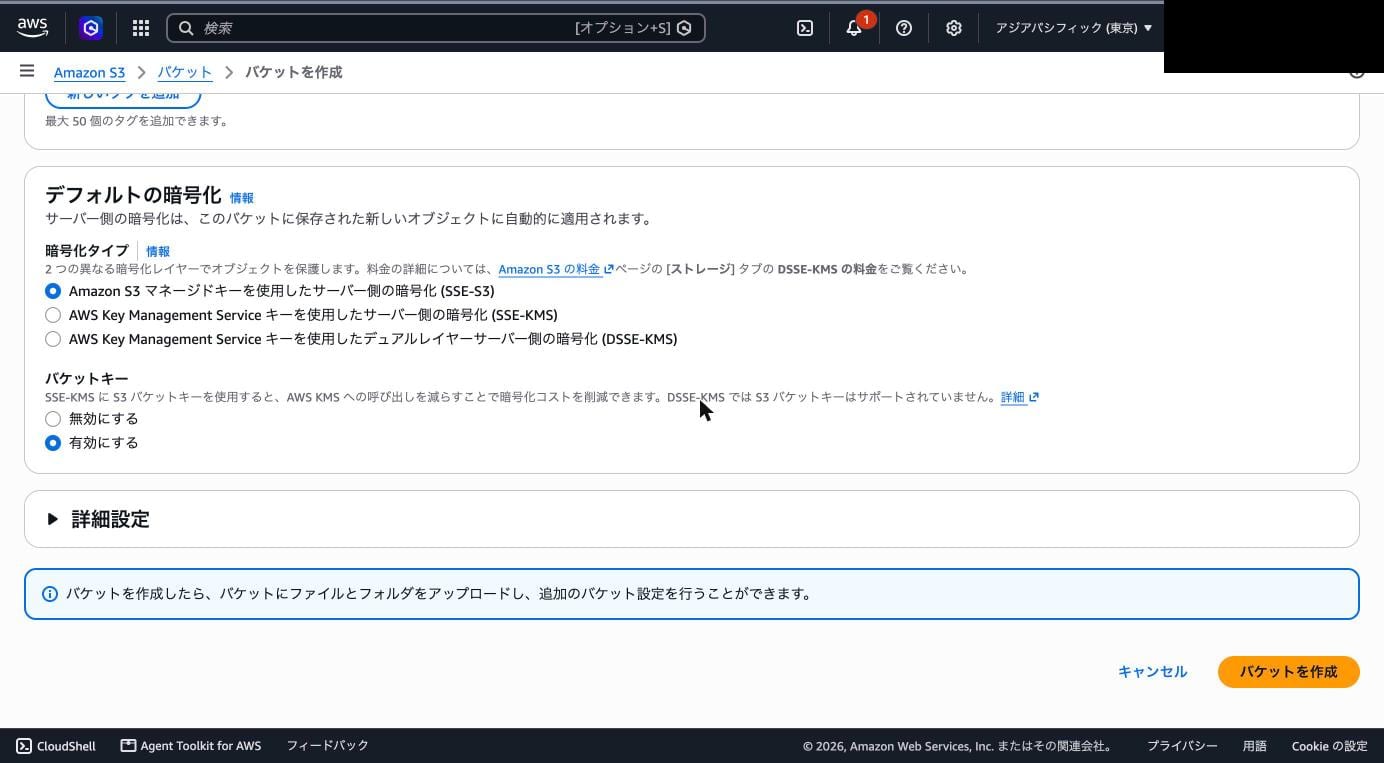
暗号化はデフォルトの SSE-S3 のままで構いません。そのまま「バケットを作成」をクリックします。
作成できました。
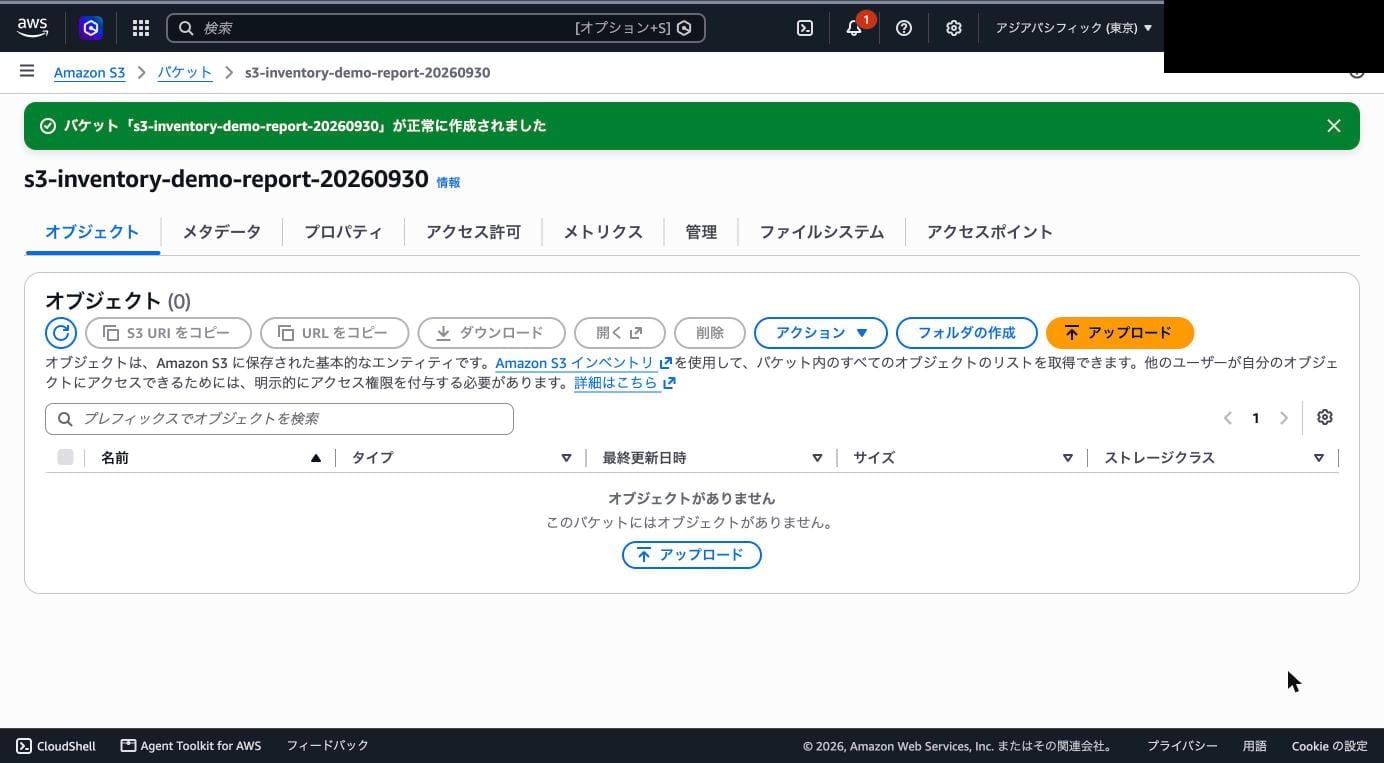
同じ手順で、分析対象のバケットとクエリ結果用のバケットも作成しておきます。
2. インベントリを設定する
分析対象バケットを開き、「管理」タブを下にスクロールすると「インベントリ設定」があります。「インベントリ設定の作成」をクリックします。
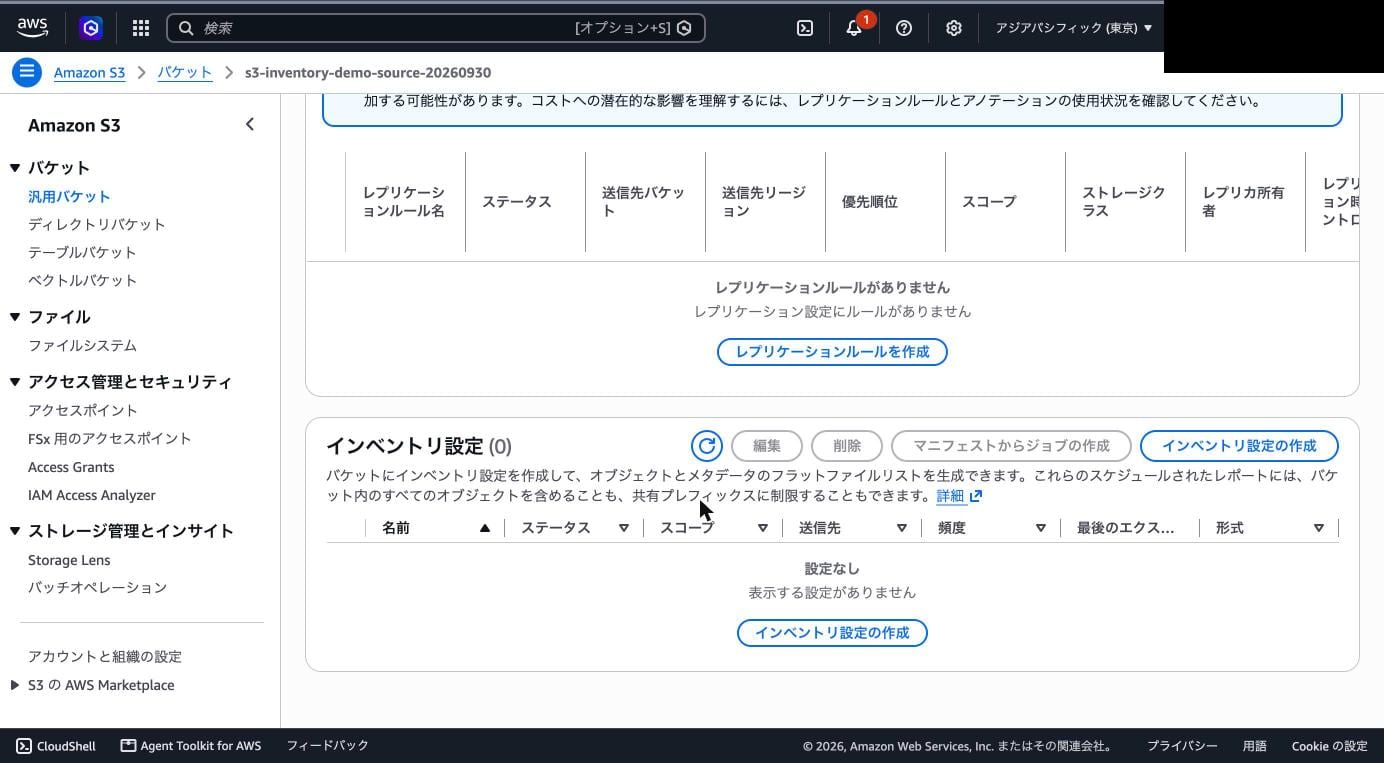
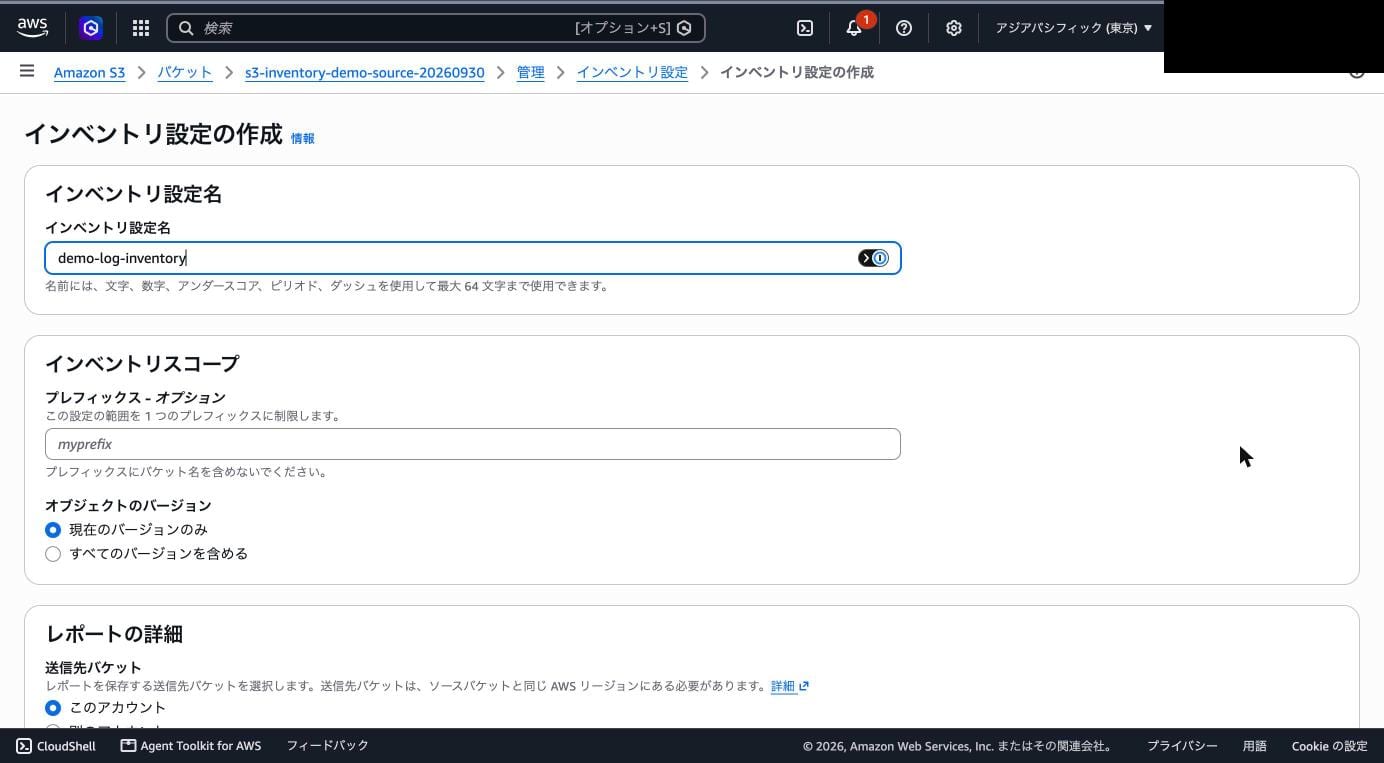
インベントリ設定名を入力します。
送信先に、先ほど作成したレポート用バケットを s3://バケット名 の形式で入力します。
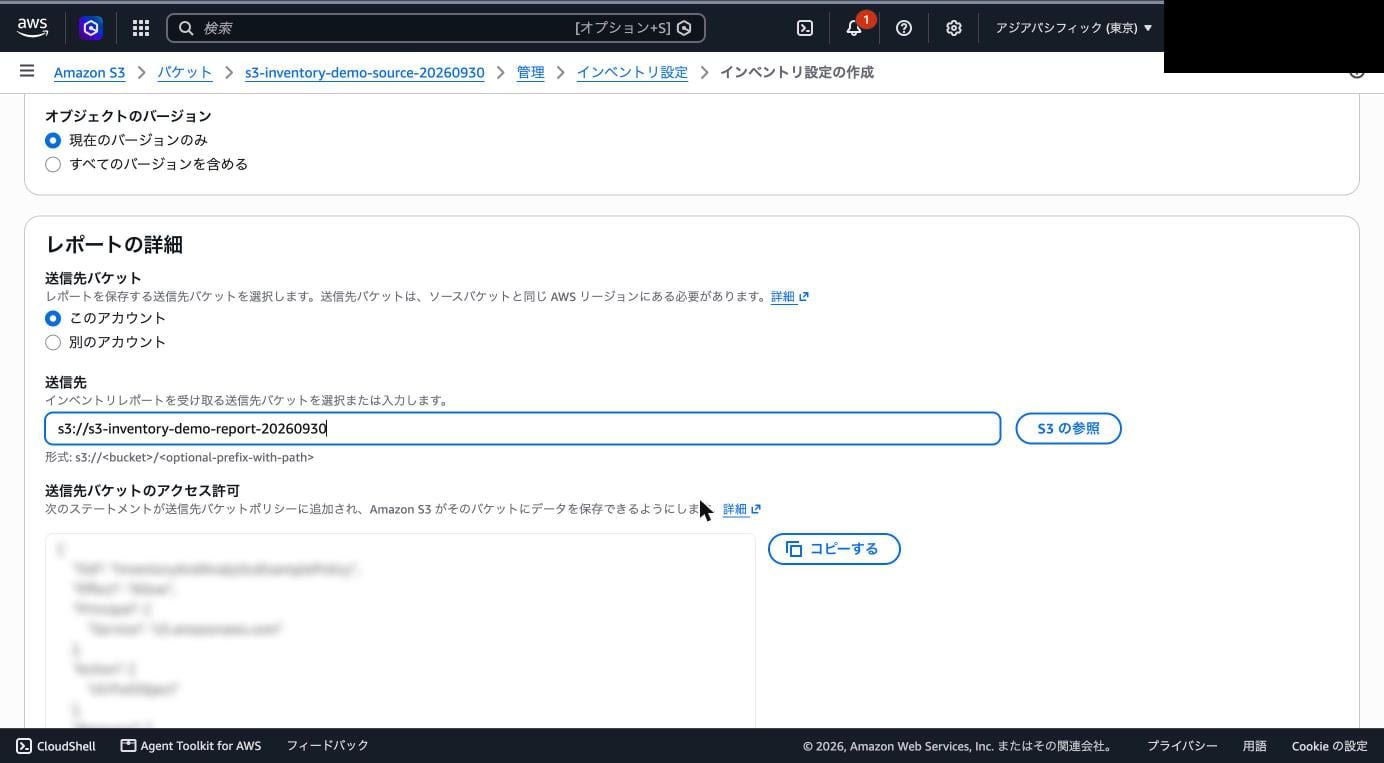
画面下部には「送信先バケットのアクセス許可」としてバケットポリシーが表示されています。これは保存時にコンソールが自動で送信先バケットへ適用してくれるため、手動でコピーする必要はありません。
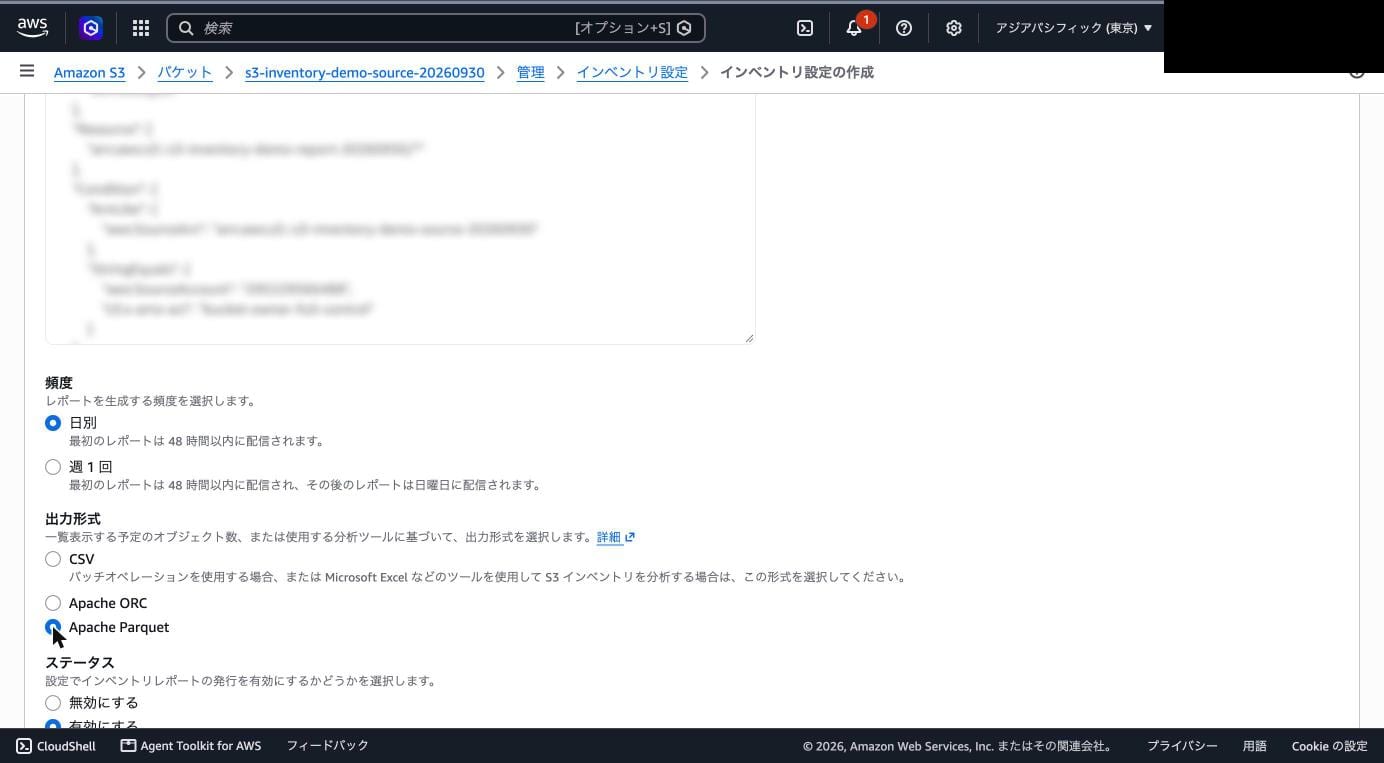
頻度は「日別」、出力形式は「Apache Parquet」を選択します。
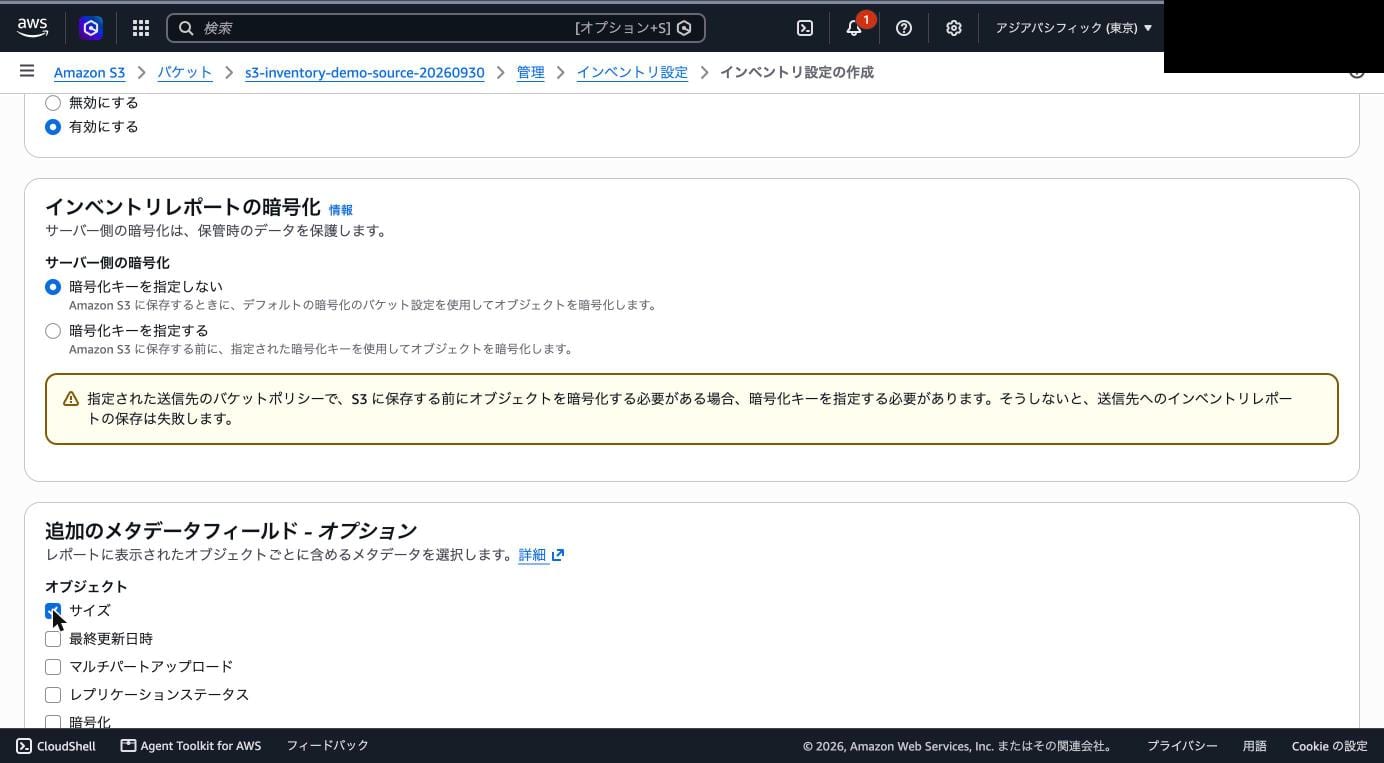
「追加のメタデータフィールド」で「サイズ」にチェックを入れます。容量を集計するために必要です。
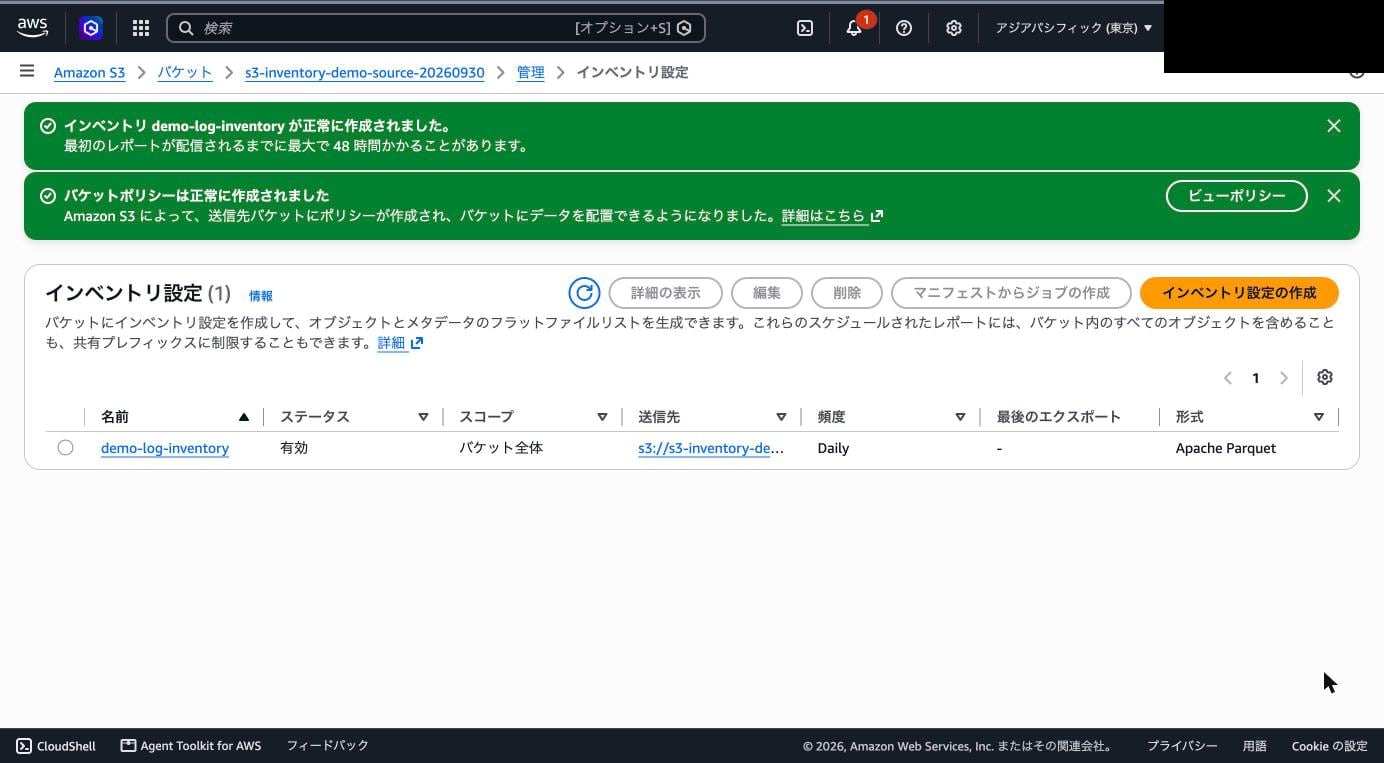
「設定を保存」をクリックすると作成完了です。バケットポリシーも自動作成された旨が表示されます。
3. Athenaのクエリ結果の場所を設定する
Athenaはクエリ結果をS3に書き出すため、この設定をしないとクエリを実行できません。
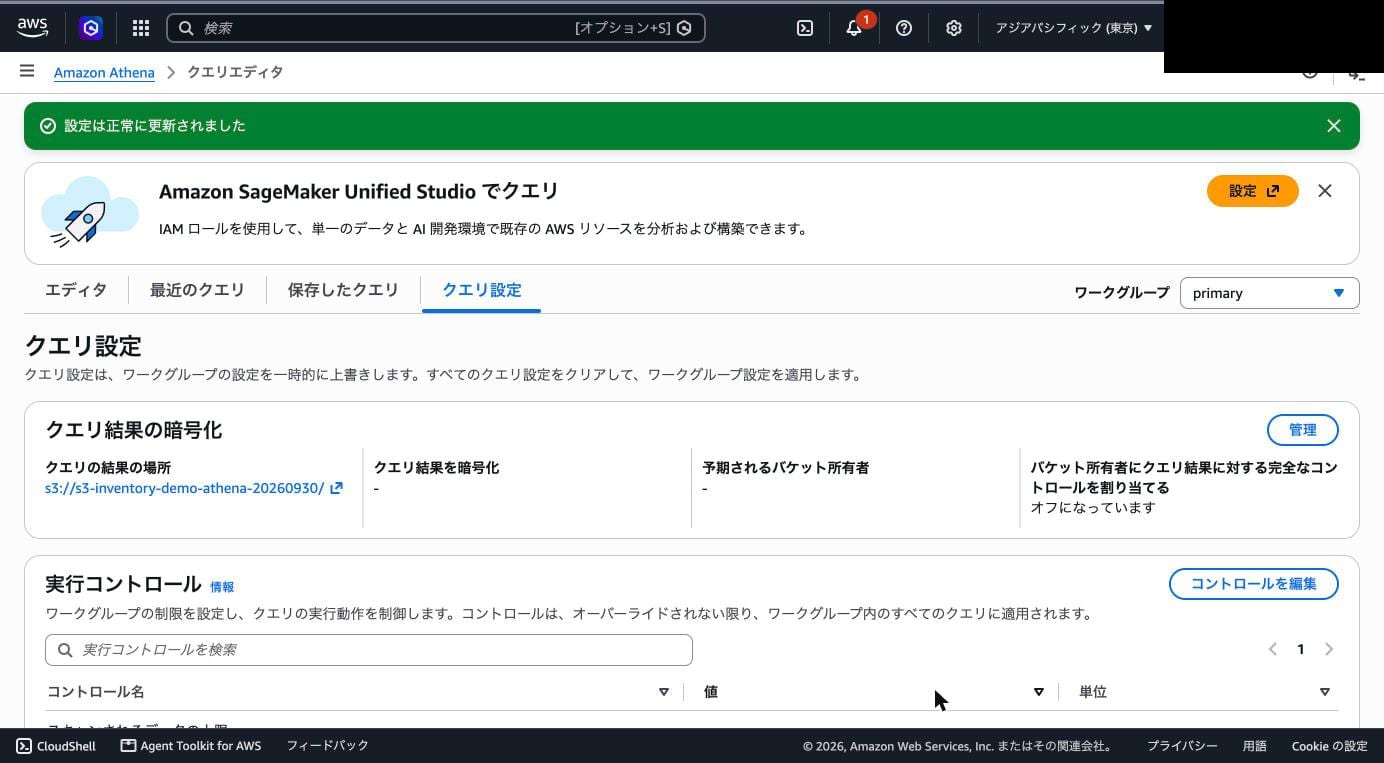
Athenaのクエリエディタを開き、「クエリ設定」タブ →「管理」をクリックします。「クエリ結果の場所」に、クエリ結果用バケットを入力します。
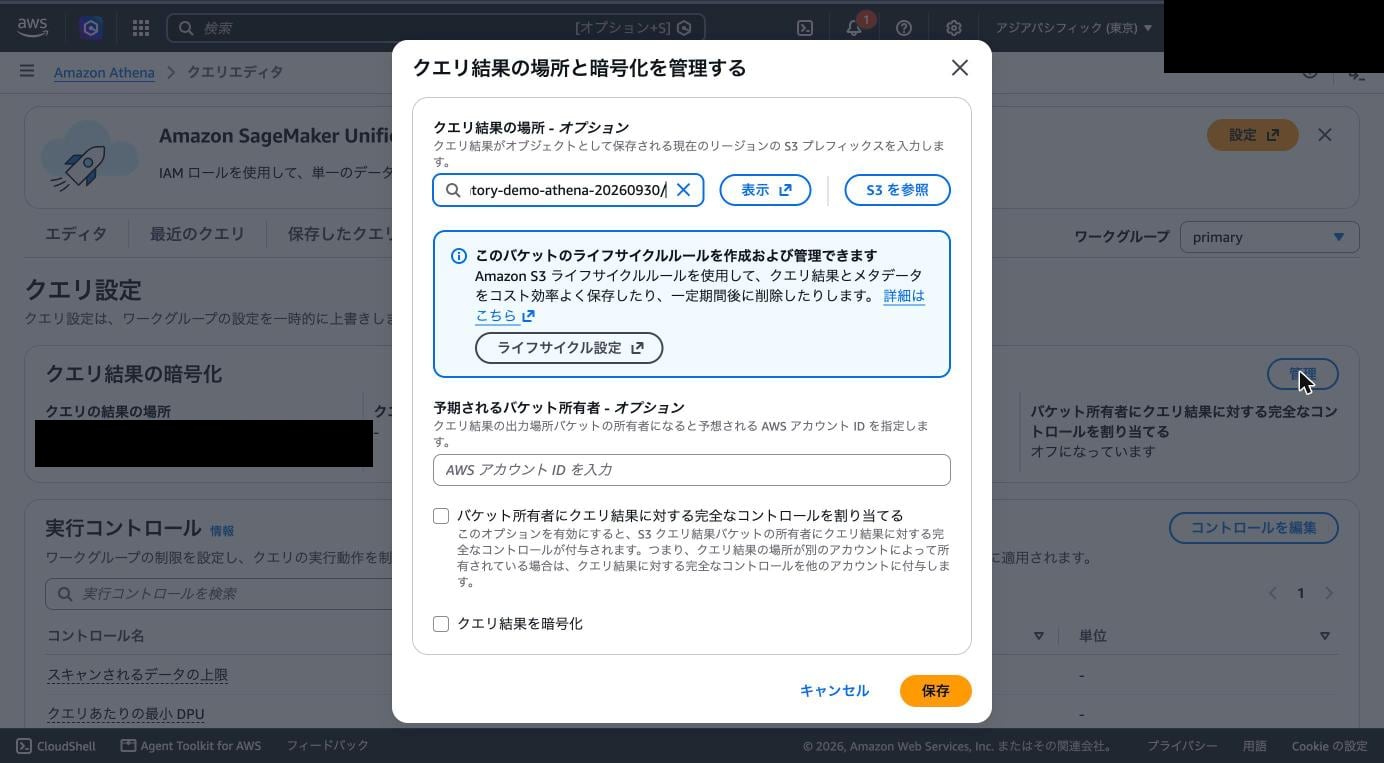
「保存」をクリックすると反映されます。
4. テーブルを作成する
ここからはクエリエディタで作業します。まずデータベースを作成します。
CREATE DATABASE s3_inventory_demo;
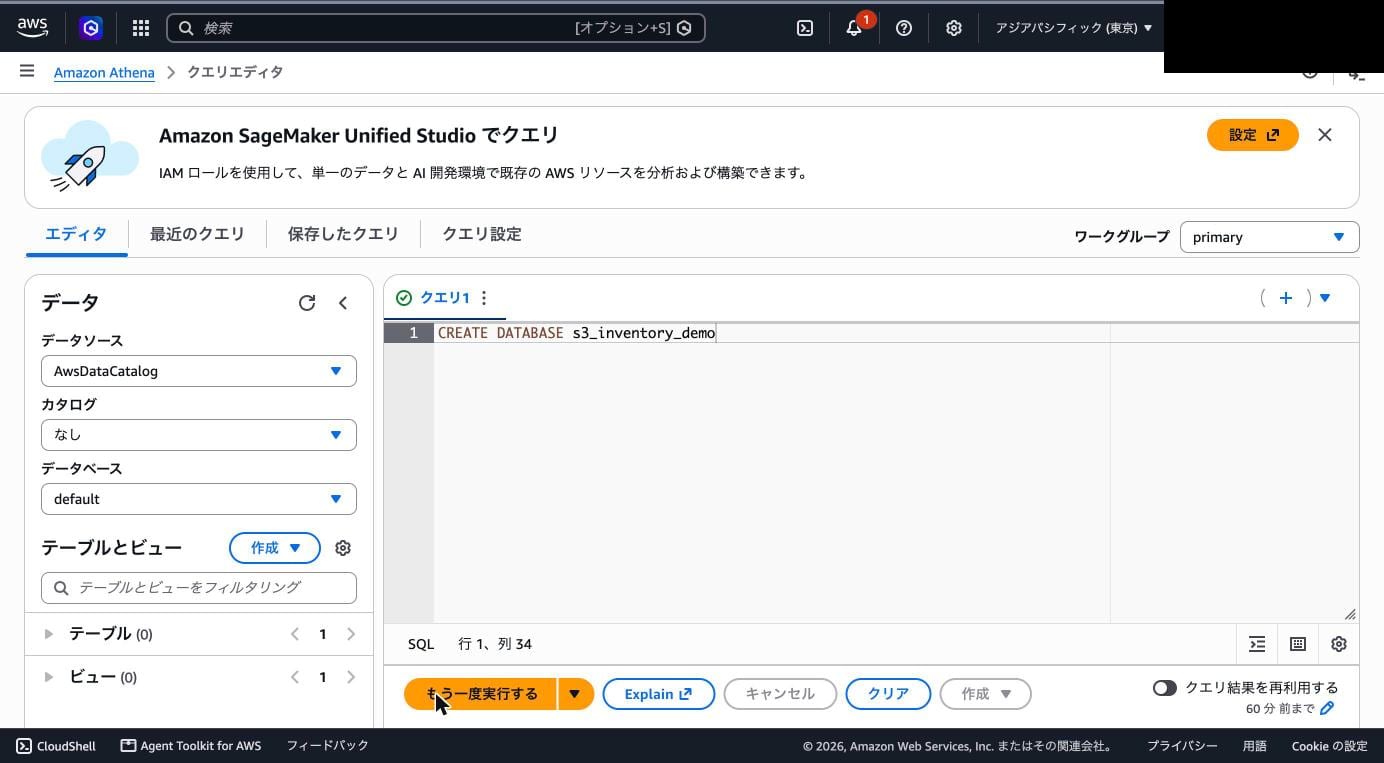
左ペインの「データベース」で作成したデータベースを選択してから、外部テーブルを作成します。
CREATE EXTERNAL TABLE s3_inventory_demo.log_inventory (
    bucket string,
    key    string,
    size   bigint
) PARTITIONED BY (dt string)
ROW FORMAT SERDE 'org.apache.hadoop.hive.ql.io.parquet.serde.ParquetHiveSerDe'
STORED AS INPUTFORMAT 'org.apache.hadoop.hive.ql.io.SymlinkTextInputFormat'
OUTPUTFORMAT 'org.apache.hadoop.hive.ql.io.IgnoreKeyTextOutputFormat'
LOCATION 's3://s3-inventory-demo-report-20260930/s3-inventory-demo-source-20260930/demo-log-inventory/hive/'
TBLPROPERTIES (
  "projection.enabled"          = "true",
  "projection.dt.type"          = "date",
  "projection.dt.format"        = "yyyy-MM-dd-HH-mm",
  "projection.dt.range"         = "2026-09-24-01-00,NOW",
  "projection.dt.interval"      = "1",
  "projection.dt.interval.unit" = "HOURS"
);
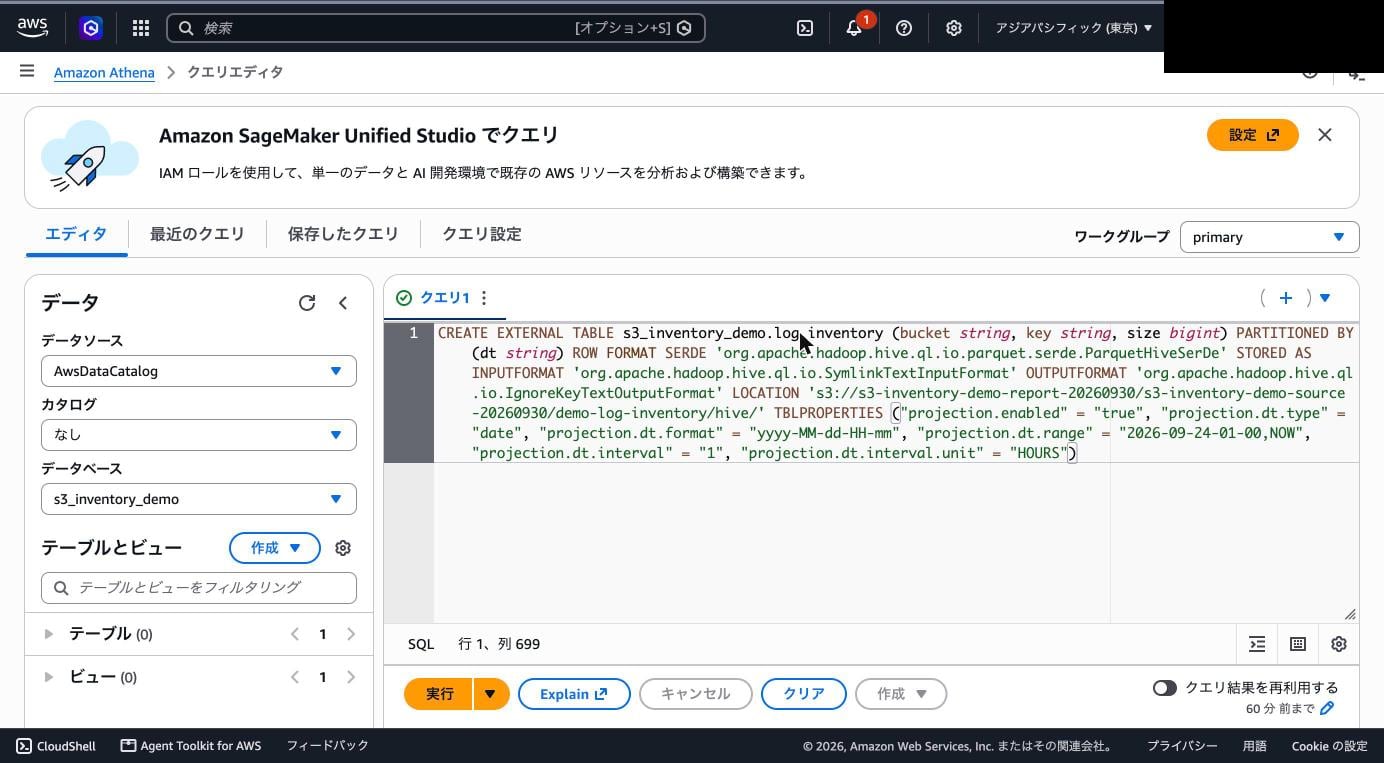
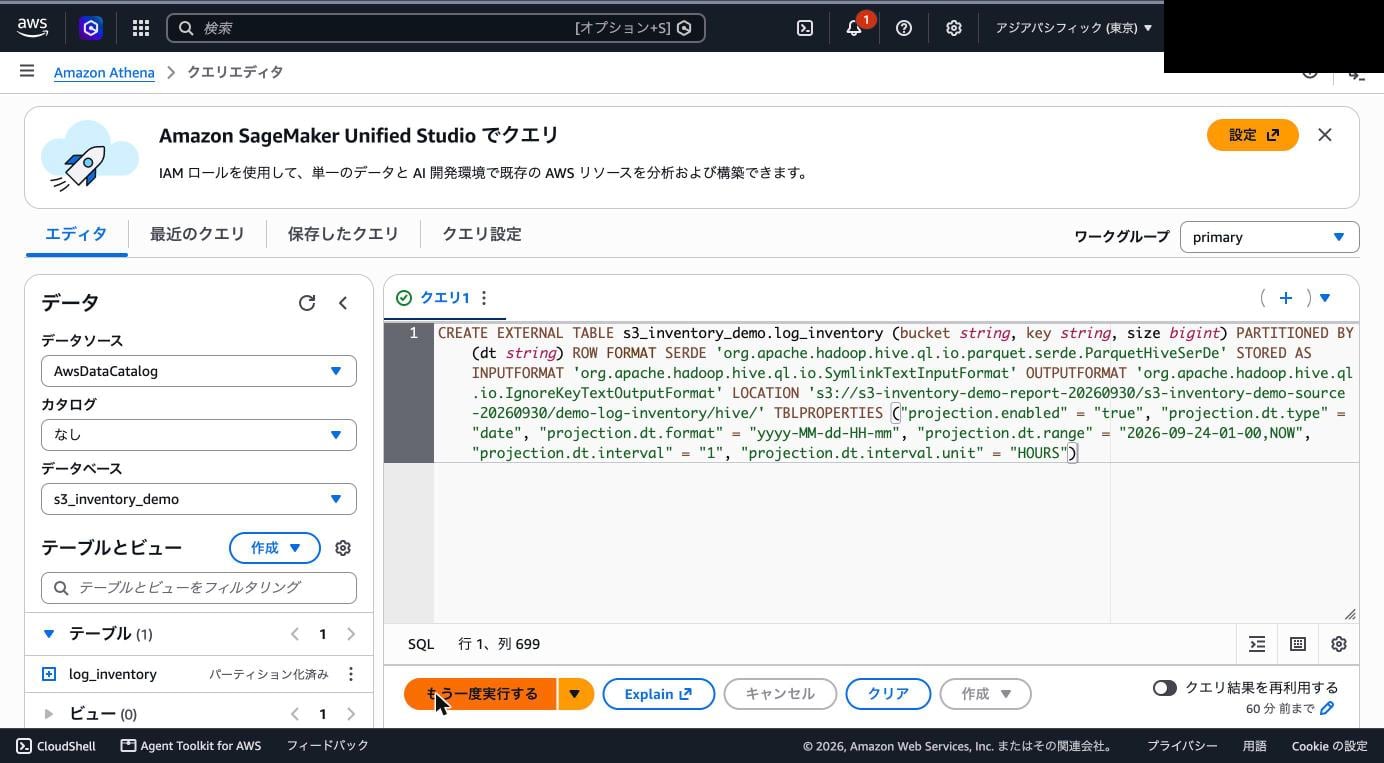
実行すると、左ペインにテーブルが「パーティション化済み」として表示されます。
押さえておきたい点は3つです。
カラム定義はレポートのスキーマと一致させます。 オプションフィールドで選んでいない列は書きません。今回は Size のみ選んだので3カラムです。
LOCATION は hive/ を指します。data/ ではありません。 インベントリの出力先には data/ と hive/ が作られますが、Parquetの実データは日付で分かれず data/ に平置きされています。hive/ 配下には日付ごとに symlink.txt が置かれ、その日のレポートを構成するParquetのパスが書かれています。hive/ を指して SymlinkTextInputFormat を使うことで、dt パーティションごとに必要なファイルだけを読むという挙動になります。
Partition Projectionを有効にすると、パーティション管理が不要になります。 MSCK REPAIR TABLE を実行する必要がなく、新しいレポートが出力されれば追加作業なしでクエリ対象になります。projection.dt.range には、出力先の hive/dt=... で最も古い値を指定します。
5. クエリを実行する
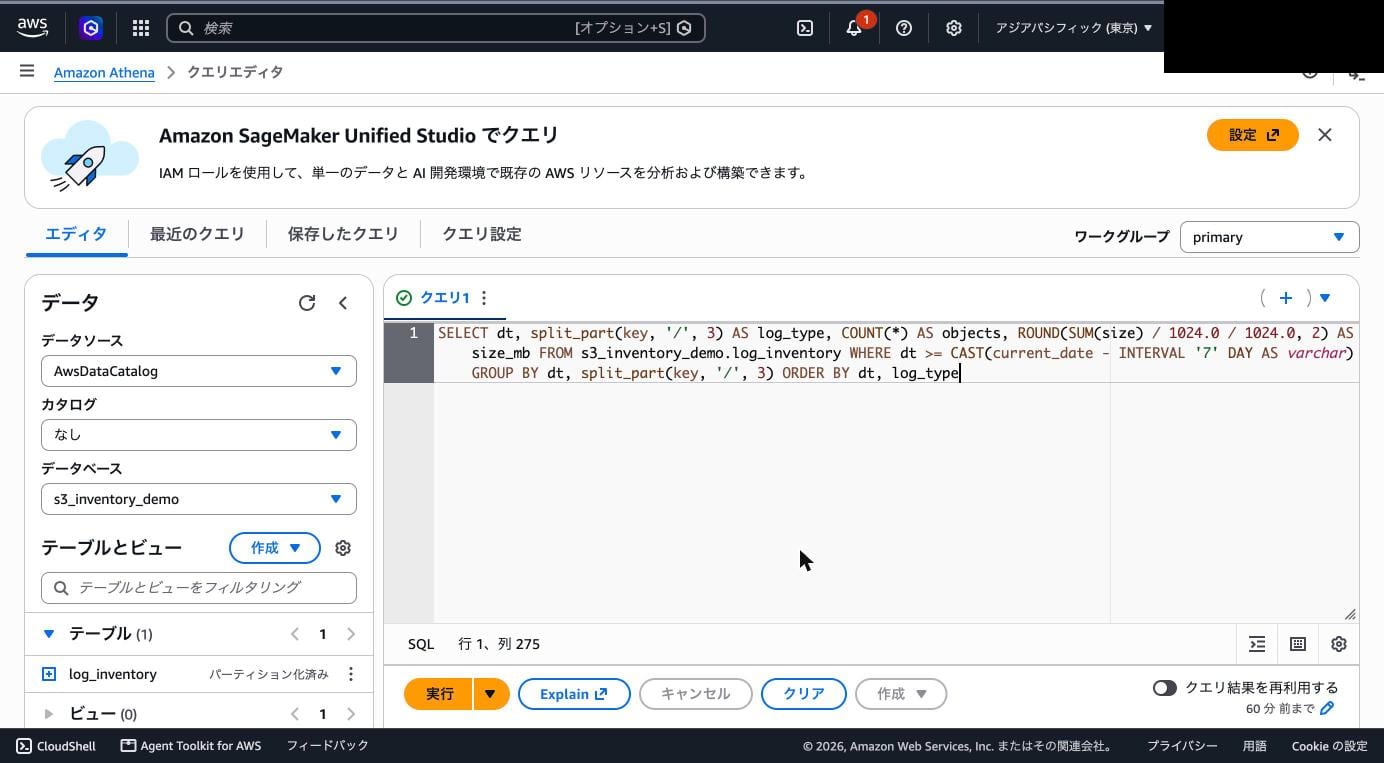
直近1週間のオブジェクト数と容量の推移を、プレフィックスの階層別に集計します。
CloudTrailログのキーは以下の構造です。
AWSLogs/123456789012/CloudTrail/ap-northeast-1/2026/09/27/....json.gz
   ↑第1層      ↑第2層      ↑第3層         ↑第4層
SELECT dt,
       split_part(key, '/', 3)               AS log_type,
       COUNT(*)                              AS objects,
       ROUND(SUM(size) / 1024.0 / 1024.0, 2) AS size_mb
FROM s3_inventory_demo.log_inventory
WHERE dt >= CAST(current_date - INTERVAL '7' DAY AS varchar)
GROUP BY dt, split_part(key, '/', 3)
ORDER BY dt, log_type;
実行結果です。
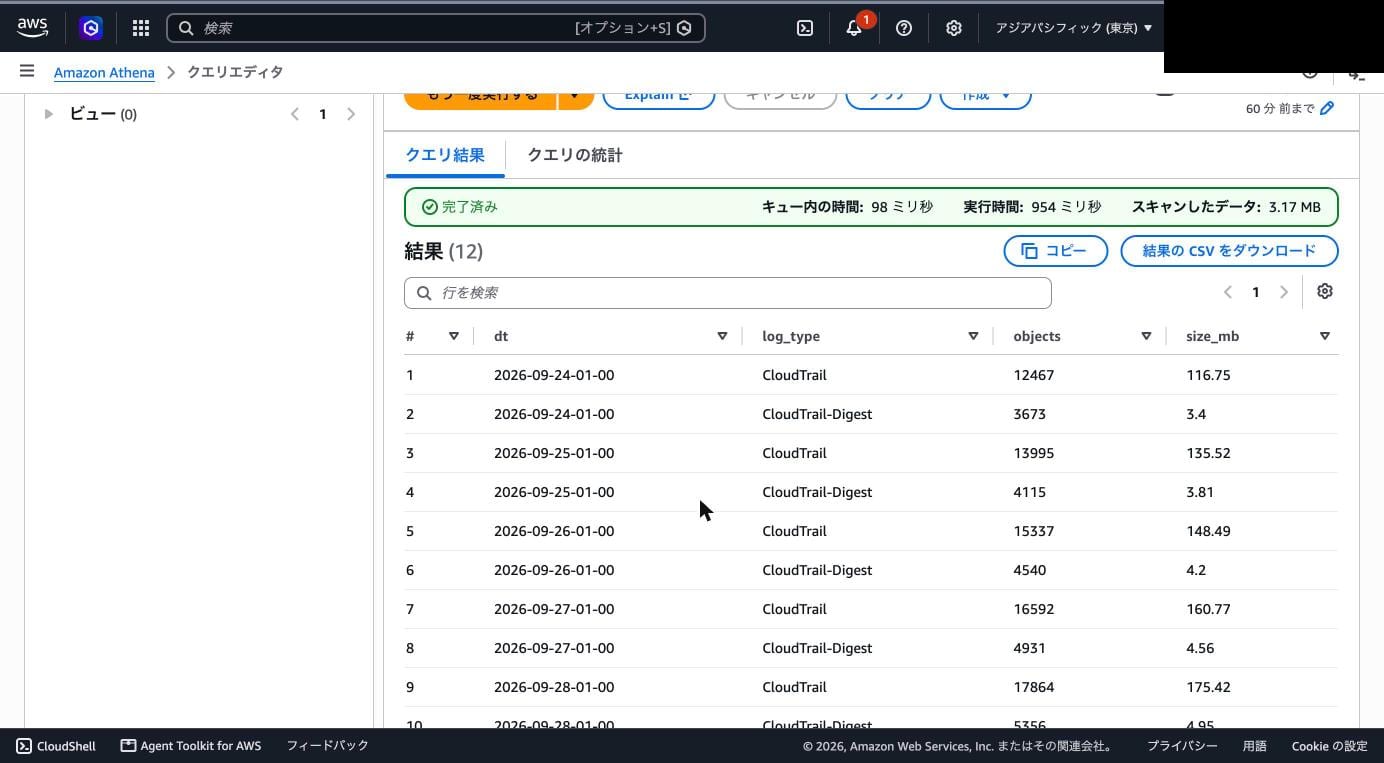
ログ本体が5日間で 12,467件・116.75MiB から 17,864件・175.42MiB へ増えている様子が一目で分かります。実行時間は954ミリ秒、スキャンしたデータは3.17MBでした。
料金について
Athenaはスキャンしたデータ量に対する従量課金です(1クエリあたり最小10MB、以降は1MB単位で切り上げ)。DDLや失敗したクエリは課金されません。
料金は1TBのスキャンあたり5$です。
インベントリログがテラオーダのサイズになることは稀だとは思いますが、
レポートが大きくなってきた場合は、WHERE dt で対象日を絞る、インベントリ設定でプレフィックスを絞る、といった対策が効きます。ワークグループの「実行コントロール」でスキャンされるデータの上限を設定しておくと、想定外の高額クエリを実行前に止められます。
最後に
S3バケット内のオブジェクトを分析したい、特定のプレフィックスや階層を指定して分析したい場合にS3インベントリ+Athenaの分析方法は有効です。
インベントリの出力対象やSQLを変更すれば、さらに多くの集計・分析が行えます。
S3オブジェクトの集計をされる方の一助になれば幸いです。