Muse Gadget SDKにAmazon Pollyで日本語読み上げを追加する ― M5Stack Core2 for AWS

はじめに
前回は、M5Stack Core2 for AWSにMuse Gadget SDKのファームウェアを書き込み、Museアプリとのペアリングと音声での質問まで試しました。今回はその続きとして、日本語の字幕表示を有効にし、Museの返答を本体のスピーカーから日本語で読み上げられるようにします。
日本語字幕にはSDKのCJKフォントを使います。読み上げにはAmazon Pollyを使い、API GatewayとLambdaで作ったTTS APIへMuseの返答テキストを送る構成にしました。
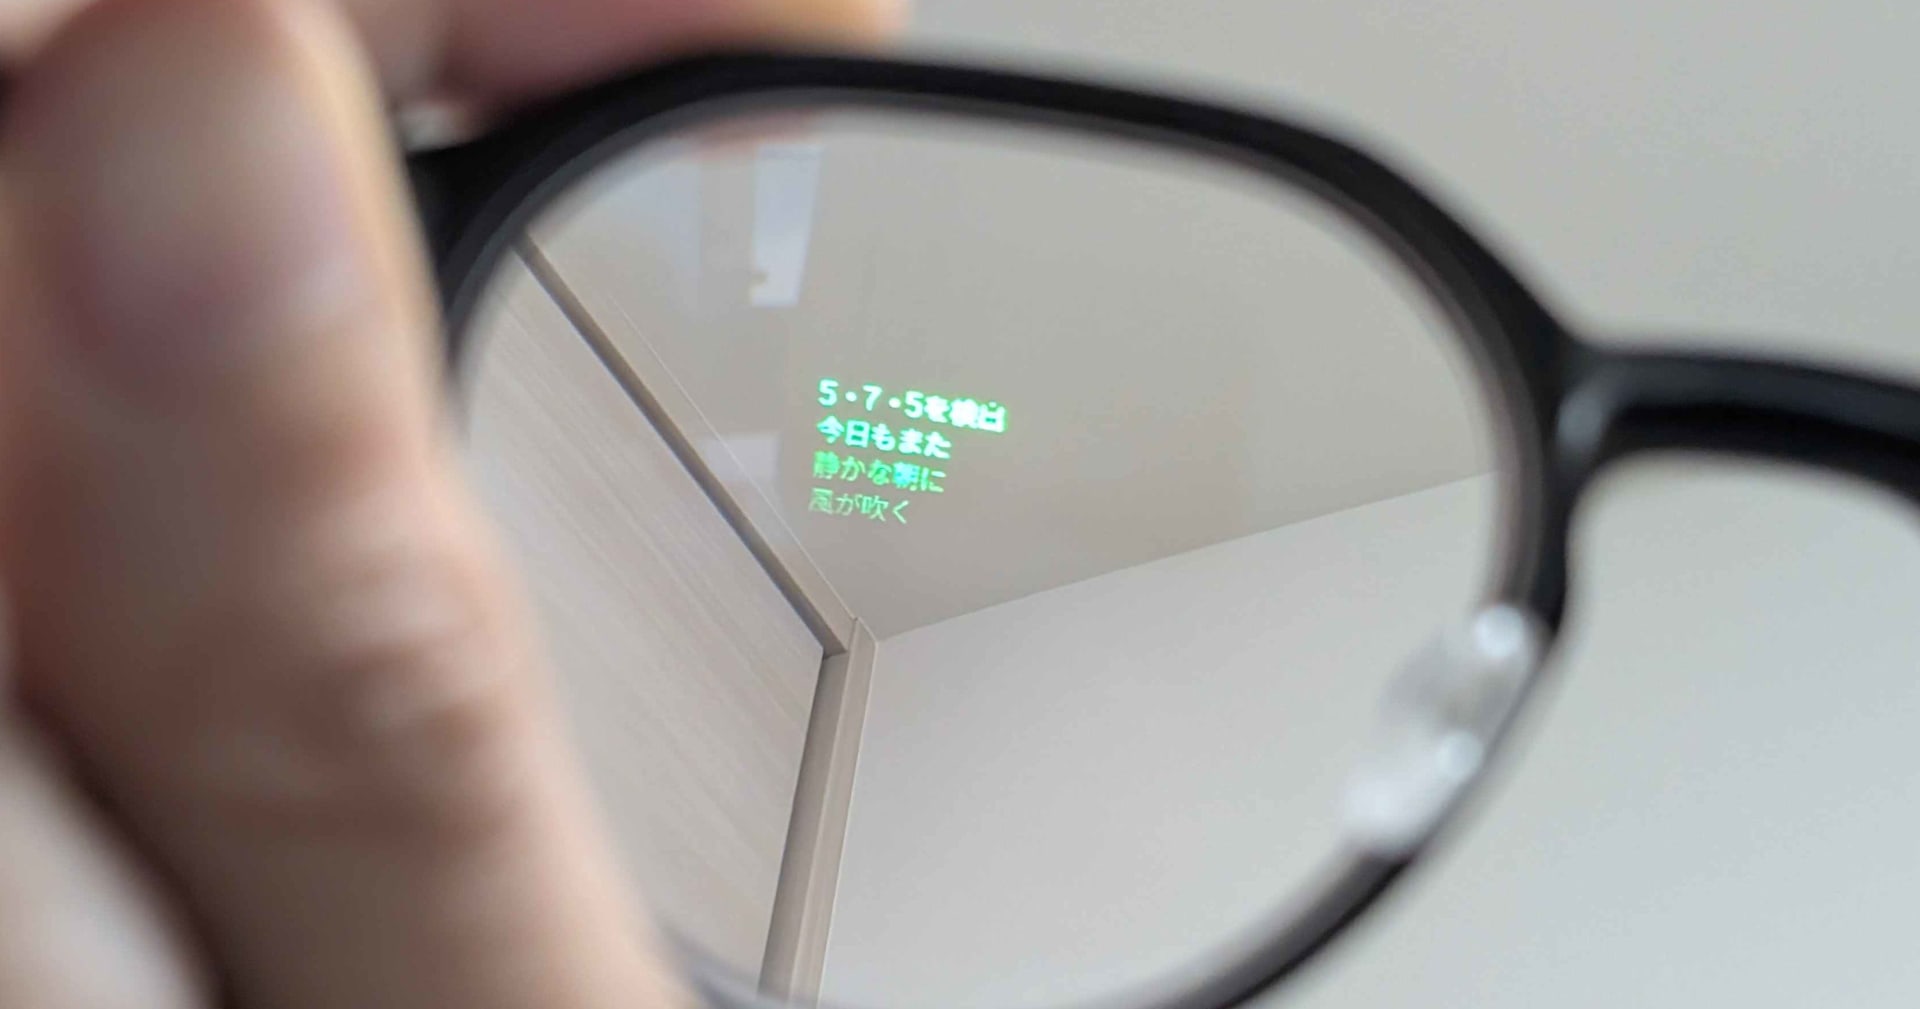
実機では、日本語で質問して日本語の返答を読み上げるところまで確認できました。字幕には一部文字化けが残るものの、音声でのやり取りができるようになりました。
今回は、港区の天気と新着メールの有無を声で尋ねる2パターンを試しました。メールの確認では「内容は読み上げないで」と添えています。この記事では、このように日本語で質問して、Core2から音声で返答を聞けるようにするまでの手順を紹介します。
港区の天気を聞く
新着メールの有無を聞く
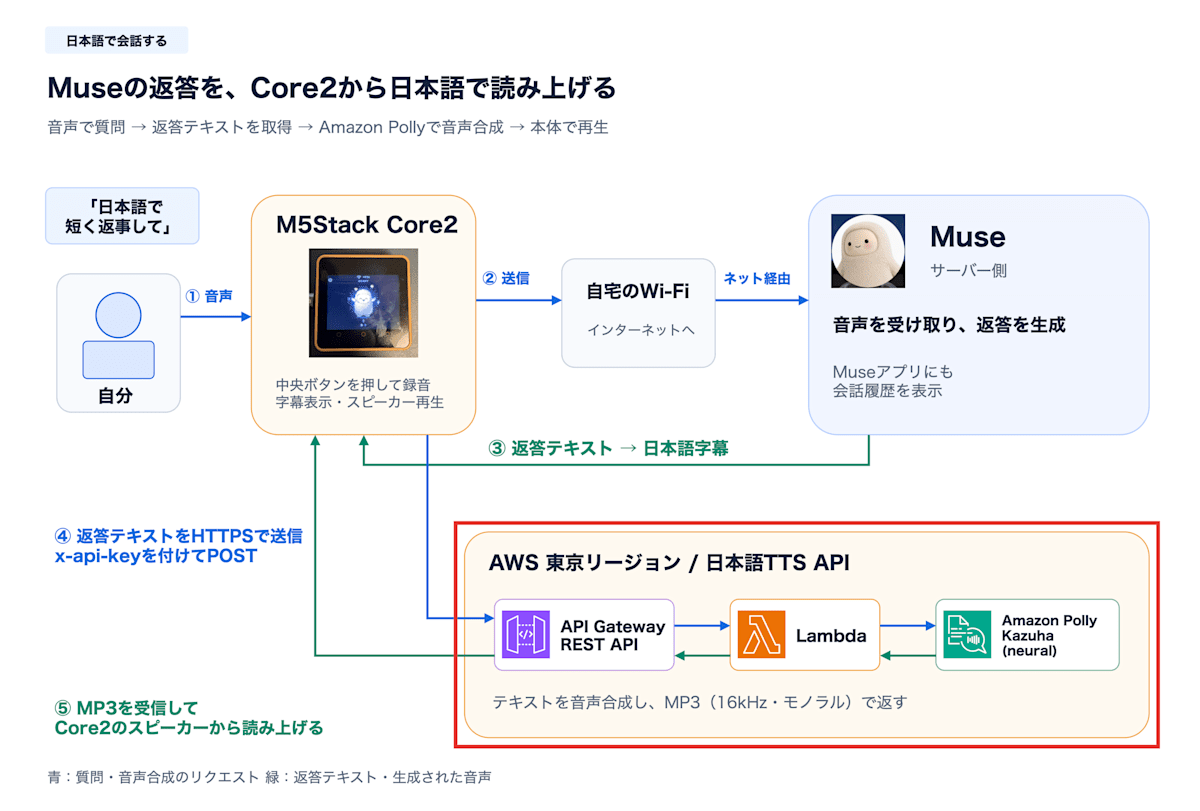
今回の構成
前回と同じく、Core2からWi-Fi経由でMuseへ音声を送ります。Museから受け取った返答テキストを画面に表示し、そのテキストをAWS上のTTS APIにも送って音声に変換します。
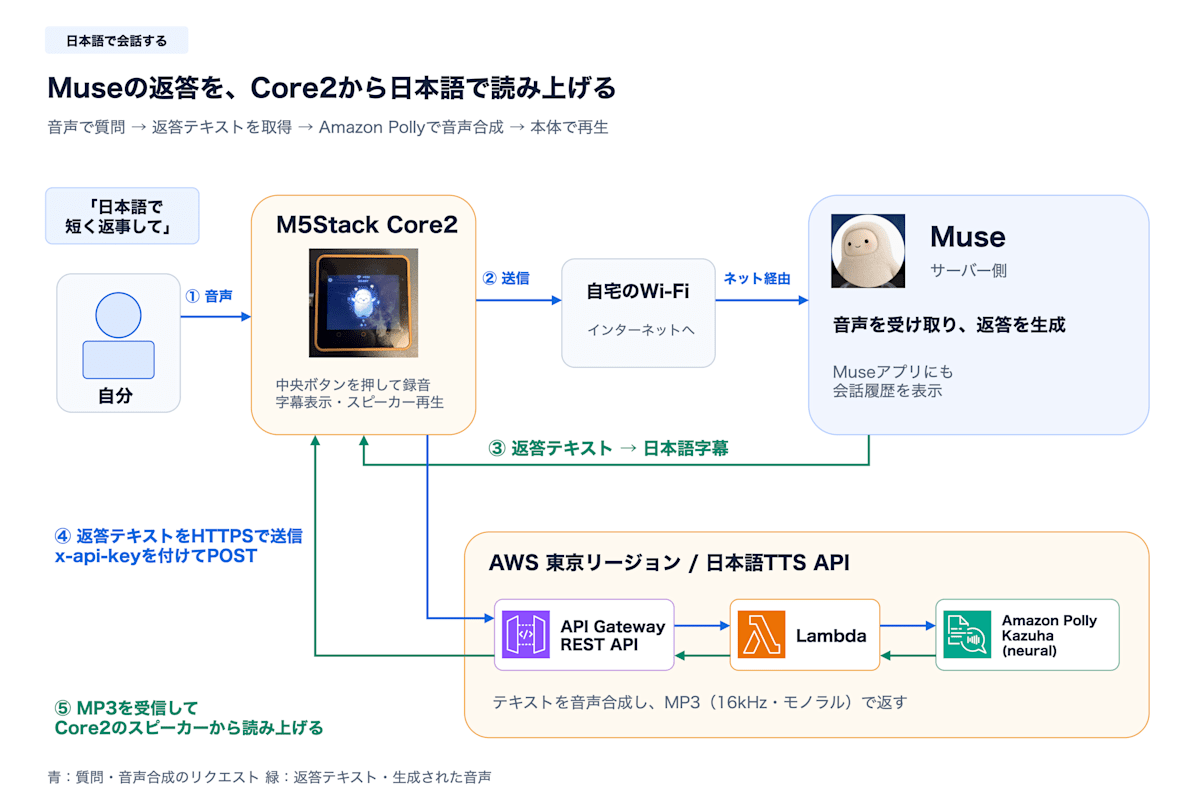
スマートフォンは初回のペアリングやWi-Fi設定に使います。設定後のMuseとの通信やTTS APIの呼び出しはCore2自身が行います。
Pollyの音声と音声合成エンジンはLambda側で指定します。Core2側で設定するのは、日本語フォントとTTSの有効化、APIのURL、APIキーです。AWSアクセスキーをCore2に保存する必要はありません。
使用する環境
| 項目 | 今回の環境 |
|---|---|
| 本体 | M5Stack Core2 for AWS(AXP192搭載、Core2 v1.0相当) |
| 開発環境 | macOS、ESP-IDF v6.0.1 |
| 本体の初期状態 | Museアプリとのペアリング・Wi-Fi設定済み |
| ファームウェア | GitHub:Muse Gadget SDK(外部TTS対応、e539d58) |
| CDKソース | GitHub:aws-tts-api |
SDKトークンの取得、ESP-IDFの導入、Museアプリとのペアリングについては、前回の記事で紹介しています。
日本語表示を有効にする
まずはSDK標準のCJKフォントを有効にし、日本語の返答を表示できることを確認します。ここではソースコードの変更は不要です。
ESP-IDFを有効にして設定画面を開く
ここからはSDKのesp32ディレクトリで作業します。ESP-IDFの保存先は自分の環境に合わせます。
. "$HOME/esp/esp-idf-v6/export.sh"
cd "$HOME/repos/github.com/shuntaka9576/muse-gadget-sdk/esp32"

idf.py --version

idf.py -B build-muse-m5stack-core2 \
  -DIDF_TARGET=esp32 \
  -DSDKCONFIG=build-muse-m5stack-core2/sdkconfig \
  -DSDKCONFIG_DEFAULTS="sdkconfig.defaults;devices/sdkconfig.muse;devices/sdkconfig.muse-m5stack-core2" \
  menuconfig
今回はESP-IDF v6.0.1でビルドしています。menuconfigを実行すると、次の設定画面が開きます。
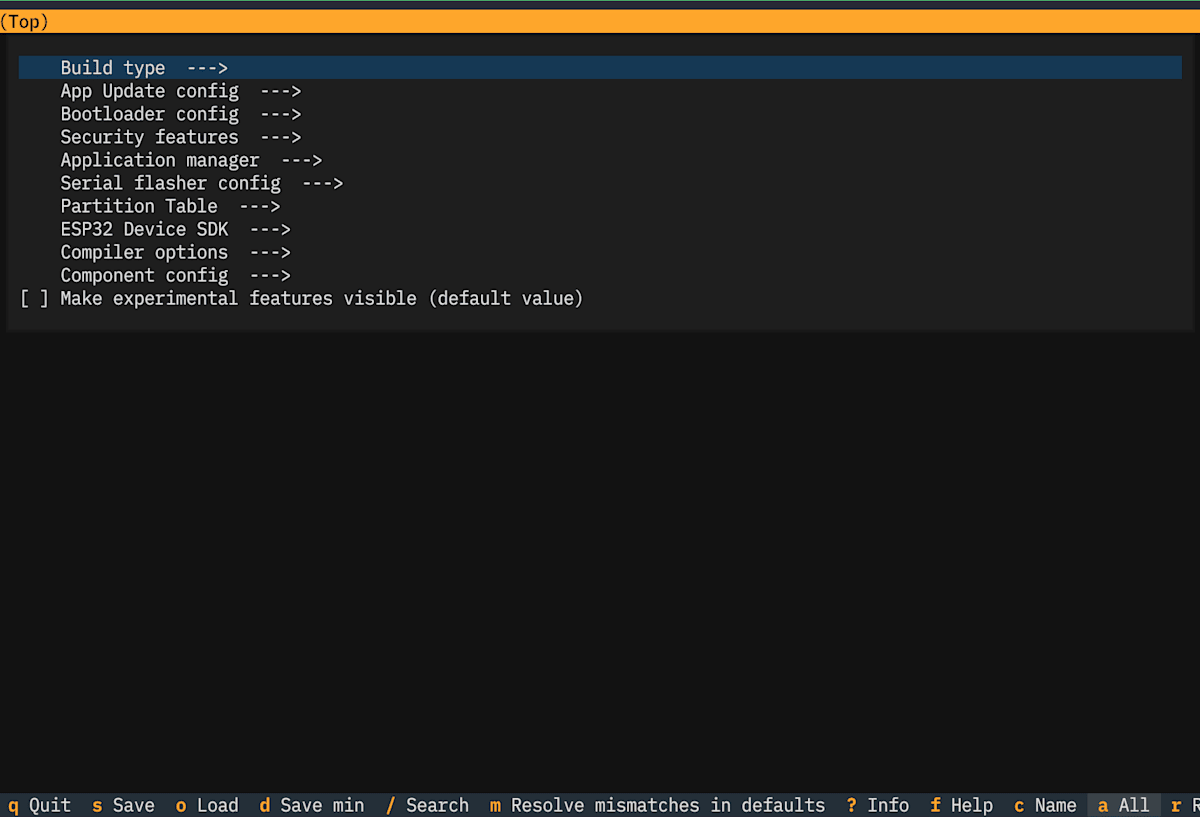
/キーを押すと検索画面に切り替わります。画面上部の入力欄に、設定項目の名前を入力します。
日本語フォントを有効にする
検索欄にMUSE_CJK_FONTと入力します。検索結果からEnterで設定項目へ移動し、Show Chinese and Japanese in captionsをSpaceで有効にします。左側の表示が[ ]から[*]に変われば有効です。
CJKフォントは、日本語のかな・漢字などを表示するためのフォントです。標準では無効なので、今回のように日本語の字幕を表示する場合に有効にします。
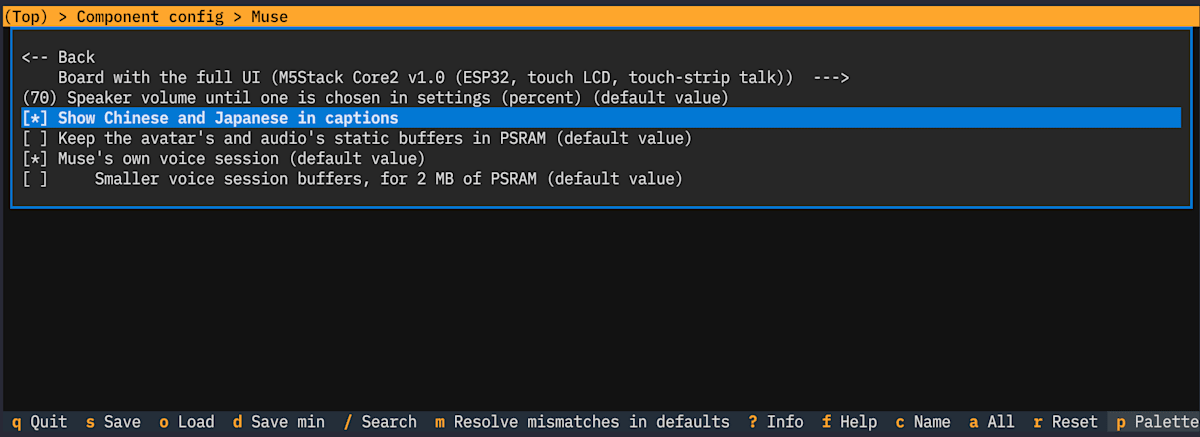
ここで一度、日本語表示を実機で確認します。sでbuild-muse-m5stack-core2/sdkconfigに保存し、qで設定画面を終了します。
SDKのesp32ディレクトリで、ファームウェアをビルドします。
tools/muse/board.sh build core2
ビルドが正常終了したら、USBで接続したCore2のポートを確認します。
python tools/muse/ports.py --list
表示されたポートに合わせてCORE2_PORTを設定し、本体へ書き込みます。
export CORE2_PORT="/dev/cu.usbserial-XXXXXXXX"
tools/muse/board.sh flash core2 "$CORE2_PORT"
本体が再起動してREADYに戻ったら、中央のタッチボタンを押しながら「こんにちは。日本語で短く返事して」と話しかけます。
CJKフォントを有効にしたファームウェアを書き込み、日本語の返答を表示した様子です。
AWSに日本語TTS APIを用意する
続いて、構成図の赤枠部分にあたるTTS APIをAWS上に用意します。API Gatewayでリクエストを受け付け、LambdaからAmazon Pollyを呼び出して音声を生成します。
Pollyの設定
Pollyの設定は次のとおりです。
| 項目 | 設定 |
|---|---|
| 音声 | Kazuha |
| エンジン | neural |
| 言語 | ja-JP |
| 音声形式 | MP3、16kHz、モノラル |
Polly・API Gateway・Lambdaなどの利用料金が発生する構成です。
Lambdaにはpolly:SynthesizeSpeechを実行できるIAMロールを付けています。音声とエンジンは、CDKでLambdaの環境変数POLLY_VOICE_ID=Kazuha、POLLY_ENGINE=neuralとして設定しています。
LambdaからはMP3をBase64エンコードしたプロキシレスポンスで返し、API Gatewayのバイナリメディアタイプにaudio/mpegを登録しています。Core2が受け取るのは、API Gatewayがバイナリに戻したMP3です。
ローカルで音声合成を確認する
まずMac上でTTS APIを起動し、日本語の音声を確認します。デプロイするLambdaと共通の処理を使ってPollyを呼び出すため、この段階でもPollyの利用料金は発生します。
polly:SynthesizeSpeechの権限を持つAWS資格情報を取得済みのシェルで作業します。以下のyour-profileは使用するプロファイル名に置き換えます。一時認証情報が設定済みの場合は、AWS_PROFILEの指定は不要です。aws sts get-caller-identityで接続先のAWSアカウントと実行主体を確認します。
cd "$HOME/repos/github.com/shuntaka9576"
git clone https://github.com/shuntaka9576/aws-tts-api.git
cd aws-tts-api

export AWS_PROFILE=your-profile
export AWS_REGION=ap-northeast-1
export CDK_DEFAULT_REGION=ap-northeast-1

aws sts get-caller-identity

bun install --frozen-lockfile
ローカルサーバーを起動します。
bun run dev
別のターミナルから、読み上げたい日本語をcurlで送信します。ローカル確認用のAPIキーはlocal-dev-keyです。
curl --silent --show-error --fail-with-body http://127.0.0.1:3000/tts \
  -H 'x-api-key: local-dev-key' \
  -H 'Content-Type: application/json' \
  -H 'Accept: audio/mpeg' \
  --data '{"text":"こんにちは。日本語の音声合成のテストです。"}' \
  --output reply-local.mp3 \
  --write-out 'HTTP status: %{http_code}\nContent-Type: %{content_type}\n'
HTTP status: 200
Content-Type: audio/mpeg
MP3を再生して、日本語で読み上げられることを確認します。
afplay reply-local.mp3
確認できたら、サーバーを起動したターミナルでCtrl+Cを押して終了します。このローカルサーバーはHTTPなので、HTTPSを使うCore2向けには、次の手順でAPI Gatewayのエンドポイントを用意します。
CDKでデプロイする
同じaws-tts-apiディレクトリで、型チェックとテストを実行し、CloudFormationテンプレートを生成します。
bun run type-check
bun run test
bun run synth
対象アカウント・リージョンでCDKを初めて使う場合は、先にbootstrapします。
bunx cdk bootstrap
差分を確認してデプロイします。デプロイ結果はJSONファイルにも保存します。
bun run diff
bun run deploy --outputs-file /tmp/aws-tts-outputs.json
今回の実行では、AwsTtsApiの1スタックに差分があり、デプロイ後にCREATE_COMPLETEになりました。以下は出力の抜粋です。エンドポイントとAPIキーIDは伏せています。
Number of stacks with differences: 1

CREATE_COMPLETE | AWS::CloudFormation::Stack | AwsTtsApi
Deployment time: 58.14s

AwsTtsApi.ApiKeyId = <APIキーID>
AwsTtsApi.TtsEndpoint = https://<api-id>.execute-api.ap-northeast-1.amazonaws.com/v1/tts

Total time: 68.86s
TtsEndpointがCore2から呼び出すURL、ApiKeyIdが次の手順でAPIキーの値を取得するためのIDです。
デプロイしたAPIのキーを取得して音声を確認する
ApiKeyIdはキーを識別するIDです。リクエストやCore2の設定には、別途取得するAPIキーの「値」を使います。
export TTS_ENDPOINT='デプロイ結果のTtsEndpoint'
export TTS_API_KEY_ID='デプロイ結果のApiKeyId'
export TTS_API_KEY="$(aws apigateway get-api-key \
  --region ap-northeast-1 \
  --api-key "$TTS_API_KEY_ID" \
  --include-value \
  --query value \
  --output text)"
APIキーは環境変数TTS_API_KEYに保存されるため、画面への出力はありません。
curlで、読み上げたい日本語をJSONとして送信します。レスポンスの音声はreply.mp3に保存し、--write-outでHTTPステータス、Content-Type、取得サイズを表示します。
curl --silent --show-error --fail-with-body "$TTS_ENDPOINT" \
  -H "x-api-key: $TTS_API_KEY" \
  -H 'Content-Type: application/json' \
  -H 'Accept: audio/mpeg' \
  --data '{"text":"こんにちは。日本語の音声合成のテストです。"}' \
  --output reply.mp3 \
  --write-out 'HTTP status: %{http_code}\nContent-Type: %{content_type}\nDownloaded: %{size_download} bytes\n'
出力は次のようになります。取得サイズは、今回の動作確認で得られた値です。
HTTP status: 200
Content-Type: audio/mpeg
Downloaded: 19124 bytes
HTTP 200とaudio/mpegを確認できたら、保存したMP3を再生します。APIキーを付けないリクエストはHTTP 403になることも確認できました。
afplay reply.mp3
Macで日本語の読み上げを確認できたら、Core2に同じURLとAPIキーを設定します。
Muse Gadget SDKからTTS APIを呼び出す
SDK側には、Museから受け取った返答テキストを外部TTS APIに送り、MP3を再生する処理を追加しました。
ここで変更するのは、構成図の赤枠で示したCore2上で動くSDKです。
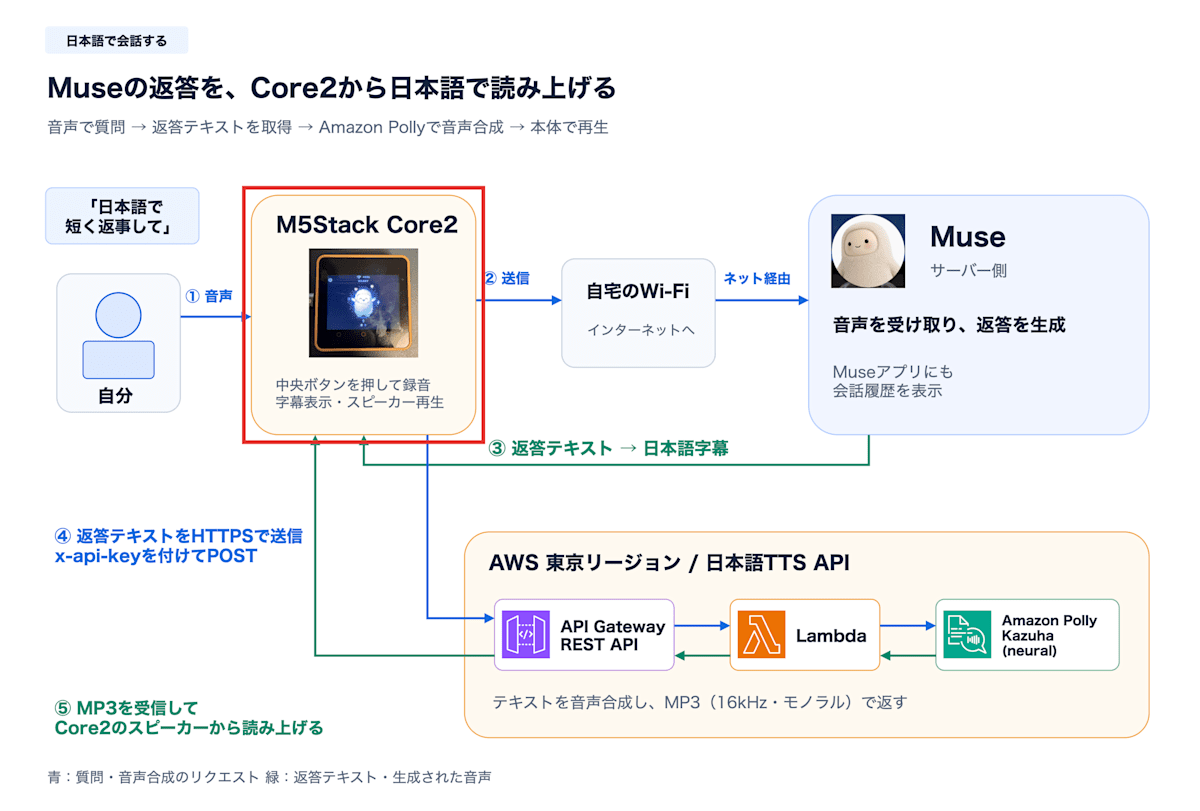
返答を受け取ってから読み上げるまでの流れは、次のとおりです。
APIへの通信は専用タスクで行い、受信したMP3を既存のデコーダーへ渡します。TLS証明書はESP-IDFのCAバンドルで検証します。
ミュート中はTTS APIを呼ばず、APIの呼び出しやMP3のデコードに失敗した場合は字幕表示へ戻します。新しい質問に切り替わった場合は、キャンセル済みの返答音声を再生しないようにしています。
音声全体を受け取ってから再生するため、読み上げが始まるまでに音声合成とダウンロードの時間がかかります。また、SDKが保持する返答テキストは1メッセージ最大1,023バイトなので、長い返答は途中までの読み上げになります。
SDKの変更差分
今回の変更は、SDKのc9354b7をベースにしています。標準のSDKでは返答を字幕表示するため、外部TTSへの通信処理とMP3再生への接続を追加しました。変更後のコミットはe539d58で、GitHubの変更差分からも確認できます。以下は実装とテストの変更差分です。
TUIの設定項目を追加する
menuconfigに表示する項目は、esp32/components/muse/Kconfigで定義します。既存のmenu "Muse"内に、TTSの有効・無効を切り替えるboolと、URL・APIキーを入力するstringを追加しました。
Kconfigの差分
diff --git a/esp32/components/muse/Kconfig b/esp32/components/muse/Kconfig
index cab98f5..b7dcb77 100644
--- a/esp32/components/muse/Kconfig
+++ b/esp32/components/muse/Kconfig
@@ -202,6 +202,27 @@ menu "Muse"
             memory and preview decoding shares CPU time with voice and Link.
             Leave disabled to build without camera support.

+    config MUSE_HTTP_TTS
+        bool "Speak replies using an HTTPS TTS API"
+        depends on MUSE_HATCH
+        default n
+        help
+            POST reply text to a TTS API and play its MP3 response.
+            Requires PSRAM. Failed requests fall back to captions.
+
+    config MUSE_HTTP_TTS_URL
+        string "TTS API HTTPS endpoint"
+        depends on MUSE_HTTP_TTS
+        default ""
+
+    config MUSE_HTTP_TTS_API_KEY
+        string "TTS API key (x-api-key)"
+        depends on MUSE_HTTP_TTS
+        default ""
+        help
+            Stored in the local sdkconfig and compiled firmware. Never commit
+            or share these files with the key included.
+
     config MUSE_CJK_FONT
         bool "Show Chinese and Japanese in captions"
         depends on MUSE_ENABLED
depends onは、項目を設定できる条件です。
| 設定項目 | 必要な条件 |
|---|---|
MUSE_HTTP_TTS |
MUSE_HATCH(Museの音声セッション)が有効 |
MUSE_HTTP_TTS_URL・MUSE_HTTP_TTS_API_KEY |
MUSE_HTTP_TTSが有効 |
Core2用の初期設定ではボードとPSRAMが有効になるため、MUSE_HATCHも既定で有効になります。保存済みの設定で無効にしている場合は、/でMUSE_HATCHを検索し、Muse's own voice sessionを有効にします。
HTTPS通信処理を追加する
新しく追加したmuse_tts_http.cppでは、返答テキストをJSONにしてTTS APIへ送ります。送信先とAPIキーには、TUIで設定した値を使います。通信を専用タスクで実行し、受信が完了したMP3を会話処理へ返す構成です。
HTTPステータス、Content-Type、受信サイズを確認し、キャンセルされた会話の音声を破棄します。
muse_tts_http.h・muse_tts_http.cppの追加差分
diff --git a/esp32/components/muse/muse_tts_http.h b/esp32/components/muse/muse_tts_http.h
new file mode 100644
--- /dev/null
+++ b/esp32/components/muse/muse_tts_http.h
@@ -0,0 +1,14 @@
+#pragma once
+#include <stddef.h>
+#include <stdint.h>
+
+struct muse_tts_result_t {
+    uint32_t generation;
+    int message;
+    uint8_t *audio;  // caller frees; null on failure
+    size_t length;
+};
+// Called only from the chat task. The worker never touches chat state.
+bool muse_tts_http_start(const char *text, uint32_t generation, int message, size_t capacity);
+bool muse_tts_http_poll(muse_tts_result_t *result);
+void muse_tts_http_cancel(void);
diff --git a/esp32/components/muse/muse_tts_http.cpp b/esp32/components/muse/muse_tts_http.cpp
new file mode 100644
--- /dev/null
+++ b/esp32/components/muse/muse_tts_http.cpp
@@ -0,0 +1,156 @@
+#include "sdkconfig.h"
+#if CONFIG_MUSE_HTTP_TTS
+#include "muse_tts_http.h"
+#include <atomic>
+#include <cstdlib>
+#include <cstring>
+#include <strings.h>
+#include "cJSON.h"
+#include "esp_crt_bundle.h"
+#include "esp_heap_caps.h"
+#include "esp_http_client.h"
+#include "esp_log.h"
+#include "esp_timer.h"
+#include "freertos/FreeRTOS.h"
+#include "freertos/queue.h"
+#include "freertos/task.h"
+
+static const char *TAG = "muse_tts_http";
+struct request_t { char *body; uint32_t generation; int message; size_t capacity; uint32_t ticket; };
+static QueueHandle_t s_requests, s_results;
+static bool s_busy;
+static std::atomic<uint32_t> s_ticket{0};
+struct download_t {
+    uint8_t *audio;
+    size_t length, capacity;
+    uint32_t ticket;
+    int64_t deadline;
+    bool failed, audio_type;
+};
+
+static esp_err_t on_http(esp_http_client_event_t *event)
+{
+    auto *d = static_cast<download_t *>(event->user_data);
+    if (d->ticket != s_ticket.load() || esp_timer_get_time() > d->deadline) {
+        d->failed = true;
+        return ESP_FAIL;
+    }
+    if (event->event_id == HTTP_EVENT_ON_HEADER &&
+        !strcasecmp(event->header_key, "Content-Type")) {
+        const char *v = event->header_value;
+        d->audio_type = !strncasecmp(v, "audio/mpeg", 10) && (v[10] == 0 || v[10] == ';');
+    }
+    if (event->event_id == HTTP_EVENT_ON_DATA) {
+        if (event->data_len < 0 || static_cast<size_t>(event->data_len) > d->capacity - d->length) {
+            d->failed = true;
+            return ESP_FAIL;
+        }
+        if (esp_http_client_get_status_code(event->client) != 200 || !d->audio_type) {
+            d->failed = true;
+            return ESP_FAIL;
+        }
+        memcpy(d->audio + d->length, event->data, event->data_len);
+        d->length += event->data_len;
+    }
+    return ESP_OK;
+}
+
+static void worker(void *)
+{
+    request_t request;
+    for (;;) {
+        if (xQueueReceive(s_requests, &request, portMAX_DELAY) != pdTRUE) continue;
+        muse_tts_result_t result{request.generation, request.message, nullptr, 0};
+        download_t d{};
+        d.capacity = request.capacity;
+        d.ticket = request.ticket;
+        d.deadline = esp_timer_get_time() + 30000000LL;
+        d.audio = static_cast<uint8_t *>(heap_caps_malloc(d.capacity, MALLOC_CAP_SPIRAM | MALLOC_CAP_8BIT));
+        esp_http_client_config_t config{};
+        config.url = CONFIG_MUSE_HTTP_TTS_URL;
+        config.method = HTTP_METHOD_POST;
+        config.timeout_ms = 25000;
+        config.crt_bundle_attach = esp_crt_bundle_attach;
+        config.disable_auto_redirect = true; // Never forward the key to another endpoint.
+        config.event_handler = on_http;
+        config.user_data = &d;
+        auto client = d.audio ? esp_http_client_init(&config) : nullptr;
+        if (client && request.ticket == s_ticket.load()) {
+            bool configured = esp_http_client_set_header(client, "Content-Type", "application/json") == ESP_OK &&
+                esp_http_client_set_header(client, "Accept", "audio/mpeg") == ESP_OK &&
+                esp_http_client_set_header(client, "x-api-key", CONFIG_MUSE_HTTP_TTS_API_KEY) == ESP_OK &&
+                esp_http_client_set_post_field(client, request.body, strlen(request.body)) == ESP_OK;
+            esp_err_t err = configured ? esp_http_client_perform(client) : ESP_FAIL;
+            int status = esp_http_client_get_status_code(client);
+            if (err == ESP_OK && status == 200 && !d.failed && d.audio_type && d.length &&
+                request.ticket == s_ticket.load() && esp_http_client_is_complete_data_received(client)) {
+                result.audio = d.audio;
+                result.length = d.length;
+                d.audio = nullptr;
+            } else {
+                ESP_LOGW(TAG, "TTS request failed (HTTP %d, %s)", status, esp_err_to_name(err));
+            }
+        }
+        if (client) esp_http_client_cleanup(client);
+        free(d.audio);
+        free(request.body);
+        // One in-flight request; the owner drains this before starting another.
+        xQueueSend(s_results, &result, portMAX_DELAY);
+    }
+}
+
+bool muse_tts_http_start(const char *text, uint32_t generation, int message, size_t capacity)
+{
+    if (s_busy || !text || !text[0] || !capacity ||
+        strncmp(CONFIG_MUSE_HTTP_TTS_URL, "https://", 8) || !CONFIG_MUSE_HTTP_TTS_API_KEY[0]) return false;
+    if (!s_requests) {
+        s_requests = xQueueCreate(1, sizeof(request_t));
+        s_results = xQueueCreate(1, sizeof(muse_tts_result_t));
+        if (!s_requests || !s_results || xTaskCreate(worker, "muse_tts", 8192, nullptr, 4, nullptr) != pdPASS) {
+            if (s_requests) vQueueDelete(s_requests);
+            if (s_results) vQueueDelete(s_results);
+            s_requests = s_results = nullptr;
+            return false;
+        }
+    }
+    // Caption storage can end mid-UTF-8 sequence; trim only that partial suffix.
+    char copy[1024];
+    size_t n = strnlen(text, sizeof(copy) - 1);
+    memcpy(copy, text, n);
+    copy[n] = 0;
+    if (n) {
+        size_t start = n - 1;
+        while (start && (static_cast<unsigned char>(copy[start]) & 0xc0) == 0x80) --start;
+        unsigned char lead = copy[start];
+        size_t width = lead < 0x80 ? 1 : lead < 0xe0 ? 2 : lead < 0xf0 ? 3 : 4;
+        if (n - start < width) copy[start] = 0;
+    }
+    // The API accepts at most 1,000 Unicode characters (not UTF-8 bytes).
+    size_t chars = 0;
+    for (size_t j = 0; copy[j]; ++j) {
+        if ((static_cast<unsigned char>(copy[j]) & 0xc0) != 0x80 && ++chars > 1000) {
+            copy[j] = 0;
+            break;
+        }
+    }
+    cJSON *json = cJSON_CreateObject();
+    if (!json) return false;
+    bool added = cJSON_AddStringToObject(json, "text", copy) != nullptr;
+    char *body = added ? cJSON_PrintUnformatted(json) : nullptr;
+    cJSON_Delete(json);
+    if (!body) return false;
+    request_t request{body, generation, message, capacity, ++s_ticket};
+    if (xQueueSend(s_requests, &request, 0) != pdTRUE) { free(body); return false; }
+    s_busy = true;
+    return true;
+}
+
+bool muse_tts_http_poll(muse_tts_result_t *result)
+{
+    if (!s_results || xQueueReceive(s_results, result, 0) != pdTRUE) return false;
+    s_busy = false;
+    return true;
+}
+
+void muse_tts_http_cancel(void) { ++s_ticket; }
+#endif
返答テキストをTTS処理へ渡す
muse_chat_session.cppのstart_tts()から通信処理を呼び出し、取得したMP3を既存のデコーダーへ渡します。ミュート中やTTSの失敗時には、従来の字幕表示を使います。
muse_chat_session.cppの差分
diff --git a/esp32/components/muse/muse_chat_session.cpp b/esp32/components/muse/muse_chat_session.cpp
index 2866f5d..50a9560 100644
--- a/esp32/components/muse/muse_chat_session.cpp
+++ b/esp32/components/muse/muse_chat_session.cpp
@@ -31,7 +31,8 @@
  * A turn has no explicit end event; like Sidekick, it settles once every
  * message is done and nothing has arrived for a few seconds.
  *
- * Everything network-side runs on one task. The voice task talks to it through
+ * The Muse connection runs on one task; optional HTTPS TTS runs on a worker
+ * and hands completed audio back through a queue. The voice task talks through
  * a command queue, a stream buffer of mic audio, an event queue (captions) and
  * a stream buffer of reply audio. A generation number tags each turn so that
  * events and audio of a cancelled turn are dropped.
@@ -72,6 +73,9 @@ extern "C" {
 #include "muse_wifi.h"
 }
 #include "muse_chat_priv.h"
+#if CONFIG_MUSE_HTTP_TTS
+#include "muse_tts_http.h"
+#endif

 #include <xplat/noise/core/ClientSession.h>
 #include <xplat/noise/core/PsaCryptoBackend.h>
@@ -960,6 +964,9 @@ static void turn_reset_streams(void)

 static void turn_finish(void)
 {
+#if CONFIG_MUSE_HTTP_TTS
+    muse_tts_http_cancel();
+#endif
     turn_reset_streams();
     s_turn.phase = P_IDLE;
     s_turn.dict_id = s_turn.chat_id = 0;
@@ -1508,38 +1515,66 @@ static void on_chat_ack(stream_t *s)

 /* ---- Turn: speech ---- */

-static void start_tts(void)
+static void show_tts_as_text(int i)
 {
-    if (s_turn.tts_msg >= 0) {
-        return;
+    msg_t &m = s_turn.msgs[i];
+    m.pcm_start = s_turn.pcm_out;
+    m.pcm_frames = (uint32_t)(m.len * MIC_RATE / TEXT_CHARS_PER_S);
+    m.tts = TTS_ACTIVE;
+    s_turn.tts_msg = i;
+    s_turn.silent = true;
+    s_turn.mp3_len = 0;
+    s_turn.mp3_ended = false;
+    show_reply_start(m);
+}
+
+#if CONFIG_MUSE_HTTP_TTS
+static void poll_http_tts(void)
+{
+    muse_tts_result_t result{};
+    if (!muse_tts_http_poll(&result)) return;
+    if (s_turn.phase == P_WAIT_REPLY && result.generation == s_turn.gen &&
+        result.generation == s_gen.load() && result.message == s_turn.tts_msg) {
+        if (result.audio && result.length <= MP3_BUF && muse_settings_speaker_on()) {
+            memcpy(s_turn.mp3, result.audio, result.length);
+            s_turn.mp3_len = result.length;
+            s_turn.mp3_ended = true;
+            mark(M_MP3);
+            ESP_LOGI(TAG, "TTS API audio received (%u bytes)", (unsigned)result.length);
+        } else {
+            ESP_LOGW(TAG, "TTS unavailable; showing captions");
+            show_tts_as_text(result.message);
+        }
     }
+    free(result.audio);
+}
+#endif
+
+static void start_tts(void)
+{
+    if (s_turn.tts_msg >= 0) return;
     for (int i = 0; i < s_turn.nmsgs; i++) {
         msg_t &m = s_turn.msgs[i];
-        if (m.tts != TTS_QUEUED) {
-            continue;
+        if (m.tts != TTS_QUEUED) continue;
+#if CONFIG_MUSE_HTTP_TTS
+        if (s_turn.texts && muse_settings_speaker_on() && muse_settings_volume() > 0 &&
+            muse_tts_http_start(s_turn.texts + i * TEXT_MAX, s_turn.gen, i, MP3_BUF)) {
+            m.pcm_start = s_turn.pcm_out;
+            m.pcm_frames = 0;
+            m.tts = TTS_ACTIVE;
+            s_turn.tts_msg = i;
+            s_turn.silent = false;
+            s_turn.mp3_len = 0;
+            s_turn.mp3_ended = false;
+            s_turn.kbps = 0;
+            s_turn.down_rate = 0;
+            mp3dec_init(&s_turn.dec);
+            mark(M_TTS);
+            show_reply_start(m);
+            return;
         }
-        /*
-         * Replies are text, shown at reading pace: silence in place of speech
-         * paces the captions and ends the turn. To speak them instead, send
-         * the message's text (s_turn.texts + i * TEXT_MAX, if texts was
-         * allocated; up to TEXT_MAX - 1 bytes) to a TTS API of your choice and
-         * play the MP3 it returns. In place of the silence below: keep
-         * m.tts = TTS_ACTIVE and s_turn.tts_msg = i, set s_turn.silent = false,
-         * m.pcm_start = s_turn.pcm_out, m.pcm_frames = 0, s_turn.mp3_len = 0,
-         * s_turn.mp3_ended = false, s_turn.kbps = 0, s_turn.down_rate = 0 and
-         * mp3dec_init(&s_turn.dec). Then, on this task, pass the MP3 to
-         * tts_data() as it arrives (it buffers up to MP3_BUF and drops the
-         * rest, so hold off while it's full) and set s_turn.mp3_ended at the
-         * end. decode() plays it at the speaker's volume, captions following,
-         * and finishes the message once it's drained.
-         */
-        m.pcm_start = s_turn.pcm_out;
-        m.pcm_frames = (uint32_t)(m.len * MIC_RATE / TEXT_CHARS_PER_S);
-        m.tts = TTS_ACTIVE;
-        s_turn.tts_msg = i;
-        s_turn.silent = true;
-        ESP_LOGI(TAG, "showing message %s (%u chars)", m.id, (unsigned)m.len);
-        show_reply_start(m);
+#endif
+        show_tts_as_text(i);
         return;
     }
 }
@@ -1648,6 +1683,10 @@ static void decode(void)
         m.pcm_frames = s_turn.pcm_out - m.pcm_start + rest;
     }
     if (s_turn.mp3_ended && !s_turn.mp3_len) {
+        if (s_turn.kbps == 0) {
+            show_tts_as_text(s_turn.tts_msg);
+            return;
+        }
         m.pcm_frames = s_turn.pcm_out - m.pcm_start;
         m.tts = TTS_FINISHED;
         s_turn.tts_msg = -1;
@@ -1961,6 +2000,9 @@ static void hatch_task(void *arg)
                 handle(cmd);
             }
         }
+#if CONFIG_MUSE_HTTP_TTS
+        poll_http_tts();
+#endif
         if (!s_connected) {
             if (!muse_wifi_connected()) {
                 s_auto_next_us = 0;
ビルド対象に登録する
CMakeLists.txtのソース一覧にもmuse_tts_http.cppを追加します。これで、追加した通信処理がファームウェアに組み込まれます。
CMakeLists.txtの差分
diff --git a/esp32/components/muse/CMakeLists.txt b/esp32/components/muse/CMakeLists.txt
index d20c459..09c487b 100644
--- a/esp32/components/muse/CMakeLists.txt
+++ b/esp32/components/muse/CMakeLists.txt
@@ -43,7 +43,7 @@ if(CONFIG_MUSE_ENABLED)
         "muse_link.c"
         "muse_ble.c")
     if(CONFIG_MUSE_HATCH)
-        list(APPEND srcs "muse_chat.c" "muse_account_api.c" "muse_chat_session.cpp")
+        list(APPEND srcs "muse_chat.c" "muse_account_api.c" "muse_chat_session.cpp" "muse_tts_http.cpp")
         list(APPEND embed "test_reply.mp3")   # muse_hatch_mp3_selftest
     else()
         list(APPEND srcs "muse_chat_link.c")   # text replies over Link's session
@@ -133,7 +133,7 @@ if(CONFIG_MUSE_ENABLED)
 elseif(CONFIG_HOMEHUB_VOICE)
     # The Voice PE board uses just the Hatch voice session; the project's main/
     # voice_muse_chat.c stands in for the Muse settings, Wi-Fi and Link hooks.
-    list(APPEND srcs "muse_chat.c" "muse_account_api.c" "muse_chat_session.cpp" "muse_chat_text.c" "muse_text.c")
+    list(APPEND srcs "muse_chat.c" "muse_account_api.c" "muse_chat_session.cpp" "muse_tts_http.cpp" "muse_chat_text.c" "muse_text.c")
     list(APPEND embed "test_reply.mp3")
 endif()
応答の検証と再生への受け渡しをテストする
追加したホストテストでは、HTTPエラー、受信サイズ超過、キャンセル済みの応答、ミュート時や失敗時の字幕表示などを確認します。
test_muse_tts_http.pyの追加差分
diff --git a/esp32/tests/test_muse_tts_http.py b/esp32/tests/test_muse_tts_http.py
new file mode 100644
--- /dev/null
+++ b/esp32/tests/test_muse_tts_http.py
@@ -0,0 +1,99 @@
+"""Host tests of the production HTTPS response guards and playback handoff."""
+from pathlib import Path
+import os
+import shlex
+import subprocess
+import tempfile
+import unittest
+ROOT = Path(__file__).resolve().parents[1]
+
+class HttpTts(unittest.TestCase):
+    def test_guards_and_playback(self):
+        http = (ROOT / 'components/muse/muse_tts_http.cpp').read_text()
+        chat = (ROOT / 'components/muse/muse_chat_session.cpp').read_text()
+        guard = http[http.index('struct download_t'):http.index('static void worker')]
+        playback = chat[chat.index('static void show_tts_as_text'):chat.index('static void tts_data')]
+        code = r'''
+#include <atomic>
+#include <cassert>
+#include <cstdint>
+#include <cstdlib>
+#include <cstring>
+#include <strings.h>
+#include "muse_tts_http.h"
+#define CONFIG_MUSE_HTTP_TTS 1
+#define ESP_LOGI(...) ((void)0)
+#define ESP_LOGW(...) ((void)0)
+#define MIC_RATE 16000
+#define TEXT_CHARS_PER_S 16
+#define TEXT_MAX 1024
+#define MP3_BUF 128
+using esp_err_t = int;
+const int ESP_OK = 0, ESP_FAIL = -1, HTTP_EVENT_ON_HEADER = 1, HTTP_EVENT_ON_DATA = 2;
+struct esp_http_client_event_t { void *user_data; int event_id; const char *header_key; const char *header_value; int data_len; void *client; const char *data; };
+static std::atomic<uint32_t> s_ticket{1};
+static int64_t clock_us;
+static int status = 200;
+static int64_t esp_timer_get_time() { return clock_us; }
+static int esp_http_client_get_status_code(void *) { return status; }
+''' + guard + r'''
+enum { P_IDLE, P_WAIT_REPLY, TTS_QUEUED, TTS_ACTIVE, M_MP3, M_TTS };
+struct msg_t { unsigned pcm_start, pcm_frames, len; int tts; };
+struct {
+ int phase, tts_msg, nmsgs, kbps, down_rate, dec; uint32_t gen, pcm_out;
+ bool silent, mp3_ended; uint8_t mp3[MP3_BUF]; size_t mp3_len; char *texts; msg_t msgs[2];
+} s_turn;
+static std::atomic<uint32_t> s_gen{7};
+static bool speaker = true, accept = true, pending;
+static int requests;
+static muse_tts_result_t result;
+static bool muse_settings_speaker_on() { return speaker; }
+static int muse_settings_volume() { return 80; }
+static void mark(int) {}
+static void show_reply_start(const msg_t &) {}
+static void mp3dec_init(int *) {}
+bool muse_tts_http_start(const char *, uint32_t, int, size_t) { ++requests; return accept; }
+bool muse_tts_http_poll(muse_tts_result_t *r) { if (!pending) return false; *r = result; pending = false; return true; }
+''' + playback + r'''
+int main() {
+ uint8_t buf[4] = {};
+ download_t d{buf, 0, sizeof(buf), 1, 100, false, false};
+ esp_http_client_event_t e{&d, HTTP_EVENT_ON_HEADER, "Content-Type", "audio/mpeg", 0, nullptr, "abcd"};
+ assert(on_http(&e) == ESP_OK && d.audio_type);
+ e.event_id = HTTP_EVENT_ON_DATA; e.data_len = 4;
+ assert(on_http(&e) == ESP_OK && d.length == 4 && !memcmp(buf, "abcd", 4));
+ e.data_len = 1;
+ assert(on_http(&e) == ESP_FAIL && d.length == 4);
+ d.length = 0; d.failed = false; d.audio_type = false;
+ assert(on_http(&e) == ESP_FAIL && !d.length);
+ d.audio_type = true; status = 403;
+ assert(on_http(&e) == ESP_FAIL && !d.length);
+ status = 302; assert(on_http(&e) == ESP_FAIL && !d.length);
+ status = 200; s_ticket = 2;
+ assert(on_http(&e) == ESP_FAIL && !d.length);
+ s_ticket = 1; clock_us = 101;
+ assert(on_http(&e) == ESP_FAIL && !d.length);
+ char text[] = "reply";
+ s_turn.phase = P_WAIT_REPLY; s_turn.gen = 7; s_turn.tts_msg = -1;
+ s_turn.nmsgs = 1; s_turn.texts = text; s_turn.msgs[0].tts = TTS_QUEUED;
+ start_tts(); assert(requests == 1 && !s_turn.silent && s_turn.tts_msg == 0);
+ start_tts(); assert(requests == 1);
+ auto complete = [](uint32_t gen, bool ok) {
+   result = {gen, 0, ok ? static_cast<uint8_t *>(malloc(4)) : nullptr, ok ? 4u : 0u};
+   if (result.audio) memcpy(result.audio, "mp3!", 4);
+   pending = true; poll_http_tts();
+ };
+ complete(6, true); assert(!s_turn.mp3_len);
+ complete(7, true); assert(s_turn.mp3_len == 4 && s_turn.mp3_ended);
+ complete(7, false); assert(s_turn.silent && !s_turn.mp3_len);
+ s_turn.tts_msg = -1; s_turn.msgs[0].tts = TTS_QUEUED; speaker = false;
+ start_tts(); assert(requests == 1 && s_turn.silent);
+ speaker = true; s_turn.tts_msg = -1; s_turn.msgs[0].tts = TTS_QUEUED; accept = false;
+ start_tts(); assert(s_turn.silent);
+}
+'''
+        with tempfile.TemporaryDirectory() as tmp:
+            source, binary = Path(tmp) / 'test.cpp', Path(tmp) / 'test'
+            source.write_text(code)
+            subprocess.run([*shlex.split(os.environ.get('CXX', 'c++')), '-std=c++17', '-Wall', '-Wextra', '-Werror', '-I', str(ROOT / 'components/muse'), str(source), '-o', str(binary)], check=True)
+            subprocess.run([str(binary)], check=True)
ここまでの変更を含むSDKで、次の節のidf.py ... menuconfigを実行します。すでに設定画面を開いている場合は、一度終了して同じコマンドで開き直すと、追加した項目を検索・設定できます。項目を表示するためのファームウェアのビルドや書き込みは不要です。
TUIで外部TTSとAPI接続先を設定する
SDKへの変更を取り込んだら、SDKのesp32ディレクトリへ戻って設定画面を開き、読み上げを有効にします。
cd "$HOME/repos/github.com/shuntaka9576/muse-gadget-sdk/esp32"

idf.py -B build-muse-m5stack-core2 \
  -DIDF_TARGET=esp32 \
  -DSDKCONFIG=build-muse-m5stack-core2/sdkconfig \
  -DSDKCONFIG_DEFAULTS="sdkconfig.defaults;devices/sdkconfig.muse;devices/sdkconfig.muse-m5stack-core2" \
  menuconfig
/を押してMUSE_HTTPと入力すると、外部TTSに関する3項目をまとめて検索できます。以下は設定後の検索結果です。
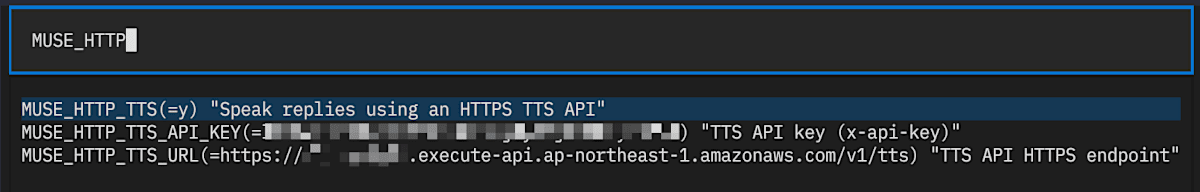
検索結果から各項目を選び、Enterで設定画面へ移動します。次の順に設定します。
MUSE_HTTP_TTS(Speak replies using an HTTPS TTS API)をSpaceで有効にします。これでAPIのURLとキーも入力できるようになります。MUSE_HTTP_TTS_URL(TTS API HTTPS endpoint)に、CDKが出力したTtsEndpointを入力します。末尾の/v1/ttsまで含めます。MUSE_HTTP_TTS_API_KEY(TTS API key (x-api-key))に、API GatewayのAPIキーの値を入力します。ApiKeyIdやMuseのSDKトークンとは別の値です。
別の項目へ移るときは、再び/でMUSE_HTTPを検索します。設定後、MUSE_HTTP_TTS(=y)と、URL・APIキーが入力されていることを確認します。
設定する4項目をまとめると次のようになります。
/で検索する名前 |
設定する値 | 設定の由来 |
|---|---|---|
MUSE_CJK_FONT |
有効 | SDK標準の設定 |
MUSE_HTTP_TTS |
有効 | 今回のソースコード変更で追加 |
MUSE_HTTP_TTS_URL |
CDKが出力したTtsEndpoint | 今回のソースコード変更で追加 |
MUSE_HTTP_TTS_API_KEY |
API GatewayのAPIキーの値 | 今回のソースコード変更で追加 |
MUSE_HTTP_TTS関連の3項目は、前述のKconfigの変更を取り込んでから設定画面を開くと表示されます。変更前のSDKでは検索しても出てきません。
設定を保存する
sで保存し、保存先がbuild-muse-m5stack-core2/sdkconfigであることを確認します。保存したらqで終了します。
TUIで入力した値はsdkconfigに保存され、ビルド時にファームウェアへ組み込まれます。設定を変更した場合は、再ビルドと本体への書き込みが必要です。
ビルドしてCore2へ書き込む
TTSの設定を保存したら、Core2用のファームウェアを再ビルドします。日本語表示を確認したときと同じ手順で、読み上げの設定を本体へ反映します。
tools/muse/board.sh build core2
今回のビルドでは、アプリ領域に30%の空きがあることを確認できました。
muse-gadget.bin binary size 0x2d1000 bytes. Smallest app partition is 0x400000 bytes. 0x12f000 bytes (30%) free.
USBでCore2を接続し、書き込み先のポートを確認します。
python tools/muse/ports.py --list
確認できたポートを指定して書き込みます。以下の/dev/cu.usbserial-XXXXXXXXは自分の環境の値に置き換えます。
export CORE2_PORT="/dev/cu.usbserial-XXXXXXXX"
tools/muse/board.sh flash core2 "$CORE2_PORT"
実機で日本語の読み上げを確認する
書き込み後、本体が起動してREADYに戻るのを待ち、次の手順でSound設定を開きます。
| 順番 | 画像 | 操作内容 |
|---|---|---|
| 1 | 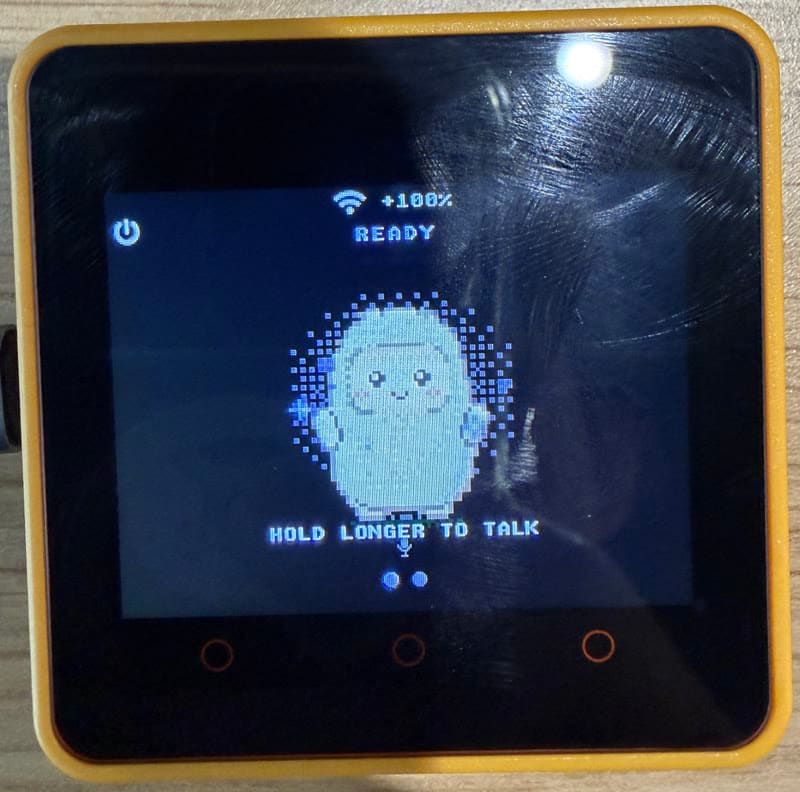 |
待機画面を右にスワイプして、設定画面を開きます。 |
| 2 | 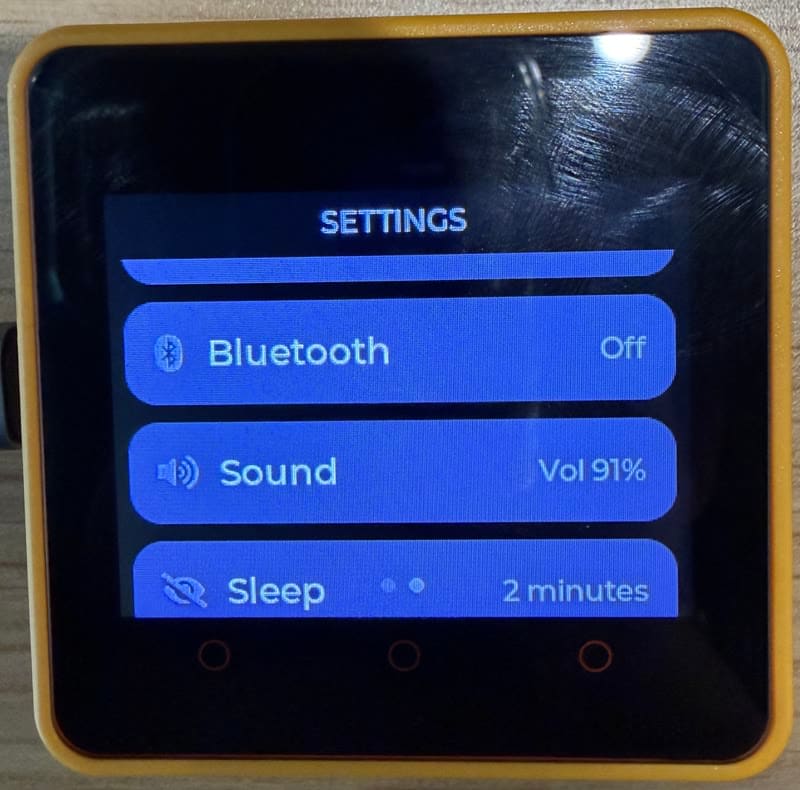 |
Soundをタップします。 |
| 3 | 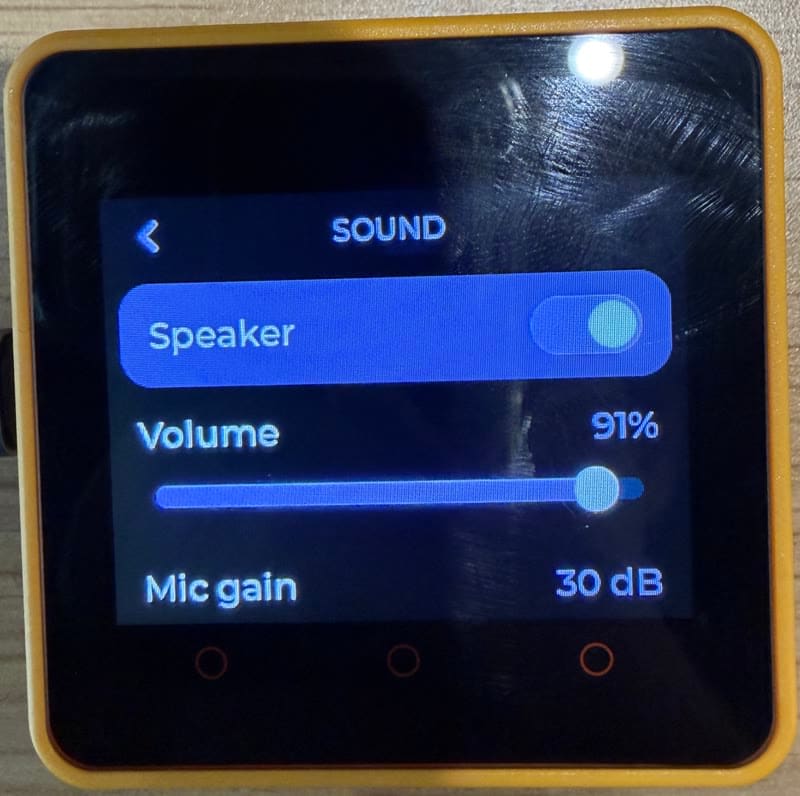 |
Speakerがオンになっていることを確認し、Volumeで音量を調整します。 |
設定できたら、待機画面へ戻ります。
画面下の中央のタッチボタンを押しながら、日本語で質問します。今回は次の2パターンを試しました。
港区の天気を聞く
まずは、場所を指定して天気を質問しました。
今日の港区の天気は?
新着メールの有無を聞く
新着メールがあるかを尋ね、続けてメールの内容は読み上げないように伝えました。
新着メール来ている? 内容は読み上げないで。
確認結果
Museアプリ側にも会話履歴が表示されました。赤枠は、今回のデモで確認した新着メールの件数と港区の天気の返答です。
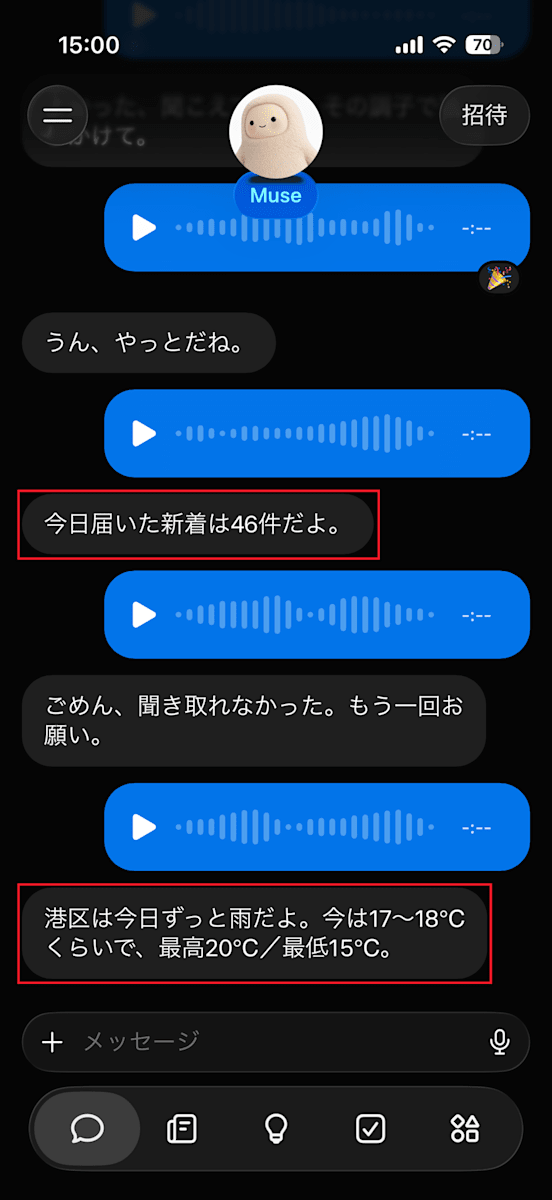
録音終了から画面がSPEAKINGに切り替わるまでは、天気が約10秒、新着メールが約49秒でした。これはMuseの返答を待つ時間も含み、TTSの処理時間だけを測ったものではありません。
2本とも、録音中のLISTENINGからTHINKING、返答中のSPEAKINGへ切り替わり、最後はREADYに戻りました。返答の字幕は、読み上げが始まる少し前から表示されています。
| 確認項目 | 新着メール | 港区の天気 |
|---|---|---|
| 字幕の内容 | 新着メールの件数を示す短文。本文の表示はなし | 天気と気温を表示し、途中で次の文に切り替わる |
| 日本語表示 | 返答のかな・漢字・数字を読める | かな・漢字・数字は読めるが、気温の数値に続く文字が四角になる |
録音終了からSPEAKINGまで |
約49秒 | 約10秒 |
| 返答後の状態 | READYに戻る |
READYに戻る |
待ち時間は、録画した動画をffmpegでコマ送り画像にして、画面の状態が切り替わる時刻から概算しました。今回の各1回の結果で、Museの応答待ちや音声合成・ダウンロードを含む時間です。Pollyだけの処理時間ではありません。
字幕は日本語で読めるようになりましたが、Museアプリ側の返答と見比べると、Core2では気温の「℃」にあたる部分が四角く表示されています。
SDKのCJKフォントの生成設定には「℃」(U+2103)が含まれていないため、フォントに必要な字形がないことが原因と考えられます。
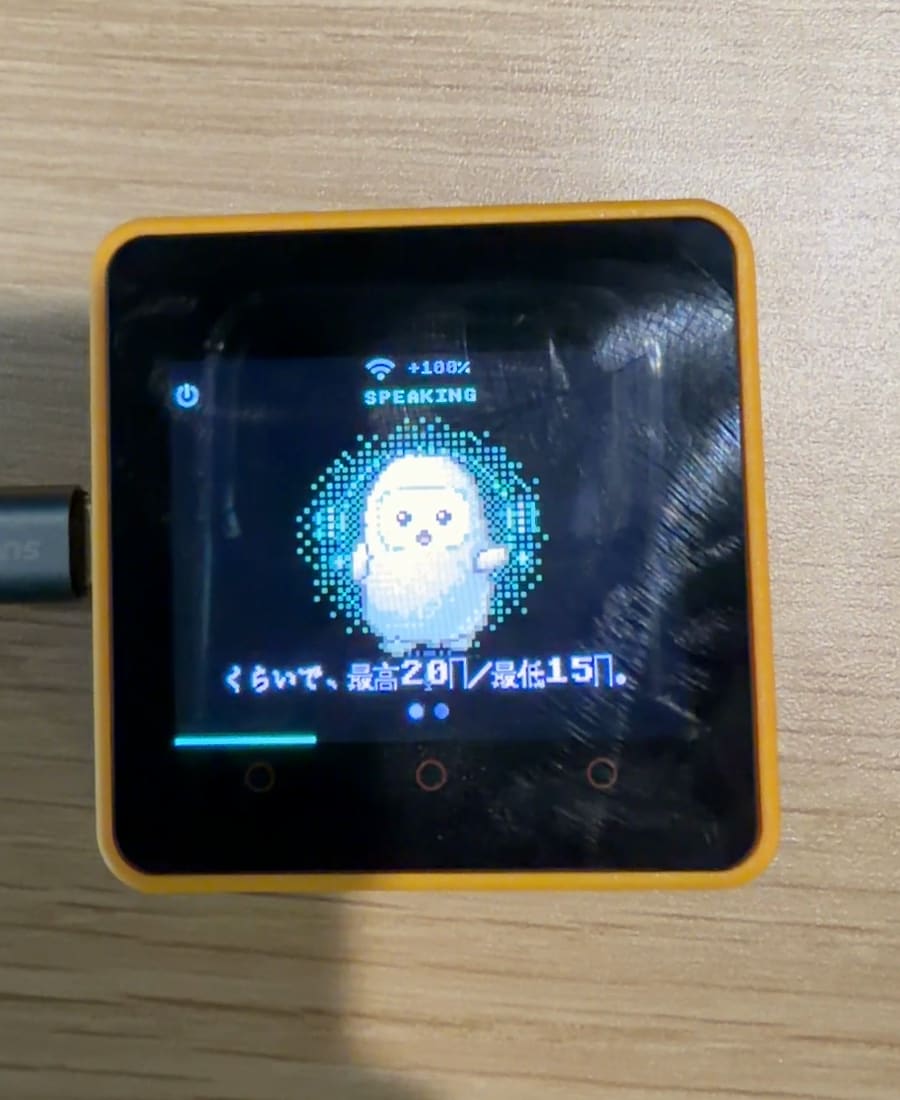
天気の動画の21秒付近。気温の数値に続く文字が四角く表示されています。
さいごに
前回のCore2とMuseの構成に、日本語フォントとAmazon Pollyを使った読み上げを追加しました。API GatewayとLambdaでTTS APIを用意し、SDKから返答テキストを送ることで、本体だけで日本語の質問と音声の返答をやり取りできるようになりました。
今回のCore2では、字幕の一部に文字化けが残り、画面下部のプログレスバーも表示が崩れていました。XではStopWatch版できれいに表示されている例を見かけたので、こちらの環境で表示が崩れる原因も調べてみたいところです。
読み上げは、音声を合成してMP3をすべて受信してから再生する仕組みなので、始まるまで少し間があります。それでも、手元のCore2に日本語で話しかけ、音声で返答を聞けるようになりました。