Strands Agentsに「Strands harness」が追加されました!

はじめに
こんにちは、スーパーマーケットが大好きなコンサル部の神野です。
Strands Agentsのチームから「Strands harness」が公開されています!
公式ブログでは、Claude CodeやCodexとほぼ同じ精度のまま、トークンのコストが28%少ないとのことです。どんなものなんでしょう・・・気になりますね!さっそく深掘りしていきましょう!
Strands harness
今までStrands Agentsでエージェントを作るときは、ツールを渡し、システムプロンプトを書き、会話を残すならセッションの保存先を用意して・・・と部品を自分で組み込んでいました。
こんな感じです。
from strands import Agent
from strands.session import SnapshotSessionManager
from strands.storage import LocalFileStorage
from strands.vended_tools import file_editor, shell

agent = Agent(
    tools=[shell, file_editor],
    system_prompt="あなたはデータ分析のアシスタントです。ファイルを調べてから作業してください。",
    session_manager=SnapshotSessionManager(
        session_id="sales", storage=LocalFileStorage("./sessions/")
    ),
)
それがStrands harnessでは関数を1行呼び出すだけで、シェル・ファイル操作・会話の保存・長期記憶・コンテキスト管理が入ったエージェントが作成できるようになりました!
下記のようなコードです。
from strands_harness import create_harness

agent = create_harness()
え、短い・・・これだけでおすすめ設定入りのエージェントが作られるみたいです!
公式ブログによると、Claude CodeやCodexなら手元でアイデアがすぐ動くのに、自分でエージェントを作るとその手軽さを再現しづらい、という声から作られたそうです。確かに・・・Claude CodeやCodexのように、話しかけたらよしなに動いてくれる体験って嬉しいですもんね!
今回は strands-harness という新しいパッケージとして公開されていて、既存の strands-agents をベースに作られています。ちなみにTypeScript版も @strands-agents/harness として公開されていて、createHarness() で同じように作れます。
今回はPython版で試してみます!
前提
今回は下記のバージョンで進めていきます。
| 項目 | バージョン |
|---|---|
| Python | 3.13.13 |
| strands-harness | 0.1.2 |
| strands-agents | 1.57.0 |
| モデル | Claude Opus 5(Amazon Bedrock、us-east-1) |
初期化して依存関係を入れていきましょう。
uv init --python 3.13 harness-try
cd harness-try
uv add strands-harness
mkdir workspace
中身を比べる
まずはモデルを呼び出さずに、2つのエージェントの中身を表示して違いを見てみましょうか。
from strands import Agent
from strands_harness import create_harness

for name, agent in [("Agent()", Agent()), ("create_harness()", create_harness())]:
    print(f"== {name}")
    print("tools:", agent.tool_names)
    print("system prompt:", len(agent.system_prompt or ""), "chars")
    print("session_manager:", type(getattr(agent, "_session_manager", None)).__name__)
== Agent()
tools: []
system prompt: 0 chars
session_manager: NoneType
== create_harness()
tools: ['shell', 'read', 'write', 'edit', 'web_fetch', 'programmatic_tool_caller', 'subagent', 'retrieve_offloaded_content', 'todo_write', 'retrieve_context', 'strands_manage_background_task', 'search_memory']
system prompt: 1665 chars
session_manager: SnapshotSessionManager
今までのSDKで作ったエージェントは、ツールもシステムプロンプトも自前で定義するので空っぽの状態ですね。一方、Strands harnessのほうは、12個のツールとシステムプロンプト、会話の保存まで提供されています。確かにすぐ便利に動かせるようになっていますね!
システムプロンプトの中身も公開されていて、「変更する前に周りを調べる」「検証できてから完了とする」「戻せない操作は先に確認する」など、コーディングエージェントでよく見る振る舞いが書かれていました!
全文も載せておきます。
システムプロンプトの全文(HARNESS_CONTRACT)
You are an agent. Keep working until the task is fully resolved before ending your turn. Only stop to ask the user when you are blocked on a decision or information that is genuinely theirs to provide.

# Acting
 - Once you have enough to act on, act. Do not ask for confirmation of steps you can verify yourself, and do not re-derive facts you have already established.
 - Explore before you change anything: understand the surrounding context and conventions, then make changes that fit them.
 - Treat a task as done only when you have verified it, not when it looks plausible. If you cannot verify, say so.

# Tools
 - Prefer the dedicated tool for a job over improvising with a general one.
 - Independent tool calls can be issued together in a single turn; run them in parallel rather than serially.
 - A denied or failed tool call is information: adjust your approach, do not retry it verbatim.
 - `<system-reminder>` tags in messages and tool results are injected by the harness, not the user.

# Safety
 - For actions that are hard to reverse or that reach outside the local environment, confirm first unless you have been explicitly told to proceed. Approval in one context does not carry to the next.
 - Report outcomes faithfully: if something fails, say so with the output; if you skipped a step, say that; when something is done and verified, state it plainly without hedging.

# Context management
When the conversation grows long, older turns may be summarized and large tool results moved out of the immediate context, with a way to retrieve them. Work as if the full history remains available; you do not need to wrap up early or hand off mid-task.
なお、Bedrockで動かすと次の警告が毎回出ます。
Model bedrock/global.anthropic.claude-opus-5 has no native web search. Pass builtin_tools={'web_search': 'exa'} to search through Exa (a third party), or drop 'web_search'.
BedrockのConverse APIにはモデル側のWeb検索機能がないので、既定で有効なWeb検索ツールを外したという内容です。
同じ依頼を試してみる!
workspace/sales.csv に売上データを置き、同じ依頼を試して違いを見てみましょう!
お題は「データからレポートをまとめて」としてみます。
date,product,amount
2026-07-03,coffee,1200
2026-07-15,tea,800
2026-07-28,coffee,1500
2026-08-02,cake,2400
2026-08-19,coffee,1300
2026-08-30,tea,700
2026-09-05,cake,2600
2026-09-12,coffee,1100
2026-09-20,tea,900
import os
import sys

from strands import Agent
from strands_harness import create_harness

MODEL = "global.anthropic.claude-opus-5"
os.chdir("workspace")

if sys.argv[1] == "plain":
    agent = Agent(model=MODEL, callback_handler=None)
else:
    agent = create_harness(model=MODEL, callback_handler=None)

result = agent("sales.csv を読んで月ごとの売上合計と、いちばん売れた商品を report.md にまとめてください。")
print(str(result).strip())
print("tools:", {name: m.call_count for name, m in result.metrics.tool_metrics.items()})
まずは今までのSDKのエージェントからです。
申し訳ありません、このチャットには実際のファイルを読み書きする機能がないため、`sales.csv` を直接開いて `report.md` を作ることができません。
(CSVの中身を貼ってもらうか、集計スクリプトを実行してもらう案が続く)
tools: {}
ツールがないので、ファイルを読めずに代わりの案を返してきました。
そりゃそうだろ・・・って感じの予想通りの結果になりました。
続いてStrands harnessです。
`report.md` を作成しました。

| 月 | 売上合計 |
|---|---:|
| 2026-07 | 3,500 |
| 2026-08 | 4,400 |
| 2026-09 | 4,600 |
| 合計 | 12,500 |

**いちばん売れた商品**: coffee(売上 5,100 / 全体の 40.8%、購入件数も4件で1位)
(「数量列がないので売上金額で判定した」などの補足が続く)
tools: {'shell': 3, 'write': 1}
シェルで集計して、レポートのファイルを書き出してくれました!集計値も合っています!
考えられたシステムプロンプトやビルトインのツールが備わっているので、雑に依頼しても対応してくれましたね!確かにより雑に依頼できるようになっています。
会話の再開と長期記憶
記憶機能もビルトインらしいのですが、どうなんでしょう。ここも少し深掘りしてみます。
作りとしては、会話と、会話から取り出した事実(長期記憶)を作業フォルダの .agent に保存します。セッションIDを引数で受け取るスクリプトで確かめます。IDの代わりに - を渡すと、新しい会話になります。
なるほどローカルに保存されるんですね。
import os
import sys

from strands_harness import create_harness

os.chdir("workspace")
session_id, prompt = sys.argv[1], sys.argv[2]

kwargs = {"session": {"id": session_id}} if session_id != "-" else {}
agent = create_harness(model="global.anthropic.claude-opus-5", callback_handler=None, **kwargs)
result = agent(prompt)
print(str(result).strip())
print("tools:", {name: m.call_count for name, m in result.metrics.tool_metrics.items()})
rm -rf workspace/.agent workspace/report.md
uv run resume.py sales "sales.csv を読んで月ごとの売上合計と、いちばん売れた商品を report.md にまとめてください。"
uv run resume.py sales "2位だった商品と、1位との差額だけ一言で教えてください。ファイルは読み直さないでください。"
uv run resume.py - "前に作った売上レポートで、いちばん売れた商品は何でしたっけ?ファイルは読まずに答えてください。"
2回目(同じセッションID)と3回目(新しい会話)の結果です。
2位は **cake(5,000)** で、1位 coffee(5,100)との差は **100** です。
tools: {}
記録によると、**いちばん売れた商品は「コーヒー(coffee)」**でした。
tools: {'search_memory': 2}
2回目は別プロセスですが、.agent に保存された履歴が読み込まれるため、ツールを使わずに前の会話の続きとして回答できています。3回目は新しい会話ですが、記憶を検索するツールで前回の結果を取得して答えてくれました!
挙動はわかったのですが、クラウドではどうでしょうか。AgentCore Memoryは連携できるんでしょうか??
保存先をAgentCore Memoryに差し替える
ローカルに保存できるのはいいですが、コンテナで動かすとセッションがクローズされた際に消えてしまいます。デフォルトから保存先をAgentCore Memoryに差し替えてみます!
| パターン | 会話の保存 | 長期記憶 |
|---|---|---|
| セッションマネージャーだけ | AgentCore Memoryのセッションマネージャー | セッションマネージャーが読み取って差し込む。Strands harness側はオフ |
| ストアも使う | 同上 | Strands harnessの記憶の仕組みのまま、保存先をAgentCore Memoryにする |
2パターンあるのですが、今回はお馴染みのセッションマネージャーを使って試してみます。
bedrock-agentcoreを追加し、長期記憶の抽出戦略(セマンティック)を持つMemoryを作っておきます。
uv add bedrock-agentcore
mkdir workspace2 && cp workspace/sales.csv workspace2/
create_memory.py(Memoryの作成)
from bedrock_agentcore.memory import MemoryClient

client = MemoryClient(region_name="us-east-1")
memory = client.create_memory_and_wait(
    name="strands_harness_demo",
    strategies=[{
        "semanticMemoryStrategy": {
            "name": "facts",
            "namespaces": ["/facts/{actorId}/"],
        }
    }],
    event_expiry_days=7,
)
print(memory["id"])
セッションマネージャーだけでつなぐ
セッションマネージャーの retrieval_config に長期記憶のnamespaceを渡すと、会話の保存に加えて長期記憶の読み取りもしてくれます。Strands harness側の長期記憶は memory=False でオフにします。
session_manager = AgentCoreMemorySessionManager(
    AgentCoreMemoryConfig(
        memory_id=MEMORY_ID,
        session_id=session_id,
        actor_id="jinno",
        retrieval_config={"/facts/{actorId}/": RetrievalConfig(top_k=5, relevance_score=0.3)},
    ),
    region_name="us-east-1",
)
agent = create_harness(model="global.anthropic.claude-opus-5", session_manager=session_manager, memory=False)
agentcore_memory_sm.py の全体
import os
import sys

from bedrock_agentcore.memory.integrations.strands.config import AgentCoreMemoryConfig, RetrievalConfig
from bedrock_agentcore.memory.integrations.strands.session_manager import AgentCoreMemorySessionManager
from strands_harness import create_harness

MEMORY_ID = os.environ["AGENTCORE_MEMORY_ID"]

os.chdir("workspace2")
session_id, prompt = sys.argv[1], sys.argv[2]

session_manager = AgentCoreMemorySessionManager(
    AgentCoreMemoryConfig(
        memory_id=MEMORY_ID,
        session_id=session_id,
        actor_id="jinno",
        # 長期記憶も読み取って会話に差し込む
        retrieval_config={"/facts/{actorId}/": RetrievalConfig(top_k=5, relevance_score=0.3)},
    ),
    region_name="us-east-1",
)

agent = create_harness(
    model="global.anthropic.claude-opus-5",
    session_manager=session_manager,
    memory=False,  # Strands harness側の長期記憶はオフ
    callback_handler=None,
)
result = agent(prompt)
print(str(result).strip())
print("tools:", {name: m.call_count for name, m in result.metrics.tool_metrics.items()})
export AGENTCORE_MEMORY_ID=<作成したMemoryのID>
uv run agentcore_memory_sm.py sm-1 "sales.csv を読んで月ごとの売上合計と、いちばん売れた商品を report.md にまとめてください。"
uv run agentcore_memory_sm.py sm-1 "2位だった商品と、1位との差額だけ一言で教えてください。ファイルは読み直さないでください。"
uv run agentcore_memory_sm.py sm-2 "前に作った売上レポートで、いちばん売れた商品は何でしたっけ?ファイルは読まずに答えてください。"
2位は cake(5,000)で、1位の coffee(5,100)との差は 100 です。
tools: {}
参考:月別売上は 7月 3,500 / 8月 4,400 / 9月 4,600、合計 12,500 でした。
tools: {}
作業フォルダに .agent は作られず、会話の再開も、新しい会話で前回の内容を答えるのもAgentCore Memory経由で動きました!ここは今までのSDKと変わらない使い勝手ですね!
ほかにも変えられる設定
ほかのデフォルト設定も、関数の引数で1つずつ変えられます。
| 引数 | 変えられること |
|---|---|
model / effort |
モデル(Anthropic・OpenAI・Google・Ollamaなども)と推論の強さ |
instructions |
用途の指示。システムプロンプトの後ろに追加される |
system_prompt |
システムプロンプトを丸ごと置き換える |
tools |
自前のツールを追加する |
builtin_tools |
使う組み込みツールを絞る |
memory / session |
長期記憶・会話の保存先を変える、オフにする |
interventions |
ツールを実行する前に承認を挟む |
mcp_servers / skills |
MCPサーバーやAgent Skillsを足す |
いくつか変えて、中身を確かめてみます。
from strands_harness import create_harness

agent = create_harness(
    model="global.anthropic.claude-opus-5",
    effort="low",
    instructions="あなたは経理担当のアシスタントです。金額は円で書いてください。",
    builtin_tools=["read", "write", "shell"],
    memory=False,
    interventions="ask",
)
print("tools:", agent.tool_names)
print("instructions:", agent.system_prompt.endswith("金額は円で書いてください。"))
print("memory:", agent.memory_manager)
tools: ['shell', 'read', 'write', 'retrieve_offloaded_content', 'todo_write', 'retrieve_context', 'strands_manage_background_task']
instructions: True
memory: None
組み込みツールは指定した3つになり、記憶の検索ツールも消えました。残りの4つは既定のプラグインが足すツールです。指示はシステムプロンプトの末尾に追加されています。
デフォルトで良さげな設定はあるものの、自分でも変えられるのはいいですね!
実際に動かしてみます。承認の設定は次で試すので、ここでは外しておきます。
import os

from strands_harness import create_harness

os.chdir("workspace")
agent = create_harness(
    model="global.anthropic.claude-opus-5",
    effort="low",
    instructions="あなたは経理担当のアシスタントです。金額は円で、1行で答えてください。",
    builtin_tools=["read", "shell"],
    memory=False,
)
agent("sales.csv の売上の合計金額を教えてください。")
Tool #1: shell
売上の合計金額は 12,500円 です。
指示どおり、円をつけて1行で答えてくれました!
システムプロンプトを丸ごと置き換えたり、自前のツールを足したりもできます。
import os

from strands import tool
from strands_harness import create_harness

@tool
def get_tax_rate(product: str) -> str:
    """商品の消費税率を返す。"""
    return "8%" if product in ("coffee", "tea", "cake") else "10%"

os.chdir("workspace")
agent = create_harness(
    model="global.anthropic.claude-opus-5",
    system_prompt="あなたは経理担当のアシスタントです。金額は円で、1行で答えてください。",
    tools=[get_tax_rate],
    builtin_tools=["read"],
    memory=False,
)
agent("coffee の消費税率を教えてください。")
Tool #1: get_tax_rate
coffee の消費税率は8%です。
渡した文がそのままシステムプロンプトに設定され、自前のツールも組み込みツールとあわせて登録されて、問題なく呼び出されました。
ツールの実行前に承認を挟む
シェルやファイル操作まで持っているエージェントなので、勝手に実行されると困る場面もありますよね。そんなときは、ツールの実行前に人の承認を挟めます。interventions="ask" を指定すると、エージェントは処理の手前で停止して承認を待ちます。承認・拒否を返すと、止まったところから続きを動かせます。
result = agent("sales.csv の行数を数えてください。")
while result.stop_reason == "interrupt":
    responses = [
        {"interruptResponse": {"interruptId": i.id, "response": answer}}
        for i in result.interrupts
    ]
    result = agent(responses)
approve.py の全体
import os
import sys

from strands_harness import create_harness

os.chdir("workspace")
answer = sys.argv[1]  # "yes" か "no"

agent = create_harness(
    model="global.anthropic.claude-opus-5",
    builtin_tools=["read", "shell"],
    memory=False,
    interventions="ask",
    callback_handler=None,
)

result = agent("sales.csv の行数を数えてください。")
while result.stop_reason == "interrupt":
    for interrupt in result.interrupts:
        print(f"[承認待ち] {interrupt.reason}".replace("\n", " ")[:160], "->", answer)
    responses = [
        {"interruptResponse": {"interruptId": i.id, "response": answer}}
        for i in result.interrupts
    ]
    result = agent(responses)

print("---")
print(str(result).strip())
[承認待ち] Approve "shell"?   Input: {"command": "ls -la /Users/.../workspace"} -> yes
[承認待ち] Approve "shell"?   Input: {"command": "find /Users/... -name 'sales*.csv' ..."} -> yes
[承認待ち] Approve "shell"?   Input: {"command": "cd /Users/...; for f in workspace/sales.csv ..."} -> yes
---
| 全行(ヘッダ含む) | **10 行** |
| データ行のみ(ヘッダ除く) | **9 行** |
[承認待ち] Approve "shell"?   Input: {"command": "ls -la; find . -name \"sales.csv\" -maxdepth 4 2>/dev/null"} -> no
---
シェルコマンドの実行が承認されませんでした(`ls` / `find` によるファイル探索がブロックされました)。そのため、`sales.csv` の場所を自分で特定できず、行数も数えられていません。
(ファイルのパスを教えてもらえれば、シェルを使わずに読むという提案が続く)
承認すればそのまま続き、拒否すると止められたことを報告して別のやり方を提案してきました。
ちなみに、リスクが高そうな呼び出しだけ承認に回す "smart" といったオプションも選べるので、必要に応じて使ってみたいですね。
これは以前紹介したStrandsに備わっているHuman in the Loopの挙動をラップした感じですね。また興味があれば下記ブログも参照ください!
使い分けを整理する
公式ドキュメントでは、今までのSDKとの使い分けが次のように整理されています。
| やりたいこと | 選ぶもの |
|---|---|
| 既定の構成で、すぐに動くAIエージェントが作りたい | Strands harness |
| 構成をすべて自分で決めたい | 今までのSDK |
とはいえ、二者択一ではないとも書かれています。Strands harnessで始めても返ってくるのは今までと同じエージェントなので、合わない部分をSDKの部品に差し替えるような使い方でもいいですね!
AgentCore Managed Harnessといい、ある程度ユーザー側が考慮することが減った状態で楽にAIエージェントを作れるようになってきましたね!
今までのStrands Agentsでも簡単だったのに、それよりも簡単だなんて・・・
おまけ Strands CLI
公式ブログでは、Strands CLI(@strands-agents/cli)も「普段の言葉で話しかけながらエージェントを試作できる」という触れ込みで紹介されていて気になったので簡単に触ってみました!
pnpm dlx @strands-agents/cli
実行すると、カエルのキャラクターと一緒に最初のメニューが出てきます。動きもあって可愛いです!
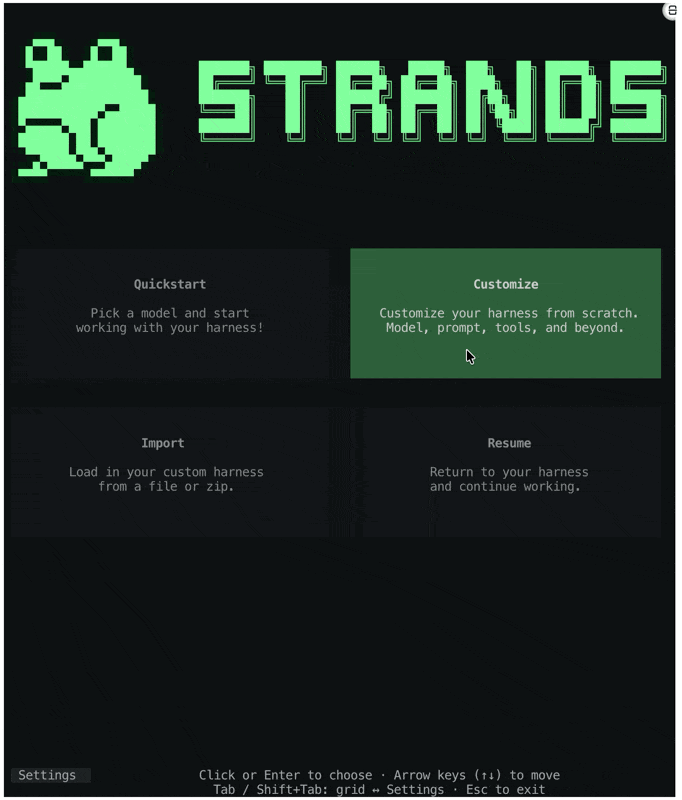
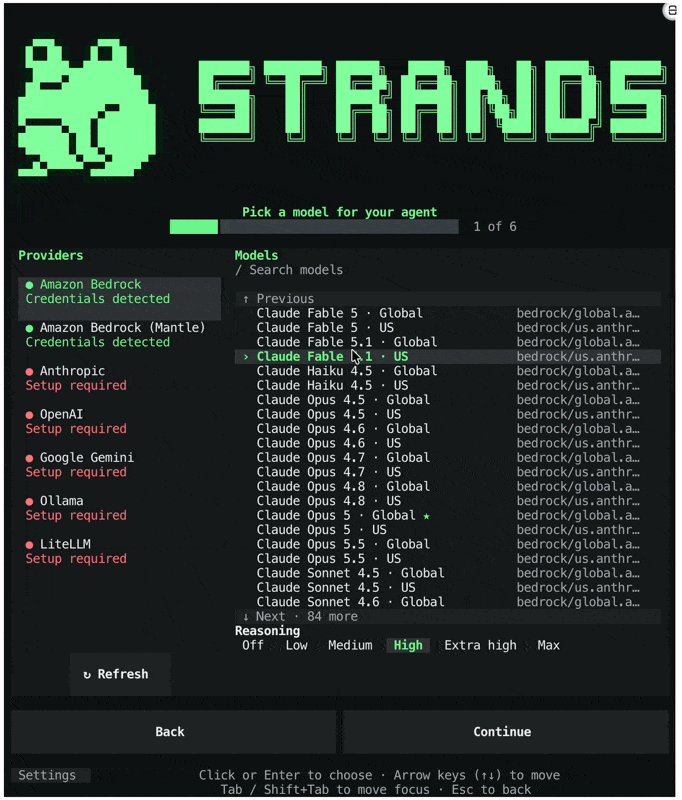
「Customize」を選ぶと、モデルやツール、MCPサーバーなどを順番に設定していきます。モデルはBedrockのものが並んでいました。今回はGPT5.6 Lunaを選んでいます。
チャットで「計算機のコードを作って」と頼むと、シェルを実行する前に承認を求められ、最後は calculator.html を作ってくれました。
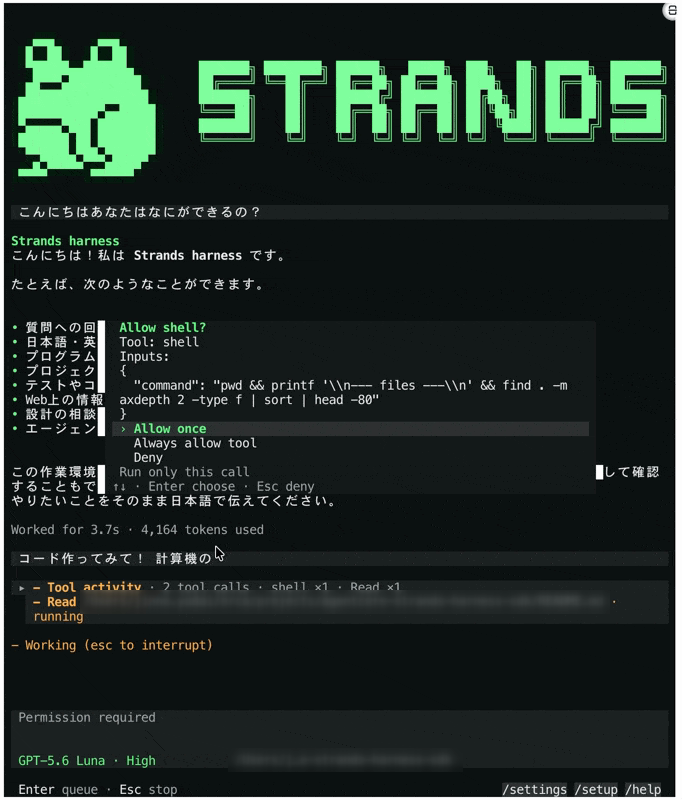
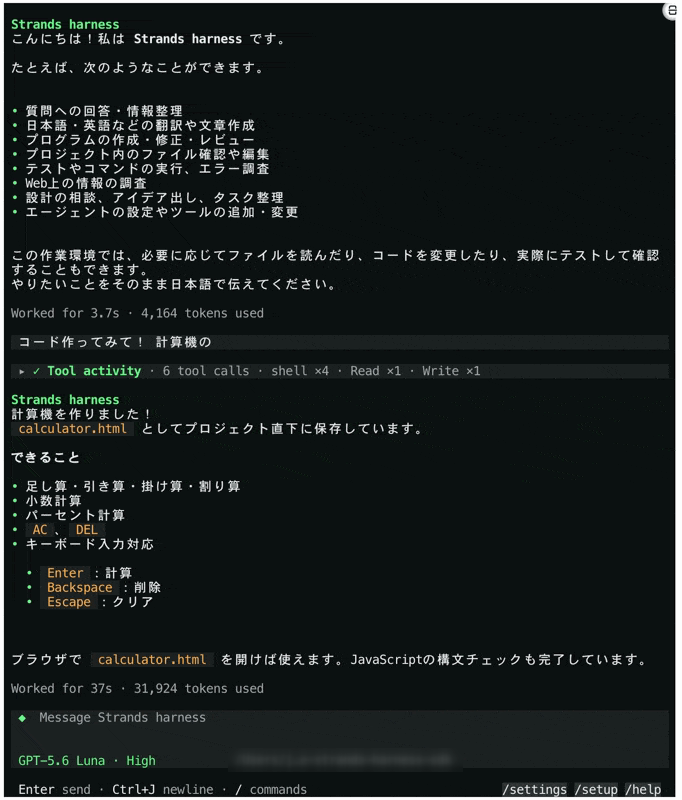
画面の雰囲気もコーディングエージェントっぽいですね。Bedrockのモデルでこういうエージェントを作ってサクッと検証したいときに便利そうです。
チャットで作ったエージェントは /export でコードに書き出せます。TypeScriptを選ぶと、選んだ設定がそのまま createHarness() の引数に入ったプロジェクトができました。
import { createHarness } from '@strands-agents/harness'

export const agent = await createHarness({
  name: 'Strands harness',
  model: 'bedrock/us.openai.gpt-5.6-luna',
  builtinTools: ['shell', 'read', 'write', 'edit', 'web_fetch', 'programmatic_tool_caller', 'subagent'],
  skills: false,
  session: {
    dir: './.agent/sessions',
  },
  memory: {
    dir: './.agent/memory',
  },
})
package.json やREADMEも一緒に出力されるので、このままアプリに組み込んだり、コーディングエージェントに渡して作り込んだりできます。今度別ブログでじっくり触れてみたいなーと思っています!
公式ブログでは、Grok Botのようなエージェントのプラットフォームを参考に、Strands harnessを動かすデスクトップアプリを作った例も紹介されていました。
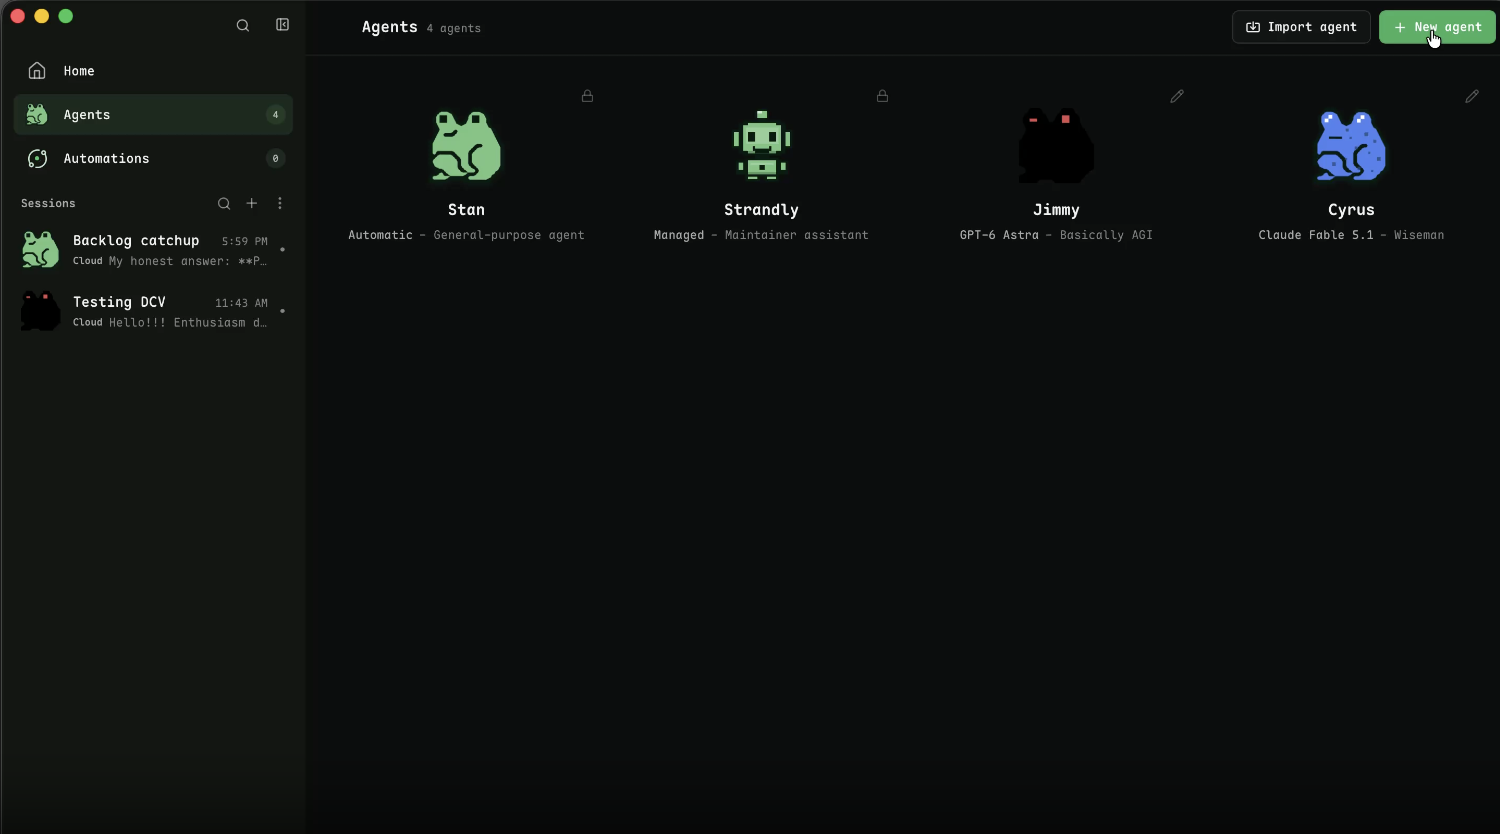
画像は公式ブログの動画から引用しています。カエルが可愛いので使ってみたいですね・・・ただ、私が探した限りでは公開されていないようでした。Strands harnessを土台に、こんな感じのアプリもサクッと作れると面白いですね!(もし公開されているなら教えてください!)
今回新しく名前が似たものが3つ出てきたので、使い分けを簡単に絵にしてみました。
おわりに
Strands Agentsも簡便になってきましたね!
自分でもStrands harnessを実践レベルで試してみて使い勝手を検証していければと思います!
本記事が少しでも役に立ちましたら幸いです。最後までご覧いただきありがとうございました!