CloudWatch Omni をマルチアカウントで使うと他アカウントのテレメトリはどこまで見えるのか検証してみた

はじめに
こんにちは!ひろたこです。
前回、アカウントをまたぐ通信の量と経路を監視アカウント1つに集約する手段を4つ比べた記事を書きました。
このとき、2026年9月に一般提供が始まった Amazon CloudWatch Omni(以下 CloudWatch Omni)も候補に挙がったのですが、検証を東京リージョンで組んでいて提供リージョン外だったため、対象外にしていました。今回はリージョンを us-east-1 に変えて CloudWatch Omni を試してみました!
CloudWatch Omni は、組織レベルドメインと集約ルールを使うと、複数アカウントのテレメトリを1つのスペースに集められます。3アカウントを貫通するアプリケーションを用意して、中央の監視アカウントからどこまで確認できるのかを見てみました。
この記事では、中央スペースで見えたもの・見えなかったものを画面と数値で整理しています。今回一番おもしろかったのは、同じ中央スペースの中で、トレースでは3アカウントが1本に繋がるのに、Application Map には依存関係の線が1本も引かれなかったことです。
なお、記載している挙動は2026年10月11日時点のものです。
CloudWatch Omni のマルチアカウント構成
CloudWatch Omni をマルチアカウントで使うときに出てくる登場人物は3つです。
| 登場人物 | 作る場所 | 役割 |
|---|---|---|
| ドメイン | AWS Organizations の管理アカウント | サインインの入り口。https://<ドメイン名>.cloudwatch-omni.global.app.aws という専用 URL を持つ |
| スペース | 各メンバーアカウント | テレメトリを見るワークスペース。1アカウント × 1リージョンに1つ |
| 集約ルール | 管理アカウントまたは委任管理者 | ソースアカウントのログ・メトリクス・Context Graph を、宛先アカウントに集める |
ポイントは、スペースをまたいだクエリができないことです。アカウントごとにスペースを作っても横断して見ることはできないので、「1つの画面で全アカウントを見たい」なら集約ルールで中央アカウントに集めるしかありません。公式ドキュメントにも、スペースを別々に作るのではなく1つのアカウントにテレメトリを集約するように、と書かれています。
もう1つ、組織レベルドメインを管理アカウントで作っておくと、メンバーアカウント側で紐付け操作が一切要らないのも効きます。メンバーアカウントがスペースを作った時点で、自動的にそのドメインにぶら下がります。
ここで混ざりやすいのが、ドメインへの紐付けと、テレメトリの集約は別ものという点です。スペースがドメインにぶら下がるのは「1つの URL からサインインして、そのスペースを選べる」という入り口の話で、これだけではテレメトリは集まりません。中央アカウントに集めるのは集約ルールの仕事で、こちらは自動では作られないので自分で作ります。今回は委任管理者の nw-monitoring から、CLI で1つ作りました。
$ aws observabilityadmin create-centralization-rule-for-organization \
    --rule-name omni-lab-centralization --rule file://rule.json \
    --profile nw-monitoring --region us-east-1
ルールの中身は、ソースに nw-app-a / nw-app-b / nw-network の3アカウント、宛先に nw-monitoring を指定し、ログとメトリクスに加えて Context Graph(SourceContextGraphConfiguration)も集める設定にしています。
今回の構成を図にすると、こうなります。
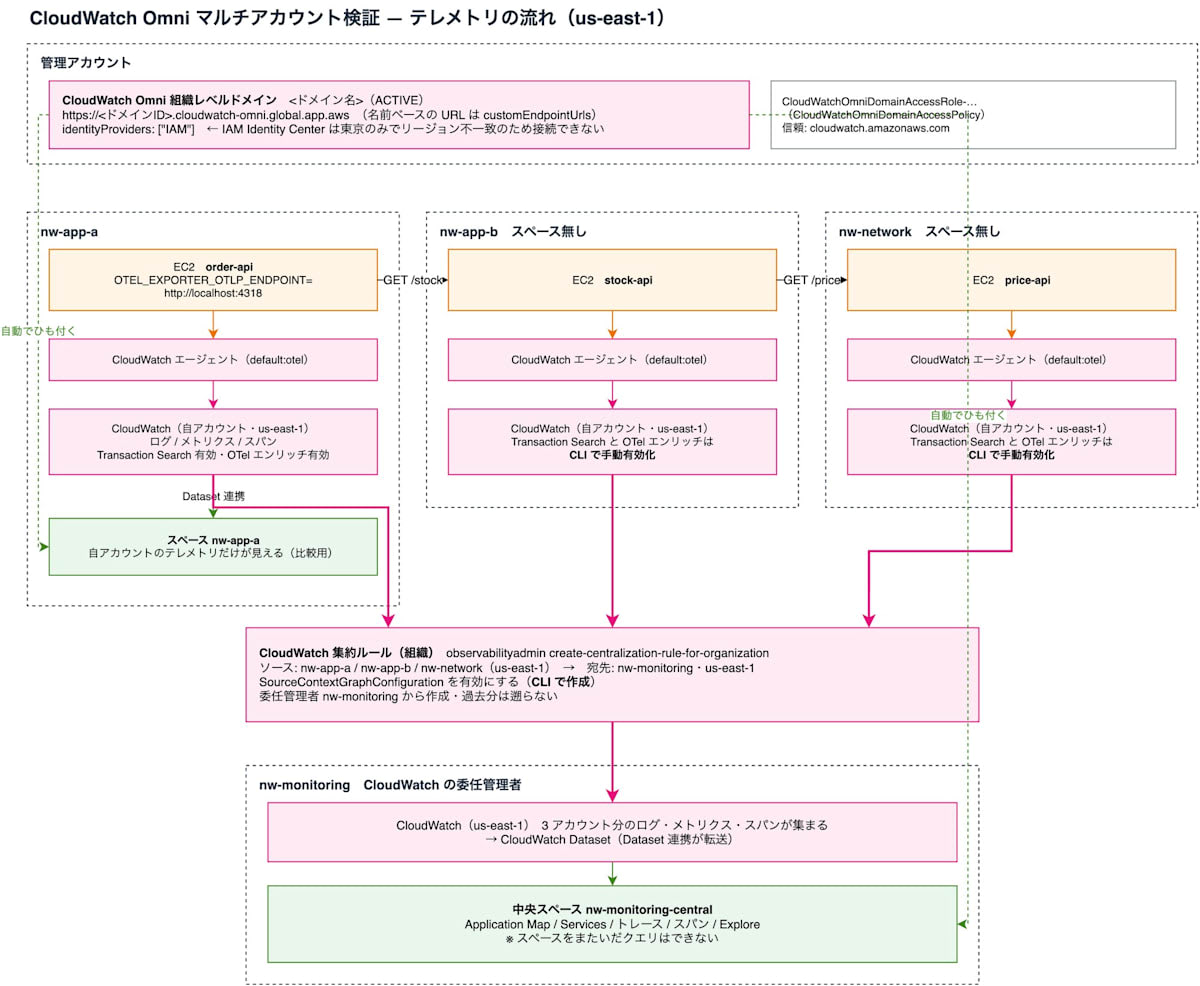
3アカウントのテレメトリを nw-monitoring の中央スペースに集め、見え方の比較用に nw-app-a にもスペースを置いています。
検証したアカウント構成
アカウントと、それぞれに置いたサービスは次のとおりです。
| アカウント | 役割 | VPC | サービス | CloudWatch Omni のスペース |
|---|---|---|---|---|
| 管理アカウント | 組織レベルドメインの作成 | — | — | 無し |
| nw-monitoring | 中央(集約先)・observabilityadmin の委任管理者 |
— | — | nw-monitoring-central |
| nw-app-a | フロント | 10.1.0.0/16 | order-api |
nw-app-a(比較用) |
| nw-app-b | バックエンド | 10.2.0.0/16 | stock-api |
無し |
| nw-network | 共有サービス・Transit Gateway 所有 | 10.0.0.0/16 | price-api |
無し |
リクエストは order-api(nw-app-a)→ stock-api(nw-app-b)→ price-api(nw-network)と、Transit Gateway 経由で3アカウントを順に貫通します。アプリケーションは Flask と requests で書いた1ファイルで、環境変数 APP_ROLE で order / stock / price を切り替えました。テレメトリを出す仕組み(計装)は、OpenTelemetry の自動計装に任せました。自動計装は、アプリケーションのコードを書き換えずに、ライブラリ側がテレメトリを出してくれる仕組みです。今回は Flask と requests 用のパッケージを入れているので、リクエストを受けたところと、下流を呼び出したところに、自動で記録が付きます。送り先はアプリケーション → localhost の CloudWatch エージェント → CloudWatch の OTLP エンドポイント、という経路です。
3アカウントを貫通していることは、レスポンスの中身で確認できます。
$ curl -sS http://localhost:8080/order | jq .
{
  "order_id": "o-1001",
  "stock": {
    "price": {
      "amount": 19.99,
      "currency": "USD"
    },
    "qty": 7,
    "sku": "sku-42"
  }
}
order のレスポンスに stock が入り、その中にさらに price が入っています。この入れ子がそのままアカウントをまたいだ呼び出しの深さで、3段とも通ったことが分かります。異常系用に ?fail=1 を付けると下流まで引き継がれ、末端の price-api が 500 を返します。
やったこと
ここからは、集約先の中央スペース(nw-monitoring-central)を開いて、他アカウントのテレメトリがどう見えるのかを順番に確かめていきます。
1. 中央スペースにサインインする
ドメインの URL にアクセスすると、「CHOOSE A SPACE」でアクセスできるスペースが並びます。
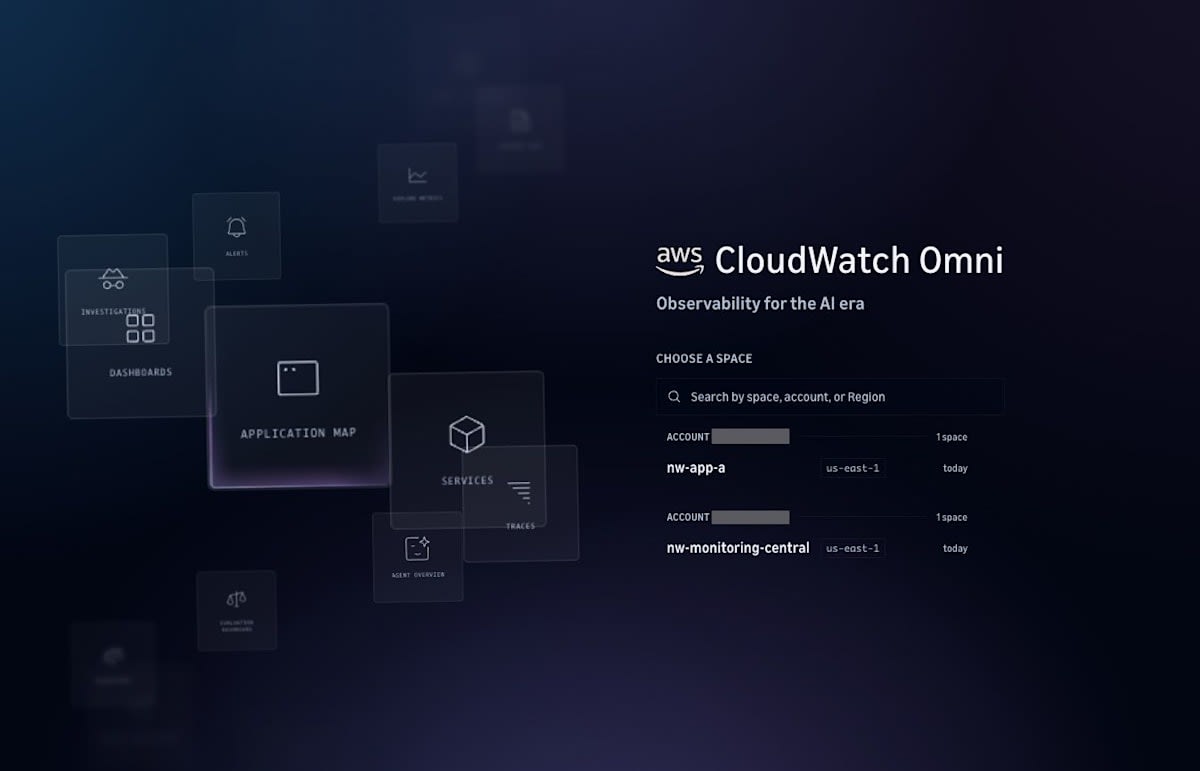
並び方がアカウント単位で、アカウント ID の見出しの下に「1 space」としてスペースがぶら下がります。今回は nw-app-a と nw-monitoring-central の2つが、それぞれのアカウントの下に出ました。検索ボックスのプレースホルダーも「Search by space, account, or Region」で、アカウントやリージョンで探すことが前提の作りになっています。サインインしているのは nw-monitoring のロールですが、ドメイン管理者なので nw-app-a のスペースも一覧に出ています。1つの URL から、アカウントを意識せずにスペースを選べるのは気持ちいいですね。
ここから nw-monitoring-central(中央スペース)に入ります。
2. Application Map を見る
まず Application Map を開きます。既定の Group by は「Application」なので、最初に出るのはノード1つだけでした。service.namespace=omni-lab が Application として扱われています。
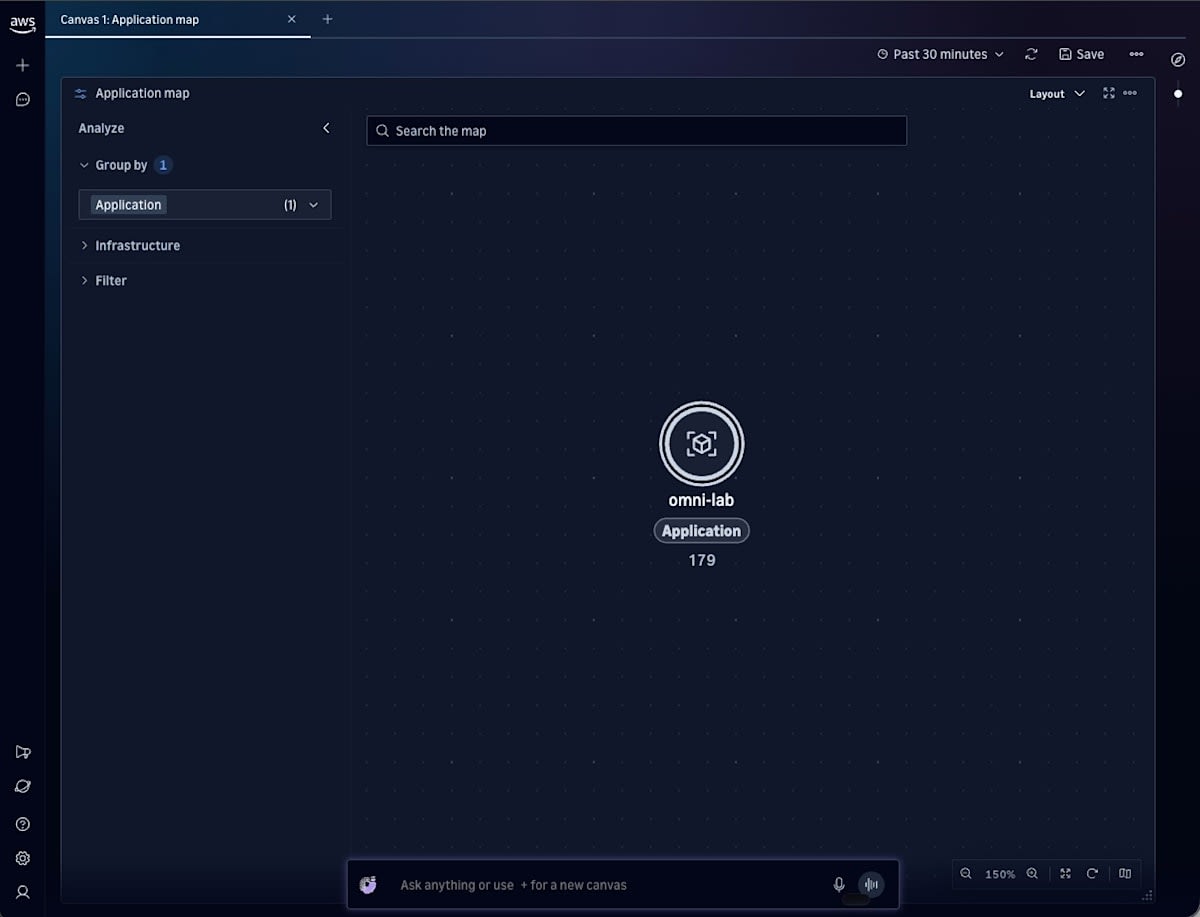
ドリルダウンすると、ようやく3サービスが出てきます。
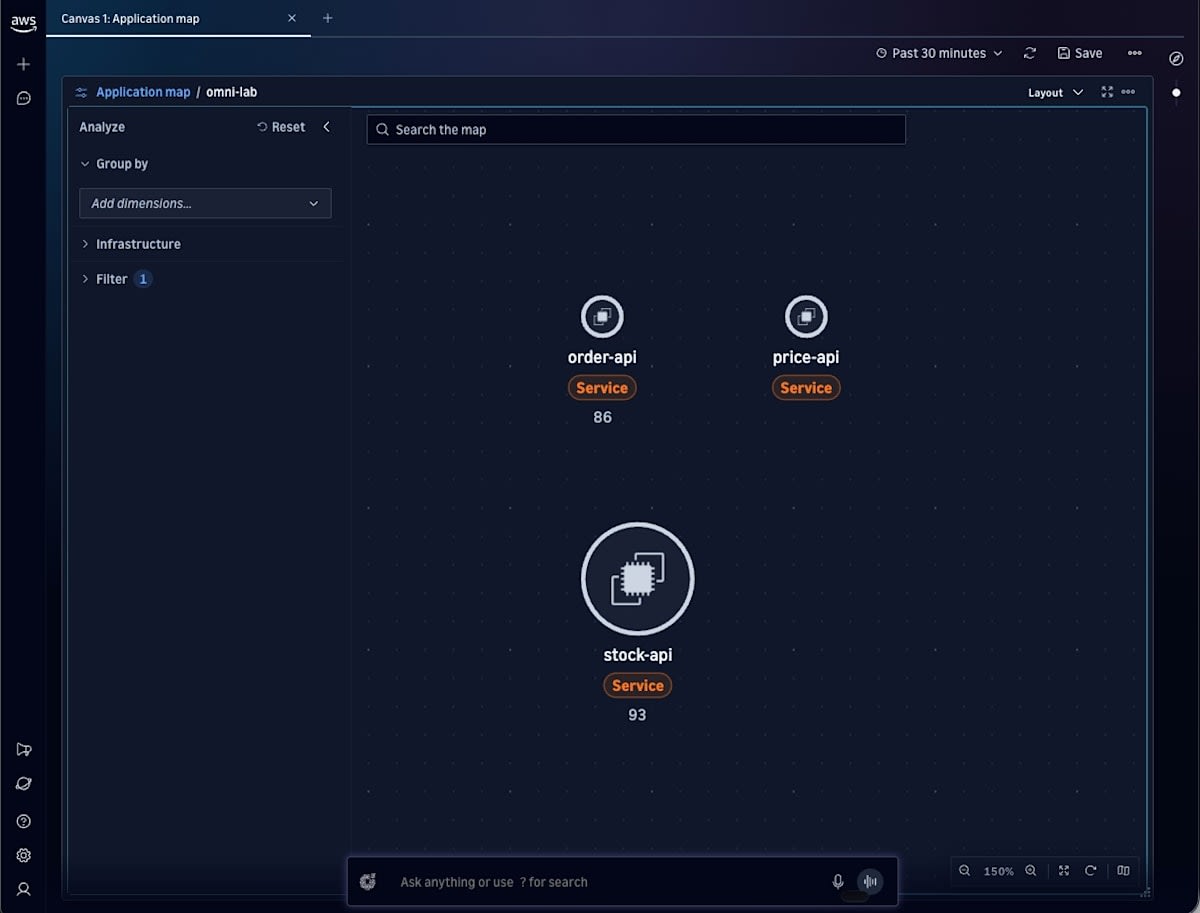
3アカウントのサービスが1つの画面に並んだのは期待どおりです。一方で気になる点が2つありました。order-api / stock-api / price-api のノードが離れて置かれたまま、依存関係の線が1本も引かれていないこと。そして order-api に 86、stock-api に 93 とリクエスト数が出ている中で、price-api だけ数字が無いことです。原因は2つとも掘れたので、「ハマったポイント」にまとめます。
なお、この Application Map のもとになっている Context Graph は、API で引くとサービスなどの点を nodes、点と点をつなぐ線を edges というキーで返します。この記事でも、以降は線のことをエッジと呼びます。
ノードを選ぶと右に Service properties が出ますが、ここにアカウント情報はありません。表示されるのは Service name / Application / Environment / Cloud provider の4つだけでした。
3. Services を見る
Services の画面では、3サービスが discovered・instrumented として認識されていました。
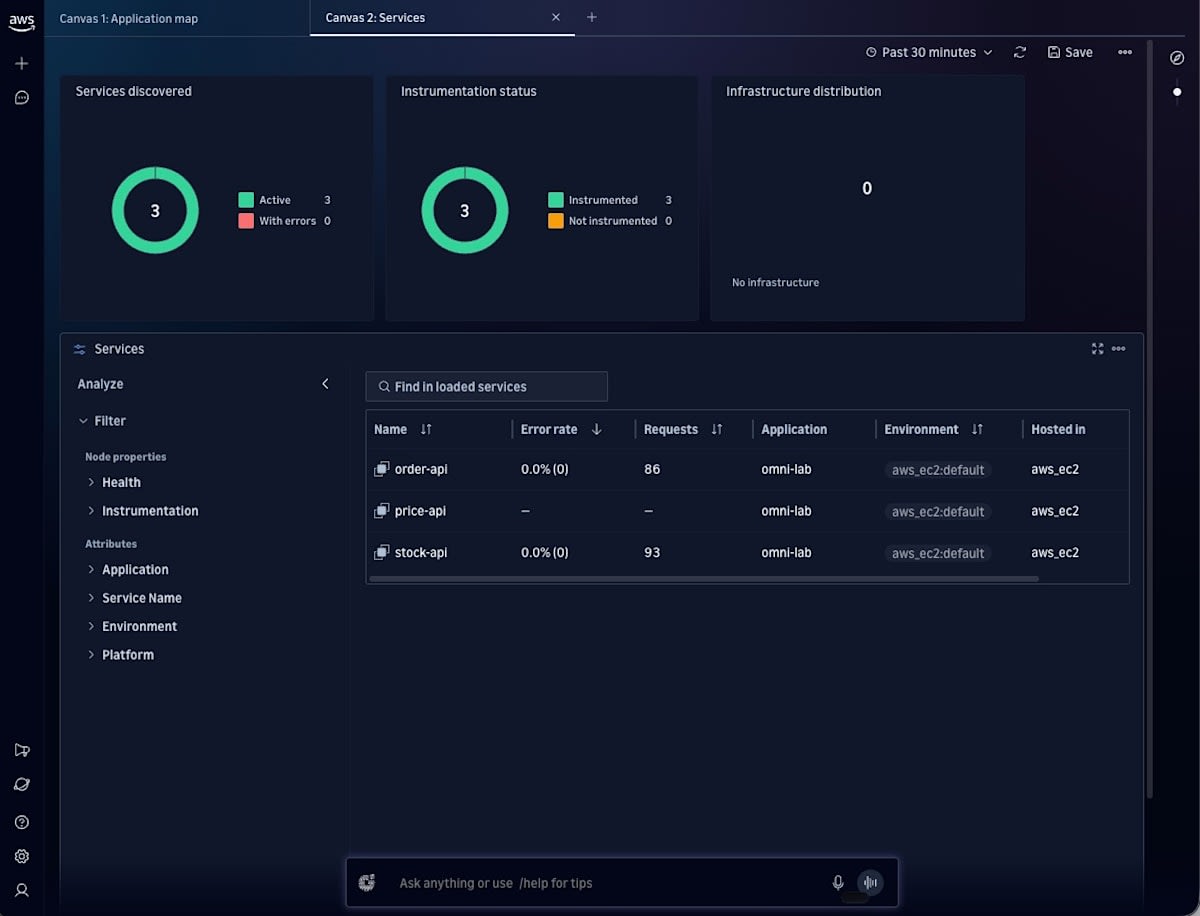
画面の上段には3つの枠が並びます。
- Services discovered(検出されたサービス): テレメトリから見つかったサービスの数です。3つ見つかっていて、内訳は Active 3 / With errors 0。エラーを出しているサービスは無い状態です
- Instrumentation status(計装の状況): そのうち計装されているサービスの数です。Instrumented 3 / Not instrumented 0 なので、3つとも OpenTelemetry のデータが届いています
- Infrastructure distribution(インフラの内訳): サービスが動いているインフラのリソースを、種類ごとに数えたものです。ここは 0(No infrastructure)でした
一覧には order-api(Error rate 0.0%・Requests 86)、stock-api(0.0%・93)、price-api(どちらも —)が、Application omni-lab / Environment aws_ec2:default / Hosted in aws_ec2 という同じ形で並びます。
別アカウントの stock-api と price-api が、何も意識せず自アカウントのサービスと同じ表に並ぶのは、マルチアカウントだと素直にうれしいです。ただ、この表にもアカウントの列はありません。Hosted in は aws_ec2 までで、どのアカウントの EC2 なのかは分かりません。
Infrastructure distribution の 0 も気になりました。Hosted in が aws_ec2 になっているので「EC2 の上で動いている」ことは分かっているのに、その EC2 インスタンス自体は、サービスに紐づくリソースとして1つも登録されていない、ということになります。実際、あとから Context Graph を API で引いてみても、ノードは3件すべて SERVICE で、RESOURCE タイプのノードは0件でした。サービスの関係だけでなくインフラまで1枚で見たい場合は、物足りないところです。
price-api の Error rate と Requests が — なのは、Application Map で数字が出なかったのと同じ症状です。
4. トレースとスパンを見る
ここが今回の本題です。
用語を先に整理しておくと、トレースは1つのリクエストがサービスをまたいで通った道のり全体、スパンはその道のりを区切った1区間です。今回だと「order-api がリクエストを受けて処理した」で1区間、「order-api が stock-api を呼び出した」で1区間……と作られていき、同じ Trace ID を持つ5本のスパンで1トレースになります。いちばん最初のスパン(ここでは order-api が /order を受けたところ)をルートスパンと呼びます。
まず Application traces から見ていきます。
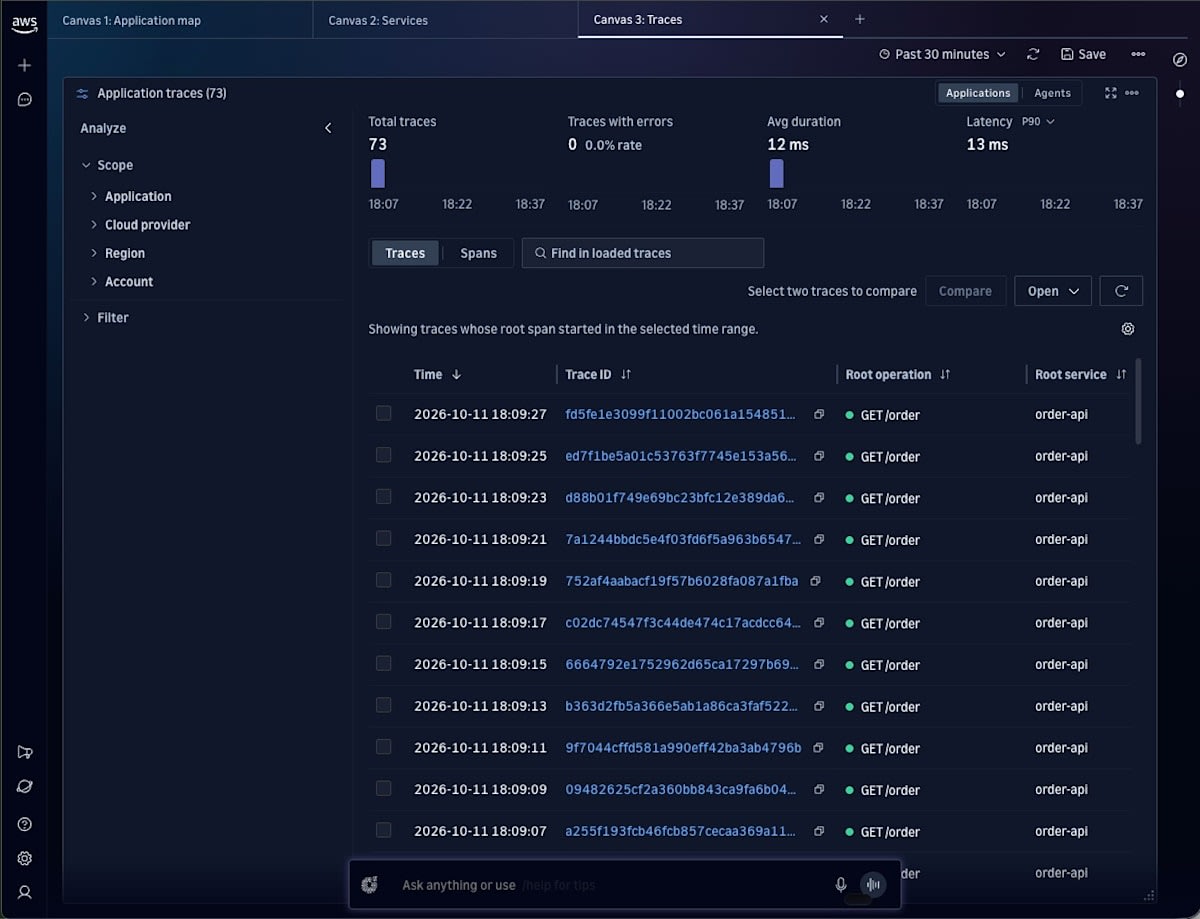
この時間帯のトレースは73件で、Avg duration 12 ms、Latency P90 13 ms。注目したいのは左の Scope で、Application / Cloud provider / Region と並んで Account のファセットがあることです。ファセットは絞り込みの軸のことで、属性ごとに「その属性にどんな値があるか」が並び、チェックを入れるだけで絞り込めます。つまり、アカウントを軸にトレースを絞れるということです。
キャンバスには「Showing traces whose root span started in the selected time range.(選択した時間範囲内にルートスパンが開始したトレースを表示しています)」と明記されていて、どの時刻で絞られているのかが分かるのも親切でした。
スパンの一覧に移ると、同じ Trace ID の行が5本並びます。
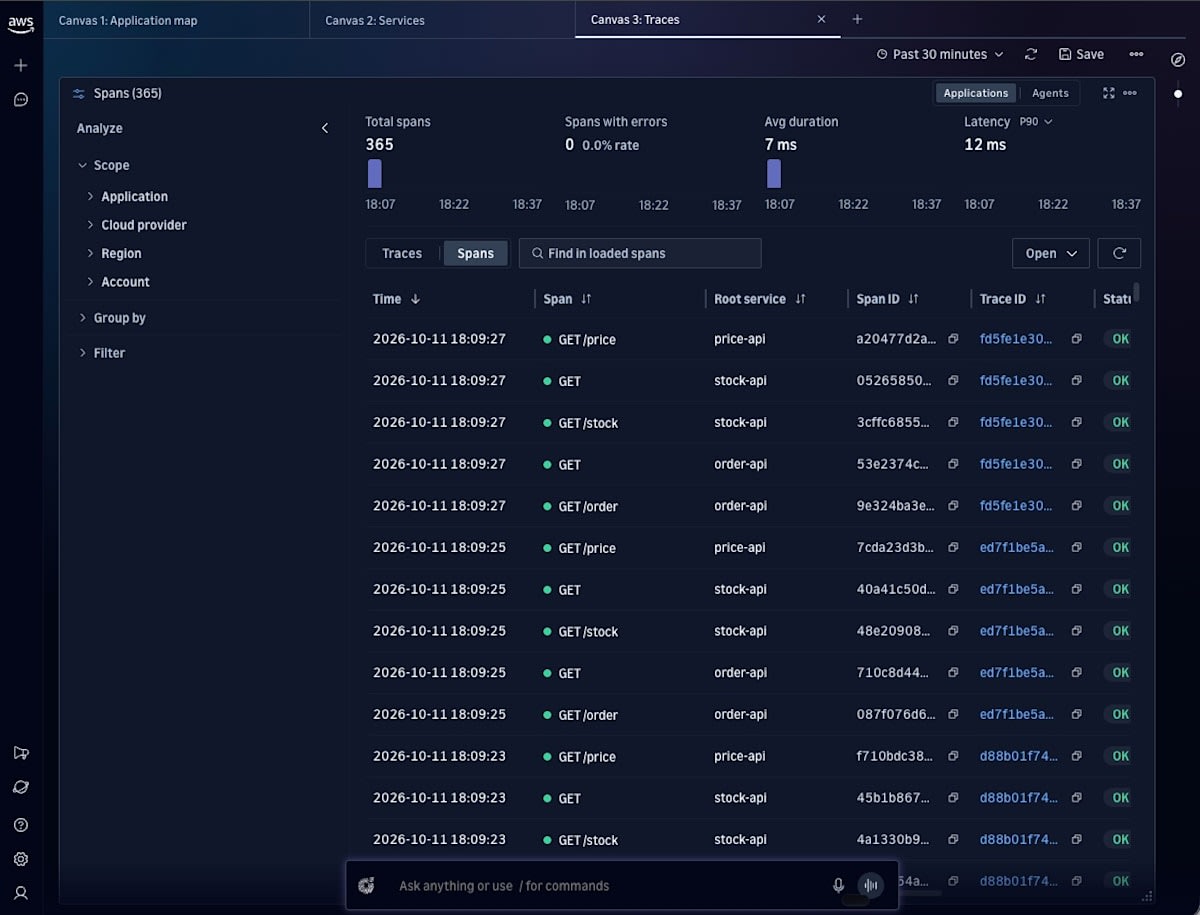
GET /order(order-api)、GET(order-api)、GET /stock(stock-api)、GET(stock-api)、GET /price(price-api)の5スパンが、同じ Trace ID・同じ時刻で1つの一覧に出てきました。3アカウントのスパンが混ざっているのに、画面上はただのスパン一覧です。総数は 365 spans で、73 traces × 5 spans とぴったり合います。Application Map で数字が出なかった price-api も、ここにはちゃんと出ています。
5. Explore でアカウントを絞り込む
Explore の Browse から Fields(92 fields)を開き、@aws.account を展開すると、3つのアカウント ID が値として列挙され、チェックボックスで選べます。
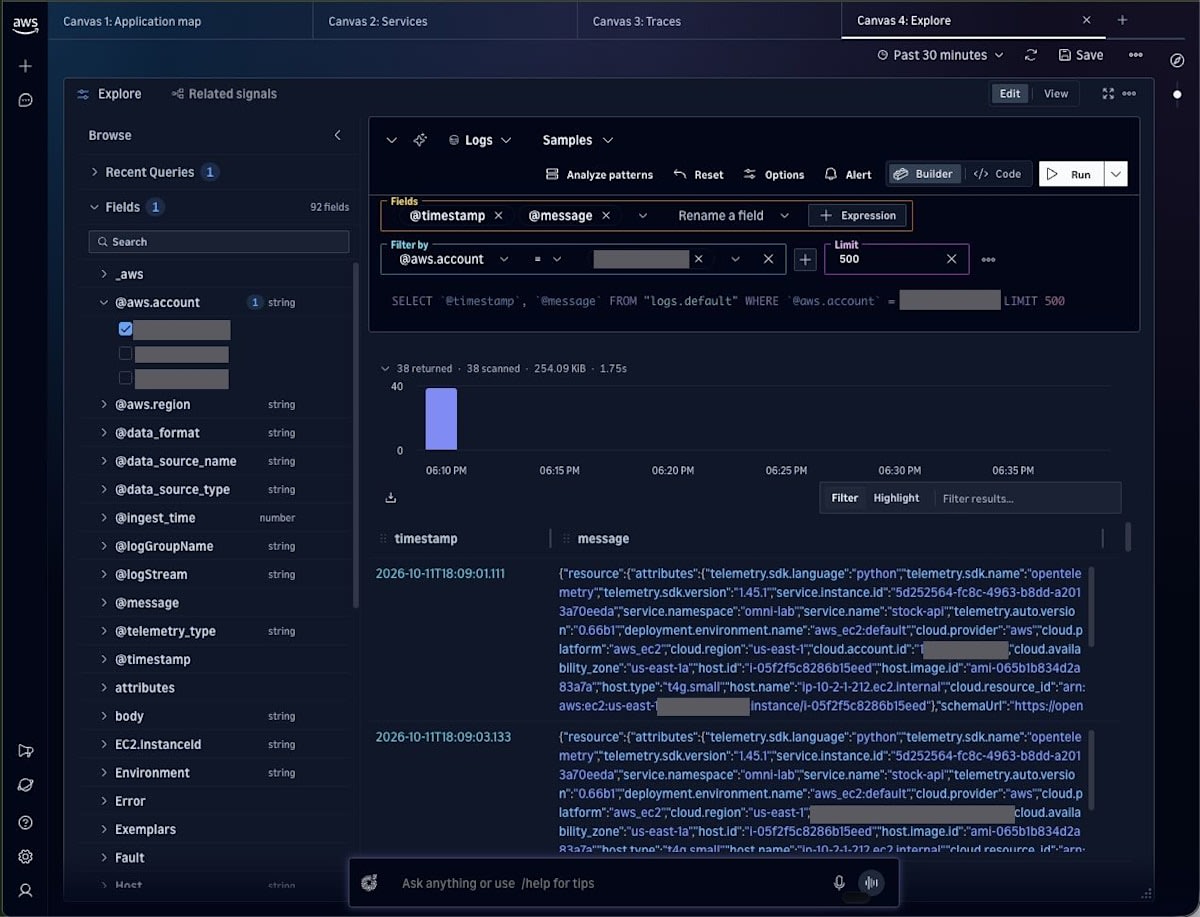
Builder で条件を組むと、下に SQL が生成されます。
SELECT `@timestamp`, `@message` FROM "logs.default" WHERE `@aws.account` = '<APP_B>' LIMIT 500
38 returned · 38 scanned · 254.09 KiB · 1.75s
アカウント ID を覚えていなくても、「どのアカウントの値が存在するか」を UI 側が列挙してくれるのが地味にありがたいです。12桁の数字をコピペして回る作業が減ります。
同じテレメトリクエリは CLI からも投げられます。扱える telemetryType は TRACES と LOGS だけで、METRICS は enum に無く ValidationException になりました。LOGS / TRACES のどちらにも @aws.account と @aws.region が標準フィールドとして存在するので、集めたデータをアカウント単位で集計できます。
まず、1回目の負荷(150リクエスト)をアカウント別・ロググループ別に数えてみます。
SELECT `@aws.account` AS account, `@logGroupName` AS log_group, count(*) AS n
FROM default
WHERE `@timestamp` BETWEEN TIMESTAMP '2026-10-11 09:00:00' AND TIMESTAMP '2026-10-11 09:15:00'
GROUP BY 1, 2 ORDER BY n DESC
| log_group | account | n |
|---|---|---|
aws/spans |
<APP_A> |
300 |
aws/spans |
<APP_B> |
300 |
aws/spans |
<NETWORK> |
150 |
/aws/application-signals/data |
<APP_B> |
192 |
/aws/application-signals/data |
<APP_A> |
186 |
/aws/application-signals/data |
<NETWORK> |
90 |
/aws/cwagent/otlp |
<APP_A> |
150 |
/aws/cwagent/otlp |
<APP_B> |
150 |
/aws/cwagent/otlp |
<NETWORK> |
150 |
アクセスログは各アカウント 150 行ずつ。スパンは app-a が 300、app-b が 300、network が 150 で、上流2つはサーバスパンとクライアントスパンで1リクエスト2本、末端はサーバスパンだけで1本なので、150リクエストで合計 750 スパンという計算が合います。中央アカウント(nw-monitoring)自身の行が出ないのも、集約ルールのソースに入れていないので正しい挙動です。
サービス別のレイテンシも、1本のクエリで3アカウント分が出ます。
SELECT `@aws.account` AS account,
       resource['attributes']['service.name'] AS service,
       kind, count(*) AS spans,
       round(avg(durationNano)/1000000, 2) AS avg_ms,
       round(max(durationNano)/1000000, 2) AS max_ms
FROM default
WHERE `@timestamp` BETWEEN TIMESTAMP '2026-10-11 09:04:00' AND TIMESTAMP '2026-10-11 09:10:00'
  AND `@logGroupName` = 'aws/spans'
GROUP BY 1,2,3 ORDER BY service, kind
| service | account | kind | spans | avg_ms | max_ms |
|---|---|---|---|---|---|
order-api |
<APP_A> |
SERVER | 150 | 12.33 | 17.75 |
order-api |
<APP_A> |
CLIENT | 150 | 10.66 | 15.22 |
stock-api |
<APP_B> |
SERVER | 150 | 6.69 | 9.63 |
stock-api |
<APP_B> |
CLIENT | 150 | 5.01 | 7.71 |
price-api |
<NETWORK> |
SERVER | 150 | 0.79 | 1.13 |
12.33 → 10.66 → 6.69 → 5.01 → 0.79 ms と、入れ子の形でレイテンシが削れていくのが1枚の表で読めます。resource['attributes']['service.name'] のようにネストした属性をブラケットで辿れるのもありがたいところでした。
集約されたログイベントそのものにも、アカウント情報が入っています。
{
  "resource": { "attributes": {
      "service.name": "price-api", "service.namespace": "omni-lab",
      "cloud.provider": "aws", "cloud.region": "us-east-1",
      "cloud.account.id": "<NETWORK>",
      "cloud.resource_id": "arn:aws:ec2:us-east-1:<NETWORK>:instance/i-0bdfc7b13fc9ba836",
      "host.id": "i-0bdfc7b13fc9ba836", "host.type": "t4g.small"
  } },
  "scope": { "name": "werkzeug",
    "attributes": { "cloudwatch.source": "cloudwatch-agent", "cloudwatch.solution": "otel-otlp" } },
  "severityText": "INFO",
  "body": "10.2.1.212 - - [11/Oct/2026 09:05:06] \"GET /price HTTP/1.1\" 200 -",
  "traceId": "", "spanId": ""
}
cloud.account.id と cloud.resource_id がリソース属性として入っていて、host.type: t4g.small までエンリッチされていました。一方で werkzeug のアクセスログは traceId / spanId が空です。スパンのコンテキスト外で出力されるログなので、ここからトレースには飛べません。
6. メンバースペースと見比べる
同じドメイン URL から、今度は nw-app-a のスペースに入ります。
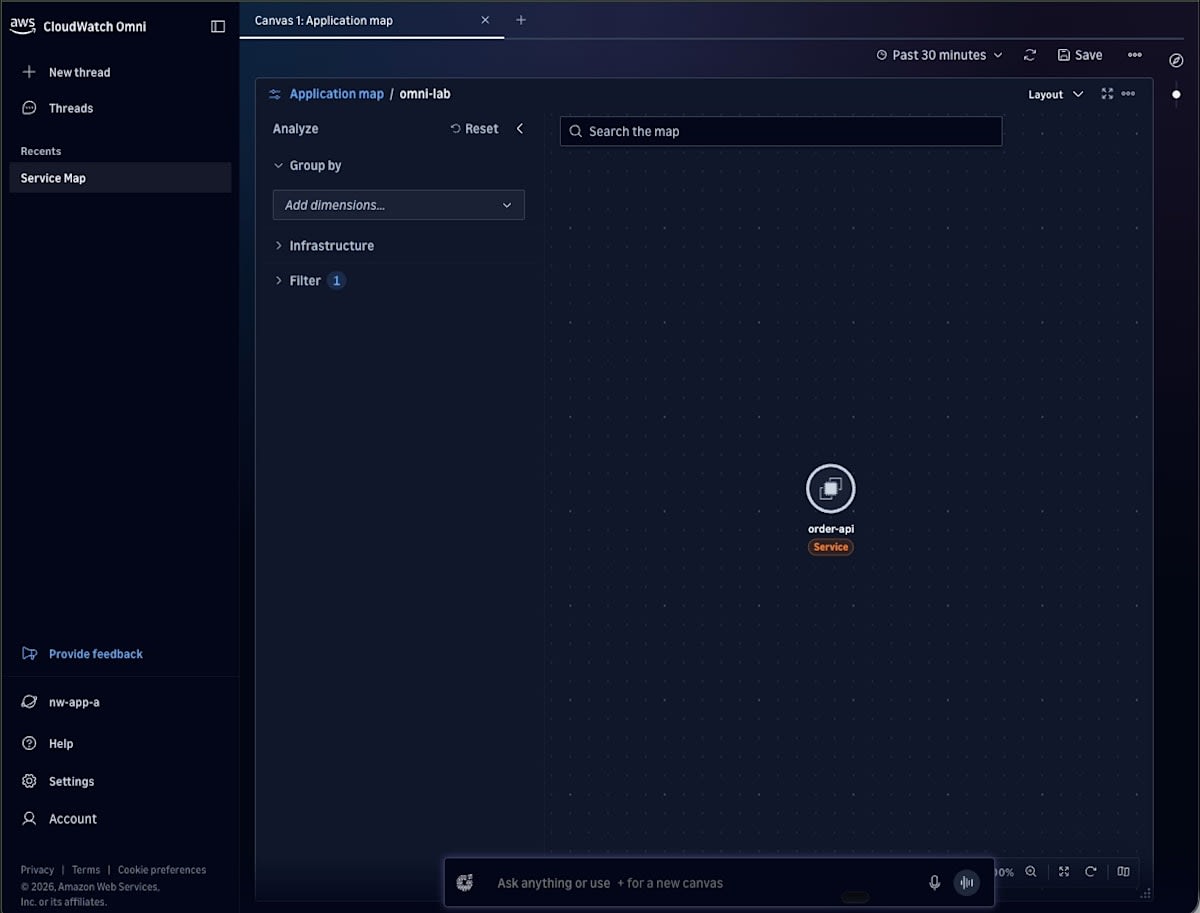
Application map に出てきたのは order-api 1つだけでした。stock-api も price-api もいません。Services も1件です。nw-app-a は集約ルールのソースであって宛先ではないので、app-b と network のデータは入ってきません。
「スペースをまたいだクエリはできないので、別々のスペースを作るのではなく1アカウントに集約してください」という公式ドキュメントの記述が、そのまま画面で体感できた形です。マルチアカウントで CloudWatch Omni を使うなら、中央スペースをどこに置くかを最初に決めておくのが大事だと実感しました。
7. 異常系で起点を探す
ここからは ?fail=1 を付けて、末端の price-api を 500 にします。負荷は90リクエストです。
Services の画面を見ると、今度は price-api にも数字が出ました。
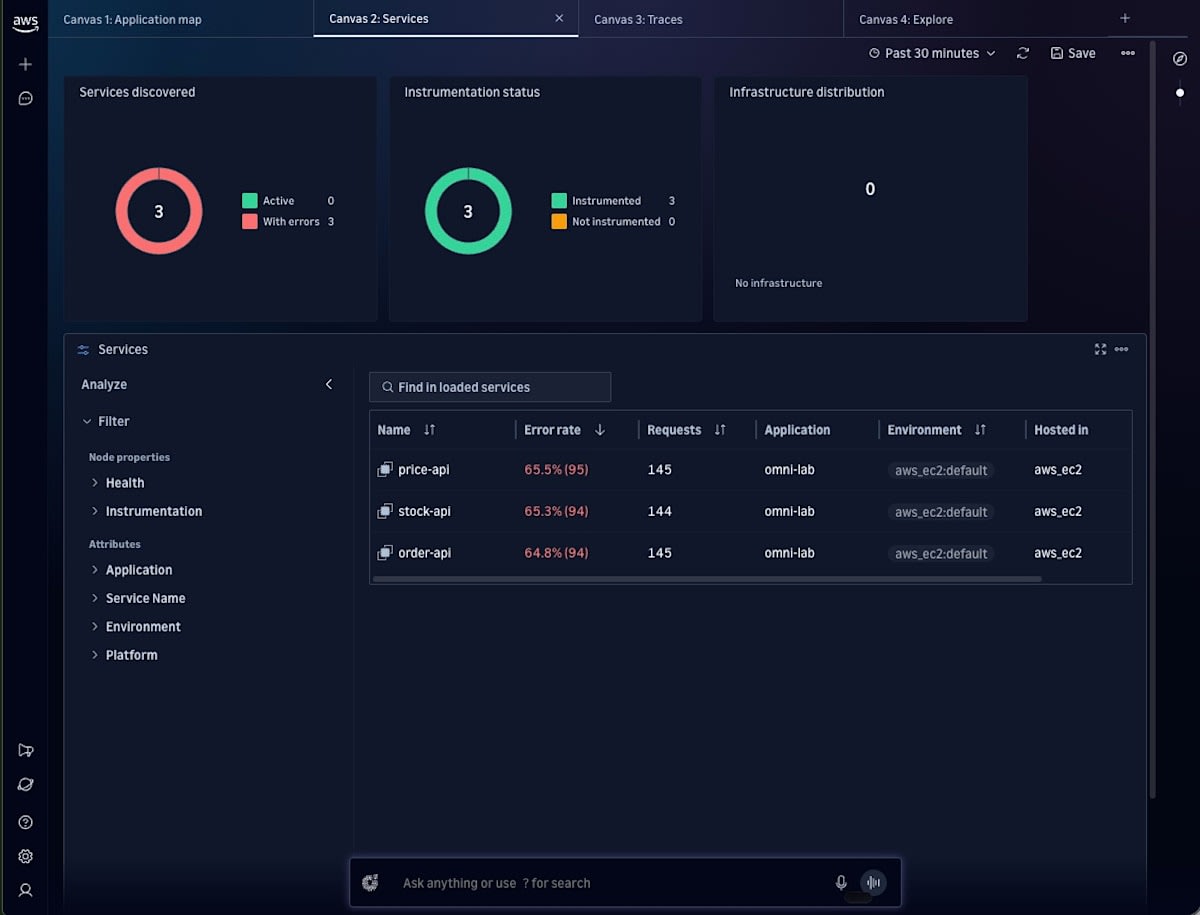
サマリーは Active 0 / With errors 3 に変わり、一覧は price-api が Error rate 65.5%(95件)・Requests 145、stock-api が 65.3%(94件)・144、order-api が 64.8%(94件)・145 です。エラー率が約 65% なのは、表示範囲(Past 30 minutes)に正常系60回と異常系90回の両方が入っているためです(90/145 ≒ 62%)。
ここで困るのが、3サービスとも同じように赤いことです。アプリが raise_for_status() しているので、下流の 500 がそのまま上流に伝播します。スパンのステータスも3アカウントすべてが 500 / ERROR になり、エラー率を見比べても、どのアカウントが起点なのかは分かりません。
これが一発で分かったのが status.message でした。
SELECT resource['attributes']['service.name'] AS service, kind,
       status['message'] AS status_message, count(*) AS n
FROM default
WHERE `@timestamp` BETWEEN TIMESTAMP '2026-10-11 09:56:12' AND TIMESTAMP '2026-10-11 09:59:30'
  AND `@logGroupName` = 'aws/spans' AND status['code'] = 'ERROR'
GROUP BY 1,2,3 ORDER BY service, kind
| service | kind | n | status.message |
|---|---|---|---|
| order-api | SERVER | 90 | HTTPError: 500 Server Error: INTERNAL SERVER ERROR for url: http://10.2.1.212:8080/stock |
| order-api | CLIENT | 90 | (空) |
| stock-api | SERVER | 90 | HTTPError: 500 Server Error: INTERNAL SERVER ERROR for url: http://10.0.1.123:8080/price |
| stock-api | CLIENT | 90 | (空) |
| price-api | SERVER | 90 | RuntimeError: price lookup failed (injected by ?fail=1) |
上流2つは「下流が 500 を返した」という HTTPError で、末端の price-api だけが本物の例外 RuntimeError を持っています。しかも HTTPError のメッセージに呼び先の URL が入っているので、アカウントをまたいで1ホップずつ辿れます。マルチアカウントでは「どのアカウントが赤いか」ではなく「どのアカウントが自分の例外で赤いか」を見るのだな、というのが今回の一番の収穫でした。
なお、Application Signals のメトリクスは 5xx を Fault、4xx を Error として別々に持っています。今回は全部 500 なので Fault だけが立ちました。
| メトリクス | order-api | stock-api | price-api |
|---|---|---|---|
| Fault(5xx)Sum | 67 | 72 | 76 |
| Error(4xx)Sum | 0 | 0 | 0 |
異常系は90リクエストなので Fault も 90 になるはずですが 67〜76 で止まっています。これは測定した時点で、まだメトリクスの集約が追いついていなかったためです。
スパンの一覧でも、ステータスが Fault になります。
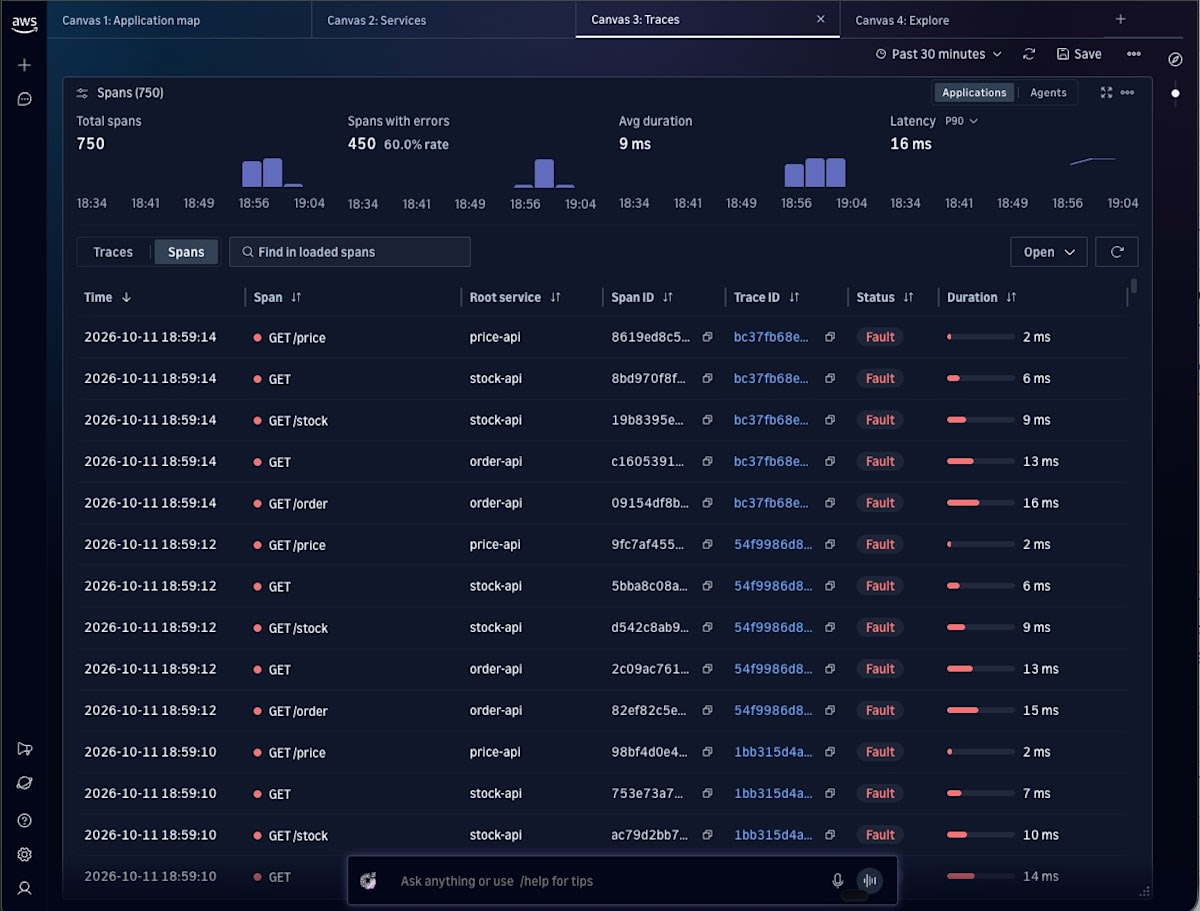
Spans は 750 件で、うち errors が 450 件(60.0%)。750 =(正常60 + 異常90)× 5 スパン、450 = 90 × 5 でぴったりです。Duration の棒グラフが 16 ms → 13 ms → 9 ms → 6 ms → 2 ms と短くなっていくので、どこまで潜った呼び出しなのかが一覧のままでも読めます。
そしてトレースの詳細を開くと、5スパンのウォーターフォールが3アカウントをまたいで描かれます。
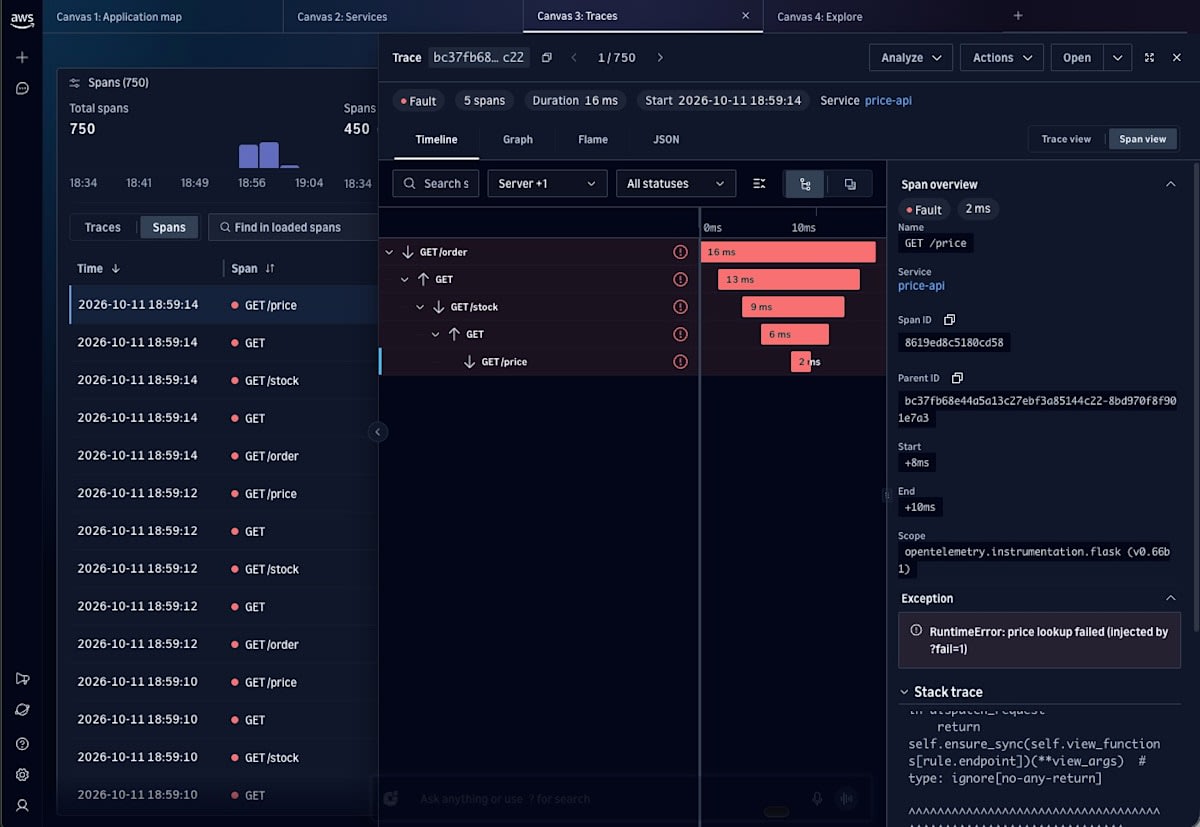
GET /order(16 ms)の中に GET(13 ms)、その中に GET /stock(9 ms)……と入れ子になっていて、矢印(↓ がサーバ、↑ がクライアント)で呼び出しの向きも分かります。スパンを選ぶと右の Span overview に、末端の例外 RuntimeError: price lookup failed (injected by ?fail=1) と、Flask の dispatch_request まで含むスタックトレースがそのまま出ました。別アカウントのアプリケーションのスタックトレースが、中央スペースから1クリックで読めるのはなかなかの体験です。ただし Span overview にもアカウント ID は出ません。
同じトレースを Graph ビューに切り替えると、呼び出しが1本に繋がります。
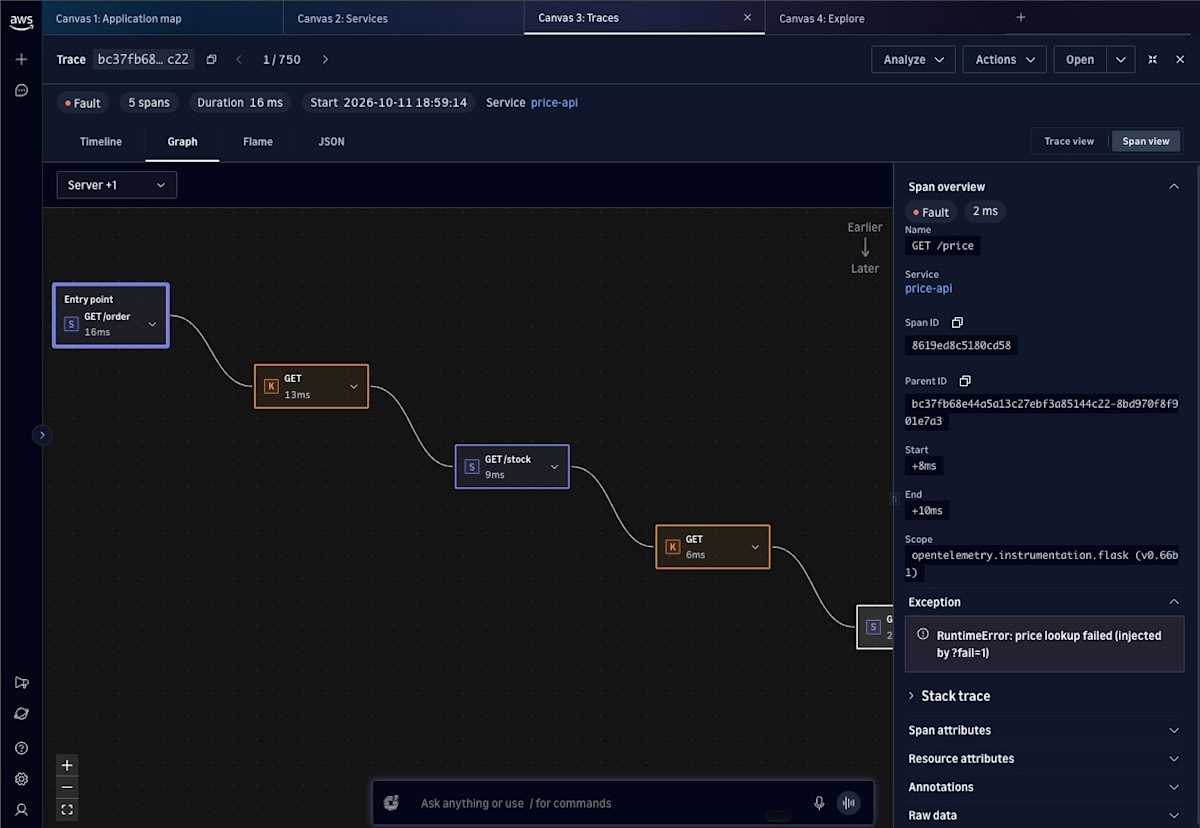
Entry point から GET /order(16 ms)→ GET(13 ms)→ GET /stock(9 ms)→ GET(6 ms)→ GET /price(2 ms)と、S(Server)と K(Client)のバッジ付きで並びました。Application Map では線が1本も引けなかったのに、トレース単位の Graph ビューでは依存関係がきれいに繋がっています。同じ中央スペースの中で、2つのビューの答えが食い違っていました。
異常系のときの Application Map も見てみましたが、ノードは3つのままでエッジは現れず、エラーを示す色の変化もありませんでした(キャンバスの時間範囲が古いままだった可能性は残ります)。
8. CloudWatch Omni のエージェントに根本原因を聞く
せっかくなので、CloudWatch Omni のエージェントに「なぜ order-api がエラーになっているのか、根本原因を教えて」と聞いてみました。すると、まず調査のしかたを聞かれます。選択肢は「ここでインラインで実行」(すぐに結果を返す簡易ルックアップ)と「バックグラウンドで詳細調査 を実行」(複数のシグナルを横断して根本原因を深掘り・Recommended)の2つです。
推奨されている「バックグラウンドで詳細調査」を選んだのですが、こちらは失敗しました。
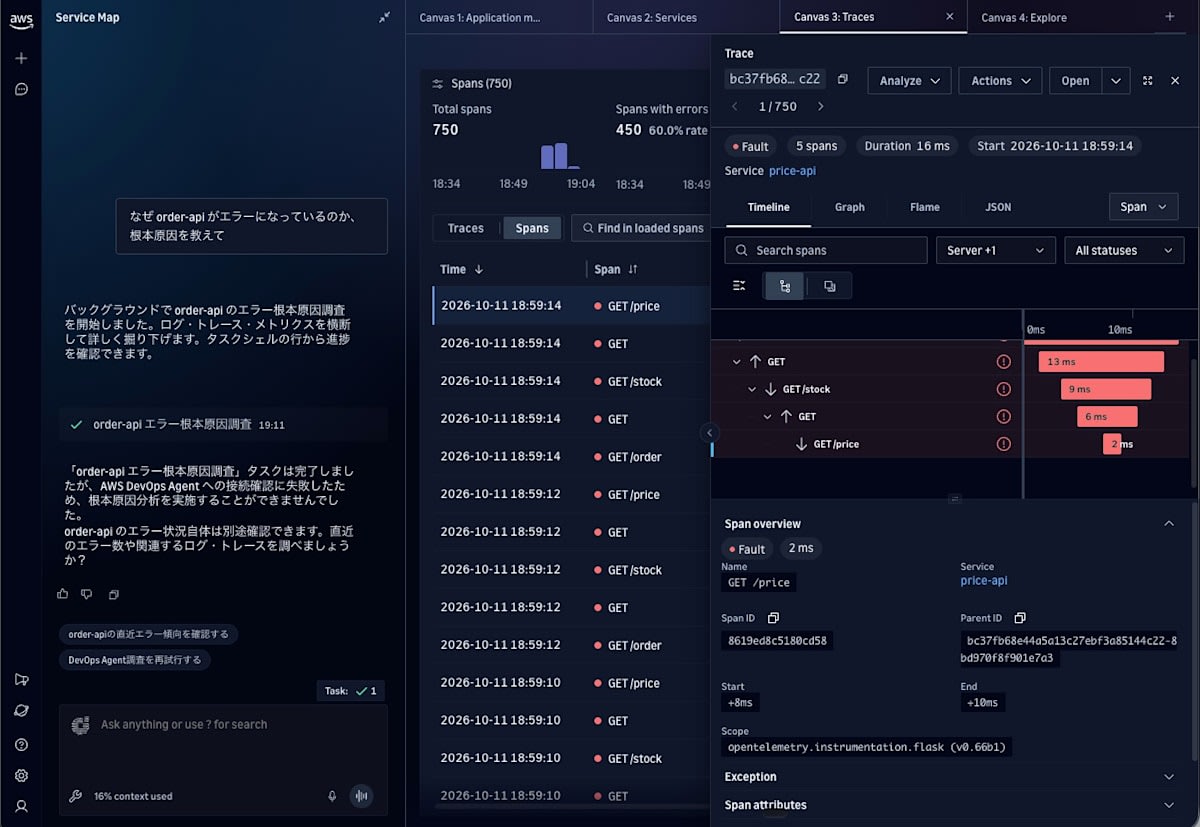
「order-api エラー根本原因調査」タスクは完了しましたが、AWS DevOps Agent への接続確認に失敗したため、根本原因分析を実施することができませんでした。
権限が足りないのかと思って調べたのですが、そもそも AWS DevOps Agent 側が未設定でした。
$ aws devops-agent list-agent-spaces --profile nw-monitoring --region us-east-1
{ "agentSpaces": [] }
$ aws devops-agent list-services --profile nw-monitoring --region us-east-1
{ "services": [] }
スペースアクセスロールには AIDevOpsAgentFullAccess が付いていますが、AWS DevOps Agent は別サービスで、aws devops-agent create-agent-space / register-service で独自の agent space を先に作る必要があります。スペース作成画面の「DevOps エージェントを使用する」チェックボックスは IAM ポリシーを付けるだけで、サービスの有効化ではないんですね。今回はここまでで、agent space の作成は未実施です。
おもしろかったのは、AWS DevOps Agent 無しでも、エージェント自身が SQL を書いて原因を特定してきたことです。
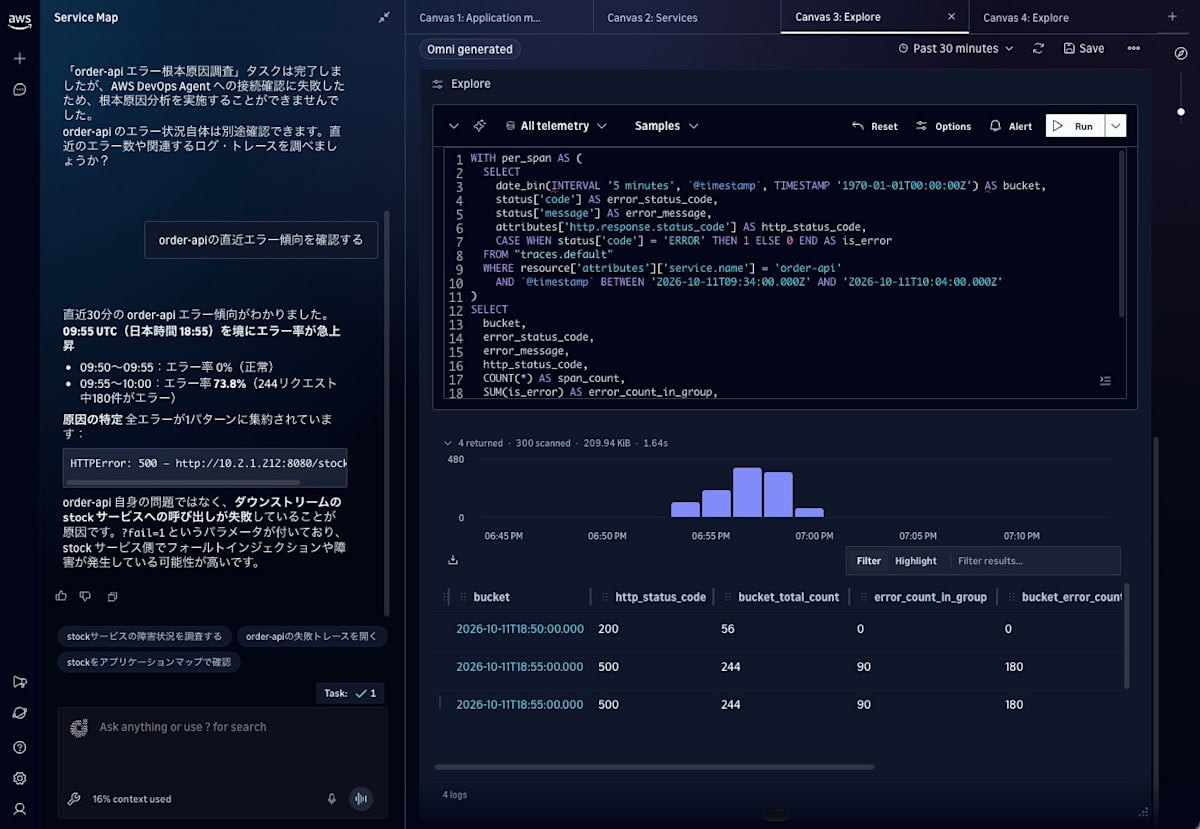
回答は、09:55 UTC(日本時間 18:55)を境にエラー率が 0% から 73.8%(244リクエスト中180件)に急上昇したこと、全エラーが HTTPError: 500 — http://10.2.1.212:8080/stock の1パターンに集約されていることを挙げたうえで、こう結んでいました。
order-api 自身の問題ではなく、ダウンストリームの stock サービスへの呼び出しが失敗していることが原因です。?fail=1 というパラメータが付いており、stock サービス側でフォールトインジェクションや障害が発生している可能性が高いです。
同時に、新しい Explore キャンバス(Omni generated バッジ付き)に SQL を生成していました。
WITH per_span AS (
  SELECT
    date_bin(INTERVAL '5 minutes', `@timestamp`, TIMESTAMP '1970-01-01T00:00:00Z') AS bucket,
    status['code'] AS error_status_code,
    status['message'] AS error_message,
    attributes['http.response.status_code'] AS http_status_code,
    CASE WHEN status['code'] = 'ERROR' THEN 1 ELSE 0 END AS is_error
  FROM "traces.default"
  WHERE resource['attributes']['service.name'] = 'order-api'
    AND `@timestamp` BETWEEN '2026-10-11T09:34:00.000Z' AND '2026-10-11T10:04:00.000Z'
)
SELECT bucket, error_status_code, error_message, http_status_code,
  COUNT(*) AS span_count, SUM(is_error) AS error_count_in_group, ...
5分バケットで集計した結果は、18:50 のバケットが http_status_code 200・56スパン・エラー0、18:55 のバケットが 500・244スパン・エラー180という内訳でした。
回答を検証結果と突き合わせると、こうなります。
| 観点 | 結果 |
|---|---|
| エラー率の急変時刻を特定したか | ⭕ 09:55 UTC を境に 0% → 73.8% |
| order-api 自身の問題ではないと言えたか | ⭕ 「ダウンストリームへの呼び出しが失敗」と明言 |
| 1ホップ下(stock-api)を特定したか | ⭕ http://10.2.1.212:8080/stock から特定 |
| 真の起点(price-api / nw-network)まで辿ったか | ❌ stock-api で止まった |
| 注入した障害であることに気づいたか | ⭕ 「?fail=1 というパラメータ」「フォールトインジェクションの可能性」 |
今回の真の起点は price-api(nw-network)で、stock-api(nw-app-b)はそれを中継しているだけです。エージェントの回答は1ホップ下で止まりました。order-api のスパンには HTTPError: 500 — http://10.2.1.212:8080/stock までしか書かれていないので、さらに下を辿るには stock-api のスパンを見に行く必要があり、そこまでは自動では行かなかった形です。
とはいえ「stockサービスの障害状況を調査する」という次アクションは提示してくるので、押し続ければ辿り着けます。エラー率の急変時刻やフォールトインジェクションの可能性まで言い当てたうえで、AWS DevOps Agent 無しでも自力で SQL を書いて分析するのは十分実用的だと感じました。3アカウントをまたぐ障害では、1ホップの回答をそのまま採ると1つ手前のアカウントを原因だと判断してしまうので、そこだけ人間が気をつければよさそうです。
ハマったポイント
Application Map に依存関係の線が引かれない
今回一番ひっかかったのがこれです。トレースの Graph ビューでは order-api → stock-api → price-api が繋がるのに、Application Map ではノードが3つ並ぶだけでエッジが1本もありません。同じ中央スペースの同じデータを見ているはずなのに、です。
集約先の /aws/application-signals/data を集計したら、理由が見えてきました。
| account | Service | Operation | RemoteService | RemoteOperation | n |
|---|---|---|---|---|---|
<APP_A> |
order-api | GET /order | (空) | (空) | 94 |
<APP_A> |
order-api | GET /order | 10.2.1.212:8080 |
GET /stock | 94 |
<APP_B> |
stock-api | GET /stock | (空) | (空) | 98 |
<APP_B> |
stock-api | GET /stock | 10.0.1.123:8080 |
GET /price | 98 |
<NETWORK> |
price-api | GET /price | (空) | (空) | 97 |
RemoteService が IP アドレスとポートになっています。スパンの属性まで降りるとはっきりします。
service: stock-api
  aws.span.kind         = CLIENT
  aws.local.service     = stock-api
  aws.local.operation   = UnmappedOperation
  aws.remote.service    = 10.0.1.123:8080     ← ここ
  aws.remote.operation  = GET /price
  http.url              = http://10.0.1.123:8080/price
今回のアプリは下流を IP 直指定(http://10.2.1.212:8080/stock)で呼んでいます。そのためクライアントスパンの aws.remote.service が 10.2.1.212:8080 という文字列になっていて、stock-api というサービスノードとは結びついていません。ここから、Application Map の依存関係は、トレースがつながっているかどうかではなく、aws.remote.service をサービス名として解決できるかどうかで決まっているのではないかと考えました。トレースと Application Map で答えが食い違ったのも、そもそも見ているデータが別物だからではないかと思います。
下流を DNS 名で呼ぶ、あるいは Private Hosted Zone を使うと変わるのか、というのは今回は未検証です。ここは次の宿題にします。マルチアカウントで Application Map のエッジを期待するなら、サービス間の呼び出しを名前で行う設計にしておくのが前提になりそうです。
なお、エッジが無くても障害調査自体は詰みません。「やったこと」の7で見たとおり、status.message に呼び先の URL が入っているので、そこからアカウントをまたいで辿れます。
集約ルールを作った直後のメトリクスは当てにならない
price-api だけ Application Map の数字と Services の Requests / Error rate が — だった件です。こちらはメトリクス集約の立ち上がりでした。
集約ルールを作った2分後に負荷を流したところ、集約先に届いたメトリクスはこうなりました。
| サービス | ソース側 | 集約先 | 集約先の範囲 | 到達率 |
|---|---|---|---|---|
| order-api | 150 | 48 | 09:05–09:09Z | 32% |
| stock-api | 150 | 49 | 09:05–09:09Z | 33% |
| price-api | 150 | 15 | 09:08–09:09Z | 10% |
分単位で見ると、サービスごとに立ち上がりのタイミングが違っていて、price-api は負荷の最後の2分しか届いていませんでした。
order-api  09:05=4  09:06=6  09:07=10  09:08=19  09:09=9    計48
stock-api  09:05=4  09:06=6  09:07=13  09:08=17  09:09=9    計49
price-api                              09:08=7   09:09=8    計15
時間をおいて再取得しても数値は変わらなかったので、遅延ではなく取りこぼしです。ルール作成の52分後に同じ負荷を流すと、今度はきちんと届きました。
| サービス | 1回目(ルール作成の2分後) | 2回目(ルール作成の52分後) |
|---|---|---|
| order-api | 150 → 48(32%) | 83 → 80(96%) |
| stock-api | 150 → 49(33%) | 83 → 82(99%) |
| price-api | 150 → 15(10%) | 83 → 81(98%) |
ログとスパンは負荷開始から8〜24秒で全量が集約先に届いていたので、同じ集約ルールでもメトリクスだけ経路が違うようです。「集約は過去分を遡らない」というドキュメントの記述は、実務では「作った直後の数字を信じない」という意味になるのだなと受け取りました。集約ルールを作ったらしばらく置いてから計測する、Services 画面で1サービスだけ — になっていたらまずこれを疑う、というのが対処になります。
アカウント情報は Context Graph にあるが、画面には出てこない
Application Map の Service properties にも Services 一覧にもアカウントの列が無かったので、データ自体が無いのかと思っていました。が、API で引くとちゃんと持っています。
{
  "nodeId": "6ca8f4ec-521c-8444-9306-538d95182b7e",
  "nodeType": "SERVICE",
  "name": "order-api",
  "nodeProperties": {
    "region": "us-east-1", "cloudProvider": "aws",
    "sourceAccountId": "<APP_A>",
    "namespace": "omni-lab", "stage": "aws_ec2:default"
  },
  "operationDetails": { "GET /order": [ { "span.kind": "SPAN_KIND_SERVER", "span.name": "GET /order" } ] },
  "signalTypes": ["METRICS", "TRACES", "LOGS"],
  "sources": ["TELEMETRY"],
  "firstObservedAt": "2026-10-11T19:21:00+09:00",
  "lastObservedAt": "2026-10-11T19:26:00+09:00"
}
aws cloudwatchomni get-context-graph のノードには nodeProperties.sourceAccountId が入っていて、3サービスがそれぞれ正しいアカウント ID を持っていました(--start-time と --end-time は必須です)。「アカウントをまたいで何が見えるか」は画面と API で答えが違うので、画面に出ていなくても諦めずに API を叩いてみるとよさそうです。
もう1つ、この Context Graph の設定は、スペース作成画面では「リソース検出を有効にする」という名前で置かれています。「その他のスペースアクセスロール権限」を展開すると出てくる3つのチェックボックスのうちの1つです。
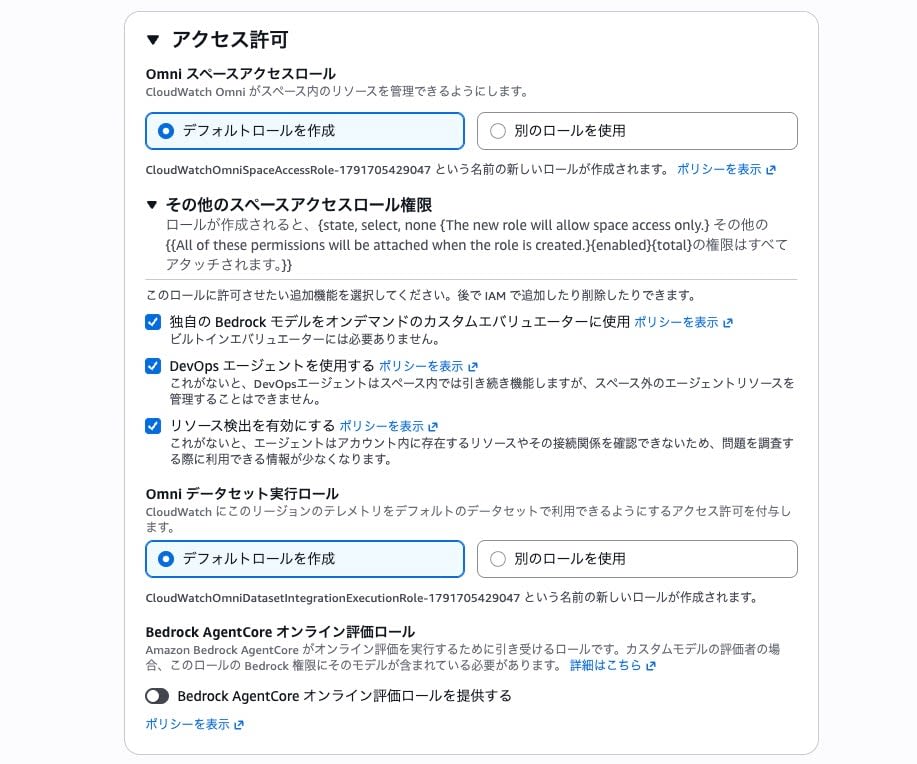
| チェックボックス | 実体のポリシー |
|---|---|
| 独自の Bedrock モデルをオンデマンドのカスタムエバリュエーターに使用 | CloudWatchOmniModelInferencePolicy |
| DevOps エージェントを使用する | AIDevOpsAgentFullAccess |
| リソース検出を有効にする | CloudWatchOmniAWSIntegrationPolicy |
画面上に "Context Graph" も "Application Map" も出てきません。説明文は「これがないと、エージェントはアカウント内に存在するリソースやその接続関係を確認できないため、問題を調査する際に利用できる情報が少なくなります。」となっていて、エージェント視点で書かれています。公式ドキュメントでは同じ CloudWatchOmniAWSIntegrationPolicy を「Resource discovery for Context Graph」と説明しているので、観点が違うんですね。
既定でチェック済みなので触らなければ問題ないのですが、「エージェントは使わないからチェックを外そう」と判断すると、アカウントをまたいだ Application Map の材料まで無くなってしまいます。ここは外さないのが無難です。
ちなみに同じ画面の説明文は、ICU MessageFormat のテンプレートが展開されないまま表示されていて読めませんでしたww
ロールが作成されると、{state, select, none {The new role will allow space
access only.} その他の {{All of these permissions will be attached when the
role is created.}{enabled}{total}の権限はすべてアタッチされます。}}
トレースが見えないときは X-Ray のインデックス率を疑う
これは構築中に気づいた点です。AWS X-Ray の Default インデックスルールの DesiredSamplingPercentage が、スペースのあるアカウントで 1.0、スペースの無いアカウントで 0.0 になっていました。スペース作成(OpenTelemetry スパンの取り込み有効化)が 1% に設定し、それ以外は 0% のままという挙動のようです。
今回のような小規模な負荷だと、1% ではトレースがほとんど索引されません。全アカウントで 100% に上げました。
$ aws xray update-indexing-rule --name Default --rule Probabilistic={DesiredSamplingPercentage=100}
「中央スペースにトレースが出てこない」となったとき、集約ルールを疑う前にここを見ると早いかもしれません。
結果
中央スペース(集約先)とメンバースペース(ソース)で、何が見えて何が見えなかったかをまとめます。
| 見たいもの | 中央スペース(集約先) | メンバースペース(ソース) | 補足 |
|---|---|---|---|
| 3アカウントのログ | ⭕ | 自分の分だけ | 同名のロググループにマージされ、ストリーム名の末尾に -<アカウントID>-<リージョン> が付く |
| 3アカウントのスパン | ⭕ | 自分の分だけ | 1 trace = 5 spans が3アカウントにまたがる |
| 1本のトレースをアカウントをまたいで辿る | ⭕ | ❌ | ウォーターフォール+末端の例外・スタックトレースまで |
| アカウントで絞り込む | ⭕ | — | @aws.account が標準フィールド。Explore が値を列挙してくれる |
| Application Map の依存関係(エッジ) | ❌ | ❌ | 呼び先が IP だと aws.remote.service が名前解決されない |
| Application Map のノードにアカウント情報 | ❌(UI)/ ⭕(API) | — | get-context-graph の sourceAccountId には入っている |
| Services 一覧のアカウント列 | ❌ | — | 表にアカウントの列が無い |
| メトリクス(Services の Requests / Error rate) | ⭕ ただし立ち上がりに数十分 | — | ルール作成直後は到達率 10〜33% |
| エージェントによる根本原因特定 | △ 1ホップ下まで | — | 3アカウントの末端までは自動で辿らない |
まとめ
CloudWatch Omni の組織レベルドメインと集約ルールで、3アカウントのテレメトリを1つのスペースに集めて検証してみました!
- 中央スペースに集めれば、ログ・スパン・トレースはアカウントを意識せず追える。別アカウントのアプリケーションのスタックトレースまで1クリックで読めた
- Application Map の依存関係は、トレースのつながりではなく
aws.remote.serviceの名前解決で決まっていそう。下流を IP 直指定で呼んでいると、トレースが1本に繋がっていてもエッジは引かれなかった - 集約ルールを作った直後のメトリクスは取りこぼす(到達率 10〜33%)。ログ・スパンが8〜24秒で届くのとは経路が違う
個人的に一番の収穫は、異常系で status.message を見たときでした。3アカウントが全部 500 で赤くなっている中、本物の例外(RuntimeError)を持っているのは起点の1つだけで、上流は呼び先の URL 付きの HTTPError。マルチアカウントの障害調査は「どのアカウントが赤いか」ではなく「どのアカウントが自分の例外で赤いか」を見るものなんだな、と腹落ちしました。
Application Map のエッジが引けなかったのは残念でしたが、原因がアプリケーション側の呼び出し方にあることまで分かったので、次は DNS 名で呼ぶ構成で再挑戦してみたいと思います。
この記事が、CloudWatch Omni をマルチアカウントで導入しようとしている方の判断材料になれば幸いです。最後まで読んでいただき、誠にありがとうございました。
参考記事
- Set up Omni for your organization - Amazon CloudWatch
- Using Context Graph - Amazon CloudWatch
- Send telemetry to CloudWatch Omni - Amazon CloudWatch
- Cross-account cross-Region log centralization - Amazon CloudWatch Logs
- AWS managed policies for CloudWatch Omni - Amazon CloudWatch
- CloudWatch Omni pricing
- [アップデート] Amazon CloudWatch Omni が一般提供開始されました!
- マルチアカウントの通信量と経路を監視アカウントで見る4つの方法を比べてみた(VPC フローログ / TGW Flow Logs / Network Flow Monitor / OAM)