マルチアカウントの通信量と経路を監視アカウントで見る4つの方法を比べてみた(VPC フローログ / TGW Flow Logs / Network Flow Monitor / OAM)

はじめに
こんにちは!ひろたこです。
AWS Organizations でアカウントが増えてくると、「どのアカウントからどのアカウントへ、どれだけ通信が流れているのか」が見えにくくなっていきませんか?フローログは各アカウントで取っているのに、見に行くのは結局それぞれのアカウントのコンソール…というのは、マルチアカウントあるあるだと思います。
DevelopersIO にも手段ごとの記事はそろっているのですが、目的から手段を選ぶための比較は見当たりませんでした。そこで今回は、アカウントをまたぐ通信の量と経路を監視アカウント1つに集約する手段を4つ、同じ構成・同じ通信で作って比べてみました!
この記事では、手段ごとに「何が見えて、何が見えなかったか」を確認し、集約して使うならどの組み合わせがよいかをまとめています。
先に結論を書くと、アカウント間の量と経路は AWS Transit Gateway(TGW)の Flow Logs、異常にすぐ気づくのは OAM で見る TGW のメトリクス、という組み合わせがおすすめです。
比べた4つの手段
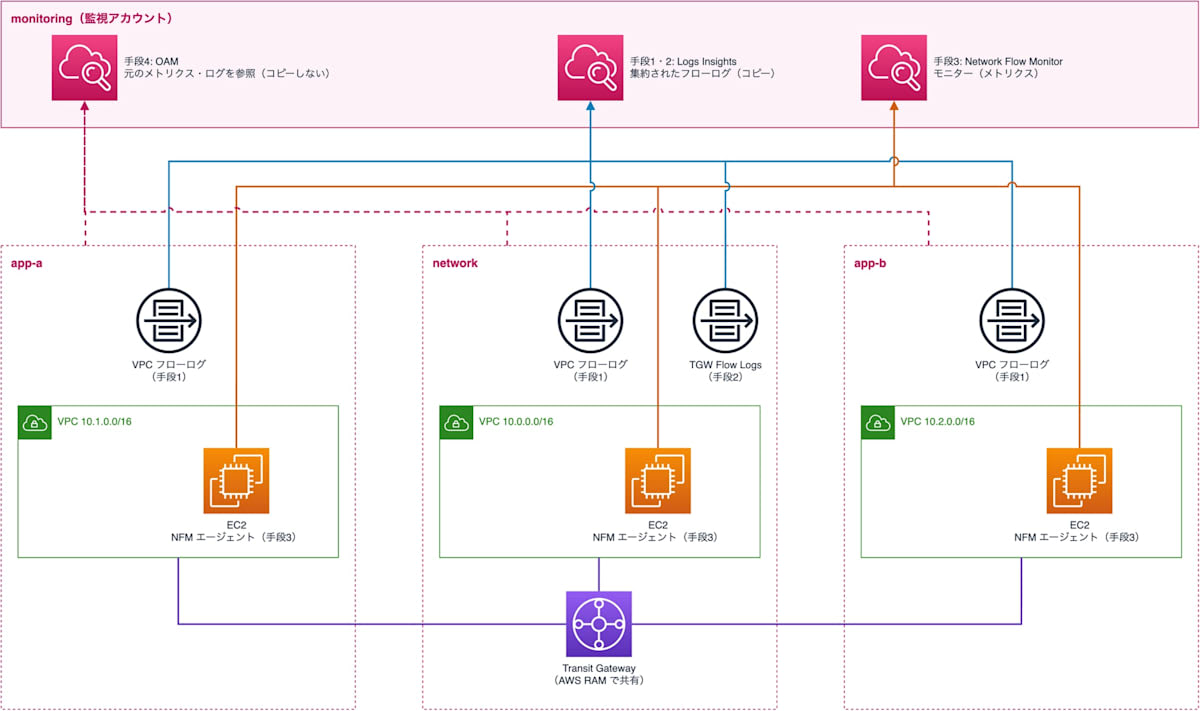
以下が、今回比べた4手段を「監視アカウント(monitoring)に何が届くか」で整理した結果です。
| 手段 | しくみ | monitoring に届くもの |
|---|---|---|
| 1. VPC フローログ × ログ集約ルール | 各アカウントの VPC フローログを、CloudWatch Logs のログ集約ルールで monitoring にコピー | ログのコピー |
| 2. TGW Flow Logs × ログ集約ルール | TGW を持つアカウントの TGW Flow Logs を、同じくログ集約ルールで monitoring にコピー | ログのコピー |
| 3. Network Flow Monitor(NFM) | 各インスタンスのエージェントが送ったフロー情報を、monitoring のモニターで集計 | メトリクス |
| 4. CloudWatch クロスアカウントオブザーバビリティ(Observability Access Manager、以下 OAM) | 各アカウントから monitoring にリンクを張り、元のメトリクス・ログを参照 | 参照(コピーしない) |
図にすると、データの流れはこうなります。
比べ方はシンプルで、転送量が分かっている通信を流して、各手段に何がどう出るかを見ました。
- S1: app-a → app-b に iperf3 で 500 MiB(ペイロード 524,288,000 bytes)
- S2: app-a → network に iperf3 で 100 MiB(104,857,600 bytes)
- S3: app-b → app-a に HTTP GET を5秒ごとに60回
リージョンは東京です。2026年9月に GA した Amazon CloudWatch Omni もマルチアカウントのテレメトリをまとめて見られるサービスですが、提供リージョンが US East (N. Virginia) / US West (Oregon) / Europe (Ireland) のため、今回は対象外にしました。
前提:CloudWatch の信頼されたアクセスと委任管理者
手段1〜3は、Organizations で CloudWatch の信頼されたアクセスを有効にし、monitoring を委任管理者に登録しておく必要があります。この1つの設定で、ログ集約ルール(手段1・2)と NFM のマルチアカウント(手段3)がまとめて使えるようになります。 手段4の OAM には不要です。
設定前は、ログ集約ルールの一覧を取るだけで UnauthorizedException になりました。
$ aws observabilityadmin list-centralization-rules-for-organization --region ap-northeast-1 --profile org-management
aws: [ERROR]: An error occurred (UnauthorizedException) when calling the ListCentralizationRulesForOrganization operation: Unauthorized
管理アカウントの CloudWatch → 設定 → Organization タブから有効化すると、サービスリンクロールも各アカウントに自動で作られます。続けて、同じ画面の「委任管理者を登録」から monitoring を登録します。
手段ごとの結果
手段1: VPC フローログ × ログ集約ルール
各アカウントで VPC フローログを自アカウントの CloudWatch Logs に出し、monitoring(委任管理者)でログ集約ルールを1つ作ります。集約先のロググループはルールが自動で作ってくれます。
ログ集約ルールの Terraform(抜粋)
resource "aws_observabilityadmin_centralization_rule_for_organization" "m1" {
  provider  = aws.monitoring
  rule_name = "nw-m1-vpc-flow-logs"

  rule {
    destination {
      account = var.account_ids.monitoring
      region  = var.region
    }

    source {
      regions = [var.region]
      scope   = "AccountId IN ('${var.account_ids.network}', '${var.account_ids.app_a}', '${var.account_ids.app_b}')"

      source_logs_configuration {
        encrypted_log_group_strategy = "SKIP"
        log_group_selection_criteria = "LogGroupName LIKE '/nw-monitoring/vpc-flow-logs%'"
      }
    }
  }
}
見るときは、monitoring の CloudWatch Logs Insights で集約先のロググループを1つだけ選びます。3アカウント分が1つに入っていて、送信元アカウントは @aws.account で見分けられます。
filter srcAddr = "10.1.1.114" and dstAddr = "10.2.1.109" and dstPort = 5201
| stats sum(bytes) as total_bytes, sum(packets) as total_packets, count(*) as records
    by @aws.account, interfaceId, flowDirection, instanceId, trafficPath
| @aws.account | flowDirection | total_bytes | total_packets |
|---|---|---|---|
<APP_A> |
egress | 528,239,531 | 62,176 |
<APP_B> |
ingress | 527,517,031 | 62,091 |
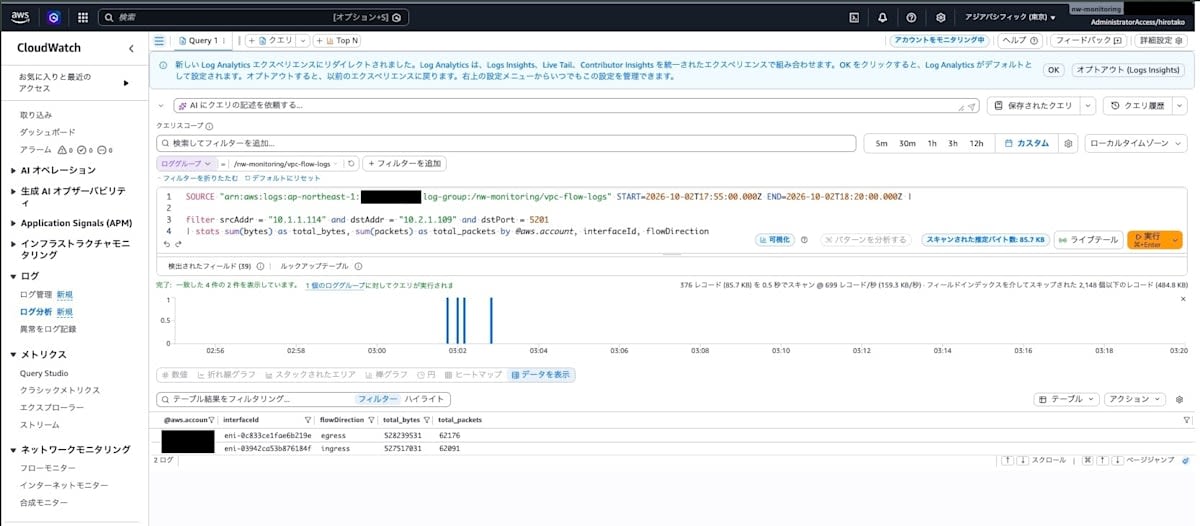
同じ流れが送信側(egress)と受信側(ingress)で2回記録されるので、合計を出すときは片方に絞らないと2倍になります。送信側が 722,500 bytes 多いのは、途中で落ちて再送された85パケット分です(iperf3 の再送回数も85)。
ENI(Elastic Network Interface)・インスタンス・向きまで分かる一方で、「どのアカウントへ」は宛先 IP から自分で引く必要があります。通信から monitoring で見えるまでは1分ほどでした。
手段2: TGW Flow Logs × ログ集約ルール
TGW を持つ network アカウントで TGW Flow Logs を CloudWatch Logs に出し、手段1と同じログ集約ルールで monitoring にコピーします。作るのは TGW 1つ分なので、手段1よりシンプルです。
TGW Flow Logs には送信元・宛先の アカウント ID がフィールドとして入っているので、アカウント間の通信量はクエリ1本で出せます。
filter flowDirection = "ingress"
| stats sum(bytes) as total_bytes, sum(packets) as total_packets, count(*) as records
    by tgwSrcVpcAccountId, tgwDstVpcAccountId
| sort total_bytes desc
| tgwSrcVpcAccountId | tgwDstVpcAccountId | total_bytes | 中身 |
|---|---|---|---|
<APP_A> |
<APP_B> |
528,076,707 | S1 + S3 の応答 |
<APP_A> |
<NETWORK> |
105,504,673 | S2 |
<APP_B> |
<APP_A> |
625,682 | S1 の ACK + S3 のリクエスト |
<NETWORK> |
<APP_A> |
70,119 | S2 の ACK |
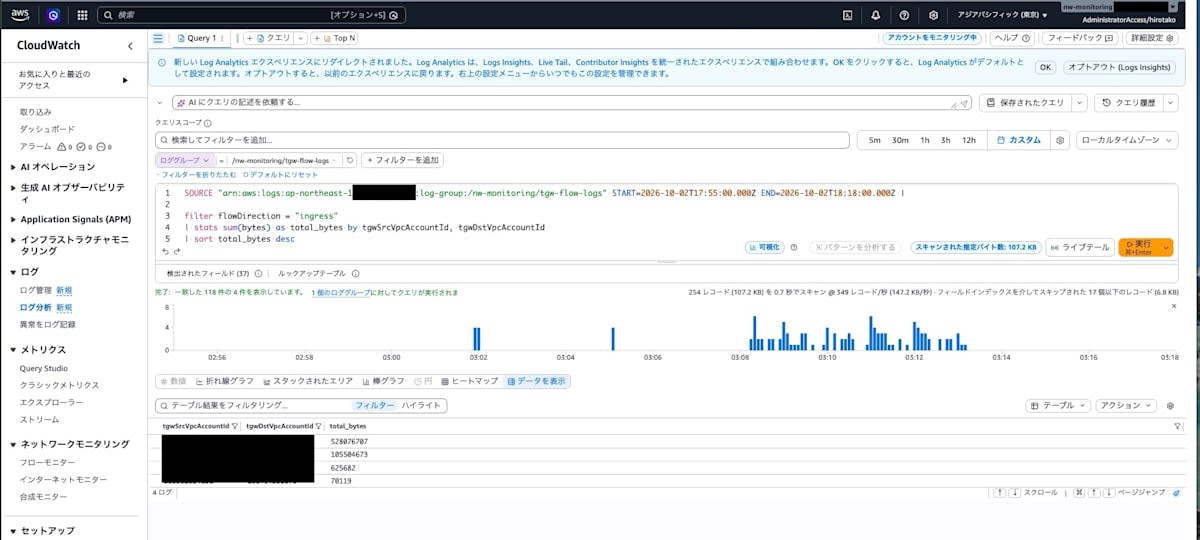
S1 の量は、データ 527,515,685 + 制御接続 1,346 = 527,517,031 bytes で、VPC フローログの受信側と1 byte まで一致しました。こちらも同じ流れが ingress / egress の2回記録されるので、flowDirection = "ingress" に絞っています。
ひとつ注意したいのが反映の遅さです。最初のレコードは1分ほどで見えたものの、S1 の全量がそろうまでには数分かかりました。量を確定させるなら、少し時間を置いてから集計するのが安全です。
IP とアカウントの対応表を持たずに「どこからどこへ何 bytes」が出るので、今回の目的には一番合っていると感じました。
手段3: NFM
monitoring(委任管理者)でスコープに4アカウントを追加してモニターを作り、各インスタンスにはエージェント(今回は 1.1.8)を入れ、インスタンスロールに送信用の管理ポリシー CloudWatchNetworkFlowMonitorAgentPublishPolicy を付けます。
見るのは、monitoring の CloudWatch → ネットワークモニタリング → フローモニターの、ワークロードインサイトとモニターの画面です。メトリクスは AWS/NetworkFlowMonitor に出ます。
ここは想定と違う結果になりました。S1(app-a → app-b の 500 MiB)が出てきませんでした。 S2(app-a → network)は 104,858,464 bytes で出ています。
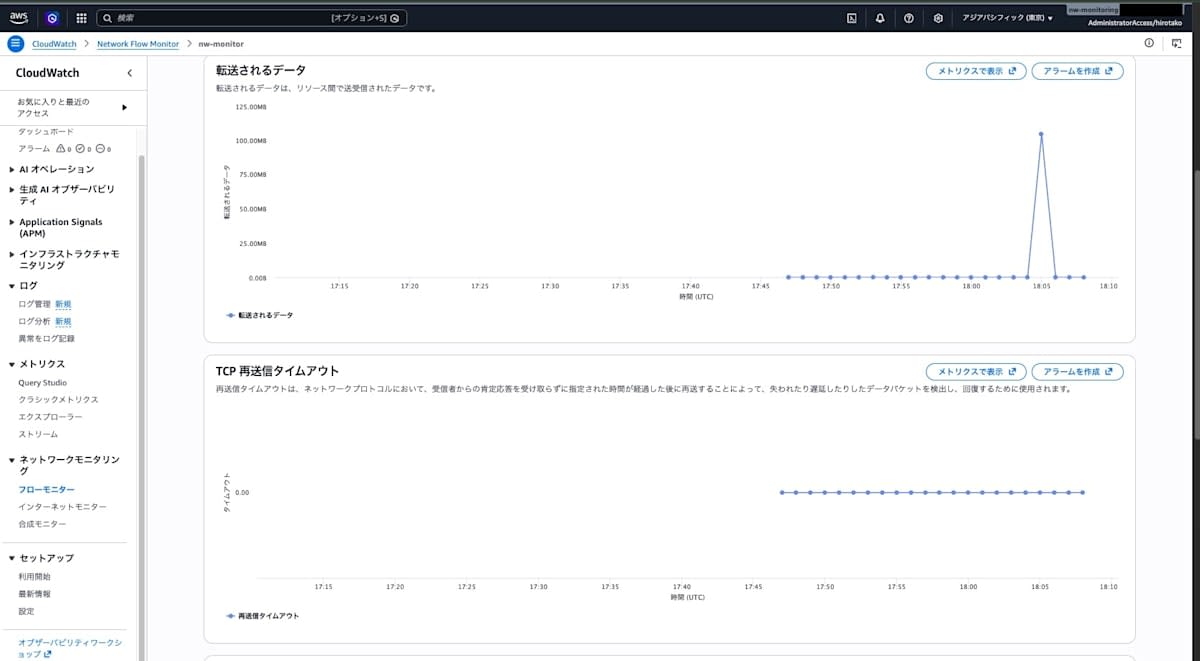
切り分けのため、向きを変えながら 50 MiB の通信を追加で流した結果がこちらです。
| 流れ | 片側が network(TGW の所有アカウント)か | NFM に出たか |
|---|---|---|
| app-a → app-b(S1・追加分) | いいえ | 出ない |
| app-b ⇔ app-a(S3) | いいえ | 出ない |
| app-a → network(S2) | はい | 出る |
| network → app-a | はい | 出る |
| app-b → network | はい | 出る |
この構成では、TGW を共有されている側のアカウント同士(app-a ⇔ app-b)の通信が出ませんでした。エージェントは全台で送信に成功していて、インターネット向けの通信は app-a / app-b のものも出ています。
原因は分かっていませんが、出てきたのが TGW を所有する network 側の行だけだったので、共有された側のフローは経路の照合ができていない可能性があるとみています。公式ドキュメントにも、Amazon EKS の共有サブネットについて「メンバーアカウントのモニターは、所有していないサブネットのフローを照合できない」という似た制約が書かれていました(Initialize Network Flow Monitor for multi-account monitoring)。
NFM は RTT・再送・タイムアウトといった通信の品質を見られるのが強みで、そこは他の3手段にはありません。今回の「アカウント間の量と経路」という用途と、共有 TGW の構成には合いませんでしたが、品質を見たいときに使うなら、まず自分の構成で対象の流れが出るかを確かめるのがよさそうです。
手段4: OAM
monitoring にシンクを作り、各アカウントからリンクを張るだけです。信頼されたアクセスも委任管理者も要らず、シンクポリシーの aws:PrincipalOrgID で組織に絞れます。4つの中で一番手軽でした。
見るのは、monitoring の CloudWatch → メトリクスです。アカウントのラベル列が増えて、各アカウントのメトリクスをそのまま見られます。
TGW のアタッチメント別の BytesIn では、S1 が 527,517,031 bytes(1分値)と出ました。フローログ系と同じ値です。ただし、メトリクスなので宛先の内訳はありません。分かるのは「app-a の VPC から TGW に入った量」までです。
TGW のメトリクスは、TGW の所有アカウントとアタッチメントの所有アカウントの両方に出るので、OAM では同じ値が2系統見えます。Amazon EC2 の NetworkOut は基本モニタリングだと5分粒度で、宛先も分かりません。
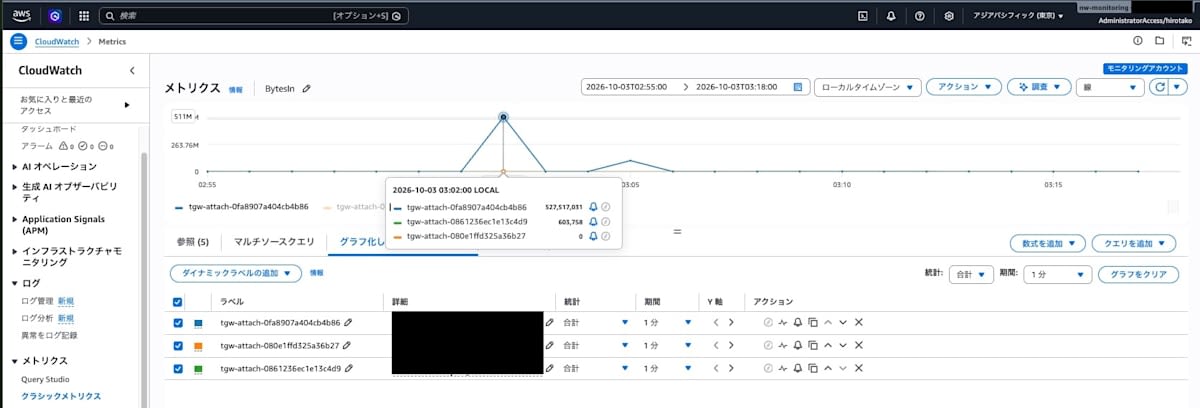
異常時にどれで気づけるか
最後に、network アカウントの TGW ルートテーブルで app-b アタッチメントの伝播を無効にし(TGW から 10.2.0.0/16 が消えます)、app-a → app-b を約6分間通らなくしてみました。VPC 側のルートを外すとパケットが TGW に届く前に落ちてしまうので、TGW 側で外しています。
| 手段 | 気づけたか | 分かったこと | 見えるまで |
|---|---|---|---|
| 1. VPC フローログ | △ | REJECT は出ない。送信側の egress はあるのに受信側の ingress がない、という「片側だけのレコード」から推測するしかない |
― |
| 2. TGW Flow Logs | ◯ | packetsLostNoRoute に、送信元アカウント・宛先 IP・入口のアタッチメントが出る |
数分 |
| 3. NFM | × | この構成では app-a ⇔ app-b の流れ自体が出ていないため、変化なし | ― |
| 4. OAM(TGW のメトリクス) | ◯ | 入口のアタッチメントの PacketDropCountNoRoute が増える(宛先は分からない) |
1〜2分 |
TGW Flow Logs で落ちた通信を出すクエリです。
filter packetsLostNoRoute > 0
| stats sum(packetsLostNoRoute) as noroute, count(*) as records by bin(1m) as t, tgwSrcVpcAccountId, dstAddr, tgwAttachmentId
| sort t asc
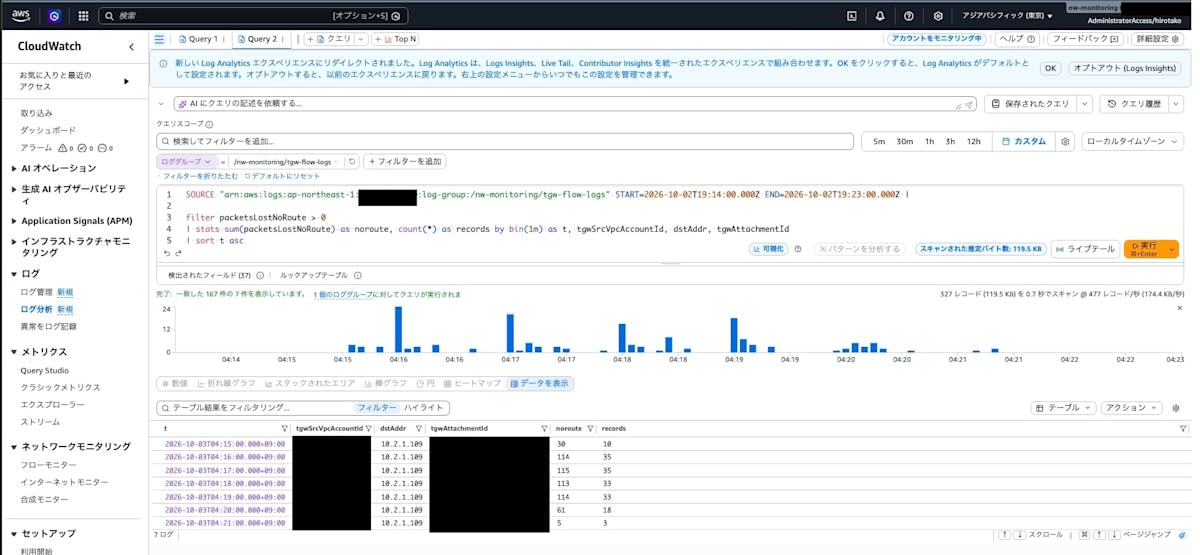
比較表
| 観点 | 1. VPC フローログ | 2. TGW Flow Logs | 3. NFM | 4. OAM |
|---|---|---|---|---|
| monitoring に届くもの | ログのコピー | ログのコピー | メトリクス | 参照 |
| 経路の粒度 | ENI・インスタンス・IP・ポート | 送信元・宛先のアカウント・VPC・アタッチメント・IP・ポート | IP・インスタンス(今回は共有 TGW の利用側同士が出ない) | アタッチメント単位(宛先なし) |
| S1(500 MiB)の値 | 受信側 527,517,031 | 527,517,031 | 出ない | 527,517,031(1分値) |
| 見えるまで | 1分ほど | 全量そろうまで数分 | 1〜2分 | 1〜2分 |
| 異常時 | △ | ◯ | × | ◯ |
| 品質(RTT・再送) | なし | なし | あり | なし |
| 前提の設定 | 信頼されたアクセス+委任管理者 | 同左 | 同左+エージェント | 不要(シンクとリンクのみ) |
| コスト | フローログの取り込み+集約先の保存 | 同左(TGW 1つ分) | 監視対象リソース × 時間 | 参照は無料 |
見えるまでの時間は、今回の観測から読み取った目安です。
集約して使うならこの構成
今回の結果から、アカウント間の通信を監視アカウントに集約するなら、次の組み合わせがよいと考えています。
| 役割 | 使う手段 | 理由 |
|---|---|---|
| 量と経路を把握する | TGW Flow Logs × ログ集約ルール | クエリ1本でアカウント間の通信量が出る。設定も TGW 1つ分で済む |
| 異常に気づく(アラーム) | OAM で TGW のメトリクス | 1〜2分で見える。シンクとリンクだけで始められる |
| 必要なときだけ深掘り | VPC フローログ × ログ集約ルール | ENI・インスタンス単位まで追える。取り込み量が多いので、対象を絞って使う |
| 通信の品質を見る | NFM | 品質の指標は NFM だけ。共有 TGW の構成では、対象の流れが出るかを先に確認する |
組み合わせるときは、次の2点に気をつけてください。
- OAM で共有するのはメトリクスだけにする。 ログ集約ルールと OAM の両方でロググループを共有すると、monitoring から同じログが2系統見えて、二重に数えてしまいます
- 集約先のロググループに保持期間を設定する。 ログ集約ルールは送信元の保持設定を引き継ぎません
ハマったポイント
ログ集約ルールと OAM の併用で、二重に数えてしまった
monitoring の Logs Insights で、同じ名前のロググループを4つ選んで S1 のクエリを実行したら、コピー1つだけを選んだときのちょうど2倍になりました。4つの内訳は、ログ集約ルールのコピー1つと、OAM で見えている元のロググループ3つです。
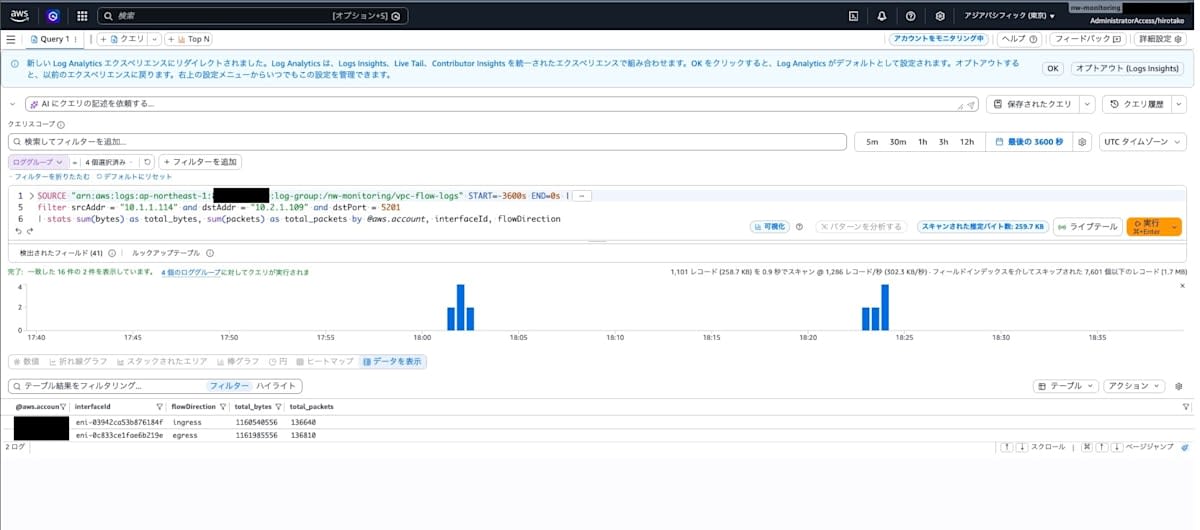
どちらも @aws.account は元のアカウント ID で出るので、結果の表を見ても重複に気づけません。ロググループは「Monitoring account」のコピー1つだけを選ぶか、OAM ではロググループを共有しないようにしましょう。ロググループを1つだけ選んでいたときは問題なく、全部選んだときに初めて気づきました。
集約先のロググループが「失効しない」のまま残る
ログ集約ルールが monitoring に作ったロググループは、保持期間が「失効しない」になっていました(元は7日)。しかも Terraform の管理外なので、terraform destroy のあとも集約先のロググループ2つだけが残っていました。保持期間は monitoring 側で設定し、撤収のときは集約先も消す、を手順に入れておくと安心です。
まとめ
マルチアカウントの通信量と経路を監視アカウントで見る4つの手段を、同じ構成・同じ通信で比べてみました!
- アカウント間の量と経路は、TGW Flow Logs がクエリ1本で出せて一番の近道。ただし全量がそろうまで数分かかる
- 異常に速く気づくなら、OAM で見る TGW のメトリクス
- NFM は、今回の共有 TGW の構成では利用側アカウント同士の通信が出なかった
個人的に一番の収穫は、TGW Flow Logs で「どのアカウントからどのアカウントへ何 bytes」がそのまま出たことでした。手段を1つに決めるより、量と経路は TGW Flow Logs、気づきは OAM のメトリクス、と役割で組み合わせるのがマルチアカウントでは扱いやすいと感じています。
この記事が、マルチアカウントのネットワーク監視の手段選びで迷っている方の助けになれば幸いです。最後まで読んでいただき、誠にありがとうございました。
参考記事
- VPC フローログをマルチアカウントで S3 に集約する
- Transit Gateway Flow Logs を Athena で分析する
- CloudWatch Network Flow Monitor の Organizations 統合
- CloudWatch クロスアカウントオブザーバビリティ(OAM)でメトリクスを集約する
- Initialize Network Flow Monitor for multi-account monitoring - Amazon CloudWatch
- Amazon CloudWatch のクロスアカウント・クロスリージョンのログ集約(What's New 2025年9月)
- Introducing VPC Flow Logs for AWS Transit Gateway - AWS Networking & Content Delivery Blog
- Amazon CloudWatch Omni(What's New 2026年9月)