層を 3 回通す 26B の MoE「Inkling 2 Mini」を DGX Spark で動かしてみた

はじめに
こんにちは、クラスメソッド製造ビジネステクノロジー部の森茂です。
Thinking Machines Lab が 11 月 20 日に Inkling 2 Mini を公開しました。26.4B のマルチモーダルモデルで、ライセンスは Apache 2.0 です。モデルカードの対応ハードウェアには「1x NVIDIA DGX Spark」と書いてあり、vLLM には DGX Spark 向けのレシピが用意されています。
気になったのは構造です。24 層のうち中央の 12 層を、同じ重みのまま 3 回通します。配布される重みは約 20GB で、先月測った 120B の Nemotron 3.5 Super VL よりずっと小さく、DGX Spark で普段使っている Qwen3.8-27B と同じくらいです。ただ dense な Qwen3.8-27B に対してこちらは MoE なので、計算に使う重みはずっと少なくなります。モデルカードはこの 2 つを比較対象に挙げているので、手元の同じ課題で並べてみることにしました。
先に結論を書いておくと、レシピは書いたまま動き、262K コンテキストで 380 秒で起動して、単発 37.83 tok/s でした。日本語 10 課題は、思考の強さを low に下げても機械判定 9/9 のままです。一方で、40 個のツールから正しい 1 つを選ぶ課題は 6 問中 1 問しか通らず、tool_choice: required を指定しても呼び出しは 0 件でした。
Super VL を測ったときの記事はこちらです(2026-10-18 時点の記事です)。
この記事では、公開翌日の Inkling 2 Mini を DGX Spark の vLLM で動かした結果を紹介します。レシピがそのまま動くか、速度はどのくらいか、そして日本語・コード・ツール・画像を Qwen3.8-27B と Super VL と同じ課題で測ります。
Inkling 2 Mini の素性
まず一次情報を押さえます。数字はモデルカードと config.json、chat_template.jinja から取っています。
| 項目 | 値 |
|---|---|
| 提供元 | Thinking Machines Lab(2026-11-20 公開) |
| パラメータ | 26.4B(アクティブ 3.4B) |
| アーキテクチャ | 24 層の decoder-only、MoE 層あたり 128 expert 中 8 を使用、画像は 23 層の ViT |
| ループ | 中央の 12 層を同じ重みで 3 回通す。1 トークンあたり 48 層分を適用 |
| 量子化 | NVFP4 と MXFP8 の混在(配布される重みはこの 1 種類) |
| コンテキスト | 1,048,576 トークン |
| 入力 | テキスト、画像 |
| 対応言語 | 英語と多言語一般 |
| ライセンス | Apache 2.0(別に Model Acceptable Use Policy がある) |
| 推奨サンプリング | 専用の節は無い。generation_config.json は temperature 1.0 |
| 配布 | 本体 19.5GB と、投機デコード用ドラフト DSpark の mtp.safetensors 636MB |
| 想定する配備先 | 1× DGX Spark、32GB 以上の Apple silicon、32GB 以上の VRAM を持つ GPU |
モデルカードは自分のことを looped transformer と呼んでいます。MoE なので、1 トークンごとに使う重み(アクティブパラメータ)は 3.4B です。ただし中央の 12 層を 3 回通すので、カードの説明では 1 回のループごとに実効で約 1.0B 増え、3 回で実効 5.4B になります。重みを増やさずに計算の深さだけ足す作りです。
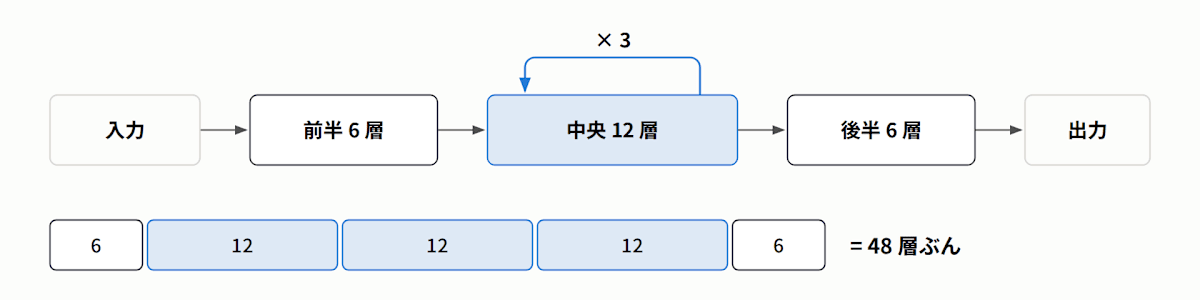
上は 1 トークンを作る流れで、24 層のうち中央の 12 層(青)だけを同じ重みのまま 3 回通す。前半と後半の 6 層は 1 回だけ通る。下はループを展開した長さで、重みは 24 層ぶんのまま、通る層は 6 + 12 × 3 + 6 の 48 層ぶんになる。
思考の強さ(reasoning effort)は reasoning_effort で指定します。名前でも 0.0〜0.99 の数値でも渡せて、テンプレートの中では数値に直されます。
| 名前 | 数値 | 補足 |
|---|---|---|
| none | 0.0 | |
| minimal | 0.1 | |
| low | 0.2 | この記事の弱い側 |
| medium | 0.7 | |
| high | 0.9 | 未指定のときの既定値 |
| xhigh、max | 0.99 |
モデルカードには「reasoning effort を最小にしても、思考は止まりきらない」という注記があります。思考を切るスイッチは無く、量を減らすだけのモデルです。
言語については、カードの制限事項に「英語以外では出力の品質が下がることがある。中国語のテストでは、切り詰めたような言い回しと言語の混在を観測した」とあります。日本語がどう出るかは、手元で見ることにします。
動かすまで
vLLM のレシピは「vLLM 0.35.0 以上が必要(未リリース)」と書いていて、対応がリリースに入るまでは専用イメージ vllm/vllm-openai:inkling-2-mini を使うよう案内しています。11 月 21 日の時点で、最新リリースの v0.34.0 にはこのモデルの定義がまだ入っていません。専用イメージには arm64 版があり、中の vLLM は 0.1.dev25855+g7cb5dae22 でした。
重みを hf download で手元に落とし、レシピの DGX Spark 版の引数をそのまま渡します。
docker run -d --name inkling --gpus all --ipc=host \
  -p 127.0.0.1:8000:8000 \
  -v "$MODEL_DIR":/model:ro \
  vllm/vllm-openai:inkling-2-mini /model \
  --served-model-name inkling-2-mini \
  --tensor-parallel-size 1 \
  --max-model-len 262144 \
  --reasoning-parser inkling \
  --enable-auto-tool-choice \
  --tool-call-parser inkling \
  --speculative-config '{"method":"dspark","num_speculative_tokens":7,"draft_sample_method":"probabilistic"}'
レシピと違うのは、重みを手元のディレクトリから読ませている点と、--served-model-name を足した点、レシピの docker 行にある --privileged を外した点です。--privileged が無くても起動しました。
コンテキスト長はモデルの上限の 1M ではなく、262,144 に抑えてあります。レシピには、DGX Spark と H100 ではメモリに収めるためにこの値にしていると説明があります。
結果は、何も変えずに起動しました。
| 項目 | 値 |
|---|---|
| 起動 | 380 秒(重みの読み込み 102 秒) |
| KV キャッシュ | 1,550,098 トークン分。262,144 のリクエストを 5.91 本抱えられる計算 |
| ホストの空き | 起動前 113.2 GiB、起動後 9.1 GiB |
| 測定中の温度 | GPU の最高 61 °C、/sys/class/thermal の一番熱いゾーンで 72.7 °C |
重みは 20GB しか無いのに、起動後の空きは 9.1 GiB まで減ります。レシピに --gpu-memory-utilization の指定が無く、vLLM が既定の割合でメモリを確保して、残りを KV キャッシュに回すためです。ほかのプロセスと同居させるなら、--gpu-memory-utilization を自分で下げる必要があります。
投機デコードの DSpark は、本体と同じリポジトリに入っている mtp.safetensors を使います。外付けのドラフトを別に落とす必要はありません。起動ログには Resolved architecture: Inkling2DSparkModel と SpeculativeConfig(method='dspark', model='/model', num_spec_tokens=7) が出ます。もう 1 行、ドラフトは画像の埋め込みを受け取らず、テキストだけで先読みするという警告も出ていました。
測定条件
速度の章の 1 行目は、このレシピ逐語の起動で測りました。それ以外は、過去の測定に寄せた 8 シーケンスの起動です。--max-model-len 131072 --max-num-seqs 8 --max-num-batched-tokens 8192 --gpu-memory-utilization 0.75、投機なし、イメージは同じです。こちらは起動 265 秒、KV キャッシュ 485,332 トークン分で、起動後の空きは 19.0 GiB でした。
サンプリングは generation_config.json の temperature 1.0 で、予算(出力トークンの上限)は 8,192 です。この予算で打ち切られた課題は 1 つもありませんでした。思考の強さは既定の high と、弱い側の low の 2 水準で測っています。
比較対象は、以前に同じ課題で測った Qwen3.8-27B(NVFP4)と Nemotron 3.5 Super VL 120B-A12B(NVFP4)です。どちらも DGX Spark の vLLM で測った値ですが、起動の設定は揃っていません。Qwen3.8-27B は思考の強さが xhigh、コンテキスト長が 262,144、--gpu-memory-utilization が 0.85 で、Super VL は KV キャッシュが fp8 です。Inkling 2 Mini の側だけを過去の測定に寄せた形なので、表はこの違いを含んだ実測として並べています。
速度
強制長 256 トークン、temperature 0 で 3 回測った中央値です。
| 構成 | 単発 tok/s | TTFT(秒) |
|---|---|---|
| レシピ逐語(262,144、DSpark で先読み 7 トークン) | 37.83 | 0.212 |
| 8 シーケンスの起動(131,072、投機なし) | 39.43 | 0.164 |
レシピ逐語で単発 37.83 tok/s です。3 回の値は 37.63〜37.87 で、ほとんど揺れません。
投機なしの 8 シーケンスの起動は 39.43 tok/s でした。この 2 行はコンテキスト長とメモリの設定が違うので、差は DSpark の効果としては読まないでください。
受理率(先読みした候補のうち本体が採用した割合)は /metrics の差分で読めます。この速度測定の区間では、先読み 2,541 トークンのうち採用は 402 トークンで、16% でした。起動直後の確認で日本語の質問とツール呼び出しを流した区間では、3,549 トークン中 935 トークンで 26% でした。レシピにも、受理率はプロンプトと温度に依存すると書いてあります。
同時実行数を変えた側は、8 シーケンスの起動で測っています。単発は 3 回の中央値、2 本以上はそれぞれ 1 回の測定です。
| 同時実行 | 1 本あたり tok/s | 合計 tok/s | TTFT(秒) |
|---|---|---|---|
| 1 | 39.43 | 39.43 | 0.164 |
| 2 | 31.85 | 61.7 | 0.247 |
| 4 | 25.99 | 86.92 | 1.928 |
| 8 | 27.27 | 133.35 | 5.968 |
8 本同時で合計 133.35 tok/s です。気になるのは最初の応答までの時間(TTFT)で、4 本で 1.9 秒、8 本で 6.0 秒まで延びます。数人で共有して対話に使うなら、合計の速さより先にここが効いてきそうです。
同じ測り方をした 2 つと並べます。
| モデル | 単発 tok/s | 8 並列の合計 tok/s | 1 本あたり |
|---|---|---|---|
| Inkling 2 Mini | 39.43 | 133.35 | 27.27 |
| Qwen3.8-27B | 12.37 | 85.86 | 10.93 |
| Nemotron 3.5 Super VL 120B-A12B | 19.18 | 79.32 | 10.12 |
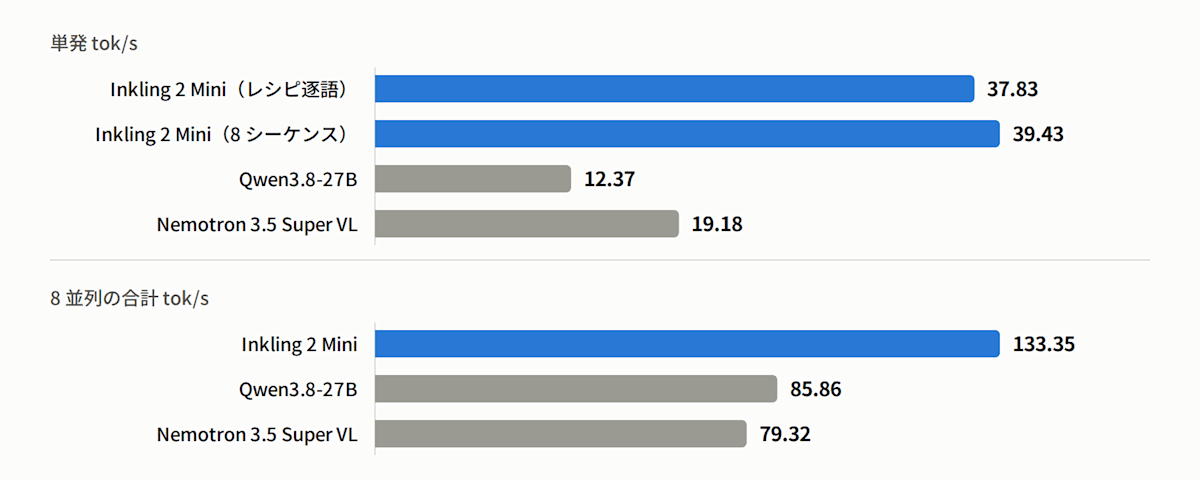
上は単発(強制長 256 トークン、3 回の中央値)、下は 8 並列の合計(1 回の測定)で、横軸の縮尺は上下で違う。レシピ逐語はコンテキスト長 262,144 で DSpark あり、8 シーケンスは 131,072 で投機なし。灰色の 2 モデルは以前に同じ課題で測った投機なしの値で、コンテキスト長や KV キャッシュの設定が揃っていない。
3 つとも投機なしの値です。Qwen3.8-27B も内蔵 MTP を切った行で揃えています。単発は Qwen3.8-27B の 3.2 倍、Super VL の 2.1 倍でした。起動の設定が揃っていないので、構成の差を含んだ比です。それでも、同じ層を 3 回通すモデルが単発 40 tok/s 近くで動くのは、思っていたより速い結果でした。
日本語
日本語 10 課題を投げました。判定は、文字数や必須語の有無、JSON がパースできるか、といった機械で確かめられる条件で採点しています。
| 課題 | Inkling 2 Mini(high) | 消費トークン | 所要(秒) |
|---|---|---|---|
| 50 字以内で答える | ○(37 字) | 753 | 21.2 |
| 自由記述 | ○ | 290 | 9.1 |
| コード生成 | ○ | 165 | 5.9 |
| 数値推論 | ○ | 430 | 12.8 |
| 語彙制約 | ○(166 字) | 808 | 21.2 |
| JSON 整形 | ○ | 346 | 12.5 |
| 固有名詞つき要約 | ○(6/6 語) | 7,737 | 212.3 |
| 図表の書き起こし | ○(5/5) | 2,719 | 74.2 |
| 敬語への言い換え | ○(5/5) | 703 | 21.0 |
| 長文からの抽出 | ○(4/4) | 540 | 23.0 |
| 機械判定の合計 | 9/9 | 14,491 | 413.1 |
自由記述は機械で採点できないので 9/9 の分母から外しています。消費トークンと所要は 10 課題すべての合計です。
機械判定は 9/9 です。同じ課題、同じ出力トークンの予算 8,192 で、Qwen3.8-27B の xhigh と Super VL の high はどちらも 8/9 でした。
| モデル(思考の強さ) | 機械判定 | 消費トークン合計 | 10 課題の所要 |
|---|---|---|---|
| Inkling 2 Mini(high) | 9/9 | 14,491 | 413.1 秒 |
| Inkling 2 Mini(low) | 9/9 | 4,095 | 110.2 秒 |
| Qwen3.8-27B(xhigh) | 8/9 | 26,205 | 2,168.6 秒 |
| Qwen3.8-27B(low) | 8/9 | 5,083 | 419.7 秒 |
| Nemotron 3.5 Super VL 120B-A12B(high) | 8/9 | 13,932 | 736.5 秒 |
比較の行には注記が要ります。Qwen3.8-27B の xhigh と Super VL の high が落とした 1 問は、出力トークンの予算 8,192 に達して本文が出なかったものです。Super VL は思考を medium にした行で 9/9 を出しています。この表だけで日本語の優劣は判断できません。言えるのは、Inkling 2 Mini は既定の high のまま、同じ 8,192 の中で 10 課題すべてに本文を返した、というところまでです。
その予算の中で一番きわどかったのが固有名詞つき要約で、7,737 トークンを使っています。11,858 字考えてから、6 語すべてを残した 150 字の要約を返しました。Nemotron 3.5 の 3 モデルが high で揃って枠を使い切った課題で、Inkling 2 Mini も上限まで 455 トークンしか残っていません。
思考はどの課題でも英語でした。日本語の質問を英語で読み解いて、最後に日本語の本文を書きます。自由記述はリモートワークのメリットとデメリットを 2 つずつ番号付きで返していて、目で読んでも不自然な言い回しや言語の混在はありませんでした。
コードを書かせる
日本語の仕様書からゼロで書かせる 5 問と、バグの入ったミニリポジトリを修正させる課題の 2 本立てです。採点はこちらで pytest を回して判定し、モデルの自己申告は使いません。
仕様からゼロで書く
| 問題 | Inkling 2 Mini | 所要(秒) | Qwen3.8-27B | Super VL |
|---|---|---|---|---|
| slugify | ○ 11/11 | 20.8 | ○ 11/11 | ○ 11/11 |
| parse_duration | ○ 16/16 | 40.4 | ○ 16/16 | ○ 16/16 |
| merge_intervals | ○ 8/8 | 17.4 | ○ 8/8 | ○ 8/8 |
| group_by_month | ○ 6/6 | 14.2 | ○ 6/6 | ○ 6/6 |
| top_k_frequent | ○ 8/8 | 15.6 | ○ 8/8 | ○ 8/8 |
| 合計 | 5/5 | 5/5 | 5/5 |
5 問 49 テスト全通過で、3 つとも同じ結果です。この課題では差がつきませんでした。Inkling 2 Mini は一番長い parse_duration でも 40 秒で返しています。
既存のバグを直す
12 個のテストのうち 5 個が失敗するミニリポジトリを渡して、ファイル読み書きのツールだけで直させる課題です。
| モデル | 修正 | ターン数 | ツール呼び出し | 所要(秒) |
|---|---|---|---|---|
| Inkling 2 Mini | 5/5 | 8 | 14 | 60.0 |
| Qwen3.8-27B | 5/5 | 5 | 11 | 119.4 |
| Super VL | 5/5 | 6 | 14 | 99.7 |
3 つとも 12 テスト全通過まで持っていきます。Inkling 2 Mini はターン数が 8 と一番多いのですが、所要は 60.0 秒で一番短く、壊れた呼び出し(パースできない出力)は 0 件でした。1 ターンで複数のツールをまとめて呼ぶ場面が多く、テストの実行とファイルの読み込みを 1 メッセージに 2〜3 件ずつ載せています。
モデルカードは、コードのデバッグで思考が長いループにはまることがあると注意しています。この課題では 8 ターンで終わり、ループは起きませんでした。
ツールとして使えるか
エージェントの部品として使えるかを見ます。Inkling 2 Mini のツール呼び出しは独自の形式で、vLLM 側は --tool-call-parser inkling が OpenAI 互換の JSON に直します。
1 つ気になっていたのが引数の扱いです。このモデルのテンプレートは、過去のツール呼び出しの引数が JSON 文字列のままだと例外を出します。OpenAI 互換の API は引数を文字列で返すので、返ってきた呼び出しをそのまま履歴に積むと落ちるのでは、という懸念がありました。実際には、文字列のまま送り返しても往復できました。サーバー側で直してくれるので、クライアントは普段どおりに書けます。
基本的な呼び出しは 5 問すべて通りました。擬似ファイルシステムを渡してバグを探させる課題も 4 ターン・6 回のツール呼び出しで解け、壊れた呼び出しは 0 件です。ストリーミングでもツール呼び出しと思考の両方がチャンクに乗ってきます。
required は 0 件で、2 か所の問い合わせは 1 メッセージにまとめる
tool_choice: required は受理されますが、守られませんでした。「こんにちは。天気の話はしないでください。」という入力に天気のツールを 1 つ渡して required を指定すると、82.4 秒かけて 12,393 字考えたあと、ツールを呼ばずに本文で挨拶を返します。エラーにはならず、呼び出しが 0 件のレスポンスが返る形です。Qwen3.8-27B と Super VL は同じ入力で 1 件呼んで止まっていました。required を前提にしたクライアントは、0 件の場合の分岐を持っておく必要があります。
「東京と大阪の天気を教えて」のような 2 か所への問い合わせは、1 つのメッセージに 2 件の呼び出しをまとめて返しました。これは比較の 2 つと同じです。
エージェントの部品としての適性
opencode や Hermes Agent のようなハーネスに載せられるかを、6 つのプローブで見ます。ここで測っているのは各ハーネスが依存する能力であって、ハーネス本体を動かした結果ではない点は先に断っておきます。
| プローブ | high | low |
|---|---|---|
| 40 個のツールから正しく選ぶ | 1/6 | 2/6 |
| 長い system prompt のルール遵守 | ○ | × |
| 定型フォーマットの再現(5 回) | ○ 5/5 | ○ 5/5 |
| 応答言語の固定 | ○(3/3) | ○(3/3) |
| 過剰なツール呼び出しの抑制 | ○(2/2) | ○(2/2) |
| マルチターンの往復 | ○ | ○ |
high は 6 つのうち 5 つを通し、ハーネス別の判定は Hermes Agent が「使える」、opencode と OpenClaw が「厳しい」でした。Super VL の high と同じ判定です。
落としたのは 40 個のツールから選ぶ課題で、high で 6 問中 1 問しか通っていません。外し方に特徴があります。「このファイルに 1 行追記して」に対して追記のツールではなくファイル検索を呼び、「毎朝 9 時に実行するよう設定して」ではディレクトリの一覧と wiki の検索を呼びます。ツールを呼ばないのではなく、目的のツールに行く前に調べ物から始めています。プローブが見ているのは最初の 1 手なので、調べ物を先に挟む動き方がそのまま不正解に数えられています。
この課題は、同じ出力トークンの予算 8,192 では Qwen3.8-27B の xhigh と Super VL の high も 4/6 で不合格でした。ただ Inkling 2 Mini の 1/6 はそれよりさらに低い値です。Super VL は思考を medium にした行と、上限を 16,384 に広げた行で 6/6 を出していました。ツールを 40 個積むハーネスに載せるなら、実地で確かめてからにします。
画像
Inkling 2 Mini は画像も読めるモデルなので、同じ 3 つのプローブを通しました。出力トークンの予算は 4,096、思考は high です。
| プローブ | Inkling 2 Mini | Qwen3.8-27B | Super VL |
|---|---|---|---|
| 保護具の列挙(作業者 2 人の絵) | ○ | ×(判定の偽陽性) | ○ |
| 棒グラフの数値読み取り | ○(4/4) | ○(4/4) | ○(4/4) |
| 点検記録の OCR | ○(CER 0.0) | ○(CER 0.0) | ○(CER 0.0) |
実際に渡した画像と、返ってきた回答を 2 つ並べます。画像はどちらも検証用に描いた合成画像です。
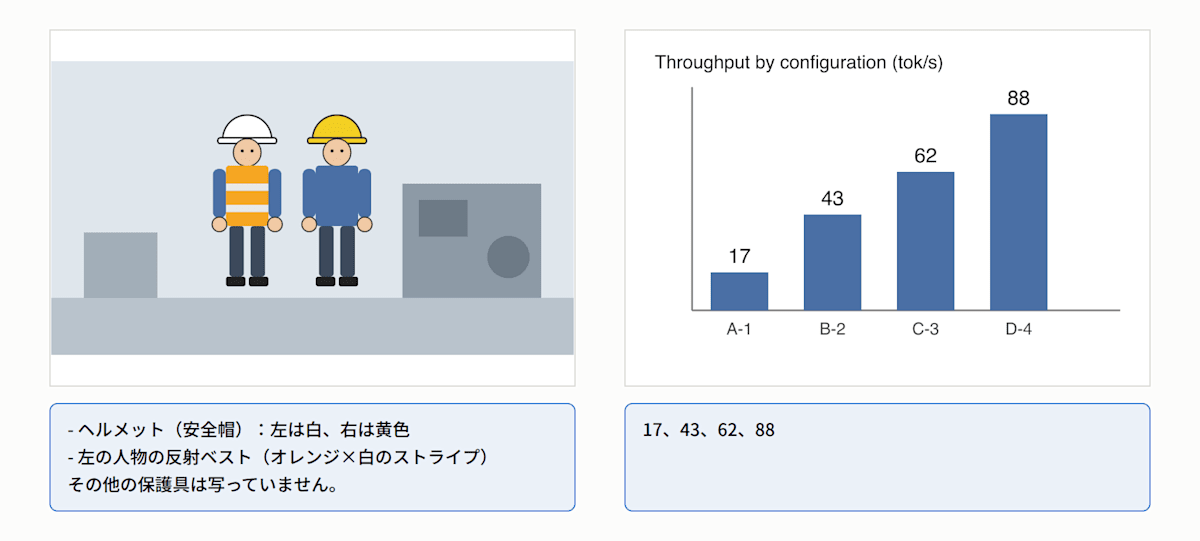
上が渡した画像、下が Inkling 2 Mini(high)の回答。左は「写っている人物が身につけている保護具をすべて挙げ、写っていないものは挙げない」という質問で、ヘルメットと反射ベストを色まで添えて挙げた。右は「各棒に付いている数値を左から順に読み上げる」という質問で、4 つとも読めている。
3 つとも通り、幻覚(写っていない物を挙げる)は 0 件です。保護具の列挙では、ヘルメットを「左は白、右は黄色」、ベストを「オレンジと白のストライプ」と色まで添えたうえで、その他の保護具は写っていないと答えました。Qwen3.8-27B は機械判定こそ × ですが、回答を読むとヘルメットと安全ベストだけを挙げていました。「手袋・ゴーグルなどは特定できないため挙げません」と断った一文を、採点スクリプトが幻覚に数えた偽陽性で、目で見れば 3 モデルとも通っています。なお Qwen3.8-27B の行だけ出力トークンの予算が 2,048 なので、条件は揃っていません。
点検記録の OCR は、日付、設備番号 AZ-4471、7.5 mm/s、判定、点検者を 1 字も落とさずに書き起こしました。所要は 3 つのプローブで 5.7〜30.9 秒です。
思考の量を変えると何が変わるか
reasoning_effort が効いているかは、最初に確かめました。テンプレートは指定を Thinking effort level: 0.9 のような 1 行の system メッセージにして、会話の先頭に差し込みます。none と high で同じ質問を投げると、入力のトークン数が 94 と 96 で変わっていたので、指定はテンプレートまで届いています。
ここで 1 つ引っかかりました。「17 × 23 を計算して」のような 1 手で解ける質問では、none でも high でも同じ 93 トークンが返ります。手数のかかる文章題に替えると、3 回の測定で none が 426〜488 トークン、high が 811〜914 トークンに分かれました。簡単な質問では差が出ないので、効いているかを確かめるときは課題を選ぶ必要があります。カードの注記どおり、none でも思考は 1,046〜1,311 字ぶん残っていました。
high と low を同じ課題で並べます。
| 項目 | high | low |
|---|---|---|
| 日本語の機械判定 | 9/9 | 9/9 |
| 日本語 10 課題の消費トークン | 14,491 | 4,095 |
| 日本語 10 課題の所要 | 413.1 秒 | 110.2 秒 |
| 固有名詞つき要約の消費トークン | 7,737 | 948 |
| 40 個のツールから正しく選ぶ | 1/6 | 2/6 |
| 長い system prompt のルール遵守 | ○ | × |
| 「使える」と判定されたハーネス | Hermes Agent | なし |
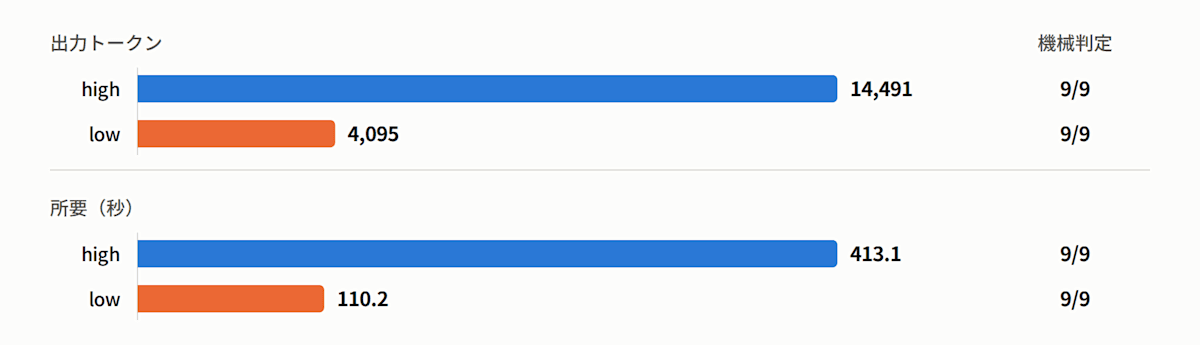
日本語 10 課題を high(既定、0.9)と low(0.2)で流した合計。出力トークンは思考と本文の合計。機械判定(自由記述を除く 9 課題)は high も low も 9/9 のまま、出力トークンは 14,491 から 4,095、所要は 413.1 秒から 110.2 秒になる。出力トークンの予算は 8,192、各 1 回の測定。
日本語の課題では、low に下げても 9/9 のまま、所要が 413.1 秒から 110.2 秒になりました。差が一番大きいのは固有名詞つき要約で、high は 7,737 トークン、low は 948 トークンです。どちらも 6 語すべてを残した要約を返していて、同じ判定のまま出力トークンは 88% 減っています。ただ「150 字以内」の指定に対して high は 150 字ちょうどに詰め、low は 182 字で許容上限の 200 字に助けられていました。長い思考は字数を詰めるのに使われています。
low で落ちたのは、長い system prompt の課題です。日本語で答える、箇条書きを使わない、というルールは守りましたが、「最後に要約の 1 行を置く」を落としました。これで Hermes Agent の判定も「厳しい」に変わります。40 個のツールから選ぶ課題は low のほうが 1 問多く通っていますが、6 問中の 1 問差で、1 回の測定です。差があるとは読んでいません。
今回の課題の範囲では、対話や文章の整形は low で判定が変わらず、長いルールを積んだ system prompt は high でないと 1 つ落としました。system prompt の課題は 1 種類だけなので、low を試すときは自分のルールで確かめるのがよさそうです。思考を切れないモデルなので、待ち時間を縮めたいときに最初に触るのはこの指定になります。
もう 1 つ、再現性の話です。temperature 0 で seed を固定して同じ質問を 2 回投げたところ、出力が 467 トークンと 488 トークンに分かれました(DSpark あり、1 回の観測)。レシピの DSpark は draft_sample_method が probabilistic なので、その影響かもしれません。出力を固定して比較したい用途では、先に確かめておくとよさそうです。
まとめ
Inkling 2 Mini は、vLLM の DGX Spark 向けレシピが書いたまま動き、262,144 のコンテキストで 380 秒で起動しました。単発はレシピ逐語で 37.83 tok/s、8 シーケンスの起動では 39.43 tok/s、8 並列の合計は 133.35 tok/s です。同じ測り方の Qwen3.8-27B は単発 12.37 tok/s、Super VL は 19.18 tok/s でした。
品質は、日本語の機械判定 9/9、コード 5 問 49 テスト全通過、バグ修正 5/5、ツール呼び出し 5/5、画像の 3 プローブ通過です。日本語は思考を low に下げても 9/9 のままで、10 課題の所要は 413.1 秒から 110.2 秒になりました。カードが英語以外での品質低下を注記していたので身構えていましたが、今回の課題では日本語の崩れは見ていません。
弱かった点もはっきりしています。40 個のツールから選ぶ課題は high で 1/6 で、tool_choice: required は受理されるのに呼び出しが 0 件でした。low では長い system prompt のルールを 1 つ落とし、8 並列では最初の応答まで 6.0 秒かかります。なお、DSpark 単体の効果と 1M のコンテキストは今回の範囲に入れていません。
20GB の重みで、DGX Spark 1 台で単発 40 tok/s 近く出て、日本語と画像が通るモデルです。個人的には、まず対話や文章の整形を low で回してみるのが、このモデルの速さを一番活かせる入り口かなと思っています。
参考リンク
- thinkingmachines/Inkling-2-Mini — モデルカード。構造、対応ハードウェア、制限事項はこちら
- Hugging Face ブログの紹介記事
- vLLM のレシピ(Inkling 2 Mini) — DGX Spark 向けの起動コマンドと DSpark の注記
- vLLM の対応 PR(#69028)(2026-11-21 時点で未マージ)
- Model Acceptable Use Policy
- Nemotron 3.5 Super VL 120B-A12B を DGX Spark で測った記事 — 比較に使った課題の説明はこちら
- DGX Spark の Qwen3.8 と GLM-5.3-Flash、4 構成を用途別に比べた記事 — Qwen3.8-27B の比較値はこのときの測定データ(8 並列の 85.86 tok/s は内蔵 MTP を切った行)