[アップデート] Amazon Bedrock の Advanced Prompt Optimization でプロンプト短縮が利用可能になったので試してみた

クラウド事業統括本部の石川です。Amazon Bedrock Advanced Prompt Optimization に、評価スコアを下げずにプロンプトを短くするオプション(プロンプト短縮)が追加されましたので、短縮なしの最適化と並べて試してみました。
Advanced Prompt Optimization(以下 AdvPO)は、プロンプトテンプレートと評価サンプル、評価方法を渡すと、評価結果をもとにプロンプトを書き換えて最適化する Amazon Bedrock の機能です。これまでの最適化は品質だけを基準にしていたため、最適化後のプロンプトが元より長くなることがありました。プロンプトが長くなると入力トークンの料金が増え、最初のトークンが返るまでの時間(TTFT)も長くなる場合があります。
今回のアップデートで、最適化時にプロンプトの長さを減らす「プロンプト短縮」をテンプレートごとに有効にできるようになりました。短縮を有効にすると、元より短く、かつ評価スコアが元以上のプロンプトだけが返されます。
AdvPO 本体の使い方は、以下の記事で紹介されています。本記事では、プロンプト短縮の有無による違いに絞って確認します。
プロンプト短縮とは
プロンプト短縮は、入力 JSONL の各テンプレートに optimizationConfig.shortenPrompt を指定して有効にします。CreateAdvancedPromptOptimizationJob の API リクエストは変わりません。テンプレート単位の設定なので、同じジョブの中で短縮を有効にするテンプレートと無効のテンプレートを混在できます。
以下は、テンプレート1つ、評価サンプル1件の例です。
{
  "version": "bedrock-2026-05-14",
  "templateId": "faq-answer-v1",
  "promptTemplate": "次の質問に1文で回答してください。\n\n質問: {{question}}",
  "optimizationConfig": {
    "shortenPrompt": true
  },
  "steeringCriteria": ["CONCISE"],
  "evaluationSamples": [
    {
      "inputVariables": [{"question": "返品の受付期間は何日ですか?"}],
      "referenceResponse": "返品は商品到着から30日以内に受け付けています。"
    }
  ]
}
短縮を有効にすると、オプティマイザーは書き換えの反復ごとに、その時点の最良候補より少し短い候補を目標にします。一度に大きく削るのではなく、反復を重ねて少しずつ短くする方式です。
公式ドキュメントには、短縮後のプロンプトは元のプロンプトの構成や詳細さを保たないことがある、とも書かれています。次に示すとおり、最適化後のプロンプトを返すかどうかの条件は「元より短いこと」と「評価スコアが元以上であること」の2つだけで、元の構成や詳細さが残っているかどうかは条件に含まれていません。そのため、評価スコアが下がらなければ、背景の説明や例示を削ったプロンプトでも返されます。今回の検証で実際に何が削られたかは、「最適化後のプロンプトを比べる」で紹介します。
最適化の反復と、最終的に返すプロンプトの判定の流れは次のとおりです。
結果には、短縮を有効にしたテンプレートに限り、次の3つの値が追加されます。
| フィールド | 内容 |
|---|---|
originalTokenCount |
元のテンプレートのトークン数 |
optimizedTokenCount |
最適化後のテンプレートのトークン数 |
compressionRatio |
optimizedTokenCount / originalTokenCount。1.0 は元のプロンプトが返されたことを示す |
トークン数は、変数に値を埋め込む前のテンプレートで数えます。
公式ドキュメントには、次の制限が記載されています。
- 「500 トークンにする」のような目標トークン数は指定できない(テンプレートごとに有効・無効を選ぶだけ)
<advpo:optimize>で囲んだ複数のセクションのうち、一部だけを短縮対象にすることはできない- すでに簡潔なプロンプトは、短縮されず compressionRatio 1.0 になることがある
また、短縮で減るのはプロンプトテンプレートの長さで、モデルの応答の長さではありません。評価方法は、システムデフォルト、steering criteria、カスタム LLM-as-a-judge、カスタム Lambda 評価器のどれでも使えます。
プロンプト短縮は、AdvPO が利用できるすべてのリージョンで使えます。東京リージョン(ap-northeast-1)も対象です。AdvPO 自体に料金はかからず、最適化中の推論(オプティマイザーの LLM、対象モデル、Judge)と Lambda の料金だけが発生します。オプティマイザーの LLM は、執筆時点では Claude Sonnet 4.6 です。
やってみた
前提条件
- 検証環境: 東京リージョン(ap-northeast-1)、AWS CLI 2.38.1
- 対象モデル: Claude Haiku 5.5(
jp.anthropic.claude-haiku-5-5) - ジョブの入出力用の S3 バケット(ジョブと同じリージョンに作成する必要があります)
- 評価用の Lambda 関数と、その実行ロール
AdvPO はサービスロールを使わず、ジョブを作成した IAM ユーザーまたはロールの権限で、対象モデルの呼び出し、S3 の読み書き、Lambda の呼び出しを行います。そのため、ジョブを作成する側に、これらの操作の権限が必要です。
検証の構成
同じ冗長なプロンプトを2つのテンプレートとして1つのジョブに入れ、片方だけ短縮を有効にしました。
| テンプレート ID | プロンプト | プロンプト短縮 |
|---|---|---|
| verbose-noshorten | 冗長なプロンプト(2,060 文字) | 無効 |
| verbose-shorten | verbose-noshorten と同じ | 有効 |
タスクは、ECサイトへの問い合わせ文を6つのカテゴリ(billing / shipping / returns / account / product_defect / other)と3段階の緊急度(high / medium / low)に分類し、{"category": "<カテゴリ>", "urgency": "<緊急度>"} の JSON だけを出力するものです。評価サンプルは8件で、判断が分かれにくいものと分かれやすいもの(返金と支払い方法変更が混ざった問い合わせ、不具合品の交換依頼など)を混ぜました。評価には、出力 JSON を正解と比較して採点する Lambda 評価器を使いました。
検証の構成は以下のとおりです。
最適化が終わった後、最適化に使わずに取っておいた12件の問い合わせ(ホールドアウト)で、元のプロンプトと最適化後のプロンプトを Converse API で実行して再評価しました。
コンソールで設定項目を確認する
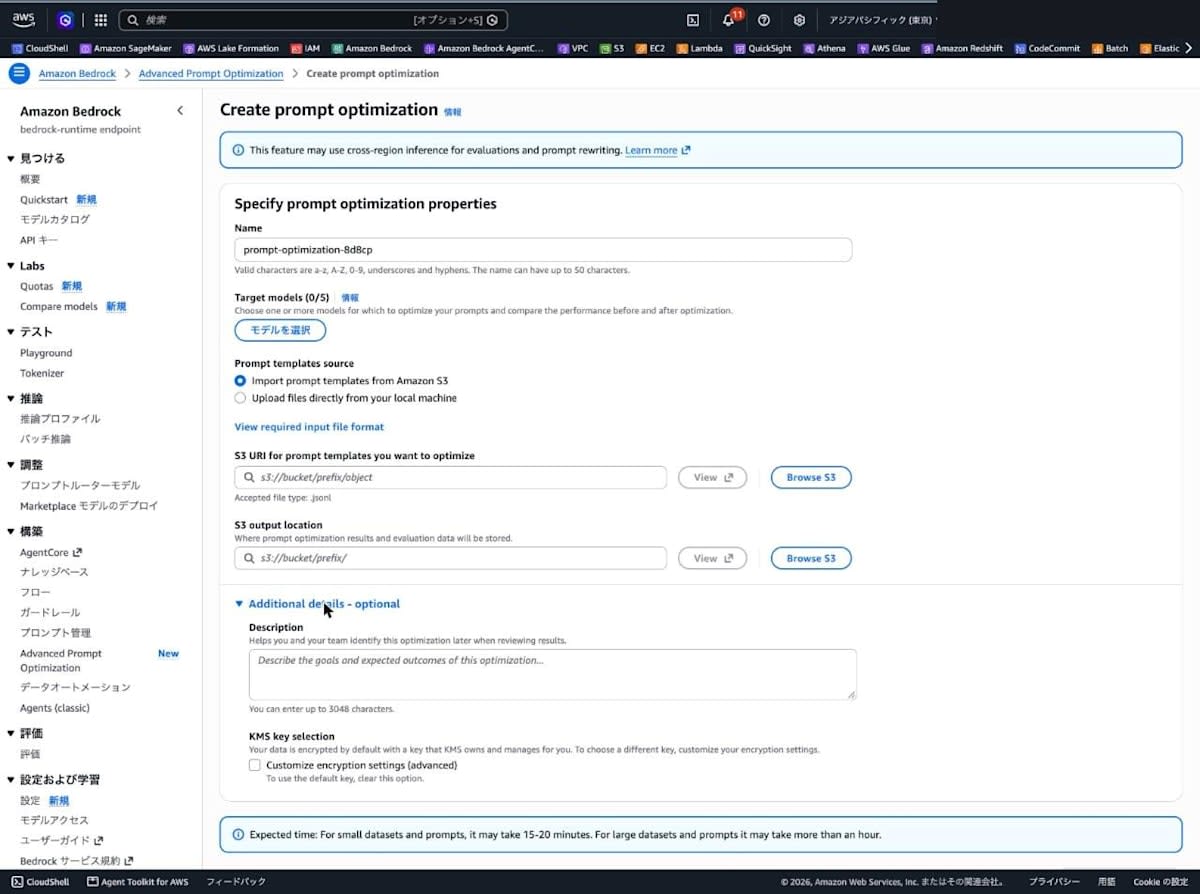
まず、マネジメントコンソールの「Create prompt optimization」画面に、短縮用の設定項目があるかを確認しました。「Additional details - optional」を開いても、説明文(Description)と KMS キーの設定しかありません。
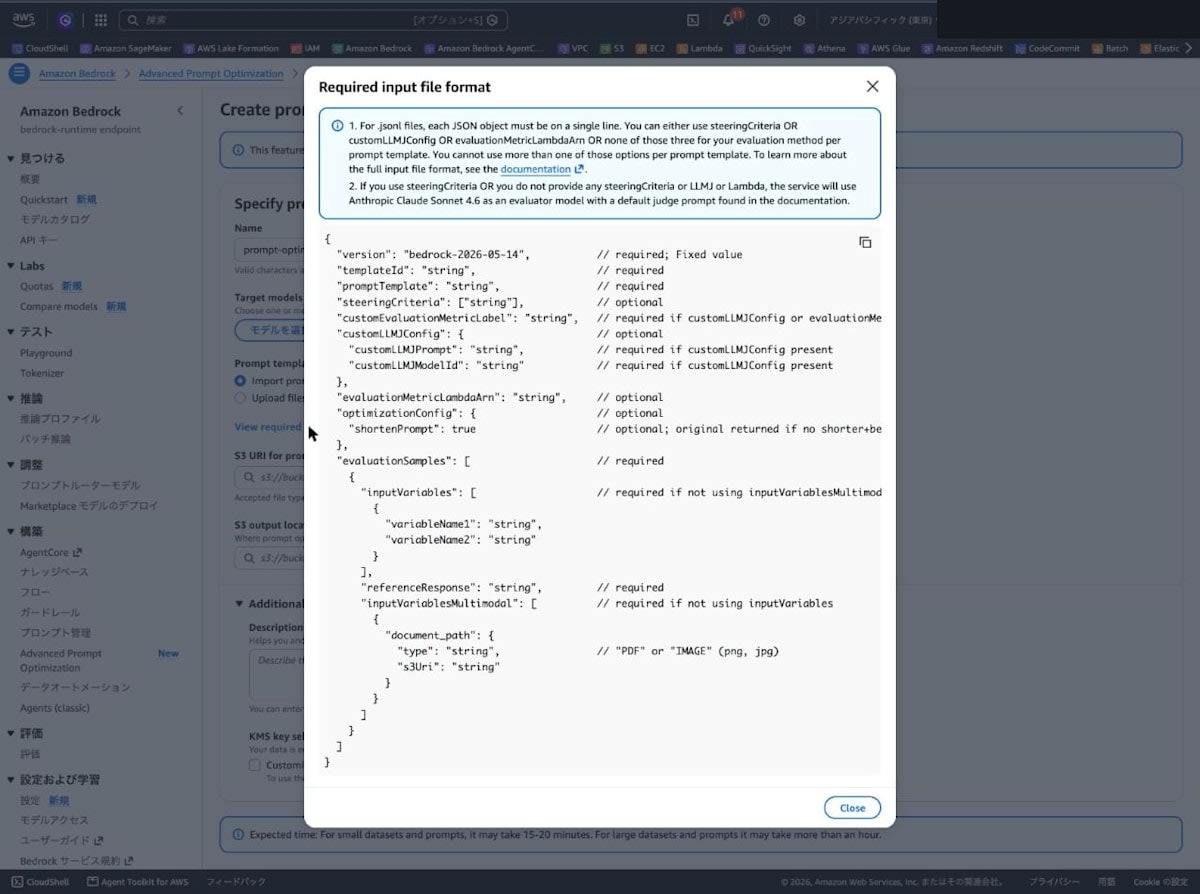
「View required input file format」をクリックすると、入力 JSONL のスキーマに optimizationConfig.shortenPrompt が記載されていました。コメントは「optional; original returned if no shorter+better prompt」です。コンソールから実行する場合も、短縮は入力 JSONL で指定します。
入力データを用意する
冗長なプロンプトは、実際の運用プロンプトで起こりがちな重複を含めて作りました。具体的には、長い前置き、例を並べたカテゴリ定義、何度も繰り返す出力形式の注意です。全文は以下のとおりで(2,060文字)、このテキストを prompt_verbose.txt として保存しています。{{inquiry}} が問い合わせ本文を埋め込む変数です。
あなたは、株式会社サンプルマートが運営するオンラインショップ「サンプルマート」のカスタマーサポート部門で働く、経験豊富で丁寧なカスタマーサポート担当者です。サンプルマートは家電、日用品、食品などを幅広く扱う総合ECサイトで、毎日多くのお客様からお問い合わせが届きます。お客様に満足していただくためには、届いたお問い合わせを正しい担当チームに素早く振り分けることがとても重要です。そこで、あなたにはお問い合わせの分類作業をお願いしたいと思います。

これから、お客様から届いたお問い合わせの本文をお渡しします。あなたの仕事は、そのお問い合わせ内容をよく読んで理解し、どのカテゴリに当てはまるのかを判断し、さらにどのくらい急いで対応する必要があるのか(緊急度)を判断することです。

## カテゴリについて

お問い合わせは、必ず以下の6つのカテゴリのうちのいずれか1つに分類してください。複数のカテゴリを選ぶことはできません。

- billing: 請求や支払いに関するお問い合わせです。たとえば、請求金額の誤り、二重請求、支払い方法の変更、領収書の発行、クレジットカードの決済エラーなど、お金の支払いや請求に関係するものはこのカテゴリになります。
- shipping: 配送に関するお問い合わせです。たとえば、商品がまだ届かない、配送状況を知りたい、お届け日時を変更したい、配送先住所を変更したいなど、商品の配送やお届けに関係するものはこのカテゴリになります。
- returns: 返品や交換に関するお問い合わせです。たとえば、注文した商品と違うものが届いたので交換したい、イメージと違ったので返品したい、返金はいつされるのかなど、返品・交換・返金の手続きに関係するものはこのカテゴリになります。
- account: アカウントに関するお問い合わせです。たとえば、ログインできない、パスワードを忘れた、登録しているメールアドレスを変更したい、退会したいなど、会員アカウントに関係するものはこのカテゴリになります。
- product_defect: 製品の不具合に関するお問い合わせです。たとえば、届いた商品が動かない、壊れていた、使用中に異常が発生したなど、商品そのものの故障や不具合に関係するものはこのカテゴリになります。
- other: 上記のどのカテゴリにも当てはまらないお問い合わせです。たとえば、商品の在庫や仕様についての質問、お店へのご意見やご要望などはこのカテゴリになります。

なお、1つのお問い合わせに複数の話題が含まれている場合は、お客様が最も解決してほしいと考えている主な要件に基づいてカテゴリを1つだけ選んでください。

## 緊急度について

緊急度は、high、medium、low の3段階のうちいずれか1つで判断してください。

- high: すぐに対応しないとお客様に大きな損害や危険が生じるおそれがあるものです。たとえば、商品の発煙・発火・異臭など安全に関わる問題、二重請求や身に覚えのない請求などお客様に金銭的な被害が出ているもの、強い怒りを示していて至急の対応を求めているものなどが該当します。
- medium: 通常の手続きや対応が必要なものです。たとえば、返品・交換の依頼、配送日時や配送先の変更、ログインできない、領収書の発行といった、対応は必要だが緊急性が高くないものが該当します。
- low: 情報の確認や質問など、急ぎではないものです。たとえば、商品の仕様や在庫に関する質問、配送状況の確認、ご意見・ご要望などが該当します。

## 出力形式について

回答は必ずJSON形式で出力してください。JSONには "category" と "urgency" の2つのキーだけを含めてください。"category" には上記の6つのカテゴリ名のいずれか(billing、shipping、returns、account、product_defect、other)を、"urgency" には high、medium、low のいずれかを英語の小文字で入れてください。

出力例:
{"category": "shipping", "urgency": "medium"}

## 注意事項

- JSON以外の文章は出力しないでください。説明や前置き、補足、謝罪の言葉なども不要です。
- 分類の理由は出力しないでください。
- コードブロックで囲まずに、JSONだけをそのまま出力してください。
- カテゴリ名と緊急度は、必ず指定された値の中から選んでください。指定されていない値を出力してはいけません。
- 繰り返しになりますが、出力はJSONのみとし、それ以外のテキストは一切含めないでください。

それでは、以下のお問い合わせを分類してください。お問い合わせの内容をよく読み、慎重に判断してください。

お問い合わせ本文:
{{inquiry}}
もう1つ、後述の「簡潔なプロンプトに短縮を有効にした場合」で使う簡潔なプロンプトも用意しました。全文は以下のとおりで(306文字)、このテキストを prompt_concise.txt として保存しています。
ECサイトの問い合わせを分類し、JSONのみを出力してください。

category(1つ選択): billing(請求・支払い), shipping(配送), returns(返品・交換・返金), account(アカウント・ログイン), product_defect(製品の故障・不具合), other(その他)
urgency: high(安全上の問題・金銭被害・強い苦情で至急対応が必要), medium(通常の手続きが必要), low(質問・状況確認・要望)

出力例: {"category": "shipping", "urgency": "medium"}

問い合わせ:
{{inquiry}}
入力 JSONL は、以下のスクリプトで生成しました。上記の prompt_verbose.txt と prompt_concise.txt を読み込み、それぞれに評価サンプル8件と正解を付けて、テンプレートごとに1行ずつ書き出します。短縮を有効にするテンプレートにだけ optimizationConfig を付けています。後述のホールドアウト用の12件も、同じスクリプトで holdout.jsonl に書き出しています。
dataset.jsonl
"""AdvPO 入力 JSONL(dataset.jsonl)とホールドアウト(holdout.jsonl)を生成する。

Usage: python3 build_dataset.py <lambda_arn>
"""
import json
import pathlib
import sys

HERE = pathlib.Path(__file__).parent
LAMBDA_ARN = sys.argv[1]

# 最適化に使う評価サンプル(易しいものと判断が分かれやすいものを混ぜる)
EVAL_SAMPLES = [
    ("注文番号A1029の配送状況を教えてください。今週中に届くか知りたいです。", "shipping", "low"),
    ("クレジットカードの明細を見たら、同じ注文で2回請求されていました。すぐに返金してください。", "billing", "high"),
    ("届いた電気ケトルを使っていたら、底から焦げたような臭いと煙が出てきました。怖くて使えません。", "product_defect", "high"),
    ("サイズを間違えて注文してしまったので、Mサイズに交換したいです。手続きを教えてください。", "returns", "medium"),
    ("パスワードを再設定しようとしても確認メールが届かず、ログインできません。", "account", "medium"),
    ("このコーヒーメーカーは海外の電圧でも使えますか?", "other", "low"),
    ("返品した商品の返金がまだされていません。それと、次回から支払い方法を銀行振込に変えたいのですが。", "returns", "medium"),
    ("届いたヘッドホンの右側から音が出ません。交換してもらえますか?", "product_defect", "medium"),
]

# 最適化に使わないホールドアウト
HOLDOUT_SAMPLES = [
    ("お届け日を土曜日の午前中に変更できますか?", "shipping", "medium"),
    ("領収書をPDFで発行してほしいです。", "billing", "medium"),
    ("注文した覚えのない商品の請求が来ています。不正利用ではないでしょうか。至急確認してください。", "billing", "high"),
    ("充電器をコンセントに差し込んだらバチッと火花が出ました。", "product_defect", "high"),
    ("イメージと色が違ったので返品したいです。", "returns", "medium"),
    ("登録しているメールアドレスを変更したいです。", "account", "medium"),
    ("御社のサイトはとても使いやすいです。今後も利用します。", "other", "low"),
    ("この冷蔵庫はいつ再入荷しますか?", "other", "low"),
    ("退会したいので手続きをお願いします。", "account", "medium"),
    ("配送先の住所を引っ越し先に変更したいです。まだ発送前だと思います。", "shipping", "medium"),
    ("届いた食器が割れていました。新しいものを送ってください。", "product_defect", "medium"),
    ("何度も電話しているのに誰も対応してくれない。注文した商品が全く違うものだった。今すぐ交換しろ。", "returns", "high"),
]

def ref(category, urgency):
    return json.dumps({"category": category, "urgency": urgency}, ensure_ascii=False)

def record(template_id, prompt, shorten):
    r = {
        "version": "bedrock-2026-05-14",
        "templateId": template_id,
        "promptTemplate": prompt,
    }
    if shorten:
        r["optimizationConfig"] = {"shortenPrompt": True}
    r["evaluationMetricLambdaArn"] = LAMBDA_ARN
    r["customEvaluationMetricLabel"] = "ClassificationScore"
    r["evaluationSamples"] = [
        {"inputVariables": [{"inquiry": q}], "referenceResponse": ref(c, u)}
        for q, c, u in EVAL_SAMPLES
    ]
    return r

verbose = (HERE / "prompt_verbose.txt").read_text(encoding="utf-8").rstrip("\n")
concise = (HERE / "prompt_concise.txt").read_text(encoding="utf-8").rstrip("\n")

records = [
    record("verbose-noshorten", verbose, shorten=False),
    record("verbose-shorten", verbose, shorten=True),
    record("concise-shorten", concise, shorten=True),
]

with open(HERE / "dataset.jsonl", "w", encoding="utf-8") as f:
    for r in records:
        f.write(json.dumps(r, ensure_ascii=False) + "\n")

with open(HERE / "holdout.jsonl", "w", encoding="utf-8") as f:
    for q, c, u in HOLDOUT_SAMPLES:
        f.write(json.dumps({"inquiry": q, "referenceResponse": ref(c, u)}, ensure_ascii=False) + "\n")

print(f"dataset.jsonl: {len(records)} templates x {len(EVAL_SAMPLES)} samples")
print(f"holdout.jsonl: {len(HOLDOUT_SAMPLES)} samples")
% python3 build_dataset.py arn:aws:lambda:ap-northeast-1:<account-id>:function:blog-advpo-eval-b54a7ae0
dataset.jsonl: 3 templates x 8 samples
holdout.jsonl: 12 samples
dataset.jsonl には、後述の簡潔なプロンプト(concise-shorten)を含む3テンプレートが入っています。このジョブでは、先頭2行(verbose-noshorten と verbose-shorten)を dataset_v2.jsonl として使いました。
% head -2 dataset.jsonl > dataset_v2.jsonl
評価用の Lambda 関数を用意する
Lambda 評価器は、compute_score(preds, golds) を実装し、集計スコア score(float)とサンプルごとのスコアのリスト scores を含む辞書を返す必要があります。
公式ドキュメントでは、0/1 よりも段階のあるスコアのほうが最適化が収束しやすいとされているため、カテゴリ一致 0.6、緊急度一致 0.3、出力が JSON だけかどうか 0.1 の配点にしました。docstring とソースコードはオプティマイザーが読んで評価の意図を理解するのに使われるため、配点を docstring に書いています。
評価用の Lambda 関数
"""
問い合わせ分類(JSON 出力)用のカスタム評価メトリクス
Handler: lambda_function.lambda_handler
"""
import json
import logging
import re
from typing import Any, Dict, List

logger = logging.getLogger()
logger.setLevel(logging.INFO)

def _parse(text: str):
    """出力を JSON として読む。前後に余計な文字列がない厳密な JSON かどうかも返す。"""
    s = (text or "").strip()
    try:
        return json.loads(s), True
    except Exception:
        pass
    m = re.search(r"\{.*\}", s, re.S)
    if m:
        try:
            return json.loads(m.group(0)), False
        except Exception:
            pass
    return None, False

def score_one(pred: str, gold: str) -> Dict[str, Any]:
    """1 サンプル分の採点結果(score と内訳)を返す。"""
    gold_obj, _ = _parse(gold)
    pred_obj, strict = _parse(pred)
    if not isinstance(pred_obj, dict):
        return {"score": 0.0, "error": "JSON として読めない出力"}

    category_ok = pred_obj.get("category") == gold_obj.get("category")
    urgency_ok = pred_obj.get("urgency") == gold_obj.get("urgency")
    format_ok = strict and set(pred_obj.keys()) == {"category", "urgency"}

    score = 0.6 * category_ok + 0.3 * urgency_ok + 0.1 * format_ok
    return {
        "score": round(score, 4),
        "category_ok": category_ok,
        "urgency_ok": urgency_ok,
        "format_ok": format_ok,
        "pred_category": pred_obj.get("category"),
        "pred_urgency": pred_obj.get("urgency"),
    }

def compute_score(preds: List[str], golds: List[str]) -> Dict[str, Any]:
    """
    問い合わせ分類の正しさを 0.0〜1.0 で採点する(高いほど良い)。

    1 サンプルあたりの内訳:
      - category が正解と一致: 0.6
      - urgency が正解と一致: 0.3
      - 出力が JSON のみ(前後の文章やコードブロックなし)で、キーが category と urgency の 2 つだけ: 0.1
    JSON として読めない出力は 0.0。
    """
    details = [score_one(p, g) for p, g in zip(preds, golds)]
    scores = [d["score"] for d in details]
    return {
        "score": sum(scores) / len(scores) if scores else 0.0,
        "scores": scores,
        "details": details,
    }

def lambda_handler(event, context):
    """APO サービスから event = {"preds": [...], "golds": [...]} が渡される。"""
    logger.info(f"Received {len(event.get('preds', []))} predictions")
    try:
        preds = event.get("preds", [])
        golds = event.get("golds", [])
        if not preds:
            return {"score": 0.0, "scores": []}
        return compute_score(preds, golds)
    except Exception as e:
        logger.error(f"Error: {e}", exc_info=True)
        return {"score": 0.0, "scores": [0.0] * len(event.get("preds", [])), "error": str(e)}
実行ロールを作成して関数をデプロイし、bedrock.amazonaws.com からの呼び出しを許可するリソースベースポリシーを追加しました。
ジョブを作成する
入力 JSONL を S3 にアップロードし、ジョブを作成しました。コマンドに短縮用のパラメータはありません。
% aws s3 cp dataset_v2.jsonl s3://blog-advpo-b54a7ae0-<account-id>/input/dataset_v2.jsonl

% aws bedrock create-advanced-prompt-optimization-job \
  --region ap-northeast-1 \
  --job-name advpo-shorten-b54a7ae0-v2 \
  --job-description 'prompt shortening verification (maxTokens 2000)' \
  --model-configurations '[{"modelId": "jp.anthropic.claude-haiku-5-5", "inferenceConfig": {"maxTokens": 2000}}]' \
  --input-config '{"s3Uri": "s3://blog-advpo-b54a7ae0-<account-id>/input/dataset_v2.jsonl"}' \
  --output-config '{"s3Uri": "s3://blog-advpo-b54a7ae0-<account-id>/output/"}'
{
    "jobArn": "arn:aws:bedrock:ap-northeast-1:<account-id>:advanced-prompt-optimization-job/27e7dbfed296"
}
推論設定は maxTokens だけを指定しています。Claude Haiku 5.5 は、temperature を指定すると temperature is deprecated for this model というエラーになりました。
また、Haiku 5.5 の応答には、回答本体の text ブロックの前に推論(reasoningContent)ブロックが含まれ、推論分も出力トークンとして数えられます。maxTokens は、この推論ブロックと text ブロックを合わせた出力トークンの上限です。推論で上限に達すると、回答の JSON が途中で切れたり、出力されなかったりします。分類結果の JSON は約20トークンですが、事前に Converse で試したところ出力トークンは 168〜387 だったため、maxTokens は 2000 にしました。
ジョブの結果を見ると、ヘッドホンの交換依頼のサンプルで出力トークンが 446 になっており、事前に試した最大値の 387 を超えていました。同じプロンプトと同じ入力を使ったもう一方のテンプレート(verbose-noshorten)では、このサンプルは 124 トークンで、推論の長さは実行ごとに変わっています。2000 以内だったため回答が途中で切れることはなく、すべてのサンプルで JSON が最後まで出力されました。なお、maxTokens は上限で、課金されるのは実際に生成されたトークン数です。このジョブでの Haiku 5.5 の出力は、1回の呼び出しあたり平均約78トークンでした。
ジョブは10分55秒で完了しました。
% aws bedrock get-advanced-prompt-optimization-job \
  --region ap-northeast-1 \
  --job-identifier arn:aws:bedrock:ap-northeast-1:<account-id>:advanced-prompt-optimization-job/27e7dbfed296 \
  --query '{jobStatus:jobStatus,creationTime:creationTime,lastModifiedTime:lastModifiedTime,failureMessage:failureMessage}' \
  --output table
----------------------------------------------------------
|            GetAdvancedPromptOptimizationJob            |
+-------------------+------------------------------------+
|  creationTime     |  2026-10-25T02:49:46.039000+00:00  |
|  failureMessage   |  None                              |
|  jobStatus        |  Completed                         |
|  lastModifiedTime |  2026-10-25T03:00:41.863000+00:00  |
+-------------------+------------------------------------+
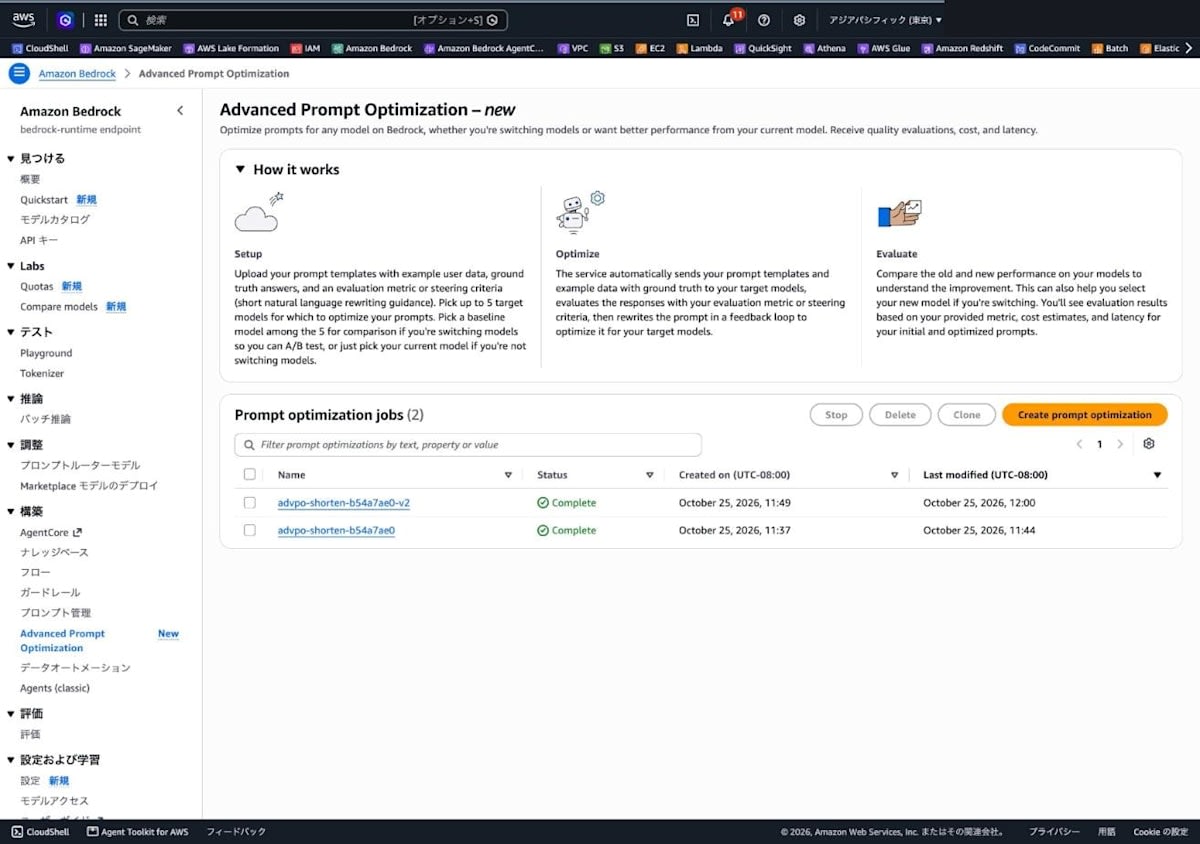
結果を確認する
結果は、出力先に指定したプレフィックスの下に <ジョブ ID>/advanced_prompt_optimization_results.jsonl として出力されます。ダウンロードして、テンプレートごとのスコア、平均入力トークン数、短縮関連の値を抜き出しました。
結果の取得
% aws s3 cp s3://blog-advpo-b54a7ae0-<account-id>/output/27e7dbfed296/advanced_prompt_optimization_results.jsonl .

% jq -r '.promptTemplateId as $t | .promptOptimizationResults[] | [$t, .originalPromptMetrics.averageScore, .optimizedPromptMetrics.averageScore, .originalPromptMetrics.averageInputTokens, .optimizedPromptMetrics.averageInputTokens, (.compressionRatio // "-"), (.originalTokenCount // "-"), (.optimizedTokenCount // "-")] | @tsv' advanced_prompt_optimization_results.jsonl | column -t
verbose-noshorten  1.0  1.0  1733  2536  -       -     -
verbose-shorten    1.0  1.0  1733  1258  0.7158  1886  1350
列は左から、テンプレート ID、元のスコア、最適化後のスコア、元の平均入力トークン数、最適化後の平均入力トークン数、compressionRatio、originalTokenCount、optimizedTokenCount です。
| 短縮なし(verbose-noshorten) | 短縮あり(verbose-shorten) | |
|---|---|---|
| スコア(元 → 最適化後) | 1.0 → 1.0 | 1.0 → 1.0 |
| 平均入力トークン(1リクエストあたり) | 1,733 → 2,536(+46%) | 1,733 → 1,258(−27%) |
| テンプレートのトークン数 | (項目なし) | 1,886 → 1,350 |
| compressionRatio | (項目なし) | 0.7158 |
| テンプレートの文字数 | 2,062 → 3,091 | 2,062 → 1,583 |
表の3つの長さの項目は、次の値です。
- 平均入力トークン: 変数
{{inquiry}}に問い合わせ本文を埋め込んだ後、実際にモデルへ送ったリクエストの入力トークン数の平均です(結果ファイルのaverageInputTokens) - テンプレートのトークン数: 変数を埋め込む前のテンプレートのトークン数です(
originalTokenCount/optimizedTokenCount)。短縮を有効にしたテンプレートにだけ出力されます - テンプレートの文字数: AdvPO の出力項目ではなく、結果ファイルの
promptTemplate(元)とoptimizedPromptTemplate(最適化後)の文字列を Python のlen()で数えた値です。改行、空白、記号、変数{{inquiry}}も1文字ずつ数えています。短縮なしのテンプレートにはトークン数の項目がないため、両方を同じ基準で比べる目的で載せました
結果ファイルでは波括弧が二重になって返されるため(後述)、元のテンプレートの文字数は、送信時の2,060文字より2文字多い2,062文字です。また、変数を埋め込んだ後の平均入力トークン(1,733)のほうが、埋め込む前のテンプレートのトークン数(1,886)より少なく、2つの値は同じ数え方ではないようです。数え方はドキュメントにも書かれていないため、それぞれ同じ項目の元と最適化後で比べてください。
スコアはどちらも 1.0 のままでした。短縮なしでは入力トークンが46%増え、短縮ありでは27%減っています。compressionRatio などの3項目は、短縮を有効にした verbose-shorten の結果にだけ含まれていました。
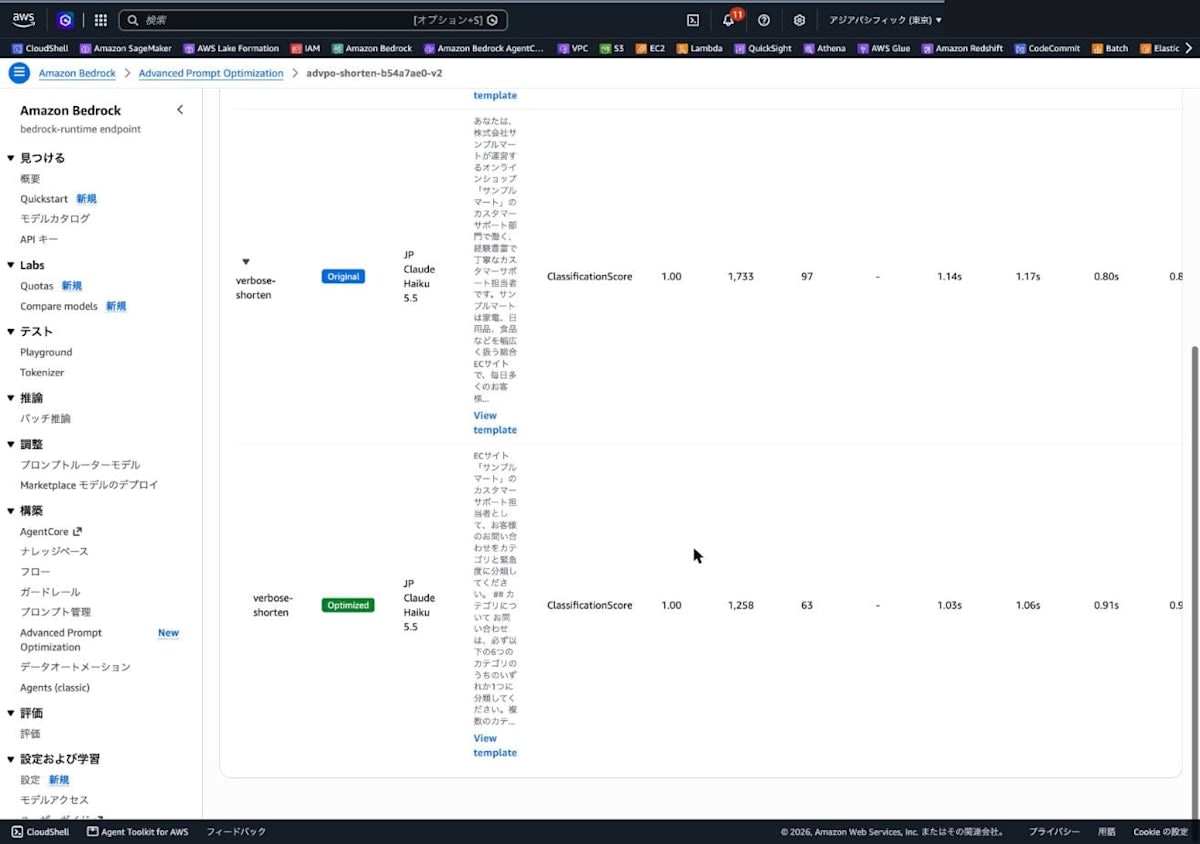
コンソールの結果ページでも同じ内容を確認できます。Summary tables タブの右端に「Compression Ratio」列があり、verbose-shorten の行に「0.72」と「1,886 → 1,350 tokens」が表示されます。短縮を無効にした verbose-noshorten の行は「-」です。
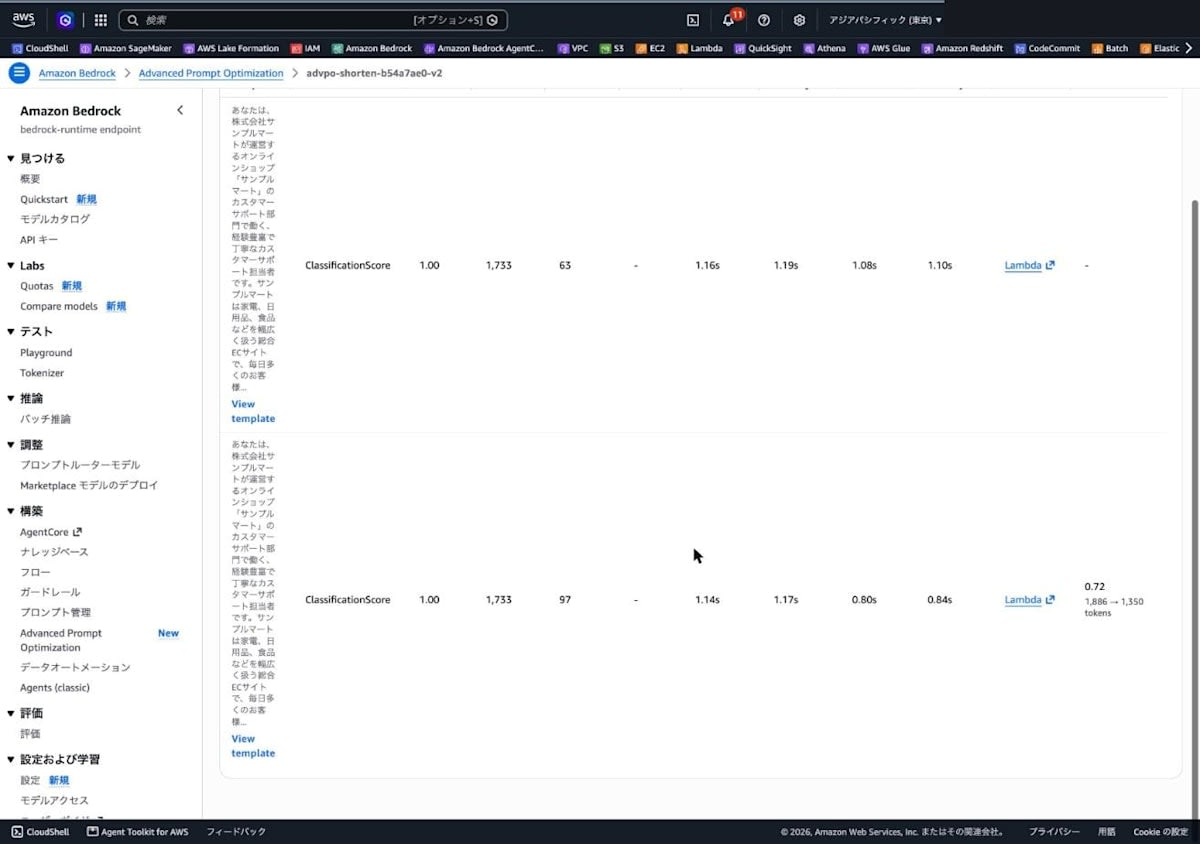
行の左端の三角をクリックして展開すると、Original と Optimized の行が並び、入力トークンが 1,733 から 1,258 に減っていることが分かります。
Graphs タブには「Prompt template length」チャートが表示され、元のテンプレートと最適化後のテンプレートのトークン数を比べられます。
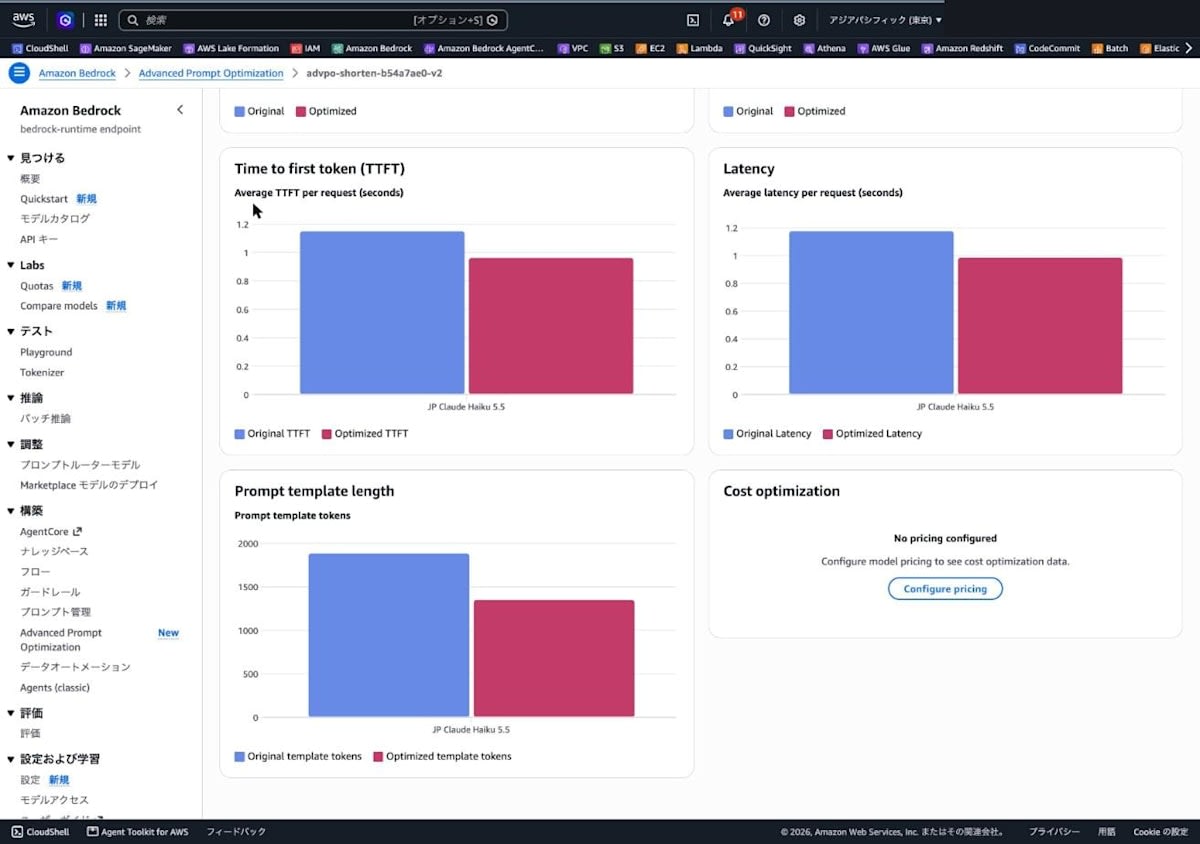
Graphs タブ上部の「Prompt template」でテンプレートを切り替えると、短縮の有無による違いがグラフで分かります。短縮なしは、スコアが同じまま入力トークンが増えていました。
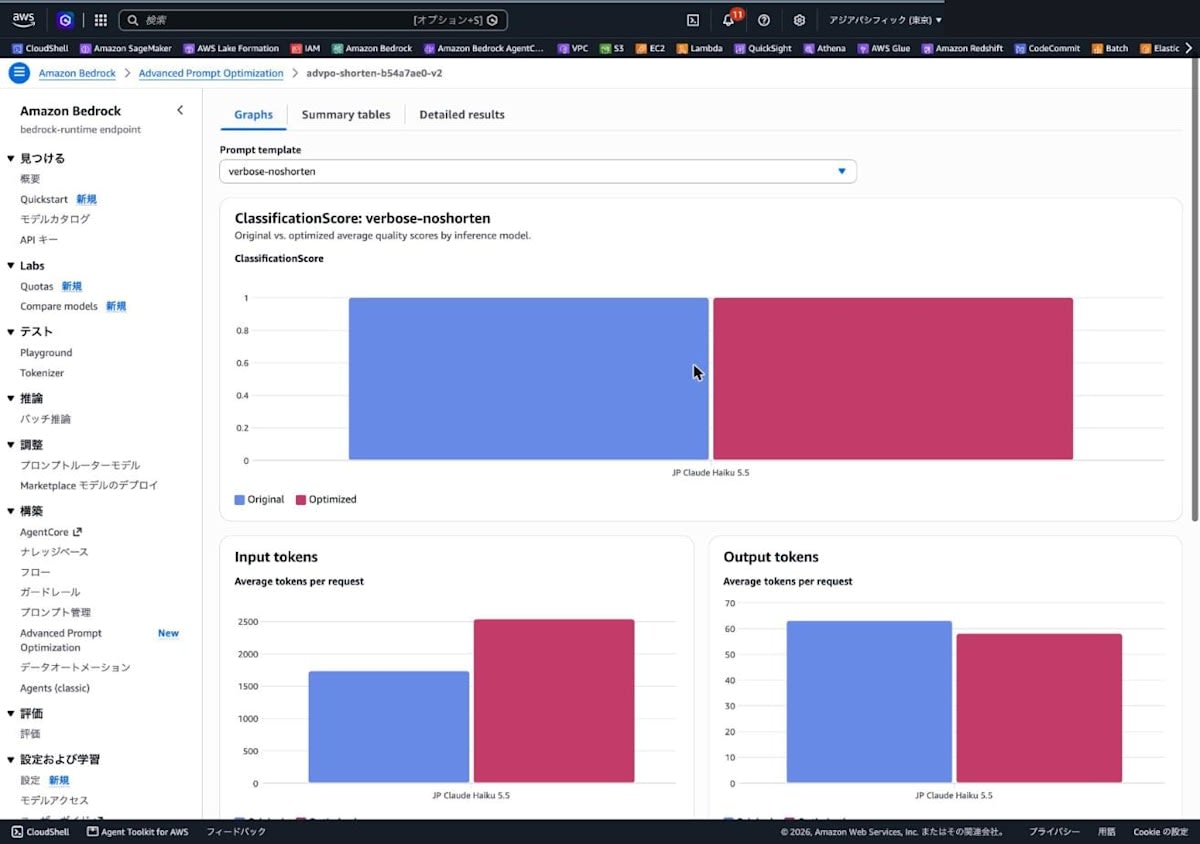
短縮ありは、スコアが同じまま入力トークンが減っていました。
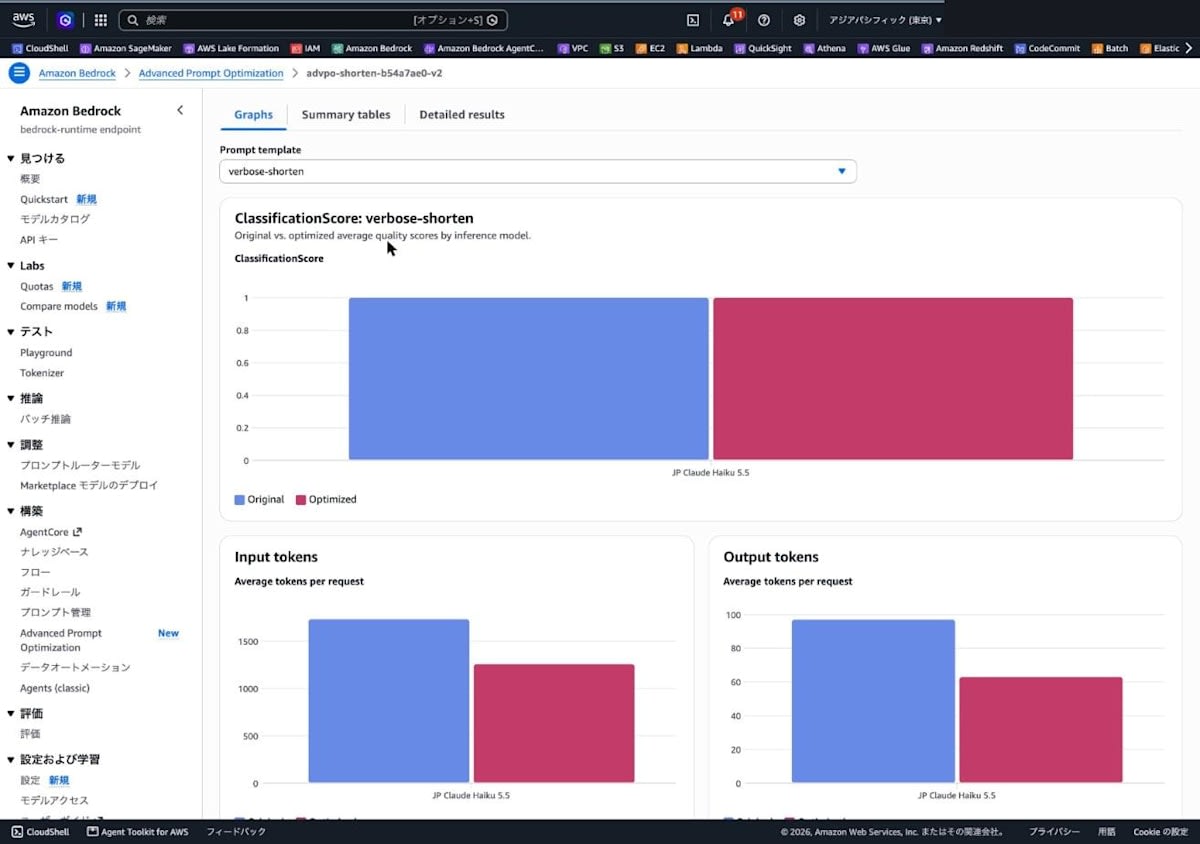
なお、テンプレートの選択を「All」のままにすると、グラフの値は全テンプレートの平均になります。テンプレートごとに比べる場合は、1つずつ切り替えて確認してください。
最適化後のプロンプトを比べる
最適化後のプロンプトは、「結果を確認する」でダウンロードした結果ファイル(advanced_prompt_optimization_results.jsonl)に含まれています。
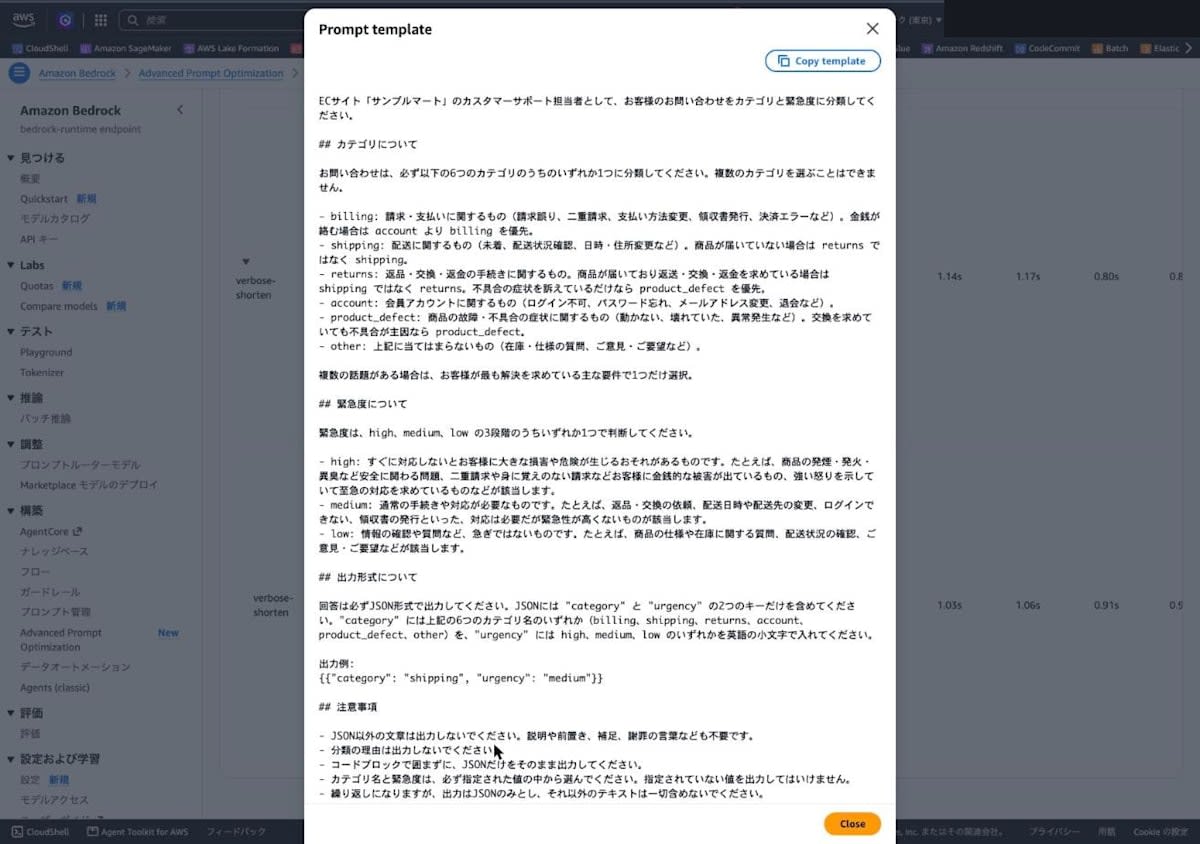
コンソールでは、「結果を確認する」で紹介した Summary tables タブで行を展開し、Optimized の行の「View template」を選ぶと、最適化後のプロンプトが表示されます。表示画面には「Copy template」ボタンもあります(この節の最後にキャプチャを載せています)。結果ファイルの項目は、公式ドキュメントの「View and interpret results」に説明があります。
上記の jq コマンドで取り出した、短縮ありの最適化後プロンプトの全文です(1,583文字)。結果ファイルの optimizedPromptTemplate をそのまま載せています(波括弧が二重になっている点は後述します)。
ECサイト「サンプルマート」のカスタマーサポート担当者として、お客様のお問い合わせをカテゴリと緊急度に分類してください。

## カテゴリについて

お問い合わせは、必ず以下の6つのカテゴリのうちのいずれか1つに分類してください。複数のカテゴリを選ぶことはできません。

- billing: 請求・支払いに関するもの(請求誤り、二重請求、支払い方法変更、領収書発行、決済エラーなど)。金銭が絡む場合は account より billing を優先。
- shipping: 配送に関するもの(未着、配送状況確認、日時・住所変更など)。商品が届いていない場合は returns ではなく shipping。
- returns: 返品・交換・返金の手続きに関するもの。商品が届いており返送・交換・返金を求めている場合は shipping ではなく returns。不具合の症状を訴えているだけなら product_defect を優先。
- account: 会員アカウントに関するもの(ログイン不可、パスワード忘れ、メールアドレス変更、退会など)。
- product_defect: 商品の故障・不具合の症状に関するもの(動かない、壊れていた、異常発生など)。交換を求めていても不具合が主因なら product_defect。
- other: 上記に当てはまらないもの(在庫・仕様の質問、ご意見・ご要望など)。

複数の話題がある場合は、お客様が最も解決を求めている主な要件で1つだけ選択。

## 緊急度について

緊急度は、high、medium、low の3段階のうちいずれか1つで判断してください。

- high: すぐに対応しないとお客様に大きな損害や危険が生じるおそれがあるものです。たとえば、商品の発煙・発火・異臭など安全に関わる問題、二重請求や身に覚えのない請求などお客様に金銭的な被害が出ているもの、強い怒りを示していて至急の対応を求めているものなどが該当します。
- medium: 通常の手続きや対応が必要なものです。たとえば、返品・交換の依頼、配送日時や配送先の変更、ログインできない、領収書の発行といった、対応は必要だが緊急性が高くないものが該当します。
- low: 情報の確認や質問など、急ぎではないものです。たとえば、商品の仕様や在庫に関する質問、配送状況の確認、ご意見・ご要望などが該当します。

## 出力形式について

回答は必ずJSON形式で出力してください。JSONには "category" と "urgency" の2つのキーだけを含めてください。"category" には上記の6つのカテゴリ名のいずれか(billing、shipping、returns、account、product_defect、other)を、"urgency" には high、medium、low のいずれかを英語の小文字で入れてください。

出力例:
{{"category": "shipping", "urgency": "medium"}}

## 注意事項

- JSON以外の文章は出力しないでください。説明や前置き、補足、謝罪の言葉なども不要です。
- 分類の理由は出力しないでください。
- コードブロックで囲まずに、JSONだけをそのまま出力してください。
- カテゴリ名と緊急度は、必ず指定された値の中から選んでください。指定されていない値を出力してはいけません。
- 繰り返しになりますが、出力はJSONのみとし、それ以外のテキストは一切含めないでください。

それでは、以下のお問い合わせを分類してください。お問い合わせの内容をよく読み、慎重に判断してください。

お問い合わせ本文:
{{inquiry}}
元のプロンプトと比べると、次の点が変わっていました。
| 項目 | 元のプロンプト | 短縮後のプロンプト |
|---|---|---|
| 冒頭の構成 | 役割と会社の説明、作業の説明の2段落(6文) | 「ECサイト「サンプルマート」のカスタマーサポート担当者として、お客様のお問い合わせをカテゴリと緊急度に分類してください。」の1文 |
| カテゴリ定義の書き方 | 「〜に関するお問い合わせです。たとえば、〜など、〜に関係するものはこのカテゴリになります。」という文章 | 「〜に関するもの(〜など)。」という括弧書き。文末は「〜を優先。」のような体言止め |
| 背景の説明 | 「家電、日用品、食品などを幅広く扱う総合ECサイト」「毎日多くのお客様からお問い合わせが届きます」「届いたお問い合わせを正しい担当チームに素早く振り分けることがとても重要」 | 削除 |
| returns の例 | 「注文した商品と違うものが届いたので交換したい、イメージと違ったので返品したい、返金はいつされるのか」 | 削除(代わりに shipping、product_defect との境界の判断ルールを追加) |
| そのほかのカテゴリの例 | 「クレジットカードの決済エラー」「使用中に異常が発生した」「登録しているメールアドレスを変更したい」など | 「決済エラー」「異常発生」「メールアドレス変更」のような短い語句に置き換え |
| 複数の話題がある場合の指示 | 「なお、1つのお問い合わせに複数の話題が含まれている場合は、お客様が最も解決してほしいと考えている主な要件に基づいてカテゴリを1つだけ選んでください。」 | 「複数の話題がある場合は、お客様が最も解決を求めている主な要件で1つだけ選択。」 |
| 緊急度、出力形式、注意事項の節 | ― | 元の文章のまま(「繰り返しになりますが、出力はJSONのみとし、それ以外のテキストは一切含めないでください。」の行も残っている) |
冒頭の2段落が1文にまとまり、カテゴリ定義が文章から括弧書きに変わった点が「構成」の変化です。背景の説明が削られ、具体例が短い語句になったり削られたりした点が「詳細さ」の変化です。これらを削っても、今回の評価サンプル8件でのスコアは 1.0 のままだったため、この短いプロンプトが返されました。一方で、短くする過程で、元のプロンプトになかったカテゴリ同士の境界の判断ルールが追加されています。
公式ドキュメントでは、短縮は反復ごとに少しずつ進むと説明されています。今回のジョブでは、短縮されたのは前半の節だけでした。
削られると困る文章がある場合について、公式ドキュメントのベストプラクティスでは、安全上の制約や法的な文言のように一字一句残す必要がある部分を、<advpo:optimize> で囲む範囲の外に置くか、<advpo:optimize> を使わない場合は <advpo:exclude> で囲むよう推奨しています。オプティマイザーが書き換えられない部分は、書かれたまま残ります(今回はこのタグを試していません)。
一方、短縮なしの最適化後プロンプトは、元の文章をすべて残したまま、カテゴリ定義の後に「優先順位ルール」と「よくある混同パターン」が追加され、3,091文字(元より1,029文字増)になっていました。product_defect の定義と、緊急度 high の定義にも、それぞれ1文が追記されています。全文は以下のとおりです。
あなたは、株式会社サンプルマートが運営するオンラインショップ「サンプルマート」のカスタマーサポート部門で働く、経験豊富で丁寧なカスタマーサポート担当者です。サンプルマートは家電、日用品、食品などを幅広く扱う総合ECサイトで、毎日多くのお客様からお問い合わせが届きます。お客様に満足していただくためには、届いたお問い合わせを正しい担当チームに素早く振り分けることがとても重要です。そこで、あなたにはお問い合わせの分類作業をお願いしたいと思います。

これから、お客様から届いたお問い合わせの本文をお渡しします。あなたの仕事は、そのお問い合わせ内容をよく読んで理解し、どのカテゴリに当てはまるのかを判断し、さらにどのくらい急いで対応する必要があるのか(緊急度)を判断することです。

## カテゴリについて

お問い合わせは、必ず以下の6つのカテゴリのうちのいずれか1つに分類してください。複数のカテゴリを選ぶことはできません。

- billing: 請求や支払いに関するお問い合わせです。たとえば、請求金額の誤り、二重請求、支払い方法の変更、領収書の発行、クレジットカードの決済エラーなど、お金の支払いや請求に関係するものはこのカテゴリになります。
- shipping: 配送に関するお問い合わせです。たとえば、商品がまだ届かない、配送状況を知りたい、お届け日時を変更したい、配送先住所を変更したいなど、商品の配送やお届けに関係するものはこのカテゴリになります。
- returns: 返品や交換に関するお問い合わせです。たとえば、注文した商品と違うものが届いたので交換したい、イメージと違ったので返品したい、返金はいつされるのかなど、返品・交換・返金の手続きに関係するものはこのカテゴリになります。
- account: アカウントに関するお問い合わせです。たとえば、ログインできない、パスワードを忘れた、登録しているメールアドレスを変更したい、退会したいなど、会員アカウントに関係するものはこのカテゴリになります。
- product_defect: 製品の不具合に関するお問い合わせです。たとえば、届いた商品が動かない、壊れていた、使用中に異常が発生したなど、商品そのものの故障や不具合に関係するものはこのカテゴリになります。お客様が交換・返品も希望している場合でも、不具合・故障・破損が問い合わせの発端であれば product_defect を選んでください(返品手続き自体が主目的の場合は returns)。
- other: 上記のどのカテゴリにも当てはまらないお問い合わせです。たとえば、商品の在庫や仕様についての質問、お店へのご意見やご要望などはこのカテゴリになります。

なお、1つのお問い合わせに複数の話題が含まれている場合は、お客様が最も解決してほしいと考えている主な要件に基づいてカテゴリを1つだけ選んでください。

カテゴリの判断に迷う場合は、以下の優先順位ルールに従ってください:

**優先順位(高い順):**
1. **安全・金銭的被害(high緊急度に直結)**: 発煙・発火・身に覚えのない請求など → safety/billing (high)
2. **product_defect**: 商品そのものが壊れている・動かないなど不具合がある場合 → product_defect(たとえお客様が交換・返品も希望していても、不具合の事実が主因であれば product_defect を選ぶ)
3. **returns**: 不具合とは無関係に返品・交換・返金の手続き自体を求めている場合(例:サイズ違い、イメージと違う、誤配送された商品の返送)
4. **shipping**: 配送状況の確認や配送先・日時の変更など、配送プロセスに関する問い合わせ(ただし、誤った商品が届いた場合の解決手段としての返品・交換は returns を優先)
5. **account**: ログイン・パスワード・登録情報など会員アカウントの操作に関する問い合わせ
6. **billing**: お金がすでに請求・決済されている、または決済エラーが発生している場合に限る。まだ購入前の支払い方法に関する一般的な質問は other を選ぶ
7. **other**: 在庫・仕様の確認、ご意見・ご要望など、上記のいずれにも該当しない場合

**よくある混同パターンと正しい分類:**
- 「壊れていたので交換したい」→ product_defect(不具合が主因)
- 「サイズが違ったので交換したい」→ returns(不具合なし、返品手続きが主題)
- 「違う商品が届いた」→ returns(誤配送の解決手段は返品・交換)
- 「商品がまだ届かない」→ shipping(配送状況の問題)
- 「二重請求された」→ billing(金銭的被害あり、urgency: high)
- 「支払い方法を変えたい(まだ請求されていない)」→ billing(支払い方法変更は billing に該当)

## 緊急度について

緊急度は、high、medium、low の3段階のうちいずれか1つで判断してください。

- high: すぐに対応しないとお客様に大きな損害や危険が生じるおそれがあるものです。たとえば、商品の発煙・発火・異臭など安全に関わる問題、二重請求や身に覚えのない請求などお客様に金銭的な被害が出ているもの、強い怒りを示していて至急の対応を求めているものなどが該当します。商品の不具合であっても、安全上の危険(感電・火災リスクなど)を伴う場合は high とします。
- medium: 通常の手続きや対応が必要なものです。たとえば、返品・交換の依頼、配送日時や配送先の変更、ログインできない、領収書の発行といった、対応は必要だが緊急性が高くないものが該当します。
- low: 情報の確認や質問など、急ぎではないものです。たとえば、商品の仕様や在庫に関する質問、配送状況の確認、ご意見・ご要望などが該当します。

## 出力形式について

回答は必ずJSON形式で出力してください。JSONには "category" と "urgency" の2つのキーだけを含めてください。"category" には上記の6つのカテゴリ名のいずれか(billing、shipping、returns、account、product_defect、other)を、"urgency" には high、medium、low のいずれかを英語の小文字で入れてください。

出力例:
{{"category": "shipping", "urgency": "medium"}}

## 注意事項

- JSON以外の文章は出力しないでください。説明や前置き、補足、謝罪の言葉なども不要です。
- 分類の理由は出力しないでください。
- コードブロックで囲まずに、JSONだけをそのまま出力してください。
- カテゴリ名と緊急度は、必ず指定された値の中から選んでください。指定されていない値を出力してはいけません。
- 繰り返しになりますが、出力はJSONのみとし、それ以外のテキストは一切含めないでください。

それでは、以下のお問い合わせを分類してください。お問い合わせの内容をよく読み、慎重に判断してください。

お問い合わせ本文:
{{inquiry}}
追加された内容を読むと、優先順位ルールでは「まだ購入前の支払い方法に関する一般的な質問は other」としている一方、混同パターンでは「支払い方法を変えたい(まだ請求されていない)→ billing」としており、両者の記述が一致していませんでした。最適化後のプロンプトは、そのまま採用せずに中身を読んで確認したほうがよいのではないかと考えます。
もう1点、結果ファイルでは、出力例の {"category": "shipping", "urgency": "medium"} が {{"category": "shipping", "urgency": "medium"}} のように、変数以外の波括弧が二重になっていました。送信したプロンプトと、結果ファイルに含まれる元のプロンプト(promptTemplate)を比べると、元のプロンプト側でも同じ置き換えが起きており、違いはこの箇所だけでした。最適化による書き換えではなく、結果を返すときの表記と考えられます。コンソールの「View template」でも、二重の波括弧で表示されます。
簡潔なプロンプトに短縮を有効にした場合
公式ドキュメントにある「すでに簡潔なプロンプトは短縮されないことがある」も確認しました。以下の簡潔なプロンプト(306文字。「入力データを用意する」に載せた prompt_concise.txt と同じ内容)に短縮を有効にし、同じ評価サンプルと Lambda 評価器を使って、別のジョブで実行しました。このジョブの maxTokens は 200 でしたが、全サンプルの出力トークンは最大 110 で、上限には達していません。
ECサイトの問い合わせを分類し、JSONのみを出力してください。

category(1つ選択): billing(請求・支払い), shipping(配送), returns(返品・交換・返金), account(アカウント・ログイン), product_defect(製品の故障・不具合), other(その他)
urgency: high(安全上の問題・金銭被害・強い苦情で至急対応が必要), medium(通常の手続きが必要), low(質問・状況確認・要望)

出力例: {"category": "shipping", "urgency": "medium"}

問い合わせ:
{{inquiry}}
jq -r 'select(.promptTemplateId=="concise-shorten") | .promptTemplateId as $t | .promptOptimizationResults[] | [$t, .originalPromptMetrics.averageScore, .optimizedPromptMetrics.averageScore, .compressionRatio, .originalTokenCount, .optimizedTokenCount, ([.dataset[].originalPromptDetails.originalPromptMetrics.outputTokens] | max)] | @tsv' advanced_prompt_optimization_results.jsonl | column -t
concise-shorten 1.0 1.0 1.0 203 203 110
元のプロンプトのスコアが最初から 1.0 で、compressionRatio は 1.0(203 → 203 トークン)でした。返された最適化後のプロンプト(optimizedPromptTemplate)は、結果ファイル内の元のプロンプト(promptTemplate)と一字一句同じです。短縮を有効にしても、必ず短いプロンプトが返るわけではないことが確認できました。
ホールドアウトで確認する
ホールドアウト(held-out data)は、最適化に使わずに取っておいた検証用のデータです。AdvPO は、ジョブに渡した評価サンプル(今回は8件)でスコアが上がるようにプロンプトを書き換えます。そのため、ジョブの結果に出るスコアは、最適化に使ったその8件での値です。最適化に使っていない入力でも同じ結果になるかは、別のデータで確かめる必要があります。公式ドキュメントでも、最適化の後に、オプティマイザーが見ていないホールドアウトデータでテストし、改善が評価サンプルに合わせただけのものではないことを確認するよう推奨されています。
今回は、「入力データを用意する」の build_dataset.py で、評価サンプルとは別の12件の問い合わせを holdout.jsonl に書き出しました。この12件はジョブには渡していません。
最適化に使った8件とは別の12件で、元のプロンプト、短縮なしの最適化後プロンプト、短縮ありの最適化後プロンプトを Converse API(maxTokens: 2000)で実行し、同じ採点関数でスコアを付けました。プロンプトは、結果ファイルの promptTemplate と optimizedPromptTemplate の文字列をそのまま使い、{{inquiry}} だけを置換しています(波括弧が二重のまま送っています)。採点には、Lambda と同じ lambda_function.py の score_one を使いました。inference_config.json には {"maxTokens": 2000} を書いています。
holdout_eval.py
"""ホールドアウトで元プロンプトと最適化後プロンプトを Converse API で実行し、同じ評価関数で採点する。

Usage: python3 holdout_eval.py <optimization_output.jsonl> <out.json>
"""
import json
import pathlib
import sys
import time

import boto3

from lambda_function import score_one

HERE = pathlib.Path(__file__).parent
MODEL_ID = "jp.anthropic.claude-haiku-5-5"
INFERENCE_CONFIG = json.loads((HERE / "inference_config.json").read_text())

client = boto3.client("bedrock-runtime", region_name="ap-northeast-1")
holdout = [json.loads(l) for l in (HERE / "holdout.jsonl").read_text(encoding="utf-8").splitlines() if l]
results = [json.loads(l) for l in pathlib.Path(sys.argv[1]).read_text(encoding="utf-8").splitlines() if l]

# 評価対象: 各テンプレートの元プロンプトと最適化後プロンプト
variants = {}
for r in results:
    tid = r["promptTemplateId"]
    variants[f"{tid}:original"] = r["promptTemplate"]
    for m in r["promptOptimizationResults"]:
        variants[f"{tid}:optimized"] = m["optimizedPromptTemplate"]

summary = {}
for name, template in variants.items():
    rows = []
    for h in holdout:
        prompt = template.replace("{{inquiry}}", h["inquiry"])
        started = time.perf_counter()
        resp = client.converse(
            modelId=MODEL_ID,
            messages=[{"role": "user", "content": [{"text": prompt}]}],
            inferenceConfig=INFERENCE_CONFIG,
        )
        elapsed = time.perf_counter() - started
        # Haiku 5.5 は reasoningContent ブロックの後に text ブロックを返すため、text ブロックだけを連結する
        text = "".join(b.get("text", "") for b in resp["output"]["message"]["content"])
        s = score_one(text, h["referenceResponse"])
        rows.append({
            "inquiry": h["inquiry"],
            "reference": h["referenceResponse"],
            "prediction": text,
            "inputTokens": resp["usage"]["inputTokens"],
            "outputTokens": resp["usage"]["outputTokens"],
            "latencyMs": resp["metrics"]["latencyMs"],
            "clientElapsedSec": round(elapsed, 3),
            **s,
        })
    n = len(rows)
    summary[name] = {
        "averageScore": round(sum(r["score"] for r in rows) / n, 4),
        "categoryAccuracy": round(sum(r["category_ok"] for r in rows if "category_ok" in r) / n, 4),
        "urgencyAccuracy": round(sum(r["urgency_ok"] for r in rows if "urgency_ok" in r) / n, 4),
        "formatOkRate": round(sum(r["format_ok"] for r in rows if "format_ok" in r) / n, 4),
        "averageInputTokens": round(sum(r["inputTokens"] for r in rows) / n, 1),
        "averageOutputTokens": round(sum(r["outputTokens"] for r in rows) / n, 1),
        "medianLatencyMs": sorted(r["latencyMs"] for r in rows)[n // 2],
        "rows": rows,
    }
    print(f"{name:32s} score={summary[name]['averageScore']:.3f} "
          f"cat={summary[name]['categoryAccuracy']:.2f} urg={summary[name]['urgencyAccuracy']:.2f} "
          f"fmt={summary[name]['formatOkRate']:.2f} in_tok={summary[name]['averageInputTokens']}")

pathlib.Path(sys.argv[2]).write_text(json.dumps(summary, ensure_ascii=False, indent=2), encoding="utf-8")
% python3 holdout_eval.py advanced_prompt_optimization_results.jsonl holdout_results.json
verbose-noshorten:original       score=1.000 cat=1.00 urg=1.00 fmt=1.00 in_tok=1725.8
verbose-noshorten:optimized      score=1.000 cat=1.00 urg=1.00 fmt=1.00 in_tok=2528.8
verbose-shorten:original         score=1.000 cat=1.00 urg=1.00 fmt=1.00 in_tok=1725.8
verbose-shorten:optimized        score=0.950 cat=0.92 urg=1.00 fmt=1.00 in_tok=1250.8
cat はカテゴリ正解率、urg は緊急度正解率、fmt は出力が JSON だけだった割合、in_tok は平均入力トークン数です(original の2行は同じプロンプトです)。
短縮ありの最適化後プロンプトは、12件中1件のカテゴリを誤りました。誤ったのは「届いた食器が割れていました。新しいものを送ってください。」で、正解の product_defect に対して returns と回答しています。このサンプルだけを、元のプロンプトと短縮後のプロンプトでそれぞれ5回実行したところ、どちらも5回とも product_defect と回答しました。元のプロンプトには送信時のファイル(prompt_verbose.txt)、短縮後のプロンプトには結果ファイルから保存したもの(optimized_verbose-shorten.txt)を使っています。
repeat_miss.py
"""ホールドアウトで外れたサンプルを、元プロンプトと短縮後プロンプトで各 5 回実行して回答の分布を見る。"""
import collections, json, pathlib, boto3
HERE = pathlib.Path(__file__).parent
c = boto3.client("bedrock-runtime", region_name="ap-northeast-1")
inquiry = "届いた食器が割れていました。新しいものを送ってください。"
prompts = {
    "original": (HERE / "prompt_verbose.txt").read_text(encoding="utf-8").rstrip("\n"),
    "shortened": (HERE.parent / "outputs" / "optimized_verbose-shorten.txt").read_text(encoding="utf-8"),
}
for name, tmpl in prompts.items():
    answers = []
    for _ in range(5):
        r = c.converse(modelId="jp.anthropic.claude-haiku-5-5",
                       messages=[{"role": "user", "content": [{"text": tmpl.replace("{{inquiry}}", inquiry)}]}],
                       inferenceConfig={"maxTokens": 2000})
        answers.append("".join(b.get("text", "") for b in r["output"]["message"]["content"]))
    print(name, dict(collections.Counter(answers)))
% python3 repeat_miss.py
original {'{"category": "product_defect", "urgency": "medium"}': 5}
shortened {'{"category": "product_defect", "urgency": "medium"}': 5}
短縮後のプロンプトでこのサンプルを実行した計6回のうち、誤りは1回でした。また、波括弧が二重のままのプロンプトで実行しても、fmt はすべて 1.00 で、出力形式への影響はありませんでした。
かかった費用
AdvPO の推論は自分のアカウントでの呼び出しとして扱われ、CloudWatch の AWS/Bedrock メトリクスにモデルごとのトークン数が記録されていました。このジョブ(2テンプレート × 評価サンプル8件)の実行中の値は次のとおりです。
| モデル | 呼び出し回数 | 入力トークン | 出力トークン |
|---|---|---|---|
jp.anthropic.claude-haiku-5-5(対象モデル) |
337 | 538,500 | 26,438 |
jp.anthropic.claude-sonnet-4-6(オプティマイザー) |
132 | 849,883 | 102,629 |
Price List API で取得した東京リージョンの単価(Sonnet 4.6 は入力 $3.30 / 出力 $16.50、Haiku 5.5 は入力 $0.11 / 出力 $0.55、いずれも100万トークンあたり)で計算すると、約 $4.57 で、そのうち約 $4.50 が Sonnet 4.6 の分でした。なお、料金ページの概算式では、Lambda で評価する場合は Judge のトークンが含まれません。Lambda はこのジョブ中に122回呼び出されました。
考察
- 短縮なしの最適化では、スコアが 1.0 のまま入力トークンが46%増えました。短縮ありでは、スコアが 1.0 のまま入力トークンが27%減りました。今回は元のプロンプトのスコアがすでに 1.0 だったため、短縮なしの最適化ではスコアは上がらず、入力トークンだけが増えました
- 1リクエストあたりの入力トークンの差(ホールドアウトで 1,725.8 → 1,250.8、約475トークン)に Haiku 5.5 の入力単価 $0.11 / 100万トークンを掛けると、100万リクエストあたり約 $52 の差になります。ジョブの費用(約 $4.57)は、約8.7万リクエスト分の入力トークン削減額に相当します。対象モデルの単価が高いほど、削減額は大きくなります
- 今回の短縮後のプロンプトでは、文章が削られただけでなく、境界の判断ルールが追加されていました。採用する前に、追加されたルールが自分のラベル定義と合っているかを確認する必要があります
- 結果ファイルとコンソールでは、変数以外の波括弧が
{{}}に置き換えられて返されます(元のプロンプトも同じです)。今回のホールドアウトでは二重のまま送っても影響はありませんでしたが、使用するテンプレートエンジンによっては{{の扱いが異なるため、組み込む前に実際にモデルへ送られる文字列を確認してください - TTFT は、ジョブ内の計測で短縮ありの平均が 1.14 → 1.03 秒、中央値が 0.80 → 0.91 秒でした。入力が46%長くなった短縮なしでも、平均 1.16 → 0.90 秒、中央値 1.08 → 0.72 秒と短くなっています。サンプル8件の1回の計測では、TTFT の差を短縮の効果と判断することはできませんでした
- 費用の大部分は、オプティマイザーの Claude Sonnet 4.6 の推論料金でした
- Claude Haiku 5.5 を対象モデルにする場合、応答に推論ブロックが含まれ、推論分も出力トークンに数えられます。
maxTokensには、最終的な応答の長さより大きな値を設定しておく必要があります。また、temperatureは指定できませんでした - 今回の結果は、1つのタスク、1つのモデル、1回のジョブでの結果です。圧縮率やスコアは、プロンプトの内容、評価サンプル、評価方法、モデルによって変わります
今後は、次のような機能拡張があると使いやすくなると思います。
- 目標トークン数や、短縮の強さを指定できる
- 短縮の反復回数を指定できる
<advpo:optimize>のセクションごとに短縮の有無を指定できる
最後に
Advanced Prompt Optimization のプロンプト短縮を、同じプロンプトで短縮なし・ありの2通りに最適化して比べました。短縮なしではスコアを保ったまま入力トークンが46%増え、短縮ありではスコアを保ったまま27%減りました(compressionRatio 0.7158)。元から簡潔なプロンプトでは、元のプロンプトがそのまま返りました。
設定は入力 JSONL に "optimizationConfig": {"shortenPrompt": true} を1行加えるだけで、API やコンソールの操作は変わりません。プロンプトの入力トークンが料金や応答時間に影響する用途で AdvPO を使う場合は、短縮ありとなしのテンプレートを同じジョブに入れて比べてみてください。最適化後のプロンプトは内容が書き換わるため、ホールドアウトデータでの確認と、追加されたルールの確認をしてから採用することをおすすめします。
合わせて読みたい