[アップデート] AgentCore Gatewayのレート制限をリクエストのヘッダーやボディの値ごとに分けられるようになりました

はじめに
こんにちは、チーズナンが好きなコンサル部の神野です。
Amazon Bedrock AgentCore Gatewayのレート制限で、リクエストのヘッダーやボディの値ごとに枠を分けられるようになりました!
公式ドキュメントに記載がありいつの間にか分割単位が増えていました。
レート制限そのものは8月に追加された機能で、以前の記事で試しているので、もしご興味があれば合わせて確認ください!
何が嬉しいか
今まで呼び出し元を分ける単位はIAMかJWTのクレームなためアプリのバックエンドが1つのIAMロールでGatewayを呼ぶ構成では利用者全員が同じ枠を共有します。利用者ごとに分けたい場合は、利用者のJWTをGatewayまで渡すなど、認証の構成から変える必要がありました。
今回のアップデートで、IAMの場合でもアプリがリクエストのボディに入れた利用者IDで枠を分けられるようになりました!
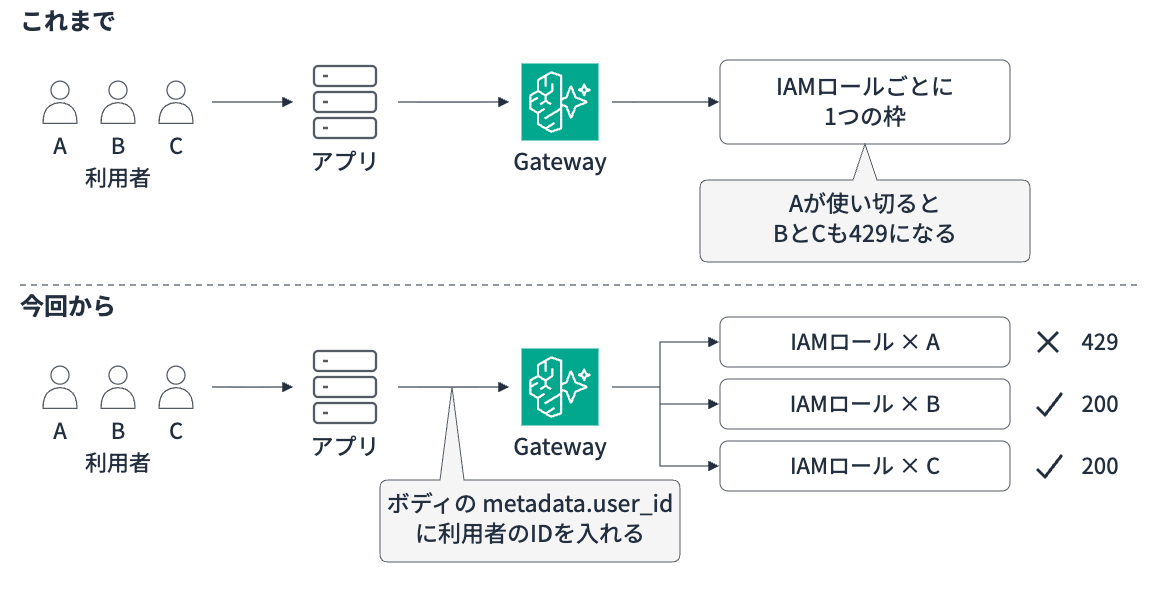
ヘッダーでも同様に分けられるため、「同じ呼び出し元でもバッチ処理のレートを個別に絞る」といった使い方もできますね。
もう少し具体的にみていきましょうか。
追加されたディメンション
ディメンションはレート制限の枠を何で分けるかを決めるキーです。ユーザーなどで分割可能だったのですが、今回のアップデートで次の2つが追加されました。
| ディメンション | 参照する値 | 例 |
|---|---|---|
$.context.request.header.<名前> |
リクエストヘッダーの値 | $.context.request.header.X-Workload |
$.context.request.body.<パス> |
JSONボディのフィールドの値 | $.context.request.body.metadata.user_id |
ヘッダーやボディの値は呼び出し側が自由に書けるので単独では使えないとドキュメント上書かれています。
どういうことかというと、Gatewayが検証したID(IAMプリンシパルやJWTのsubクレームなど)と同一のレート制限内で組み合わせ、その組み合わせごとに枠を作る必要があります。
下記絵のようなイメージです。
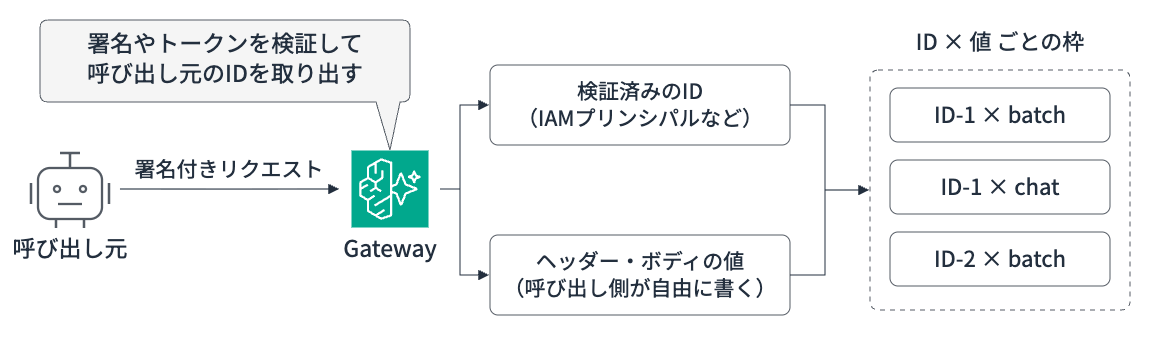
確かにユーザーが勝手に決めた値だけだと信頼しきれないためでしょうかね。
ちなみに検証済みのIDが前提なのでインバウンド認証なしのGatewayではこのディメンションを使えません。
前提
今回は下記前提で進めていきます!
| 項目 | 内容 |
|---|---|
| リージョン | us-east-1(バージニア北部) |
| boto3 / botocore | 1.43.114 |
| Python / パッケージ管理 | 3.14.6 / uv |
| Gateway | AgentCore Gateway(AWS_IAM認証) |
| ターゲット | 推論ターゲット(Bedrock Mantleコネクタ)、Claude Haiku 4.5 / GPT-5.6 Luna |
検証用のGatewayは前回の記事と同じ構成です。IAMロールの作成からGatewayの作成、呼び出し用のスクリプトまでを折りたたんでおきます。
検証環境の準備
作業用のプロジェクトを作成します。
uv init --no-readme agentcore-rl-dims
cd agentcore-rl-dims
uv python pin 3.14
uv add 'boto3>=1.43.114' requests
GatewayのサービスロールにはBedrockとMantleの呼び出し権限を付けます。
aws iam create-role \
  --role-name rate-limit-demo-gateway-role \
  --assume-role-policy-document '{
    "Version": "2012-10-17",
    "Statement": [{
      "Effect": "Allow",
      "Principal": {"Service": "bedrock-agentcore.amazonaws.com"},
      "Action": "sts:AssumeRole",
      "Condition": {"StringEquals": {"aws:SourceAccount": "<ACCOUNT_ID>"}}
    }]
  }'

aws iam put-role-policy \
  --role-name rate-limit-demo-gateway-role \
  --policy-name inference-permissions \
  --policy-document '{
    "Version": "2012-10-17",
    "Statement": [
      {
        "Effect": "Allow",
        "Action": ["bedrock:InvokeModel", "bedrock:InvokeModelWithResponseStream"],
        "Resource": "*"
      },
      {
        "Effect": "Allow",
        "Action": "bedrock-mantle:*",
        "Resource": "arn:aws:bedrock-mantle:*:<ACCOUNT_ID>:project/*"
      }
    ]
  }'
GatewayとBedrock Mantleコネクタの推論ターゲットを作成します。
import time

import boto3

client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")

gateway = client.create_gateway(
    name="rl-dims-demo-gateway",
    roleArn="arn:aws:iam::<ACCOUNT_ID>:role/rate-limit-demo-gateway-role",
    protocolType="MCP",
    authorizerType="AWS_IAM",
)
print(gateway["gatewayId"], gateway["gatewayUrl"])

while client.get_gateway(gatewayIdentifier=gateway["gatewayId"])["status"] != "READY":
    time.sleep(5)

client.create_gateway_target(
    gatewayIdentifier=gateway["gatewayId"],
    name="bedrock-mantle",
    credentialProviderConfigurations=[{"credentialProviderType": "GATEWAY_IAM_ROLE"}],
    targetConfiguration={"inference": {"connector": {"source": {"connectorId": "bedrock-mantle"}}}},
)
uv run setup.py
Gatewayの /inference/v1/messages へSigV4署名を付けてリクエストする関数と、決めた時間だけ呼び出し続けて結果を数える関数です。<GATEWAY_ID> は setup.py の出力に置き換えます。
import json

import boto3
import requests
from botocore.auth import SigV4Auth
from botocore.awsrequest import AWSRequest

GATEWAY_URL = "https://<GATEWAY_ID>.gateway.bedrock-agentcore.us-east-1.amazonaws.com"
credentials = boto3.Session().get_credentials()

def call(headers=None, body_extra=None):
    body = {
        "model": "anthropic.claude-haiku-4-5",
        "anthropic_version": "bedrock-2023-05-31",
        "max_tokens": 16,
        "messages": [{"role": "user", "content": "hi"}],
        **(body_extra or {}),
    }
    req = AWSRequest(
        method="POST",
        url=f"{GATEWAY_URL}/inference/v1/messages",
        data=json.dumps(body),
        headers={"Content-Type": "application/json", **(headers or {})},
    )
    SigV4Auth(credentials, "bedrock-agentcore", "us-east-1").add_auth(req)
    res = requests.post(req.url, data=req.body, headers=dict(req.headers))
    return res.status_code, res.text
import time
from collections import Counter
from concurrent.futures import ThreadPoolExecutor

def keep_calling(fn, seconds, interval):
    counts = Counter()
    end = time.time() + seconds
    while time.time() < end:
        status, _ = fn()
        counts[status] += 1
        time.sleep(interval)
    return counts

def run(patterns, seconds=40):
    """patterns: (ラベル, 呼び出す関数, 並列数, 呼び出し間隔の秒数) のリスト"""
    with ThreadPoolExecutor(max_workers=50) as executor:
        futures = {
            label: [executor.submit(keep_calling, fn, seconds, interval) for _ in range(workers)]
            for label, fn, workers, interval in patterns
        }
    for label, fs in futures.items():
        total = sum((f.result() for f in fs), Counter())
        print(f"{label:<24} 200: {total[200]:>3}  429: {total[429]:>3}")
準備できたら早速試してみましょう!
ボディのuser_idで利用者ごとに分ける
Anthropic Messages APIのボディには利用者を識別するための metadata.user_id があるので、アプリがここに利用者IDを入れて呼び出す想定で、利用者ごとに1分あたり60リクエストの枠を作ります。
import boto3

client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")

response = client.create_gateway_rate_limit(
    gatewayIdentifier="<GATEWAY_ID>",
    rateLimitId="per-end-user",
    dimensionKeys=[
        "$.context.iam.principal",
        "$.context.request.body.metadata.user_id",
    ],
    entries=[
        {
            "dimensions": {
                "$.context.iam.principal": "*",
                "$.context.request.body.metadata.user_id": "*",
            },
            "requests": [{"rate": 60, "period": "minute"}],
        },
    ],
)
print(response["rateLimitId"], response["status"])
* は「値ごとに独立した枠を作る」という意味なので、このエントリ1つで「IAMロール × 利用者ID」ごとに60回/分の枠ができます。
uv run create_body_limit.py
30秒ほど待って反映されたら、user-aは並列5本で呼び出し続け、同じ時間にuser-cは2秒に1回だけ呼び出します。それぞれ40秒間の結果を数えます。
from call import call
from load import run

run([
    ("user-a(並列5本)", lambda: call(body_extra={"metadata": {"user_id": "user-a"}}), 5, 0),
    ("user-c(2秒に1回)", lambda: call(body_extra={"metadata": {"user_id": "user-c"}}), 1, 2),
])
user-a(並列5本)             200:  81  429:  42
user-c(2秒に1回)            200:  11  429:   0
前回の記事でも触れたとおり、レート制限は厳密な回数制御ではなく、トラフィックを流し始めた直後は設定レートを超えて通る場合があります。この挙動は公式ドキュメントにも記載されています。
同じIAMロールからの呼び出しでも、user-aが429で制限され、user-cは問題なく通っていますね!
429の応答には、どのレート制限に当たったかが limitKey で返ってきます。
{"type":"error","error":{"type":"rate_limit_error","message":"Rate limit exceeded","limitKey":"per-end-user","metric":"requests","retryAfter":1.0}}
ヘッダーで処理の種類ごとに分ける
次はヘッダーです。X-Workload: batch のリクエストを60回/分、その他のリクエストを6000回/分に設定します。
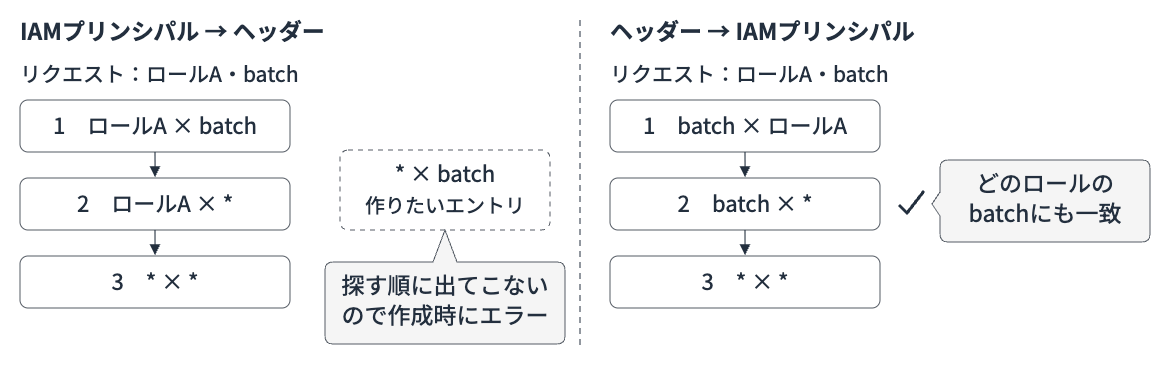
最初は「IAMプリンシパル → ヘッダー」の順に並べ、「誰でも(*)× batch」のエントリを作ろうとしたところ、エラーになりました。
ValidationException Wildcard '*' may only appear at trailing positions. Found non-wildcard value at position 1 after '*'
これはエントリの探し方によるもので、Gatewayはリクエストの値に一番近いエントリから順に探し、そのとき後ろのディメンションから1つずつ * に置き換えていきます。
| 探す順 | IAMプリンシパル | X-Workload |
|---|---|---|
| 1 | ロールA | batch |
| 2 | ロールA | * |
| 3 | * |
* |
この順番では、「* × batch」のように * の後ろに具体的な値があるエントリには一度もたどり着きません。そのため、作成時にエラーとして弾かれます。
ヘッダーを先に並べると、探す順番は次のようになります。
| 探す順 | X-Workload | IAMプリンシパル |
|---|---|---|
| 1 | batch | ロールA |
| 2 | batch | * |
| 3 | * |
* |
2番目の「batch × *」で、どのロールから来たbatchのリクエストにも一致させられます。IAMプリンシパルは何番目に置いても組み合わせの条件を満たすので、この順番で問題ありません。探す順番はドキュメントにも記載があるのでこちらも必要に応じてご参照ください。
ちょっとわかりづらいので絵も書いてみました。
どういった書き方がいいかわかったところでコードを書いてレート制限を反映します。
import boto3

client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")

response = client.create_gateway_rate_limit(
    gatewayIdentifier="<GATEWAY_ID>",
    rateLimitId="per-workload",
    dimensionKeys=[
        "$.context.request.header.X-Workload",
        "$.context.iam.principal",
    ],
    entries=[
        {
            "dimensions": {
                "$.context.request.header.X-Workload": "batch",
                "$.context.iam.principal": "*",
            },
            "requests": [{"rate": 60, "period": "minute"}],
        },
        {
            "dimensions": {
                "$.context.request.header.X-Workload": "*",
                "$.context.iam.principal": "*",
            },
            "requests": [{"rate": 6000, "period": "minute"}],
        },
    ],
)
print(response["rateLimitId"], response["status"])
反映後、ヘッダーの書き方を変えた5パターンを、それぞれ並列3本で40秒間同時に呼び出しました。
from call import call
from load import run

run([
    ("X-Workload: batch", lambda: call({"X-Workload": "batch"}), 3, 0),
    ("x-workload: batch", lambda: call({"x-workload": "batch"}), 3, 0),
    ("X-Workload: Batch", lambda: call({"X-Workload": "Batch"}), 3, 0),
    ("X-Workload: chat", lambda: call({"X-Workload": "chat"}), 3, 0),
    ("(ヘッダーなし)", lambda: call(), 3, 0),
])
X-Workload: batch        200:  36  429:  44
x-workload: batch        200:  37  429:  42
X-Workload: Batch        200:  66  429:   0
X-Workload: chat         200:  64  429:   0
(ヘッダーなし)                 200:  66  429:   0
batchで429が返りました! ヘッダー名を小文字にしても同じ枠として数えられています。
ちなみに、値を Batch にしたものやヘッダーを付けなかったリクエストはすべて通りました。
OpenAI形式ならsafety_identifierで分ける
OpenAI形式のAPIでは、ボディの safety_identifier が利用者を識別するフィールドなのでこちらを使用してみましょうか(以前の user は非推奨になっています)。
GPT-5.6 LunaをResponses APIで呼び出して試します。呼び出し用の関数は、call.py のパスとボディをResponses形式に変えたものです。
import json

import boto3
import requests
from botocore.auth import SigV4Auth
from botocore.awsrequest import AWSRequest

GATEWAY_URL = "https://<GATEWAY_ID>.gateway.bedrock-agentcore.us-east-1.amazonaws.com"
credentials = boto3.Session().get_credentials()

def call_openai(body_extra=None):
    body = {
        "model": "openai.gpt-5.6-luna",
        "max_output_tokens": 16,
        "input": "hi",
        **(body_extra or {}),
    }
    req = AWSRequest(
        method="POST",
        url=f"{GATEWAY_URL}/inference/v1/responses",
        data=json.dumps(body),
        headers={"Content-Type": "application/json"},
    )
    SigV4Auth(credentials, "bedrock-agentcore", "us-east-1").add_auth(req)
    res = requests.post(req.url, data=req.body, headers=dict(req.headers))
    return res.status_code, res.text
ボディの節と同じく、利用者ごとに60回/分の枠を作ります。
import boto3

client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")

response = client.create_gateway_rate_limit(
    gatewayIdentifier="<GATEWAY_ID>",
    rateLimitId="per-end-user-openai",
    dimensionKeys=[
        "$.context.iam.principal",
        "$.context.request.body.safety_identifier",
    ],
    entries=[
        {
            "dimensions": {
                "$.context.iam.principal": "*",
                "$.context.request.body.safety_identifier": "*",
            },
            "requests": [{"rate": 60, "period": "minute"}],
        },
    ],
)
print(response["rateLimitId"], response["status"])
反映後、ボディの節と同じ形でuser-aとuser-cを比べます。
from call_openai import call_openai
from load import run

run([
    ("user-a(並列5本)", lambda: call_openai({"safety_identifier": "user-a"}), 5, 0),
    ("user-c(2秒に1回)", lambda: call_openai({"safety_identifier": "user-c"}), 1, 2),
])
user-a(並列5本)             200:  77  429:  51
user-c(2秒に1回)            200:  11  429:   0
OpenAI形式でも、safety_identifierの値で枠を分けられました!
注意点
呼び出し側が書いた値で枠を分けるので、使う前に押さえておきたい点がいくつかあります。
値の扱い
ヘッダーやボディの値は、次のルールで扱われます。
- ボディのパスにはドット区切りのフィールド名を指定します。末尾の値は文字列・数値・真偽値に対応しています。
- 値の前後の空白は取り除かれますが、大文字小文字は区別されます(
goldとGoldは別の枠)。 - ヘッダーがない、パスが存在しない、値に
/|,*が含まれる、といった場合はそのレート制限ごとスキップされ、リクエストは通ります。
ドキュメントでは「Selector syntax and value constraints」と「Dimension resolution behavior」の節に記載があります。
/ を含む値は制限されない
利用者IDを org/user-a のような形式にすると、並列5本で40秒間呼び出しても一度も429になりませんでした。
from call import call
from load import run

run([
    ("user_id: org/user-a", lambda: call(body_extra={"metadata": {"user_id": "org/user-a"}}), 5, 0),
])
user_id: org/user-a 200: 109 429: 0
組織とユーザーをつないだIDのように / を含む形式を使用していると評価自体が無効化されるため、入力値の形式には注意が必要です。
値を変えれば別の枠になる
ヘッダーの結果のとおり、値を少し変えるかヘッダーを外せば、batch向けの枠を受けずに呼び出せます。ボディの利用者IDも同じで、呼び出し側がIDを変えれば別の枠になります。
そのため、この機能はバックエンドが必ず正しい値を入れてくると信頼できる呼び出し元の流量を分ける用途に向いています。
呼び出し元ごとの合計にも上限をかけたい場合は、IAMプリンシパルで分けるレート制限を別に作って併用します。複数のレート制限を設定した場合、すべての制限を通過したリクエストが実行されます(AND評価)。
試しに呼び出し元ごと60回/分の枠を追加しました。
import boto3

client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")

client.create_gateway_rate_limit(
    gatewayIdentifier="<GATEWAY_ID>",
    rateLimitId="per-caller",
    dimensionKeys=["$.context.iam.principal"],
    entries=[
        {
            "dimensions": {"$.context.iam.principal": "*"},
            "requests": [{"rate": 60, "period": "minute"}],
        },
    ],
)
この状態で、呼び出すたびに利用者IDを変えながら、並列5本で40秒間呼び出します。
import itertools
import json
import threading
import time
from collections import Counter
from concurrent.futures import ThreadPoolExecutor

from call import call

counter = itertools.count()
counts = Counter()
lock = threading.Lock()

def worker(seconds=40):
    end = time.time() + seconds
    while time.time() < end:
        # 呼び出すたびに別の利用者IDにする
        status, text = call(body_extra={"metadata": {"user_id": f"user-{next(counter)}"}})
        limit_key = json.loads(text)["error"]["limitKey"] if status == 429 else "-"
        with lock:
            counts[(status, limit_key)] += 1

with ThreadPoolExecutor(max_workers=5) as executor:
    for _ in range(5):
        executor.submit(worker)

for (status, limit_key), n in sorted(counts.items()):
    print(f"{status} limitKey={limit_key}: {n}")
200 limitKey=-: 73
429 limitKey=per-caller: 52
利用者IDごとの枠はどれも1回目なので空いていますが、追加した per-caller の枠で止まりました。利用者ごとの枠と呼び出し元全体の上限を、2つのレート制限で個別に管理できます。
おまけ 値の入れ忘れはCedarで止められる?
本来はバックエンドが必ず正しい値を入れる作りにしてほしいところです。とはいえ値を入れ忘れたリクエストはレート制限をすり抜けてしまうので、Gateway側でも止められないかAgentCore Policyで試してみました。
Policy Engineを作ってGatewayにENFORCEモードでアタッチし、値が入っていなければ拒否するポリシーを入れます。Policyの基本的な使い方は以前の記事で紹介しています。
結論として、推論ターゲットへのリクエストでは、Cedarの context.input から参照できるボディのフィールドが限られていました。今回試した結果は次のとおりです。
| API | フィールド | Cedarで参照できたか |
|---|---|---|
| Anthropic Messages | metadata.user_id |
できない |
| OpenAI Chat Completions | user |
できる |
| OpenAI Chat Completions / Responses | safety_identifier |
できない |
参照できなかったフィールドは、リクエストに入れていても「入っていない」と判定され、すべて拒否されました。必須にできたのはChat Completionsの user だけです。
Policy Engineの準備
Gatewayの実行ロールに、ポリシー評価の権限を付けます。
aws iam put-role-policy \
  --role-name rate-limit-demo-gateway-role \
  --policy-name policy-engine-permissions \
  --policy-document '{
    "Version": "2012-10-17",
    "Statement": [{
      "Effect": "Allow",
      "Action": [
        "bedrock-agentcore:GetPolicyEngine",
        "bedrock-agentcore:AuthorizeAction",
        "bedrock-agentcore:PartiallyAuthorizeActions"
      ],
      "Resource": [
        "arn:aws:bedrock-agentcore:us-east-1:<ACCOUNT_ID>:policy-engine/<ENGINE_ID>",
        "arn:aws:bedrock-agentcore:us-east-1:<ACCOUNT_ID>:gateway/*"
      ]
    }]
  }'
Policy Engineを作成し、GatewayにENFORCEモードでアタッチします。
import boto3

client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")

engine = client.create_policy_engine(name="RlDimsDemoEngine")
print(engine["policyEngineId"])

gw = client.get_gateway(gatewayIdentifier="<GATEWAY_ID>")
client.update_gateway(
    gatewayIdentifier=gw["gatewayId"],
    name=gw["name"],
    roleArn=gw["roleArn"],
    protocolType=gw["protocolType"],
    authorizerType=gw["authorizerType"],
    policyEngineConfiguration={"arn": engine["policyEngineArn"], "mode": "ENFORCE"},
)
ENFORCEモードはデフォルト拒否なので、全許可のポリシーと、user がなければ拒否するポリシーの2本を入れます。
import boto3

client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")
ENGINE_ID = "<ENGINE_ID>"
GATEWAY_ARN = "<GATEWAY_ARN>"

policies = {
    # ENFORCEモードはデフォルト拒否なので、まず全許可を入れる
    "allow_all": f'permit (principal, action, resource == AgentCore::Gateway::"{GATEWAY_ARN}");',
    # userが入っていないChat Completionsのリクエストを拒否する
    "require_user": (
        'forbid (principal, action == AgentCore::Action::"bedrock-mantle___POST:/v1/chat/completions", '
        f'resource == AgentCore::Gateway::"{GATEWAY_ARN}")\n'
        "unless { context.input has user };"
    ),
}
for name, statement in policies.items():
    client.create_policy(
        policyEngineId=ENGINE_ID,
        name=name,
        definition={"cedar": {"statement": statement}},
        validationMode="IGNORE_ALL_FINDINGS",
    )
Chat Completions 形式で呼び出せる gpt-oss-120b で、user の有無を比べます。
check_user_required.py
import json

import boto3
import requests
from botocore.auth import SigV4Auth
from botocore.awsrequest import AWSRequest

GATEWAY_URL = "https://<GATEWAY_ID>.gateway.bedrock-agentcore.us-east-1.amazonaws.com"
credentials = boto3.Session().get_credentials()

def call_chat(body_extra=None):
    body = {
        "model": "openai.gpt-oss-120b",
        "max_tokens": 16,
        "messages": [{"role": "user", "content": "hi"}],
        **(body_extra or {}),
    }
    req = AWSRequest(
        method="POST",
        url=f"{GATEWAY_URL}/inference/v1/chat/completions",
        data=json.dumps(body),
        headers={"Content-Type": "application/json"},
    )
    SigV4Auth(credentials, "bedrock-agentcore", "us-east-1").add_auth(req)
    res = requests.post(req.url, data=req.body, headers=dict(req.headers))
    return res.status_code, res.text

for label, extra in [("user", {"user": "user-a"}), ("no user", None)]:
    status, text = call_chat(extra)
    print(label, status, "" if status == 200 else text)
user 200
no user 403 {"error":{"message":"Request Denied: Gateway Target request not allowed due to policy enforcement [Policy evaluation denied due to require_user-djgb74zm3l]","type":"permission_error","code":"403"}}
user を入れ忘れたリクエストだけ、Policyで止められました! ただ、Anthropic Messagesの metadata.user_id は参照できなかったので、この記事のメインの例ではCedarでの必須化はできません。入れ忘れ対策は結局バックエンド側で必ず値を入れる作りにしておくのが確実そうです。
検証済みのIDなしでは作成できない
ドキュメントにあるとおり、検証済みのIDを入れずにヘッダーやボディのディメンションだけでレート制限を作ろうとすると作成時に拒否されます。
body-only -> ValidationException Custom request header/body dimensions require an IAM co-dimension in the same rate limit
header-only -> ValidationException Custom request header/body dimensions require an IAM co-dimension in the same rate limit
そもそも呼び出し側がどんな値を送ってくるかはGatewayでは確かめられません。値の正しさは呼び出し側次第なので、枠を検証済みのIDの中に閉じておく仕様はなんとなく理解できますね。
後片付け
レート制限、ターゲット、Gatewayの順に削除します。
import sys
import time

import boto3

region, gw = sys.argv[1], sys.argv[2]
client = boto3.client("bedrock-agentcore-control", region_name=region)

for rate_limit in client.list_gateway_rate_limits(gatewayIdentifier=gw)["rateLimits"]:
    client.delete_gateway_rate_limit(gatewayIdentifier=gw, rateLimitId=rate_limit["rateLimitId"])

for target in client.list_gateway_targets(gatewayIdentifier=gw)["items"]:
    client.delete_gateway_target(gatewayIdentifier=gw, targetId=target["targetId"])

while client.list_gateway_targets(gatewayIdentifier=gw)["items"]:
    time.sleep(5)
client.delete_gateway(gatewayIdentifier=gw)
uv run cleanup.py us-east-1 <GATEWAY_ID>
Policy Engineを作った場合は、Gatewayを削除したあとにポリシーとPolicy Engineも削除します。
import time

import boto3

client = boto3.client("bedrock-agentcore-control", region_name="us-east-1")
ENGINE_ID = "<ENGINE_ID>"

for policy in client.list_policies(policyEngineId=ENGINE_ID)["policies"]:
    client.delete_policy(policyEngineId=ENGINE_ID, policyId=policy["policyId"])

while client.list_policies(policyEngineId=ENGINE_ID)["policies"]:
    time.sleep(5)
client.delete_policy_engine(policyEngineId=ENGINE_ID)
IAMロールが不要になった場合は、aws iam delete-role-policy と aws iam delete-role で削除してください。
おわりに
1つのIAMロールの裏にいる利用者ごとに枠を分けられるのはアプリのバックエンドからGatewayを呼ぶ構成だと便利そうですね!ヘッダーやボディでレート制限を実現できてより、幅が広がるアップデートでした!
本記事が少しでも参考になりましたら幸いです。最後までご覧いただきありがとうございました!