Amazon Connect Customerで音声・チャット終了後にリアルタイム文字起こしを要約してコンタクト属性へ保存してみた

はじめに
Amazon Connect Customer Contact Lens では、会話の文字起こしや分析結果を取得する方法として、主に以下の2種類があります。
- 通話後の分析
- リアルタイム分析
通話後の分析は、コンタクト終了後に文字起こしや分析を実施する方式です。以前、通話後の分析結果を利用して会話内容を日本語で要約し、コンタクト詳細に表示する方法を紹介しました。
この方式では、S3 バケットへのファイルアップロードをトリガーに要約処理を開始するため、要約を確認できるまでに数分かかることがありました。
そこで前回は、音声通話のリアルタイム分析結果を取得し、通話終了後に要約をコンタクト属性へ保存する方法を紹介しました。
今回は、この仕組みを拡張して、音声通話とチャットの両方を1つの Lambda 関数で処理します。コンタクト終了イベントを契機にリアルタイム分析の文字起こしを取得し、Amazon Bedrock で生成した要約をコンタクト属性へ保存します。
Lambda 関数の処理が完了すると、Amazon Connect Customer のコンタクト詳細画面に要約を表示できます。
なお、リアルタイム分析の文字起こし精度は、通話後の分析と比べて差が出る場合があります。精度を最優先する用途では、通話後の分析を利用するか、実際の会話データで要約品質を確認してから導入してください。
全体像
今回の構成では、Amazon EventBridge で Amazon Connect Customer のコンタクト終了イベントを受信し、Lambda 関数を実行します。
Lambda 関数はイベント内の channel を確認し、音声通話なら ListRealtimeContactAnalysisSegments、チャットなら ListRealtimeContactAnalysisSegmentsV2 を呼び出します。その後、取得した文字起こしを Amazon Bedrock に渡して要約を生成し、UpdateContactAttributes でコンタクト属性に保存します。
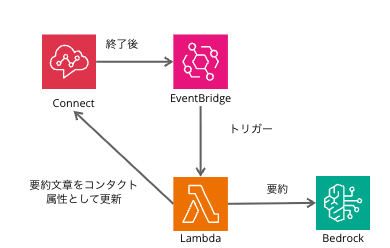
音声通話とチャットで共通の Lambda 関数を実行し、チャネルごとに文字起こし取得 API を切り替える構成
処理の流れは以下のとおりです。
- 音声通話またはチャットが終了する
- EventBridge ルールがコンタクト終了イベントを検知し、Lambda 関数を実行する
- Lambda 関数が
channelを確認して、音声通話またはチャットを判定する - チャネルに対応する API でリアルタイム分析の文字起こしを取得する
- Lambda 関数が Amazon Bedrock に文字起こしを渡し、要約を生成する
UpdateContactAttributesを使用して、要約をrealtimesummary属性としてコンタクトに保存する
使用するリアルタイム分析 API
Amazon Connect Customer Contact Lens には、リアルタイム分析結果を取得する API が2種類あります。音声通話とチャットでは利用する API が異なります。
| チャネル | API | boto3 クライアント |
|---|---|---|
| 音声通話 | ListRealtimeContactAnalysisSegments |
connect-contact-lens |
| チャット | ListRealtimeContactAnalysisSegmentsV2 |
connect |
音声通話用 API
ListRealtimeContactAnalysisSegments は、音声通話のリアルタイム分析セグメントを取得する API です。
音声データは24時間保持されるため、この API はコンタクト終了後24時間以内に呼び出す必要があります。今回のように終了イベントをトリガーに Lambda 関数を実行する構成では、この制約を満たしやすくなります。
チャット用 API
ListRealtimeContactAnalysisSegmentsV2 は、チャットのリアルタイム分析セグメントを取得する API です。この API は CHAT チャネル専用であり、VOICE チャネルに対して呼び出すと InvalidRequestException になります。
また、OutputType と SegmentTypes の指定が必須です。今回は、マスキングされていない文字起こしを取得するため、以下を指定します。
OutputType:RawSegmentTypes:Transcript
チャットでインフライト秘匿化を有効にし、出力ポリシーを RedactedOnly にしている場合は、OutputType に Raw を指定できません。その場合は Redacted を指定してください。
Lambda 関数を作成する
今回の検証では、Lambda 関数を以下の設定で作成しました。
| 項目 | 値 |
|---|---|
| ランタイム | Python 3.14 |
| タイムアウト | 20 秒 |
| メモリ | 128 MB |
| リージョン | ap-northeast-1 |
IAM ロールを設定する
Lambda 関数の実行ロールには、以下の権限を付与します。
- Amazon Bedrock のモデルを呼び出すための
bedrock:InvokeModel - 音声通話の文字起こしを取得するための
connect:ListRealtimeContactAnalysisSegments - チャットの文字起こしを取得するための
connect:ListRealtimeContactAnalysisSegmentsV2 - コンタクト属性を更新するための
connect:UpdateContactAttributes
CloudWatch Logs へのログ出力には、AWS 管理ポリシーの AWSLambdaBasicExecutionRole をアタッチします。
以下は、Amazon Connect Customer のインスタンス ID が 3ff2093d-af96-43fd-b038-3c07cdd7609c の場合のポリシー例です。アカウント ID、リージョン、インスタンス ID は利用する環境に合わせて置き換えてください。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "InvokeBedrockModel",
      "Effect": "Allow",
      "Action": "bedrock:InvokeModel",
      "Resource": "*"
    },
    {
      "Sid": "ReadAndUpdateConnectContact",
      "Effect": "Allow",
      "Action": [
        "connect:ListRealtimeContactAnalysisSegments",
        "connect:ListRealtimeContactAnalysisSegmentsV2",
        "connect:UpdateContactAttributes"
      ],
      "Resource": "arn:aws:connect:ap-northeast-1:111111111111:instance/3ff2093d-af96-43fd-b038-3c07cdd7609c/contact/*"
    }
  ]
}
UpdateContactAttributes は、進行中のコンタクトと終了済みのコンタクトのどちらにもコンタクト属性を作成または更新できる API です。
Lambda 関数のコード
以下のコードでは、EventBridge イベントから contactId、initialContactId、instanceArn、channel を取得します。
文字起こし取得には contactId を使用し、要約をコンタクト属性へ保存する際には initialContactId を使用します。転送が発生した場合でも、最初のコンタクトレコードに属性を保存するためです。
import json
import os
import time

import boto3

MODEL_ID = os.environ["MODEL_ID"]

MAX_RESULTS = 100
CHAT_OUTPUT_TYPE = "Raw"
CHAT_SEGMENT_TYPES = ["Transcript"]

EMPTY_RESULT_RETRY_COUNT = 3
EMPTY_RESULT_RETRY_SECONDS = 1

connect_lens_client = boto3.client("connect-contact-lens")
connect_client = boto3.client("connect")
bedrock_client = boto3.client("bedrock-runtime")

def validate_and_extract_ids(detail: dict) -> tuple[str, str, str, str]:
    contact_id = detail.get("contactId")
    initial_contact_id = detail.get("initialContactId", contact_id)
    instance_arn = detail.get("instanceArn")
    channel = detail.get("channel")

    if not contact_id or not initial_contact_id or not instance_arn or not channel:
        raise ValueError("Event detail is missing required fields.")

    try:
        instance_id = instance_arn.rsplit("/", maxsplit=1)[-1]
    except IndexError as error:
        raise ValueError(f"Invalid instanceArn format: {instance_arn}") from error

    return contact_id, initial_contact_id, instance_id, channel.upper()

def extract_transcript(segment: dict, sort_key) -> dict | None:
    transcript = segment.get("Transcript")

    if not transcript:
        return None

    content = transcript.get("Content", "").strip()

    if not content:
        return None

    return {
        "participant": transcript.get("ParticipantRole", "UNKNOWN"),
        "content": content,
        "sort_key": sort_key,
    }

def fetch_voice_transcripts(instance_id: str, contact_id: str) -> list[dict]:
    transcripts = []
    next_token = None

    print(f"Fetching voice transcripts. ContactId={contact_id}")

    while True:
        params = {
            "InstanceId": instance_id,
            "ContactId": contact_id,
            "MaxResults": MAX_RESULTS,
        }

        if next_token:
            params["NextToken"] = next_token

        response = connect_lens_client.list_realtime_contact_analysis_segments(
            **params
        )

        for segment in response.get("Segments", []):
            transcript = segment.get("Transcript", {})
            sort_key = transcript.get("BeginOffsetMillis", 0)

            normalized_transcript = extract_transcript(segment, sort_key)

            if normalized_transcript:
                transcripts.append(normalized_transcript)

        next_token = response.get("NextToken")

        if not next_token:
            break

    return sorted(transcripts, key=lambda item: item["sort_key"])

def fetch_chat_transcripts(instance_id: str, contact_id: str) -> list[dict]:
    transcripts = []
    next_token = None

    print(f"Fetching chat transcripts. ContactId={contact_id}")

    while True:
        params = {
            "InstanceId": instance_id,
            "ContactId": contact_id,
            "MaxResults": MAX_RESULTS,
            "OutputType": CHAT_OUTPUT_TYPE,
            "SegmentTypes": CHAT_SEGMENT_TYPES,
        }

        if next_token:
            params["NextToken"] = next_token

        response = connect_client.list_realtime_contact_analysis_segments_v2(
            **params
        )

        for segment in response.get("Segments", []):
            transcript = segment.get("Transcript", {})
            absolute_time = transcript.get("Time", {}).get("AbsoluteTime", "")

            normalized_transcript = extract_transcript(segment, absolute_time)

            if normalized_transcript:
                transcripts.append(normalized_transcript)

        next_token = response.get("NextToken")

        if not next_token:
            break

    return sorted(transcripts, key=lambda item: item["sort_key"])

def fetch_transcripts_with_retry(
    channel: str,
    instance_id: str,
    contact_id: str,
) -> list[dict]:
    for attempt in range(EMPTY_RESULT_RETRY_COUNT):
        if channel == "VOICE":
            transcripts = fetch_voice_transcripts(instance_id, contact_id)
        elif channel == "CHAT":
            transcripts = fetch_chat_transcripts(instance_id, contact_id)
        else:
            raise ValueError(f"Unsupported channel: {channel}")

        if transcripts:
            return transcripts

        if attempt < EMPTY_RESULT_RETRY_COUNT - 1:
            print(
                "No transcripts found. "
                f"Retrying after {EMPTY_RESULT_RETRY_SECONDS} second(s)."
            )
            time.sleep(EMPTY_RESULT_RETRY_SECONDS)

    return []

def generate_summary(full_text: str) -> str:
    prompt = f"""
以下の会話ログを要約してください。

<conversation>
{full_text}
</conversation>

要約の条件:
1. 「【問い合わせ】... / 【対応】... / 【結論】...」の形式で出力すること。
2. 改行を含めず、1行で出力すること。
3. 簡潔にまとめること。
4. 会話ログにない内容を補完しないこと。
"""

    response = bedrock_client.converse(
        modelId=MODEL_ID,
        messages=[
            {
                "role": "user",
                "content": [
                    {
                        "text": prompt
                    }
                ],
            }
        ],
        inferenceConfig={
            "maxTokens": 1000,
            "temperature": 0.0,
        },
    )

    content_list = response["output"]["message"]["content"]

    if not content_list:
        raise RuntimeError("Bedrock returned an empty response.")

    summary = content_list[0].get("text", "").replace("\n", " ").strip()

    if not summary:
        raise RuntimeError("Generated summary is empty.")

    return summary

def update_contact_attributes(
    instance_id: str,
    initial_contact_id: str,
    summary: str,
) -> None:
    connect_client.update_contact_attributes(
        InstanceId=instance_id,
        InitialContactId=initial_contact_id,
        Attributes={
            "realtimesummary": summary
        },
    )

    print(
        "Contact attributes updated. "
        f"InitialContactId={initial_contact_id}"
    )

def lambda_handler(event, context):
    print(json.dumps(event, ensure_ascii=False))

    detail = event.get("detail", {})

    contact_id, initial_contact_id, instance_id, channel = validate_and_extract_ids(
        detail
    )

    print(
        "Processing contact. "
        f"ContactId={contact_id}, "
        f"InitialContactId={initial_contact_id}, "
        f"Channel={channel}"
    )

    transcripts = fetch_transcripts_with_retry(
        channel=channel,
        instance_id=instance_id,
        contact_id=contact_id,
    )

    if not transcripts:
        print("No transcripts found.")
        return {
            "statusCode": 200,
            "body": "No transcripts found.",
        }

    full_text = "\n".join(
        f"[{item['participant']}] {item['content']}"
        for item in transcripts
    )

    summary = generate_summary(full_text)

    print("Generated summary:")
    print(summary)

    update_contact_attributes(
        instance_id=instance_id,
        initial_contact_id=initial_contact_id,
        summary=summary,
    )

    return {
        "statusCode": 200,
        "body": "Success",
    }
このコードでは、音声通話とチャットの文字起こしを取得する処理を分けていますが、Amazon Bedrock による要約生成とコンタクト属性の更新処理は共通化しています。
また、リアルタイム分析のセグメント配列の順序を前提にせず、音声通話では BeginOffsetMillis、チャットでは AbsoluteTime を使って並び替えています。これにより、ページネーションを含む応答を取得した場合も、時系列順に近い会話ログを Amazon Bedrock へ渡せます。
チャット用 API のレスポンスを整形する
ListRealtimeContactAnalysisSegmentsV2 のレスポンスには、文字起こし以外にもカテゴリや分析結果など、複数種類のセグメントが含まれる場合があります。
今回は SegmentTypes に Transcript を指定しているため、会話本文を含む Transcript セグメントだけを取得します。
レスポンスの例は以下のとおりです。
{
  "Channel": "CHAT",
  "Status": "COMPLETED",
  "Segments": [
    {
      "Transcript": {
        "Id": "11111111-2222-3333-4444-555555555555",
        "ParticipantId": "participant-id-1",
        "ParticipantRole": "CUSTOMER",
        "DisplayName": "Customer Name",
        "Content": "こんにちは、パスワードをリセットしたいのですが。",
        "ContentType": "text/plain",
        "Time": {
          "AbsoluteTime": "2026-01-14T23:51:30.000Z"
        },
        "Sentiment": "NEUTRAL"
      }
    },
    {
      "Transcript": {
        "Id": "22222222-3333-4444-5555-666666666666",
        "ParticipantId": "agent-id-1",
        "ParticipantRole": "AGENT",
        "DisplayName": "Support Agent",
        "Content": "かしこまりました。ご本人確認のため、生年月日をお願いします。",
        "ContentType": "text/plain",
        "Time": {
          "AbsoluteTime": "2026-01-14T23:51:35.000Z"
        },
        "Sentiment": "POSITIVE"
      }
    }
  ]
}
Lambda 関数では、各セグメントから発言者、発言内容、並び替え用の時刻だけを抽出します。Amazon Bedrock へ渡す前のデータは、以下のような形式になります。
[
    {
        "participant": "CUSTOMER",
        "content": "こんにちは、パスワードをリセットしたいのですが。",
        "sort_key": "2026-01-14T23:51:30.000Z"
    },
    {
        "participant": "AGENT",
        "content": "かしこまりました。ご本人確認のため、生年月日をお願いします。",
        "sort_key": "2026-01-14T23:51:35.000Z"
    }
]
最終的には、以下のような会話ログ文字列を生成して要約します。
[CUSTOMER] こんにちは、パスワードをリセットしたいのですが。
[AGENT] かしこまりました。ご本人確認のため、生年月日をお願いします。
Amazon Connect Customer フローを設定する
リアルタイム分析を利用するには、Amazon Connect Customer インスタンスで会話分析を有効にしたうえで、対象フローに記録・分析の設定ブロックを追加します。
今回の検証では、音声通話とチャットの両方を受け付けるフローを使用しました。
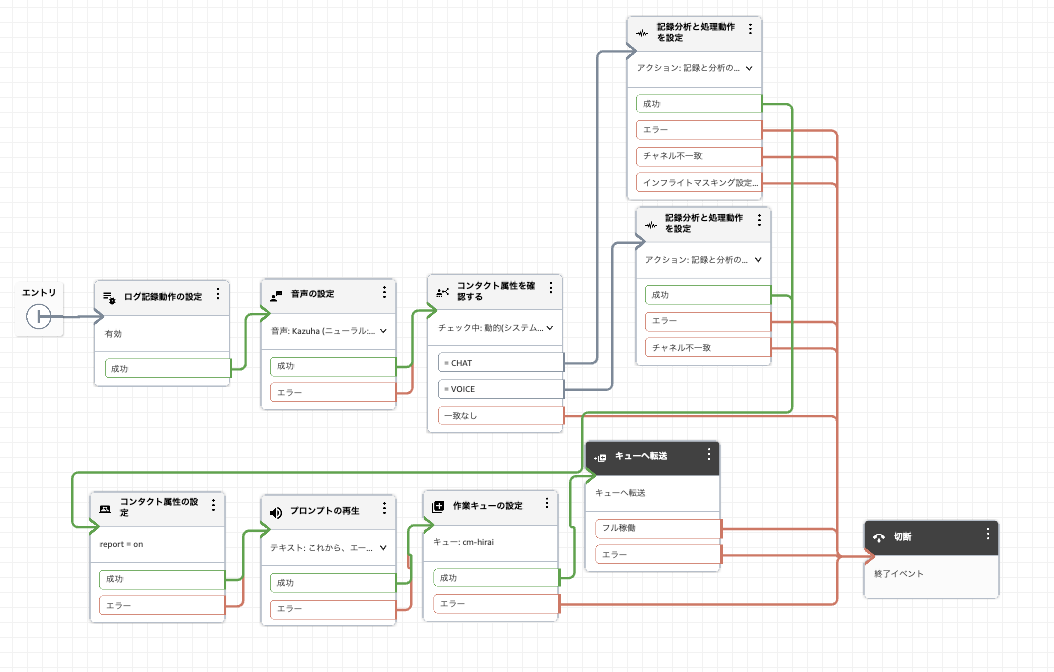
音声通話とチャットの会話分析を有効にするフロー例
音声通話の設定
音声通話では、フロー内の記録・分析設定ブロックで、エージェントと顧客の音声録音を有効にします。
さらに、分析設定でリアルタイム分析を有効にします。通話後の分析も併用する場合は、画面上で「リアルタイムおよび通話後の分析」を選択します。
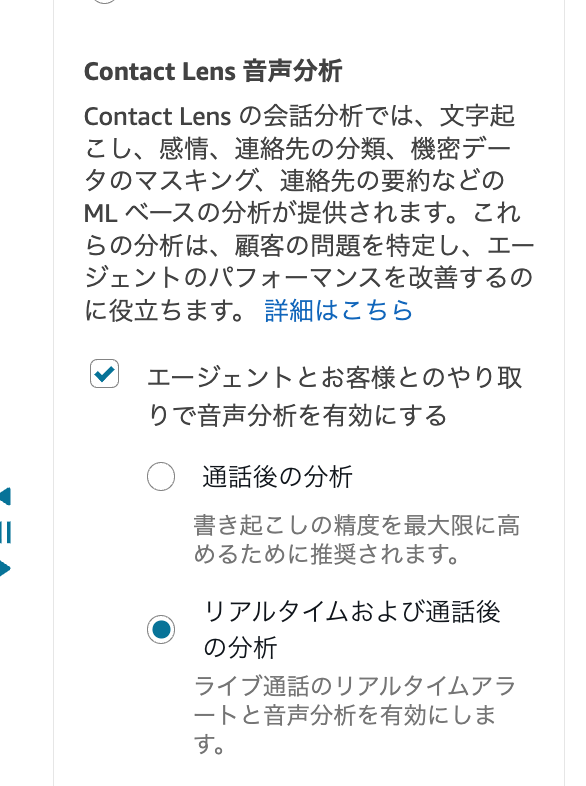
音声通話でリアルタイムおよび通話後の分析を有効にした例
音声通話で会話分析を有効にするには、エージェントと顧客の両方の音声録音を有効にする必要があります。
チャットの設定
チャットでは、同じ記録・分析設定ブロックで「会話分析を有効にする」を有効化します。
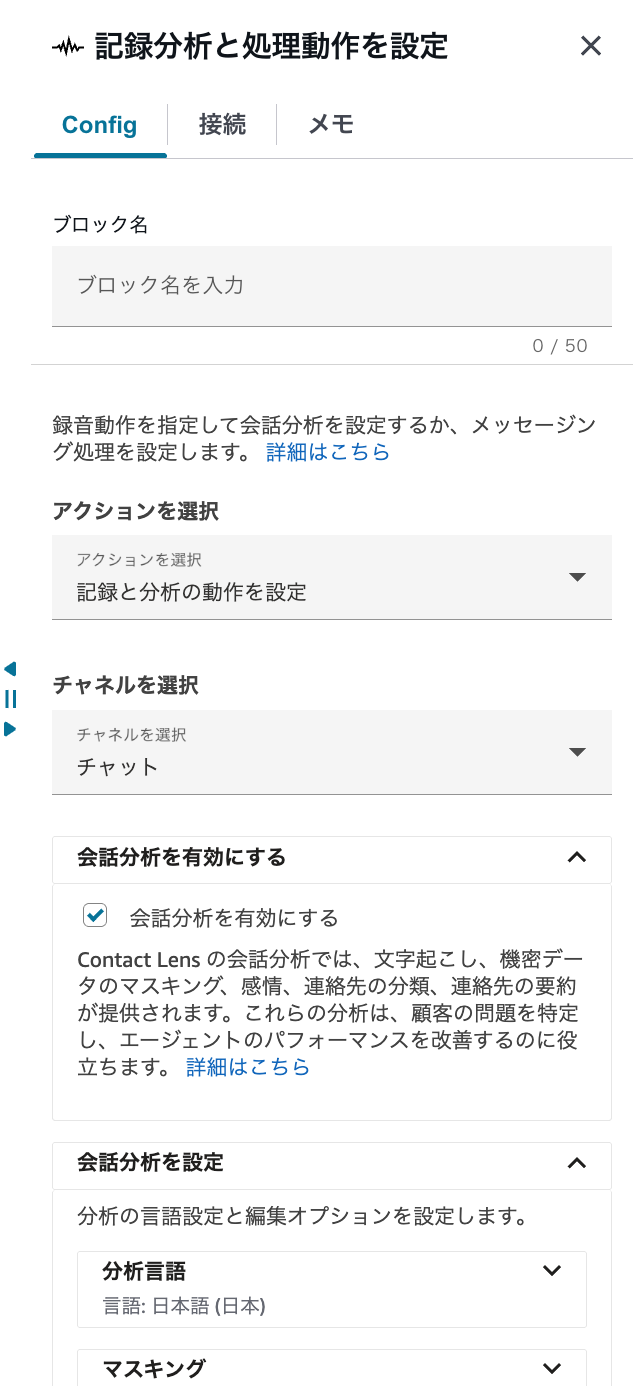
チャットで会話分析を有効にした例
コンタクト転送を行うフローでは、転送先のコンタクトでも会話分析を継続するために、転送後のフローにも記録・分析設定ブロックを配置してください。転送では別のコンタクト ID が生成されるためです。
EventBridge ルールを作成する
Amazon Connect Customer のコンタクト終了イベントを Lambda 関数のトリガーとして設定します。
以下は、ap-northeast-1 の特定インスタンスにおける、音声通話とチャットの DISCONNECTED イベントを対象とするイベントパターンです。
{
  "source": [
    "aws.connect"
  ],
  "detail-type": [
    "Amazon Connect Contact Event"
  ],
  "detail": {
    "eventType": [
      "DISCONNECTED"
    ],
    "channel": [
      "VOICE",
      "CHAT"
    ],
    "instanceArn": [
      "arn:aws:connect:ap-northeast-1:111111111111:instance/3ff2093d-af96-43fd-b038-3c07cdd7609c"
    ]
  }
}
instanceArn のアカウント ID、リージョン、インスタンス ID は、対象環境の値へ置き換えてください。
Amazon Connect Customer のコンタクトイベントには、contactId、initialContactId、channel、instanceArn などが含まれます。
Lambda 関数では channel.upper() を使用して大文字へ正規化しています。そのため、イベントの channel が VOICE または Voice の形式で渡された場合も、音声通話として処理できます。
動作確認
チャットの場合
チャットでパスワードリセットに関する問い合わせを行い、チャットを終了しました。
EventBridge ルールから Lambda 関数が実行され、ListRealtimeContactAnalysisSegmentsV2 によりチャットの文字起こしを取得しました。その後、Amazon Bedrock が以下の要約を生成しました。
【問い合わせ】パスワードリセットメールのリンクをクリックしても「リンクが無効です」というエラーが表示されログインできない。複数デバイス・ブラウザで試したが同じエラーが発生。 / 【対応】エージェントがパスワードリセットリンクを再発行し、新しいリンクを顧客に送信。 / 【結論】新しいリンクでログインに成功し、問題解決。
コンタクト詳細画面の属性セクションでは、realtimesummary 属性に生成結果を確認できました。
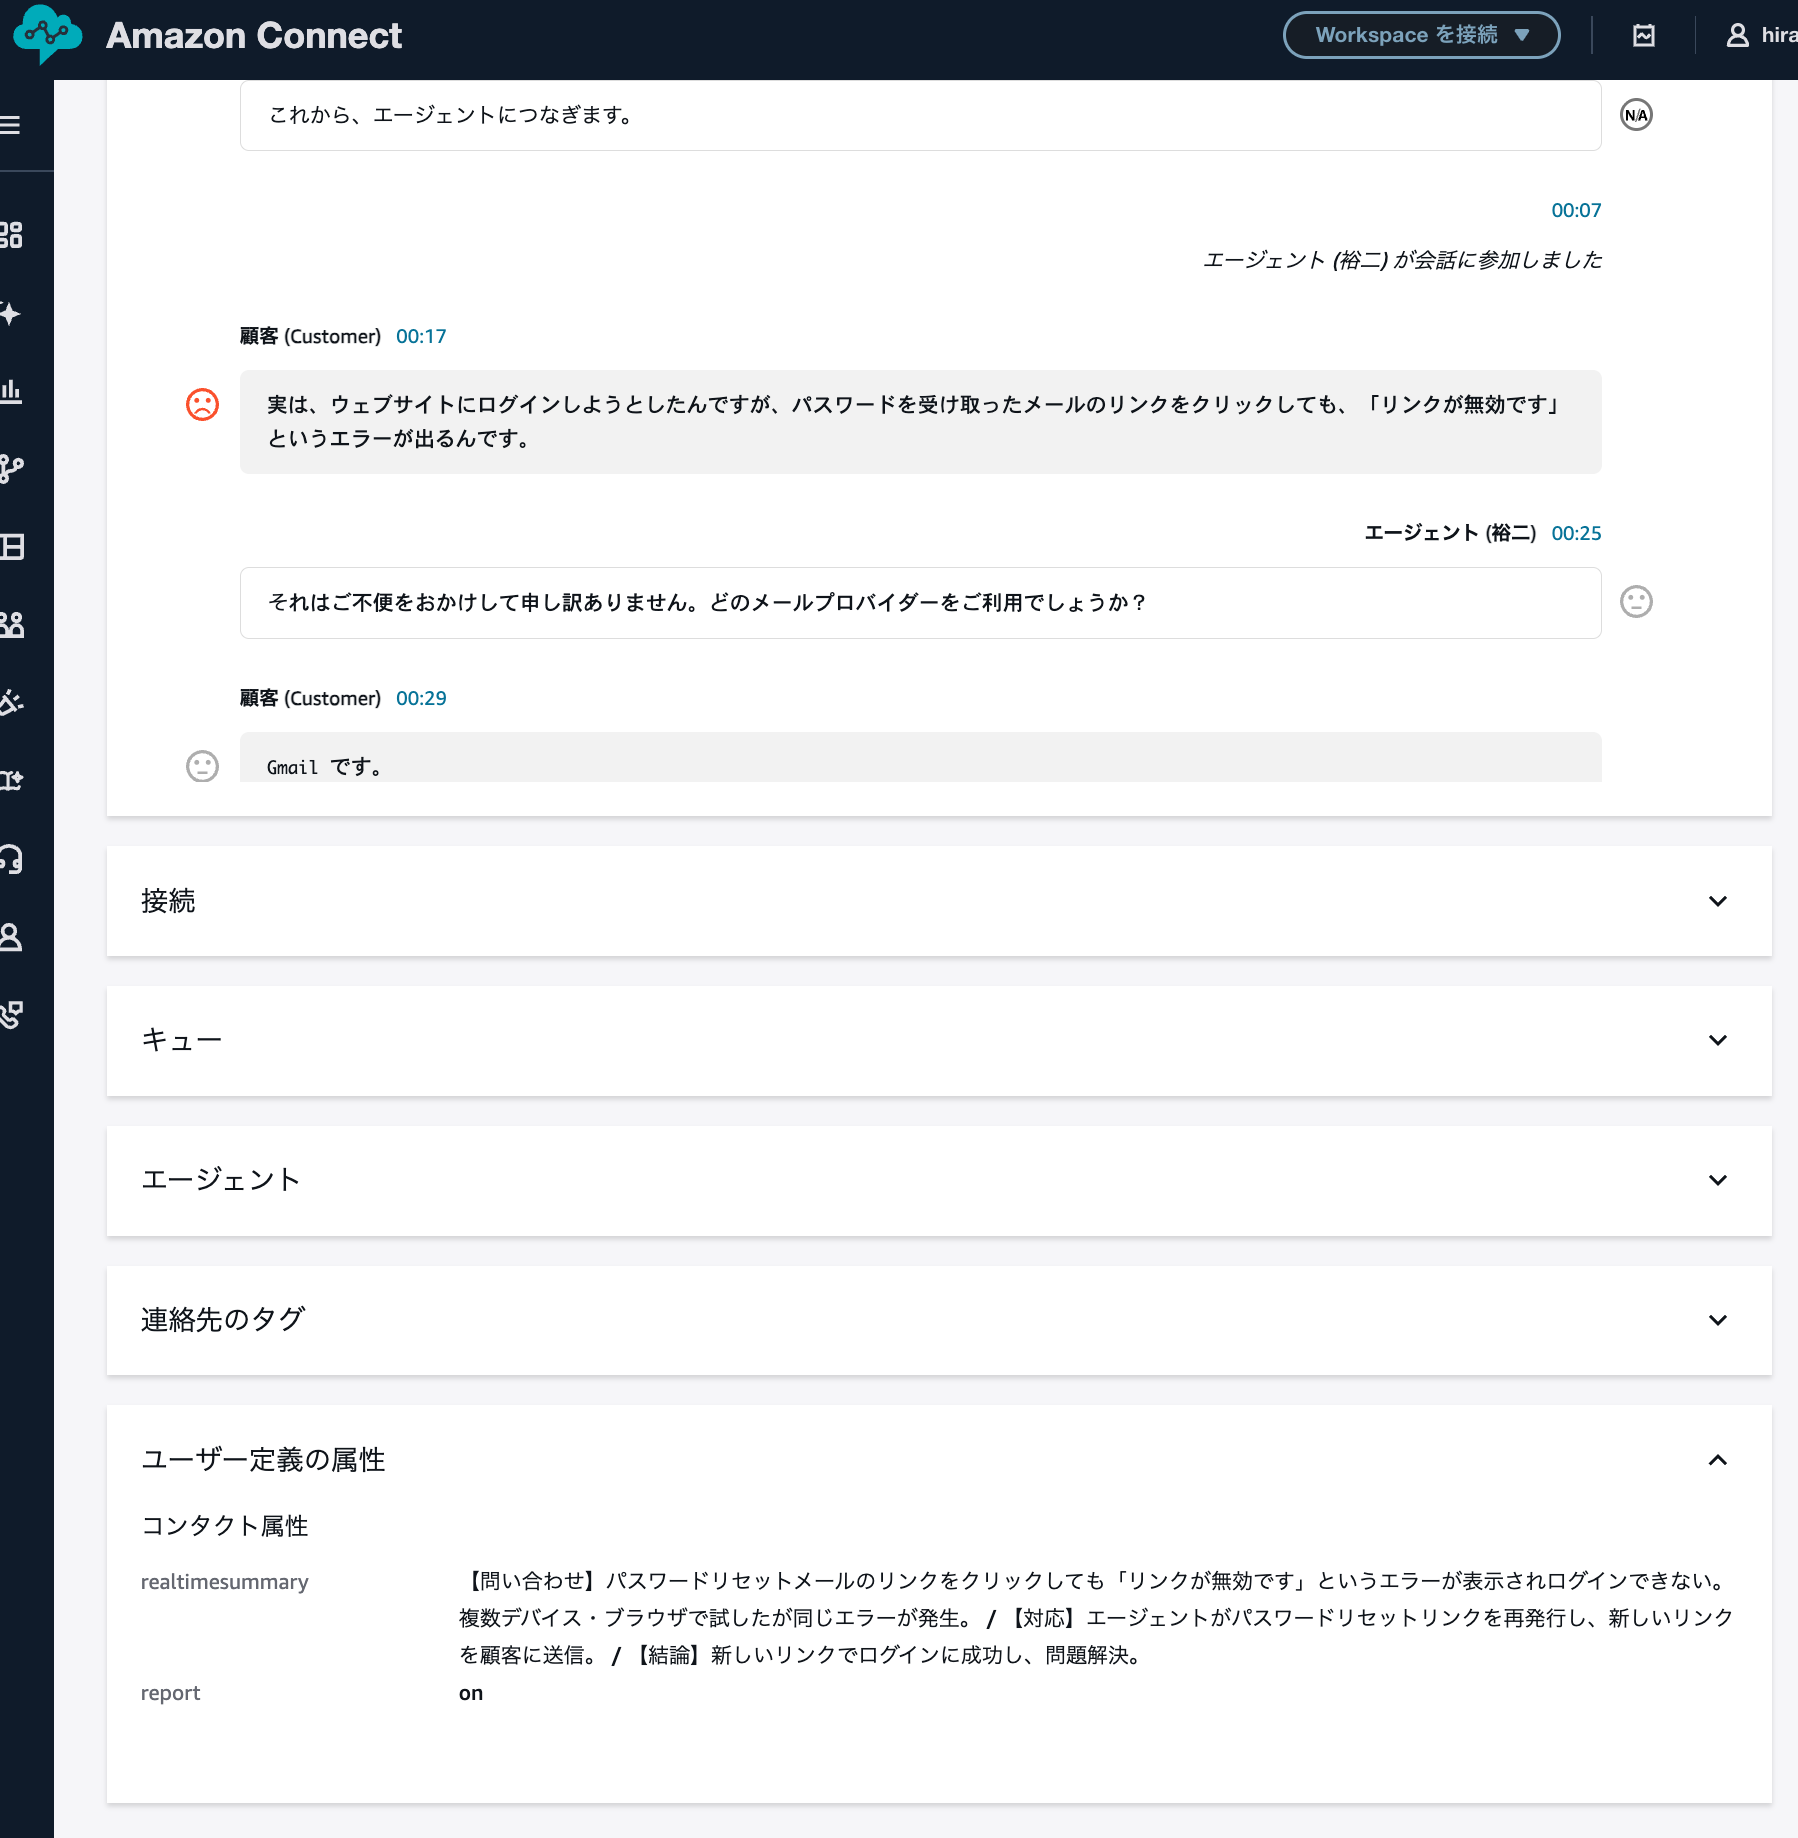
チャット終了後に realtimesummary 属性へ要約が保存された例
音声通話の場合
音声通話でも、通話終了後に同じ Lambda 関数が実行されます。
Lambda 関数は channel が VOICE であることを確認し、connect-contact-lens クライアントから ListRealtimeContactAnalysisSegments を呼び出します。取得した文字起こしを要約した後、realtimesummary 属性としてコンタクト詳細に保存できます。
今回の検証では、音声通話とチャットで Lambda 関数、Amazon Bedrock の要約プロンプト、コンタクト属性の保存処理を共通化できました。
実装時のポイント
API クライアントを正しく使い分ける
音声通話とチャットでは、API 名だけでなく boto3 クライアントも異なります。
- 音声通話の
ListRealtimeContactAnalysisSegmentsはconnect-contact-lensクライアントで呼び出す - チャットの
ListRealtimeContactAnalysisSegmentsV2はconnectクライアントで呼び出す
特にチャット用 API は connect-contact-lens ではなく connect クライアントに含まれるため、実装時に注意が必要です。
contactId と initialContactId を使い分ける
文字起こしの取得には、終了イベントに含まれる contactId を使用します。
一方、UpdateContactAttributes の InitialContactId には、コンタクトセンターとの最初のやり取りを表す ID を指定します。転送が発生したコンタクトでは、contactId と initialContactId が異なる場合があります。
そのため、要約の保存先を最初のコンタクトレコードに統一したい場合は、イベントの initialContactId を使用します。
チャットの OutputType を秘匿化設定に合わせる
チャット用 API の OutputType には Raw または Redacted を指定します。
Raw:マスキングされていない文字起こしを取得するRedacted:秘匿化された文字起こしを取得する
チャットの秘匿化ポリシーが RedactedOnly の場合、Raw は取得できません。Lambda 関数の CHAT_OUTPUT_TYPE と、Amazon Connect Customer フローの秘匿化設定を一致させてください。
コンタクト属性の容量を確認する
UpdateContactAttributes で保存できるコンタクト属性は、コンタクト全体で最大 32,768 UTF-8 バイトです。
今回のように短い1行要約を保存する構成であれば扱いやすいですが、長文の会話ログそのものをコンタクト属性に保存する用途には向いていません。要約の最大文字数をプロンプトで制御する、または Lambda 関数側で文字数を制限することを検討してください。
まとめ
Amazon Connect Customer Contact Lens のリアルタイム分析 API を利用し、音声通話とチャットの終了後に要約をコンタクト属性へ保存する方法を紹介しました。
- 音声通話とチャットでは、文字起こし取得に使用する API と boto3 クライアントが異なる
- Lambda 関数で
channelを判定することで、要約生成とコンタクト属性更新の処理を共通化できる - チャットの
OutputTypeと、コンタクト属性の容量制限を事前に確認する必要がある
通話やチャットの終了後に要約を確認できるようにすることで、後処理時間の短縮や、CRM への連携処理の起点として活用できます。