Amazon ECS の GPU 共有でコンテナごとのメモリ・演算の上限が守られるか試してみた

はじめに
2026 年 10 月 27 日、Amazon ECS が NVIDIA Multi-Process Service(MPS)による GPU 共有に対応しました。
これまで ECS のタスクには GPU を 1 枚単位でしか割り当てられず、GPU の一部しか使わない小さな推論モデルでも、GPU を 1 枚専有していました。今回の対応で、1 枚の GPU を複数のタスクで共有し、コンテナごとに GPU メモリと演算の上限を指定できるようになります。
本記事では、EC2 の g5.xlarge で、コンテナごとの上限が本当に守られるのか、複数のタスクを同時に動かすと性能はどうなるのかを検証してみます!
GPU 共有の設定
GPU 共有は、タスク定義のコンテナ定義にある resourceRequirements で、GPU を専有する場合の value の代わりに sharingStrategy を指定します。
"resourceRequirements": [
  {
    "type": "GPU",
    "sharingStrategy": {
      "nvidiaMps": {
        "memory": 4096,
        "maxComputePercent": 50
      }
    }
  }
]
memory はコンテナが使える GPU メモリの上限で、単位は MiB です。maxComputePercent は演算の上限で、1〜100 の整数で指定し、省略すると 100 になります。
ECS は GPU メモリの残量だけを見てタスクを配置し、演算の上限は配置の判断に使いません。
ドキュメントには、ECS が MPS のデーモンを起動し、コンテナごとの上限を強制すると書かれています。
検証環境
検証環境は次の通りです。
- インスタンス:g5.xlarge。GPU は NVIDIA A10G で、SM は 80 個、GPU メモリは ECS 上で 22,587 MiB
- AMI:Amazon Linux 2023 の GPU 用 ECS 最適化 AMI 2023.0.20261022
- ソフトウェア:ECS エージェント v1.108.1、Docker v25.0.16、NVIDIA ドライバー v580.178.04
- コンテナイメージ:pytorch/pytorch:2.14.1-cuda12.6-cudnn9-runtime
タスク定義は、GPU の指定だけを変えた 6 種類を用意しました。
| タスク定義 | GPU の指定 |
|---|---|
| mps-bench-dedicated | GPU を 1 枚専有 |
| mps-bench-m4096-c25 | memory 4096、maxComputePercent 25 |
| mps-bench-m4096-c50 | memory 4096、maxComputePercent 50 |
| mps-bench-m4096-c75 | memory 4096、maxComputePercent 75 |
| mps-bench-m4096 | memory 4096、maxComputePercent なし |
| mps-bench-m20480 | memory 20480、maxComputePercent なし |
計測用のスクリプトは Python と PyTorch で書き、環境変数 MODE で次の動作を切り替えます。
mem:GPU メモリを 256 MiB ずつ確保し、失敗するまでの量を記録するcompute:FP16 の 8192×8192 の行列積を繰り返し、スループットを TFLOPS で記録する
結果は 1 行の JSON でログに出力しています。想定通りに上限がかからなくても止まるよう、念のため確保するメモリと実行時間には上限を設けました。
スクリプトはイメージをビルドせずに済むよう SSM パラメータに入れ、シークレットとしてコンテナに渡しています。
CloudFormation テンプレート
AWSTemplateFormatVersion: "2010-09-09"
Description: Amazon ECS GPU sharing (NVIDIA MPS) benchmark on g5.xlarge

Parameters:
  VpcId:
    Type: AWS::EC2::VPC::Id
  SubnetIds:
    Type: List<AWS::EC2::Subnet::Id>
  DesiredCapacity:
    Type: Number
    AllowedValues: [0, 1]
    Default: 0
  BenchImage:
    Type: String
    Default: pytorch/pytorch:2.14.1-cuda12.6-cudnn9-runtime
  GpuAmiId:
    Type: AWS::SSM::Parameter::Value<AWS::EC2::Image::Id>
    Default: /aws/service/ecs/optimized-ami/amazon-linux-2023/gpu/recommended/image_id

Resources:
  Cluster:
    Type: AWS::ECS::Cluster
    Properties:
      ClusterName: mps-bench
      ClusterSettings:
        - Name: containerInsights
          Value: enhanced

  LogGroup:
    Type: AWS::Logs::LogGroup
    Properties:
      LogGroupName: /ecs/mps-bench
      RetentionInDays: 14

  BenchScript:
    Type: AWS::SSM::Parameter
    Properties:
      Name: /mps-bench/bench.py
      Type: String
      Value: |
        import json, os, time, urllib.request

        MODE = os.environ.get("MODE", "info")
        KEYS = ["CUDA_MPS_PINNED_DEVICE_MEM_LIMIT", "CUDA_MPS_ACTIVE_THREAD_PERCENTAGE",
                "CUDA_MPS_PIPE_DIRECTORY", "NVIDIA_VISIBLE_DEVICES"]
        ORIG = {k: os.environ.get(k) for k in KEYS}


        def emit(**kw):
            kw.update(run=os.environ.get("RUN_ID", ""), mode=MODE, ts=round(time.time(), 3))
            print(json.dumps(kw), flush=True)


        # 上限の強制のされ方を確かめるため、CUDA の初期化前に環境変数を書き換える
        BYPASS = os.environ.get("BYPASS", "")
        if BYPASS == "unset":
            for k in KEYS[:2]:
                os.environ.pop(k, None)
        elif BYPASS == "raise":
            os.environ["CUDA_MPS_PINNED_DEVICE_MEM_LIMIT"] = "0=20G"
            os.environ["CUDA_MPS_ACTIVE_THREAD_PERCENTAGE"] = "100"

        try:
            url = os.environ["ECS_CONTAINER_METADATA_URI_V4"] + "/task"
            TASK = json.load(urllib.request.urlopen(url, timeout=2))["TaskARN"].split("/")[-1]
        except Exception:
            TASK = None

        # 全員が揃ってから計測を始めるため、指定時刻まで待つ
        start_at = float(os.environ.get("START_AT", "0"))
        if start_at > time.time():
            time.sleep(min(start_at - time.time(), 300))

        import torch

        p = torch.cuda.get_device_properties(0)
        free, total = torch.cuda.mem_get_info()
        emit(event="info", task=TASK, bypass=BYPASS, env=ORIG,
             effective={k: os.environ.get(k) for k in KEYS[:2]},
             gpu=p.name, uuid=str(getattr(p, "uuid", "")), sms=p.multi_processor_count,
             total_mib=total >> 20, free_mib=free >> 20,
             torch=torch.__version__, cuda=torch.version.cuda)

        if MODE == "mem":
            chunk = int(os.environ.get("CHUNK_MIB", "256"))
            cap = min(int(os.environ.get("MAX_MIB", "24000")), 24000)
            bufs, err = [], None
            while len(bufs) * chunk < cap:
                try:
                    bufs.append(torch.empty(chunk << 20, dtype=torch.uint8, device="cuda"))
                except Exception as e:
                    err = f"{type(e).__name__}: {str(e)[:400]}"
                    break
            torch.cuda.synchronize()
            emit(event="mem", allocated_mib=len(bufs) * chunk, error=err)
            time.sleep(min(float(os.environ.get("HOLD_SEC", "0")), 300))

        elif MODE == "compute":
            n = int(os.environ.get("N", "8192"))
            dur = min(float(os.environ.get("DURATION", "60")), 600)
            win = float(os.environ.get("WINDOW", "5"))
            a = torch.randn(n, n, device="cuda", dtype=torch.float16)
            b = torch.randn_like(a)
            for _ in range(3):
                a @ b
            torch.cuda.synchronize()
            t_start, total_it = time.time(), 0
            while time.time() - t_start < dur and total_it < 200000:
                w0, it = time.time(), 0
                while time.time() - w0 < win:
                    for _ in range(10):
                        a @ b
                    torch.cuda.synchronize()
                    it += 10
                w1 = time.time()
                total_it += it
                emit(event="window", t0=round(w0, 3), t1=round(w1, 3),
                     tflops=round(2 * n**3 * it / (w1 - w0) / 1e12, 2))
            emit(event="compute_done", iters=total_it,
                 tflops=round(2 * n**3 * total_it / (time.time() - t_start) / 1e12, 2))

        elif MODE == "crash":
            # 範囲外のインデックスで GPU 側のアサーションを発生させる
            x = torch.zeros(8, device="cuda")
            try:
                x[torch.tensor([1 << 20], device="cuda")].sum().item()
                torch.cuda.synchronize()
                emit(event="crash", error=None)
            except Exception as e:
                emit(event="crash", error=f"{type(e).__name__}: {str(e)[:400]}")

  InstanceRole:
    Type: AWS::IAM::Role
    Properties:
      AssumeRolePolicyDocument:
        Version: "2012-10-17"
        Statement:
          - Effect: Allow
            Principal: { Service: ec2.amazonaws.com }
            Action: sts:AssumeRole
      ManagedPolicyArns:
        - arn:aws:iam::aws:policy/service-role/AmazonEC2ContainerServiceforEC2Role
        - arn:aws:iam::aws:policy/AmazonSSMManagedInstanceCore

  InstanceProfile:
    Type: AWS::IAM::InstanceProfile
    Properties:
      Roles: [!Ref InstanceRole]

  ExecutionRole:
    Type: AWS::IAM::Role
    Properties:
      AssumeRolePolicyDocument:
        Version: "2012-10-17"
        Statement:
          - Effect: Allow
            Principal: { Service: ecs-tasks.amazonaws.com }
            Action: sts:AssumeRole
      ManagedPolicyArns:
        - arn:aws:iam::aws:policy/service-role/AmazonECSTaskExecutionRolePolicy
      Policies:
        - PolicyName: read-bench-script
          PolicyDocument:
            Version: "2012-10-17"
            Statement:
              - Effect: Allow
                Action: ssm:GetParameters
                Resource: !Sub arn:aws:ssm:${AWS::Region}:${AWS::AccountId}:parameter/mps-bench/*

  InstanceSecurityGroup:
    Type: AWS::EC2::SecurityGroup
    Properties:
      GroupDescription: mps-bench instances (no inbound)
      VpcId: !Ref VpcId

  LaunchTemplate:
    Type: AWS::EC2::LaunchTemplate
    Properties:
      LaunchTemplateData:
        ImageId: !Ref GpuAmiId
        InstanceType: g5.xlarge
        IamInstanceProfile: { Arn: !GetAtt InstanceProfile.Arn }
        SecurityGroupIds: [!Ref InstanceSecurityGroup]
        MetadataOptions: { HttpTokens: required, HttpPutResponseHopLimit: 2 }
        BlockDeviceMappings:
          - DeviceName: /dev/xvda
            Ebs: { VolumeSize: 80, VolumeType: gp3, DeleteOnTermination: true }
        UserData:
          Fn::Base64: !Sub |
            #!/bin/bash
            cat >> /etc/ecs/ecs.config <<EOF
            ECS_CLUSTER=${Cluster}
            ECS_ENABLE_GPU_SUPPORT=true
            ECS_IMAGE_PULL_BEHAVIOR=prefer-cached
            EOF
            systemctl enable --now amazon-ssm-agent || (dnf install -y amazon-ssm-agent && systemctl enable --now amazon-ssm-agent)

  AutoScalingGroup:
    Type: AWS::AutoScaling::AutoScalingGroup
    Properties:
      MinSize: "0"
      MaxSize: "1"
      DesiredCapacity: !Ref DesiredCapacity
      VPCZoneIdentifier: !Ref SubnetIds
      LaunchTemplate:
        LaunchTemplateId: !Ref LaunchTemplate
        Version: !GetAtt LaunchTemplate.LatestVersionNumber
      Tags:
        - Key: Name
          Value: mps-bench
          PropagateAtLaunch: true

  TdDedicated:
    Type: AWS::ECS::TaskDefinition
    Properties:
      Family: mps-bench-dedicated
      RequiresCompatibilities: [EC2]
      NetworkMode: bridge
      ExecutionRoleArn: !GetAtt ExecutionRole.Arn
      ContainerDefinitions:
        - Name: bench
          Image: !Ref BenchImage
          Essential: true
          Cpu: 512
          Memory: 3072
          Command: ["sh", "-c", "printf '%s' \"$BENCH_SCRIPT\" > /tmp/bench.py && exec python /tmp/bench.py"]
          Secrets:
            - Name: BENCH_SCRIPT
              ValueFrom: !Ref BenchScript
          ResourceRequirements:
            - Type: GPU
              Value: "1"
          LogConfiguration:
            LogDriver: awslogs
            Options:
              awslogs-group: !Ref LogGroup
              awslogs-region: !Ref AWS::Region
              awslogs-stream-prefix: mps-bench-dedicated

  TdMps25:
    Type: AWS::ECS::TaskDefinition
    Properties:
      Family: mps-bench-m4096-c25
      RequiresCompatibilities: [EC2]
      NetworkMode: bridge
      ExecutionRoleArn: !GetAtt ExecutionRole.Arn
      ContainerDefinitions:
        - Name: bench
          Image: !Ref BenchImage
          Essential: true
          Cpu: 512
          Memory: 3072
          Command: ["sh", "-c", "printf '%s' \"$BENCH_SCRIPT\" > /tmp/bench.py && exec python /tmp/bench.py"]
          Secrets:
            - Name: BENCH_SCRIPT
              ValueFrom: !Ref BenchScript
          ResourceRequirements:
            - Type: GPU
              SharingStrategy:
                NvidiaMps:
                  Memory: 4096
                  MaxComputePercent: 25
          LogConfiguration:
            LogDriver: awslogs
            Options:
              awslogs-group: !Ref LogGroup
              awslogs-region: !Ref AWS::Region
              awslogs-stream-prefix: mps-bench-m4096-c25

  TdMps50:
    Type: AWS::ECS::TaskDefinition
    Properties:
      Family: mps-bench-m4096-c50
      RequiresCompatibilities: [EC2]
      NetworkMode: bridge
      ExecutionRoleArn: !GetAtt ExecutionRole.Arn
      ContainerDefinitions:
        - Name: bench
          Image: !Ref BenchImage
          Essential: true
          Cpu: 512
          Memory: 3072
          Command: ["sh", "-c", "printf '%s' \"$BENCH_SCRIPT\" > /tmp/bench.py && exec python /tmp/bench.py"]
          Secrets:
            - Name: BENCH_SCRIPT
              ValueFrom: !Ref BenchScript
          ResourceRequirements:
            - Type: GPU
              SharingStrategy:
                NvidiaMps:
                  Memory: 4096
                  MaxComputePercent: 50
          LogConfiguration:
            LogDriver: awslogs
            Options:
              awslogs-group: !Ref LogGroup
              awslogs-region: !Ref AWS::Region
              awslogs-stream-prefix: mps-bench-m4096-c50

  TdMps75:
    Type: AWS::ECS::TaskDefinition
    Properties:
      Family: mps-bench-m4096-c75
      RequiresCompatibilities: [EC2]
      NetworkMode: bridge
      ExecutionRoleArn: !GetAtt ExecutionRole.Arn
      ContainerDefinitions:
        - Name: bench
          Image: !Ref BenchImage
          Essential: true
          Cpu: 512
          Memory: 3072
          Command: ["sh", "-c", "printf '%s' \"$BENCH_SCRIPT\" > /tmp/bench.py && exec python /tmp/bench.py"]
          Secrets:
            - Name: BENCH_SCRIPT
              ValueFrom: !Ref BenchScript
          ResourceRequirements:
            - Type: GPU
              SharingStrategy:
                NvidiaMps:
                  Memory: 4096
                  MaxComputePercent: 75
          LogConfiguration:
            LogDriver: awslogs
            Options:
              awslogs-group: !Ref LogGroup
              awslogs-region: !Ref AWS::Region
              awslogs-stream-prefix: mps-bench-m4096-c75

  TdMps100:
    Type: AWS::ECS::TaskDefinition
    Properties:
      Family: mps-bench-m4096
      RequiresCompatibilities: [EC2]
      NetworkMode: bridge
      ExecutionRoleArn: !GetAtt ExecutionRole.Arn
      ContainerDefinitions:
        - Name: bench
          Image: !Ref BenchImage
          Essential: true
          Cpu: 512
          Memory: 3072
          Command: ["sh", "-c", "printf '%s' \"$BENCH_SCRIPT\" > /tmp/bench.py && exec python /tmp/bench.py"]
          Secrets:
            - Name: BENCH_SCRIPT
              ValueFrom: !Ref BenchScript
          ResourceRequirements:
            - Type: GPU
              SharingStrategy:
                NvidiaMps:
                  Memory: 4096
          LogConfiguration:
            LogDriver: awslogs
            Options:
              awslogs-group: !Ref LogGroup
              awslogs-region: !Ref AWS::Region
              awslogs-stream-prefix: mps-bench-m4096

  TdMpsBig:
    Type: AWS::ECS::TaskDefinition
    Properties:
      Family: mps-bench-m20480
      RequiresCompatibilities: [EC2]
      NetworkMode: bridge
      ExecutionRoleArn: !GetAtt ExecutionRole.Arn
      ContainerDefinitions:
        - Name: bench
          Image: !Ref BenchImage
          Essential: true
          Cpu: 512
          Memory: 3072
          Command: ["sh", "-c", "printf '%s' \"$BENCH_SCRIPT\" > /tmp/bench.py && exec python /tmp/bench.py"]
          Secrets:
            - Name: BENCH_SCRIPT
              ValueFrom: !Ref BenchScript
          ResourceRequirements:
            - Type: GPU
              SharingStrategy:
                NvidiaMps:
                  Memory: 20480
          LogConfiguration:
            LogDriver: awslogs
            Options:
              awslogs-group: !Ref LogGroup
              awslogs-region: !Ref AWS::Region
              awslogs-stream-prefix: mps-bench-m20480

Outputs:
  ClusterName:
    Value: !Ref Cluster
  AutoScalingGroupName:
    Value: !Ref AutoScalingGroup
スタックは次のコマンドで作成しました。サブネットには、Docker Hub と AWS の API に接続できるものを指定します。
aws cloudformation deploy \
  --stack-name mps-bench \
  --template-file mps-bench.yaml \
  --capabilities CAPABILITY_IAM \
  --parameter-overrides \
    VpcId=<VPC の ID> \
    SubnetIds=<サブネットの ID>,<サブネットの ID> \
    DesiredCapacity=1
タスクを起動し、環境変数で動作を切り替えてから結果を収集します。スクリプトの実行には、AWS CLI のほかに jq が必要です。
aws ecs run-task \
  --cluster mps-bench \
  --task-definition mps-bench-m4096-c50 \
  --launch-type EC2 \
  --overrides '{"containerOverrides":[{"name":"bench","environment":[{"name":"MODE","value":"compute"}]}]}'
タスクの起動と結果を収集するスクリプト
#!/usr/bin/env bash
# mps-bench のタスクを起動し、終了後にログの JSON 行を集めて保存する。
# 使い方: run.sh <ラベル> '<ファミリー>|K=V|K=V' ['<ファミリー>|K=V' ...] [--delay 秒] [--no-wait]
# 同じ呼び出しで指定したタスクには同じ START_AT を渡し、計測の開始を揃える。
set -eo pipefail

CLUSTER=mps-bench
LOG_GROUP=/ecs/mps-bench
OUT="$(cd "$(dirname "$0")" && pwd)/results"

label=$1; shift
delay=45 wait=true specs=()
while (($#)); do
  case $1 in
    --delay) delay=$2; shift 2 ;;
    --no-wait) wait=false; shift ;;
    *) specs+=("$1"); shift ;;
  esac
done
start_at=$(($(date +%s) + delay))
mkdir -p "$OUT"
save() { printf '%s\n' "$rec" > "$OUT/$label.json"; }

tasks='[]' failures='[]'
for i in "${!specs[@]}"; do
  IFS='|' read -ra parts <<<"${specs[$i]}"
  family=${parts[0]}
  env=$(jq -n --arg run "$label-$i" --arg at "$start_at" '{RUN_ID: $run, START_AT: $at}')
  for kv in "${parts[@]:1}"; do
    env=$(jq --arg k "${kv%%=*}" --arg v "${kv#*=}" '.[$k] = $v' <<<"$env")
  done
  overrides=$(jq -c '{containerOverrides: [{name: "bench",
    environment: (to_entries | map({name: .key, value: .value}))}]}' <<<"$env")
  r=$(aws ecs run-task --cluster "$CLUSTER" --task-definition "$family" \
    --launch-type EC2 --count 1 --overrides "$overrides" --output json)
  failures=$(jq -c --argjson r "$r" '. + $r.failures' <<<"$failures")
  tasks=$(jq -c --argjson r "$r" --arg f "$family" --argjson env "$env" \
    '. + [$r.tasks[] | {arn: .taskArn, family: $f, env: $env}]' <<<"$tasks")
done
rec=$(jq -n --arg label "$label" --argjson at "$start_at" \
  --argjson tasks "$tasks" --argjson failures "$failures" \
  '{label: $label, start_at: $at, tasks: $tasks, failures: $failures}')
jq -c '{launched: (.tasks | length), failures}' <<<"$rec"

arns=$(jq -r '.tasks[].arn' <<<"$rec")
if [[ -z $arns ]]; then save; exit; fi
sleep $((delay < 20 ? delay : 20))
gpu='[]'
ci=$(aws ecs list-container-instances --cluster "$CLUSTER" --query containerInstanceArns --output text)
if [[ -n $ci && $ci != None ]]; then
  gpu=$(aws ecs describe-container-instances --cluster "$CLUSTER" --container-instances $ci \
    --query 'containerInstances[].gpuDevices[]' --output json)
fi
running=$(aws ecs describe-tasks --cluster "$CLUSTER" --tasks $arns --query tasks --output json)
rec=$(jq --argjson g "$gpu" --argjson d "$running" \
  '.gpu_devices_running = $g | .describe_tasks_running = $d' <<<"$rec")
if ! $wait; then save; exit; fi

# 待機は 1 回あたり最大 10 分。2 回で打ち切る
for _ in 1 2; do
  aws ecs wait tasks-stopped --cluster "$CLUSTER" --tasks $arns && break
done
stopped=$(aws ecs describe-tasks --cluster "$CLUSTER" --tasks $arns --query tasks --output json)
n=$(jq '.tasks | length' <<<"$rec")
for ((i = 0; i < n; i++)); do
  arn=$(jq -r ".tasks[$i].arn" <<<"$rec")
  family=$(jq -r ".tasks[$i].family" <<<"$rec")
  lines=$(aws logs filter-log-events --log-group-name "$LOG_GROUP" \
    --log-stream-names "$family/bench/${arn##*/}" \
    --query 'events[].message' --output json 2>/dev/null || echo '[]')
  rec=$(jq --argjson i "$i" --arg arn "$arn" --argjson d "$stopped" --argjson lines "$lines" '
    ($d[] | select(.taskArn == $arn)) as $t | $t.containers[0] as $c
    | [$lines[] | fromjson? | objects] as $json
    | .tasks[$i] += {
        stopped_reason: $t.stoppedReason, exit_code: $c.exitCode, reason: $c.reason,
        gpu_ids: $c.gpuIds, gpu_sharing: $c.gpuSharingStrategy,
        json: $json, other_lines: (($lines | length) - ($json | length)),
        tail: ([$lines[] | select(startswith("{") | not)] | .[-5:])
      }' <<<"$rec")
done
save
jq -c '.tasks[] | {family, exit: .exit_code, gpu: .gpu_ids,
  events: [.json[] | select(.event | IN("info", "mem", "compute_done", "crash"))],
  other_lines}' <<<"$rec"
コンテナに上限が設定される仕組み
まず、インスタンスの中で MPS がどう動いているのかを確認しました。
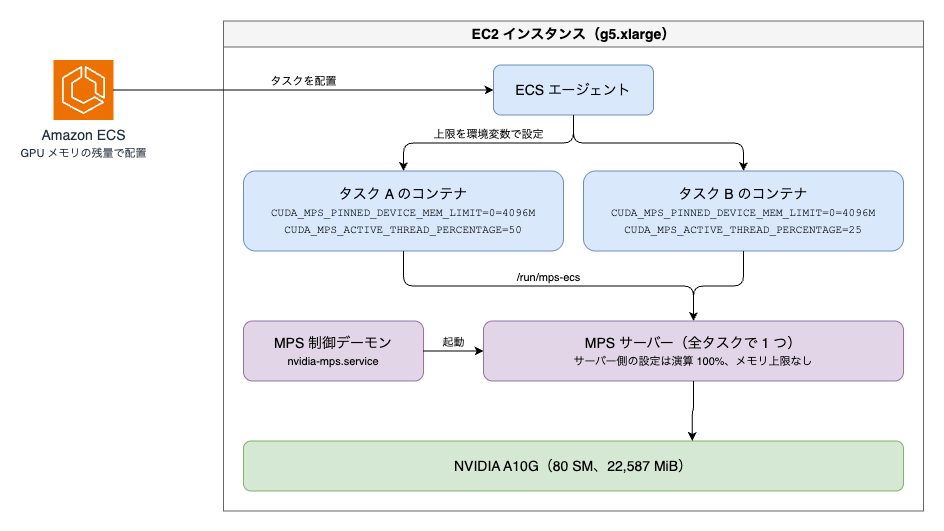
GPU 用の AMI では、systemd の nvidia-mps.service が MPS の制御デーモンを nvidia-cuda-mps-control -f -multiuser-server で起動していました。ecs.service より先に起動する設定で、MPS との通信には /run/mps-ecs を使います。
memory が 4096、maxComputePercent が 50 のタスクを起動すると、コンテナには ECS が次の環境変数を設定していました。
{
  "CUDA_MPS_PINNED_DEVICE_MEM_LIMIT": "0=4096M",
  "CUDA_MPS_ACTIVE_THREAD_PERCENTAGE": "50",
  "CUDA_MPS_PIPE_DIRECTORY": "/run/mps-ecs",
  "NVIDIA_VISIBLE_DEVICES": "void"
}
複数のタスクを起動しても MPS のサーバーのプロセスは 1 つだけで、全てのタスクがこのサーバーを共有していました。サーバー側の設定は、演算が 100%、メモリは上限なしのままです。
つまり、コンテナごとの上限は、サーバーではなくコンテナの環境変数で指定されているということです。
共有の状態は、DescribeContainerInstances の応答の gpuDevices で確認できます。以下は maxComputePercent が 50 のタスクを 2 つ実行している間の値です。
[
  {
    "gpuId": "GPU-e2499c30-9e84-17c2-4315-944340692a58",
    "sharingMode": "NVIDIA_MPS",
    "totalMemoryInMiB": 22587,
    "remainingMemoryInMiB": 14395,
    "containerCount": 2
  }
]
remainingMemoryInMiB は、22,587 MiB から 2 タスク分の 4,096 MiB を引いた値です。
コンテナごとの設定は、DescribeTasks の応答の gpuIds と gpuSharingStrategy で確認できます。
"gpuIds": ["GPU-e2499c30-9e84-17c2-4315-944340692a58"],
"gpuSharingStrategy": {"nvidiaMps": {"memory": 4096, "maxComputePercent": 50}}
メモリの上限が守られているか検証
memory が 4096 のタスクで GPU メモリを確保していくと、3,840 MiB で OutOfMemoryError になりました。確保の単位を 32 MiB に細かくすると、3,936 MiB まで確保できました。
CUDA の初期化直後に取得した空き容量は 3,960 MiB でした。上限の 4,096 MiB から、CUDA 自身が使う分を引いた量なのではないかと思われます。
対照として、GPU を専有するタスクで同じことを試すと、22,272 MiB まで確保できました。
つまり、メモリの上限は指定した通りに守られていることが分かります。
演算の上限が守られているか検証
maxComputePercent を指定すると、PyTorch から見える SM の数が割合通りに減りました。
| maxComputePercent | SM の数 |
|---|---|
| 指定なし | 80 |
| 75 | 60 |
| 50 | 40 |
| 25 | 20 |
1 タスクだけで行列積を実行した場合のスループットは次の通りでした。
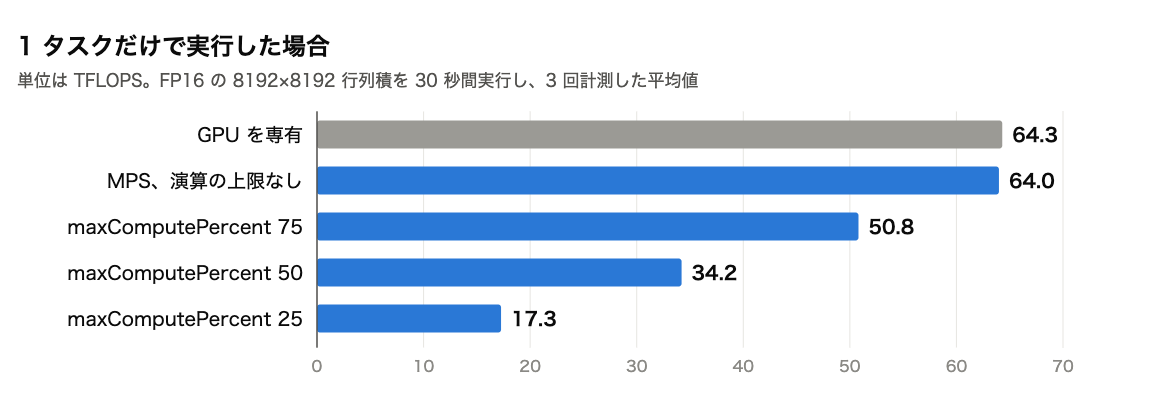
GPU を専有した場合の 64.3 TFLOPS に対して、上限 25、50、75 のスループットはそれぞれ 26.9、53.2、79.0% でした。3 回の計測で、ほとんど差はありません。
設定した割合より少し高いのは、メモリ帯域など SM 以外の資源は分割されないためなのではないかと推測しています。
上限を指定しない MPS のタスクは 64.0 TFLOPS で、GPU を専有した場合とほぼ同じでした。MPS を経由すること自体による性能の低下は、ほとんどなさそうです。
複数のタスクを同時に動かした場合の性能
次に、複数のタスクを同時に動かし、60 秒間のスループットを計測しました。
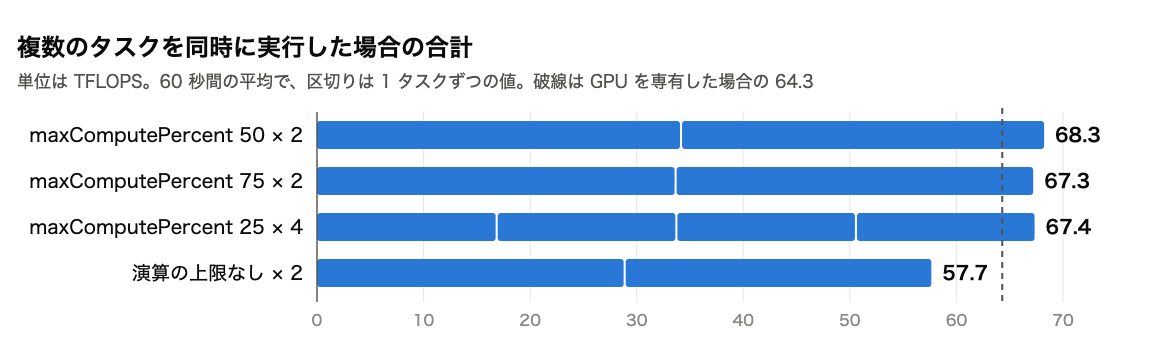
maxComputePercent が 50 のタスクを 2 つ動かすと、それぞれ 34.16 TFLOPS で、1 タスクだけのときの 34.21 TFLOPS とほぼ同じでした。上限 25 のタスクを 4 つ動かした場合も同様です。
上限 50 のタスク 2 つの合計は 68.3 TFLOPS で、GPU を専有した場合の 64.3 TFLOPS を上回りました。上限を指定して分けると、1 つのタスクで専有するより合計のスループットが上がるようです。
上限の合計が 150% になる、上限 75 のタスク 2 つでは、それぞれ 33.65 TFLOPS で、GPU をほぼ半分ずつ分け合う結果になりました。
一方、上限を指定しないタスクを 2 つ動かすと、それぞれ 28.87 TFLOPS で、合計は 57.7 TFLOPS と GPU を専有した場合より下がりました。2 つのタスクが同じ SM を取り合うことによる損失なのではないか、と推測しています。
同じ GPU に載せるタスクの maxComputePercent の合計を 100% 以内にしておくと、タスク同士の性能は互いに影響しませんでした。
コンテナの中で環境変数を書き換えた場合
上限が環境変数で渡されているのであれば、コンテナの中で書き換えるとどうなるのでしょうか?気になったので試してみました。
memory が 4096、maxComputePercent が 25 のタスクで、CUDA を初期化する前に環境変数を消すか、値を変えます。
import os

# 上限を消す場合
os.environ.pop("CUDA_MPS_PINNED_DEVICE_MEM_LIMIT", None)
os.environ.pop("CUDA_MPS_ACTIVE_THREAD_PERCENTAGE", None)

# 上限を変える場合
# os.environ["CUDA_MPS_PINNED_DEVICE_MEM_LIMIT"] = "0=20G"
# os.environ["CUDA_MPS_ACTIVE_THREAD_PERCENTAGE"] = "100"

import torch  # この後の最初の CUDA の呼び出しで初期化される
すると、どちらの方法でも上限が外れました。
| 項目 | 上限通り | 環境変数を消した場合 | 環境変数を変えた場合 |
|---|---|---|---|
| SM の数 | 20 | 80 | 80 |
| スループット | 17.27 TFLOPS | 64.26 TFLOPS | 63.86 TFLOPS |
| 確保できたメモリ | 3,840 MiB | 20,224 MiB | 20,224 MiB |
20,224 MiB は、スクリプトに設けた上限で止めた値です。GPU のメモリが足りなくなったわけではありません。
これらの環境変数は、制御デーモンに設定した上限を更に厳しくする方向にしか働きません[1]。今回の環境ではデーモン側に上限がないため、環境変数を消すとそのまま上限がなくなる、ということだと思います。
なお、RunTask の containerOverrides でこれらの環境変数を指定すると、リクエスト自体は受け付けられますが、コンテナには ECS が設定した値が入っていました。外から上書きすることはできず、上限を外せるのはコンテナの中で動くコードだけです。
上限を外したタスクが他のタスクに与える影響
上限を外したタスクが 20,224 MiB を確保している間に、memory が 4096 の別のタスクを起動しました。
すると、このタスクは自分の上限の 4,096 MiB に届かず、1,792 MiB で OutOfMemoryError になりました。
このときの remainingMemoryInMiB は 14,395 MiB で、上限を外したタスクの超過は反映されていませんでした。ECS は、タスク定義の値で残量を計算しているようです。
ドキュメントの「コンテナごとの上限を強制する」という説明から、私はサーバー側で強制されるものを想像していたので、この挙動は少し意外でした。上限は、コンテナが環境変数を書き換えないことを前提にした仕組みだと考えた方が良さそうです。
ドキュメントには、別のサービスのタスクが同じ GPU に載らないようにするには、キャパシティープロバイダーかクラスターを分けるよう書かれています。
GPU メモリが足りない場合
memory が 20480 のタスクを実行している間に、memory が 4096 のタスクを起動しました。残りは 2,107 MiB なので、配置できないはずです。
想定通り、RunTask の応答の failures に RESOURCE:GPU_MEMORY が返り、タスクは起動しませんでした。
"failures": [
  {
    "arn": "arn:aws:ecs:ap-northeast-1:123456789012:container-instance/b6c1f565ead746628ff6280bbdc27ed3",
    "reason": "RESOURCE:GPU_MEMORY"
  }
]
Container Insights で取得できる GPU のメトリクス
オブザーバビリティが強化された Container Insights を有効にしていましたが、MPS で共有するタスクには GPU に関する項目が記録されませんでした。GPU を専有するタスクでは、パフォーマンスログに GpuDevicesReserved が 1.0 と記録されています。
ドキュメントによれば、MPS で共有する場合は、タスク単位とコンテナ単位の GPU の使用率やメモリ使用量のメトリクスが出力されません。
電力や温度は出力されるとのことですが、今回は GPU を専有した場合を含めて、使用率などのメトリクスが出ていませんでした。EC2 の場合は、CloudWatch エージェントの導入が必要なのかもしれません。
おわりに
結論としては、ECS の GPU 共有では、メモリと演算の上限が指定した通りに守られ、演算の上限の合計を 100% 以内にすると、タスク同士の性能も互いに影響しませんでした。
ただし、上限はコンテナの環境変数で伝えられているため、コンテナの中のコードが書き換えると制限が外れてしまいます。別のチームや顧客のワークロードを同じ GPU に載せる場合は、キャパシティープロバイダーやクラスターを分けておきましょう。
GPU を使い切らないワークロードを複数お持ちの方は、ぜひ試してみてください!