Amazon Athena の Iceberg テーブルへの同時 UPDATE で ICEBERG_COMMIT_ERROR になったクエリを再試行してみた

はじめに
テクニカルサポートの 片方 です。
Amazon Athena で Apache Iceberg のテーブルを使うと、UPDATE や DELETE で行を更新・削除できます。ただ、バッチの処理を複数のジョブに分けて並列に実行すると、同じテーブルに同時に書き込むことになり、どちらかのクエリが ICEBERG_COMMIT_ERROR で失敗することがあります。
このエラーは StartQueryExecution の呼び出しでは分からず、GetQueryExecution で状態を確かめたときに FAILED として返ります。失敗に気づかずにいると、更新が欠けたままになります。
そこで、2 つのクライアントから同じテーブルへ同時に UPDATE し、失敗の出方と、失敗したクエリだけを再試行したときに全件が反映されるかを確かめました。
構成
東京リージョンに、次のリソースを作りました。
- Amazon S3 のバケット iceberg-orders-lake-k7m2
- AWS Glue Data Catalog のデータベース orders_lake
- Athena のワークグループ orders-iceberg-wg
テーブルは Iceberg 形式の order_status(order_id、status、updated_at)で、1,000 行を INSERT INTO で入れました。
Athena の UPDATE は、位置削除ファイルと更新後の行を、同じトランザクションで書き込みます。
Athena Iceberg
UPDATEは、Iceberg 位置削除ファイルと新しく更新された行を同じトランザクション内のデータファイルとして書き込みます。UPDATEは、INSERT INTOとDELETEを組み合わせたものと考えることができます。UPDATEオペレーションは、スキャンしたデータ量の分だけ課金されます。
書き込みのクライアントは、作業端末で実行する Python(boto3)のスクリプトです。2 つのスレッドから、次の 2 つの UPDATE をほぼ同時に StartQueryExecution で送ります。対象の行は、401〜600 で重なっています。
- クライアント A:
order_idが 1〜600 でstatus = 'pending'の行をpackedにする - クライアント B:
order_idが 401〜1,000 でstatus = 'pending'の行をpackedにする
1 ラウンドごとに、全行を pending に戻してから 2 つの UPDATE を送り、終わった後に packed の行数を数えます。全件が反映されていれば 1,000 行です。
再試行の方針は、次のとおりです。
GetQueryExecutionのStateがFAILEDで、エラーのメッセージにICEBERG_COMMIT_ERRORを含むときだけ、同じ文をもう一度StartQueryExecutionする。- 待ち時間は、フルジッター付きの指数バックオフ(基準 1 秒、上限 30 秒)。再試行は最大 4 回(初回を含めて 5 回)。
UPDATEにはAND status = 'pending'を付ける。同じ文をもう一度実行しても、更新する行が無いようにするため(冪等性)。- API の呼び出しそのものの再試行は、boto3 の standard モード(
max_attemptsに 5 を指定)に任せる。
先に結論から
- 再試行なしでは、5 ラウンドすべてで、2 つの
UPDATEのどちらか 1 つがICEBERG_COMMIT_ERRORで失敗し、反映は毎回 600 行で止まりました。 - 失敗したクエリだけを同じ文で再試行すると、10 ラウンドのうち 9 ラウンドで、1 回の再試行で全件(1,000 行)が反映されました。
- 手順 5 で記録した、失敗したクエリ 5 件の
AthenaErrorは、どれもRetryableがfalseでした。Retryableを再試行の条件にしていたら、再試行されずに更新が欠けていたことになります。 - 1 ラウンドだけ、
FAILEDなのにスクリプトが取り出したエラーのメッセージが空で、再試行の条件に合わず、600 行で止まりました。 - 失敗したクエリにもスキャン量は記録されます。ただし、クエリ単位の料金では、失敗したクエリは課金の対象外です(2026 年 10 月時点)。
やってみた
次の順に進めました。
- テーブルを作る
- 同時に UPDATE するスクリプトを書く
- 再試行なしで 5 ラウンド実行する
- 再試行ありで 5 ラウンド実行する
- スクリプトを直して、再試行ありでもう一度 5 ラウンド実行する
1. テーブルを作る
Athena で Iceberg テーブルを作り、UNNEST(sequence(1, 1000)) で 1,000 行を入れました。スクリプトの setup は、行数が 0 のときだけ INSERT INTO を実行するので、何度実行しても 1,000 行のままです。
CREATE TABLE IF NOT EXISTS order_status (order_id int, status string, updated_at timestamp)
LOCATION 's3://iceberg-orders-lake-k7m2/order_status/'
TBLPROPERTIES ('table_type' = 'ICEBERG', 'format' = 'parquet')
INSERT INTO order_status
SELECT id, 'pending', current_timestamp FROM UNNEST(sequence(1, 1000)) AS t(id)
2. 同時に UPDATE するスクリプトを書く
検証に使った Python のスクリプトです。run_query がクエリを 1 回実行して完了まで待ち、run_with_retry が ICEBERG_COMMIT_ERROR のときだけ再試行します。このコードは、手順 5 で直した後のものです。
"""Athena の Iceberg テーブルへ 2 つのクライアントから同時に UPDATE し、ICEBERG_COMMIT_ERROR と再試行を確かめる。

使い方:
  .venv/bin/python logs/Y24/iceberg_concurrency.py setup            # テーブルを作り 1,000 行入れる(何度実行しても 1,000 行)
  .venv/bin/python logs/Y24/iceberg_concurrency.py run noretry 5    # 5 ラウンド、再試行なし
  .venv/bin/python logs/Y24/iceberg_concurrency.py run retry 5      # 5 ラウンド、再試行あり
  .venv/bin/python logs/Y24/iceberg_concurrency.py snapshots        # スナップショットの数

- 再試行(SDK):boto3 の standard モード(API の呼び出しのスロットリングなどに対して、最大 5 回)。
- 再試行(クエリ):GetQueryExecution の State が FAILED で、ErrorMessage に ICEBERG_COMMIT_ERROR を含むときだけ、
  フルジッター付きの指数バックオフ(基準 1 秒、上限 30 秒、最大 5 回)で同じ文をもう一度 StartQueryExecution する。
- 冪等性:UPDATE に `AND status = 'pending'` を付け、同じ文を 2 回実行しても 2 回目は 0 行の更新になるようにする。
"""
import json
import random
import sys
import threading
import time

import boto3
from botocore.config import Config

REGION = "ap-northeast-1"
WORKGROUP = "orders-iceberg-wg"
DATABASE = "orders_lake"
TABLE = "order_status"
BUCKET = "iceberg-orders-lake-k7m2"

athena = boto3.client("athena", region_name=REGION, config=Config(retries={"mode": "standard", "max_attempts": 5}))

def run_query(sql, label=""):
    """クエリを 1 回実行して完了まで待ち、(state, error_message, scanned_bytes, elapsed_s, query_id) を返す。"""
    t0 = time.time()
    qid = athena.start_query_execution(QueryString=sql, QueryExecutionContext={"Database": DATABASE}, WorkGroup=WORKGROUP)["QueryExecutionId"]
    wait = 0.5
    while True:
        q = athena.get_query_execution(QueryExecutionId=qid)["QueryExecution"]
        state = q["Status"]["State"]
        if state in ("SUCCEEDED", "FAILED", "CANCELLED"):
            ae = q["Status"].get("AthenaError", {})
            err = ae.get("ErrorMessage", "") or q["Status"].get("StateChangeReason", "")
            if state == "FAILED":
                print(json.dumps({"failed_query": qid, "AthenaError": ae, "StateChangeReason": q["Status"].get("StateChangeReason", "")}, ensure_ascii=False), file=sys.stderr)
            scanned = q.get("Statistics", {}).get("DataScannedInBytes", 0)
            return state, err, scanned, time.time() - t0, qid
        time.sleep(wait)
        wait = min(2.0, wait * 1.5)

def run_with_retry(sql, label, max_attempts=5, base=1.0, cap=30.0):
    """ICEBERG_COMMIT_ERROR のときだけ再試行する。試行ごとの結果の一覧を返す。"""
    attempts = []
    for i in range(1, max_attempts + 1):
        state, err, scanned, elapsed, qid = run_query(sql, label)
        attempts.append({"attempt": i, "state": state, "error": err[:120], "scanned": scanned, "elapsed": round(elapsed, 1)})
        if state == "SUCCEEDED":
            break
        if state == "FAILED" and "ICEBERG_COMMIT_ERROR" in err and i < max_attempts:
            sleep = random.uniform(0, min(cap, base * 2 ** (i - 1)))
            attempts[-1]["backoff"] = round(sleep, 2)
            time.sleep(sleep)
            continue
        break
    return attempts

def fetch_scalar_rows(sql):
    state, err, _, _, qid = run_query(sql)
    if state != "SUCCEEDED":
        raise RuntimeError(f"{state}: {err}")
    rows = athena.get_query_results(QueryExecutionId=qid)["ResultSet"]["Rows"][1:]
    return [[c.get("VarCharValue") for c in r["Data"]] for r in rows]

def setup():
    run_query(f"""
        CREATE TABLE IF NOT EXISTS {TABLE} (order_id int, status string, updated_at timestamp)
        LOCATION 's3://{BUCKET}/{TABLE}/'
        TBLPROPERTIES ('table_type' = 'ICEBERG', 'format' = 'parquet')
    """)
    n = int(fetch_scalar_rows(f"SELECT count(*) FROM {TABLE}")[0][0])
    if n == 0:
        print(run_query(f"INSERT INTO {TABLE} SELECT id, 'pending', current_timestamp FROM UNNEST(sequence(1, 1000)) AS t(id)"))
    print("rows:", fetch_scalar_rows(f"SELECT count(*) FROM {TABLE}")[0][0])

def reset():
    state, err, *_ = run_query(f"UPDATE {TABLE} SET status = 'pending', updated_at = current_timestamp WHERE status <> 'pending'")
    assert state == "SUCCEEDED", err

def round_once(mode, rnd):
    # クライアント A は 1〜600、クライアント B は 401〜1000 を同時に更新する(同じデータファイルを対象にする)
    sqls = {
        "A": f"UPDATE {TABLE} SET status = 'packed', updated_at = current_timestamp WHERE order_id BETWEEN 1 AND 600 AND status = 'pending'",
        "B": f"UPDATE {TABLE} SET status = 'packed', updated_at = current_timestamp WHERE order_id BETWEEN 401 AND 1000 AND status = 'pending'",
    }
    results = {}

    def worker(name):
        if mode == "retry":
            results[name] = run_with_retry(sqls[name], name)
        else:
            state, err, scanned, elapsed, qid = run_query(sqls[name], name)
            results[name] = [{"attempt": 1, "state": state, "error": err[:120], "scanned": scanned, "elapsed": round(elapsed, 1)}]

    threads = [threading.Thread(target=worker, args=(n,)) for n in ("A", "B")]
    for t in threads:
        t.start()
    for t in threads:
        t.join()
    packed = int(fetch_scalar_rows(f"SELECT count(*) FROM {TABLE} WHERE status = 'packed'")[0][0])
    print(json.dumps({"round": rnd, "mode": mode, "results": results, "packed_rows": packed, "expected": 1000}, ensure_ascii=False))
    return results, packed

def main():
    cmd = sys.argv[1]
    if cmd == "setup":
        setup()
    elif cmd == "run":
        mode, rounds = sys.argv[2], int(sys.argv[3])
        summary = {"rounds": rounds, "mode": mode, "commit_errors": 0, "retries": 0, "incomplete_rounds": 0, "failed_scanned_bytes": 0}
        for r in range(1, rounds + 1):
            reset()
            results, packed = round_once(mode, r)
            for name, attempts in results.items():
                for a in attempts:
                    if a["state"] == "FAILED" and "ICEBERG_COMMIT_ERROR" in a["error"]:
                        summary["commit_errors"] += 1
                        summary["failed_scanned_bytes"] += a["scanned"]
                summary["retries"] += max(0, len(attempts) - 1)
            if packed != 1000:
                summary["incomplete_rounds"] += 1
        print("SUMMARY", json.dumps(summary))
    elif cmd == "snapshots":
        rows = fetch_scalar_rows(f'SELECT count(*) FROM "{TABLE}$snapshots"')
        print("snapshots:", rows[0][0])
    elif cmd == "status":
        print(fetch_scalar_rows(f"SELECT status, count(*) FROM {TABLE} GROUP BY status ORDER BY status"))

if __name__ == "__main__":
    main()
3. 再試行なしで 5 ラウンド実行する
.venv/bin/python logs/Y24/iceberg_concurrency.py run noretry 5
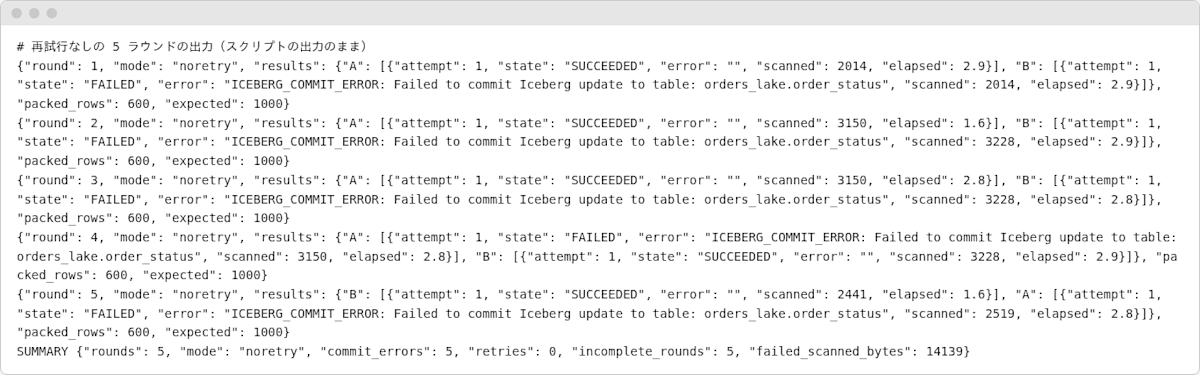
画像は、スクリプトが 1 ラウンドごとに出力する JSON と、最後の SUMMARY の行です(手順 5 の画像も同じです)。
5 ラウンドすべてで、2 つのうち 1 つが ICEBERG_COMMIT_ERROR で失敗し、packed の行数は 600 で止まりました。失敗したのは、A が 2 回、B が 3 回です。エラーのメッセージは、次のとおりでした。
ICEBERG_COMMIT_ERROR: Failed to commit Iceberg update to table: orders_lake.order_status
4. 再試行ありで 5 ラウンド実行する
.venv/bin/python logs/Y24/iceberg_concurrency.py run retry 5
4 ラウンドは、失敗した側が 1 回の再試行で成功し、1,000 行になりました。
残りの 1 ラウンドでは、クライアント A が FAILED なのに、スクリプトが取り出したエラーのメッセージが空でした。再試行の条件(ICEBERG_COMMIT_ERROR を含む)に合わなかったので、再試行されずに 600 行で止まりました。このときのスクリプトは、AthenaError の ErrorMessage だけを見ていて、失敗の理由を残していませんでした。
5. スクリプトを直して、再試行ありでもう一度 5 ラウンド実行する
手順 4 を受けて、スクリプトを 2 か所直しました(手順 2 のコードが、直した後のものです)。
ErrorMessageが空のときは、StateChangeReasonを見る。- 失敗したクエリの
AthenaErrorとStateChangeReasonを、丸ごと標準エラーに出す。
同じコマンドで、もう一度 5 ラウンド実行しました。
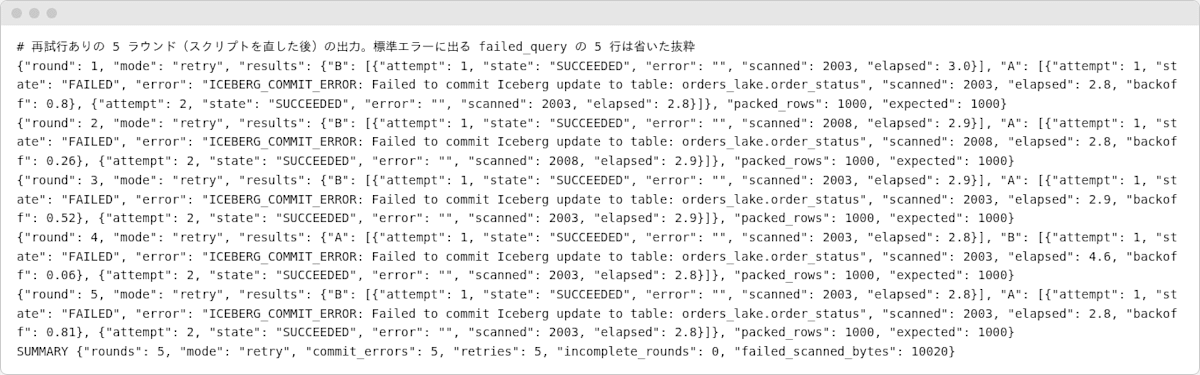
標準エラーに出る failed_query の行は、画像では省いています。5 ラウンドすべてで、失敗した側が 1 回の再試行で成功し、packed の行数は 1,000 になりました。バックオフの待ち時間は、0.06〜0.81 秒でした。
手順 4 と合わせると、再試行ありの 10 ラウンドのうち 9 ラウンドで、全件が反映されたことになります。
確認してみた
失敗したクエリの AthenaError
手順 5 で記録した、失敗したクエリの AthenaError は、5 件とも次のとおりで、Retryable は false でした。
{"ErrorCategory": 2, "ErrorType": 233, "Retryable": false, "ErrorMessage": "ICEBERG_COMMIT_ERROR: Failed to commit Iceberg update to table: orders_lake.order_status"}
Retryable は、再実行すれば成功するかもしれないことを示すフィールドです。
Retryable
True if the query might succeed if resubmitted.
スクリプトは、エラーのメッセージで再試行するかを判断していて、Retryable は見ていません。もし Retryable を条件にしていたら、この 5 件は再試行されず、手順 5 のどのラウンドも 600 行で止まっていたことになります。
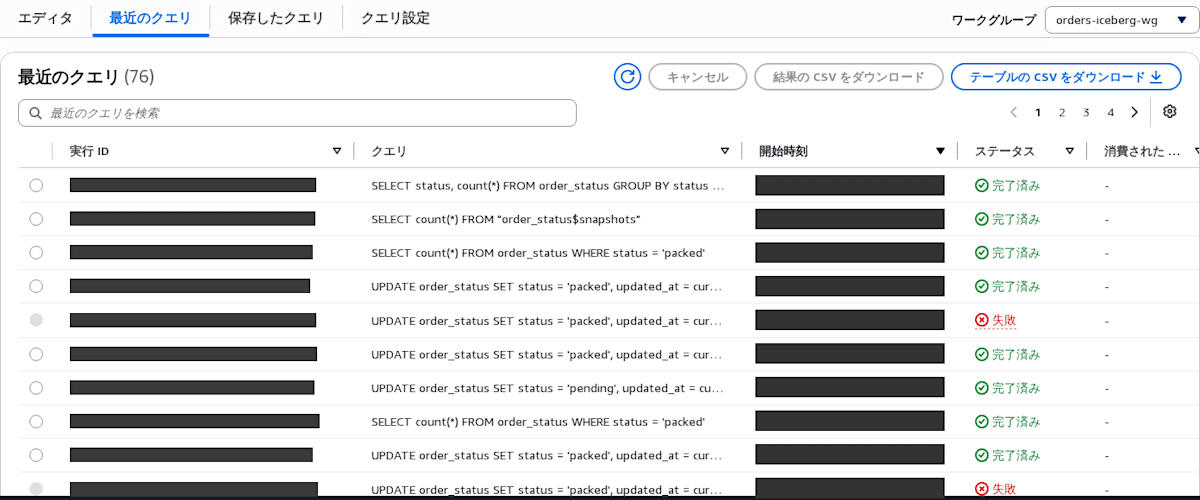
Athena のコンソールの「最近のクエリ」でも、失敗した UPDATE のステータスは「失敗」でした。
スキャン量と料金
失敗したクエリにも、DataScannedInBytes が記録されていました。合計は、再試行なしの 5 回で 14,139 バイト、手順 5 の再試行ありの 5 回で 10,020 バイトです。
ただし、記録されたスキャン量と料金は別です。2026 年 10 月時点で、クエリ単位の料金では、失敗したクエリは課金の対象外です。
With per query pricing, you are not charged for failed queries.
スナップショット
"order_status$snapshots" の件数は、手順 3 と手順 4 の後で 24、手順 5 の後で 39 でした。
この数は、スナップショットを作る操作の数と一致します。
- 手順 3 と 4 まで(24 件):
INSERT INTOが 1 回、成功したUPDATEが 14 回、行を変えたリセットのUPDATEが 9 回。 - 手順 5(15 件増):成功した
UPDATEが 10 回、行を変えたリセットのUPDATEが 5 回。
失敗したクエリでは、スナップショットは増えていませんでした。最初のリセット(すべて pending のままで、0 行の更新)でも増えていません。
まとめ
重なる行を対象に 2 つの UPDATE を同時に送ると、15 ラウンドすべてで、どちらか 1 つが失敗しました。エラーのメッセージが取れた 14 件は、すべて ICEBERG_COMMIT_ERROR です。並列のジョブで同じ Iceberg テーブルを更新するなら、失敗は「たまに起きるもの」ではなく、「起きる前提」で考えたほうがよさそうです。
一方で、ICEBERG_COMMIT_ERROR で失敗したクエリは、同じ文で送り直すだけで、9 件すべてが 1 回目の再試行で成功しました。UPDATE に status = 'pending' のような条件を付けておけば、成功した文がもう一度実行されても、更新する行はありません。安心して再試行に任せられます。
気を付けたいのは、再試行の判断に何を使うかです。AthenaError の Retryable は、この ICEBERG_COMMIT_ERROR では false でした。Retryable を再試行の条件にしていたら、記録した 5 件は再試行されず、更新が欠けたままになっていました。
また、エラーのメッセージが空で返った失敗が 1 回あり、これは再試行の条件に合わず、更新が欠けました。再試行の条件に合わなかったクエリは、上限まで再試行して失敗したクエリと同じように、別に記録して後から確かめる仕組みが要ります。
本ブログが誰かの参考になれば幸いです。
参考資料
- UPDATE - Amazon Athena
- Iceberg テーブルデータを更新する - Amazon Athena
- AthenaError - Amazon Athena API Reference
- Athena エラーカタログ - Amazon Athena
- Amazon Athena FAQs
クラスメソッドオペレーションズ株式会社について
クラスメソッドグループのオペレーション企業です。
運用・保守開発・サポート・情シス・バックオフィスの専門チームが、IT・AIをフル活用した「しくみ」を通じて、お客様の業務代行から課題解決や高付加価値サービスまでを提供するエキスパート集団です。
当社は様々な職種でメンバーを募集しています。
「オペレーション・エクセレンス」と「らしく働く、らしく生きる」を共に実現するカルチャー・しくみ・働き方にご興味がある方は、クラスメソッドオペレーションズ株式会社 コーポレートサイト をぜひご覧ください。※2026年1月 アノテーション㈱から社名変更しました