[アップデート] Amazon Redshift で Apache Iceberg マテリアライズドビューが作成できるようになったので試してみた

クラウド事業統括本部の石川です。Amazon Redshift で、結果を Apache Iceberg テーブルとして保存するマテリアライズドビュー(以下、Iceberg MV)の作成と更新がサポートされましたので、実際に試してみました。
Amazon Redshift で Apache Iceberg マテリアライズドビューの作成と更新がサポートされました。CREATE MATERIALIZED VIEW に USING ICEBERG 句を付けて作成した MV は、事前に計算した結合・集計の結果を、AWS Glue Data Catalog に登録された Amazon S3(汎用バケットまたは S3 テーブルバケット)の Iceberg テーブルとして保存します。保存先が Iceberg テーブルなので、Amazon Athena、Amazon EMR 上の Apache Spark、AWS Glue、Trino などの Iceberg 互換エンジンから、そのまま読み取れます。
アナウンスでは、次の 2 点が挙げられています。
- 多数のユーザーやチームが同じ結合・集計を毎回実行する代わりに、一度計算した結果を全員で読み取れる
- Redshift だけでパイプラインを組んでも、下流の各エンジンが同じオープンな結果を共有できる
Iceberg マテリアライズドビューとは
従来の Redshift のマテリアライズドビューは、結果を Redshift マネージドストレージ(RMS)に保存し、Redshift からしか読めません。Iceberg MV は、結果を標準の Iceberg テーブルとして S3 に保存するため、Iceberg を読めるエンジンであればどれからでも読めます。
Apache Iceberg は、S3 上の Parquet などのデータファイルを、スナップショット単位のメタデータでテーブルとして管理するオープンテーブルフォーマットです。
ドキュメントによると、Iceberg MV を作成すると Redshift は次の処理を行います。
- 定義クエリを実行し、結果を Parquet データファイルとして S3 に書き込む
- Iceberg メタデータとともにテーブルを Glue Data Catalog に登録し、他のエンジンから見えるようにする
- MV の定義とリフレッシュ状態を Glue に保存する(クラスターに依存しない管理になる)
構文は以下です。
CREATE MATERIALIZED VIEW mv_name
USING ICEBERG
[LOCATION 's3://bucket/path/']
[PARTITIONED BY (partition_transform [, ...])]
[TABLE PROPERTIES ('property_name' = 'property_value' [, ...])]
AS query
**リフレッシュは手動の REFRESH MATERIALIZED VIEW のみで、AUTO REFRESH には対応していません。**ドキュメントに記載されている増分リフレッシュの対象とフルリフレッシュになる条件は、次のとおりです。
| 区分 | 内容 |
|---|---|
| 増分リフレッシュの対象 | SELECT / FROM / WHERE / GROUP BY と COUNT / SUM の組み合わせ、Iceberg テーブル同士の INNER JOIN |
| 定義はできるがフルリフレッシュになる | DISTINCT、外部結合、ウィンドウ関数、サブクエリ、集合演算、GROUPING SETS / ROLLUP / CUBE、COUNT / SUM 以外の集計関数、COUNT(DISTINCT) / SUM(DISTINCT) |
| フルリフレッシュに切り替わる | 前回リフレッシュ時のソースのスナップショットが期限切れになった場合、Redshift の REFRESH 以外で MV のデータが変更された場合 |
主な制限は以下です。
- 対応環境は Redshift Serverless と RG インスタンスのプロビジョンドクラスター(RA3 / DC2 は非対応)
- ソースは Iceberg テーブルのみ(Redshift ネイティブテーブル、Hive / Parquet の外部テーブル、Iceberg フォーマットバージョン 3 は不可)
- UDF、可変関数(GETDATE など)、ORDER BY / LIMIT / OFFSET、大文字の識別子は使用不可
- 自動クエリリライト、自動 MV、AUTO REFRESH、CASCADE、FGAC は非対応
enable_case_sensitive_identifierがtrueの場合は作成・リフレッシュ不可- Redshift で作成した MV の REFRESH / DROP は Redshift からのみ可能
- 汎用 S3 バケットに保存した場合、Redshift はコンパクションを行わない(S3 テーブルバケットは自動でコンパクションされる)
やってみた
検証環境
- AWS リージョン: アジアパシフィック(東京)
- Amazon Redshift Serverless
- ベースキャパシティ: 8 RPU(4 RPU では Iceberg MV を作成できなかったため。考察を参照)
- トラック: current
- ワークグループのバージョン: 1.0.477953(patch 205)
- 保存先: 汎用 S3 バケット(
LOCATIONを指定) - SQL クライアント: Redshift Query Editor v2(一部の確認用クエリは Redshift Data API で実行)
VPC(3 AZ のサブネット)、S3 バケット、Glue データベース iceberg_mv_blog、Athena ワークグループ、IAM ロール、Redshift Serverless の namespace / workgroup は、次の CloudFormation テンプレートで作成しました。IAM ロール(MV の定義者ロール)は AWS ブログの手順に合わせて、信頼ポリシーに redshift.amazonaws.com と glue.amazonaws.com を含め、インラインポリシーも AWS ブログの内容にしています。AWS ブログによると、glue.amazonaws.com は、Glue がソーステーブルの権限を MV の定義者ロールに代わって確認するために必要とのことです。
redshift-iceberg-mv.yaml
AWSTemplateFormatVersion: '2010-09-09'
Description: Verification environment for Amazon Redshift Iceberg materialized views (blog)

Resources:
  # ------------------------------------------------------------
  # Network (Redshift Serverless requires subnets in 3 AZs)
  # ------------------------------------------------------------
  Vpc:
    Type: AWS::EC2::VPC
    Properties:
      CidrBlock: 10.30.0.0/16
      EnableDnsSupport: true
      EnableDnsHostnames: true
      Tags:
        - Key: Name
          Value: redshift-iceberg-mv-vpc

  Subnet1:
    Type: AWS::EC2::Subnet
    Properties:
      VpcId: !Ref Vpc
      CidrBlock: 10.30.0.0/24
      AvailabilityZone: !Select [0, !GetAZs '']
      Tags:
        - Key: Name
          Value: redshift-iceberg-mv-subnet-1

  Subnet2:
    Type: AWS::EC2::Subnet
    Properties:
      VpcId: !Ref Vpc
      CidrBlock: 10.30.1.0/24
      AvailabilityZone: !Select [1, !GetAZs '']
      Tags:
        - Key: Name
          Value: redshift-iceberg-mv-subnet-2

  Subnet3:
    Type: AWS::EC2::Subnet
    Properties:
      VpcId: !Ref Vpc
      CidrBlock: 10.30.2.0/24
      AvailabilityZone: !Select [2, !GetAZs '']
      Tags:
        - Key: Name
          Value: redshift-iceberg-mv-subnet-3

  RedshiftSecurityGroup:
    Type: AWS::EC2::SecurityGroup
    Properties:
      GroupDescription: Redshift Serverless for Iceberg MV verification
      VpcId: !Ref Vpc
      SecurityGroupIngress:
        - IpProtocol: tcp
          FromPort: 5439
          ToPort: 5439
          CidrIp: 10.30.0.0/16

  # ------------------------------------------------------------
  # Storage / Catalog
  # ------------------------------------------------------------
  DataBucket:
    Type: AWS::S3::Bucket
    Properties:
      BucketName: !Sub redshift-iceberg-mv-${AWS::AccountId}-${AWS::Region}
      BucketEncryption:
        ServerSideEncryptionConfiguration:
          - ServerSideEncryptionByDefault:
              SSEAlgorithm: AES256
      PublicAccessBlockConfiguration:
        BlockPublicAcls: true
        BlockPublicPolicy: true
        IgnorePublicAcls: true
        RestrictPublicBuckets: true

  # The account-level Lake Formation default permissions are empty,
  # so IAM_ALLOWED_PRINCIPALS is set explicitly for tables in this database.
  GlueDatabase:
    Type: AWS::Glue::Database
    Properties:
      CatalogId: !Ref AWS::AccountId
      DatabaseInput:
        Name: iceberg_mv_blog
        Description: Source tables and Iceberg materialized views for the blog verification
        CreateTableDefaultPermissions:
          - Principal:
              DataLakePrincipalIdentifier: IAM_ALLOWED_PRINCIPALS
            Permissions:
              - ALL

  AthenaWorkGroup:
    Type: AWS::Athena::WorkGroup
    Properties:
      Name: redshift-iceberg-mv-wg
      State: ENABLED
      RecursiveDeleteOption: true
      WorkGroupConfiguration:
        EnforceWorkGroupConfiguration: true
        EngineVersion:
          SelectedEngineVersion: Athena engine version 3
        ResultConfiguration:
          OutputLocation: !Sub s3://${DataBucket}/athena-results/

  # ------------------------------------------------------------
  # MV definer role (trust: Redshift + Glue, policies from the AWS blog)
  # ------------------------------------------------------------
  MvDefinerRole:
    Type: AWS::IAM::Role
    Properties:
      RoleName: !Sub redshift-iceberg-mv-definer-${AWS::Region}
      AssumeRolePolicyDocument:
        Version: '2012-10-17'
        Statement:
          - Effect: Allow
            Principal:
              Service:
                - redshift.amazonaws.com
                - redshift-serverless.amazonaws.com
                - glue.amazonaws.com
            Action: sts:AssumeRole
      Policies:
        - PolicyName: s3-mv-access
          PolicyDocument:
            Version: '2012-10-17'
            Statement:
              - Effect: Allow
                Action:
                  - s3:GetObject
                  - s3:PutObject
                  - s3:DeleteObject
                  - s3:ListBucket
                  - s3:GetBucketLocation
                Resource:
                  - !Sub arn:aws:s3:::redshift-iceberg-mv-${AWS::AccountId}-${AWS::Region}
                  - !Sub arn:aws:s3:::redshift-iceberg-mv-${AWS::AccountId}-${AWS::Region}/*
        - PolicyName: glue-mv-access
          PolicyDocument:
            Version: '2012-10-17'
            Statement:
              - Effect: Allow
                Action:
                  - glue:GetDatabase
                  - glue:GetDatabases
                  - glue:GetTable
                  - glue:GetTables
                  - glue:CreateTable
                  - glue:UpdateTable
                  - glue:DeleteTable
                  - glue:GetPartitions
                  - glue:BatchGetPartition
                Resource:
                  - !Sub arn:aws:glue:${AWS::Region}:${AWS::AccountId}:catalog
                  - !Sub arn:aws:glue:${AWS::Region}:${AWS::AccountId}:database/iceberg_mv_blog
                  - !Sub arn:aws:glue:${AWS::Region}:${AWS::AccountId}:table/iceberg_mv_blog/*
        - PolicyName: mv-access
          PolicyDocument:
            Version: '2012-10-17'
            Statement:
              - Effect: Allow
                Action: iam:PassRole
                Resource: !Sub arn:aws:iam::${AWS::AccountId}:role/redshift-iceberg-mv-definer-${AWS::Region}

  # ------------------------------------------------------------
  # Redshift Serverless (8 RPU)
  # ------------------------------------------------------------
  RedshiftNamespace:
    Type: AWS::RedshiftServerless::Namespace
    Properties:
      NamespaceName: redshift-iceberg-mv-ns
      DbName: dev
      IamRoles:
        - !GetAtt MvDefinerRole.Arn
      DefaultIamRoleArn: !GetAtt MvDefinerRole.Arn

  RedshiftWorkgroup:
    Type: AWS::RedshiftServerless::Workgroup
    Properties:
      WorkgroupName: redshift-iceberg-mv-wg
      NamespaceName: !Ref RedshiftNamespace
      BaseCapacity: 8
      PubliclyAccessible: false
      EnhancedVpcRouting: false
      SubnetIds:
        - !Ref Subnet1
        - !Ref Subnet2
        - !Ref Subnet3
      SecurityGroupIds:
        - !Ref RedshiftSecurityGroup

Outputs:
  BucketName:
    Value: !Ref DataBucket
  MvDefinerRoleArn:
    Value: !GetAtt MvDefinerRole.Arn
  WorkgroupName:
    Value: !Ref RedshiftWorkgroup
  AthenaWorkGroupName:
    Value: !Ref AthenaWorkGroup
Lake Formation のデフォルト権限が空のアカウントの場合
AWS ブログには「Glue データベースを素の create-database で作れば IAM_ALLOWED_PRINCIPALS を継承する」と書かれています。しかし今回の検証アカウントは、Lake Formation の CreateDatabaseDefaultPermissions / CreateTableDefaultPermissions を空にしています。そのため、スタックで作成したデータベースには作成者の権限しか付いていませんでした。
% aws lakeformation list-permissions \
  --resource '{"Database":{"Name":"iceberg_mv_blog"}}' \
  --region ap-northeast-1 \
  --query 'PrincipalResourcePermissions[].[Principal.DataLakePrincipalIdentifier,join(`,`,Permissions)]' \
  --output table
-----------------------------------------------------------------------------------------------
|                                       ListPermissions                                       |
+----------------------------------------------------+----------------------------------------+
|  arn:aws:iam::123456789012:role/cm-ishikawa |  ALL,ALTER,CREATE_TABLE,DESCRIBE,DROP  |
+----------------------------------------------------+----------------------------------------+
テンプレートでは CreateTableDefaultPermissions に IAM_ALLOWED_PRINCIPALS を指定しています。そのうえで、データベース自体にも IAM_ALLOWED_PRINCIPALS を付与し、IAM の権限だけで動く状態にしました。
% aws lakeformation grant-permissions \
  --principal DataLakePrincipalIdentifier=IAM_ALLOWED_PRINCIPALS \
  --resource '{"Database":{"Name":"iceberg_mv_blog"}}' \
  --permissions ALL \
  --region ap-northeast-1

% aws lakeformation list-permissions \
  --resource '{"Database":{"Name":"iceberg_mv_blog"}}' \
  --region ap-northeast-1 \
  --query 'PrincipalResourcePermissions[].[Principal.DataLakePrincipalIdentifier,join(`,`,Permissions)]' \
  --output table
-----------------------------------------------------------------------------------------------
|                                       ListPermissions                                       |
+----------------------------------------------------+----------------------------------------+
|  arn:aws:iam::123456789012:role/cm-ishikawa |  ALL,ALTER,CREATE_TABLE,DESCRIBE,DROP  |
|  IAM_ALLOWED_PRINCIPALS                            |  ALL                                   |
+----------------------------------------------------+----------------------------------------+
Lake Formation のデフォルト権限を外しているアカウントで試す場合は、この点に注意してください。
外部スキーマとソーステーブルの作成
外部スキーマを作成します。ここで指定する IAM ロールが MV の定義者ロールになります。
CREATE EXTERNAL SCHEMA iceberg_mv_blog
FROM DATA CATALOG
DATABASE 'iceberg_mv_blog'
REGION 'ap-northeast-1'
IAM_ROLE 'arn:aws:iam::123456789012:role/redshift-iceberg-mv-definer-ap-northeast-1';
続いて、MV のソースにする Iceberg テーブルを 2 つ作成します。最初は VARCHAR(50) のように長さを指定していましたが、次のエラーになりました。
ERROR: VARCHAR(N) specifying length is not supported for column "customer_name" in Iceberg table. Hint: Use VARCHAR for strings in Iceberg tables.
Redshift で Iceberg テーブルを作成する場合、文字列は長さを指定しない VARCHAR にする必要がありました。修正後の SQL は以下です。
CREATE TABLE iceberg_mv_blog.customers (
    customer_id   INT,
    customer_name VARCHAR,
    region        VARCHAR
)
USING ICEBERG
LOCATION 's3://redshift-iceberg-mv-123456789012-ap-northeast-1/source/customers/';

CREATE TABLE iceberg_mv_blog.orders (
    order_id    INT,
    customer_id INT,
    order_date  DATE,
    amount      DECIMAL(10,2)
)
USING ICEBERG
LOCATION 's3://redshift-iceberg-mv-123456789012-ap-northeast-1/source/orders/';

INSERT INTO iceberg_mv_blog.customers VALUES
    (1, 'alice', 'jp'),
    (2, 'bob',   'us'),
    (3, 'carol', 'eu'),
    (4, 'dave',  'jp');

INSERT INTO iceberg_mv_blog.orders VALUES
    (1, 1, '2026-10-01', 100.00),
    (2, 2, '2026-10-01', 200.00),
    (3, 3, '2026-10-02', 150.00),
    (4, 1, '2026-10-02',  80.00),
    (5, 4, '2026-10-03', 120.00),
    (6, 2, '2026-10-03',  60.00);
Iceberg MV のソースは Iceberg フォーマットバージョン 2 以下である必要があります。Redshift で作成した orders のメタデータ JSON から主な項目を取り出すと、format-version は 2 でした。
% aws s3 cp s3://redshift-iceberg-mv-123456789012-ap-northeast-1/source/orders/metadata/00001-0e10cd25-e8f4-4c7c-9e73-6a3eeb134b51.metadata.json - --region ap-northeast-1 \
  | python3 -c 'import json,sys; d=json.load(sys.stdin); print(json.dumps({"format-version":d["format-version"],"current-snapshot-id":d.get("current-snapshot-id"),"snapshots":len(d.get("snapshots",[])),"properties":d.get("properties")},indent=2))'
{
  "format-version": 2,
  "current-snapshot-id": 16835891855951713,
  "snapshots": 1,
  "properties": {
    "write.format.default": "parquet",
    "write.parquet.compression-codec": "zstd"
  }
}
Iceberg MV の作成
次の 3 つの MV を作成します。
daily_sales: 単一テーブルの SUM / COUNT + GROUP BY(増分リフレッシュの対象)。day(order_date)でパーティション分割region_sales: Iceberg テーブル同士の INNER JOIN + SUM / COUNT(増分リフレッシュの対象)region_avg: AVG を使用(フルリフレッシュの対象)
CREATE MATERIALIZED VIEW iceberg_mv_blog.daily_sales
USING ICEBERG
LOCATION 's3://redshift-iceberg-mv-123456789012-ap-northeast-1/mv/daily_sales/'
PARTITIONED BY (day(order_date))
AS
SELECT order_date,
       SUM(amount) AS total_amount,
       COUNT(*)    AS order_count
FROM iceberg_mv_blog.orders
GROUP BY order_date;

CREATE MATERIALIZED VIEW iceberg_mv_blog.region_sales
USING ICEBERG
LOCATION 's3://redshift-iceberg-mv-123456789012-ap-northeast-1/mv/region_sales/'
AS
SELECT c.region,
       SUM(o.amount) AS total_amount,
       COUNT(*)      AS order_count
FROM iceberg_mv_blog.orders o
JOIN iceberg_mv_blog.customers c
  ON o.customer_id = c.customer_id
GROUP BY c.region;

CREATE MATERIALIZED VIEW iceberg_mv_blog.region_avg
USING ICEBERG
LOCATION 's3://redshift-iceberg-mv-123456789012-ap-northeast-1/mv/region_avg/'
AS
SELECT c.region,
       AVG(o.amount) AS avg_amount
FROM iceberg_mv_blog.orders o
JOIN iceberg_mv_blog.customers c
  ON o.customer_id = c.customer_id
GROUP BY c.region;
3 つとも作成できました。
AVG を使う region_avg の作成時には、増分リフレッシュの対象外であることを示す Info が表示されました。
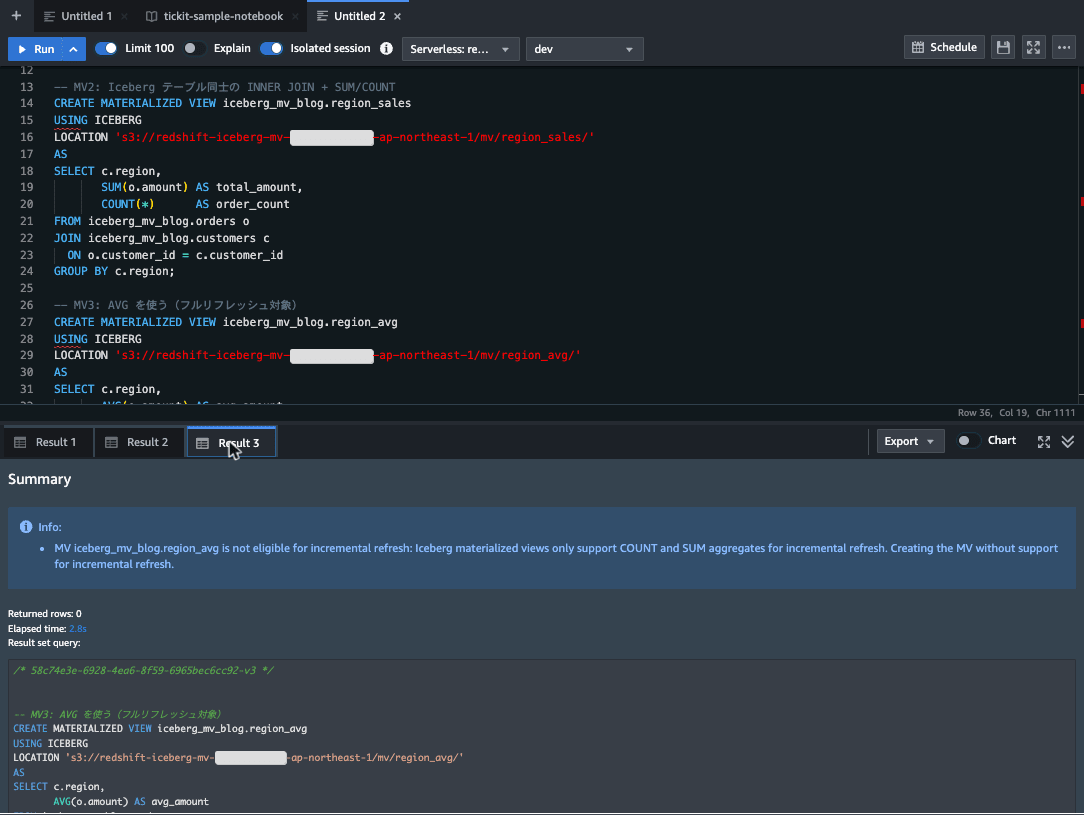
MV iceberg_mv_blog.region_avg is not eligible for incremental refresh: Iceberg materialized views only support COUNT and SUM aggregates for incremental refresh. Creating the MV without support for incremental refresh.
作成された MV を確認する
SHOW TABLES で一覧を確認します。diag_orders と diag_sales_by_region は、AWS ブログに載っている例(CTAS でソースを作り、SUM / COUNT の MV を作成する)を試したときに作成したものです。
SHOW TABLES FROM SCHEMA dev.iceberg_mv_blog;
| database_name | schema_name | table_name | table_type | table_acl | remarks | owner | last_altered_time | last_modified_time | dist_style | table_subtype |
|---|---|---|---|---|---|---|---|---|---|---|
| dev | iceberg_mv_blog | customers | EXTERNAL TABLE | NULL | NULL | NULL | NULL | DATA CATALOG TABLE | ||
| dev | iceberg_mv_blog | daily_sales | EXTERNAL TABLE | NULL | NULL | NULL | NULL | ICEBERG MATERIALIZED VIEW | ||
| dev | iceberg_mv_blog | diag_orders | EXTERNAL TABLE | NULL | NULL | NULL | NULL | DATA CATALOG TABLE | ||
| dev | iceberg_mv_blog | diag_sales_by_region | EXTERNAL TABLE | NULL | NULL | NULL | NULL | ICEBERG MATERIALIZED VIEW | ||
| dev | iceberg_mv_blog | orders | EXTERNAL TABLE | NULL | NULL | NULL | NULL | DATA CATALOG TABLE | ||
| dev | iceberg_mv_blog | region_avg | EXTERNAL TABLE | NULL | NULL | NULL | NULL | ICEBERG MATERIALIZED VIEW | ||
| dev | iceberg_mv_blog | region_sales | EXTERNAL TABLE | NULL | NULL | NULL | NULL | ICEBERG MATERIALIZED VIEW |
Iceberg MV は table_type = 'EXTERNAL TABLE'、table_subtype = 'ICEBERG MATERIALIZED VIEW' と表示されます。
一方、Redshift Serverless で今回の IAM ユーザー(Query Editor v2 のフェデレーションユーザー)から実行すると、STV_MV_INFO は permission denied for relation stv_mv_info になり、SVV_MV_INFO は 0 行でした。Iceberg MV を一覧するには SHOW TABLES を使います。
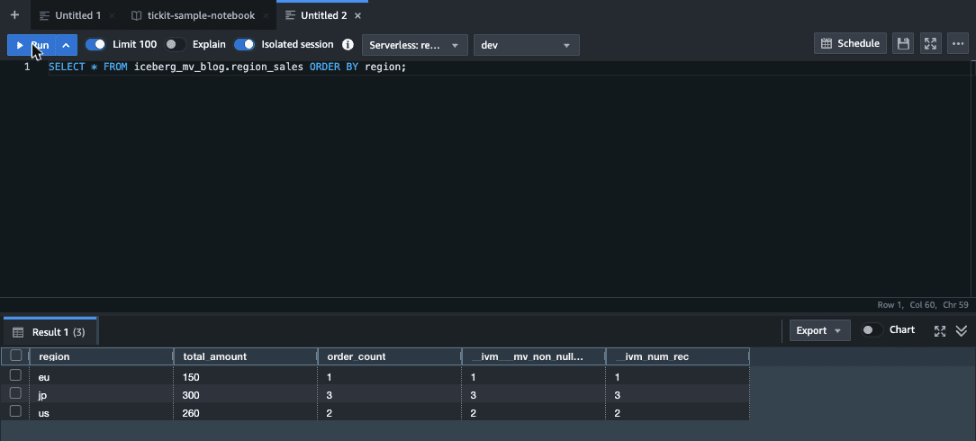
MV の中身を SELECT * で確認します。
SELECT * FROM iceberg_mv_blog.region_sales ORDER BY region;
| region | total_amount | order_count | __ivm___mv_non_null_count_aggvar_1 |
__ivm_num_rec |
|---|---|---|---|---|
| eu | 150 | 1 | 1 | 1 |
| jp | 300 | 3 | 3 | 3 |
| us | 260 | 2 | 2 | 2 |
定義に書いた 3 列のほかに、__ivm___mv_non_null_count_aggvar_1 と __ivm_num_rec という列があります。daily_sales にも同じ 2 列がありました。
SELECT * FROM iceberg_mv_blog.daily_sales ORDER BY order_date;
| order_date | total_amount | order_count | __ivm___mv_non_null_count_aggvar_1 |
__ivm_num_rec |
|---|---|---|---|---|
| 2026-10-01 | 300.00 | 2 | 2 | 2 |
| 2026-10-02 | 230.00 | 2 | 2 | 2 |
| 2026-10-03 | 180.00 | 2 | 2 | 2 |
一方、フルリフレッシュ対象の region_avg には、これらの列はありません。
SELECT * FROM iceberg_mv_blog.region_avg ORDER BY region;
| region | avg_amount |
|---|---|
| eu | 150.00 |
| jp | 100.00 |
| us | 130.00 |
増分リフレッシュの対象になる MV にだけ、列名が __ivm で始まる列が追加されています。
Glue Data Catalog の登録内容
Glue から region_sales のテーブル定義を取得します。
region_sales のテーブル定義
% aws glue get-table --database-name iceberg_mv_blog --name region_sales --region ap-northeast-1 --output json
{
    "Table": {
        "Name": "region_sales",
        "DatabaseName": "iceberg_mv_blog",
        "Owner": "redshift_iceberg",
        "CreateTime": "2026-10-19T09:27:44+09:00",
        "UpdateTime": "2026-10-19T09:27:44+09:00",
        "Retention": 0,
        "StorageDescriptor": {
            "Columns": [
                {
                    "Name": "region",
                    "Type": "string",
                    "Parameters": {
                        "Required": "false"
                    }
                },
                {
                    "Name": "total_amount",
                    "Type": "decimal(38, 2)",
                    "Parameters": {
                        "Required": "false"
                    }
                },
                {
                    "Name": "order_count",
                    "Type": "long",
                    "Parameters": {
                        "Required": "false"
                    }
                },
                {
                    "Name": "__ivm___mv_non_null_count_aggvar_1",
                    "Type": "long",
                    "Parameters": {
                        "Required": "false"
                    }
                },
                {
                    "Name": "__ivm_num_rec",
                    "Type": "long",
                    "Parameters": {
                        "Required": "false"
                    }
                }
            ],
            "Location": "s3://redshift-iceberg-mv-123456789012-ap-northeast-1/mv/region_sales",
            "Compressed": false,
            "NumberOfBuckets": 0,
            "SortColumns": [],
            "StoredAsSubDirectories": false
        },
        "TableType": "EXTERNAL_TABLE",
        "Parameters": {
            "mv_metadata_checksum": "c4b523f6e988c665b0165bc6a7ea2a17030718cc9149c110171a97b8c9c71b72",
            "auto_refresh_enabled": "false",
            "created_by_engine": "redshift",
            "metadata_location": "s3://redshift-iceberg-mv-123456789012-ap-northeast-1/mv/region_sales/metadata/00001-fd47ad1a-25cf-43b6-9abf-4103245c98df.metadata.json",
            "format": "ICEBERG",
            "mv_sub_object_versions": "16835891855951713,1669592421218426949",
            "table_type": "ICEBERG"
        },
        "CreatedBy": "arn:aws:sts::123456789012:assumed-role/redshift-iceberg-mv-definer-ap-northeast-1/RedshiftIamRoleSession",
        "IsRegisteredWithLakeFormation": false,
        "CatalogId": "123456789012",
        "VersionId": "0",
        "ViewDefinition": {
            "IsProtected": true,
            "IsManaged": false,
            "Definer": "arn:aws:iam::123456789012:role/redshift-iceberg-mv-definer-ap-northeast-1",
            "ViewVersionId": 3142918037762759303,
            "ViewVersionToken": "0",
            "LastRefreshType": "FULL",
            "SubObjects": [
                "arn:aws:glue:ap-northeast-1:123456789012:table/iceberg_mv_blog/orders",
                "arn:aws:glue:ap-northeast-1:123456789012:table/iceberg_mv_blog/customers"
            ],
            "SubObjectVersionIds": [
                16835891855951713,
                1669592421218426949
            ],
            "Representations": [
                {
                    "Dialect": "REDSHIFT",
                    "DialectVersion": "1.0",
                    "ViewOriginalText": "\nSELECT c.region,\n       SUM(o.amount) AS total_amount,\n       COUNT(*)      AS order_count\nFROM iceberg_mv_blog.orders o\nJOIN iceberg_mv_blog.customers c\n  ON o.customer_id = c.customer_id\nGROUP BY c.region;",
                    "ViewExpandedText": "SELECT \"c\".\"region\" AS \"region\", SUM(\"o\".\"amount\") AS \"total_amount\", COUNT(CAST(1 AS INT4)) AS \"order_count\" FROM \"#lf_db_d61092c987fe_temporary_iceberg_mv\".\"arn:aws:glue:ap-northeast-1:123456789012:table/iceberg_mv_blog/orders\" AS \"o\" INNER JOIN \"#lf_db_d61092c987fe_temporary_iceberg_mv\".\"arn:aws:glue:ap-northeast-1:123456789012:table/iceberg_mv_blog/customers\" AS \"c\" ON \"o\".\"customer_id\" = \"c\".\"customer_id\" GROUP BY \"c\".\"region\"",
                    "IsStale": false
                }
            ]
        },
        "IsMultiDialectView": false,
        "IsMaterializedView": true
    }
}
IsMaterializedViewがtrueで、ViewDefinitionに MV の情報が入っているDefinerは外部スキーマに指定した IAM ロールSubObjectsはソースの 2 テーブル、SubObjectVersionIdsは作成時点のソースのスナップショット ID(orders の 16835891855951713 は、前述のメタデータ JSON のcurrent-snapshot-idと同じ値)Representationsには Redshift 方言(REDSHIFT)の定義 SQL が入っているParametersにcreated_by_engine: redshift、auto_refresh_enabled: falseが入っている- 列定義には内部列(
__ivm_*)も含まれている
ドキュメントの「MV の定義とリフレッシュ状態を Glue に保存する」という説明は、この ViewDefinition に対応しています。
S3 のファイル構成
MV の保存先の S3 オブジェクトを一覧します。
% aws s3 ls s3://redshift-iceberg-mv-123456789012-ap-northeast-1/mv/ --recursive --region ap-northeast-1
2026-10-19 09:27:39       1919 mv/daily_sales/data/order_date=2026-10-01/4c66c9/20261019_6058_bcf2b8c6-6724-4b63-b535-e1007c6c50ca_64.parquet
2026-10-19 09:27:39       1919 mv/daily_sales/data/order_date=2026-10-02/49aa53/20261019_6058_4d2d4a09-005a-48a1-ae2f-e2ab85f79c0f_66.parquet
2026-10-19 09:27:39       1919 mv/daily_sales/data/order_date=2026-10-03/e5d859/20261019_6058_81088fec-e8d1-4c8e-9f3e-c3d6fe33cb48_0.parquet
2026-10-19 09:27:40       1699 mv/daily_sales/metadata/00001-bd460bc4-f105-4fd0-9fc6-c9e38b0a9270.metadata.json
2026-10-19 09:27:39       4107 mv/daily_sales/metadata/20261019_6058_0f7b32f7-5930-4d9e-b319-9e7d1e0afb8f_0.manifest.avro
2026-10-19 09:27:39       4108 mv/daily_sales/metadata/20261019_6058_99fc8a44-b21f-49c6-8d66-9394cea7abaf_66.manifest.avro
2026-10-19 09:27:39       4108 mv/daily_sales/metadata/20261019_6058_b663843b-f2c7-4784-bb3a-961623f7d2ec_64.manifest.avro
2026-10-19 09:27:40       2553 mv/daily_sales/metadata/snap-5280038748078563914-1-0f865d10-e5dd-4e76-947f-a2a498597c0b.avro
2026-10-19 09:27:47        740 mv/region_avg/data/6e0d3f/20261019_6158_9fe949a5-3357-49ca-89cf-a29d3bccc5d8_0.parquet
2026-10-19 09:27:47        740 mv/region_avg/data/713352/20261019_6158_2b9b7862-ecab-4bc0-8228-0bb1a48b7b20_66.parquet
2026-10-19 09:27:47        740 mv/region_avg/data/e2ad2a/20261019_6158_97c1d275-08b1-4e82-9680-8b5050f11f19_64.parquet
2026-10-19 09:27:47       1411 mv/region_avg/metadata/00001-ca0a0fef-7884-42d0-a64f-cf08af40725d.metadata.json
2026-10-19 09:27:47       3640 mv/region_avg/metadata/20261019_6158_236b3761-56bb-4bfe-95aa-1d3ccd040d8b_0.manifest.avro
2026-10-19 09:27:47       3641 mv/region_avg/metadata/20261019_6158_56129cf1-83fd-4587-9fec-904e3ce22d02_66.manifest.avro
2026-10-19 09:27:47       3641 mv/region_avg/metadata/20261019_6158_b896a9f6-d7f2-42d2-9a32-ad51fb726594_64.manifest.avro
2026-10-19 09:27:47       2499 mv/region_avg/metadata/snap-4033410673910401238-1-220dc0a3-3a53-495e-9104-f187be4c9d33.avro
2026-10-19 09:27:43       1859 mv/region_sales/data/39f810/20261019_6145_82411241-bb7e-4e62-aeb8-1b0fb9fb996f_64.parquet
2026-10-19 09:27:43       1859 mv/region_sales/data/70a995/20261019_6145_e7a1f734-743c-4b55-8582-b5da37ebd97f_66.parquet
2026-10-19 09:27:43       1859 mv/region_sales/data/c47b5f/20261019_6145_cef3b708-b594-479a-9e07-87d5cc84e934_0.parquet
2026-10-19 09:27:44       1625 mv/region_sales/metadata/00001-fd47ad1a-25cf-43b6-9abf-4103245c98df.metadata.json
2026-10-19 09:27:44       3925 mv/region_sales/metadata/20261019_6145_0c2fa387-ba7e-4678-9bdb-30b80f5c7f90_64.manifest.avro
2026-10-19 09:27:44       3925 mv/region_sales/metadata/20261019_6145_2b409ab8-5171-4535-b2db-a4ae55fd4a5d_66.manifest.avro
2026-10-19 09:27:44       3924 mv/region_sales/metadata/20261019_6145_962e8747-c7bf-49d8-80d5-2dc911d262b8_0.manifest.avro
2026-10-19 09:27:44       2505 mv/region_sales/metadata/snap-3142918037762759303-1-39539373-690c-4d26-a0be-d726f56d0700.avro
PARTITIONED BY (day(order_date)) を指定した daily_sales は、日付ごとのディレクトリ(order_date=2026-10-01/ など)に Parquet が書き込まれています。パーティションを指定していない region_sales と region_avg は、それぞれデータファイルが 3 つでした。
daily_sales のメタデータ JSON からも主な項目を取り出します。
% M=$(aws glue get-table --database-name iceberg_mv_blog --name daily_sales --region ap-northeast-1 --query 'Table.Parameters.metadata_location' --output text)
% aws s3 cp $M - --region ap-northeast-1 \
  | python3 -c 'import json,sys; d=json.load(sys.stdin); print(json.dumps({"format-version":d["format-version"],"partition-specs":d["partition-specs"],"properties":d.get("properties"),"snapshots":[{"snapshot-id":s["snapshot-id"],"summary":s["summary"]} for s in d.get("snapshots",[])]},indent=2,ensure_ascii=False))'
{
  "format-version": 2,
  "partition-specs": [
    {
      "spec-id": 0,
      "fields": [
        {
          "name": "day_order_date",
          "transform": "day",
          "source-id": 1,
          "field-id": 1000
        }
      ]
    }
  ],
  "properties": {
    "write.format.default": "parquet",
    "write.parquet.compression-codec": "zstd"
  },
  "snapshots": [
    {
      "snapshot-id": 5280038748078563914,
      "summary": {
        "operation": "append",
        "added-data-files": "3",
        "added-records": "3",
        "total-records": "3",
        "total-data-files": "3",
        "total-delete-files": "0",
        "total-position-deletes": "0",
        "total-equality-deletes": "0"
      }
    }
  ]
}
MV 自体も Iceberg フォーマットバージョン 2、Parquet(zstd)で、day 変換のパーティションフィールド(day_order_date)が登録されていました。作成時のスナップショットは append 1 つです。
Athena から参照する
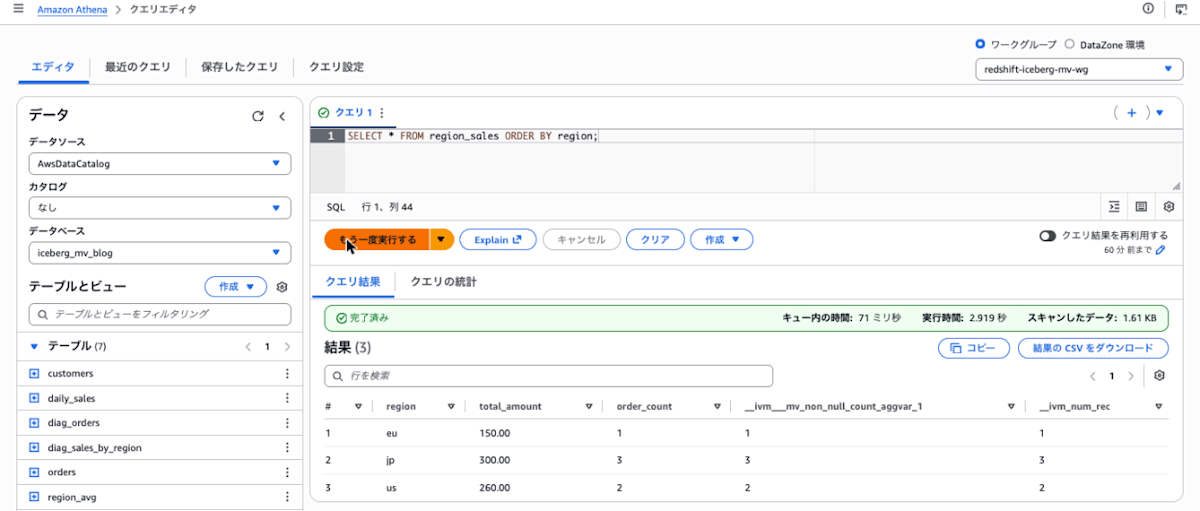
Athena のクエリエディタでデータベース iceberg_mv_blog を選ぶと、3 つの MV は「テーブル」として表示されました(「ビュー」は 0 件)。Redshift の接続なしで、Athena から MV を参照します。
SELECT * FROM region_sales ORDER BY region;
| region | total_amount | order_count | __ivm___mv_non_null_count_aggvar_1 |
__ivm_num_rec |
|---|---|---|---|---|
| eu | 150.00 | 1 | 1 | 1 |
| jp | 300.00 | 3 | 3 | 3 |
| us | 260.00 | 2 | 2 | 2 |
Redshift と同じ値が返りました(Athena engine version 3、実行時間 2.919 秒、スキャンしたデータ 1.61 KB)。Athena から SELECT * した場合も、内部列(__ivm_*)が通常の列として返ります。
リフレッシュの動作を確認する(増分 / フル)
ソースの 6 行に 2 行を追加した場合
orders に 2 行を追加して、3 つの MV をリフレッシュします。
INSERT INTO iceberg_mv_blog.orders VALUES
    (7, 3, '2026-10-03',  90.00),
    (8, 4, '2026-10-04',  50.00);

REFRESH MATERIALIZED VIEW iceberg_mv_blog.daily_sales;
REFRESH MATERIALIZED VIEW iceberg_mv_blog.region_sales;
REFRESH MATERIALIZED VIEW iceberg_mv_blog.region_avg;
増分リフレッシュの対象である daily_sales と region_sales でも、次の Info が表示され、フルリフレッシュになりました。
Materialized view daily_sales was fully refreshed. Future refreshes may be incremental. Reason: Delta threshold exceeded for arn:aws:glue:ap-northeast-1:123456789012:table/iceberg_mv_blog/orders.
Materialized view region_sales was fully refreshed. Future refreshes may be incremental. Reason: Delta threshold exceeded for arn:aws:glue:ap-northeast-1:123456789012:table/iceberg_mv_blog/orders.
Materialized view region_avg was recomputed.
ソースの変更量が一定の割合(Delta threshold)を超えると、増分リフレッシュの対象の MV でもフルリフレッシュになるようです。この判定はドキュメントには記載されていません。6 行に対して 2 行の追加は、割合としては大きい変更です。
リフレッシュの履歴を確認します。ドキュメントには SVL_MV_REFRESH_STATUS の例が載っていますが、今回の Redshift Serverless 環境では permission denied for relation svl_mv_refresh_status になりました。そこで SYS_MV_REFRESH_HISTORY を使います(duration の単位はマイクロ秒です)。
SELECT mv_name, TRIM(status) AS status, refresh_type, start_time, duration
FROM sys_mv_refresh_history
WHERE schema_name = 'iceberg_mv_blog'
ORDER BY start_time;
| mv_name | status | refresh_type | start_time | duration |
|---|---|---|---|---|
| daily_sales | Refresh successfully recomputed MV from scratch | Manual | 2026-10-19 00:32:34.544931 | 1735095 |
| region_sales | Refresh successfully recomputed MV from scratch | Manual | 2026-10-19 00:32:37.093283 | 1629545 |
| region_avg | Refresh successfully recomputed MV from scratch | Manual | 2026-10-19 00:32:39.538226 | 1581982 |
ソースを 1,000 行に増やしてから 1 行を追加した場合
変更の割合を小さくするため、orders に 1,000 行を追加してリフレッシュし、その後 1 行だけ追加してリフレッシュします。
-- 1,000 行を追加
INSERT INTO iceberg_mv_blog.orders
SELECT
    1000 + a.n * 100 + b.n * 10 + c.n                        AS order_id,
    (a.n + b.n + c.n) % 4 + 1                                AS customer_id,
    DATEADD(day, (a.n + b.n + c.n) % 5, '2026-10-01')::date AS order_date,
    10.00::decimal(10, 2)                                    AS amount
FROM (
    SELECT 0 AS n UNION ALL
    SELECT 1      UNION ALL
    SELECT 2      UNION ALL
    SELECT 3      UNION ALL
    SELECT 4      UNION ALL
    SELECT 5      UNION ALL
    SELECT 6      UNION ALL
    SELECT 7      UNION ALL
    SELECT 8      UNION ALL
    SELECT 9
) a
CROSS JOIN (
    SELECT 0 AS n UNION ALL
    SELECT 1      UNION ALL
    SELECT 2      UNION ALL
    SELECT 3      UNION ALL
    SELECT 4      UNION ALL
    SELECT 5      UNION ALL
    SELECT 6      UNION ALL
    SELECT 7      UNION ALL
    SELECT 8      UNION ALL
    SELECT 9
) b
CROSS JOIN (
    SELECT 0 AS n UNION ALL
    SELECT 1      UNION ALL
    SELECT 2      UNION ALL
    SELECT 3      UNION ALL
    SELECT 4      UNION ALL
    SELECT 5      UNION ALL
    SELECT 6      UNION ALL
    SELECT 7      UNION ALL
    SELECT 8      UNION ALL
    SELECT 9
) c;

REFRESH MATERIALIZED VIEW iceberg_mv_blog.daily_sales;
REFRESH MATERIALIZED VIEW iceberg_mv_blog.region_sales;
REFRESH MATERIALIZED VIEW iceberg_mv_blog.region_avg;
1,000 行の追加(Affected rows: 1000)後は、次のとおり前回と同じく Delta threshold exceeded でフルリフレッシュでした。
Materialized view daily_sales was fully refreshed. Future refreshes may be incremental. Reason: Delta threshold exceeded for arn:aws:glue:ap-northeast-1:123456789012:table/iceberg_mv_blog/orders.
Materialized view region_sales was fully refreshed. Future refreshes may be incremental. Reason: Delta threshold exceeded for arn:aws:glue:ap-northeast-1:123456789012:table/iceberg_mv_blog/orders.
Materialized view region_avg was recomputed.
続いて、1,008 行になった orders に 1 行だけ追加します。
-- 1 行だけ追加
INSERT INTO iceberg_mv_blog.orders VALUES (9, 3, '2026-10-04', 500.00);

REFRESH MATERIALIZED VIEW iceberg_mv_blog.daily_sales;
REFRESH MATERIALIZED VIEW iceberg_mv_blog.region_sales;
REFRESH MATERIALIZED VIEW iceberg_mv_blog.region_avg;
今度は daily_sales と、INNER JOIN の region_sales が増分リフレッシュになりました。
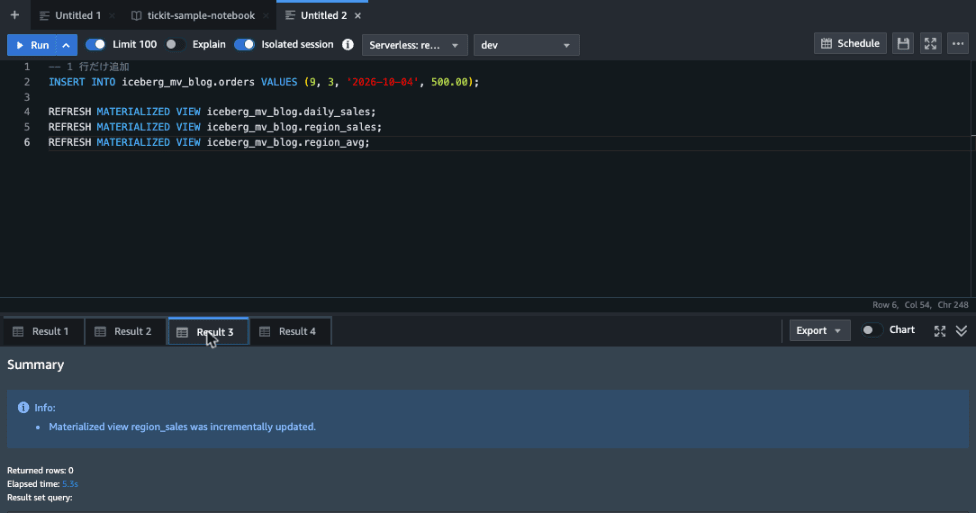
Materialized view daily_sales was incrementally updated.
Materialized view region_sales was incrementally updated.
Materialized view region_avg was recomputed.
ここまでのリフレッシュ履歴は以下です。
SELECT TRIM(mv_name) AS mv_name, TRIM(status) AS status, TRIM(refresh_type) AS refresh_type, start_time
FROM sys_mv_refresh_history
WHERE schema_name = 'iceberg_mv_blog'
ORDER BY start_time;
| mv_name | status | refresh_type | start_time |
|---|---|---|---|
| daily_sales | Refresh successfully recomputed MV from scratch | Manual | 2026-10-19 00:32:34.544931 |
| region_sales | Refresh successfully recomputed MV from scratch | Manual | 2026-10-19 00:32:37.093283 |
| region_avg | Refresh successfully recomputed MV from scratch | Manual | 2026-10-19 00:32:39.538226 |
| daily_sales | Refresh successfully recomputed MV from scratch | Manual | 2026-10-19 00:34:27.89646 |
| region_sales | Refresh successfully recomputed MV from scratch | Manual | 2026-10-19 00:34:30.62646 |
| region_avg | Refresh successfully recomputed MV from scratch | Manual | 2026-10-19 00:34:33.378693 |
| daily_sales | Refresh successfully updated MV incrementally | Manual | 2026-10-19 00:35:15.315989 |
| region_sales | Refresh successfully updated MV incrementally | Manual | 2026-10-19 00:35:20.737085 |
| region_avg | Refresh successfully recomputed MV from scratch | Manual | 2026-10-19 00:35:26.297112 |
増分リフレッシュは Refresh successfully updated MV incrementally、フルリフレッシュは Refresh successfully recomputed MV from scratch と記録されます。
DELETE / UPDATE の場合
1 行の DELETE と 1 行の UPDATE の後にも、それぞれリフレッシュします。
DELETE FROM iceberg_mv_blog.orders WHERE order_id = 9;
REFRESH MATERIALIZED VIEW iceberg_mv_blog.daily_sales;
REFRESH MATERIALIZED VIEW iceberg_mv_blog.region_sales;

UPDATE iceberg_mv_blog.orders SET amount = 120.00 WHERE order_id = 1;
REFRESH MATERIALIZED VIEW iceberg_mv_blog.daily_sales;
REFRESH MATERIALIZED VIEW iceberg_mv_blog.region_sales;
DELETE、UPDATE とも Affected rows は 1 で、4 回の REFRESH はすべて incrementally updated でした。
SELECT TRIM(mv_name) AS mv_name, TRIM(status) AS status, start_time
FROM sys_mv_refresh_history
WHERE schema_name = 'iceberg_mv_blog' AND start_time > '2026-10-19 00:36:00'
ORDER BY start_time;
| mv_name | status | start_time |
|---|---|---|
| daily_sales | Refresh successfully updated MV incrementally | 2026-10-19 00:36:54.985699 |
| region_sales | Refresh successfully updated MV incrementally | 2026-10-19 00:36:59.692358 |
| daily_sales | Refresh successfully updated MV incrementally | 2026-10-19 00:37:07.331847 |
| region_sales | Refresh successfully updated MV incrementally | 2026-10-19 00:37:12.017439 |
結果の正しさを確認する
増分リフレッシュで正しい値になっているかを確認するため、MV の値とソースを直接集計した値を突き合わせます。DELETE / UPDATE 後の region_sales です。
SELECT m.region,
       m.total_amount AS mv_total, s.total_amount AS src_total,
       m.order_count  AS mv_cnt,   s.order_count  AS src_cnt
FROM iceberg_mv_blog.region_sales m
FULL JOIN (
    SELECT c.region, SUM(o.amount) AS total_amount, COUNT(*) AS order_count
    FROM iceberg_mv_blog.orders o
    JOIN iceberg_mv_blog.customers c ON o.customer_id = c.customer_id
    GROUP BY c.region
) s ON m.region = s.region
ORDER BY 1;
| region | mv_total | src_total | mv_cnt | src_cnt |
|---|---|---|---|---|
| eu | 2750.00 | 2750.00 | 253 | 253 |
| jp | 5350.00 | 5350.00 | 502 | 502 |
| us | 2770.00 | 2770.00 | 253 | 253 |
DELETE / UPDATE 後の daily_sales です。
SELECT COALESCE(m.order_date, s.order_date) AS order_date,
       m.total_amount AS mv_total, s.total_amount AS src_total,
       m.order_count  AS mv_cnt,   s.order_count  AS src_cnt
FROM iceberg_mv_blog.daily_sales m
FULL JOIN (
    SELECT order_date, SUM(amount) AS total_amount, COUNT(*) AS order_count
    FROM iceberg_mv_blog.orders
    GROUP BY order_date
) s ON m.order_date = s.order_date
ORDER BY 1;
| order_date | mv_total | src_total | mv_cnt | src_cnt |
|---|---|---|---|---|
| 2026-10-01 | 2320.00 | 2320.00 | 202 | 202 |
| 2026-10-02 | 2230.00 | 2230.00 | 202 | 202 |
| 2026-10-03 | 2270.00 | 2270.00 | 203 | 203 |
| 2026-10-04 | 2050.00 | 2050.00 | 201 | 201 |
| 2026-10-05 | 2000.00 | 2000.00 | 200 | 200 |
1 行追加後の REFRESH(region_avg は最後にリフレッシュした時点)の region_avg です。
SELECT m.region, m.avg_amount AS mv_avg, s.avg_amount AS src_avg
FROM iceberg_mv_blog.region_avg m
FULL JOIN (
    SELECT c.region, AVG(o.amount) AS avg_amount
    FROM iceberg_mv_blog.orders o
    JOIN iceberg_mv_blog.customers c ON o.customer_id = c.customer_id
    GROUP BY c.region
) s ON m.region = s.region
ORDER BY 1;
| region | mv_avg | src_avg |
|---|---|---|
| eu | 12.79 | 12.79 |
| jp | 10.61 | 10.61 |
| us | 10.94 | 10.94 |
いずれも一致しました。Athena から読んだ DELETE / UPDATE 後の region_sales も、eu 2750.00 / 253、jp 5350.00 / 502、us 2770.00 / 253 で同じ値でした。
増分リフレッシュで MV に何が書き込まれたか
1 行追加後の増分リフレッシュの直後、Glue の登録内容は次のように変わっていました。
aws glue get-table --database-name iceberg_mv_blog --name region_sales --region ap-northeast-1 \
  --query 'Table.{UpdateTime:UpdateTime,LastRefreshType:ViewDefinition.LastRefreshType,ViewVersionId:ViewDefinition.ViewVersionId,SubObjectVersionIds:ViewDefinition.SubObjectVersionIds,mv_sub_object_versions:Parameters.mv_sub_object_versions}' \
  --output json
{
    "UpdateTime": "2026-10-19T09:35:25+09:00",
    "LastRefreshType": "INCREMENTAL",
    "ViewVersionId": 6628680760292774923,
    "SubObjectVersionIds": [
        1669592421218426949,
        2956492144512067407
    ],
    "mv_sub_object_versions": "16835891855951713,1669592421218426949"
}
LastRefreshType が INCREMENTAL になり、SubObjectVersionIds には orders の最新スナップショット ID(2956492144512067407)が入っています。ViewVersionId は、MV 自体の Iceberg スナップショット ID と同じ値でした(次の $snapshots の 4 行目)。一方、Parameters の mv_sub_object_versions は作成時の値のままでした。
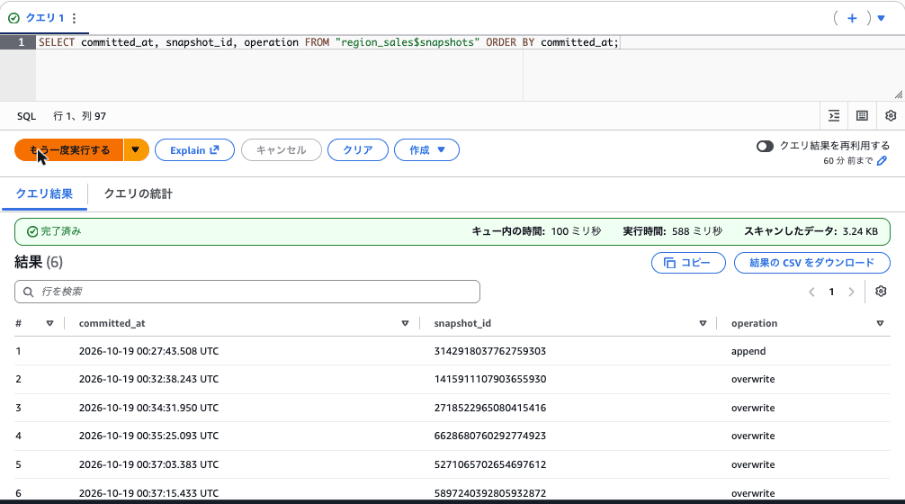
MV のスナップショット履歴は、Athena から Iceberg のメタデータテーブル $snapshots で確認できます。まずコンソールで一覧を表示しました。
SELECT committed_at, snapshot_id, operation FROM "region_sales$snapshots" ORDER BY committed_at;
summary から追加行数と position delete の件数も取り出します。
SELECT committed_at, snapshot_id, operation,
       summary['added-records']          AS added_records,
       summary['added-position-deletes'] AS added_pos_deletes
FROM "region_sales$snapshots"
ORDER BY committed_at;
| committed_at | snapshot_id | operation | added_records | added_pos_deletes |
|---|---|---|---|---|
| 2026-10-19 00:27:43.508 UTC | 3142918037762759303 | append | 3 | |
| 2026-10-19 00:32:38.243 UTC | 1415911107903655930 | overwrite | 3 | 0 |
| 2026-10-19 00:34:31.950 UTC | 2718522965080415416 | overwrite | 3 | 0 |
| 2026-10-19 00:35:25.093 UTC | 6628680760292774923 | overwrite | 1 | 1 |
| 2026-10-19 00:37:03.383 UTC | 5271065702654697612 | overwrite | 1 | 1 |
| 2026-10-19 00:37:15.433 UTC | 5897240392805932872 | overwrite | 1 | 1 |
- 作成時:
appendで 3 行(3 リージョン分)を書き込む - フルリフレッシュ(2 行目・3 行目):
overwriteで 3 行すべてを書き直す - 増分リフレッシュ(4〜6 行目): 値が変わった 1 リージョン分について、position delete で古い行を 1 行削除し、新しい行を 1 行追加する
増分リフレッシュのたびに、小さなデータファイルと delete ファイルが増えていきます。汎用 S3 バケットに保存する場合は、ドキュメントにあるとおり、Spark の rewrite_data_files などで定期的にコンパクションする必要があります。
制限事項を確認する
ドキュメントに記載されている制限を、いくつか試しました。いずれも、作成の段階で専用のエラーメッセージを返して拒否されました。
| 試した内容 | エラーメッセージ |
|---|---|
| Redshift ネイティブテーブルをソースにする | Iceberg materialized view can only reference Iceberg tables. Table "local_orders" is not an Iceberg table. |
| ORDER BY を含める | Materialized views do not support ORDER BY clauses. |
AUTO REFRESH YES を指定する |
AUTO REFRESH is not supported with CREATE MATERIALIZED VIEW USING ICEBERG. |
| GETDATE() を含める | Iceberg materialized views cannot use mutable functions (e.g., getdate). |
同じセッションで SET enable_case_sensitive_identifier TO true の後に作成する |
CREATE MATERIALIZED VIEW USING ICEBERG is not supported when case sensitive identifiers are enabled. |
なお、AUTO REFRESH NO を USING ICEBERG の前に書くと、syntax error at or near "USING" in context "AUTO REFRESH NO USING", at line 1 になりました。USING ICEBERG は MV 名の直後に書く必要があります。
DROP MATERIALIZED VIEW
region_avg を DROP します。
DROP MATERIALIZED VIEW iceberg_mv_blog.region_avg;
Glue からは削除されましたが、S3 のデータは残っていました。
% aws glue get-table --database-name iceberg_mv_blog --name region_avg --region ap-northeast-1 --query 'Table.Name' --output text
aws: [ERROR]: An error occurred (EntityNotFoundException) when calling the GetTable operation: Entity Not Found
% aws s3 ls s3://redshift-iceberg-mv-123456789012-ap-northeast-1/mv/region_avg/ --recursive --summarize --region ap-northeast-1 | tail -3

Total Objects: 32
   Total Size: 74049
この状態で、同じ LOCATION に MV を作り直すと、次のエラーになります。
ERROR: Cannot create Iceberg table: S3 location "s3://redshift-iceberg-mv-123456789012-ap-northeast-1/mv/region_avg" contains existing objects
  Hint: Please provide an empty S3 location or specify a different path
DROP した MV を同じパスで作り直す場合は、先に S3 のプレフィックスを削除する必要があります。
考察
検証結果から、注意点を整理します。
最初に、ベースキャパシティについてです。4 RPU(1.0.477953 / patch 205)の workgroup では、AWS ブログに載っている例を含めて試したすべての MV が、次のエラーで作成できませんでした。
ERROR: External Catalog Error: Detail: ----------------------------------------------- error: External Catalog Error: code: 16000 context: Invalid column type for column $ivm_path_hash. query: 1796[child_sequence:1] location: s3_request_builder.cpp:3610 process: padbmaster [pid=1073824039] -----------------------------------------------
ベースキャパシティを 8 RPU に変更すると、同じバージョンで作成できました。4 RPU に戻して再現するかは確認していないため、原因が 4 RPU の構成にあるとは断定できません。Iceberg MV を試す場合は、8 RPU 以上で始めるのが無難です。なお、最新の patch 206(1.0.485645)は、検証時点で東京リージョンには適用されていませんでした。
そのほかの注意点は以下です。
- 増分リフレッシュの対象でも、変更量が大きいとフルリフレッシュになる: 6 行に 2 行、8 行に 1,000 行を追加した場合は、
Delta threshold exceededでフルリフレッシュになりました。1,008 行に対する 1 行の INSERT / DELETE / UPDATE では、増分リフレッシュになりました。しきい値の具体的な値はドキュメントにも Info にも示されていません。実際にどちらで実行されたかは、REFRESH の Info かSYS_MV_REFRESH_HISTORYのstatusで確認できます。 - 内部列が下流のエンジンに見える: 増分リフレッシュの対象の MV には、
__ivm___mv_non_null_count_aggvar_1と__ivm_num_recが Glue の列定義として登録されます。そのため、Athena などからSELECT *すると、これらの列も返ります。利用者には、必要な列を明示して参照してもらう運用が必要です。 - Redshift Serverless での監視: ドキュメントの例にある
SVL_MV_REFRESH_STATUSとSTV_MV_INFOは、今回の環境ではpermission deniedでした。リフレッシュ履歴はSYS_MV_REFRESH_HISTORY、一覧はSHOW TABLESで確認できます。 - 汎用 S3 ではファイルが増え続ける: 増分リフレッシュのたびに、データファイルと position delete ファイルが追加されます。汎用 S3 バケットに保存する場合はコンパクションとスナップショットの期限切れ処理を計画し、それを避けたい場合は S3 テーブルバケットの利用を検討します。
- DROP しても S3 のデータは残る: DROP しても S3 のデータは消えないため、同じパスでの作り直しやストレージ費用のために、S3 プレフィックスの削除が別途必要です。
- Lake Formation の設定に依存する: Lake Formation のデフォルト権限を外しているアカウントでは、AWS ブログの手順どおりには IAM だけで動きません。Glue データベースへの
IAM_ALLOWED_PRINCIPALSの付与、または Lake Formation での権限付与が必要です。 - Iceberg テーブルの文字列型: Redshift で Iceberg テーブルを作成する場合、
VARCHAR(N)は使えずVARCHARを指定します。
今後、以下の対応に期待したいです。
- AUTO REFRESH への対応
- Iceberg MV を使った自動クエリリライトへの対応
- 4 RPU 構成での作成エラーの解消
最後に
Redshift の SQL だけで、結合・集計の結果を Iceberg テーブルとして S3 に保存できるようになりました。作成した MV は Glue Data Catalog に IsMaterializedView: true のテーブルとして登録され、Athena から Redshift に接続せずに読めました。INNER JOIN を含む MV でも、ソースの小さな変更(INSERT / DELETE / UPDATE)は増分リフレッシュで反映され、結果はソースを直接集計した値と一致しました。
一方で、変更量によるフルリフレッシュへの切り替え、下流のエンジンから見える内部列、DROP 後に S3 に残るデータなど、ドキュメントからは読み取れない動作もありました。Redshift で作った集計結果を Athena や Spark のユーザーと共有したい場合や、Iceberg を前提にデータ基盤を揃えたい場合は、まず Serverless で小さな MV を作り、リフレッシュの種類と下流からの見え方を確認してみてください。Redshift からしか参照しない、読み取りの速さを優先したいといった用途では、従来の RMS のマテリアライズドビューも選択肢になります。
合わせて読みたい