Amazon Aurora DSQL の SQL ステートメント統計を有効にして Database Insights と PromQL で確認してみた

はじめに
2026年11月17日に、Aurora DSQL の SQL ステートメント統計(statement statistics)が発表されました。
この機能は、クラスターが実行した SQL ごとに実行回数、所要時間、行数、DPU を記録し、CloudWatch の OpenTelemetry(OTel)メトリクスとして出力します。今回は、稼働中のクラスター(us-west-2)で機能を有効にし、検証用テーブルに SQL を流して、PromQL、Database Insights、CloudWatch Logs で確認しました。
有効化と反映
設定と確認
update-cluster の --metric-groups に STATEMENT_STATISTICS を指定すると有効になります。
aws dsql update-cluster --identifier <クラスターID> --metric-groups '[{"metricGroup":"STATEMENT_STATISTICS"}]' --region us-west-2 --output json
{
    "status": "UPDATING"
}
get-cluster の metricGroups で設定を確認できます。
aws dsql get-cluster --identifier <クラスターID> --region us-west-2 --query '{status:status,metricGroups:metricGroups}' --output json
{
    "status": "ACTIVE",
    "metricGroups": [
        {
            "metricGroup": "STATEMENT_STATISTICS"
        }
    ]
}
反映までの時間
設定の数分後に、正規化 SQL テキストの書き込み先であるロググループ /aws/dsql/normalized-sql-text が作成され、同時に書き込みも確認できました。設定直後に SQL を実行したため、作成と書き込みが同じタイミングになっています。
統計の取得
以降の表と画面には、テーブル名に stmtstat_ を含む検証用の文だけを載せています。
検証用テーブル stmtstat_orders には9,000行を投入しました。1トランザクションで扱える行数に上限があるため、3,000行ずつ3回に分けています。
検証用テーブルの作成(01-setup.sql)
CREATE TABLE stmtstat_orders (id bigint PRIMARY KEY, customer_id int NOT NULL, status text NOT NULL, amount int NOT NULL);
INSERT INTO stmtstat_orders SELECT g, (g % 1000) + 1, CASE WHEN g % 10 = 0 THEN 'cancelled' ELSE 'paid' END, (g * 7) % 5000 FROM generate_series(1, 3000) AS g;
INSERT INTO stmtstat_orders SELECT g, (g % 1000) + 1, CASE WHEN g % 10 = 0 THEN 'cancelled' ELSE 'paid' END, (g * 7) % 5000 FROM generate_series(3001, 6000) AS g;
INSERT INTO stmtstat_orders SELECT g, (g % 1000) + 1, CASE WHEN g % 10 = 0 THEN 'cancelled' ELSE 'paid' END, (g * 7) % 5000 FROM generate_series(6001, 9000) AS g;
SELECT count(*) FROM stmtstat_orders;
PromQL
取得に使った PromQL クエリは次のとおりです。メトリクスの各データポイントの値は、直前のデータポイントからの増分です。rate() ではなく sum_over_time() で時間範囲内の値を足し、続けて query ID ごとに sum by で合算します。
topk(100, sum by ("db.query.id") (sum_over_time({"aws.dsql.query.calls", "@resource.aws.dsql.cluster_id"="<クラスターID>"}[1h])))
上のクエリの aws.dsql.query.calls を差し替えて、aws.dsql.query. で始まる10個のメトリクスをそれぞれ取得できます。
次の表は、メトリクスごとの結果を query ID で結合し、正規化 SQL テキストと並べたものです。10個のメトリクスのうち7つを示します。各値は直近1時間の合計です。
| 正規化 SQL | calls | time (s) | rows | scanned_rows | compute_dpu | read_dpu | write_dpu |
|---|---|---|---|---|---|---|---|
| SELECT count(*) FROM stmtstat_orders WHERE customer_id = $0 | 22 | 0.222186 | 22 | 198161 | 0.200141 | 11.8401 | 0 |
| SELECT * FROM stmtstat_orders WHERE id = $0 | 10 | 0.009784 | 10 | 10 | 0.008134 | 0.00234 | 0 |
| UPDATE stmtstat_orders SET amount = amount + $0 WHERE id = $1 | 5 | 0.009116 | 5 | 5 | 0.008783 | 0.004218 | 0.03125 |
| INSERT INTO stmtstat_orders SELECT g, ... | 3 | 0.115042 | 9000 | 15 | 0.114245 | 2.11671 | 56.25 |
| DELETE FROM stmtstat_orders WHERE id = $0 | 3 | 0.004036 | 3 | 3 | 0.003895 | 0.001404 | 0.01875 |
customer_id を 1 から 22 まで変えた22回の SELECT は、コメントや空白だけが違う2文を含めて1つの query ID にまとまりました。流した文は次のとおりです。
SELECT count(*) FROM stmtstat_orders WHERE customer_id = 1;
SELECT count(*) FROM stmtstat_orders WHERE customer_id = 2;
-- customer_id = 3 から 20 まで同形
/* batch-job */ SELECT count(*)   FROM stmtstat_orders WHERE customer_id = 21;
SELECT count(*) FROM stmtstat_orders WHERE customer_id = 22; -- trailing comment
PromQL を実行するスクリプト(promql-calls.sh)
PromQL は、コンソールの Query Studio のほかに、署名付きリクエストで HTTP API からも実行できます。次のスクリプトは awscurl を使い、第1引数のメトリクス名、第2引数のクラスターID、第3引数の時間範囲(省略時は 1h)でクエリを実行します。
#!/usr/bin/env bash
# usage: promql-calls.sh <metric> <cluster-id> [range]  例: promql-calls.sh aws.dsql.query.calls $CL 1h
set -euo pipefail
M="$1"; CL="$2"; RANGE="${3:-1h}"
Q="topk(100, sum by (\"db.query.id\") (sum_over_time({\"${M}\", \"@resource.aws.dsql.cluster_id\"=\"${CL}\"}[${RANGE}])))"
ENC="$(python3 -c 'import sys,urllib.parse;print("query="+urllib.parse.quote(sys.argv[1]))' "$Q")"
awscurl --service monitoring --region us-west-2 --profile "${AWS_PROFILE:-default}" \
  -X POST 'https://monitoring.us-west-2.amazonaws.com/api/v1/query' \
  -H 'Content-Type: application/x-www-form-urlencoded' \
  -d "$ENC"
Database Insights
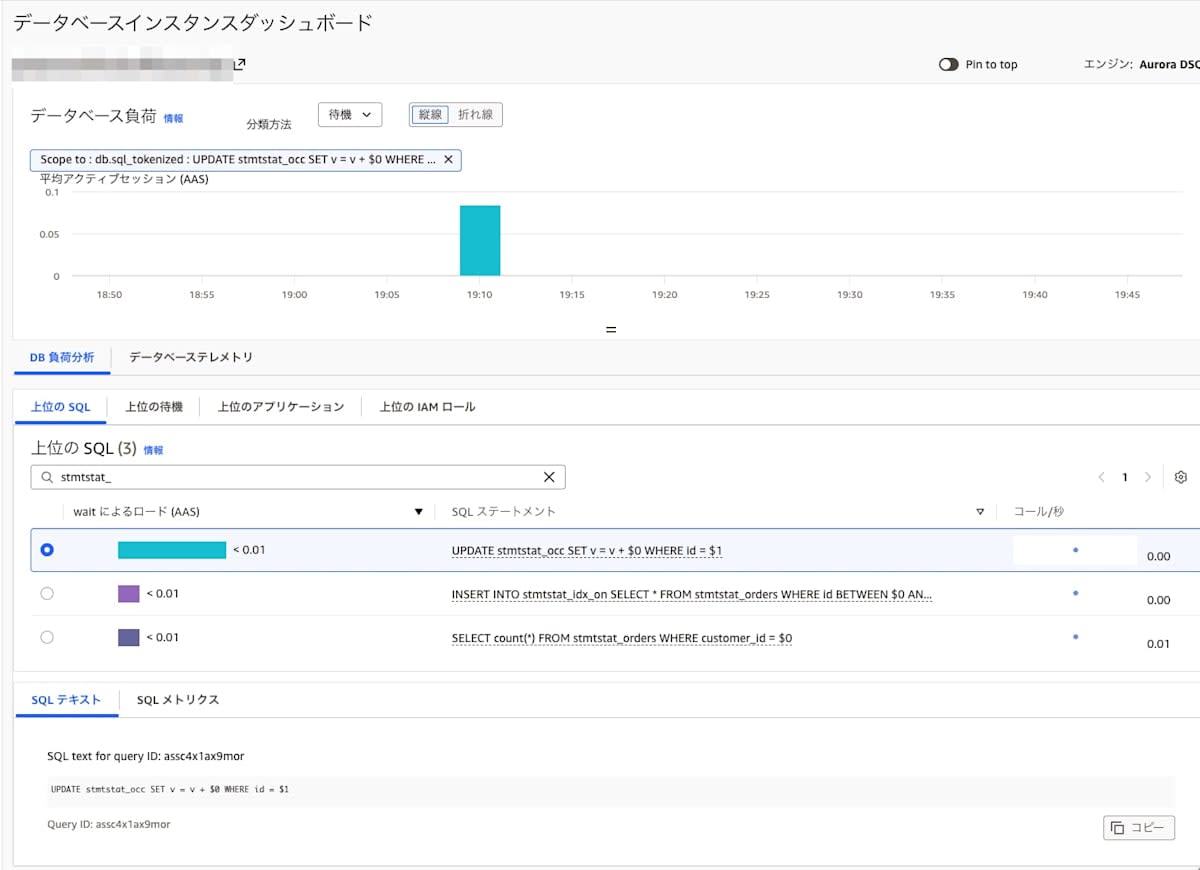
CloudWatch コンソールの Database Insights でクラスターを開き、Top SQL の検索欄に stmtstat_ を入力すると、検証用の文に絞り込まれます。文を選ぶと、SQL テキストと Query ID が下部に表示されました。
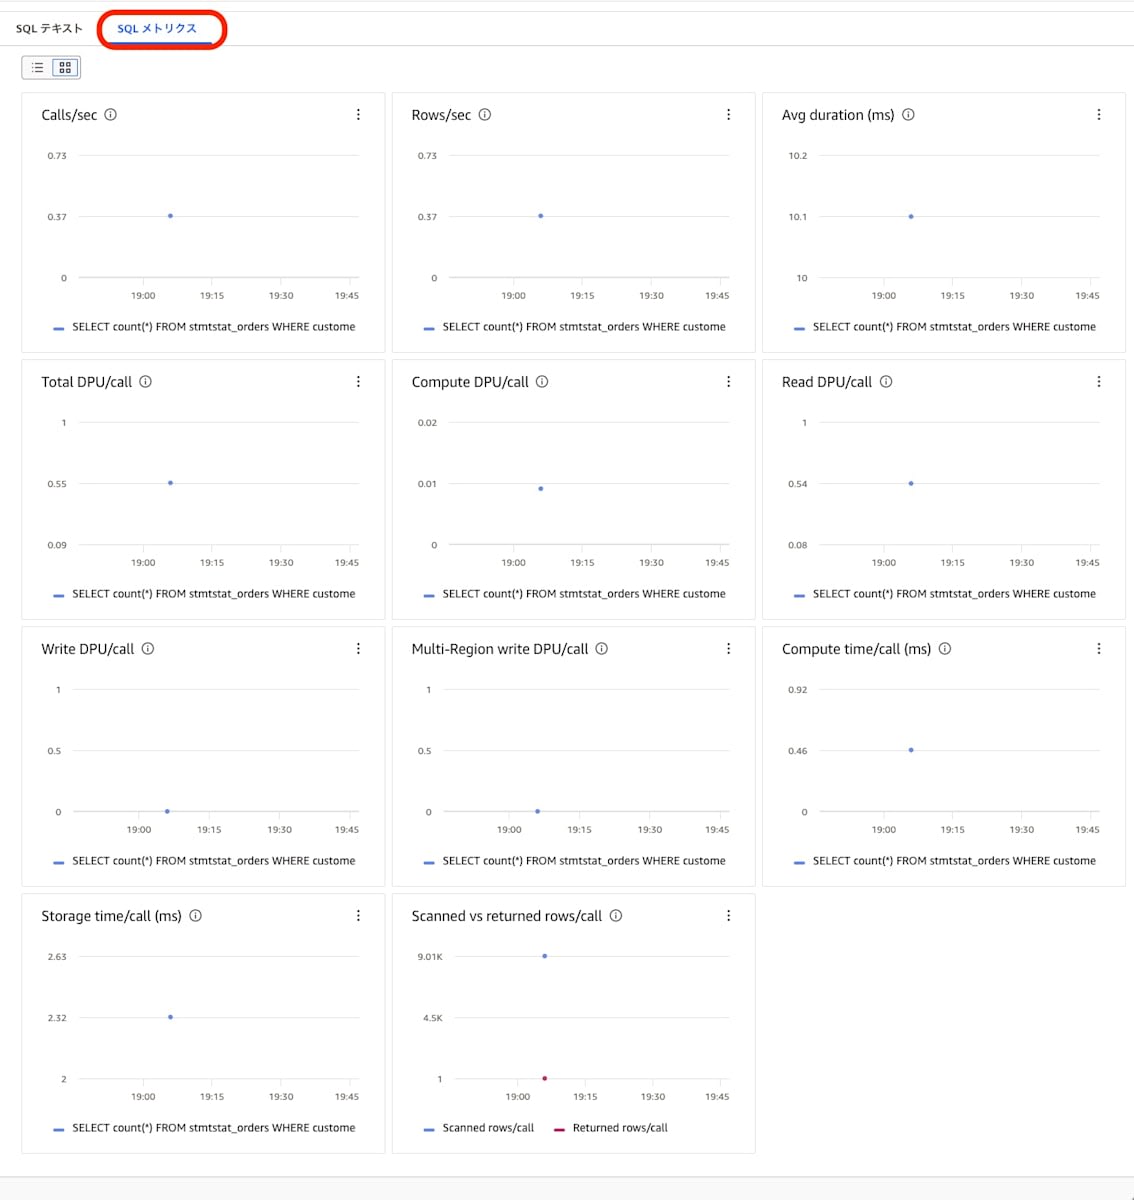
SQL メトリクスタブには、選択した文のチャートが11個並びます。
CloudWatch Logs
PromQL の結果では、文は query ID でしか示されません。query ID に対応する正規化 SQL は、ロググループ /aws/dsql/normalized-sql-text を Logs Insights で検索すると取得できます。
fields @timestamp, queryId, normalizedText | filter queryId = '<query ID>' | dedup queryId
時間範囲は、調べたい期間の開始時刻より3時間前から取ります。実行され続けている文の正規化 SQL は、少なくとも3時間ごとに再び書き込まれるためです。ログ1件は queryId、clusterId、normalizedText を持つ JSON です。
スキャン行数とインデックス
stmtstat_orders と同じ9,000行を持つ2つのテーブル(stmtstat_idx_off、stmtstat_idx_on)を作りました。インデックスは stmtstat_idx_on の customer_id 列にだけ作成しました。
インデックスは空のテーブルに作成し、9,000行はその後に投入しています。CREATE INDEX ASYNC はインデックスを非同期に作成するため、次のクエリで完了を確かめてから検索を流しました。
SELECT * FROM sys.jobs ORDER BY 1 DESC LIMIT 3;
検索は、各テーブルに対して SELECT count(*) FROM <テーブル名> WHERE customer_id = N の N を 1 から 20 まで変えて20回流しました。さらに、customer_id = 5 の検索を EXPLAIN ANALYZE でもう1回実行しました。各テーブルの calls は21です。
比較用テーブルの作成とデータ投入
CREATE TABLE stmtstat_idx_off (id bigint PRIMARY KEY, customer_id int NOT NULL, status text NOT NULL, amount int NOT NULL);
CREATE TABLE stmtstat_idx_on  (id bigint PRIMARY KEY, customer_id int NOT NULL, status text NOT NULL, amount int NOT NULL);
CREATE INDEX ASYNC stmtstat_idx_on_cust ON stmtstat_idx_on (customer_id);
INSERT INTO stmtstat_idx_off SELECT * FROM stmtstat_orders WHERE id BETWEEN 1 AND 3000;
INSERT INTO stmtstat_idx_off SELECT * FROM stmtstat_orders WHERE id BETWEEN 3001 AND 6000;
INSERT INTO stmtstat_idx_off SELECT * FROM stmtstat_orders WHERE id BETWEEN 6001 AND 9000;
INSERT INTO stmtstat_idx_on SELECT * FROM stmtstat_orders WHERE id BETWEEN 1 AND 3000;
INSERT INTO stmtstat_idx_on SELECT * FROM stmtstat_orders WHERE id BETWEEN 3001 AND 6000;
INSERT INTO stmtstat_idx_on SELECT * FROM stmtstat_orders WHERE id BETWEEN 6001 AND 9000;
| インデックス無し | インデックス有り | |
|---|---|---|
| calls | 21 | 21 |
| time 合計 (s) | 0.194082 | 0.028278 |
| scanned_rows 合計 | 189002 | 200 |
| scanned_rows ÷ calls | 約9,000.1 | 約9.52 |
| read_dpu 合計 | 11.2489 | 0.01871 |
インデックスを作成したテーブルでは、作成していないテーブルに比べて、scanned_rows と time の合計がともに減少したことを確認できました。
記録の対象
記録される文
SELECT、INSERT、UPDATE、DELETE が記録されました。
記録されない文
次の文は、PromQL の結果と正規化 SQL テキストのログのどちらにも出ませんでした。
- BEGIN と COMMIT
- CREATE TABLE、CREATE INDEX ASYNC、DROP TABLE
- SHOW application_name
- 存在しない列を参照してエラーになった SELECT
まとめ
Aurora DSQL の SQL ステートメント統計は、update-cluster で STATEMENT_STATISTICS を指定すると有効になります。
所要時間、実行回数、DPU の面で影響の大きな SQL を特定でき、SQL やインデックスの改善対象を見つけるのに役立ちます。
ステートメント統計には CloudWatch の標準のメトリクス料金とログ料金が適用され、Aurora DSQL の追加料金はかかりません。ぜひご活用ください。