CloudWatch Logsのデータ保護ポリシーで氏名や住所、マイナンバーをマスクして障害調査に使えるか検証してみた

こんにちは。運用イノベーション部の小形です。
以前、障害調査のために本番端末にあるログを確認したいことがありましたが、そのログには個人情報が含まれていたためそのまま外に持ち出せませんでした。
調査に必要な部分だけを1件ずつテキストファイルに書き写して持ち出したという思い出があります。
CloudWatch Logsには、ログの中の機密データをマスクする「データ保護ポリシー」があります。
これを使えば、マスクしたログをそのまま調査に使えるかと思いました。
しかし、AWSが用意している検出ルール(マネージドデータ識別子)には日本向けのものがありません。
そこで今回は、日本の個人情報を含むダミーのログを用意してどこまでマスクできるのか、マスクできなかった場合どうすればマスクできるのか、実際にマスクしたログで調査ができそうかを検証してみました。
なお、データ保護ポリシーのログの読み方や出力先ごとの見え方は下記の記事で詳しく検証されております。
結論
- マネージドデータ識別子だけでは、検証したログの日本の個人情報の約7割がマスクされませんでした
- カスタムデータ識別子(正規表現)を足すとすべてマスクできましたが、JSON形式のログは壊れました
- マスクしたログでも、障害の原因は追えました。ただし、影響を受けたユーザーまでは分かりません。
- 元の値は
logs:Unmaskを持つ人だけが見られて、その操作はCloudTrailに残ります
検証の内容
ロググループを3つ用意し、内容が全く同じダミーログ(94行)を入れて比較してみました。
| ロググループ | データ保護ポリシー |
|---|---|
| A | マネージドデータ識別子のみ(7個) |
| B | Aに加えて、カスタムデータ識別子(9個) |
| C | なし(比較用) |
ダミーログは、リクエストを受け付けるAPIが出力したものを想定して、JSON形式と自由文の2種類にしました。40件のリクエストのうち14件が、外部APIのタイムアウト(E504)で失敗する流れです。
受付のログには、個人情報を入れています。氏名(漢字・ローマ字)、電話番号、住所、生年月日、郵便番号、マイナンバー、運転免許証番号、口座番号、カード番号、金額、IPアドレスです。値はすべて架空です。
ログの取り出しは、logs:Unmask 権限のないIAMロールで、AWS CLIの filter-log-events を使いました。
障害調査をする担当者が、マスクされたログを手元に持ってくる想定です。
マネージドデータ識別子だけで試す
Aには、次の7つの識別子を設定してみました。
EmailAddress CreditCardNumber Name Address IpAddress DateOfBirth PhoneNumber-US
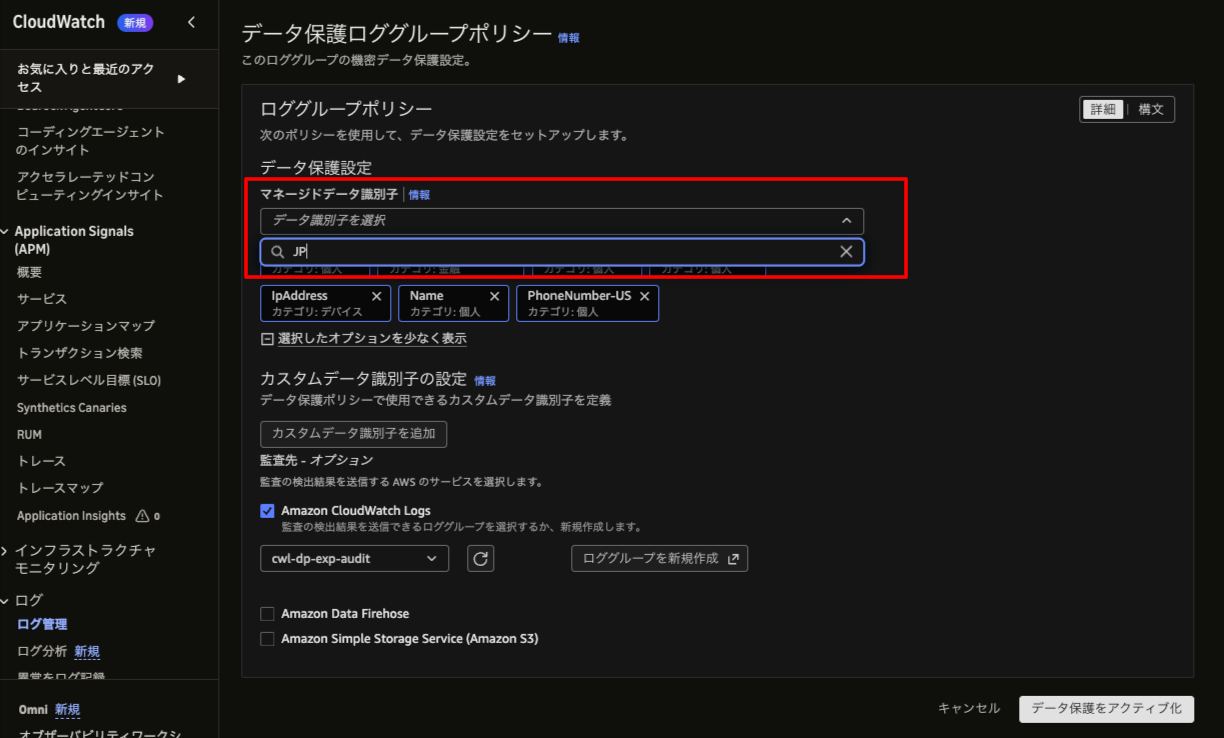
電話番号は日本向けがないため、近い形のUS向けのものを選んでみました。識別子の一覧を「JP」で検索しても、候補に何も出てきません。
同じ受付ログを、マスク前とマスク後で比べたのが次のとおりです。
- マスク前のログ
{
  "ts": "2026-11-12T06:18:50.200Z",
  "level": "INFO",
  "request_id": "20261112000501",
  "msg": "application received",
  "user_email": "taro.yamada@example.com",
  "name_romaji": "Taro Yamada",
  "name_ja": "検証 太郎",
  "phone": "090-0000-0001",
  "birth_date": "1975-01-01",
  "dob": "1975-01-01",
  "seinengappi": "1975-01-01",
  "address": "東京都架空区サンプル町1-1-1",
  "postal_code": "000-0001",
  "card_number": "4242 4242 4242 4242",
  "account_number": "1000000",
  "my_number": "123456789001",
  "drivers_license": "300000000001",
  "loan_amount": 500000,
  "repayment_amount": 8333,
  "client_ip": "192.0.2.10"
}
- マスク後のログ
{
  "ts": "2026-11-12T06:18:50.200Z",
  "level": "INFO",
  "request_id": "20261112000501",
  "msg": "application received",
  "user_email": "***********************",
  "name_romaji": "***********",
  "name_ja": "検証 太郎",
  "phone": "090-0000-0001",
  "birth_date": "**********",
  "dob": "**********",
  "seinengappi": "1975-01-01",
  "address": "東京都架空区サンプル町1-1-1",
  "postal_code": "000-0001",
  "card_number": "*******************",
  "account_number": "1000000",
  "my_number": "123456789001",
  "drivers_license": "300000000001",
  "loan_amount": 500000,
  "repayment_amount": 8333,
  "client_ip": "**********"
}
メールアドレス、ローマ字の氏名、カード番号、IPアドレスはマスクされました。一方で、漢字の氏名、住所、郵便番号、マイナンバー、運転免許証番号、口座番号、金額はそのまま残りました。Name はラテン文字だけが対象で、Address の対象国にも日本は入っていないので、ドキュメントどおりの結果です。
受付ログに含まれる機微な項目540個のうち、367個(68%)がマスクされませんでした。
電話番号の書き方による違い
同じ電話番号でも、書き方によってマスクされるものとされないものがありました。
| 書き方 | 例 | 結果 |
|---|---|---|
| ハイフンなし | 09000000002 |
マスクされた |
| ハイフンあり | 090-0000-0004 |
マスクされなかった |
+81 付き |
+819000000006 |
マスクされなかった |
生年月日はキー名で結果が変わった
DateOfBirth は、近くに dob や birth date などのキーワードがあるときだけ検出されます。今回のログでは、birth_date と dob はマスクされましたが、同じ値の seinengappi と、自由文の 生年月日= はマスクされませんでした。値の形が同じでも、キー名次第で守られるかどうかが変わります。
カスタムデータ識別子で補ってみる
カスタムデータ識別子は、正規表現で検出ルールを書ける機能です。1つのポリシーに10個まで、正規表現は200文字までです。
番号のように形が決まっているものは、値の形で書きました。氏名や住所のように形が決まっていないものは、name_ja や addr= といったキー名を手がかりにしています。
実際に設定した9個は次のとおりです。左が名前、右が正規表現です。
JpPhoneHyphen   \b0\d{1,4}-\d{1,4}-\d{4}\b
JpPhoneIntl     \+81\d{9,10}\b
Digits12        \b\d{12}\b|\b\d{4}[ -]\d{4}[ -]\d{4}\b
Digits7Postal   \b\d{7}\b|\b\d{3}-\d{4}\b
JpAmounts       loan\w*\W+\d+|repayment\w*\W+\d+
JpName          name_ja\W+[^"]+|name=\S+ \S+
JpAddress       address\W+[^"]+|addr=\S+
BirthNoKeyword  seinengappi\W+\d{4}-\d{2}-\d{2}
JpBirthKeyword  生年月日=\d{4}-\d{2}-\d{2}
それぞれの対象は次のとおりです。
| 名前 | 対象 |
|---|---|
| JpPhoneHyphen | ハイフンありの電話番号 |
| JpPhoneIntl | +81 付きの電話番号 |
| Digits12 | 12桁の数字(マイナンバー、運転免許証番号) |
| Digits7Postal | 7桁の数字(口座番号)、123-4567 形式(郵便番号) |
| JpAmounts | loan または repayment で始まるキーの金額 |
| JpName | 漢字の氏名(name_ja と name= の値) |
| JpAddress | 住所(address と addr= の値) |
| BirthNoKeyword | seinengappi の生年月日 |
| JpBirthKeyword | 生年月日= の生年月日 |
氏名や住所、金額、生年月日の識別子は、今回のダミーログのキー名(name_ja、address、loan_amount など)に合わせて書いています。実際に使うときは、自分たちのログのキー名に合わせて書き換える必要があります。
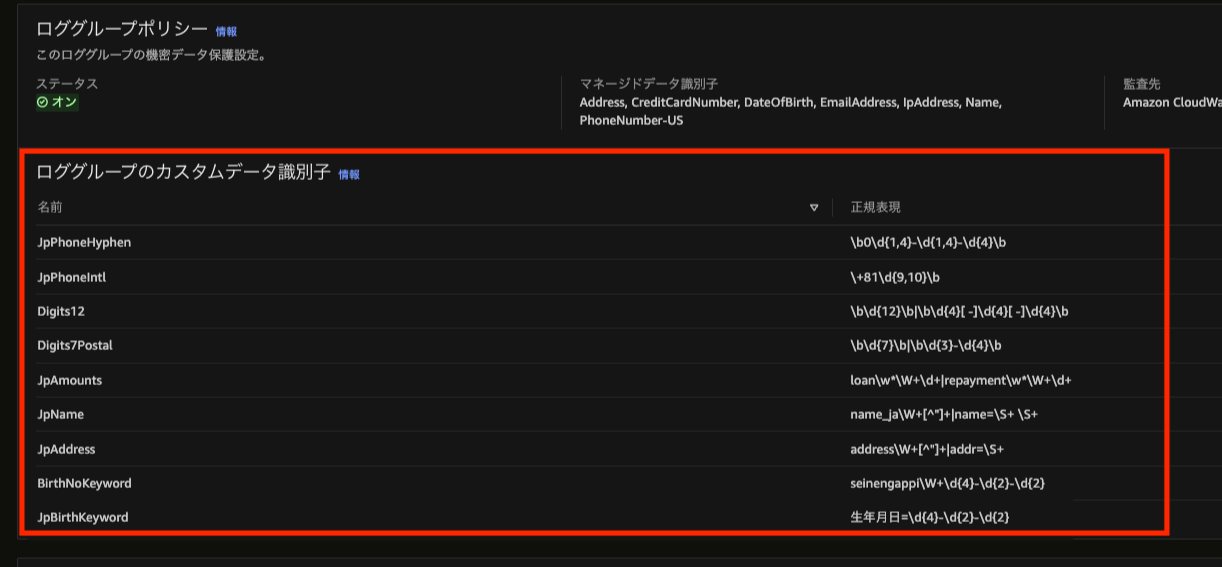
その結果、540個すべてをマスクできました。request_id や時刻、E504 などは残っていて、調査に必要そうな項目を巻き込むこともありませんでした。
なお、ドキュメントで正規表現に使える文字の一覧には、日本語の文字や丸括弧は載っていません。今回は保存でき、日本語の識別子は実際にマスクも効きましたが、公式ドキュメントにない挙動なので、使う場合は事前に確認したほうがよさそうです。
その代わりJSONが壊れた
キー名を手がかりにした識別子は、マッチした範囲をまるごとマスクします。そのため、値だけでなく、キー名や区切りの ":" まで * に置き換わりました。
| 元のログ | マスク後 |
|---|---|
"seinengappi":"1975-01-01" |
"************************" |
"address":"東京都架空区サンプル町1-1-1" |
"**************************" |
"loan_amount":500000 |
"******************* |
"キー":値 の組が、ただの文字列や、閉じていない " に変わっています。マスク後の受付ログ全体はこうなりました。
{"ts":"2026-11-12T07:22:31.200Z","level":"INFO","request_id":"20261112000501","msg":"application received","user_email":"***********************","name_romaji":"***********","***********************":"*************","birth_date":"**********","dob":"**********","************************","**************************","postal_code":"********","card_number":"*******************","account_number":"*******","my_number":"************","drivers_license":"************","*******************,"**********************,"client_ip":"**********"}
この1行を jq に渡すと、エラーになります。
※ jq は、JSONを読み取って、項目を取り出したり整形したりするコマンドラインのツールです。
jq: parse error: Objects must consist of key:value pairs at line 1, column 288
受付ログ20件はすべて、JSONとして読めなくなってしまいました。これには次の問題があります。
- マスクしていない項目まで取り出せなくなる: 1行まるごと読めないので、同じ行にある
request_idやtsも、jqなどのツールでは取り出せません。障害調査では、request_idで受付から失敗までのログをつなげて見ることが多いと思います。それがツールでできなくなります。実際、今回の集計でも、Bのログだけは JSON として読めず、正規表現で集計し直しました - どの項目があったのかも分からなくなる: キー名ごと消えるので、
phoneやaddressがあったこと自体が分かりません - コンソールでも整形されない: JSON として展開されず、1行の文字列のまま表示されます
キー名を残して値だけをマスクできないか、後読み((?<=loan=)\d+ のような書き方)を試しました。しかし、保存時に Regexes in Custom Data Identifiers are too complex. というエラーになり、保存できませんでした。
事実として確認できたのは、ここまでです。次は、検証できていないので仮説です。
- 後読みが保存できれば、キー名を残して値だけをマスクできるのではないか
- 後読みで保存できなかった原因は、後読みそのものが使えないためではないか(エラーの文面は「複雑すぎる」で、「使えない」とは書かれていません)
どちらも試せていないため、分かりません。確かなのは、今回のようにキー名を手がかりにした識別子を使うと、JSONの形が保てなかった、ということです。
AとBの結果をまとめると次のとおりです。
| A | B | |
|---|---|---|
| マスクされなかった項目 | 367 / 540(68%) | 0 / 540 |
| JSONとして読める受付ログ | 20 / 20 | 0 / 20 |
マスクしたログで障害調査はできるか
「タイムアウトで失敗したリクエストを調べる」という想定で、マスクなしのCと、A・Bを比べました。
| 調べたいこと | C(マスクなし) | A・B |
|---|---|---|
| 失敗したリクエスト | 14件を特定できる | 14件を特定できる |
| 失敗の原因 | E504、3回再試行 |
同じ |
| 影響を受けたユーザー | 10人 | 分からない |
request_id やエラーコードは残るので、何が、いつ、なぜ失敗したかは追えました。一方、メールアドレスもIPアドレスもマスクされるため、誰が影響を受けたのかは分かりません。IPアドレスは IpAddress を選んだ結果なので、守るのか調査に使うのかを先に決めておく必要があります。
冒頭でお話しした、私が以前体験したことのように1件ずつ書き写す必要は、原因の調査に限ればなさそうです。
元の値を見られるのは誰か
logs:Unmask 権限のない調査担当のロールで --unmask を付けると、拒否されました。
An error occurred (AccessDeniedException) when calling the FilterLogEvents operation: ... is not authorized to perform: logs:Unmask on resource: ...
logs:Unmask を持つロールでは、元の値が取り出せました。
この操作はCloudTrailに残ります。FilterLogEvents のイベントに "unmask": true が記録されるので、どのロールでいつ元の値を見たのかを後から確認できます。拒否された操作も記録されていました。
{
  "eventName": "FilterLogEvents",
  "userIdentity": {
    "sessionContext": {
      "sessionIssuer": { "userName": "cwl-dp-exp-security" }
    }
  },
  "requestParameters": {
    "logGroupName": "cwl-dp-exp-a",
    "unmask": true
  }
}
ただ、今回はロールのセッション名をロール名のままにしていたので、記録からは「どのロールか」までしか分かりませんでした。実際に運用するなら、セッション名に実行した人を入れておくと追いやすくなると思います。
まとめ
冒頭の問いに、今回の検証で分かったことです。
- 日本の個人情報は、どこまでマスクできたか: マネージドデータ識別子だけでは、約7割がマスクされませんでした。カスタムデータ識別子で補うと、今回のダミーログではすべてマスクできました。ただし、キー名を手がかりにした識別子を使うと、JSONのログが壊れました
- マスクしたログで、障害調査はできそうか: 原因の調査はできそうです。影響を受けたユーザーが誰で何人なのかは、分かりませんでした
- ログを1件ずつ書き写さずに済みそうか: 原因の調査に限れば、済みそうです
以上の結果から、次のような分け方なら運用できそうだと考えています。
- 原因の調査: 調査担当は
logs:Unmask権限を持たず、マスクしたログをそのまま持ち出して使う - 影響を受けたユーザーの特定:
logs:Unmask権限を持つ担当者だけが元の値を見る。誰が見たかをCloudTrailで追えるように、セッション名に実行者を入れる - JSON形式のログ: キー名を手がかりにした識別子は使わず、氏名や住所はそもそもアプリ側でログに出さないようにする
データ保護ポリシーは、ログを出したあとで守る仕組みです。今回、同じ電話番号でも書き方で守られるかが変わったように、マスクできる範囲はログの書き方に左右されます。そのため、ログを出す側で、個人情報を出さないこと、キー名や書式をそろえることを先に決めておくほうが確実だと考えました(これは今回検証していません)。データ保護ポリシーは、それでも残る分を守る最後の備えとして使うのがよさそうです。