AWS DevOps Agent は同じ事故が2回起きたら作業ミスを記憶してくれた

こんにちは。運用イノベーション部の小形です。
前回は、AWS DevOps Agent に作業ミスが原因の障害を調べさせて、ミスの理由まで仮説が出てくることを検証しました。
今回はその続きになります。DevOps Agent には、過去の調査から学んで覚えておく「メモリ」という機能があります。前回の作業ミスによる事故を、DevOps Agent は覚えてくれるのかを見てみました。
結果、1回目の事故では記憶しませんでした。同じ事故をもう一度起こすと、初めて記憶してくれました。
結論
- 1回目の事故のあとに学習を実行しても、記憶は作られませんでした
- 学習エージェントは、その理由を「新しいモニターは、調査が2件以上のときだけ記憶する」と説明しました
- 同じ作業ミスによる事故をもう一度起こして調査すると、記憶が作られました
DevOps Agent のメモリ
DevOps Agent のメモリには、いくつかの種類があります。今回検証したのは monitors です。公式ドキュメントでは、次のように説明されています。
- アラームごとに、繰り返し発生する根本原因の履歴を記録する
- 学習エージェントが、過去2週間の調査を分析して、1日1回作る
- アラームが鳴ったとき、調査の前に読まれる
つまり、同じアラームが鳴ったときに「前もこれだったな」と思い出すための記憶です。
なお、DevOps Agent のメモリ機能については「たかやま」さんが下記のブログで詳しく説明しています。
検証の内容
構成は前回と同じです。ディスクの逼迫中に、作業者がアプリの索引ファイル(tmp_index)を消してしまい、ヘルスチェックのアラームが鳴る、という事故です。
検証の流れは下記です。
- 作業ミスによる事故を起こして、DevOps Agent に調査させる(1回目。ディスクのアラームと、ヘルスチェックのアラームを、1件ずつ調査)
- 学習を実行して、記憶ができたかを見る
- 同じ事故をもう一度起こして、調査させる(2回目)
- もう一度学習を実行して、記憶ができたかを見る
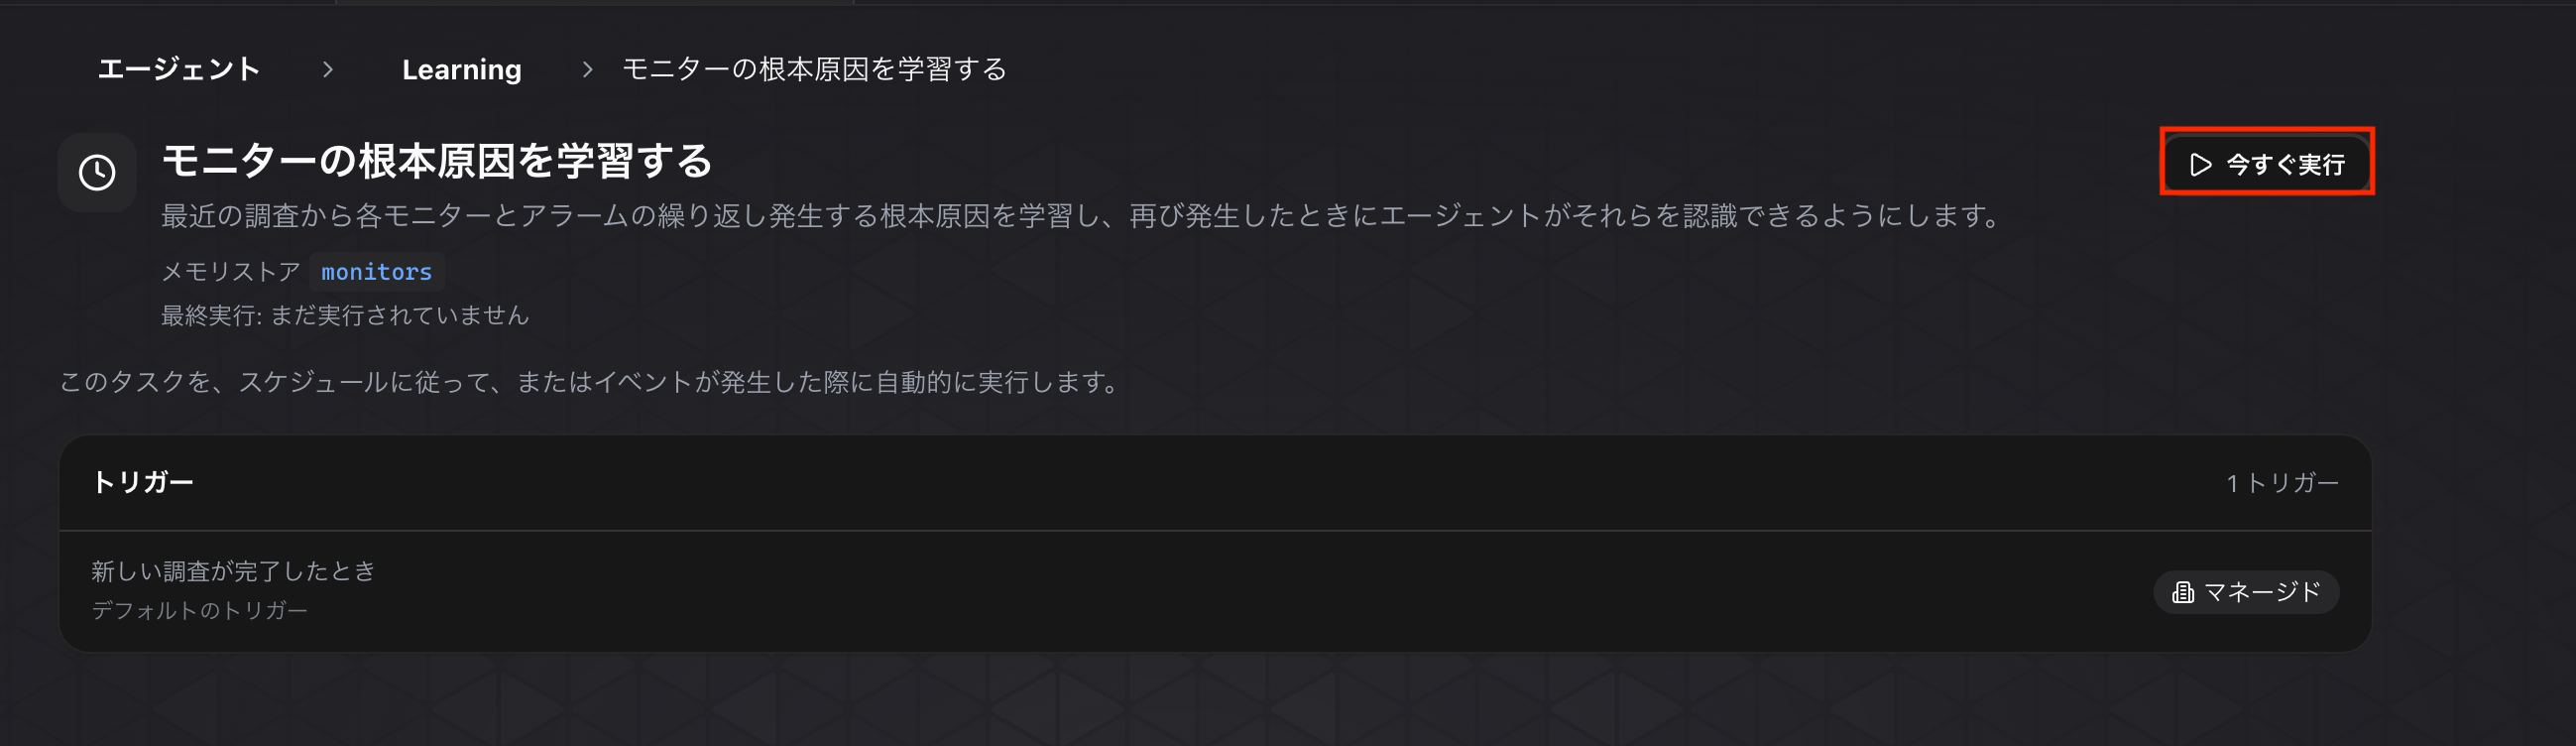
学習の自動の実行は、1日1回までです。翌日まで待たずに結果を見るため、学習のタスクの画面にある「今すぐ実行」から、手動で実行しました。
1回目の事故のあと、学習を実行する
前回の事故(1回目)の調査が終わったあと、学習を実行しました。1分ほどで終わりましたが、記憶は1件も作られませんでした。
No memories were uploaded since no monitors qualified for memory creation.
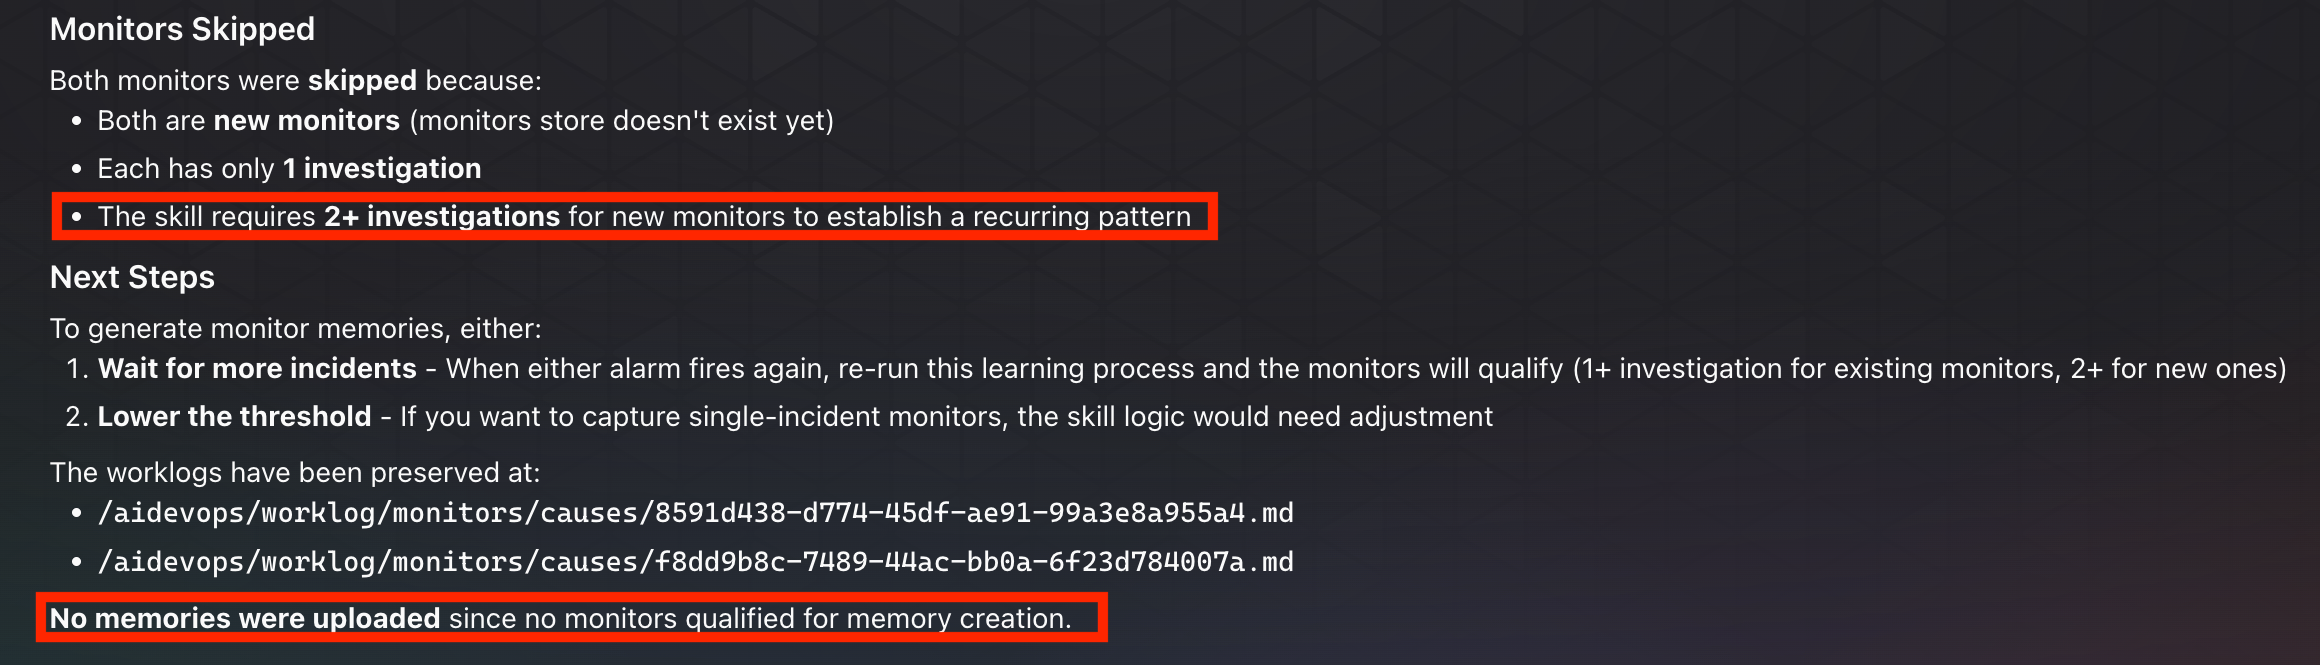
学習エージェントは下記の通り説明してくれました。
monitorsのストアは、まだ空っぽだった(初めての実行)- そのため、2つのアラームは、どちらも「新しいモニター」として扱われた
- 新しいモニターは、調査が2件以上あるときだけ記憶にする。1回の発報では、繰り返しのパターンだと言えないため
- 2つのアラームは、どちらも調査が1件ずつだったので、見送った
面白いことに、学習エージェントは、調査ごとに原因を要約した作業用のファイルを先に作っていました。内容は「SSM Session Manager による tmp_index の手動削除」という要約です。ただ、記憶(メモリ)にするのは、そのあとの段階で、条件を満たしたモニターだけのようです。
同じ事故をもう一度起こしてみる
前回と同じコマンドで、もう一度 tmp_index を削除しました。ヘルスチェックのアラームが鳴ったので、同じように調査させます。
調査が終わってから、もう一度学習を実行しました。今度は、記憶が1件作られました。
Monitors captured: 1 monitor memory created
  dam-exp-health-check-failed (2 investigations)
Monitors skipped: 1 monitor
  dam-exp-disk-used-high (1 investigation) - skipped because new monitors require 2+ investigations to establish a recurring pattern
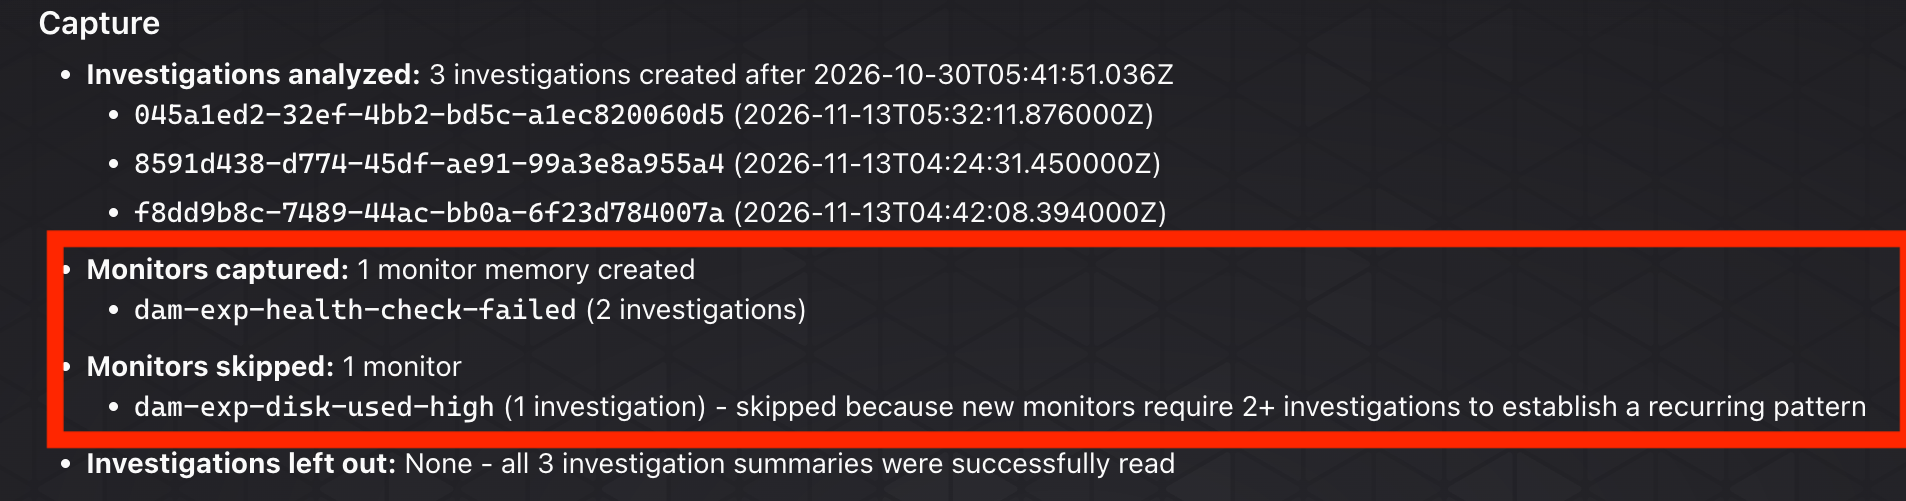
ヘルスチェックのアラームは、調査が2件そろったので記憶になりました。ディスクのアラームは、調査がまだ1件なので、今回も見送られています。
作られた記憶の中身はこちらです。
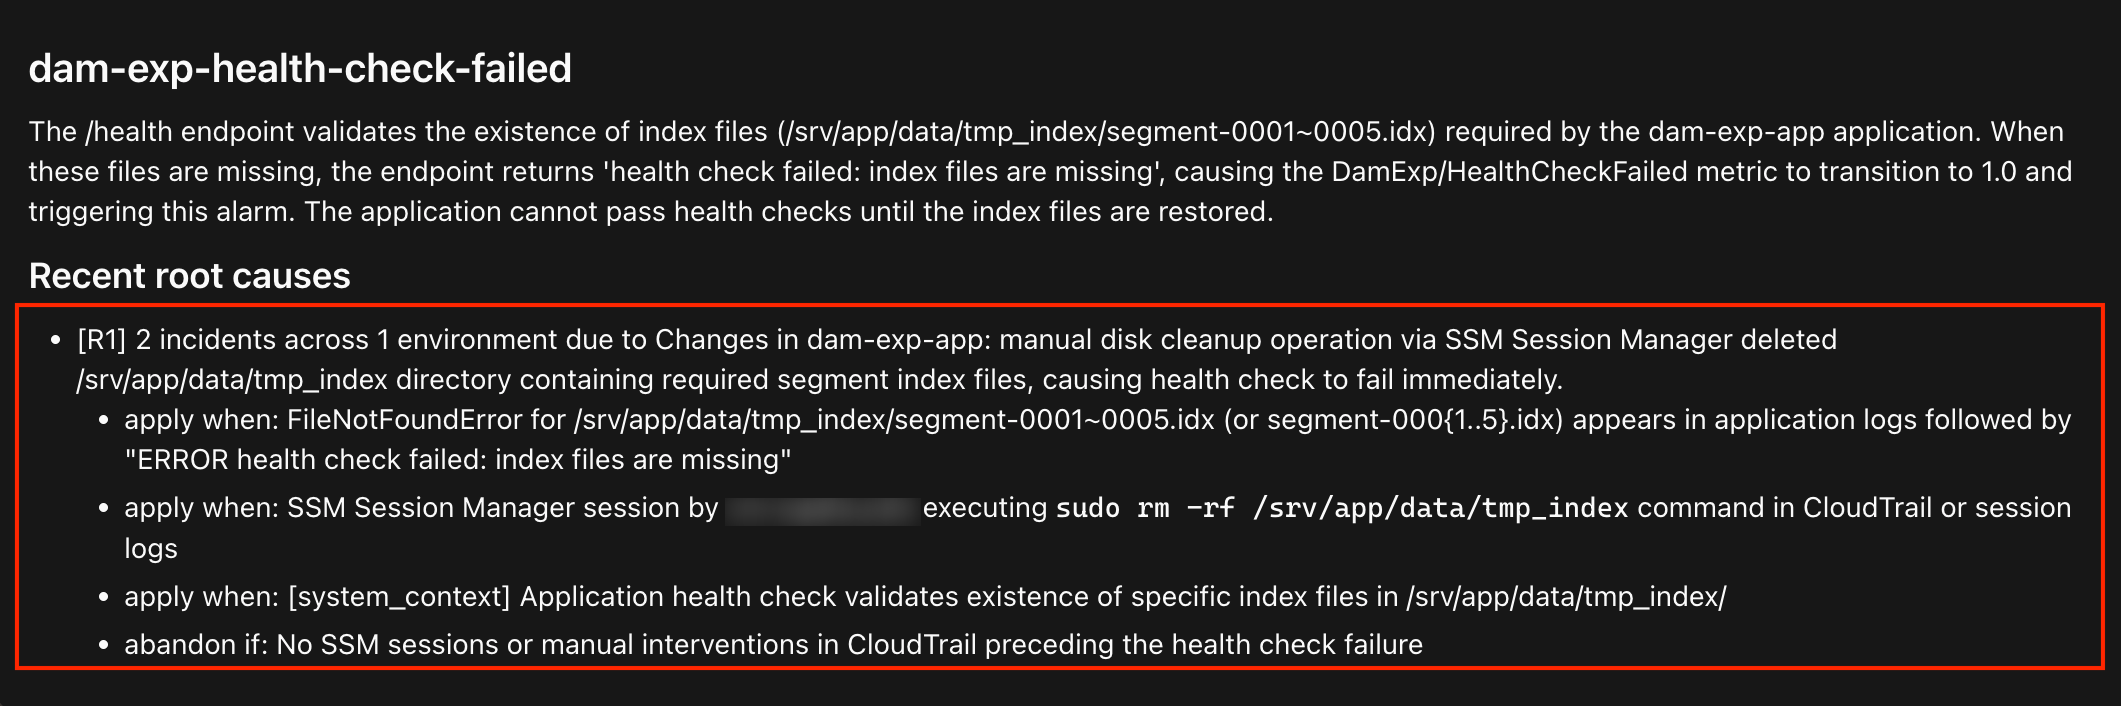
記憶には、次のことが書かれていました。
/healthは、tmp_indexの索引ファイルがないと失敗する- 根本原因は、手作業のディスク整理で
tmp_indexが消されたこと(2回の事故) - この記憶を使う条件(アプリのログに
FileNotFoundErrorが出ているとき、など)
なぜ、1回では記憶にならないのか
公式ドキュメントでも、monitors は「繰り返し発生する根本原因」の履歴とされています。学習のタスクの説明にも、「繰り返し発生する根本原因を学習し」と書いてあります。1回だけでは、たまたま起きたのか、繰り返す問題なのかを区別できません。2回そろって初めて「繰り返し」と言える、という考え方だと思います。
ただ、「2件以上」という具体的な条件は、公式ドキュメントには見当たりませんでした。今回は、学習エージェントが実行中に説明した内容として書いています。今後変更になる可能性もあります。
運用の目線で見ると、再発防止のための記憶が、再発してから作られる ということです。1回目の事故を、2回目の前に活かしたいなら、記憶とは別の手段が必要になりそうです。
まとめ
- 1回目の事故では、記憶は作られませんでした
- 学習エージェントによると、新しいモニターは調査が2件以上で記憶になります
- 同じ事故が2回起きて初めて記憶されました