[Grafana] Ductus で、直近 7 日は DynamoDB、それより前は S3 + Athena から読んで、Grafana の 1 本の線にしてみました

1 はじめに
製造ビジネステクノロジー部の平内(SIN)です。
センサーデータなどを DynamoDB に溜めていくと、ほとんど読まない古いデータの保存費用が積み上がっていきます。古いデータを S3 に移せば費用は下がりますが、今度は Grafana で、DynamoDB と S3 のデータが別々になってしまいます。保存は分けても、Grafana では 1 本の線として見たい、という要件はよくあると思います。
今回は、このような要件に簡単に応えることができるかも知れない、Ductusのコールドストア機能の使用例です。
Ductusの基本的な使用方法(データセットの定義や Grafana の設定)については、下記のブログをご参照下さい。
今回は、まず Grafana の Mixed データソース(Athena のクエリと API のクエリを 1 つのパネルに並べる方法)で試し、その後、Ductus の API の中でホットとコールドをつなぐ方式で 90 日分を表示し、規模を上げたときの費用を試算してみました。
Mixed データソースと Ductus のコールドストアは、同じ項目(仕組み・90 日・30 日・境界の前後)で並べて比べています。
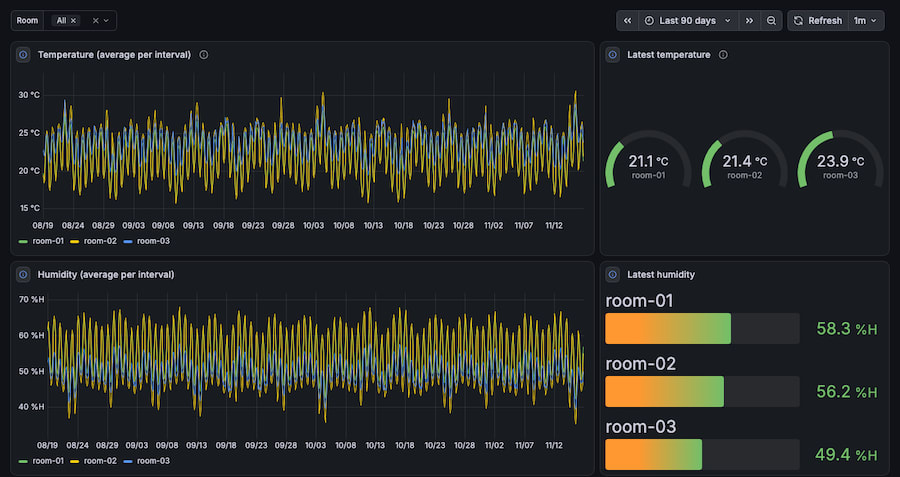
下の画像は、Ductus のサンプルダッシュボードで 90 日分を表示したものです。直近 7 日が DynamoDB、それより前が S3 + Athena から読んだ値で、Grafana 側はパネルごとに Infinity の 1 クエリのままです。
先に結論を述べると、次のようになりました。
- Mixed データソースでは、90 日で API 側の期間の上限(31 日)に当たって直近 7 日が欠け、30 日では系列が 2 本に分かれ、境界の前後では 2 本が重なりました
- Ductus の API の中でつなぐと、90 日でも 1 本の線になります。90 日・1 日平均の問い合わせで、Athena が読んだ量は約 6.1MB でした
- 1 台だけ表示したときに Athena が読む量は、Parquet ファイルの中の並びで決まりました。99 台で、時刻順のファイルでは全体の約 92% を、キー順のファイルでは 1/3 前後を読みました
- 1 つのパネルを 30 秒更新で 10 分表示すると、Athena の呼び出しは Mixed データソースで 20 回(Athena の結果の再利用は効かず)、Ductus で 10 回(API のキャッシュが効く)でした
- 1 回の読み込みが 10MB に満たないため、自動更新の費用は「回数 × 10MB」で決まります。Ductus のサンプルダッシュボード(パネル 6 つ)を開きっぱなしにすると、月 $7.6〜15.3 の計算でした
本稿はあくまで、サンプルデータを使った特定環境での一例として捉えてください。
2 準備
Mixed データソースと Ductus のコールドストアでは、同じデータ(DynamoDB の 7 日分と S3 の 83 日分)を表示します。ここでは、そのデータと Ductus を用意します。
(1) 環境
2026 年 11 月時点、ap-northeast-1 で確認しています。
| 項目 | バージョン |
|---|---|
| Ductus | 0.1.0(コミット 74b5d81) |
| Node.js | 22.23.4 |
| pnpm | 10.24.0 |
| Grafana | 13.3.1 |
| Infinity | 4.1.5 |
| grafana-athena-datasource | 3.4.2 |
ほかに、Docker(ローカルの Grafana に使用)、AWS CLI v2、CDK の bootstrap が済んだ AWS アカウントが必要です。
(2) 取得
$ git clone https://github.com/furuya02/dynamodb-timeseries-api.git
$ cd dynamodb-timeseries-api
$ pnpm install
(3) datasets.yaml
clone したディレクトリの config/datasets.yaml で、cold の 3 行のコメントを外します。
Github config/datasets.yaml
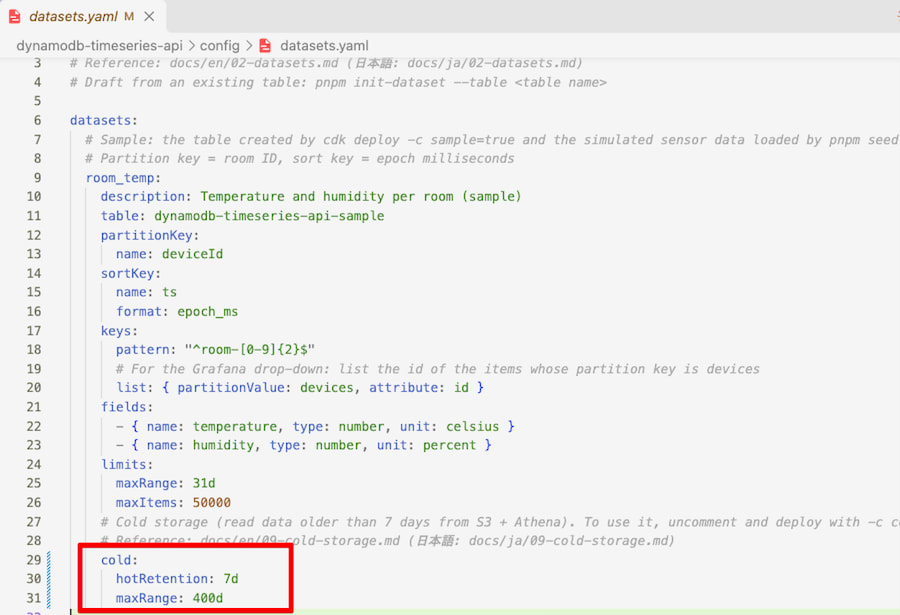
hotRetention は、DynamoDB から読む期間です(既定 7 日)。長くすると DynamoDB の保存費用が増え、短くすると生データで見られる期間が減ります。用途に合わせて変える前提の値です。
(4) デプロイとデータ
$ pnpm cdk-deploy -c sample=true -c cold=true -c coldRemovalPolicy=destroy -c auth=apiKey
$ pnpm seed --cold-days 83
-c coldRemovalPolicy=destroy を付けると、cdk destroy でコールドのバケットも中身ごと消えます。検証で最初から消すつもりの場合に付けます。
pnpm seed --cold-days 83 は、DynamoDB に 7 日分を入れたあと、その前の 83 日分を 1 分の集計にして S3 に直接書きます。
私の環境では、DynamoDB 29,865 件と、コールド 85 ファイル(6.2MB)の用意が 68 秒 で終わりました。
DynamoDB からコールドへの取り込み方法は、デプロイ時に -c coldIngest=scheduled(既定)か -c coldIngest=stream で選びます。今回は付けていないので、定期実行です。
| 定期実行(scheduled、既定) | ストリーム(stream) | |
|---|---|---|
| 反映の遅れ | 翌日(毎日 01:00 UTC に前日分) | 最大 15 分(Firehose が書き込む間隔) |
| 費用の内訳 | Lambda と RCU | Lambda と Firehose |
| 前提条件 | キーを列挙できること | テーブルの Streams を有効にすること |
テーブルによって使えるほうが変わるので、片方に絞らず選べるようになっています。どちらでも、コールドを読むのは 7 日より前なので、取り込みが数時間遅れても表示は変わりません。
定期実行では、hotRetention を 2 日以上にする必要があります。前日分を翌日に取り込むため、それより短いと間が欠けるからです。
(5) Grafana
cdk-deploy の出力に、API キーの値を取得するコマンド(GetApiKeyCommand)が表示されます。
Outputs:
DynamodbTimeseriesApiStack.Endpoint = https://xxxxxxxxxx.execute-api.ap-northeast-1.amazonaws.com/v1/
DynamodbTimeseriesApiStack.GetApiKeyCommand = aws apigateway get-api-key --api-key xxxxxxxxxx --include-value --query value --output text
このコマンドで取得した値を、環境変数に入れます。
$ export TSAPI_API_KEY=$(aws apigateway get-api-key --api-key xxxxxxxxxx --include-value --query value --output text)
デプロイの出力からデータソースの設定を作り、ローカルの Grafana(Docker)を起動します。
$ pnpm grafana-config
$ pnpm grafana-up
ブラウザで http://localhost:3000/ を開き、「Dashboards」→「dynamodb-timeseries-api」を選びます。
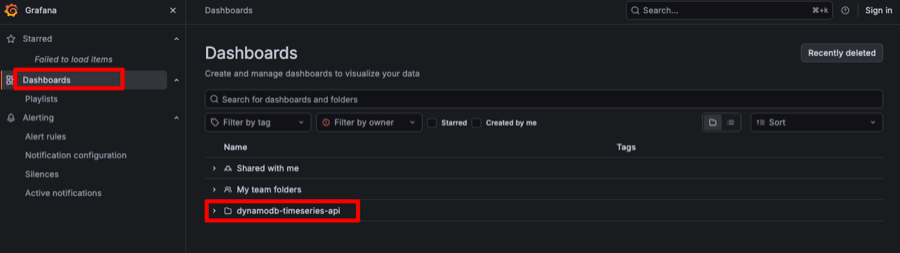
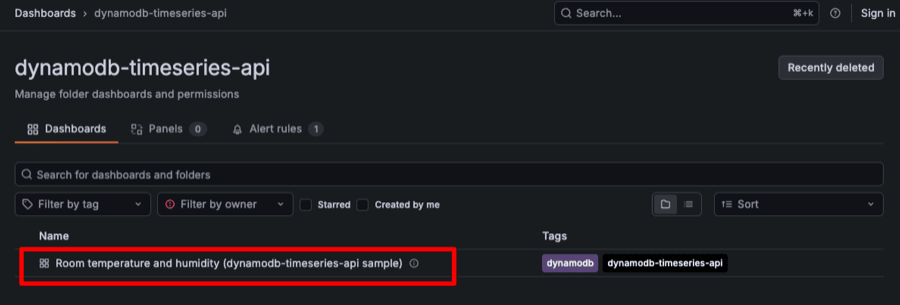
「Room temperature and humidity (dynamodb-timeseries-api sample)」を選びます。
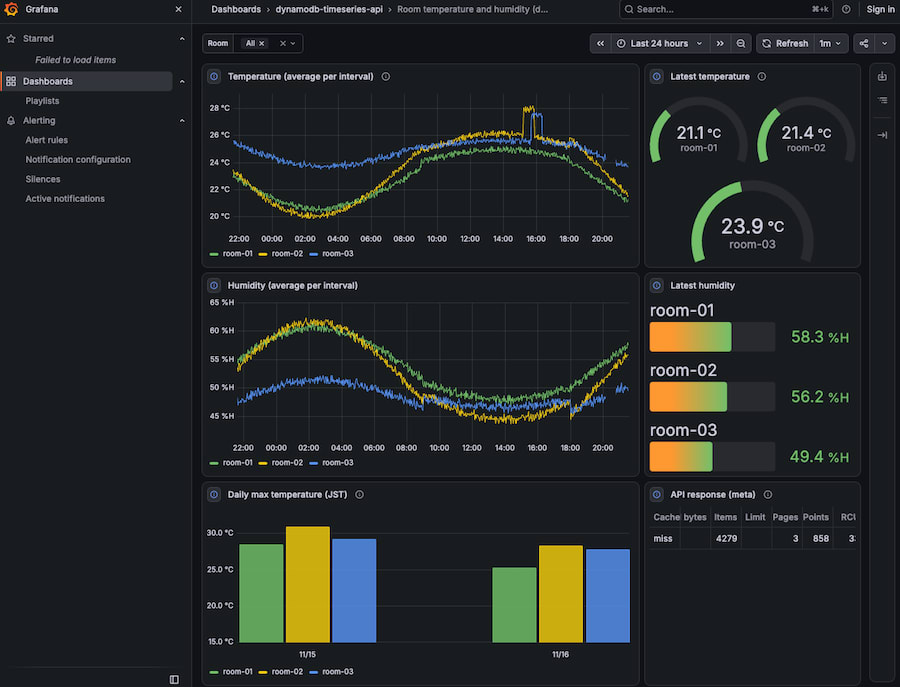
Ductus のサンプルダッシュボードが表示されます。
3 Mixed データソース
(1) 仕組み
以前、Timestream for InfluxDB と S3 Tables で同じ構成を組んだときは、Mixed データソースで 2 つのクエリを並べました。
そこで、Ductus の API の中でつなぐ前に、Grafana 側で 2 つのクエリを並べる方式を同じように試しました。
パネルのデータソースを Mixed にし、次の 2 つのクエリを 1 つのパネルに置きます。
| クエリ | データソース | 読む範囲 |
|---|---|---|
| A | Infinity(コールドを使わない設定の Ductus) | DynamoDB |
| B | Amazon Athena(grafana-athena-datasource 3.4.2) | S3 の 1 分の集計 |
クエリ B の SQL は、次のように 1 時間平均を返すものにしました。
SELECT $__unixEpochGroup(ts / 1000, 1h) AS time, sum(val_sum) / sum(cnt) AS athena_room01
FROM cold
WHERE dataset = 'room_temp' AND key = 'room-01' AND field = 'temperature'
  AND dt BETWEEN '$__rawTimeFrom(yyyy-MM-dd)' AND '$__rawTimeTo(yyyy-MM-dd)'
  AND $__unixEpochFilter(ts / 1000)
GROUP BY 1 ORDER BY 1
(2) 90 日
90 日を表示すると、Athena の線だけが表示されました。直近 7 日(DynamoDB の分)が欠けています。
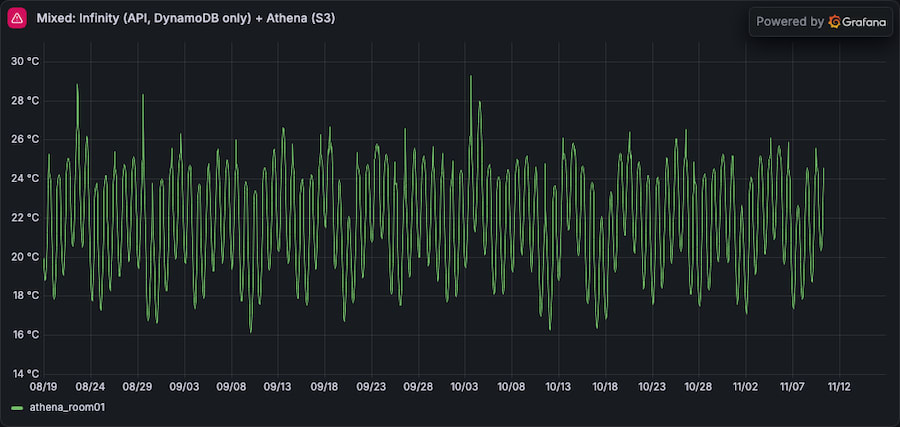
API の期間の上限(limits.maxRange、既定 31 日)に当たり、Infinity のクエリが 400 になっていました。
API は「The time range is too long. Keep it within 31d (limits.maxRange)」を返していますが、Grafana のパネルには左上に警告アイコンが出るだけです。Grafana 側のエラーは「unsuccessful HTTP response code / status code : 400 Bad Request」で、API が返した理由の文は表示されませんでした。
Grafana の時間範囲はパネル内のすべてのクエリに共通なので、Infinity のクエリだけ期間を短くする、ということは簡単にはできません。
(3) 30 日
31 日以内の 30 日にすると、両方の線が表示されます。ただ、系列は 2 本に分かれ、色と凡例も別になります。
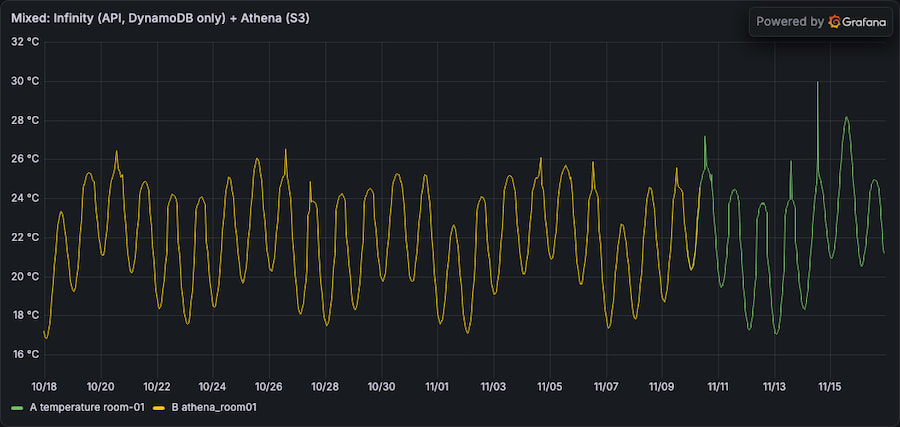
アラートや Stat パネルで「この部屋の温度」として 1 つの値を扱いたい場合は、2 本の系列を Grafana の変換で 1 本にまとめる手間がかかります。
(4) 境界の前後
境界(現在 − 7 日)の前後 4 日を表示しました。境界の 11/09 23:06 頃から 11/10 09:00 まで(JST)、黄色(Athena)と緑(DynamoDB)の 2 本が重なっています。
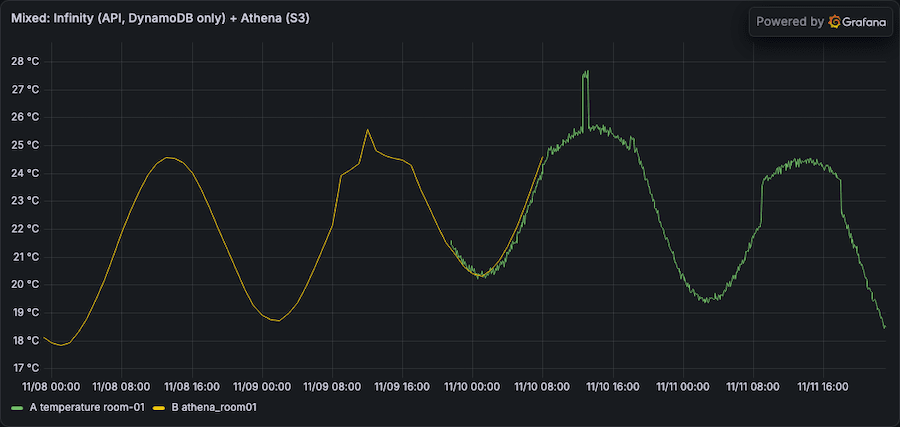
ここでは、2 つのことが同時に起きています。
- Athena の SQL は日付のパーティション単位で読むため、UTC の日の終わり(JST 09:00)まで、DynamoDB と同じ時間帯を読んでいます
- 粒度が違います。Athena は SQL に書いた 1 時間固定、Infinity は Grafana の $__interval_ms に合わせた約 5 分です
重なりをなくすには、SQL に境界(now − 7d)を書き、Infinity の from も境界にそろえる必要があります。時間範囲を 2 つのクエリで別々に組み立てることになり、境界の値を変えるたびに両方を直すことになります。
4 Ductus のコールドストア
(1) 仕組み
Ductus でコールドストアを有効にしたときの構成は、次のとおりです(手順書の図です)。
Github docs/ja/09-cold-storage.md
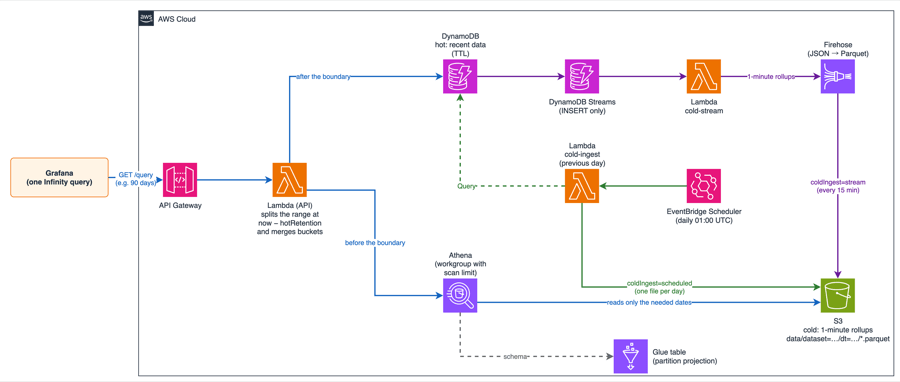
データの流れは、次の 4 つです。
| 流れ | 担当 | 内容 |
|---|---|---|
| 1. 書き込み | センサー(アプリ) | DynamoDB だけに書き込みます。コールドストアを有効にしても、書き込む側は変わりません |
| 2. S3 への取り込み | Ductus | DynamoDB のデータを 1 分ごとに集計し(件数・合計・最小・最大・最後の値)、S3 に Parquet ファイルとして書きます。定期実行なら毎日 01:00 UTC に前日分を、ストリームなら Firehose で数分おきに書きます |
| 3. 古いデータの削除 | DynamoDB の TTL | hotRetention(既定 7 日)に 1 日を足した期間を過ぎたアイテムを、DynamoDB が自動で消します |
| 4. 読み込み | Ductus の API | 頼まれた期間を境界で 2 つに分け、DynamoDB と S3(Athena)から読んで、1 本の系列にして返します |
TTL を設定しなくても動きます。DynamoDB にデータが残り続けるだけで、API は境界より前を S3 から読みます。
今回の pnpm seed は、サンプルを早く用意するために、83 日分を S3 に直接書いています。取り込みを待つと、83 日分がそろうまで 83 日かかるためです。
Grafana から見ると、Infinity の 1 クエリのままで、データが 2 か所に分かれていることを意識しません。境界は「現在 − hotRetention(既定 7 日)」を 1 分単位に切り捨てた時刻です。
読み込みの中身は、次の 2 つのコードです。split.ts で境界を計算して期間を分け、app.ts で 2 か所を同時に読んで 1 本にまとめます。
split.ts は、頼まれた期間と境界を比べて、次の 3 通りに分けます。
| 頼まれた期間 | 読み先 | 例 |
|---|---|---|
| すべて境界より後 | DynamoDB だけ | Last 24 hours |
| すべて境界より前 | S3 だけ | 1 か月前の 1 日分 |
| 境界をまたぐ | 境界の手前までを S3、境界からを DynamoDB | Last 90 days |
Github cdk/lambda/api/split.ts
// 要点抜粋
const boundary = Math.floor((now - retention) / COLD_STEP_MS) * COLD_STEP_MS;
if (req.from >= boundary) return { hot: { from: req.from, to: req.to } };
if (req.to < boundary) return { cold: { from: req.from, to: req.to } };
return { cold: { from: req.from, to: boundary - 1 }, hot: { from: boundary, to: req.to } };
2 つの読み込みは、Promise.all で同時に実行します。コールドの範囲がないとき(Last 24 hours など)は、S3 は読みません。最後の toResponse で、同じ区切りの値を足し合わせ、1 本の系列として返します。
Github cdk/lambda/api/app.ts
// 要点抜粋
const [hot, cold] = await Promise.all([
  readHot(),
  split.cold && coldReader ? coldReader.read(req, split.cold.from, split.cold.to) : Promise.resolve(undefined),
]);
return toResponse(req, hot, cold);
コールドは、S3 の Parquet を Glue テーブル(パーティション射影)経由で Athena から読みます。S3 Tables(Iceberg)は、権限の設定が増えるため採っていません。パーティション射影なら、パーティションの登録も不要です。
パーティションは dataset と dt(UTC の日付)で、key では分けていません。key でも分けると、ファイルの数がキーの数だけ増えるためです(1000 キーなら 1 日 1000 ファイル)。
(2) 90 日
90 日を表示すると、1 本の線で表示されました。直近 7 日(DynamoDB の分)も欠けていません。
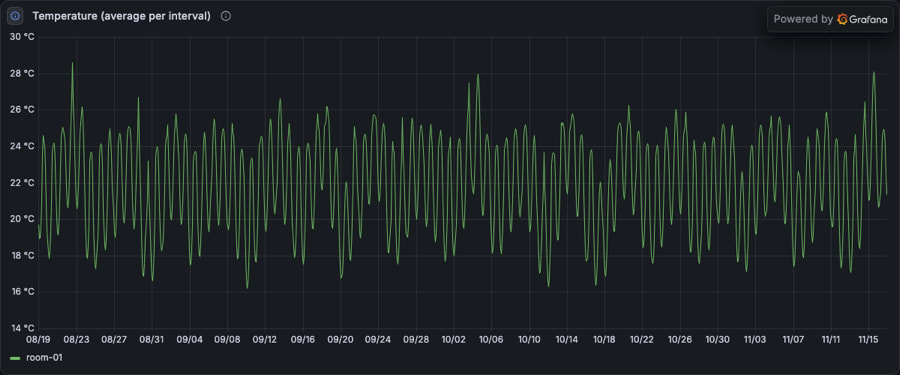
コールドストアを有効にしたデータセットでは、期間の上限に limits.maxRange(31 日)ではなく、cold.maxRange(既定 400 日)を使います。DynamoDB を読む期間は hotRetention までに収まるので、DynamoDB の読み込み量を抑えるための 31 日の上限を、コールドの範囲にまで当てる必要がないためです。
API の応答の meta.cold に、Athena の読み込みの情報が入ります。90 日・room-01・1 日平均の問い合わせでは、bytesScanned(Athena が読んだ量)は 6,066,503 バイト(約 6.1MB)、engineMs(Athena の実行時間)は 1133 でした。10MB に満たないため、課金は 10MB として扱われます。
https://aws.amazon.com/athena/pricing/
(3) 30 日
30 日でも、系列は room-01 の 1 本だけです。色と凡例も 1 つです。
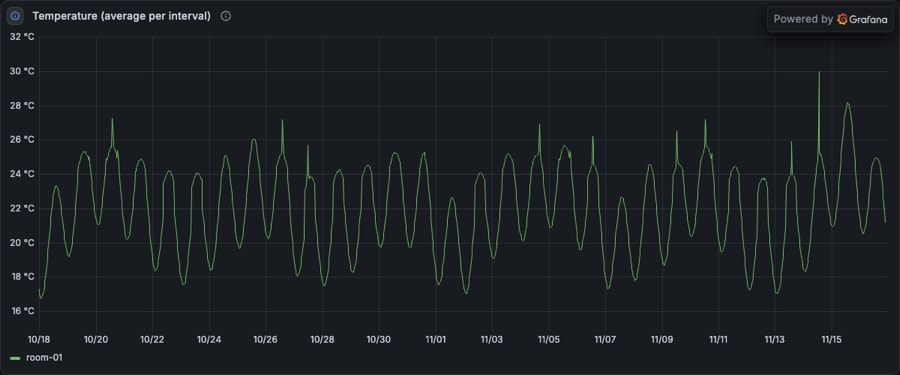
Grafana から見ると 1 つの系列なので、アラートや Stat パネルでも、DynamoDB だけを読んでいたときと同じクエリのまま使えます。
(4) 境界の前後
境界の前後 24 時間を拡大しました。境界(この画像では 11/09 23:06 頃)の前後で、線はそのままつながっています。
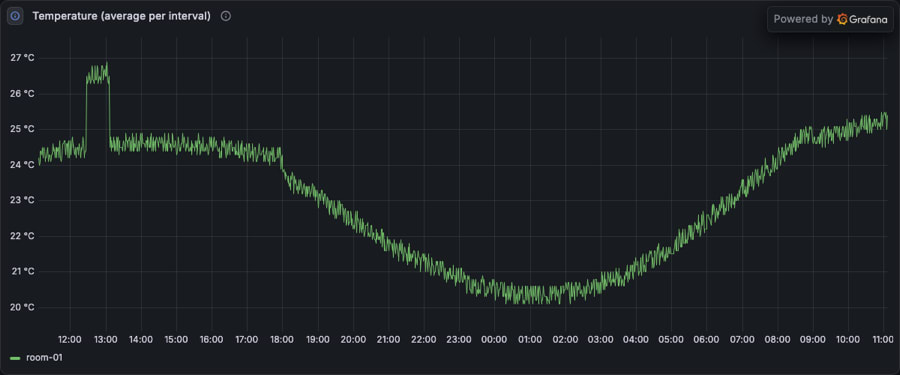
12:30 頃の高い値は seed が意図的に入れている一時的な高温、18:00 の折れ目は空調が入る時間帯の終わりで、どちらも境界とは関係ありません。
重なりも粒度の違いも出ないのは、Ductus の API が境界で期間を分け、区切りごとに足し合わせてから返すためです。
ここで鍵になるのが、コールドに保存している値です。コールドには、1 分ごとに「件数・合計・最小・最大・最後の値」を保存しています。平均そのものは保存しません。
1 時間の区切りが境界をまたぐと、その 1 時間の値はコールドとホットの両方から作ることになります。
例えば、境界をまたぐ 1 時間のうち、前半 30 分がコールド(1 分の集計 30 件、平均 20.0 度)、後半 30 分がホット(10 秒ごと 180 件、平均 22.0 度)だったとします。
| 求め方 | 計算 | 結果 |
|---|---|---|
| 平均の平均 | (20.0 + 22.0) / 2 | 21.0 度 |
| 件数と合計から | (20.0 × 30 + 22.0 × 180) / (30 + 180) | 約 21.7 度 |
件数と合計を持っておけば、区切りをまたいでも足し合わせるだけで正しい平均が出ます。最小・最大・件数も同じです。
同じ日の値を、Athena でコールドから集計した結果と DynamoDB から集計した結果で比べ、平均・最小・最大・件数が一致することも確かめました。
なお、1 分より細かい interval を指定しても、コールドの範囲は 1 分ごとの値になります。古いデータを秒単位で見る用途には向かない、という割り切りです。
5 比較
Mixed データソースと、Ductus のコールドストアを並べました。
| 項目 | Mixed データソース | Ductus のコールドストア |
|---|---|---|
| つなぐ場所 | Grafana のパネル | Ductus の API |
| Grafana のデータソース | 2 つ(Infinity と Athena) | 1 つ(Infinity) |
| 90 日 | 直近 7 日が欠ける(31 日の上限で 400) | 1 本の線(上限は cold.maxRange の 400 日) |
| 30 日 | 系列が 2 本に分かれる | 1 本の線 |
| 境界の前後 | UTC の日の終わりまで 2 本が重なり、粒度も違う | そのままつながる |
| 境界の値を変えるとき | SQL と Infinity の両方を直す | datasets.yaml の hotRetention だけ |
| Athena の回数(1 パネル・30 秒更新・10 分) | 20 回(結果の再利用は効かない) | 10 回(API のキャッシュ) |
| 保存費用 | 同じ(同じ S3 と DynamoDB のデータ) | 同じ |
Mixed データソースは、Grafana の設定だけで試せるのが利点です。ただ、期間の上限・系列・境界の扱いを、2 つのクエリで合わせ続けることになります。
ホットとコールドを 1 つのデータとして扱いたい場合は、Ductus の API の中でつなぐほうが扱いやすいのでは、と思います。
6 費用
(1) 保存
1000 台・1 分ごと(温度と湿度の 2 列)で、保存費用を試算しました(2026 年 11 月時点の東京リージョンの単価)。
| 保持期間 | DynamoDB に全部置く | ホット 7 日 + コールド |
|---|---|---|
| 1 年 | 月 $25.47 | 月 $0.63 |
| 3 年 | 月 $76.40 | 月 $0.91 |
DynamoDB の 1 アイテムを 170 バイト(推定)、コールドを 1 台・1 列・1 日あたり 7.6KB(実測)として計算しました。保持期間が長いほど、差は広がります。
Mixed データソースも同じデータを読むので、保存費用は Ductus と同じです。
https://aws.amazon.com/dynamodb/pricing/on-demand/
https://aws.amazon.com/s3/pricing/
(2) 自動更新
Athena は問い合わせのたびに課金され、1 回 10MB 未満でも 10MB として扱われます。Grafana の自動更新では、この回数が費用を決めます。
1 つのパネル(room-01・Last 30 days)を 30 秒更新で 10 分開いたままにし、Athena の回数を比べました。
| 条件 | Athena の回数(10 分) | 1 回の読み込み | 月額(24 時間開きっぱなし) |
|---|---|---|---|
| Mixed データソース | 20 回 | 約 0.6MB | 約 $4.3 |
| Mixed データソース(Athena の結果の再利用あり) | 20 回(再利用は 0 回) | 約 0.6MB | 約 $4.3 |
| Ductus のコールドストア(cacheTtlSeconds 30、既定) | 10 回 | 約 1.7MB | 約 $2.2 |
Mixed データソースは、更新のたびに Grafana から Athena を呼びます。Athena プラグインには結果を再利用する設定(resultReuseEnabled)がありますが、1 回も効きませんでした。SQL に入る時刻の条件($__unixEpochFilter)が更新のたびに 30 秒ずつ進み、同じ SQL にならないためです。
Ductus は、API が from / to を interval の区切りに丸めてからキャッシュするので、同じ区切りの間は Athena を呼びません。1 回の読み込みは Ductus のほうが多いのですが(件数・合計・最小・最大・最後の値の列を読むため)、どちらも 10MB に満たないので、費用は回数だけで決まります。
パネルが 6 つのサンプルダッシュボード(90 日)では、10 分で 71 回(月 $15.3)でした。キャッシュは Lambda の実行環境ごとにあるため、TTL を 300 秒に延ばしても 35 回(月 $7.6)にしか減りませんでした。
(3) 台数
台数が増えたときに、1 回の読み込み量がどう変わるかを確かめました。コールドのファイルは 1 日 1 ファイルで、全台のデータが入っています。そのため、1 台だけを表示しても、Athena はほかの台のデータを含むファイルを読みます。
| 1 台を表示したときに読む量 | 時刻順のファイル(pnpm seed) | キー順のファイル(Ductus の取り込み) |
|---|---|---|
| 99 台(実測) | 104.4MB | 36〜45MB |
| 1000 台(99 台からの見積もり) | 約 1.05GB | 45MB 前後 |
Ductus の取り込みはキーの順に書くので、Athena が関係のない台の部分を読み飛ばせます。そのため、台数が増えても読む量はほとんど増えません。seed のデータは時刻順で読み飛ばしが効かないため、サンプルデータで見積もると高く出ます。Mixed データソースも同じファイルを読むので、同じ傾向になるはずです(未測定)。
99 台のうち、読み込み量が極端に小さく、原因が分からなかった 2 台(room-98・99)は除外しています。
ただ、1000 台では 1 回 45MB になり、最低課金の 10MB を超えます。30 秒更新のままだと月 $69 程度の計算です。長い期間を表示するパネルは、更新間隔を長めにするのが良いと思います。
7 片付け
ローカルの Grafana を止めてから、デプロイと同じ -c を付けて destroy します。
$ pnpm grafana-down
$ pnpm cdk-destroy -c sample=true -c cold=true -c coldRemovalPolicy=destroy -c auth=apiKey
-c coldRemovalPolicy=destroy でデプロイしていれば、バケットも消えます。このとき、バケットを空にするために CDK が作る Lambda のロググループ(/aws/lambda/DynamodbTimeseriesApiStac-CustomS3AutoDeleteObject-...)が、削除の後に残ります。
削除のときに、この Lambda が実行されてロググループが作られるためです。スタックの管理外なので、手で削除しました(コマンドは手順書の 9.6 にあります)。
既定(coldRemovalPolicy=retain)でデプロイした場合は、バケットが残るので、不要なら aws s3 rb で中身ごと削除します。
8 最後に
今回は、Ductus のコールドストア機能の使用例として、直近 7 日を DynamoDB、それより前を S3 + Athena から読み、Grafana の 1 本の線にしてみました。
Ductus を使うと、データが DynamoDB と S3 の 2 か所に分かれていることを、ほとんど意識せずに済みます。
- 書き込む側は変わりません。センサーは今までどおり DynamoDB に書くだけで、S3 への取り込みと古いデータの削除は、Ductus と DynamoDB の TTL が受け持ちます
- Grafana 側も変わりません。Infinity の 1 クエリのまま、長い期間が 1 本の線になります。アラートや Stat パネルも、同じクエリで使えます
- 設定は 1 か所です。境界の期間(hotRetention)や期間の上限は datasets.yaml に、取り込みの方法はデプロイ時の -c に書くだけです
Grafana 側で 2 つのクエリを並べる方法と比べると、境界の扱いを自分で合わせ続ける必要がない点が、いちばんの違いだと思います。
古いデータを安く持ちながら、今までと同じ見え方で長い期間を見たい場合に、試してみてください。
Ductus は、以下で公開しています。コールドストアの設定は、手順書(docs/ja/09-cold-storage.md)もあわせて参考にしてください。