[アップデート] Lambda Managed InstancesでGPUインスタンスが使えるようになりました

はじめに
皆様こんにちは、あかいけです。
皆様は、汚名を返上したいと思ったことはありますか?私はあります。
2025年12月のre:Growth 2025で、私は「Lambda Managed Instancesで遂にLambdaでもGPUが使えるぞ!わっしょい!」というお話をしました。
しかしその後の確認で、GPUインスタンスを使えないことがわかり、お詫びと訂正の記事を出しています…。
それから私はLambda Managed InstancesのGPU対応を心待ちにして日々を過ごしていました。
そして時は流れ2026年11月16日、ついにLambda Managed InstancesがGPUインスタンスに対応しました!!!
というわけで今回は、GPUインスタンス上でLambda関数を動かしてみた結果をお届けし、汚名を返上したいと思います。
アップデートの概要
2026年11月16日に、Lambdaの13個のAPIが更新され、Lambda Managed InstancesでGPUインスタンスを使うための設定が追加されました。
主な変更点は次のとおりです。
- 関数側
CreateFunctionやUpdateFunctionConfigurationなど関数系の8個のAPIに、GPUメモリを指定するAcceleratorConfig.AcceleratorMemorySizeが追加された- 実行環境ごとに割り当てるGPUメモリ(GiB)で、指定できる値は3、6、12、16、24、48
- 指定した値は最小値で、インスタンスタイプによってはそれより多く割り当てられることがある
AcceleratorConfigを使う関数は、/tmp(EphemeralStorage)の上限が32,768 MBになる- 関数の状態の理由コードに
IncompatibleAcceleratorInstanceTypesが追加された(名前からすると、キャパシティプロバイダーのインスタンスタイプが関数のGPUの指定に合わないときの理由コードのようです)
- キャパシティプロバイダー側
CreateCapacityProviderなどキャパシティプロバイダー系の5個のAPIで、インスタンスを増減させる基準として、CPU使用率に加えてGPU使用率(LambdaCapacityProviderAverageGPUUtilization)を指定できるようになった- GPUを使うための専用の設定はなく、使いたいGPUインスタンスタイプを既存の
AllowedInstanceTypesなどで指定する
- 利用条件
- パッケージタイプが
Image(コンテナイメージ)で、アーキテクチャがx86_64の関数のみ CapacityProviderConfigの指定が必須(つまりLambda Managed Instancesの関数のみ)
- パッケージタイプが
なお、検証時点(2026年11月18日)では、What's Newでの発表は見当たりませんでした。
Lambda Managed Instancesの製品ページにもGPUについての記載はまだなく、LambdaのロードマップのIssueもDeveloper Previewのままだったので、これから発表されるのでしょう。(おそらく)
前回(2025年12月)の状況
前回はus-east-1で、GPUを搭載したインスタンスタイプを1つずつAllowedInstanceTypesに指定してキャパシティプロバイダーを作成しました。
その結果、すべて次のエラーになりました。
The specified instance type(s) g6.xlarge aren't supported for x86_64 architecture. Choose supported instance types for this architecture.
当時のLambda Managed Instancesで使えたのは、汎用(M系)、コンピューティング最適化(C系)、メモリ最適化(R系)のインスタンスだけでした。
対応インスタンスタイプを調べてみた
まずは前回と同じく、アクセラレータ(GPU、Inferentia、Trainium、FPGAなど)を搭載したインスタンスタイプをDescribeInstanceTypesで洗い出しました。
そのうえで、1タイプずつAllowedInstanceTypesに指定してキャパシティプロバイダーを作成してみました。
バージニア北部リージョンの場合
バージニア北部リージョン(us-east-1)では、アクセラレータ付きの81タイプのうち37タイプで作成できました。
| ファミリー | GPU | GPUメモリ(1基あたり) | 作成できたサイズ |
|---|---|---|---|
| g4dn | NVIDIA T4 | 16 GB | xlarge〜16xlarge(metalを除く) |
| g5 | NVIDIA A10G | 24 GB | xlarge〜48xlarge |
| g6 | NVIDIA L4 | 24 GB | xlarge〜48xlarge |
| g6e | NVIDIA L40S | 48 GB | xlarge〜48xlarge |
| g6f | NVIDIA L4(分割) | 3〜12 GB | large〜4xlarge |
| gr6 | NVIDIA L4 | 24 GB | 4xlarge、8xlarge |
| gr6f | NVIDIA L4(分割) | 12 GB | 4xlarge |
作成できたのは、x86_64でNVIDIA GPUを積んだG系のインスタンスだけでした。
AcceleratorMemorySizeに指定できる値(3、6、12、16、24、48)も、これらのGPUメモリと対応しているようです。
一方、次のタイプは前回と同じくaren't supported for ... architectureのエラーになりました。
- P系(p3dn、p4d、p4de、p5、p5en、p6-b200、p6-b300)
- G系の新しい世代(g7、g7e)
- Graviton搭載のg5g(arm64)
- Inferentia(inf1、inf2)、Trainium(trn1、trn1n)
- FPGA(f2)、動画トランスコード用のvt1
- g4dn.metal
東京リージョンの場合
EC2のインスタンスタイプは、リージョンやAZによって提供されているものが違います。
そのため、Lambda Managed Instancesが対応しているインスタンスタイプでも、リージョンやAZによっては使えないことがあります。
東京リージョンでは、AZの違いが影響しました。
デフォルトVPCの3つのサブネット(ap-northeast-1a、1c、1d)を指定すると、g4dn以外は次のエラーになりました。
No instance types are available in all VPC availability zones. Choose instance types supported in all Availability Zones or adjust the selection.
これは「対応していない」というエラーではなく、「指定したすべてのAZで提供されているインスタンスタイプがない」というエラーです。
DescribeInstanceTypeOfferingsで確認すると、g5やg6系は1aと1cでのみ提供されており、1dでは提供されていませんでした。
サブネットを1aと1cの2つに絞ると、g5、g6、g6e、g6f、gr6、gr6fの代表的なサイズ(g5.xlarge、g6.xlarge、g6e.xlarge、g6f.large、gr6.4xlarge、gr6f.4xlarge)でも作成できました。
対応しているファミリー自体は、us-east-1と同じです。
GPUインスタンスを使うときは、サブネットを決める前に提供AZを確認しておくのがよさそうです。
関数作成時の制約を確認してみた
AcceleratorConfigはコンテナイメージを使うLambda Managed Instancesの関数でしか使えない、とドキュメントにあります。
そこで、条件を変えて関数を作成するとどうなるかを確認しました。
なお、検証時点では手元のAWS CLI(2.36.39)がAcceleratorConfigに対応していなかったため、すでに対応していたCloudFormationで関数を作成しています。
Zipパッケージの2つはus-east-1で、コンテナイメージの5つは後述の検証環境(東京リージョン)でビルドしたイメージを使って確認しました。
| 条件 | 結果 |
|---|---|
| Zipパッケージ + Lambda Managed Instances | AcceleratorConfig is not supported for functions with the Zip package type. To use AcceleratorConfig, set the package type to Image and specify a container image in Amazon ECR. |
| Zipパッケージ + 通常のLambda | Invalid request provided: AcceleratorConfig can't be specified unless creating a Lambda Managed Instance function. |
| コンテナイメージ + 通常のLambda | Invalid request provided: AcceleratorConfig can't be specified unless creating a Lambda Managed Instance function. |
| コンテナイメージ + arm64 | You cannot use a Lambda Managed Instances function with a capacity provider that does not support the architecture of the function |
| GPUを許可していないキャパシティプロバイダー(m7i.largeのみ) | The specified capacity provider does not include any accelerator instance types. Use a capacity provider with accelerator instance types or remove the AcceleratorConfig. |
| GPUメモリが足りないインスタンスタイプ(g6.xlargeで48 GiBを指定) | The specified capacity provider does not allow for any instance types whose accelerator chips each provide at least 48 GB of memory. Use a capacity provider that allows higher-memory accelerators or reduce the function's AcceleratorMemorySize. |
| 有効値以外のGPUメモリ(8 GiBを指定) | The specified value for AcceleratorMemorySize isn't valid. The value must be one of 3, 6, 12, 16, 24 or 48 GB. |
どの条件も、関数を作成した時点でエラーになりました。
なお、通常のLambdaを指定したときのエラーには、LambdaのリクエストIDが付いていませんでした。
LambdaのAPIを呼ぶ前に、CloudFormation側の検証で返されたエラーのようです。
コンテナイメージ + arm64は、x86_64のキャパシティプロバイダーにarm64の関数を紐づけたときの一般的なエラーです。
ただ、前述のとおりarm64のGPUインスタンス(g5g)はキャパシティプロバイダーで許可できないので、arm64でGPUを使う構成はそもそも作れません。
GPUメモリが足りない場合のエラーからは、AcceleratorMemorySizeが「GPU 1基あたりのメモリ」として判定されていることがわかります。
結論として、ドキュメントのとおりAcceleratorConfigはコンテナイメージを使うLambda Managed Instancesの関数でしか使えませんでした。
GPUインスタンスのクォータ
GPUインスタンスは、通常のインスタンスとは別の「Running On-Demand G and VT instances」というクォータの対象です。
このクォータは、起動しているG系とVT系のインスタンスのvCPUの合計に対する上限です。
Lambda Managed Instancesでは、関数のバージョンを発行すると、AZ冗長のためにインスタンスが既定で3台起動します。
そのため、g6.xlarge(4 vCPU)を既定の3台で使うなら、12 vCPU分のクォータが必要です。
今回の検証用アカウントでは、このクォータが4 vCPUまでだったので、とりあえずg6.xlarge 1台構成でやってみます。
試してみた
検証環境
検証環境の構成は以下のとおりです。
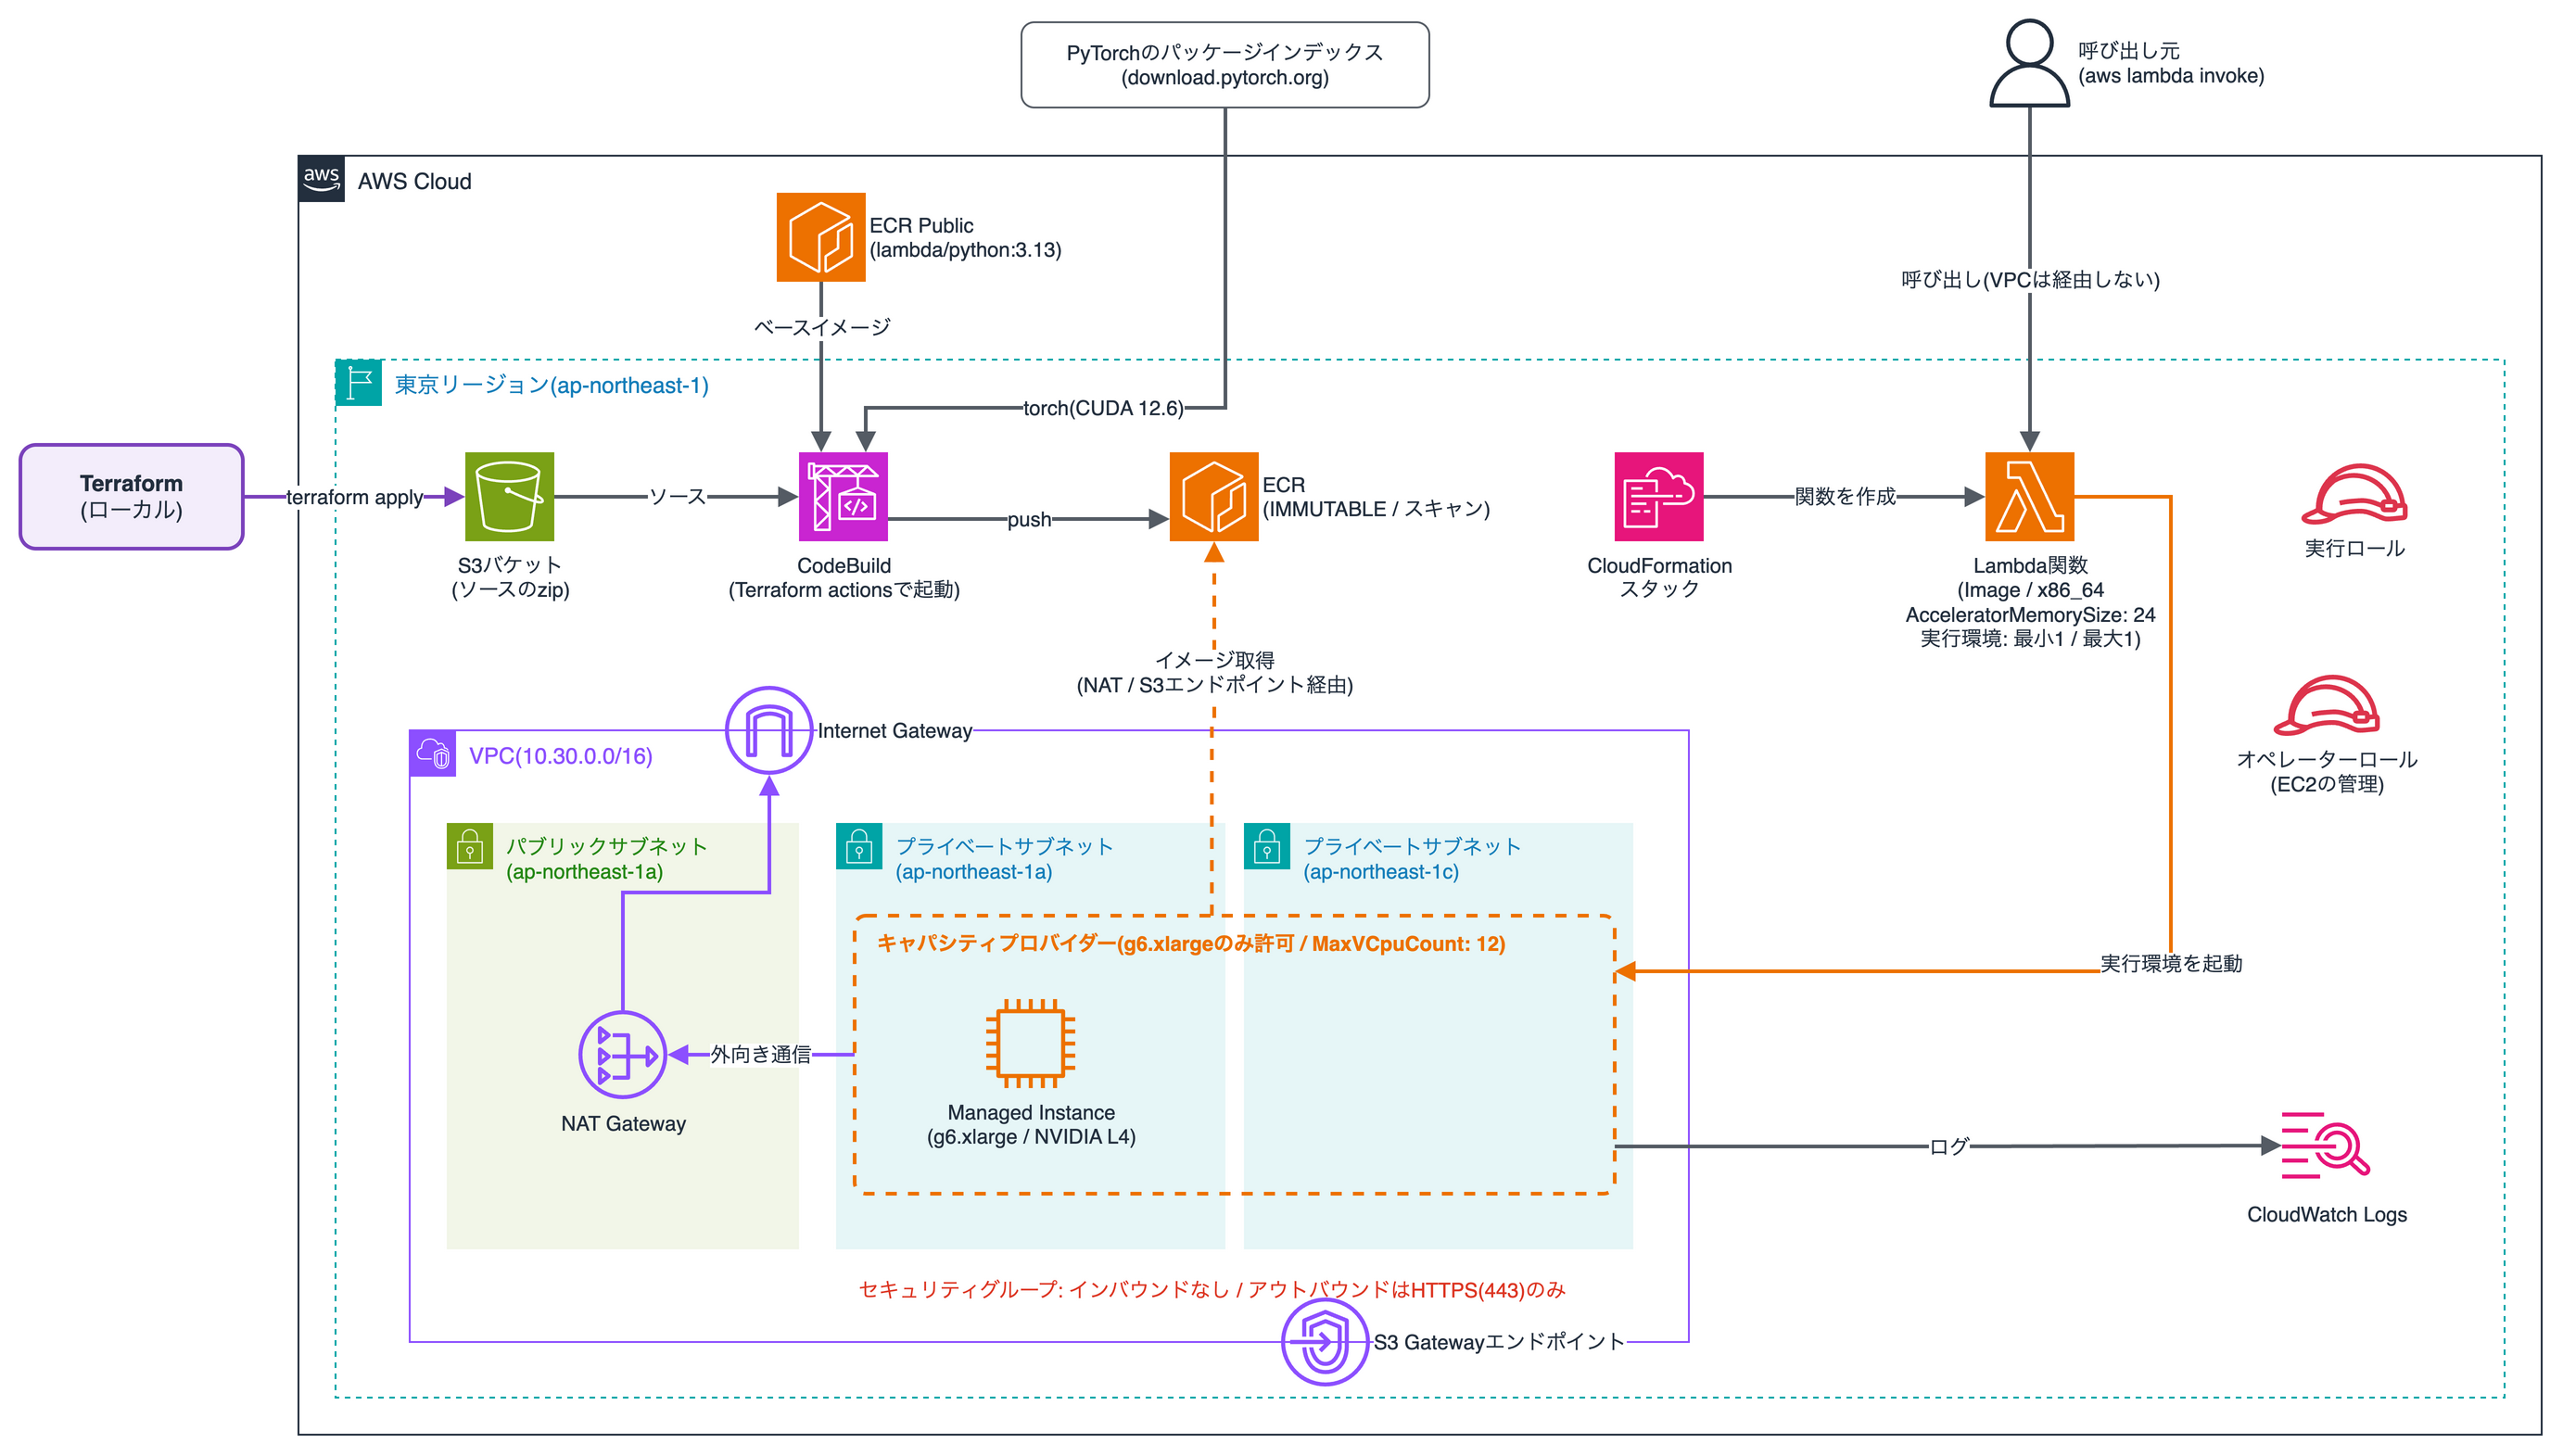
構築で使ったIaCは以下のリポジトリに置いているので、ご自由にお使いください。
主な構成は次のとおりです。
- リージョン
- ap-northeast-1(東京)。検証用アカウントのGPUクォータが東京で4 vCPUだったため
- ネットワーク
- プライベートサブネット2つ(東京でg6.xlargeを提供している1aと1c)
- 外向きの通信はNAT Gateway経由で、ECRのイメージレイヤーはS3 Gatewayエンドポイント経由
- セキュリティグループはインバウンドなし、アウトバウンドはHTTPS(443)のみ
- キャパシティプロバイダー
- g6.xlargeのみ許可し、
MaxVCpuCountは指定できる最小の12 - 実際に起動できるのは、GPUクォータ(4 vCPU)に収まる1台まで
- g6.xlargeのみ許可し、
- Lambda関数
- コンテナイメージ、x86_64、メモリ8 GB、
AcceleratorMemorySizeは24 GiB - 実行環境の数は最小1、最大1(
MinExecutionEnvironmentsとMaxExecutionEnvironments)
- コンテナイメージ、x86_64、メモリ8 GB、
- コンテナイメージ
- Python 3.13のLambdaベースイメージにPyTorch(CUDA 12.6版)を入れたもの
- 関数は、CPUとGPUで同じサイズの行列積を実行し、かかった時間を返す
- イメージのビルド
- CodeBuildでビルドし、ECRにpushする
- Terraform actionsの
aws_codebuild_start_buildを使い、terraform applyの中でビルドを起動する(ローカルにDockerは不要)
Terraformで書けなかったところ
検証時点のAWS Provider(6.73.0)とAWS Cloud Control Provider(1.110.0)は、どちらも関数のAcceleratorConfigに対応していませんでした。
そこでGPU関数だけは、すでにAcceleratorConfigに対応していたCloudFormationのテンプレートをaws_cloudformation_stackで作成しています。
なおAWS Providerには対応のIssueとPRがすでに作られているので、近いうちに使えるようになるでしょう。
GPU上で関数を実行する
関数の作成が完了したら、$LATEST.PUBLISHED(最後に発行したバージョン)を指定して呼び出します。
aws lambda invoke --region ap-northeast-1 \
  --function-name lmi-gpu-function \
  --qualifier '$LATEST.PUBLISHED' \
  --cli-binary-format raw-in-base64-out \
  --payload '{"size": 4096, "repeat": 10}' response.json
レスポンスは次のとおりでした。
{
  "torch_version": "2.14.1+cu126",
  "cuda_runtime_version": "12.6",
  "cuda_available": true,
  "driver_version": "NVRM version: NVIDIA UNIX Open Kernel Module for x86_64  580.178.04  Release Build  (dvs-builder@U22-I3-AE18-16-4)  Tue Jul  7 12:18:12 UTC 2026",
  "gpu": {
    "name": "NVIDIA L4",
    "device_count": 1,
    "total_memory_gib": 22.03,
    "compute_capability": "8.9"
  },
  "cpu_count": 4,
  "uid": 993,
  "env": {
    "NVIDIA_VISIBLE_DEVICES": null,
    "CUDA_VISIBLE_DEVICES": null,
    "NVIDIA_DRIVER_CAPABILITIES": null
  }
}
LambdaのコードからNVIDIA L4がちゃんと使えています。🎉🎉🎉
- GPU
- g6.xlargeに積まれているNVIDIA L4が1基
- PyTorchから見えるメモリは22.03 GiB(公称24 GB)
- ドライバーとCUDA
- ホストのNVIDIAドライバーは580系(Open Kernel Module)
- CUDA 12.6版のPyTorchが、追加の設定なしで動いた
- 実行ユーザー
- uidは993で、rootではない
- Dockerfileで
USERの指定はしていない
続いて、同じサイズの行列積(float32)をCPUとGPUで実行した時間です。
CPU側の計算に使えるのは、関数のメモリ(8 GB)と比率(4:1)の設定上は2 vCPUです。
(レスポンスのcpu_countの4は、g6.xlarge全体のvCPU数です)
| 行列のサイズ | CPU(1回あたり) | GPU(1回あたり) | 速度の比 |
|---|---|---|---|
| 4096×4096 | 0.680秒(0.20 TFLOPS) | 0.0103秒(13.3 TFLOPS) | 約66倍 |
| 8192×8192 | 5.380秒(0.20 TFLOPS) | 0.0978秒(11.2 TFLOPS) | 約55倍 |
GPUにすると、行列積が50倍以上速くなりました。
呼び出し全体の時間(CloudWatch Logsのplatform.report)は、4096×4096が2.84秒、8192×8192が17.9秒で、ほとんどがCPU側の計算の時間です。
インスタンスの台数を指定する
起動するインスタンスの台数は、関数の実行環境の数(FunctionScalingConfigのMinExecutionEnvironmentsとMaxExecutionEnvironments)で指定できました。
今回は両方を1にしたところ、g6.xlargeが1台だけ起動しています。
一方、キャパシティプロバイダーのMaxVCpuCount(起動するインスタンスのvCPUの合計の上限)は、12より小さい値を指定できませんでした。
APIリファレンス上の最小値は2ですが、g6.xlarge 1台分の4を指定すると、次のエラーになります。
The requested maximum vCPU count 4 is below the recommended minimum. Increase the vCPU count or reduce current usage and try again.
そのため、MaxVCpuCountでは1台に絞れません。
なお、指定しているのはあくまで実行環境の数なので、1台に複数の実行環境が載るインスタンスタイプでは、台数と一致しない可能性があります。
また、1台構成にすると、既定の3台構成で得られるAZ冗長はなくなります。
GPU使用率でのスケーリング
今回のアップデートで、キャパシティプロバイダーのスケーリングポリシーに、GPU使用率(LambdaCapacityProviderAverageGPUUtilization)を指定できるようになりました。
スケーリングポリシーはターゲット追跡型で、スケーリングモードをManualにして目標値(TargetValue)を指定すると、GPU使用率がその値に近づくようにインスタンスが増減します。
今回の検証で確認できたのは、次の範囲です。
- スケーリングポリシーの作成
- GPUインスタンスを許可したキャパシティプロバイダーでは、GPU使用率のポリシーを作成でき、CPU使用率のポリシーとの併用もできた
- CPUのインスタンスだけを許可したキャパシティプロバイダーでは、
The LambdaCapacityProviderAverageGPUUtilization metric type is only supported on GPU capacity providers.というエラーで作成できなかった
- メトリクス
- CloudWatchの
AWS/Lambda名前空間に、キャパシティプロバイダー単位(GPUUtilization、GPUAllocatedなど6種類)と実行環境単位(ExecutionEnvironmentGPUUtilizationなど4種類)のGPUメトリクスが出ていた GPUAllocatedが1、GPUAvailableが0で、g6.xlargeのGPU 1基が関数の実行環境に割り当てられていたGPUUtilizationは関数を呼び出した1分間だけ2.22%で、それ以外は0%だった(行列積が1秒未満で終わるため)
- CloudWatchの
GPU使用率が上がったときに実際にスケールアウトするかは、クォータが1台分しかないため確認できていません。
さいごに
以上、Lambda Managed InstancesでGPUインスタンスが使えるようになったアップデートの紹介でした。
前回の記事から苦節約1年、ようやくLambdaでGPUを使えるようになりました…。
ただし、以下のような制約はあるため利用する際は考慮が必要です。
- 対応するインスタンスタイプはG系のNVIDIA GPUを積んだインスタンス
- コンテナイメージを使うx86_64の関数に限られる
- GPUインスタンスはAZによって提供されていないことがあるので、サブネットのAZに注意する
- GPUインスタンスのクォータは通常のインスタンスとは別枠なので、事前に確認しておく
今回は前回と同じ方法で確認し直し、実際にGPUで関数を動かすところまで試したので、今度こそ間違った情報ではない…はずです!
この記事が、前回の記事で勘違いさせてしまった方や、LambdaでGPUを使いたかった方の参考になれば幸いです。