GPUとゼロスケールに対応したLambda Managed InstancesでLLMを実行する関数を作って動かしたら、コールドスタートに約4分20秒かかった

こんちには。製造ビジネステクノロジー部の中村(@nokomoro3)です。
re:Invent 2026の直前に、Lambda Managed Instances(以下、LMI)へのアップデートが2日続けて発表されました。
- 2026年11月17日:LMIがゼロスケールに対応(
MinExecutionEnvironments=0)
- 2026年11月18日:LMIがGPUインスタンスに対応(
AcceleratorConfig)
GPUの対応については、あかいけさんがg6.xlargeで動かした記事をすでに書かれています。
GPUインスタンスはコストが高めなので、使わない間に止められるかどうかで費用が大きく変わります。一方で、ゼロスケール状態からのコールドスタートではGPUインスタンスの起動、イメージの取得、モデルのロードが必要になり、通常のLambdaのコールドスタートとは別の要素で時間がかかる可能性があります。
そこで本記事では、以前g7eで試したvLLMの構成を踏襲して、LMIのGPUインスタンスでLLMを動かし、ゼロスケール状態からのコールドスタートにかかる時間とその内訳を測ってみました。
結論
- g6e.xlarge(NVIDIA L40S)で、vLLMとQwen3-30B-A3Bを動かし、ゼロスケール状態から最初の応答が返るまで約260秒(約4分20秒)
- ここでのゼロスケール状態とは、最後の呼び出しから約16.5分たってインスタンスが終了した後の状態とする(終了するまでの間もインスタンスの料金がかかる)
- 約260秒の内訳は次のとおり
- インスタンスの起動(OSの起動まで):約19秒
- コンテナイメージの取得と展開など:約144秒
- vLLMの初期化:約92秒(うち、S3からの重み29GiBのロードが約44秒)
- 応答が返るまで:約6秒(計測の呼び出し間隔の待ちを含む)
- コンテナイメージは圧縮後4.82GB、展開後10.79GBで、イメージの取得と展開がコールドスタートの時間の大きな部分を占めていると推測
- コールドスタートを待つ間、同期呼び出しには429(
TooManyRequestsException)が返り続けるためクライアント側で対応が必要
検証の構成
構成の概要
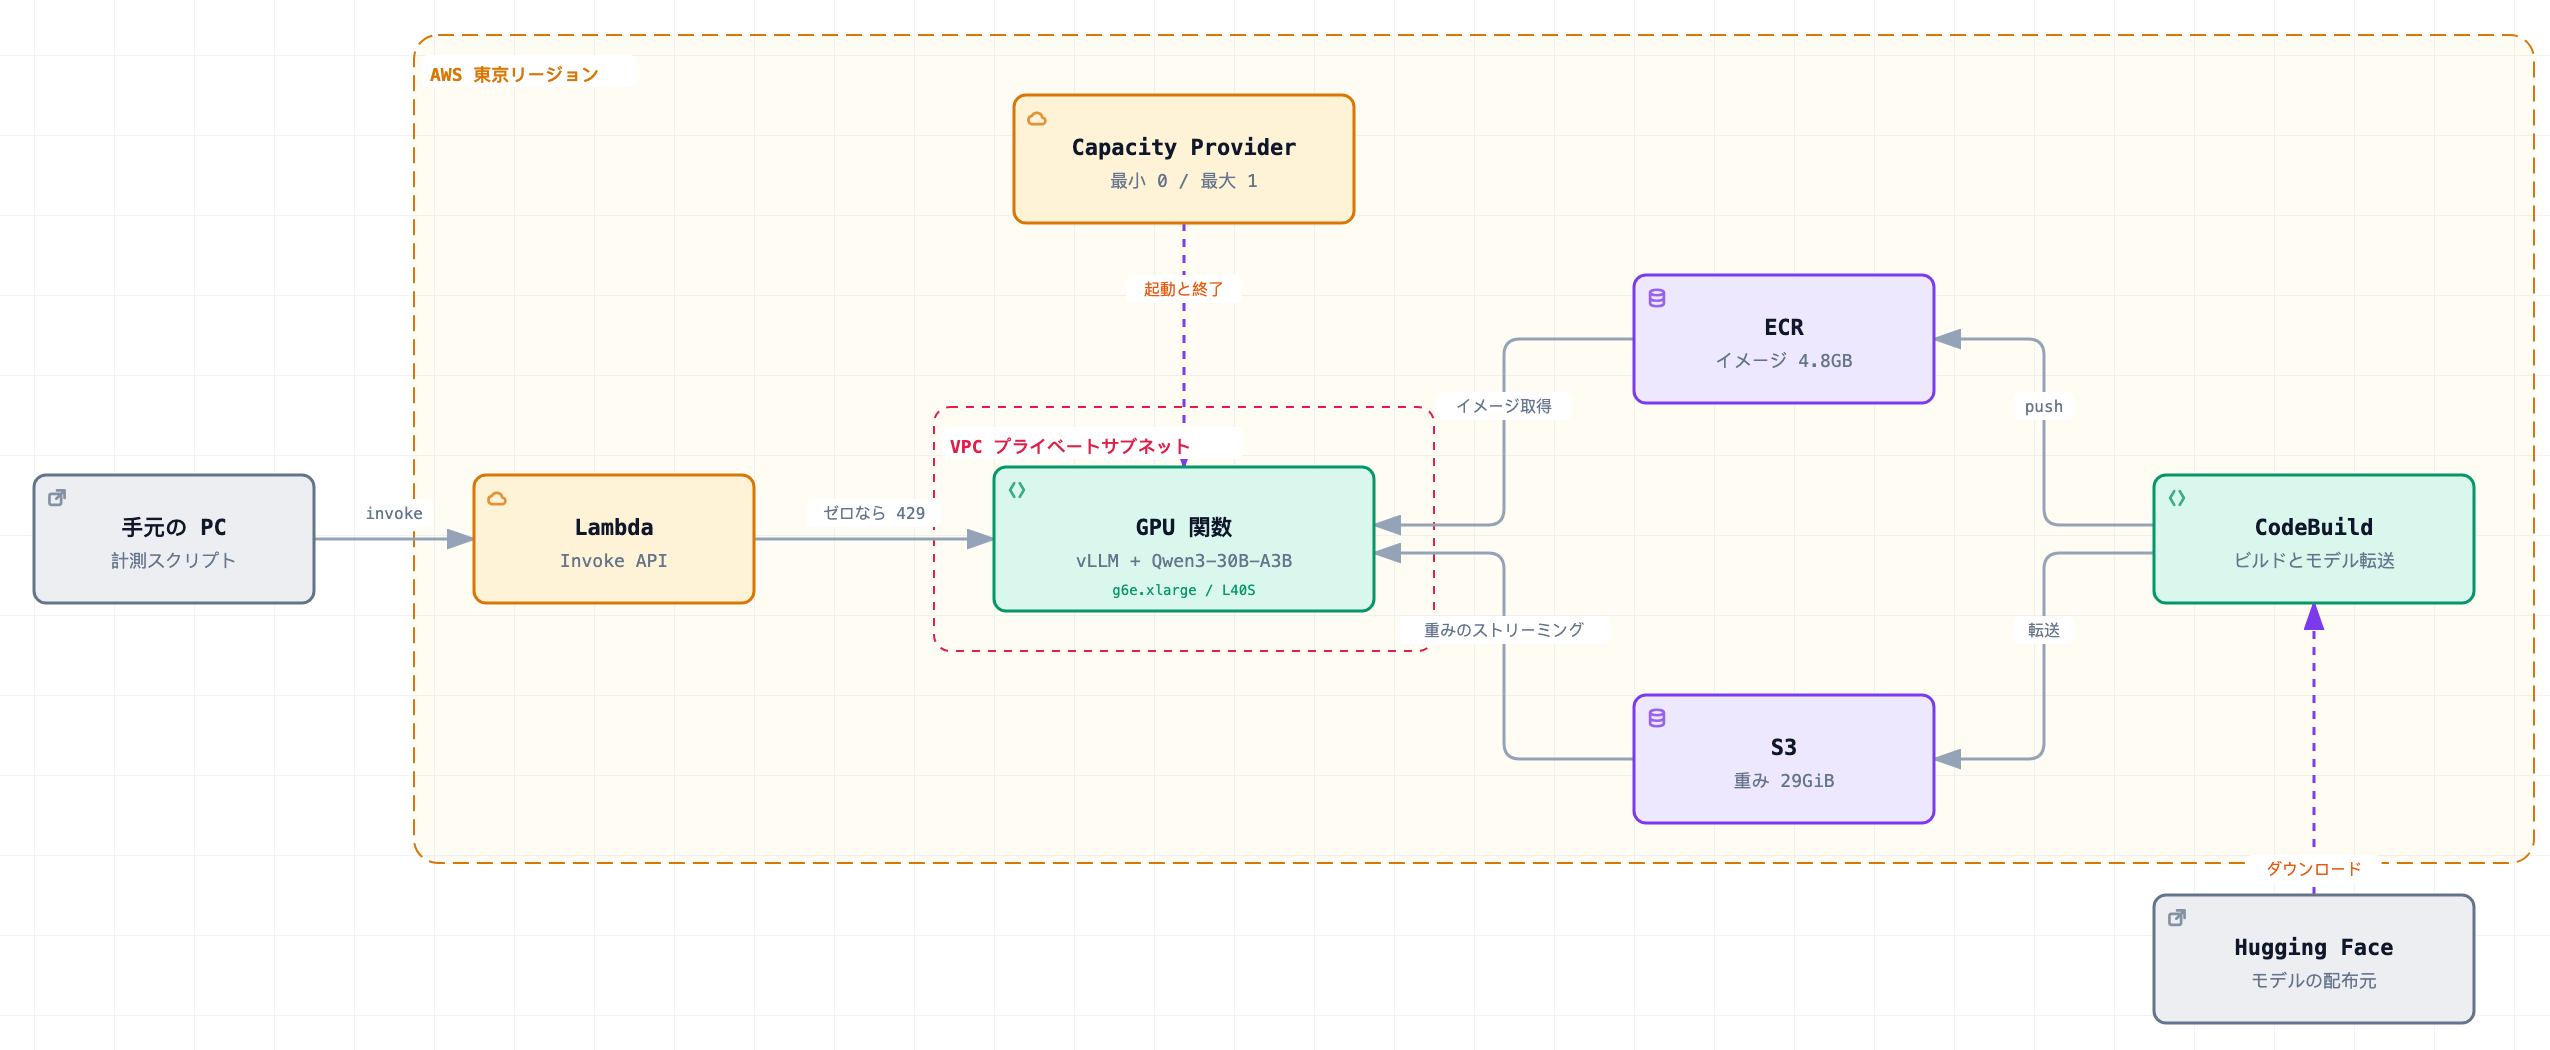
構成は、あかいけさんのTerraform(Lamaglama39/lambda-managed-instances-gpu)を参考に、LLM向けに書き直しました。
検証に使ったコードは、次のリポジトリで公開しています。
以下が概要です。
- VPCのプライベートサブネット(東京リージョンの1a、1c)にCapacity Providerを置き、外向きの通信はNATゲートウェイ経由にする
- コンテナイメージはCodeBuildでビルドしてECRに置く
- モデルの重みは、CodeBuildでHugging FaceからS3へ転送しておき、Lambda関数の初期化中にS3から直接GPUへ読み込む
- Lambda関数は
MinExecutionEnvironments=0、MaxExecutionEnvironments=1にする
2026年11月19日時点では、Terraformの最新のAWS Provider(6.73.0)でもaws_lambda_functionがAcceleratorConfigに対応していないため、Lambda関数だけはCloudFormation(Terraformのaws_cloudformation_stackを使用)で作っています。
インスタンスとモデル
以下の記事のDeepSeek V4 Flashとg7eは、そのままでは使えませんでした。
LMIが対応しているGPUインスタンスはG系のg4dn、g5、g6、g6e、g6f、gr6、gr6fで、g7eは含まれていないためです。
またAcceleratorMemorySizeの上限は48GiBなので、DeepSeek V4 FlashのNVFP4版(以前の記事ではRTX PRO 6000の2基で動かしたもの)は載せるのが難しそうです。
GPUを使うLambda関数では、どのGPUで動かすかを2か所で指定します。
- Capacity Provider:起動してよいインスタンスタイプを
AllowedInstanceTypesに並べる(GPUを使う場合は、対応するGPUインスタンスタイプだけを並べる) - Lambda関数:GPU 1基あたりに必要な最小のメモリを
AcceleratorMemorySizeで指定する
Lambdaは、許可されたインスタンスタイプのうちAcceleratorMemorySizeを満たすものから、インスタンスを選びます。
when several instance types in your capacity provider qualify, chooses the latest generation with the lowest GPU memory that satisfies your function's GPU memory requirement.
(Capacity Providerの中に条件を満たすインスタンスタイプが複数ある場合は、Lambda関数が必要とするGPUメモリを満たすもののうち、最新世代でGPUメモリが最も小さいものを選びます)
今回は、Capacity Providerで許可するインスタンスタイプを、対応インスタンスで最もGPUメモリの大きいg6e.xlargeだけにし、Lambda関数のAcceleratorMemorySizeに上限の48を指定しました。
モデルは、L40Sの1基に載る30B級のMoEモデルにしています。
| 項目 | 内容 |
|---|---|
| インスタンス | g6e.xlarge(4 vCPU、32GiB、NVIDIA L40S 1基) |
| モデル | Qwen/Qwen3-30B-A3B-Instruct-2507-FP8(総パラメーター30B、有効パラメーター3B、重みは29.1GiB、Apache-2.0) |
| 推論エンジン | vLLM 0.33.0(PyTorch 2.14.0) |
| ランタイム | AWS公式のLambda Python 3.12ベースイメージ |
| Lambda関数のメモリ | 24,576MB(vCPUあたり8GiB) |
AcceleratorMemorySize |
48(GiB) |
PerExecutionEnvironmentMaxConcurrency |
1 |
| Lambda関数のタイムアウト | 900秒 |
L40Sの実際のメモリは45,776MiB(約44.7GiB)ですが、AWSのドキュメントではG6eのGPUメモリは48GBとされており、AcceleratorMemorySizeに48を指定して関数を作成できました。
Lambda関数のタイムアウトを最大の900秒にしたのは、初期化の時間を確保するためです。
LMIでは、初期化(ハンドラーの外のコード)にかけられる時間が、Lambda関数のタイムアウトで決まります。
For Lambda Managed Instances functions, initialization can take up to 15 minutes. The timeout is the maximum of 130 seconds or the configured function timeout (up to 900 seconds).
(Lambda Managed Instancesの関数では、初期化に最大15分かけられます。タイムアウトは、130秒と設定した関数のタイムアウト(最大900秒)のうち大きい方です)
タイムアウトを130秒未満のままにしておくと、初期化は130秒で打ち切られます。今回のようにLLMを初期化中にロードする場合、モデルやイメージが大きいとすぐに130秒を超えてしまうため、タイムアウトを上げておく必要があります。
vLLMの設定
vLLMの設定は、以前の記事の最終形に近づけました。
以前の記事との違いは次の3点です。
- /tmp領域にダウンロードなしにモデルをメモリにロードする工夫
load_format="runai_streamer"で、S3の重みをRun:ai Model Streamerで読み込む。/tmpに一度モデルをダウンロードせずに済む
- FlashInferを使わないようにした
- vLLMは既定ではFlashInferを選び、そのカーネルを実行時にコンパイルしようとする
- LambdaのベースイメージにはCUDA Toolkit(
nvcc)がないため、そのままでは初期化が失敗する
- 今回のモデルにMTPの重みがないためMTPは使用なし
初期化はハンドラーの外のコードでエンジンを作り、ハンドラー呼び出し時はテキスト生成だけを行います。
また、コールドスタートの内訳を出すために、初期化の開始時に/proc/uptimeを読んで、インスタンスのOSが起動してから何秒経っていたかを記録しました。
この値を初期化の開始時刻から引くと、OSが起動した時刻が分かります。
計測の方法
手元のPCから次の手順で計測しました。
- インスタンスがない状態で、boto3の既定の設定で1回呼び出し、諦めるまでの時間を記録する
- 以降はSDKのリトライを止め(
total_max_attempts=1)、5秒ごとに呼び出し続ける - 呼び出しのたびに、
describe-instancesでインスタンスの状態を記録する(LMIのインスタンスは既定ではEC2のAPIの一覧に出てこないため、IncludeManagedResources=Trueを付ける) - 最初に成功した応答から、Lambda関数内で記録した初期化の時刻を取り出す
初回デプロイ
リクエスト時の計測前に、Lambda関数を作成したときの流れも記録しておきます。Lambda関数を作成すると、最小を0にしていても実行環境が1つ起動し、それが準備できてからCloudFormationのスタックが完了しました。
| 経過 | 出来事 |
|---|---|
| 0:00 | スタックの作成を開始 |
| 1:49 | g6e.xlargeの起動(CloudTrailのRunInstances) |
| 4:18 | Lambda関数の初期化が始まる |
| 5:47 | 初期化が完了(92.7秒) |
| 6:55 | スタックの作成が完了 |
この後は一度も呼び出していませんが、初期化の完了から約17.6分後にインスタンスが終了しました。そのため、呼び出さなくても、デプロイのたびに20分強のGPU料金がかかることになりそうです。
ゼロスケール状態からのコールドスタート
最初の応答までの時間と内訳
最後の呼び出しから時間がたち、インスタンスまで終了した状態から呼び出して、最初の応答が返るまで約260秒かかりました。
なお、実行環境が残っている間に呼び出せば、次の呼び出しはすぐに返ります(今回は生成込みで約1.6秒)。
実行環境がいつ止まるかは測っていませんが、インスタンスは最後の呼び出しから約16.5分で終了しました。
| 区間 | 時間 | 根拠 |
|---|---|---|
| 最初の呼び出しから、インスタンスのOSが起動するまで | 約18.7秒 | 初期化の開始時刻と/proc/uptimeの差 |
| OSの起動から、Lambda関数の初期化の開始まで | 143.5秒 | 初期化の開始時の/proc/uptime |
| Lambda関数の初期化 | 92.1秒 | ハンドラー内で記録した時刻 |
| 初期化の完了から、応答まで | 5.7秒 | 呼び出しの間隔(5秒)の待ちと、生成の1.6秒 |
| 合計 | 約260秒 |
インスタンスの起動要求は、最初の呼び出しから約8秒後に出ていました(EC2のLaunchTime)。
一番長いのは、OSが起動してから関数の初期化が始まるまでの143.5秒です。
この区間には、OSの起動、Lambdaのエージェントの起動、コンテナイメージ(圧縮後4.8GB)の取得と展開が含まれます。
(LMIの内部の処理なので、それぞれの時間は分けられませんでした。)
初回デプロイ時もインスタンスの起動要求から初期化の開始まで約2分29秒だったので、毎回この程度かかると考えてよさそうです。
インスタンス確保の影響
GPUインスタンスの空きが少なく、確保に時間がかかっているのではないか、という見方もできますが、今回は、起動要求の約10秒後にはrunningになっており、OSも最初の呼び出しから約18.7秒で起動していました。
空きがなければ、起動要求の段階でInsufficientInstanceCapacityのようなエラーと再試行がCloudTrailに残るはずですがRunInstancesは3回とも一度で成功しています。
したがって、今回のコールドスタートの時間の大半は、インスタンスの確保ではなく、確保した後の処理にかかっていたと言えます。ただし、GPUインスタンスが混み合う時間帯であれば確保で待たされる可能性はあると考えています。
コンテナイメージの大きさ
コンテナイメージの大きさの内訳をCodeBuildでdocker pullして確かめました。
| 項目 | サイズ |
|---|---|
| 圧縮後(ECRの表示) | 4.82GB |
展開後(docker image inspect) |
10.79GB |
| うちPythonパッケージのレイヤー | 9.9GB |
うちCUDAのライブラリ(nvidia/) |
3,546MB |
うちPyTorch(torch/) |
1,174MB |
うちTriton(triton/) |
896MB |
うちvLLM(vllm/) |
870MB |
うちFlashInfer(flashinfer/、今回は使っていない) |
535MB |
同じ東京リージョンのCodeBuildでは、docker pullに103秒かかりました。
LMIの内部の時間を直接測ったわけではありませんが、この結果から、143.5秒の大部分はイメージの取得と展開だとみています。
GPUを使うLambda関数の起動時間の最適化について、AWSのドキュメントにも同じ趣旨の説明があります。
GPU images are often several gigabytes, so this step usually dominates startup time. Unpacking is CPU-heavy and can take longer than the download itself.
(GPU用のイメージは数GBになることが多いため、通常はこの手順(イメージの取得)が起動時間の大半を占めます。展開はCPUを多く使い、ダウンロードそのものより時間がかかることがあります)
同じページでは、イメージの取得を短くする方法として、レイヤーを分けること(レイヤーは並列にダウンロードされ、届いたものから展開される)と、SOCI(Seekable OCI)による遅延読み込みが挙げられています。
今回のイメージは、Pythonパッケージの9.9GBが1つのレイヤーにまとまっていたので、どちらも改善の余地があります(今回は試していません)。
なお、イメージのサイズの上限は、GPUを使うLambda関数とそれ以外で異なります。
通常のLambdaのコンテナイメージは展開後10GBまでですが、GPUを使うLambda関数は32GB(イメージ内の1ファイルは10GBまで)まで使えます。
今回の10.79GBのイメージでLambda関数を作成できたのは、このためです。
Lambda関数の初期化の内訳
Lambda関数の初期化(92.1秒)は、vLLMのログから次のように分けられます。
| 区間 | 時間 | 内容 |
|---|---|---|
| 0.0〜9.3秒 | 9.3秒 | vLLMのimport |
| 9.3〜26.8秒 | 17.5秒 | S3から設定とトークナイザーを取得し、エンジンのプロセスを起動 |
| 26.8〜70.7秒 | 44.3秒 | 重みのロード |
| 70.7〜91.8秒 | 21.0秒 | メモリのプロファイル、KVキャッシュの確保、CUDA Graphのキャプチャ、ウォームアップ |
重みのロードでは、29.0GiBをS3から42.0秒(707.6MiB/s)で読んでいました。
[RunAI Streamer] Overall time to stream 29.0 GiB of all files to cpu: 42.01s, 707.6 MiB/s
Model loading took 29.11 GiB memory and 44.294827 seconds
Graph capturing finished in 2 secs, took 0.06 GiB
init engine (profile, create kv cache, warmup model) took 21.00 s
429のメッセージとSDKのリトライ
ゼロの状態で呼び出すと、待たされるのではなく、すぐに429が返ります。
このとき返ってきたTooManyRequestsExceptionのエラーメッセージには、理由と対処がそのまま書かれていました。
No execution environments are available for this function version. Lambda scaled the function down to zero after a period of inactivity and is starting a new execution environment, which may take a few minutes. Retry the request with exponential backoff. To keep environments always available, set Mi...
(メッセージの末尾は省略しています)
(関数がしばらく使われなかったためゼロまで縮んでおり、新しい実行環境を起動しています。数分かかることがあるので、指数バックオフでリトライしてください、という内容です)
boto3の既定の設定(standardモード)で呼び出すと、3回試して2.86秒で諦め、この429がそのまま例外になりました。
4分以上かかるコールドスタートには、まったく足りません。
同期呼び出しでコールドスタートを待つなら、呼び出し側で数分間リトライし続ける必要があります。
今回の計測では、SDKのリトライを止めて5秒間隔で呼び直しました。
最大回数を増やす方法でも待てるはずですが、standardモードのバックオフは1回あたり最大20秒なので、5分程度待つには数十回を指定することになります。
最後の呼び出しからゼロスケール状態になるまで
最後の呼び出しから、インスタンスが終了(shutting-down)するまでは約16.5分でした(15秒間隔で確認)。
初回デプロイの後に一度も呼ばなかったときも約17.6分だったので、アイドルが15分を超えたあたりで実行環境が止まり、その後にインスタンスが終了しているようです。
料金の目安
g6e.xlargeの東京リージョンのオンデマンド料金は$2.699/時で、LMIではこれに15%の管理手数料が加わり、約$3.10/時になります。
| 使い方 | 料金の目安 |
|---|---|
常時1台(MinExecutionEnvironments=1) |
約$3.10 × 730時間 = 約$2,266/月 |
| ゼロスケールで、1回起こして数分使う | 約$3.10 × 約22分 = 約$1.1/回 |
ゼロスケールにすると、1回起こすたびに、コールドスタートの約4分とアイドルの約16.5分の分の料金がかかります。
1日に数回しか使わないなら、常時1台に比べて桁違いに安くなります。
注意点
FlashInferのJITコンパイルで初期化が失敗する
最初のデプロイでは、Lambda関数の初期化が次のエラーで失敗しました。
FileNotFoundError: [Errno 2] No such file or directory: 'which'
vLLMがAttentionとサンプリングにFlashInferを選び、そのカーネルをJITコンパイルしようとしてnvccを探したところで落ちていました。
Lambdaのベースイメージには、whichコマンドもCUDA Toolkitも入っていません。vLLMのログにも、事前にビルドされたカーネル(flashinfer-cubin)がなく、nvccもないのでFlashInferのカーネルは使えない、という警告が出ていました。
今回はAttentionをTRITON_ATTNにし、VLLM_USE_FLASHINFER_SAMPLER=0でサンプラーもPyTorchの実装にして回避しました。
あわせて、Lambdaでは/tmp以外に書き込めないので、vLLMやTritonのキャッシュの置き場所も/tmpに向けています。
初期化に失敗すると、CloudFormationのスタックはROLLBACK_COMPLETEになり、スタックを削除しないと作り直せない点にも注意が必要です。
依存パッケージのロックでllguidanceが解決できない
イメージに入れるパッケージは、uvでハッシュ付きのロックを作ってからインストールしました。
このとき、--python-platform x86_64-manylinux_2_28を指定すると、vLLMが依存するllguidance(1.7系)が解決できませんでした。llguidanceのx86_64のホイールはmanylinux_2_31以上向けしかないためです。
Lambdaのベースイメージ(Amazon Linux 2023)のglibcは2.34なので、x86_64-manylinux_2_34を指定して解決しました。
ロックの入力と、生成に使ったコマンドは次のとおりです。
まとめ
Lambda Managed InstancesのGPUインスタンス(g6e.xlarge)でvLLMとQwen3-30B-A3BのFP8版を動かし、ゼロスケール状態からのコールドスタートにかかる時間を測りました。
インスタンスまで終了した状態からのコールドスタートは約4分20秒で、そのうち6割強はインスタンスの起動とイメージ(展開後10.79GB)の取得、残りのほとんどがvLLMの初期化でした。
短縮のためには、まずイメージの取得と展開を短くするのが効きそうです。
具体的には、使わないパッケージ(今回ならFlashInfer)を外してイメージを小さくする、大きなレイヤーを分ける、SOCIで遅延読み込みする、といった方法があります。
LambdaはvLLM入りのGPU用ベースイメージや、SOCIのインデックスを含むベースイメージ(-sociの付いたタグ)を用意しているので、自前のイメージではなくそちらを使うのも手です(いずれも今回は試していません)。
ただし、これらを組み合わせても、インスタンスの起動とモデルのロードの分は残るため、数秒で応答を返す必要があるリアルタイムの用途には向きません。
そうした用途では、MinExecutionEnvironmentsを1以上にして実行環境を常に残しておく必要があります。
また、コールドスタートを待つ間は429が返り続けるので、呼び出し側には数分単位のリトライが必要です。そのあたりにもご留意ください。
本記事がご参考になれば幸いです。
参考リンク
- AWS Lambda now supports scale to and from zero for Lambda Managed Instances(What's New)
- AWS Lambda adds support for GPU instances on Lambda Managed Instances(What's New)
- AWS Lambda now supports GPU instances for Event Functions on Lambda Managed Instances(AWS News Blog)
- Run GPU-accelerated Event Functions on Lambda Managed Instances(AWSドキュメント)
- Optimizing startup time for GPU-accelerated functions(AWSドキュメント)
- Scaling Lambda Managed Instances(AWSドキュメント)
- Understanding the Lambda Managed Instances execution environment(AWSドキュメント)
- [アップデート] Lambda Managed InstancesでGPUインスタンスが使えるようになりました | DevelopersIO
- DeepSeek V4 FlashをAWSのg7eにvLLMでセルフホストして、性能チューニングしてみた | DevelopersIO
- Qwen/Qwen3-30B-A3B-Instruct-2507-FP8(Hugging Face)