テレオペデータを使わずisaac sim上で合成したデータでGR00Tを学習できるかを検証してみた

はじめに
ロボットアームの進展は凄まじい状況であり、高価なアームでなくとも衣服を畳んだり料理をしたりみたいな事例も出てきました。加えてGR00Tなどの基盤モデルの登場で着実にロボットアーム開発はコモディティ化されて敷居は下がってきています。
一方で、独自のタスクに応用しようとすると学習データの準備が壁になります。フィジカル AI では実際にアームを動かして正解データを集める必要があり(いわゆるテレオペ)、画像認識や言語モデルのアノテーションと比較しても作業に能力と時間が必要となります。
フィジカルAIのボトルネックは学習データ収集と言えそうです。
そこで本記事ではNvidiaの公式チュートリアルにて元からあるテレオペデータと、チュートリアルを応用してシミュレーションから1から生成したデータでそれぞれ基盤モデル(GR00T)を学習し比較検証をしてみたいと思います。
NVIDIA のチュートリアルについて
アームを使って遠心管(原文:vial、まあ試験管的なやつ)をラックにしまうタスクがチュートリアルとして用意されています。
実験環境構築(物理) -> データ収集 -> シミュレーション上での学習 -> 実機での検証の一通りのフローを試すことができて、アーム開発の流れを一通り体験することができます。
実機の実験環境を再現するための部品表(BOM)も用意されており、合計 $500 未満で同じワークスペースを組めます。
BOM表
ロボット(約 $300)
- SO-101(WowRobo package 3、オレンジ。リーダーアーム + グリッパカメラ付き)
ワークスペース(計 約 $130)
- Logitech C920(俯瞰カメラ、USB)
- ライトボックス用 白フォームボード 20×30 インチ × 5
- 3D プリント角部品 × 8(任意、テープで代用可)
- Neewer 調光 LED バー(CRI > 90、約 4000K)
- 黒 EVA フォームマット
- Anker 25W USB-C 充電器 + USB-C ケーブル 6 ft
小道具(計 約 $20)
- 遠心管(Falcon チューブ相当、50 ml、スクリューキャップ)× 1〜4
- 3D プリントの黄色ラック(Printables でモデル配布)
配置も細かく指定されており、俯瞰カメラは背面 40 cm の高さ・ロボット中心から 27 cm・下向き 45°、ライトボックスは約 30×20×20 インチ、ラックを左・遠心管を右に....とかなり細かく再現できるよう情報が公開されています
(そこまで頑張らないと実機では再現できない...?)
シミュレーション環境や学習スクリプトや学習データなども用意されており、スムーズに試すことができます。
ソフトウェア側
シミュレーション環境
- アーム・遠心管 3 本・ラック・マット・ライトボックスのシーン(USD)
- Isaac Lab のタスク環境として実装済み(
Lerobot-So101-Teleop-Vials-To-Rack-*)
評価スクリプト
- 「遠心管が垂直・ラックの中・手を離した」で成功とする判定
- ただし、傾いて寄りかかった状態も成功に数える緩さがある
データセット(Hugging Face の sreetz-nv/so101_teleop_vials_rack_left ほか)
- 人間テレオペ 75 本(sim)
- 実機 5 本を足した版
- Cosmos で水増しした版(7 本 / 70 本)
学習スクリプト
- GR00T N1.6 の後学習の手順と設定(バッチ 64、1 万 step)
- LeRobot v3 → v2 の変換込み
一方でシミュレーション上でもテレオペでデータを収集する前提であり、シミュレーション上でテレオペをせず0から学習用の合成データを作成するのは本記事での独自の取り組みとなります。
合成データについては別章で説明します。
まずテレオペデータからの学習(公式手順)を再現する
実行環境
公式の検証環境は RTX 5090 / RTX PRO 6000 のワークステーション + Docker ですが、今回は RunPod の L40S 48GB × 1(16 vCPU、RAM 188GB、ディスク 200GB)で検証しました。ベースイメージは nvidia/cuda:12.8.1-cudnn-devel-ubuntu24.04 です。
公式ではdocker/sim(Isaac Sim / Isaac Lab / テレオペ)と docker/real(GR00T 推論サーバ + 実機評価)の2つのコンテナに分けていますが、クラウドの制約上今回は Docker を使わずIsaac 側と GR00T 側で venv を分けています。
Isaac 側(Python 3.11)
| パッケージ | 版 |
|---|---|
| Isaac Sim | 5.1.0(pip) |
| Isaac Lab | v2.3.2(ソースから) |
| LeRobot | 0.4.3(コミット e670ac5) |
| torch | 2.7.0+cu128 |
GR00T 側(Python 3.12)
| パッケージ | 版 |
|---|---|
| Isaac-GR00T | コミット ead52833 |
| torch | 2.7.1+cu128 |
| flash-attn | 2.7.4.post1 |
その他のバージョン情報
基盤
| 項目 | 版 |
|---|---|
| NVIDIA ドライバ | 570.124.06 |
| CUDA | 12.8 |
| uv | 0.12 |
Isaac 側の付随パッケージ
| パッケージ | 版 |
|---|---|
| isaacsim | isaacsim[all,extscache] |
| isaaclab / isaaclab_tasks / isaaclab_mimic | 0.54.2 / 0.11.12 / 1.0.16 |
| torchvision / triton | 0.22.0 / 3.3.0 |
| numpy | 1.26 |
| gymnasium | 1.2.1 |
GR00T 側の付随パッケージ
| パッケージ | 版 |
|---|---|
| transformers | 4.51.3 |
同じデータで自分で後学習する
公式の75本(LeRobot v3 形式)を GR00T が読める v2 形式に変換し、カメラの対応を指定してから後学習します。Isaac-GR00T 側の venv で実行します。
cd /workspace/Isaac-GR00T
export HF_DATASET_REPO_ID=sreetz-nv/so101_teleop_vials_rack_left
export CONVERSION_ROOT=/workspace/datasets/conv
export DATASET_DIR=${CONVERSION_ROOT}/${HF_DATASET_REPO_ID}

# (1) LeRobot v3 -> v2 変換(GR00T 同梱スクリプト)
uv run --project scripts/lerobot_conversion python scripts/lerobot_conversion/convert_v3_to_v2.py \
    --repo-id "${HF_DATASET_REPO_ID}" --root "${CONVERSION_ROOT}"

# (2) modality.json をコピーし、カメラの対応を指定
#     front <- external_D455(俯瞰)、wrist <- ego(手首)
#     ※ コース本文はこれが逆になっている(後述)
cp examples/SO100/modality.json "${DATASET_DIR}/meta/"
sed -i \
  -e 's|"original_key": "observation.images.front"|"original_key": "observation.images.external_D455"|g' \
  -e 's|"original_key": "observation.images.wrist"|"original_key": "observation.images.ego"|g' \
  "${DATASET_DIR}/meta/modality.json"

# (3) 後学習(公式と同じ 1 万 step、実効バッチ 64)
export PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True
source .venv/bin/activate
python gr00t/experiment/launch_finetune.py \
    --base_model_path /workspace/models/nvidia/GR00T-N1.6-3B \
    --dataset_path "${DATASET_DIR}" \
    --modality_config_path examples/SO100/so100_config.py \
    --embodiment_tag NEW_EMBODIMENT \
    --num_gpus 1 \
    --output_dir /workspace/out_ft/so101_vials_rack_left_ftB \
    --max_steps 10000 --save_steps 5000 --save_total_limit 5 \
    --warmup_ratio 0.05 --weight_decay 1e-5 --learning_rate 1e-4 \
    --global_batch_size 32 --gradient_accumulation_steps 2 \
    --color_jitter_params brightness 0.3 contrast 0.4 saturation 0.5 hue 0.08 \
    --dataloader_num_workers 4
L40S1枚で9時間半(1万 step)でした。
つまずきどころ
- バッチサイズは慎重に。 公式どおり
--global_batch_size 64にすると、L40S(46GB)では逆伝播で OOM しました(43.8 / 44.4 GB で step 7 に落ちる)。32 × 勾配蓄積 2 で実効 64 にしています。注意点として、この GR00T のリファレンスではper_device_batch = global_batch_size // num_gpusで、蓄積回数で割ってくれません。--global_batch_sizeには「1 ステップ分」を渡す必要があります。PYTORCH_CUDA_ALLOC_CONF=expandable_segments:Trueも断片化対策として入れています(VRAM 40.5GB で安定)。 - ディスク容量に注意 デフォルト設定のディスク容量が少なかったこともあり、最後の学習checkpoint(22GB)保存時に落ちて最初からになってしまい時間とクラウド代が溶けました。
まあ当たり前と言えば当たり前なのですが、isaac環境でも容量を喰うのでゆとりのある容量があった方が安心です。
(都度不要なものを削除すれば200GB程度で足りる想定) - データ読み込みがボトルネック tqdm 上は 1.7 s/step ですが、shard のキャッシュ待ちで平均 3.3〜3.5 s/step になります。dataloader の worker を 16 に増やすと逆に遅くなり(5.5 s/step、同時デコードで詰まる)、4 が最良でした。
- カメラのマッピングについて公式に誤植があるかも GR00Tへの入力に
front(俯瞰から撮影したカメラ)とwrist(手首グリッパーについたカメラ)を与える必要があります。シミュレーション上ではegoカメラがグリッパについており、external_D455で俯瞰から撮影していますが、チュートリアル上の記載ではfrontがegoでwristにexternal_D455が指定されて逆になっています。その通りにやるとカメラのマッピングが誤ったまま学習することになってしまいます。筆者も気づかずに学習し10%の成功率で絶望することとなりました。(のちに気づいて安堵、修正後は結果に記載したとおり70%弱ほどの成功率)
(応用)合成データを作成する
先ほどは公式が用意したテレオペのデータで学習しましたが、いよいよ本題のシミュレーション上で0からデータを合成していきたいと思います。
学習データとして欲しいものは遠心管を掴んでラックにしまうためのアームの軌跡データであり、テレオペではなくシミュレーション上でスクリプトでアームを制御することで学習データを収集します。
今回はシミュレーション空間がしっかり用意されており、アーム・遠心管・ラックの座標を取得することができます。
そしてアームの実行計画を立ててそれをもとに各ステップのアームの目標座標を計算することはできます。
一方でアームの操作を行うには各関節のどれくらい回転させるかの制御に落とす必要があります。
ただ、目的座標さえわかれば逆運動学より各関節のモータの回転量を求めることができ、スクリプトで下記動作計画に沿ってアームを制御することができます。
ざっくりと下記のようなステップで計画をします
- アームを遠心管まで移動させる
- 遠心管を掴む
- 掴んだ遠心管をラック位置上まで移動させる
- 掴んだ遠心管を下げラックの穴に入れる
- 遠心管を離す
4は難所のためループで少しずつ移動させながら都度目標位置と現状の位置を再計算して細かく制御をするようにします。
座標はどうやって取るのか
Isaac Lab ではシーンに置く物がすべて名前付きで宣言されていて、名前で取り出すと位置や向きをそのまま読めます。現実なら画像認識やマーカーで推定するところが、プロパティを読むだけで誤差なく分かるのがシミュレーションの強みです。
robot = env.scene["robot"]       # アーム(SO-101)
vial  = env.scene["vial_2"]      # 遠心管
rack  = env.scene["rack_left"]   # ラック

vial.data.root_pos_w    # 遠心管の位置 (x, y, z) [m]、ワールド座標
vial.data.root_quat_w   # 遠心管の向き(クォータニオン)
※ 座標がとれても座標系の変換など少し面倒ではある(ワールド座標 -> ロボット根本座標など)
ただ、計算自体は標準機能で対応可能
動作計画どおりにアームを動かす
目標座標が分かっても、アームに渡せるのは本来「各関節の角度」です。そこで、手先の目標位置・向きを渡すと IK(逆運動学)が関節角に変換してくれるように、アームへの指令の形を差し替えています。
action = [x, y, z, qw, qx, qy, qz, jaw]   # 手先の目標位置・向き + 爪の開閉
env.step(action)   # IK で関節角に変換し、物理を 1 ステップ進める(アームが目標へ少し動く)
env.step() 1 回で進むのはほんの一瞬なので、目標を少しずつずらしながらループで繰り返してアームを動かします。例えば「遠心管の真上まで移動する」はこんなイメージです。
start  = 今の手先の位置
target = 遠心管の位置 + [0, 0, 0.06]      # 遠心管の 6cm 上

for i in range(60):                       # 60 ステップかけて移動
    p = start + (target - start) * (i + 1) / 60
    env.step([*p, *手先の向き, 爪を開く])
動作計画の 1〜5 は、このように「どこを目標に、何ステップかけて動くか」の組み合わせで書いています。
ラック・遠心管の位置をランダムに変えつつ上記動作計画でアームを動かすことでデータを量産していきます。
なお、これらの動作計画に沿ってアームを動かしても角度などによっては摩擦が足りず落としてしまったりするため、成功したもののみだけ学習データとして採用します。
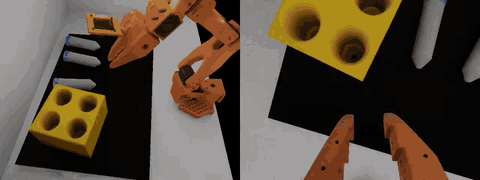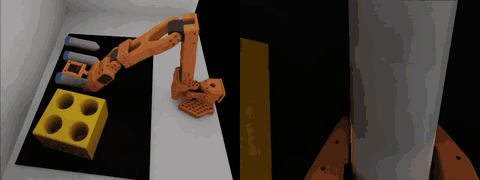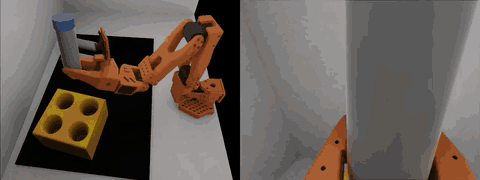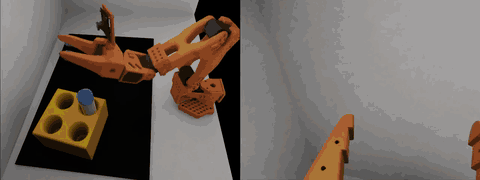
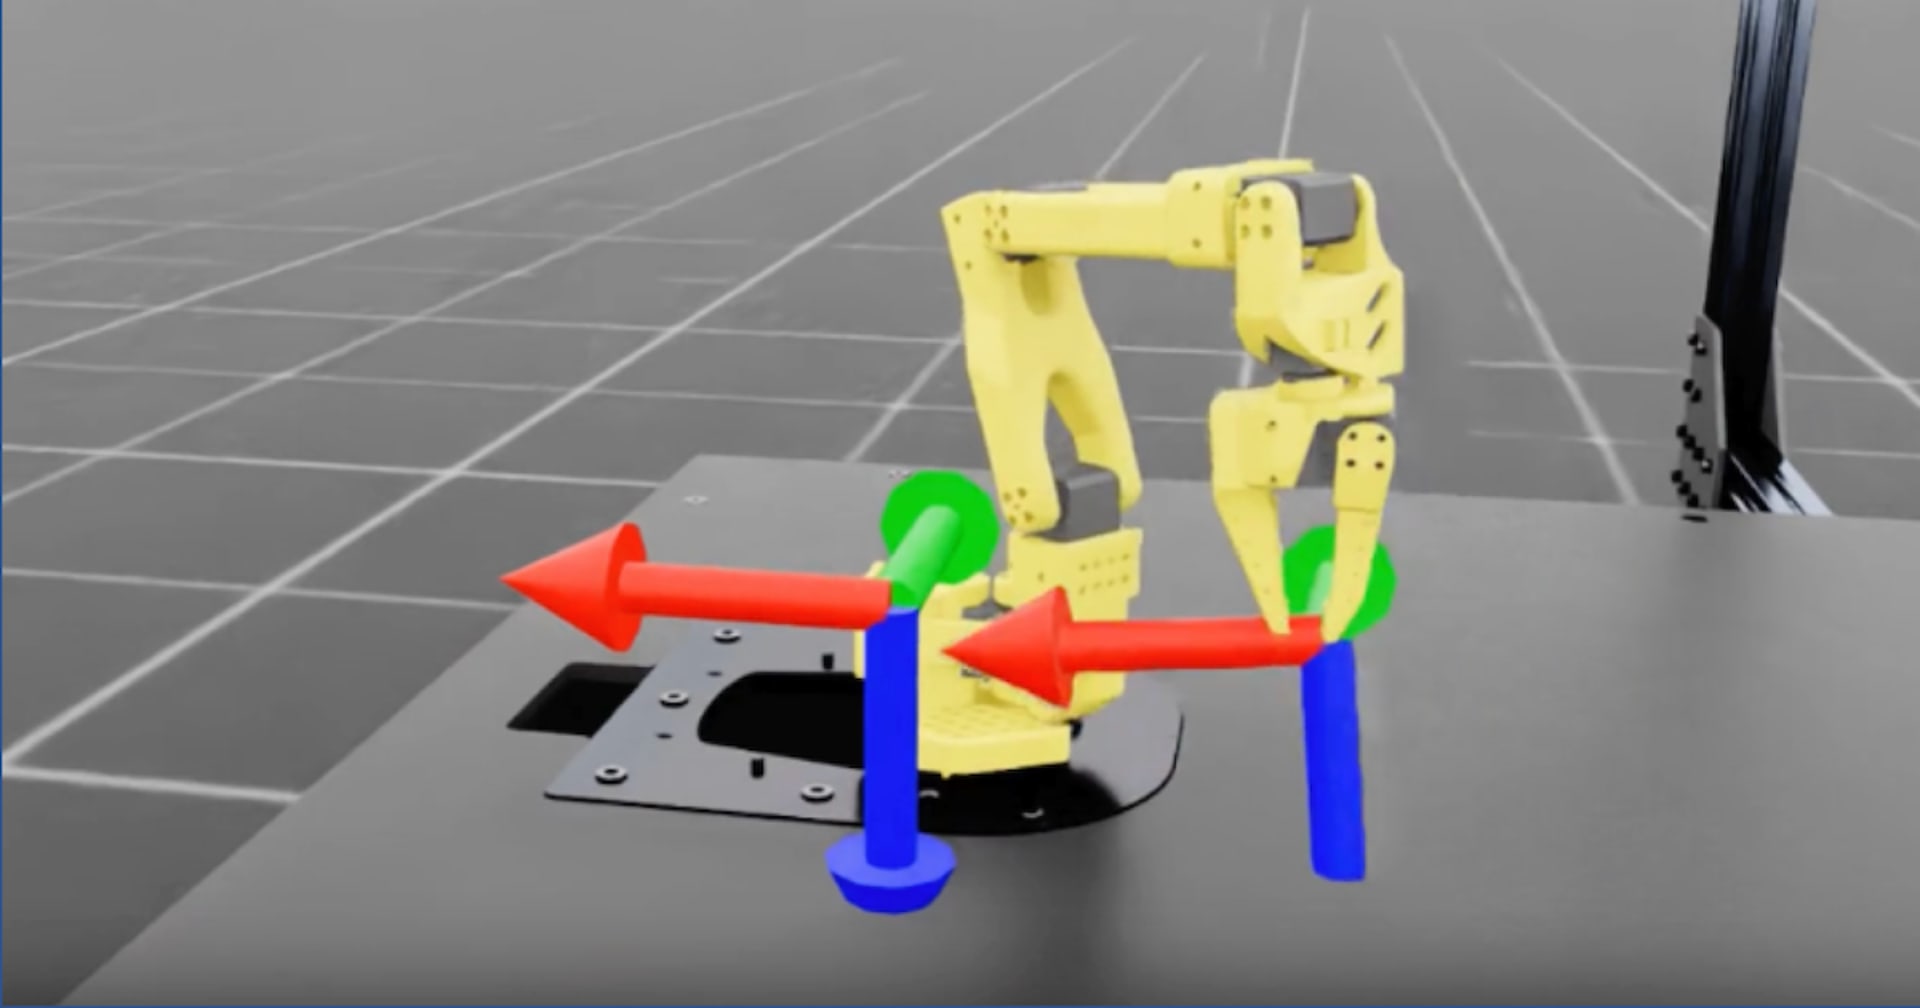
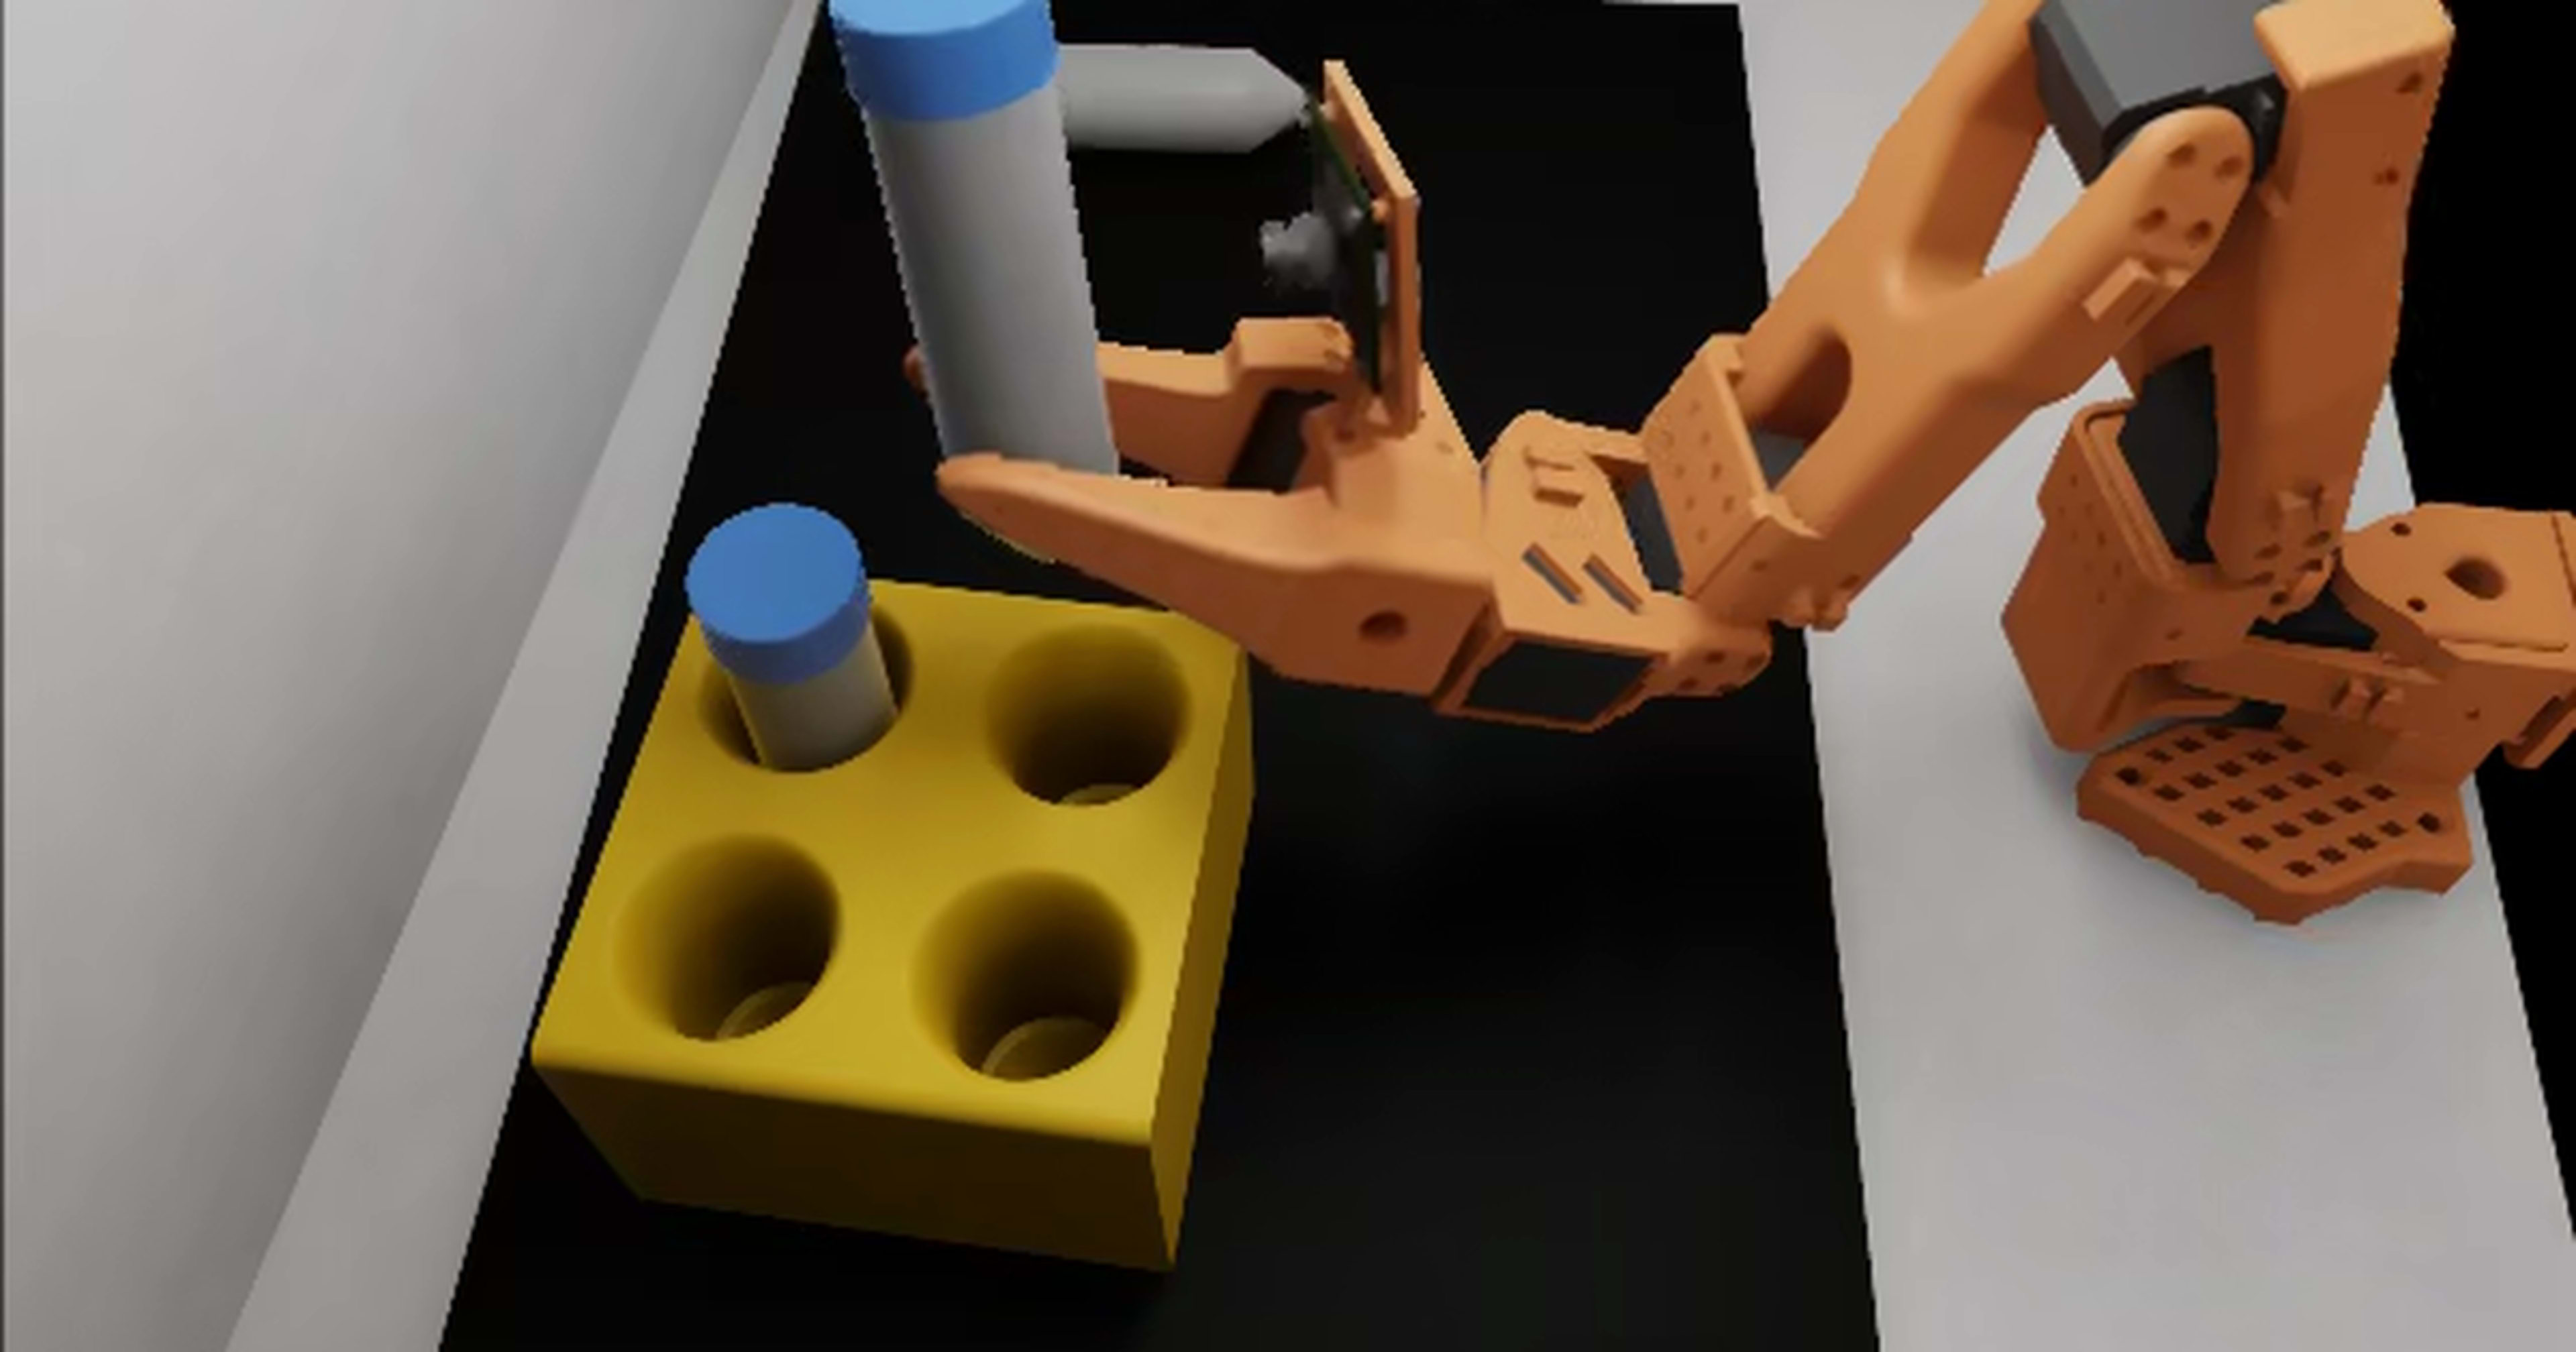
こちらが実際の動作計画をもとにアームを動かした学習用データになります。
4の微調整のところで過剰に振動してしまったり掴むところが先端すぎる気がしたりとツッコミどころはあるものの、とりあえずは遠心管をしっかり差し込めてます
結果
評価は全て公式の評価環境(Lerobot-So101-Teleop-Vials-To-Rack-Eval)で30エピソードで行いました。
比較の相手(基準線)は、公式データ(人間が sim 内でテレオペした 75 本)で自分が後学習した方策です。学習量を揃えるため 5,000 step 時点の値を使います。
| 学習データ | 本数 | step | 成功率 |
|---|---|---|---|
| 人間テレオペ(公式データ、自分で後学習) | 75 | 5,000 | 20/30(67%) |
| 動作計画で作った合成データ(人間 0 本) | 67 | 5,000 | 19/30 + 19/30 = 38/60(63%) |
人間のテレオペを 1 本も使わず、動作計画をもとにシミュレーション上で動作したアームデータだけで作った67本で、人間75 本とほぼ同じ成功率に届きました。
なお人間75本は10,000 stepまで学習しても21/30(70%)で、大きくは伸びませんでした。また人間側の 5,000 step は 10,000 step 学習の途中で保存したもの、合成データ側は 5,000 step で学習を終える設定なので、学習率の下がり方は同じではありません。
公式の成功判定は「傾いて寄りかかった状態」も成功に数えるので、「遠心管がスロットに垂直に着座した」という厳しめの判定でも数えました。合成データ側では60本中37本で着座しており、置き方の質は悪くありません。一方で「着座しているのに公式判定では不成功」も 60 本中 15 本ありました(公式判定が、離してから着座するまでの時間を短めにしか見ていないためです)。
動作計画からの学習データ作成から学習・評価まで L40S 1 枚で約7.6時間程度かかりました。
所感とまとめ
大抵合成データは本物のデータに敗北することが多いですが、今回はほぼ同点とかなり健闘しました。
実際シミュレーション上で生成したアーム動作模様も(少し変な挙動はあるものの)テレオペと遜色なく遠心管をしまえているので、そう考えると結果自体は納得です。
もちろんこの手法も万全ではなく、以下の条件が揃った場合のみ機能する想定です
- シミュレーション環境がしっかり構築されていること
→ アームの動作計画を立てる上では適切に3Dオブジェクトが配置されて座標が取得できる必要があります - 外的影響が少なく動作計画が立てられること
→ 今回は遠心管をつかめてさえしまえばあとは目標座標までアームを移動させて離すだけなのでよかったものの、極端な話対象が不規則に動いているとかだと動作計画が立てられなくてアウトです。
(不規則な動きもシミュレーションできるのならできなくはないですが、単純な座標計算ではなくなるので複雑にはなります)
加えて今回はシミュレーション上での検証なので、「結局実機でも使えるの!?」の疑問にはまだ答えられていません。
せっかく公式も部品表や3Dプリンタのデータも用意してくれているのでいずれ実機でも検証したいと思います。
(....が準備が大変。そこがフィジカルAIの大変なところではありますね)