OpenCode、pi、DeepSeek Harness を同じモデルにつないで、モデル非依存のコーディングエージェントハーネスの違いを比べてみる

はじめに
こんにちは、クラスメソッド製造ビジネステクノロジー部の嶋田です。
2026 年 8 月に DeepSeek が DeepSeek Harness を公開しました。
モデルを差し替えられるコーディングエージェントは以前からいくつもあり、モデルの会社が出したものにも Codex CLI があります。
この記事では、いちばん使われている OpenCode、私が普段使っている pi、いちばん新しい DeepSeek Harness の 3 つを取り上げます。
普段 pi を使っていながら、残りの 2 つが何をどう変えたものなのか、そもそもこの 3 つは Claude Code や Codex CLI と何が違うのかを、きちんと理解しておきたかったからです。
まず 3 つの成り立ちと設計の違いを整理します。
次に「Claude や OpenAI のモデルをこれらに載せるとどうなるのか」を、知っておくとよい経緯 2 つと、モデルとハーネスの相性という理屈 1 つに分けて書きます。
最後に、3 つを同じモデルにつないで同じ課題を解かせ、動き方の違いを見ます。
記事内の情報は 2026 年 9 月 14 日時点のものです。
確認したバージョンは OpenCode 1.18.30、pi 0.85.1、DeepSeek Harness 0.1.5-rc.1 です。
DeepSeek Harness は developer preview で、互換性を壊す変更があると README に明記されています。
ハーネスとは何か
ハーネスは、モデル本体の外側にある層の総称です。
ツールの定義、system prompt、コンテキストの管理、セッションの保存、権限、サンドボックスが含まれます。
DeepSeek Harness の設計文書は、これを "Agent = Model + Harness" と書いています。
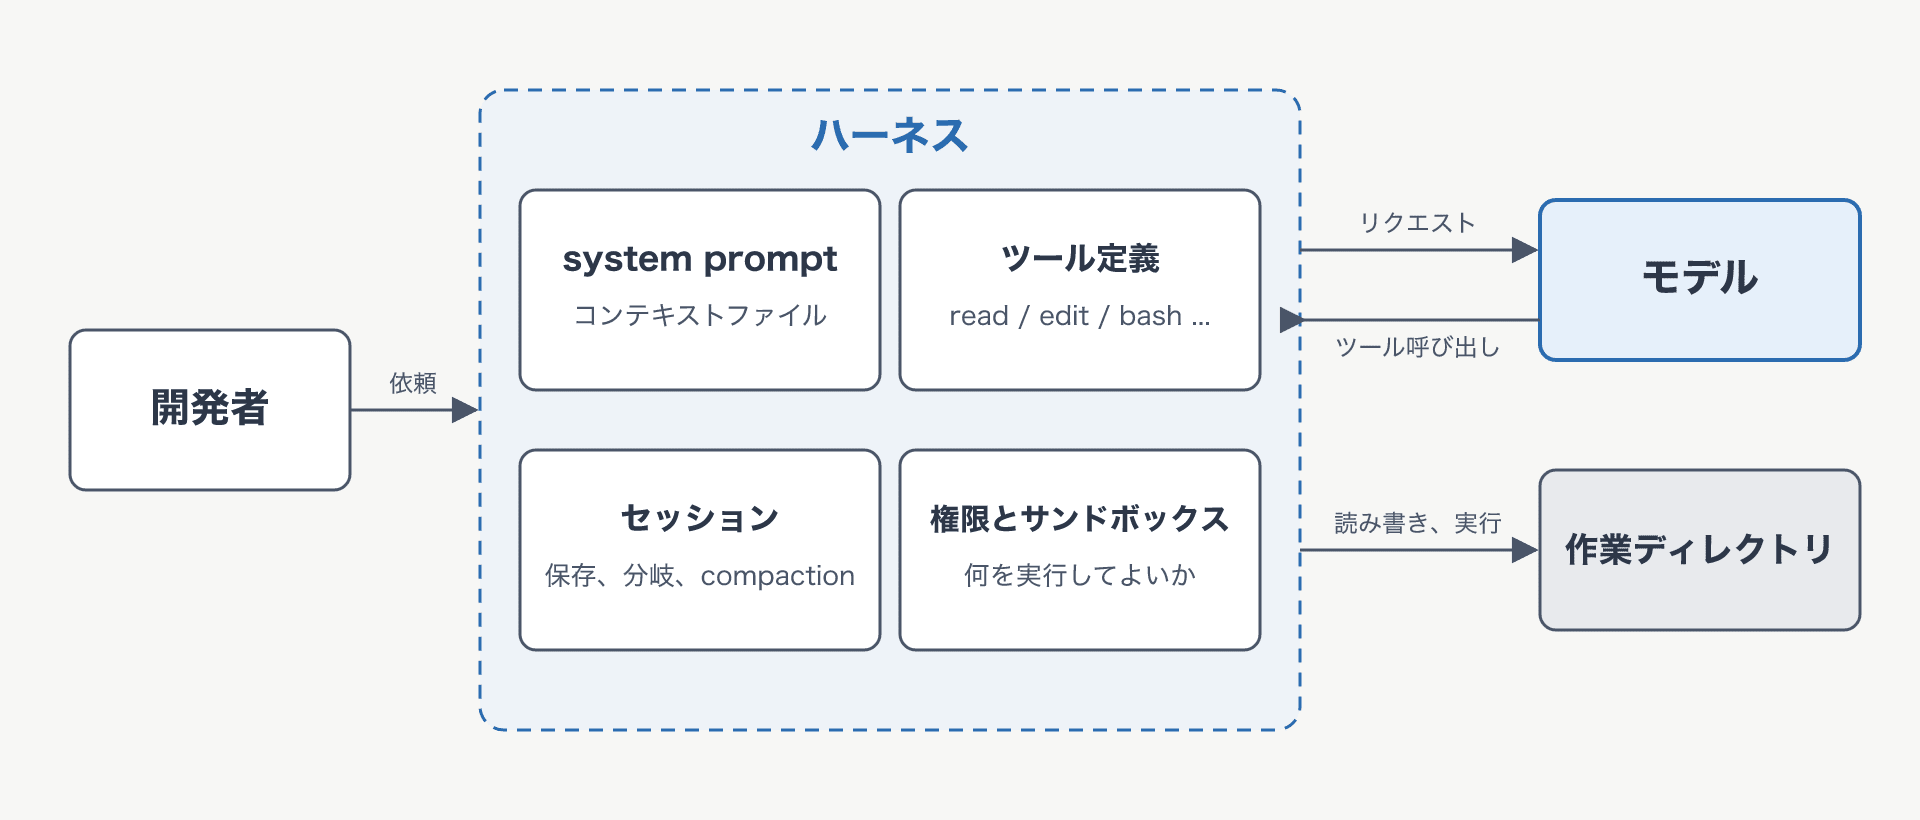
ハーネスはモデルの外側にあり、モデルとの往復と作業ディレクトリへの読み書きを仲介する
Claude Code や Codex CLI は、モデルの会社が自社モデルのために作ったハーネスです。
この記事で扱う 3 つは、特定のモデルを前提にせずに作られたハーネスです。
どちらも同じ構造で、Codex CLI のように設定で他社のモデルを指せるものもありますが、モデルとハーネスを同じ会社が同時に設計しているかどうかが違います。
この違いが後半の話の前提になります。
3 つの成り立ちと設計
| OpenCode | pi | DeepSeek Harness (dsh) |
|
|---|---|---|---|
| 作者 | Anomaly Innovations | Mario Zechner | DeepSeek |
| 公開 | 2025 年 | 2025 年 | 2026 年 8 月 13 日 (developer preview) |
| ライセンス | MIT | MIT | MIT |
| 設計方針 | 全部入り | 最小限 | 全部プラグイン |
| 既定ツール | bash、edit、write、read、grep、glob、lsp、apply_patch、skill、todowrite、webfetch、websearch、question | read、write、edit、bash | bash、read、write、edit、glob、grep、str_replace_editor、skill、todo、subagent、web ほか |
| 省いたもの | 特になし | MCP、サブエージェント、plan mode、権限ポップアップ、TODO、background bash | 固定の workflow |
| 拡張のしかた | plugins、MCP、agents、skills | TypeScript の extension、Skills、prompt template、theme | Cordis 上のプラグイン差し替え |
| セッション | client/server。TUI、desktop、IDE で共有 | JSONL のツリー。分岐と巻き戻し | 追記ログ。resume、fork、search、replay |
| 非対話実行 | opencode run |
pi -p |
dsh --profile headless |
OpenCode は Claude Code の OSS 版を目指した全部入り
OpenCode は SST の開発元である Anomaly Innovations が作っている、Claude Code と同じ使い勝手を目指したハーネスです。
LSP の自動読み込み、MCP、複数エージェント、プラグインを最初から持っています。
1 つのサーバプロセスが TUI、デスクトップアプリ、IDE 拡張を駆動する client/server 構成なので、opencode serve で常駐させて別のクライアントからつなぐこともできます。
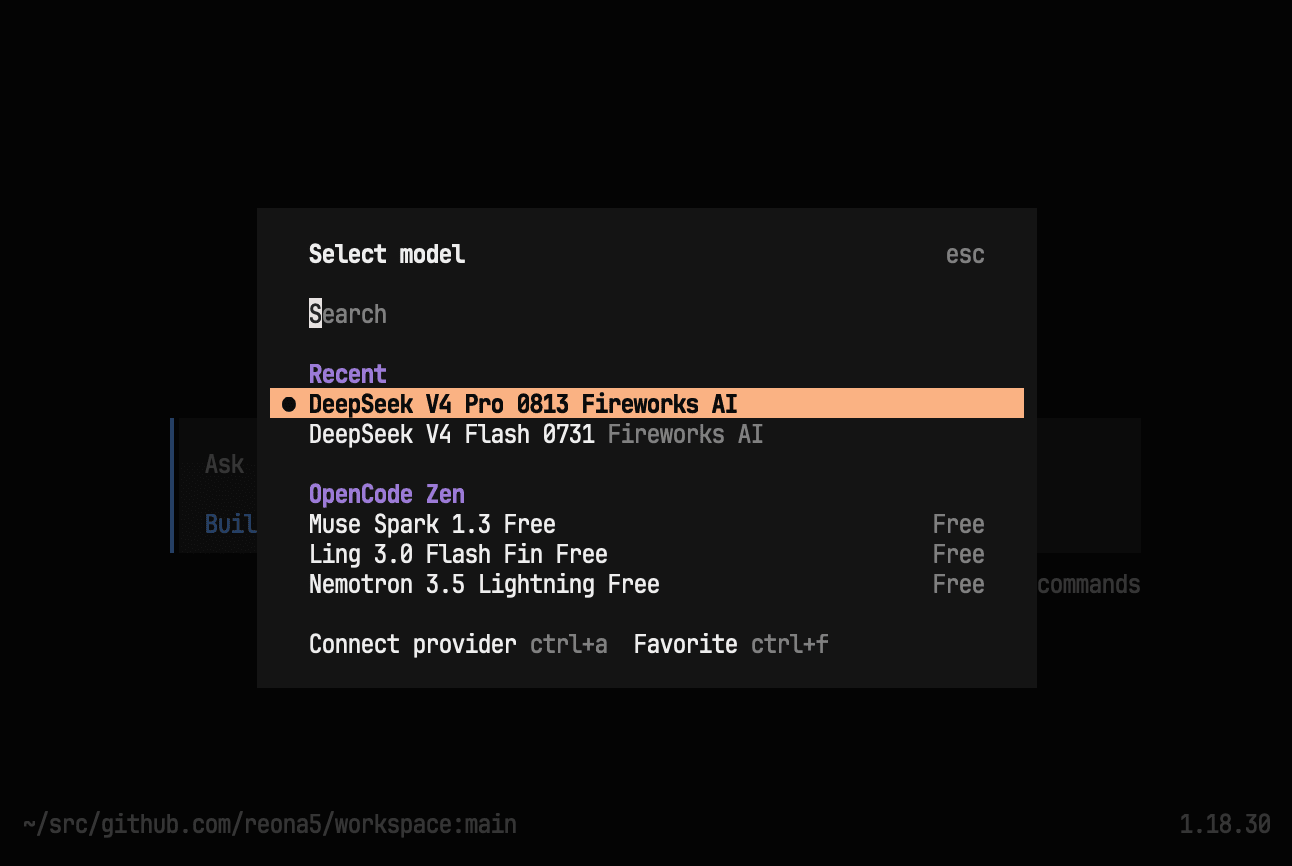
OpenCode の TUI。プロバイダを足すとモデル選択にそのまま並ぶ
OpenCode を Go 製と書いている記事を見かけますが、これは経緯の混同です。
元になった Go 実装は Charm に移って Crush という別の名前になり、現在の OpenCode は TypeScript で書き直されたものです。
課金面では、モデルを従量で使う Zen、Claude を API 課金のゲートウェイ経由で使う Black、open-weight モデル専用の Go という 3 つの有料プランがあります。
この構成になった理由は次の節で書きます。
pi は 4 つのツールだけを持つ最小限のハーネス
pi は libGDX の作者として知られる Mario Zechner が作っているハーネスです。
既定のツールは read、write、edit、bash の 4 つで、system prompt も短く保たれています。
pi は MCP、サブエージェント、plan mode、権限ポップアップ、TODO、background bash を意図的に持ちません。
README には省いた理由がそれぞれ書かれていて、MCP は CLI ツールか extension で、サブエージェントは tmux か extension で、権限はコンテナで代替する、という立場です。
足りないものは TypeScript の extension で足す設計で、実際に pi の周辺には MCP アダプタ、サブエージェント、権限制御の extension がパッケージとして公開されています。
セッションは JSONL のツリーで保存され、任意の時点から分岐して続きを試せます。
compaction も履歴を消さずに行い、元の分岐に戻れます。
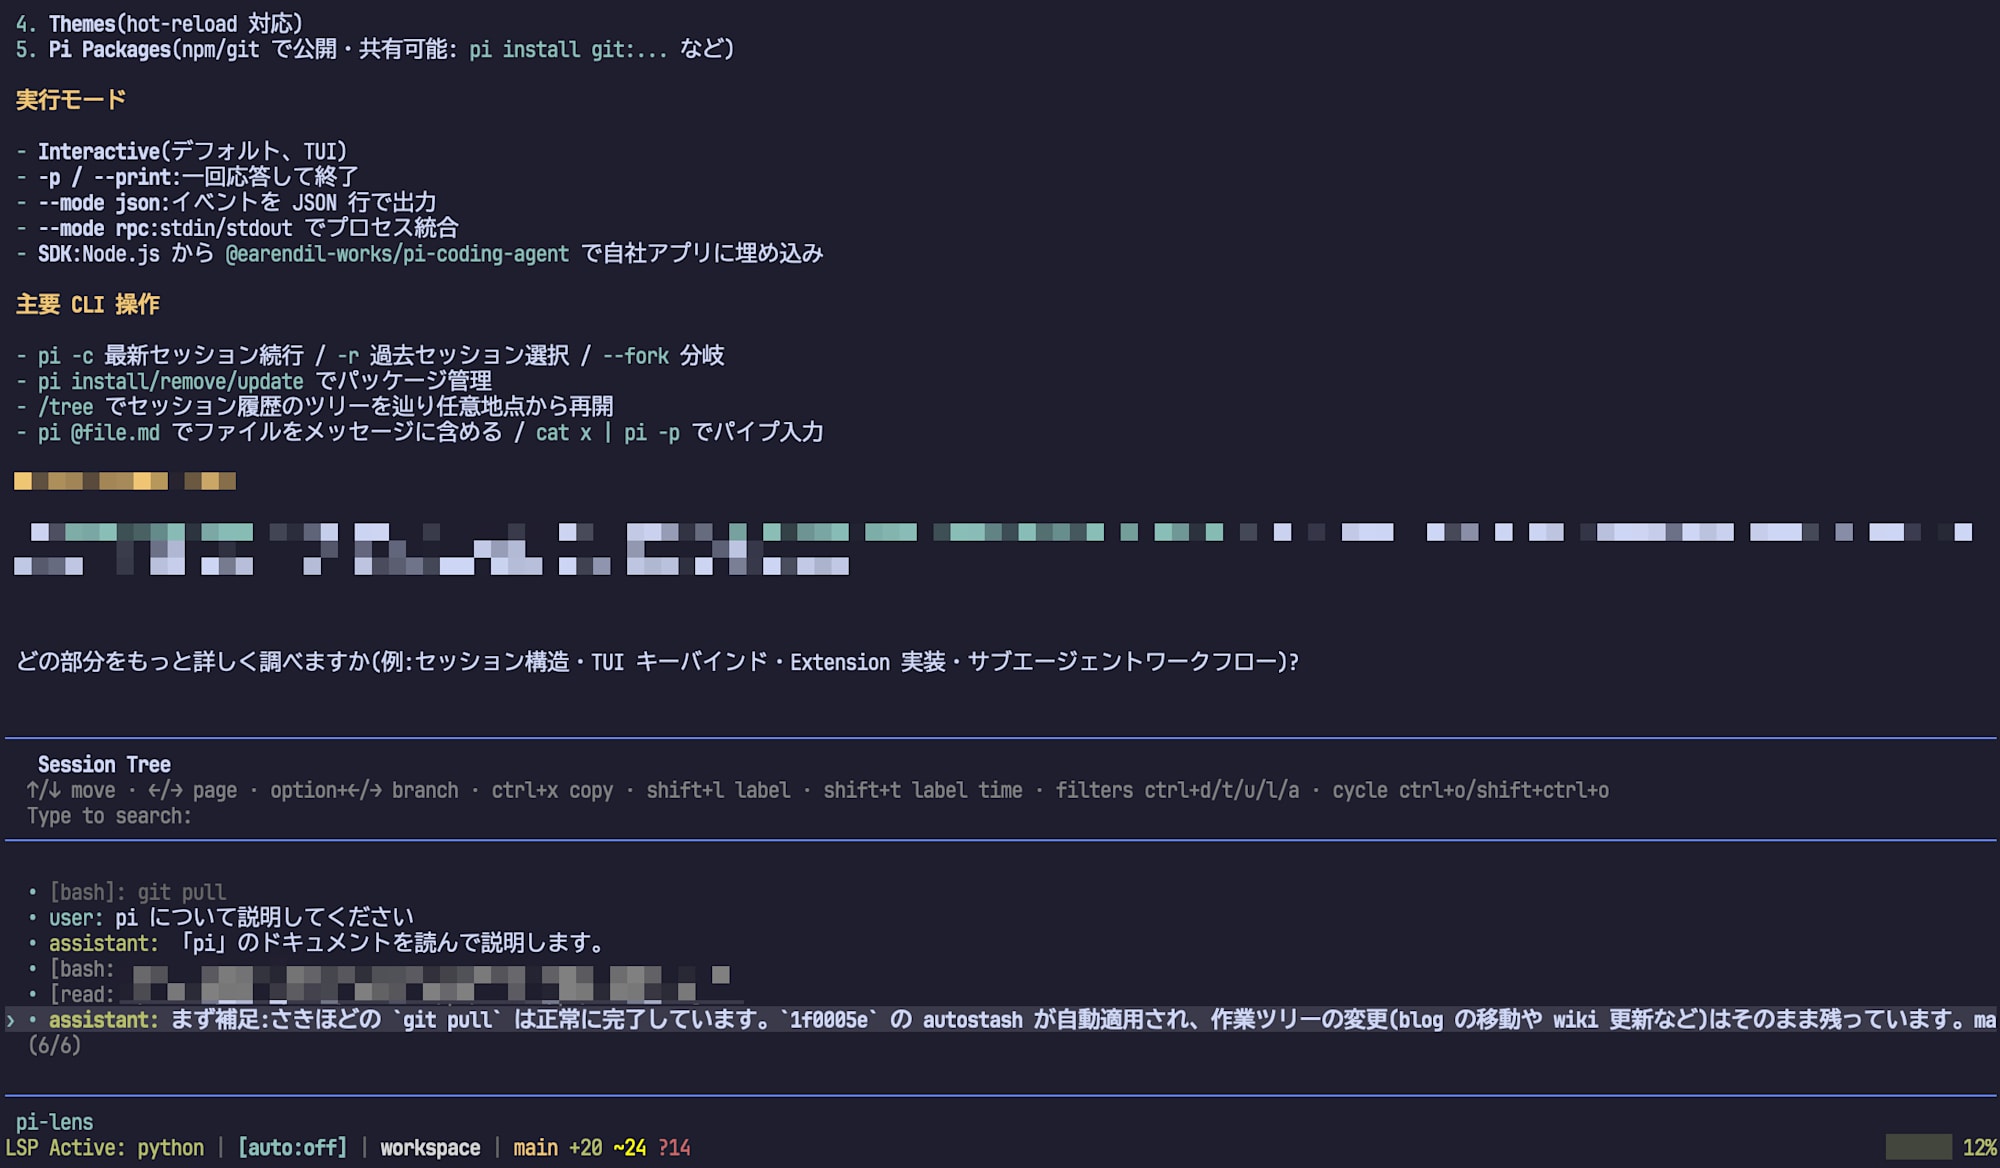
pi の /tree。分岐した枝を選び直して続きを試せる
DeepSeek Harness はモデルの会社が出したモデル非依存のハーネス
DeepSeek Harness は DeepSeek が 2026 年 8 月 13 日に MIT ライセンスで公開したハーネスで、コマンド名は dsh です。
Cordis という依存性注入のフレームワークの上で、モデルのアダプタ、ツールの登録、セッション、エージェントループ、サンドボックス、UI までを全部プラグインとして扱います。
手元に入れた 0.1.5-rc.1 では、@deepseek-ai スコープに 300 を超えるパッケージが同梱されていました。
調べて意外だったのは、DeepSeek Harness のマルチプロバイダ層が pi のパッケージだという点です。
dsh-llm-pi-ai というプラグインが pi のリポジトリの @earendil-works/pi-ai に依存していて、OpenAI 互換や Anthropic 互換のエンドポイントへの接続はそこで処理されます。
DeepSeek 自身のモデルには別の専用アダプタがあります。
もう 1 つ、Claude Code と Codex の hooks.json をそれぞれ読み込むプラグインが同梱されています。
既存のハーネス向けに書いた設定資産を持ち込める余地が、最初から用意されているということです。
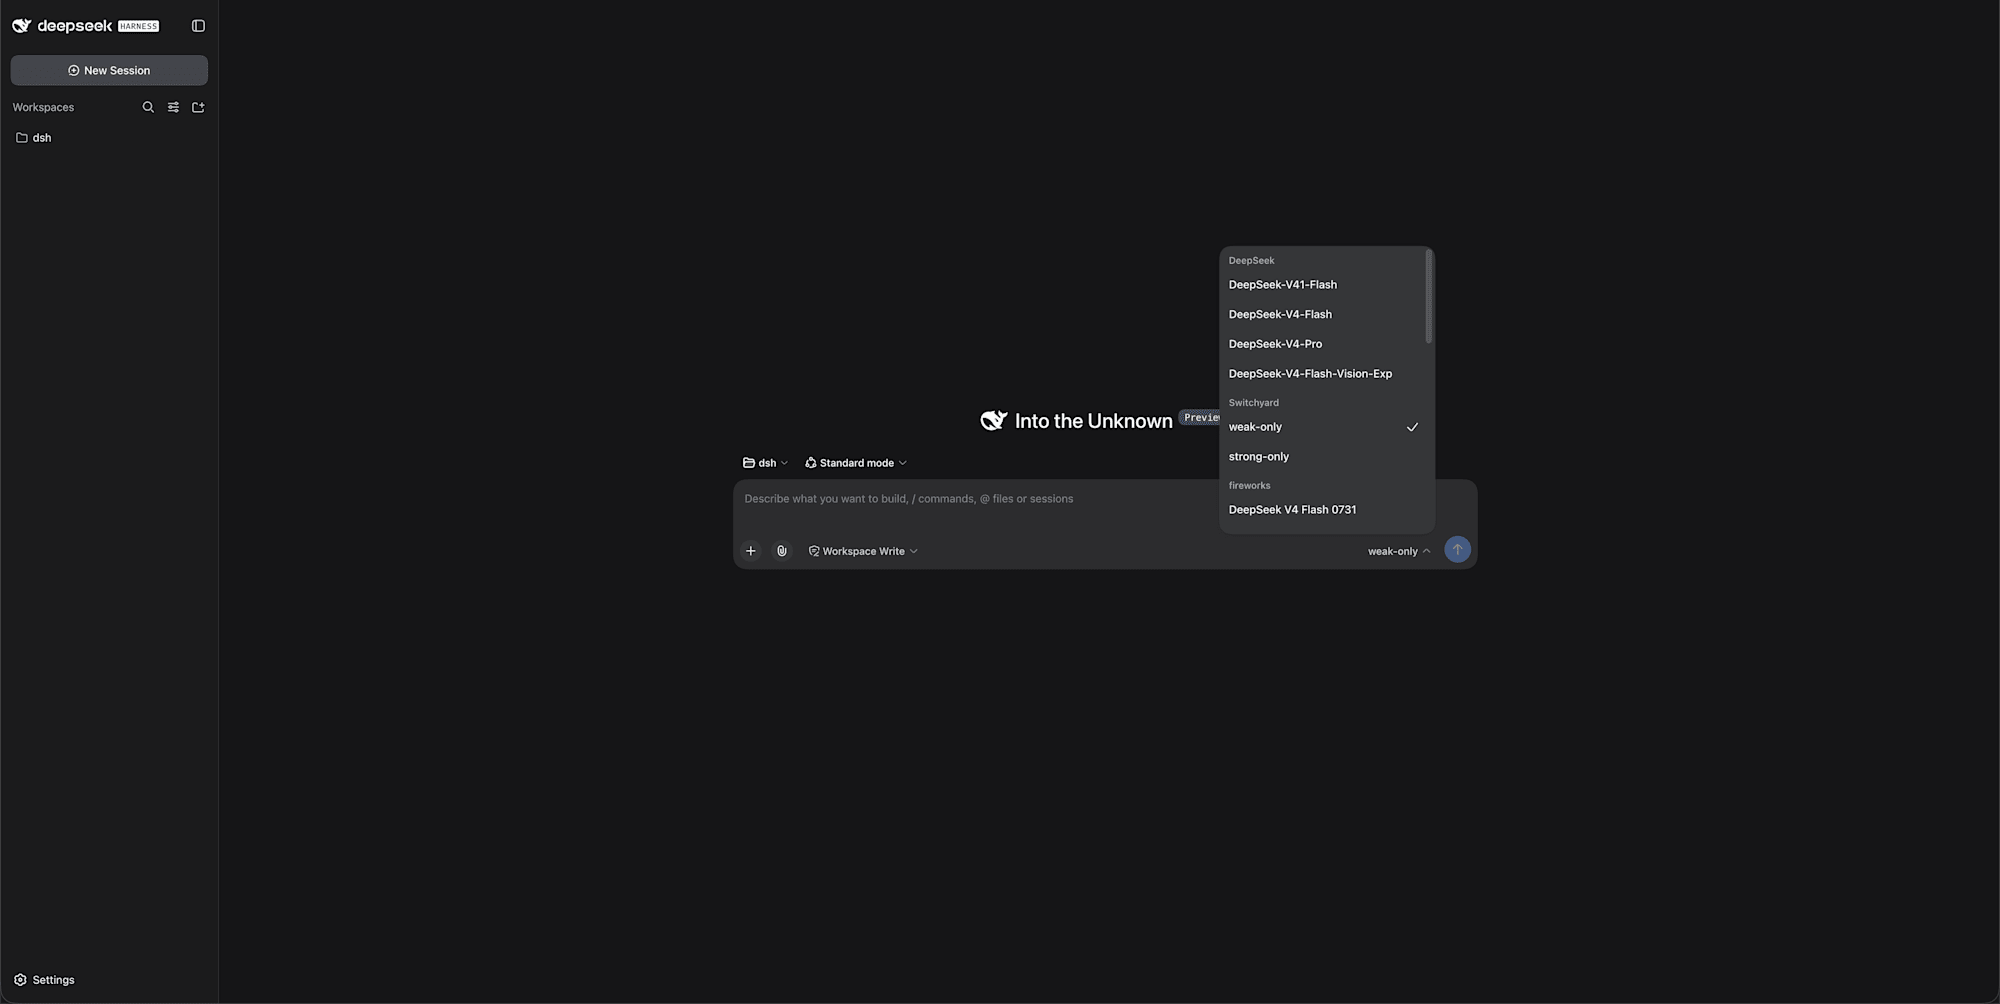
dsh の Web UI。プロバイダを追加すると、OpenCode や pi と同じようにモデルを選べる
Claude や OpenAI のモデルを載せるとどうなるか
「これらのハーネスに Claude や OpenAI のモデルを載せるのは適切ではない」という言い方を見かけます。
調べてみると、この一言には性質の違う話が混ざっていました。
1 つは、Anthropic と OpenAI がそれぞれ下した判断の経緯です。
もう 1 つはモデルとハーネスの相性という理屈で、こちらはハーネスを選ぶときの根拠になります。
順に書きます。
Anthropic はサブスクリプションの流用を規約で塞いだ
2026 年 1 月 9 日、Anthropic は Claude Pro や Max のサブスクリプションで発行される OAuth トークンを、第三者ツールから使う経路をサーバ側で遮断しました。
OpenCode、Cline、Roo Code の利用者が影響を受けました。
2 月には Claude Code の Legal and compliance のドキュメントが、第三者の開発者は Claude Console 発行の API キーを使うこと、Free、Pro、Max プランの認証情報でユーザーの代わりにリクエストを流してはならないことを明記する形に改定されました。
4 月 4 日には、サブスクリプションの利用枠そのものが第三者ハーネスに使えなくなりました。
Anthropic 側が挙げた理由は、定額プランの計算資源を従量課金を通さずに自律ループで消費していたこと、Claude Code のクライアントを名乗るヘッダを送って認証を通していたこと、それに伴う技術的な不安定さです。
ここで区別しておきたいのは、禁じられたのはサブスクリプション経由の利用であって、Claude そのものではないことです。
API キーで従量課金する経路は今も使えます。
OpenCode Black は、API 課金のゲートウェイ経由で Claude を売っている商品です。
つまり、これらのハーネスで Claude は「使えない」のではなく「定額では使えないので割高になる」が正確です。
OpenAI は第三者ハーネスからの利用を認めた
OpenAI は逆の方向に動きました。
OpenAI 幹部の Tibo Sottiaux と Sam Altman が、ChatGPT Plus 以上のサブスクリプションを pi や OpenCode などの第三者ハーネスから使ってよいと公言しています。
Sottiaux は、pi と OpenCode がそれぞれ Codex トラフィックの 5% ずつを占めるとも述べています。
利用規約に明示の許可が書かれているわけではありませんが、経営側の発言としては認める方向です。
したがって、Claude と OpenAI をまとめて「第三者ハーネスに載せるべきではない」と書くと事実と合いません。
規約の話は Anthropic に限った話です。
モデルとハーネスの相性はベンチマークの差になって現れる
経緯とは別に、ハーネスを選ぶときの根拠になる理屈があります。
モデルの性能は、モデル単体ではなく、モデルとハーネスの組で決まるという話です。
各社のモデルは自社ハーネスの上で事後学習されていて、ツールの語彙が重みに焼き付いている、という説明を見かけます。
分かりやすいのがファイル編集のツールです。
Codex CLI は apply_patch という patch 形式で編集し、Claude Code は Edit ツールに old_string と new_string を渡す文字列置換で編集します。
認識するコンテキストファイルの名前も、CLAUDE.md と AGENTS.md で違います。
慣れない形式のツールを渡されたモデルは、推論に使うトークンが増え、間違いも増える、というのがこの説明の中身です。
同じモデル、同じベンチマークでハーネスだけを変えた公開データがあります。
Terminal-Bench はターミナル上の多段タスクを解かせるベンチマークで、2.1 までは運営が比較の基準にしている参照実装のエージェント Terminus 2 のスコアも公開していました。
| 条件 | Terminal-Bench 2.1 |
|---|---|
| Claude Opus 4.6 + Claude Code | 70.1% |
| Claude Opus 4.6 + Terminus 2 | 63.8% |
同じモデルでも、純正のハーネスと汎用のハーネスで 6 ポイントの差が出ています。
Terminal-Bench は 2026 年 9 月時点で 4.0 が最新ですが、3.0 以降は各モデルを 1 つのハーネスで走らせた結果だけが並び、同じモデルをハーネス違いで比べた行がありません。
同じモデルで Claude Code と Terminus 2 が並ぶ最後の版が 2.1 なので、ここでは 2.1 の数字を使っています。
arXiv の Harness-Bench も、複数のモデルとハーネスの組み合わせで 5,194 本の実行を取り、モデルとハーネスの組ごとに完了率も失敗のしかたも大きく変わると結論しています。
ただし「事後学習が原因で差が出る」という因果関係は、公開されている範囲では推論です。
差があることは測られていますが、原因を切り分けた実験は見つけられませんでした。
ここから言えるのは 2 つです。
Claude や GPT をラボ純正でないハーネスに載せると性能は組み合わせごとに変わるので、測り直す必要があります。
そして、専用ハーネスを持たないか、持っていても囲い込んでいない open-weight のモデル (GLM、Kimi、DeepSeek、Qwen) は、モデル非依存のハーネスと無理なく組み合わせられます。
OpenCode Go が open-weight モデル専用のプランとして出てきたのは、この状況の表れだと考えています。
類似ツールをどう分類するか
同じ枠に入りそうなツールを、モデルとの結びつきで分けるとこうなります。
- モデルの会社が自社モデル向けに作ったもの:Claude Code、Codex CLI、Gemini CLI、Copilot CLI。モデルと同時に設計される側です。Codex CLI と Gemini CLI はソースが公開されていて、Codex CLI は設定で他社のエンドポイントも指定できますが、設計の起点は自社モデルです。
- モデルを差し替えられるターミナル向けの OSS:OpenCode、pi、Crush、Aider、Goose。この記事の主題です。
- IDE 拡張:Cline、Roo Code、Kilo Code、Cursor。1 月の遮断で OpenCode と同じ影響を受けました。
- 常駐して自律的に動くもの:OpenHands、OpenClaw、Hermes。Slack などから依頼を受けて動く用途です。
DeepSeek Harness は 1 つ目と 2 つ目の中間にいます。
モデルの会社が出したものですが、他社モデルへの接続を担う層が pi のパッケージで、自社モデルのアダプタはその横に別に置かれています。
ツールやセッションまでプラグインとして差し替えられる点も、2 つ目の側の性質です。
自社モデルの API を値上げした同じ週にハーネスを無料で公開したことも含めて、ハーネスを囲い込む Anthropic と、開く DeepSeek と OpenAI の対比として見ると位置が分かりやすくなります。
同じモデルにつないで同じ課題を解かせる
設計の違いが動き方にどう出るかを見るために、3 つを同じモデルにつなぎ、同じ課題を非対話モードで解かせました。
接続先
モデルの入口は、手元の Docker コンテナで動かしている NeMo Switchyard の OpenAI 互換エンドポイントにしました。
Switchyard の weak-only というルートを 3 つから同じように指定し、実体はセッションログの responseModel から Fireworks AI の DeepSeek V4 Flash (0731) であることを確認しています。
モデルが同じなので、差が出ればそれはハーネス側の差です。
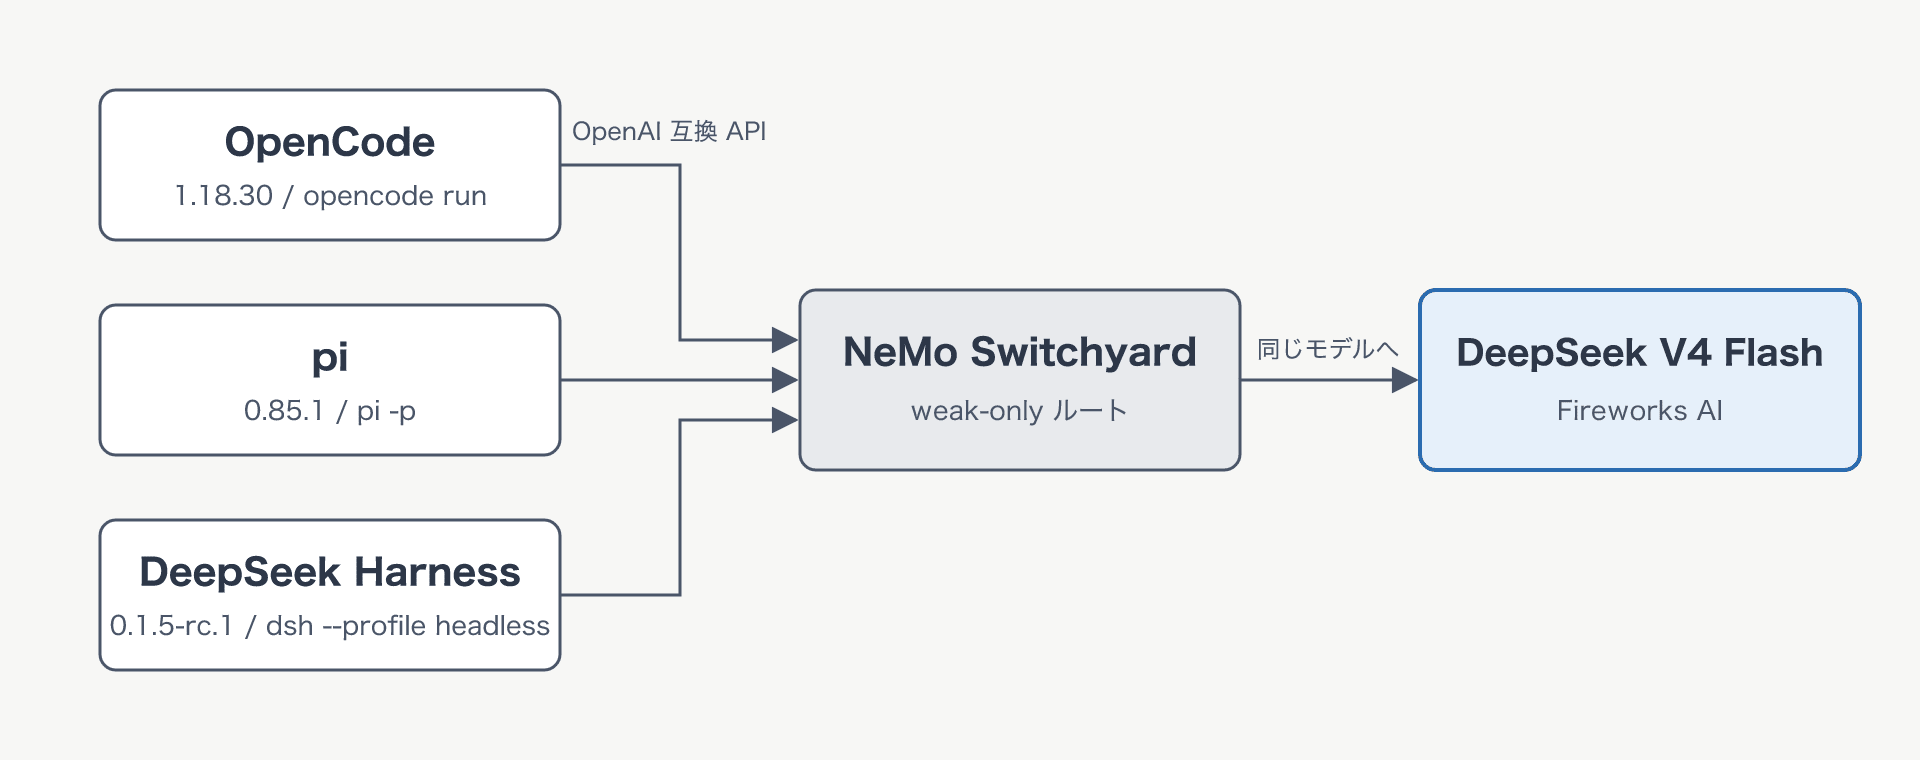
3 つとも同じ Switchyard のルートにつなぎ、実体を同じモデルにそろえる
3 つとも OpenAI 互換エンドポイントの登録は設定ファイル 1 つで済みます。
書式はそれぞれ違います。
OpenCode はプロジェクト直下の opencode.json に書きます。
Chat Completions 形式のエンドポイントには @ai-sdk/openai-compatible を指定します。
{
  "$schema": "https://opencode.ai/config.json",
  "provider": {
    "switchyard": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Switchyard",
      "options": {
        "baseURL": "http://127.0.0.1:4100/v1",
        "apiKey": "{env:SWITCHYARD_API_KEY}"
      },
      "models": {
        "weak-only": { "name": "weak-only", "limit": { "context": 262144, "output": 16384 } }
      }
    }
  },
  "model": "switchyard/weak-only"
}
pi は ~/.pi/agent/models.json に書きます。
{
  "providers": {
    "switchyard": {
      "baseUrl": "http://127.0.0.1:4100/v1",
      "api": "openai-completions",
      "apiKey": "$SWITCHYARD_API_KEY",
      "models": [
        { "id": "weak-only", "input": ["text"], "contextWindow": 262144, "maxOutputTokens": 16384 }
      ]
    }
  }
}
DeepSeek Harness は ~/.dsh/settings.yaml (置き場所は DSH_HOME で変えられます) に、プラグイン ID をキーにして書きます。
api: openai-completions という指定の名前が pi と同じなのは、前述のとおり中身が pi のパッケージだからです。
llm-pi-ai:
  providers:
    switchyard:
      apiKeyEnv: SWITCHYARD_API_KEY
      api: openai-completions
      baseURL: http://127.0.0.1:4100/v1
      models:
        - id: weak-only
          contextWindow: 262144
          maxTokens: 16384
          input: [text]
agent-default-model:
  provider: switchyard
  model: weak-only
session-telemetry-otel:
  mode: DISABLED
課題
課題は小さな Python の CLI の修正にしました。
テキストファイルの単語頻度を数えるスクリプトに、句読点が単語にくっつく、大文字と小文字を別に数える、という 2 つの問題を仕込んであります。
wordfreq.py には 2 つの問題があります。単語の前後の句読点が単語の一部として数えられること、大文字と小文字が別の単語として数えられることです。
次を行ってください。
1. count_words を修正し、句読点を除いて大文字小文字を区別せずに数えるようにする
2. `--top N` オプションを追加し、上位 N 件だけ表示できるようにする
3. pytest のテストを tests/test_wordfreq.py に追加する(修正した 2 点と --top の 3 ケース以上)
4. pytest を実行して全件成功することを確認する
作業が終わったら、変更したファイルと確認結果を短く報告してください。
同じ内容のディレクトリを 3 つ用意し、それぞれの非対話モードでこの文面を渡しました。
opencode run --pure --format json -m switchyard/weak-only "$(cat TASK.md)"
pi -p --mode json --no-extensions --no-skills "$(cat TASK.md)"
dsh --profile headless "$(cat TASK.md)"
OpenCode の --pure と pi の --no-extensions は、外部プラグインを切って素のハーネスで比べるための指定です。
DeepSeek Harness の headless プロファイルは、既定の workspace-write モード (作業ディレクトリ内の書き込みだけ許可) のまま動かしています。
結果
3 つとも課題を最後まで進め、変更ファイルと確認結果を報告して終了しました。
| OpenCode | pi | DeepSeek Harness | |
|---|---|---|---|
| 所要時間 | 68 秒 | 45 秒 | 71 秒 |
| モデルへのリクエスト回数 | 19 | 6 | 13 |
| ツール呼び出し | 19 回 (bash 7、edit 7、read 2、write 2、glob 1) | 7 回 (read 3、bash 2、write 2) | 14 回 (bash 5、read 4、edit 3、write 2) |
| 最初のリクエストの入力トークン | 8,084 | 1,744 | 7,626 |
| 入力トークン合計 (キャッシュ読み込み込み) | 238,856 | 19,899 | 148,638 |
| 出力トークン合計 | 4,617 | 2,007 | 4,277 |
| 追加したテスト | 8 件 | 6 件 | 8 件 |
| 報告した pytest 結果 | 8 passed | 6 passed | 8 passed |
成果物は 3 つとも動きます。
報告と実際の結果も一致していました。
ただ、数字には差があります。
最初のリクエストの大きさは、そのまま system prompt とツール定義の大きさです。
課題の文面はどれも同じなので、OpenCode の 8,084 トークンと pi の 1,744 トークンの差は、ハーネスがモデルに渡している前置きの差です。
DeepSeek Harness は OpenCode に近い量でした。
この差はリクエストのたびに積み上がるので、合計の入力トークンでは OpenCode が pi の 12 倍ほどになっています。
プロンプトキャッシュが使える経路なら料金への影響は小さくなりますが、ローカルモデルで動かすなら毎回の prefill 時間にそのまま加わります。
使い分けの目安
3 つを触った範囲での目安です。
- OpenCode:Claude Code の操作感のまま、モデルだけ差し替えたいとき。LSP、MCP、IDE 連携を最初から使えます。代わりに 1 リクエストあたりの前置きは大きく、ローカルモデルではその重さが見えます。
- pi:前置きを小さく保ちたいとき、ハーネスの中身を自分で把握したいとき。足りない機能は extension で足す前提なので、最初に自分で選ぶ手間がかかります。最小限の構成から自分で足していく形になるので、私はこれをいちばん使っています。
- DeepSeek Harness:ツール、セッション、サンドボックスの単位で入れ替えて実験したいとき。developer preview ではありますが、Web UI の完成度も高く実用的だと感じました。
前にも書きましたが、どれを選んでも Claude を定額で使うことはできないので、Anthropic のモデルを使いたい場合は Claude Code や Claude Code on the web を使うのがいいでしょう。
これらのハーネスで使うなら、Claude は API キーの従量課金、OpenAI のモデルは ChatGPT のサブスクリプション、それ以外は open-weight のモデルを API かローカルで、というのが 2026 年 9 月時点の選択肢です。
おわりに
OpenCode、pi、DeepSeek Harness は、どれもモデルを差し替えられるハーネスですが、全部入り、最小限、全部プラグインと設計の向きが違いました。
調べてみると、Opus のようなクローズドなモデルでも、動かすハーネスが違えばベンチマークのスコアが変わることが分かりました。
同じモデルに 3 つをつないで実際に走らせると、所要時間や必要とするトークン量にも差が出ました。
DeepSeek Harness のプロバイダ層が pi のパッケージだったことも、調べるまで知りませんでした。
この記事で取り上げた 3 つ以外にも、コーディングエージェントのハーネスは次々に出てきています。
気になるものがあれば実際に触ってみて、自分の使い方に合うものを見つけてください。
参考資料
- OpenCode
- OpenCode Docs: Providers
- OpenCode Docs: Tools
- pi coding agent README (GitHub)
- deepseek-ai/deepseek-harness (GitHub)
- DeepSeek Harness launches as open source rival to Claude Code (VentureBeat)
- Anthropic cracks down on unauthorized Claude usage by third-party harnesses (VentureBeat)
- Anthropic officially bans using subscription authentication for third-party Claude use (AlternativeTo)
- ChatGPT Plus: Enjoy $200 of Tokens for $20 While It Lasts (manifest.build)
- Codex for Open Source (OpenAI Developers)
- Model-Harness-Fit (Nicolas Bustamante)
- Harness-Bench: Measuring Harness Effects across Models in Realistic Agent Workflows (arXiv)
- NeMo Switchyard (GitHub)
- 第 2 回: NeMo Switchyard と事後学習済み judge でリクエストを振り分ける
- Terminal-Bench 2.1 (tbench.ai news)