はじめに
LLMの処理は、大きく学習と推論の2つに分けられます。
学習
推論
何をするか
大量の文章を使って、モデルの重みを調整する
学習済みの重みを使って、入力に続く文章を生成する
重み
更新する
固定(更新しない)
身近な例
モデルを作る・ファインチューニングする
ChatGPTやローカルLLMで質問に答えてもらう
この記事で扱うKVキャッシュは推論側の話です。推論はさらに、prefillとdecodeという2つの段階に分かれます。ローカルLLMを触っていると、どちらもよく目にする言葉だと思います。2つの段階は、次のように性質が異なります。
prefill
decode
何をするか
入力されたプロンプトの全トークンをまとめて処理する
1トークンずつ文章を生成する
処理の特徴
大量の行列演算を並列に行う
1トークン生成するたびに、モデルの重みや過去の計算結果をメモリから読み出す
速度を左右するもの
計算性能(compute bound)
メモリ帯域(memory bound)
decodeがmemory boundということは、decodeの速度はGPUの計算性能よりも、メモリからどれだけ速くデータを読み出せるか(メモリ帯域)で決まるということです。そのため、LLMを動かすハードウェアでは、メモリの容量と帯域、そしてメモリをどう配置するかが重要になります。まずGPT-2でprefillとdecodeを順に追い、KVキャッシュが何を使い回しているのかを見たうえで、最後に、KVキャッシュや重みを置くメモリが、実際のハードウェアでどう配置されているかを確認します。
GPT-2型モデルの推論処理を追う
この記事で追う例
GPT-2に The cat sat on という文章を入力し、続きとして the mat and purred が生成される場面を例に、処理の流れを追います(トークンの区切りと生成される文章は説明用の例です)。
\begin{array}{lll}
\text{1. prefill} & \boxed{\texttt{The}}\,\boxed{\texttt{cat}}\,\boxed{\texttt{sat}}\,\boxed{\texttt{on}} \;\longrightarrow\; \boxed{\texttt{the}} & \texttt{The cat sat on}\textcolor{#e05d44}{\texttt{ the}} \\[6pt]
\text{2. decode} & \boxed{\texttt{the}} \;\longrightarrow\; \boxed{\texttt{mat}} & \texttt{The cat sat on the}\textcolor{#e05d44}{\texttt{ mat}} \\[6pt]
\text{3. decode} & \boxed{\texttt{mat}} \;\longrightarrow\; \boxed{\texttt{and}} & \texttt{The cat sat on the mat}\textcolor{#e05d44}{\texttt{ and}} \\[6pt]
\text{4. decode} & \boxed{\texttt{and}} \;\longrightarrow\; \boxed{\texttt{purred}} & \texttt{The cat sat on the mat and}\textcolor{#e05d44}{\texttt{ purred}}
\end{array}
prefillでは、プロンプトの4トークンをまとめて処理し、最初の1トークン the を生成します。decodeでは、直前に生成した1トークンだけを入力して、次の1トークンを生成します。このとき、過去のトークンの計算結果をどう使い回すかが、KVキャッシュの話につながります。
推論処理の流れ
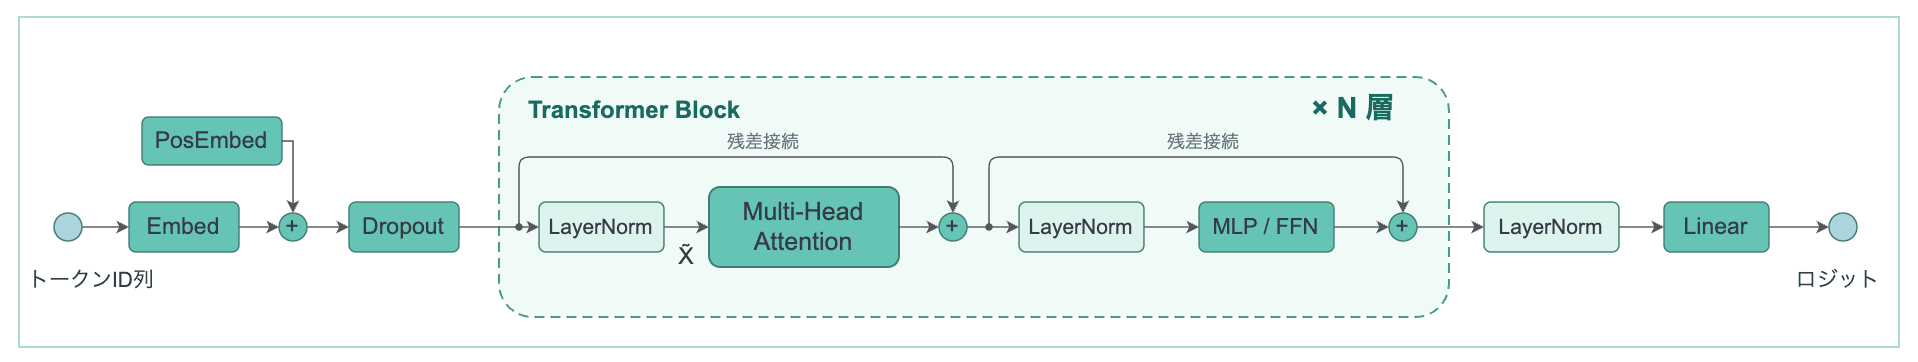
次の図は、推論で行われる処理の流れです。
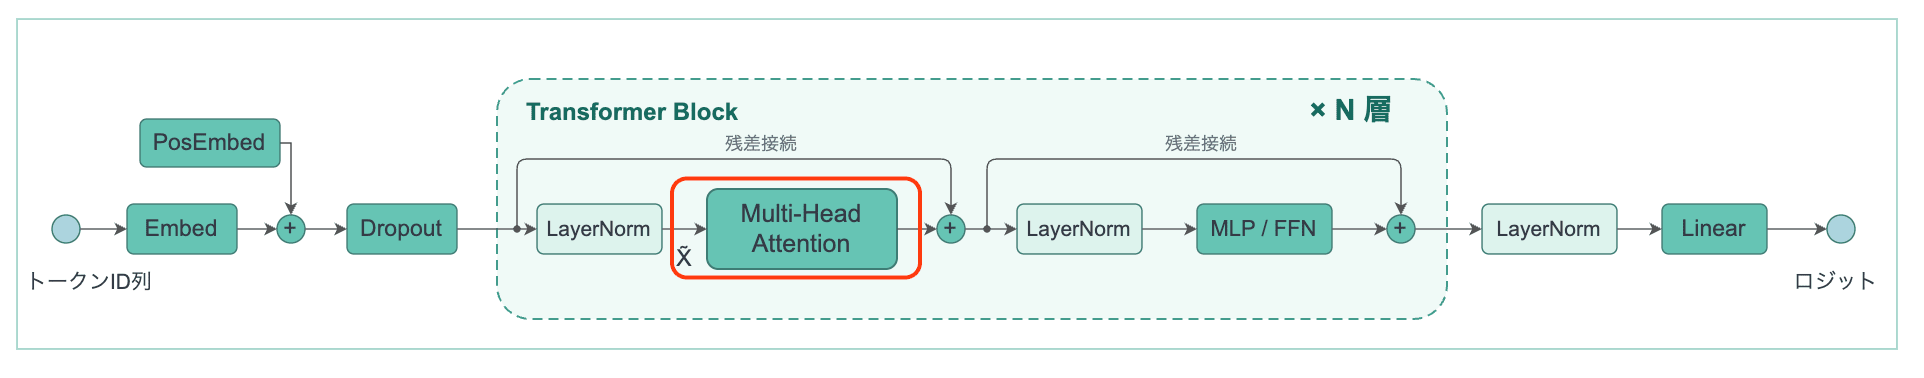
上の図には多くの部品がありますが、この中で過去のトークンを参照するのは、次の図で赤枠をつけたAttentionだけです。ほかの部品は1トークンずつ独立に計算するので、decodeでも新しいトークンの1行だけを計算すれば済みます。そこでここからは、prefillとdecodeのそれぞれでAttentionが何を計算しているのかに絞って追います。
Transformer Blockに \times N N N
この先の説明は、次の動画の場面を切り出しながら進めます。prefillからdecodeまで、Attentionの計算が層ごとにどう進み、KVキャッシュがあると何を使い回せるのかを動画にしました。左がKVキャッシュあり、右がなしです。色の意味は次のとおりです。
色
意味
🟦 青
このステップで計算する値
🟩 緑
KVキャッシュから読む値
🟥 赤
キャッシュがないため、前のステップと同じ値をもう一度計算している部分
▨ 斜線
前のステップで計算済みで、今回は使わない部分
https://youtu.be/eBtSIzcETe0
動画のトークンの下にある 1〜8 は位置の番号で、q_i k_i v_i i
prefillの流れ
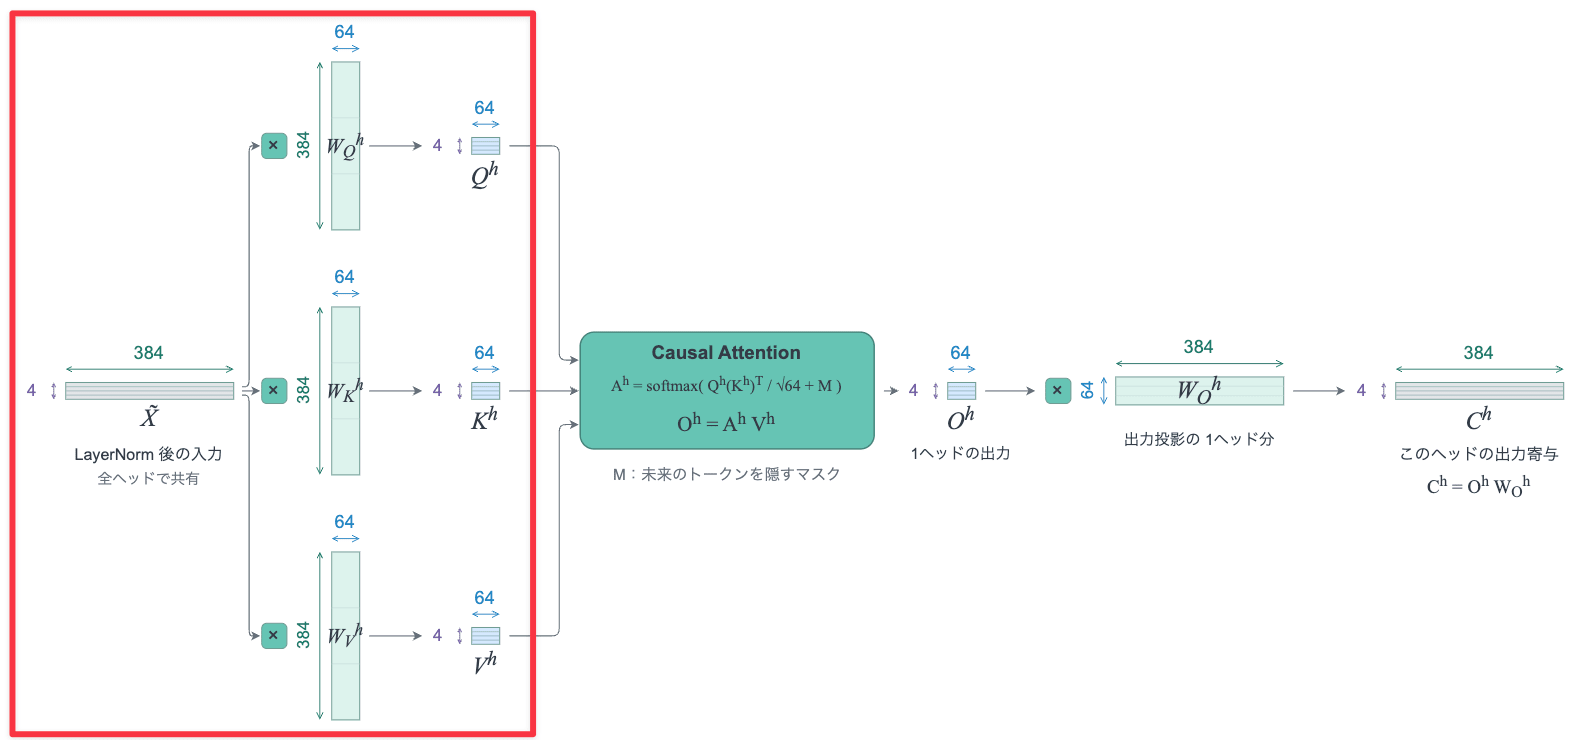
まずはprefillです。プロンプトの4トークン The cat sat on をまとめて入力し、次のトークン the を求めます。先ほどの全体図で赤枠をつけたMulti-Head Attentionの中を見ていきます。多少数式が出てきますが、行列の積と内積の計算だけです。
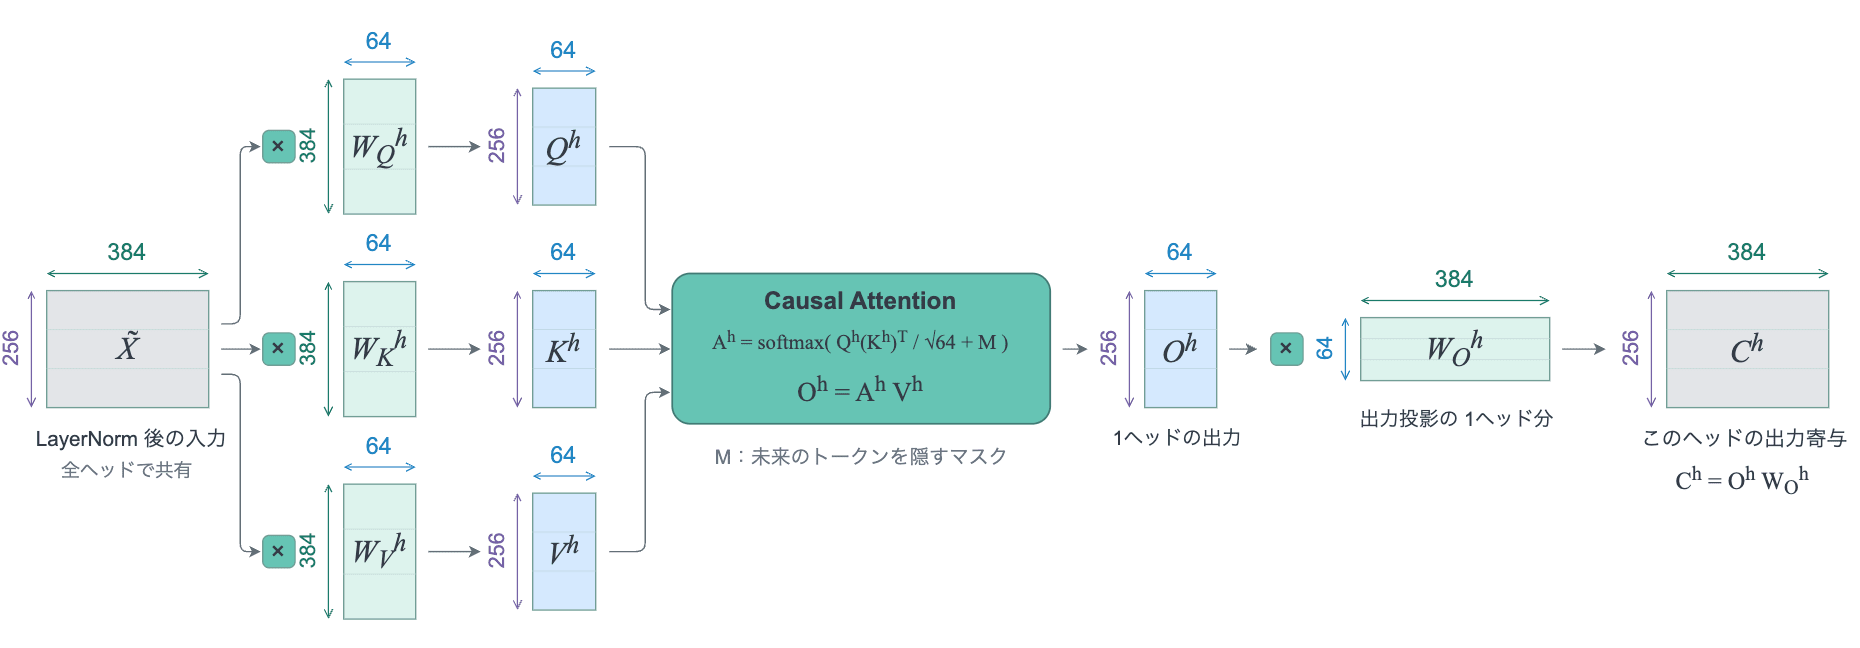
この記事の設定では、Multi-Head Attentionは6つのヘッドで構成されています。以降の式に出てくる記号の読み方は次のとおりです。大きさはprefill(4トークン)のときの値です。
記号
意味
大きさ
h ヘッドの番号(1〜6)。右肩の h h
-
\tilde{X} LayerNorm後の入力。1行が1トークンに対応する。全ヘッドで共通
4 \times 384
\tilde{x}_i \tilde{X} i i 1 \times 384
W_Q^h W_K^h W_V^h ヘッド h
384 \times 64
Q^h K^h V^h ヘッド h
4 \times 64
q_i k_i v_i Q^h K^h V^h i h 1 \times 64
(K^h)^\top K^h 64 \times 4
M 未来のトークンを隠すマスク。見てよいところは 0 -\infty
4 \times 4
A^h 注目度(Attentionの重み)。a_{ij} i j
4 \times 4
O^h ヘッド h o_i i
4 \times 64
\sqrt{64} 1ヘッドの次元64の平方根。内積の値が大きくなりすぎないように割る
-
次の図は、そのうち1ヘッド分の動きです。
上の図は、トークン数を最大の256として描いたものです。ここからは、prefillで実際に入力する4トークンで見ていきます。
上の図は、prefillの入力 The cat sat on の4トークンで描き直したもので、赤枠は Q^h K^h V^h \tilde{X} The、2行目が cat、3行目が sat、4行目が on の 4 \times 384 h W_Q^h W_K^h W_V^h 384 \times 64 Q^h K^h V^h 4 \times 64
\underbrace{\tilde{X}}_{4 \times 384}\,\underbrace{W_Q^h}_{384 \times 64} = \underbrace{Q^h}_{4 \times 64},
\qquad
\tilde{X}\,W_K^h = K^h,
\qquad
\tilde{X}\,W_V^h = V^h
1行ずつ見ると、各トークンの q_i k_i v_i \tilde{x}_i
\begin{pmatrix} \tilde{x}_1 \\ \tilde{x}_2 \\ \tilde{x}_3 \\ \tilde{x}_4 \end{pmatrix} W_Q^h
=
\begin{pmatrix} \tilde{x}_1 W_Q^h \\ \tilde{x}_2 W_Q^h \\ \tilde{x}_3 W_Q^h \\ \tilde{x}_4 W_Q^h \end{pmatrix}
=
\begin{pmatrix} q_1 \\ q_2 \\ q_3 \\ q_4 \end{pmatrix}
\begin{matrix} \leftarrow \texttt{The} \\ \leftarrow \texttt{cat} \\ \leftarrow \texttt{sat} \\ \leftarrow \texttt{on} \end{matrix}
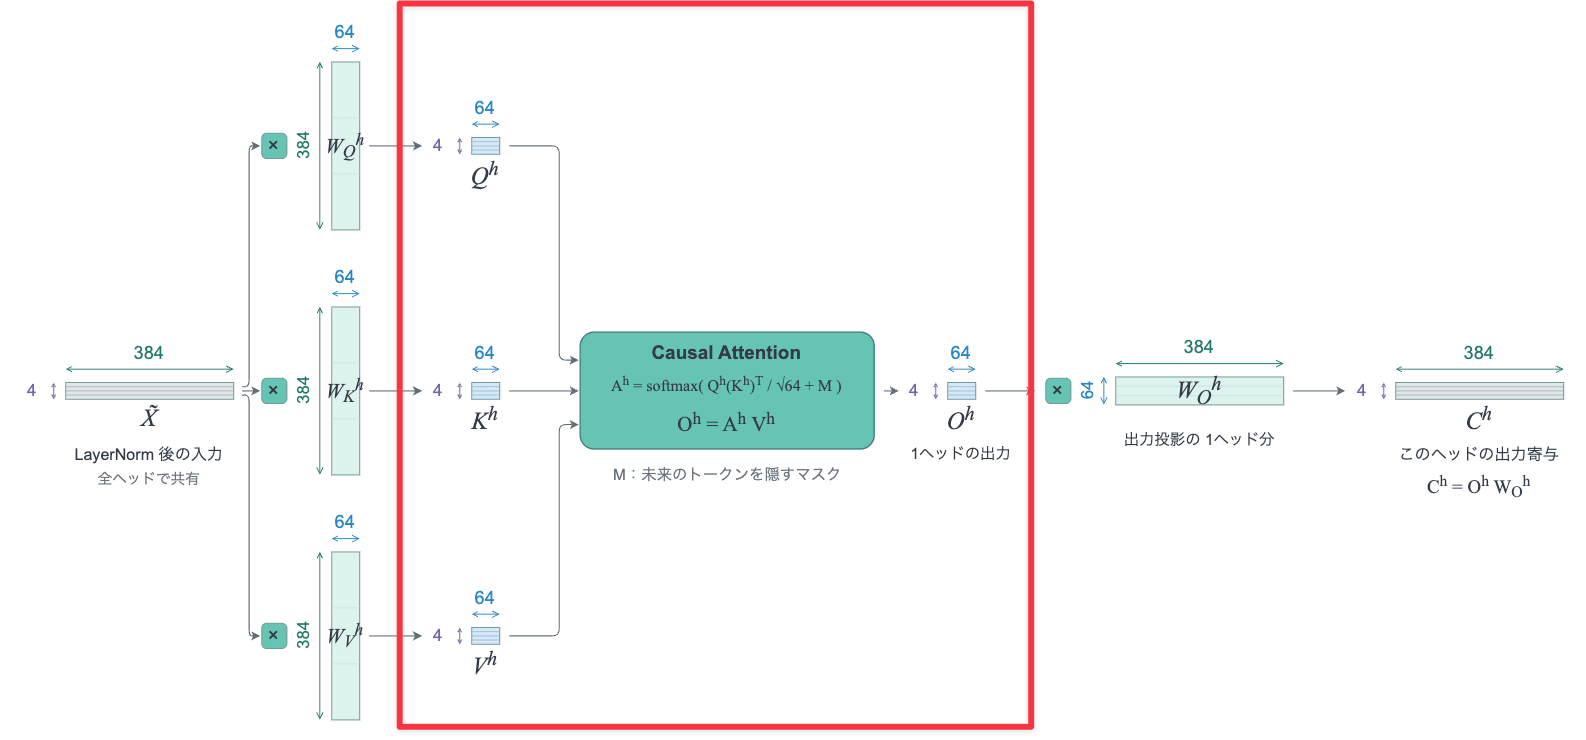
こうして作った Q^h K^h V^h O^h \mathrm{Attention}
O^h = \mathrm{Attention}(Q^h,\ K^h,\ V^h)
上の図の赤枠は、作った Q^h K^h V^h O^h
A^h = \mathrm{softmax}\!\left(\frac{Q^h (K^h)^\top}{\sqrt{64}} + M\right),
\qquad
O^h = A^h V^h
2つをまとめると、先ほどの \mathrm{Attention}
\mathrm{Attention}(Q^h,\ K^h,\ V^h) = \mathrm{softmax}\!\left(\frac{Q^h (K^h)^\top}{\sqrt{64}} + M\right) V^h
まず Q^h (K^h)^\top \top Q^h K^h 4 \times 64 K^h 64 \times 4 4 \times 4
\underbrace{Q^h}_{4 \times 64}\ \underbrace{(K^h)^\top}_{64 \times 4} = \underbrace{Q^h (K^h)^\top}_{4 \times 4}
転置すると、K^h k_1 k_4 i j Q^h i q_i K^h j k_j
\begin{pmatrix} q_1 \\ q_2 \\ q_3 \\ q_4 \end{pmatrix}
\begin{pmatrix} k_1^\top & k_2^\top & k_3^\top & k_4^\top \end{pmatrix}
=
\begin{pmatrix}
q_1 \cdot k_1 & q_1 \cdot k_2 & q_1 \cdot k_3 & q_1 \cdot k_4 \\
q_2 \cdot k_1 & q_2 \cdot k_2 & q_2 \cdot k_3 & q_2 \cdot k_4 \\
q_3 \cdot k_1 & q_3 \cdot k_2 & q_3 \cdot k_3 & q_3 \cdot k_4 \\
q_4 \cdot k_1 & q_4 \cdot k_2 & q_4 \cdot k_3 & q_4 \cdot k_4
\end{pmatrix},
\qquad
q_i \cdot k_j = \sum_{d=1}^{64} q_{i,d}\, k_{j,d}
これにマスク M \sqrt{64}
Q^h (K^h)^\top + M =
\begin{array}{c|cccc}
& k_1\ \texttt{The} & k_2\ \texttt{cat} & k_3\ \texttt{sat} & k_4\ \texttt{on} \\ \hline
q_1\ \texttt{The} & q_1 \cdot k_1 & \textcolor{gray}{-\infty} & \textcolor{gray}{-\infty} & \textcolor{gray}{-\infty} \\
q_2\ \texttt{cat} & q_2 \cdot k_1 & q_2 \cdot k_2 & \textcolor{gray}{-\infty} & \textcolor{gray}{-\infty} \\
q_3\ \texttt{sat} & q_3 \cdot k_1 & q_3 \cdot k_2 & q_3 \cdot k_3 & \textcolor{gray}{-\infty} \\
q_4\ \texttt{on} & q_4 \cdot k_1 & q_4 \cdot k_2 & q_4 \cdot k_3 & q_4 \cdot k_4
\end{array}
マスク M -\infty -\infty A^h
A^h =
\begin{array}{c|cccc}
& v_1 & v_2 & v_3 & v_4 \\ \hline
\texttt{The} & a_{11} & \textcolor{gray}{0} & \textcolor{gray}{0} & \textcolor{gray}{0} \\
\texttt{cat} & a_{21} & a_{22} & \textcolor{gray}{0} & \textcolor{gray}{0} \\
\texttt{sat} & a_{31} & a_{32} & a_{33} & \textcolor{gray}{0} \\
\texttt{on} & a_{41} & a_{42} & a_{43} & a_{44}
\end{array}
最後に O^h = A^h V^h V^h on の出力は o_4 = a_{41} v_1 + a_{42} v_2 + a_{43} v_3 + a_{44} v_4 k v
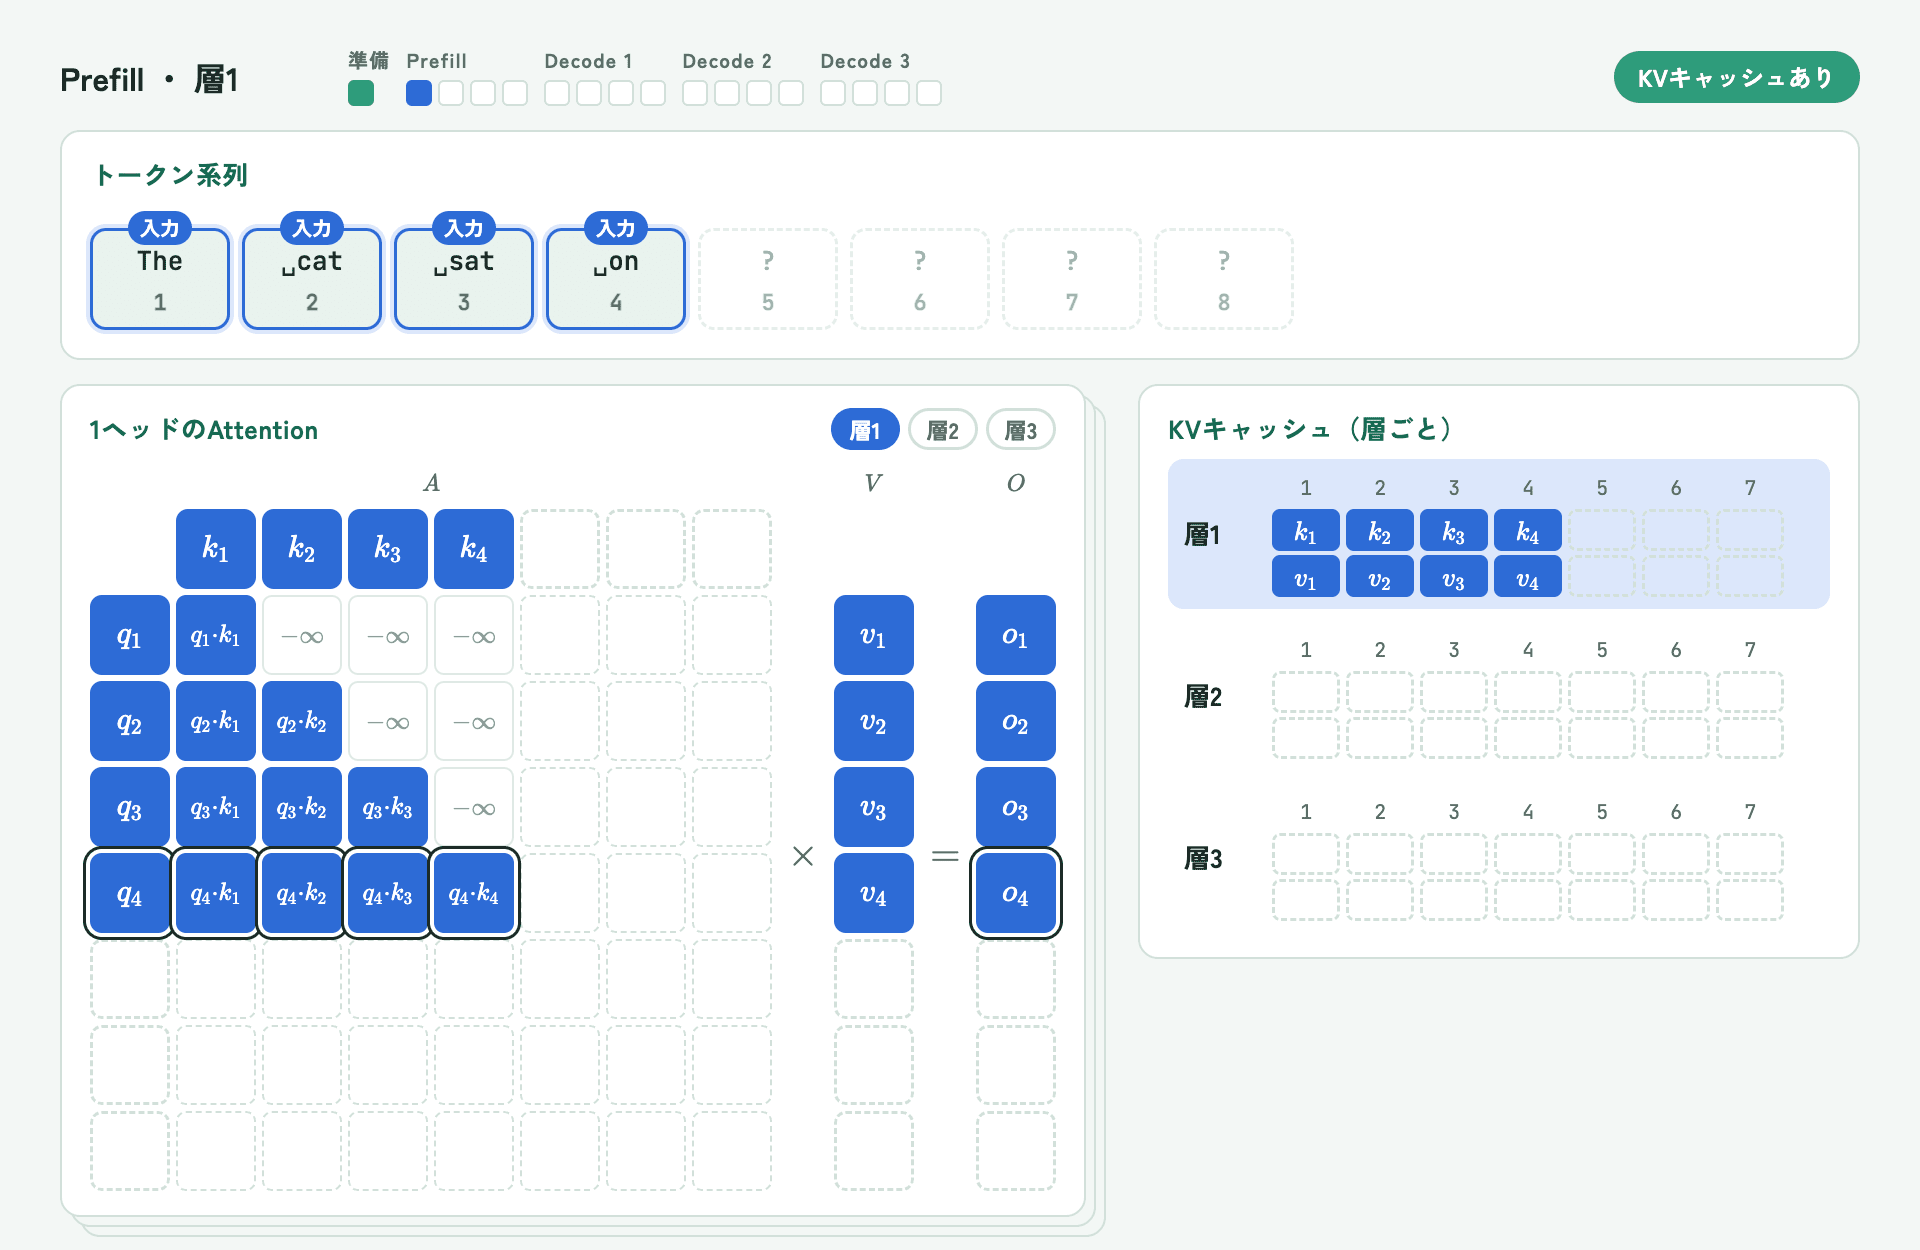
ここまでの計算を動画で見たのが、次の図(prefill・層1の場面)です。
上の図では、4トークン分の q k v -\infty k_1 k_4 v_1 v_4
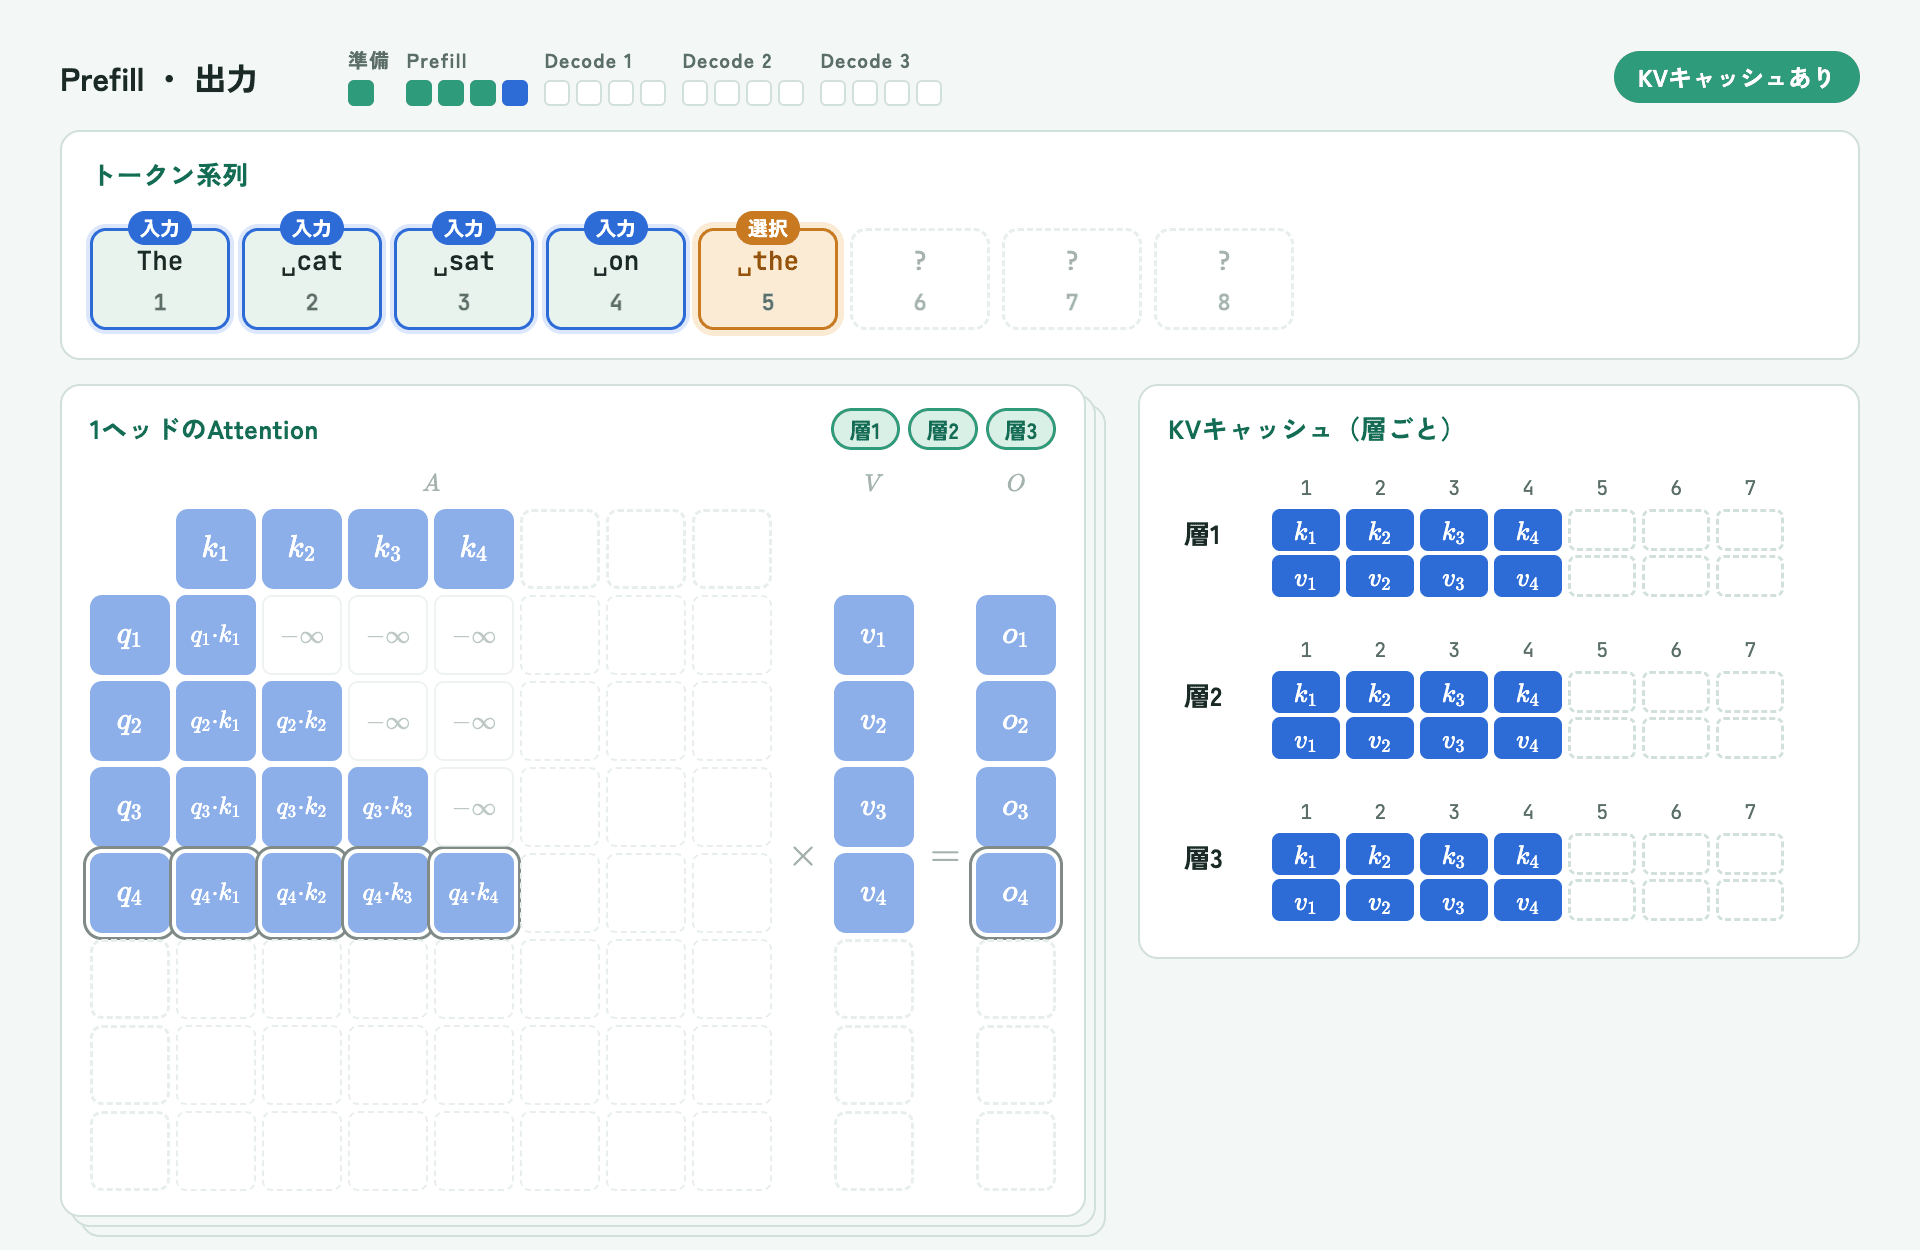
上の図は、3層を通ったあとの出力の場面です。最後の位置(on)の出力から、次のトークン the を選びます。この時点で、KVキャッシュには3層それぞれに4トークン分の k v
decodeの流れ
続いてdecodeです。decodeの1ステップ目では、直前に生成した the(位置5)だけを入力し、次のトークン mat を求めます。以降の式では、\textcolor{#146B53}{\boxed{k}} \textcolor{#2D6BD6}{\boxed{\bm{k}}}
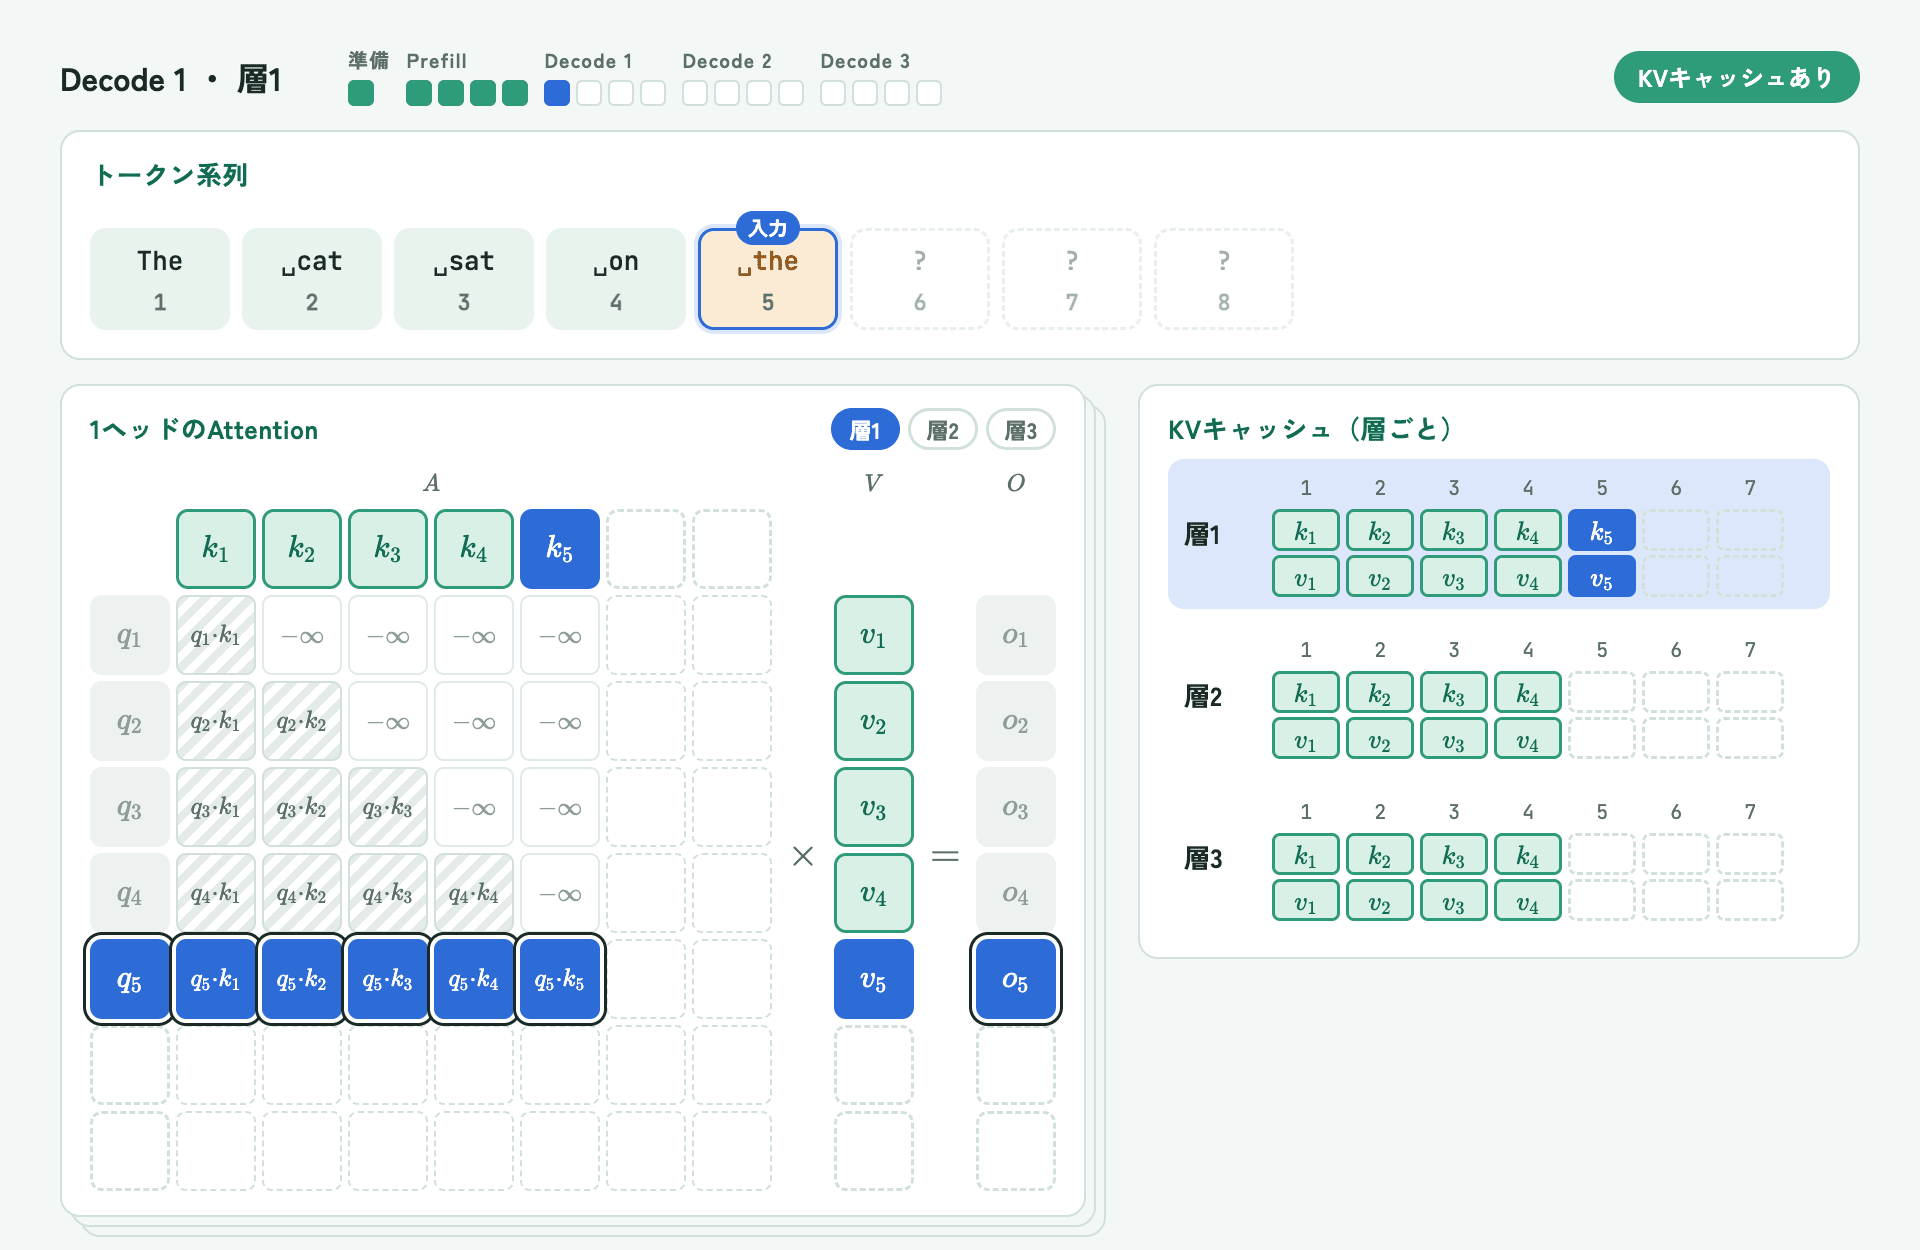
上の図は、動画のdecode 1・層1の場面です。計算するのは位置5の1行(青)だけで、k_1 k_4 v_1 v_4
新しく計算するのは、入力した the の1行分の q k v
\underbrace{\tilde{x}_5}_{1 \times 384}\,W_Q^h = \textcolor{#2D6BD6}{\boxed{\bm{q_5}}},\qquad \tilde{x}_5\,W_K^h = \textcolor{#2D6BD6}{\boxed{\bm{k_5}}},\qquad \tilde{x}_5\,W_V^h = \textcolor{#2D6BD6}{\boxed{\bm{v_5}}}\qquad (\text{各 } 1 \times 64)
過去4トークン分の k v
\def\arraystretch{1.5}
\begin{array}{r l | c c | l}
\text{位置} & & K^h & V^h & \\ \hline
1 & \texttt{The} & \textcolor{#146B53}{\boxed{k_1}} & \textcolor{#146B53}{\boxed{v_1}} & \textcolor{#146B53}{\text{KVキャッシュから読む}} \\
2 & \texttt{cat} & \textcolor{#146B53}{\boxed{k_2}} & \textcolor{#146B53}{\boxed{v_2}} & \textcolor{#146B53}{\text{KVキャッシュから読む}} \\
3 & \texttt{sat} & \textcolor{#146B53}{\boxed{k_3}} & \textcolor{#146B53}{\boxed{v_3}} & \textcolor{#146B53}{\text{KVキャッシュから読む}} \\
4 & \texttt{on} & \textcolor{#146B53}{\boxed{k_4}} & \textcolor{#146B53}{\boxed{v_4}} & \textcolor{#146B53}{\text{KVキャッシュから読む}} \\
5 & \texttt{the} & \textcolor{#2D6BD6}{\boxed{\bm{k_5}}} & \textcolor{#2D6BD6}{\boxed{\bm{v_5}}} & \textcolor{#2D6BD6}{\text{今回計算して末尾に追加}}
\end{array}
内積を取るのも the の1行だけです。最新のトークンは過去をすべて見てよいので、マスクも要りません。
\def\arraystretch{1.5}
\begin{array}{c|ccccc}
& \textcolor{#146B53}{\boxed{k_1}}\,\texttt{The} & \textcolor{#146B53}{\boxed{k_2}}\,\texttt{cat} & \textcolor{#146B53}{\boxed{k_3}}\,\texttt{sat} & \textcolor{#146B53}{\boxed{k_4}}\,\texttt{on} & \textcolor{#2D6BD6}{\boxed{\bm{k_5}}}\,\texttt{the} \\ \hline
\textcolor{#2D6BD6}{\boxed{\bm{q_5}}}\,\texttt{the} & \textcolor{#2D6BD6}{q_5 \cdot k_1} & \textcolor{#2D6BD6}{q_5 \cdot k_2} & \textcolor{#2D6BD6}{q_5 \cdot k_3} & \textcolor{#2D6BD6}{q_5 \cdot k_4} & \textcolor{#2D6BD6}{q_5 \cdot k_5}
\end{array}
\textcolor{#2D6BD6}{(q_5 \cdot k_1,\ \dots,\ q_5 \cdot k_5)}\;\xrightarrow{\ \text{softmax}\ }\;(a_{51},\ a_{52},\ a_{53},\ a_{54},\ a_{55})
出力 o_5 v_1 v_4 v_5
o_5 = \underbrace{a_{51}\,\textcolor{#146B53}{\boxed{v_1}} + a_{52}\,\textcolor{#146B53}{\boxed{v_2}} + a_{53}\,\textcolor{#146B53}{\boxed{v_3}} + a_{54}\,\textcolor{#146B53}{\boxed{v_4}}}_{\textcolor{#146B53}{\text{KVキャッシュから読む}}} + \underbrace{a_{55}\,\textcolor{#2D6BD6}{\boxed{\bm{v_5}}}}_{\textcolor{#2D6BD6}{\text{今回計算}}}
つまり、the が過去の文脈を取り込む材料は、計算済みの k v k_j v_j j
\def\arraystretch{1.5}
\begin{array}{c|l}
\text{層2以降の } k_j,\ v_j & \text{計算済みの文脈} \\ \hline
\textcolor{#146B53}{\boxed{k_1}},\ \textcolor{#146B53}{\boxed{v_1}} & \texttt{The} \\
\textcolor{#146B53}{\boxed{k_2}},\ \textcolor{#146B53}{\boxed{v_2}} & \texttt{The cat} \\
\textcolor{#146B53}{\boxed{k_3}},\ \textcolor{#146B53}{\boxed{v_3}} & \texttt{The cat sat} \\
\textcolor{#146B53}{\boxed{k_4}},\ \textcolor{#146B53}{\boxed{v_4}} & \texttt{The cat sat on}
\end{array}
この計算結果は後からトークンが増えても変わらないので、KVキャッシュに保存したものをそのまま使えます。
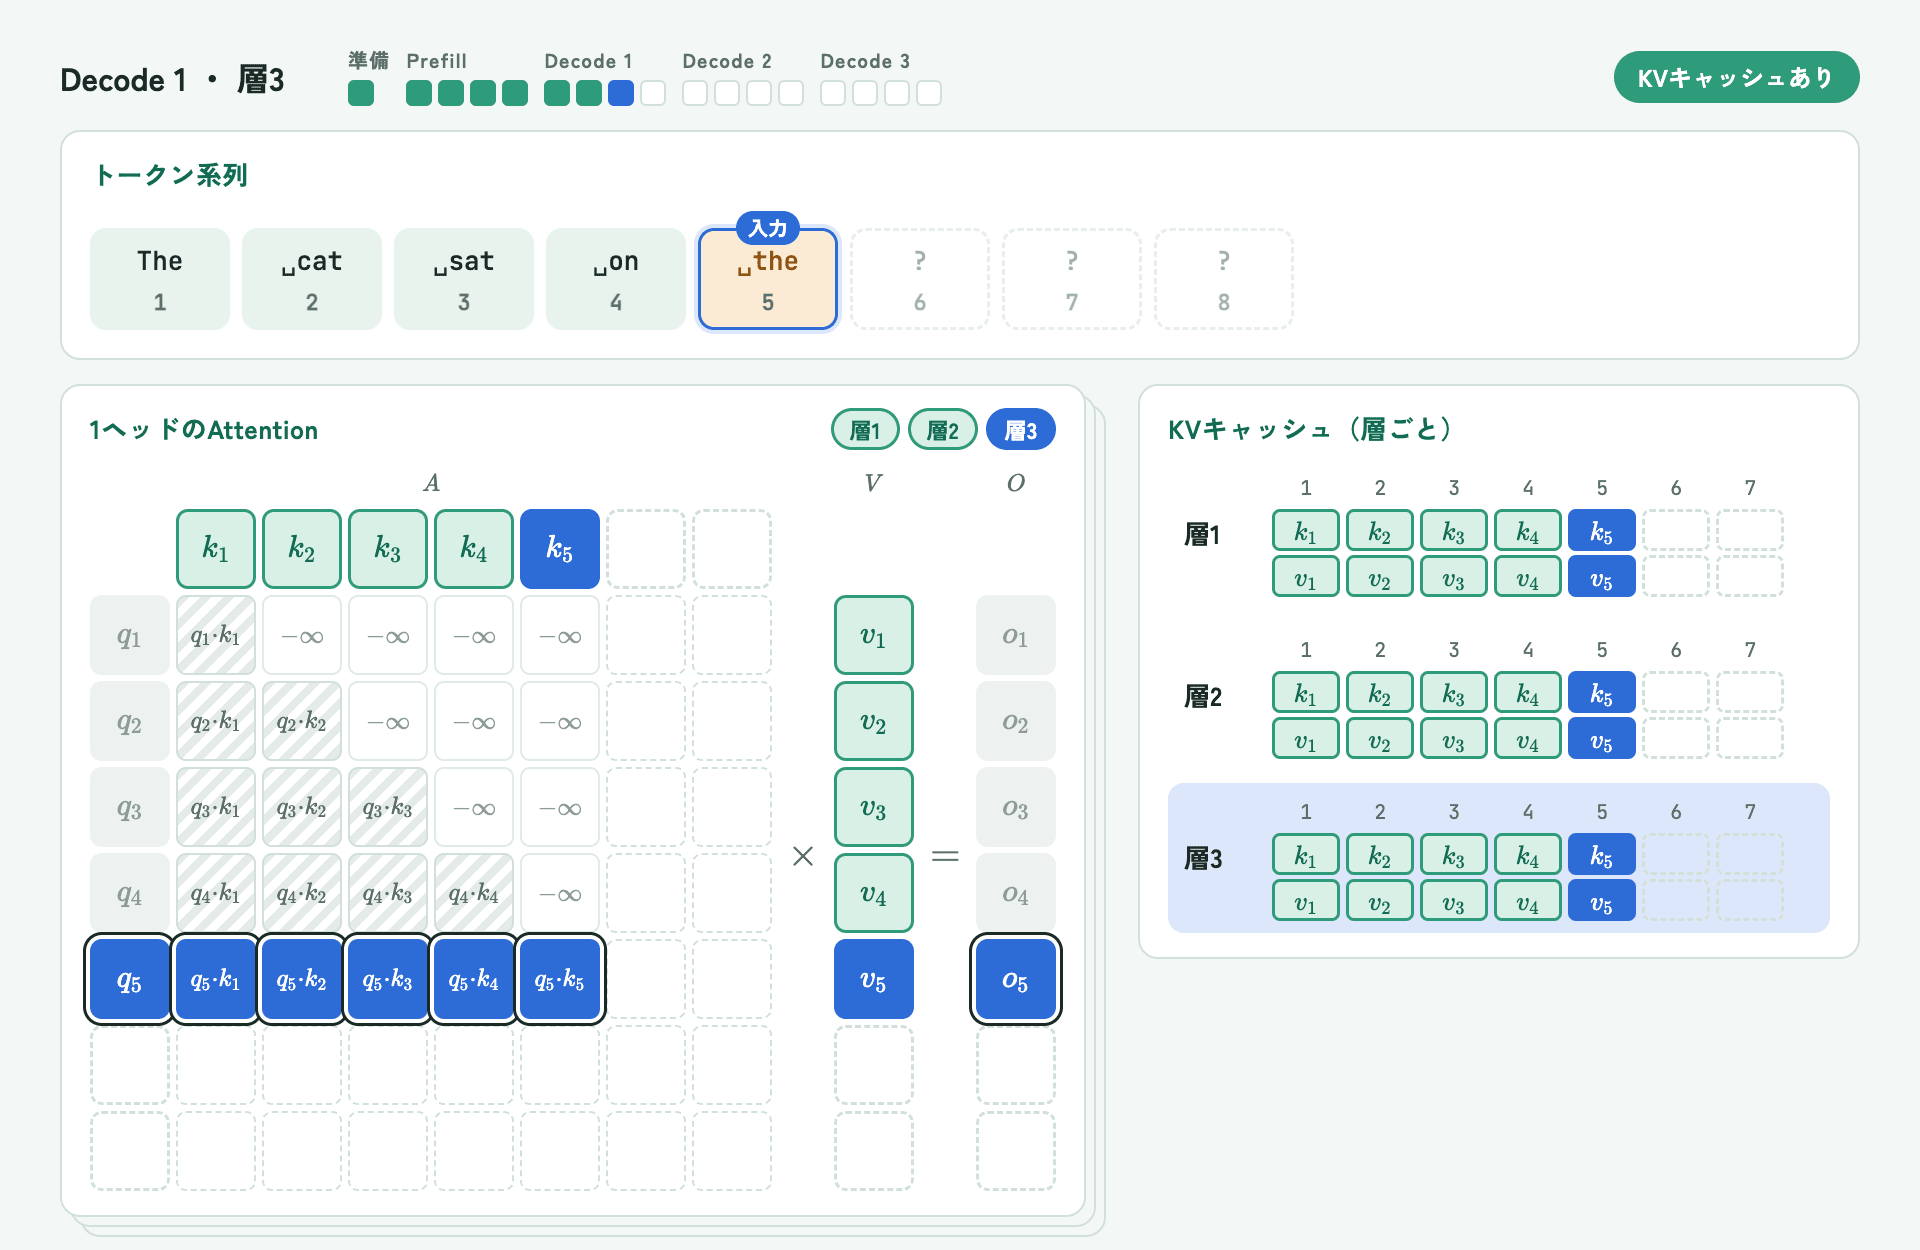
上の図は、同じdecode 1で層3まで進んだ場面です。次のトークンの予測に使うのは、最後の位置の出力 o_5 q_1 q_4 o_1 o_4 k v q
! 予測に使うのは最後の行だけなのに、なぜ全部の行を計算するのか
decodeでは q_5 o k v
\def\arraystretch{1.35}
\begin{array}{r|cccc}
\text{予測} & \textcolor{gray}{\times} & \textcolor{gray}{\times} & \textcolor{gray}{\times} & \texttt{the} \\
& \textcolor{gray}{\uparrow o_1} & \textcolor{gray}{\uparrow o_2} & \textcolor{gray}{\uparrow o_3} & \uparrow o_4 \\
\text{層3} & \textcolor{#146B53}{\boxed{k_1,\ v_1}} & \textcolor{#146B53}{\boxed{k_2,\ v_2}} & \textcolor{#146B53}{\boxed{k_3,\ v_3}} & \textcolor{#146B53}{\boxed{k_4,\ v_4}} \\
& \uparrow o_1 & \uparrow o_2 & \uparrow o_3 & \uparrow o_4 \\
\text{層2} & \textcolor{#146B53}{\boxed{k_1,\ v_1}} & \textcolor{#146B53}{\boxed{k_2,\ v_2}} & \textcolor{#146B53}{\boxed{k_3,\ v_3}} & \textcolor{#146B53}{\boxed{k_4,\ v_4}} \\
& \uparrow o_1 & \uparrow o_2 & \uparrow o_3 & \uparrow o_4 \\
\text{層1} & \textcolor{#146B53}{\boxed{k_1,\ v_1}} & \textcolor{#146B53}{\boxed{k_2,\ v_2}} & \textcolor{#146B53}{\boxed{k_3,\ v_3}} & \textcolor{#146B53}{\boxed{k_4,\ v_4}} \\
& \uparrow & \uparrow & \uparrow & \uparrow \\
\text{入力} & \texttt{The} & \texttt{cat} & \texttt{sat} & \texttt{on}
\end{array}
緑の k v
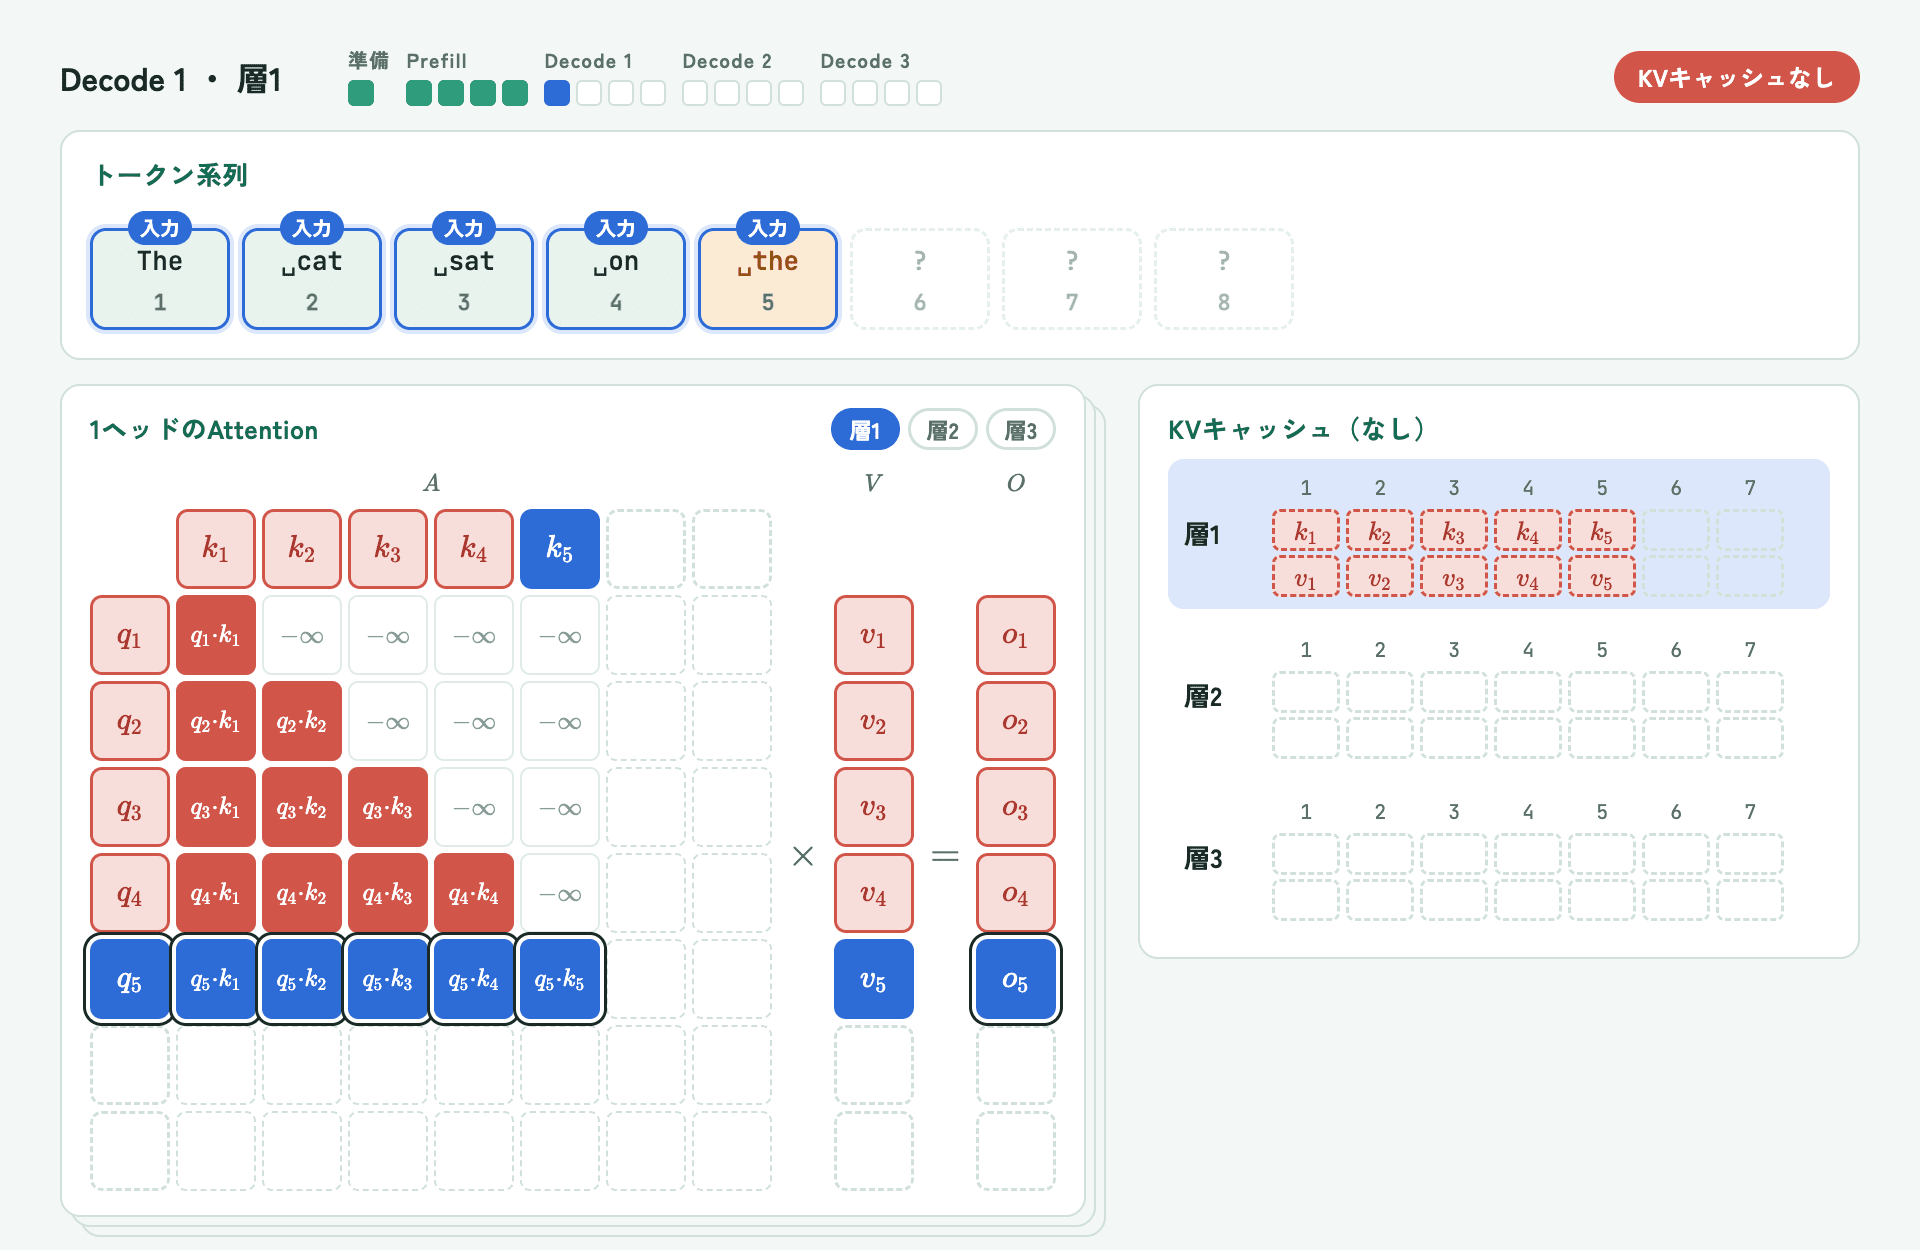
上の図は、同じdecode 1・層1をKVキャッシュなしで見た場面です。KVキャッシュがなければ、過去の k v The cat sat on the をもう一度Embedから通し、全層で 5 \times 5 \textcolor{#C0392B}{\boxed{k}}
\def\arraystretch{1.5}
\begin{array}{c|ccccc}
& \textcolor{#C0392B}{\boxed{k_1}} & \textcolor{#C0392B}{\boxed{k_2}} & \textcolor{#C0392B}{\boxed{k_3}} & \textcolor{#C0392B}{\boxed{k_4}} & \textcolor{#2D6BD6}{\boxed{\bm{k_5}}} \\ \hline
\textcolor{#C0392B}{\boxed{q_1}}\,\texttt{The} & \textcolor{#C0392B}{q_1 \cdot k_1} & \textcolor{#A0ABA7}{-\infty} & \textcolor{#A0ABA7}{-\infty} & \textcolor{#A0ABA7}{-\infty} & \textcolor{#A0ABA7}{-\infty} \\
\textcolor{#C0392B}{\boxed{q_2}}\,\texttt{cat} & \textcolor{#C0392B}{q_2 \cdot k_1} & \textcolor{#C0392B}{q_2 \cdot k_2} & \textcolor{#A0ABA7}{-\infty} & \textcolor{#A0ABA7}{-\infty} & \textcolor{#A0ABA7}{-\infty} \\
\textcolor{#C0392B}{\boxed{q_3}}\,\texttt{sat} & \textcolor{#C0392B}{q_3 \cdot k_1} & \textcolor{#C0392B}{q_3 \cdot k_2} & \textcolor{#C0392B}{q_3 \cdot k_3} & \textcolor{#A0ABA7}{-\infty} & \textcolor{#A0ABA7}{-\infty} \\
\textcolor{#C0392B}{\boxed{q_4}}\,\texttt{on} & \textcolor{#C0392B}{q_4 \cdot k_1} & \textcolor{#C0392B}{q_4 \cdot k_2} & \textcolor{#C0392B}{q_4 \cdot k_3} & \textcolor{#C0392B}{q_4 \cdot k_4} & \textcolor{#A0ABA7}{-\infty} \\
\textcolor{#2D6BD6}{\boxed{\bm{q_5}}}\,\texttt{the} & \textcolor{#2D6BD6}{q_5 \cdot k_1} & \textcolor{#2D6BD6}{q_5 \cdot k_2} & \textcolor{#2D6BD6}{q_5 \cdot k_3} & \textcolor{#2D6BD6}{q_5 \cdot k_4} & \textcolor{#2D6BD6}{q_5 \cdot k_5}
\end{array}
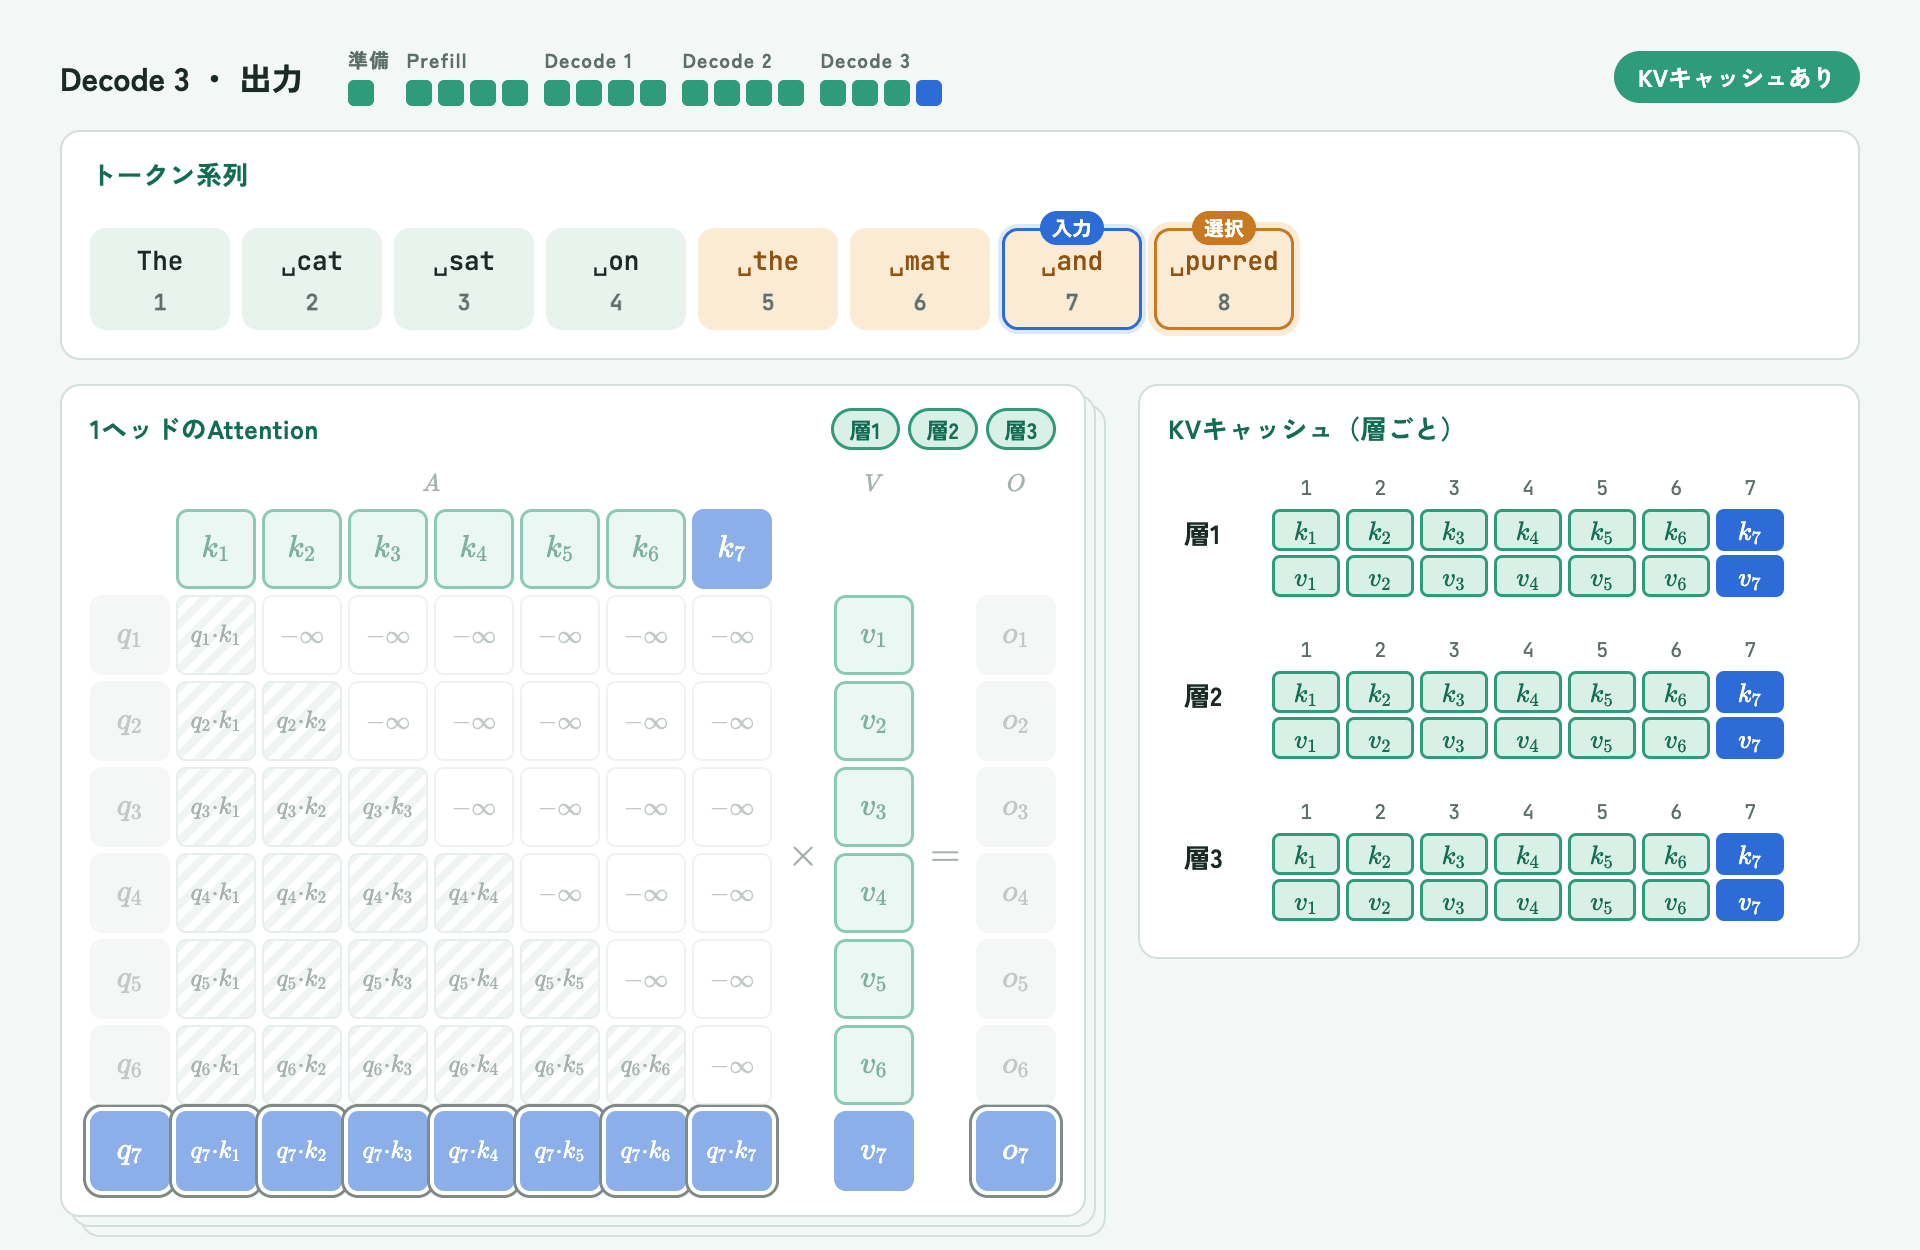
上の図は、decode 3まで進んだ場面です。decodeを進めるたびに、KVキャッシュは1トークン分ずつ伸びていき、毎回計算するのは青の1つだけです。次の表は1層・1ヘッド分なので、実際には V^h
\def\arraystretch{1.6}
\begin{array}{r|l|l}
& K^h\ \text{のキャッシュ} & \text{入力} \to \text{出力} \\ \hline
\text{prefill} & \textcolor{#2D6BD6}{\boxed{\bm{k_1}}}\,\textcolor{#2D6BD6}{\boxed{\bm{k_2}}}\,\textcolor{#2D6BD6}{\boxed{\bm{k_3}}}\,\textcolor{#2D6BD6}{\boxed{\bm{k_4}}} & \texttt{The cat sat on} \to \texttt{the} \\
\text{decode 1} & \textcolor{#146B53}{\boxed{k_1}}\,\textcolor{#146B53}{\boxed{k_2}}\,\textcolor{#146B53}{\boxed{k_3}}\,\textcolor{#146B53}{\boxed{k_4}}\,\textcolor{#2D6BD6}{\boxed{\bm{k_5}}} & \texttt{the} \to \texttt{mat} \\
\text{decode 2} & \textcolor{#146B53}{\boxed{k_1}}\,\textcolor{#146B53}{\boxed{k_2}}\,\textcolor{#146B53}{\boxed{k_3}}\,\textcolor{#146B53}{\boxed{k_4}}\,\textcolor{#146B53}{\boxed{k_5}}\,\textcolor{#2D6BD6}{\boxed{\bm{k_6}}} & \texttt{mat} \to \texttt{and} \\
\text{decode 3} & \textcolor{#146B53}{\boxed{k_1}}\,\textcolor{#146B53}{\boxed{k_2}}\,\textcolor{#146B53}{\boxed{k_3}}\,\textcolor{#146B53}{\boxed{k_4}}\,\textcolor{#146B53}{\boxed{k_5}}\,\textcolor{#146B53}{\boxed{k_6}}\,\textcolor{#2D6BD6}{\boxed{\bm{k_7}}} & \texttt{and} \to \texttt{purred}
\end{array}
KVキャッシュとハードウェアのメモリ構成
ここまで見てきたように、decodeでは1トークンごとに、モデルの重みと、過去のトークンの計算結果であるKVキャッシュを読み出します。KVキャッシュはコンテキスト長に比例して大きくなるため、メモリの容量と帯域の両方を圧迫します。では、実際のハードウェアではメモリがどう配置されているのかを見てみます。ここでは、代表的な4つの構成について、メモリの配置と帯域から見たざっくりとした特性を描きます。
Vera Rubin
GB10 Grace Blackwell
Apple Silicon(Mac Studio)
グラフィックボード(RTX 5090)
GPUが使うメモリ
HBM4(GPUパッケージ内)
LPDDR5X(CPUと共有)
ユニファイドメモリ(CPUと共有)
GDDR(GPU基板上のVRAM)
CPU側のメモリ
別途LPDDR5X(NVLink-C2Cで接続)
GPUと同じ
GPUと同じ
別途メインメモリ(PCIe経由)
容量・帯域
HBMへの帯域が非常に広い
128GB / 273GB/s
最大512GB / 1.2TB/s(M5 Ultra)
例:32GB / 約1.8TB/s(RTX 5090)
主な用途
データセンター
手元での開発・検証
Macでの開発・ローカルLLM
ゲーミング・個人のローカルLLM
この先の4枚は、メモリの配置と接続の違いを比べるための自作の模式図です。青は計算チップ、オレンジはメモリ、グレーの枠はパッケージや基板を表します。矢印の太さは帯域の違いを概念的に表したもので、実際の比率や配線を再現したものではありません。
Vera Rubin(データセンター向け)
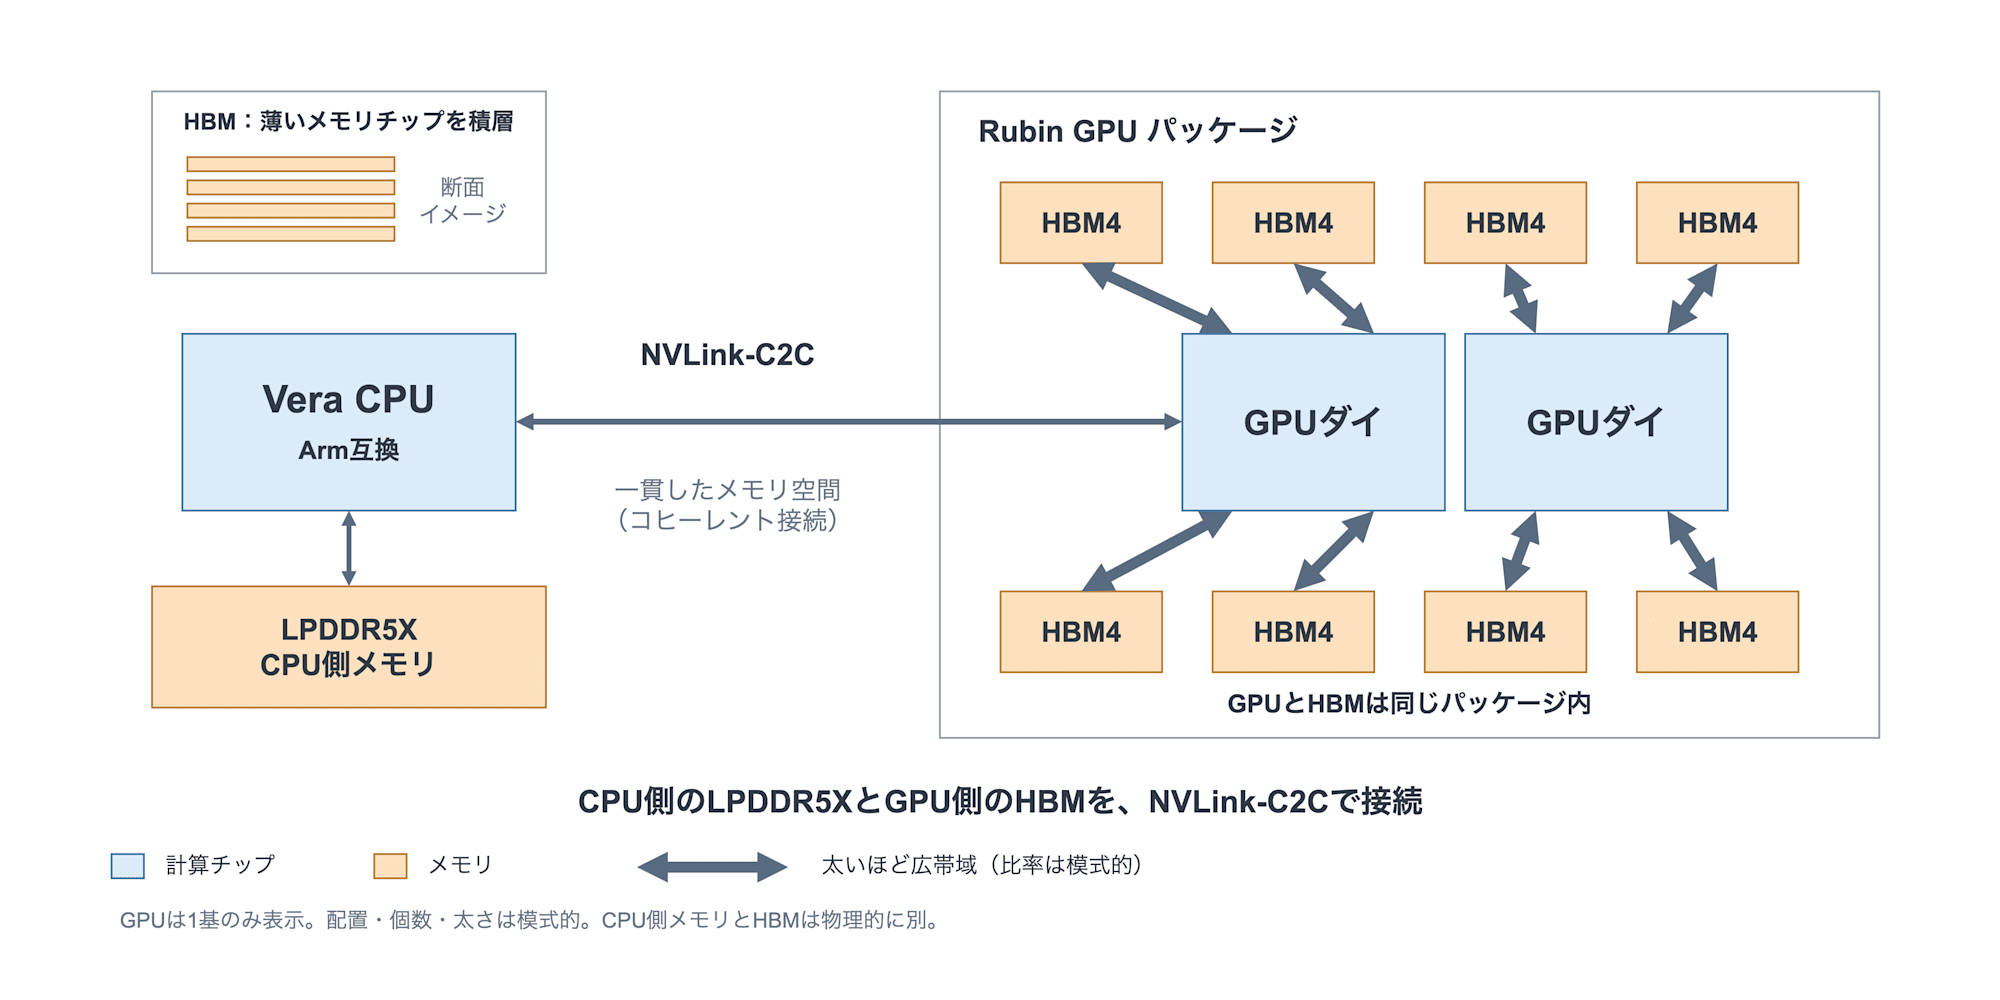
Rubin GPUのパッケージ内に、HBM4(メモリチップを縦に積み、非常に広いバス幅でGPUとつなぐ高帯域メモリ)が配置されています。Vera CPU側には別途LPDDR5Xがあり、NVLink-C2Cで整合性を保ったまま相互にアクセスできますが、物理的には別のメモリです。次の図ではRubin GPUを1基だけ描いています。
構成の出典:NVIDIA公式・Vera Rubinの技術解説 。プラットフォーム全体ではなく、CPU・GPUとメモリの関係を抜粋。
GB10 Grace Blackwell(DGX Spark)
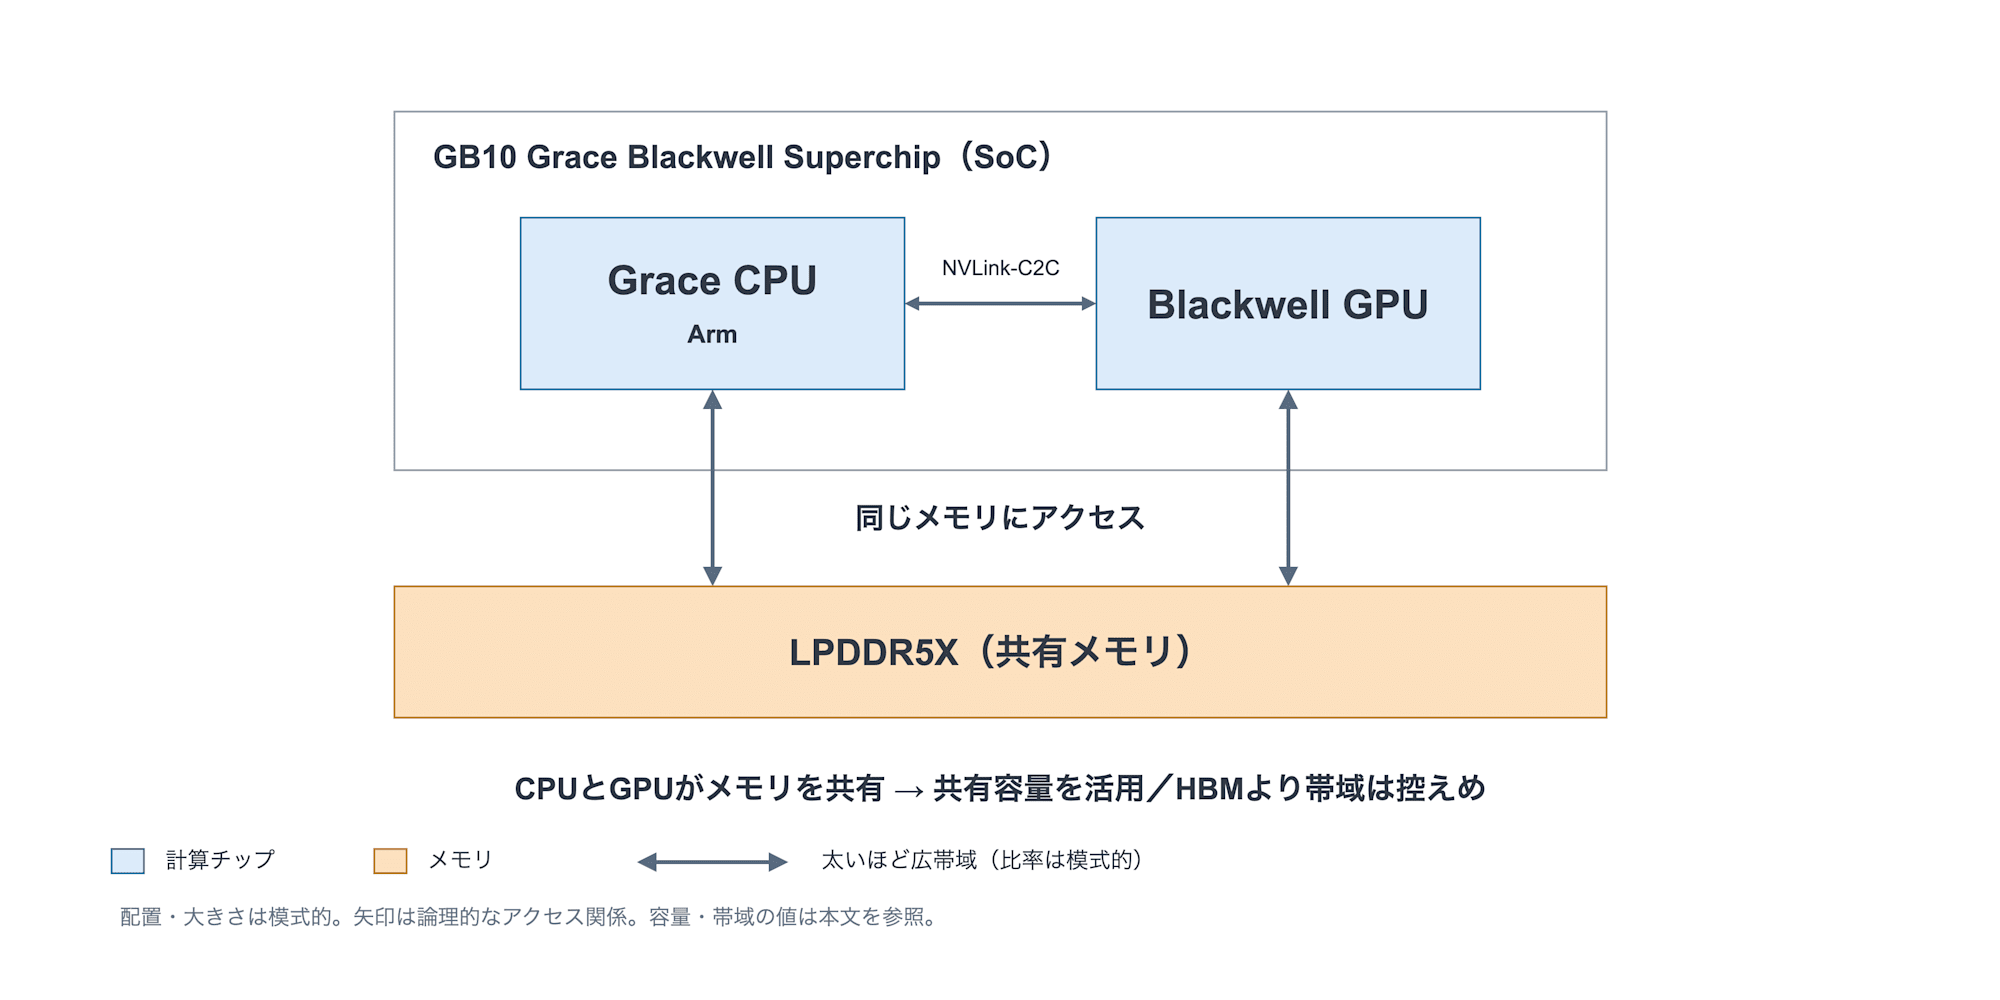
DGX Sparkに搭載されるSoCで、Grace CPU(Arm)とBlackwell GPUがNVLink-C2Cでつながり、128GBのLPDDR5Xを共有します(ユニファイドメモリ)。大きなモデルも載せられる一方、帯域は273GB/sと控えめです。
構成・名称の出典:NVIDIA公式・GB10の発表 。容量・帯域:DGX Spark仕様 。矢印は論理的なアクセス関係。
Apple Silicon(Mac Studio)
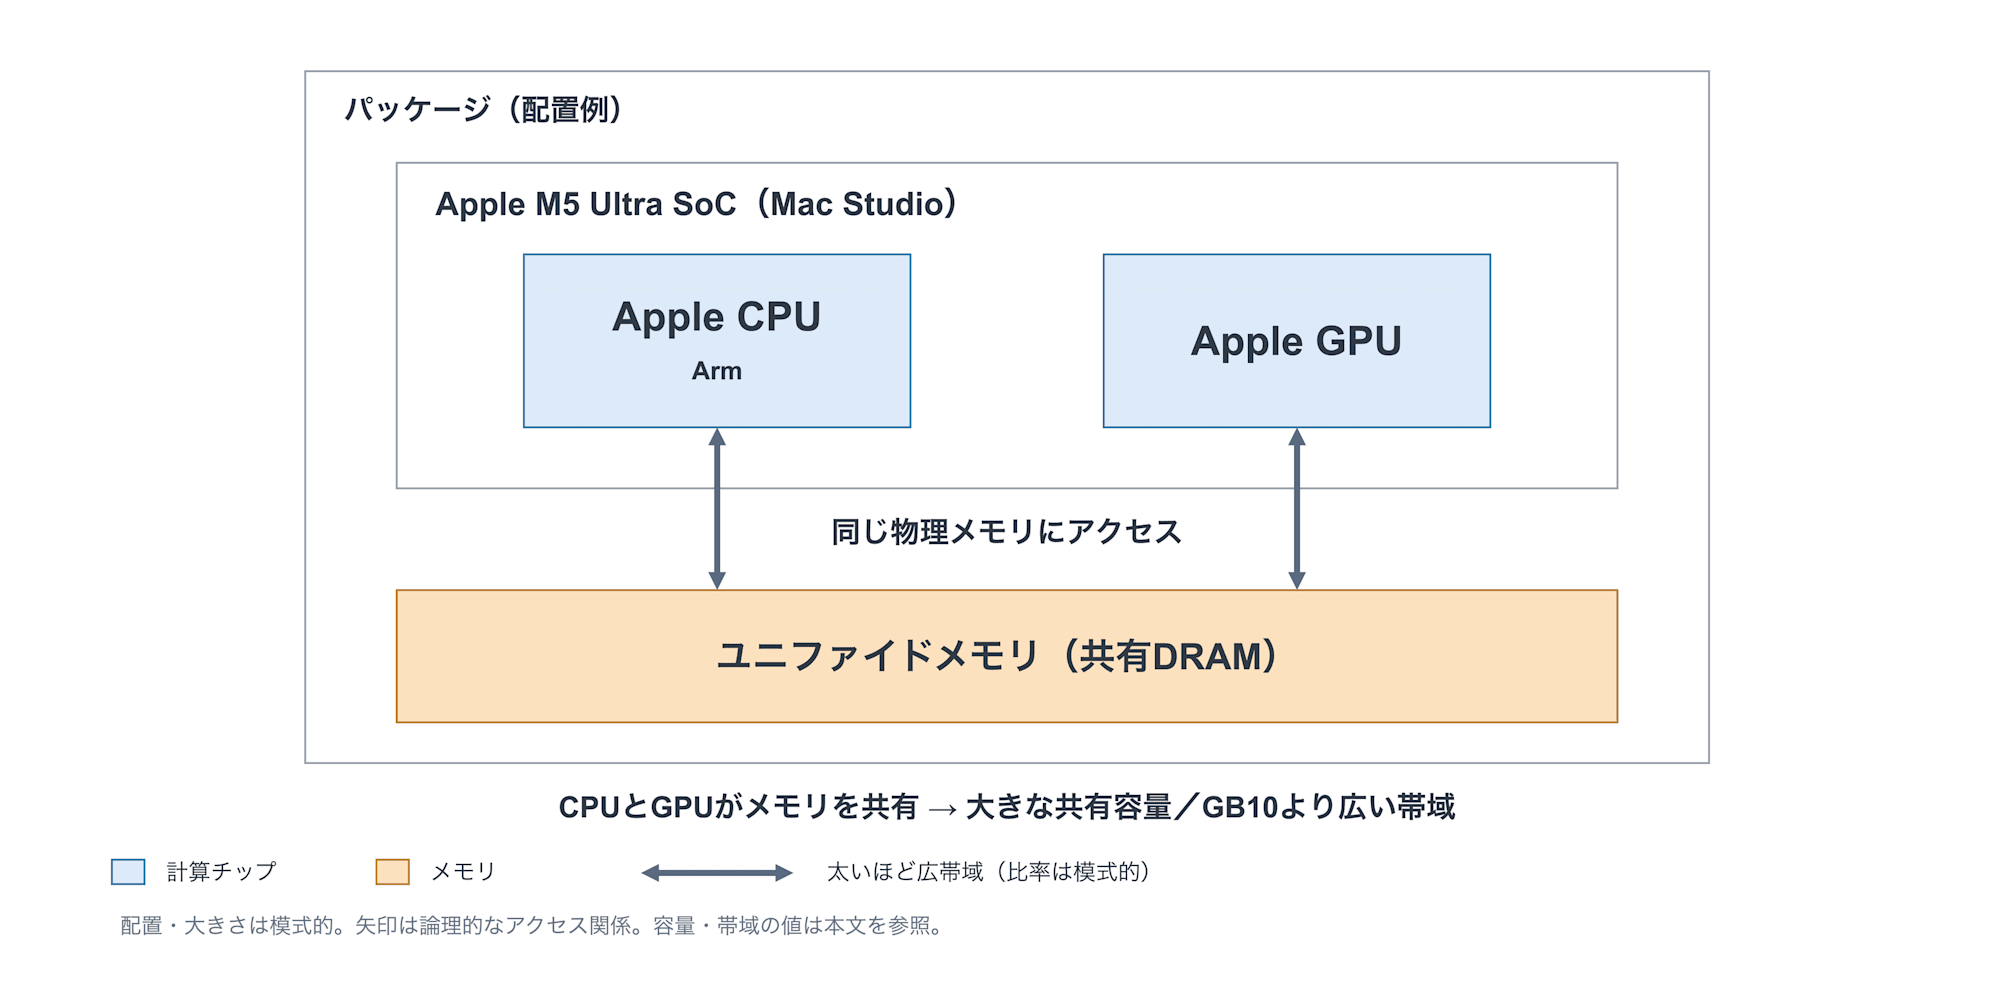
GB10と同じく、CPUとGPUが同じ物理メモリを共有するユニファイドメモリ構成です(内部の接続方式まで同じとは限りません)。違うのは帯域の大きさで、Mac StudioのM5 Ultraは最大512GBのユニファイドメモリを1.2TB/sで読み出せます。GB10(128GB・273GB/s)と比べると容量は4倍、帯域は約4.4倍で、グラフィックボードのRTX 5090(VRAM 32GB・約1.8TB/s)に近い帯域を、より大きな容量で持つ形です。
Mac Studioのチップ
ユニファイドメモリ
メモリ帯域
M5 Max
36〜128GB
460GB/s〜614GB/s
M5 Ultra
96〜512GB
1.2TB/s
ただし、メモリはOSやほかのアプリとも共有するため、搭載容量のすべてをLLMに使えるわけではありません。
容量・帯域の出典:Apple公式・Mac Studioの技術仕様 。配置は模式的なもので、実際のチップ構成を再現したものではない。
グラフィックボード(RTX 5090)
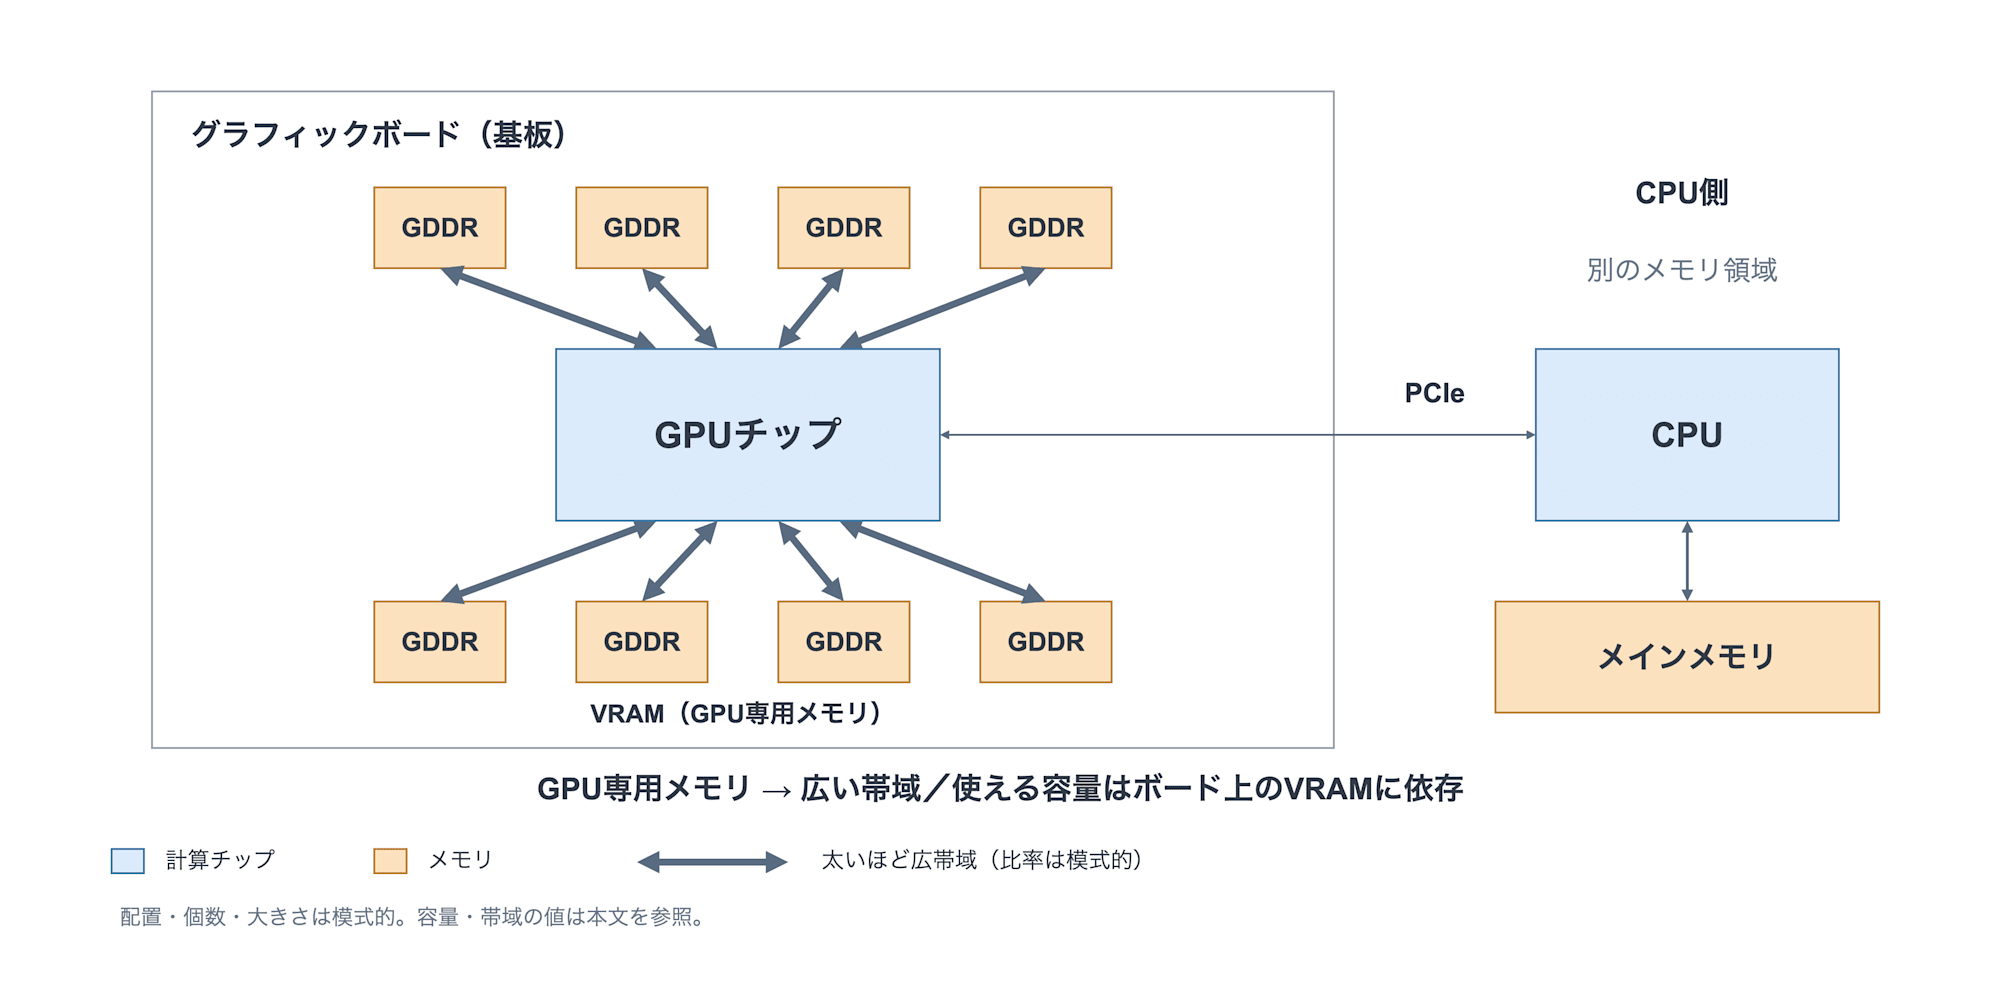
一般的なPCに挿すグラフィックボードでは、基板上にGPU専用のVRAM(GDDR)があり、CPU側のメインメモリとは別です。たとえばRTX 5090は32GBのGDDR7で、帯域は約1.8TB/sです。広帯域ですが、GPUに置けるモデルやKVキャッシュの量はVRAM容量で頭打ちになります。
製品例の仕様:NVIDIA公式・RTX 5090のメモリ容量と帯域 。メモリの個数・配置は特定製品を再現したものではない。
では、VRAMが足りなければマザーボード側のメインメモリ(DDR5)を足せばよいのでしょうか。llama.cppなどでは、VRAMに収まらない部分をメインメモリに置くこと(オフロード)ができますが、一般に生成速度は大きく落ちます。ざっくり言うと、メインメモリは計算するチップから見て読み出しの経路が細いためです。
VRAM(RTX 5090)
メインメモリ(DDR5)
GB10
容量
32GB
32〜128GB程度
128GB(CPUとGPUで共有)
帯域の目安
約1.8TB/s
約90GB/s(DDR5-5600、2チャネル)
273GB/s
GPUからの経路
直結
PCIe 5.0 x16経由(片方向約64GB/s)
直接アクセス
たとえば重みのうち20GBをメインメモリに置くと、1トークンごとにその20GBを約90GB/sで読むだけで約0.2秒かかります。合計容量が足りていても、速く読めるメモリに載っていなければ、decodeは速くなりません。
さいごに
GPT-2型の小さなモデルを例に、prefillとdecodeの流れを追いながら、KVキャッシュが何を使い回しているのかを見てきました。
Attentionは難しそうに見えますが、中身は行列の積と内積、それにsoftmaxくらいで、今回のように4トークン・1ヘッドに絞れば手で追える計算です。そして、causal maskによって過去のトークンの k v
また、prefillは計算性能(compute)、decodeはメモリ帯域が効く、という違いを意識しておくと、ローカルLLMを扱うときの判断がしやすくなります。どのハードウェアを選ぶか、どこまで量子化するか、コンテキスト長をどれくらいにするか、といった判断の多くは、読み出すデータの量とメモリ帯域の話に置き換えて考えられるからです。実際の速度はCUDAカーネルや推論エンジンの実装にも左右されますが、大まかな見当をつけるうえで、この見方はよく効きます。
今回は記事の長さの都合で、説明用の設定を図と数式で追うところまでにとどめました。今後は、実際にこの記事の設定(埋め込み次元384・6ヘッド・3層)程度の小さなモデルを作り、KVキャッシュの有無による速度やメモリ使用量の違いを検証してみたいと思います。
参考文献
この記事を書くにあたって、特にAttentionやTransformerの仕組みの理解では、次の書籍を大いに参考にしました。トークナイザからTransformer、事前学習・事後学習までを実装しながら学べる一冊です。
斎藤 康毅『ゼロから作るDeep Learning ❻ ―LLM編』オライリー・ジャパン、2026年
https://www.oreilly.co.jp/books/9784814401611/