TiDB Cloud LakeのMySQLデータソースにTiDB Cloudを直接指定して同期してみた

こんにちは、ゲームソリューション部のsoraです。
今回は、TiDB Cloud LakeのMySQLデータソースにTiDB Cloudのクラスタを直接指定して、データを同期できるか試してみました。
先に結論
MySQLデータソースにTiDB Cloudを直接指定すると、Snapshot(全件コピー)は取り込めた- ただし
SSL Modeをrequireにする、binlog_formatをROWにする、Primary Keyを入れる、の3つが必要だった - CDCによるリアルタイム同期は、TiDBがMySQLのbinlogを流さないのでできなかった
- 代わりに
Archive Scheduleで「昨日分」を日次で差分同期でき、MERGEで重複しないので継続同期の代わりになった - 取り込みは遅めで、裏でステージングテーブルが積み上がる点には注意が必要
TiDB Cloud側の準備
同期元となるTiDB Cloudのクラスタを用意します。
今回はTiDB Cloud Starterにappdb.app_logsというテーブルを作り、アプリケーションログを模したダミーデータを入れました。
テーブル定義はこちらです。
attributes列にJSONを持たせて、Lake側でどう変換されるかも見られるようにしています。
CREATE TABLE appdb.app_logs (
    log_id     BIGINT PRIMARY KEY,
    level      VARCHAR(16) NOT NULL,
    service    VARCHAR(64) NOT NULL,
    message    TEXT,
    attributes JSON,
    logged_at  DATETIME NOT NULL,
    KEY idx_logged_at (logged_at)
);
ダミーデータの作り方は、以下の記事で使ったスクリプトと同じものを使っています。
行数は最初50万行で試したのですが、後述のとおり取り込みが遅くて時間がかかったので、途中から2万行に減らしました。
あわせて、TiDB側でbinlog_formatをROWに変えておきます。
SET GLOBAL binlog_format = 'ROW';
これはSnapshotの実行時に必要です。
LakeのMySQL連携は接続時にbinlog_formatがROWかどうかを見ていて、TiDBは既定でSTATEMENTを返すため、ROWにしておかないとbinlog must ROW formatというエラーで実行が止まります。
データソースの登録
Data > Data Sources > Create Data Sourceで、ServiceにMySQL – Credentialsを選びます。
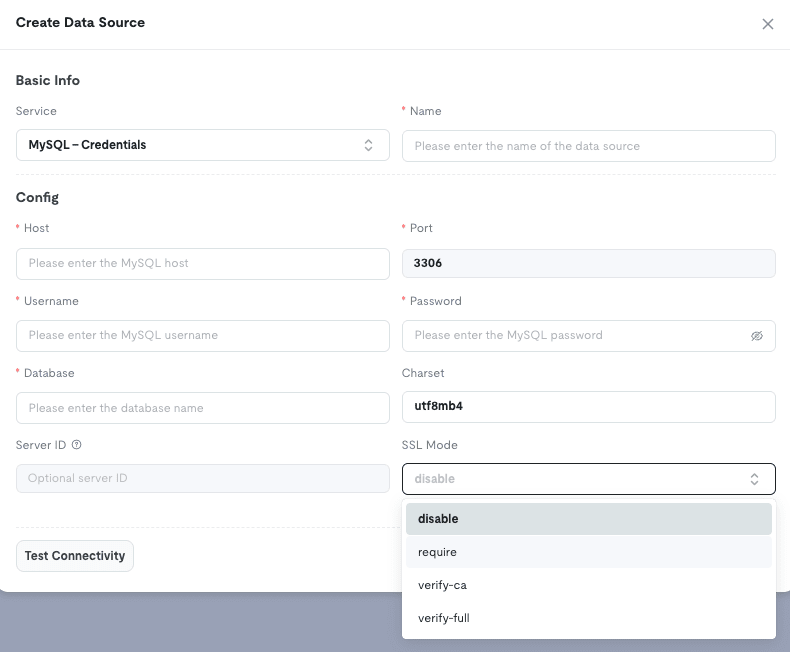
入力する値はこちらです。
| 項目 | 値 |
|---|---|
| Host | gateway01.<region>.prod.aws.tidbcloud.com |
| Port | 4000 |
| Username | TiDB CloudのSQLユーザー |
| Password | パスワード |
| Database | appdb |
| SSL Mode | require |
SSL Modeはrequireを選びます。
公式ドキュメントには載っていないのですが、実際のフォームにはSSL Modeのドロップダウンがあり、disable / require / verify-ca / verify-fullの4つから選べます。
既定のdisableはTiDBがTLS必須なので繋がりません。
Test Connectivityを押すと、TiDB側のエラーがそのまま返ってきます。
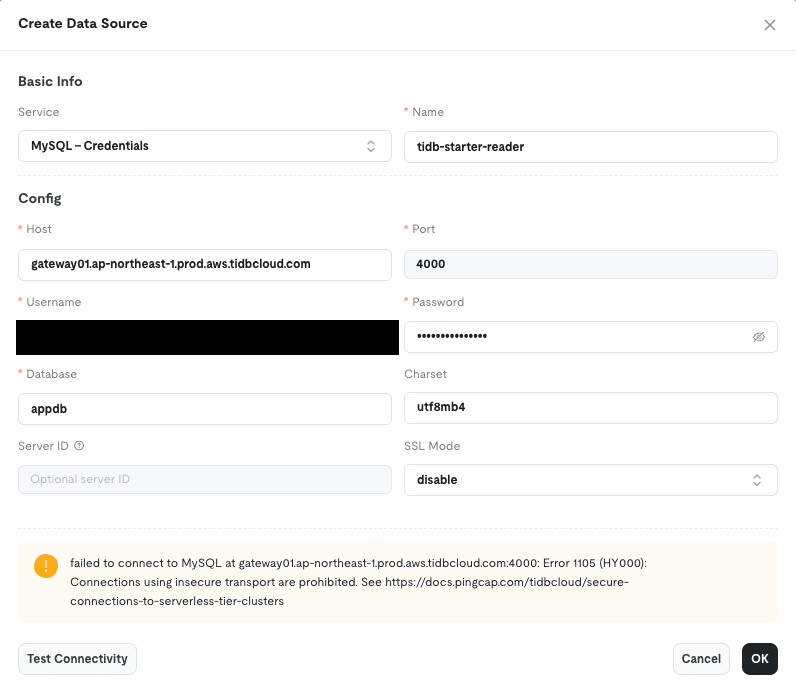
failed to connect to MySQL at gateway01...:4000: Error 1105 (HY000): Connections using insecure transport are prohibited.
verify-caとverify-fullは、この接続テストは通るのですが、後のタスク実行でTLS設定のエラーになって落ちます(後述)。
そのため、実行まで通るrequireにしておくのが無難でした。
requireでTest Connectivityが通ったら保存します。
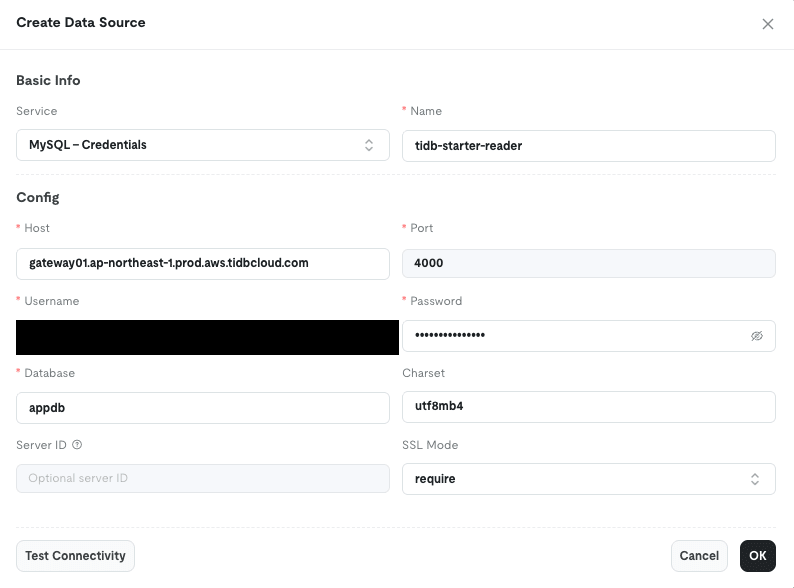
注意点: TiDB側で接続元を見ると、送信元IPはLakeを作った東京リージョンではなく、オレゴン(us-west-2)のIPでした。
接続のたびにIPも変わりました。
Dedicatedで送信元をアクセスリストに登録する場合は、この点に注意が必要です。
Snapshotタスクの作成と実行
Data > Data Integration > Create Taskでタスクを作ります。
Sync Modeは3つから選びます。
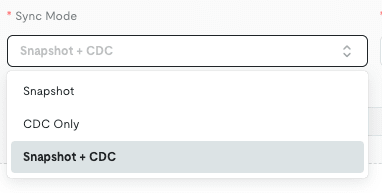
| モード | 内容 |
|---|---|
| Snapshot | 一度きりの全件コピー |
| CDC Only | binlogを読んで変更を流し続ける継続同期 |
| Snapshot + CDC | 全件コピーしてから継続同期に移る |
ここではSnapshotを選びます。
SnapshotにするとSnapshot WHERE ConditionとArchive Scheduleの欄が出ますが、まずはWHEREなし、Archive ScheduleもOffで進めます。
Primary Keyにはlog_idを入れます。
Snapshotでは任意に見えるのですが、空のままだと実行時に次のエラーで落ちます。
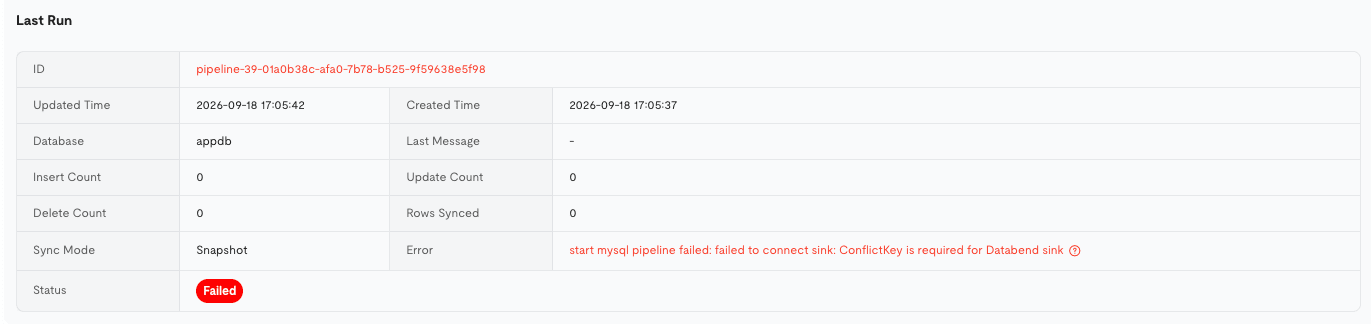
start mysql pipeline failed: failed to connect sink: ConflictKey is required for Databend sink
Databend sinkと出ているとおり、Lakeの中身はDatabendです。
取り込みは主キーでのMERGEで書かれるので、Primary Keyが必須でした。
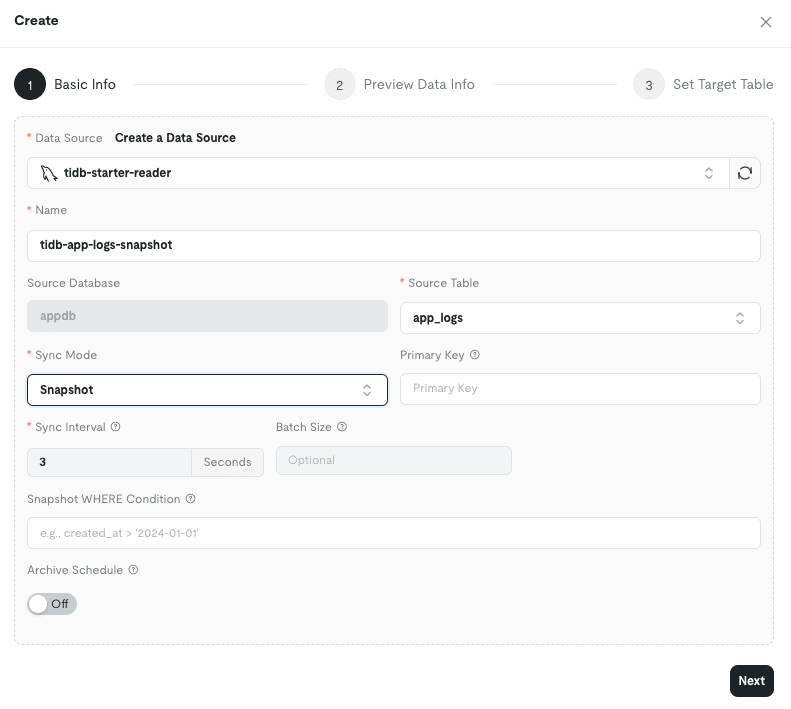
Nextで進むとプレビューが出て、ターゲットではWarehouse・データベース・テーブル名を指定します。
Upload Data ToでNew Tableを選ぶと、列のマッピングが表示されます。
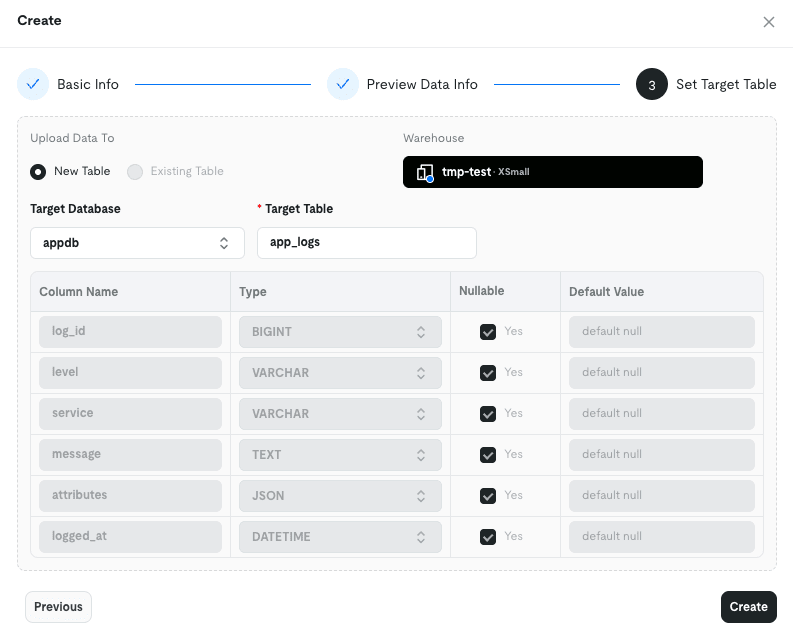
CreateしてStartを押すと、取り込みが始まります。
ここまでで押さえる設定は3つでした。
| 設定 | 値 | 入れないとどうなるか |
|---|---|---|
SSL Mode |
require |
verify-*は接続テストは通るが実行でTLSエラー |
binlog_format |
ROW |
binlog must ROW formatで落ちる |
Primary Key |
log_id |
ConflictKey is requiredで落ちる |
注意点: requireではなくverify-fullやverify-caで保存すると、接続テストは通るのに、実行時だけ次のエラーになります。
接続テストは通るので、保存できたからといって安心はできません。
start mysql pipeline failed: failed to connect source: failed to create canal: writeAuthHandshake: tls: either ServerName or InsecureSkipVerify must be specified in the tls.Config
取り込み速度の確認
Snapshotは無事に走りましたが、驚くほど遅く、2万行の取り込みに約3分半かかりました。
TiDB側で何が投げられているかを見ると、Lakeは主キーでページングしながら1000行ずつ読んでいます。
SELECT * FROM `appdb`.`app_logs` WHERE `log_id` > 1000 ORDER BY `log_id` LIMIT 1000
このSELECT自体はTiDB側で数ミリ秒から数十ミリ秒で終わっていました。
遅いのはLakeへの書き込みの方です。
Lake側のSQL Historyを見ると、書き込みの正体が分かりました。
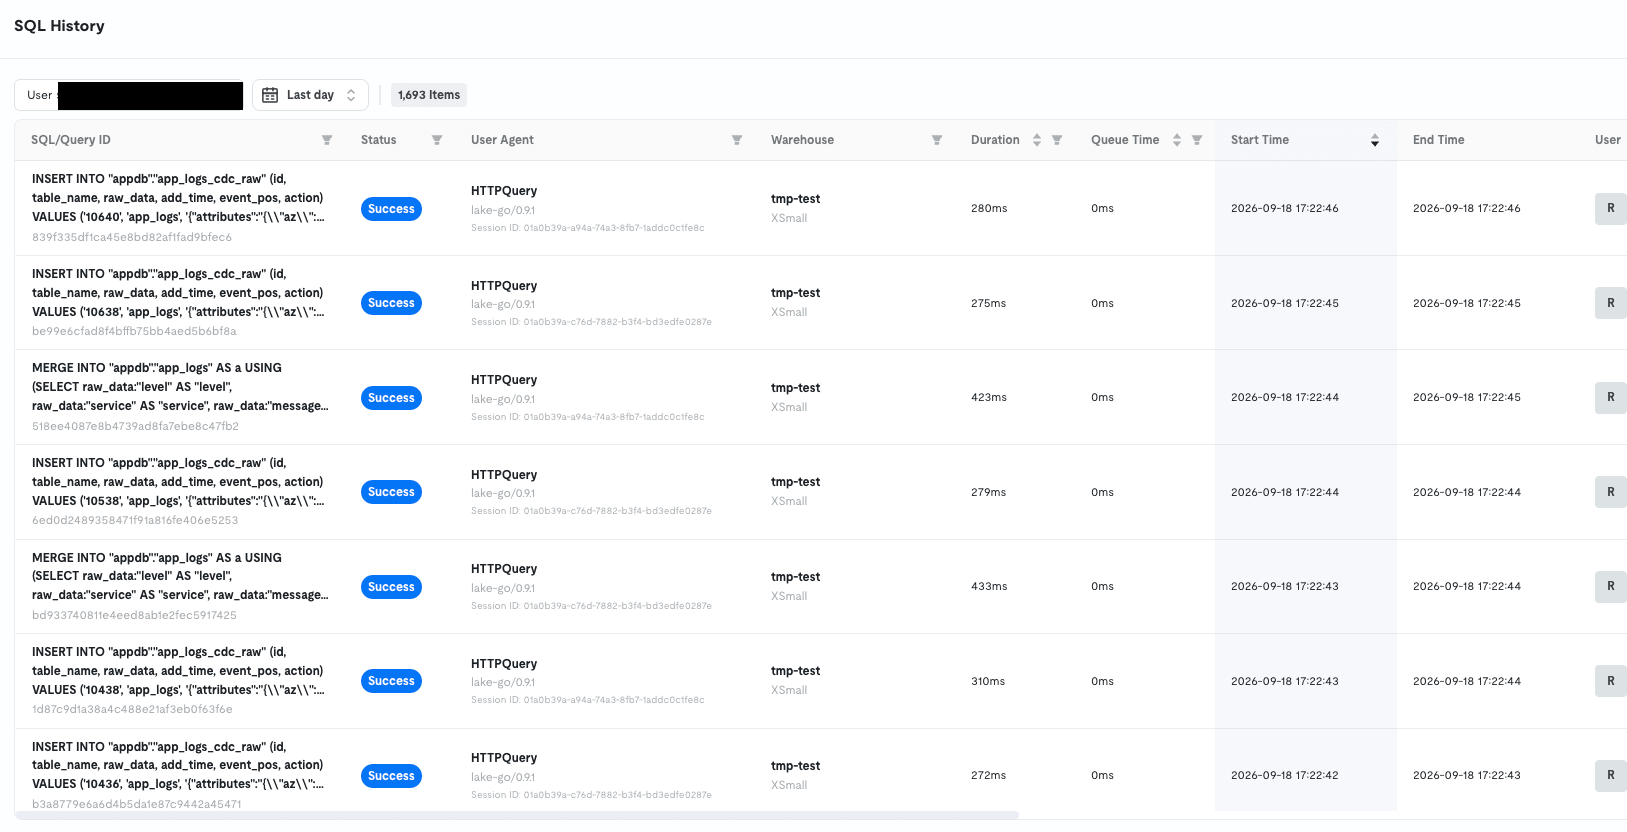
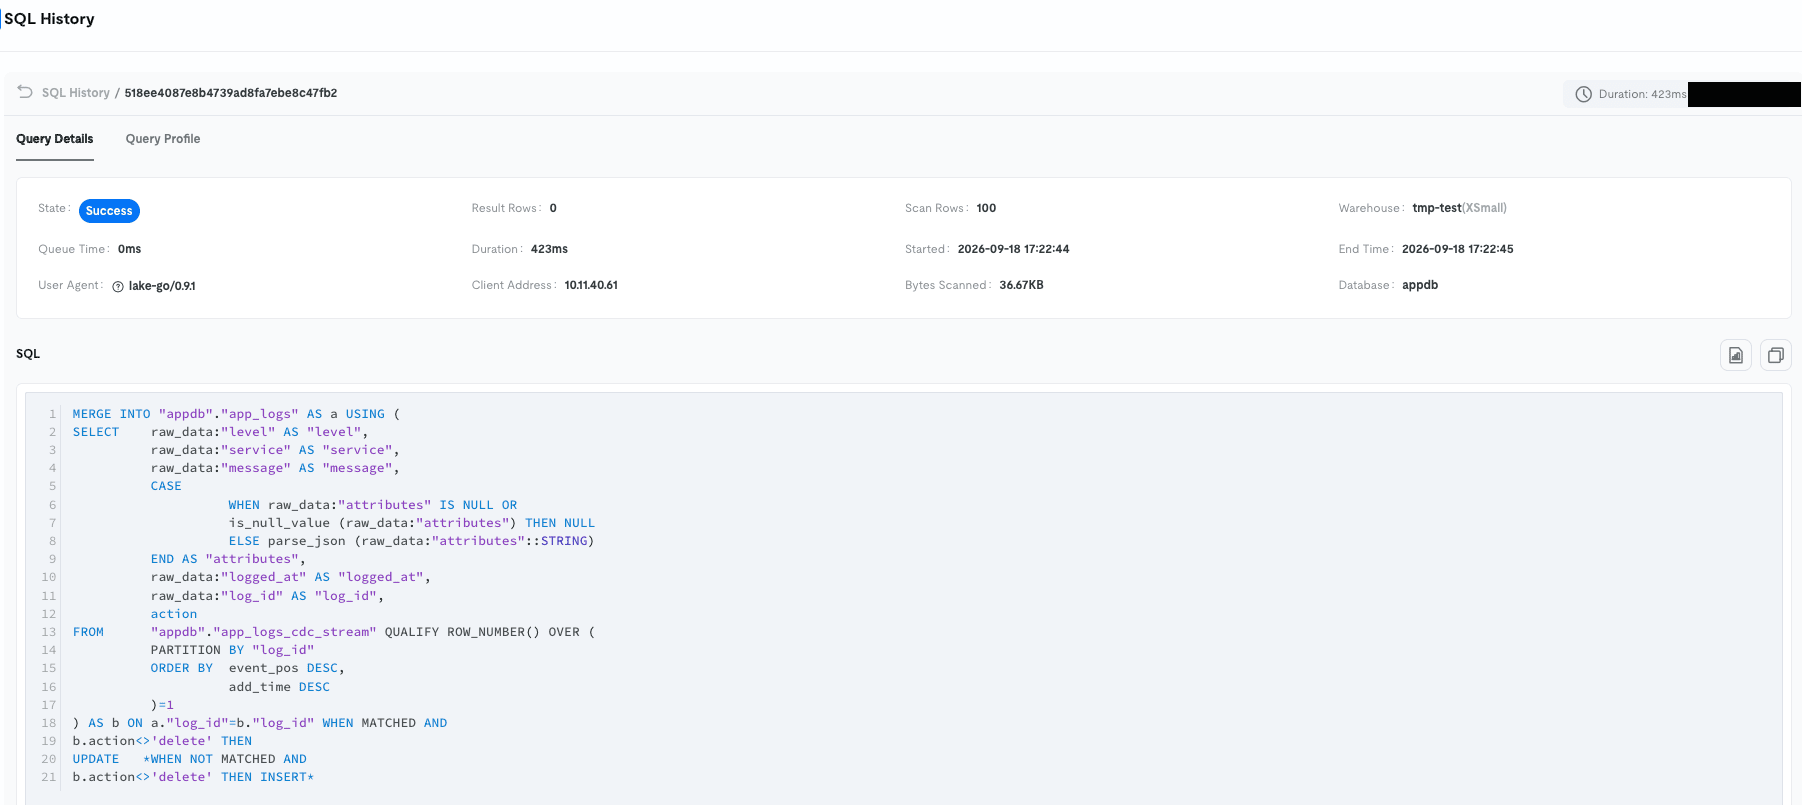
読んだ行を100行ごとにステージングテーブルへINSERTし、200行ごとに本体テーブルへMERGEしています。
Snapshotモードでも、裏ではCDC用のステージングテーブルとMERGEの経路を通っていました。
1つのMERGE文のQuery Profileを見ると、時間のほぼ半分がストレージへのコミット(CommitSink)に使われていました。
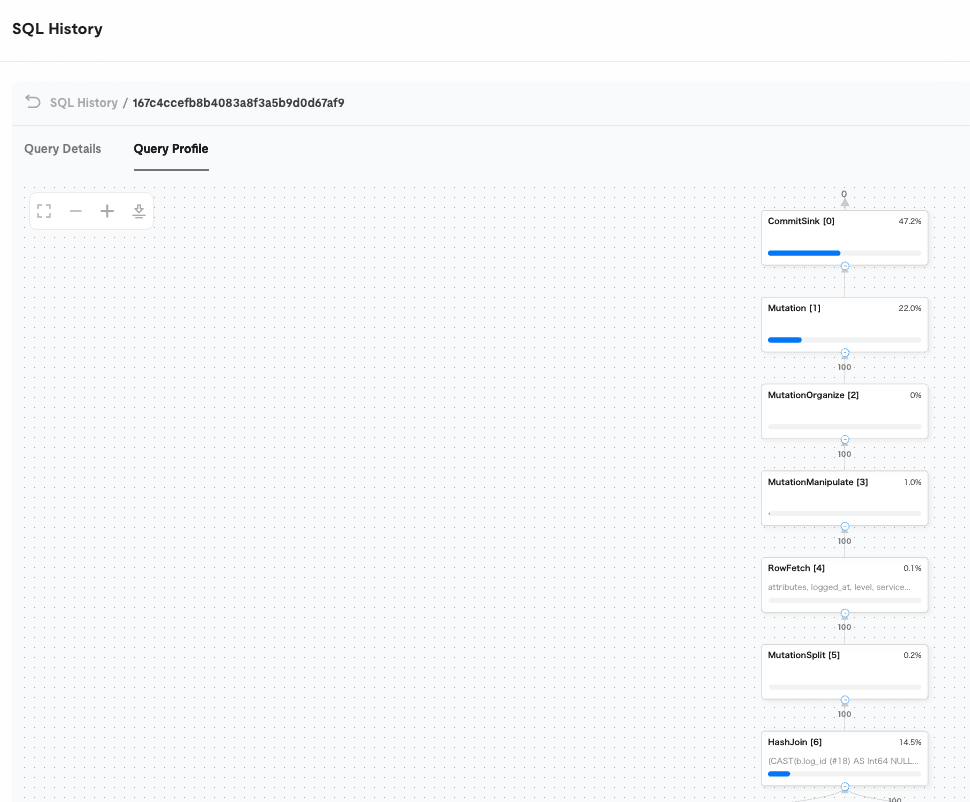
Databendは1回の書き込みごとにParquetファイルとメタデータをオブジェクトストレージに書きます。
その固定コストが、100行・200行という小さい単位で何千回も積み上がるので遅くなる、というわけです。
なお、型の変換はS3経由で取り込んだときと同じで、jsonはVARIANTに、DATETIMEはTIMESTAMPになりました。
注意点: 取り込みが終わったあとにテーブルを見ると、ステージングテーブルapp_logs_cdc_rawが本体と同じ行数だけ残っていました。
raw_data列に元の1行をまるごとJSONで持つので、今回のデータでは本体の約1.4倍のサイズになっていました(本体795.75KBに対して1.08MB)。
再実行するときの注意点
同じSnapshotをやり直すときは、Lake側のテーブルを消すだけでなく、タスクごと作り直す必要がありました。
検証の途中で行数を減らすため、Lake側のテーブルを消して同じタスクをもう一度Startしたところ、なぜか先頭の1000行が欠けて19000行しか入りませんでした。
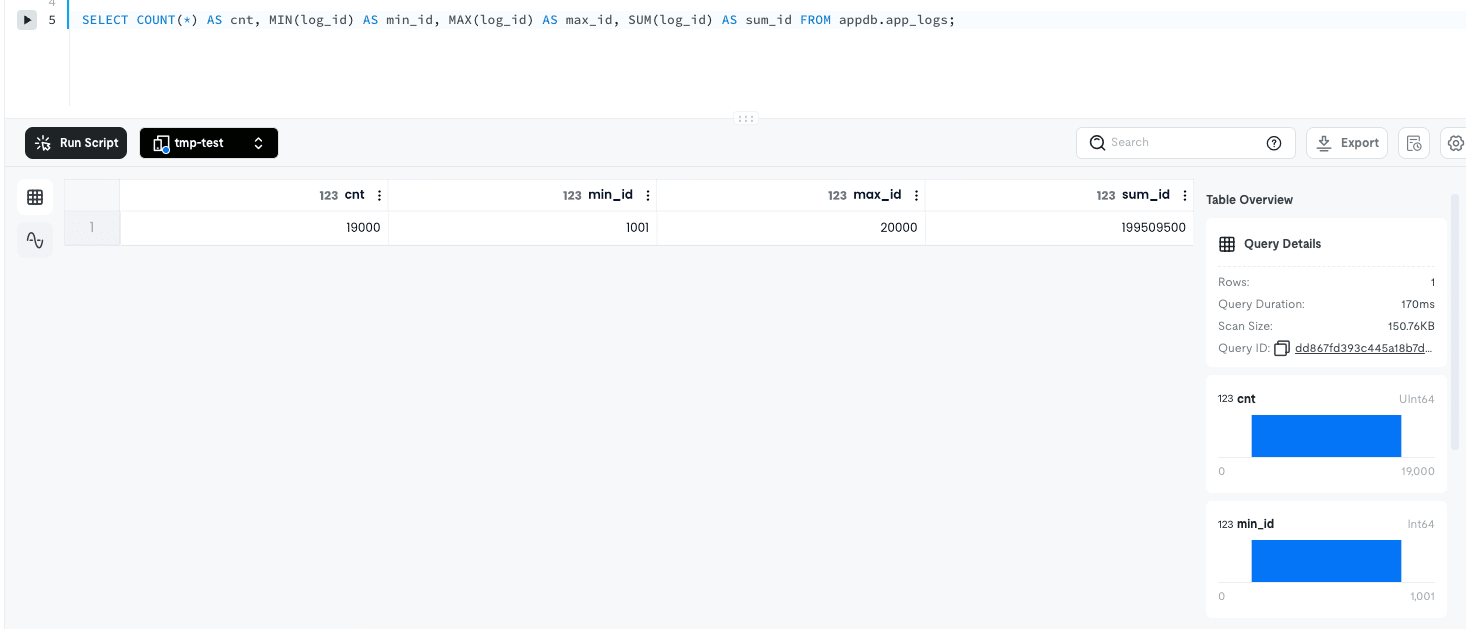
TiDB側の履歴を見ると、2回目以降の実行はWHERE log_id > '1000'から読み始めていました。
最初のバッチ位置がタスクのチェックポイントとして残っていて、Lake側のテーブルを消してもリセットされないのが原因でした。
同じソーステーブルは1つのタスクにしか紐づけられないので、タスクを削除して新しく作り直したところ、今度は先頭からきちんと2万行入りました。
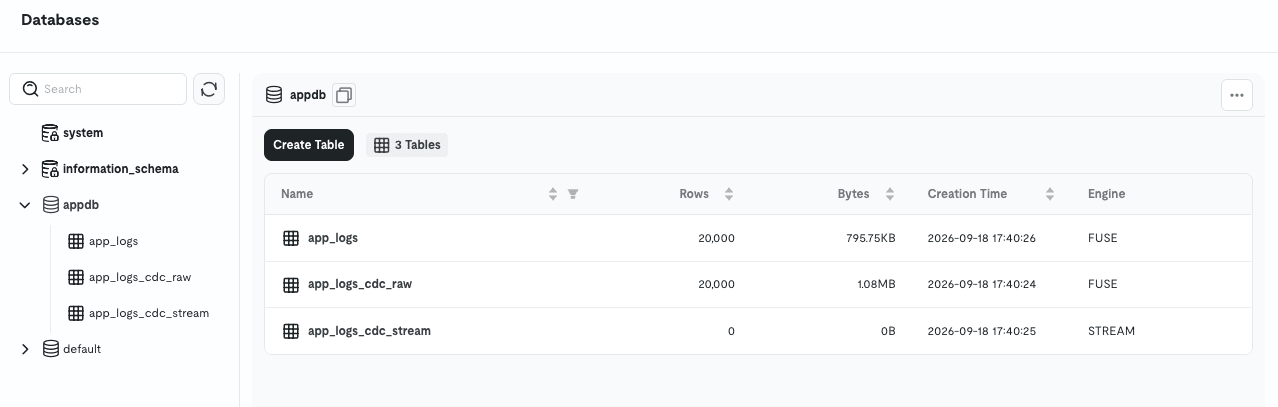
Run HistoryにはSuccessと表示されるので、行数を突き合わせないと欠けに気づけない点も注意です。
CDCモードの動作確認
ここまではSnapshotの話でした。
継続同期のCDCも試しましたが、同期元がTiDB Cloudの場合は動きませんでした。
CDCは同期元で後から起きた変更をLakeに流し続ける仕組みで、MySQLではその変更をbinlogから読みます。
TiDBはMySQL互換のインターフェースを持ちますが、MySQLのレプリケーションプロトコルには対応していないと公式ドキュメントに記載があります。
そのためbinlogをレプリケーションプロトコルで読むCDCは、TiDBに対しては成立しません。
このことから、モードごとの結果が説明できます。
CDC Onlyは失敗はしません。
Runningのままになり、TiDB側を見るとレプリカとして接続を張ったまま、来ないbinlogイベントを待ち続けていました。
ターゲットテーブルすら作られず、Warehouseだけが動き続けます。
失敗が出ない分、かえって気づきにくい動きです。
Snapshot + CDCは、逆にすぐ失敗しました。
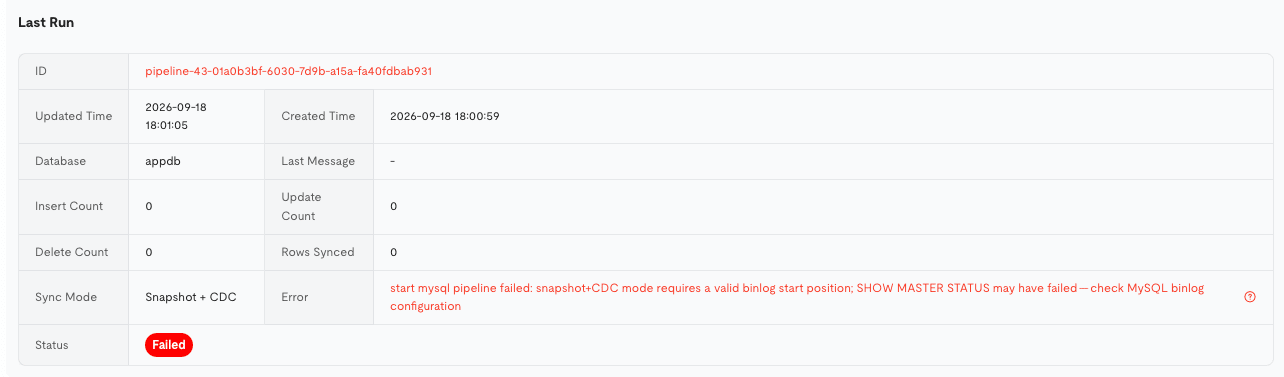
start mysql pipeline failed: snapshot+CDC mode requires a valid binlog start position; SHOW MASTER STATUS may have failed
このモードはSnapshotのあとにその時点のbinlog位置からCDCを継ぐ設計です。
そのためSnapshotを始める前に、有効なbinlog開始位置を確保しようとします。
TiDBのSHOW MASTER STATUSはそれらしい値を返すのですが、MySQLのbinlog位置としては再開に使えないので、Snapshotに進む前に止まってしまいました。
整理するとこうなります。
| モード | TiDBに対する結果 |
|---|---|
| Snapshot | 通る |
| CDC Only | 失敗しないが、イベントを待ってぶら下がる |
| Snapshot + CDC | binlog位置が無効で即失敗 |
TiDBの変更履歴はbinlogではなくTiCDCで扱います。
継続的にLakeへ流したい場合は、TiCDCでS3に書き出して読む経路になります。
この経路にはTiCDCが必要で、TiDB Cloud DedicatedかEssential以上で使えます。
Archive Scheduleでの定期実行
CDCが使えないなら、Snapshotを定期実行すればよいのでは、というのが最後の確認です。
Snapshotタスクを編集してArchive ScheduleをOnにすると、4つの項目が出ます。
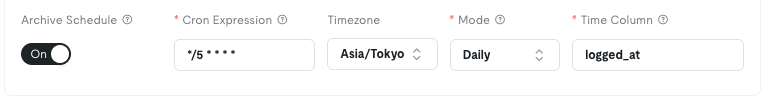
| 項目 | 入れた値 | 役割 |
|---|---|---|
| Cron Expression | */5 * * * * |
いつ実行するか(今回は5分ごと) |
| Timezone | Asia/Tokyo |
日付境界の基準 |
| Mode | Daily |
取り込む範囲の幅(1日) |
| Time Column | logged_at |
どの列で範囲を切るか |
保存すると、タスクのステータスはStoppedのままになります。
Startを押す必要はなく、放置しておくと次のCronのタイミングで自動的にRunningに変わって実行されました。
実行時にTiDBへ投げられるSQLは以下です。
SELECT * FROM `appdb`.`app_logs`
WHERE logged_at >= '2026-09-17 00:00:00' AND logged_at < '2026-09-18 00:00:00'
ORDER BY `log_id` LIMIT 1000
Mode: DailyとTime Column: logged_atから、「昨日1日分」の範囲を自動でWHEREに付けています。
全件ではなく差分だけを読むわけです。
これを確かめるため、TiDB側に昨日の日付で500行を追加してみました。
すると次の自動実行でその500行だけが読まれて、本体テーブルapp_logsが2万行から20500行に増えました。
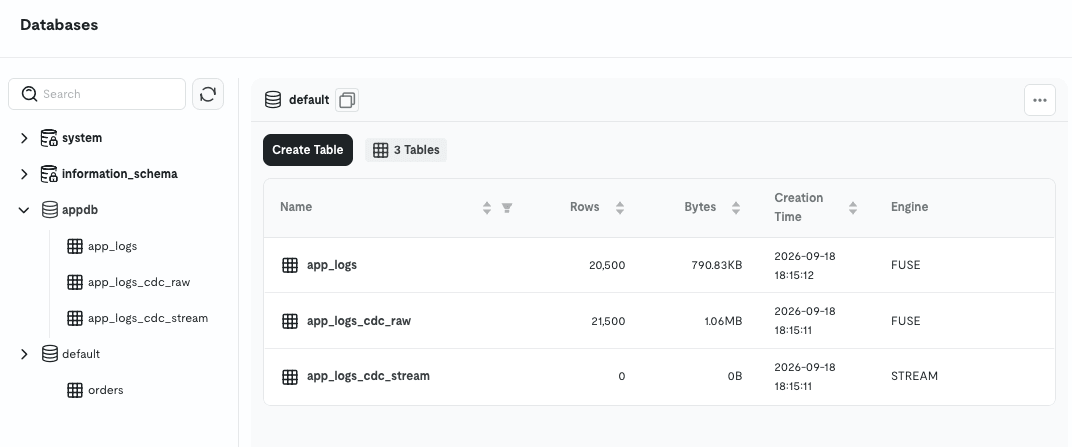
このあと何も足さずに5分ごとの実行を数回待ちましたが、本体app_logsは20500行のままでした。
本体への書き込みは主キーでのMERGE(upsert)なので、同じ範囲を何度読み込んでも上書きされて重複しません。
Time Columnで区切った差分を、日次で安全に取り込み続けられる、ということです。
リアルタイムの同期ではありませんが、「TiDBに溜まったログを定期的にLakeへ逃がす」という用途にはこれで十分でした。
本体app_logsが20500行なのに対して、ステージングテーブルapp_logs_cdc_rawは21500行になっています。
ステージングは取り込みの途中でTiDBから読んだ行を一時的にためる追記専用のテーブルで、本体はここからMERGEで重複を消しながら書かれます。
注意点
- ステージングは同じ部分を繰り返し読むことがある。
- ステージングの21500行は、初回の2万行に、スケジュールで読んだ500行が3回分足された数(2万 + 500 × 3)です。
- 今回は
ModeをDailyにしたまま5分ごとに回したので、3回とも同じ「昨日(9/17)分」の部分を読み、同じ500行を3回追記していました。 - 区切りは
Daily/Weekly/Monthlyの3つからしか選べないため、それより短い間隔で回すと、このように同じ部分を繰り返し読む形になります。 - 日付が変われば読む部分もずれるので、
0 1 * * *のように1日1回で回す実運用では、毎回別の日を読み、同じ行を読み直すことはありません。
- ステージングは自動では消えない。
- 追記専用で、今回の検証では自動削除されませんでした。
- 1日1回の運用でも日々の分は積み上がっていくので、不要になったら手動で削除するなど、掃除は別途考えておくとよさそうです。
- 実行のたびにWarehouseが起動する。
- 5分ごとのような短い間隔にするとそのたびに課金されるので、日次のアーカイブなら
0 1 * * *のように1日1回で十分です。
- 5分ごとのような短い間隔にするとそのたびに課金されるので、日次のアーカイブなら
最後に
今回は、TiDB Cloud LakeのMySQLデータソースにTiDB Cloudを直接指定して、Snapshotとその定期実行でデータを同期できるかを試してみました。
CDCはTiDBがMySQLのbinlogを流さないのでできませんが、Archive Scheduleを使えばS3を挟まずに定期的な差分同期ができました。
この記事がどなたかの参考になれば幸いです。