public previewのTiDB Cloud Lakeを触ってみた

こんにちは、ゲームソリューション部のsoraです。
今回は、2026年6月30日にpublic previewが始まったTiDB Cloud Lakeを触ってみたことについて書いていきます。
S3に置いたファイルをロードせずにSQLで読めるところと、TiDB Cloudのクラスタとはまったく別のスタックで動いているところが気になったので、そのあたりを中心に確認していきます。
なお、本記事の内容は2026年9月15日時点のもので、public preview中のためGAで変わる可能性があります。
TiDB Cloud Lakeとは
分析ワークロード向けのデータウェアハウスサービスです。
コンピュートとストレージを分離した構成で、コンピュートはWarehouseという単位になっています。
使うときだけ起動して、使わないときは止めておけます。
データの置き場所については、料金ページに「physically stored in Amazon S3」と書かれていました。
ストレージの料金もS3の価格がベースになっています。
SQLでの分析に加えて、全文検索・ベクトル検索・地理空間分析が同じエンジンに入っています。
またS3上のファイルを、テーブルにロードせずそのままクエリすることもできます。
TiDB Cloudのクラスタとの関係
一番気になっていたのがここでした。
TiDBにはTiKV(行ストア)とTiFlash(列ストア)があるので、TiDB Cloud Lakeがそこにどう絡むのかが分かりにくかったためです。
触ってみた結果、TiDB Cloudのクラスタと連携させて使う前提のサービスではありませんでした。
クラスタを1つも持っていなくてもTiDB Cloud Lake単体で作成できますし、コンソールの入口も別です。
同じTiDB Cloudのアカウントと請求に乗っているという点で繋がっているだけ、という理解をしています。
別のスタックで動いている
TiDB Cloud Lakeは、ストレージ層がFuseEngineという別エンジンです。
メタデータも独立したRaftクラスタを持っていて、クラスタ側のPDとは関係ありません。
クラスタ側もTiDB Xというアーキテクチャでオブジェクトストレージを永続層に使うようになっています。
ただしそちらはTiKV相当とTiFlash相当がその上のキャッシュ層として動く構成で、TiDB Cloud Lakeとは別物です。
クラスタからTiDB Cloud Lakeへのデータ投入は、MySQL Integration Task(スナップショット + CDC)やS3経由のロードとして用意されています。
TiFlashとの使い分け
| 項目 | TiFlash(HTAP) | TiDB Cloud Lake |
|---|---|---|
| データの置き場所 | TiDBクラスタ内、TiKV(行ストア)から同期 | TiDB Cloud Lake側の別ストレージ、別途取り込みが必要 |
| 対象データ | TiDBに入っているデータのみ | S3のログ、Kafka、他DB、Icebergも混ぜられる |
S3のログのようにクラスタの外にあるデータも混ぜて分析したい場合や、長期間貯めたデータをまとめて集計したい場合がTiDB Cloud Lakeの出番だと思います。
触ってみる
TiDB Cloud Lakeを作成する
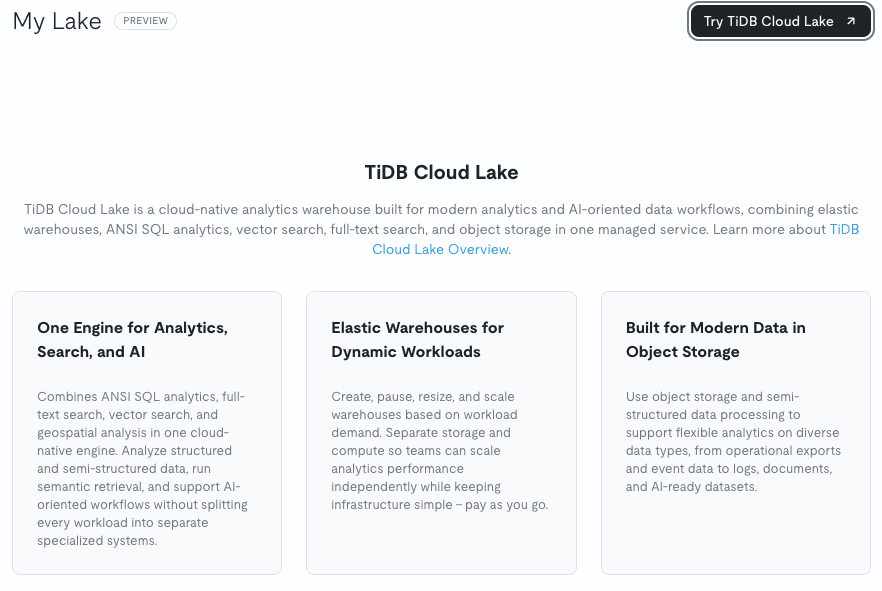
TiDB Cloudのコンソールの左ナビゲーションの「My Lake」から「Try TiDB Cloud Lake」で作成画面に入ります。
作成後のコンソールも独立していて、クラスタ側の画面とは行き来しません。
請求画面だけはTiDB Cloud Lake側に無く、TiDB Cloud側のBillingで見る形になっています。
作成ダイアログでは、名前・プラン・クラウド・リージョンを指定します。
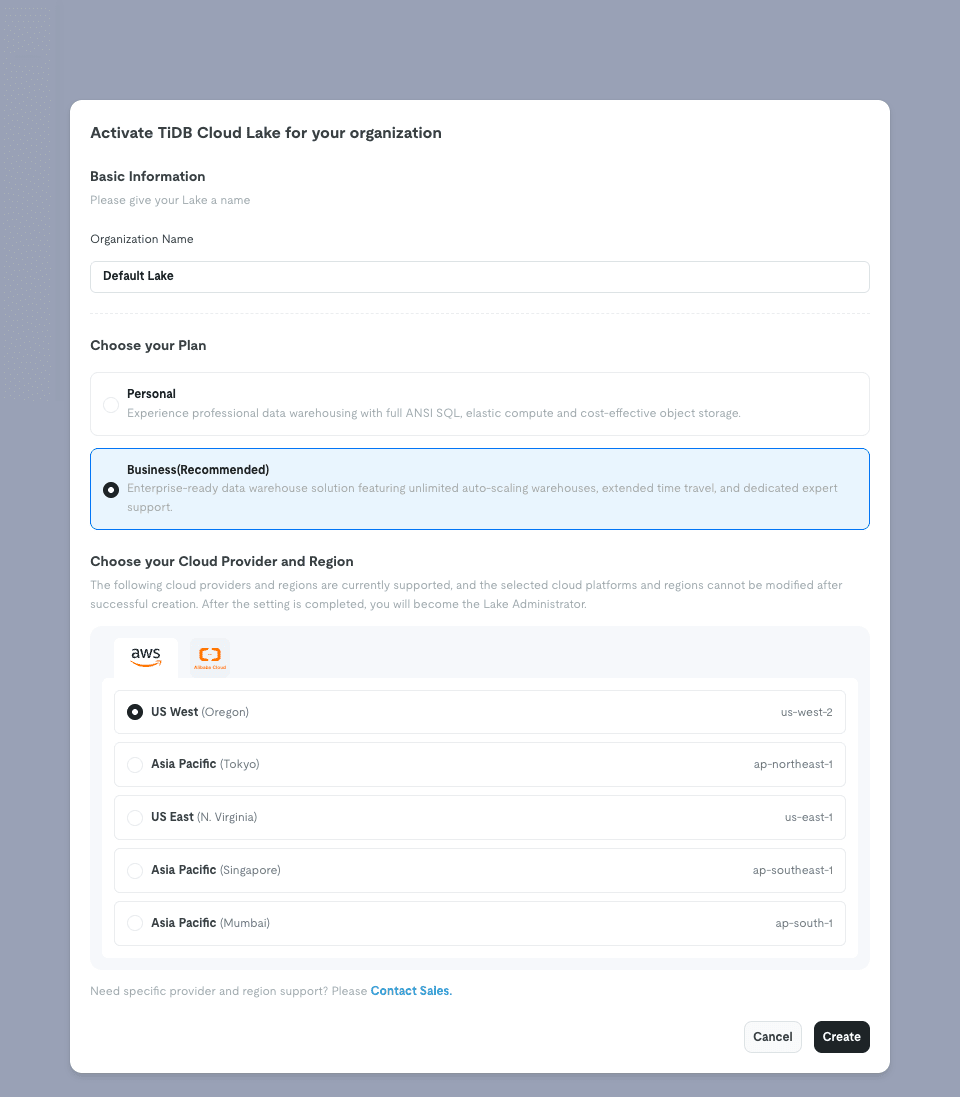
クラウドとリージョンは作成後に変更できないので、ここだけ注意が必要です。
The following cloud providers and regions are currently supported, and the selected cloud platforms and regions cannot be modified after successful creation.
選べるクラウドはAWSとAlibaba Cloudで、AWSでは東京(ap-northeast-1)を含む5リージョンがありました。
今回はPersonalプラン、AWSの東京リージョンで作成しています。
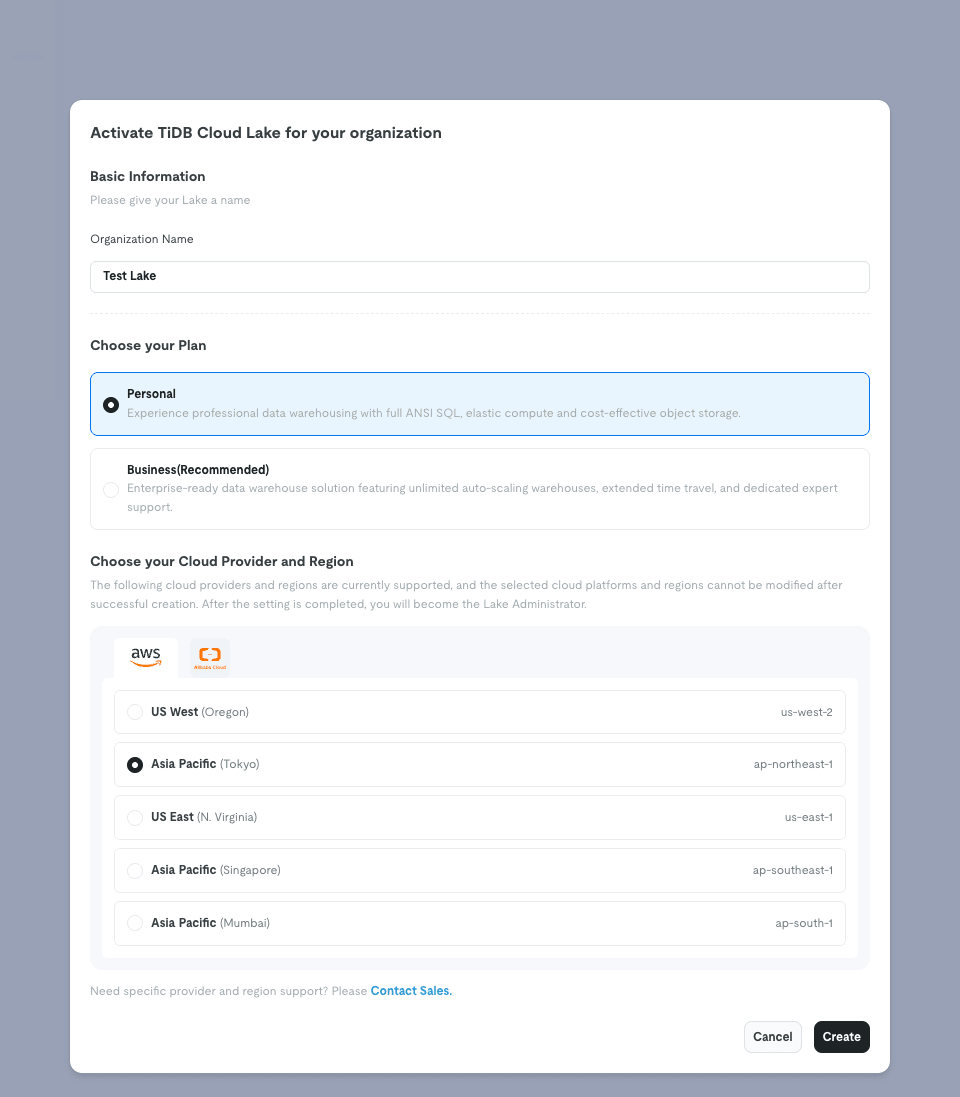
Createを押すと初期化が始まり、Audit Logsのタイムスタンプで見ると約2分で完了していました。
作成直後の状態
作成が終わると、Worksheetにチュートリアルが8本入っていました。
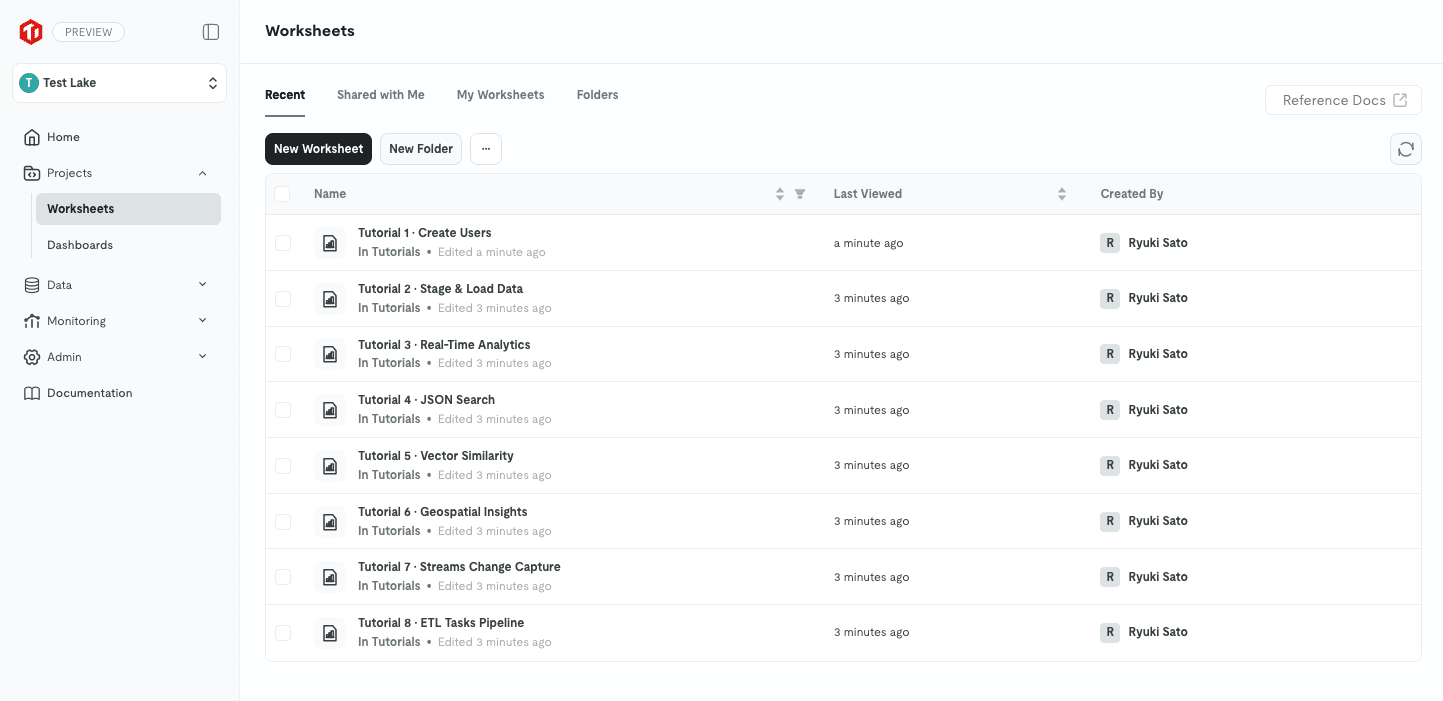
ユーザー作成・Stageとロード・分析・JSON検索・ベクトル検索・地理空間・Stream・ETLの8本で、この製品で何ができるかの一覧になっています。
中身を見た限りでは実行前の状態でした。
Warehouseもdefaultという名前で1つ自動で作られています。
サイズはSmall、Auto Suspendは5分、状態はSuspendedでした。
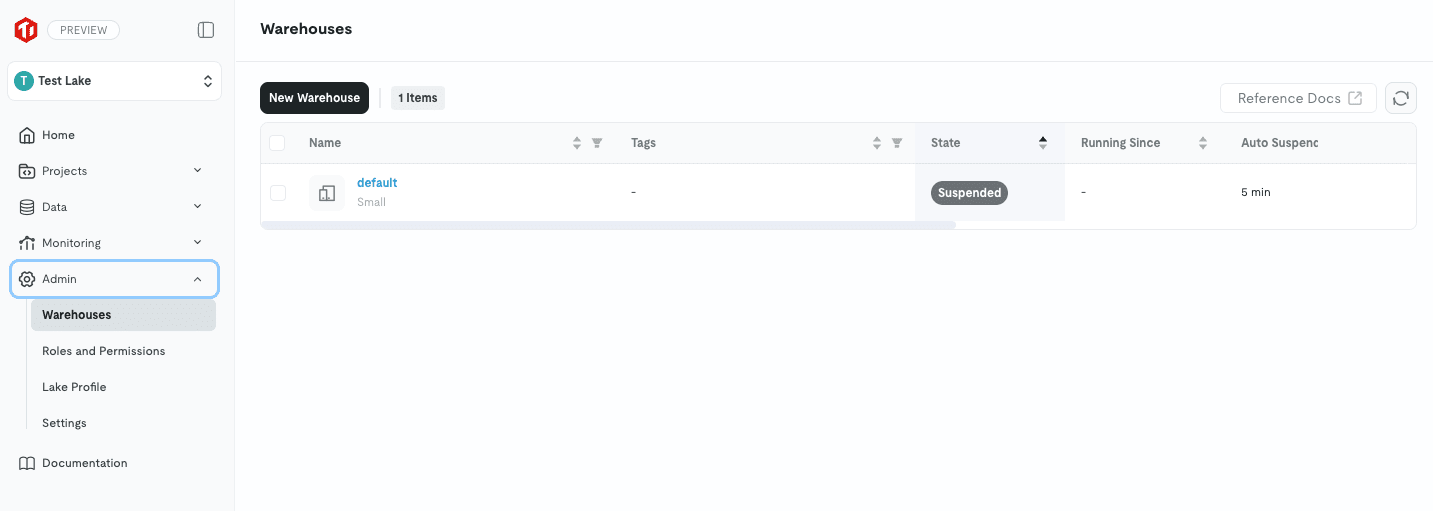
停止状態で作られるので、この時点では課金されていません。
Warehouseの設定
自動生成されたdefaultはSmall($3.20/h)だったので、XSmall($1.60/h)に変更してみます。
Admin > Warehousesの…からSettingを開くと、作り直さずにサイズを変更できます。
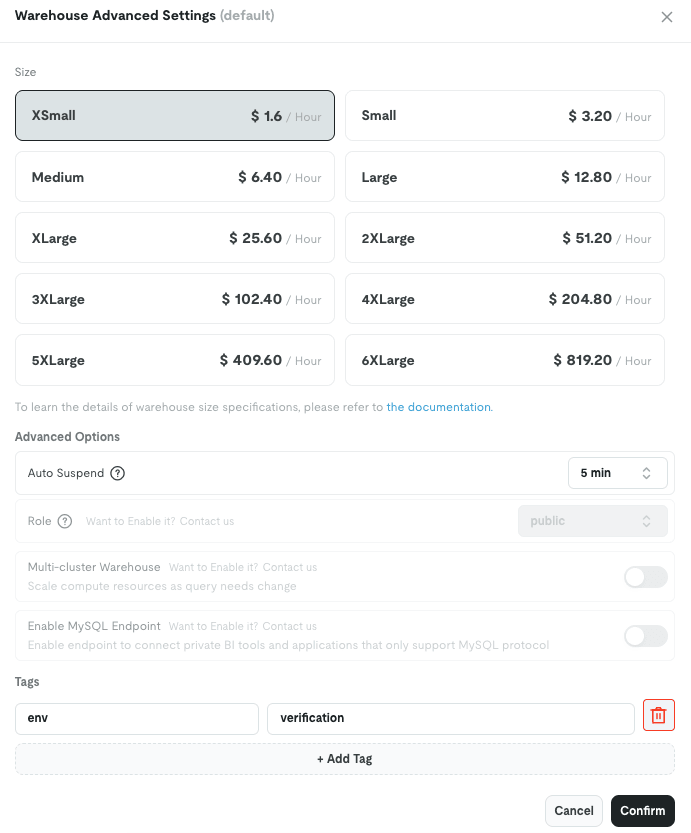
Auto Suspendはドロップダウンで選ぶ形式でした。
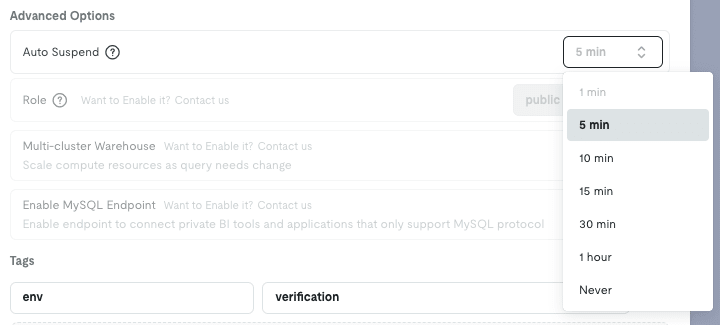
1 min / 5 min / 10 min / 15 min / 30 min / 1 hour / Neverの7つで、デフォルトは5分です。
Neverを選ぶと自動停止しなくなります。
削除も試してみたくて実施した後、検証用にtest-warehouseをXSmallで作り直しました。
新規作成した場合は作った時点でRunningになり、そこから課金が始まります。
起動には10秒もかかりませんでした。
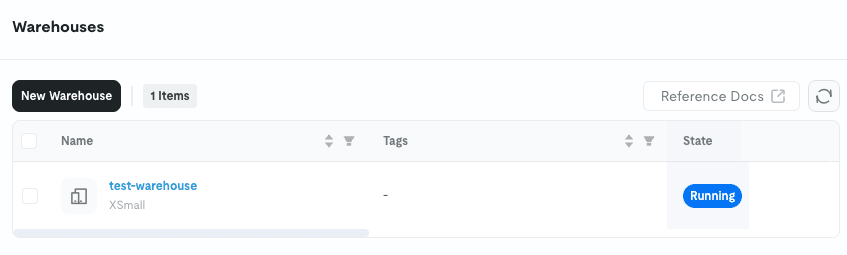
Warehouseの詳細画面にはAuto Resume: Trueという項目があり、停止中にクエリが来ると自動で起動する設定が既定で有効になっていました。
実際、このあとSQLを実行したタイミングでも、停止していたWarehouseが自動的にRunningになりました。
無効になっている項目がある
Advanced Optionsのうち3項目が「Want to Enable it? Contact us」表示でグレーアウトしていました。
| 項目 | 内容 | 公式ドキュメントの記載 |
|---|---|---|
| Role | Warehouseに紐づくロールの指定(public固定) |
デフォルトで無効。サポートチケットでの申請が必要 |
| Multi-cluster Warehouse | 需要に応じたクラスタ数の自動調整 | デフォルトで無効。申請が必要で、BusinessとDedicatedのみ利用可能 |
| Enable MySQL Endpoint | MySQLプロトコルのみ対応するBIツール向けのエンドポイント | デフォルトで無効。サポートチケットでの申請が必要 |
RoleとMySQL EndpointについてはEditionによる制限は書かれておらず、いずれも「デフォルトでは無効なので申請してほしい」という記載でした。
Multi-cluster Warehouseだけは、Editionの機能一覧でもBusiness以上となっています。
ちなみに、Warehouseの作成・削除・サイズ変更はAdmin配下にあり、DataやProjectsからは触れません。
IAMロールでS3に接続する
S3のデータを読むには接続情報を登録します。
アクセスキーを使う方法とIAMロールを使う方法があるので、ロールの方を試しました。
信頼ポリシーに書くTiDB側のARNが必要なのですが、公式ドキュメントにはこう書かれています。
Raise a support ticket to get the IAM role ARN for your TiDB Cloud Lake organization
サポートチケットが必要かと思ったのですが、Data > Data Sources > CreateでAWS – SQS(S3)を選ぶと画面に表示されていました。
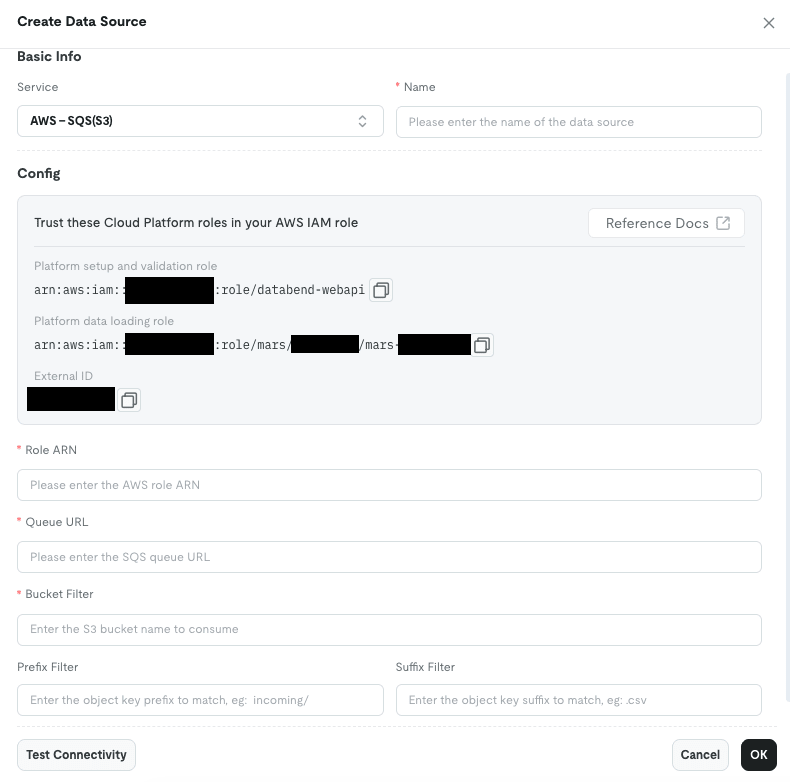
AWS – Credentialsの方を選ぶとAccess Key / Secret Keyの入力欄しか出ないので、見つけにくいだけでした。
External IDはLake ProfileのIDと同じ値です。
ここで表示されるsetup用のロールがarn:aws:iam::xxxxxxxxxxxx:role/databend-webapiという名前で、後述するストレージエンジンの話と繋がります。
権限ポリシーはバケットへの読み書きだけに絞りました。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "ListBucket",
      "Effect": "Allow",
      "Action": [
        "s3:ListBucket",
        "s3:GetBucketLocation"
      ],
      "Resource": "arn:aws:s3:::<バケット名>"
    },
    {
      "Sid": "ReadWriteObjects",
      "Effect": "Allow",
      "Action": [
        "s3:GetObject",
        "s3:PutObject"
      ],
      "Resource": "arn:aws:s3:::<バケット名>/tidb-cloud-lake/*"
    }
  ]
}
s3:GetBucketLocationを入れているのは、TiDB Cloud Lakeがリージョンを自動検出するためです。
検出に失敗するとus-east-1にフォールバックする仕様なので、明示的に許可しておきました。
信頼ポリシーには、コンソールに出ていた2つのPlatform roleとExternal IDを設定します。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "AWS": [
          "arn:aws:iam::xxxxxxxxxxxx:role/databend-webapi",
          "arn:aws:iam::xxxxxxxxxxxx:role/mars/tnxxxxxxx/mars-tnxxxxxxx"
        ]
      },
      "Action": "sts:AssumeRole",
      "Condition": {
        "StringEquals": {
          "sts:ExternalId": "<Lake ID>"
        }
      }
    }
  ]
}
CONNECTIONとStageを作る
Worksheetで以下を実行します。
CREATE CONNECTION lake_s3_conn
    STORAGE_TYPE = 's3'
    ROLE_ARN     = 'arn:aws:iam::<AWSアカウントID>:role/tidb-cloud-lake-role'
    EXTERNAL_ID  = '<Lake ID>';

CREATE STAGE orders_stage
    URL = 's3://<バケット名>/tidb-cloud-lake/'
    CONNECTION = (CONNECTION_NAME = 'lake_s3_conn');

LIST @orders_stage;
LISTでファイルが見えれば、AssumeRoleが成功しています。
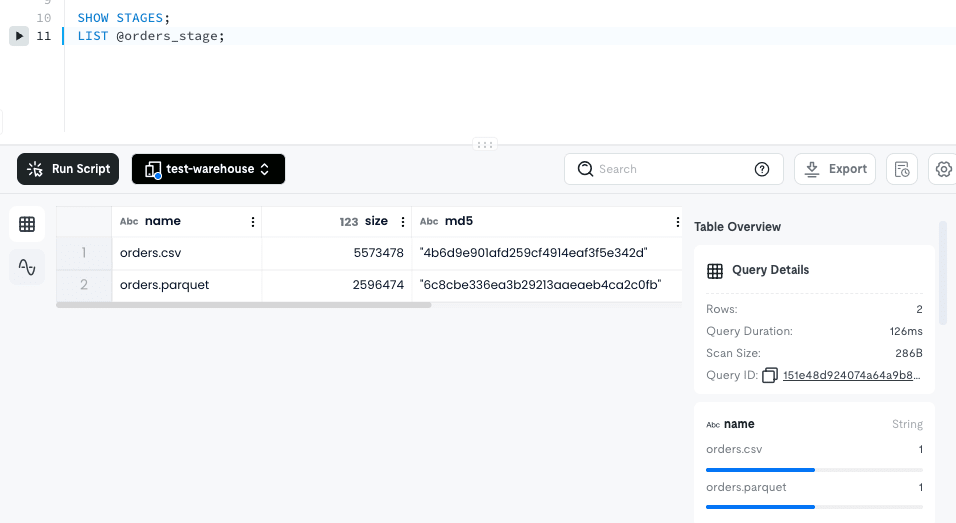
orders.csvが5,573,478バイト、orders.parquetが2,596,474バイトで、アップロードしたファイルと一致していました。
md5も返るので、整合性の確認にも使えます。
SHOW STAGESの結果をエクスポートすると、Stageが保持している設定を確認できます。
{
  "access_key_id": "",
  "secret_access_key": "",
  "security_token": "",
  "role_arn": "arn:aws:iam::<AWSアカウントID>:role/tidb-cloud-lake-role",
  "external_id": "la***xl",
  "region": "ap-northeast-1",
  "storage_class": "Standard"
}
認証情報が空のままになっていて、キーを一切保持していないことが確認できました。
regionも指定していないのに正しく検出されています。
External IDはマスクされる一方、role_arnはそのまま保持されていました。
S3のファイルをロードせずにクエリする
TiDB Cloud Lakeらしいと感じたのがここです。
テーブルを作らずに、S3上のファイルを直接SQLで読めます。
CSVにはヘッダ行があるので、先に名前付きのファイルフォーマットを作ります。
SKIP_HEADERをインラインで書けないためです。
CREATE FILE FORMAT csv_with_header
    TYPE = CSV,
    FIELD_DELIMITER = ',',
    RECORD_DELIMITER = '\n',
    COMPRESSION = AUTO,
    SKIP_HEADER = 1;

SELECT $1, $2, $3, $4, $5, $6, $7
FROM @orders_stage (
    FILE_FORMAT => 'csv_with_header',
    PATTERN     => '.*[.]csv'
)
LIMIT 10;
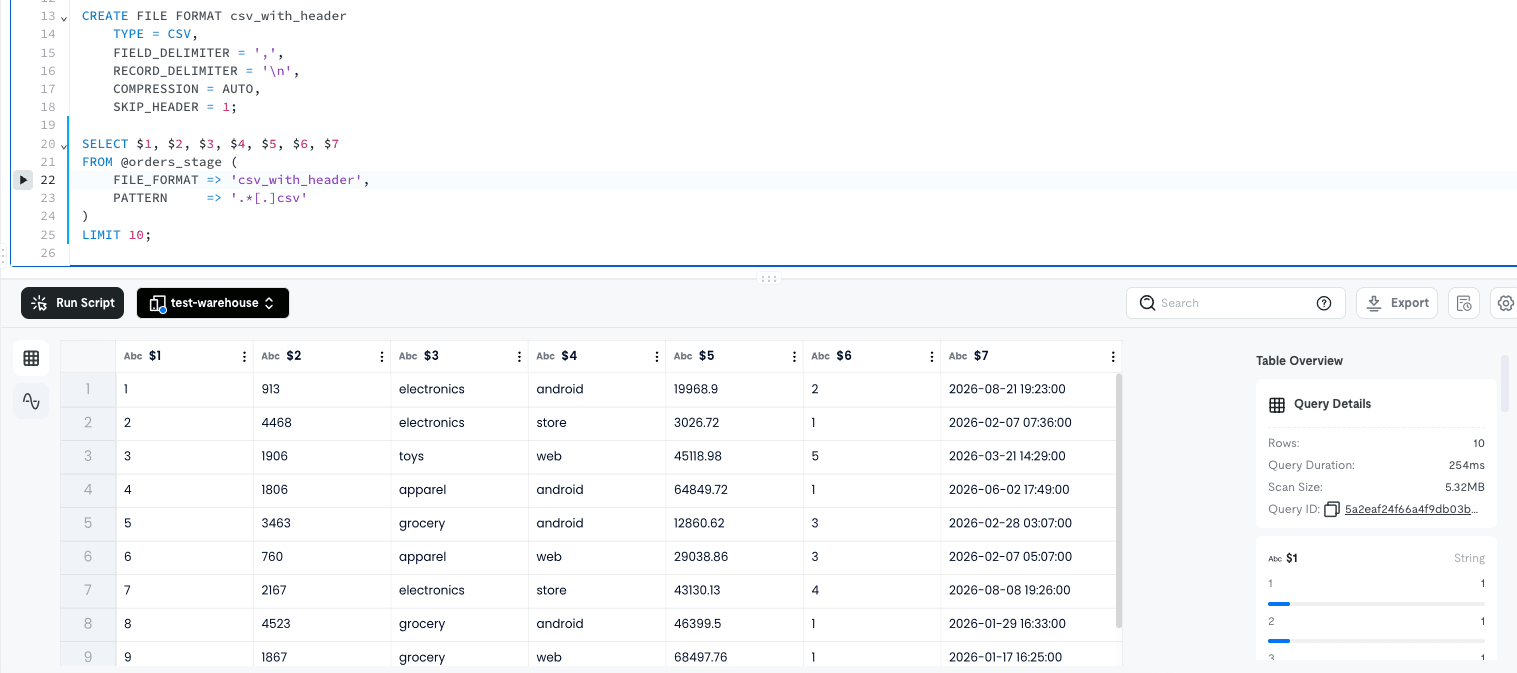
列は$1〜$7の位置指定でアクセスします。
結果ペインの右側にQuery Detailsが出るのですが、Scan Sizeが5.32MBでした。
LIMIT 10でもCSVファイル全体を読んでいます。
型はすべてStringとして扱われます。
CSVには型情報がないので当然ではあるのですが、集計するにはキャストが必要です。
Parquetの方はビルトインの指定だけで読めました。
SELECT *
FROM @orders_stage (
    FILE_FORMAT => 'parquet',
    PATTERN     => '.*[.]parquet'
)
LIMIT 10;
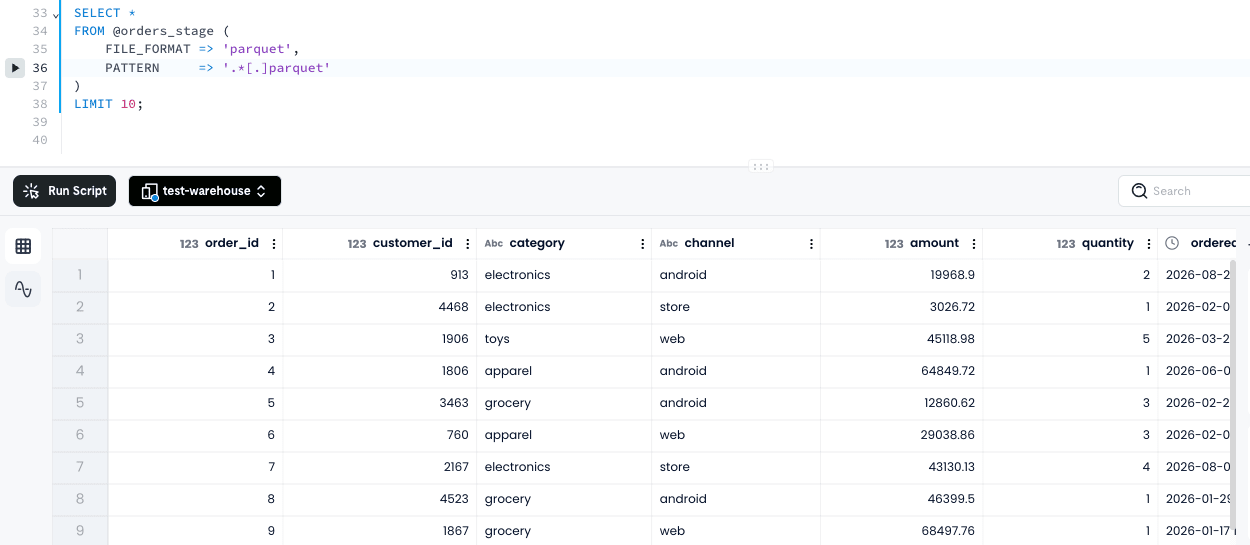
列名も型もファイルに埋まっているので、$1の位置指定もキャストも不要でした。
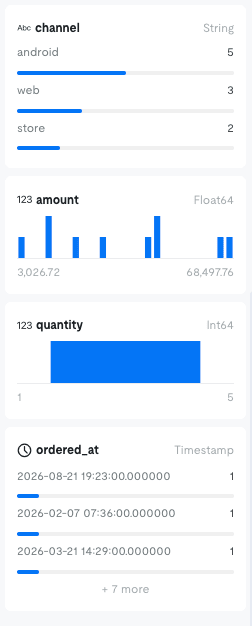
order_idやquantityはInt64、amountはFloat64、ordered_atはTimestampとして認識されています。
結果ペインの列プロファイルも、数値ならヒストグラム、文字列なら頻度表と型に応じて変わります。
テーブルにロードして集計する
次はテーブルに入れてみます。
USE default;

CREATE TABLE orders (
    order_id     BIGINT,
    customer_id  BIGINT,
    category     VARCHAR,
    channel      VARCHAR,
    amount       DECIMAL(12, 2),
    quantity     INT,
    ordered_at   TIMESTAMP
);

COPY INTO orders FROM @orders_stage
PATTERN = '.*[.]csv'
FILE_FORMAT = (TYPE = 'CSV', SKIP_HEADER = 1);
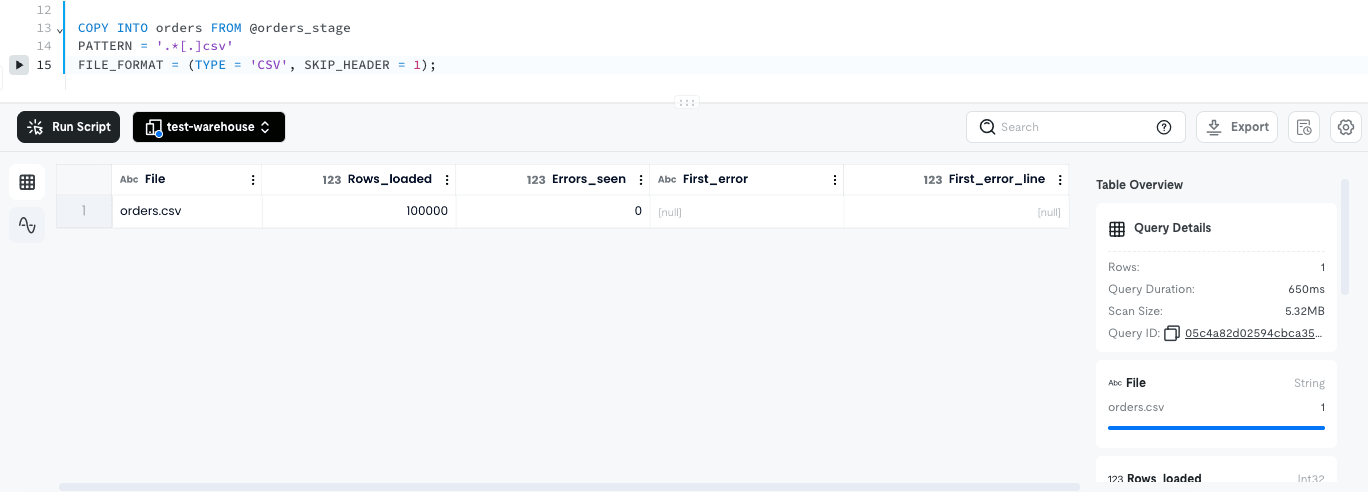
10万行が650msで入りました。
結果にはRows_loadedのほかにErrors_seen・First_error・First_error_lineが返るので、失敗時に何行目で何が起きたかを追えます。
COUNT(*)はデータを読まずに返る
ロード後に件数を数えてみます。
SELECT COUNT(*) FROM orders;
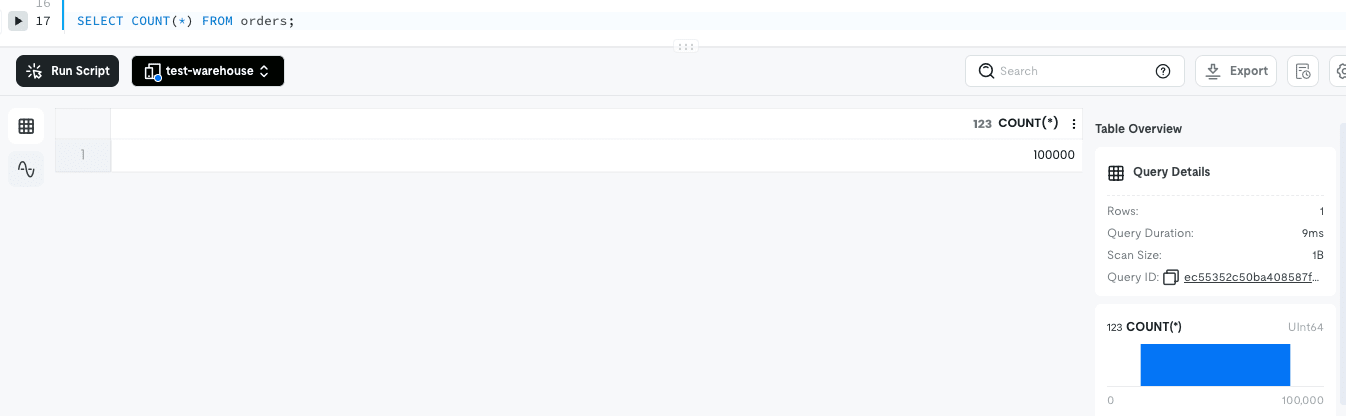
結果は100000で、Query Durationが9ms、Scan Sizeが1Bでした。
テーブルの統計情報から答えを返していて、データを読んでいません。
同じことをStage直接クエリでやると5.32MBスキャンしていたので、繰り返しクエリするならロードした方が速いことが分かります。
型は定義どおりに変換される
DESC orders;
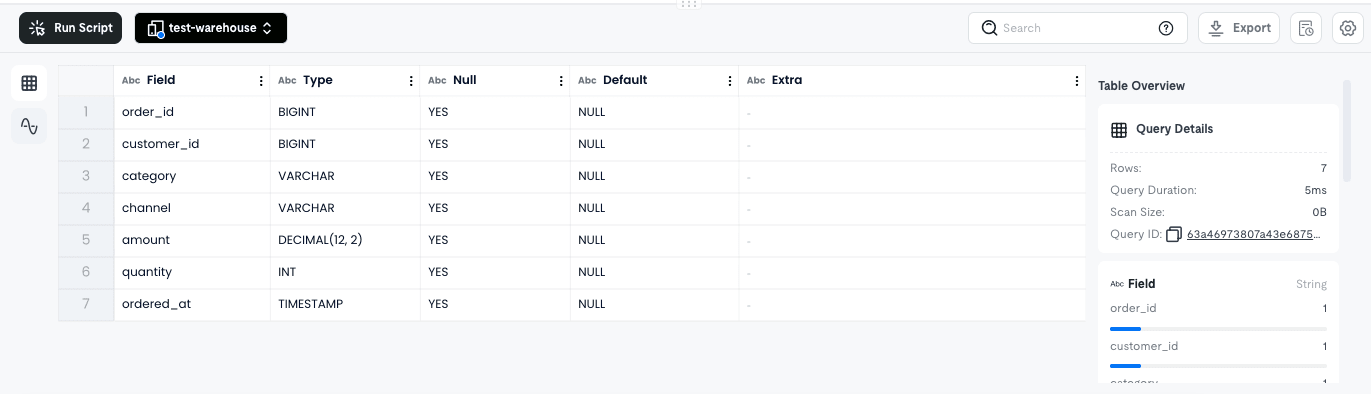
amountはDECIMAL(12, 2)、ordered_atはTIMESTAMPとして入っていました。
Stage直接クエリでは全列Stringだったので、ロードするとDDLの型で解釈されます。
SELECT * FROM orders LIMIT 5;
order_id,customer_id,category,channel,amount,quantity,ordered_at
75310,1097,books,web,54246.02,2,2026-01-10 18:15:00.000000
75311,1383,grocery,ios,35545.20,3,2026-07-11 22:34:00.000000
75312,4132,apparel,web,47361.31,5,2026-04-07 10:14:00.000000
ちなみに、LIMIT 5がorder_id = 1から返っていません。
分散ストレージなので行の順序は保証されず、先頭から見たい場合はORDER BYが必要でした。
集計もしてみます。
SELECT
    category,
    COUNT(*)    AS order_count,
    SUM(amount) AS total_amount,
    AVG(amount) AS avg_amount
FROM orders
GROUP BY category
ORDER BY total_amount DESC;
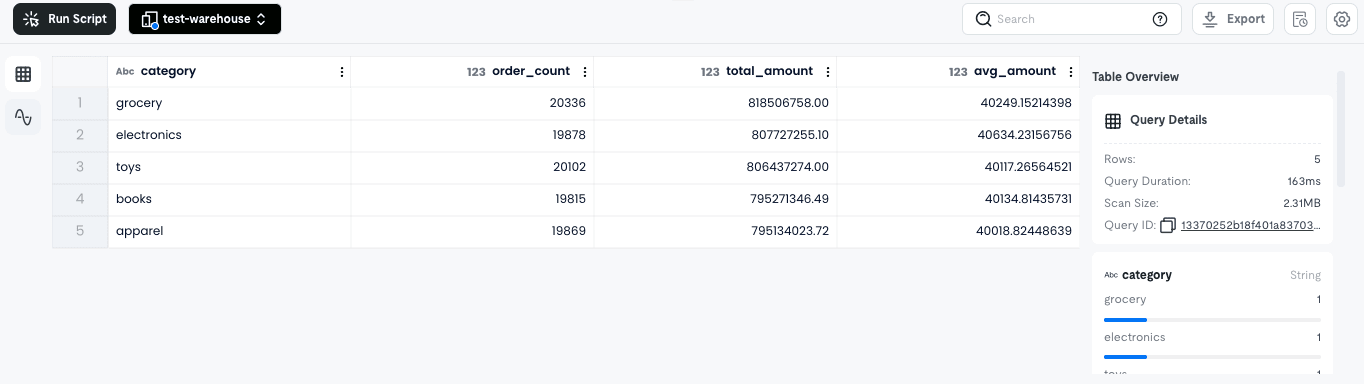
5カテゴリそれぞれ約2万件で、合計はちょうど100,000件でした。
ダミーデータをカテゴリごとに等確率で振ったので、どれもほぼ同じ値になっています。
CREATE文に内部実装が出ている
Data > Databasesでテーブルを選ぶと、Table DefinitionタブにCREATE文が表示されます。
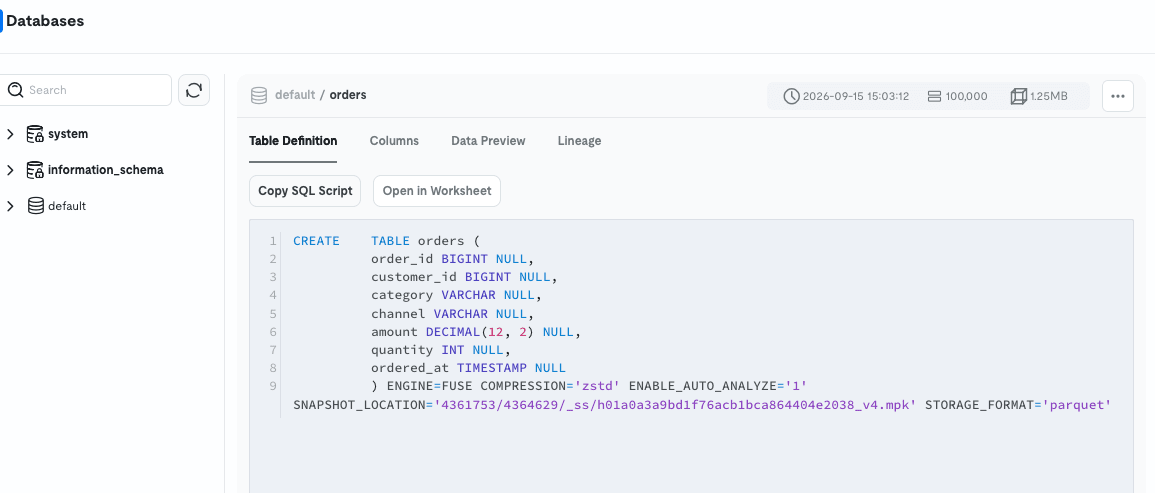
CREATE TABLE orders (
    order_id BIGINT NULL,
    customer_id BIGINT NULL,
    category VARCHAR NULL,
    channel VARCHAR NULL,
    amount DECIMAL(12, 2) NULL,
    quantity INT NULL,
    ordered_at TIMESTAMP NULL
) ENGINE=FUSE
  COMPRESSION='zstd'
  ENABLE_AUTO_ANALYZE='1'
  SNAPSHOT_LOCATION='4361753/4364629/_ss/h01a0a3a9bd1f76acb1bca864404e2038_v4.mpk'
  STORAGE_FORMAT='parquet'
自分で書いたDDLにはなかったオプションが補完されています。
| オプション | 分かること |
|---|---|
ENGINE=FUSE |
ストレージエンジンがFuseEngine |
STORAGE_FORMAT='parquet' |
内部のストレージフォーマットもParquet |
COMPRESSION='zstd' |
zstd圧縮。10万行が1.25MB(元CSVの約24%) |
ENABLE_AUTO_ANALYZE='1' |
統計の自動更新が既定でON |
SNAPSHOT_LOCATION |
タイムトラベルの実体。スナップショットの世代管理 |
FuseEngineという名前と、先ほどのdatabend-webapiというPlatform roleの名前を合わせると、TiDB Cloud LakeのベースがDatabendであることが読み取れます。
TiDBの名を冠していますが、ストレージエンジンの時点でTiKVやTiFlashとは別物であることが、このCREATE文から分かりました。
S3に書き戻す
集計結果をParquetでS3に出してみます。
最初に以下のように書いて失敗しました。
COPY INTO 's3://<バケット名>/tidb-cloud-lake/export/category_summary/'
FROM ( SELECT ... )
CONNECTION = (CONNECTION_NAME = 'lake_s3_conn')
FILE_FORMAT = (TYPE = 'PARQUET');
sql_syntax(1005): Unexpected "CONNECTION", a reserved keyword;
use a different identifier or quote it with backticks.
公式の構文を見ると、アンロード側にはCONNECTION句がありませんでした。
ロード(COPY INTO <table> FROM <location>)には書けるのですが、アンロード(COPY INTO <location> FROM <table>)には書けません。
出力先にStageを使えば認証情報を書かずに済みます。
COPY INTO @orders_stage/export/category_summary/
FROM (
    SELECT category, COUNT(*) AS order_count, SUM(amount) AS total_amount
    FROM orders
    GROUP BY category
)
FILE_FORMAT = (TYPE = PARQUET)
DETAILED_OUTPUT = true;
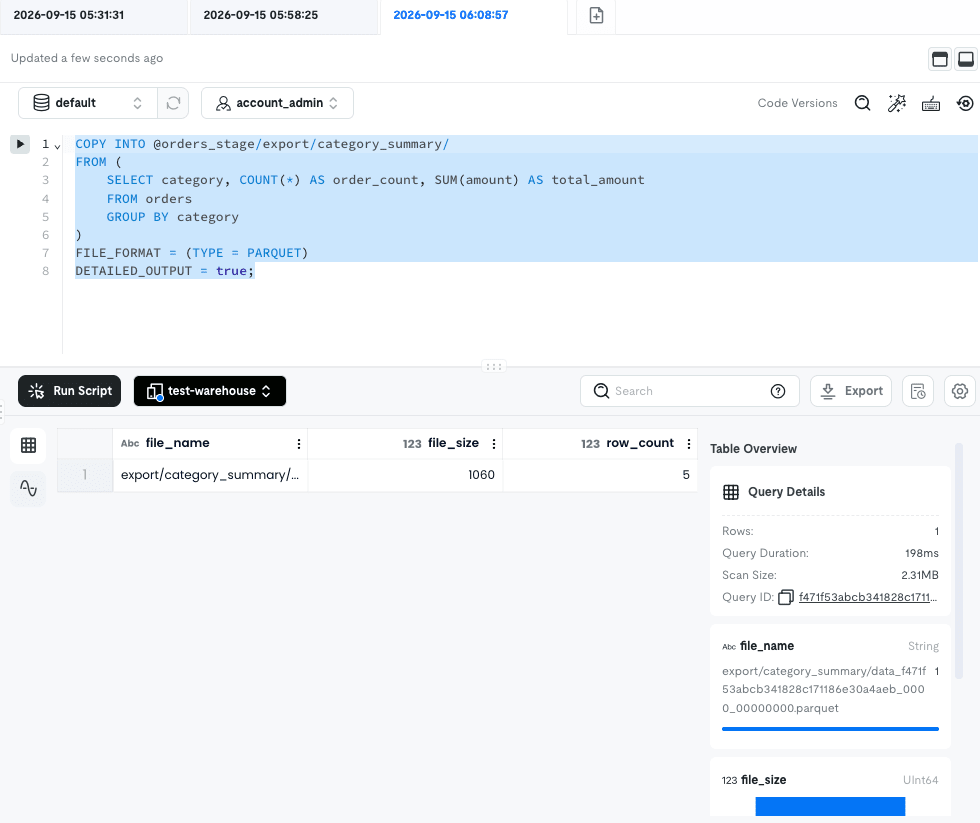
5行・1,060バイトのParquetが1ファイル出力されました。
ファイル名はdata_<Query ID>_0000_00000000.parquetという形式で、末尾の連番からして大きいデータでは分割されるようです。
権限は最初に設定したs3:PutObjectだけで足りて、マルチパートアップロード関連の権限は不要でした。
Dashboardを作る
Projects > Dashboardsでダッシュボードを作れます。
Create a Tileを押すとタイル専用のクエリ編集画面が開き、そこでクエリを書いてチャート表示に切り替える流れでした。
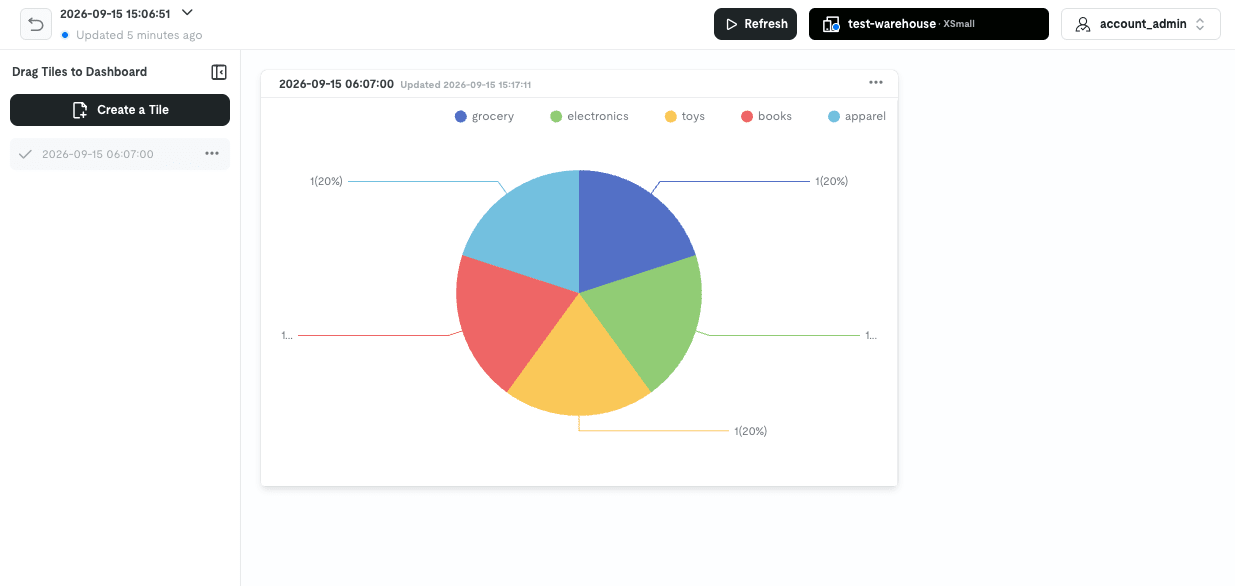
チャートはScorecard / Pie chart / Bar chart / Line chartの4種類です。
ここで気になったのが、Dashboardの画面上部にRefreshボタンとWarehouseの選択があることです。
つまり保存された画像ではなく、開くたびにWarehouseでクエリが再実行されます。
MySQL Endpointを有効にするとAuto Suspendが無効化されるとドキュメントに明記されているので、BIツールを常時接続する場合と比べると、組み込みのDashboardは見たときだけ課金される分コストでは有利そうです。
Data Integrations
Data > Data Integrationsは、取り込みをGUIで設定する画面です。
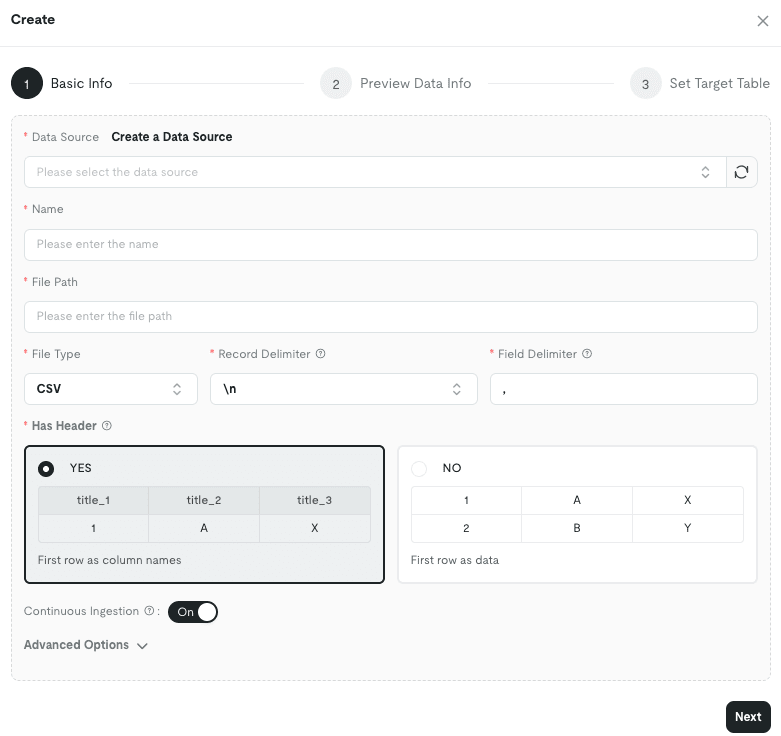
データソース・ファイルパス・ファイル形式・区切り文字・ヘッダの有無を指定していく3ステップのウィザードで、COPY INTOでやったことをSQLなしで設定できます。
違いはContinuous Ingestionのトグルで、Onにすると継続的な取り込みになります。
MySQLやPostgreSQLを選べばスナップショット + CDCでの継続同期ができるので、他のデータベースからTiDB Cloud Lakeにデータを流し続けるのはここを使うことになりそうです。
接続情報はData > Data Sourcesに登録しておきます。
選べる種類はAWS – Credentials / AWS – SQS(S3) / TiDB / MySQL / PostgreSQL / Kafka / FeiShu Botの7つでした。
Task
Data > Taskは、SQLを依存関係付きで組んで定期実行する画面です。
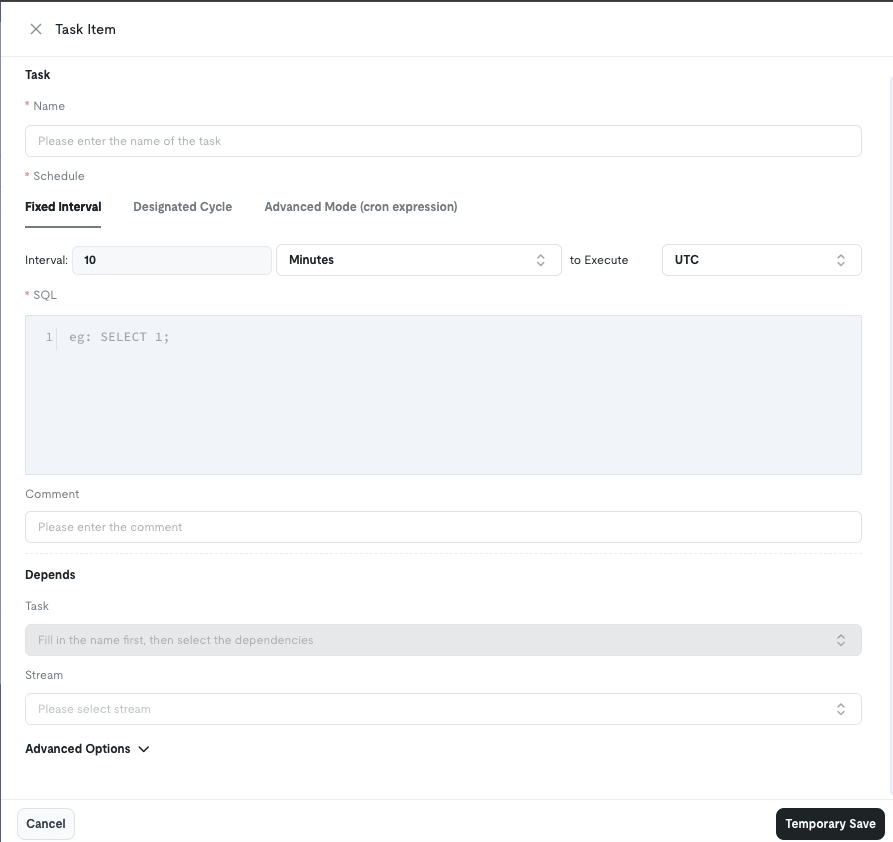
スケジュールは固定間隔のほかcron式でも指定できます。
Dependsで他のタスクとStreamを指定でき、Streamは変更差分を溜め続ける仮想テーブルです。
組み合わせると「新しく入ったデータだけを加工して別テーブルに書く」パイプラインが作れます。
Monitoring
Monitoring > Metricsでは、ストレージサイズ・スキャン量・クエリの成功率・Warehouseの状態がまとめて見られます。
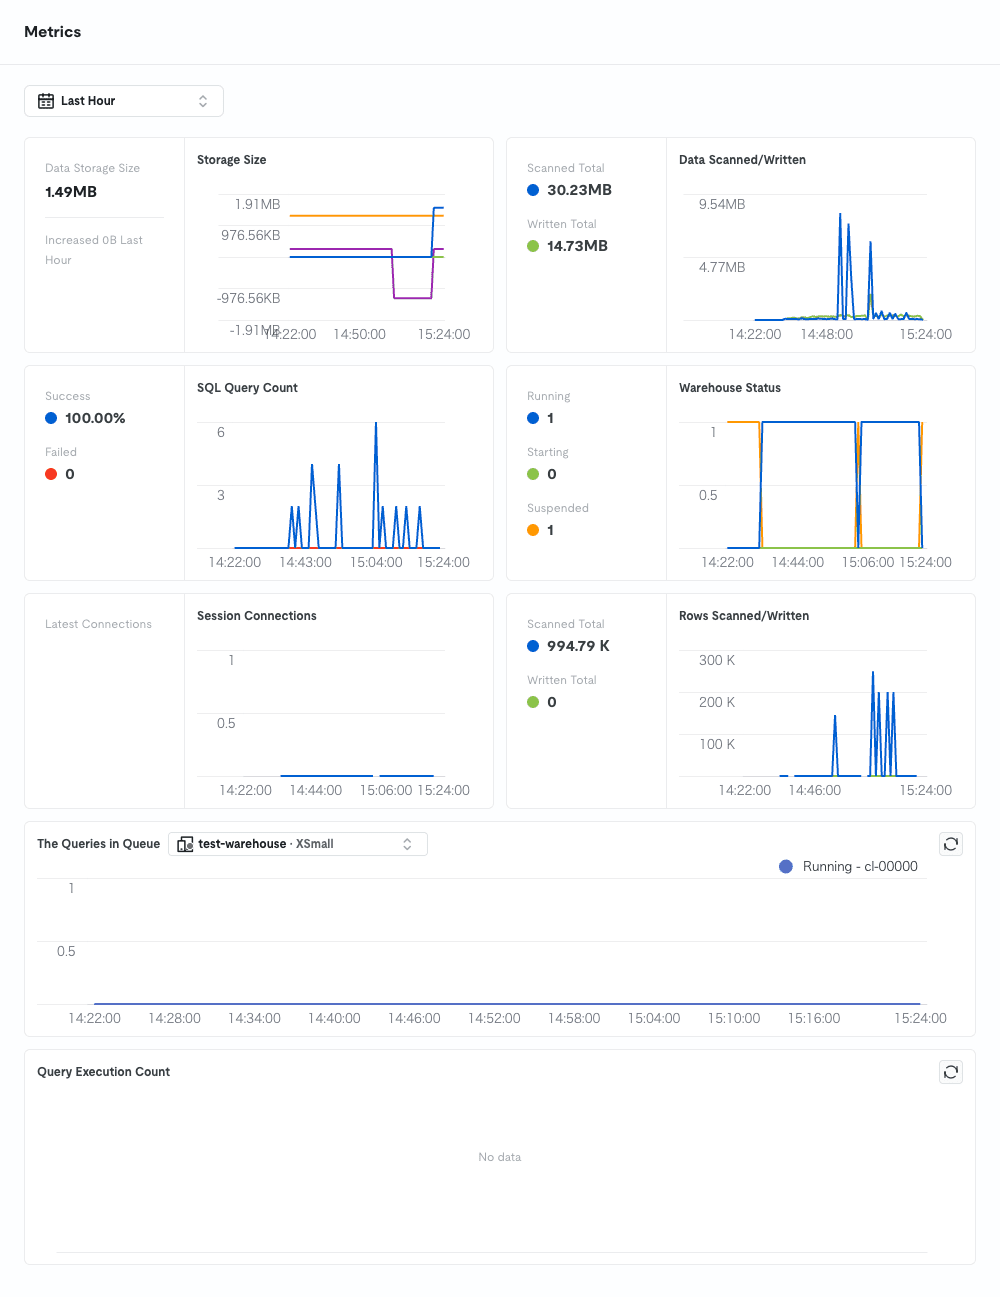
Warehouse Statusのグラフを見ると、起動と停止が繰り返されている様子が分かります。
Data Storage SizeはLake全体の値で、10万行を入れただけの状態で1.49MBでした。
Monitoring > SQL Historyには実行したクエリが残ります。
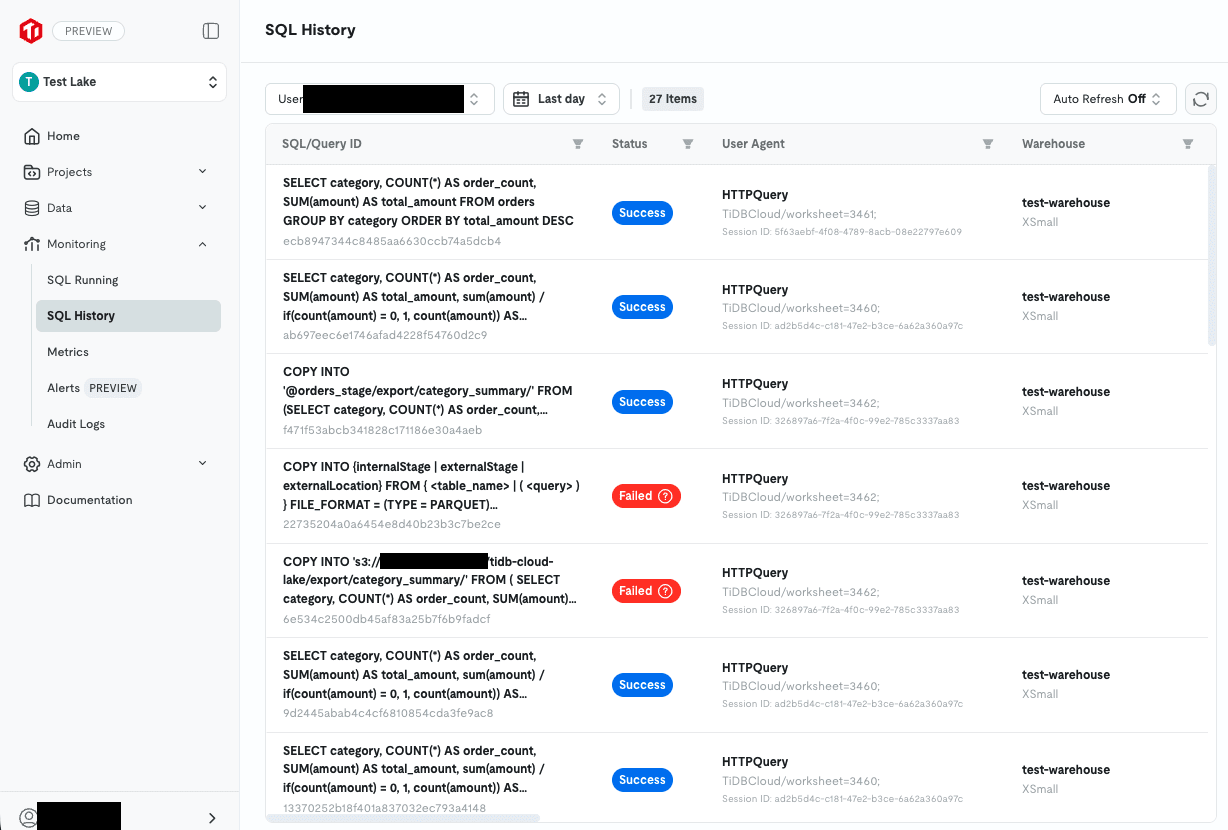
成功・失敗のステータス、実行時間、キュー待ち時間、どのWarehouseで実行したかが並びます。
User AgentにTiDBCloud/worksheet=3461とWorksheetのIDが入るので、どの画面から実行したかも追えました。
ちなみに、CREATE CONNECTIONの履歴を見るとExternal IDがla***xlとマスクされていて、秘密情報がそのまま残らないようになっています。
Monitoring > Alertsでは通知を設定できます。
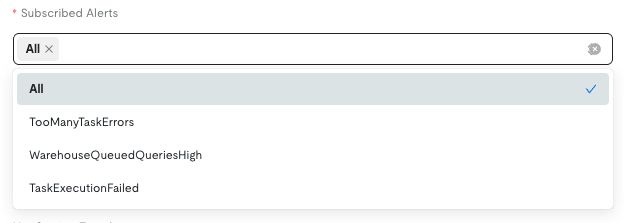
購読できるのはTooManyTaskErrors / WarehouseQueuedQueriesHigh / TaskExecutionFailedの3種類で、タスクの失敗とWarehouseのキュー滞留が対象でした。
通知先はEmailとFeishu Botです。
Monitoring > Audit Logsには操作履歴が残ります。
Worksheetの編集や設定変更が、実行者・IPアドレス・時刻とともに記録されていました。
補足: 結果のExportには権限が必要
クエリ結果をCSVでダウンロードしようとしたら、権限エラーになりました。
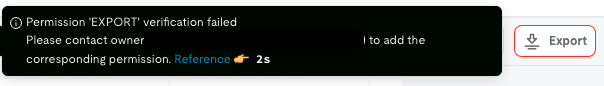
Permission 'EXPORT' verification failed
Please contact owner ... to add the corresponding permission.
自分がLake Ownerなのに「オーナーに連絡してください」と言われて一瞬戸惑ったのですが、Admin > Roles and Permissionsの…にAdd EXPORT Permissionというメニューがありました。
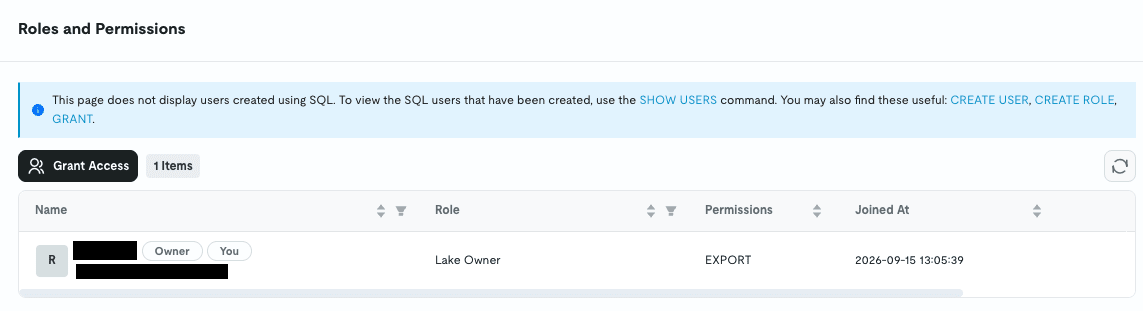
Allows downloading worksheet results
DWHには顧客データが入るので、結果をローカルにダウンロードできること自体を別の権限に分ける設計だと思われます。
料金
Warehouseは秒課金で、サイズごとに単価が決まっています。
Editionは2つあり、Businessの単価はPersonalの1.5倍です。
| サイズ | Personalの単価 |
|---|---|
| XSmall | $1.60/h |
| Small | $3.20/h |
| Medium | $6.40/h |
| Large | $12.80/h |
| XLarge | $25.60/h |
XLargeより上は2XLargeから6XLargeまであり、1段上がるごとに倍になります。
全サイズの単価は以下に載っています。
ストレージは両Edition共通で$23.00/月/TBです。
前述のとおり実体はS3に置かれるので、S3の価格がそのまま反映されています。
そしてもう1つ、SQLクエリの実行ごとにREST APIリクエストの課金があり、Personalで$1.00/10,000リクエストでした。
なお、これらはpublic preview時点の価格で、GAで変更の可能性があると公式に明記されています。
どちらに入れるか
TiFlashはクラスタのリソースに含まれるので、クラスタが動いている限り費用が発生します。
一方でTiDB Cloud LakeはWarehouseを止めていれば0で、XSmallを1日1時間だけ使うなら月$48程度です。
常にデータを見続けるならクラスタ側、必要なときだけ大量のデータを触るならTiDB Cloud Lakeという使い分けになりそうです。
ただし、クエリのたびにWarehouseが起動して5分アイドルしてから止まるので、触りながら検証していると想像より動いている時間は長くなります。
利用料金はTiDB Cloud側のBillingで確認できました。
最後に
今回は、public previewのTiDB Cloud Lakeで、S3のファイルを直接クエリしたりテーブルにロードして集計したりといったところを触ってみました。
この記事がどなたかの参考になれば幸いです。