[アップデート] CloudWatch の PromQL アラームから Auto Scaling を起動できるようになったので、ECS サービスをステップスケーリングしてみた

はじめに
こんにちは!ひろたこです。
これまでは OTel 側のメトリクスでスケールさせたい場合、同じ値を従来のメトリクスにも送り、従来のアラームを別に作る必要がありました。
しかし、2026年11月10日のアップデートで、Amazon CloudWatch の PromQL アラームから Auto Scaling のスケーリングポリシーを起動できるようになりました。
そこでこの記事では、アプリが OTel SDK で出すカスタムメトリクスを PromQL アラームで評価し、Application Auto Scaling のステップスケーリングで Amazon ECS サービスのタスク数が実際に増減するところまで試しました。
分かったことは次のとおりです。
- クエリ
sum(app_active_requests) > 10に対して値を 15 / 25 / 35(しきい値 10 を 5 / 15 / 25 超えた状態)にすると、ステップどおり +1 / +2 / +3 でスケールアウトした - 負荷をかけてから ALARM になるまで約40〜46秒、増えたタスクが RUNNING になるまで約72〜95秒だった
- 注意点として、ALARM が続くあいだスケーリングがくり返されること、止まったタスクの時系列が数分残ること、使えるクエリの形が決まっていること、ターゲット追跡ポリシーは作成できても発火時に失敗すること、メトリクスが途切れるとアラームが OK になることを確認した
PromQL アラームからのスケーリングとは
PromQL アラームは、PromQL のクエリの結果で状態が決まる CloudWatch のアラームです。今回のアップデートで、このアラームのアクションに Amazon EC2 Auto Scaling と Application Auto Scaling のスケーリングポリシーを指定できるようになりました。
従来のメトリクスアラームとは、しきい値の持ち方と評価のパラメータが違います。
| 項目 | 従来のメトリクスアラーム | PromQL アラーム |
|---|---|---|
| 評価対象 | Namespace / MetricName / Dimensions、または Metrics |
EvaluationCriteria の PromQLCriteria.Query(PromQL のクエリ) |
| しきい値 | Threshold と ComparisonOperator |
API のパラメータにはない。クエリの比較式に書く(例 sum(metric) > 10) |
| 評価のパラメータ | Period / EvaluationPeriods / DatapointsToAlarm |
評価間隔(EvaluationInterval)/ 保留期間(PendingPeriod)/ 回復期間(RecoveryPeriod) |
評価間隔はアラームを評価する頻度で、10 / 20 / 30 秒か 60 秒の倍数を指定します。保留期間は「超過が続いてから ALARM になるまで」、回復期間は「超過していない状態が続いてから OK に戻るまで」の秒数です。
ステップスケーリングは「しきい値をどれだけ超えたか」で適用するステップを決めますが、PromQL アラームにはしきい値のパラメータがありません。この点について、アナウンスには次のように書かれています。
For step scaling, how far the value is past the threshold in your PromQL query decides which step applies. The query must return a single series and compare it to a threshold.
クエリが単一の時系列を返し、クエリの中でしきい値と比較していることが条件です。この記事では、クエリの値がしきい値を超えたぶん(値 − しきい値)を超過幅と呼んでいます。sum(metric) > 10 で値が 15 なら、超過幅は 5 です。
起動できるポリシーの種類は、ドキュメント「Alarm actions」の表では次のようになっています。
| アクション | 従来のメトリクスアラーム | PromQL アラーム |
|---|---|---|
| Amazon EC2 Auto Scaling のポリシー | シンプル、ステップ、ターゲット追跡 | シンプル、ステップ |
| Application Auto Scaling のポリシー | ステップ、ターゲット追跡 | ステップ |
シンプルスケーリングは Amazon EC2 Auto Scaling だけのポリシーなので、ECS サービスで使えるのはステップスケーリングだけです。ターゲット追跡スケーリングは未対応です。
検証環境
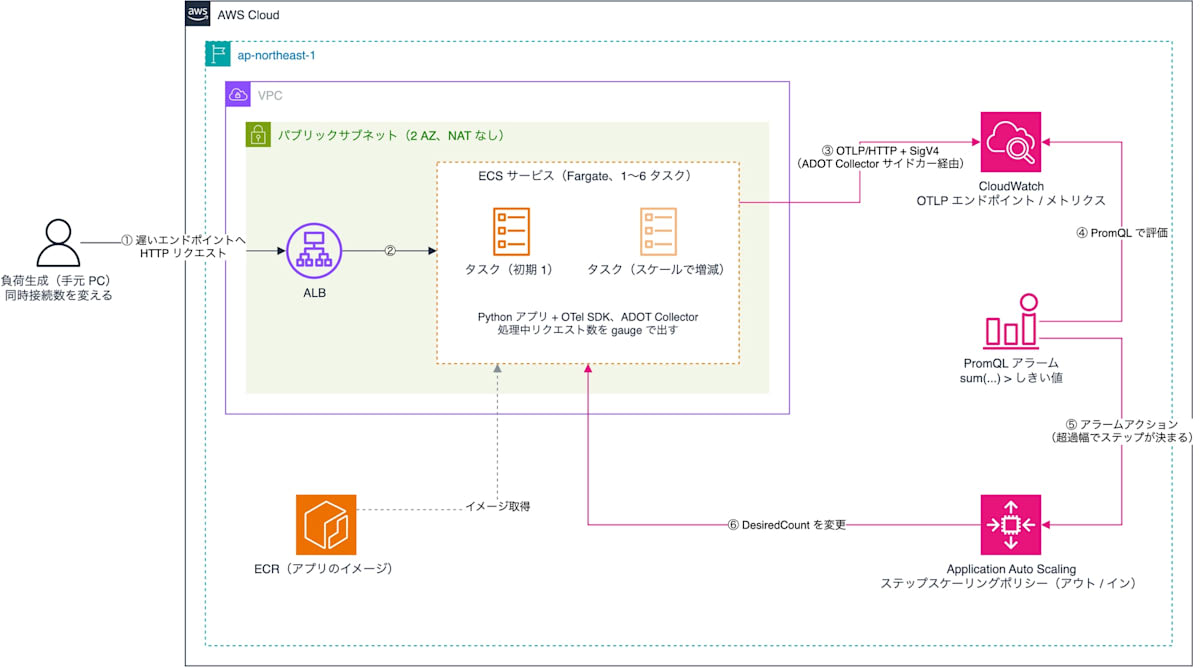
Application Load Balancer(以下 ALB)の後ろに ECS サービス(AWS Fargate)を置きました。タスクの中でアプリが出したメトリクスを AWS Distro for OpenTelemetry(以下 ADOT)Collector が CloudWatch の OTLP エンドポイントへ送り、それを PromQL アラームが評価して、Application Auto Scaling のステップスケーリングポリシーを起動する構成です。環境は Terraform で作りました。
| ツール | バージョン |
|---|---|
| AWS CLI | 2.37.12 |
| Terraform | v1.15.7 |
| Terraform AWS provider | v6.72.0 |
| OTel SDK(Python) | opentelemetry-sdk 1.45.2 |
| ADOT Collector | v0.51.0 |
- 検証リージョン:
ap-northeast-1(東京)
アプリは FastAPI で作った小さな Web アプリです。/slow?seconds=N にアクセスすると N 秒待ってから応答し、処理中のリクエスト数を gauge app_active_requests として 10 秒ごとに送ります。同時接続数を変えて負荷をかければ、メトリクスの値を狙った数字にできます。
- タスクは
appとcollector(ADOT Collector)の2コンテナ。Collector が OTLP/HTTP で受け取り、SigV4 で署名してhttps://monitoring.ap-northeast-1.amazonaws.com/v1/metricsへ送る - AWS Fargate は ARM64、0.25 vCPU / 0.5 GB
- リソース属性は
service.name=promql-step-app、service.instance.id=<ECS タスク ID> - タスクロールの権限は
cloudwatch:PutMetricDataのみ - スケーラブルターゲットは最小 1・最大 6 タスク
アラームとステップスケーリングポリシーは、スケールアウト用とスケールイン用の2組を用意しました。
| 項目 | スケールアウト用 | スケールイン用 |
|---|---|---|
| アラーム名 | promql-step-scale-out |
promql-step-scale-in |
| クエリ | sum(app_active_requests) > 10 |
sum(app_active_requests) < 5 |
| 評価間隔 | 10 秒 | 10 秒 |
| 保留期間 | 30 秒 | 120 秒 |
| 回復期間 | 30 秒 | 0 秒 |
| ポリシーのステップ | 超過幅 0 以上 10 未満で +1、10 以上 20 未満で +2、20 以上で +3 | −1 |
| クールダウン | 60 秒 | 60 秒 |
| アラームの作成方法 | コンソール | AWS CLI |
やってみた
1. タスクごとの時系列を 1 本にまとめる
スケーリングアクションを付ける PromQL アラームには、単一の時系列を返すクエリが必要です。まずはクエリの結果がどうなるかを確かめました。
タスクを 2 つにして、同時接続 8 の負荷をかけた状態でクエリを実行します。scripts/promql.sh は、PromQL API(https://monitoring.ap-northeast-1.amazonaws.com/api/v1/query)を SigV4 で叩く自作スクリプトです。
scripts/promql.sh
#!/bin/bash
# CloudWatch の PromQL API(Prometheus 互換の instant query)を SigV4 で叩く。
# GET だとクエリに " や > を含むときに curl の SigV4 署名が合わないため、POST(フォーム)で送る。
# 使い方: scripts/promql.sh '<PromQL クエリ>'
set -euo pipefail
REGION="${AWS_REGION:-ap-northeast-1}"
PROFILE="${AWS_PROFILE:-default}"
eval "$(aws configure export-credentials --profile "$PROFILE" --format env)"
curl -s -m 20 \
  --aws-sigv4 "aws:amz:${REGION}:monitoring" \
  --user "${AWS_ACCESS_KEY_ID}:${AWS_SECRET_ACCESS_KEY}" \
  ${AWS_SESSION_TOKEN:+-H "x-amz-security-token: ${AWS_SESSION_TOKEN}"} \
  -X POST "https://monitoring.${REGION}.amazonaws.com/api/v1/query" \
  --data-urlencode "query=$1"
echo
まず、タスクごとの値を見ます。出力は data.result の部分だけを抜粋して整形しています(以降も同じです)。
$ scripts/promql.sh 'sum by ("@resource.service.instance.id") (app_active_requests)'
{
  "result": [
    { "metric": { "@resource.service.instance.id": "<TASK_ID_1>" }, "value": [1794397915.849, "4"] },
    { "metric": { "@resource.service.instance.id": "<TASK_ID_2>" }, "value": [1794397915.849, "4"] }
  ]
}
タスクごとに時系列が分かれ、値は 4 と 4 でした。ALB が同時接続 8 を 2 タスクに 4 ずつ振り分けています。このままだと時系列が 2 本あるので、アラームには使えません。
なお、リソース属性は @resource.<属性名> というラベルになり、@ や . を含むので PromQL では引用符で囲んで書きます。
これを sum で 1 本にまとめます。
$ scripts/promql.sh 'sum(app_active_requests)'
{
  "result": [
    { "metric": {}, "value": [1794397830.088, "8"] }
  ]
}
ラベルなしの 1 本になりました。sum は全体の処理中リクエスト数(8)です。avg に変えると、同じく 1 本で、値は 1 タスクあたりの数(4)になりました。
次に、比較式を付けてみます。
$ scripts/promql.sh 'sum(app_active_requests) > 5'
{
  "result": [
    { "metric": {}, "value": [1794397916.297, "8"] }
  ]
}
$ scripts/promql.sh 'sum(app_active_requests) > 100'
{
  "result": []
}
条件を満たすと元の値(8)を持つ時系列が返り、満たさないと結果は空になります。比較式は PromQL の通常どおりフィルタとして働くので、返ってきた値とクエリ中のしきい値の差が超過幅になるわけですね。
2. PromQL アラームを作ってスケーリングポリシーを紐付ける
スケールアウト用はコンソールで、スケールイン用は AWS CLI で作りました。
コンソールで作る(スケールアウト用)
アラーム作成の最初のステップで、データソース「メトリクス」、タイプ「PromQL」を選びます。ドキュメント「Using PromQL in alarms」の手順は「Select metric」から PromQL のタブを選ぶ流れですが、実際の画面では「クラシック」と並ぶタイプの選択肢になっていました。
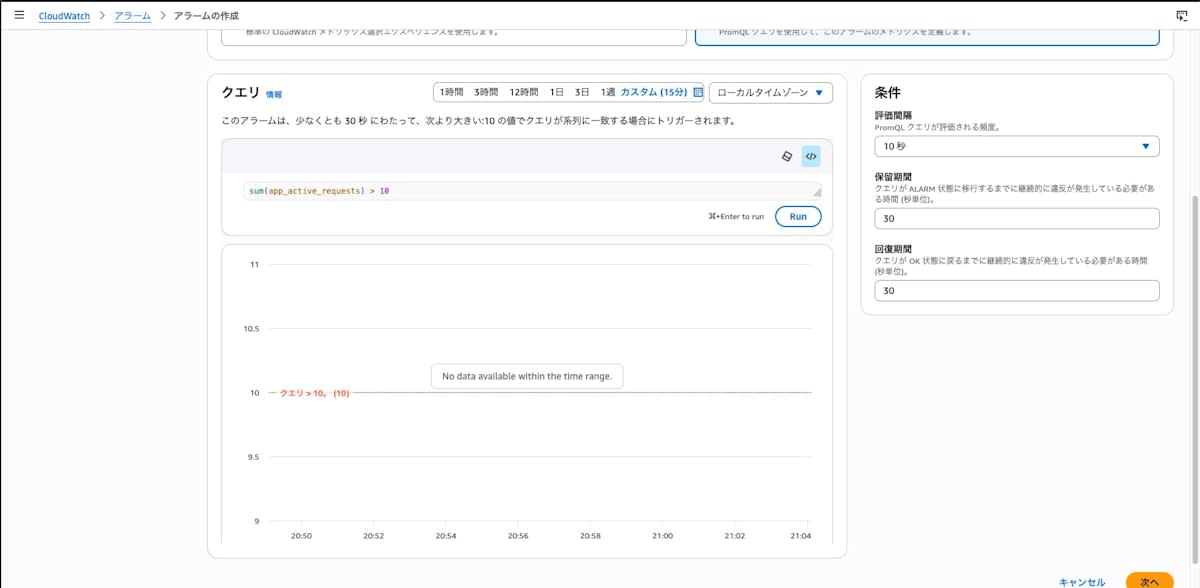
「条件」にある入力欄は評価間隔・保留期間・回復期間の3つだけです。同じドキュメントの手順にはしきい値・評価期間・datapoints to alarm の設定が出てきますが、その入力欄はありませんでした。既定値は評価間隔 1 分、保留期間 120、回復期間 300 で、今回は 10 秒・30・30 に変えています。
クエリに sum(app_active_requests) > 10 を入れると、説明文が「このアラームは、少なくとも 30 秒 にわたって、次より大きい:10 の値でクエリが系列に一致する場合にトリガーされます。」になり、グラフに「クエリ > 10。(10)」のしきい値線が引かれました。コンソールはクエリの比較式からしきい値を読み取っています。
クエリの入力方法は、ブロックを組み立てるビルダーと、テキストで書くコードの2通りです。ビルダーは書き方に癖があったので、私はコードで書いてからビルダー表示に戻しました。
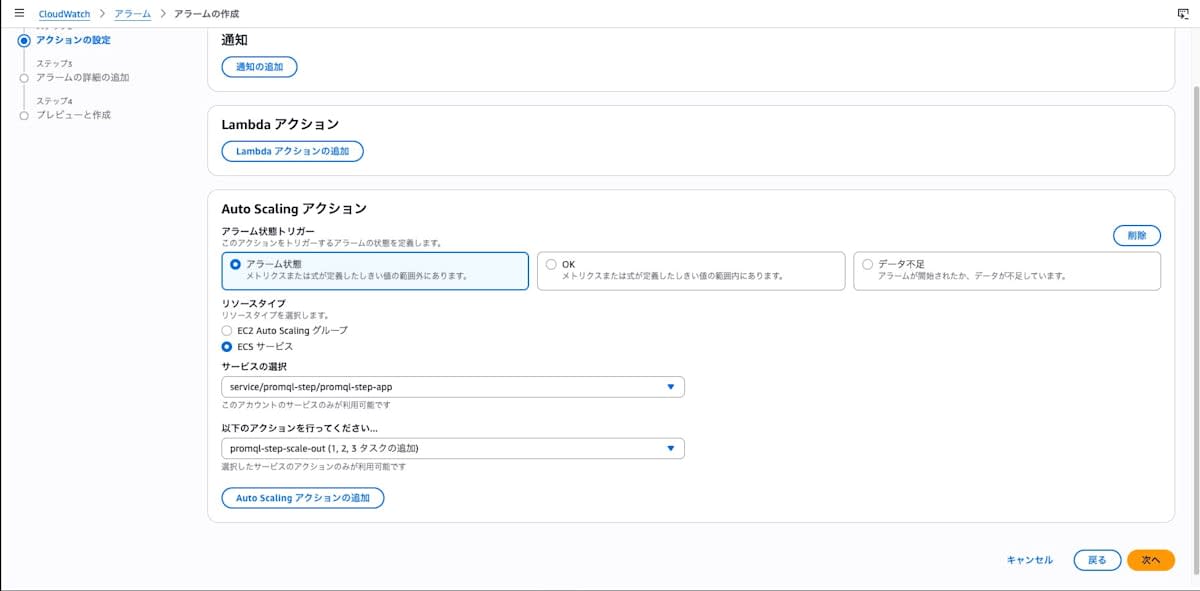
アクションの設定には「Auto Scaling アクション」があります。リソースタイプ「ECS サービス」から service/promql-step/promql-step-app を選ぶと、ポリシーの候補に「promql-step-scale-out (1, 2, 3 タスクの追加)」が出てきました。
作成後に describe-alarms で見ると、定義は次の CLI で作ったものと同じ形(EvaluationCriteria.PromQLCriteria)で、しきい値を別に持つフィールドはありませんでした。
AWS CLI で作る(スケールイン用)
CLI では --evaluation-criteria と --evaluation-interval を使います。--alarm-actions には Application Auto Scaling のポリシー ARN をそのまま渡しました。
$ aws cloudwatch put-metric-alarm \
  --alarm-name promql-step-scale-in \
  --alarm-description "Scale in when in-flight requests are low (PromQL)" \
  --evaluation-criteria 'PromQLCriteria={Query="sum(app_active_requests) < 5",PendingPeriod=120,RecoveryPeriod=0}' \
  --evaluation-interval 10 \
  --alarm-actions "<スケールイン用ポリシーの ARN>" \
  --tags Key=Project,Value=promql-alarm-ecs-step-scaling
出力はなく、終了コード 0 で作成できました。AWS CLI 2.37.12 のままで通っています。
$ aws cloudwatch describe-alarms --alarm-names promql-step-scale-in
{
    "MetricAlarms": [
        {
            "AlarmName": "promql-step-scale-in",
            "AlarmActions": [
                "arn:aws:autoscaling:ap-northeast-1:<ACCOUNT_ID>:scalingPolicy:17b42db7-74ff-42c7-aa6c-31cc17ab9c0c:resource/ecs/service/promql-step/promql-step-app:policyName/promql-step-scale-in"
            ],
            "StateValue": "OK",
            "StateReason": "No time series evaluated to ALARM",
            "EvaluationCriteria": {
                "PromQLCriteria": {
                    "Query": "sum(app_active_requests) < 5",
                    "PendingPeriod": 120,
                    "RecoveryPeriod": 0
                }
            },
            "EvaluationInterval": 10
        }
    ]
}
(必要な項目だけ抜粋しています)
作成直後の状態は OK です。このとき負荷は止めてあって sum(app_active_requests) は 0 だったので、しばらくするとこのアラームが ALARM になり、タスクが 2 から 1 に減りました。
3. スケールアウトさせる
ここからが本題です。同時接続数を 15 / 25 / 35 と変えて、超過幅ごとに想定したステップが適用されるかを確かめました。まずは同時接続 15(超過幅 5)で 300 秒間の負荷をかけます。負荷をかける scripts/load.py と、クエリの値・アラームの状態・タスク数を 5 秒おきに記録する scripts/watch.sh は、どちらも自作スクリプトです。
scripts/load.py
#!/usr/bin/env python3
"""/slow へ同時接続数を一定に保ってリクエストを投げ続ける。

使い方: scripts/load.py <ALB の URL> <同時接続数> <継続秒数> [1リクエストの秒数=20]
"""
import sys
import threading
import time
import urllib.request
from datetime import datetime, timezone

url, concurrency, duration = sys.argv[1], int(sys.argv[2]), float(sys.argv[3])
seconds = float(sys.argv[4]) if len(sys.argv) > 4 else 20.0
deadline = time.time() + duration
errors = 0

def now():
    return datetime.now(timezone.utc).strftime("%Y-%m-%dT%H:%M:%SZ")

def worker():
    global errors
    while time.time() < deadline:
        remain = max(1.0, min(seconds, deadline - time.time()))
        try:
            urllib.request.urlopen(f"{url}/slow?seconds={remain}", timeout=remain + 30).read()
        except Exception:
            errors += 1
            time.sleep(1)

print(f"{now()} start concurrency={concurrency} duration={duration}s", flush=True)
threads = [threading.Thread(target=worker, daemon=True) for _ in range(concurrency)]
for t in threads:
    t.start()
for t in threads:
    t.join()
print(f"{now()} end errors={errors}", flush=True)
scripts/watch.sh
#!/bin/bash
# 5 秒おきに、クエリの値・アラームの状態・タスク数を 1 行ずつ出す(時刻は UTC)。
# 使い方: scripts/watch.sh <継続秒数>
set -uo pipefail
cd "$(dirname "$0")/.."
END=$(( $(date +%s) + $1 ))
val() { scripts/promql.sh "$1" | python3 -c 'import sys,json; r=json.load(sys.stdin)["data"]["result"]; print(r[0]["value"][1] if r else "-")' 2>/dev/null || echo "?"; }
echo "time(UTC) sum avg count scale-out scale-in desired running"
while [ "$(date +%s)" -lt "$END" ]; do
  T=$(date -u +"%H:%M:%S")
  SUM=$(val 'sum(app_active_requests)'); AVG=$(val 'avg(app_active_requests)'); CNT=$(val 'count(app_active_requests)')
  OUT=$(aws cloudwatch describe-alarms --alarm-names promql-step-scale-out --query 'MetricAlarms[0].StateValue' --output text)
  IN=$(aws cloudwatch describe-alarms --alarm-names promql-step-scale-in --query 'MetricAlarms[0].StateValue' --output text)
  SVC=$(aws ecs describe-services --cluster promql-step --services promql-step-app --query 'services[0].[desiredCount,runningCount]' --output text)
  echo "$T $SUM $AVG $CNT $OUT $IN $SVC"
  sleep 5
done
$ scripts/watch.sh 560 > logs/runA-watch.log &
$ python3 scripts/load.py <ALB の URL> 15 300 20
2026-11-11T12:15:58Z start concurrency=15 duration=300.0s
2026-11-11T12:20:59Z end errors=0
watch.sh の出力から、最初のスケールアウトまでを抜粋します。
time(UTC) sum avg count scale-out scale-in desired running
12:15:59 0 0 1 OK ALARM 1	1
12:16:07 15 15 1 OK OK 1	1
12:16:46 15 15 1 ALARM OK 2	1
12:17:33 15 15 1 ALARM OK 2	2
12:17:41 15 7.5 2 ALARM OK 2	2
sum が 15 になってしばらくするとスケールアウト用のアラームが ALARM になり、desired が 2 に、続いて running が 2 になりました。超過幅 5 で +1 のステップが適用されています。しきい値は API のどこにも数値として持っていないのに、クエリの比較式から超過幅が計算されてステップが決まりました。
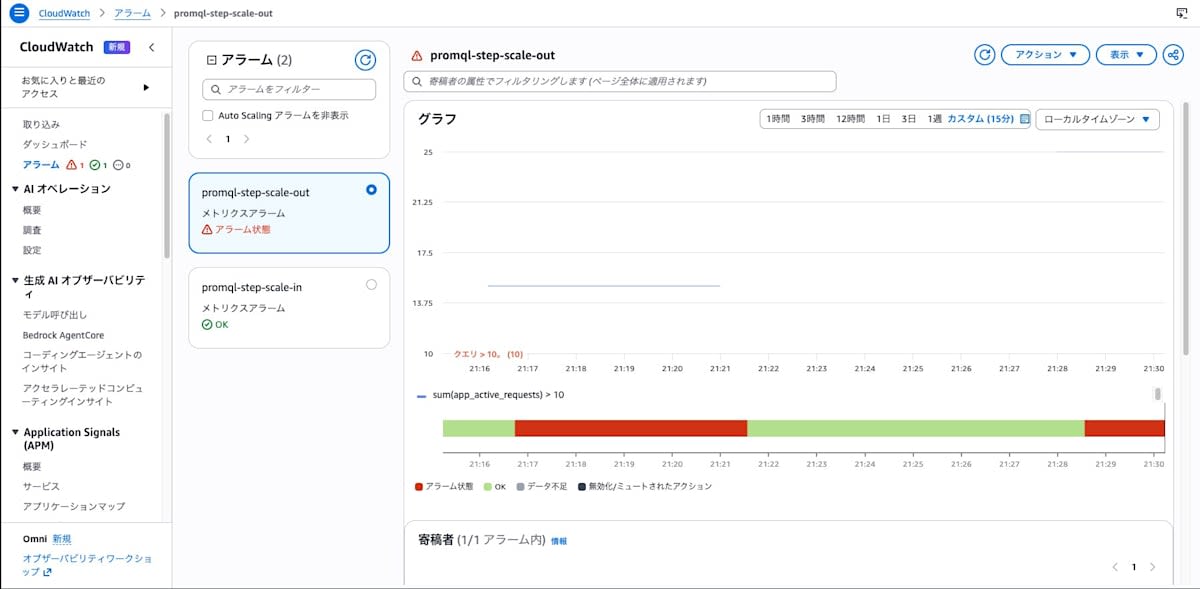
アラームのグラフには、しきい値線「クエリ > 10。(10)」と値 15 の線、ALARM だった時間帯の赤い帯が出ています。
同じ要領で、同時接続 25(超過幅 15)と 35(超過幅 25)も試しました。
| 実測 | 同時接続数(= sum の値) |
しきい値 | 超過幅 | 想定ステップ | 実際のタスク数の変化 |
|---|---|---|---|---|---|
| A | 15 | 10 | 5 | +1 | 1 → 2(+1) |
| B | 25 | 10 | 15 | +2 | 1 → 3(+2) |
| C | 35 | 10 | 25 | +3 | 1 → 4(+3) |
3 パターンとも、ポリシーに定義したステップどおりにタスクが増えました!
所要時間は次のとおりです。
| 実測 | 負荷開始 → ALARM | ALARM → アクティビティ開始 | アクティビティ開始 → RUNNING | 負荷開始 → RUNNING |
|---|---|---|---|---|
| A | 約 46 秒 | 0.27 秒 | 約 41〜49 秒 | 約 87〜95 秒 |
| B | 約 40 秒 | 0.16 秒 | 約 32〜39 秒 | 約 72〜79 秒 |
| C | 約 41 秒 | 0.18 秒 | 約 46〜54 秒 | 約 87〜95 秒 |
それぞれの時刻は画面ではなく CLI で取っています。負荷開始は load.py が出力した開始時刻、ALARM は aws cloudwatch describe-alarm-history の状態遷移の時刻、アクティビティ開始は aws application-autoscaling describe-scaling-activities の StartTime です。RUNNING は増えたタスクがすべて RUNNING になった時点で、watch.sh が describe-services の runningCount を数秒おきに見ているぶん、幅があります。
負荷開始から ALARM までの約 40〜46 秒は、保留期間 30 秒に、アプリの送信間隔(10 秒)と評価間隔(10 秒)のぶんが乗った時間です。ALARM になってからスケーリングアクティビティが始まるまでは 0.2〜0.3 秒で、ほぼ同時でした。
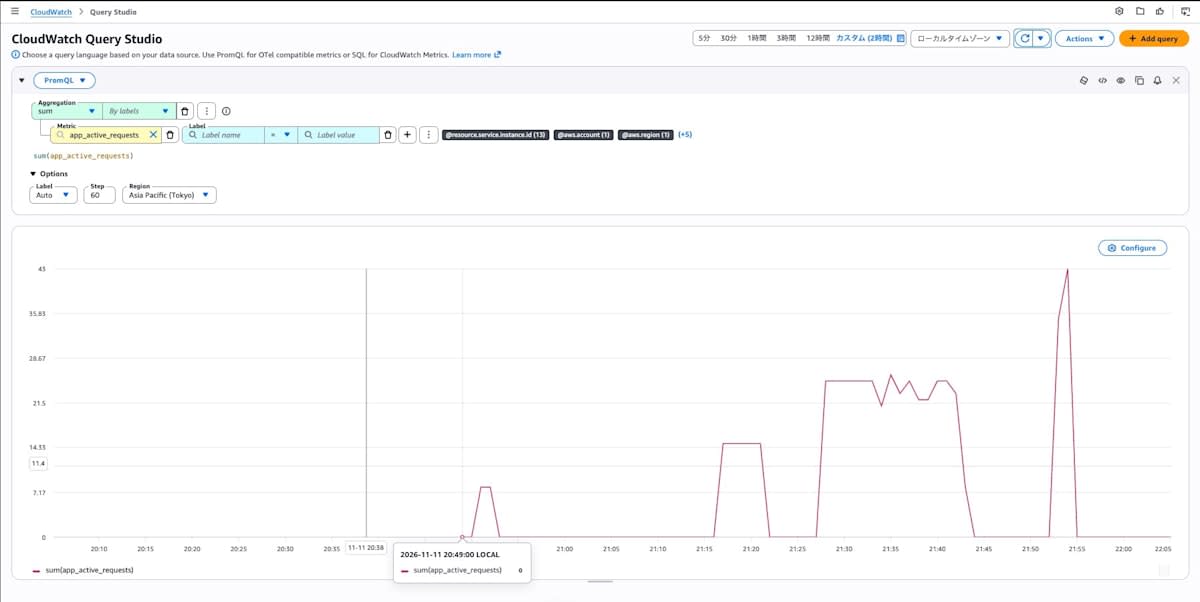
Query Studio で sum(app_active_requests) を見ると、動作確認のときの 8 に続いて、実測A の 15、実測B の 25、実測C の 35 の山が並んでいます。
4. スケールインさせる
実測B の負荷を止めたあとの経過を追いました。スケールイン用のアラームは sum(app_active_requests) < 5、保留期間 120 秒です。watch.sh の出力(抜粋)と、負荷終了からの経過は次のとおりです。
time(UTC) sum avg count scale-out scale-in desired running
12:42:51 25 4.166666666666667 6 ALARM OK 6	6
12:43:07 0 0 6 ALARM OK 6	6
12:43:38 0 0 6 OK OK 6	6
12:45:05 0 0 6 OK ALARM 5	6
12:45:13 0 0 6 OK ALARM 5	5
12:46:48 0 0 6 OK ALARM 4	4
| できごと | 負荷終了からの経過 |
|---|---|
| スケールアウト用アラームが OK に戻る | 約 40 秒 |
| スケールイン用アラームが ALARM になる | 約 131 秒 |
| 最初のスケールインのアクティビティ開始 | 約 131 秒 |
| 1 タスクに戻るアクティビティの終了 | 約 9 分 27 秒 |
値が 5 未満になってからスケールイン用アラームが ALARM になるまでは約 120 秒で、保留期間どおりでした。ALARM の 0.2 秒後に最初のアクティビティが始まっています。
その後は ALARM が続くあいだ、ちょうど 100 秒おきに −1 されました。6 → 1 まで 5 回、合計 6 分 40 秒です。負荷がないあいだアラームは ALARM のままですが、タスク数は最小の 1 で止まります。
気をつけたいポイント
ALARM が続くあいだスケーリングはくり返される
スケーリングアクションは、ほかのアクションと違って状態が変わったときだけでなく、ALARM が続くあいだくり返し実行されます(ドキュメント「Alarm actions」にも記載があります)。今回の実測でもそのとおりになりました。
| 実測 | タスク数 | アクティビティ開始の間隔 |
|---|---|---|
| A(スケールアウト、+1) | 1 → 2 → 3 → 4 | 140 秒、130 秒 |
| B(スケールアウト、+2) | 1 → 3 → 5 → 6(最大) | 130 秒、130 秒 |
| B のあと(スケールイン、−1) | 6 → 5 → 4 → 3 → 2 → 1 | 100 秒 × 4 |
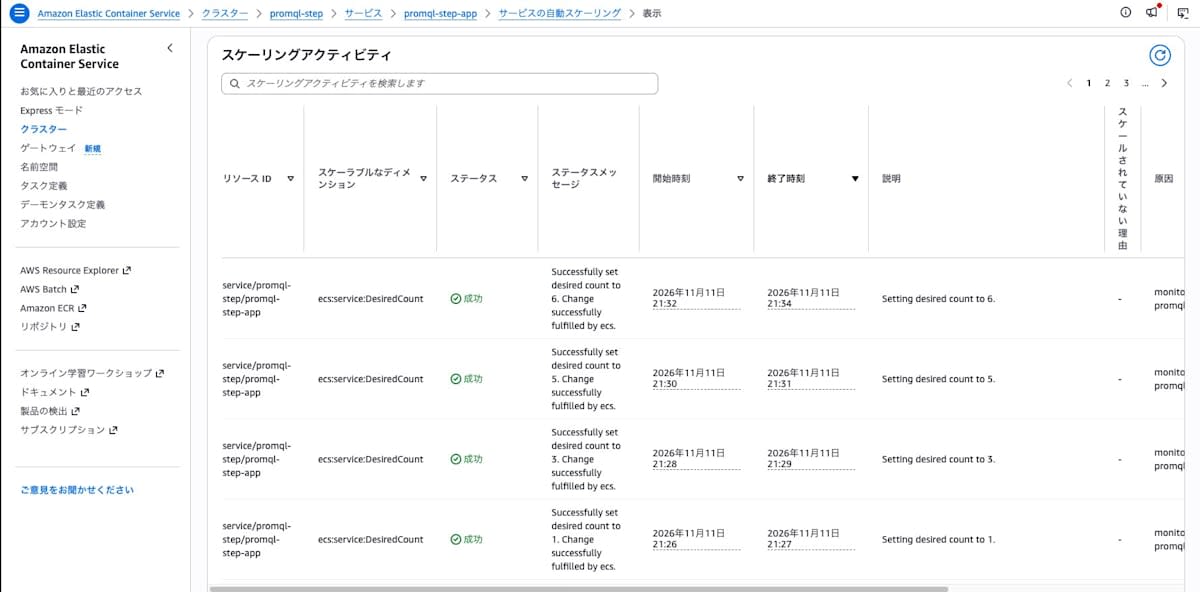
実測B では +2 がくり返され、3 回目は最大タスク数の 6 で頭打ちになりました。なお、アラーム履歴に Action が記録されるのは ALARM に変わったときの 1 回だけで、2 回目以降はスケーリングアクティビティ側にしか出てきません。
クールダウンは 60 秒ですが、間隔はそれより長くなっています。次のアクティビティは前のアクティビティの終了から 64〜69 秒後に始まっていたので、クールダウンはアクティビティの完了から数えているように見えます。スケールアウトは完了まで 64〜70 秒、スケールインは 31〜36 秒かかっており、間隔はおおよそ「アクティビティの所要時間 + クールダウン 60 秒 + 数秒」でした。
ここで気をつけたいのが、アラームの条件に sum を使っていた点です。
| 状態(実測A) | 実タスク数 | sum |
avg |
count |
|---|---|---|---|---|
| 負荷 15、スケール前 | 1 | 15 | 15 | 1 |
| 1 回目のスケール後 | 2 | 15 | 7.5 | 2 |
| 2 回目のスケール後 | 3 | 15 | 5 | 3 |
sum は全体の処理中リクエスト数なので、タスクが増えても 15 のまま下がりません。負荷が続く限り ALARM も続き、最大タスク数まで増え続けます。avg は 15 → 7.5 → 5 と下がっていきました。
もうひとつ、実測A では負荷を止めたあとにもう 1 回スケールアウトしています。負荷終了の約 15 秒後、値が 0 になったのとほぼ同時に 3 → 4 のアクティビティが始まりました。アラームが OK に戻ったのは負荷終了の約 34 秒後です。回復期間(30 秒)のあいだは ALARM のままなので、クールダウン明けと重なると余分に増えます。実測C は負荷を 120 秒で止めたので、次のクールダウン明けより前に OK へ戻り、くり返しは起きませんでした。
止まったタスクの時系列がしばらく残る
スケールインでタスクが止まっても、そのタスクの時系列はすぐには消えません。実測A のあと、タスクが 4 → 2 に減った時点でも count(app_active_requests) は 4 のままでした。
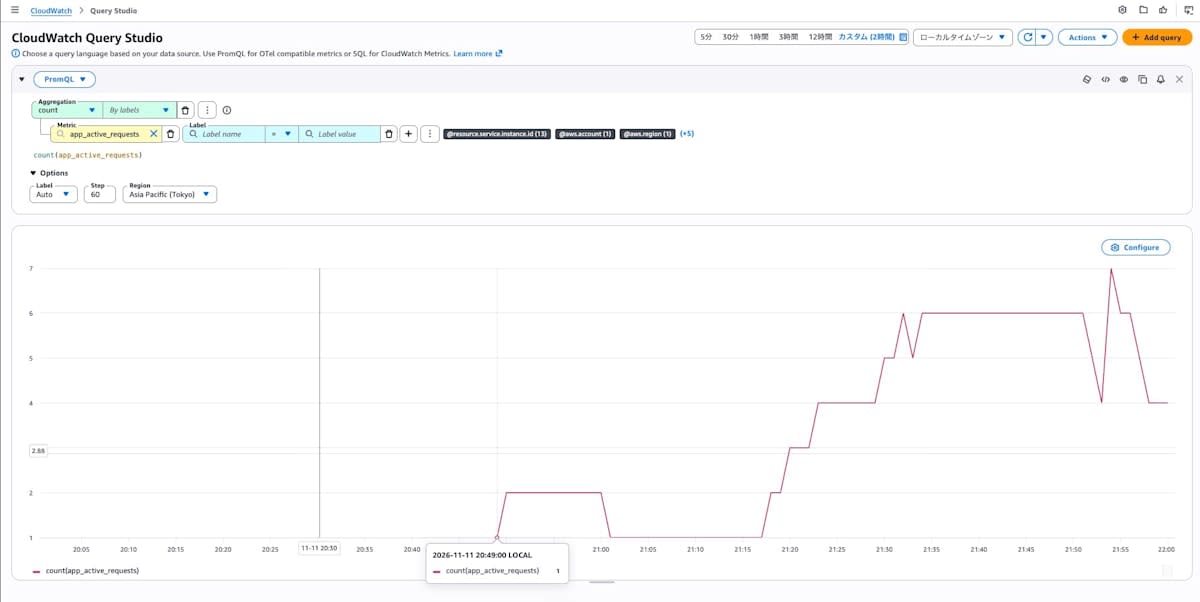
Query Studio で count を見ると、実際のタスク数とは違う動きをしているのが分かります。
この影響を受けるのが avg と count です。実測B の開始時、実際のタスクは 1 つでしたが count は 4 で、avg は 25 ÷ 4 = 6.25 になっていました。止まったタスクの最後の値が平均の分母に入るためです。sum は、残った時系列の値が 0 なので影響を受けませんでした。
タスクを 0 にして確かめたときは、送信が止まってから時系列が消えるまで約 6 分かかりました。
また、新しいタスクの時系列が現れる瞬間には、sum が 13 や 29、43 に一瞬ぶれることがありました。ALB の振り分けが変わる途中の値と、各クエリの評価時刻の差によるものと思われます。
スケーリングアクションを付けると、使えるクエリの形が決まっている
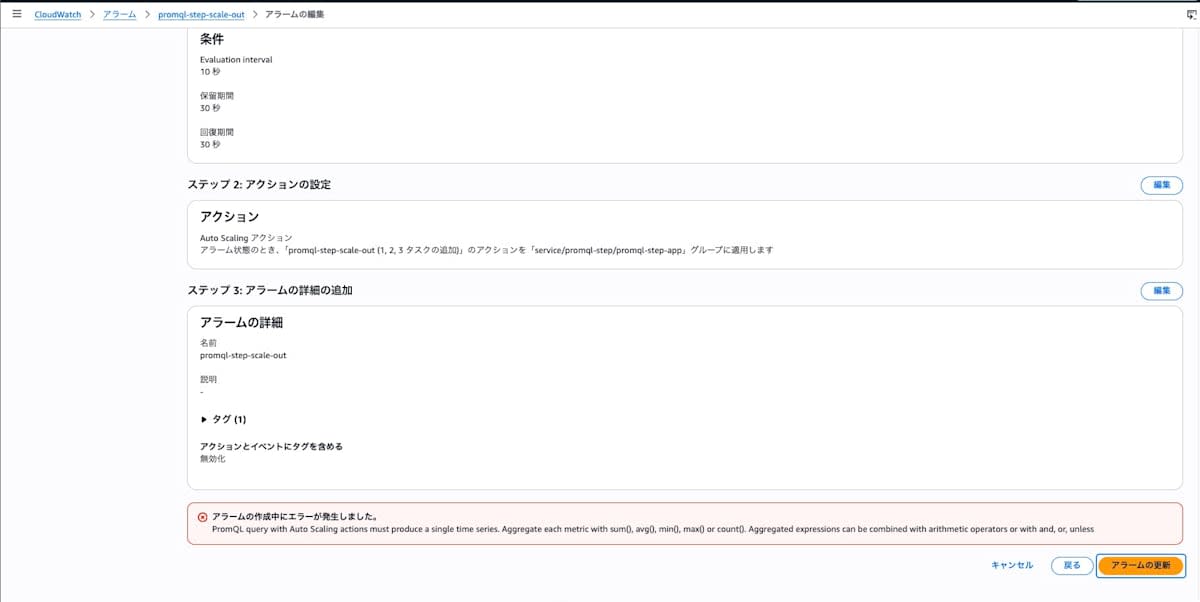
スケーリングポリシーをアクションに付けた PromQL アラームは、クエリの形が合わないと作成時に ValidationError になります。
$ aws cloudwatch put-metric-alarm --alarm-name promql-step-test-multi \
  --evaluation-criteria '{"PromQLCriteria":{"Query":"app_active_requests > 30","PendingPeriod":30,"RecoveryPeriod":30}}' \
  --evaluation-interval 10 --alarm-actions "<スケールアウト用ポリシーの ARN>"
aws: [ERROR]: An error occurred (ValidationError) when calling the PutMetricAlarm operation: PromQL query with Auto Scaling actions must produce a single time series. Aggregate each metric with sum(), avg(), min(), max() or count(). Aggregated expressions can be combined with arithmetic operators or with and, or, unless
クエリだけ変えて試した結果がこちらです。
| クエリ | 結果 | エラーメッセージ(全文) |
|---|---|---|
app_active_requests > 30(集約なし) |
ValidationError | PromQL query with Auto Scaling actions must produce a single time series. Aggregate each metric with sum(), avg(), min(), max() or count(). Aggregated expressions can be combined with arithmetic operators or with and, or, unless |
sum by ("@resource.service.instance.id") (app_active_requests) > 30 |
ValidationError | (同上) |
sum(app_active_requests)(比較なし) |
ValidationError | PromQL query with Auto Scaling actions must have a comparison condition in the form '<expr> <op> <threshold>' where <op> is >, >=, <, or <= |
sum(app_active_requests) > 50 * 2(右辺が式) |
ValidationError | PromQL query with Auto Scaling actions must compare against a numeric threshold |
sum(app_active_requests) > 100 and count(app_active_requests) > 0 |
ValidationError | PromQL query with Auto Scaling actions must have a comparison condition in the form '<expr> <op> <threshold>' where <op> is >, >=, <, or <= |
sum(app_active_requests) >= 100 |
作成できた | — |
100 < sum(app_active_requests)(左右が逆) |
作成できた | — |
sum(app_active_requests) > bool 100 |
作成できた | — |
使える形は「集約した式 + > >= < <= + 数値」です。しきい値と式の左右は逆でも通りますが、右辺が 50 * 2 のような式だと拒否されました。
単一の時系列かどうかは、実行結果ではなくクエリの構文で判定されています。試した時点でタスクは 1 つでしたが、集約なしのクエリは拒否されました。sum by (...) も同じです。
1 つ目のエラーメッセージには「and, or, unless で組み合わせられる」とありますが、... > 100 and count(...) > 0 は比較条件の形のエラーで拒否されました。比較は式全体の最後に 1 つだけ、という意味だと思われます(未検証です)。
> bool 100 は作成できました。このクエリは常に値 0 の時系列を返しますが、作成から 100 秒以上たっても状態は OK のままで、スケーリングも起きませんでした。スケーリングアクション付きのアラームでは、「時系列が返れば超過」とは別の評価をしているように見えます。
コンソールの場合は、クエリの入力時やアクションの選択時には止められません。既存のアラームのクエリを集約なしに書き換えてみたところ、最後の「アラームの更新」を押した時点で同じエラーメッセージが表示され、アラームは更新されませんでした。
ターゲット追跡ポリシーは作成できてしまい、発火したときに失敗する
ターゲット追跡スケーリングは未対応ですが、CLI でターゲット追跡ポリシーの ARN をアクションに指定すると、どうなるのでしょうか。確認用にターゲット追跡ポリシーを 1 つ作り、その ARN を渡してみました。
$ aws cloudwatch put-metric-alarm --alarm-name promql-step-test-target-tracking \
  --evaluation-criteria '{"PromQLCriteria":{"Query":"sum(app_active_requests) > 100","PendingPeriod":30,"RecoveryPeriod":30}}' \
  --evaluation-interval 10 --alarm-actions "<ターゲット追跡ポリシーの ARN>"
出力はなく、終了コード 0。作成時にはエラーになりませんでした。ステップスケーリングとターゲット追跡の ARN を 2 つ並べたアラームも作成できています。
発火させるために、クエリを常に真になる sum(app_active_requests) >= 0 に変えたところ、アラーム履歴は次のようになりました。
| 種別 | 内容 |
|---|---|
| StateUpdate | Alarm updated from OK to ALARM |
| Action | Failed to execute AutoScaling action: Alarm name promql-step-test-target-tracking doesn't match any alarm configured for scaling policy: arn:aws:autoscaling:ap-northeast-1:<ACCOUNT_ID>:scalingPolicy:17b42db7-74ff-42c7-aa6c-31cc17ab9c0c:resource/ecs/service/promql-step/promql-step-app:policyName/promql-step-target-tracking |
アクションの実行に失敗し、タスク数は変わらず、スケーリングアクティビティにも何も出ませんでした。クエリの形は作成時に検査されますが、ポリシーの種別は作成時には検査されません。失敗に気づけるのは発火したあとのアラーム履歴だけなので、CLI や IaC で ARN を渡すときはポリシーの種別を確かめておきたいところです。
コンソールでは、Auto Scaling アクションのプルダウンに出てくるのはステップスケーリングの 2 つだけで、ターゲット追跡ポリシーは選べませんでした。ただ、従来のメトリクスアラームの編集画面でも同じプルダウンにターゲット追跡ポリシーは出てこなかったので、PromQL アラームに限らないコンソールの仕様のように見えます。
メトリクスが途切れるとアラームは OK になる
最後に、メトリクスが届かなくなったときの挙動です。最小タスク数を 0 に変えて、タスクが止まったあとを観察しました(- はクエリの結果が空だったことを表します)。
time(UTC) sum avg count scale-out scale-in desired running
13:11:16 0 0 1 OK ALARM 1	1
13:11:24 0 0 1 OK ALARM 0	1
13:11:32 0 0 1 OK ALARM 0	0
13:17:28 - - - OK ALARM 0	0
13:17:36 - - - OK OK 0	0
最小タスク数を 0 にすると、ALARM のままだったスケールイン用アラームが 8 秒後にタスクを 0 にしました。その後もしばらくは最後の値(0)が返り続け、約 6 分後にクエリの結果が空になったところで、アラームは OK に変わっています(理由は「No time series evaluated to ALARM」)。INSUFFICIENT_DATA にはなりません。クエリの結果が空なら「超過している時系列がない」という扱いです。
このあいだ、スケールアウト用アラームは OK のままでした。タスクが 0 でメトリクスがなければ sum(app_active_requests) > 10 が真になることはないので、このメトリクスだけでは 0 タスクからのスケールアウトはできません。
小ネタ: curl の SigV4 で PromQL API を叩くときは POST で
検証中にハマったのがここです。curl 8.7.1 の --aws-sigv4 で PromQL API を GET(-G と --data-urlencode)で叩くと、sum(app_active_requests) > 5 のようなクエリが署名エラーになりました。
{"message":"The request signature we calculated does not match the signature you provided. Check your AWS Secret Access Key and signing method. Consult the service documentation for details."}
sum(app_active_requests) のように " > @ を含まないクエリは通ります。クエリ文字列に > や " が入ると、curl が署名用に正規化したクエリ文字列とサーバー側の正規化が合わないのが原因かなと思っています。
-X POST でフォームのボディとして送ると、同じクエリが通りました。PromQL は記号が多いので、SigV4 で叩くときは最初から POST にしておくのが安全です。
結果
| 検証項目 | 結果 |
|---|---|
| タスクごとの時系列を 1 本にまとめる | sum / avg でラベルなしの 1 本になる。比較式を付けると、条件を満たすとき元の値を持つ時系列が返る |
| PromQL アラームとポリシーの紐付け | コンソールでも AWS CLI 2.37.12 でも、ステップスケーリングポリシーを指定して作成できた |
| スケールアウト | 超過幅 5 / 15 / 25 で +1 / +2 / +3。負荷開始から ALARM まで約 40〜46 秒、RUNNING まで約 72〜95 秒 |
| スケールイン | 保留期間 120 秒どおりに ALARM になり、100 秒おきに −1。最小タスク数で止まる |
| クエリの形の制約 | 集約なし・比較なし・右辺が式のクエリは、作成時に ValidationError |
| ターゲット追跡ポリシー | CLI では作成できるが、発火時にアクションが失敗する。コンソールでは選べない |
| メトリクスが途切れたとき | アラームは OK になる。0 タスクからのスケールアウトはできない |
まとめ
- OTel で送っているカスタムメトリクスだけで、アラームの評価から ECS サービスのスケーリングまでつながった。今回の構成では、スケーリング用に従来のカスタムメトリクスを別に送っていない
- 集約に
sumを使うかavgを使うかで、くり返しの止まり方も、止まったタスクの時系列の影響も変わる。しきい値だけでなく集約の選び方まで含めてクエリを決めたい - 間違いには「作成時に止めてもらえるもの」(クエリの形)と「発火するまで分からないもの」(ポリシーの種別)がある。後者はアラーム履歴の Action を見て確かめる
この記事が、OTel のメトリクスでスケーリングを組みたい方の参考になれば幸いです。
最後まで読んでいただき、誠にありがとうございました。