Kiro のアクティビティレポートを OpenTelemetry でエクスポートして PromQL で集計してみた

はじめに
Kiro Enterprise のアクティビティレポートでは、2026年2月に S3 への CSV 出力が、2026年9月に OpenTelemetry(OTel)による出力がサポートされました。
OTel 経由で CloudWatch に取り込まれたメトリクスは、PromQL でクエリできます。
本記事では、S3 への CSV 出力と、OTel 経由で CloudWatch へ出力する設定をともに有効化し、同日のデータを対象に、S3 の CSV に出力された値を PromQL でも取得できるか検証しました。
検証内容
OTel エクスポートを有効化した環境で、us-east-1 の CloudWatch に届いたメトリクスを PromQL から取得しました。
OTel エクスポートの構成
PromQL で取得するために必要な構成を、公式ドキュメントの要件と稼働中の設定の両方から確認しました。
Kiro はメトリクスを 1 日 1 回、02:00 UTC に送信します。ある活動日のメトリクスは翌日に送られます。送信に失敗した日付は再送されず、バックフィルも行われません。
宛先が CloudWatch の場合、ベアラー API キーが必要です。Kiro はエクスポートを SigV4 で署名できないためです。エンドポイントは https://monitoring.<region>.amazonaws.com/v1/metrics です。プロトコルは HTTP/protobuf で、認証ヘッダーは Authorization=Bearer <api-key> です。
KMS キー、Secrets Manager のシークレット、Kiro プロファイルは同一リージョンに置く必要があります。シークレットの暗号化に既定の aws/secretsmanager キーは使えません。Kiro がシークレットを別の AWS アカウントから読むためです。データポイントには IAM Identity Center のユーザー ID が入り、解決できる場合はメールアドレスも含まれます。これらは CloudWatch のメトリクスラベルとして保存されるため、PromQL やダッシュボードを参照できる利用者から見える状態になります。
作成したリソースは、CMK、CloudWatch 送信用の IAM ユーザーとサービス固有の API キー、エンドポイントと認証情報を入れたシークレットです。今回、シークレットは Kiro プロファイルと同じアカウントに作成しました。put-key-policy はキーポリシー全体を置き換えます。kms-key-policy.json には既定の Enable IAM User Permissions ステートメントを残したまま、Kiro 向けのステートメントを追加しました。
# 1. CMK を作成する(既定の aws/secretsmanager では Kiro から復号できない)
aws kms create-key --description "Kiro OTel export secret encryption" --region us-east-1
aws kms create-alias --alias-name alias/kiro-otel-export --target-key-id <key-id> --region us-east-1
aws kms put-key-policy --key-id <key-id> --policy-name default \
  --policy file://kms-key-policy.json --region us-east-1

# 2. CloudWatch へ送信するための IAM ユーザーと API キーを作る
aws iam create-user --user-name kiro-otel-metrics-user
aws iam attach-user-policy --user-name kiro-otel-metrics-user \
  --policy-arn arn:aws:iam::aws:policy/CloudWatchAPIKeyAccess
aws iam create-service-specific-credential --user-name kiro-otel-metrics-user \
  --service-name cloudwatch.amazonaws.com

# 3. エンドポイントと認証情報をシークレットに入れる(Kiro プロファイルと同一リージョン)
# API キーをシェル履歴に残したくない場合は --secret-string file://secret.json でも渡せる
aws secretsmanager create-secret --name kiro-otel-export --kms-key-id <key-id> \
  --secret-string '{"OTEL_EXPORTER_OTLP_ENDPOINT":"https://monitoring.us-east-1.amazonaws.com/v1/metrics","OTEL_EXPORTER_OTLP_HEADERS":"Authorization=Bearer <SERVICE_CREDENTIAL_SECRET>"}' \
  --region us-east-1
aws secretsmanager put-resource-policy --secret-id kiro-otel-export \
  --resource-policy file://secret-resource-policy.json --region us-east-1
エクスポートの有効化そのものは、Kiro のコンソールで操作します。
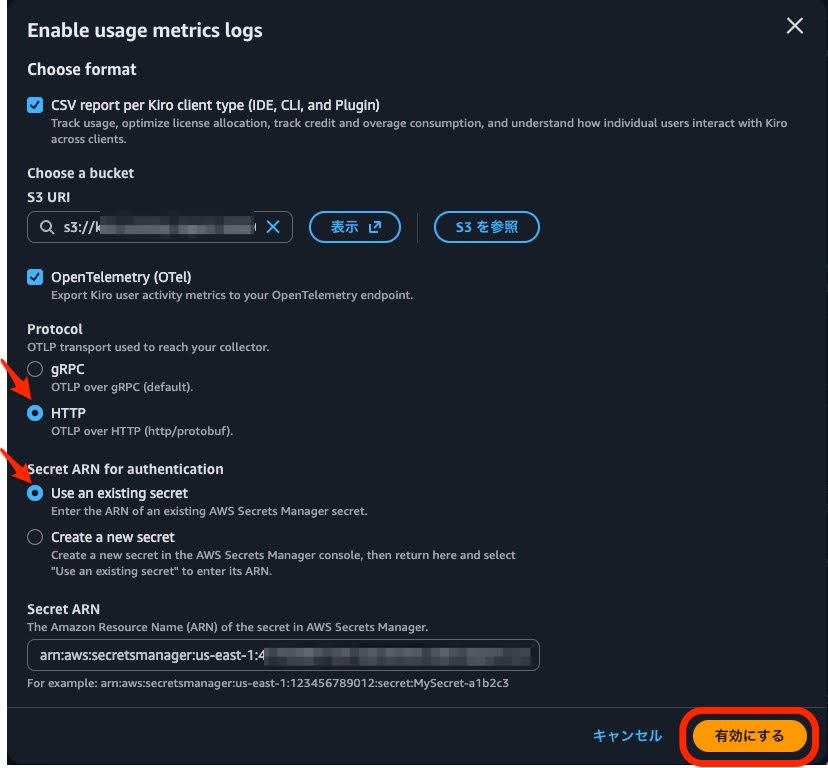
「Enable usage metrics logs」ダイアログでは、CSV レポートと OpenTelemetry の両方にチェックを入れました。Protocol は HTTP(OTLP over HTTP (http/protobuf))、認証では「Use an existing secret」を選び、既存シークレットの ARN を指定しました。
上記のコマンドで作成したリソースについて、現在の設定を確認しました。KMS キーポリシーと Secrets Manager のリソースポリシーは、いずれも q.amazonaws.com への許可です。シークレットのリソースポリシーは動作確認のための最小許可で、呼び出し元を絞る条件キーは付けていません。
稼働中の設定(KMS キーポリシー・シークレット・IAM・list-metrics)
{
  "kms_get_key_policy.Policy の Kiro 向けステートメント": {
    "Sid": "AllowKiroDecryptViaSecretsManager",
    "Effect": "Allow",
    "Principal": {
      "Service": "q.amazonaws.com"
    },
    "Action": [
      "kms:Decrypt",
      "kms:DescribeKey"
    ],
    "Resource": "*",
    "Condition": {
      "StringEquals": {
        "kms:ViaService": "secretsmanager.us-east-1.amazonaws.com"
      }
    }
  },
  "secret_describe": {
    "Name": "kiro-otel-export",
    "KmsKeyId": "xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxff",
    "LastAccessedDate": "2026-09-14T09:00:00+09:00"
  },
  "secret_resource_policy.ResourcePolicy のステートメント": {
    "Sid": "AllowKiroGetSecretValue",
    "Effect": "Allow",
    "Principal": {
      "Service": "q.amazonaws.com"
    },
    "Action": "secretsmanager:GetSecretValue",
    "Resource": "*"
  },
  "iam_attached_user_policies": [
    {
      "PolicyName": "CloudWatchAPIKeyAccess",
      "PolicyArn": "arn:aws:iam::aws:policy/CloudWatchAPIKeyAccess"
    }
  ],
  "cloudwatch list-metrics --namespace kiro": []
}
OTLP で取り込んだメトリクスは、従来のメトリクス API からは見えません。namespace に kiro を指定した list-metrics の応答は空でした。公式ドキュメントの記載も同じです。GetMetricData や ListMetrics などの対象は CloudWatch Metrics (Classic) だけです。OpenTelemetry Metrics には PromQL クエリ API を使うとあります。
PromQL の実行方法
PromQL の HTTP API は SigV4 署名で呼び出します。SigV4 のサービス名は monitoring です。エンドポイントは https://monitoring.<region>.amazonaws.com/api/v1/<operation> です。
必要な IAM 権限は API オペレーションによって異なります。/api/v1/query と /api/v1/query_range には cloudwatch:GetMetricData と cloudwatch:ListMetrics の 2 つが必要です。series とラベル系の API オペレーションには ListMetrics だけが必要です。
制限値として、1 リクエストあたりの最大範囲は 7 days、1 クエリで返る最大系列数は 500、実行タイムアウトは 20 秒と記載されています。対応リージョンの表には、OTLP メトリクスの取り込み、PromQL クエリ、Query Studio の 3 列があります。us-east-1 や ap-northeast-1 を含む掲載リージョンは、いずれも 3 列すべてに対応していると記載されています。
署名が必要なため、botocore で署名だけを行う最小のクライアントを用意しました。
REGION = "us-east-1"
HOST = f"https://monitoring.{REGION}.amazonaws.com"
SERVICE = "monitoring"

def call(path, params):
    creds = botocore.session.get_session().get_credentials().get_frozen_credentials()
    if METHOD == "GET":
        qs = urllib.parse.urlencode(params, doseq=True, quote_via=urllib.parse.quote)
        url = f"{HOST}{path}" + (f"?{qs}" if qs else "")
        req = AWSRequest(method="GET", url=url)
        SigV4Auth(creds, SERVICE, REGION).add_auth(req)
        return _send(urllib.request.Request(url, headers=dict(req.headers), method="GET"))
これを promql.py として保存し、次のように実行しました。
# メトリクス名の一覧(start / end に epoch 秒を渡す。付けないと空配列が返る)
python3 promql.py names 1788825600 1789344000

# ラベル名の一覧
python3 promql.py labels 1788825600 1789344000

# インスタントクエリ(レポート日 2026-09-13 のデータポイントは 2026-09-14T00:00Z に立つ)
python3 promql.py query 'sum by ("kiro.client.type") ({"kiro.daily.credits", date="2026-09-13"})' 1789344000
promql.py の全文
#!/usr/bin/env python3
"""CloudWatch PromQL (Prometheus 互換 API) を SigV4 で叩く最小クライアント.

usage:
  promql.py labels <start-epoch> <end-epoch>
  promql.py names <start-epoch> <end-epoch>
  promql.py date-values <start-epoch> <end-epoch>
  promql.py series '<selector>'
  promql.py query '<promql>' [epoch-seconds]
  promql.py query_range '<promql>' <start-epoch> <end-epoch> <step>
"""
import json
import sys

import botocore.session
from botocore.auth import SigV4Auth
from botocore.awsrequest import AWSRequest
import urllib.request
import urllib.parse

REGION = "us-east-1"
HOST = f"https://monitoring.{REGION}.amazonaws.com"
SERVICE = "monitoring"

METHOD = "GET"

def call(path, params):
    creds = botocore.session.get_session().get_credentials().get_frozen_credentials()
    if METHOD == "GET":
        qs = urllib.parse.urlencode(params, doseq=True, quote_via=urllib.parse.quote)
        url = f"{HOST}{path}" + (f"?{qs}" if qs else "")
        req = AWSRequest(method="GET", url=url)
        SigV4Auth(creds, SERVICE, REGION).add_auth(req)
        return _send(urllib.request.Request(url, headers=dict(req.headers), method="GET"))
    body = urllib.parse.urlencode(params, doseq=True)
    url = f"{HOST}{path}"
    req = AWSRequest(
        method="POST",
        url=url,
        data=body,
        headers={"Content-Type": "application/x-www-form-urlencoded"},
    )
    SigV4Auth(creds, SERVICE, REGION).add_auth(req)
    prepared = urllib.request.Request(
        url, data=body.encode(), headers=dict(req.headers), method="POST"
    )
    return _send(prepared)

def _send(prepared):
    try:
        with urllib.request.urlopen(prepared) as resp:
            return resp.status, resp.read().decode()
    except urllib.error.HTTPError as e:
        return e.code, e.read().decode()

def main():
    cmd = sys.argv[1]
    # /api/v1/labels と /api/v1/label/<name>/values は start / end を付けないと
    # 空配列が返る。第2・第3引数で epoch 秒を受け取る。
    window = {}
    if cmd in ("labels", "names", "date-values") and len(sys.argv) > 3:
        window = {"start": sys.argv[2], "end": sys.argv[3]}
    if cmd == "labels":
        status, out = call("/api/v1/labels", window)
    elif cmd == "names":
        status, out = call("/api/v1/label/__name__/values", window)
    elif cmd == "date-values":
        status, out = call("/api/v1/label/date/values", window)
    elif cmd == "series":
        status, out = call("/api/v1/series", {"match[]": sys.argv[2]})
    elif cmd == "query":
        p = {"query": sys.argv[2]}
        if len(sys.argv) > 3:
            p["time"] = sys.argv[3]
        status, out = call("/api/v1/query", p)
    elif cmd == "query_range":
        p = {
            "query": sys.argv[2],
            "start": sys.argv[3],
            "end": sys.argv[4],
            "step": sys.argv[5],
        }
        status, out = call("/api/v1/query_range", p)
    else:
        print(__doc__)
        sys.exit(2)
    print(f"HTTP {status}")
    try:
        print(json.dumps(json.loads(out), indent=2, ensure_ascii=False))
    except json.JSONDecodeError:
        print(out)

if __name__ == "__main__":
    main()
取得できたメトリクス名は次のとおりです。時間範囲を渡さずに実行した場合は、空配列が返りました。
{
  "status": "success",
  "data": [
    "kiro.daily.conversations",
    "kiro.daily.credits",
    "kiro.daily.messages",
    "kiro.daily.model_messages",
    "kiro.daily.overage_credits",
    "otel.sdk.metric_reader.collection.duration"
  ]
}
Kiro の日次メトリクスが 5 つと、OTel SDK 内部のメトリクスが 1 つ届いていました。
ラベル名の一覧には、日付、ユーザー、クライアント種別、モデル名、サブスクリプション、利用上限に対応するものがそろっていました。
取得できたラベル名の一覧
{
  "status": "success",
  "data": [
    "@aws.account",
    "@aws.region",
    "@instrumentation.@name",
    "@instrumentation.@schema_url",
    "@instrumentation.@version",
    "@resource.@schema_url",
    "@resource.kiro.account.id",
    "@resource.kiro.profile.arn",
    "@resource.kiro.profile.id",
    "@resource.service.name",
    "@resource.telemetry.sdk.language",
    "@resource.telemetry.sdk.name",
    "@resource.telemetry.sdk.version",
    "__monotonicity__",
    "__name__",
    "__temporality__",
    "__type__",
    "__unit__",
    "date",
    "kiro.client.type",
    "kiro.model.name",
    "kiro.overage.cap",
    "kiro.overage.enabled",
    "kiro.subscription.tier",
    "kiro.usage.limit",
    "kiro.user.email",
    "kiro.user.id",
    "kiro.user.new",
    "otel.component.name",
    "otel.component.type"
  ]
}
セレクタにはメトリクス名を明示する必要があります。メトリクス名を正規表現だけで指定したところ、400 が返りました。
メトリクス名を正規表現だけで指定したときの応答
{
  "query": "{__name__=~\"kiro.daily..*\"}",
  "http": 400,
  "response": {
    "error": "Selector must have a metric name. Found matchers: [__name__]",
    "errorType": "bad_data",
    "status": "error"
  }
}
CSV との突き合わせ
同じ内容は S3 の CSV レポートにも出ています。CSV は日付・ユーザー・クライアント種別ごとに 1 行です。
Date,UserId,Client_Type,Chat_Conversations,Credits_Used,Overage_Cap,Overage_Credits_Used,Overage_Enabled,ProfileId,Subscription_Tier,Total_Messages,New_User,User_Email,Usage_Limit,auto_messages,claude_opus_5_messages,claude_sonnet_4.6_messages,gpt_5.6_luna_messages,gpt_5.6_sol_messages,gpt_5.6_terra_messages
2026-09-13,xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxx0a,KIRO_CLI,323,752.1328506192372,5000.0,0.0,true,arn:aws:codewhisperer:us-east-1:123456789012:profile/xxxxxxxxxxxxx,POWER,1401,false,xxxxxxxx-a@example.com,10000,1401,0,0,0,0,0
カラムとメトリクス・ラベルの対応は次のとおりです。
| CSV カラム | PromQL |
|---|---|
| Credits_Used | kiro.daily.credits |
| Overage_Credits_Used | kiro.daily.overage_credits |
| Total_Messages | kiro.daily.messages |
| Chat_Conversations | kiro.daily.conversations |
<model>_messages |
kiro.daily.model_messages の kiro.model.name ラベル |
| Date | date ラベル |
| UserId | kiro.user.id ラベル |
| Client_Type | kiro.client.type ラベル |
| Subscription_Tier | kiro.subscription.tier ラベル |
| Usage_Limit | kiro.usage.limit ラベル |
| Overage_Cap / Overage_Enabled | kiro.overage.cap / kiro.overage.enabled ラベル |
| New_User | kiro.user.new ラベル |
| User_Email | kiro.user.email ラベル |
CSV はクライアント種別ごとにファイルが分かれるため、同じ日の 3 ファイルをまとめて合計しました。
for path in sys.argv[1:]:
    for row in csv.DictReader(open(path)):
        key = (row["Date"][:10], row["Client_Type"])
        credits[key] += float(row["Credits_Used"] or 0)
        messages[row["Date"][:10]] += int(row["Total_Messages"] or 0)
# 同じ日の CLI / IDE / WEB の 3 ファイルをまとめて集計する
python3 csv_aggregate.py s3-2026-09-12-*.csv s3-2026-09-13-*.csv
クライアント種別ごとのクレジットと、日次のメッセージ数が出ました。
2026-09-12	KIRO_CLI	929.981886
2026-09-12	KIRO_IDE	30.041061
2026-09-12	KIRO_WEB	34.783152
2026-09-13	KIRO_CLI	1795.626213
2026-09-13	KIRO_IDE	70.219843
2026-09-13	KIRO_WEB	29.099002
2026-09-12	Total_Messages	2200
2026-09-13	Total_Messages	3551
PromQL 側では、クレジットをクライアント種別で合計し、同じ日を対象に問い合わせました。
{
  "query": "sum by (\"kiro.client.type\") ({\"kiro.daily.credits\", date=\"2026-09-13\"})",
  "response": {
    "status": "success",
    "data": {
      "resultType": "vector",
      "result": [
        {
          "metric": {
            "kiro.client.type": "KIRO_IDE"
          },
          "value": [
            1789344000.0,
            "70.21984331824211"
          ]
        },
        {
          "metric": {
            "kiro.client.type": "KIRO_CLI"
          },
          "value": [
            1789344000.0,
            "1795.6262133304313"
          ]
        },
        {
          "metric": {
            "kiro.client.type": "KIRO_WEB"
          },
          "value": [
            1789344000.0,
            "29.099002319237147"
          ]
        }
      ]
    }
  }
}
レポート日 2026-09-13 のクレジットを並べます。S3 CSV 側は KIRO_CLI / KIRO_IDE / KIRO_WEB の 3 ファイルを合計した値です。
| クライアント種別 | S3 CSV | PromQL |
|---|---|---|
| KIRO_CLI | 1795.626213 | 1795.6262133304313 |
| KIRO_IDE | 70.219843 | 70.21984331824211 |
| KIRO_WEB | 29.099002 | 29.099002319237147 |
上の表の S3 CSV 列は、集計スクリプトの出力書式で小数 6 桁に丸めた値です。CSV の Credits_Used 自体は、PromQL と同じく float の全桁が含まれています。メッセージ数も、2026-09-12 が 2200、2026-09-13 が 3551 で、両者一致しました。PromQL 側の値は、後述の SQL 集計で出したものです。
利用内訳の取得
クライアント種別ごとの内訳は、前節のクエリでそのまま取れました。モデル別のメッセージ数は、モデル名のラベルで合計します。
{
  "query": "sum by (\"kiro.model.name\") ({\"kiro.daily.model_messages\", date=\"2026-09-13\"})",
  "response": {
    "status": "success",
    "data": {
      "resultType": "vector",
      "result": [
        {
          "metric": {
            "kiro.model.name": "gpt-5.6-sol"
          },
          "value": [
            1789344000.0,
            "37"
          ]
        },
        {
          "metric": {
            "kiro.model.name": "gpt-5.6-luna"
          },
          "value": [
            1789344000.0,
            "8"
          ]
        },
        {
          "metric": {
            "kiro.model.name": "claude-opus-5"
          },
          "value": [
            1789344000.0,
            "714"
          ]
        },
        {
          "metric": {
            "kiro.model.name": "auto"
          },
          "value": [
            1789344000.0,
            "2443"
          ]
        },
        {
          "metric": {
            "kiro.model.name": "gpt-5.6-terra"
          },
          "value": [
            1789344000.0,
            "345"
          ]
        },
        {
          "metric": {
            "kiro.model.name": "claude-sonnet-4.6"
          },
          "value": [
            1789344000.0,
            "4"
          ]
        }
      ]
    }
  }
}
CSV でモデルごとのカラムに分かれていた値が、PromQL では 1 つのメトリクスの系列として返りました。
クレジットの集計は、ダッシュボードのウィジェットにも配置できます。ウィジェットの properties.data.queries に PromQL を書き、language に PromQL を指定します。
{
  "type": "chart",
  "x": 0,
  "y": 0,
  "width": 12,
  "height": 6,
  "properties": {
    "view": "line",
    "title": "日次クレジット(クライアント種別)",
    "region": "us-east-1",
    "data": {
      "queries": [
        {
          "id": "credits_by_client",
          "type": "cloudwatch-metrics",
          "language": "PromQL",
          "query": "sum by (\"kiro.client.type\") ({\"kiro.daily.credits\"})",
          "label": "__verbose__",
          "step": 86400
        }
      ]
    },
    "plotOptions": {
      "legend": {
        "position": "bottom",
        "show": true
      },
      "style": {
        "lineWidth": 2
      }
    }
  }
}
ウィジェットを 5 枚並べた定義を dashboard-kiro-otel.json として保存し、ダッシュボードを作成しました。
aws cloudwatch put-dashboard \
  --dashboard-name kiro-otel-promql \
  --dashboard-body file://dashboard-kiro-otel.json \
  --region us-east-1
応答には、ウィジェット定義の座標指定が無視されるという検証メッセージが 5 枚分返りました。
{
    "DashboardValidationMessages": [
        {
            "DataPath": "/widgets/0",
            "Message": "The \"x\" property is not expected to be part of a widget definition, will be ignored"
        }
    ]
}
作成したダッシュボードには、日次クレジットのクライアント種別別の折れ線と、最新値を表示する number ウィジェットを置きました。モデル別メッセージの円グラフ、ヘビーユーザー上位 10 の棒グラフ、サブスクリプション階層別のクレジットと超過クレジットの折れ線も並べています。number ウィジェットは、期間内の合計ではなく最新のデータポイントの値を表示します。
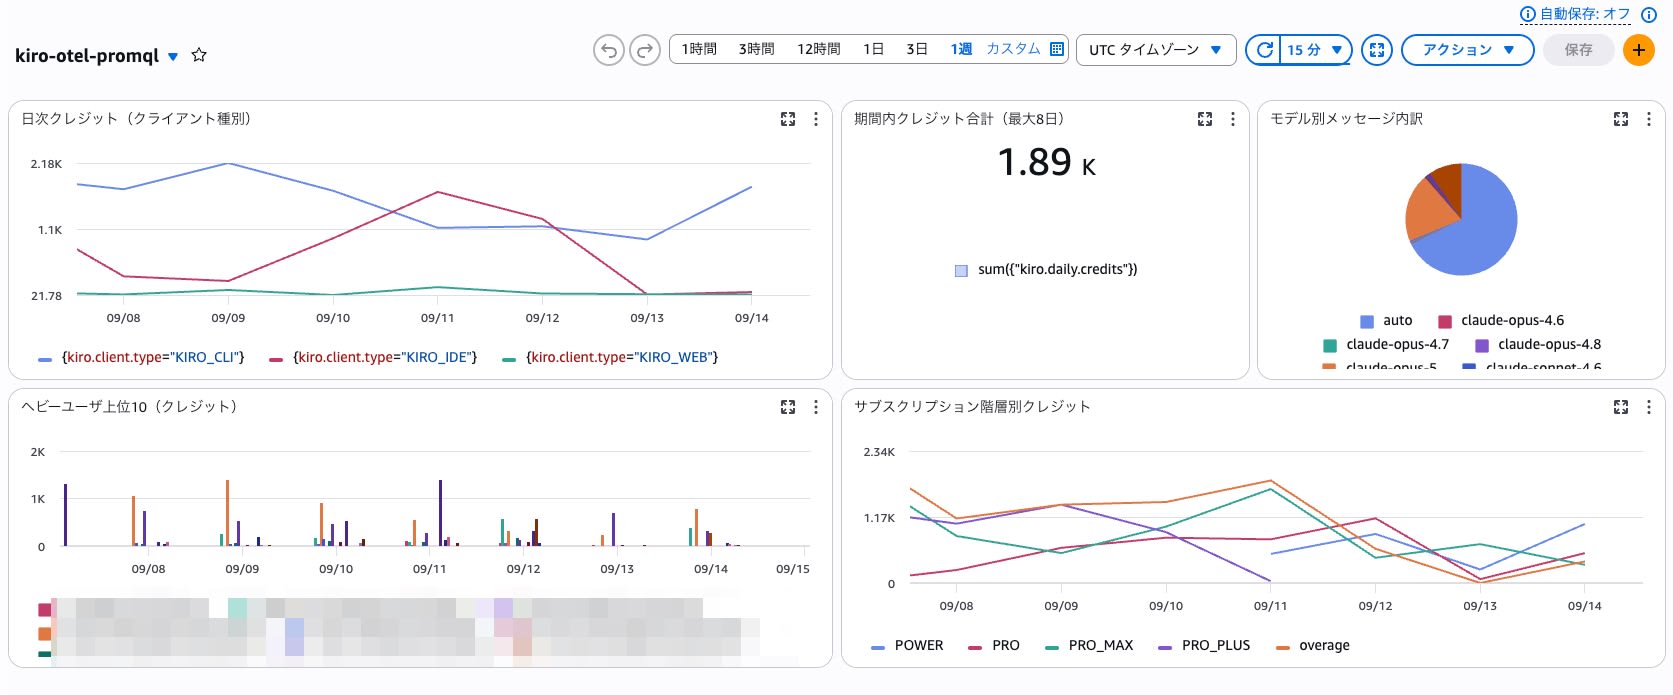
1 リクエストの時間範囲の上限(後述の実測で 8 日)に収まるよう、このダッシュボードは 1 週間表示にしています。
月間集計と DB 化
クレジットの月間合計を PromQL で取得する際の制約を確認します。
{
  "query": "sum({\"kiro.daily.credits\"})",
  "http": 400,
  "response": {
    "error": "Query time range 1209600000ms exceeds 691200000ms limit",
    "errorType": "bad_data",
    "status": "error"
  }
}
上限は 691200000 ミリ秒、つまり 8 日でした。ドキュメントの記載は 7 日なので、実測のほうが 1 日長い値です。
{
  "query": "sum(sum_over_time({\"kiro.daily.credits\"}[7d]))",
  "http": 400,
  "response": {
    "error": "Range selector 604800000ms exceeds 86400000ms limit",
    "errorType": "bad_data",
    "status": "error"
  }
}
range selector は 86400000 ミリ秒、つまり 1 日までです。月合計は 1 リクエストでは出せないため、期間を 8 日以下の窓に分割して日付ラベルでマージするスクリプトを書きました。データポイントのタイムスタンプはレポート日の翌日 00:00 UTC に立つため、問い合わせ窓は 1 日後ろへずらしています。
MAX_WINDOW_DAYS = 8  # 実測の上限(ドキュメントの記載は 7 日)

def chunks(first, last):
    """レポート日 first..last を 8 日以下の窓に分割する。

    データポイントのタイムスタンプはレポート日 +1 日 00:00 UTC に立つため、
    問い合わせ窓は 1 日後ろへずらす。
    """
    out = []
    cur = first
    while cur <= last:
        end = min(cur + datetime.timedelta(days=MAX_WINDOW_DAYS - 1), last)
        out.append(
            (
                cur,
                end,
                int(
                    datetime.datetime.combine(
                        cur + datetime.timedelta(days=1),
                        datetime.time(),
                        datetime.UTC,
                    ).timestamp()
                ),
                int(
                    datetime.datetime.combine(
                        end + datetime.timedelta(days=1),
                        datetime.time(),
                        datetime.UTC,
                    ).timestamp()
                ),
            )
        )
        cur = end + datetime.timedelta(days=1)
    return out
これを monthly_credits.py として保存し、前月と当月を 1 ユーザー分ずつ取得しました。1 か月分は、いずれも 4 リクエストに分割されます。
# 前月(2026-08)
python3 monthly_credits.py 2026-08 <kiro.user.id> --raw-out monthly-2026-08.json

# 当月(2026-09)
python3 monthly_credits.py 2026-09 <kiro.user.id> --raw-out monthly-2026-09.json
前月分は、4 チャンクすべてが空の結果でした。
{
  "chunk": 1,
  "report_date_from": "2026-08-01",
  "report_date_to": "2026-08-08",
  "start_epoch": 1785628800,
  "end_epoch": 1786233600,
  "http_status": 200,
  "response": {
    "status": "success",
    "data": {
      "resultType": "matrix",
      "result": []
    }
  }
}
有効化した月より前は、PromQL から遡れませんでした。当月分は系列が返り、1 チャンク目には 2026-09-03 の KIRO_IDE が入っていました。
当月分 1 チャンク目の応答(先頭 1 系列)
{
  "chunk": 1,
  "report_date_from": "2026-09-01",
  "report_date_to": "2026-09-08",
  "start_epoch": 1788307200,
  "end_epoch": 1788912000,
  "http_status": 200,
  "response": {
    "status": "success",
    "data": {
      "resultType": "matrix",
      "result": [
        {
          "metric": {
            "date": "2026-09-03",
            "kiro.client.type": "KIRO_IDE"
          },
          "values": [
            [
              1788480000.0,
              "81.07452051907131"
            ]
          ]
        }
      ]
    }
  }
}
4 リクエスト分の結果をマージし、日付順に並べました。以下は 2026-09-03 から 2026-09-07 までの 5 日分の抜粋です。09-17 以降のチャンクは未来の日付を対象としていたため、データは返りませんでした。
| date | KIRO_CLI | KIRO_IDE | KIRO_WEB | total |
|---|---|---|---|---|
| 2026-09-03 | 0.000000 | 81.074521 | 34.719170 | 115.793691 |
| 2026-09-04 | 0.000000 | 567.937403 | 22.614996 | 590.552399 |
| 2026-09-05 | 268.559799 | 236.676726 | 19.740736 | 524.977261 |
| 2026-09-06 | 1231.302509 | 0.000000 | 67.092049 | 1298.394558 |
| 2026-09-07 | 997.004132 | 22.291942 | 30.999795 | 1050.295869 |
月間の値を集計するにはリクエストの分割と結果のマージを自前で行う必要があるため、集計を DB 側に寄せる方法も試しました。
METRICS = [
    "kiro.daily.credits",
    "kiro.daily.overage_credits",
    "kiro.daily.messages",
    "kiro.daily.conversations",
    "kiro.daily.model_messages",
]

# 複数メトリクスを `or` で連結すると、ラベルセットが同一の系列は左辺に畳まれて消える。
# メトリクス名を保持したままフラット化するため、ここではメトリクスごとに 1 リクエストずつ発行する
# (`label_replace` で名前を通常ラベルへ写せば 1 リクエストにまとめられる)
2 日分をダンプして SQLite に投入しました。
# 2 日分の生シリーズを全メトリクス分ダンプしてフラット CSV にする
python3 dump_raw.py 2026-09-12 2026-09-13 --outdir raw

# SQLite に投入して SQL で集計する
python3 load_sqlite.py raw/promql-flat-2026-09-12_2026-09-13.csv kiro_otel.db
出力される CSV は、ラベルがそのまま列になった形です。
metric,date,kiro.user.id,kiro.user.email,kiro.client.type,kiro.model.name,kiro.subscription.tier,kiro.usage.limit,kiro.overage.enabled,kiro.overage.cap,kiro.user.new,__unit__,__type__,__temporality__,timestamp,value
kiro.daily.credits,2026-09-12,xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxa0,xxxxxxxx-b@example.com,KIRO_CLI,,PRO,1000,true,5000,false,credits,Sum,delta,2026-09-13T00:00:00+00:00,17.16783699751244
投入先のテーブルと、日次のクレジットとメッセージを横断して取得する SQL です。
CREATE TABLE kiro_otel (
    metric TEXT, report_date TEXT, user_id TEXT, email TEXT,
    client_type TEXT, model_name TEXT, tier TEXT, usage_limit INTEGER,
    overage_enabled TEXT, overage_cap INTEGER, is_new TEXT,
    unit TEXT, type TEXT, temporality TEXT, ts TEXT, value REAL
);

SELECT report_date,
       ROUND(SUM(CASE WHEN metric='kiro.daily.credits' THEN value END), 3) AS credits,
       CAST(SUM(CASE WHEN metric='kiro.daily.messages' THEN value END) AS INT) AS messages,
       CAST(SUM(CASE WHEN metric='kiro.daily.conversations' THEN value END) AS INT) AS conversations,
       ROUND(SUM(CASE WHEN metric='kiro.daily.overage_credits' THEN value END), 3) AS overage
FROM kiro_otel GROUP BY report_date ORDER BY report_date;
期間合計とメトリクス横断の突き合わせが、それぞれ 1 文で返りました。
--- 期間合計(PromQL では 8 日窓の分割が必要な集計)
from_date | to_date | total_credits
2026-09-12 | 2026-09-13 | 2889.751158

--- クレジットとメッセージを1クエリで突き合わせ(PromQL の or では畳まれる組み合わせ)
report_date | credits | messages | conversations | overage
2026-09-12 | 994.806000 | 2200 | 277 | 0.000000
2026-09-13 | 1894.945000 | 3551 | 502 | 381.488000
期間をまたぐ合計も、メトリクスを横断した突き合わせも、SQL なら 1 文で集計できました。同じ内容を PromQL で出すには、8 日窓の分割と、メトリクス名を通常ラベルへ写す変換が必要になります。
料金
OTel エクスポートの有効化で新たに増える固定費は、CMK とシークレットの 2 つです。CloudWatch 側の取り込み・クエリ料金、無料利用枠、少額の API 呼び出し料金は、本記事の計算対象外とします。
KMS のカスタマーマネージドキーは、1 キーあたり $1/月です。Secrets Manager は、1 シークレットあたり $0.40/月です。
まとめ
Kiro のアクティビティレポートを OTel エクスポートで CloudWatch へ送り、S3 の CSV レポートと同じ内容を PromQL で取得できることを確認しました。
本記事で検証した範囲では、CloudWatch だけで月次・期間横断の集計まで完結させることは難しいことが分かりました。一方、Grafana や Datadog など、OTel に対応した既存の可視化環境がある場合は、Kiro の利用状況をダッシュボードへ統合する選択肢になります。
AWS 上でアクティビティレポートを月次・期間横断で集計するなら、まずは S3 の CSV をデータソースとして Athena などで分析する方式をお試しください。