[アップデート] Amazon ElastiCache Serverless for Valkeyでベクトル検索と集計が使えるようになりました!

はじめに
こんにちは、ラーメンが好きなコンサルティング部の神野です。
Amazon ElastiCache Serverless for Valkeyでベクトル検索・全文検索・ハイブリッド検索・集計が使えるようになりました!
以前ノードベースのElastiCache for ValkeyとAmazon Bedrock AgentCoreでセマンティックキャッシュを作ったのですが、VPCが必要ですしServerlessがいいなと思っていたので嬉しいですね!
今回はそのServerless版を作ってみます!
主な変更点
Valkey 9.0以降のServerlessで使えるようになったのは次の検索と集計です。
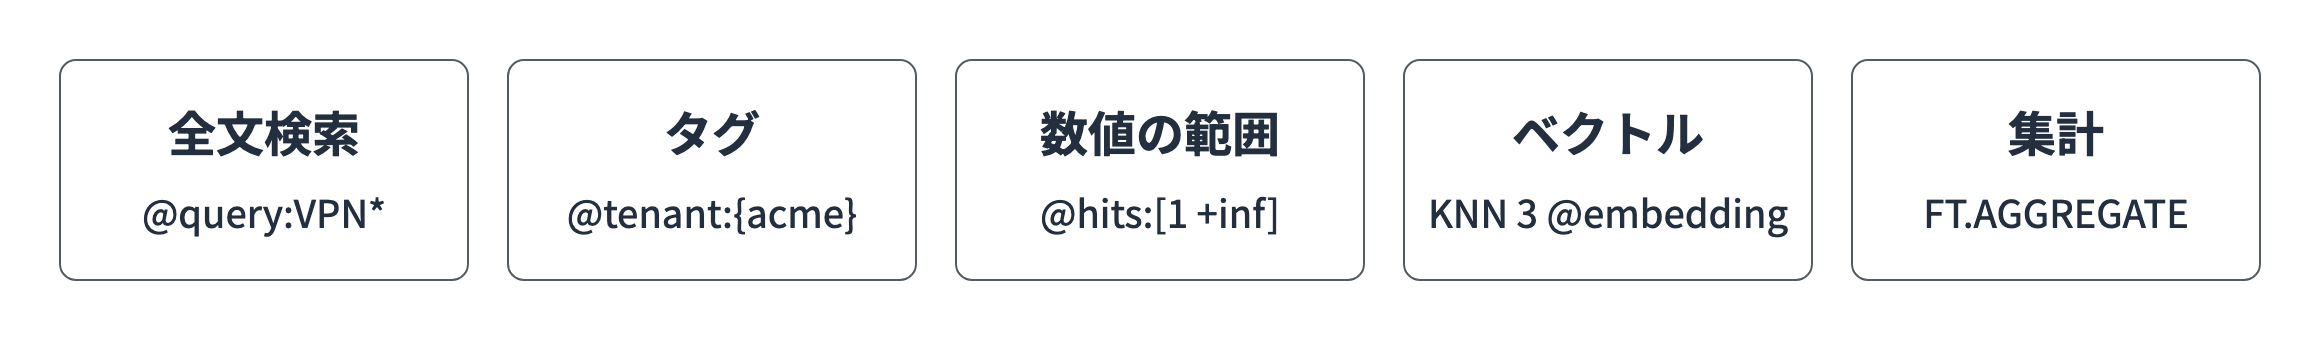
これまでServerlessでは検索のコマンド(FT.CREATEやFT.SEARCHなど)が使えず、ベクトル検索にはノードベースのクラスターが必要でした。今回からはServerlessでもインデックスを作り、全文・タグ・数値・ベクトルの条件で検索できます!
条件は組み合わせられるのでタグで絞り込んでからベクトルで近いものを探すハイブリッド検索も1つのクエリで書けます。
# acmeテナントのキャッシュだけを対象に、ベクトルが近い3件を探す
FT.SEARCH semantic_cache_idx "@tenant:{acme}=>[KNN 3 @embedding $vec AS score]" PARAMS 2 vec <埋め込みベクトル>

# テナントごとのキャッシュ件数とヒット回数の合計を出す
FT.AGGREGATE semantic_cache_idx "@hits:[-inf +inf]" LOAD 2 @tenant @hits GROUPBY 1 @tenant REDUCE COUNT 0 AS entries REDUCE SUM 1 @hits AS total_hits
もう1つ組み合わせたいのが2026年9月のアップデートで追加されたパブリックエンドポイントです。
接続タイプでパブリックを選ぶとVPCなしでインターネットから接続でき、その代わりにIAM認証とTLS 1.3が必須になります。AWS CLIでは作成時に --connection-type public を指定します。
aws elasticache create-serverless-cache \
    --serverless-cache-name my-public-cache \
    --engine valkey \
    --major-engine-version 9 \
    --connection-type public \
    --user-group-id default.iam-user-group
接続タイプはキャッシュの作成後に変えられないので、パブリックにするなら作成時に決めておきます。
今回の検索と組み合わせると、ベクトル検索のためだけにVPCを用意する必要がなくなります。前回の記事ではノードベースのクラスターをVPCに置き、NAT Gatewayも用意していました。
今回はどちらも要りません。ローカルのPCから踏み台なしで検索できるのも嬉しいですね!
Serverlessの上限値
Serverlessはノードベースと上限値が一部異なります。今回の実装に関係するものを抜粋しました。
| 項目 | Serverless | ノードベース(9.0以降) |
|---|---|---|
| ベクトルの次元数 | 4096 | 32768 |
| KNN検索のK | 512 | 10000 |
| インデックスあたりのプレフィックス数 | 8 | 16 |
| HNSWのM | 32 | 2000000 |
Valkey 9.0の検索機能(Valkey Search 1.2)はFT.SEARCHでフィルタとベクトルを組み合わせて検索できますが、FT.HYBRIDコマンドには対応していません・・・
今回作るもの
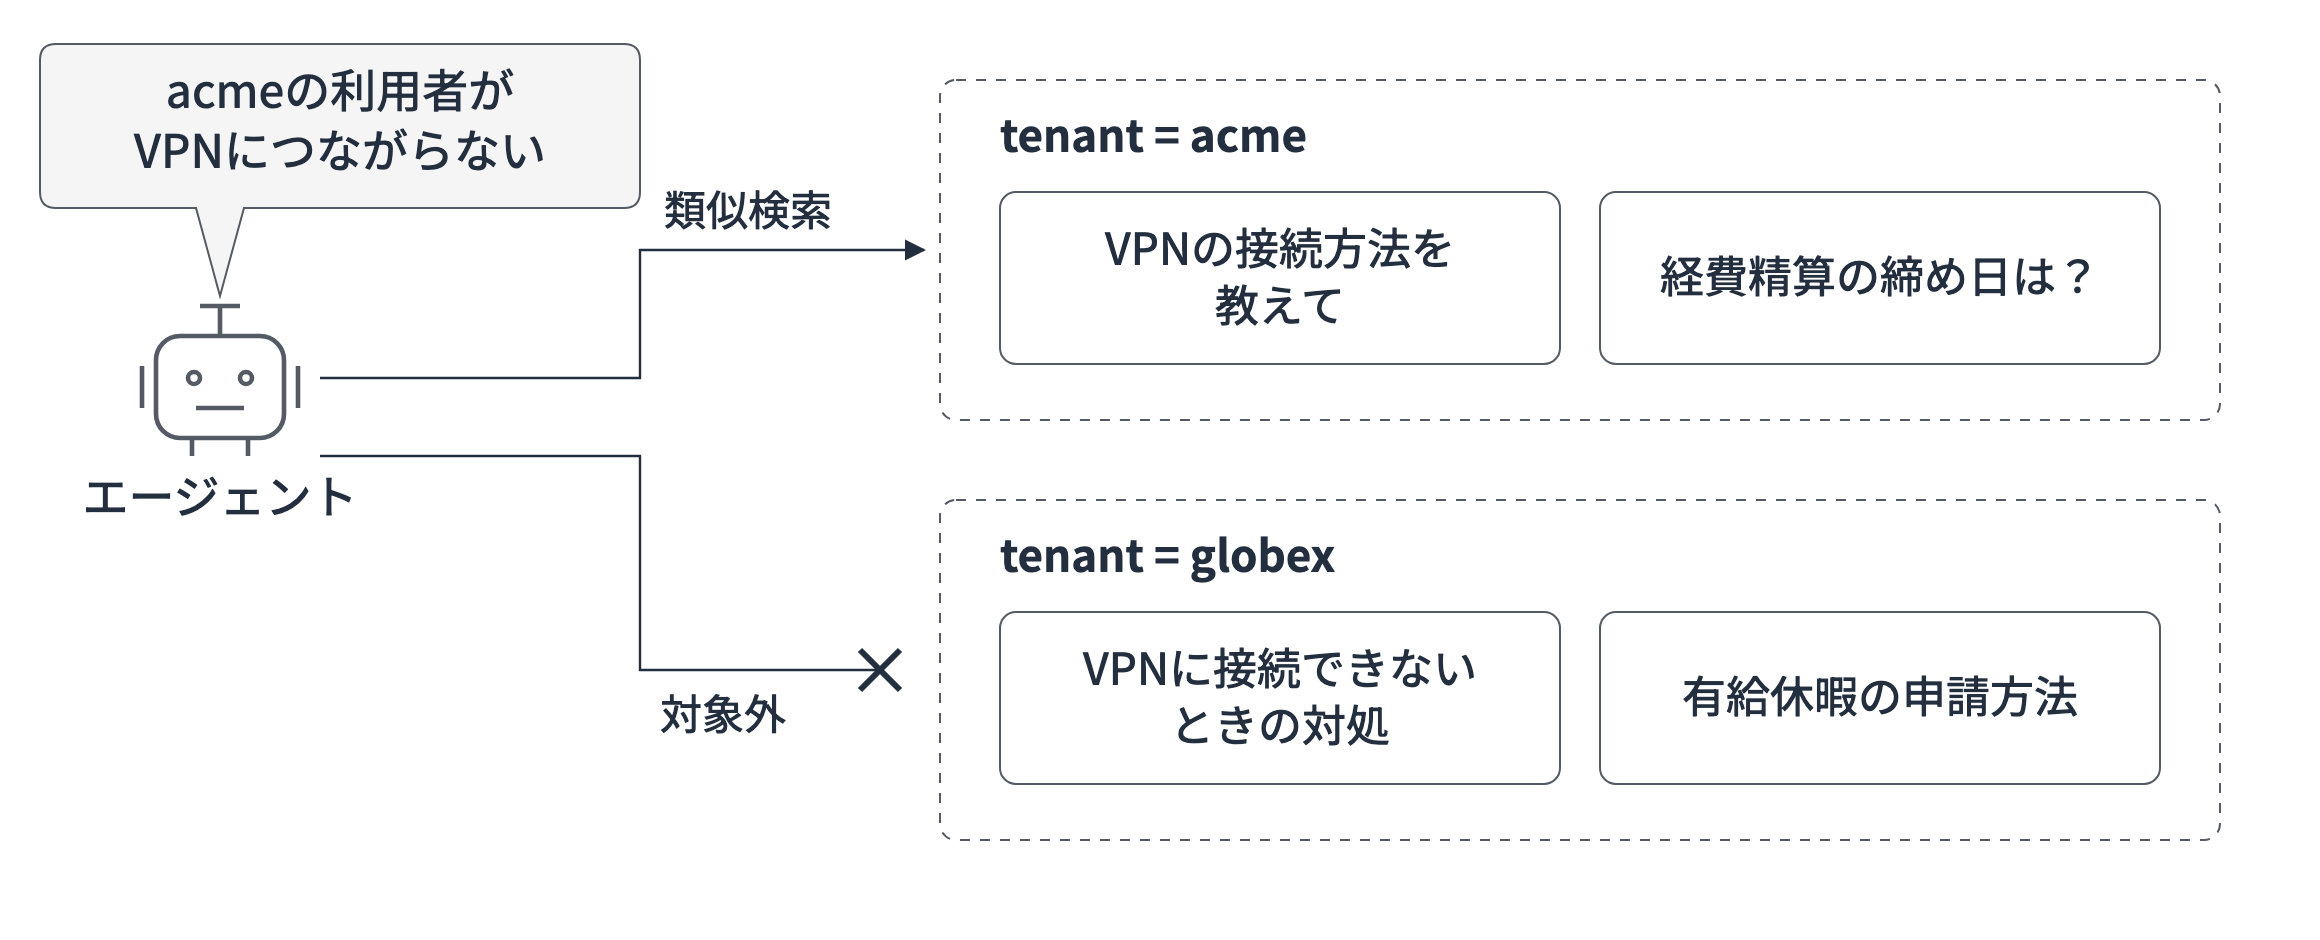
前回のセマンティックキャッシュにテナントの区別を追加します。SaaSのヘルプデスクを想定していて、A社の利用者にB社向けの回答を返さないよう同じテナントのキャッシュだけを類似検索の対象にします!このサンプルでは動作確認用にテナント名を引数で指定します。
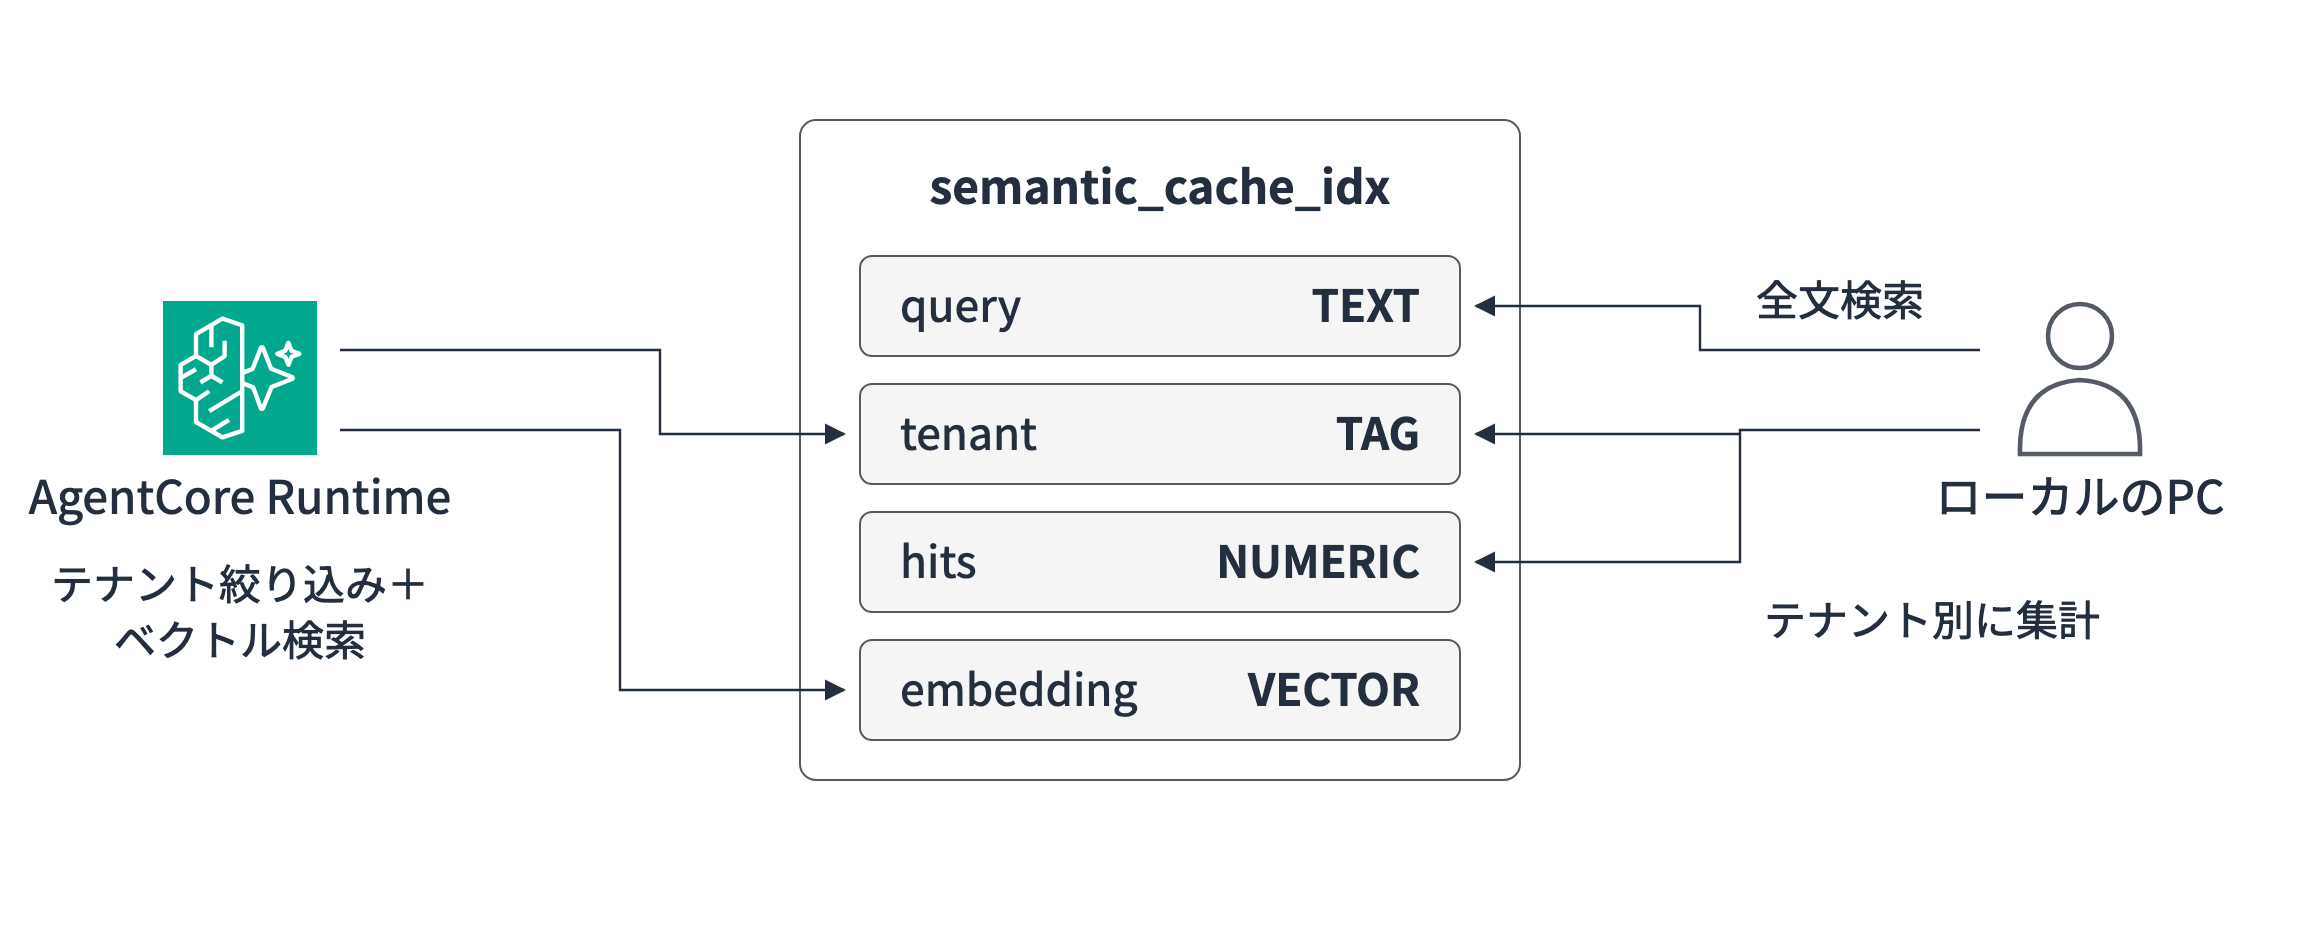
キャッシュは1つのインデックスにまとめておきます。
Runtimeはテナントの絞り込みとベクトル検索で回答を探し、ローカルのPCからは質問文の全文検索とテナント別の集計を実行して挙動を確認してみます!
コード一式はGitHubに置いています。記事では要点のコードを抜粋して紹介します。
| パス | 内容 |
|---|---|
bin/ lib/ |
CDKアプリ(ElastiCache Serverless・AgentCore Runtime・IAM) |
agent/ |
Runtimeで動かすエージェント(Strands Agents+Valkey GLIDE) |
client/ |
Runtimeの呼び出しと、キャッシュへの全文検索・集計のスクリプト |
git clone https://github.com/yuu551/elasticache-serverless-semantic-cache.git
cd elasticache-serverless-semantic-cache
pnpm install
CDKでキャッシュとRuntimeを作る
CDKは執筆時点の最新版(aws-cdk-lib 2.276.0)を使います。
キャッシュとRuntimeを作る部分を抜粋します。
// ElastiCache Serverless for Valkey 9(パブリックエンドポイント)
const cache = new elasticache.CfnServerlessCache(this, 'Cache', {
  serverlessCacheName: CACHE_NAME,
  engine: 'valkey',
  majorEngineVersion: '9',
  connectionType: 'public',
  userGroupId: 'default.iam-user-group',
});

// AgentCore Runtime V2(VPCなしのパブリックネットワーク)
const runtime = new agentcore.Runtime(this, 'Runtime', {
  runtimeName: 'serverlessSemanticCache',
  agentRuntimeArtifact: agentcore.AgentRuntimeArtifact.fromAsset(
    path.join(import.meta.dirname, '../agent'),
    { platform: Platform.LINUX_ARM64 },
  ),
  platformVersion: agentcore.PlatformVersion.V2,
  networkConfiguration: agentcore.RuntimeNetworkConfiguration.usingPublicNetwork(),
  environmentVariables: {
    VALKEY_HOST: cache.attrEndpointAddress,
    VALKEY_CACHE_NAME: CACHE_NAME,
    VALKEY_USER: CACHE_USER,
  },
});
ElastiCache Serverlessにはalpha版のL2(@aws-cdk/aws-elasticache-alpha)もありますが、執筆時点ではVPCの指定が必須で接続タイプを選べませんでした。
そのためL1の CfnServerlessCache を使い、connectionType: 'public' を指定してパブリックエンドポイントにしています。
ユーザーグループの default.iam-user-group はAWSが用意しているIAM認証用のグループで、自分でユーザーを作らずに始められます。
IAM認証を使うには、接続元のIAMロールやユーザーに elasticache:Connect の権限が必要です。対象のリソースはキャッシュとユーザーの両方になる点に注意です。
runtime.addToRolePolicy(new iam.PolicyStatement({
  actions: ['elasticache:Connect'],
  resources: [
    cache.attrArn,
    this.formatArn({ service: 'elasticache', resource: 'user', resourceName: CACHE_USER, arnFormat: cdk.ArnFormat.COLON_RESOURCE_NAME }),
  ],
}));
エージェントを実装する
エージェントは前回と同じくStrands Agentsで書き、Valkeyのクライアントは公式のValkey GLIDEに変えました。GLIDEはIAM認証トークンの作成と更新に対応しているので便利です。
IAM認証でパブリックエンドポイントにつなぐ
パブリックエンドポイントへの接続にはIAM認証トークンを使います。トークンはIAMの認証情報で署名したURLで、APIを呼び出さずにその場で作れます。
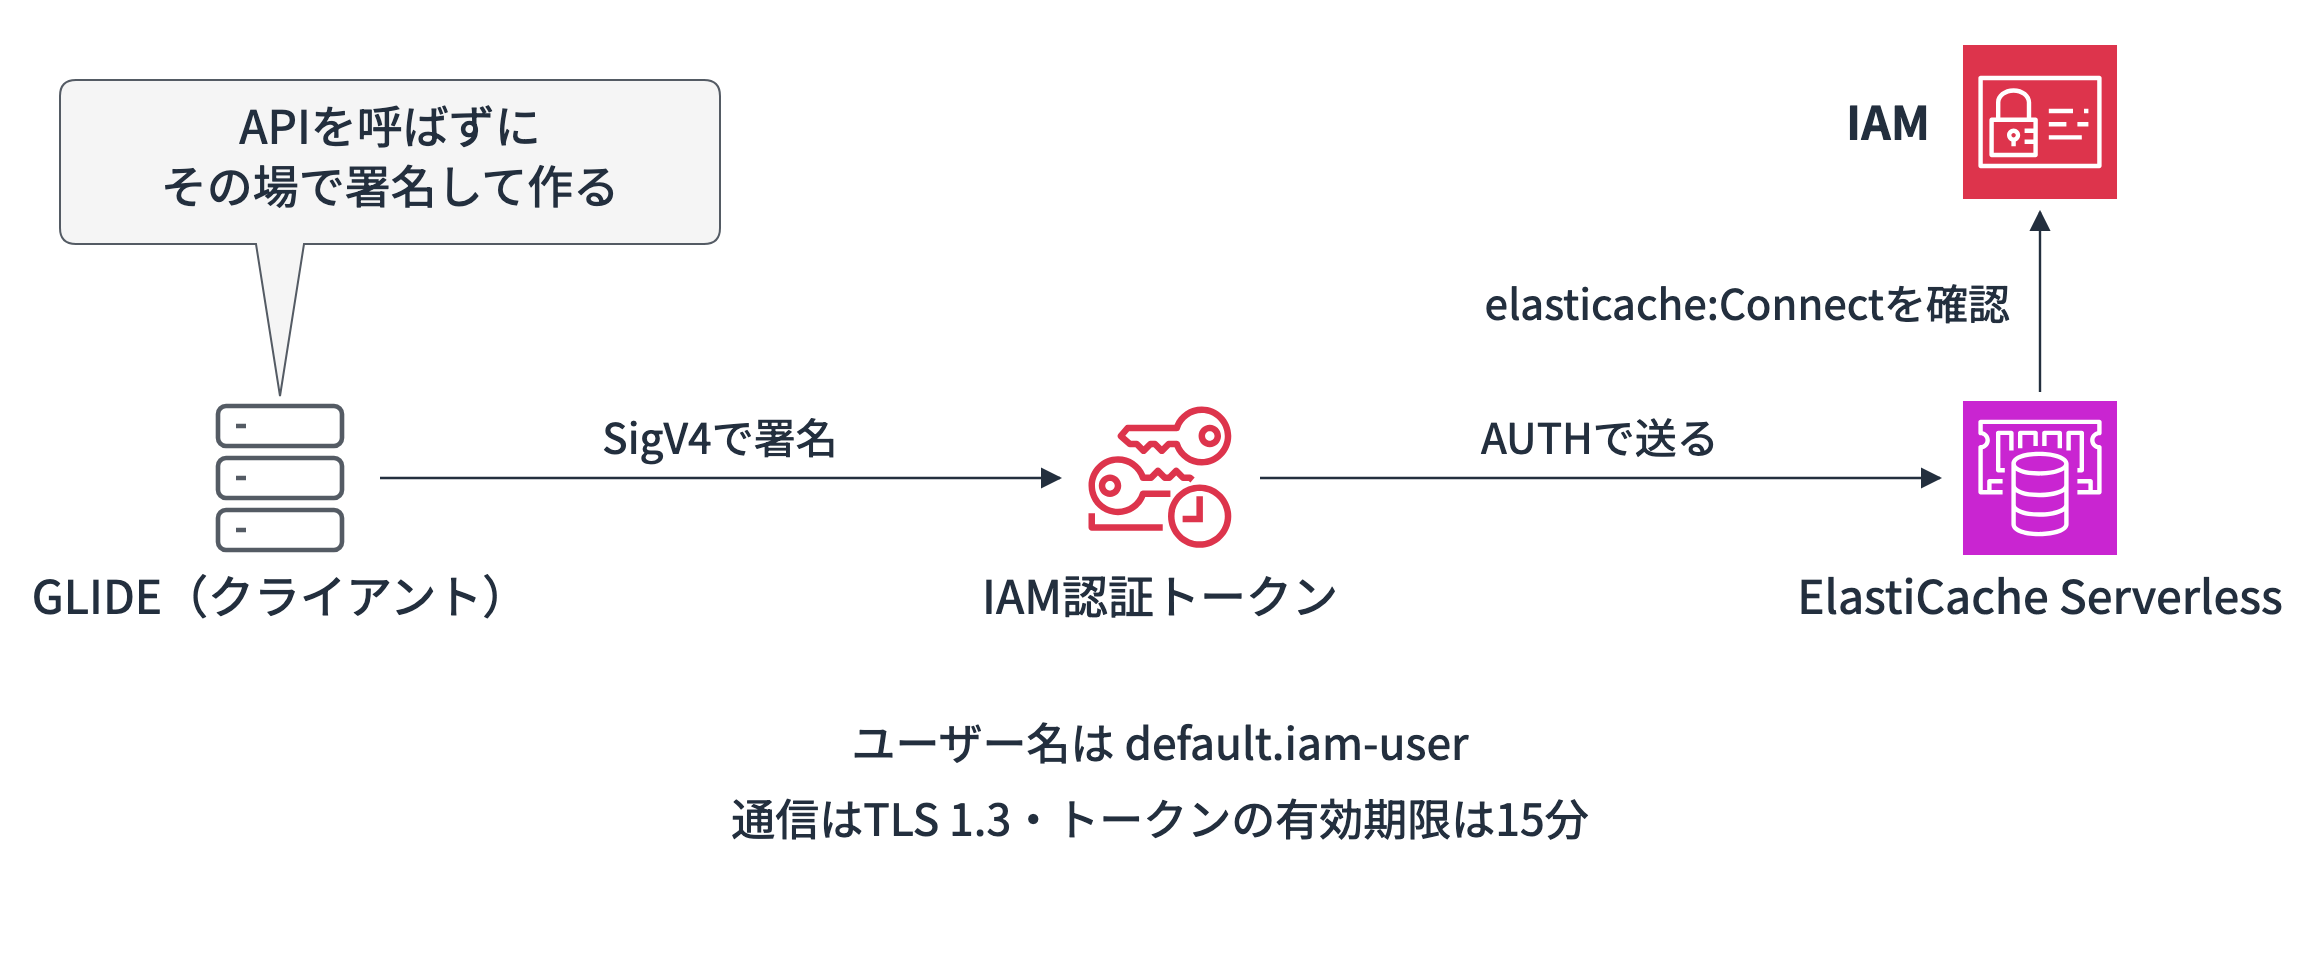
GLIDEでは接続設定に IamAuthConfig を渡すとトークンの作成と更新を自動で行ってくれます。
self._config = GlideClusterClientConfiguration(
    addresses=[NodeAddress(host, 6379)],
    use_tls=True,
    request_timeout=5000,
    credentials=ServerCredentials(
        username=user_id,  # default.iam-user
        iam_config=IamAuthConfig(
            cluster_name=cache_name,
            service=ServiceType.ELASTICACHE,
            region=region,
        ),
    ),
)
ちなみにGLIDEのタイムアウトはデフォルトの250msだと検証中に警告が出たので、5秒に延ばしています!
接続は最初のリクエストで作る
AgentCore Runtime V2は起動して準備ができた状態をスナップショットとして保存し、インスタンスごとにそこから復元します。起動時に初期化した値はスナップショット時点の状態のまま、復元されたすべてのインスタンスへ引き継がれます。
そのため、公式ドキュメントでも期限のある認証情報やトークンは起動時ではなくリクエストを処理するときに用意するよう案内されています。IAM認証トークンの有効期限は15分なので、起動時に接続を作るとスナップショットからの復元時には期限切れになっている可能性があります。
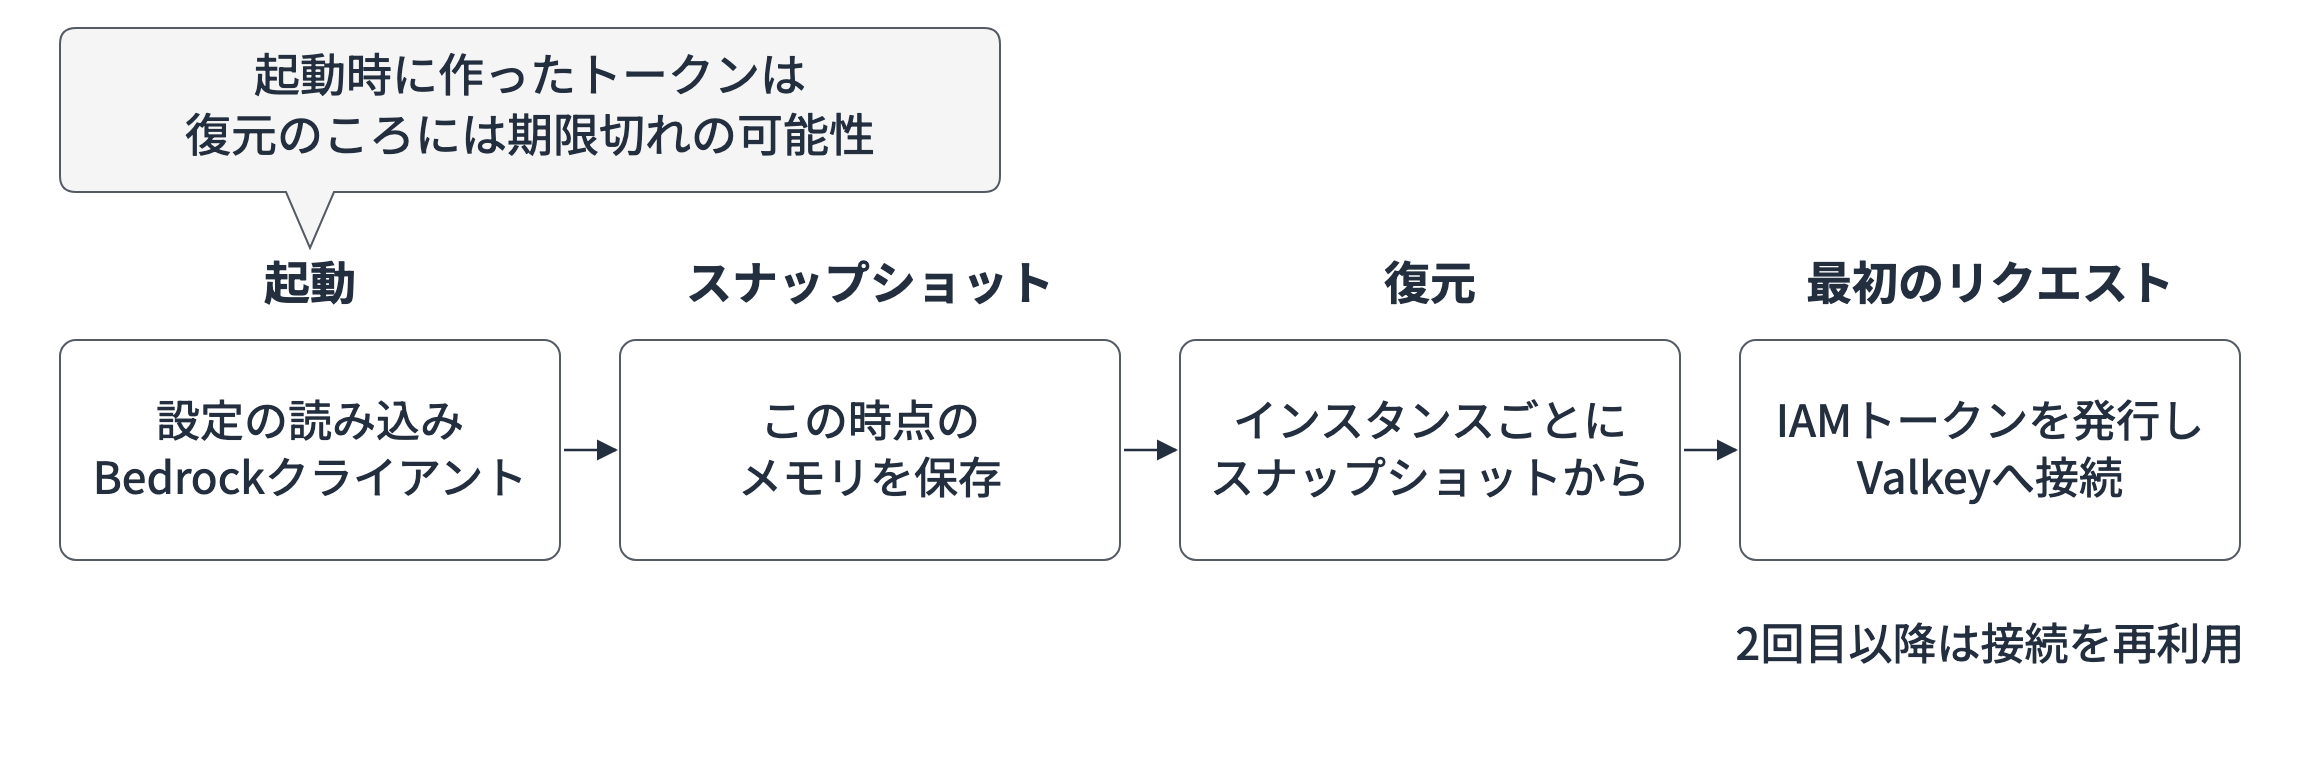
そこで起動時には接続設定を準備しておき、接続そのものは最初のリクエスト時に確立してインスタンス内で再利用します。
async def _get_client(self) -> GlideClusterClient:
    # Runtime V2はスナップショットから復元されるため、
    # 期限のあるIAMトークンを使う接続は最初のリクエストで作る
    if self._client is None:
        self._client = await GlideClusterClient.create(self._config)
        await self._setup_index(self._client)
    return self._client
インデックスを作ってハイブリッド検索する
キャッシュは1件ずつハッシュに保存し、そのうち次の4つのフィールドをインデックスに登録します。
| フィールド | 型 | 入れる値 | 使う検索 |
|---|---|---|---|
| query | TEXT | 利用者の質問文 | 全文検索 |
| tenant | TAG | テナント名(acmeなど) | テナントの絞り込み・集計のグループ分け |
| hits | NUMERIC | キャッシュがヒットした回数 | 数値の範囲・集計 |
| embedding | VECTOR | 質問文の埋め込み(1024次元) | ベクトル検索 |
回答の本文(answer)も同じハッシュに入れますが、検索の条件には使わないのでインデックスには登録していません。
await client.custom_command([
    "FT.CREATE", INDEX_NAME,
    "ON", "HASH",
    "PREFIX", "1", KEY_PREFIX,
    "SCHEMA",
    "query", "TEXT",
    "tenant", "TAG",
    "hits", "NUMERIC",
    "embedding", "VECTOR", "HNSW", "6",
    "TYPE", "FLOAT32",
    "DIM", str(self.dims),
    "DISTANCE_METRIC", "COSINE",
])
エージェントの検索では、テナントで候補を絞ってからベクトル検索します。
result = await client.custom_command([
    "FT.SEARCH", INDEX_NAME,
    f"@tenant:{{{tenant}}}=>[KNN 3 @embedding $vec AS score]",
    "PARAMS", "2", "vec", vec,
    "RETURN", "1", "score",
])
テナントがacmeのときのクエリは @tenant:{acme}=>[KNN 3 @embedding $vec AS score] になります。それぞれの意味は次のとおりです。
| 部分 | 意味 |
|---|---|
@tenant:{acme} |
tenantがacmeのキャッシュを候補にする |
=> |
左の条件で絞った候補に右のベクトル検索をかける |
KNN 3 @embedding $vec |
embeddingが質問の埋め込み($vec)に近い3件を探す |
AS score |
近さ(コサイン距離)をscoreという名前で返す |
scoreはコサイン距離(0〜2)なので、前回と同じく 1 - distance / 2 で0〜1の類似度スコアに変換し、0.8以上をキャッシュヒットとします。
ヒットしたらそのキーの回答を取り出してhitsを1増やし、ミスしたらStrands Agentsで回答を作って保存します。流れは前回と同じです。
デプロイする
検証した環境は次のとおりです。
| 項目 | バージョン・値 |
|---|---|
| リージョン | 東京(ap-northeast-1) |
| aws-cdk-lib / AWS CDK CLI | 2.276.0 / 2.1148.0 |
| Node.js / TypeScript | 26.13.0 / 7.0.2 |
| Python(コンテナ) | 3.14 |
| uv | 0.13.6 |
| strands-agents / bedrock-agentcore | 1.64.0 / 1.25.4 |
| valkey-glide | 2.6.0 |
| ElastiCache for Valkey | 9.0(Serverless) |
| 埋め込みモデル | Amazon Titan Text Embeddings V2(1024次元) |
| LLM | Claude Haiku 5.5(jp推論プロファイル) |
早速デプロイしましょう!
pnpm cdk deploy
 ✅  ServerlessSemanticCacheStack

✨  Deployment time: 321.4s

Outputs:
ServerlessSemanticCacheStack.CacheEndpoint = semantic-cache-xxxxxx.public.serverless.apne1.cache.amazonaws.com
ServerlessSemanticCacheStack.CacheName = semantic-cache
ServerlessSemanticCacheStack.RuntimeArn = arn:aws:bedrock-agentcore:ap-northeast-1:123456789012:runtime/serverlessSemanticCache-xxxxxxxxxx
エンドポイントに public が入っていますね。前回はVPCやNAT Gatewayも含めて617秒かかっていたので、構成が減った分だけデプロイも短くなりました。キャッシュは約2分で作成が終わり、Runtimeはスナップショットの準備を含めて約3分かかりました。
動かしてみる
ローカルのPCからはリポジトリの client フォルダのスクリプトで呼び出します。スクリプトはCloudFormationのスタック出力からエンドポイントとRuntimeのARNを取得するので、値を書き換える必要はありません。
cd client
uv sync
キャッシュミスとヒットを確かめる
テナントacmeとして質問してみます!まだキャッシュは空なのでミスになるはずです。
uv run invoke.py "VPNに接続する方法を教えて" --tenant acme
{
  "response": "VPNの接続は一般的に次の手順で行います。製品によって画面が異なる場合があります。…",
  "cache_hit": false,
  "model_id": "jp.anthropic.claude-haiku-5-5",
  "timing_ms": {
    "embedding": 474.8,
    "vector_search": 3.2,
    "connect_and_index": 2425.6,
    "agent_invocation": 3657.3,
    "total": 6712.6
  }
}
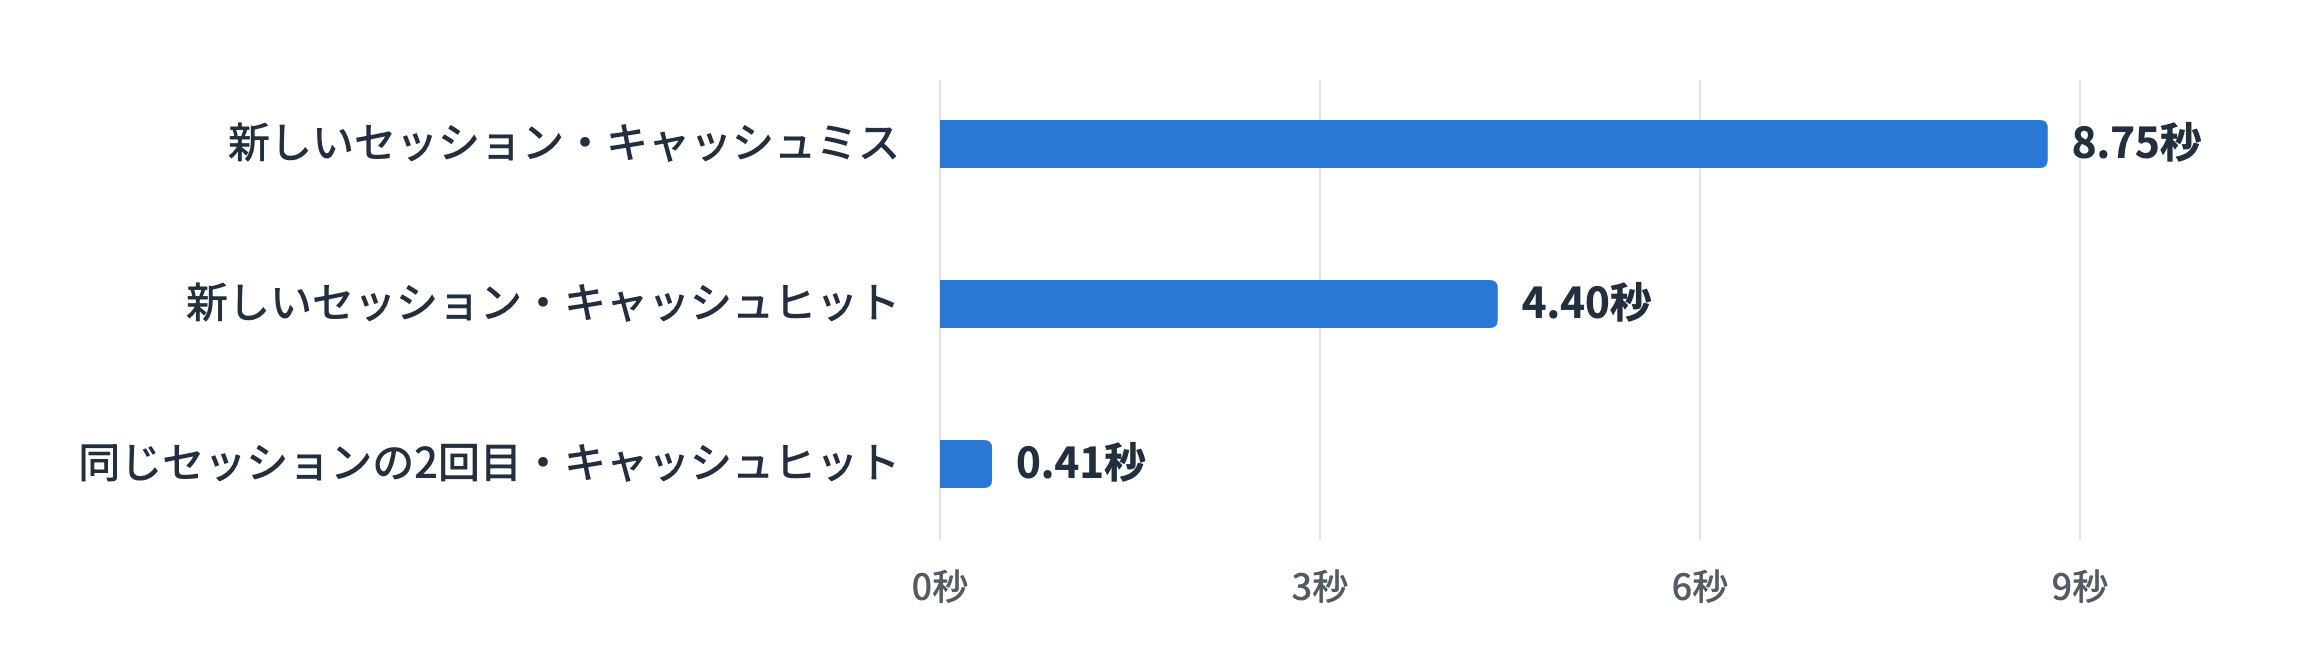
呼び出し全体: 8745.4 ms
LLMの呼び出しが3.7秒で接続の作成とインデックスの確認(connect_and_index)に2.4秒かかっています。これは最初のリクエストでIAM認証トークンを作ってクラスターに接続し、インデックスの有無を確認した時間です。
ベクトル検索自体は3.2msでした。リージョンなどの条件は違いますが前回のノードベースでは18.2msだったので、Serverlessでも十分速いですね。
同じ質問と言い換えた質問でも試してみます!
uv run invoke.py "VPNに接続する方法を教えて" --tenant acme
uv run invoke.py "VPNのつなぎ方を知りたい" --tenant acme
"cache_hit": true,
"similarity_score": 1.0,
"timing_ms": { "embedding": 553.8, "vector_search": 3.1, "connect_and_index": 1879.6, "total": 2440.8 }
呼び出し全体: 4403.4 ms

"cache_hit": true,
"similarity_score": 0.8661,
"timing_ms": { "embedding": 523.4, "vector_search": 3.2, "connect_and_index": 2135.2, "total": 2666.8 }
呼び出し全体: 5119.3 ms
どちらもキャッシュヒットしました!言い換えた質問も類似度0.8661で、閾値の0.8を超えています。
ただ、ヒットしても毎回connect_and_indexに約2秒かかっていますね。
これは、invoke.pyが呼び出しごとに新しいセッションIDを作るからです。セッションが変わるたびにスナップショットから新しいインスタンスが復元され、クラスターへ接続し直しています。
同じセッションでは接続を再利用する
そこでセッションIDを固定して3回続けて呼び出してみます!
SESSION=$(uuidgen)
uv run invoke.py "経費精算の締め日はいつ?" --tenant acme -s $SESSION
uv run invoke.py "経費精算の締め日はいつ?" --tenant acme -s $SESSION
uv run invoke.py "経費の精算はいつまでに出せばいい?" --tenant acme -s $SESSION
"cache_hit": false,
"timing_ms": { "embedding": 190.2, "vector_search": 3.0, "connect_and_index": 210.2, "agent_invocation": 2654.4, "total": 3190.2 }
呼び出し全体: 5214.2 ms

"cache_hit": true,
"similarity_score": 1.0,
"timing_ms": { "embedding": 160.4, "vector_search": 3.0, "total": 167.8 }
呼び出し全体: 411.0 ms

"cache_hit": true,
"similarity_score": 0.8623,
"timing_ms": { "embedding": 146.5, "vector_search": 2.9, "total": 153.7 }
呼び出し全体: 398.0 ms
2回目以降はconnect_and_indexがなくなり、ヒット時はRuntime内で約160ms・呼び出し全体でも約0.4秒で返ってきました!1回目の接続は210msで、セッションによって0.2〜2.4秒ほどの幅がありました。
テナントで絞り込めているか確かめる
acmeに保存した質問を今度はglobexとして投げます。
SESSION=$(uuidgen)
uv run invoke.py "VPNに接続する方法を教えて" --tenant globex -s $SESSION
uv run invoke.py "VPNのつなぎ方を知りたい" --tenant globex -s $SESSION
"cache_hit": false,
"model_id": "jp.anthropic.claude-haiku-5-5",

"cache_hit": true,
"similarity_score": 0.8661,
"cache_key": "cache:globex:b32d0012f03439a593d0514c8135ef0a",
まったく同じ質問がacmeにあってもglobexではミスになり、LLMで回答を作りました。2回目はglobexのキー(cache:globex:...)がヒットしていて、テナントごとにキャッシュが分かれていることが分かりますね!
ローカルのPCから全文検索と集計を実行する
ローカルのPCからキャッシュへ直接つないで確認してみます!
接続設定はエージェントと同じGLIDEの IamAuthConfig で、トンネルや踏み台は使いません!
まずは全文検索でキャッシュ済みの質問から「VPN」を探します。集計用に、invoke.pyでglobexへ「有給休暇の申請方法は?」も1件追加してあります。
# 全文検索でキャッシュ済みの質問文をキーワードで探す
command = ["FT.SEARCH", INDEX_NAME, f"@query:{args.query}",
           "RETURN", "3", "query", "tenant", "hits"]
uv run cache_ops.py text 'VPN'
uv run cache_ops.py text 'VPN*'
== text VPN
[ 0 ]
(35.2 ms)

== text VPN*
[
  2,
  {
    "cache:globex:b32d0012f03439a593d0514c8135ef0a": { "query": "VPNに接続する方法を教えて", "tenant": "globex", "hits": "1" },
    "cache:acme:b32d0012f03439a593d0514c8135ef0a": { "query": "VPNに接続する方法を教えて", "tenant": "acme", "hits": "2" }
  }
]
(45.7 ms)
あれ、「VPN」では0件で前方一致の「VPN*」だと2件ヒットしました。
これはValkeyの全文検索が空白と記号で文を語に区切るためです。
FT.INFOで区切りに使う文字を確認すると半角の記号だけでした。
punctuation: ,.<>{}[]"':;!@#$%^&*()-+=~/\|?
日本語の文は空白で区切らないので「VPNに接続する方法を教えて」が丸ごと1語になり、「VPN」とは一致しなかったわけです。同じ理由で「経費精算*」は「経費精算の締め日はいつ?」に当たり、文の途中にある「締め日*」では0件でした。
日本語で語ごとに検索する方法は集計のあとで試してみます!
次は集計を試してみます。テナントごとのキャッシュ件数とヒット回数の合計を出します。
# テナントごとのキャッシュ件数とヒット回数の合計を集計する
command = ["FT.AGGREGATE", INDEX_NAME, "@hits:[-inf +inf]",
           "LOAD", "2", "@tenant", "@hits",
           "GROUPBY", "1", "@tenant",
           "REDUCE", "COUNT", "0", "AS", "entries",
           "REDUCE", "SUM", "1", "@hits", "AS", "total_hits",
           "SORTBY", "2", "@total_hits", "DESC"]
@hits:[-inf +inf] はhitsが入っているすべてのキャッシュを対象にする条件で、LOAD で読み込んだtenantごとにグループ分けして件数(COUNT)とhitsの合計(SUM)を出します。
uv run cache_ops.py stats
[
  { "tenant": "acme", "entries": "2", "total_hits": "4" },
  { "tenant": "globex", "entries": "2", "total_hits": "1" }
]
(55.0 ms)
acmeは2件のキャッシュが合計4回使われていますね!続けてよくヒットしている質問の上位も抽出してみます!
uv run cache_ops.py ranking
[
  { "hits": "2", "query": "VPNに接続する方法を教えて", "tenant": "acme" },
  { "hits": "2", "query": "経費精算の締め日はいつ?", "tenant": "acme" },
  { "hits": "1", "query": "VPNに接続する方法を教えて", "tenant": "globex" }
]
(122.2 ms)
これまでの呼び出しと数が合っていますね。どの回答がよく使われているかをキャッシュの中から直接集計できるので、閾値の調整や回答の見直しに使えそうです。
Janomeで分かち書きして日本語の語で検索する
全文検索で見たとおり日本語の文は丸ごと1語になります。
語ごとに検索したい場合は形態素解析で空白区切りにする方法があるので、Janomeで試してみました。JanomeはPython単体で動く形態素解析のライブラリで、辞書も同梱されているため uv add janome でそのまま使えます。
ここからは別の検証用インデックス(ja_idx)に質問文を5件登録し、原文と分かち書きしたフィールドで検索結果を比べます。分かち書きはJanomeで名詞・動詞・形容詞を取り出して基本形にしたもので、これを別のフィールド(tokens)へ保存し、検索語も同じように分割します。
export VALKEY_HOST=<スタック出力のCacheEndpoint> VALKEY_CACHE_NAME=semantic-cache
uv run janome_search.py setup
uv run janome_search.py search 締め日
uv run janome_search.py cleanup
setupで検証用のインデックスと質問文を登録し、searchで原文への前方一致と分かち書きしたフィールドの両方を検索します。
@query:締め日*            -> 0件
@tokens:締め日            -> 1件 ["経費精算の締め日はいつ?"]
@tokens:つなぐ            -> 1件 ["VPNのつなぎ方を知りたい"]
@tokens:申請 @tokens:方法 -> 1件 ["有給休暇の申請方法は?"]
文の途中の語でも検索できるようになり、「つなぐ」で「つなぎ方」も見つかりました!キーワードで検索したい場合はこのように事前に工夫する必要がありそうですね。
スクリプトはリポジトリの client/janome_search.py に置いています。
実際のセマンティックキャッシュで使うなら、分かち書きはエージェントの処理に組み込むことになります。キャッシュを保存するときに質問文を分かち書きしてtokensにも入れ、ローカルのPCなどから全文検索するときは検索語を同じように分割します。
# __init__(起動時・スナップショット前)でTokenizerを作っておく
self.tokenizer = Tokenizer()

def tokenize(self, text: str) -> str:
    """内容語の基本形を空白区切りにする(例: 経費 精算 締め日 いる)"""
    return " ".join(t.base_form for t in self.tokenizer.tokenize(text)
                    if t.part_of_speech.split(",")[0] in CONTENT_POS)

# store()で保存するフィールドに分かち書きを足す
await client.hset(key, {
    "query": query,
    "tokens": self.tokenize(query),
    # answer・tenant・hits・embeddingは今までどおり
})
インデックスにもtokensのTEXTフィールドを追加しておきます。
実際にエージェントへ組み込んでデプロイしてみると、Runtimeが保存した分かち書きをローカルのPCから @tokens:締め日 などで検索できました。ただ、ローカルのPCより分かち書きに時間がかかることもありました。キャッシュミスのときの応答に上乗せされる部分なので、組み込み方には工夫の余地がありそうです。たとえば次のような方法が考えられます。
- 回答を返したあとに分かち書きしてtokensだけ後から書き足す
- tokensがまだないキャッシュを定期的なバッチ処理でまとめて分かち書きする
- 辞書を使わない2文字ずつの区切り(バイグラム)にして処理を軽くする
あくまで一例ですが!
後片付け
検証が終わったらスタックを削除します。
pnpm cdk destroy
Serverlessが合うケースとコスト感
Serverlessとノードベースでは料金体系が異なります。公式ドキュメントの使い分けの目安とあわせて整理しました。
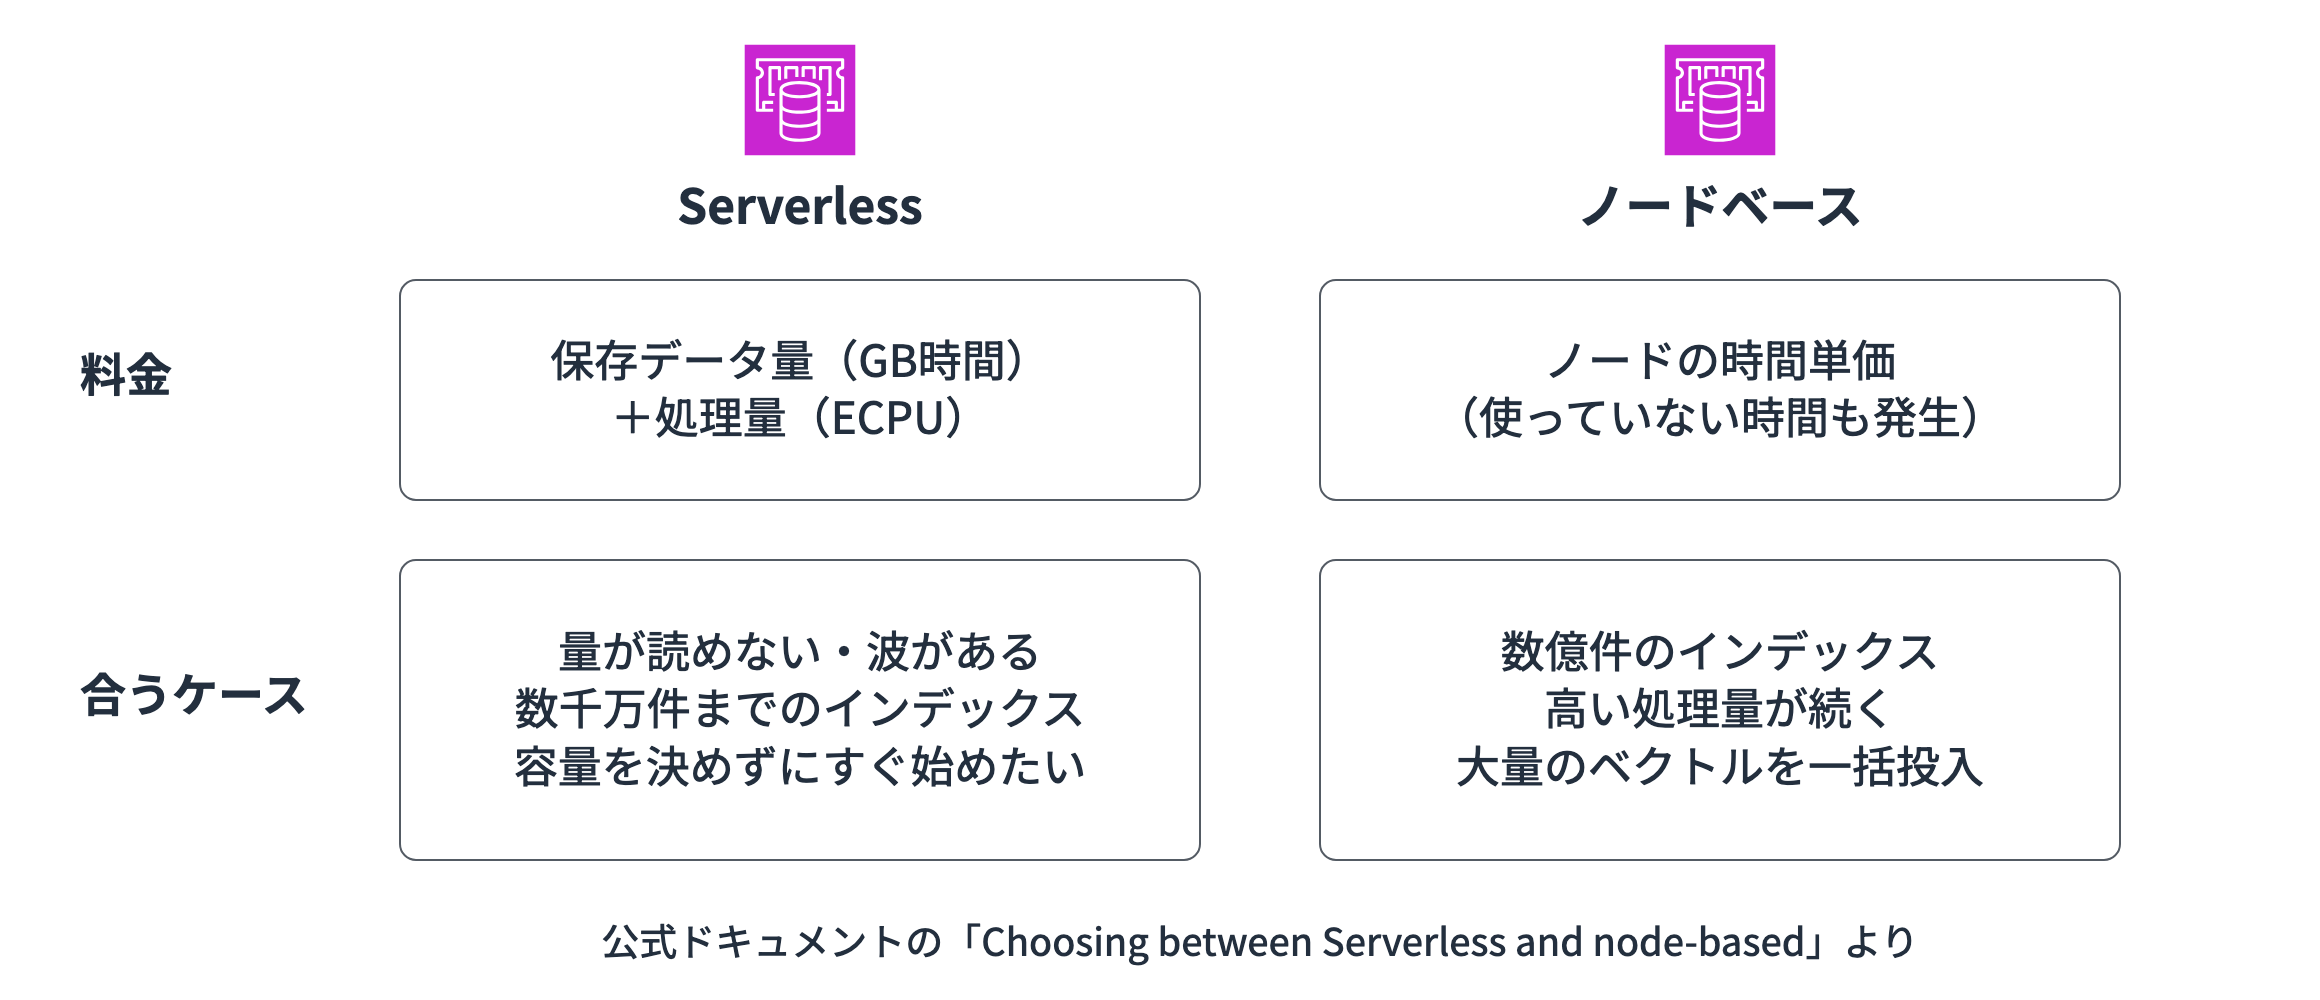
始めたばかりの段階や検証環境では使った分だけ払うServerlessが合いそうですね!
執筆時点の東京リージョンの単価は次のとおりです。
| 項目 | 単価 |
|---|---|
| データ保存 | 1GB時間あたり$0.101(最小100MB) |
| ECPU | 100万ECPUあたり$0.0027 |
| 検索インデックス | 対象のテキスト・数値データの30%分とベクトルデータの10%分を保存量に加算 |
ECPUはデータ1KBの読み書きで1 ECPUが基本です。検索のように処理が重いコマンドを実行すると、その分多くのECPUを消費します。料金ページの計算例では検索1回をGETの1,000倍の処理時間とみなして1,000 ECPUで見積もっています。この前提で月の検索回数と料金の目安をグラフにしてみました。
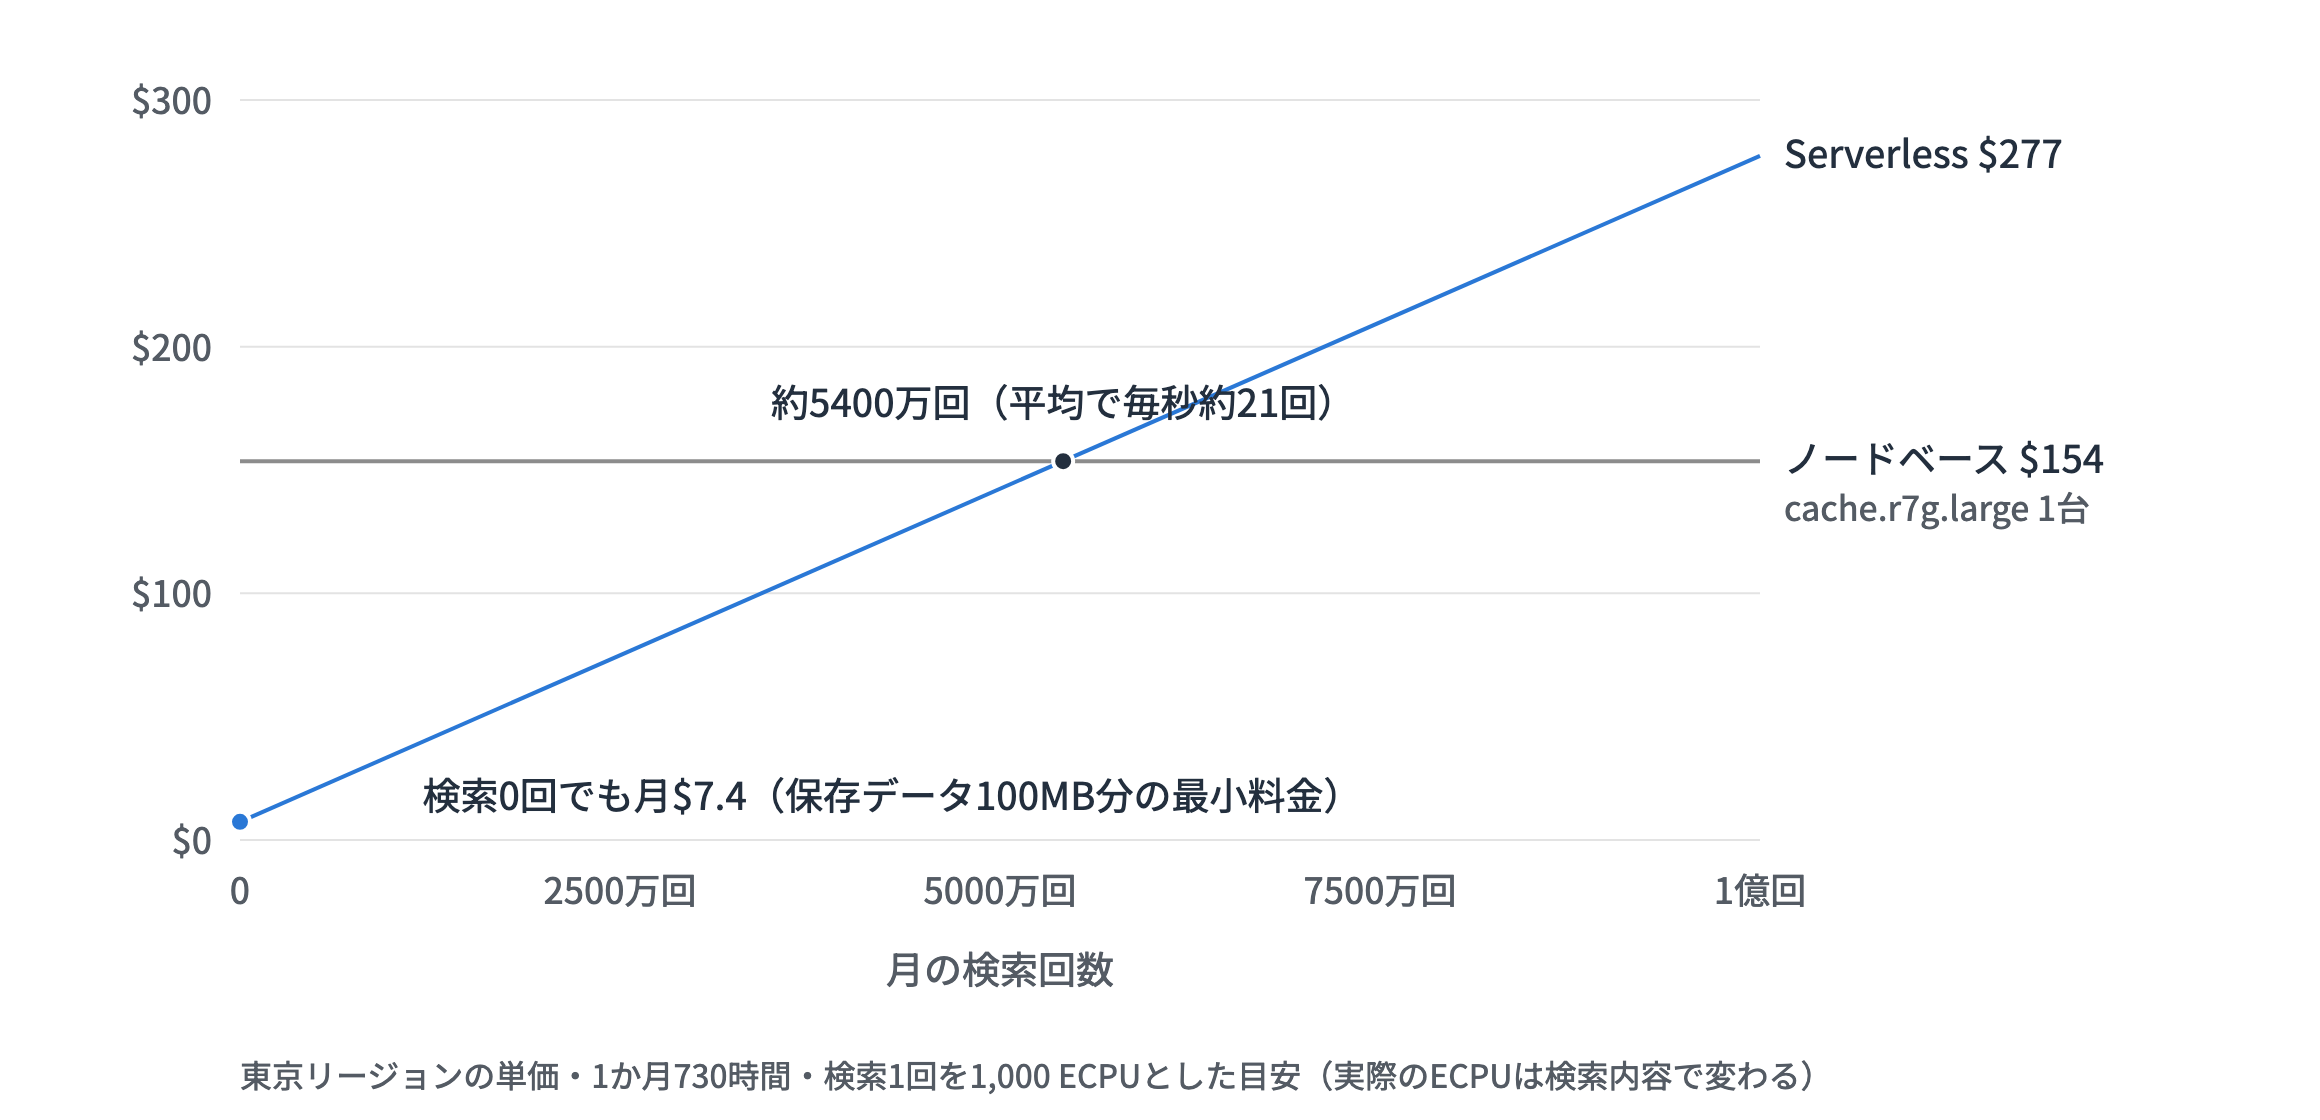
今回のキャッシュは数件なので保存データは最小課金の100MBに収まり、検索がなければ月$7.4ほどです。検索100万回ごとに$2.7増える計算なので、ノードベースのcache.r7g.largeを1台動かす月$154と並ぶのは月5400万回(平均で毎秒約21回)あたりです。
前回のようにVPCの中からBedrockを呼び出す構成では、NAT Gatewayの料金(東京で月$45ほど)も加わってくるので、キャッシュサーバーを使いたいだけの場合は維持費も高く感じますね。
ただし検索1回のECPUはクエリの内容やインデックスの大きさで変わります。実際に見積もるときは、本番に近いクエリを実行してCloudWatchのECPU消費(ElastiCacheProcessingUnits)を確認しておきたいところです!
おわりに
前回VPCまわりの構成で悩ましかったところが、Serverlessとパブリックエンドポイントですっきりしましたね!
本記事が少しでも参考になりましたら幸いです。最後までご覧いただきありがとうございました!