生成しない拡散モデル Nemotron Deciffusion 8B を DGX Spark で試してみた

はじめに
こんにちは、クラスメソッド製造ビジネステクノロジー部の森茂です。
2026 年 10 月 14 日に、Nemotron Deciffusion 8B というモデルが公開されました。名前は decision と diffusion を掛けたものに見えますが、公開ページに由来の説明はありません。土台は NVIDIA の Nemotron-Labs-Diffusion-8B、つまり拡散言語モデルです。ところが文章は 1 文字も書きません。状況と質問と選択肢を渡すと、「どの選択肢がもっともらしいか」の確率だけを返します。公開したのは NVIDIA の Solutions Architect である Alex Steiner 氏です。GitHub の個人アカウントと専用の Hugging Face organization から出ていて、NVIDIA 公式のリリースではない点は先に書いておきます。
拡散言語モデルといえば、文章の穴を並列に埋めていく生成の速さの話だと思っていました。その生成を捨てて、判定だけに使う。この向きは正直、意表を突かれました。しかも API は TypeSafe の Jev と互換の /v1/systemone です。この 1 か月、生成しない判定を 3 本の記事で追いかけてきました。OpenJev の実装を読み比べた記事(2026-09-18 時点の記事です)、NeMo Switchyard の判定役を 1 トークン判定に作り替えた記事(2026-09-23 時点の記事です)、生成せずに選ぶことだけをする決定モデル CLM を同じ物差しに乗せた記事(2026-09-27 時点の記事です)の 3 本です。評価セット 528 件と比べ方は手元にそのまま残っています。同じ API で呼べるなら、流さない手はありません。
先に結論を書いておくと、Jev と同じ日本語の質問を渡した zero-shot の Deciffusion は、同じ 528 件で測った Jev 1.13 と同じ水準でした。 実運用 87 件の誤送 0、設計相談 10 件は全件 strong、未見 237 件は誤送 10 件で AUC 0.858 です。1 判定の p50 は入力の中央値 961 トークンで 138 ms、FP8 で常駐 9 GiB。測定の前日に公開された Jev 1.14 でも同じ 528 件を流し直しましたが、並ぶという読みは変わりませんでした。ただし弱点も Jev とそろっています。見極め 14 問のうち 10 問を weak に流し、実行環境の節を足すと weak が減りました。手元の判定役をそのまま置き換えるところまでは届いていません。
この記事では、Nemotron Deciffusion 8B の素性と仕組みを一次情報で整理します。そのうえで DGX Spark で動かし、9/23 と 9/27 の記事と同じ 528 件で Jev や CLM、現行の判定役と並べた結果を紹介します。ルーターやエージェントの判断部分に小さな決定モデルを置きたい人に刺さるといいなと思っています。
Nemotron Deciffusion 8B の素性
まず、公開されている一次情報を表にまとめます。公開元は NVIDIA の organization ではなく、個人アカウントと専用の organization です。README も "Built on NVIDIA Nemotron-Labs-Diffusion-8B" と書くだけで、NVIDIA の製品としては名乗っていません。
| 項目 | 内容 |
|---|---|
| 公開日 | 2026-10-14(v2 が最初の公開版) |
| 開発者 | Alex Steiner 氏(GitHub pst2154、Solutions Architect@NVIDIA) |
| 土台 | nvidia/Nemotron-Labs-Diffusion-8B(全層を判定専用に学習し直し) |
| 重み | nemotron-deciffusion/Nemotron-Deciffusion-8B-v2(BF16)と NVFP4 版(GB200 で検証、GB10 では未検証) |
| ライセンス | モデルは NVIDIA Nemotron Open Model License、コードは Apache 2.0 |
| API | POST /v1/systemone。choice(最大 501 択)、noul(はい・いいえ)、score(順序つき段階)の 3 型、1 リクエスト最大 512 質問 |
| 長い入力 | 8,192 トークン超は自動で圧縮 |
| 配信 | ghcr.io/pst2154/nemotron-deciffusion:8b-v2(amd64 と arm64)。vLLM に未 merge の差分を重ねたもの、FP8 が既定 |
| 学習データ | Aegis 2.0、When2Call、HelpSteer2/3、Open-SWE-Traces、QuALITY、HotpotQA、SQuAD 2.0、PRM800K、HH-RLHF など 21 のデータセット。README とモデルカードは、すべての学習ソースが商用学習を許すライセンスだと明記 |
学習データの一覧やモデルカードに、日本語や多言語への言及はありません。日本語がそのまま通るかは、後の章で 1 件だけ確かめています。
公称値のうち、この記事の関心に近いものを抜きます。数字は公開リポジトリの release/v2/SOURCES.md に出典つきで載っているものです。
| 公称値 | 値 |
|---|---|
| JevBench public、top-1 | 210/231(hard tier 90/111) |
| エージェントの run を verify する AUC(未見の coding-agent run) | 0.725 |
| プロンプトインジェクションで注入された答えを選んだ割合 | 4.93% |
| 1 判定の p50(GB200、NVFP4、約 362 トークン、同時 1) | 24.1 ms |
マスクを 1 つだけ埋める拡散モデル
拡散言語モデルは、文章のあちこちに空いたマスク(穴)を、前後の文脈を見ながら並列に埋めていくモデルです。5 月の記事で DGX Spark 上の生成を測ったときも、この穴埋めの速さが主題でした。Deciffusion がやっているのは、その穴埋めを 1 マスだけに絞ることです。状況と質問を書いた答案用紙に、答え欄が 1 つだけ空いている。そこに A か B か C のどれが入るかを、周りを全部読んでから決める。それだけのモデルです。
ふつうの LLM との違いを、配信コードの serving/app/scoring.py から読み取れる範囲で図にします。
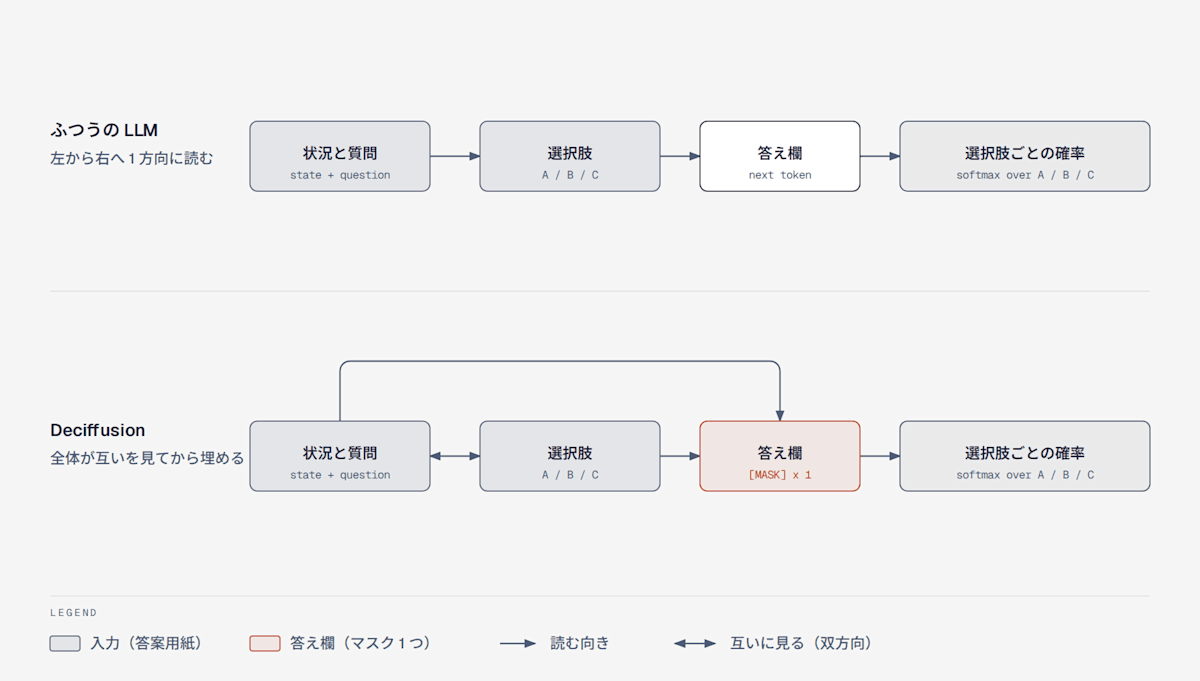
9/23 の記事で作った 1 トークン判定は、ふつうの LLM が「次の 1 語」として weak か strong を出す確率を読むものでした。Deciffusion も最後の読み出し方は同じです。選択肢に A、B、C のような 1 トークンの符号を振り、答え欄に入る符号の確率を読みます。違いは、その答え欄が文章の末尾の「次の 1 語」ではなく「マスクされた 1 マス」で、答案用紙の全体が互いを見てからそのマスを埋めていることです。ふつうの LLM は左から右にしか読めませんが、拡散モデルは状況も質問も選択肢も同時に見ています。
これが性格を 2 つ決めています。1 つ目は決定性です。選択肢の並び順は配信側が決め打ちし、乱数を使いません。同じ入力には同じ確率が返るので、この記事の Deciffusion の測定は 1 回です。2 つ目は速さの出し方です。前後を同時に読む代わりに、同じ文章の読み込みを次回に使い回す仕組み(prefix caching)は使えません。CLM が 2 回目の判定を 1 ms 台で返したような近道はなく、毎回まるごと読みます。その代わり 1 つの状況に最大 512 の質問を束ねられるので、質問が多い場面で元を取る設計です。ここは後の速さの章で数字を見ます。
DGX Spark では docker 1 行で動いた
起動は README の docker run 1 行です。手元で変えたのはメモリの上限だけ。手元の Spark では Switchyard の判定役コンテナが複数動いていて空きが 31 GB ほどだったので、GPU_MEMORY_UTILIZATION を 0.18 に下げました。
mkdir -p ~/.cache/deciffusion
docker run -d --name deciffusion --gpus all --shm-size=8g -p 127.0.0.1:8770:8770 \
  -v $HOME/.cache/deciffusion:/models \
  -e GPU_MEMORY_UTILIZATION=0.18 -e MAX_MODEL_LEN=16384 \
  ghcr.io/pst2154/nemotron-deciffusion:8b-v2
until curl -sf localhost:8770/health > /dev/null; do sleep 10; done
image は arm64 版があり、初回起動で 16 GB の重みを Hugging Face から取って FP8 に量子化しながら読み込みます。起動から約 5 分で /health が 200 になりました。常駐したモデルは 9.03 GiB です。
地味にうれしかったのは、起動スクリプトに DGX Spark 向けの分岐が最初から入っていたことです。GB10 を検出すると、起動時の自動チューニング(FlashInfer の autotune)を切り、メモリの上限とコンテキスト長を Spark 向けの既定値にします。コメントには、autotune が GB10 を 86 ℃ まで上げてフリーズさせたため、と書かれています。作者も GB10 の熱で止まる現象に当たっていたようで、少し親近感が湧きますね。手元のログにも "Skipping FlashInfer autotune because it is disabled" が出ていて、この分岐が効いていることが確認できました。
動作確認は README の例のチケットを 3 つの質問型で投げました。「どの窓口に回すか」の choice、「至急か」の noul、「優先度」の score です。日本語に訳した状況と選択肢でも同じ向きの答えが返ります。
{
  "answers": {
    "route": {
      "type": "choice",
      "probabilities": { "billing": 0.9875, "shipping": 0.0063, "tech": 0.0063 },
      "confidence": 0.9875,
      "choice": "billing"
    },
    "urgent": { "type": "noul", "noul": 0.531 },
    "priority": { "type": "score", "probabilities": { "0": 0.096, "1": 0.38, "2": 0.488, "3": 0.035 }, "score": 1.463 }
  },
  "usage": { "input_tokens": 503, "decision_positions": 3 },
  "metrics": { "seconds": 0.489, "engine_seconds": 0.471, "questions": 3 }
}
choice は選択肢ごとの確率を返し、一番高い確率を confidence として添えます。noul は「はい」の確率、score は段階の期待値です。日本語版では route の確率が 0.9835 と英語版の 0.9875 にほぼ揃い、urgent は 0.531 から 0.349 へ動きました。1 件だけなので、日本語で同じ判断になるとまでは言えません。ここでは、日本語の入力が壊れずに通る、とだけ書いておきます。
この記事の物差し
手元のユースケースを先に説明します。NeMo Switchyard は、コーディングエージェントへの依頼を、小さく安いモデル(weak)と大きく高いモデル(strong)のどちらに振るかを決める仕組みです。その振り分けを決める係が判定役で、いまは JSON を書く LLM が担っています。判定役が受け取るのは、依頼の会話と、weak 側のエージェントが何をできるか(使えるツール、権限、実行環境)を書いたカードです。質問は「この依頼を weak と strong のどちらに振るか」の二択です。判定役の位置を図にすると、こうなります。
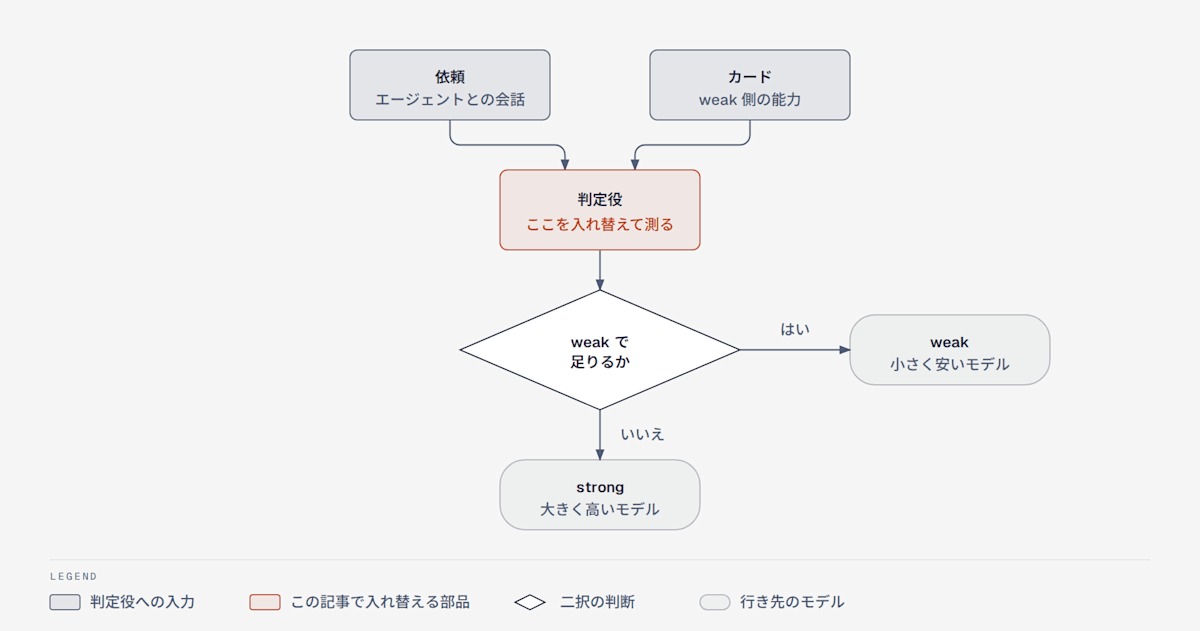
比べ方は 9/27 の CLM の記事と同じで、本番の判定役が受け取った入力をそのまま凍結した 528 件を流します。
| 評価セット | 件数 | 中身 | 読むところ |
|---|---|---|---|
| 実運用 87 件 | 87(採点対象 81) | 実運用で流れた依頼。英語 72、日本語 15 | 誤送と安全側の数 |
| 実装課題 30 件 × 2 | 30 × 2 | weak で完遂できる実装課題。実行環境の節あり版となし版 | カードの環境節に追従するか |
| 設計相談 10 件 | 10 | 設計の壁打ち。すべて strong | strong に残せるか |
| 見極め 14 問 | 14 | 一見 weak で済みそうだが strong が要る難問 | 難問を読めるか |
| 環境ペア 40 組 | 80 | 環境の 1 行だけが違い、正しい行き先が分かれる 2 通り | 環境節の 1 行の違いを読むか |
| 開発用 40 件 | 40 | 規則を凍結するための開発用 | 採点には使わない |
| 未見 237 件 | 237 | 未見の合成依頼と LiveCodeBench 由来。日本語 126、英語 111 | 一般化 |
採点の言葉を 3 つだけ決めておきます。誤送は、strong が要る依頼を weak に流した数です。安全側は、weak で済む依頼を strong に送った数で、損はしませんが節約になりません。AUC は、モデルが出す「weak でよい確率」の並べ方がどれだけ正しいかを 0.5 から 1 で表した指標で、1 に近いほど weak と strong を確率で分けられています。
確率をどこで切って weak にするかの規則は、結果を見る前に開発用 40 件と実運用の半分で決めて固定します。候補は「一番高い確率が 0.9 以上なら採用、それ未満は保険で strong に送る」のような閾値で、誤送が最少、次に安全側が最少のものを選びます。Jev と CLM の記録値は、この規則で 9/27 に採点した値です。
Jev と同じ 528 件を流したら、Jev に並んだ
ここからが本題です。Jev と同じ日本語の質問と選択肢の説明を渡しました。規則は「確率 0.9 以上で採用、未満は strong」で、Jev と CLM zero-shot も同じ規則が選ばれています。CLM 学習後の列だけは「weak の確率 0.7 以上で weak」です。
| 評価セット | n | Deciffusion | Jev 1.13 | CLM zero-shot | CLM 学習後 | 現行の判定役 |
|---|---|---|---|---|---|---|
| 実運用 87 件 | 81 | 75 / 0 / 6 | 69 / 0 / 12 | 58 / 1 / 22 | 34 / 0 / 47 | 79 / 1 / 1 |
| 実装課題(環境の節あり) | 30 | 20 / 0 / 10 | 19 / 0 / 11 | 0 / 0 / 30 | 11 / 0 / 19 | 20 / 0 / 10 |
| 実装課題(環境の節なし) | 30 | 28 / 0 / 2 | 9 / 0 / 21 | 13 / 0 / 17 | 7 / 0 / 23 | 17 / 0 / 13 |
| 設計相談 10 件 | 10 | 10 / 0 / 0 | 10 / 0 / 0 | 10 / 0 / 0 | 10 / 0 / 0 | 9 / 1 / 0 |
| 見極め 14 問 | 14 | 4 / 10 / 0 | 2 / 12 / 0 | 14 / 0 / 0 | 13 / 1 / 0 | 11 / 3 / 0 |
| 環境ペア 40 組 | 80 | 71 / 2 / 7 | 74 / 2 / 4 | 45 / 2 / 33 | 63 / 0 / 17 | — |
| 未見 237 件 | 237 | 170 / 10 / 57 | 156 / 10 / 71 | 124 / 42 / 71 | 179 / 6 / 52 | — |
数字は正解 / 誤送 / 安全側の順です。Deciffusion は 1 回測定、Jev は 3 反復の多数決、CLM は 1 回で、Jev と CLM と現行の値は 9/27 の記録値です。
正直、ここまで Jev に並ぶとは思っていませんでした。実運用 87 件の誤送 0 は Jev と同じで、安全側は 6 件と Jev の 12 件より少ない。設計相談 10 件は全件 strong に残し、環境ペア 17 組はすべて正しい向きに確率を付けています。未見 237 件では誤送 10 件が Jev と同数で、安全側は 57 件と Jev の 71 件より少なくなりました。AUC は未見 237 件で 0.858、開発用を除く全体で 0.902。Jev の 0.856 と 0.901 とほぼ同じ曲線です。
同時に、Jev の弱点もそのまま引き継いでいます。見極め 14 問は、依頼文は実装の形をしているのに weak の手には余る難問です。Deciffusion は 10 問を確率 0.9 以上で weak と答えました。weak の確率の中央値は 0.932 で、迷ってすらいません。Jev は 12 問、現行の判定役は 3 問、CLM zero-shot は 0 問です。汎用の決定モデルは「依頼文が実装の形をしているか」を読んでいて、「この実装がこのエージェントの手に余るか」は読んでいない。9/23 と同じ読みになります。
もう 1 つ、予想と逆向きの数字が出ました。実装課題 30 件には、カードに実行環境の節(read_file や run_tests が使える、という記述)が付いた版と付かない版があります。節が付けば weak に流しやすくなるのが期待する向きで、Jev は節あり 19、節なし 9 と期待どおりでした。Deciffusion は節なし 28、節あり 20 と、節を足すと weak が 8 件減ります。減った 8 件は誤送ではなく、確率が 0.9 を下回って保険で strong に送られた分です。環境の 1 行の違いは読めている(環境ペア 17/17)のに、節そのものが付くと自信が下がる。この理由は今回の測定では分かりません。
ところで、この原稿を書いている途中で、Jev 1.14.0 が前日の 10/14 に公開されていたことに気づきました。比較相手が旬を過ぎていては困るので、同じ 528 件を typesafe/jev-1.14 でも 3 反復流しました。OpenRouter 経由で 1,584 回、0.09 USD です。同じ手順で規則を決め直すと、1.14 では「weak の確率 0.5 以上で weak」が選ばれ、1.13 の「確率 0.9 以上で採用」と変わりました。そこで両方の規則で読んでいます。
| 評価セット | Jev 1.14(自前の規則) | Jev 1.14(1.13 と同じ規則) | Jev 1.13 | Deciffusion |
|---|---|---|---|---|
| 実運用 87 件 | 76 / 0 / 5 | 67 / 0 / 14 | 69 / 0 / 12 | 75 / 0 / 6 |
| 実装課題(環境の節あり) | 30 / 0 / 0 | 17 / 0 / 13 | 19 / 0 / 11 | 20 / 0 / 10 |
| 実装課題(環境の節なし) | 30 / 0 / 0 | 5 / 0 / 25 | 9 / 0 / 21 | 28 / 0 / 2 |
| 設計相談 10 件 | 10 / 0 / 0 | 10 / 0 / 0 | 10 / 0 / 0 | 10 / 0 / 0 |
| 見極め 14 問 | 0 / 14 / 0 | 7 / 7 / 0 | 2 / 12 / 0 | 4 / 10 / 0 |
| 環境ペア 40 組 | 77 / 3 / 0 | 77 / 1 / 2 | 74 / 2 / 4 | 71 / 2 / 7 |
| 未見 237 件 | 176 / 16 / 45 | 148 / 4 / 85 | 156 / 10 / 71 | 170 / 10 / 57 |
Jev 1.14 の AUC は未見 237 件で 0.847、全体で 0.902 と、1.13 の 0.856 と 0.901 からほぼ動いていません。環境ペアも 17/17 のままです。自前の規則では安全側が大きく減る代わりに未見の誤送が 16 件に増え、見極め 14 問は全問 weak でした。1.13 と同じ規則で読むと見極めは 7/14、未見の誤送は 4 件で、安全側が 85 件に増えます。どちらの読み方でも Deciffusion は Jev 1.14 と同じ水準で、見極め 14 問を weak に流す弱点も 3 者で共通でした。
質問の書き方で動くのは閾値側だけだった
CLM の記事では、質問の書き方で zero-shot の結果が大きく動きました。同じことを Deciffusion でも確かめます。英語の質問(en)と、行き先のモデル名を書いた英文(model-names)の 2 通りを足し、規則はそれぞれ決め直しました。
| 評価セット | ja | en | model-names |
|---|---|---|---|
| 実運用 87 件 | 75 / 0 / 6 | 32 / 0 / 49 | 37 / 0 / 44 |
| 実装課題の weak(節あり / なし) | 20 / 28 | 14 / 18 | 27 / 30 |
| 設計相談の strong | 10 | 10 | 10 |
| 見極め 14 問の strong | 4 | 12 | 7 |
| 環境ペア 40 組 | 71 / 2 / 7 | 63 / 2 / 15 | 75 / 2 / 3 |
| 未見 237 件 | 170 / 10 / 57 | 149 / 3 / 85 | 193 / 21 / 23 |
| AUC(全体 / 未見 237) | 0.902 / 0.858 | 0.891 / 0.852 | 0.901 / 0.884 |
| 環境ペア 17 組で正しい向き | 17 | 17 | 17 |
AUC はどの書き方でも全体 0.89 から 0.90 の幅に収まりました。確率の並べ方は質問の書き方で大きく動かず、動くのは確率の絶対値、つまり閾値をどこで切るかです。英語の質問は全体が strong 寄りで、実運用の weak で済む 56 件のうち 49 件を strong に送ります。見極め 14 問は 12 問が strong に残りましたが、これはモデルが strong を選んだのではなく、確率が 0.9 に届かず保険で strong に送られた分です。weak で済む依頼の大半を strong に送る判定役は、費用を節約する目的に合いません。model-names は逆に weak 寄りで、実装課題はほぼ全件 weak に流せますが、未見 237 件の誤送が 21 件と最も多くなりました。
日本語の入力は、実運用の 15 件と未見 237 件の日本語 126 件がすべて正常に通りました。実運用 87 件と全体の AUC では、日本語の質問が一番よかった。事実としてはそれだけで、モデルカードが日本語に触れていないモデルで日本語の質問が最もよく働いた理由は、今回の測定からは分かりません。
1 判定 138 ms、同時 8 本は苦手だった
速さは Spark の上で、呼び出す側も同じマシンに置いて測りました。応答にサーバー側の処理時間も入るので、両方を記録しています。入力は実運用 87 件(中央値 961 トークン、最大 1,803 トークン)です。
| 条件 | client p50 | client p95 | server p50 |
|---|---|---|---|
| 同時 1、1 巡目 | 137.6 ms | 255.4 ms | 136.5 ms |
| 同時 1、2 巡目(同じ 87 件) | 137.8 ms | 257.2 ms | 136.9 ms |
| 同時 8 | 2,728.5 ms | 3,766.0 ms | 2,725.7 ms |
| 同時 1、質問 3 本(choice + noul + score) | 336.6 ms | 959.3 ms | 335.4 ms |
| 同時 1、choice の選択肢 2 個 | 208.5 ms | 209.5 ms | 207.2 ms |
| 同時 1、choice の選択肢 10 個 | 258.7 ms | 260.3 ms | 257.3 ms |
| 同時 1、choice の選択肢 100 個 | 1,434.2 ms | 1,436.8 ms | 1,432.4 ms |
同時 1 の p50 は 137.6 ms で、2 巡目も同じ値です。読み込みの使い回しが無いので、CLM の「2 巡目は 1.1 ms」のような近道はありません。その代わり 2 巡の確率は 87 件すべて一致し、決定的に動くことが確かめられました。9/23 の 1 トークン判定の 0.25 秒と見比べると、同じ桁の中で短い側にいます。Jev の 0.25 秒は回線込みの値なので、ここには並べません。公称の GB200 で 24.1 ms は、入力が約 362 トークンで GPU も違うので、こちらも並べる土俵が違います。
意外だったのは同時 8 です。1 件あたりが 2.7 秒まで伸びて、全体でも 1 秒あたり 2.96 件と、同時 1 で順に流したときの 5.43 件を下回りました。同時に投げたほうが遅い、という逆転です。前後を同時に読む設計では prompt を分割して少しずつ処理できず、1,000 トークン前後の prompt を 8 本まとめた 1 回分が GB10 には重い、というのが見立てですが、原因の切り分けはしていません。手元の判定役は 1 セッションに 1 回ずつ呼ぶので実害は小さいものの、同時に多数の判定を流す使い方では公称値と同じ曲線は描けません。
1 つの状況に質問を 3 本束ねると 336.6 ms で、1 本の 2.4 倍です。3 本を別々に投げる 3 倍よりは短いので、束ねる売りは Spark でも成り立ちます。選択肢を 2 個から 100 個に増やすと 208 ms から 1,434 ms まで伸びました。選択肢の説明がそのまま prompt に入るので、入力が長くなった分です。CLM は候補の埋め込みを使い回して 1,000 候補でも 110 ms で返したので、候補が多い場面は CLM の設計が、質問が多い場面は Deciffusion の設計が向いている、という使い分けになりそうです。
汎用の決定モデルに Switchyard の何を任せるか
ここまでの判定役を、9/23 の記事と同じ型で並べます。
| 判定役 | 良かったところ | 足りなかったところ | いまの扱い |
|---|---|---|---|
| 現行の JSON 判定役 | 誤送がほぼ無く、難問もカードの環境節も読める | 1 回 1 秒弱 | 本番で稼働中 |
| Jev 1.13 / 1.14 | 実運用 87 件の誤送 0、環境ペア 17/17。回線込み 0.25 秒 | 難問 14 問中 12 問を weak と判定(1.14 は規則次第で 7〜14 問)。外部 API | 汎用の判断向け |
| CLM(学習後) | 未見 237 件の AUC 0.892、難問 13/14。手元で約 9 分で学習し直せる | zero-shot では届かない。学習データの偏りも覚える | 学習込みの候補 |
| Nemotron Deciffusion 8B v2 | zero-shot で実運用・設計相談・未見 237 件が Jev と同水準。実運用 87 件の誤送 0、安全側 6。ローカルで 138 ms、決定的、日本語がそのまま通る | 難問 14 問中 10 問を weak。環境節を足すと自信が下がる。同時 8 で遅くなる | 汎用の判断向け。学習し直しは続編 |
9/23 の記事で決めた採用の目安で読むと、設計相談 10 件を strong に残す条件は満たし、見極め 14 問で 9 問以上を strong に残す条件は 4 問で満たしません。環境節を足すと weak が増える条件は向きが逆で満たさず、すべて正常に返り判定が 0.35 秒以内という条件は満たします。Jev と同じ場所で止まっているので、手元の判定役としての結論も Jev と同じです。カードを知らない汎用の決定モデルは、依頼の形は読めても、このエージェントが何を苦手とするかは知りません。
それでも、この 1 か月で見てきた判定役の中で、Deciffusion の立ち位置は少し違います。Jev は外部 API で、CLM は zero-shot では使えませんでした。Deciffusion は重みが手元にあり、学習なしで Jev と同じ成績が出て、推論は 1 台の Spark で 138 ms です。リポジトリには finetune/ があり、LoRA は 80 GB 級 GPU 1 枚から、full fine-tune は 8 枚からと書かれています。9/23 と 9/27 の記事で使った判定データは 4,511 件あります。これで見極め 14 問が動くかどうかは、CLM の学習より重い宿題ですが、試す価値のある宿題だと思っています。
汎用の判定として使う場面、たとえばツール選び、エスカレーションの要否、トリアージのような「カードを知らなくてよい」判断であれば、今回の数字はそのまま使えます。1 つの状況に質問を束ねられること、確率が決定的に返ること、日本語がそのまま通ることは、ルーターの部品としては扱いやすい性質ですね。
まとめ
Nemotron Deciffusion 8B v2 を DGX Spark で動かし、Jev と同じ 528 件で判定役として測りました。起動は docker 1 行で、GB10 向けの分岐が最初から入っていて、FP8 で 9 GiB、1 判定 138 ms です。Jev と同じ日本語の質問を渡した zero-shot の成績は、Jev 1.13 と同じ水準でした。実運用 87 件の誤送 0、設計相談 10/10、未見 237 件の誤送 10 件と AUC 0.858 です。前日に出た Jev 1.14 を同じ 528 件で流し直しても、この読みは変わりませんでした。拡散モデルの使い道にこの向きがあったのか、というのが今回いちばんの収穫です。穴埋めを答え欄 1 マスに絞るだけで、生成しない判定の読み出し口になる。重みが手元にあり、学習なしでここまで出て、同じ入力には同じ確率が返る。ルーターの部品として欲しかった性質が、最初からそろっていました。
一方で、手元の判定役として足りないところも Jev と同じでした。見極め 14 問の 10 問を weak に流し、実行環境の節を足すと weak が減る。カードを知らない汎用モデルが、このエージェントの限界を読めないのは、学習データの形から来るものだと見ています。質問の書き方で動いたのは閾値に引っかかる数だけでした。今回は Day0 ということで 1 回測定、公称値は BF16 ですが手元は FP8 です。NVFP4 版の起動も試していません。
次は finetune/ で手元の判定データを学習させ、見極め 14 問が動くかを見てみたいところです。LoRA の要件が 80 GB 級 GPU 1 枚なので、128 GB の Spark で収まるかどうかも含めて続編で扱う予定です。
参考リンク
- Nemotron Deciffusion 8B 公開ページ
- pst2154/nemotron-deciffusion(GitHub) — 配信コード、
finetune/、release/v2/SOURCES.md - nemotron-deciffusion/Nemotron-Deciffusion-8B-v2(Hugging Face)
- nemotron-deciffusion/Nemotron-Deciffusion-8B-v2-NVFP4(Hugging Face)
- nvidia/Nemotron-Labs-Diffusion-8B(Hugging Face) — 土台モデル
- vllm-project/vllm#59299 —
/v1/systemoneの汎用エンドポイント(2026-10-08 merge) - vllm-project/vllm#60283 — Deciffusion の diffusion decision reads(未 merge)
- Jev: For the builders AND dreamers(TypeSafe AI Blog) — Jev 1.14.0 の公開告知(2026-10-14)
- Models(TypeSafe docs) —
jev-latest/jev-previewの指し先 - OpenJev を読んで、生成しない AI の別解を考えてみた(2026-09-18)
- Nemotron 3.5 Lightning の判定役を、Jev のように生成しない 1 トークン判定にしてみた(2026-09-23)
- 生成しない決定モデル CLM を、Switchyard の判定役として DGX Spark で試してみた(2026-09-27)
- Nemotron-Labs-Diffusion を DGX Spark で動かして tri-mode 生成を実測してみた(2026-05-21)