OpenAIがGitサーバーを作り直した「Pando」について調べてみた

どうも!オペ部の西村祐二です!
AIエージェントに複数の作業を任せると、コードを書く作業に加えて、ブランチへのpushやCIからのfetchも増えていきます。OpenAIが開発したPandoは、この並列開発を支えるGit互換バックエンドです。
面白いのは、Gitの操作体系を維持しながら、サーバー側で「何を毎回計算するか」「どの更新を一緒に調整するか」を変えている点です。今回は公式記事のArchitecting Pandoを中心に、pushからfetchまでを具体例で追ってみます。
Pandoが解決したいのは「書き手」と「読み手」の増加
PandoはGitクライアントではなく、pushを受け付け、fetchやcloneに必要なデータを提供するサーバー側の仕組みです。OpenAIのモノレポ全体で利用されています。
公式記事では、Codexによる並列開発の増加が背景として説明されています。1人が複数の変更を進め、そのpushをきっかけに複数のCIジョブが同じコミットを取得するため、書き込みと読み込みの両方が増えます。
たとえば、エージェントAが認証を修正し、Bがテストを追加し、Cがドキュメントを直すとします。それぞれ別ブランチへの変更なので、リポジトリを提供する側でも独立して受け付けたいところです。さらにCIの読み手が増えても、同じ履歴を配る処理を毎回やり直さずに済むと助かります。
この2つの要求に対して、Pandoはrefごとに更新を調整することと、packfileを読み手の間で再利用することを組み合わせています。
まずGitの「オブジェクト・ref・packfile」を整理する
Gitのオブジェクトは、ファイル内容を持つblob、ディレクトリ構造を持つtree、履歴をつなぐcommitなどのデータです。コミットからtreeやblob、親コミットをたどると、必要なファイルと履歴に到達できます。
一方、ブランチのrefは「いまどのコミットを指しているか」を表す参照です。オブジェクトが履歴の実体、refがその入口に当たります。
packfileは、複数のオブジェクトをまとめ、圧縮や差分表現を使って保存・転送する形式です。単純に「変更したファイルの一覧」ではありません。
ここで重要なのは、pushされるpackに、その履歴に必要なオブジェクトが全部入っているとは限らないことです。サーバーが既に持っていると合意した履歴は、省略して送れます。packだけを別の読み手に渡しても、その読み手が省略分を持っていなければ履歴を復元できません。
つまり、packを再利用するには、どのpackを保存したかに加えて、そのpackが何に依存するかも把握する必要があります。
サーバーを増やすだけでは解消しない待ち合わせ
公式記事は、Pandoの前に検討した分散Gitの方式として、3フェーズコミット(3PC)と共有の書き込み先行ログ(WAL)を説明しています。
| 公式記事でモデル化した方式 | 更新の進め方 | 負荷が集中する箇所 |
|---|---|---|
| 3PC | リポジトリの複製を持つサーバー間で、ref更新を複数段階で合意します | 複製先のディスクと、合意に必要な通信 |
| WAL | packを保存し、ref更新を共有マニフェストに記録します | 更新順序を決める共有マニフェストと、各複製への反映 |
たとえばWAL方式では、認証ブランチとドキュメントブランチへのpushが別々でも、最後に同じマニフェストを更新するなら、そこで競合します。オブジェクトの保存先を増強しても、この共通の更新箇所は残ります。
これは公式記事が比較用にモデル化した方式の説明です。すべてのGitホスティングサービスが同じ内部実装、同じ制約を持つという意味ではありません。元記事の比較説明も、この前提で読む必要があります。
Pandoが見直した2つの前提
Pandoは、次の2つを常に満たす設計から離れています。
| 見直した前提 | Pandoの選択 | 引き換えになること |
|---|---|---|
| 全refをリポジトリ全体の同一時点の状態として扱う | refごとに更新を調整し、必要な履歴の依存関係を記録します | 複数ブランチの読み取りが同じ時点の状態とは限りません |
| 読み手ごとに重複を避けた専用packを作る | 保存済みのpackを選んで再利用します | 既に持つオブジェクトを一部再取得する場合があります |
「リポジトリ全体でそろえる仕事」と「読み手ごとに作り直す仕事」を減らす選択です。ただし、その分だけ依存関係の管理と、どのpackを渡すかの選択が重要になります。
push:データを保存し、ブランチの入口を更新する
次は公式発表をもとに自作した概念図です。公式の構成図ではありません。メタデータキャッシュなどは省略しています。
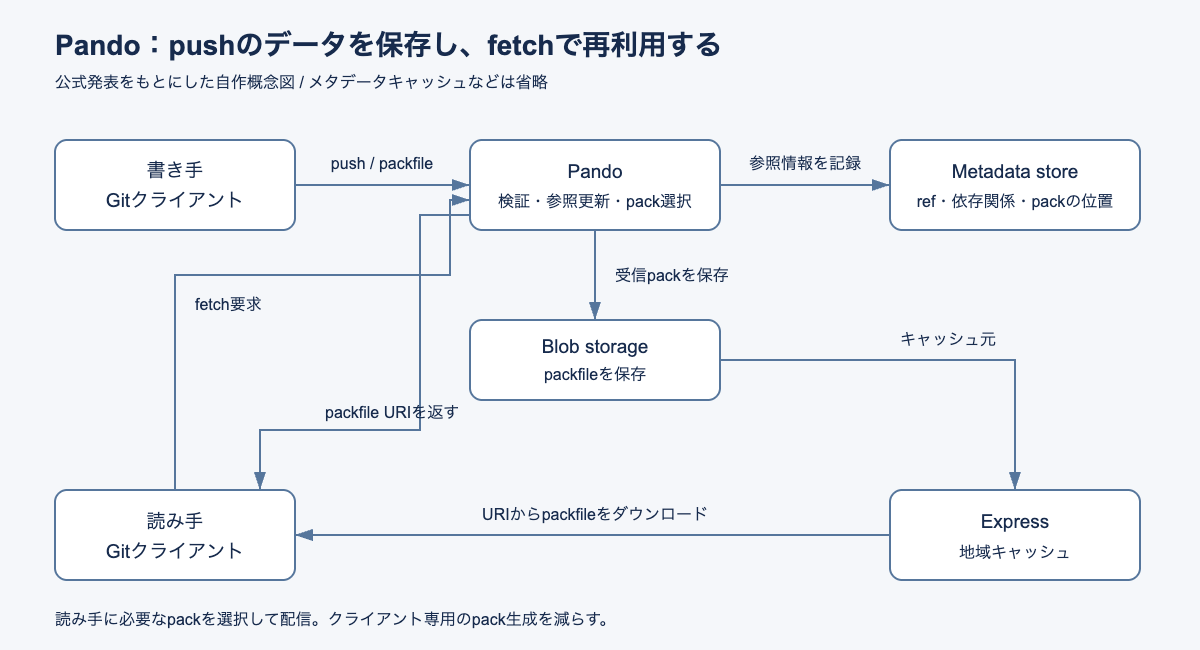
公式記事のpushの説明を整理すると、次の流れです。
- Gitクライアントがpackを送ります。
- Pandoは受信packを検証しながら、変更されないデータとしてpackの保存先(blob storage)へ保存します。
- 参照情報の保存先(metadata store)に、新しいref versionと依存関係、packの位置を記録します。
- ブランチの現在のref versionを指すref pointerを、新しい記録へトランザクション内で一括更新します。
3と4は同じトランザクションで行われます。
ref versionは、ブランチ更新の1回分を表す記録です。新しい先端コミットだけでなく、それを供給したpackと、依存する過去のref versionも保持します。単に「ブランチ名とコミットID」だけを保存する仕組みではありません。
また、受信packを各サーバーのローカルリポジトリに展開してから配信可能にする必要がありません。Pandoのサーバーは、Gitの交渉やpackの選択を主に担当します。
更新の競合を調整する対象は個別のref pointerなので、異なるブランチへのpushを独立して進められます。同じブランチへの同時更新については競合の調整が残ります。
push成功直後にfetchできる状態を作る
ref versionの記録とref pointerの更新は、同期処理で行われます。このため、新しく更新したコミットを直後に取得でき、自分の書き込みを読み取れる整合性(read-your-own-write)を提供します。
compactionの予約などの非同期処理も、同じトランザクションで記録します。データを利用可能にするための処理と、後から配信を効率化する処理を分けています。
公式記事のO(1)という説明は、push時のメタデータ読み書き回数についてです。大きなpackの転送や検証まで、サイズによらず一定時間で終わるという意味ではありません。
なぜtrunkだけを共通の土台にするとpackを再利用できるのか
pushの前には、サーバーが持つrefなどの情報をクライアントへ伝えます。公式記事では、これをadvertiseと呼んでいます。クライアントはその情報を使い、送らずに済むオブジェクトを判断できます。
多くのrefを伝えるほど、pushのpackから省略できる範囲は広がります。ただし、別の読み手も同じ省略分を持つとは限らず、packの再利用は難しくなります。反対に何も土台を示さなければ、履歴全体を含める負担が大きくなります。
Pandoでは、新しい作業ブランチへのpushに対し、デフォルトで指定したtrunkブランチを共通の土台として示します。ここでいうtrunkは開発の基準となるブランチで、以下ではmainとします。
同じブランチへ2回pushする例
次の図は、依存関係を説明するための自作概念図です。コミットやpackの名前、読み手の状態は架空で、公式の構成図ではありません。
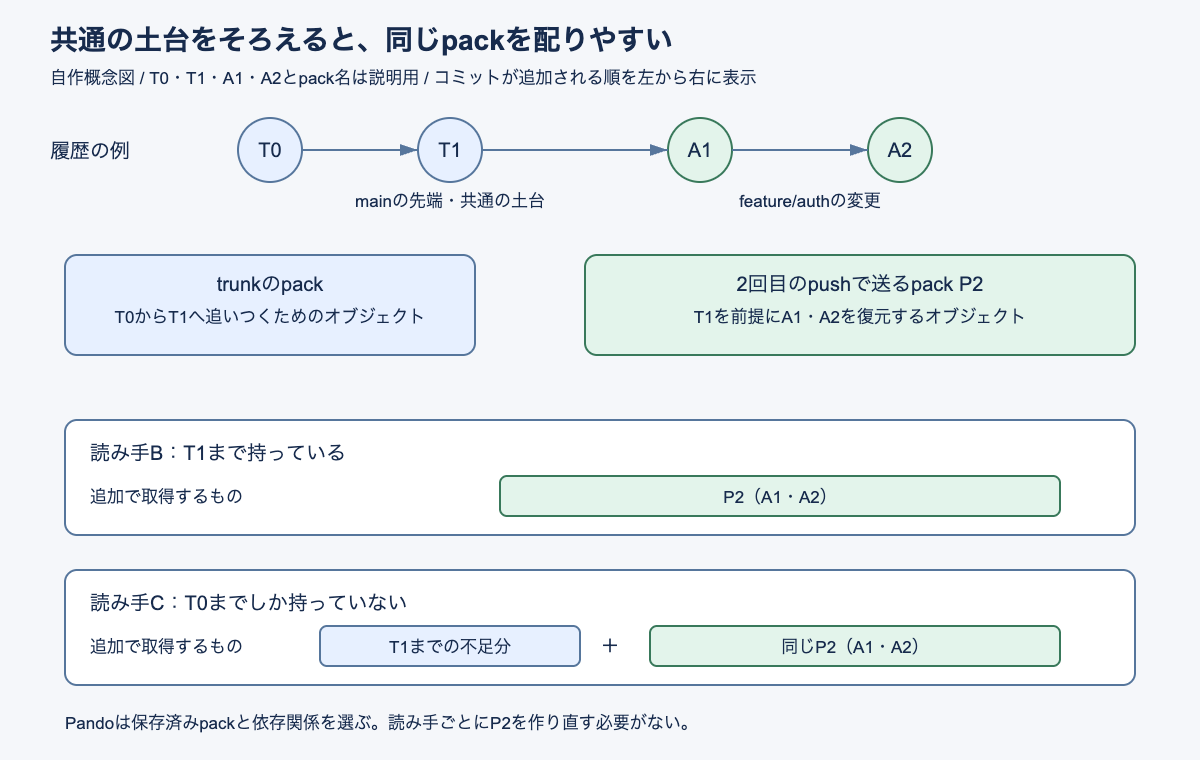
mainのコミットT1から、feature/authでA1、A2と変更を加える場合を考えます。
| タイミング | 共通の土台 | 作業ブランチのpackが含む範囲 |
|---|---|---|
| 1回目:A1をpush | T1までの履歴 | T1を持つ相手がA1を復元するためのオブジェクト |
| 2回目:A2をpush | T1までの履歴 | T1を持つ相手がA1・A2を復元するためのオブジェクト |
2回目も土台がT1なら、A1に必要なデータを再度含めます。前回のpushから増えたA2だけを送るより転送量は増えますが、T1を持つほかの読み手は2回目のpackだけで作業ブランチを取得できます。
この例では土台をT1に固定しています。実際に省略できる範囲は、push時の交渉で合意した履歴に依存します。また、共通の土台まで送ってしまう、毎回リポジトリ全体を転送する、という説明ではありません。
更新の安全確認と、packから省略する履歴を分ける
ここで「作業ブランチの現在位置を伝えなければ、他人が更新していないか確認できないのでは」と気になります。
公式記事で紹介されているOpenAIのGitビルドには、explicit havesという改善があります。更新対象ブランチの現在位置を伝えることと、packから省略してよい履歴を指定することを分離します。
これにより、--force-with-leaseで作業ブランチが想定から動いていないかを確認しつつ、pack自体はtrunkを土台に組み立てられます。「ブランチの更新確認」と「送るデータの最適化」は別の問題として扱っています。クライアント側の改善も、pack再利用を成立させる要素です。
fetch:読み手専用のpackを生成する代わりに、保存済みpackを選ぶ
fetchの交渉では、クライアントが持つコミットをhave、取得したいコミットをwantとして伝えます。Pandoはこれらをref versionに対応付け、必要なオブジェクトをそろえられるよう、保存済みpackの組み合わせを選びます。
先ほどの例なら、T1を持つ読み手は、A1とA2を含むpackを取得します。一方、T0までしか持たない読み手には、T1までの不足分も必要です。Pandoは作業ブランチのpackだけでなく、その依存分も選びます。
読み手ごとに異なるのは、主にどのpackを組み合わせるかです。同じpackを何人にも配れるため、読み手の数だけ圧縮処理を繰り返す負担を減らせます。ただし、各packに含まれるオブジェクトの一部が、読み手の手元と重複する場合はあります。
packの選択と、実データの配信を分ける
Pandoが使うpackfile-uriは、packをダウンロードするURIをGitの応答で伝えられる仕組みです。Pandoは応答内のpackを空にし、実データをURI経由で取得させます。
実データの配信はExpressというサービスが担当し、blob storageのデータを地域ごとにキャッシュします。メタデータにも別のキャッシュがあります。したがって、Pandoがpackを選ぶ処理と、大きなpackを読み手へ届ける処理を、それぞれ増強できます。
たとえば100台のCIが同じコミットを取得する場合、同じpackをキャッシュから配れる構成です。これは「100台向けにデータを100回作る仕事」を減らす説明であり、100台へのネットワーク転送自体が不要になるわけではありません。
因果整合性は、何を保証して何をそろえないのか
Pandoは、取得対象を作った書き手の履歴と依存関係を読み手へ渡します。packを取得できても必要な土台が欠けている、という状態を避けるための設計です。同じrefへの更新は、順番に処理した場合と矛盾しないよう調整します(直列化可能性)。
一方、すべてのrefを同じ瞬間の状態として読み取る保証はありません。公式記事では、cloneの交渉中にfooとbarが更新された場合の例を挙げています。
| 読み手 | fooの観測 | barの観測 |
|---|---|---|
| 読み手A | 更新前 | 更新後 |
| 読み手B | 更新後 | 更新前 |
この組み合わせがあり得る、という説明です。取得する各履歴の依存関係を満たすことと、全ブランチの観測時点をそろえることは異なります。
別々の作業ブランチを更新する開発では、全refの同一時点性より、各ブランチを安全に更新して取得できることが重要になります。ただし、複数refの同一時点の状態を前提とする処理では、その前提を見直す必要があります。これは因果整合性の説明を読む際の注意点です。
compaction:細かいpackをまとめ、探索も短くする
packを再利用するだけでは、長くfetchしていない読み手に大量の小さなpackを渡すことになります。そこでPandoは、バックグラウンドでcompactionを行います。
pushでできた最小単位のpackをL0として、連続するref versionの範囲をcoverにまとめ、さらに広い範囲を上位レベルにまとめます。coverが十分に埋まると、その範囲のオブジェクトを1つのpackへ再構成します。
説明用に、8回のpushで8個の小さなpackができたとします。ある読み手がその8回分すべてを必要とし、その範囲の統合packが用意されていれば、8個を個別に取得する代わりにまとめて取得できます。8という数は説明用で、Pandoの実際の統合条件ではありません。
compactionには、次の2つの効果があります。
- オブジェクトを再配置して圧縮し、転送量や取得するpackの数を減らします。
- 履歴の範囲を階層でまとめ、必要なpackを選ぶ際にref versionを1つずつたどる負担を減らします。
後者は、目次を使って、関係のない章を飛ばし、目的の箇所を探すことに近いです。coverは再圧縮が終わる前でも探索に役立ちます。単に複数ファイルを結合するだけの処理ではありません。
公式記事では、fetch時のメタデータ読み取りをO(log Δ)と説明しています。Δは、手元と取得先の間の最短のref version距離です。これはpack選択の探索コストの説明であり、ダウンロードするデータ量まで対数になるという意味ではありません。
また、まとめた後も下位レベルのpackは保持します。少しだけ遅れている読み手や、個別オブジェクトを読む用途もあるためです。通常の「古いpackを捨てて容量を回収する処理」とは分けて理解する必要があります。compactionの節は、転送の効率と取得開始前の探索の両方を扱っています。
性能と公開状況をどう読むか
OpenAIは、本番環境でpushのレイテンシの中央値を約80%削減し、標準的なクラウドVMでclone・fetchが10 Gbpsの回線を使い切ることを確認したと報告しています。
これらはOpenAIの環境での結果です。Gitクライアントを交換するだけで同じ性能になるという数値ではありません。また、公式ページの方式比較シミュレーションは説明用のモデルで、本番ベンチマークとは区別されています。
2026年11月4日時点で、公式発表にはPando本体の一般向け導入手順や料金の案内はありません。技術の共有方法は検討中です。公開されているOpenAIのGitフォークと、Pando本体の提供状況も別です。
Gitクライアント側の改善については、公開パッチトラッカーから追えます。Pandoを自分で導入できるかに加え、Git本体へどの改善が還元されるかも見ていきたいです。
まとめ
Pandoの設計は、ブランチごとに更新を調整し、pushで受け取ったpackと依存関係を保存して、fetchで再利用するという流れでつながっています。trunkを共通の土台にする交渉、ref version、packfile-uri、地域キャッシュ、compactionが、この流れを支えています。
その代わり、全refの同一時点性や、読み手ごとの重複のない転送は優先していません。並列pushと繰り返しのfetchが増える環境で、どの保証と処理を残し、どこを簡略化するか。Pandoは、その設計判断を具体的に理解できる事例です。