Snowflake Openflow Gen 2 で PostgreSQL CDC のセットアップと設定ファイルによる構成変更を試してみた

はじめに
2026年9月のアップデートで Snowflake Openflow の第 2 世代(Gen 2)の Deployment と Runtime が一般提供となりました。
あわせて、コネクタの設定もパブリックプレビューとして、SQL やセットアップウィザードから行えるようになっています。
Gen 2 の Snowflake Deployment 上で Amazon RDS for PostgreSQL の CDC コネクタの設定、簡単な構成変更を試してみた内容を記事としました。
Gen 1 と Gen 2 の違い
Gen 1 と Gen 2 比較は以下に記載があります。
Gen2 になったことでの主な違いは以下の通りです。コネクタ設定については設定ファイルで管理できるので、コネクタ管理を CI/CD パイプラインに統合できるとされています。
- Deployment・Runtime の管理
- SQL で作成・変更できる
- 上記のため、Snowflake のオブジェクトとして RBAC で管理できる
- コネクタの設定方法
- セットアップウィザード、またはステージ上の設定ファイル
- ※2026年10月時点で、この方法で設定できるコネクタは PostgreSQL と MySQL / MariaDB の 2 つ。いずれも Gen 2 の Runtime が必要
- セットアップウィザード、またはステージ上の設定ファイル
- 設定の保存先
- Gen 1:キャンバス上のフロー
- Gen 2:ステージ上の
config.json(バージョンとして保存)
- 設定の変更方法
- Gen 1:キャンバスで編集
- Gen 2:
liveバージョンを編集し、COMMITで新しいバージョンにする
試してみる
前提条件
以下の環境を使用しています。
- Snowflake:商用アカウント
- Edition:Enterprise
- クラウドサービス:AWS
- リージョン:東京(
AWS_AP_NORTHEAST_1) - Deployment の種類:Snowflake Deployment
- AWS 側
- Amazon RDS for PostgreSQL(論理レプリケーションを有効化)
構成については、以下の記事の内容を参考にしています。
Snowflake Deployment は、Snowpark Container Services(SPCS)上で動作します。アウトバウンドの PrivateLink にも対応していますが、今回はこちらの記事を参考にインターネット経由で接続します。
具体的には、RDS をプライベートサブネットに作成し、前段にインターネット向けの NLB を置き NLB のセキュリティグループで Snowflake の egress IP だけを許可する構成としています。
事前準備
NLB へのネットワークアクセス制御にために、Snowflake の Egress IP を確認しておきます。範囲ごとに有効期限があるため、本番運用時は期限切れの前に、許可リストを更新する必要があります。
SELECT SYSTEM$GET_SNOWFLAKE_EGRESS_IP_RANGES();
PostgreSQL 側の準備としては、論理レプリケーションの確認、サンプルデータ、レプリケーション用ユーザー、Publication を作成しておきます。
サンプルデータは以下の内容で用意しました。
サンプルデータの作成 SQL
CREATE TABLE public.customers (
  customer_id  integer PRIMARY KEY,
  name         text        NOT NULL,
  email        text        NOT NULL,
  created_at   timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE public.orders (
  order_id     integer PRIMARY KEY,
  customer_id  integer       NOT NULL REFERENCES public.customers (customer_id),
  amount       numeric(10,2) NOT NULL,
  status       text          NOT NULL,
  ordered_at   timestamptz   NOT NULL DEFAULT now()
);

-- 顧客 1 万件(generate_series で連番を作り、1 回の INSERT で投入する)
INSERT INTO public.customers (customer_id, name, email, created_at)
SELECT g,
       'Customer ' || g,
       'user' || g || '@example.com',
       now() - random() * interval '365 days'
FROM generate_series(1, 10000) AS g;

-- 注文 10 万件(顧客 ID は 1〜10000 のいずれか。外部キー制約を満たす)
INSERT INTO public.orders (order_id, customer_id, amount, status, ordered_at)
SELECT g,
       1 + floor(random() * 10000)::int,
       round((random() * 50000)::numeric, 2),
       (ARRAY['paid', 'shipped', 'delivered', 'cancelled'])[1 + floor(random() * 4)::int],
       now() - random() * interval '365 days'
FROM generate_series(1, 100000) AS g;

SELECT COUNT(*) FROM public.customers;  -- 10000
SELECT COUNT(*) FROM public.orders;     -- 100000
SELECT status, COUNT(*) FROM public.orders GROUP BY status ORDER BY status;  -- 4 種類にほぼ均等に分かれる

 count
-------
 10000
(1 row)

 count
--------
 100000
(1 row)
Snowflake 側:管理用オブジェクトの作成
以下の手順で Openflow を管理するロールと、データベース・スキーマを作成しました。
ここで作成するデータベースとスキーマは、Runtime とコネクタを格納する領域となります。データの取り込み先は後程作成します。
USE ROLE ACCOUNTADMIN;

CREATE ROLE IF NOT EXISTS yasuhara_openflow_admin;
GRANT ROLE yasuhara_openflow_admin TO ROLE ACCOUNTADMIN;

-- アカウントレベルのデプロイメント作成権限を付与
GRANT CREATE OPENFLOW DEPLOYMENT ON ACCOUNT TO ROLE yasuhara_openflow_admin;
GRANT CREATE DATABASE ON ACCOUNT TO ROLE yasuhara_openflow_admin;
GRANT CREATE INTEGRATION ON ACCOUNT TO ROLE yasuhara_openflow_admin;
GRANT CREATE COMPUTE POOL ON ACCOUNT TO ROLE yasuhara_openflow_admin;

USE ROLE yasuhara_openflow_admin;

-- Openflow管理用のデータベーススキーマを作成
CREATE DATABASE yasuhara_openflow_db;
CREATE SCHEMA IF NOT EXISTS yasuhara_openflow_db.openflow_schema;
その他のポイントとして、Runtime とコネクタをスキーマ内に作成するには、そのスキーマに対するCREATE OPENFLOW RUNTIMEとCREATE OPENFLOW CONNECTOR権限が必要です。
次に、コネクタが Snowflake にアクセスする際に使用するロールと、外部への接続を許可するネットワークルール・外部アクセス統合を作成します。
USE ROLE ACCOUNTADMIN;

CREATE ROLE IF NOT EXISTS yasuhara_openflow_execute_as_rl;
GRANT ROLE yasuhara_openflow_execute_as_rl TO ROLE yasuhara_openflow_admin;
GRANT USAGE ON DATABASE yasuhara_openflow_db TO ROLE yasuhara_openflow_execute_as_rl;
GRANT USAGE ON SCHEMA yasuhara_openflow_db.openflow_schema TO ROLE yasuhara_openflow_execute_as_rl;

USE DATABASE yasuhara_openflow_db;
USE SCHEMA openflow_schema;

-- 接続先は NLB の DNS 名とポート
CREATE OR REPLACE NETWORK RULE openflow_my_runtime_network_rule
  MODE = EGRESS
  TYPE = HOST_PORT
  VALUE_LIST = ('<NLB の DNS 名>:5432');

CREATE OR REPLACE EXTERNAL ACCESS INTEGRATION yasuhara_openflow_my_runtime_eai
  ALLOWED_NETWORK_RULES = (yasuhara_openflow_db.openflow_schema.openflow_my_runtime_network_rule)
  ENABLED = TRUE;

GRANT USAGE ON INTEGRATION yasuhara_openflow_my_runtime_eai TO ROLE yasuhara_openflow_execute_as_rl;
取り込み先のデータベース、MERGE 用のウェアハウス、PostgreSQL のパスワードを保存するシークレットを作成します。
※取り込み先のスキーマは、コネクタが作成するため、事前には作成しません。
CREATE DATABASE IF NOT EXISTS yasuhara_pg_openflow_dest;
CREATE WAREHOUSE IF NOT EXISTS yasuhara_openflow_wh WAREHOUSE_SIZE = XSMALL AUTO_SUSPEND = 60;

GRANT USAGE ON DATABASE yasuhara_pg_openflow_dest TO ROLE yasuhara_openflow_execute_as_rl;
GRANT CREATE SCHEMA ON DATABASE yasuhara_pg_openflow_dest TO ROLE yasuhara_openflow_execute_as_rl;
GRANT USAGE, OPERATE ON WAREHOUSE yasuhara_openflow_wh TO ROLE yasuhara_openflow_execute_as_rl;

-- シークレットを作成
CREATE OR REPLACE SECRET yasuhara_openflow_db.openflow_schema.pg_password
  TYPE = GENERIC_STRING
  SECRET_STRING = '<openflow_repl のパスワード>';

-- シークレットの読み取り権限を付与
GRANT READ ON SECRET yasuhara_openflow_db.openflow_schema.pg_password TO ROLE yasuhara_openflow_execute_as_rl;
Openflow のコンポーネントを作成
Deployment、Runtime、コネクタを作成します。
はじめに Deployment を SQL で作成します。
USE ROLE yasuhara_openflow_admin;

-- Deploymentを作成
CREATE OPENFLOW DEPLOYMENT yasuhara_snowflake_deployment
  DEPLOYMENT_TYPE = SNOWFLAKE
  DISPLAY_NAME = 'My gen 2 Snowflake Deployment';
+-------------------------------------------------------------------------+
| status                                                                  |
|-------------------------------------------------------------------------|
| Openflow Deployment YASUHARA_SNOWFLAKE_DEPLOYMENT successfully created. |
+-------------------------------------------------------------------------+
作成後、Openflow UI からも確認できます。
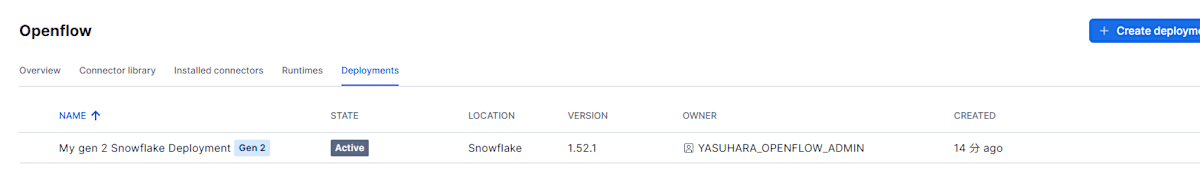
Deployment には、モニタリング用に専用のイベントテーブルを設定しておきます。
CREATE EVENT TABLE IF NOT EXISTS yasuhara_openflow_db.openflow_schema.openflow_events;

ALTER OPENFLOW DEPLOYMENT yasuhara_snowflake_deployment
  SET EVENT_TABLE = 'yasuhara_openflow_db.openflow_schema.openflow_events';
Runtime を作成します。
USE ROLE yasuhara_openflow_admin;
USE DATABASE yasuhara_openflow_db;
USE SCHEMA openflow_schema;

CREATE OPENFLOW RUNTIME my_runtime
  IN DEPLOYMENT yasuhara_snowflake_deployment
  NODE_TYPE = MEDIUM
  NODE_TYPE_TIER = 'M4'
  MIN_NODES = 1
  MAX_NODES = 1
  EXECUTE_AS_ROLE = yasuhara_openflow_execute_as_rl
  EXTERNAL_ACCESS_INTEGRATIONS = (yasuhara_openflow_my_runtime_eai)
  DISPLAY_NAME = 'My gen 2 Runtime';
+---------------------------------------------------+
| status                                            |
|---------------------------------------------------|
| Openflow Runtime MY_RUNTIME successfully created. |
+---------------------------------------------------+
こちらも作以後に UI で確認できました。
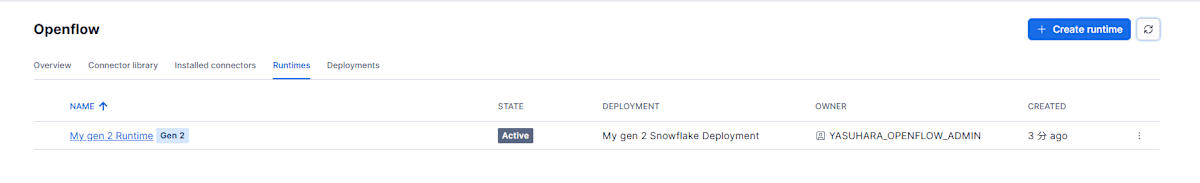
続けてコネクタを作成します。コネクタの初回作成は GUI から行いました。
公式ドキュメントでも、最初のコネクタの設定にはセットアップウィザードを使うよう案内されています。
はじめに「Connector library」からコネクタを Runtime にインストールします。
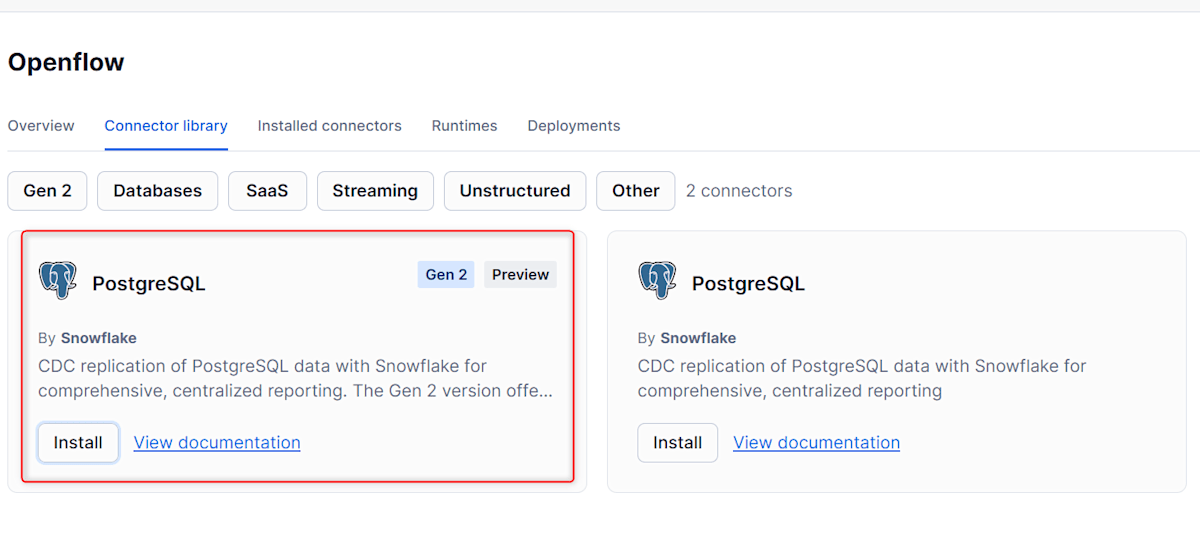
コネクタをインストールしたら、Openflow の画面の「Installed Connector」にも、作成したコネクタが表示されます。
コネクタのセットアップウィザード
Openflow の画面で、作成したコネクタの編集をクリックします。
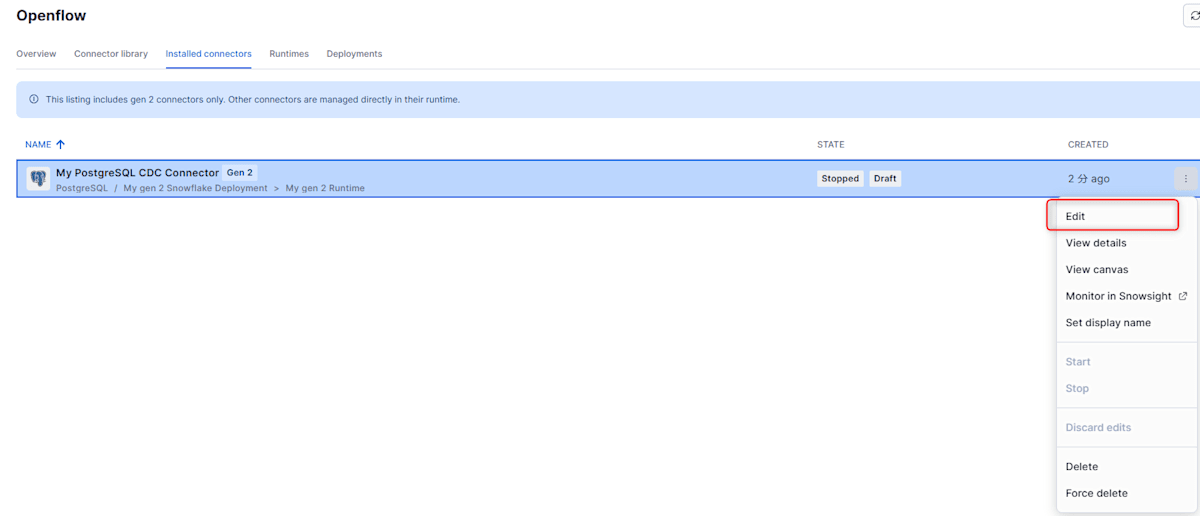
セットアップウィザードは下図のようになっていました。はじめに接続情報を入力します。
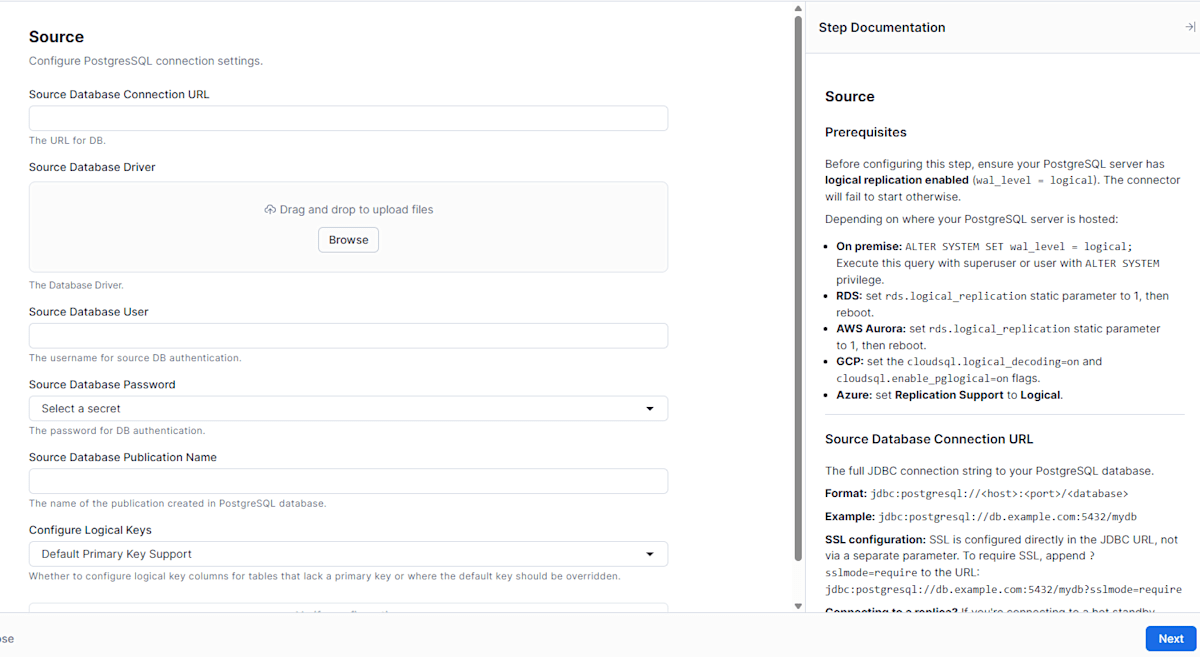
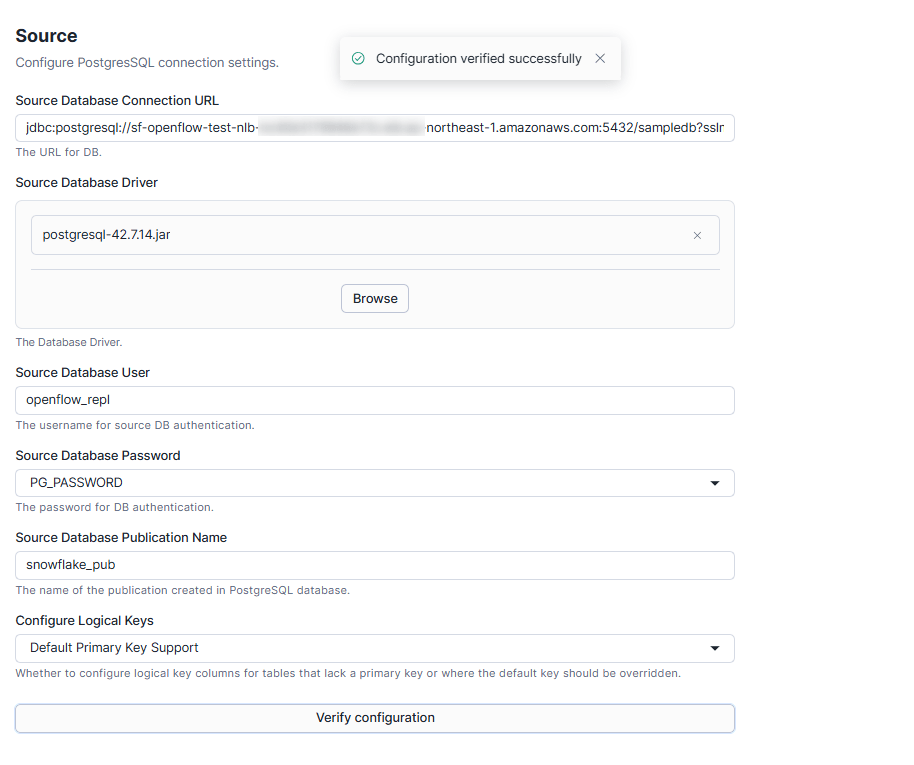
主な項目と設定は以下の通りです。
- Source Database Connection URL
jdbc:postgresql://<NLB の DNS 名>:5432/sampledb?sslmode=require
- Source Database Driver
- PostgreSQL の JDBC ドライバー(
postgresql-42.7.14.jar)をアップロード
- PostgreSQL の JDBC ドライバー(
- Source Database User
openflow_repl
- Source Database Password
- シークレットオブジェクト
yasuhara_openflow_db.openflow_schema.pg_passwordを選択
- シークレットオブジェクト
- Source Database Publication Name
snowflake_pub
- Configure Logical Keys
- Default Primary Key Support(既定のまま)
注意点として JDBC ドライバーは、PostgreSQL の公式サイトからダウンロードしたものを、ウィザードからアップロードします
入力後「Verify Configuration」を実行し、問題なければ次に進みます。
Replication table schema
レプリケーションするスキーマとテーブルを選びます。
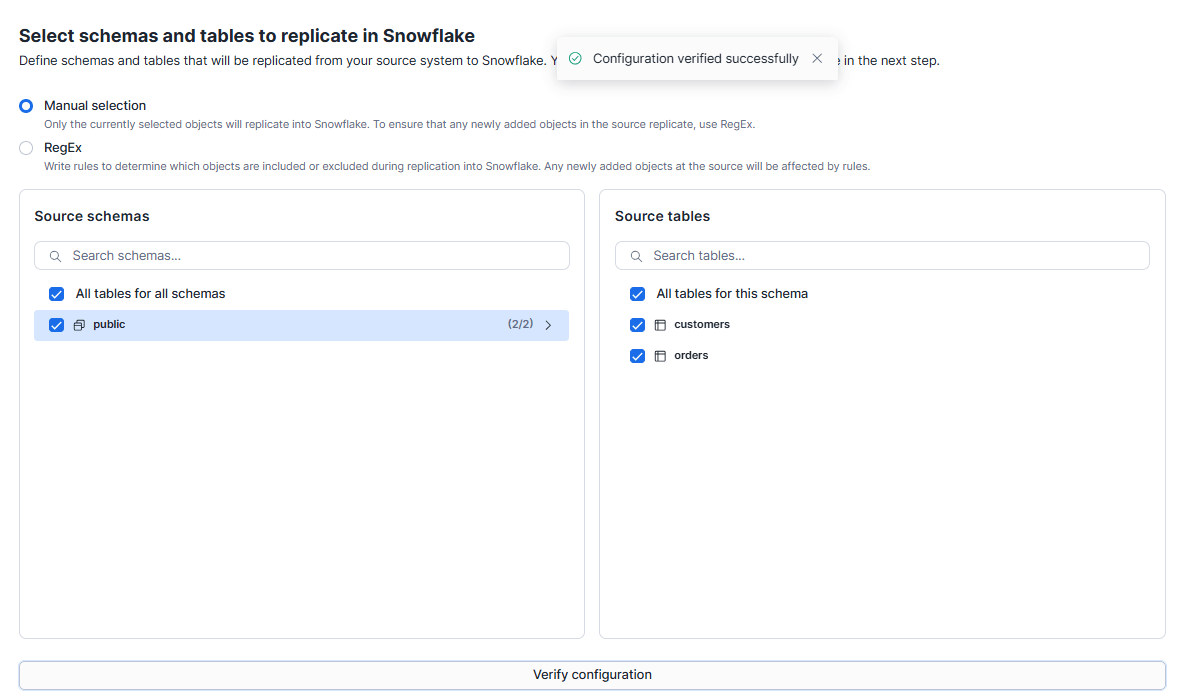
対象は以下の2つから選択できます。
- Manual selection
- 選んだオブジェクトだけを対象にする。ソースに追加されたテーブルは対象にならない
- RegEx
- 正規表現で対象を決める。ソースに追加されたテーブルにも、ルールが適用される
今回は、Manual selection でサンプルデータとして作成したpublic.customersとpublic.ordersを選択しました。
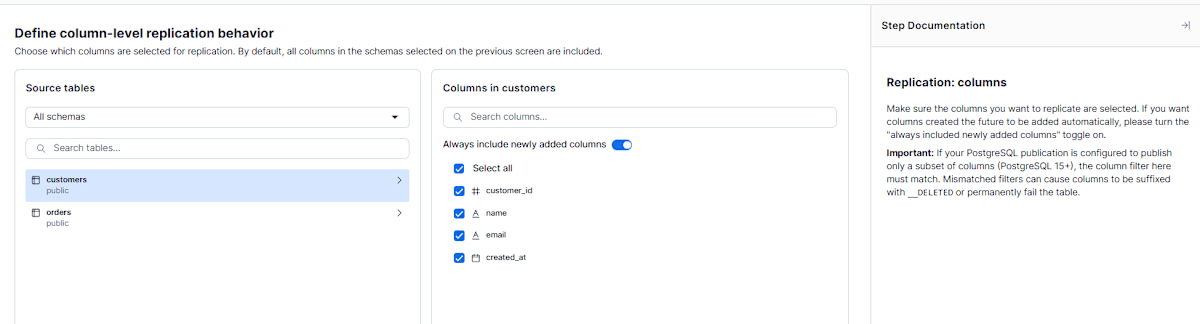
Replication columns
レプリケーションする列を決めます。既定では、選んだテーブルの全列が対象です。今回は、全列を取り込むため、何も設定せずに進みました。
Destination details
取り込み先の設定です。
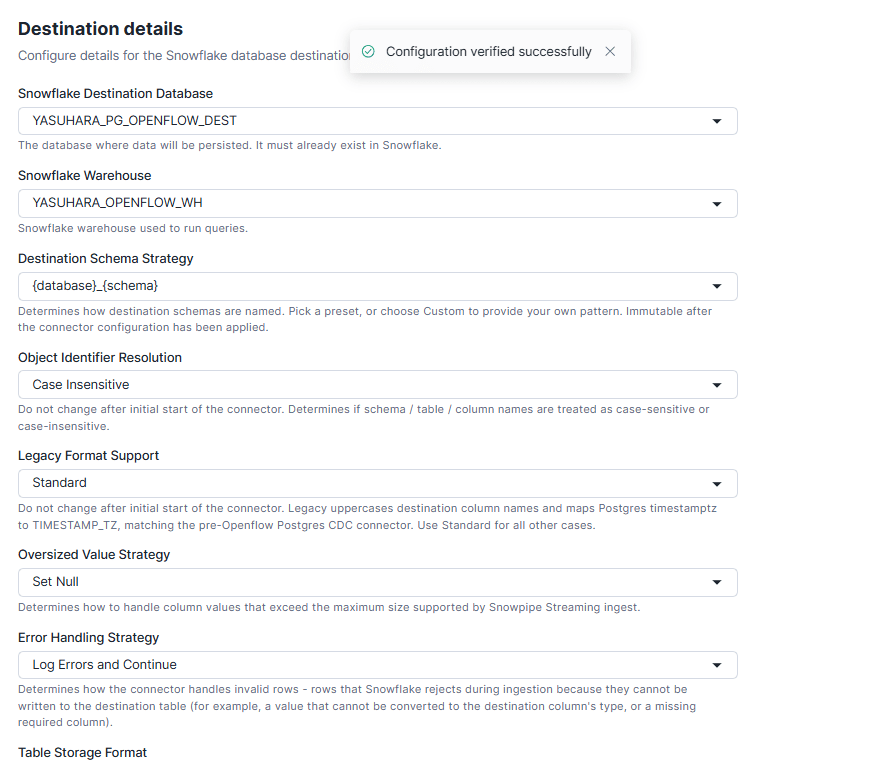
こちらは以下の通り設定しました。
| 項目 | 内容 | 今回の設定 |
|---|---|---|
| Snowflake Destination Database | 書き込み先の DB | yasuhara_pg_openflow_dest |
| Snowflake Warehouse | 宛先テーブルへの MERGE を実行するウェアハウス | yasuhara_openflow_wh |
| Destination Schema Strategy | 宛先のスキーマ名の付け方 | {database}_{schema} |
| Object Identifier Resolution | 名前の大文字・小文字の扱い | Case-insensitive(すべて大文字で保存) |
| Legacy Format Support | 旧コネクタの列名・型に合わせるか | Standard |
| Oversized Value Strategy | 大きすぎる値の扱い | Set Null(既定) |
| Error Handling Strategy | 受け付けられない行の扱い | Log Errors and Continue(既定) |
| Table Storage Format | 宛先テーブルの形式 | Standard |
- Destination Schema Strategy、Object Identifier Resolution、Table Storage Format は初期設定後は変更できません。変更時はコネクタを再作成します
- 宛先スキーマは
{database}_{schema}を選んだため、SAMPLEDB_PUBLICになります
Tuning
CDC の変更を宛先に反映するタイミングを設定します。
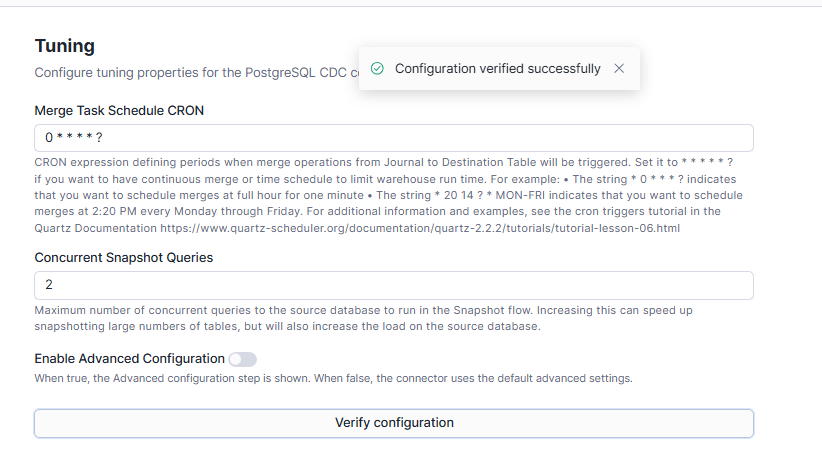
こちらは以下の通りとしました。
- Merge Task Schedule CRON
- ジャーナルテーブルの変更を、宛先テーブルへ MERGE するタイミング
- MERGE のときにウェアハウスが動くため、ウェアハウスのコストはここで発生する
- 今回の設定:
0 * * * * ?(1 分ごと)
- Concurrent Snapshot Queries
- 初回スナップショットで、並列にスナップショットするテーブルの最大数
- 今回の設定:2(既定)
Migration
初回スナップショットの扱いと、CDC に使うレプリケーションスロットを決めます。
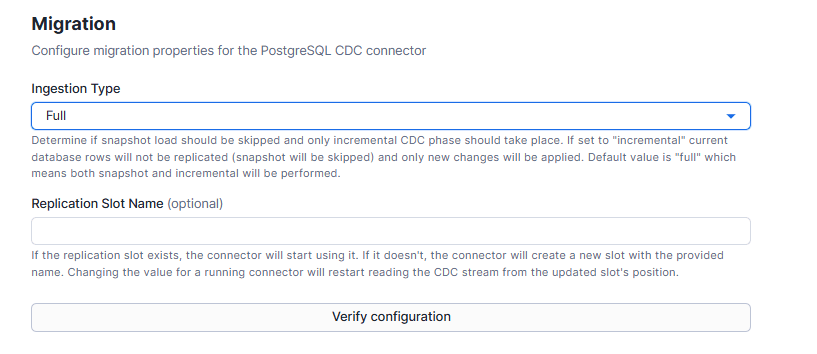
- Ingestion Type
full:全量のスナップショットのあと、CDC に切り替えるincremental:スナップショットを飛ばして、増分だけ取り込む- 今回の設定:
full(既定)
- Replication Slot Name
- CDC に使うレプリケーションスロット名
- 空欄ならコネクタが新規に作成
- 今回の設定:空欄(既定)
最後にサマリを確認して、「Apply」をクリックします。
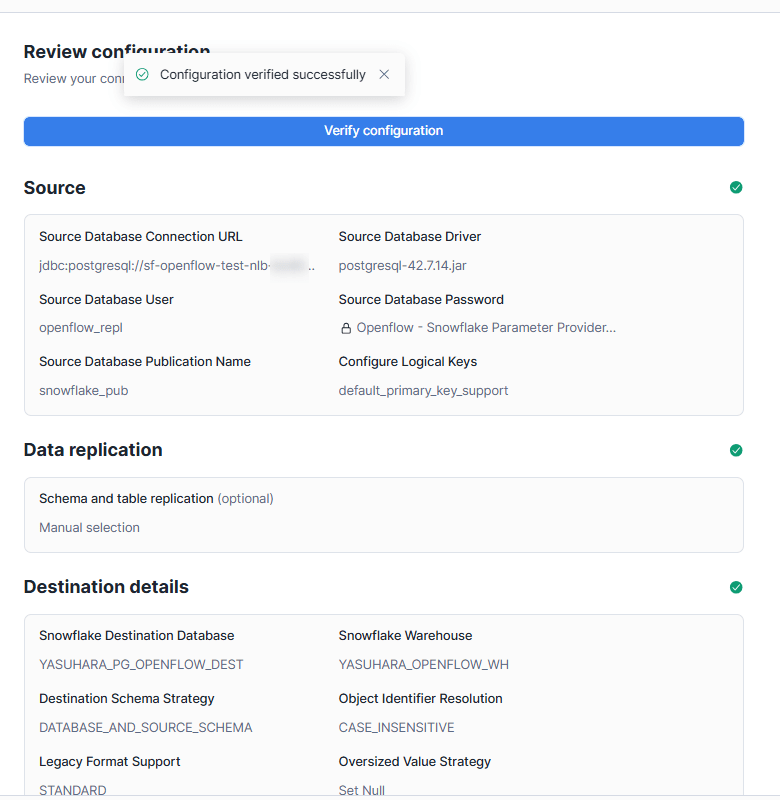
実行
Apply 後に下図の「Start」でコネクタを起動します。
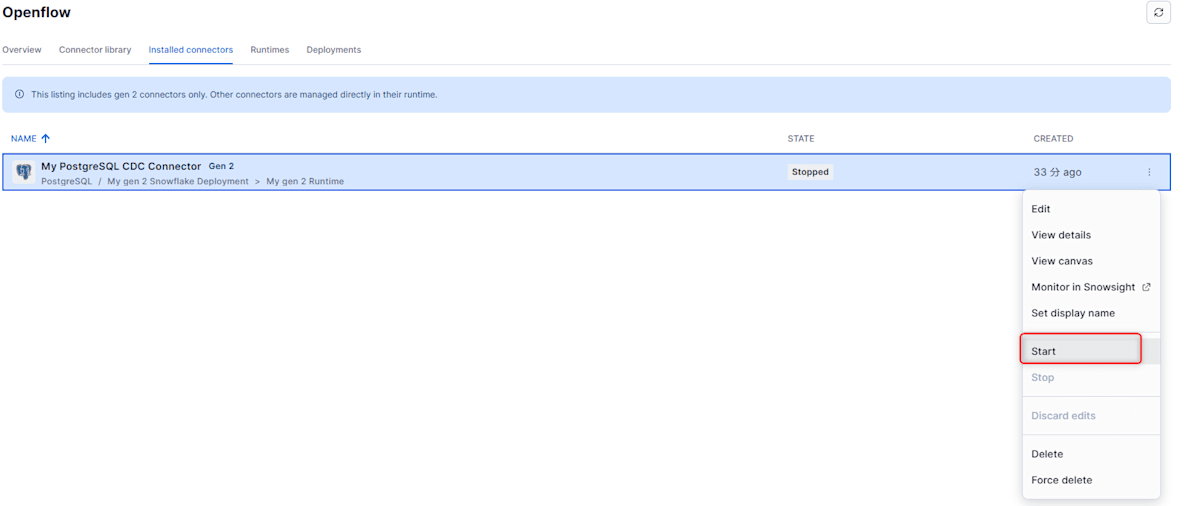
しばらくすると、データが取り込まれます。宛先のテーブルの件数を確認します。
USE ROLE yasuhara_openflow_admin;
USE WAREHOUSE yasuhara_openflow_wh;

SELECT 'customers' AS table_name, COUNT(*) AS cnt FROM yasuhara_pg_openflow_dest.sampledb_public.customers
UNION ALL
SELECT 'orders', COUNT(*) FROM yasuhara_pg_openflow_dest.sampledb_public.orders;
+------------+--------+
| TABLE_NAME |    CNT |
|------------+--------|
| customers  |  10000 |
| orders     | 100000 |
+------------+--------+
ソースの PostgreSQL 側と件数が一致しました。
変更が反映されることを確認
PostgreSQL 側で、INSERT・UPDATE・DELETE を実行して、Snowflake に反映されるか確認します。
-- INSERT
INSERT INTO public.customers (customer_id, name, email)
VALUES (10001, 'Customer 10001', 'user10001@example.com'),
       (10002, 'Customer 10002', 'user10002@example.com');
INSERT INTO public.orders (order_id, customer_id, amount, status)
VALUES (100001, 10001, 1234.50, 'pending'),
       (100002, 10002, 99.99,   'pending');

-- UPDATE
UPDATE public.orders    SET status = 'refunded' WHERE order_id = 102;
UPDATE public.orders    SET amount = 9999.00    WHERE order_id = 103;
UPDATE public.customers SET email = 'updated1@example.com' WHERE customer_id = 1;

-- DELETE
DELETE FROM public.orders WHERE order_id = 104;
1分ごとの同期設定としたので、すぐ Snowflake 側で確認すると INSERT と UPDATE はそのまま反映されました。
-- INSERT の反映確認
SELECT 'customers' AS table_name, COUNT(*) AS cnt FROM yasuhara_pg_openflow_dest.sampledb_public.customers
UNION ALL
SELECT 'orders', COUNT(*) FROM yasuhara_pg_openflow_dest.sampledb_public.orders;
+------------+--------+
| TABLE_NAME |    CNT |
|------------+--------|
| customers  |  10002 |
| orders     | 100002 |
+------------+--------+

-- UPDATE の反映確認
SELECT order_id, status, amount FROM yasuhara_pg_openflow_dest.sampledb_public.orders
WHERE order_id IN (102, 103, 104, 100001, 100002) ORDER BY order_id;
+----------+-----------+----------+
| ORDER_ID | STATUS    |   AMOUNT |
|----------+-----------+----------|
|      102 | refunded  | 14713.44 |
|      103 | delivered |  9999.00 |
|      104 | paid      | 10516.81 |
|   100001 | pending   |  1234.50 |
|   100002 | pending   |    99.99 |
+----------+-----------+----------+

SELECT customer_id, email FROM yasuhara_pg_openflow_dest.sampledb_public.customers
WHERE customer_id IN (1, 10001, 10002) ORDER BY customer_id;
+-------------+-----------------------+
| CUSTOMER_ID | EMAIL                 |
|-------------+-----------------------|
|           1 | updated1@example.com  |
|       10001 | user10001@example.com |
|       10002 | user10002@example.com |
+-------------+-----------------------+
ソース側の DELETE は、行が物理的に消えず、_SNOWFLAKE_DELETED列がTRUEになる論理削除として反映されます。
SELECT order_id, status, amount, _snowflake_deleted, _snowflake_updated_at
FROM yasuhara_pg_openflow_dest.sampledb_public.orders
WHERE order_id = 104;
+----------+--------+----------+--------------------+-------------------------+
| ORDER_ID | STATUS |   AMOUNT | _SNOWFLAKE_DELETED | _SNOWFLAKE_UPDATED_AT   |
|----------+--------+----------+--------------------+-------------------------|
|      104 | paid   | 10516.81 | True               | 2026-10-11 02:01:00.368 |
+----------+--------+----------+--------------------+-------------------------+
構成をファイルでコネクタ設定を変更してみる
初期設定はセットアップウィザードで行いました。この設定内容(config.json)を編集して変更してみます。
例として、MERGE の実行間隔(Merge Task Schedule CRON)を、1 分ごとから 5 分ごとに変更します。
まず、構成ファイル(config.json)の保存場所と書き方を確認します。
- 保存場所
- コネクタに紐づくステージの、バージョンごとのディレクトリ(
snow://openflow_connector/<DB>.<スキーマ>.<コネクタ>/versions/<バージョン>/config.json) - ウィザードで Apply すると、設定がコミット済みのバージョン(
version$1)として保存され、編集用のliveバージョンは空になる version$1には、config.jsonと、ウィザードでアップロードした JDBC ドライバー(postgresql-42.7.14.jar)が入っている
- コネクタに紐づくステージの、バージョンごとのディレクトリ(
- 書き方
configurationの配列に、ウィザードの画面に対応した区分(name。Source、Tuningなど)ごとに、propertiesが入っている- 値の書き方は、
valueTypeで決まるSTRING_LITERAL:"value": "文字列"SECRET_REFERENCE:"fullyQualifiedSecretName": "DB.スキーマ.シークレット名"ASSET_REFERENCE:"assetIds": ["postgresql-42.7.14.jar"](アップロードした jar のファイル名)
- パスワードの値は、
config.jsonに含まれない。シークレットの名前だけが入っている - ウィザードの項目名と、
config.jsonのキーは、一致しない場合がある(例:ウィザードで選んだ{database}_{schema}は、Destination Schema Strategyの値DATABASE_AND_SOURCE_SCHEMAとして入っている)
- 取得と更新
- 取得は
GET、更新はPUTで行える
- 取得は
Sourceの区分は、以下のようになっていました。
{
  "name": "Source",
  "properties": {
    "Source Database Connection URL": { "valueType": "STRING_LITERAL", "value": "jdbc:postgresql://<NLB の DNS 名>:5432/sampledb?sslmode=require" },
    "Source Database Driver": { "valueType": "ASSET_REFERENCE", "assetIds": ["postgresql-42.7.14.jar"] },
    "Source Database User": { "valueType": "STRING_LITERAL", "value": "openflow_repl" },
    "Source Database Password": { "valueType": "SECRET_REFERENCE", "fullyQualifiedSecretName": "YASUHARA_OPENFLOW_DB.OPENFLOW_SCHEMA.PG_PASSWORD" },
    "Source Database Publication Name": { "valueType": "STRING_LITERAL", "value": "snowflake_pub" }
  }
}
公式ドキュメントでは設定変更は以下の流れとされているので、こちらに沿って進めてみます。
- default のバージョンから、編集用の
liveバージョンを作成 liveのconfig.jsonを取得して編集- 編集したファイルを
liveに戻す COMMITして新しい default のバージョンにする
コネクタを停止
ここでは、コネクタを停止してから作業を行いました。Gen2 ではコネクタの管理も SQL から可能です。
-- コネクタを停止する
ALTER OPENFLOW CONNECTOR yasuhara_openflow_db.openflow_schema.my_postgres_connector STOP;
-- 確認
SELECT SYSTEM$WAIT_FOR_STABLE_OPENFLOW_CONNECTORS(600, 'yasuhara_openflow_db.openflow_schema.my_postgres_connector');
+---------------------------------------------------------------------------------------------------------------+
| SYSTEM$WAIT_FOR_STABLE_OPENFLOW_CONNECTORS(600, 'YASUHARA_OPENFLOW_DB.OPENFLOW_SCHEMA.MY_POSTGRES_CONNECTOR') |
|---------------------------------------------------------------------------------------------------------------|
| OK                                                                                                            |
+---------------------------------------------------------------------------------------------------------------+
Gen 2 のSTOPやCOMMIT、STARTは非同期で実行されます。SYSTEM$WAIT_FOR_STABLE_OPENFLOW_CONNECTORS関数は、状態が落ち着くまで待ち、成功すればOKを返します。タイムアウトや失敗ではエラーになります。
今回は試していませんが、CI/CD などの自動化時にも利用できます。
live バージョンの作成と取得
コミット済みのバージョン(version$1など)は、あとから書き換えられず、設定を変更するには現在の default をコピーして編集用のliveバージョンを作成します。
ALTER OPENFLOW CONNECTOR yasuhara_openflow_db.openflow_schema.my_postgres_connector ADD LIVE VERSION FROM LAST;
+------------------------------------+
| status                             |
|------------------------------------|
| Live version successfully created. |
+------------------------------------+
作成したliveバージョンのconfig.jsonを、ローカルに取得して編集します。
snow sql -c <接続名> -q "GET 'snow://openflow_connector/yasuhara_openflow_db.openflow_schema.my_postgres_connector/versions/live/config.json' 'file://<ローカルのディレクトリ>/';"
config.json の編集
現在のロード頻度はTuningのMerge Task Schedule CRONでした。
{
  "name": "Tuning",
  "properties": {
    "Concurrent Snapshot Queries": { "valueType": "STRING_LITERAL", "value": "2" },
    "Enable Advanced Configuration": { "valueType": "STRING_LITERAL", "value": "false" },
    "Merge Task Schedule CRON": { "valueType": "STRING_LITERAL", "value": "0 * * * * ?" }
  }
}
この値を以下の通り0 0/5 * * * ?(毎時 0 分から 5 分おき)に書き換えます。
{
  "name": "Tuning",
  "properties": {
    "Concurrent Snapshot Queries": { "valueType": "STRING_LITERAL", "value": "2" },
    "Enable Advanced Configuration": { "valueType": "STRING_LITERAL", "value": "false" },
    "Merge Task Schedule CRON": { "valueType": "STRING_LITERAL", "value": "0 0/5 * * * ?" }
  }
}
live への戻しと COMMIT
編集したファイルを、liveに PUT します。
snow sql -c <接続名> -q "PUT 'file://<ローカルのディレクトリ>/config.json' 'snow://openflow_connector/yasuhara_openflow_db.openflow_schema.my_postgres_connector/versions/live/' AUTO_COMPRESS = FALSE OVERWRITE = TRUE;"
PUT 後はCOMMITでliveを新しい default のバージョンにします。COMMITすると、liveが新しい default になり、liveは削除されます。
ALTER OPENFLOW CONNECTOR yasuhara_openflow_db.openflow_schema.my_postgres_connector COMMIT;
+--------------------------------------+
| status                               |
|--------------------------------------|
| Live version successfully committed. |
+--------------------------------------+

SELECT SYSTEM$WAIT_FOR_STABLE_OPENFLOW_CONNECTORS(600, 'yasuhara_openflow_db.openflow_schema.my_postgres_connector');
+---------------------------------------------------------------------------------------------------------------+
| SYSTEM$WAIT_FOR_STABLE_OPENFLOW_CONNECTORS(600, 'YASUHARA_OPENFLOW_DB.OPENFLOW_SCHEMA.MY_POSTGRES_CONNECTOR')
|
|---------------------------------------------------------------------------------------------------------------|
| OK                                                                                                            |
+---------------------------------------------------------------------------------------------------------------+
COMMIT後は新しいバージョンとして VERSION$2 が追加され、default(is_default が true)になっていました。
-- default が version$2 になり、live が消えている
SHOW VERSIONS IN OPENFLOW CONNECTOR yasuhara_openflow_db.openflow_schema.my_postgres_connector;
+-------------------------------+-----------+-------+----------------------------------------------------------------------------------------------------------+------------+---------+----------+---------+---------+---------------------+-----------------+
| created_on                    | name      | alias | location_uri                                                                                             | is_default | is_live | is_first | is_last | comment | source_location_uri | git_commit_hash |
|-------------------------------+-----------+-------+----------------------------------------------------------------------------------------------------------+------------+---------+----------+---------+---------+---------------------+-----------------|
| 2026-10-16 11:29:23.558 +0900 | VERSION$2 | NULL  | snow://openflow_connector/YASUHARA_OPENFLOW_DB.OPENFLOW_SCHEMA.MY_POSTGRES_CONNECTOR/versions/version$2/ | true       | false   | false    | true    | NULL    | NULL                | NULL            |
| 2026-10-11 10:25:12.999 +0900 | VERSION$1 | NULL  | snow://openflow_connector/YASUHARA_OPENFLOW_DB.OPENFLOW_SCHEMA.MY_POSTGRES_CONNECTOR/versions/version$1/ | false      | false   | true     | false   | NULL    | NULL                | NULL            |
+-------------------------------+-----------+-------+----------------------------------------------------------------------------------------------------------+------------+---------+----------+---------+---------+---------------------+-----------------+
確認ができたので、コネクタを起動します。
ALTER OPENFLOW CONNECTOR yasuhara_openflow_db.openflow_schema.my_postgres_connector START;
SELECT SYSTEM$WAIT_FOR_STABLE_OPENFLOW_CONNECTORS(600, 'yasuhara_openflow_db.openflow_schema.my_postgres_connector');
反映の確認
PostgreSQL で、注文 102 の金額を、1 分ごとに更新し続けます。
UPDATE public.orders SET amount = amount + 1 WHERE order_id = 102;
\watch 60
しばらくした後、ウェアハウス側の MERGE 履歴を確認すると、5 分ごとに実行されていました。
-- 宛先テーブル:_SNOWFLAKE_UPDATED_AT も、MERGE の開始時刻と同じ時刻
>SELECT order_id, amount, _SNOWFLAKE_UPDATED_AT
FROM YASUHARA_PG_OPENFLOW_DEST.SAMPLEDB_PUBLIC.ORDERS
WHERE order_id = 102;
+----------+----------+-------------------------+
| ORDER_ID |   AMOUNT | _SNOWFLAKE_UPDATED_AT   |
|----------+----------+-------------------------|
|      102 | 14717.44 | 2026-10-16 05:10:01.389 |
+----------+----------+-------------------------+

>SELECT order_id, amount, _SNOWFLAKE_UPDATED_AT
FROM YASUHARA_PG_OPENFLOW_DEST.SAMPLEDB_PUBLIC.ORDERS
WHERE order_id = 102;

+----------+----------+-------------------------+
| ORDER_ID |   AMOUNT | _SNOWFLAKE_UPDATED_AT   |
|----------+----------+-------------------------|
|      102 | 14722.44 | 2026-10-16 05:15:01.055 |
+----------+----------+-------------------------+

>SELECT order_id, amount, _SNOWFLAKE_UPDATED_AT
FROM YASUHARA_PG_OPENFLOW_DEST.SAMPLEDB_PUBLIC.ORDERS
WHERE order_id = 102;

+----------+----------+-------------------------+
| ORDER_ID |   AMOUNT | _SNOWFLAKE_UPDATED_AT   |
|----------+----------+-------------------------|
|      102 | 14727.44 | 2026-10-16 05:20:00.341 |
+----------+----------+-------------------------+

-- マージの実行履歴
> SELECT START_TIME, EXECUTION_STATUS, TOTAL_ELAPSED_TIME
FROM TABLE(snowflake.information_schema.query_history_by_warehouse(
  WAREHOUSE_NAME=>'YASUHARA_OPENFLOW_WH',
  END_TIME_RANGE_START=>DATEADD(minute,-30,CURRENT_TIMESTAMP()), RESULT_LIMIT=>500))
WHERE QUERY_TYPE='MERGE' ORDER BY START_TIME;
+-------------------------------+------------------+--------------------+
| START_TIME                    | EXECUTION_STATUS | TOTAL_ELAPSED_TIME |
|-------------------------------+------------------+--------------------|
| 2026-10-16 14:10:01.389 +0900 | SUCCESS          |               2927 |
| 2026-10-16 14:15:01.055 +0900 | SUCCESS          |               3655 |
| 2026-10-16 14:20:00.341 +0900 | SUCCESS          |               3217 |
+-------------------------------+------------------+--------------------+
さいごに
Gen 2 の Snowflake Deployment 上で PostgreSQL の CDC を SQL とセットアップウィザードで構築しconfig.jsonを編集して設定を変更するところまで試しました。Git 連携も試せればと思いました。
こちらの内容が何かの参考になれば幸いです。