Amazon Personalizeで映画の視聴履歴からグッズを推薦し、効果測定まで試してみた

はじめに
クラウド事業統括本部の浅野です。
ECサイトを運営していると、ユーザーの好みや傾向は、そのサイトの中だけでなく、同じユーザーが使っている別のサービスでの行動にも表れていることがあります。そうしたデータもレコメンドに活用できるとよさそうですが、多くのレコメンドの仕組みは1つのサイト内の行動データをもとにしているため、同じ運営元のサービスであっても、別のサービスでの行動を使ってECサイトの商品をレコメンドしようとすると、サイト間でデータをどう持たせて連携するかといったところから考える必要があり、なかなか大変です。
Amazon Personalizeは、行動ログやアイテムの属性データを用意して渡すことで、機械学習を使ったレコメンドができるサービスなので、こうした課題にどこまで対応できるのか、実際に試してみることにしました。今回は、映画のレビューサービスとグッズを販売するECサイトを想定して、ユーザーがこれまでにどんな映画を評価してきたかをもとに、ECサイトのグッズをレコメンドできるかを検証しました。
また、Amazon Personalizeを使うのは今回が初めてだったのですが、データをどんな形で渡せばよいのか、日々のデータ更新やレコメンドの配信をどう進めるのか、さらに、そのレコメンドが実際に購入につながったかをどう測るのかなどの運用観点まで踏まえて本記事でまとめます。
検証したいこと
カタログ横断のレコメンド
映画とグッズのように種類の違うアイテムを、同じユーザーの行動として1つのモデルに学習させたときにどうなるかを確かめました。
- 映画の行動しかないユーザーに、グッズをレコメンドできるか
- レコメンドアルゴリズムは、映画の好みをグッズのレコメンドにどう反映するか
運用に乗せる観点で確かめたこと
構築して終わりではなく、実際に運用に活かす上で以下のポイントを意識して検証しました。
- 配信と鮮度: 日次のバッチ推論で全ユーザー分のレコメンドを作って配信する場合、結果は次のジョブまで固定されます。リアルタイム推論ならどれくらい変わるか。また、バッチ推論で配信するとき、新しい行動はいつレコメンドに効くか
- 効果測定: レコメンドを見たユーザーのクリック・購入を「どのレコメンドから来たか」付きで集計できるか
- 集計結果の保存: 集計の材料をAmazon S3に長期間残し、CTR(クリック率)やCVR(購入率)を分析できるか
Amazon Personalizeの全体像
構成要素の関係
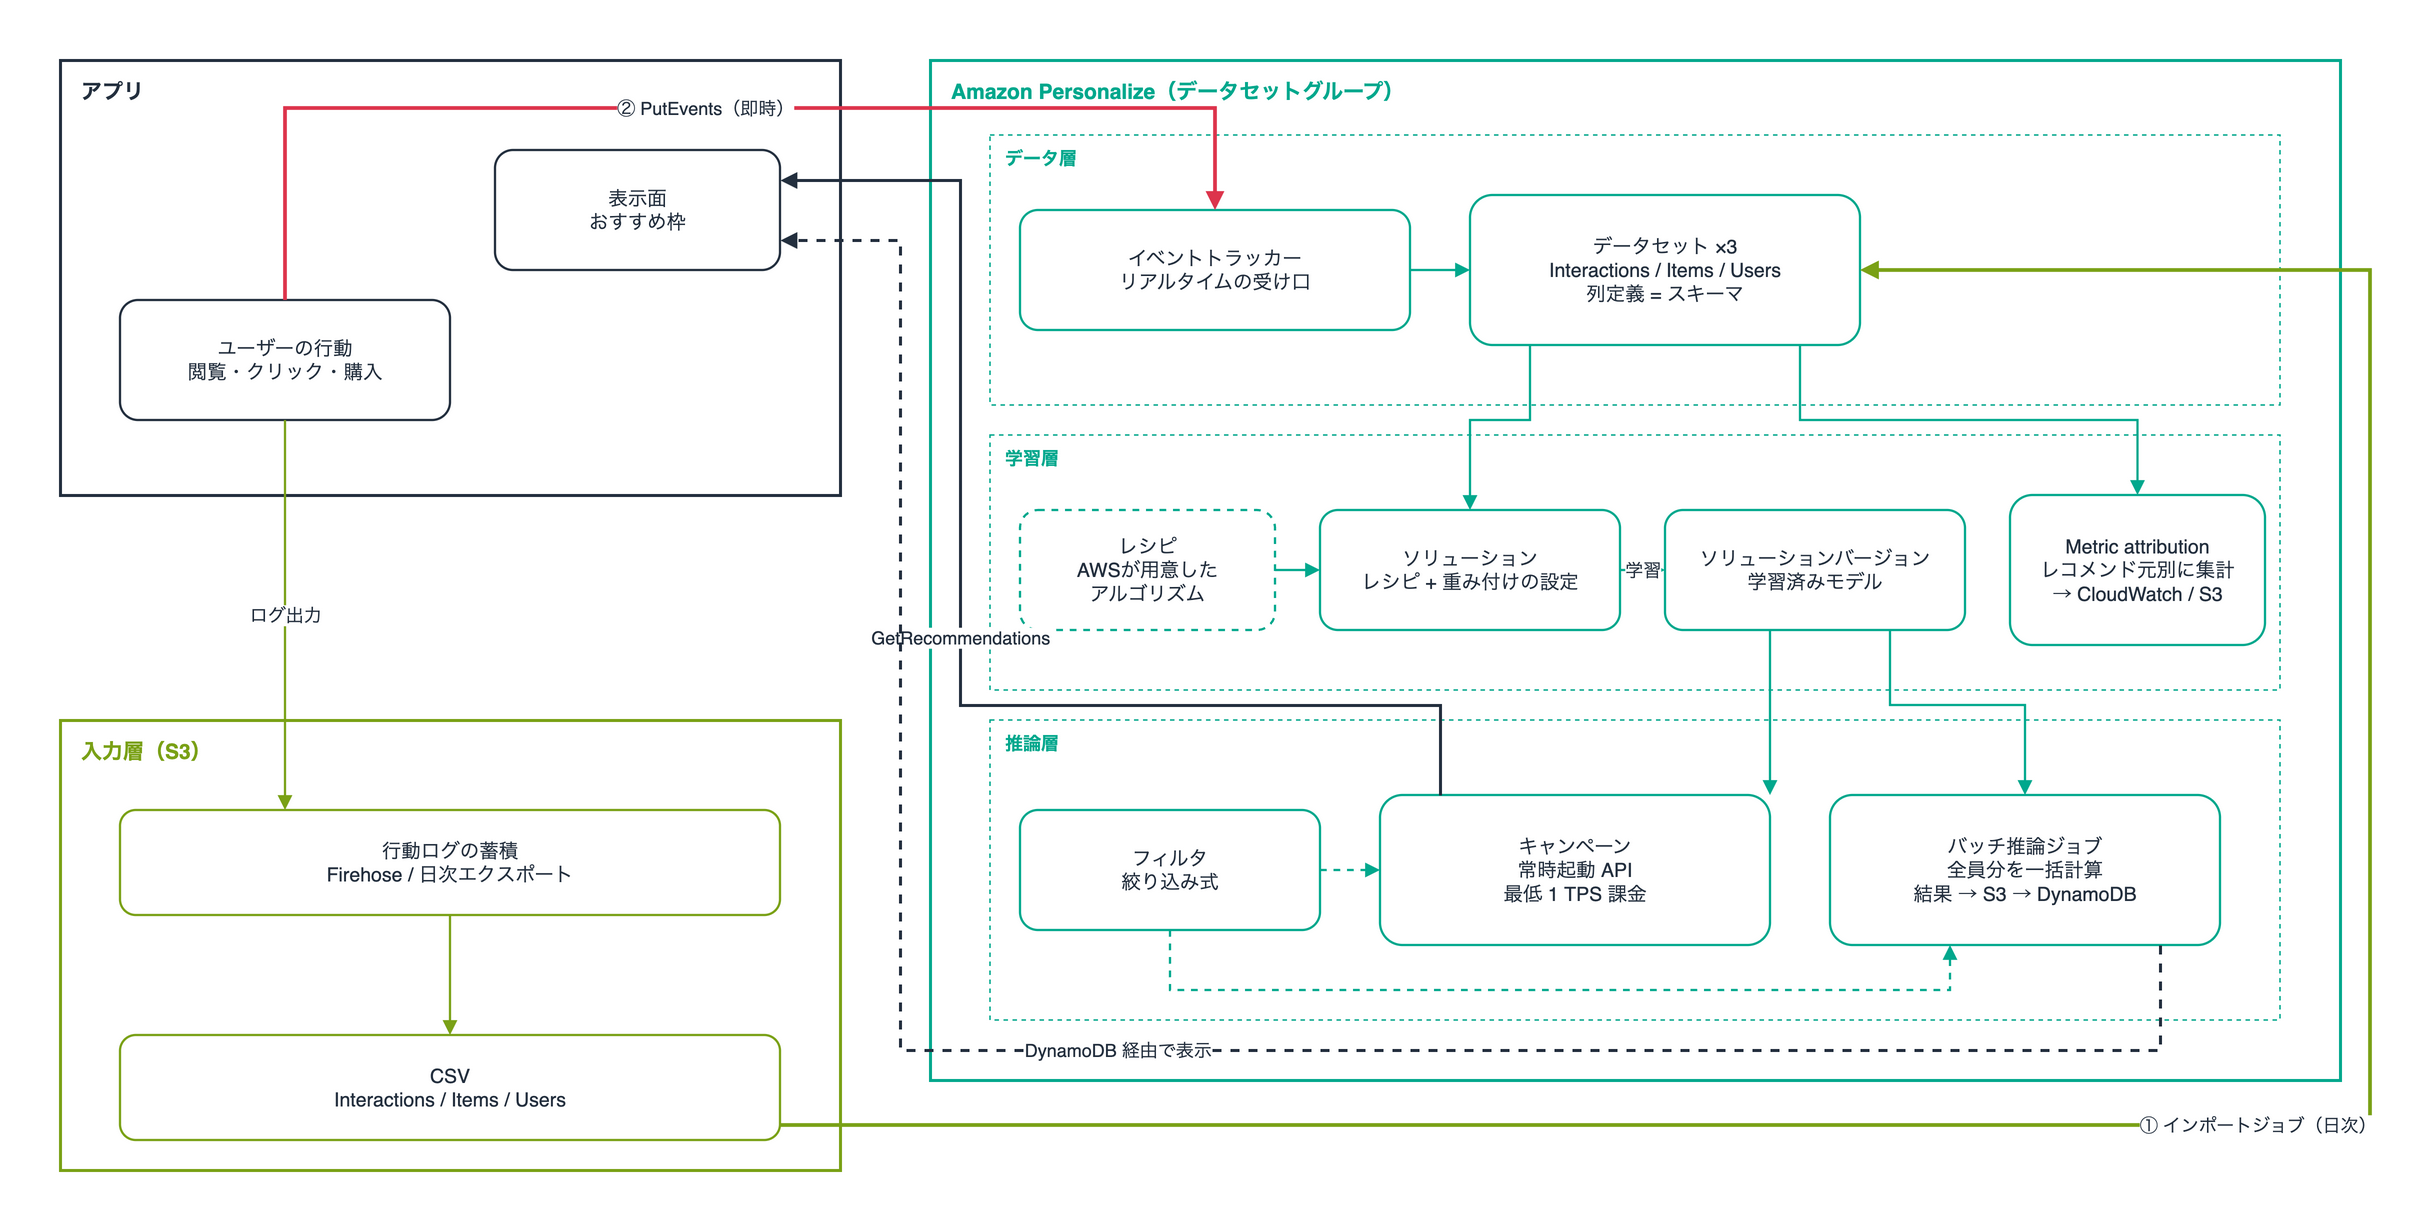
Amazon Personalizeは、大きく分けると「データを入れる」「学習する」「レコメンドを取り出す」の3段階で動きます。全体像を図にすると次のようになります。
図の右側がAmazon Personalizeの中身で、上から「データ層」「学習層」「推論層」の3層に分かれています。左側はアプリと、データを置いておくS3(入力層)です。
| 用語 | 役割 |
|---|---|
| データセットグループ | 1つのレコメンドプロジェクトの箱。箱同士でデータは共有されない |
| データセット | 学習に使うデータの入れ物 |
| イベントトラッカー | アプリから行動を1件ずつ送る受け口 |
| レシピ | AWSが用意したレコメンドのアルゴリズム。目的ごとに1つ選ぶ |
| ソリューション | どのレシピで、どう学習するかの設定 |
| ソリューションバージョン | 学習してできたモデル。学習のたびに増える |
| キャンペーン | モデルを常時起動のAPIにしたもの |
| バッチ推論ジョブ | 全ユーザー分のレコメンドをまとめて計算し、S3に出力するジョブ |
| フィルタ | レコメンドから条件に合うものだけを残す(または除く)式 |
| Metric attribution | レコメンドをきっかけに起きた行動を、レコメンド元ごとに数える集計ルール |
データ層
データセットグループという箱の中に、データセット(行動ログや商品マスタ)を入れます。データの入れ方は2通りあります。
- これまでに蓄積したデータ(行動ログ、商品マスタ、ユーザーマスタ)は、S3に置いたCSVからまとめて取り込む(図の①)
- 運用中に新しく発生する行動(閲覧、購入など)は、アプリからイベントトラッカーに1件ずつ送る(図の②)
どちらで入れても、最終的には同じデータセットに貯まります。
学習層
ソリューションに「どのレシピで、どう学習するか」を設定し、学習を実行するとソリューションバージョン(学習済みのモデル)ができます。混乱しやすいのは、この2つの関係です。
- ソリューションは「学習のさせ方」の設定で、一度作れば使い続ける
- ソリューションバージョンは、その設定で学習したモデル。学習のたびに増える
- 新しいデータを入れても、モデルは自動では変わらない。反映するには再学習する(定期的に自動で学習させる設定もある)
推論層
できたモデルから、キャンペーン(常時起動のAPI)かバッチ推論ジョブ(まとめて計算してS3に出力)でレコメンドを取り出します。どちらも、どのソリューションバージョンを使うかを指定して動きます。キャンペーンは最新のバージョンに自動で切り替える設定にもできます。
フィルタを使うと、「グッズだけを出す」「購入済みのものを除く」といった出し分けを、モデルを作り直さずに切り替えられます。
アプリは、キャンペーンのAPIを直接呼ぶか、バッチ推論の結果を読んでレコメンドを表示します。バッチ推論の結果はS3にファイルで出力されるので、アプリからユーザーIDで引けるようにDBへ入れ直して使います。図では今回の検証で使ったAmazon DynamoDBを書いていますが、入れ直す先はRDSやAuroraなど、ほかのDBでも構いません。
日々の運用の流れ
日々の運用では、「データを入れる → 必要なタイミングで学習してバージョンを更新する → そのバージョンでレコメンドを取り出す」を繰り返していくことになります。
イベントトラッカーで送った直近の行動は、再学習しなくてもリアルタイム推論の結果に数秒〜数分で反映されます。モデルそのものは学習した時点のままですが、レコメンドを計算するときにそのユーザーの直近の行動を加味してくれます。
用意するデータ
Amazon Personalizeは「誰が何に反応したか」の履歴から好みを学習するサービスです。そのため、入れるデータの種類があらかじめ決められています。中心になるのは次の3つです。
| データセット | 1行が表すもの | 必須列 | 必須かどうか |
|---|---|---|---|
| Interactions | 誰が・何に・いつ・何をしたか(閲覧、購入など) | USER_ID, ITEM_ID, TIMESTAMP | 必須。これだけでも学習できる |
| Items | アイテム1件の属性(カテゴリ、価格、説明文など) | ITEM_ID | 任意。入れると新商品にも対応でき、フィルタにも使える |
| Users | ユーザー1人の属性(会員種別など) | USER_ID | 任意 |
このほかに、Actions / Action interactionsというデータセットもあります。これは商品ではなく「ユーザーに次に促したい行動」(会員登録、クーポン利用など)をすすめるという別用途のレシピ専用で、商品のレコメンドには適していませんので、今回は使用しませんでした。
データセットの種類を増やすことはできず、1つのデータセットグループに各1つしか作れません。その代わり、列は自由に設計できます(Itemsは最大100列)。「映画とグッズ」のような違いは、表を分けるのではなく列で表現します。
データの入れ方は2通りある
データセットへのデータの入れ方は、S3に置いたCSVをまとめて取り込む方法(バルクインポート)と、APIで1件ずつ送る方法の2通りあります。APIの場合、閲覧や購入のような行動ログはイベントトラッカー経由でPutEvents APIを使って送り、商品やユーザーの情報はPutItems / PutUsers APIで送ります。どちらで入れても同じデータセットに貯まりますが、入れられる単位、レコメンドに反映されるまでの時間、「どのレコメンドから来たか」のラベルの付け方が違います。行動ログの場合で比べると次のとおりです。
| S3のCSVをインポート | イベントトラッカー(PutEvents) | |
|---|---|---|
| 入れる単位 | ファイル単位。差分の取り込みでも1ファイル1,000件以上が必要 | 1回のAPI呼び出しで最大10件 |
| 反映までの時間 | インポートジョブの完了まで数分〜十数分 | 送った直後 |
| レコメンドへの反映 | 再学習して新しいモデルを作るまで反映されない | リアルタイム推論では、再学習しなくても数秒〜数分で反映される |
| レコメンド元のラベル | スキーマにEVENT_ATTRIBUTION_SOURCE列を足し、CSVに書いておく |
送るときに、行動1件ごとにラベルを付ける |
| 向いている用途 | これまでに蓄積したデータの初回投入と、1日1回などまとめて取り込めば足りる行動 | 起きた直後からレコメンドに効かせたい行動 |
どちらを使うかは、レコメンドの配信方式で決まります。リアルタイム推論で配信するなら、直後の行動をレコメンドに効かせるために、運用中に新しく発生する行動はPutEventsで送ります。バッチ推論だけで配信するなら、新しく発生した行動も1日1回CSVにまとめて増分インポートし、再学習してからバッチ推論を実行すれば足ります。この場合はイベントトラッカーを作らずに済みます。
レコメンドの取り出し方
学習したモデルからレコメンドを取り出す方法は2つです。どちらも同じモデルを使い、違いは「いつ計算するか」です。
| リアルタイム推論(キャンペーン) | バッチ推論 | |
|---|---|---|
| 仕組み | アプリが聞いたその場で、ユーザーIDを渡して計算する | 夜間などに、ユーザーIDの一覧を渡して全員分を計算しS3に出す |
| 鮮度 | リクエストのたびに計算するので、数秒〜数分前の行動まで反映できる | ジョブを実行した時点の結果で固定され、次のジョブまで変わらない(日次なら最大1日前の状態)。今回は1ジョブの実行に約12〜54分かかった |
| 費用 | リクエストがなくても最低1TPS分が毎時かかる | 入力したユーザー数分だけかかる |
やってみた
リージョンは東京(ap-northeast-1)です。日次で全員分を作る運用はコストを読みやすいため、バッチ推論を本命にし、リアルタイム推論は比較として試しました。
全体像の中から次のコンポーネントを使い、レコメンドを出して効果を測るところまでを通しています。
- データセットグループを1つ作り、映画とグッズのデータを同じデータセットに入れる
- ソリューションを3つ作り、それぞれ学習してソリューションバージョン(モデル)を作る
- フィルタで、レコメンドに出すアイテムをグッズだけなどに絞る
- バッチ推論ジョブで全ユーザー分のレコメンドを作り、DynamoDBに入れて配信する(比較としてキャンペーンでのリアルタイム推論も試す)
- レコメンドを見たユーザーの行動を、イベントトラッカー経由とS3のCSVインポートの両方で入れ、Metric attributionでレコメンド元ごとに集計する
- 集計の材料をS3に残し、Amazon AthenaでCTRやCVRを計算する
アプリ側は実在しないので、配信とユーザーの行動はスクリプトで模擬しました。
検証に使ったS3バケット、IAMロール、DynamoDB、AthenaワークグループはTerraformで作り、Amazon PersonalizeのリソースはすべてAWS CLIで作成しました。
Terraformのコード
data "aws_caller_identity" "current" {}

locals {
  bucket_name = "${var.name_prefix}-${data.aws_caller_identity.current.account_id}-${var.region}"
}

# 入出力・ログ・集計 CSV・Athena 結果をすべて置く検証用バケット
resource "aws_s3_bucket" "main" {
  bucket = local.bucket_name
}

resource "aws_s3_bucket_public_access_block" "main" {
  bucket                  = aws_s3_bucket.main.id
  block_public_acls       = true
  block_public_policy     = true
  ignore_public_acls      = true
  restrict_public_buckets = true
}

resource "aws_s3_bucket_server_side_encryption_configuration" "main" {
  bucket = aws_s3_bucket.main.id
  rule {
    apply_server_side_encryption_by_default {
      sse_algorithm = "AES256"
    }
  }
}

# Personalize サービスプリンシパルがバケットを読み書きするためのバケットポリシー
# (データセットインポートの読み取り、バッチ推論・Metric attribution レポートの書き込み)
data "aws_iam_policy_document" "bucket_policy" {
  statement {
    sid    = "PersonalizeAccess"
    effect = "Allow"
    principals {
      type        = "Service"
      identifiers = ["personalize.amazonaws.com"]
    }
    actions   = ["s3:GetObject", "s3:ListBucket", "s3:PutObject"]
    resources = [aws_s3_bucket.main.arn, "${aws_s3_bucket.main.arn}/*"]
  }
}

resource "aws_s3_bucket_policy" "main" {
  bucket = aws_s3_bucket.main.id
  policy = data.aws_iam_policy_document.bucket_policy.json
}

# Personalize のサービスロール
data "aws_iam_policy_document" "personalize_assume" {
  statement {
    effect  = "Allow"
    actions = ["sts:AssumeRole"]
    principals {
      type        = "Service"
      identifiers = ["personalize.amazonaws.com"]
    }
  }
}

resource "aws_iam_role" "personalize" {
  name               = "${var.name_prefix}-personalize-role"
  assume_role_policy = data.aws_iam_policy_document.personalize_assume.json
}

data "aws_iam_policy_document" "personalize_role" {
  statement {
    sid       = "S3Access"
    effect    = "Allow"
    actions   = ["s3:GetObject", "s3:ListBucket", "s3:PutObject"]
    resources = [aws_s3_bucket.main.arn, "${aws_s3_bucket.main.arn}/*"]
  }
  statement {
    sid       = "CloudWatchMetricAttribution"
    effect    = "Allow"
    actions   = ["cloudwatch:PutMetricData"]
    resources = ["*"]
  }
}

resource "aws_iam_role_policy" "personalize" {
  name   = "${var.name_prefix}-personalize-policy"
  role   = aws_iam_role.personalize.id
  policy = data.aws_iam_policy_document.personalize_role.json
}

# バッチ結果を置く DynamoDB テーブル(オンデマンド)
resource "aws_dynamodb_table" "recommendations" {
  name         = "${var.name_prefix}-recommendations"
  billing_mode = "PAY_PER_REQUEST"
  hash_key     = "user_id"
  range_key    = "source"

  attribute {
    name = "user_id"
    type = "S"
  }
  attribute {
    name = "source"
    type = "S"
  }
}

# 評価クエリ用 Athena ワークグループ
resource "aws_athena_workgroup" "main" {
  name = var.name_prefix
  configuration {
    result_configuration {
      output_location = "s3://${aws_s3_bucket.main.bucket}/athena-results/"
    }
  }
  force_destroy = true # ワークグループ削除時に名前付きクエリも消す(データは S3 側に残る)
}
1. 検証データを用意する
実データの代わりに、公開データセットのMovieLensのうち、小規模版のデータ(610人のユーザーが映画に付けた約10万件の評価)を使い、映画レビューサービスの行動ログに見立てています。
MovieLensにはグッズがないため、スクリプトで映画ごとのグッズと、その閲覧・購入行動を合成して足しました。
- グッズ: 評価が5件以上ある映画に0〜3点(アクリルスタンド、Tシャツ、ポスターなど)
- グッズの行動: ユーザーの30%に、★4以上を付けた映画のグッズを「閲覧 → カート → 購入」した履歴を付ける
グッズの行動を持たせたのはユーザーの30%だけで、残り70%は映画の行動しかありません。この70%のユーザーにもグッズをレコメンドできるかどうか注目して検証を進めます。
generate_goods.py
"""MovieLens ml-latest-small から Personalize 用の CSV を生成する。

- 映画(mv_<movieId>)とグッズ(gd_<n>)を同じ Items に入れる
- 全ユーザーの評価を rate イベントにし、30% のユーザー(cross セグメント)には
  高評価作品のグッズに対する product_view / add_to_cart / purchase を合成する
- 残り 70%(movie_only セグメント)は映画の行動のみ。カタログ横断検証の対象
"""
import csv
import random
import re
from collections import defaultdict
from pathlib import Path

random.seed(42)

RAW = Path(__file__).parent / "raw" / "ml-latest-small"
OUT = Path(__file__).parent / "generated"
OUT.mkdir(exist_ok=True)

GOODS_TYPES = [
    ("アクリルスタンド", 1800),
    ("Tシャツ", 3500),
    ("ポスター", 2200),
    ("ステッカー", 600),
    ("マグカップ", 1500),
]
CROSS_RATIO = 0.30
MAX_GOODS_PER_MOVIE = 3
MIN_RATINGS_FOR_GOODS = 5
MAX_PURCHASE_CANDIDATES = 20
P_ADD_TO_CART = 0.6
P_PURCHASE = 0.35
DAY = 86400

def year_of(title: str) -> int | None:
    m = re.search(r"\((\d{4})\)\s*$", title)
    return int(m.group(1)) if m else None

def year_to_epoch(year: int) -> int:
    import datetime as dt
    return int(dt.datetime(year, 1, 1, tzinfo=dt.timezone.utc).timestamp())

movies = {}
with open(RAW / "movies.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        movies[row["movieId"]] = {
            "title": row["title"],
            "genres": row["genres"].replace("(no genres listed)", "Unknown"),
        }

ratings = []
first_ts = {}
count = defaultdict(int)
with open(RAW / "ratings.csv", newline="", encoding="utf-8") as f:
    for row in csv.DictReader(f):
        ts = int(row["timestamp"])
        ratings.append((row["userId"], row["movieId"], float(row["rating"]), ts))
        count[row["movieId"]] += 1
        first_ts[row["movieId"]] = min(first_ts.get(row["movieId"], ts), ts)

# ---- Items: 映画
items = []
for mid, m in movies.items():
    y = year_of(m["title"])
    created = year_to_epoch(y) if y else first_ts.get(mid, min(first_ts.values()))
    items.append({
        "ITEM_ID": f"mv_{mid}",
        "ITEM_TYPE": "movie",
        "GENRES": m["genres"],
        "WORK_ID": mid,
        "PRICE": "",
        "DESCRIPTION": f"{m['title']}。ジャンル: {m['genres'].replace('|', '、')}。",
        "CREATION_TIMESTAMP": created,
    })

# ---- Items: グッズ(評価が一定数ある作品に 0〜3 点)
goods_by_movie = defaultdict(list)
gid = 0
for mid, m in movies.items():
    if count[mid] < MIN_RATINGS_FOR_GOODS:
        continue
    n = random.randint(0, MAX_GOODS_PER_MOVIE)
    for gtype, base_price in random.sample(GOODS_TYPES, n):
        gid += 1
        item_id = f"gd_{gid}"
        price = float(base_price + random.choice([0, 100, 200, 300, 500]))
        created = first_ts[mid] + random.randint(30, 365) * DAY
        items.append({
            "ITEM_ID": item_id,
            "ITEM_TYPE": "goods",
            "GENRES": m["genres"],
            "WORK_ID": mid,
            "PRICE": price,
            "DESCRIPTION": f"{m['title']} の{gtype}。ジャンル: {m['genres'].replace('|', '、')}。",
            "CREATION_TIMESTAMP": created,
        })
        goods_by_movie[mid].append((item_id, price, created))

# ---- Users
user_ids = sorted({r[0] for r in ratings}, key=int)
cross_users = set(random.sample(user_ids, int(len(user_ids) * CROSS_RATIO)))
users = [{"USER_ID": u, "SEGMENT": "cross" if u in cross_users else "movie_only"} for u in user_ids]

# ---- Interactions: 映画の評価
interactions = []
for uid, mid, rating, ts in ratings:
    interactions.append({
        "USER_ID": uid, "ITEM_ID": f"mv_{mid}", "TIMESTAMP": ts,
        "EVENT_TYPE": "rate", "EVENT_VALUE": rating,
    })

# ---- Interactions: グッズ行動(cross ユーザーの高評価作品に紐づくグッズ)
by_user = defaultdict(list)
for uid, mid, rating, ts in ratings:
    if uid in cross_users and rating >= 4.0 and goods_by_movie.get(mid):
        by_user[uid].append((mid, ts))

n_view = n_cart = n_purchase = 0
for uid, cands in by_user.items():
    random.shuffle(cands)
    for mid, ts in cands[:MAX_PURCHASE_CANDIDATES]:
        item_id, price, created = random.choice(goods_by_movie[mid])
        t = max(ts, created) + random.randint(1, 60) * DAY
        interactions.append({"USER_ID": uid, "ITEM_ID": item_id, "TIMESTAMP": t,
                             "EVENT_TYPE": "product_view", "EVENT_VALUE": ""})
        n_view += 1
        if random.random() < P_ADD_TO_CART:
            t += random.randint(60, 3600)
            interactions.append({"USER_ID": uid, "ITEM_ID": item_id, "TIMESTAMP": t,
                                 "EVENT_TYPE": "add_to_cart", "EVENT_VALUE": ""})
            n_cart += 1
            if random.random() < P_PURCHASE / P_ADD_TO_CART:
                t += random.randint(60, 3600)
                interactions.append({"USER_ID": uid, "ITEM_ID": item_id, "TIMESTAMP": t,
                                     "EVENT_TYPE": "purchase", "EVENT_VALUE": price})
                n_purchase += 1

interactions.sort(key=lambda r: r["TIMESTAMP"])

def write(name, rows, fields):
    with open(OUT / name, "w", newline="", encoding="utf-8") as f:
        w = csv.DictWriter(f, fieldnames=fields)
        w.writeheader()
        w.writerows(rows)

write("items.csv", items, ["ITEM_ID", "ITEM_TYPE", "GENRES", "WORK_ID", "PRICE", "DESCRIPTION", "CREATION_TIMESTAMP"])
write("users.csv", users, ["USER_ID", "SEGMENT"])
write("interactions.csv", interactions, ["USER_ID", "ITEM_ID", "TIMESTAMP", "EVENT_TYPE", "EVENT_VALUE"])

n_movies = sum(1 for i in items if i["ITEM_TYPE"] == "movie")
n_goods = len(items) - n_movies
print(f"items: {len(items)} (movie {n_movies}, goods {n_goods})")
print(f"users: {len(users)} (cross {len(cross_users)}, movie_only {len(users) - len(cross_users)})")
print(f"interactions: {len(interactions)} (rate {len(ratings)}, product_view {n_view}, add_to_cart {n_cart}, purchase {n_purchase})")
作ったデータの件数は次のとおりです。
| データ | 内訳 | 件数 |
|---|---|---|
| Interactions(107,026件) | rate(映画の評価) | 100,836件 |
| product_view(グッズの閲覧) | 3,173件 | |
| add_to_cart(グッズをカートに追加) | 1,891件 | |
| purchase(グッズの購入) | 1,126件 | |
| Items(15,228件) | 映画 | 9,742件 |
| グッズ | 5,486件 | |
| Users(610人) | 映画とグッズの両方の行動がある | 183人 |
| 映画の行動しかない | 427人 |
映画とグッズは同じItemsに入れ、ITEM_TYPE列(movie / goods)で区別しています。グッズには元になった映画のIDをWORK_IDとして持たせ、「この作品のグッズ」を後から取り出せるようにしました。
実際のデータの一例です。ユーザー35が映画「Quiz Show」を★4で評価し、その後Quiz Showのポスターを閲覧 → カート → 購入した、という流れが3つのデータにまたがって入っています。
Interactions(行動ログ)
| USER_ID | ITEM_ID | TIMESTAMP | EVENT_TYPE | EVENT_VALUE |
|---|---|---|---|---|
| 35 | mv_300 | 830939505 | rate | 4.0 |
| 35 | gd_278 | 835641416 | product_view | (空) |
| 35 | gd_278 | 835644556 | add_to_cart | (空) |
| 35 | gd_278 | 835646812 | purchase | 2200.0 |
Items(アイテムマスタ)
| ITEM_ID | ITEM_TYPE | GENRES | WORK_ID | PRICE | DESCRIPTION |
|---|---|---|---|---|---|
| mv_300 | movie | Drama | 300 | (空) | Quiz Show (1994)。ジャンル: Drama。 |
| gd_278 | goods | Drama | 300 | 2200.0 | Quiz Show (1994) のポスター。ジャンル: Drama。 |
Users(ユーザーマスタ)
| USER_ID | SEGMENT |
|---|---|
| 35 | cross(映画とグッズの両方の行動あり) |
| 3 | movie_only(映画の行動のみ) |
映画の評価もグッズの購入も、同じユーザーID・同じInteractionsに時系列で並んでいるのがポイントです。SEGMENTは、映画とグッズの両方の行動があるユーザー(cross)か、映画の行動しかないユーザー(movie_only)かを表す列です。この列を付けた理由は2つです。
- 後から「映画の行動しかないユーザーにも、グッズがレコメンドされているか」を、区分ごとに集計して確かめるため
- 学習の手がかりにするため。両方の行動があるユーザーと映画の行動しかないユーザーでは、行動の量も中身も違います。この区分をユーザーの属性としてモデルに渡しておけば、モデルは「同じ区分のユーザー同士は傾向が似ている」という情報も使えます。映画の行動しかないユーザーのレコメンドを作るときに、同じく映画の行動しかないユーザーの傾向も参考にできるようにする意図です
また、映画とグッズは1つのデータセットグループに一緒に入れる必要があります。データセットグループ同士はデータを共有しないため、別々に分けると映画の好みからグッズをレコメンドできません。さらに、Itemsの列の定義は1つのデータセットグループに1つしか持てないため、映画とグッズのように種類の違うアイテムも同じItemsに入れ、ITEM_TYPEのような列で種類を分けて扱います。
次に、スキーマを書きます。スキーマは、CSVの各列が何の値か(文字列か数値かなど)をAmazon Personalizeに伝える定義で、Avro形式(JSONで記述)で書きます。
自分で追加した文字列の列は、スキーマで次の設定をするかどうかで扱いが変わります。
"categorical": trueを設定した列: カテゴリとして学習に使われる(ジャンル、アイテムの種類など)"textual": trueを設定した列: 文章として学習に使われる(商品の説明文など)- どちらも設定しない列: 学習には使われず、フィルタの条件や結果の表示にだけ使える
どの列を学習に使うかは、スキーマを書く前に整理しておく必要があります。目安は次のとおりです。
| 設定 | 設定する列の目安 | 例 |
|---|---|---|
categorical |
取りうる値が限られていて、同じ値を持つアイテム同士に好みの共通点がありそうな列 | ジャンル、商品カテゴリ、ブランド、アイテムの種類 |
textual |
文章の中身から好みの手がかりが得られる列 | 商品説明、あらすじ |
| 設定しない | 値がアイテムごとにほぼばらばらで共通点にならない列や、絞り込みにだけ使いたい列 | 作品ID、在庫の有無 |
{
  "type": "record",
  "name": "Items",
  "namespace": "com.amazonaws.personalize.schema",
  "fields": [
    { "name": "ITEM_ID", "type": "string" },
    { "name": "ITEM_TYPE", "type": "string", "categorical": true },
    { "name": "GENRES", "type": "string", "categorical": true },
    { "name": "WORK_ID", "type": "string" },
    { "name": "PRICE", "type": ["null", "float"] },
    { "name": "DESCRIPTION", "type": ["null", "string"], "textual": true },
    { "name": "CREATION_TIMESTAMP", "type": "long" }
  ],
  "version": "1.0"
}
今回のItemsでは、ITEM_TYPE(映画かグッズか)とGENRES(ジャンル)にcategorical、DESCRIPTION(説明文)にtextualを設定しました。WORK_IDには設定していません。作品IDそのものを学習させる意味はないので、「同じ作品のグッズ」を絞り込むフィルタ専用の列として使っています。
InteractionsとUsersのスキーマも同じ形式で書きます。
- Interactions:
USER_ID(誰が)、ITEM_ID(何に)、TIMESTAMP(いつ)、EVENT_TYPE(何をしたか)、EVENT_VALUE(購入金額や評価値)の5列です。どれもAmazon Personalizeが役割を決めている予約済みの列名で、名前のとおりに扱われるため、categoricalなどの設定はしていません - Users:
USER_IDと、自分で追加したSEGMENTの2列です。SEGMENTはユーザーの区分を学習の手がかりとしてモデルに渡すため、categoricalを設定しています
interactions.json / users.json
{
  "type": "record",
  "name": "Interactions",
  "namespace": "com.amazonaws.personalize.schema",
  "fields": [
    { "name": "USER_ID", "type": "string" },
    { "name": "ITEM_ID", "type": "string" },
    { "name": "TIMESTAMP", "type": "long" },
    { "name": "EVENT_TYPE", "type": "string" },
    { "name": "EVENT_VALUE", "type": ["null", "float"] }
  ],
  "version": "1.0"
}
{
  "type": "record",
  "name": "Users",
  "namespace": "com.amazonaws.personalize.schema",
  "fields": [
    { "name": "USER_ID", "type": "string" },
    { "name": "SEGMENT", "type": "string", "categorical": true }
  ],
  "version": "1.0"
}
2. データセットグループとMetric attributionを作る
データセットグループを作る
ここからAmazon Personalizeのリソースを作ります。まずはデータの入れ物です。データセットグループ(箱)を作り、「1. 検証データを用意する」で書いた3つのスキーマを登録してから、スキーマを指定してInteractions・Items・Usersの3つのデータセットを作ります。コマンドの<…ARN>には、前のコマンドの結果で返ってきたARNを入れます。
aws personalize create-dataset-group --name personalize-verify
aws personalize create-schema --name personalize-verify-items --schema file://data/schemas/items.json
aws personalize create-dataset --name personalize-verify-items --dataset-type Items \
  --dataset-group-arn <データセットグループARN> --schema-arn <スキーマARN>
# Interactions / Users も同様
作成した3つのデータセットです。
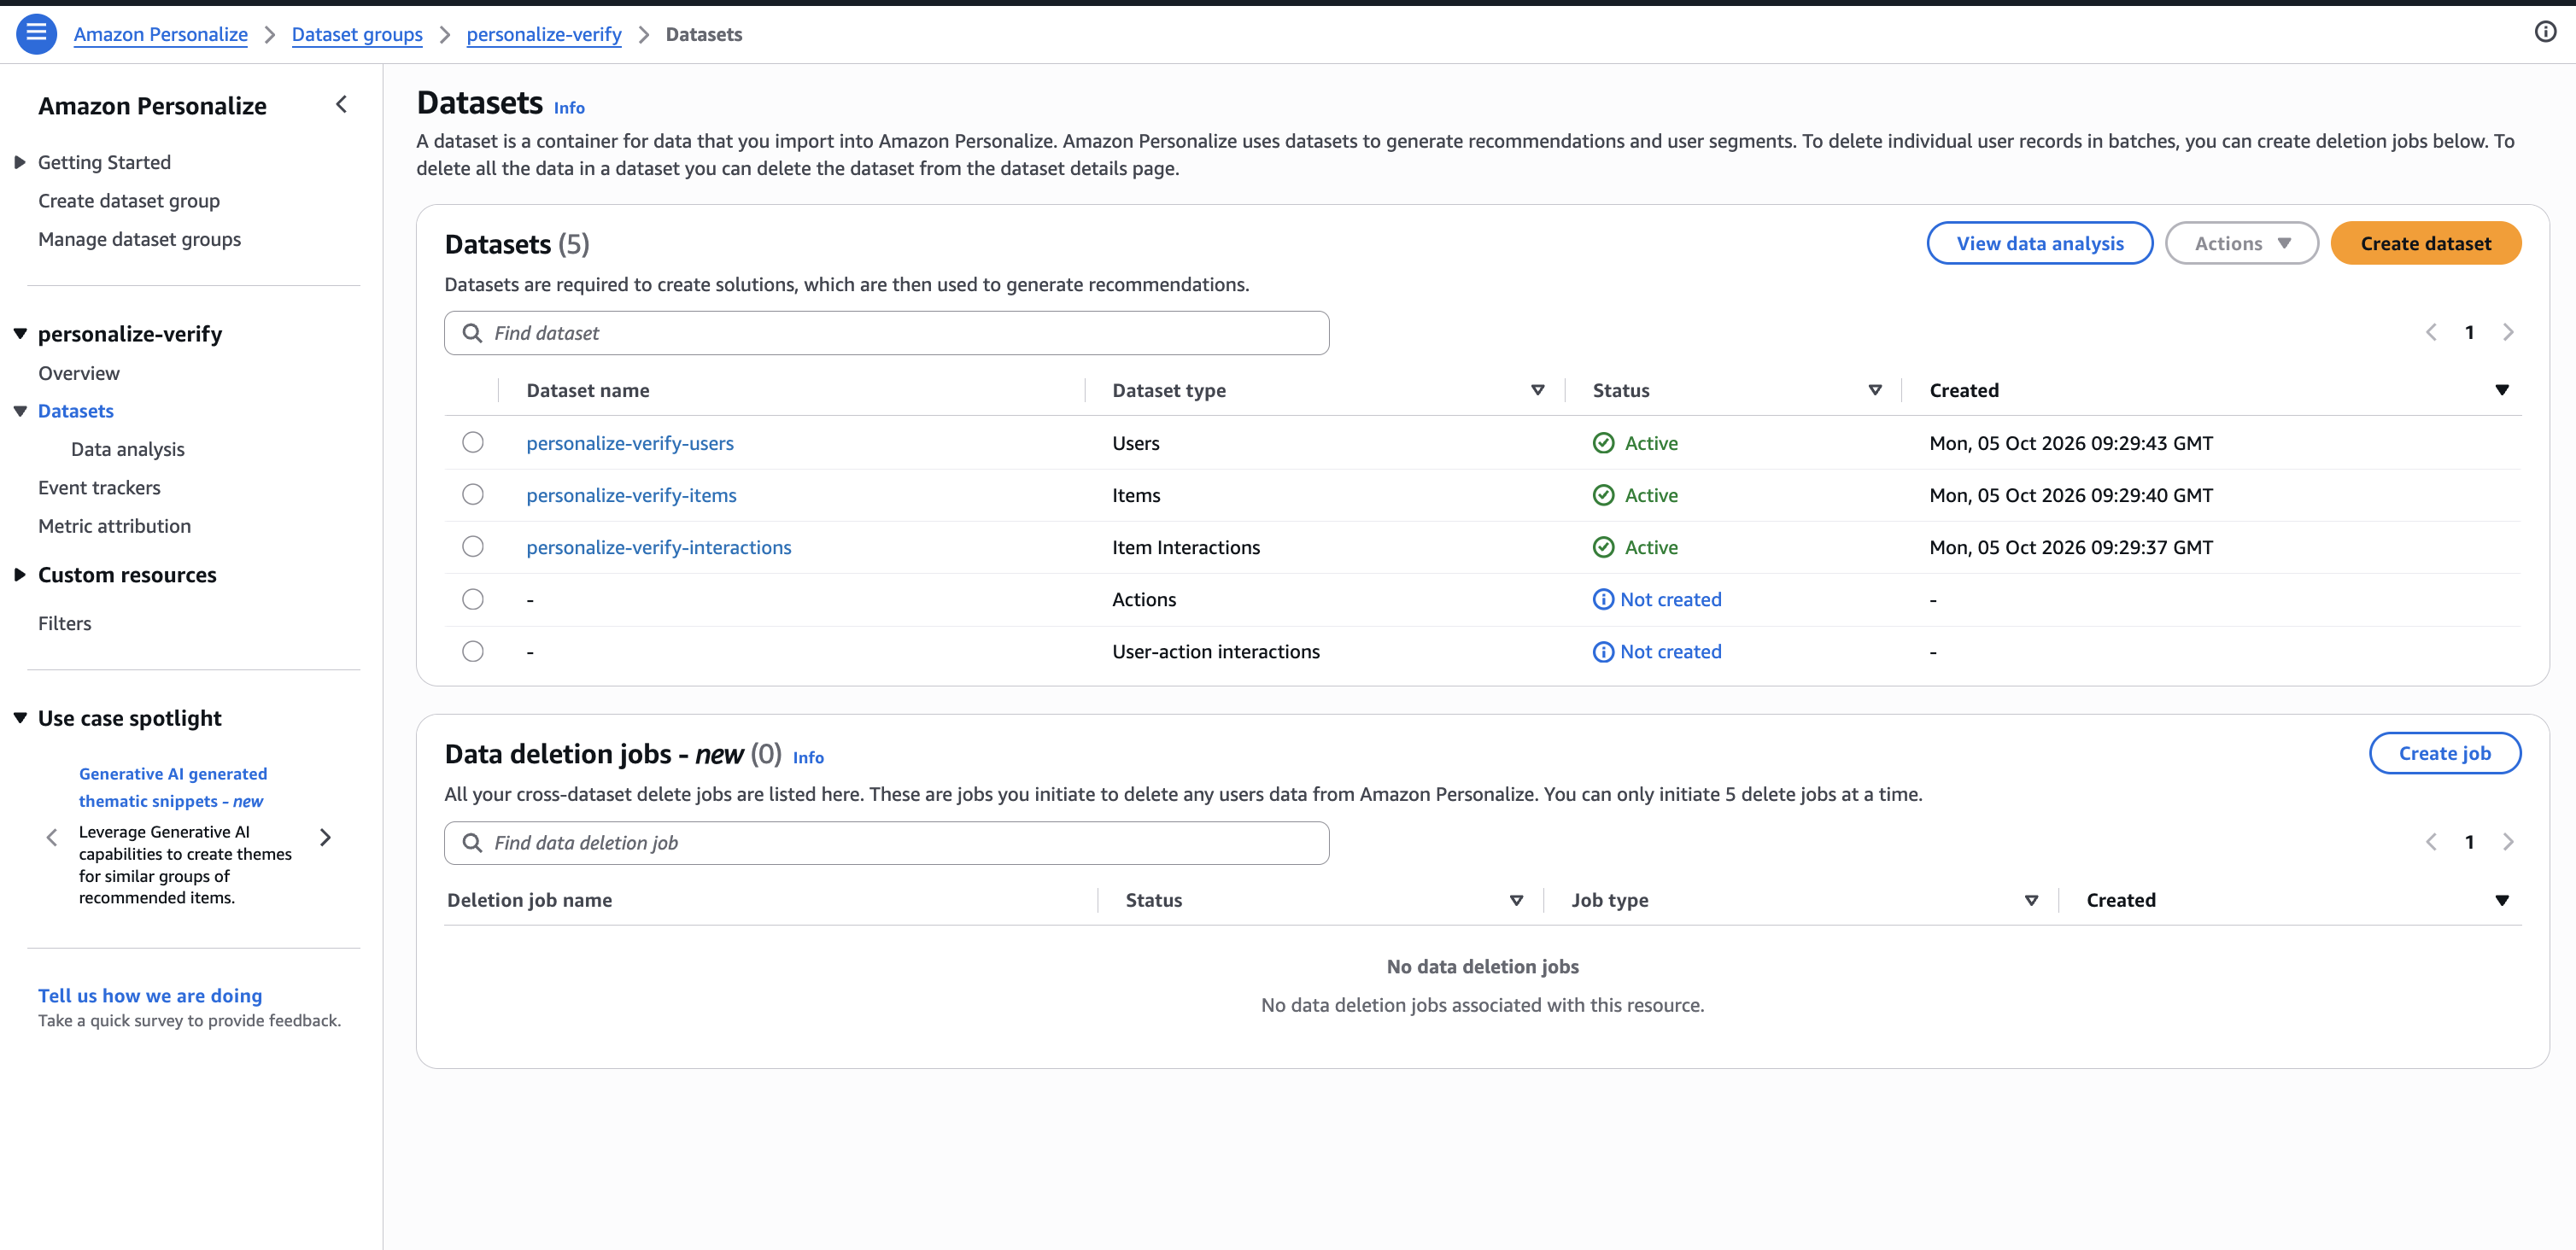
データセットグループには「ドメイン」と「カスタム」の2種類があり、作成時の--domainの指定で決まります。
- ドメイン:
--domainにECOMMERCE(EC)かVIDEO_ON_DEMAND(動画配信)を指定する。業種ごとに用意されたユースケースを選ぶと、レシピ選びや学習をAWSが管理してくれる - カスタム:
--domainを指定しない。レシピを自分で選び、学習も自分で実行する
今回はレシピを自分で選んで比べたかったので、カスタムで作りました。詳細画面のDomainがCustomになっています。
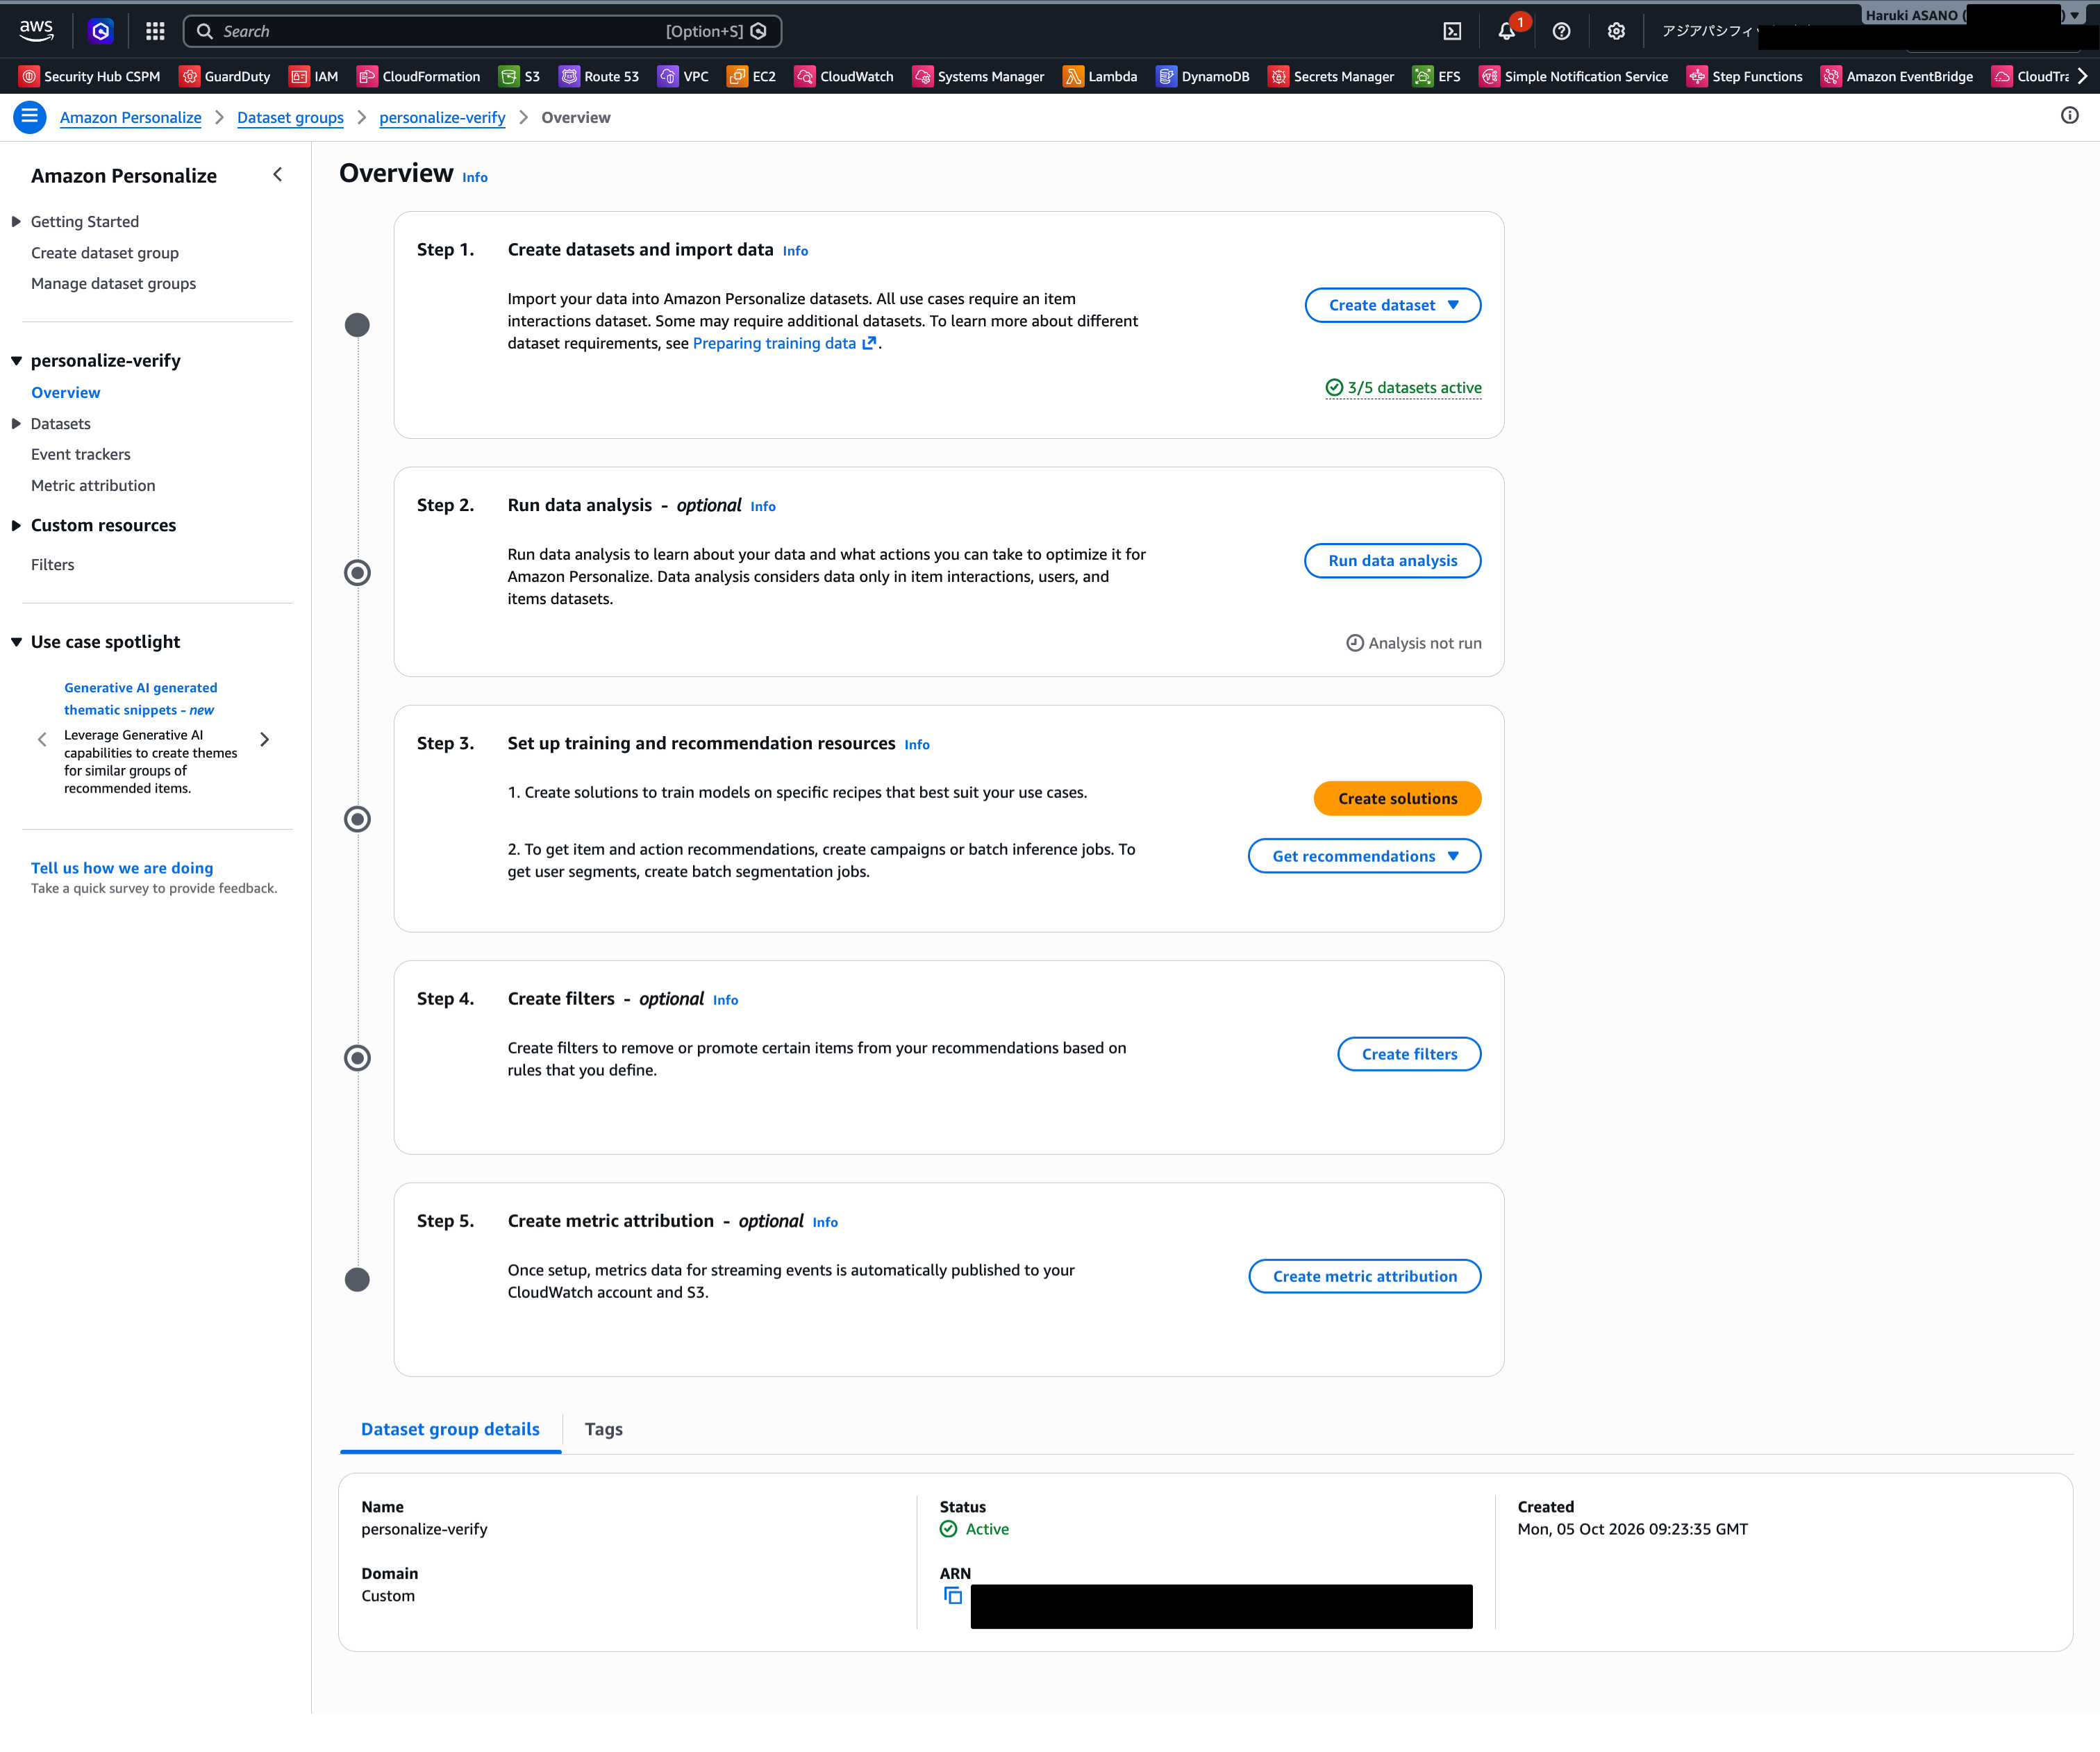
Metric attributionを作る
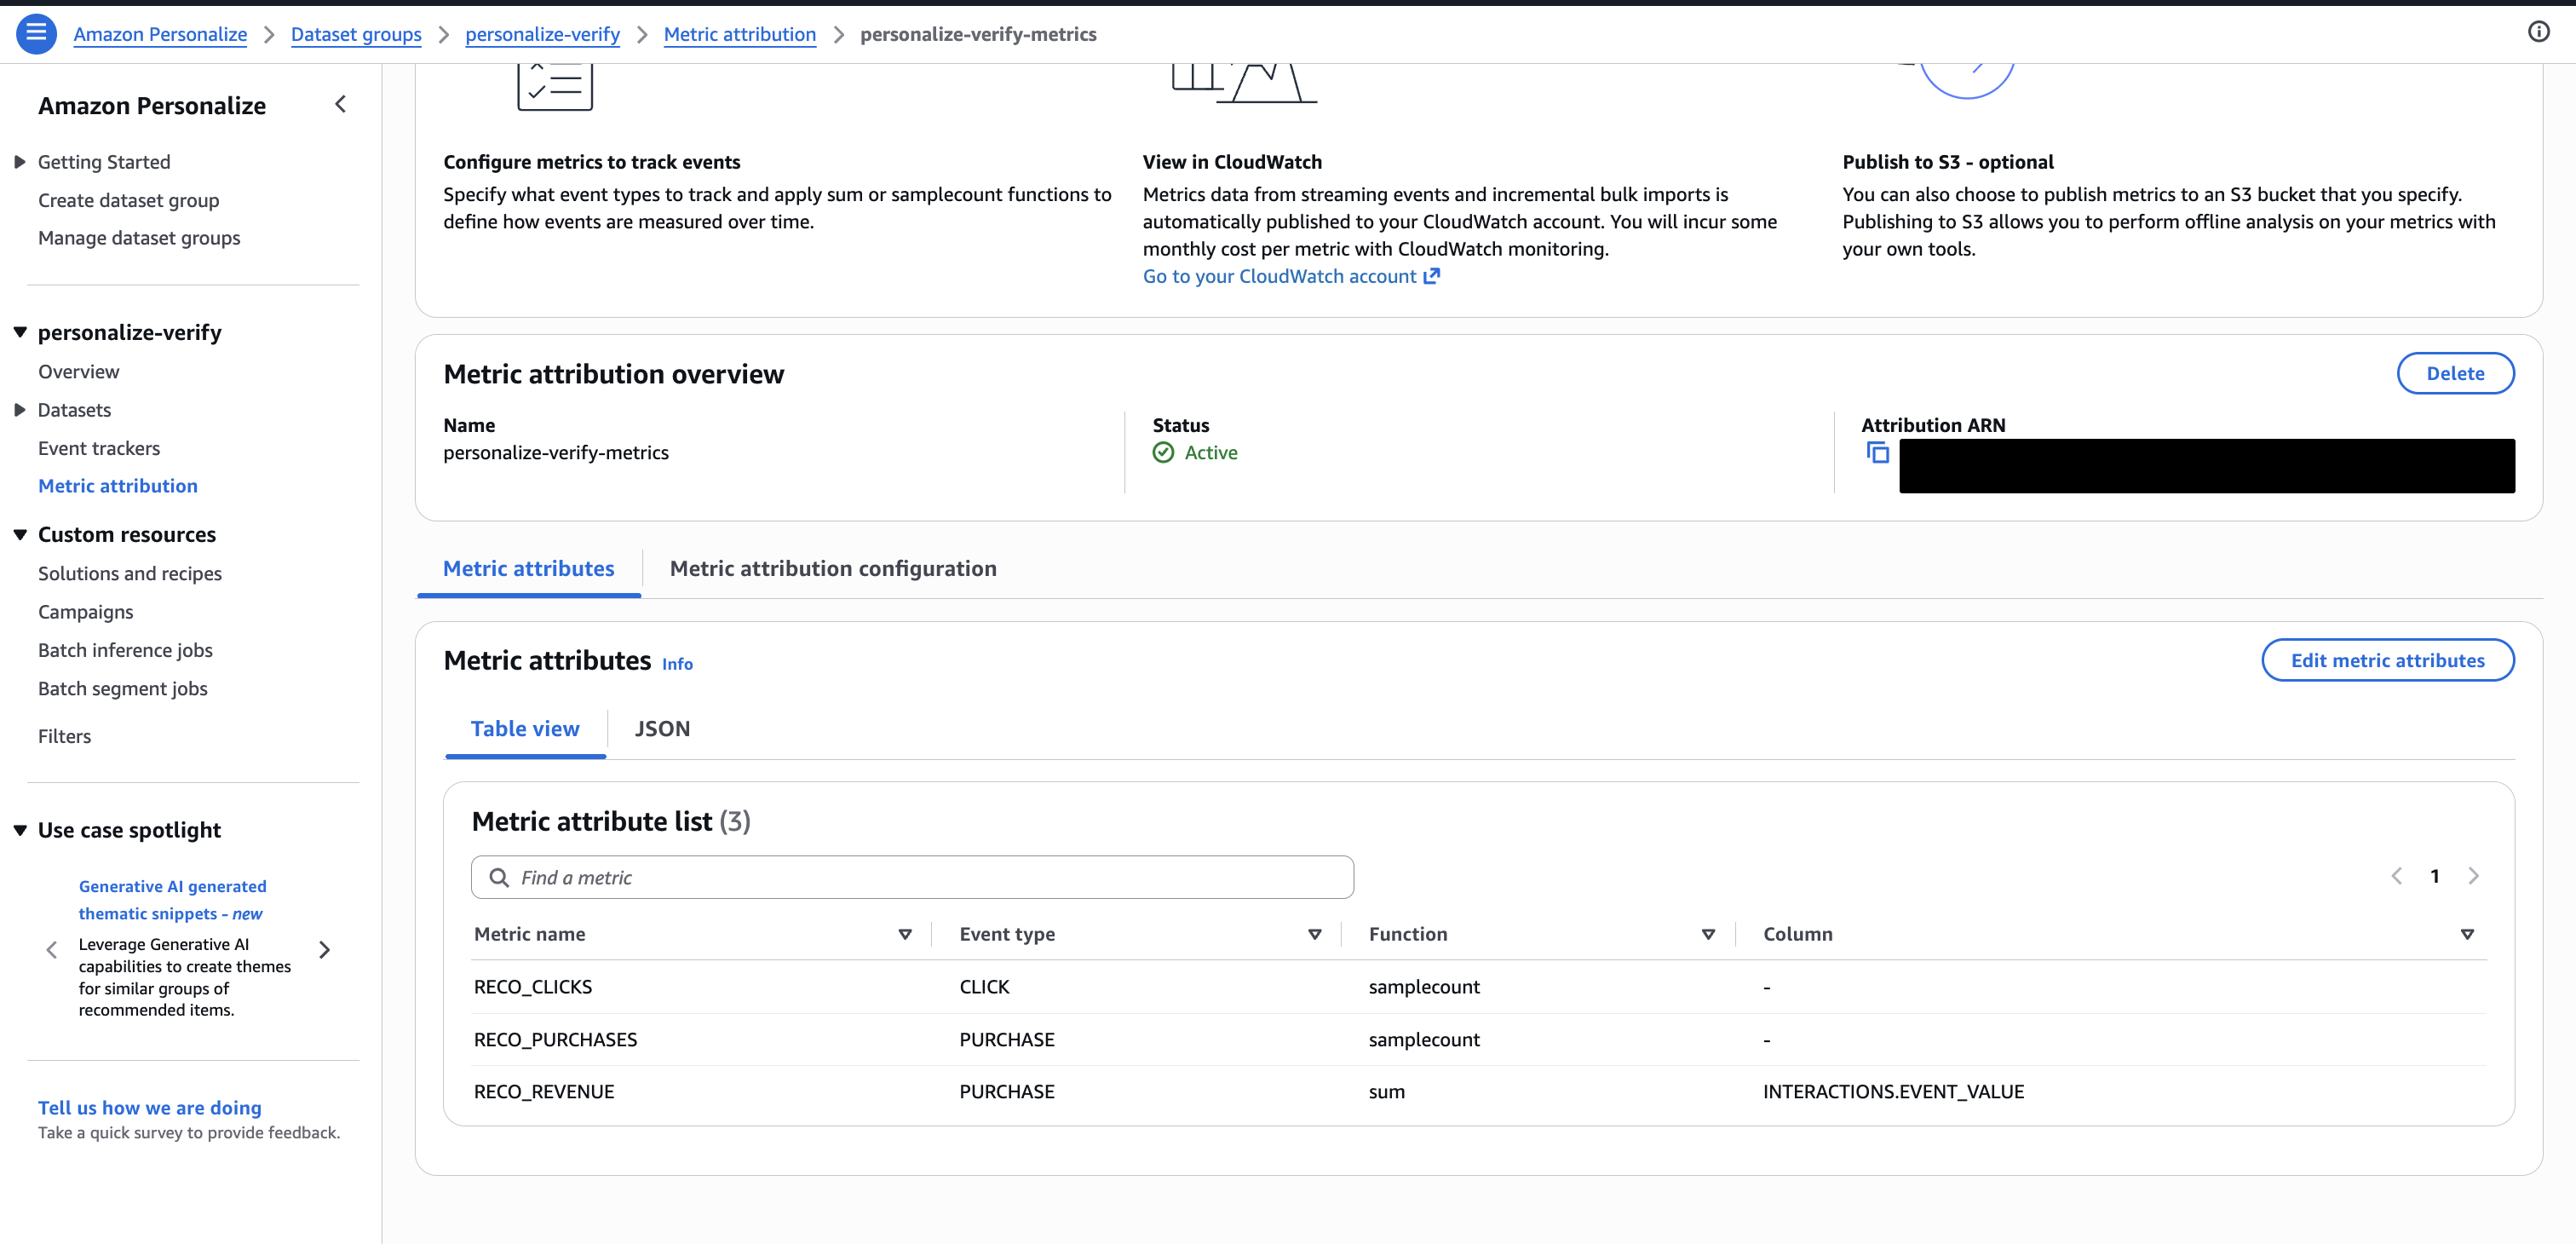
続けて、効果測定のためのMetric attributionを作ります。Metric attributionは、Interactionsに入ってきた行動のうち、指定した種類(EVENT_TYPE)の行動を、レコメンド元(どのレコメンドを経由したか)ごとに数える集計ルールです。集計結果はAmazon CloudWatchのメトリクスとして見られるほか、S3にCSVで出力することもできます。今回はクリック件数、購入件数、購入金額の合計の3つを登録しました。
このうちクリックは、このあとインポートする行動ログには入っていません。インポートする行動ログは、映画の評価とグッズの閲覧・カート追加・購入の4種類です。クリック(click)は、後でレコメンドの配信を模擬するときに、「レコメンドを見たユーザーがクリックした」という行動としてPutEventsで送ります。その時点で数えられるように、ここでルールに入れておきます。
aws personalize create-metric-attribution \
  --name personalize-verify-metrics \
  --dataset-group-arn <データセットグループARN> \
  --metrics-output-config '{"roleArn":"<ロールARN>","s3DataDestination":{"path":"s3://<バケット>/metrics/"}}' \
  --metrics '[
    {"metricName":"reco_clicks","eventType":"click","expression":"SAMPLECOUNT()"},
    {"metricName":"reco_purchases","eventType":"purchase","expression":"SAMPLECOUNT()"},
    {"metricName":"reco_revenue","eventType":"purchase","expression":"SUM(Interactions.EVENT_VALUE)"}
  ]'
3. データをインポートする
S3に置いた3つのCSVを、データセットごとにインポートジョブを作って取り込みます。何も指定しないと、データセットの中身をCSVで丸ごと置き換えるインポート(FULL)になります。
Interactionsのインポートには、--publish-attribution-metrics-to-s3というオプションを付けました。CSVで取り込んだ行動も、Metric attributionで数えられるのかを確かめるためです。このオプションを付けると、取り込んだ行動をMetric attributionのルール(クリック件数・購入件数・購入金額)で数えた結果が、S3にCSVファイルで出力されます。ItemsとUsersは数える対象ではないので付けていません。
aws personalize create-dataset-import-job --job-name import-interactions-01 \
  --dataset-arn <InteractionsのARN> \
  --data-source dataLocation=s3://<バケット>/input/interactions.csv \
  --role-arn <ロールARN> --publish-attribution-metrics-to-s3
3つのデータセットとも約10分で取り込みが終わり、直後にS3へAggregatedAttributionMetrics-DATASET_IMPORT_FULL-<日時>.csvという集計CSVが出力されました。中身の先頭は次のとおりです。
| METRIC_NAME | EVENT_TYPE | VALUE | MATH_FUNCTION | EVENT_ATTRIBUTION_SOURCE | TIMESTAMP |
|---|---|---|---|---|---|
| RECO_PURCHASES | PURCHASE | 1.0 | SAMPLECOUNT() | SOURCE_NAME_UNDEFINED | 847231200 |
| RECO_REVENUE | PURCHASE | 1100.0 | SUM(INTERACTIONS.EVENT_VALUE) | SOURCE_NAME_UNDEFINED | 847231200 |
| RECO_PURCHASES | PURCHASE | 1.0 | SAMPLECOUNT() | SOURCE_NAME_UNDEFINED | 847560600 |
| RECO_REVENUE | PURCHASE | 2300.0 | SUM(INTERACTIONS.EVENT_VALUE) | SOURCE_NAME_UNDEFINED | 847560600 |
1行が「15分ごとの区切り × ルール × レコメンド元」の集計値で、VALUEが件数や合計金額、TIMESTAMPが区切りの時刻(UNIX秒)です。
購入件数のVALUEを合計すると1,126件で、CSVの購入行数と一致しました。インポートしたCSVには「どのレコメンドから来たか」を表す列を入れていないので、すべての購入がSOURCE_NAME_UNDEFINED、つまりレコメンドを経由していない行動として数えられています。
取り込んだデータは、コンソールのData analysisで診断できます。学習に十分な量があるか、品質に問題がないかを指摘してくれます。
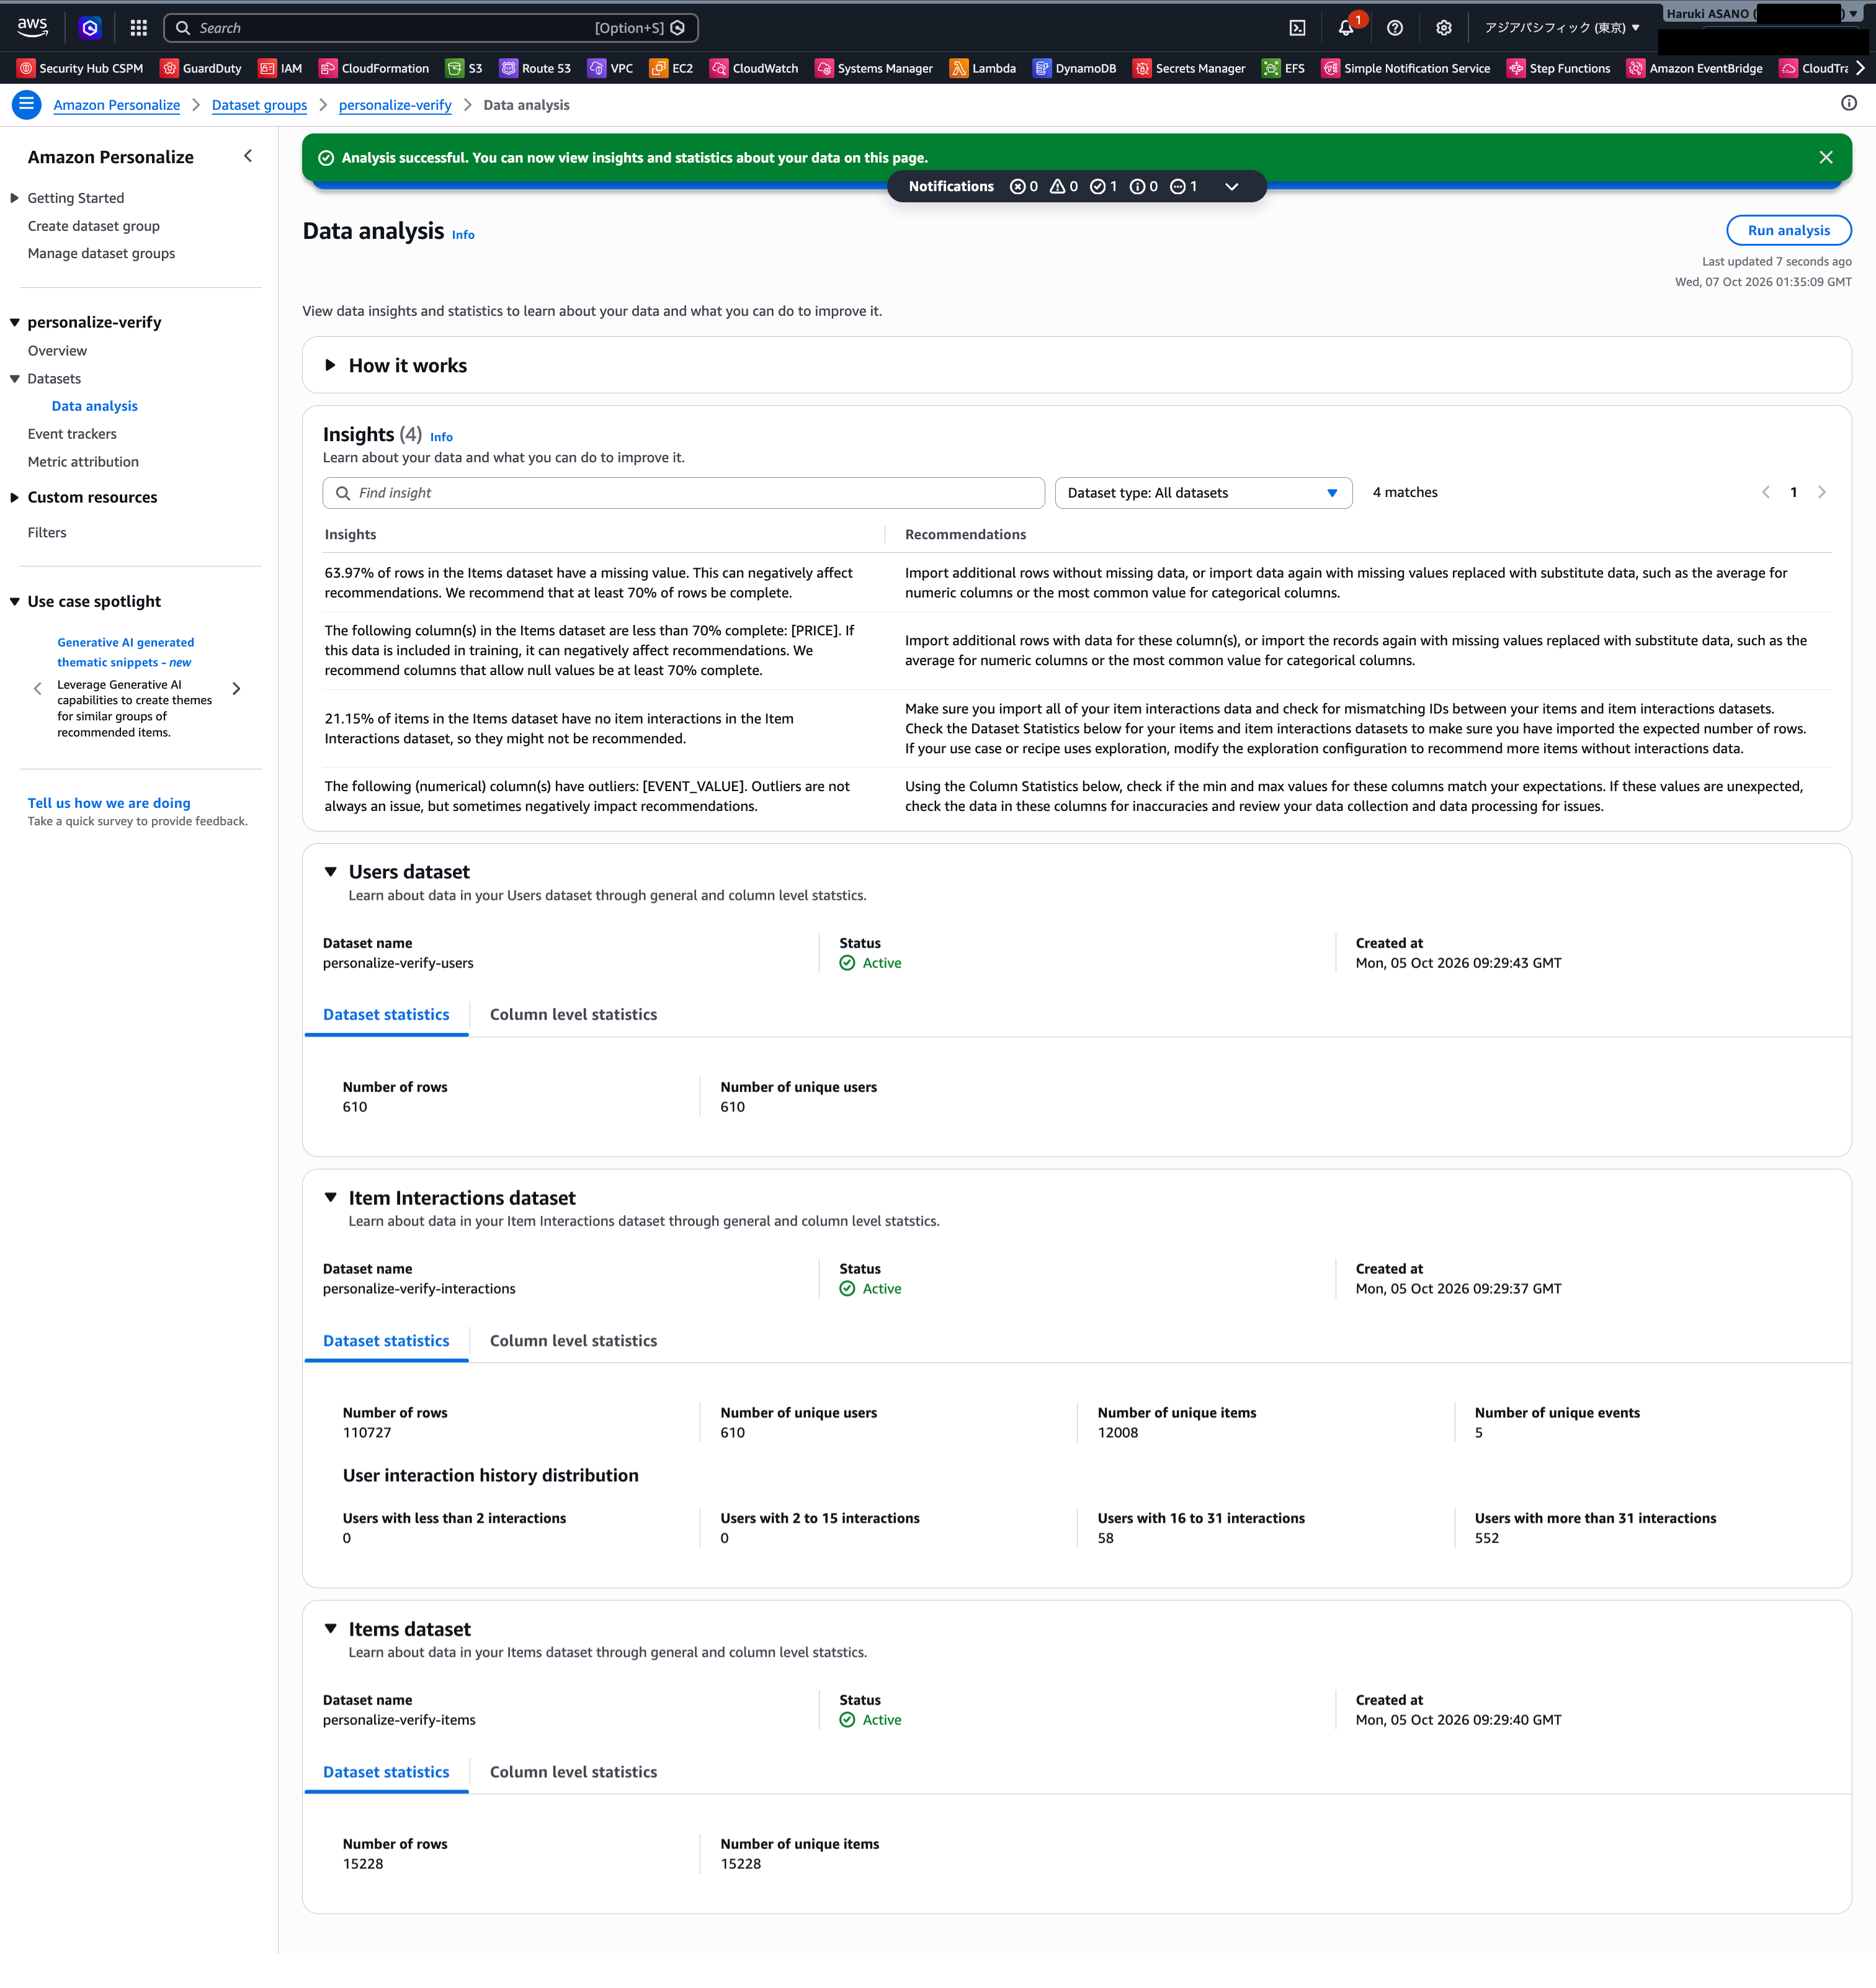
全ユーザーが16件以上の行動を持っていて量は十分でしたが、次の指摘が出ました。
- Itemsの63.97%の行に欠損値がある。映画には価格がないため、
PRICE列が空になっている - アイテムの21.15%に行動がなく、レコメンドされにくい
EVENT_VALUEに外れ値がある。映画の評価値(0.5〜5.0)と購入金額(600〜4,000)を同じ列に入れたため
いずれも、種類の違うアイテムを1つの表に同居させたことで出ている指摘です。片方にしかない列は欠損扱いになるので、実データで設計するときは欠損の埋め方とEVENT_VALUEの用途を先に決めておくとよさそうです。
増分インポートを試す
ここまでのFULLのインポートは、データセットの中身を丸ごと置き換えます。運用では日々の差分だけを足していきたいので、既存のデータに追加する増分インポート(--import-mode INCREMENTAL)も試しました。
1回目は、390件の行動を入れたファイルを取り込んだところ、失敗しました。
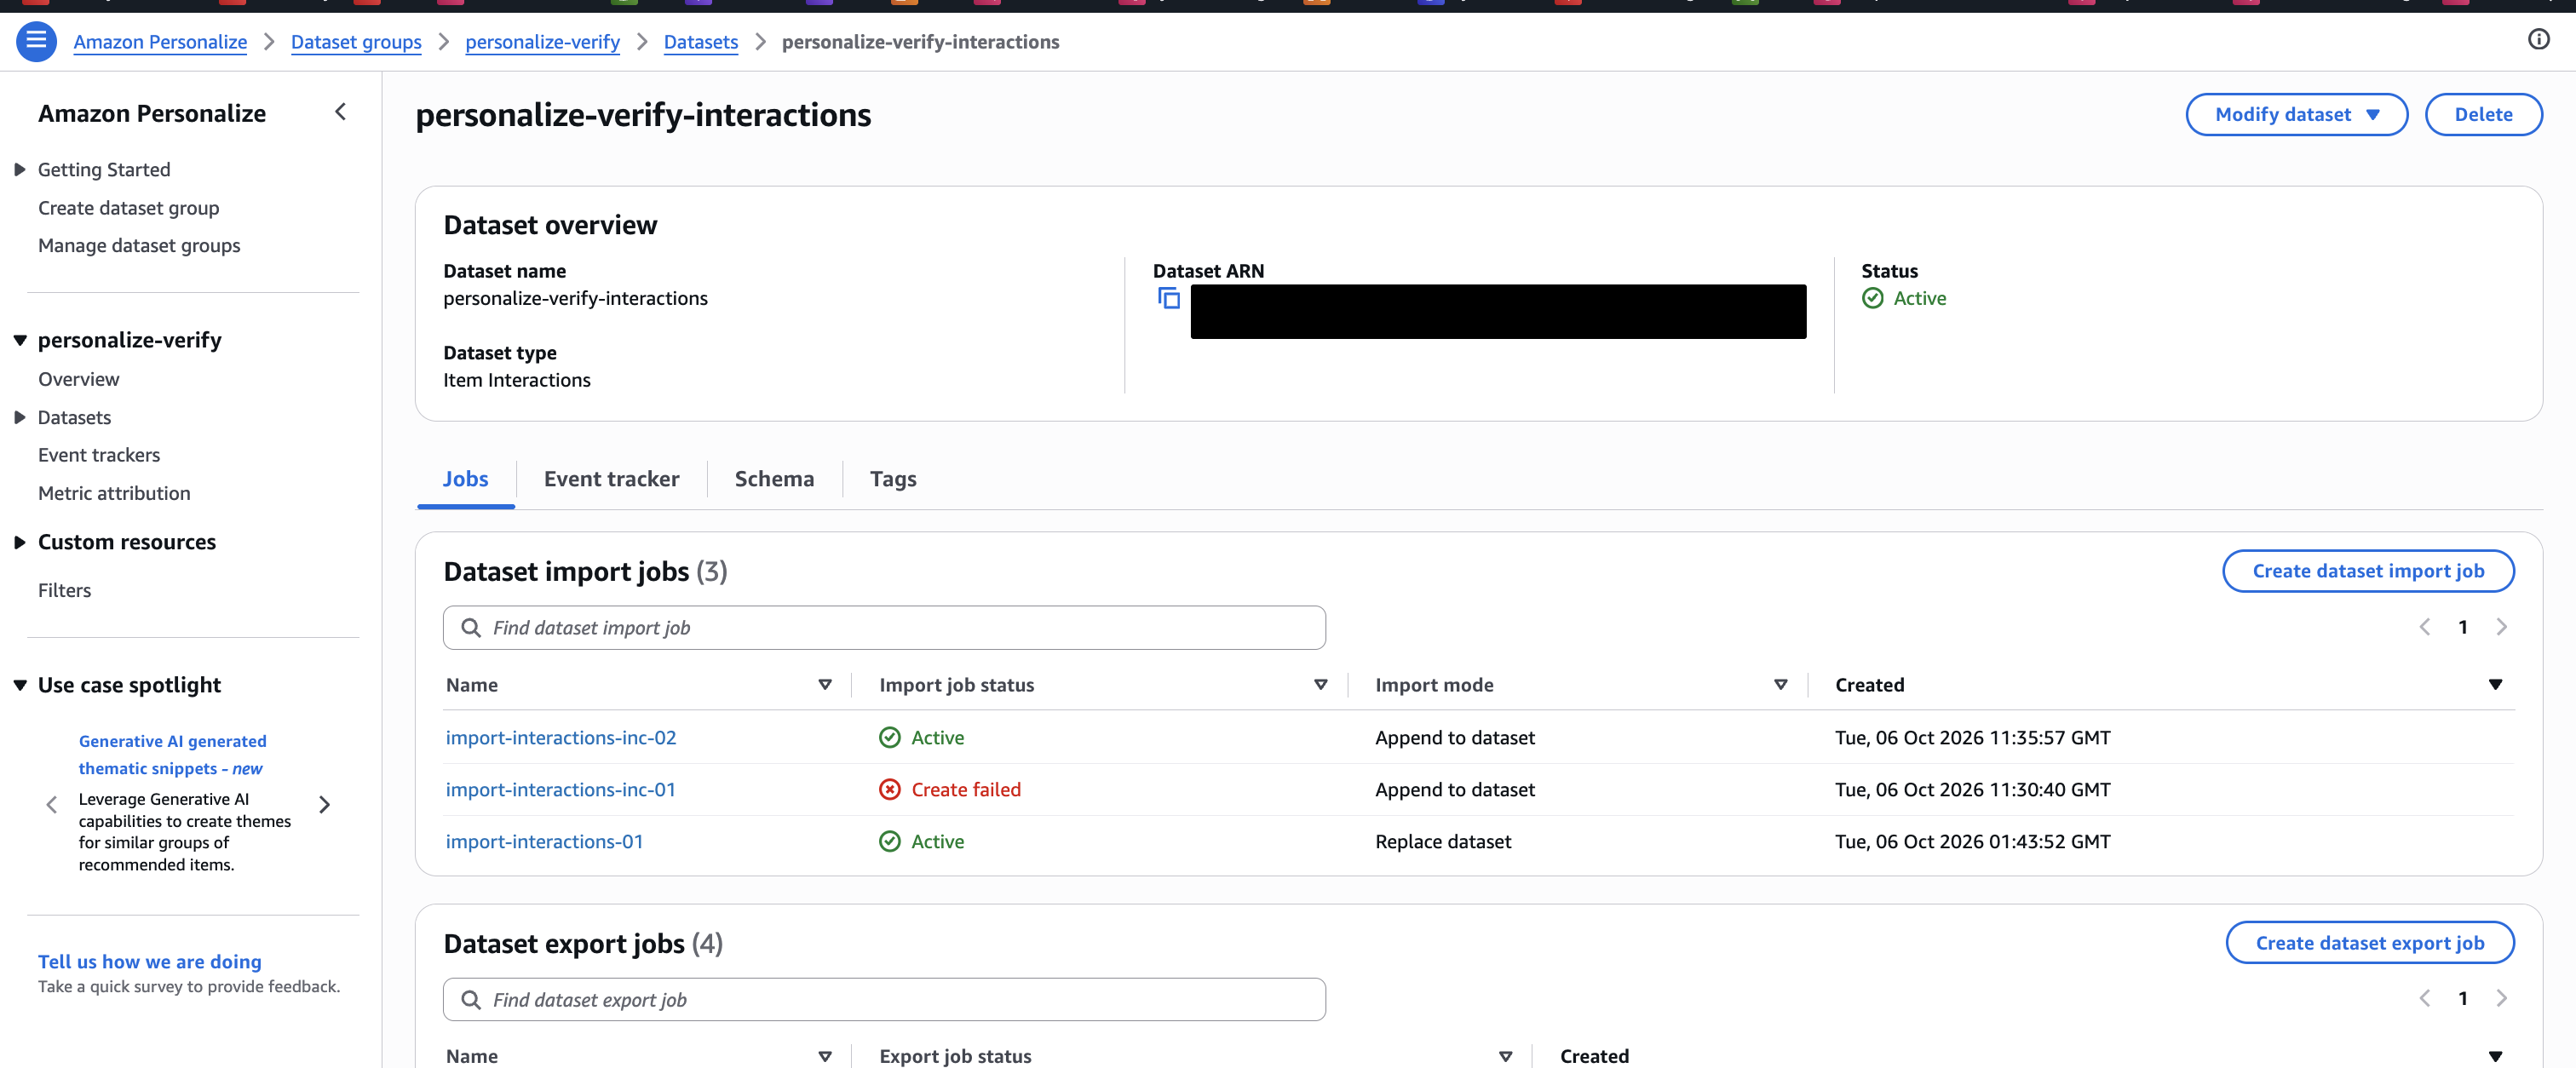
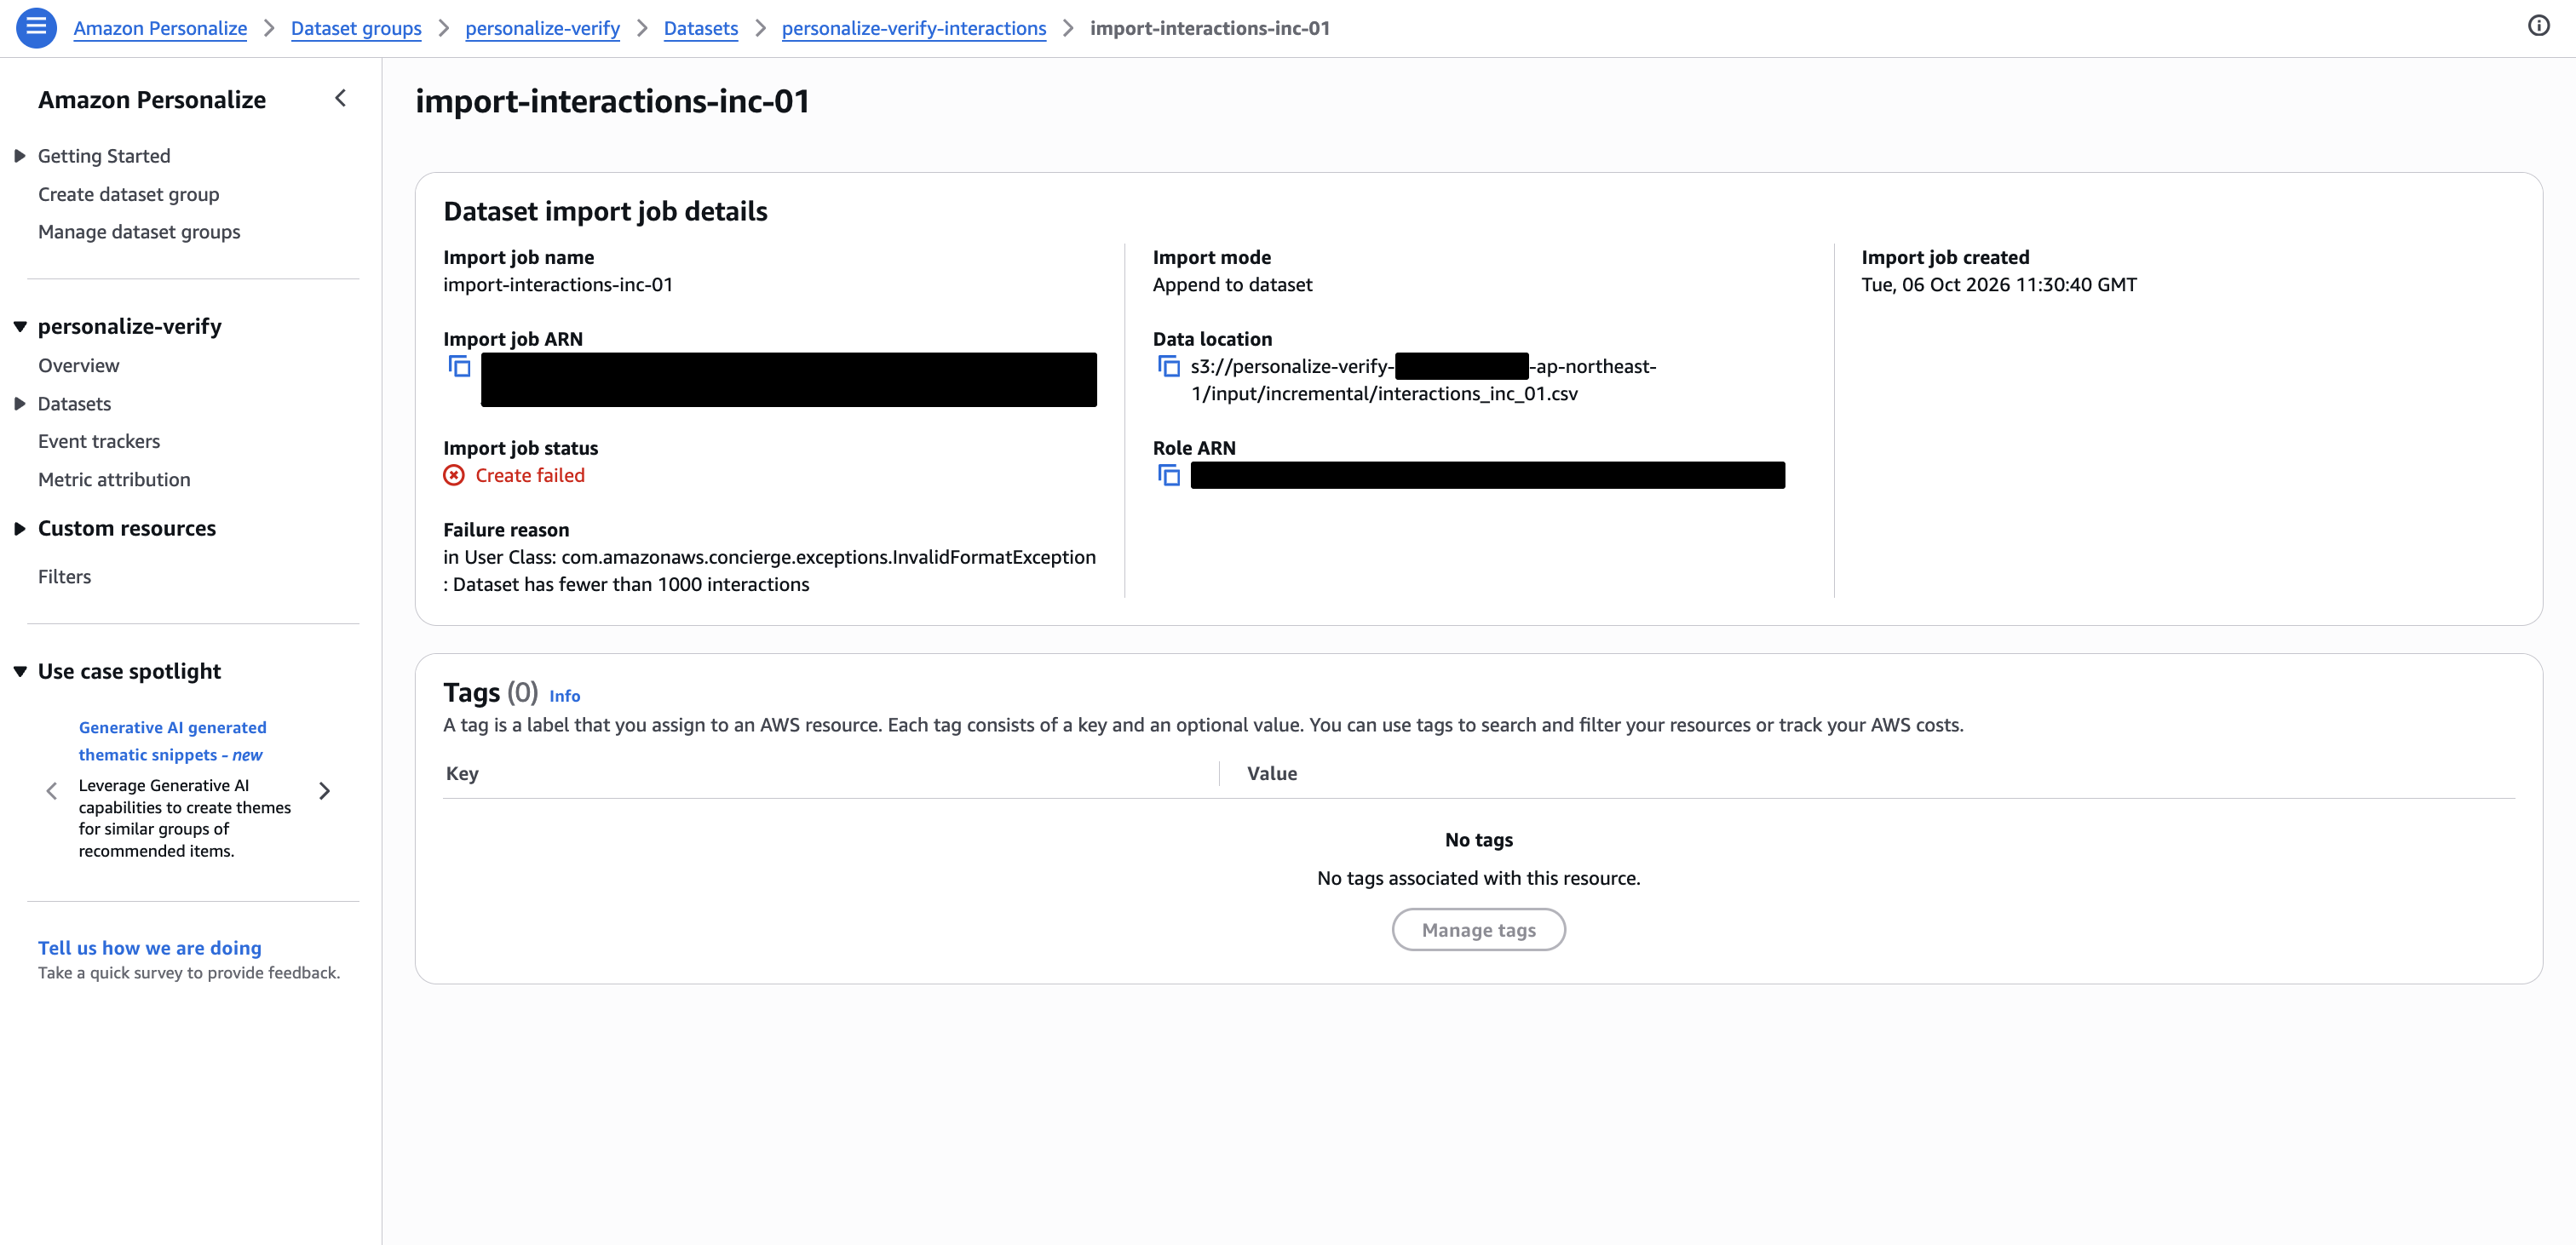
エラーは「Dataset has fewer than 1000 interactions」で、件数が足りないというものです。そこで、2回目は1,291件(クリック1,000件と購入291件)に増やして取り込んだところ、約4分で成功しました。既存の107,026件は残ったまま、1,291件が追加されています。
4. 3つのレシピで学習する
Interactions、Items、Usersの3つのデータセットに取り込みが終わったので、ここからモデルを学習します。
学習の手順は、レシピ(アルゴリズム)を選んでソリューションを作り、そのソリューションからソリューションバージョンを作成する、という流れです。ソリューションバージョンを作成した時点で学習が始まります。
レシピは目的ごとに複数あり、今回は次の3つを使いました。
| レシピ | 目的 | 特徴 |
|---|---|---|
| User-Personalization-v2 | このユーザーへのレコメンド | Transformerベースで、学習対象のアイテム数が最大500万。イベントの種類ごとに重みを付けられる |
| Similar-Items | このアイテムに似ているもの | 行動の傾向(同じユーザーに一緒に評価・購入されるか)とアイテムの属性の両方で探す |
| Popularity-Count | 個人化の効果を比べるための基準 | 全員に同じ人気順を返す |
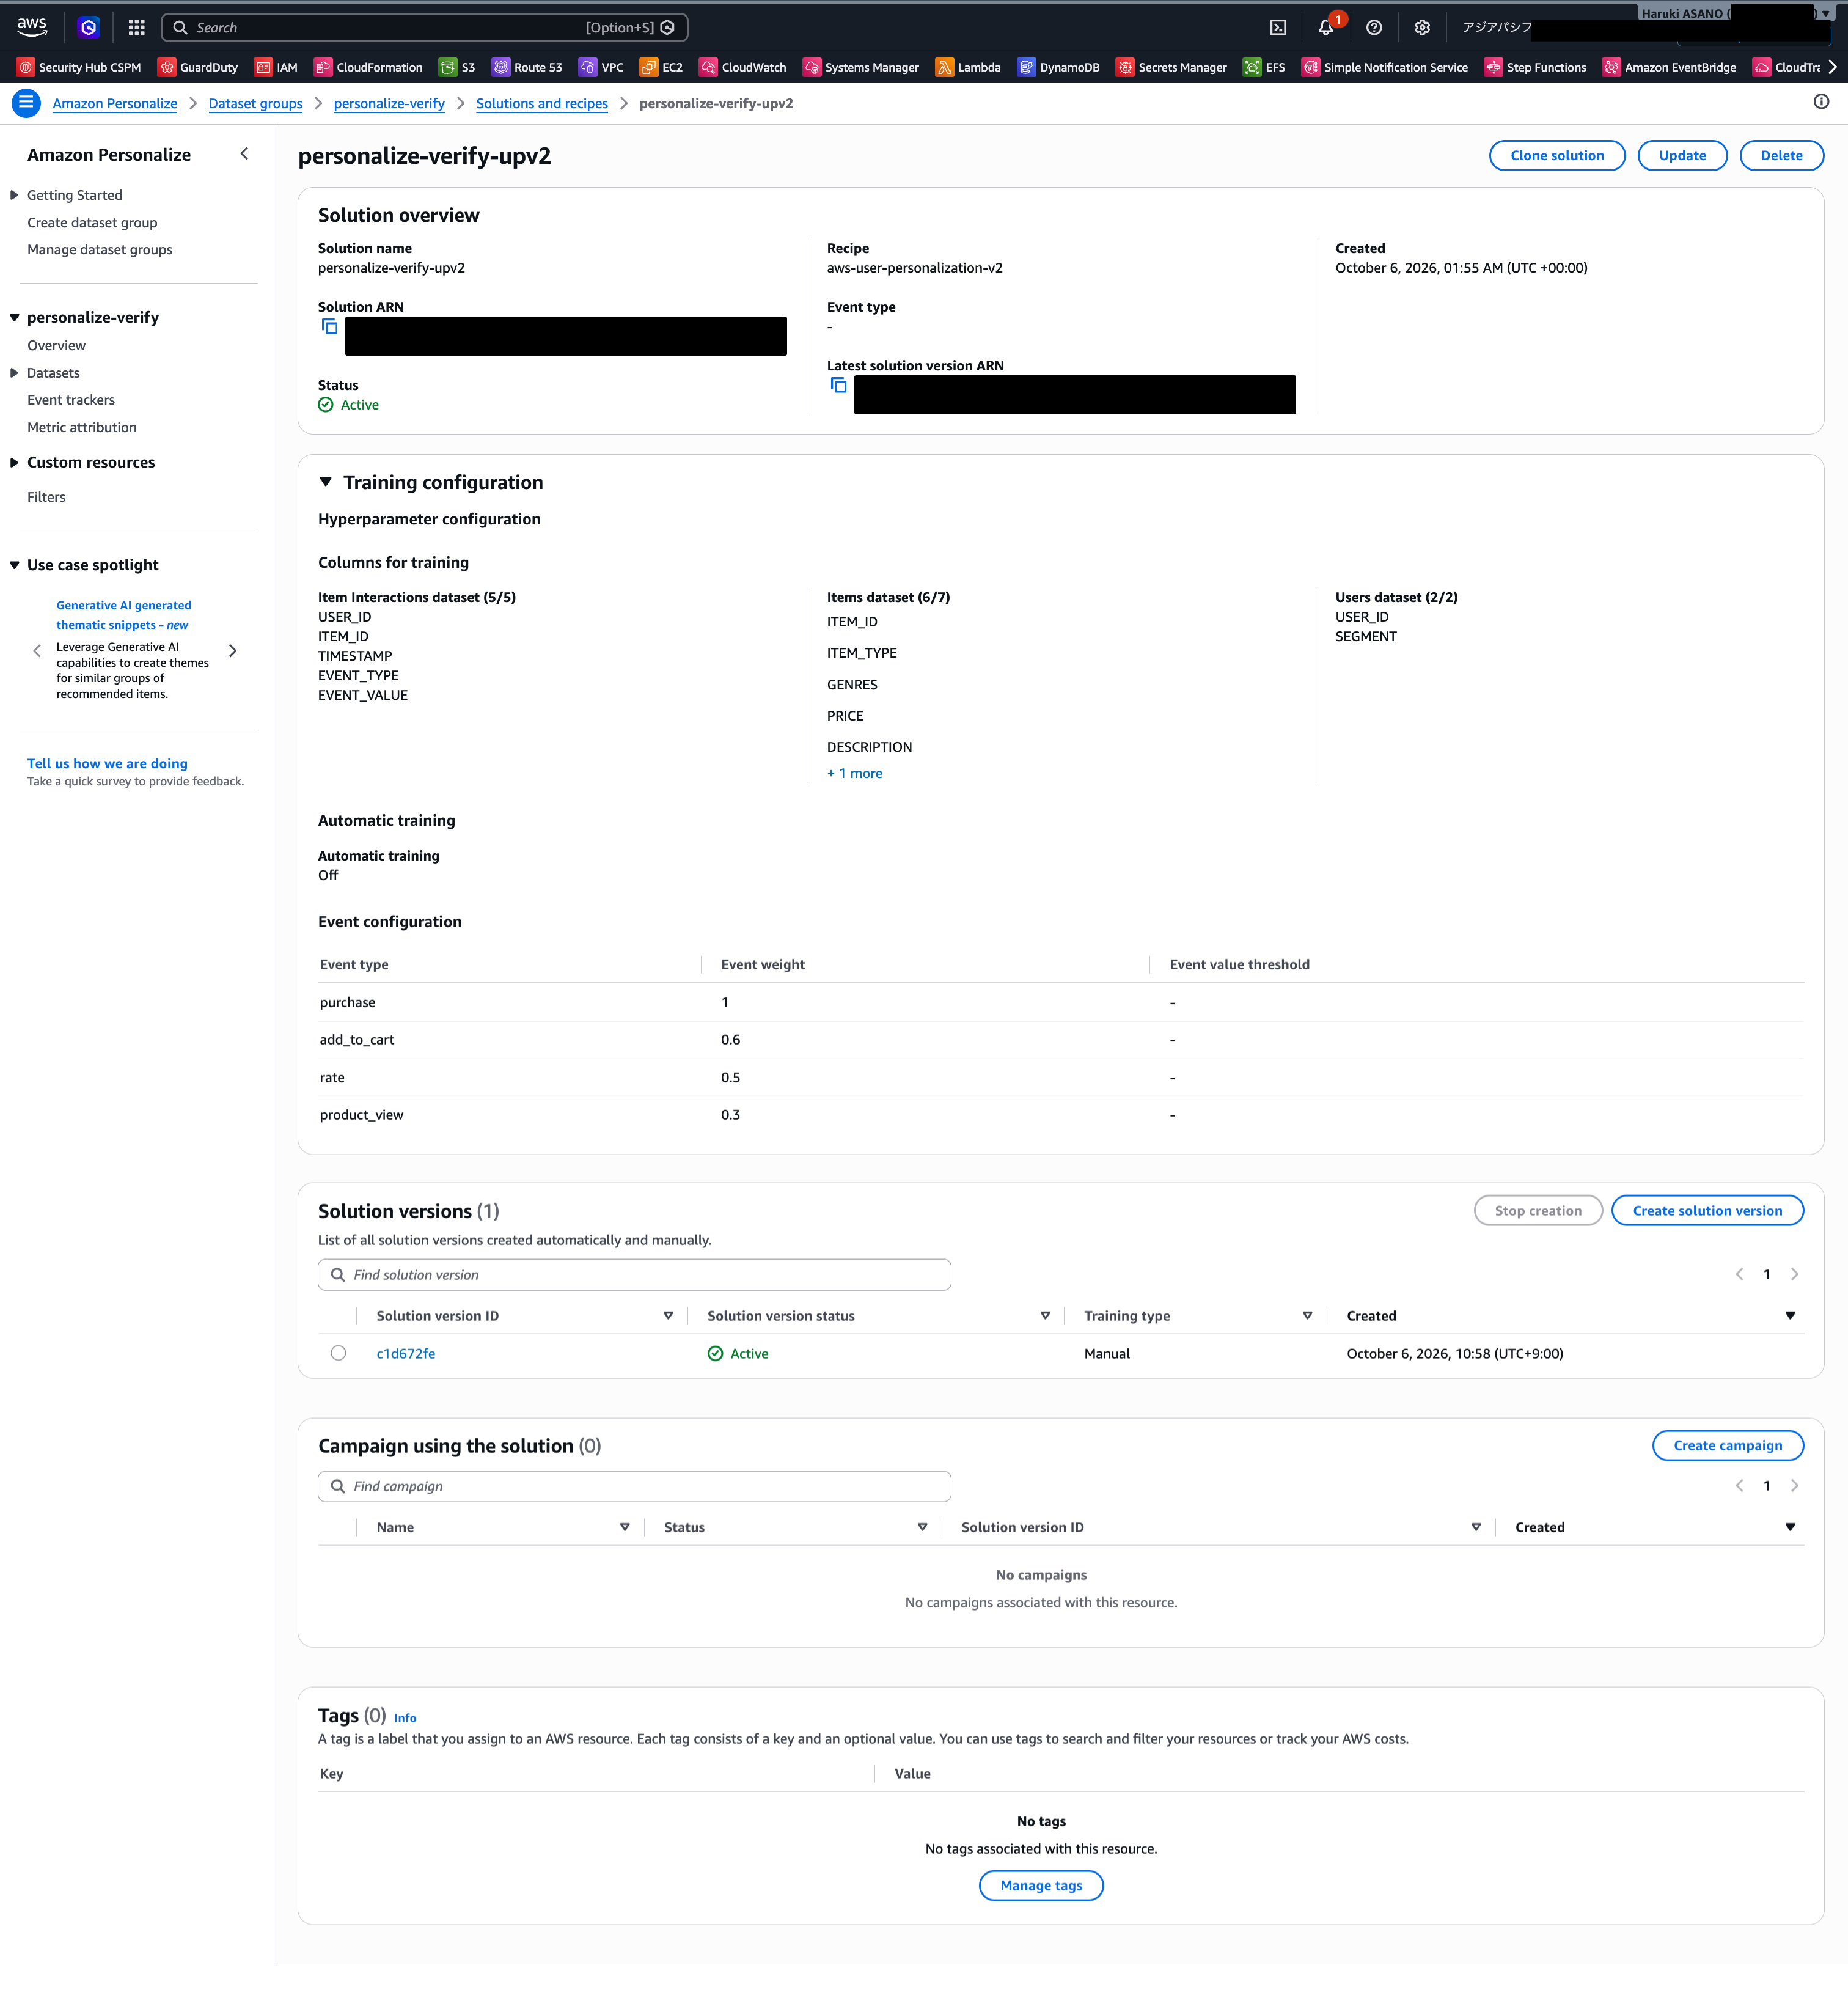
Interactionsには、映画の評価、グッズの閲覧・カート追加・購入の4種類の行動が混ざっています。同じ1件の行動でも、グッズを見ただけなのか、買うまで至ったのかで好みの強さは違います。User-Personalization-v2では、こうしたイベントの種類ごとに0〜1の重みを設定でき、重みの大きい種類の行動につながりそうなアイテムほど上位に出しやすくなります。今回は購入を最も重く、閲覧を最も軽くしました。
aws personalize create-solution --name personalize-verify-upv2 \
  --dataset-group-arn <データセットグループARN> \
  --recipe-arn arn:aws:personalize:::recipe/aws-user-personalization-v2 \
  --no-perform-auto-training \
  --solution-config '{"eventsConfig":{"eventParametersList":[
    {"eventType":"purchase","weight":1.0},
    {"eventType":"add_to_cart","weight":0.6},
    {"eventType":"rate","weight":0.5},
    {"eventType":"product_view","weight":0.3}]}}'

aws personalize create-solution-version --solution-arn <ソリューションARN>
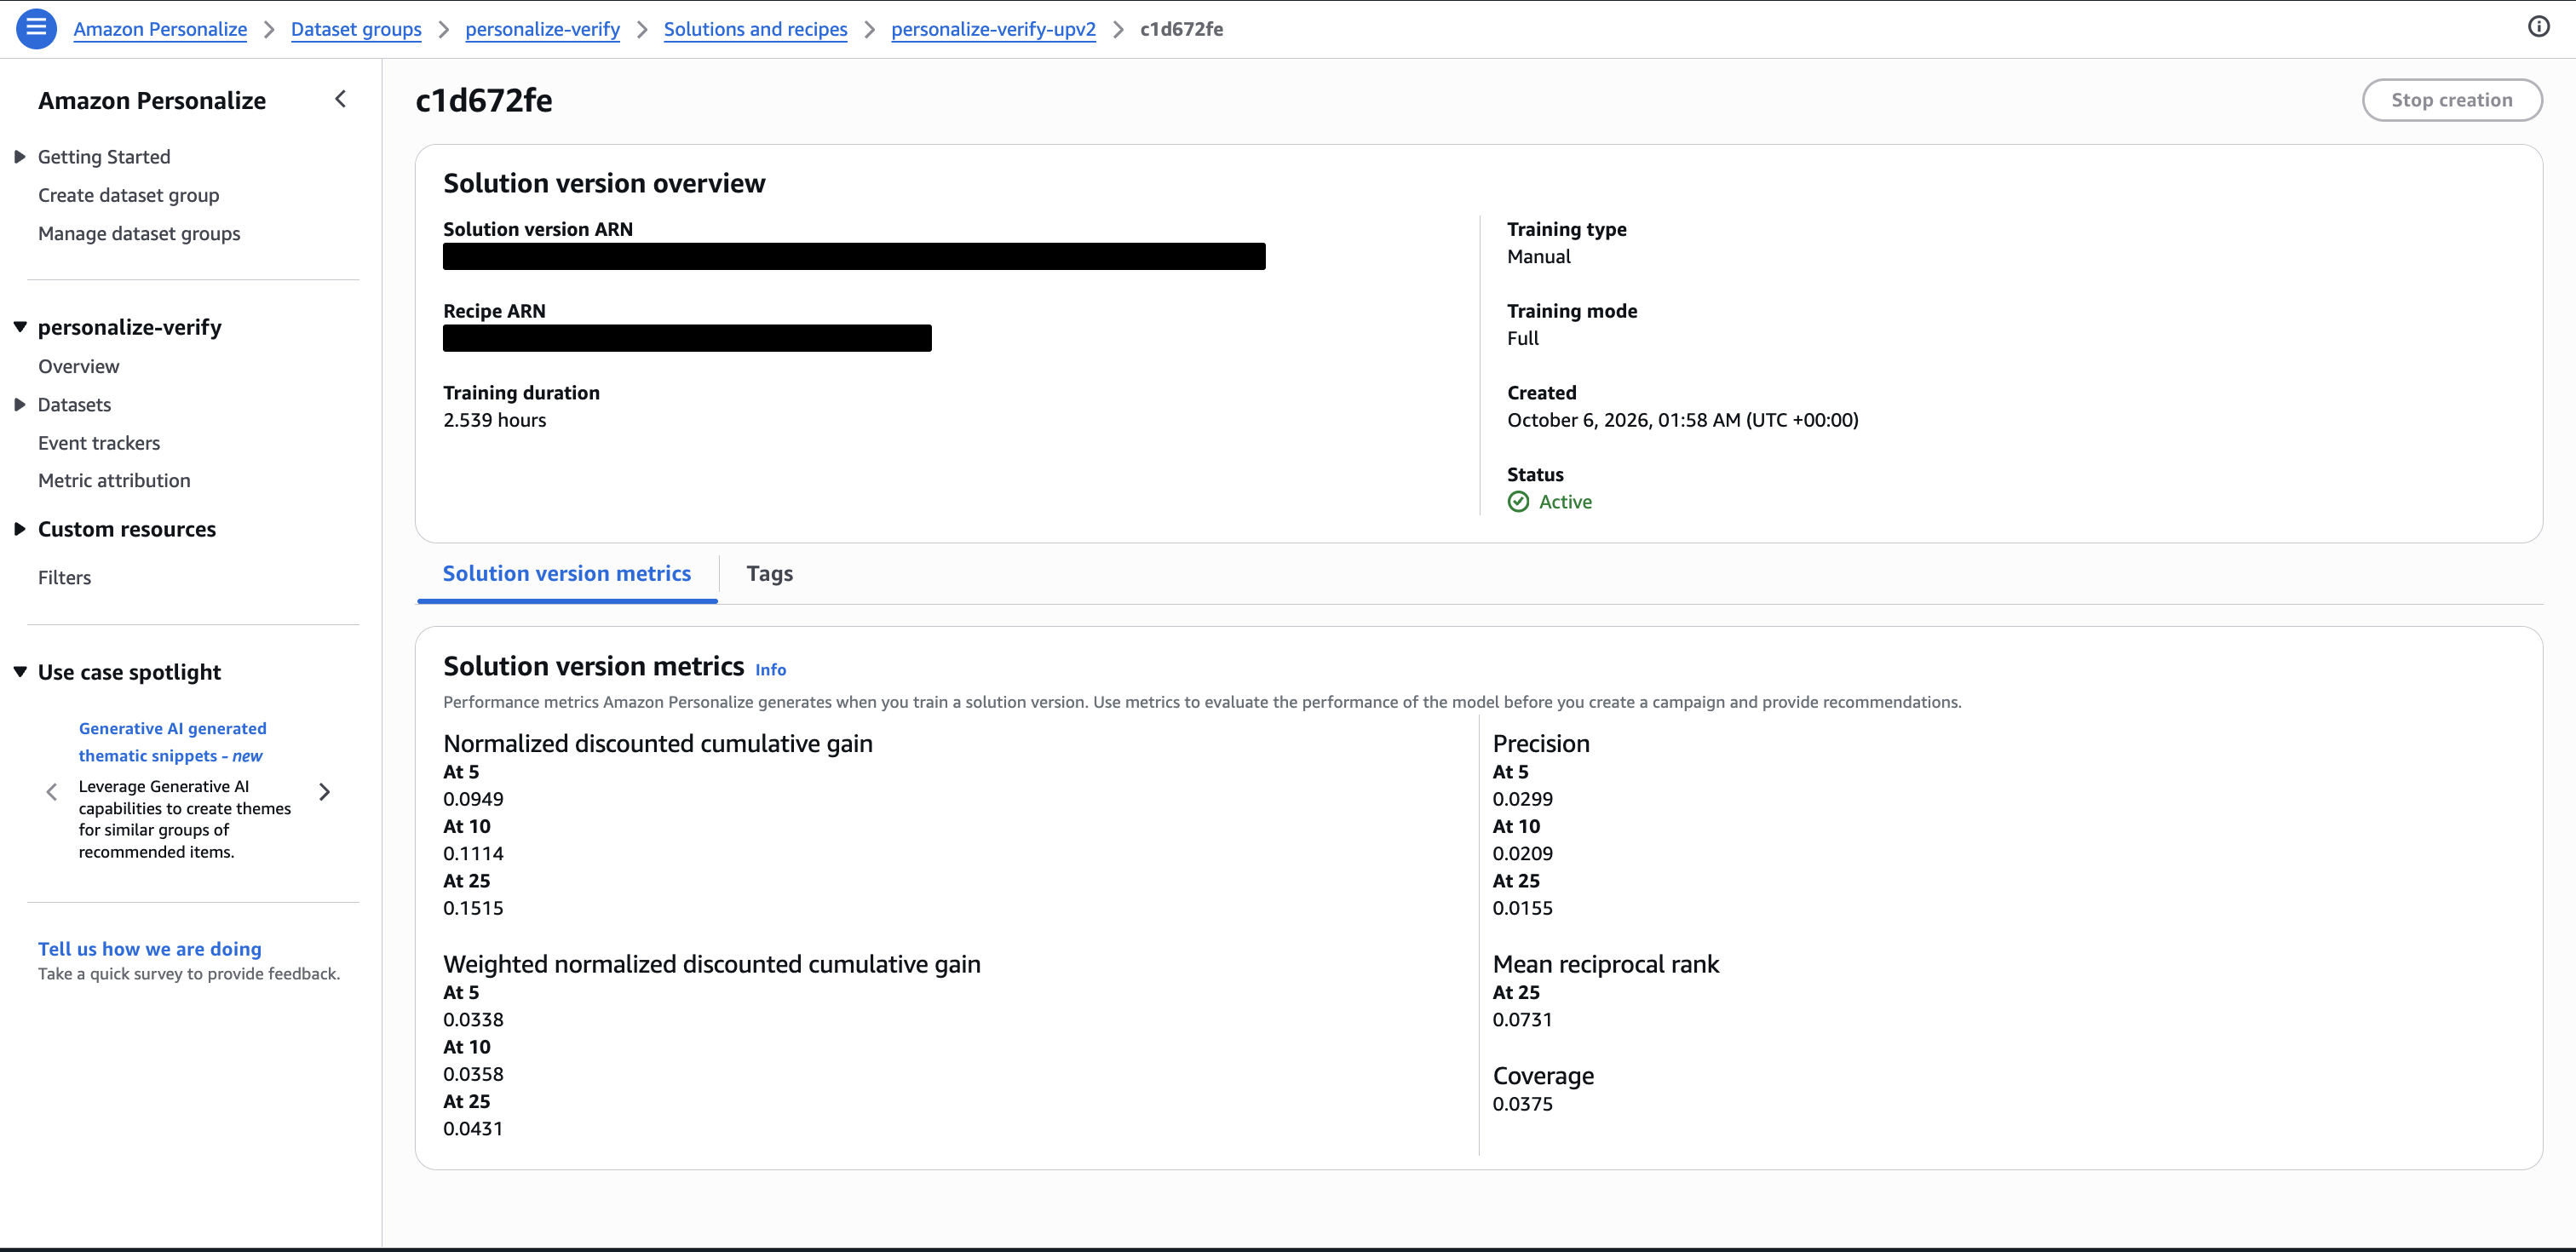
学習が終わると、データの一部を評価用に取り分けて計算した指標が表示されます。
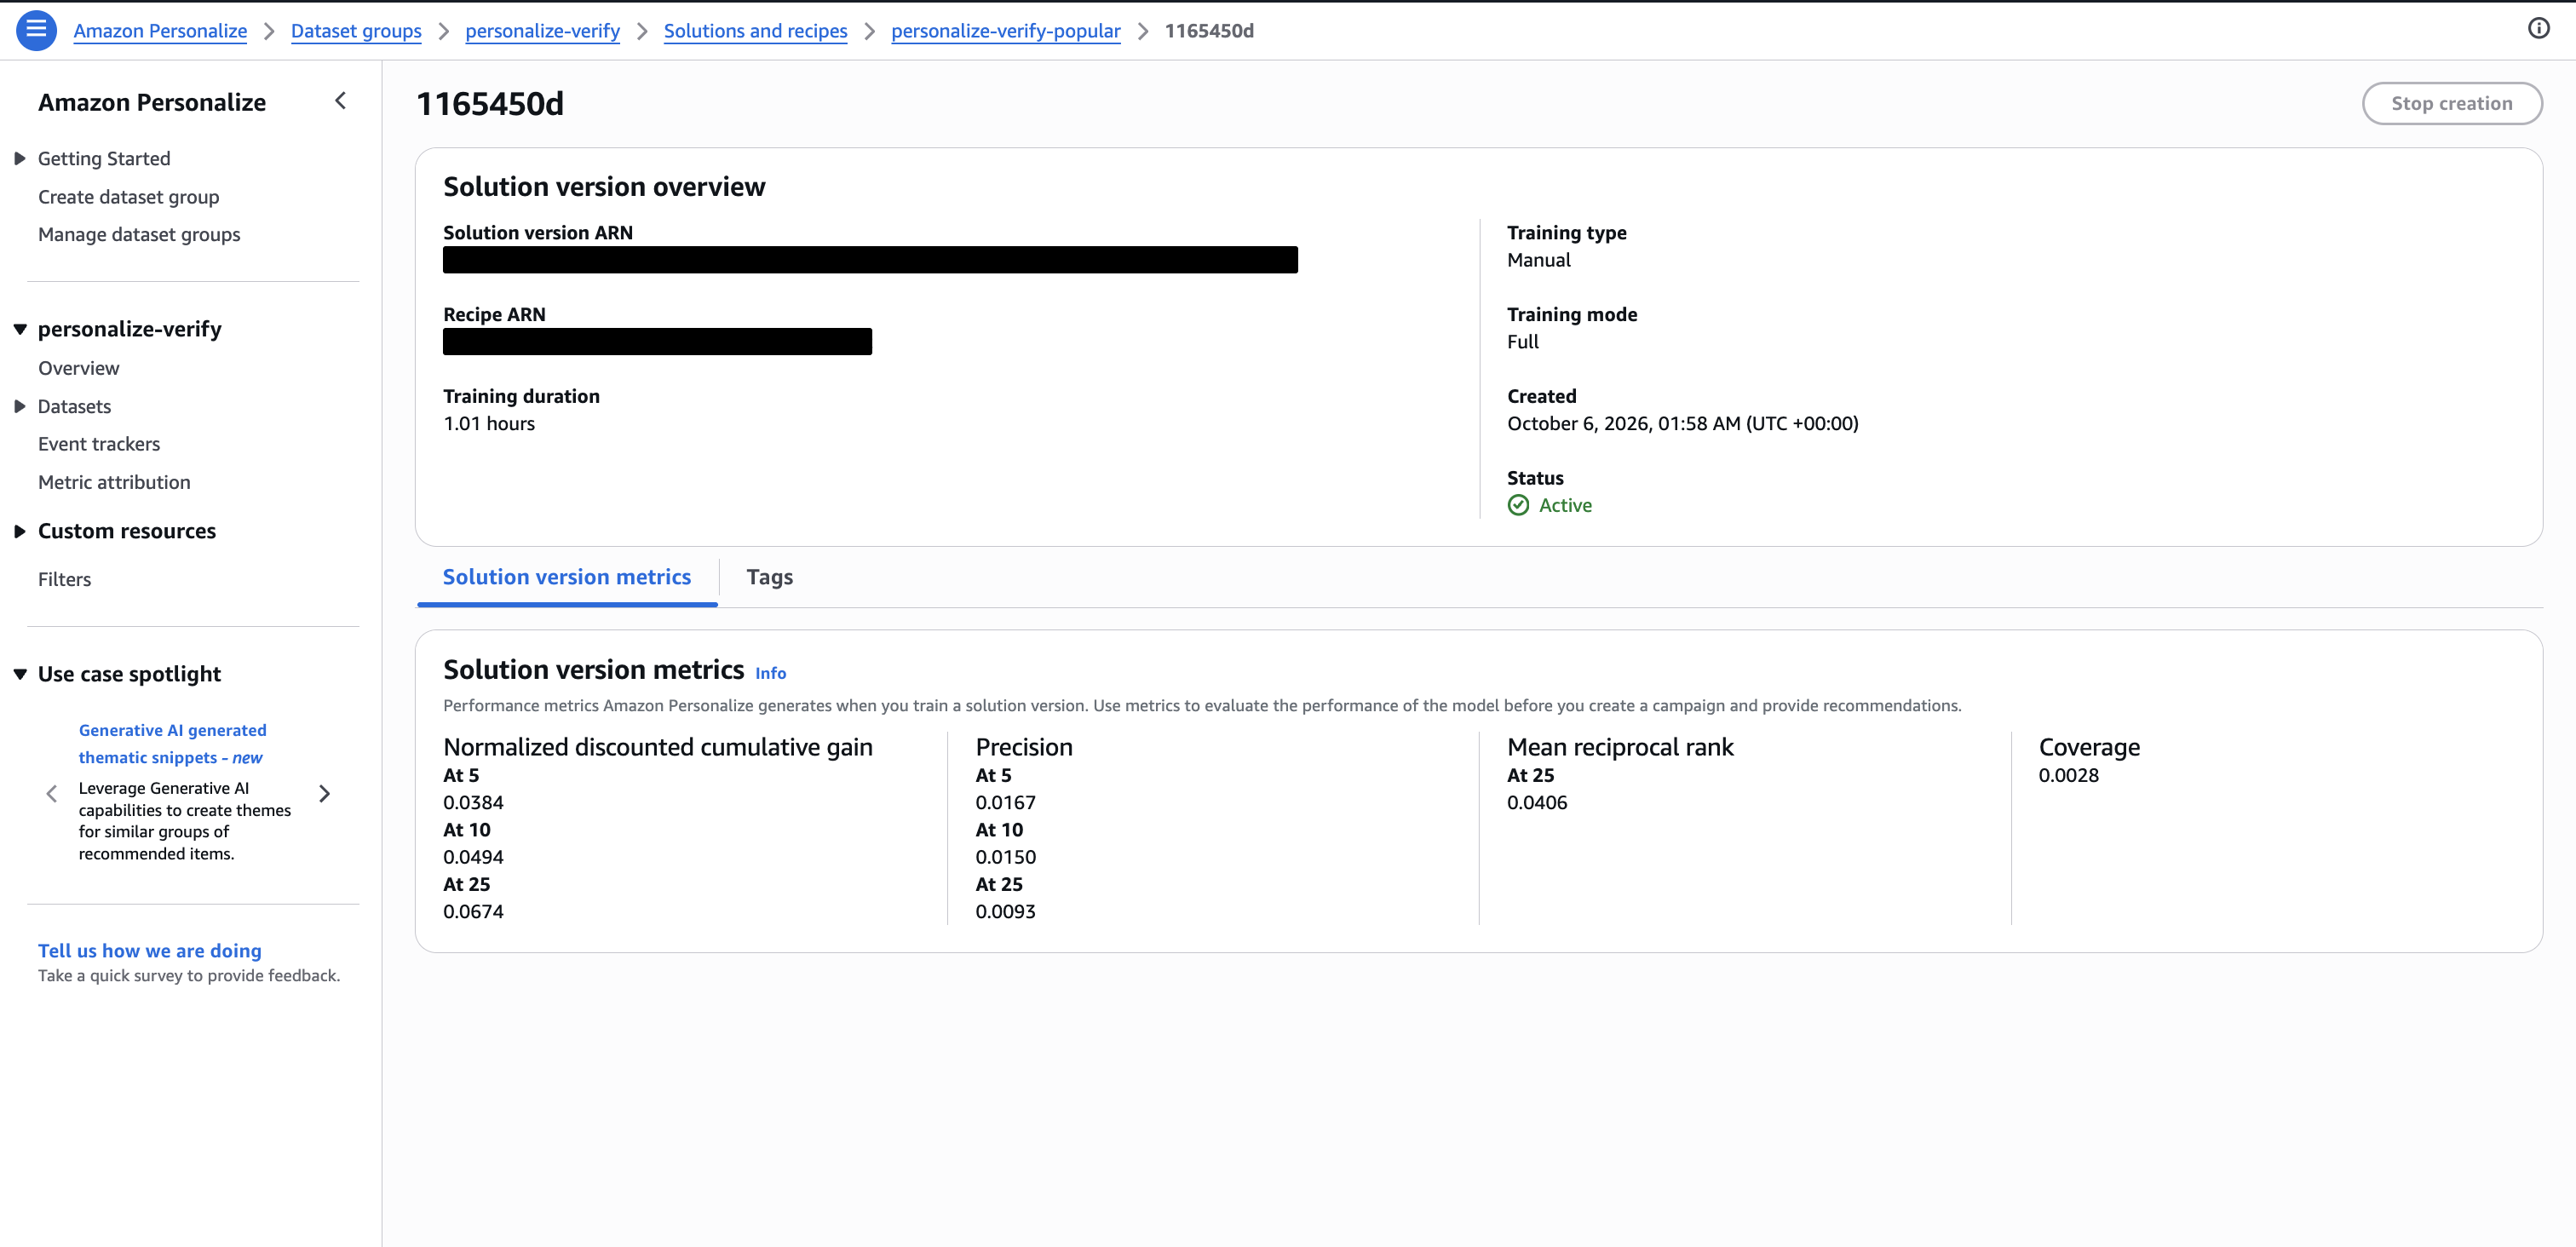
| User-Personalization-v2 | Similar-Items | Popularity-Count | |
|---|---|---|---|
| 学習の実時間 | 55分 | 44分 | 15分 |
| 課金 | 107,026件 × $0.002 / 1,000 = $0.21 | 3.85時間 × $0.24 = $0.92 | 1.01時間 × $0.24 = $0.24 |
| precision@10(上位10件の的中率) | 0.021 | 0.015 | 0.015 |
| NDCG@10(上位ほど重く見た的中度) | 0.111 | 0.050 | 0.049 |
| coverage(レコメンドに登場するアイテムの割合) | 0.038 | 0.037 | 0.003 |
User-Personalization-v2と人気順(Popularity-Count)を比べると、次のことが分かります。
- NDCG@10: 評価用に取り分けた実際の行動が、レコメンドの上位10件にどれだけ入っていたかを表す値で、上位で当たるほど高くなります。User-Personalization-v2は0.111で、人気順(0.049)の約2.3倍でした。全員に人気順を見せるより、ユーザーごとに出し分けたほうが、実際に反応するアイテムを言い当てられています
- coverage: 全アイテムのうち、誰かのレコメンドに1回でも出てきたアイテムの割合です。人気順は全員に同じアイテムを出すため0.003にとどまり、User-Personalization-v2は0.038で約13倍でした。ユーザーごとに違うアイテムを出しているので、レコメンドに登場するアイテムの幅が広がっています
5. フィルタで出し分ける
1つのItemsに映画とグッズが混ざっているので、そのままだとレコメンドにも両方が出てきます。そこで、モデルはそのままに、出すアイテムを絞るフィルタを4つ作りました。
アプリ側で結果を絞り込むこともできますが、たとえば上位50件を受け取ってからグッズだけを残すと、映画が混ざっていた分だけ件数が減ってしまいます。Amazon Personalizeのフィルタなら、条件に合うアイテムの中から指定した件数を返してくれます。また、フィルタはモデルとは別に作るので、出し分けの条件を変えても再学習は要りません。
aws personalize create-filter --name same-work-goods --dataset-group-arn <データセットグループARN> \
  --filter-expression 'INCLUDE ItemID WHERE Items.ITEM_TYPE IN ("goods") AND Items.WORK_ID IN CurrentItem.WORK_ID'
| フィルタ | 式 | 用途 |
|---|---|---|
| goods-only | INCLUDE ItemID WHERE Items.ITEM_TYPE IN ("goods") |
グッズだけを出す |
| movie-only | INCLUDE ItemID WHERE Items.ITEM_TYPE IN ("movie") |
映画だけを出す |
| same-work-goods | INCLUDE ItemID WHERE Items.ITEM_TYPE IN ("goods") AND Items.WORK_ID IN CurrentItem.WORK_ID |
入力した作品と同じ作品のグッズだけを出す |
| exclude-purchased | EXCLUDE ItemID WHERE Interactions.EVENT_TYPE IN ("purchase") |
購入済みのものを除く |
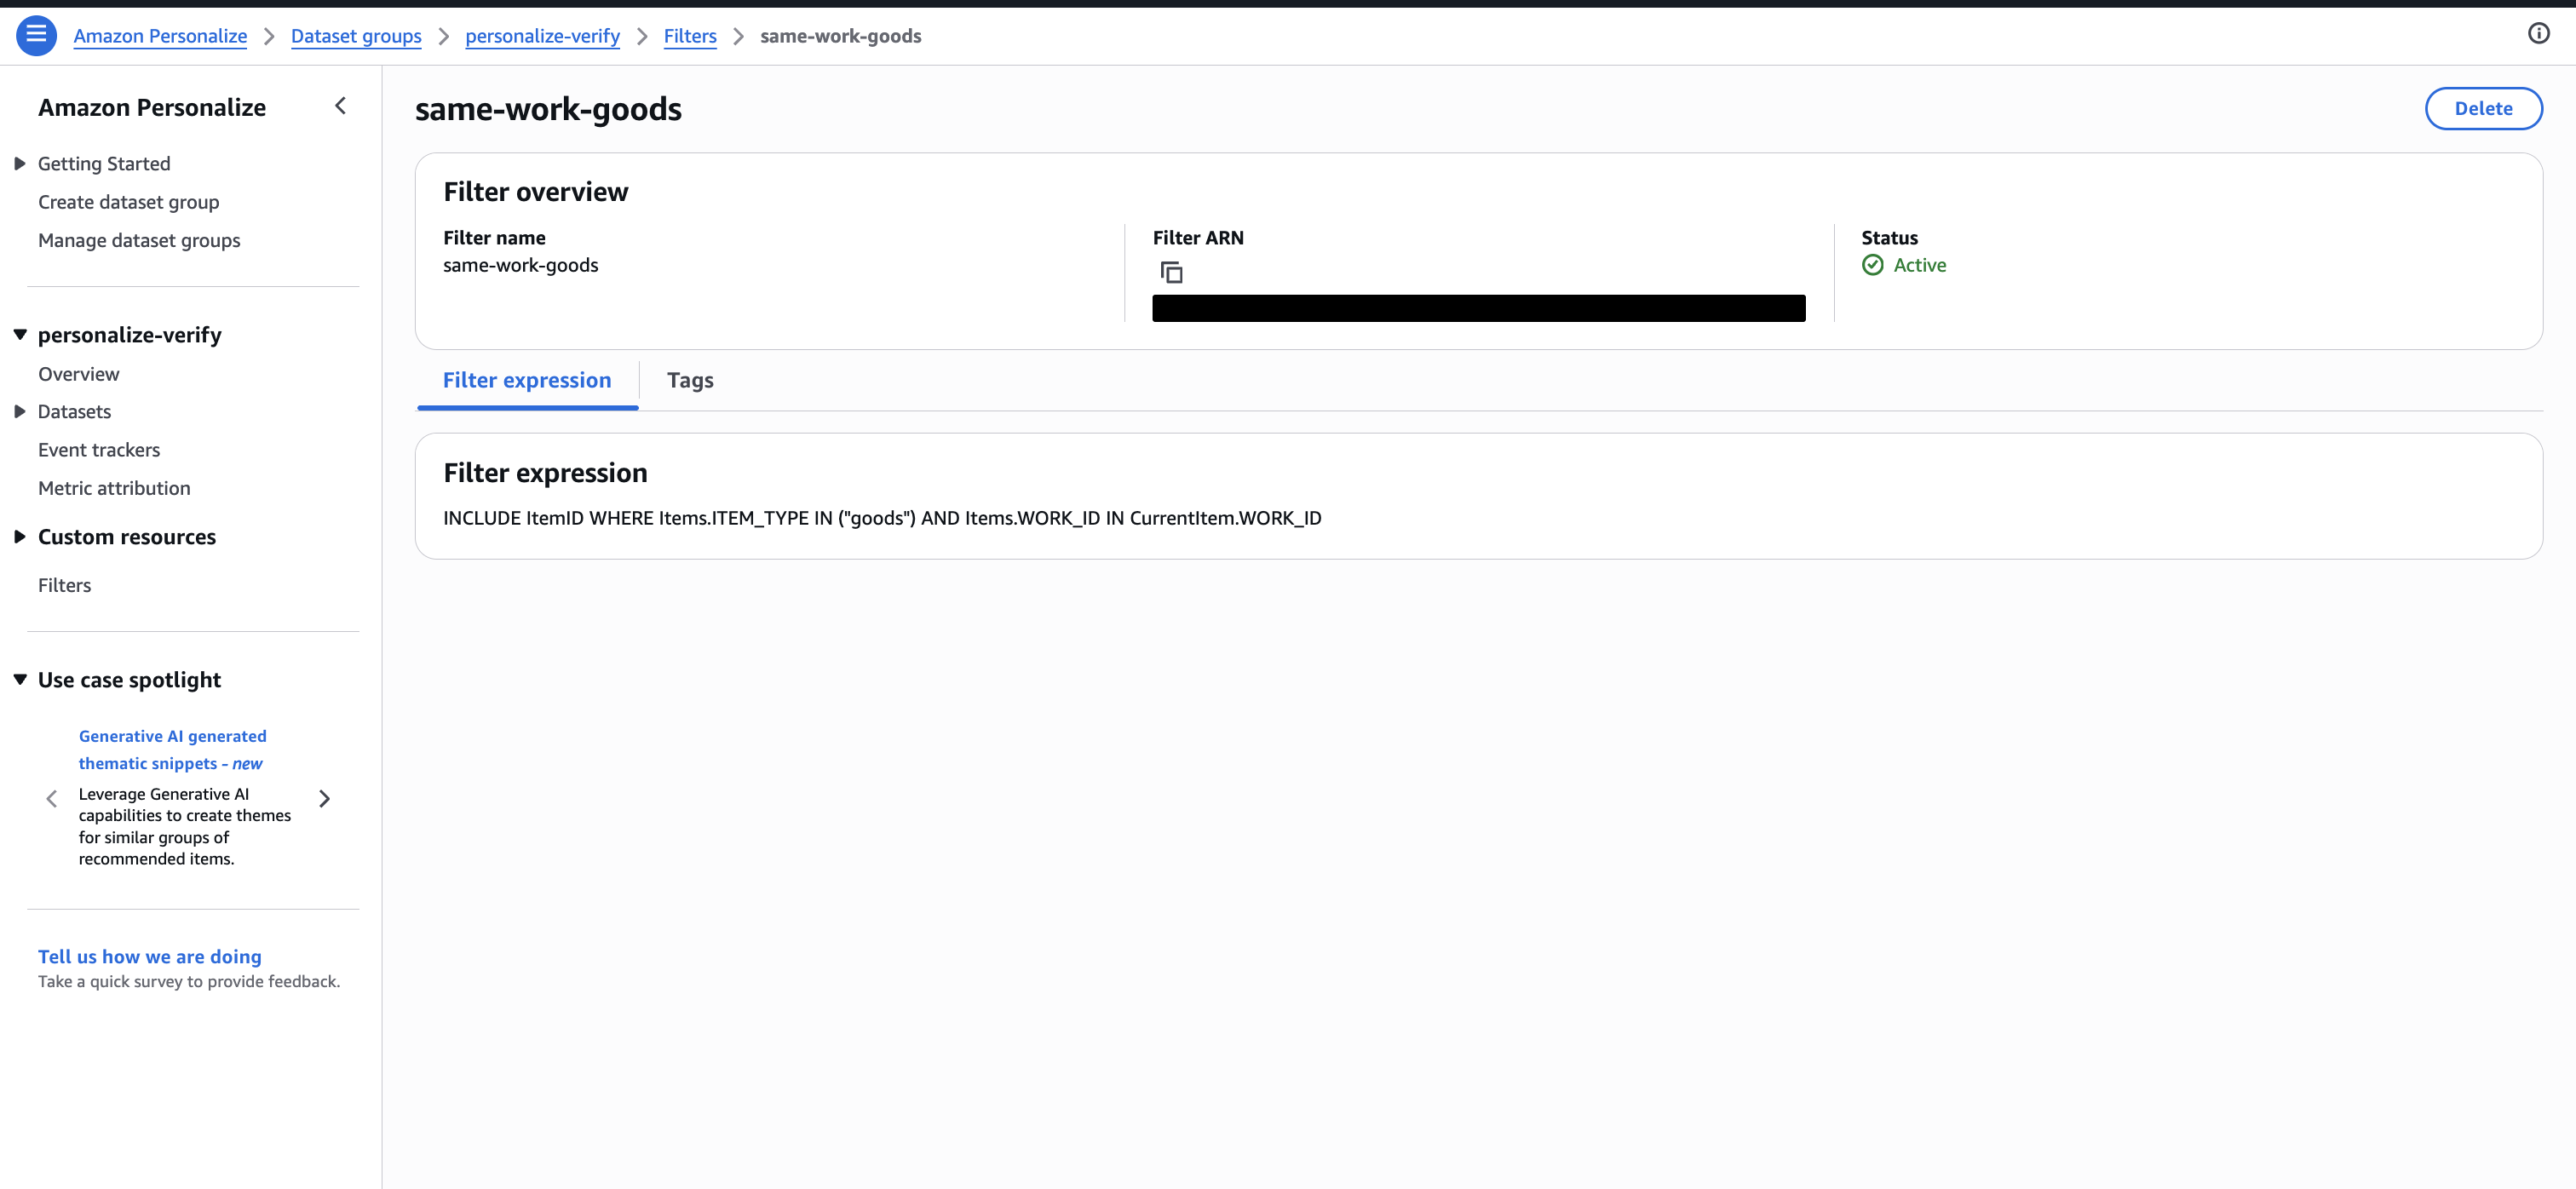
CurrentItemは、Similar-Itemsのように「このアイテムに似たもの」を聞くときに、いま渡したアイテムを指します。映画のIDを渡せば、WORK_IDが一致するグッズ、つまりその作品のグッズだけが返ります。
6. バッチ推論でレコメンドを作る
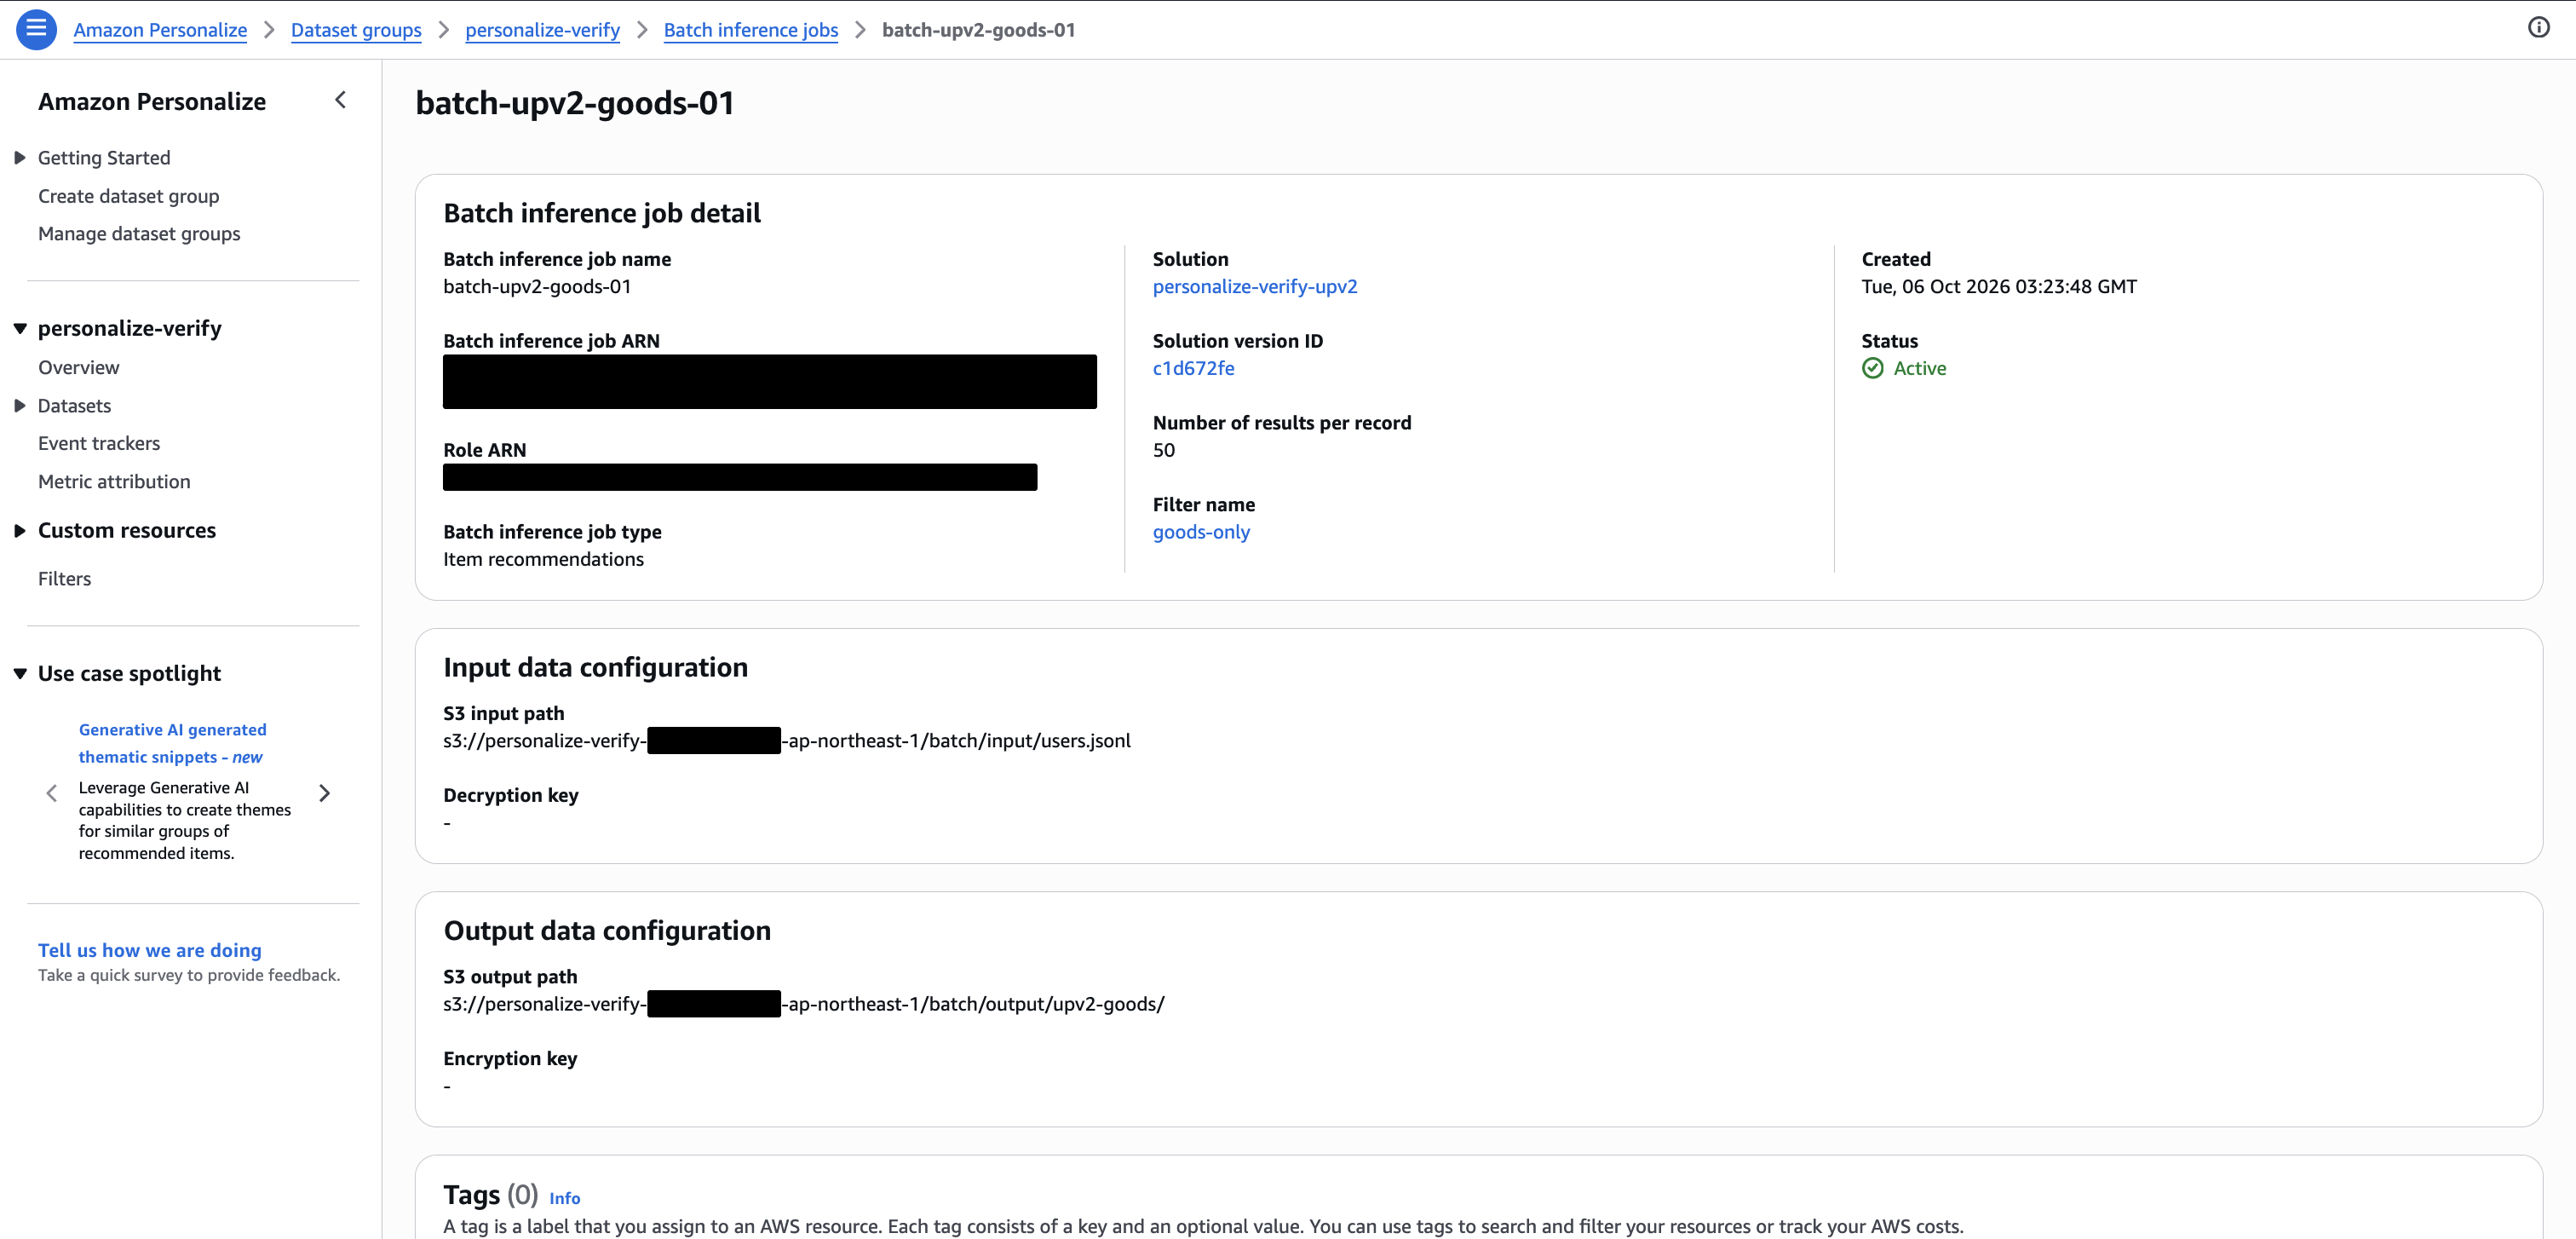
本命のバッチ推論です。User-Personalization-v2の場合、バッチ推論ジョブには次の条件を指定しました。
- 使うモデル: User-Personalization-v2のソリューションバージョン
- フィルタ: goods-only(グッズだけを出す)
- 1人あたりのレコメンドの件数: 今回は50件。表示のたびに10件を選び直すための候補にするため、多めに取っています
- 入力と出力の場所: 入力するユーザーIDの一覧と、結果を書き出すS3のパス
バッチ推論では、「誰の分のレコメンドを計算するか」をユーザーIDの一覧で渡します。行動データではなく、計算してほしい相手の名簿です。JSON Lines形式でS3に置きます。
{"userId": "1"}
{"userId": "2"}
aws personalize create-batch-inference-job --job-name batch-upv2-goods-01 \
  --solution-version-arn <upv2のソリューションバージョンARN> \
  --filter-arn <goods-onlyのARN> --num-results 50 --role-arn <ロールARN> \
  --job-input s3DataSource={path=s3://<バケット>/batch/input/users.jsonl} \
  --job-output s3DataDestination={path=s3://<バケット>/batch/output/upv2-goods/}
3つのモデルでそれぞれバッチ推論を実行しました。
| ジョブ | 入力 | 所要 | 課金 |
|---|---|---|---|
| User-Personalization-v2 × goods-only × 50件 | 610ユーザー | 15.5分 | $0.09 |
| Similar-Items × same-work-goods × 20件 | 9,742作品 | 12分 | $0.65 |
| Popularity-Count × goods-only × 50件 | 610ユーザー | 11.5分 | $0.04 |
小さなデータでも1ジョブ10分以上かかりました。日次で回す場合は、この時間を見込んでスケジュールを組む必要がありそうです。出力は入力ファイル名に.outが付いたJSON Linesで、ユーザーごとにレコメンドのアイテムとスコアが並びます。
{"input":{"userId":"1"},"output":{"recommendedItems":["gd_3230","gd_3017","gd_551", ...],"scores":[0.0451986, ...],"reason":[...]},"error":null}
カタログ横断の結果
検証の本題です。グッズの行動が1件もなく、映画の行動しかないユーザー427人について、User-Personalization-v2のバッチ推論の結果を確認しました。あわせて、Similar-Itemsで「この作品のグッズ」を出せるかも確認しています。
| 確認したこと | 結果 |
|---|---|
| 映画の行動しかない427人に、グッズのレコメンドが返るか | 427人全員に、グッズだけが50件ずつ、スコア付きで返った |
| 人気順と同じものばかりになっていないか | 上位10件のうち、人気順の上位10件と同じグッズは平均0.9件(9%)だけだった |
| 一人ひとりに違うグッズが出ているか | 427人の上位10件に出てきたグッズは、合わせて693種類あった。人気順だと全員が同じ10件になる |
| 作品から、その作品のグッズを出せるか | Similar-Itemsにsame-work-goodsのフィルタを付けると、グッズのある2,761作品すべてで、同じ作品のグッズだけが返った |
グッズを一度も見たことがないユーザーにも、映画の行動をもとに個人化されたグッズのレコメンドが返りました。カタログ横断のレコメンドは仕組みとして成り立っています。
一方で、レコメンドの中身を見ていくと、Sci-Fi / Action / Horrorを好むユーザーにファミリー作品のグッズが上位に来ている例がありました。上位10件のうち、ユーザーがよく高評価するジャンル上位3つに合うグッズの割合を比べると、User-Personalization-v2で0.88、人気順で0.80と、差は小さめでした。
調べてみると、原因は合成データの作り方にありました。グッズの購入行動を、評価数の多い有名作品を中心に作っていたため、買われているグッズの多くがファミリー作品のものになっていたのです。このモデルは、好みが似たユーザーが買ったものを上に出します。買われているグッズがそもそも偏っていると、映画の好みよりも「よく買われているグッズ」のほうが優先されてしまいます。
つまり、カタログ横断のレコメンドの質は、レコメンドされる側(今回はグッズ)の行動データがどれだけ幅広く集まっているかに左右されます。この点は「8. リアルタイム推論と比べる」でもう一度確かめます。
7. DynamoDBに載せて配信する
バッチ推論の結果は、S3上のファイルとして出力されます。アプリがレコメンドを表示するたびにこのファイルを読むと遅いため、ユーザーIDですぐに引けるDBに入れ直しておく必要があります。格納先は、使い方に合わせて選びます。
| 格納先の選択肢 | 向いている場面 |
|---|---|
| DynamoDB | ユーザーIDで引くだけのシンプルな参照。サーバーレスで運用が軽い |
| Aurora / RDS | 既存の商品マスタと結合して、在庫や価格の条件で出し分けたい場合。LOAD DATA FROM S3などでS3から直接ロードできる |
| S3を直接読む | 表示のたびにファイルを読むことになり遅いため、配信には向かない |
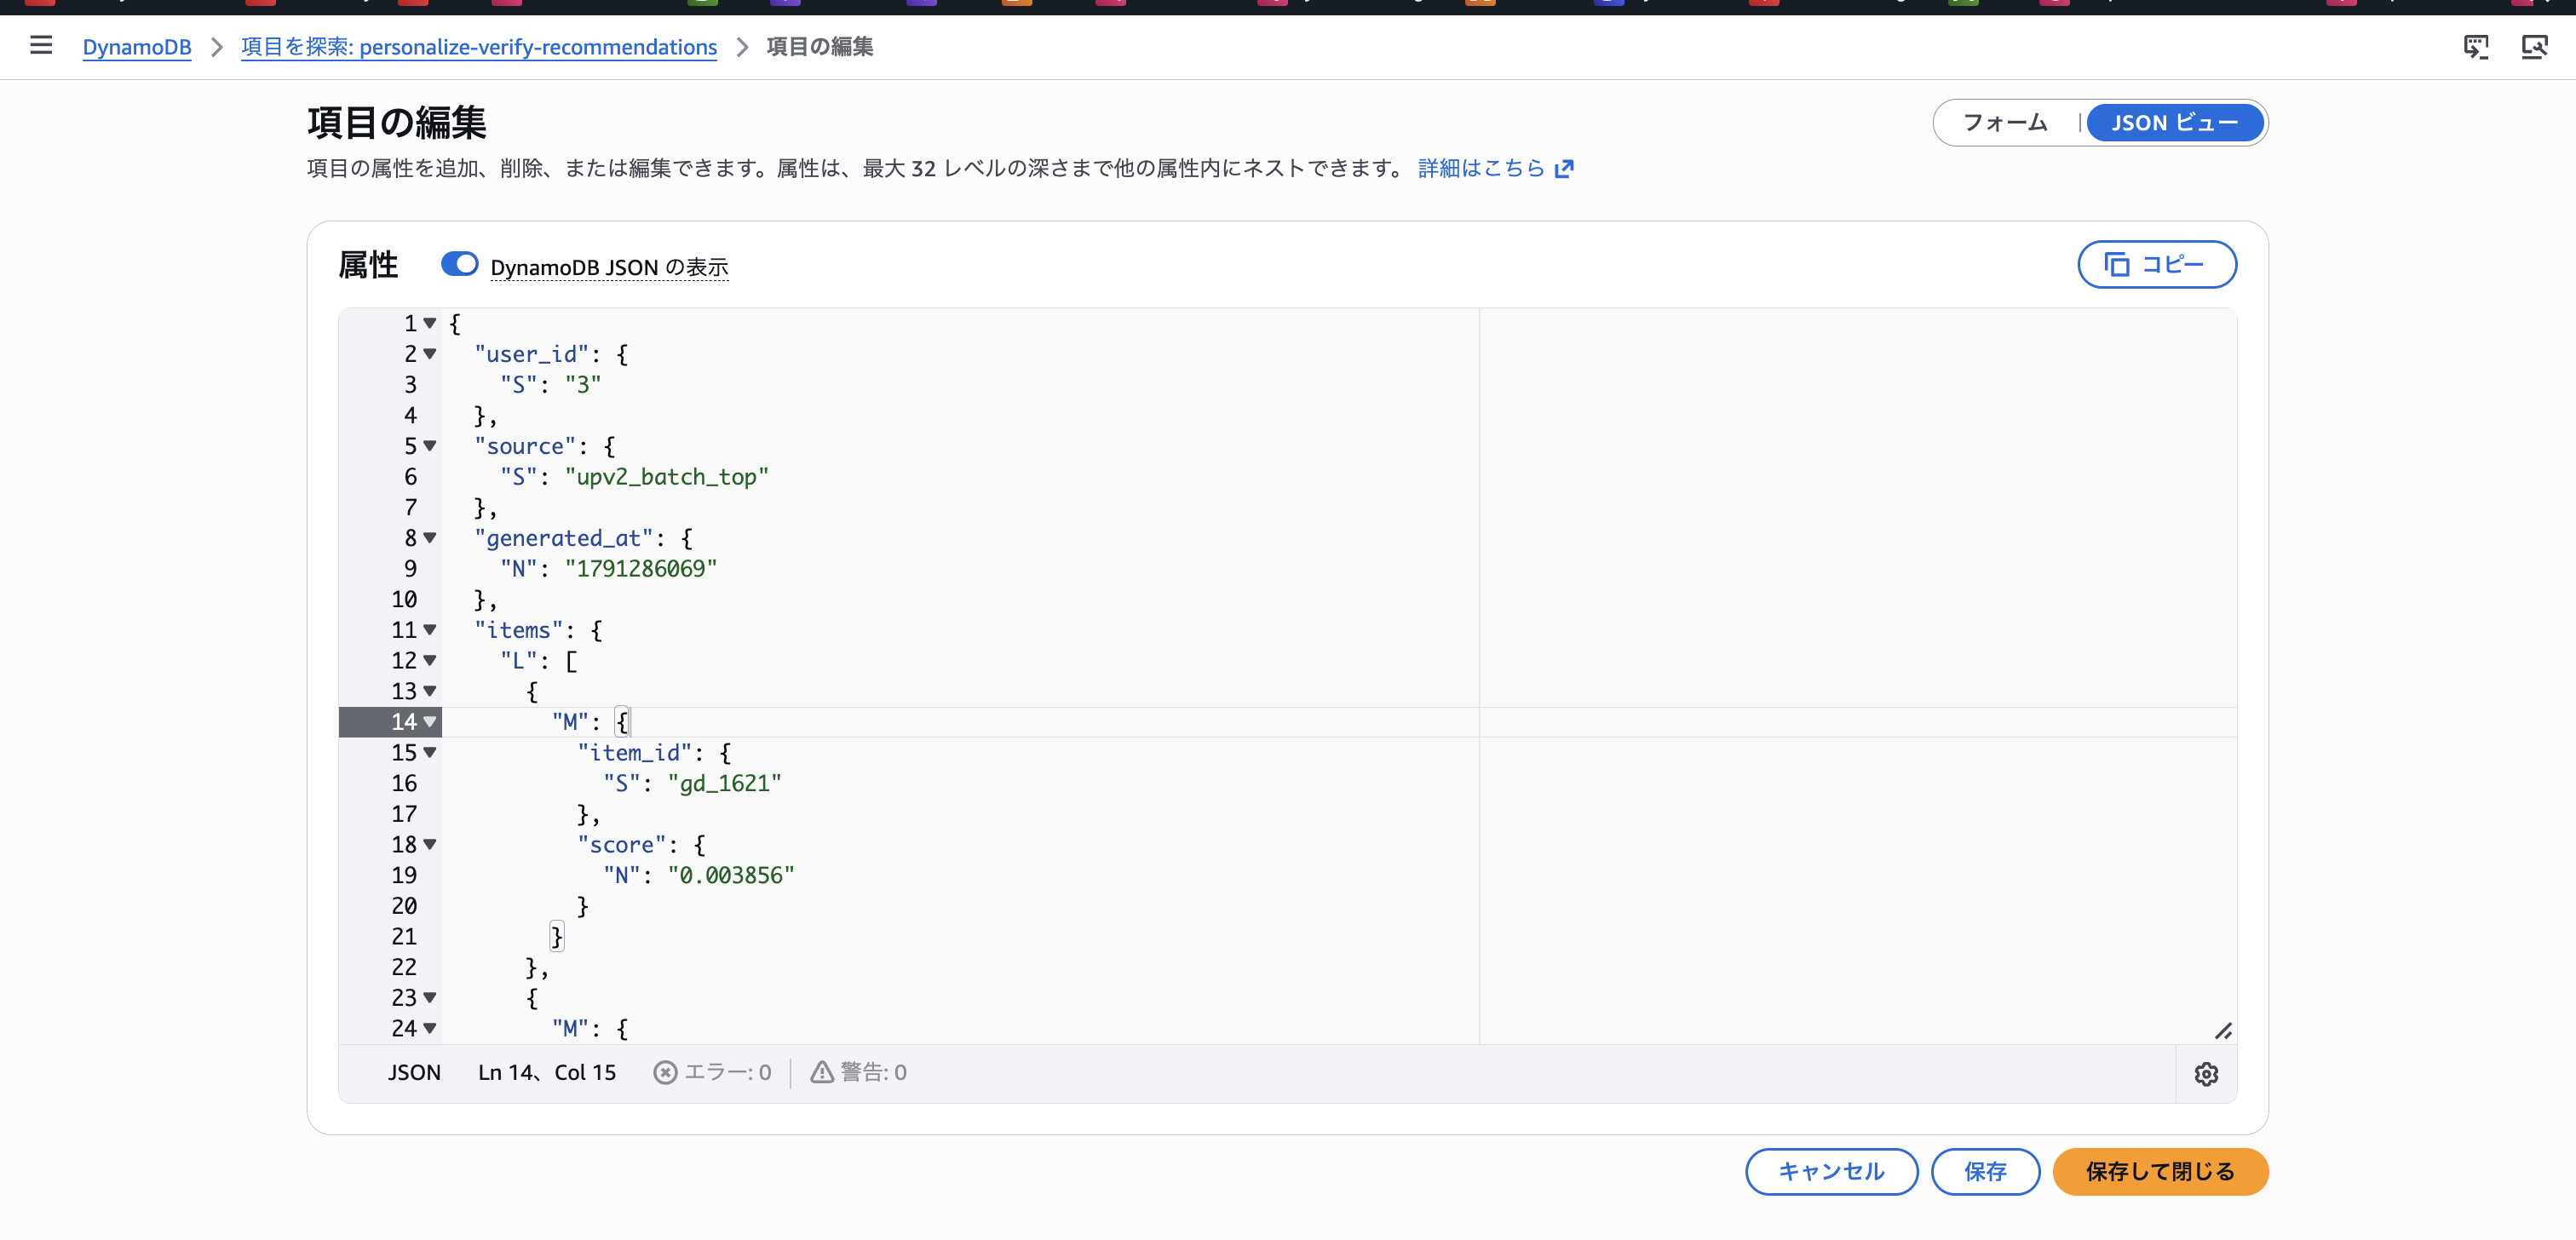
今回は「ユーザーIDで引くだけ」なのでDynamoDBを選び、次の形で格納しました。
- パーティションキー:
user_id - ソートキー:
source(どのモデルの結果か。例:upv2_batch_top) - 値: レコメンドするアイテムIDとスコアの一覧(1人50件)
{
  "user_id": "3",
  "source": "upv2_batch_top",
  "items": [
    { "item_id": "gd_1621", "score": 0.003856 },
    { "item_id": "gd_545", "score": 0.0034577 },
    { "item_id": "gd_761", "score": 0.0030942 },
    ...
  ]
}
今回は、S3の出力ファイルを読んでDynamoDBに書き込むスクリプトを、手動で1回実行しました。実際の運用では、バッチ推論ジョブの完了をきっかけにS3の出力を読み込み、DBへ書き込むデータパイプラインを設計する必要があります。
「1日中同じレコメンド」を避ける
バッチ推論の結果は、次にジョブを実行するまで変わりません。DBの値をそのまま表示すると、ユーザーがページを何度開いても、1日中同じレコメンドが並びます。
まず、Amazon Personalizeの機能で入れ替えられないかを確認しました。
| 機能 | バッチ推論の結果の入れ替えに使えるか |
|---|---|
| exploration(行動の少ない新しいアイテムを混ぜる) | User-Personalization-v2では自動で制御されていて、強さを調整できない |
| Promotions(結果の一定割合を、条件に合うアイテムで埋める) | リアルタイム推論でしか使えない |
| フィルタ | 条件で絞り込むだけで、ランダムに入れ替える機能はない |
どれも使えなかったため、配信側で入れ替える仕組みを作りました。考え方は次のとおりです。
- バッチ推論では、表示する10件より多い50件を、候補として取っておく
- 表示のたびに、50件の中から10件をランダムに選ぶ。ただし、スコアが高いものほど選ばれやすくする
- 選ぶ結果は15分ごとに変わるようにする。15分間は同じ並びのままなので、ページを開き直すたびにばらばらに変わることはない
10件の選び方
候補にはそれぞれ「選ばれやすさ」を表す重みを付け、重みが大きいものほど選ばれやすくなるようにランダムに選びます。重みが大きい順に上から10件を取るわけではありません。重みが小さい候補も、確率は低いものの選ばれることがあるので、表示のたびに顔ぶれが変わります。以下では、この選び方を「抽選」と呼びます。
重みは、スコアをα乗した値(weight = score ^ α)にしました。αは、スコアの差をどれだけ選ばれやすさの差に反映させるかを決める値です。たとえば、スコアが0.04と0.004の2つの候補から1つを選ぶ場合は、次のようになります。
| α | 重み | 選ばれやすさ |
|---|---|---|
| 0 | 1と1 | スコアに関係なく同じ(完全なランダム) |
| 1 | 0.04と0.004 | スコアが高いほうが10倍選ばれやすい |
| 2 | 0.0016と0.000016 | スコアが高いほうが100倍選ばれやすい(ほぼスコア順と同じ) |
αを大きくするほどスコア順の固定表示に近づき、小さくするほど入れ替わりが大きくなります。
抽選は、重み付きのランダム抽出でよく使われる方法で実装しています(下のコードのweighted_sample)。候補ごとに0〜1の乱数uを引いてu ^ (1 / weight)を計算し、この値が大きい順に10件を取ります。重みが大きいほどこの値は1に近づきやすいので、選ばれやすくなります。
15分ごとに変わる動きは、乱数の種を「ユーザーID + 15分ごとの時間の区切り」にすることで作っています。同じ区切りの中では同じ乱数になるので、結果も同じになります。
def weighted_sample(rng, cands, weights, n):
    keys = [(rng.random() ** (1.0 / w), c) for c, w in zip(cands, weights)]
    return [c for _, c in sorted(keys, key=lambda t: -t[0])[:n]]

def pick(user_id, cands, scores, n=10, alpha=1.0, interval_sec=900, now=None):
    bucket = int((now or time.time()) // interval_sec)
    rng = random.Random(f"{user_id}:{bucket}")
    floor = min(s for s in scores if s) if any(scores) else 1.0
    weights = [((s or floor) ** alpha) if alpha > 0 else 1.0 for s in scores]
    return weighted_sample(rng, cands, weights, n)
αによってどれくらい変わるかを、ユーザー1の実際の候補50件で確かめました。αごとに2,000回抽選し、次の4つの値を出しています。
- 1位が出る確率: スコア1位のアイテムが、表示する10件に入る確率
- 20位が出る確率: スコア20位のアイテムが、表示する10件に入る確率
- 入れ替わり: 抽選をやり直すたびに、10件のうち平均何件が前回と変わるか
- 表示したスコアの合計: 上位10件を固定で出したときのスコアの合計を100%として、抽選で選んだ10件のスコアの合計が何%になるか。レコメンドの質の目安
| α | 1位が出る確率 | 20位が出る確率 | 入れ替わり(10件中) | 表示したスコアの合計 |
|---|---|---|---|---|
| 0 | 20% | 19% | 8.0件 | 44% |
| 1 | 78% | 16% | 7.2件 | 71% |
| 1.5 | 97% | 16% | 6.3件 | 82% |
| 2 | 100% | 2% | 1.2件 | 99% |
α=0は完全なランダムなので、入れ替わりは一番大きくなります。その代わり、表示したスコアの合計は、上位10件を固定で出す場合の半分以下まで下がります。反対にα=2ではほぼスコア順のままで、ほとんど入れ替わりません。
入れ替わりを増やすほどレコメンドの質は下がるので、どこで折り合いを付けるかを決める必要があります。今回のデータでは、α=1〜1.5あたりがちょうどよいバランスでした。また、15分の区切りをまたいだときに、10件中5件が入れ替わることも確認できました。
入れ替えのロジックは配信APIに置く
今回の構成で一番のポイントだと考えているのが、この入れ替えのロジックを置く場所です。Amazon Personalizeにもアプリにも置かず、DBとアプリの間に挟む配信APIに置くのがよいと考えています。
バッチ推論 → S3 → DynamoDB(1人50件の候補) → 配信API(重み付き抽選で10件を選ぶ) → アプリ
配信APIに置くと、次のことができます。
- アプリをリリースし直さずに調整できる: αや入れ替えの間隔を変えても、変更は配信APIだけで済みます。表示の調整のたびにアプリのリリースを待つ必要がありません
- Amazon Personalize側をやり直さずに済む: 入れ替えは候補50件の中で行うので、表示の仕方を変えても再学習やバッチ推論の再実行は要りません
- 効果測定のラベルを同じ場所で付けられる: 「どのレコメンド元を、どの枠に表示したか」のラベルも配信APIで付けます。このラベルは、後半の効果測定でそのまま使います
8. リアルタイム推論と比べる
ここまではバッチ推論で配信してきました。比較として、表示のたびに計算するリアルタイム推論も試しました。
確かめたかったのは、「6. バッチ推論でレコメンドを作る」で見えた「好みと合わないファミリー作品のグッズが上位に来る」問題が、本人の新しい行動で変わるかどうかです。
リアルタイム推論には、次の2つを作ります。
- キャンペーン: 学習したモデルを、常時起動のAPIとして公開したもの。アプリはユーザーIDを渡して、その場でレコメンドを受け取る
- イベントトラッカー: アプリから行動を1件ずつ、リアルタイムに送るための受け口
aws personalize create-campaign --name personalize-verify-upv2-rt \
  --solution-version-arn <upv2のソリューションバージョンARN> --min-provisioned-tps 1
aws personalize create-event-tracker --name personalize-verify-tracker \
  --dataset-group-arn <データセットグループARN>
試したのは、バッチ推論でファミリー作品のグッズが上位に来ていたユーザー3です。映画の行動しかなく、Sci-Fi / Action / Horrorの作品を好んで評価しています。手順は次のとおりです。
- ユーザー3のレコメンドを、グッズだけに絞って25件取得する
- ユーザー3がホラー作品のグッズを3つ見て、そのうち1つを買った、という4件の行動をPutEventsで送る
- 約4.5分後に、もう一度レコメンドを取得する
aws personalize-runtime get-recommendations --campaign-arn <キャンペーンARN> \
  --user-id 3 --num-results 25 --filter-arn <goods-onlyのARN>

aws personalize-events put-events --tracking-id <トラッキングID> --user-id 3 --session-id s3-rt-test \
  --event-list '[
    {"eventId":"e1","eventType":"product_view","itemId":"gd_2302","sentAt":<UNIX秒>},
    {"eventId":"e2","eventType":"product_view","itemId":"gd_2304","sentAt":<UNIX秒>},
    {"eventId":"e3","eventType":"product_view","itemId":"gd_1771","sentAt":<UNIX秒>},
    {"eventId":"e4","eventType":"purchase","itemId":"gd_2304","eventValue":3500,"sentAt":<UNIX秒>}
  ]'
行動を送る前と後の上位10件です。
| 順位 | 行動を送る前 | 行動を送った後(約4.5分後) |
|---|---|---|
| 1 | Muppet Christmas Carolのグッズ | Sawのグッズ |
| 2 | Home Aloneのグッズ | The Sixth Senseのグッズ |
| 3 | The Wizard of Ozのグッズ | Dawn of the Deadのグッズ |
| 4 | Mulanのグッズ | Die Hardのグッズ |
| 5 | Into the Woodsのグッズ | Rosemary's Babyのグッズ |
| 6 | Shrekのグッズ | Deep Impactのグッズ |
| 7 | The Rocky Horror Picture Showのグッズ | The Departedのグッズ |
| 8 | Mary Poppinsのグッズ | Sleepy Hollowのグッズ |
| 9 | E.T.のグッズ | The Cabin in the Woodsのグッズ |
| 10 | Scott Pilgrim vs. the Worldのグッズ | Interstellarのグッズ |
| 1位のスコア | 0.0039 | 0.0173 |
送る前はファミリー作品のグッズが並んでいましたが、送った後は上位10件がすべて入れ替わり、Horror / Thriller / Sci-Fiの作品のグッズが並びました。
- 送った後の10件はすべてTシャツでした。買ったのがTシャツだったことまで反映されています
- 1位のスコアは約4.5倍になりました。モデルがこのユーザーの好みをより確信できるようになったと読めます
バッチ推論で見えた問題は、本人のグッズの行動が数件入るだけで解消されました。カタログ横断のレコメンドでは、レコメンドされる側(グッズ)の行動をリアルタイムに送り込むことが、質にかなり効いてきそうです。
9. 新しい行動はバッチ推論にいつ効くか
バッチ推論で配信する場合、新しい行動がいつレコメンドに反映されるかで、日次の処理の組み方が変わります。公式ドキュメントによると、行動の入れ方によって反映のタイミングが違います。
- CSVで取り込んだ行動: 再学習するまで反映されない
- PutEventsで送った行動: User-Personalization系のレシピなら、約15分後から反映される
実際にそうなるかを確かめるため、同じ内容の行動をCSVとPutEventsで入れ分けて比べました。
確かめ方
対象にしたのは、これまでアニメーション作品をほとんど見ていないユーザーです。このユーザーにアニメーション作品の行動を入れて「急に好みが変わった」状態を作り、レコメンドにアニメーション作品のグッズが増えるかを見ます。入れ方ごとに、次のグループに分けました。
| グループ | 人数 | 入れたデータ |
|---|---|---|
| A | 20人 | アニメーション作品の映画の高評価と、そのグッズの行動(1人50件)をCSVで取り込む |
| B | 20人 | Aと同じ内容の行動を、PutEventsで送る |
| C | 20人 | 後半に、ホラー作品の行動をPutEventsで送る |
| 新規 | 5人 + 5人 | 学習した時点ではいなかったユーザー。Aと同じ内容の行動を、5人はCSV、5人はPutEventsで入れる |
推論はすべて、User-Personalization-v2のモデルとgoods-onlyのフィルタを使い、70人分のレコメンドを25件ずつ作りました。手順は次のとおりです。ドキュメントでは、バッチ推論はジョブを始める15分前までに入ったデータを使うとされているため、行動を送ってからバッチ推論を始めるまで16分空けています。
- 何も入れていない状態で、バッチ推論を実行する(推論①)
- A、B、新規の行動を入れ、16分待ってからバッチ推論を実行する(推論②)
- 再学習してから、バッチ推論を実行する(推論③)
- CにPutEventsで行動を送り、16分待ってからバッチ推論を実行する(推論④)
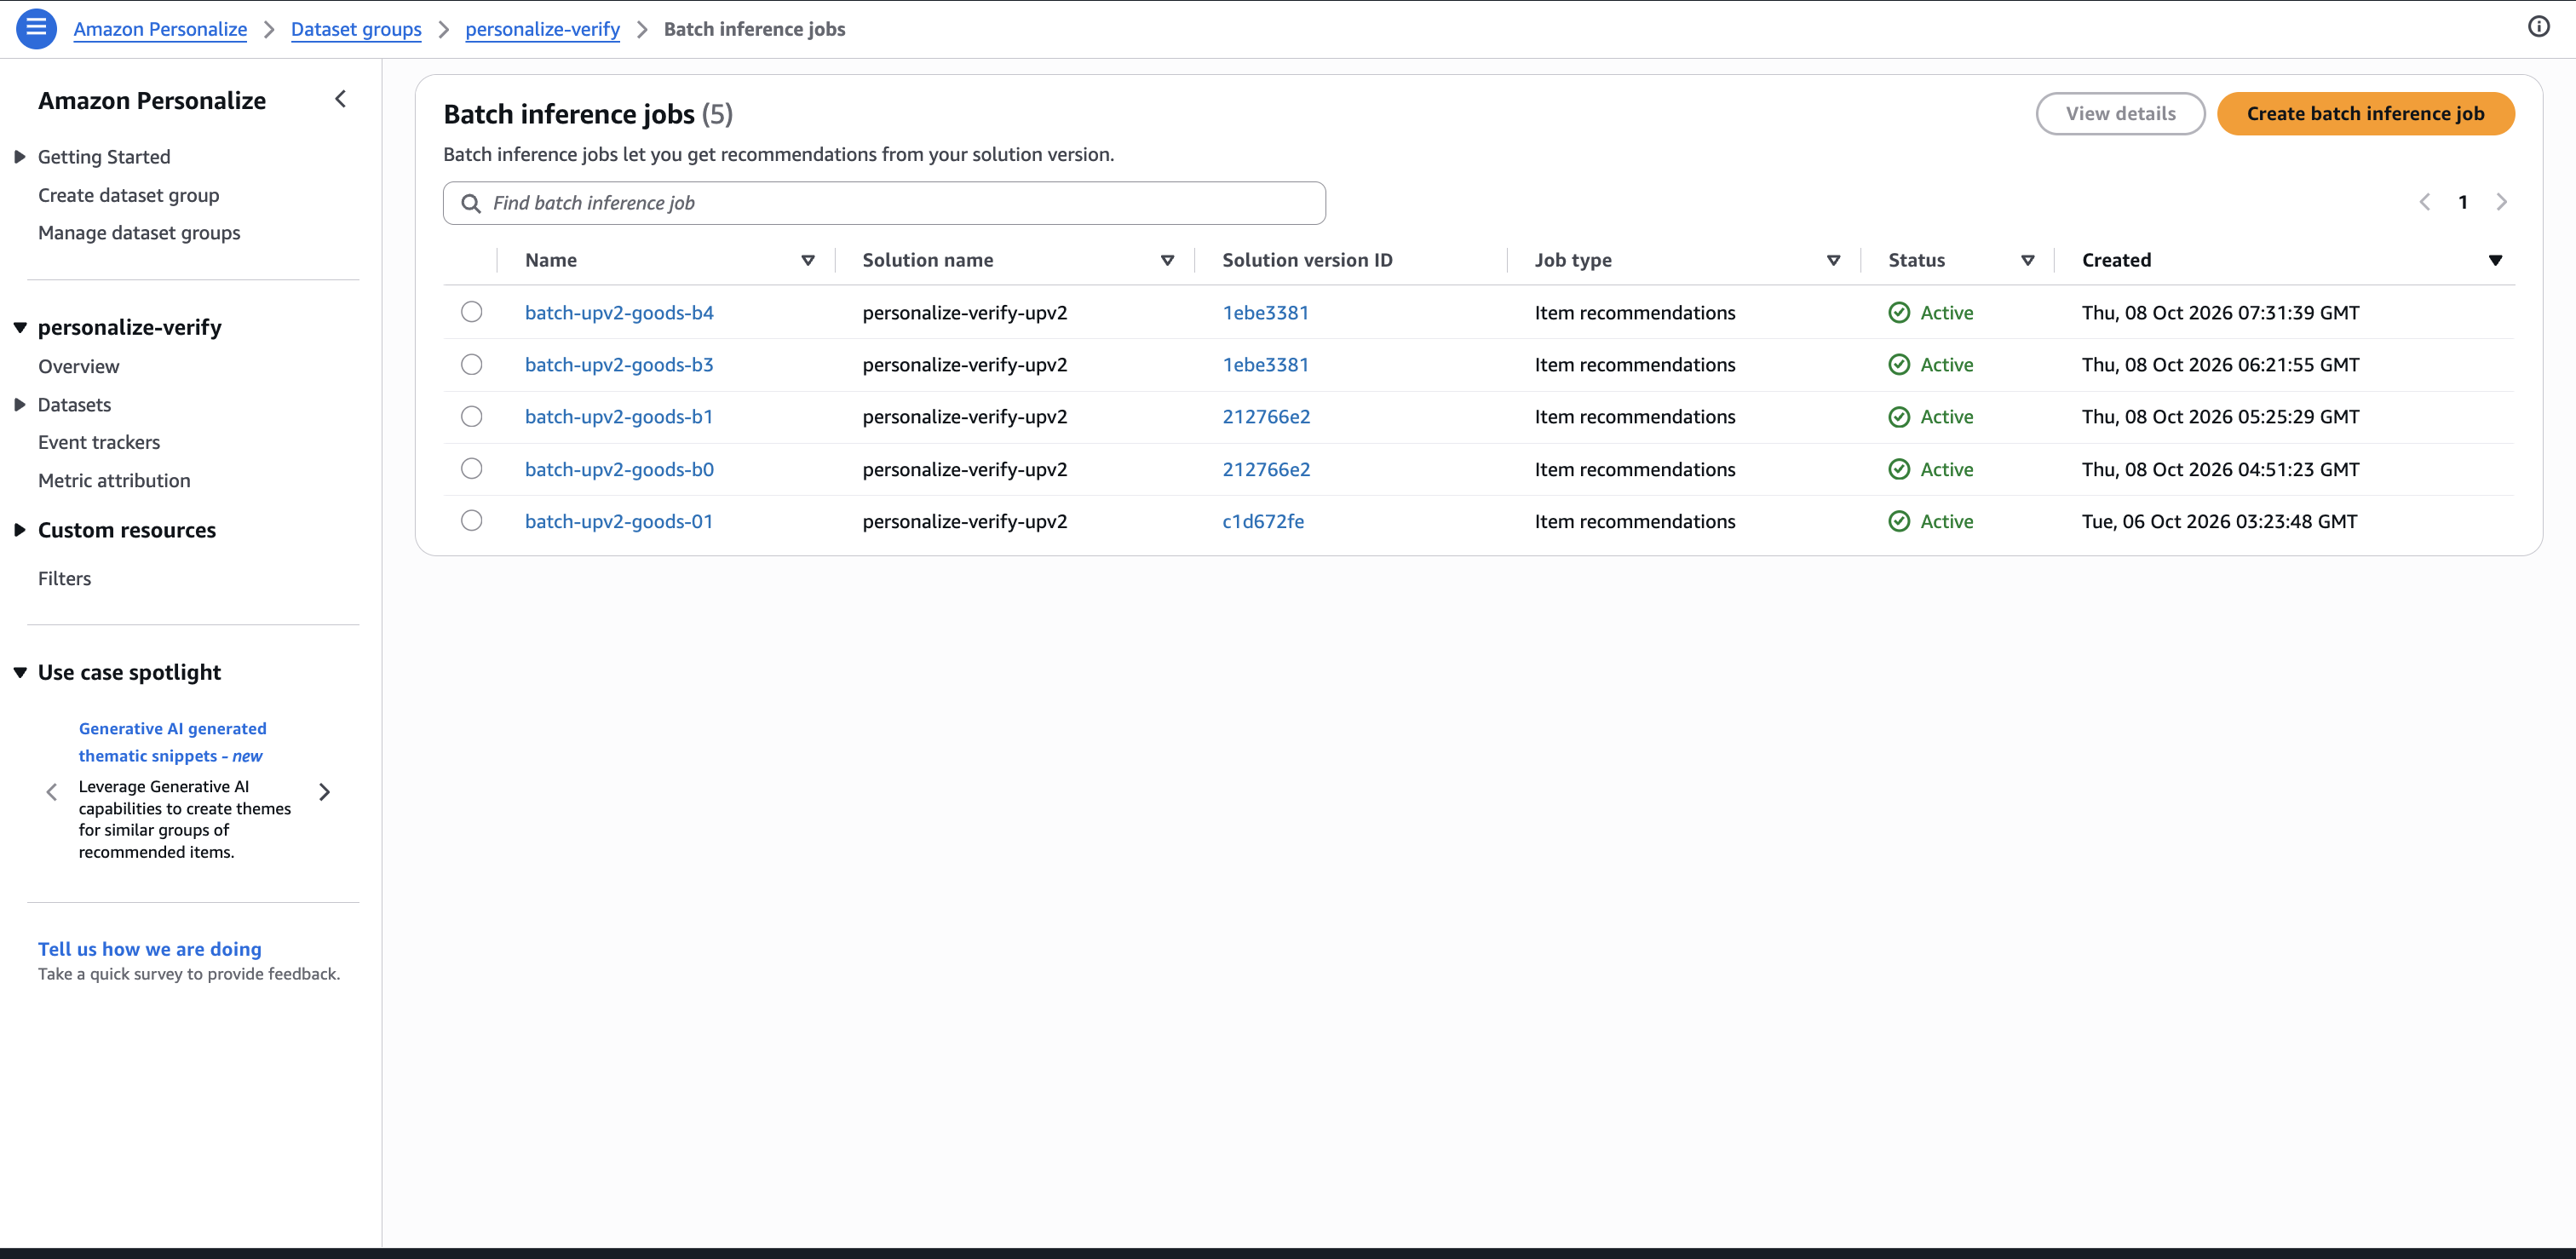
結果
レコメンド上位25件のうち、入れた行動のジャンル(Cはホラー、それ以外はアニメーション)のグッズが占める割合です。割合が上がっていれば、入れた行動がレコメンドに反映されたことになります。
| グループ | 推論① | 推論② 再学習なし | 推論③ 再学習後 | 推論④ 再学習なし |
|---|---|---|---|---|
| A(CSV) | 0.07 | 0.07 | 0.66 | 0.66 |
| B(PutEvents) | 0.06 | 0.06 | 0.02 | 0.02 |
| C(PutEvents) | — | — | 0.05 | 0.05 |
| 新規(CSV) | 0.12 | 0.12 | 0.91 | 0.91 |
| 新規(PutEvents) | 0.12 | 0.12 | 0.04 | 0.04 |
- CSV: 再学習するまでは変わらず、再学習すると大きく上がりました。ドキュメントのとおりです
- PutEvents(再学習なし): ドキュメントと違い、変わりませんでした。推論①→②のBも、推論③→④のCも、全員のレコメンドが順位とスコアまで同じでした
- PutEvents(再学習後): 再学習しても反映されませんでした。行動がデータセットに入っていることは、データセットのエクスポートで確認しています
バッチ推論で配信する場合、今回確実に新しい行動を反映できたのは「CSVで取り込んで再学習する」方法でした。日次の処理は、この順番で組むのが確実です。
10. レコメンドが生んだ行動を計測する
ここからは効果測定です。知りたいのは「どのレコメンドが、どれだけクリックや購入につながったか」です。
ただ、Amazon Personalizeは「何を見せるか」は決めてくれますが、見せた後にユーザーが何をしたかは、こちらから送らない限り分かりません。そこで、実際のサービスで行う次の流れを模擬しました。
- 配信APIがレコメンドを返すとき、「誰に、どの枠で、どのレコメンド元の結果を見せたか」を、表示ログとしてS3に書く
- ユーザーのクリック、カート追加、購入を、「どのレコメンド元から来たか」のラベル付きでPutEventsに送る。同じ内容をS3にも書く
- 送った行動を、Metric attributionがレコメンド元ごとに集計する
「どのレコメンドから来たか」の付け方
行動に「どのレコメンドから来たか」を付ける方法は、2通りあります。
| 付けるもの | 中身 | 今回 |
|---|---|---|
recommendationId |
リアルタイム推論のレスポンスに付くID。これを付けて送ると、どのキャンペーンのレコメンドかをAmazon Personalizeが判別する | 使わない。バッチ推論の結果には付かず、どの表示枠かも区別できない |
eventAttributionSource |
自由に決められる文字列。最大100種類 | 使う。レコメンド元_枠の形にした(例: upv2_batch_top) |
両方を付けた場合はeventAttributionSourceが優先されます。PutEventsでは、metricAttributionの中に入れて送ります。
personalize_events.put_events(
    trackingId=TRACKING_ID, userId="1", sessionId="s-1",
    eventList=[{
        "eventId": "...",
        "eventType": "purchase",
        "itemId": "gd_858",
        "eventValue": 2200.0,
        "sentAt": 1791285710,
        "metricAttribution": {"eventAttributionSource": "upv2_batch_top"},
    }])
模擬したデータ
DynamoDBに入れたバッチ推論の結果から、表示ログを1,320件作りました。レコメンド元は次の3つです。
| レコメンド元 | 想定 | 表示ログ |
|---|---|---|
upv2_batch_top |
個人化モデル(User-Personalization-v2)を、トップの枠に表示 | 610件 |
popular_batch_top |
人気順(Popularity-Count)を、トップの枠に表示 | 610件 |
thirdparty_detail |
他社のレコメンドを、商品詳細の枠に表示 | 100件 |
この表示に対して、レコメンド元ごとにクリック率を変えて、クリック、カート追加、購入の行動を2,406件作り、PutEventsで送りました。比較のため、ラベルなし(レコメンドを経由していない)の購入も混ぜています。
表示ログ・行動ログの1行
{"ts": 1791286074, "user_id": "1", "placement": "top", "source": "upv2_batch_top", "recommendation_id": null, "item_ids": ["gd_238", "gd_4580", "gd_3230", ...]}
{"event_id": "4ef9952b-...", "user_id": "1", "session_id": "s-1-2026-10-06", "event_type": "click", "item_id": "gd_858", "sent_at": 1791285710, "event_value": null, "event_attribution_source": "popular_batch_top"}
集計結果
Metric attributionの集計結果は、CloudWatchのメトリクスとして出力されます。レコメンド元ごとに分かれて表示されました。
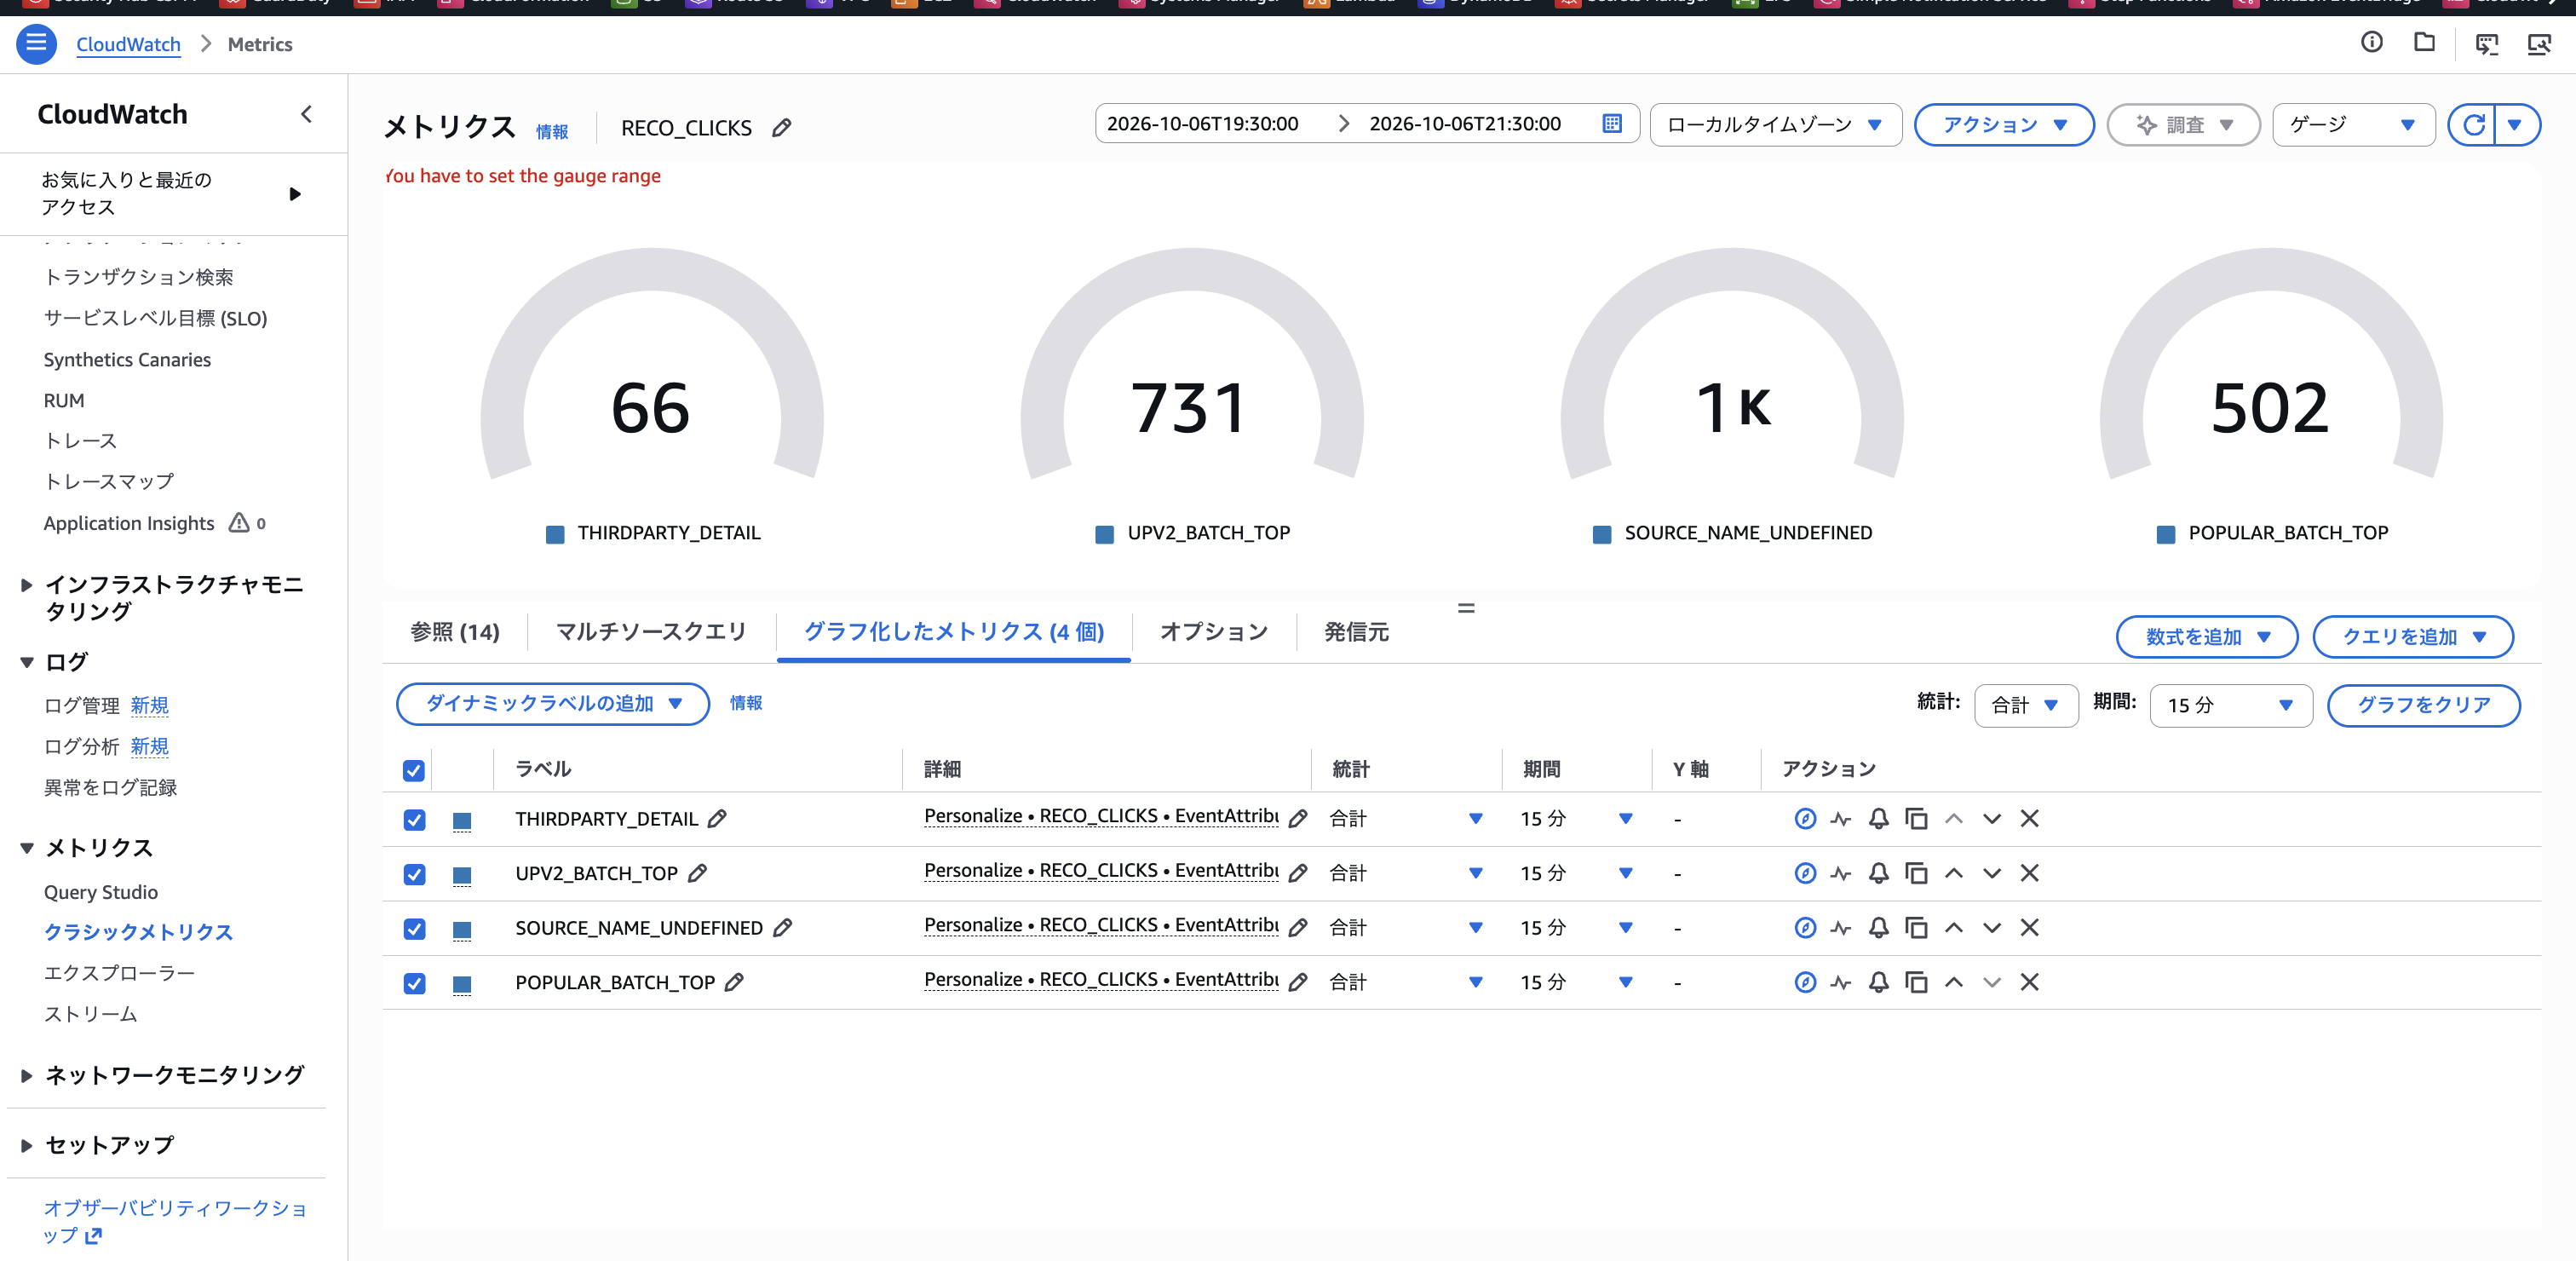
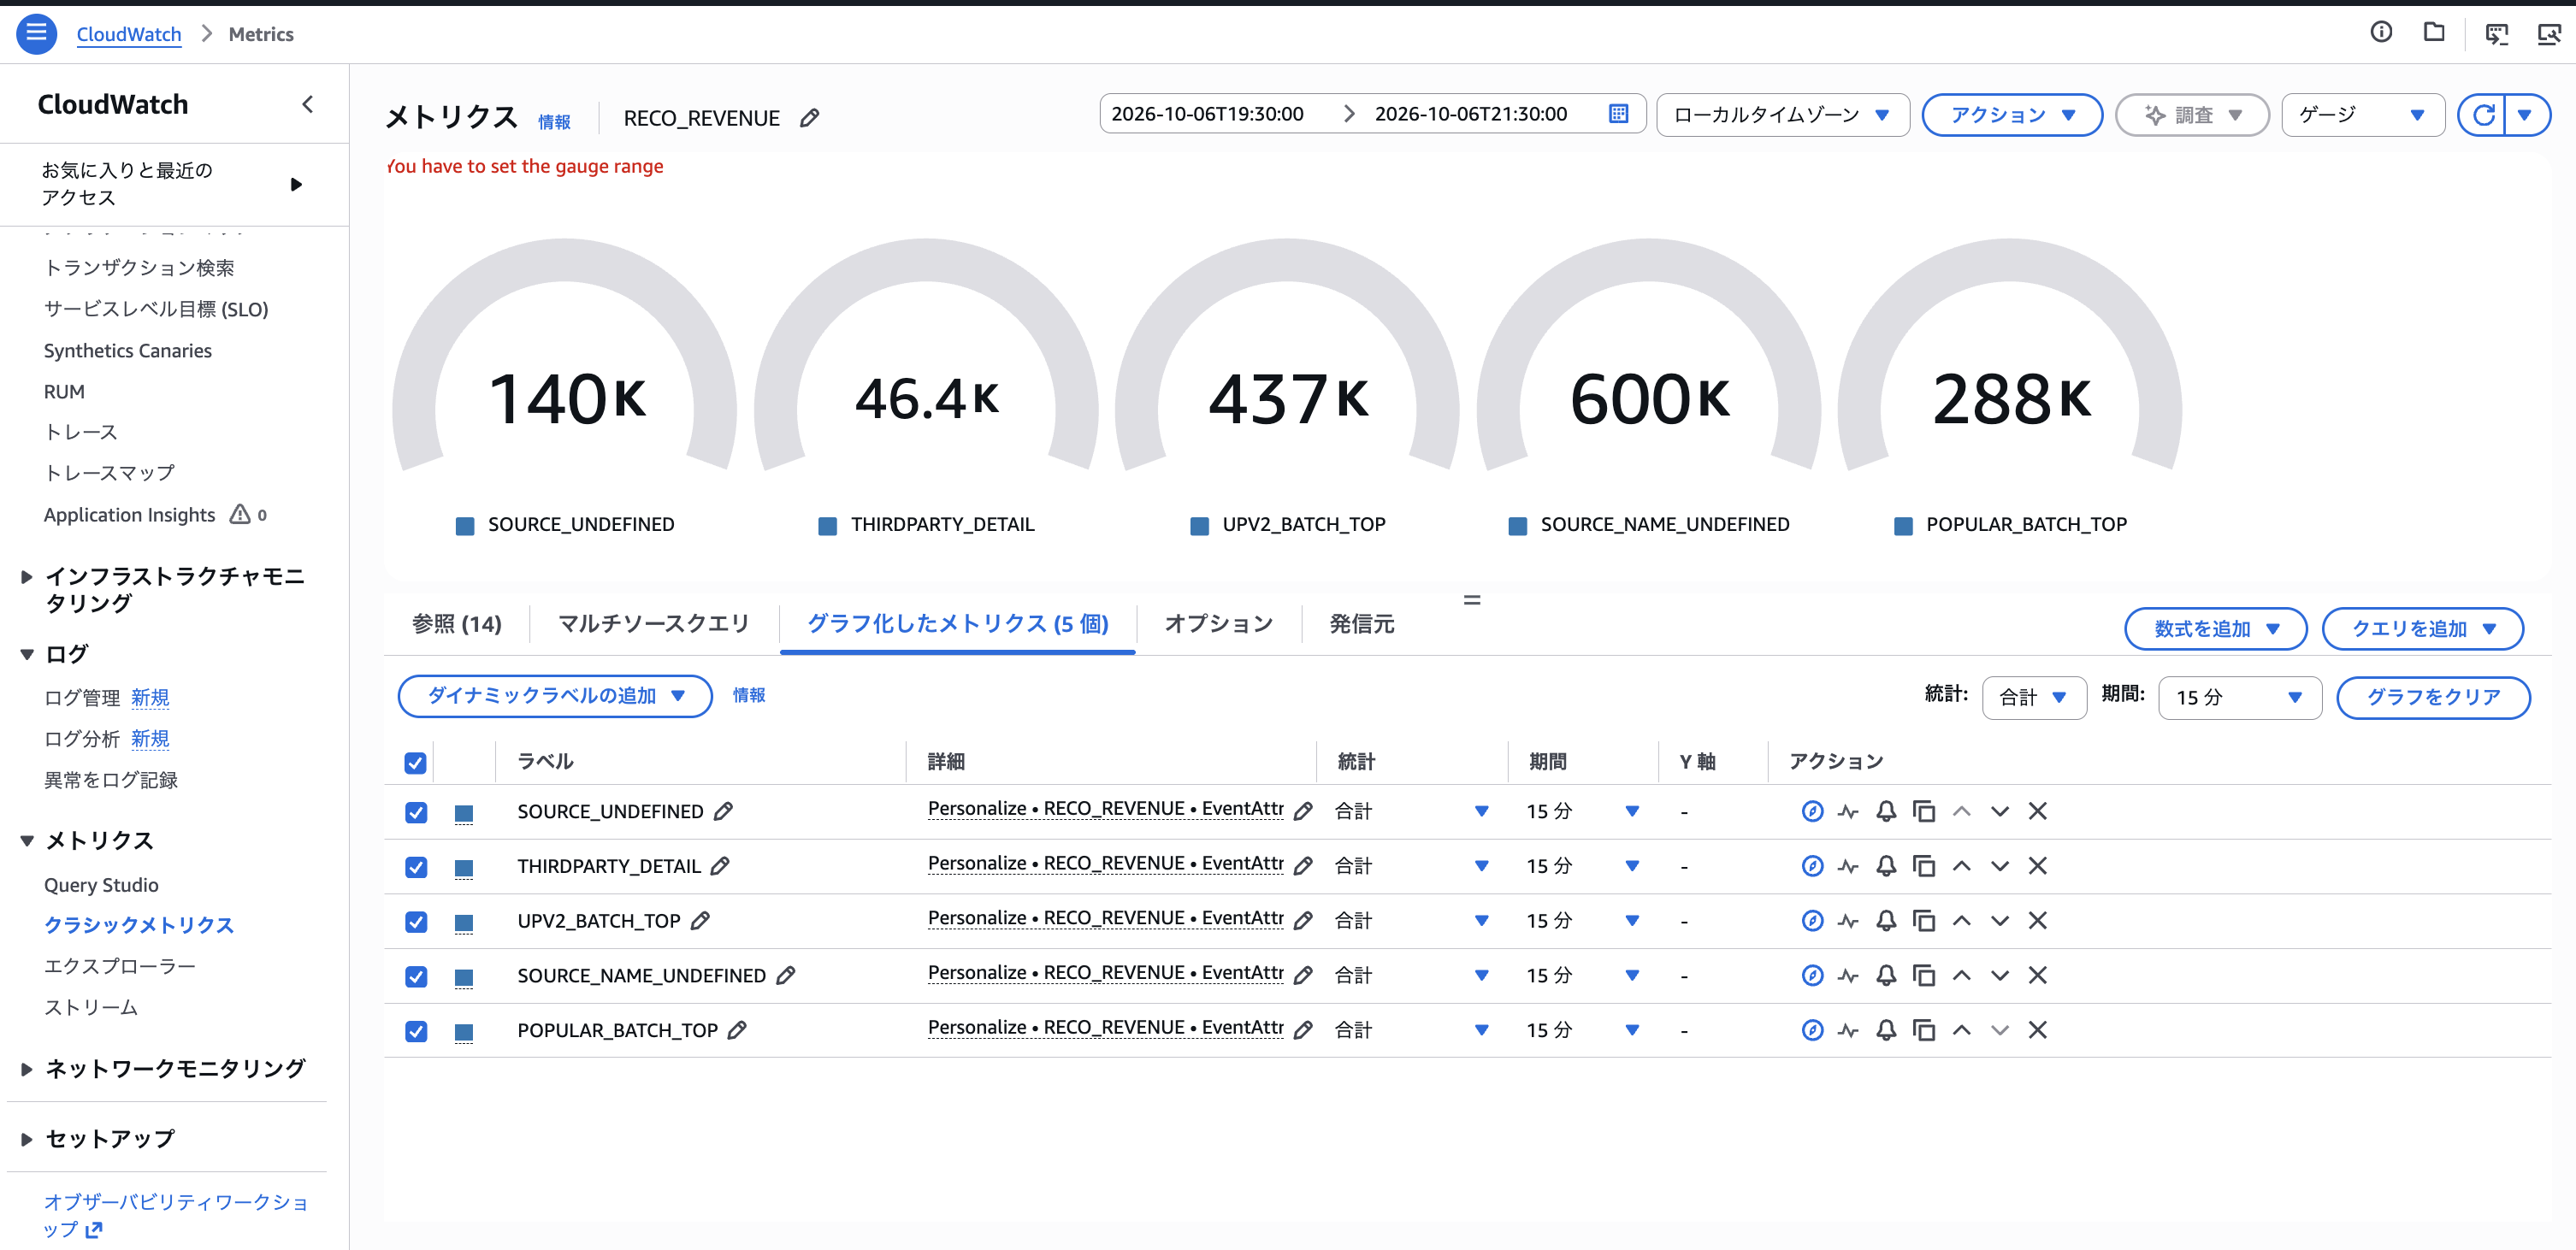
送った件数と、CloudWatchの値を突き合わせました。
| レコメンド元 | クリック(送信 / CloudWatch) | 購入(送信 / CloudWatch) | 購入金額(送信 / CloudWatch) |
|---|---|---|---|
| UPV2_BATCH_TOP | 731 / 731 | 229 / 229 | 437,200 / 437,200 |
| POPULAR_BATCH_TOP | 502 / 502 | 138 / 138 | 287,700 / 287,700 |
| THIRDPARTY_DETAIL | 66 / 66 | 26 / 26 | 46,400 / 46,400 |
| SOURCE_UNDEFINED(ラベルなし) | — | 61 / 61 | 143,400 / 143,400 |
件数も金額も、レコメンド元ごとに完全に一致しました。「どのレコメンドが、どれだけ購入と売上を生んだか」を、Amazon Personalizeの標準機能で数えられることが確認できました。
ほかに気づいた点です。
- レコメンド元の名前は、CloudWatchでは大文字に変換される
- ラベルなしの行動の表記が2種類ある。PutEventsで送ったものは
SOURCE_UNDEFINED、CSVでインポートしたものはSOURCE_NAME_UNDEFINEDになる。集計するときは、両方を「レコメンドを経由していない」として扱う
CSVだけで計測できるか
リアルタイム推論を使わず、バッチ推論だけで配信する場合は、行動ログをアプリ側にためておき、日次でCSVとして取り込む運用もできます。この場合はイベントトラッカーを作らずに済みます。そこで、CSVで取り込んだ行動でも、レコメンド元ごとに集計できるかを確かめました。
CSVでラベルを渡すには、InteractionsのスキーマにEVENT_ATTRIBUTION_SOURCE列を足します。PutEventsのeventAttributionSourceにあたる、Amazon Personalizeが予約している列名です。ドキュメントでも、インポートする行動にレコメンド元を含めれば比較できること、増分インポートした行動はCloudWatchに自動で送られることが書かれています。
比較のため、データセットグループを2つ新しく作りました。
- ラベル列あり:
EVENT_ATTRIBUTION_SOURCE列を足したスキーマ - ラベル列なし: これまでと同じスキーマ
それぞれにインポートし、Metric attributionの集計(S3への出力とCloudWatch)に出るかを確認しました。
| インポート | スキーマのラベル列 | ラベルの値 | 回数 | S3への集計出力 | CloudWatch |
|---|---|---|---|---|---|
| FULL | あり | 全行空 | 1回 | 出た(レコメンド元は空文字) | — |
| 増分 | あり | 入っている | 3回 | 出なかった | 出なかった |
| 増分 | あり | 全行空 | 1回 | 出なかった | 出なかった |
| 増分 | なし | — | 2回 | 出た | 出た |
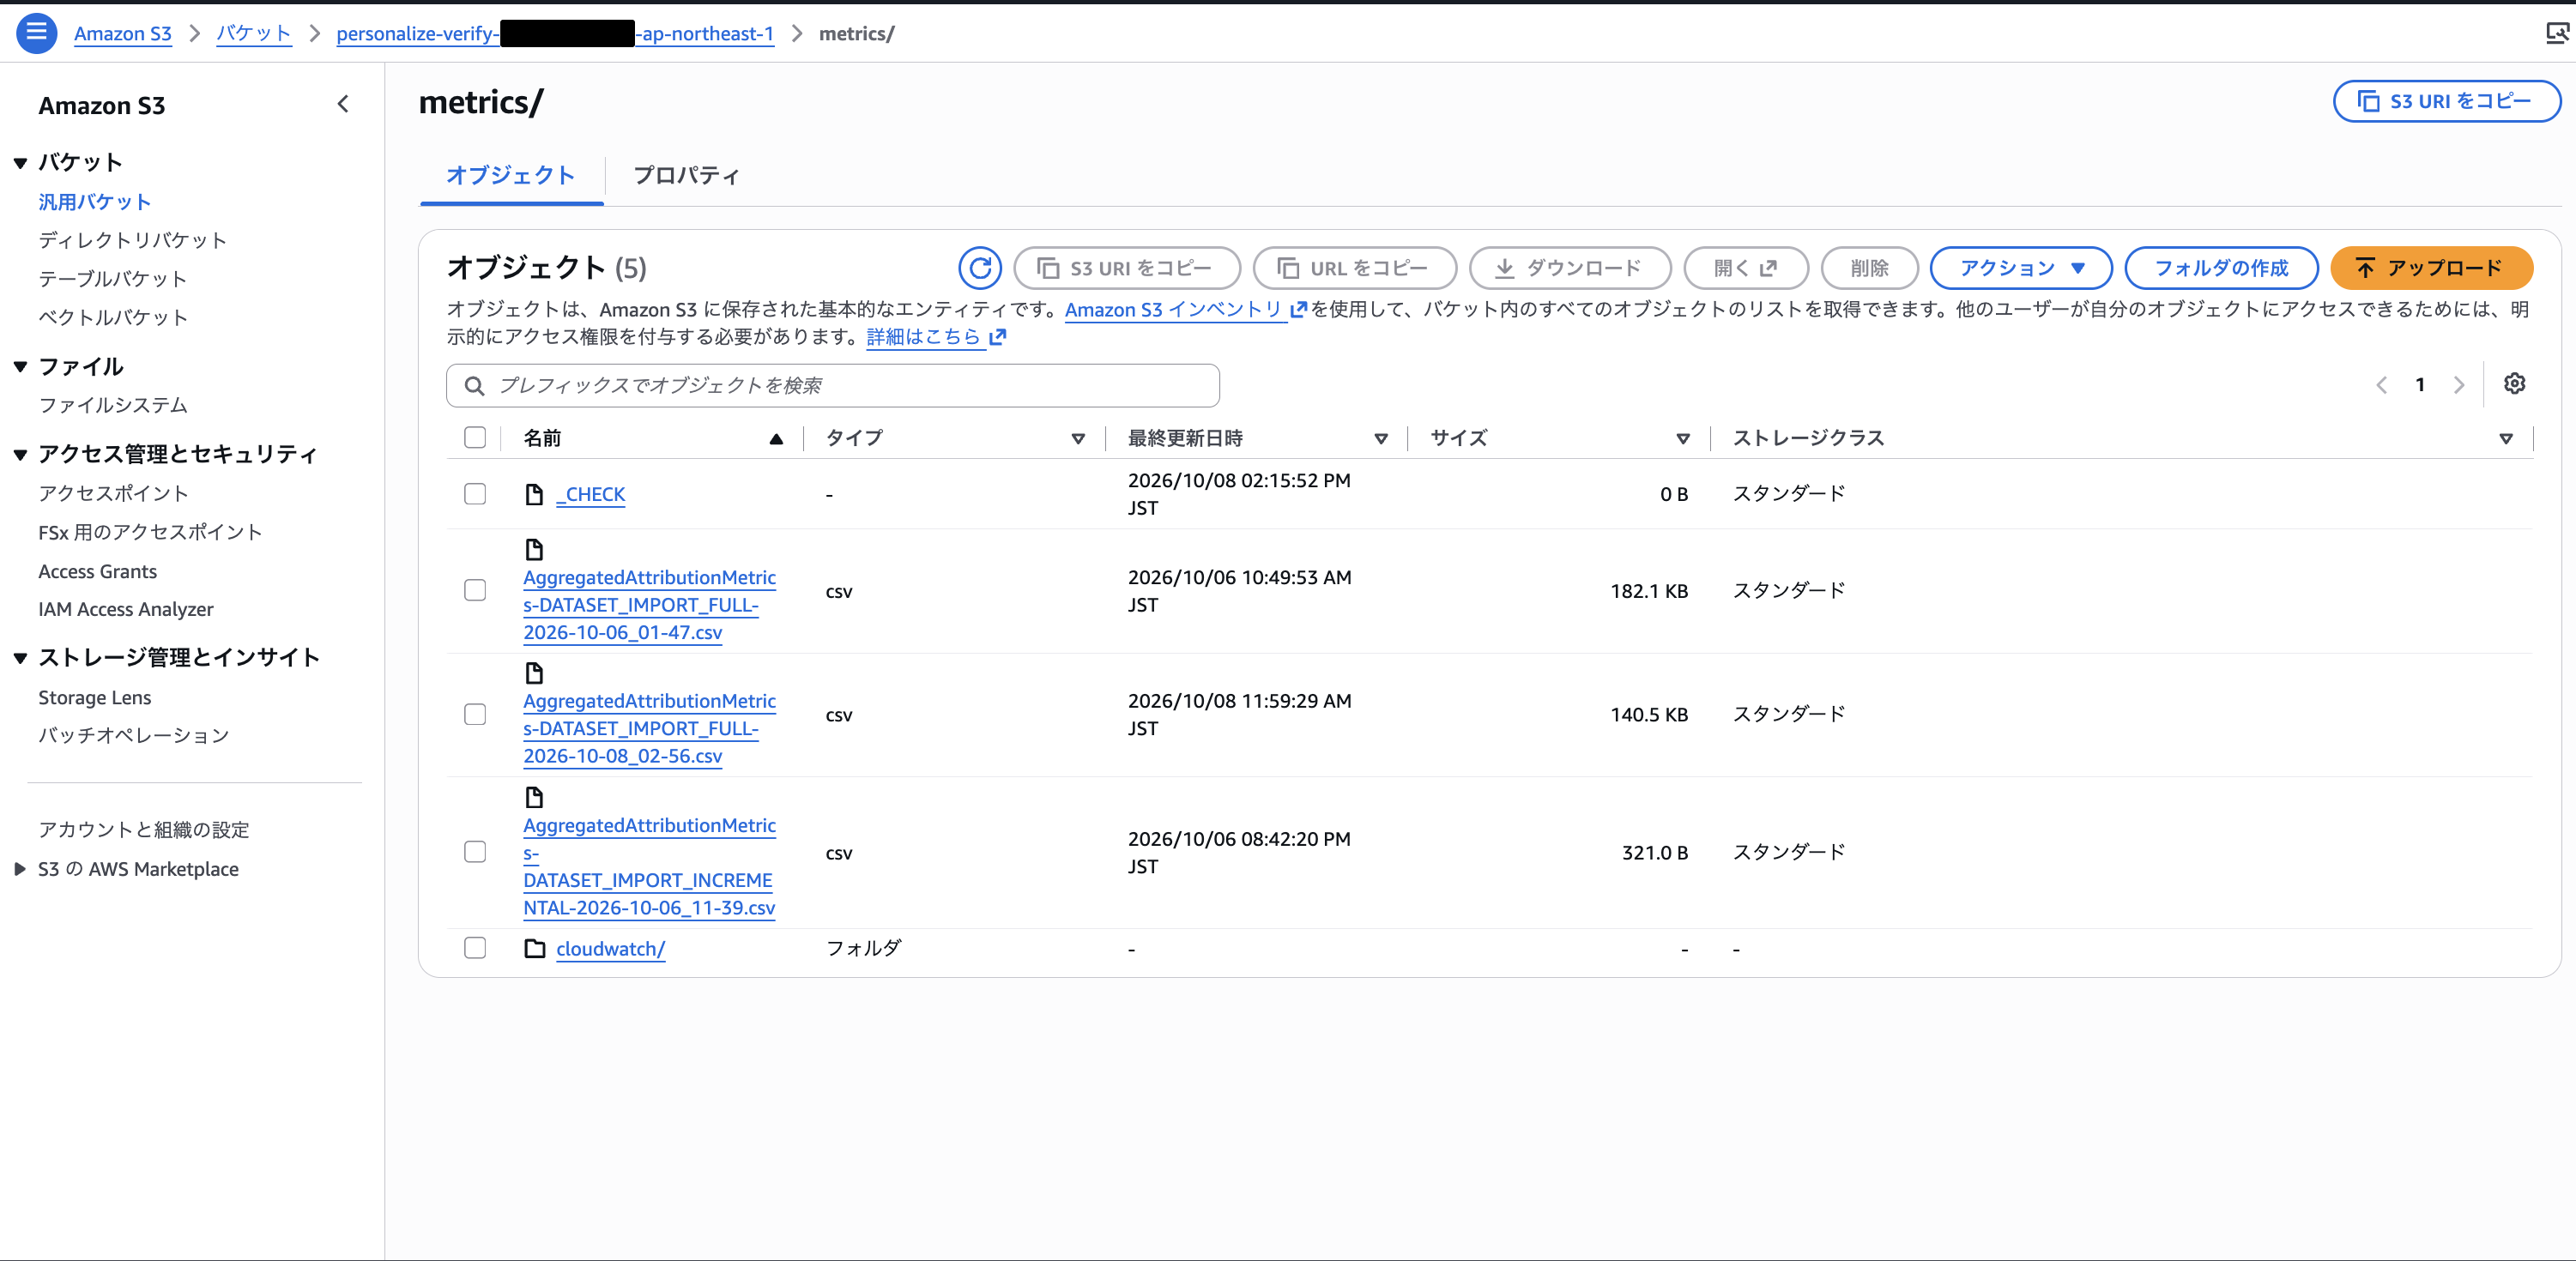
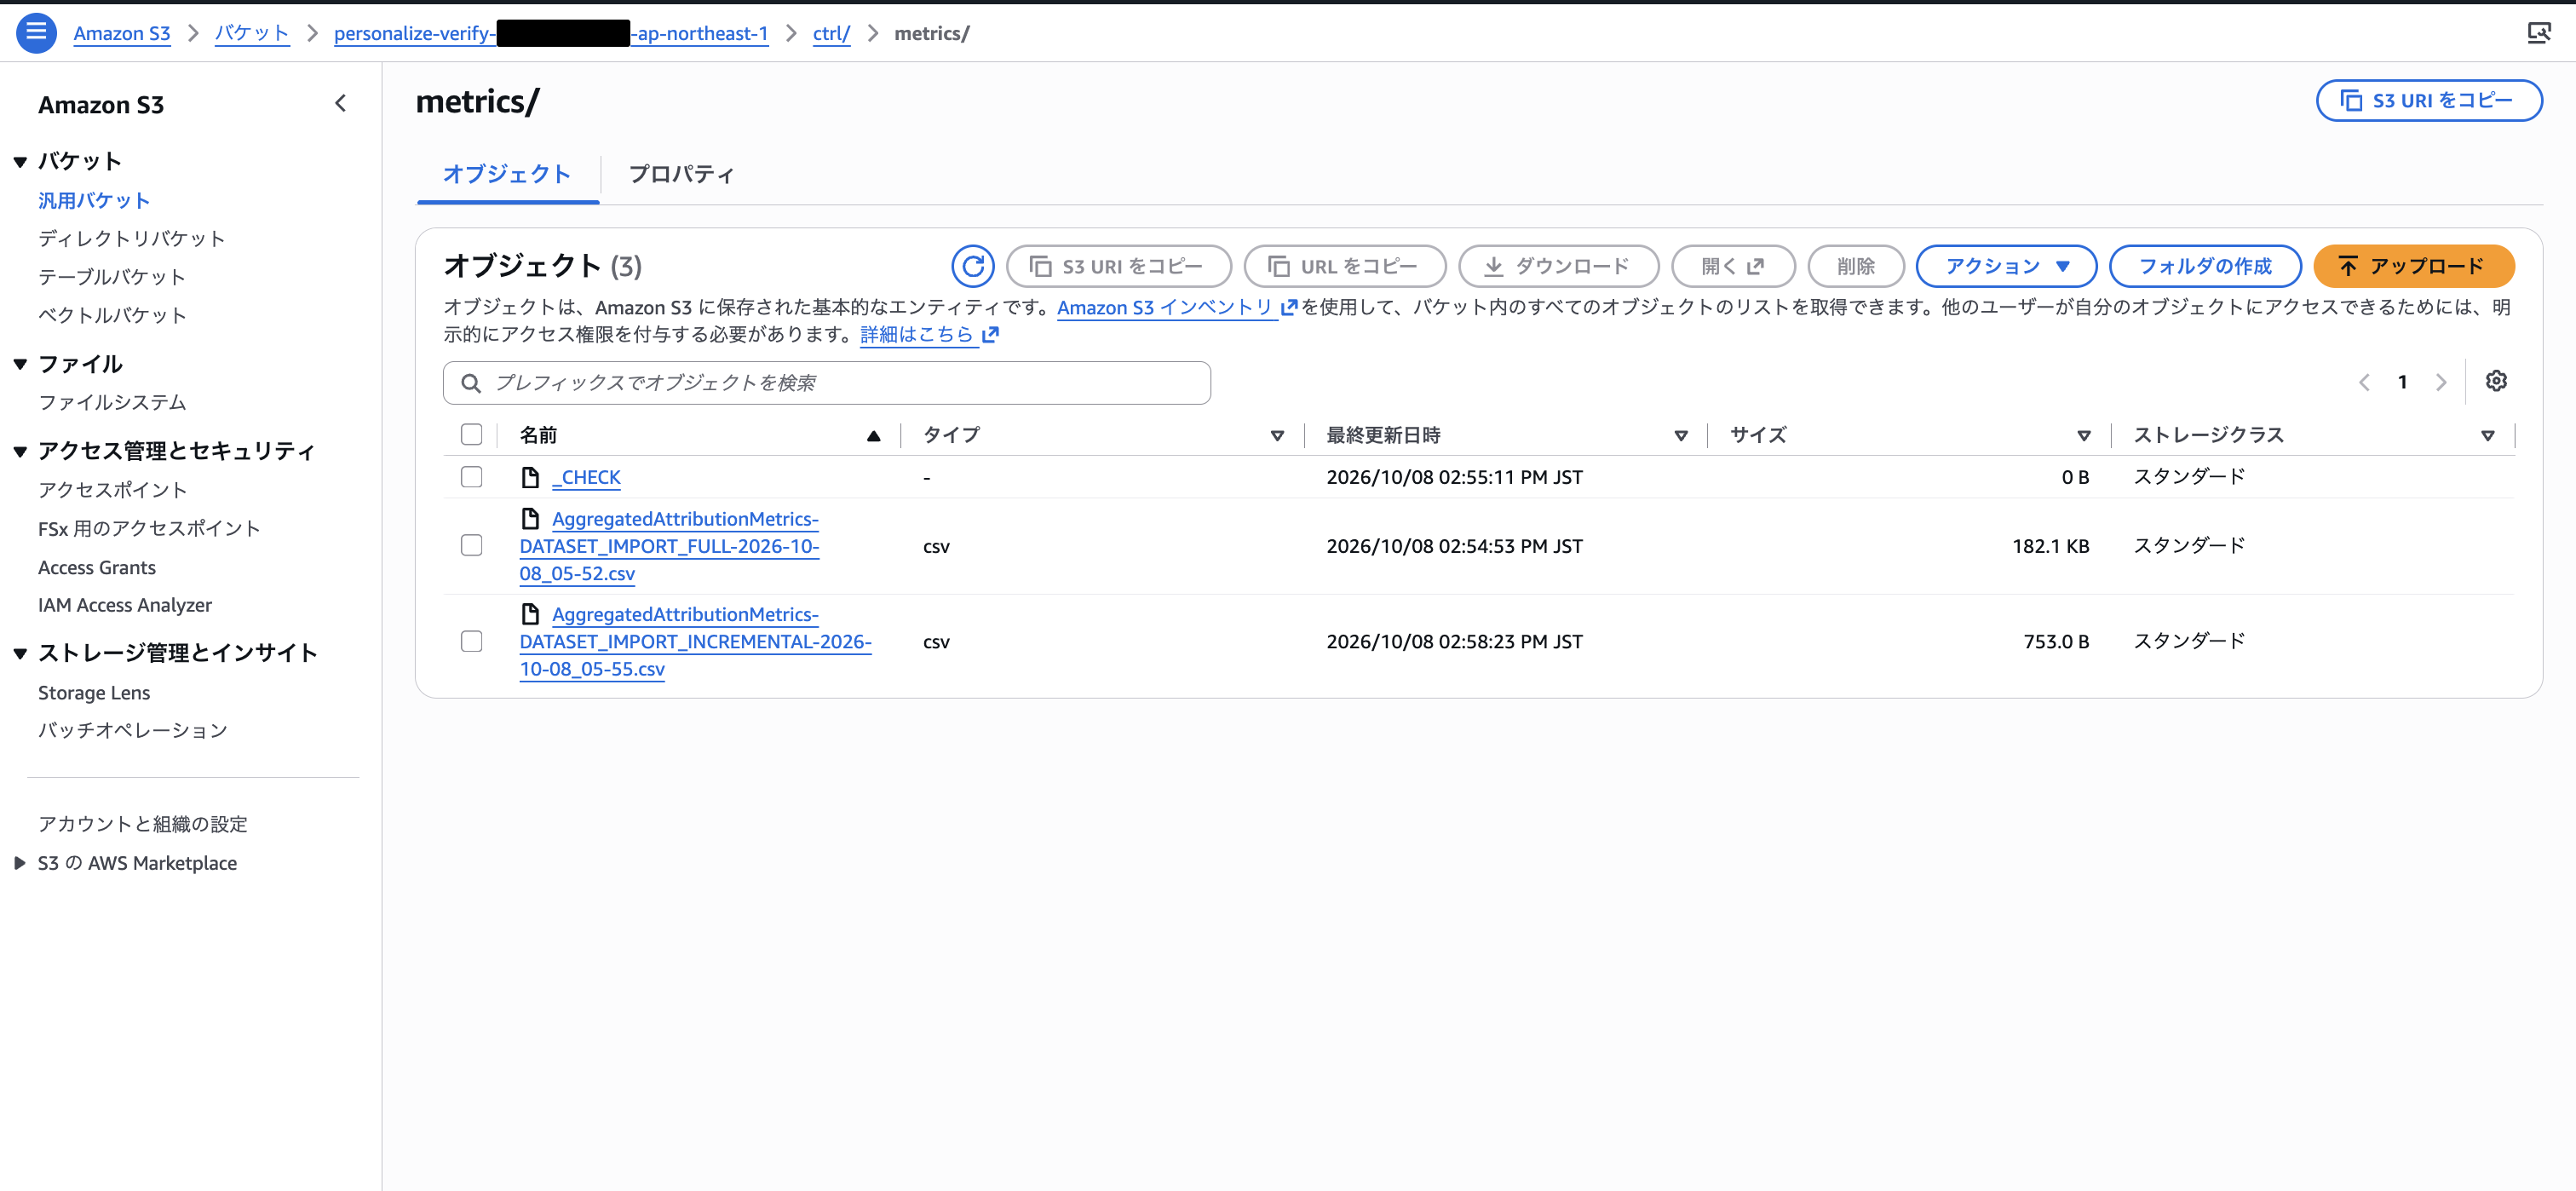
ラベル列のあるデータセットへの増分インポートは、4回とも集計に出ませんでした。ラベルの値が空でも出ていないので、値の中身ではなく、スキーマにラベル列があること自体で集計が止まっているように見えます。
データが取り込まれていないわけではありません。データセットをエクスポートすると、CSVで書いたラベルが1件も欠けずに入っていました。
user_id,item_id,timestamp,event_type,event_value,event_attribution_source
1,gd_247,1791433300000,click,,popular_batch_top
122,gd_4421,1791433301000,purchase,2000.0,upv2_batch_top
つまり、ラベル付きの行動はデータセットに取り込まれているのに、Metric attributionではレコメンド元ごとに評価できない状態です。Metric attributionの作成順、出力オプション、件数、行動の時刻(14日以内)、重複、CloudWatchの確認範囲など、集計に関わる条件は確認しましたが、原因は特定できていません。
11. S3に残して集計する
CloudWatchで見られるのは直近2週間分です。月単位で効果を追うには、集計の材料をS3に残しておく必要があります。方法を3つ確かめました。
| 方法 | レコメンド元の内訳 | 結果 |
|---|---|---|
インポート時のS3出力(「3. データをインポートする」で使った--publish-attribution-metrics-to-s3) |
残らない | ラベルなしのCSVでは、すべてSOURCE_NAME_UNDEFINEDになる。ラベル列を足すと、増分インポートでは出力されない |
| データセットエクスポート(PutEventsで送った分を書き出す) | 残る | event_attribution_source列に、送ったラベルがそのまま入る |
| 自分でS3に書いたログ(「10. レコメンドが生んだ行動を計測する」の手順2) | 残る | 送信と同時に書くので確実 |
データセットエクスポートは、Amazon Personalizeに入っているデータをS3にCSVで書き出す機能です。--ingestion-mode PUTで、PutEventsなどで1件ずつ入れたデータだけを対象にできます。
aws personalize create-dataset-export-job --job-name export-interactions-put \
  --dataset-arn <InteractionsのARN> --ingestion-mode PUT --role-arn <ロールARN> \
  --job-output s3DataDestination={path=s3://<バケット>/export/interactions-put/}
timestamp,session_id,event_type,user_id,item_id,event_value,impression,recommendation_id,event_attribution_source
1791285717000,s-3-2026-10-06,click,3,gd_294,,,,upv2_batch_top
1791285778000,s-41-2026-10-06,click,41,gd_148,,,,popular_batch_top
最後に、自分でS3に書いた表示ログと行動ログをAthenaで集計しました。CTR(クリック ÷ 表示)を出すには表示回数が必要ですが、Amazon Personalizeは表示回数を数えません。そのため、表示ログは自分で持つ必要があります。
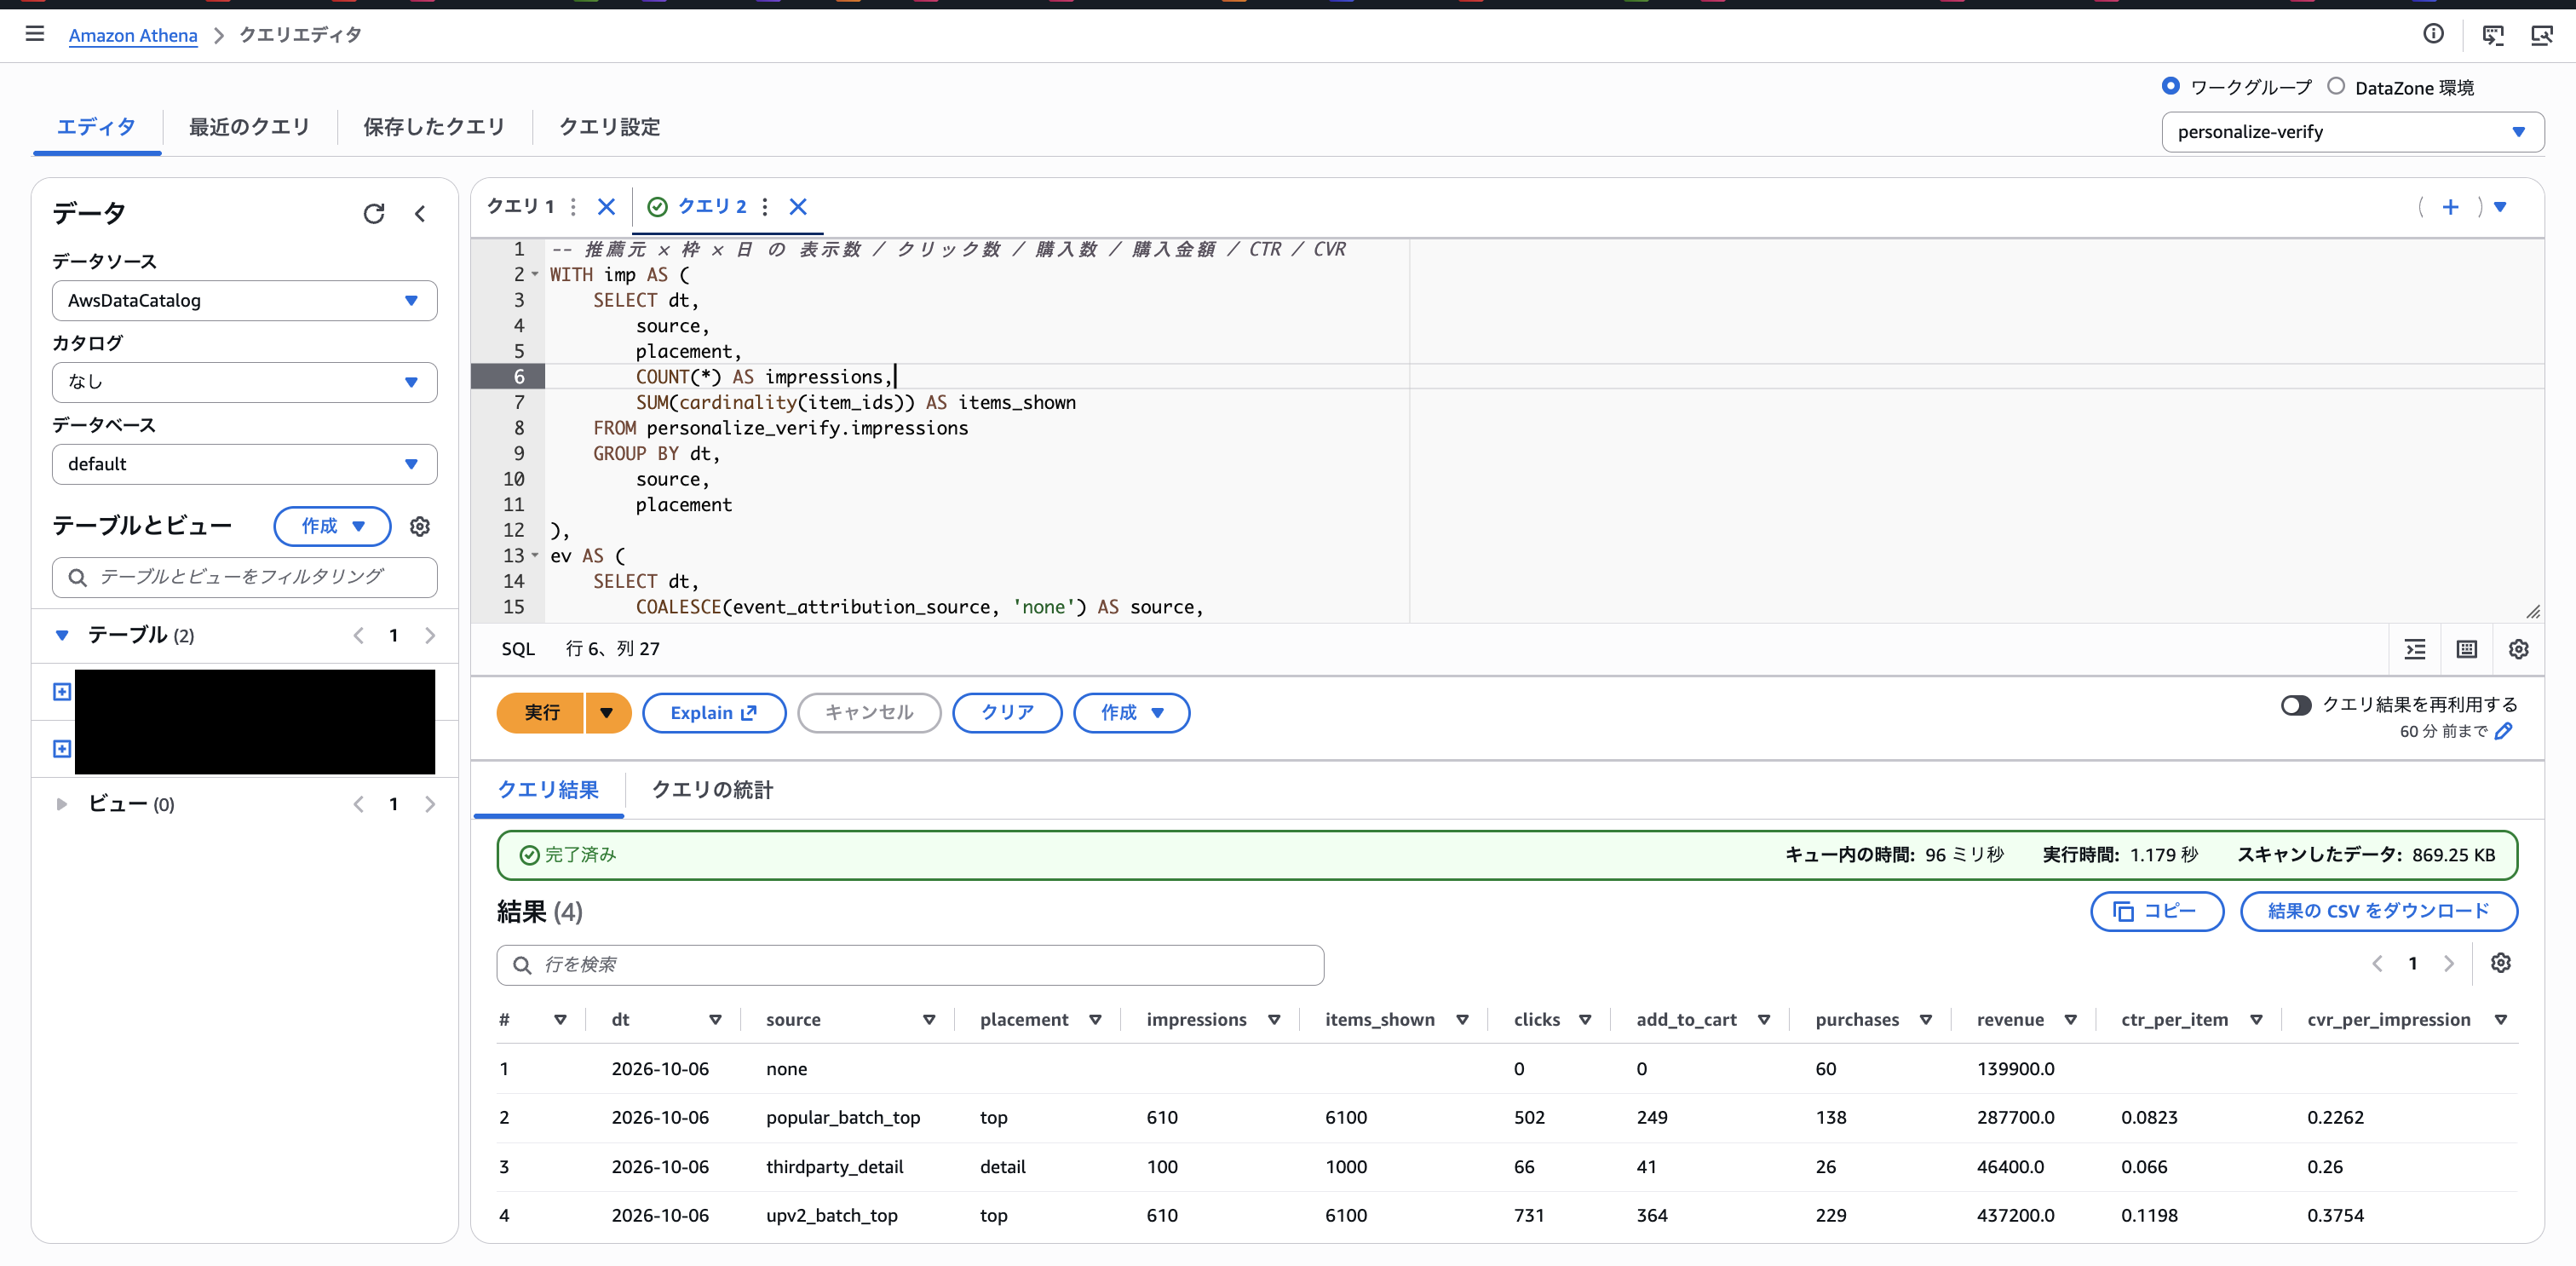
| レコメンド元 | 表示 | クリック | 購入 | 購入金額 | CTR | CVR |
|---|---|---|---|---|---|---|
| upv2_batch_top | 610 | 731 | 229 | 437,200 | 12.0% | 37.5% |
| popular_batch_top | 610 | 502 | 138 | 287,700 | 8.2% | 22.6% |
| thirdparty_detail | 100 | 66 | 26 | 46,400 | 6.6% | 26.0% |
| none | — | — | 60 | 139,900 | — | — |
件数はCloudWatchの値と一致しています。行動は模擬なので比率そのものに意味はありませんが、「レコメンド元 × 表示枠 × 日」でCTR・CVR・売上を出すための材料がそろうことを確認できました。
集計SQL
WITH imp AS (
  SELECT dt, source, placement, COUNT(*) AS impressions, SUM(cardinality(item_ids)) AS items_shown
  FROM personalize_verify.impressions GROUP BY dt, source, placement
),
ev AS (
  SELECT dt, COALESCE(event_attribution_source, 'none') AS source,
         SUM(CASE WHEN event_type = 'click' THEN 1 ELSE 0 END) AS clicks,
         SUM(CASE WHEN event_type = 'add_to_cart' THEN 1 ELSE 0 END) AS add_to_cart,
         SUM(CASE WHEN event_type = 'purchase' THEN 1 ELSE 0 END) AS purchases,
         SUM(CASE WHEN event_type = 'purchase' THEN event_value ELSE 0 END) AS revenue
  FROM personalize_verify.events GROUP BY dt, event_attribution_source
)
SELECT ev.dt, ev.source, imp.placement, imp.impressions, imp.items_shown, ev.clicks, ev.add_to_cart, ev.purchases, ev.revenue,
       ROUND(CAST(ev.clicks AS double) / NULLIF(imp.items_shown, 0), 4) AS ctr_per_item,
       ROUND(CAST(ev.purchases AS double) / NULLIF(imp.impressions, 0), 4) AS cvr_per_impression
FROM ev LEFT JOIN imp ON ev.dt = imp.dt AND ev.source = imp.source
ORDER BY ev.dt, ev.source;
まとめ
| 検証したいこと | 結果 |
|---|---|
| 1. 映画の行動しかないユーザーにグッズをレコメンドできるか | できる。427人全員に、人気順とは違うグッズが返った |
| 2. 映画の好みはグッズのレコメンドにどう反映されるか | グッズ側の行動データの広がりに左右される。本人のグッズの行動が数件入ると大きく改善した |
| 3. 配信と鮮度 | バッチ推論と配信側の抽選で、レコメンドを一定間隔で入れ替えられる |
| 4. 効果測定 | PutEventsで送った行動は、レコメンド元ごとに完全に一致した。CSVの増分インポートは集計に出なかったため、PutEventsを利用したくない場合は自前の分析基盤で測るのが確実 |
| 5. 集計結果の保存 | できる。自前のログとデータセットエクスポートで残し、AthenaでCTR・CVRを適切に評価できた |
運用で気を付けたい点
- 増分インポートも1ファイル1,000件以上が必要
- バッチ推論の結果には
recommendationIdが付かず、表示回数も数えられない。レコメンド元のラベルと表示ログは自分で持つ - キャンペーンは使っていなくても毎時課金される
コストを抑えて運用する場合の推奨構成
キャンペーン(リアルタイム推論)は、リクエストがなくても毎時課金されます。コストを抑えながら、レコメンドの更新と効果測定をきちんと回すなら、バッチ推論だけで組む次の構成が現実的な落とし所だと感じました。常時起動のリソースがなく、今回の検証で確実に動いた方法だけで組んでいます。
- 表示ログと、レコメンド元付きの行動ログをS3にためる
- 日次で行動ログを増分インポートし、再学習してからバッチ推論する(新しい行動を確実に反映できたのはこの方法)
- 結果をDBに入れ、配信APIで入れ替えながら返す(1日中同じレコメンドにならないようにする)
- 効果測定は、1のログを自前の分析基盤で集計する(Metric attributionには頼らない)
リアルタイム推論は、直近の行動をすぐに反映したい枠に絞って、効果が見えてから足していくのがよいと思います。
検証にかかった費用
検証に使ったアカウントでは無料利用枠は適用されていません。実行時間は、各リソースの作成から完了(キャンペーンは削除)までの時間です。
| 区分 | 実行したもの | 実行時間 | 金額 |
|---|---|---|---|
| 学習 | User-Personalization-v2(「4. 3つのレシピで学習する」で作成) | 約55分 | $0.21 |
| Similar-Items | 約44分(課金上は3.85時間) | $0.92 | |
| Popularity-Count | 約15分(課金上は1.01時間) | $0.24 | |
| User-Personalization-v2(「9. 新しい行動はバッチ推論にいつ効くか」の検証で2回) | 約55分 × 2回 | $0.44 | |
| バッチ推論 | User-Personalization-v2(610人) | 約15分 | $0.09 |
| Similar-Items(9,742作品) | 約12分 | $0.65 | |
| Popularity-Count(610人) | 約12分 | $0.04 | |
| User-Personalization-v2(「9. 新しい行動はバッチ推論にいつ効くか」の検証で4回、各70人) | 約17〜54分 | $0.04 | |
| リアルタイム推論 | キャンペーン1つ(最低1TPS) | 7時間23分 | $3.92 |
| その他 | データ取り込み、CloudWatch、S3、DynamoDB、Athena | — | 約$0.03 |
| 合計 | 約$6.6 |
キャンペーンは、リクエストがなくても稼働している間ずっと課金されるため、費用の半分以上を占めています。
最後に
実際に検証してみて、データさえ用意できれば、すぐに環境を作ってレコメンドを出すところまで進められる手軽さは、Amazon Personalizeの大きな良さだと感じました。学習の仕組みや推論の基盤を自分で用意する必要はなく、映画とグッズのように種類の違うアイテムをまたぐレコメンドも、列とフィルタの設計だけで形になります。
一方で、マネージドサービスとはいえ、実際に運用する前提で考えるとそれなりにしんどさもあります。データセットグループ、スキーマ、インポートジョブ、ソリューション、フィルタ、バッチ推論ジョブ、Metric attributionと関連するリソースが多く、その周りにもS3やDB、配信API、分析基盤が必要になります。さらに、どのデータをどの形で用意するか、効果をどう評価するかは、データを入れる前に関係者とすり合わせておかないと、後から直すのが大変そうです。
また、使えるアルゴリズムはAWSが用意したレシピの中から選ぶ形です。調整できるのは行動の種類ごとの重み、学習に使う列、フィルタ、再学習の頻度などで、モデルの構造や特徴量の作り方までは変えられません。独自のロジックを組み込みたい場合は、配信側の工夫で補うか、自社でモデルを作るかを考える必要があります。
逆に言えば、次の4点を最初に固めておけば、とてもスムーズに回せるサービスだと思います。
- やりたいレコメンドが、既存のレシピとフィルタの組み合わせで実現できるか
- どのサービスの行動を、どのユーザーIDでまとめ、Itemsにどんな列を持たせるか
- 配信をバッチ推論にするかリアルタイム推論にするか(新しい行動の反映方法と費用がここで決まる)
- 効果を何で測り、表示ログとレコメンド元のラベルをどこに残すか
これから利用を検討している方は、まずこの4点を整理するところから始めてみてください。この記事がどなたかの参考になれば幸いです。今回は以上です。