非構造化テキストのチャンク化・ベクトル検索を行えるdbtパッケージ「dbt_context_engineering」を試してみた

さがらです。
dbt Labsから、AIエージェントが読むテキストデータをdbtでモデリングするためのOSSパッケージ、dbt_context_engineeringが公開されています。チャンク化・埋め込み・分類・ベクトル検索といった処理を、dbtのマクロとモデルとして書けるのが特徴です。
このパッケージは、エージェントや検索サービスそのものではなく、それらが読むコンテキストをdbtで整備するためのものです。テキストの加工や検索処理に、バージョン管理・テスト・リネージといったdbtの考え方を持ち込めます。
今回はdbt Projects on Snowflake上で、日本語の「注文に関するお問い合わせ・レビュー」をチャンク化・ベクトル化して検索する手順と、分類ラベルで検索対象を絞り込む方法をまとめます。
機能概要
dbt_context_engineeringは、問い合わせ・レビュー・通話記録などの非構造化テキストを、AIエージェントが検索・引用できる形に整えるためのdbtパッケージです。READMEでは、Snowflake(Cortex)、Databricks、BigQuery、Redshift(Amazon Bedrock)への対応が説明されています。
今回使う主なマクロと、Snowflakeでの処理は次のとおりです。
| マクロ | 役割 | Snowflakeでの主な処理 |
|---|---|---|
chunk |
テキスト行をチャンクへまとめる | LENGTH・CEILによるトークン数の推定、SUM ... OVERなどによるグループ分け |
embed |
テキストをベクトル化する | AI_EMBED |
vector_search |
ベクトルの類似度で検索する | VECTOR_COSINE_SIMILARITYとORDER BY・LIMIT |
classify |
テキストに分類ラベルを付ける | AI_CLASSIFYと、返却オブジェクトからのラベル取り出し |
guard_batch |
AI処理前に処理量を確認する | COUNT・SUMによる集計と、dbt側での上限チェック |
このように、独自のAIエンジンを提供するものではなく、Snowflakeの関数などを呼び出すSQLをマクロで生成します。各マクロの実装コードは、使用する箇所でリンクを載せています。
基本となる流れは、次の3ステップです。
chunk: 複数のテキスト行を、推定トークン数を目安にチャンクへまとめるembed: 各チャンクをベクトル化するvector_search: 検索クエリとの類似度を計算し、上位のチャンクを返す
さらに、classifyで分類ラベルを付け、検索対象を絞り込むこともできます。公式ブログでは、ベクトルの類似度だけでは質問への関連性を十分に判断できない例と、その対策として分類ラベルを使うパターンが紹介されています。
Snowflakeで使う場合のCortex Searchとの関係
Snowflake向けのパッケージと聞くと、「dbt経由でCortex Searchサービスを作るものなのか?」と思うかもしれません。
結論からいうと、Cortex Searchサービスの作成機能もありますが、それはオプションです。標準の検索処理では、Cortex Searchを使いません。
標準の構成では、embedで生成したベクトルを通常のテーブルの列として保持します。vector_searchは、そのベクトル列と検索クエリのベクトルに対して、VECTOR_COSINE_SIMILARITYで類似度を計算します。
一方、オプションとして用意されているのが、create_vector_indexマクロです。実装コードはこちらです。
Snowflake向けの実装では、AI関数ではなく、CREATE OR REPLACE CORTEX SEARCH SERVICEというDDLを生成・実行します。通常のモデルのビルドとは別に、dbt run-operationで明示的に実行する仕組みです。
ただし、確認時点ではBeta機能であり、実環境での「作成 → 検索 → 削除」の一連の検証は未完了とされています。作成したサービスは別途課金され、通常のテーブルとは異なるライフサイクルを持つため、不要になったら明示的な削除も必要です。
また、サービスを作成しても、この記事で使うvector_searchが自動的にCortex Search経由へ切り替わるわけではありません。
コスト
chunkはAIを使わないため、AI関数の利用料は発生しません。ただし、SQL実行に使うSnowflakeの計算リソースや、作成したテーブルのストレージまで無料になるわけではありません。
embedとclassifyは、SnowflakeのAI_EMBEDとAI_CLASSIFYを呼び出します。この記事では検索クエリのベクトル化にもembedを使うため、検索結果のモデルを再構築する際にもAI関数を使用します。
処理量の管理には、次のような仕組みがあります。
ai_functions_enabled: AI関数の実行を有効化する設定guard_batch: 行数・推定トークン数の上限チェックdev_sample_filter: 開発中の処理対象のサンプリングlog_ai_runなど: 実行ログの記録
サンプリングやログ記録は、利用側でモデルやフックに組み込む必要があります。また、guard_batchは請求金額そのものを上限にして止める機能ではありません。
参考として、サンプリング用マクロの実装はこちらです。
Snowflakeでは、RANDOM()でランダムな順序を作り、ROW_NUMBER()とQUALIFYで件数を制限するSQLを生成します。本記事では全24件を対象にするため、このマクロは使用しません。
前提条件
dbt Projects on Snowflake(dbt 1.12.3)を使用します。
今回の検証では、Snowflakeの操作もdbtの実行も、すべてACCOUNTADMINロールで行います。そのため、検証用のロール作成や権限付与は行いません。
外部パッケージとして、dbt_context_engineeringを使います。dbt Projects on Snowflakeで外部パッケージを使うには、EXTERNAL ACCESS INTEGRATIONが必要です。許可するホストは必要最小限に絞ることをおすすめします。具体的な手順については、こちらのブログをご参照ください。
事前準備
扱うデータについて
dbtのSnowflake向けクイックスタートでは、架空のお店「Jaffle Shop」のデータを使います。本記事では、そのデータ構成を参考にします。
今回は記事内のCSVだけで試せるように、小規模な顧客・注文データを用意します。さらに、注文に関するお問い合わせ・レビューと、サポートの返信を自作のseedとして追加します。
| seed | 内容 | 件数 |
|---|---|---|
raw_customers |
顧客 | 12件 |
raw_orders |
注文 | 20件 |
raw_order_feedback |
日本語の問い合わせ・レビュー・サポート返信 | 24件 |
raw_order_feedbackは、1件あたり約200文字を目安にした架空の文章です。次の内容を混ぜています。
- 配送拠点の仕分けミスや渋滞による配送遅延
- 雪や暴風雨による配送への影響
- 商品の取り違えや配送ラベルの誤り
- 商品・包装の品質に関する不満
- 商品やサービスに対する称賛
- 配送の状況確認や、対応完了の連絡
今回のポイントは、「配送という話題には関係しているが、遅延の原因は説明していない文章」も含めていることです。
公式ブログの短い定型文をそのまま日本語訳したデータではないため、同じ検索順位やスコアになることは期待しません。
1. Snowflakeオブジェクトの準備
検証用に、以下のオブジェクトを使用します。既存のものがあれば適宜読み替えてください。
| 種別 | 名前 |
|---|---|
| ウェアハウス | DBT_CE_DEMO_WH |
| データベース | DBT_CE_DEMO_DB |
| 出力先スキーマ | DBT_CE_DEMO |
ACCOUNTADMINで、ウェアハウス・データベース・スキーマを作成します。
USE ROLE ACCOUNTADMIN;

CREATE OR REPLACE WAREHOUSE DBT_CE_DEMO_WH
  WAREHOUSE_SIZE = XSMALL
  AUTO_SUSPEND = 60
  AUTO_RESUME = TRUE;

CREATE OR REPLACE DATABASE DBT_CE_DEMO_DB;

CREATE SCHEMA IF NOT EXISTS DBT_CE_DEMO_DB.DBT_CE_DEMO;
以降の操作も、すべてACCOUNTADMINロールで行うため、ロールの作成や、Cortex AI関数・各オブジェクトへの権限付与は不要です。
2. EXTERNAL ACCESS INTEGRATIONの準備
dbt depsで外部パッケージを取得するため、EXTERNAL ACCESS INTEGRATIONを作成します。公式Docに記載のある、dbt depsに必要な最小限のホスト(hub.getdbt.comとcodeload.github.com)のみ許可します。
EXTERNAL ACCESS INTEGRATIONの作成SQL(クリックで展開)
USE ROLE ACCOUNTADMIN;

-- dbt depsに必要な最小限のホストのみ許可するネットワークルール
CREATE OR REPLACE NETWORK RULE dbt_network_rule
  MODE = EGRESS
  TYPE = HOST_PORT
  VALUE_LIST = ('hub.getdbt.com', 'codeload.github.com');

-- 外部アクセス統合の作成
CREATE OR REPLACE EXTERNAL ACCESS INTEGRATION dbt_external_access_integration
  ALLOWED_NETWORK_RULES = (dbt_network_rule)
  ENABLED = TRUE;
3. Workspaceでdbtプロジェクトを作成
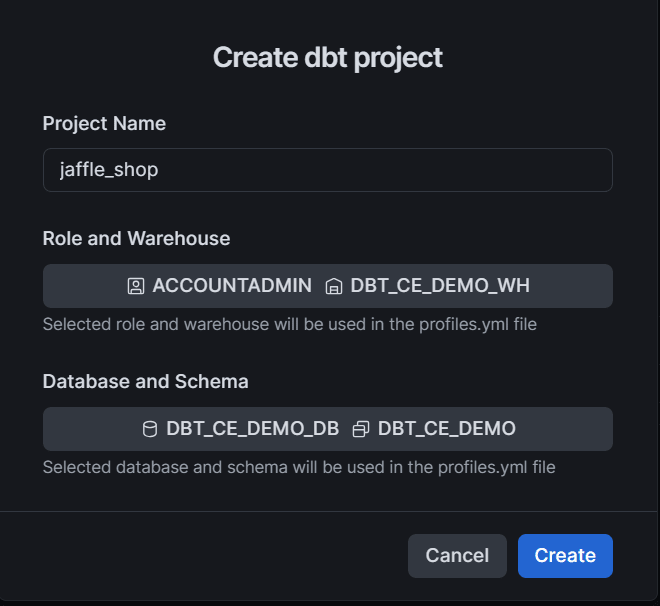
SnowsightのProjects→Workspacesで、dbtプロジェクトのWorkspaceを作成します。
先ほど作成したオブジェクトを用いて、下図のように作成します。作成後、modelsフォルダ内のサンプルのmy_first_dbt_model.sqlとmy_second_dbt_model.sqlは削除しておきます。
4. seedのロード
seedsフォルダに、次の3つのCSVを配置します。
seeds/raw_customers.csv(クリックで展開)
id,first_name,last_name
1,Michael,Perez
2,Shawn,Mitchell
3,Kathleen,Payne
4,Jimmy,Cole
5,Katherine,Reed
6,Sarah,Robinson
7,Martin,Meyer
8,Frank,Rose
9,Jennifer,Fox
10,Henry,Watts
11,Diana,Lopez
12,Tom,Kim
seeds/raw_orders.csv(クリックで展開)
id,user_id,order_date,status
1,1,2026-10-01,completed
2,2,2026-10-01,completed
3,3,2026-10-02,completed
4,4,2026-10-03,returned
5,5,2026-10-03,completed
6,6,2026-10-04,shipped
7,7,2026-10-05,completed
8,8,2026-10-06,completed
9,9,2026-10-07,return_pending
10,10,2026-10-08,completed
11,1,2026-10-09,completed
12,2,2026-10-10,shipped
13,3,2026-10-11,completed
14,4,2026-10-12,placed
15,5,2026-10-13,completed
16,6,2026-10-14,completed
17,11,2026-10-15,completed
18,12,2026-10-16,returned
19,7,2026-10-17,completed
20,8,2026-10-18,completed
seeds/raw_order_feedback.csv(クリックで展開)
feedback_id,order_id,channel,created_at,feedback_text
1,3,email,2026-10-02 18:10:00,"注文した商品が、案内されていた配達予定日を二日過ぎてようやく届きました。追跡画面の表示が長い時間変わらず、問い合わせても到着の見通しが分からなかったため、予定を何度も変更することになりました。さらに、配達員が隣の建物に商品を置いてしまい、受け取りにも時間がかかりました。配送が遅れた理由と、届け先の確認が適切に行われなかった理由を調べてください。今後は予定に変更がある時点で、早めに連絡していただきたいです。"
2,3,chat,2026-10-03 09:05:00,"昨日問い合わせた配送遅延について、配送会社から追加の説明がありました。地域の配送拠点で仕分け先を間違え、別の営業所へ商品を送ってしまったことが原因だったそうです。正しい拠点へ戻す作業に時間がかかり、当初の配達予定に間に合わなかったとのことでした。天候や注文の集中ではなく、拠点内の仕分け作業に問題があったと理解しています。同じことが繰り返されないよう、物流の担当部署にも今回の経緯を共有していただけると助かります。"
3,4,review,2026-10-05 12:30:00,"届いたホットサンドを開けたところ、全体がすっかり冷めていて、パンも水分を吸って柔らかくなっていました。写真では表面が香ばしく焼けているように見えたので、実物との違いが残念でした。具材の温かさもほとんど感じられず、家族と相談して今回は注文した商品を返品することにしました。包装の中に蒸気がこもっていたようにも見えるため、調理後の保管方法や容器の仕様を確認してほしいです。次回は説明どおりの品質で受け取りたいです。"
4,1,review,2026-10-02 20:00:00,"今回初めて注文しましたが、パンの表面が香ばしく、中のチーズも程よく溶けていて、とてもおいしくいただきました。ハムと具材のバランスがよく、最後まで飽きずに食べられたのもよかったです。家族にも好評で、別の味も試してみたいという話になりました。注文画面が分かりやすく、商品の説明から受け取りまで安心して利用できました。忙しい日の昼食として使いやすいので、次回は人数分をまとめて注文したいと思っています。ごちそうさまでした。"
5,2,chat,2026-10-02 11:15:00,"先ほどはお問い合わせへのご対応ありがとうございました。ご案内いただいた内容を確認し、こちらで必要な手続きが済んだことをご連絡します。現時点で追加の質問やお願いはありませんので、この問い合わせは対応完了として扱っていただいて大丈夫です。注文に関する連絡は登録済みのメールアドレスで受け取れますので、今後確認が必要になった場合はそちらへお願いします。今回は状況の共有のみで、商品の品質や配送について新たに申告したい事項はありません。"
6,5,chat,2026-10-04 08:40:00,"配送担当への確認が済みましたので、取り急ぎ状況をご連絡します。今回の注文については、担当者と管理画面の内容を照合し、現在表示されている情報を確認しています。お客様に新しくお願いする手続きや、追加で提出していただく情報はありません。現時点では詳細な調査結果や配送予定の変更についてお知らせする内容はなく、確認を実施したことのご報告となります。今後ご案内が必要になりましたら、このチャットまたは登録メールアドレスへご連絡します。"
7,6,email,2026-10-06 10:00:00,"商品の追跡情報が四日間ずっと輸送中のままで、いつ受け取れるのか分からず困っています。配送会社のお知らせでは、輸送経路の山間部で大雪が降り、一部の道路が通行止めになっていると案内されていました。今回の注文も、その影響で配送が止まっているのでしょうか。天候による遅れであれば事情は理解できますが、到着の見込みだけでも知りたいです。商品の保管状態も気になりますので、現在地と今後の配送予定を確認して連絡していただけると助かります。"
8,7,email,2026-10-06 15:20:00,"ハムとチーズのホットサンドを注文しましたが、届いた袋には野菜だけの商品が入っていました。注文確認メールと伝票には正しい商品名が記載されているため、注文時ではなく、商品を取りそろえる作業で間違いが起きたように見えます。一緒に注文した家族の分は合っていたので、一部の商品だけ取り違えたのだと思います。食事の予定があるため、正しい商品を届けてもらえるか確認したいです。出荷前に商品と伝票を照合する手順も見直していただきたいです。"
9,7,chat,2026-10-06 15:45:00,"このたびはご連絡いただきありがとうございます。ご申告いただいた注文内容を担当部署へ共有し、正しい商品を本日中にお届けする手配を進めています。お届け先は今回の注文に登録されているご住所で承っていますので、変更がある場合のみお知らせください。詳しいお届け時間は、担当者からの連絡をご確認いただければと思います。こちらのメッセージは再手配の受付状況をお知らせするもので、追加の原因調査結果については現時点でご案内できる情報はありません。"
10,7,email,2026-10-07 09:10:00,"再手配していただいた商品を受け取り、注文内容と一致していることを確認しました。今回の問い合わせについて、こちらから追加でお願いすることはありません。受け取りが完了したことをお伝えしたかったため、ご連絡しました。担当の方にも確認済みと共有していただければと思います。今後こちらで確認する必要がある書類や手続きがありましたら、登録済みのメールアドレスへお知らせください。この連絡への返信は不要ですので、対応完了として扱っていただいて構いません。"
11,8,chat,2026-10-07 13:00:00,"本日の注文について、受け取り可能な時間帯を確認したくご連絡しました。注文画面に表示されている案内は確認していますが、外出の予定を調整したいため、現在の配送予定をもう一度教えていただけますか。現時点で配達が遅れているという問い合わせではなく、あくまで受け取りの準備のための確認です。住所や電話番号に変更はありません。時間帯の指定ができない場合は、その旨をご案内いただければ大丈夫です。必要であれば注文番号も改めてお送りします。"
12,9,email,2026-10-09 17:30:00,"受け取った商品の外箱が大きくつぶれており、中を確認すると容器のふたがずれて、具材とソースが袋の中に漏れていました。食べ物に触れる部分まで汚れていたため、そのまま食べることには不安があります。受け取り直後の写真を撮影しましたので、必要であればお送りします。今回は返品または返金をお願いしたいです。商品を重ねたときに容器が変形しないか、箱の強度や緩衝材の入れ方も確認してください。注文した商品自体は楽しみにしていたので、とても残念です。"
13,10,review,2026-10-09 19:00:00,"価格に対して十分なボリュームがあり、昼食としてとても満足できました。注文時に商品の違いを問い合わせたところ、スタッフの方が具材や味付けを分かりやすく説明してくれたので、安心して選べました。届いた商品も案内されていた内容どおりで、家族と分けておいしくいただきました。予定していた時間に受け取れたため、その後の用事にも余裕を持って出かけられました。味だけでなく接客もよかったので、初めて利用する知人にも紹介したいと思います。"
14,11,chat,2026-10-10 10:30:00,"ご案内いただいた内容を確認しました。こちらで確認したかった点は解消しましたので、追加の調査や折り返しの連絡は不要です。注文情報についても手元の控えと一致しており、現時点で変更をお願いする予定はありません。このメッセージは問い合わせを終了してよいことをお伝えするために送っています。担当部署への引き継ぎが残っている場合は、確認済みであることだけ共有してください。今後別の確認事項が生じた際には、改めてこちらからご連絡します。"
15,12,email,2026-10-12 08:15:00,"指定していた配達時間を過ぎても商品が届かず、問い合わせたところ、配送車が渋滞にはまっているとの説明でした。同じ地域への注文で時間帯に間に合わなかったのは、今月に入ってこれで三回目です。毎回同じ道路の混雑が理由であれば、配送ルートや一台あたりの配達件数を見直す必要があるのではないでしょうか。予定に合わせて在宅しているため、遅れる場合は事前に知らせてほしいです。今回の到着見込みと、繰り返し遅延している原因への対応を教えてください。"
16,13,review,2026-10-12 21:00:00,"味付けは好みでしたが、届いた商品の大きさが掲載写真から想像していたものより小さく、食事としては少し物足りなく感じました。写真では具材がたっぷり入っているように見えたものの、実際には端の部分に具がほとんどなく、パンだけを食べているような箇所もありました。個体差があることは理解していますが、価格を考えるともう少し内容をそろえてほしいです。商品の重量や具材の量を案内に記載してもらえると、次回注文するときの参考になると思います。"
17,15,chat,2026-10-14 12:00:00,"ご連絡いただいた注文について、配送担当と確認を行いました。担当者が現在の登録内容を確認したことを、このチャットで共有します。現時点でお客様に対応いただく追加作業はありませんので、こちらからの次のご案内をお待ちください。配送予定の変更や、確認済みの問題について新しい詳細をお知らせする連絡ではありません。今後必要な情報がそろい次第、登録されている連絡先へご案内します。このメッセージに対して、受領確認の返信をしていただく必要はありません。"
18,16,email,2026-10-15 09:45:00,"今回の注文は予定より一日遅れて届きました。配送会社からは、暴風雨の影響で高速道路が通行止めになり、配送車が通常の経路を使えなくなったと説明を受けています。迂回路も混雑していたため、当日中の配達が難しかったそうです。遅れは残念でしたが、担当の運転手さんが早めに電話で状況を知らせてくれたので、受け取り予定を調整できました。天候が原因であれば仕方ないと思いますが、注文画面の到着予定にも変更が反映されると、さらに分かりやすいです。"
19,17,review,2026-10-16 18:20:00,"新しく追加されたメニューを昼食用に注文しました。香ばしいパンと具材の組み合わせがよく、普段頼んでいる商品とは違ったおいしさを楽しめました。味が濃すぎないので最後まで食べやすく、職場の同僚からも好評でした。個別に包装されていて配りやすかった点も、まとめて注文する立場として助かりました。商品の説明や写真から想像したとおりの内容で、満足しています。期間限定であれば販売期間を知りたいですし、できれば今後も定番として残してほしいです。"
20,18,email,2026-10-17 14:05:00,"配達完了の通知が来たのに商品が見当たらず、確認したところ隣の家に届いていました。注文確認メールの住所は正しかったのですが、商品の配送ラベルには別の番地が印字されていました。配送員の見間違いというより、出荷前のラベル作成や貼り付けの段階で誤りがあったように思います。近所の方から連絡をいただいて気付きましたが、食品なので受け取りまでの保管状態も心配です。倉庫で住所情報とラベルを照合する手順を確認し、今後の対応を教えてください。"
21,18,chat,2026-10-17 14:30:00,"ご連絡いただいた注文について、明日の再配達を受け付けました。お届け先は登録済みの住所を利用する予定ですので、変更が必要な場合は本日中にお知らせください。具体的な配達時間のご案内は、配送担当からの連絡をお待ちいただければと思います。このメッセージは再配達の受付が完了したことをお伝えするためのものです。調査内容や原因について新たに確定した情報は含まれていません。受け取り方法について追加のご希望がある場合は、このチャットからご連絡ください。"
22,19,chat,2026-10-18 11:00:00,"注文した商品の受け取りについて、配達予定の時間帯を教えていただけますか。午後に短時間だけ外出する可能性があるため、在宅する時間を調整したいと考えています。現在のところ配達予定日を過ぎているわけではなく、配送上のトラブルを報告する問い合わせでもありません。注文時の住所や連絡先はそのままで問題ありません。細かい時刻が分からない場合は、午前か午後かといった目安だけでも助かります。追加で必要な情報があれば、確認して返信します。"
23,20,review,2026-10-19 20:30:00,"注文から受け取りまでがスムーズで、届いたホットサンドも温かいまま食べられました。パンの表面がべたつかず、具材もしっかり入っていて、家で手軽に外食気分を楽しめたのがよかったです。包装が開けやすく、食卓に出すまでに手間がかからなかった点も助かりました。配達の方も丁寧に声をかけてくれたので、最後まで気持ちよく利用できました。忙しくて食事の準備が難しい日に頼れるお店が見つかってうれしいです。また別の商品も注文してみたいと思います。"
24,14,chat,2026-10-13 16:00:00,"お問い合わせへのご回答を確認しました。説明いただいた内容で理解できましたので、この件について追加の対応をお願いする必要はありません。注文の状況についても、こちらで確認したかった内容は把握できています。今回のメッセージは対応完了のご連絡であり、新しい不具合や配送の問題をお伝えするものではありません。確認のために別の担当者からご連絡いただく予定がある場合は、すでに解決している旨を共有してください。今後必要になった際には、改めてお問い合わせします。"
channelのemail・chat・reviewは管理用の値として英語のままにしています。検索・分類の対象であるfeedback_textは、すべて日本語です。
dbt_project.ymlの末尾に、seedの設定を追加します。既にseeds:がある場合は、その配下にマージしてください。
seeds:
  jaffle_shop:
    +quote_columns: false
    raw_order_feedback:
      +column_types:
        feedback_text: varchar
        created_at: timestamp
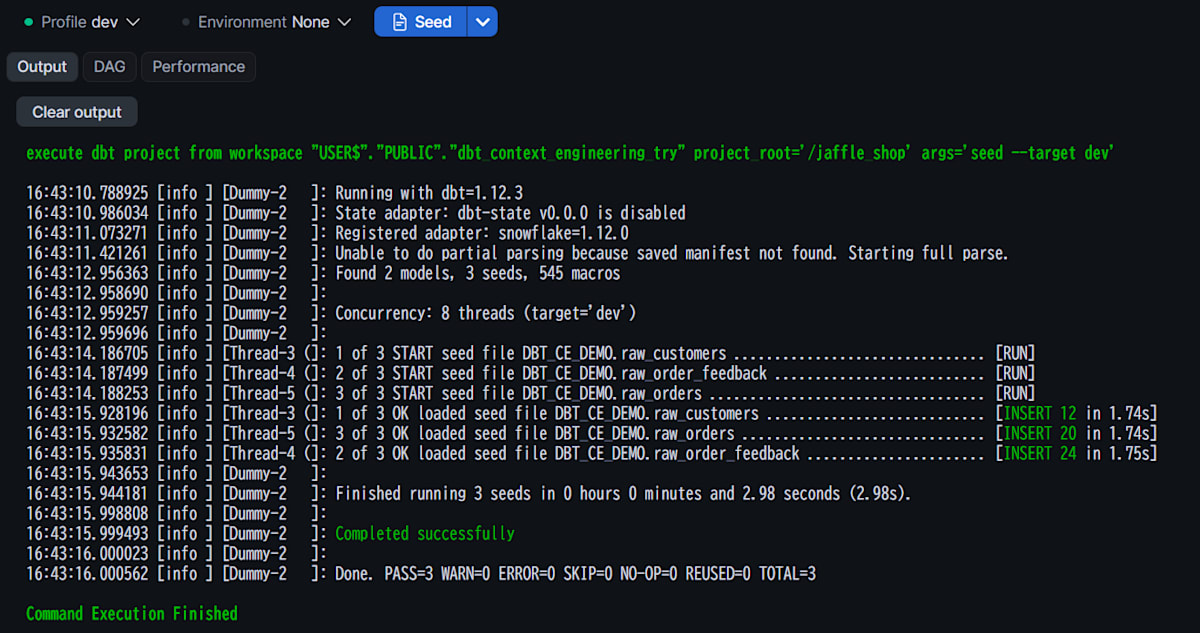
Workspaceでdbt seedを実行します。再ロードする場合は、Additional Flagsに--full-refreshも追加します。PASS=3 ERROR=0のように、3つのseedがすべて成功していればOKです。
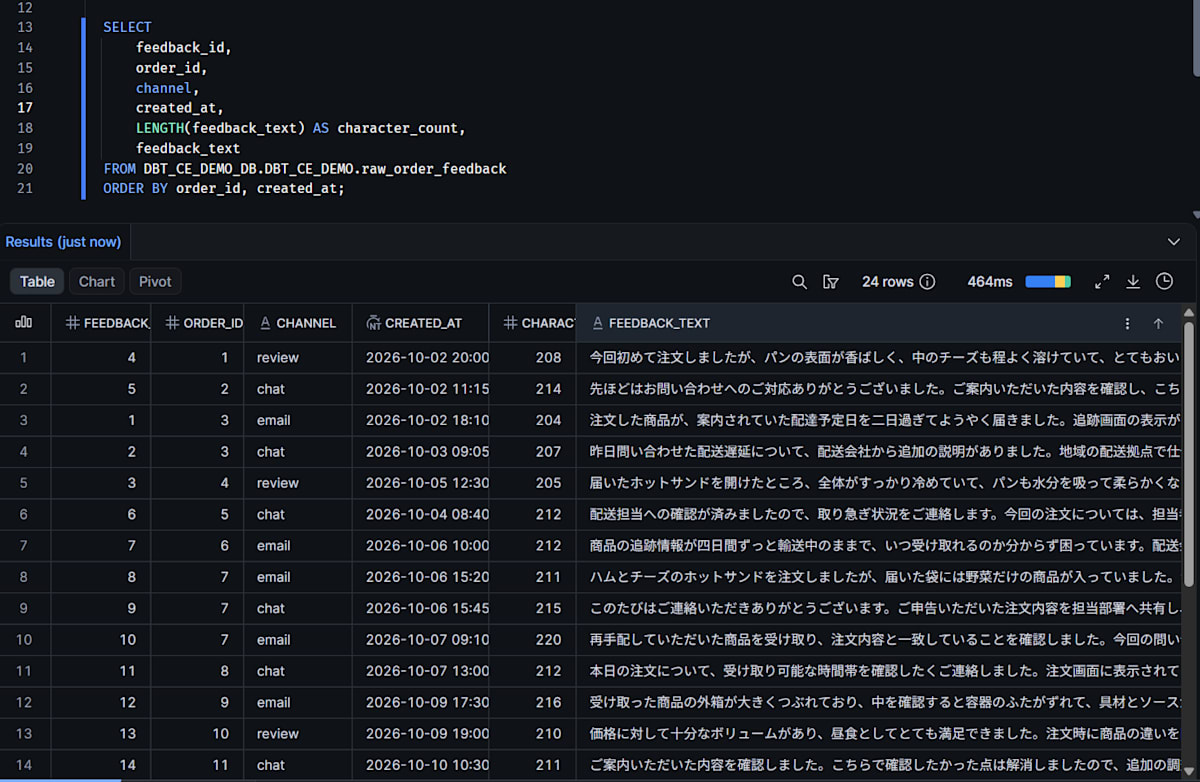
サンプルとして、ロードしたデータについて1テーブル確認します。24件の日本語の文章が表示されていればOKです。character_countで各文章の文字数も確認します。
SELECT
    feedback_id,
    order_id,
    channel,
    created_at,
    LENGTH(feedback_text) AS character_count,
    feedback_text
FROM DBT_CE_DEMO_DB.DBT_CE_DEMO.raw_order_feedback
ORDER BY order_id, created_at;
5. stagingモデルの作成
今回はseedを利用するため、ref()で参照します。顧客・注文・フィードバックの3つのstagingモデルを作成します。
-- models/staging/stg_customers.sql
select
    id as customer_id,
    first_name,
    last_name
from {{ ref('raw_customers') }}
-- models/staging/stg_orders.sql
select
    id as order_id,
    user_id as customer_id,
    order_date,
    status
from {{ ref('raw_orders') }}
-- models/staging/stg_order_feedback.sql
select
    feedback_id,
    order_id,
    channel,
    created_at,
    feedback_text
from {{ ref('raw_order_feedback') }}
今回の検索処理で直接使うのは、stg_order_feedbackです。顧客・注文モデルは、後で検索結果に注文情報や顧客情報を付けるための土台として用意しています。
6. dbt_context_engineeringのインストール
プロジェクト直下にpackages.ymlを置きます。以下では0.2.0を指定します。
packages:
  - package: dbt-labs/dbt_context_engineering
    version: "0.2.0"
packages.ymlを保存したら、WorkspaceのDepsで、事前準備で作成したEXTERNAL ACCESS INTEGRATION(dbt_external_access_integration)を指定して実行します。
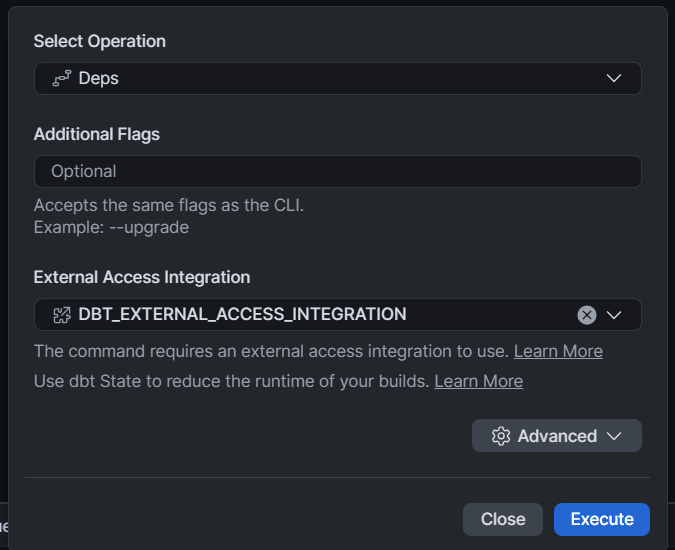
dbt_context_engineeringのインストールが成功し、Workspaceにdbt_packagesフォルダが作られていればOKです。
7. varsの設定とstagingモデルの実行
dbt_project.ymlにvarsを追加します。
vars:
  # AI関数は実行コマンドで明示的に有効化
  ai_functions_enabled: false

  # 多言語対応の埋め込みモデル
  embedding_model: 'snowflake-arctic-embed-l-v2.0'

  # 今回の日本語サンプルでは小さめに設定
  chunk_target_tokens: 64
  chunk_overlap_tokens: 0

  # guard_batchの上限
  max_batch_rows: 10000
  max_est_tokens: 5000000
chunk_target_tokensを小さめにしている理由を補足します。
確認したchunk実装では、CEIL(LENGTH(テキスト) / 4.0)で推定トークン数を計算しています。日本語の実際のトークン数を測定しているわけではないため、今回は約200文字のコメントを何件もまとめすぎないよう、目標値を64にしています。
ただし、**この設定だけで1コメント1チャンクになるわけではなく、モデルの入力上限を確実に守れるわけでもありません。**実際に作られたチャンクを後ほど確認します。
AI関数を使うコマンドでは、WorkspaceのAdditional Flagsに次のオプションを入れて有効化します。dbt_project.ymlのデフォルトは無効のままにしておきます。
--vars '{"ai_functions_enabled": true}'
続いて、stagingモデルを作成します。Workspaceでdbt runを、Additional Flagsに--select stg_customers stg_orders stg_order_feedbackを入れて実行します。
3つのモデルが正常に作成されていればOKです。
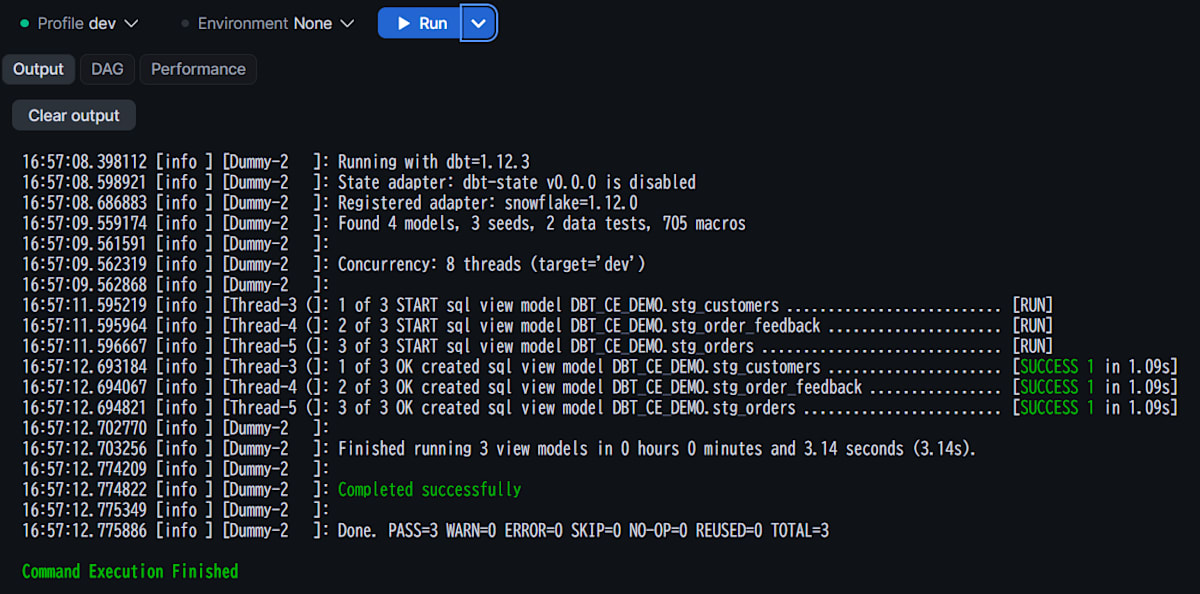
試してみた
1. chunk: 文章をチャンクにまとめる
まず、chunkで文章をまとめます。実装コードはこちらです。
Snowflakeでは、AI関数を使わず、ウィンドウ関数などのSQLでチャンクを作成します。
大まかな処理は、次のとおりです。
LENGTHとCEILで、各行の推定トークン数を計算SUM(...) OVER (...)で、同じ注文内の累積値を計算FLOORやDENSE_RANKで、チャンクのグループを決定- グループごとに文章を連結し、元の行IDを
source_rowsへ保持
Snowflake固有のテキスト分割AIを呼ぶのではなく、入力された行を順番にまとめる処理です。
今回は注文ごとに分け、同じ注文に関する文章を投稿日時順に並べます。
-- models/context/feedback_chunks.sql
{{ config(materialized='table') }}

{{ dbt_context_engineering.chunk(
    relation = ref('stg_order_feedback'),
    id_column = 'feedback_id',
    order_column = 'created_at',
    text_column = 'feedback_text',
    partition_column = 'order_id',
    label_column = 'channel'
) }}
partition_column = 'order_id'によって、異なる注文の文章が同じチャンクに入らないようにします。
label_column = 'channel'を指定すると、文章の前にemail:などのチャネル名が付きます。ここでいうラベルは、後ほどclassifyで付ける分類ラベルとは別です。
Workspaceでdbt runを、Additional Flagsに次の内容を入れて実行します。
--select feedback_chunks
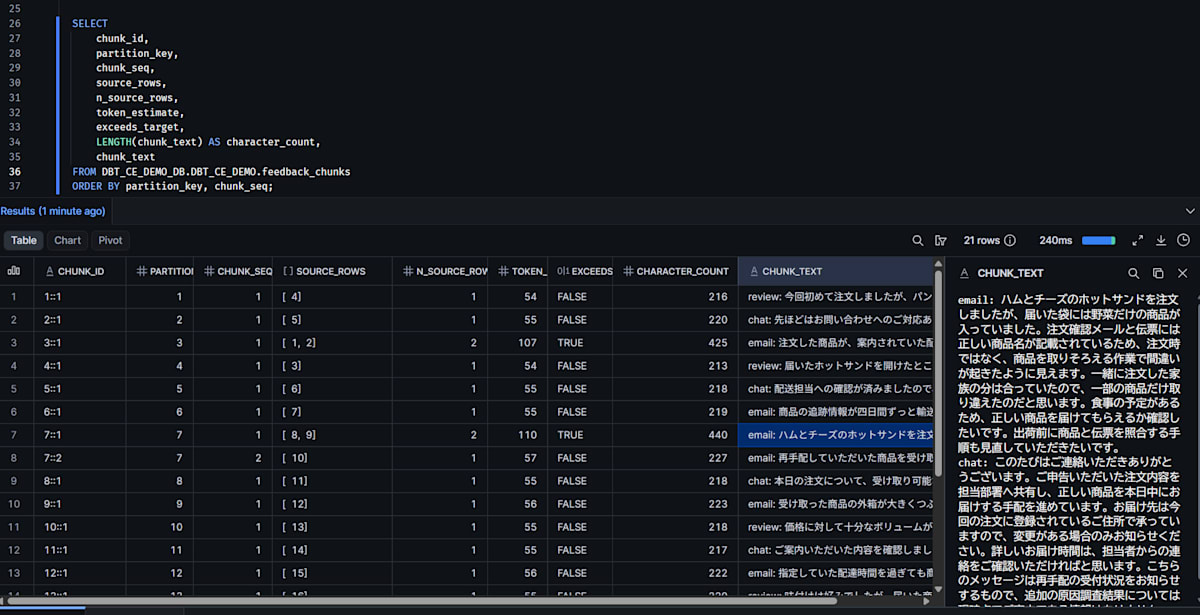
結果を確認します。
SELECT
    chunk_id,
    partition_key,
    chunk_seq,
    source_rows,
    n_source_rows,
    token_estimate,
    exceeds_target,
    LENGTH(chunk_text) AS character_count,
    chunk_text
FROM DBT_CE_DEMO_DB.DBT_CE_DEMO.feedback_chunks
ORDER BY partition_key, chunk_seq;
結果として、下図のとおりとなりました。今回の例では、1つのコメントが分割されることなく、同じ注文のコメントはまとめてチャンク化されていました。
2. embed: チャンクをベクトル化する
次に、embedでチャンクをベクトル化します。実装コードはこちらです。
Snowflake向けのsnowflake__embedでは、AI_EMBEDを呼び出します。今回の設定で生成されるSQL式は、次の形です。
AI_EMBED('snowflake-arctic-embed-l-v2.0', chunk_text)
AI_EMBEDは、テキストを数値のベクトルへ変換し、VECTOR型で返します。今回のモデルでは1024次元のベクトルになります。
モデルには、処理量を確認するguard_batchも設定します。実装コードと、推定トークン数の計算はこちらです。
Snowflakeでは、入力テーブルに対してCOUNT(*)と推定トークン数のSUMを実行します。集計結果をdbt側で上限と比較し、超過していればコンパイルエラーとして停止します。
-- models/context/feedback_embeddings.sql
{{ config(
    materialized='table',
    pre_hook=[
        "{{ dbt_context_engineering.guard_batch(ref('feedback_chunks'), 'chunk_text') }}"
    ]
) }}

select
    chunk_id,
    partition_key as order_id,
    source_rows,
    chunk_text,
    {{ dbt_context_engineering.embed('chunk_text') }} as embedding
from {{ ref('feedback_chunks') }}
検索結果から元の投稿をたどれるように、source_rowsも引き継ぎます。
Workspaceでdbt runを、Additional Flagsに次の内容を入れて実行します。AI関数を使うため、ai_functions_enabledを有効化します。
--select feedback_embeddings --vars '{"ai_functions_enabled": true}'
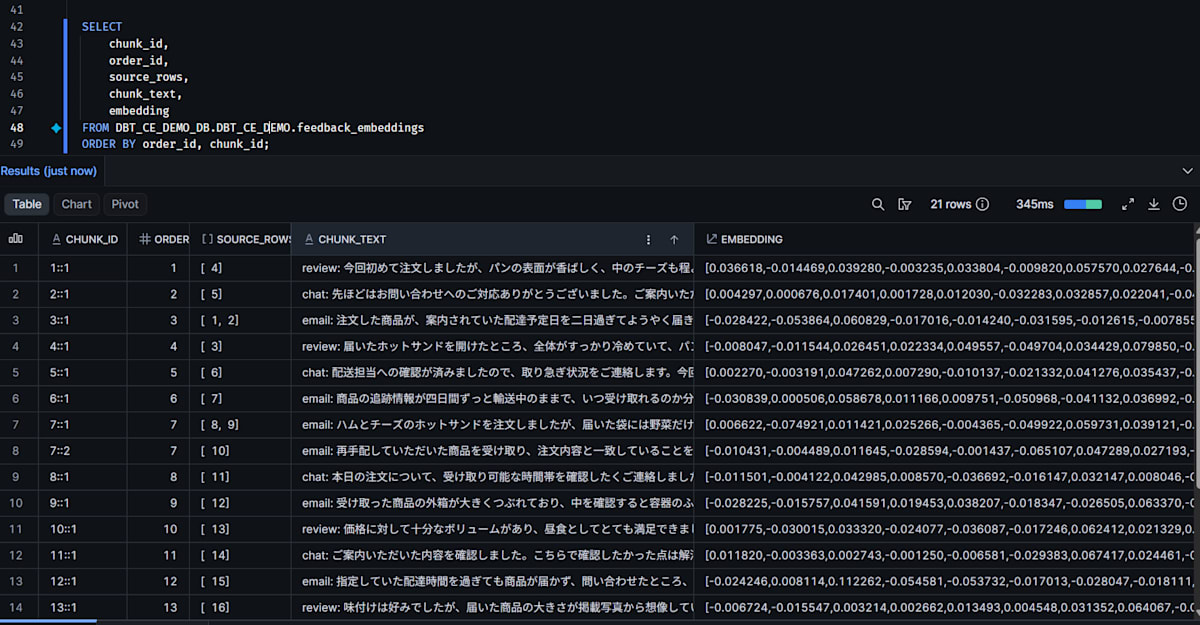
結果を確認します。
SELECT
    chunk_id,
    order_id,
    source_rows,
    chunk_text,
    embedding
FROM DBT_CE_DEMO_DB.DBT_CE_DEMO.feedback_embeddings
ORDER BY order_id, chunk_id;
各チャンクのembedding列に、ベクトルが入っていればOKです。
なお、ここまでの設定では、ai_run_logへのログ記録は行っていません。
ログを記録する際に使うマクロは、開始ログのlog_ai_runと、正常終了ログのcomplete_ai_runです。
Snowflakeでは、どちらもログテーブルへINSERTする処理です。開始時と正常終了時のレコードを追記するもので、Snowflakeの実際の請求額を自動取得する関数ではありません。利用するには、ログテーブルの準備とフックへの組み込みが必要です。本記事ではログ設定は省略します。
3. vector_search: 日本語で意味検索する
日本語の検索クエリとして、次の文章を使います。
配送が遅れた注文について、遅延の原因を知りたい
目的は、配送に関係する文章を広く集めることではなく、仕分けミス・渋滞・悪天候など、遅延の原因が書かれた文章を取得することです。
ここで使うマクロは、vector_searchです。実装コードはこちらです。
Snowflakeでは、VECTOR_COSINE_SIMILARITYで、保存済みのベクトルと検索クエリのベクトルの類似度を計算します。その結果をscoreとして、ORDER BY score DESCとLIMITで上位を返します。
また、vector_searchは検索文字列を自動でベクトル化しません。query_embeddingに、ベクトルを返すSQL式を渡す必要があります。
そのため、検索クエリ側でもembedを使用します。この部分もSnowflakeではAI_EMBEDです。文書側と検索クエリ側で、同じ埋め込みモデルを使います。
-- models/context/search_raw.sql
{{ config(materialized='table') }}

{{ dbt_context_engineering.vector_search(
    relation = ref('feedback_embeddings'),
    embedding_column = 'embedding',
    query_embedding = dbt_context_engineering.embed(
        "'配送が遅れた注文について、遅延の原因を知りたい'"
    ),
    top_k = 10,
    id_column = 'chunk_id',
    select_columns = [
        'order_id',
        'source_rows',
        'chunk_text'
    ]
) }}
embedの引数の内側にシングルクォートがあるのは、SQL上の文字列リテラルとして渡すためです。
生成されるSQLの中心部分は、次の形になります。
SELECT
    chunk_id,
    order_id,
    source_rows,
    chunk_text,
    VECTOR_COSINE_SIMILARITY(
        embedding,
        AI_EMBED(
            'snowflake-arctic-embed-l-v2.0',
            '配送が遅れた注文について、遅延の原因を知りたい'
        )
    ) AS score
FROM DBT_CE_DEMO_DB.DBT_CE_DEMO.feedback_embeddings
ORDER BY score DESC, chunk_id
LIMIT 10;
このように、Cortex Searchサービスへの問い合わせではなく、通常のテーブルに対するSQLとなります。
実際にテーブルとして生成するため、Workspaceでdbt runを、Additional Flagsに次の内容を入れて実行します。
--select search_raw --vars '{"ai_functions_enabled": true}'
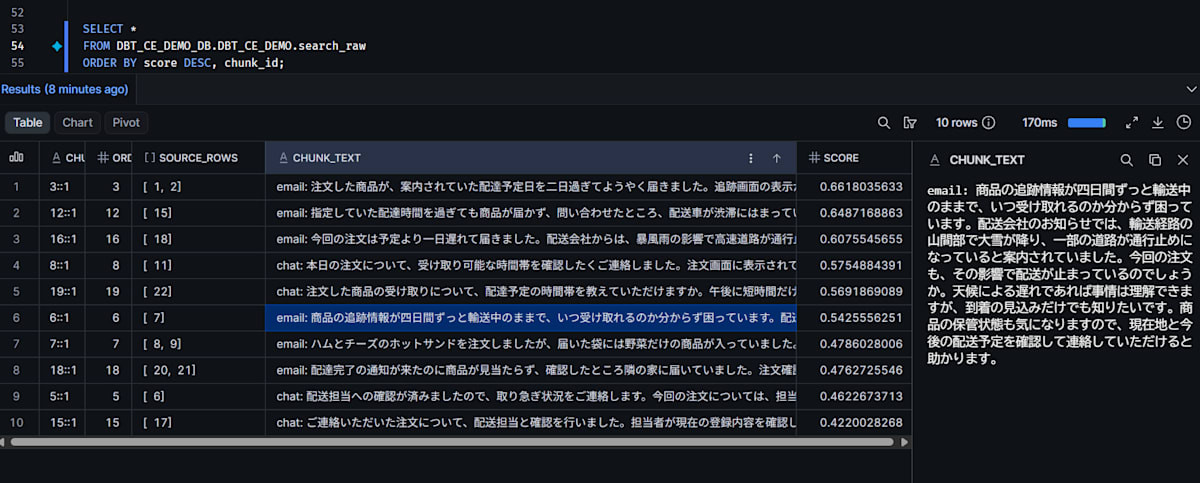
結果をスコア順に確認します。
SELECT *
FROM DBT_CE_DEMO_DB.DBT_CE_DEMO.search_raw
ORDER BY score DESC, chunk_id;
scoreはコサイン類似度です。値が高いほどクエリに近いベクトルとして順位付けされますが、回答の正しさや関連性の確率ではありません。
結果として、上位スコア3件については、「仕分け先の間違い」「渋滞」「暴風雨の影響で通行止め」と、「配送が遅れた注文について、遅延の原因を知りたい」という質問に合致するテキストが出てきました。
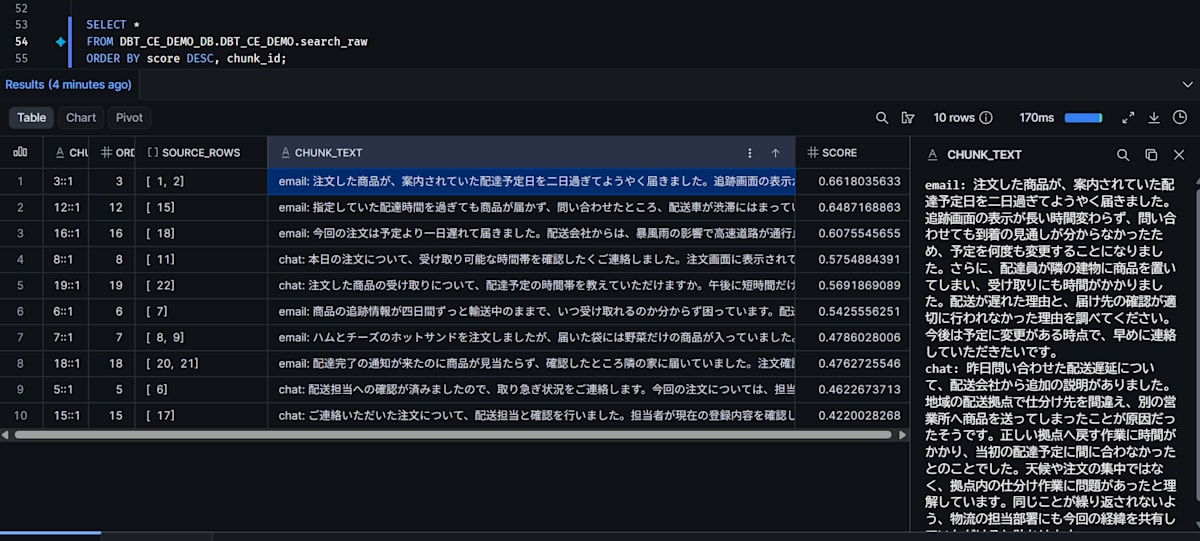
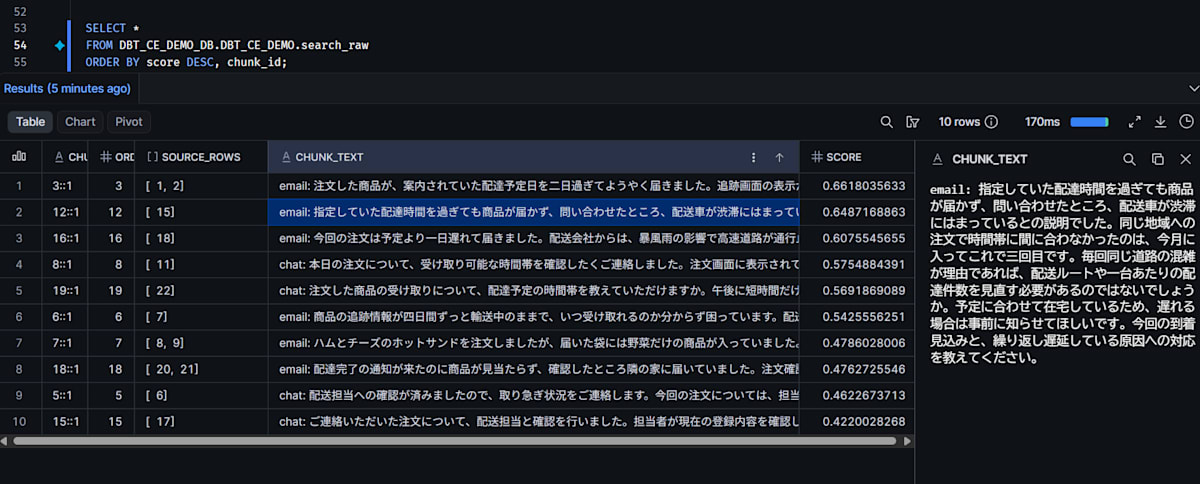
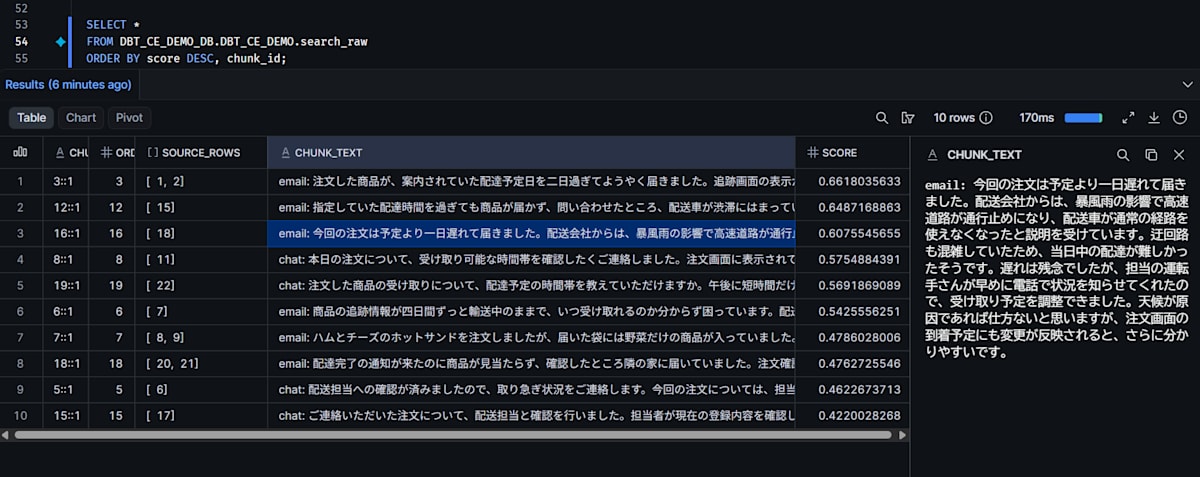
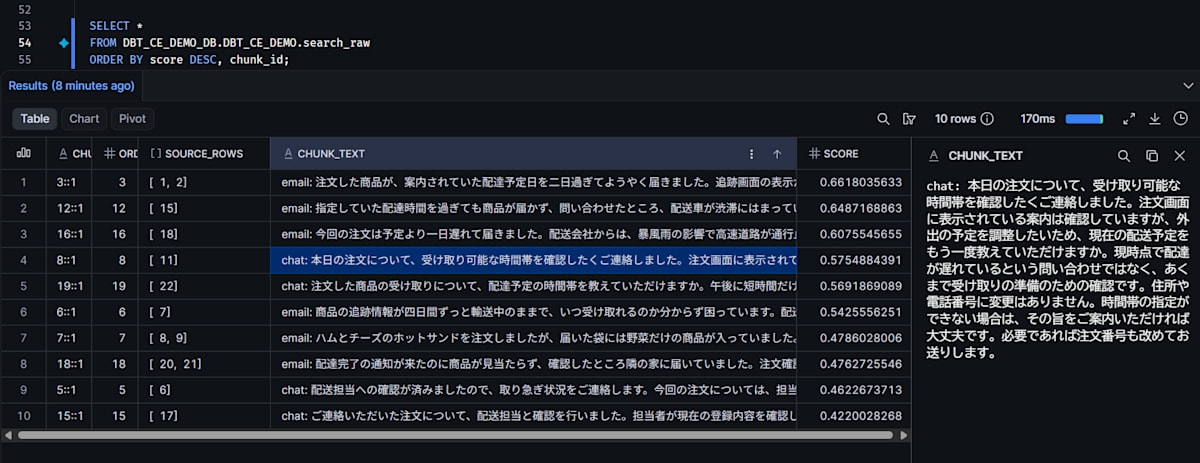
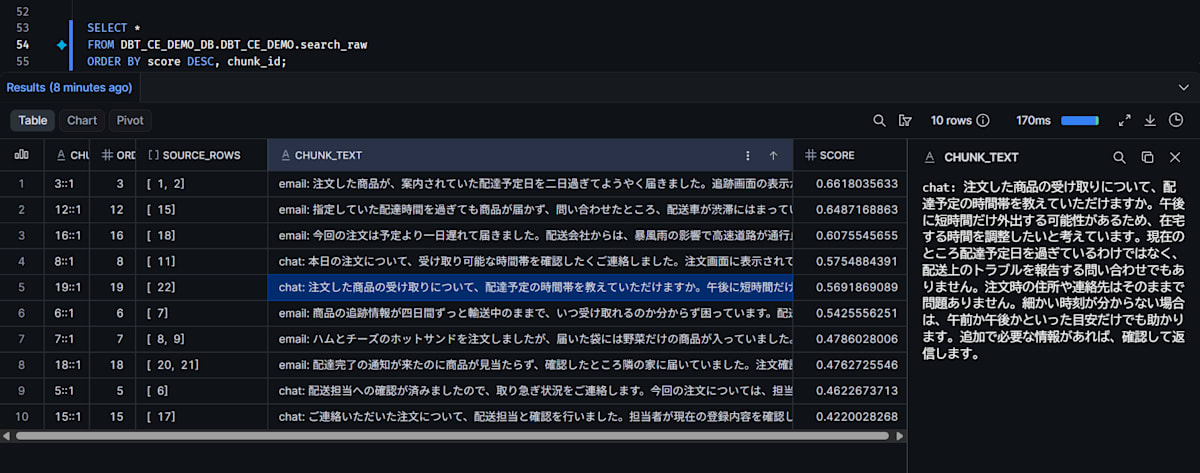
一方で、4位~6位のスコアのレコードについては「配送状況の確認」に関するテキストが中心であり、必ずしも「配送が遅れた注文について、遅延の原因を知りたい」という問いに答えるものではありませんでした。
なお、この例では固定の検索クエリに対する結果を、dbtでテーブルとして作成しています。エンドユーザーに提供する場合、対話型の検索画面や、任意の質問を受け付けるAPIなどは別途作成が必要となりますのでご注意ください。
4. classify: ラベルで絞り込んで関連性を改善する
次に、各チャンクへ分類ラベルを付け、検索対象を絞り込みます。
今回は、次の6つのラベルを定義します。
| ラベル | 内容 |
|---|---|
delivery_delay |
天候以外の原因による配送遅延 |
weather_disruption |
雪・暴風雨などによる配送への影響 |
handling_error |
商品の取り違え・配送ラベルの誤り・誤配送 |
product_quality |
商品・包装の品質に関する不満 |
praise |
商品やサービスに対する具体的な称賛 |
routine_status |
状況確認・手続き案内・対応完了などの連絡 |
ラベルの識別子はSQLで扱いやすいよう英語のままにし、分類の指示は日本語で記述します。
まず、自分のプロジェクトに、プロンプトと分類スキーマをマクロとして定義します。
macros/prompts/feedback_topic.sql(クリックで展開)
-- macros/prompts/feedback_topic.sql
{% macro prompt__feedback_topic__v1() -%}
{%- raw -%}
以下の注文に関する文章を読み、最も適切なトピックラベルを1つ選んでください。

入力には、お客様からの問い合わせやレビューだけでなく、
サポート担当者からの返信が含まれる場合もあります。
また、同じ注文に関する複数のメッセージが含まれる場合もあります。

ラベルの定義:
- delivery_delay:
  渋滞、配送拠点の仕分けミス、配送ルートなど、
  天候以外の理由による配送の遅れが主な話題である文章。
- weather_disruption:
  大雪、暴風雨、悪天候による通行止めなど、
  天候が配送に影響したことが主な話題である文章。
- handling_error:
  商品の取り違え、配送ラベルの誤り、
  届け先の間違いなどが主な話題である文章。
- product_quality:
  商品の温度、食感、量、包装の破損、
  中身の漏れなど、品質への不満が主な話題である文章。
- praise:
  商品のおいしさ、接客、包装などに対する
  具体的な称賛が主な話題である文章。
- routine_status:
  状況確認、配達時間の問い合わせ、受付完了、
  再配達の手配、対応完了などの定型的な連絡。
  原因や具体的な問題について、新しい説明がない文章。

判断ルール:
- 文章の長さではなく、内容に基づいて分類してください。
- 「配送」「確認」「再配達」という言葉だけで
  delivery_delayに分類しないでください。
- 単に配達予定を尋ねている文章や、
  配送担当に確認したことだけを伝える文章はroutine_statusです。
- 天候が配送遅延の原因として明記されている場合は、
  weather_disruptionを優先してください。
- 配送遅延の原因が主な話題で、誤配送にも触れている場合は、
  主題に応じてdelivery_delayまたはweather_disruptionを選んでください。
- 問題が解決したことだけを伝えるお礼はroutine_statusです。
- 複数のメッセージがある場合、定型的な返信よりも、
  具体的な問題や原因の説明を重視してください。
- 複数の具体的な問題がある場合は、中心となる話題を1つ選んでください。

対象の文章:
{{ input }}
{%- endraw -%}
{%- endmacro %}

{% macro schema__feedback_topic__v1() -%}
{%- raw -%}
{
  "type": "object",
  "properties": {
    "topic": {
      "type": "string",
      "enum": [
        "delivery_delay",
        "weather_disruption",
        "handling_error",
        "product_quality",
        "praise",
        "routine_status"
      ]
    }
  },
  "required": ["topic"],
  "additionalProperties": false
}
{%- endraw -%}
{%- endmacro %}
これらを読み込む際に使うのが、promptとschema_defです。実装コードはこちらです。
この2つは、SnowflakeのAI関数を呼ぶものではありません。dbtのコンパイル時に、指定した名前・バージョンに対応するマクロを探し、プロンプト文字列とJSONスキーマ文字列を取得します。今回はprompt__feedback_topic__v1とschema__feedback_topic__v1が呼ばれます。
実際の分類に使うマクロと、プロンプトと入力列の組み立てを行うマクロはこちらです。
Snowflake向けの処理は、次の流れです。
- スキーマの
enumから分類候補を取得 render_promptで、プロンプトの{{ input }}部分に入力列を組み込むSQL式を生成ARRAY_CONSTRUCTで分類候補の配列を作り、AI_CLASSIFYへ渡す- 戻り値の
:labels[0]を取り出し、文字列に変換
続いて、分類モデルを作成します。guard_batchも再び使用します。今回はmeta.ai_promptを設定し、入力テキストに加えて、プロンプトやスキーマも推定量に含めるようにします。ただし、これも実際の請求トークン数の測定ではありません。
-- models/context/feedback_classified.sql
{{ config(
    materialized='table',
    meta={
        'ai_prompt': {
            'name': 'feedback_topic',
            'version': 'v1'
        }
    },
    pre_hook=[
        "{{ dbt_context_engineering.guard_batch(ref('feedback_chunks'), 'chunk_text') }}"
    ]
) }}

select
    chunk_id,
    {{ dbt_context_engineering.classify(
        'chunk_text',
        dbt_context_engineering.prompt('feedback_topic', 'v1'),
        dbt_context_engineering.schema_def('feedback_topic', 'v1')
    ) }} as classification
from {{ ref('feedback_chunks') }}
Workspaceでdbt runを、Additional Flagsに次の内容を入れて実行します。
--select feedback_classified --vars '{"ai_functions_enabled": true}'
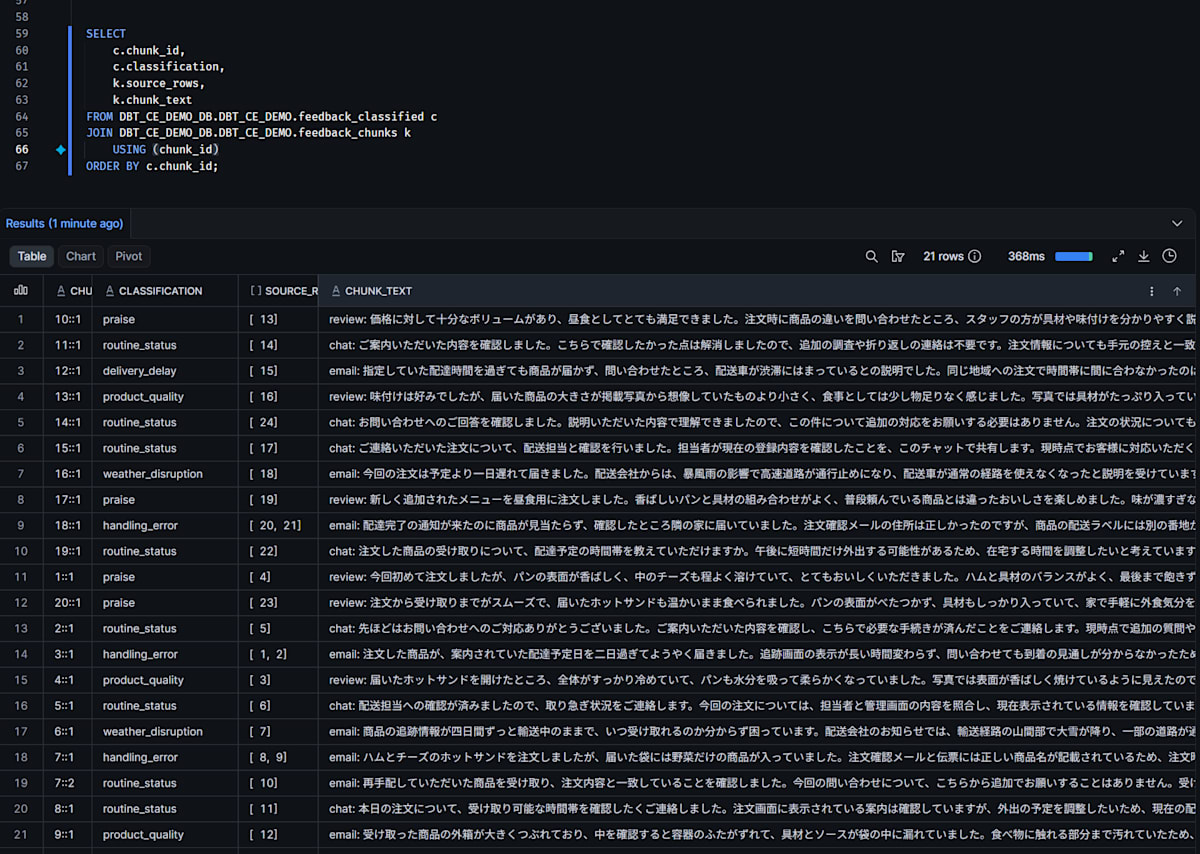
分類結果を確認します。
SELECT
    c.chunk_id,
    c.classification,
    k.source_rows,
    k.chunk_text
FROM DBT_CE_DEMO_DB.DBT_CE_DEMO.feedback_classified c
JOIN DBT_CE_DEMO_DB.DBT_CE_DEMO.feedback_chunks k
    USING (chunk_id)
ORDER BY c.chunk_id;
パッケージのclassifyが返すのは、ラベル文字列です。後続のSQLでは、classification:topicなどではなく、classificationをそのまま文字列として比較します。
結果としては、CLASSIFICATIONがNULLのレコードもなく、適切に分類されていました。
次に、埋め込みと分類ラベルを結合します。このモデル自体にはAI関数の呼び出しを書かず、保存済みの結果を結合するビューにします。
-- models/context/feedback_embeddings_labeled.sql
{{ config(materialized='view') }}

select
    e.chunk_id,
    e.order_id,
    e.source_rows,
    e.chunk_text,
    e.embedding,
    c.classification
from {{ ref('feedback_embeddings') }} e
join {{ ref('feedback_classified') }} c
    using (chunk_id)
最後に、検索対象をdelivery_delay・weather_disruption・handling_errorの3つのラベルに絞ります。検索クエリは、比較のため先ほどと同じものを使います。
ここでも、先ほどのvector_searchと、クエリのベクトル化に使うembedを使用します。Snowflakeでは、filterに渡した条件がSQLのWHERE句になります。対象ラベルの行に絞ったうえで、VECTOR_COSINE_SIMILARITYによるスコア順に上位を取得する形です。
-- models/context/search_classified.sql
{{ config(materialized='table') }}

{{ dbt_context_engineering.vector_search(
    relation = ref('feedback_embeddings_labeled'),
    embedding_column = 'embedding',
    query_embedding = dbt_context_engineering.embed(
        "'配送が遅れた注文について、遅延の原因を知りたい'"
    ),
    top_k = 10,
    id_column = 'chunk_id',
    select_columns = [
        'order_id',
        'source_rows',
        'chunk_text',
        'classification'
    ],
    filter = "classification in ('delivery_delay', 'weather_disruption', 'handling_error')"
) }}
Workspaceでdbt runを、Additional Flagsに次の内容を入れて実行します。
--select feedback_embeddings_labeled search_classified --vars '{"ai_functions_enabled": true}'
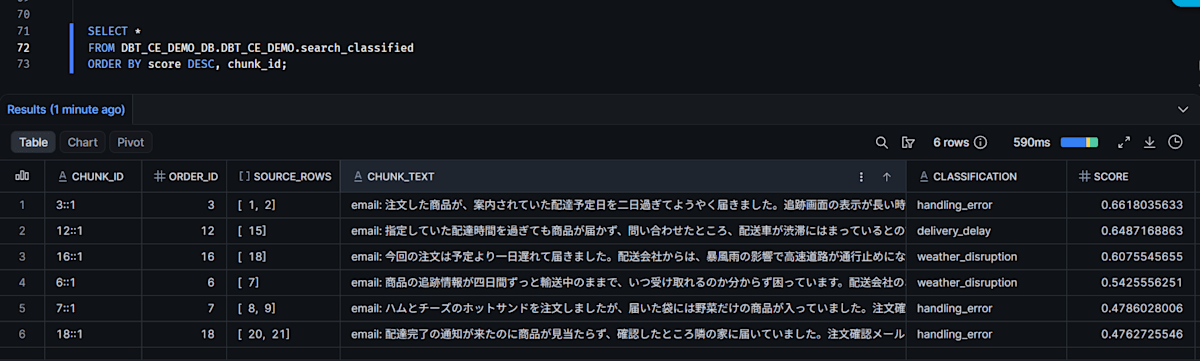
結果を確認します。
SELECT *
FROM DBT_CE_DEMO_DB.DBT_CE_DEMO.search_classified
ORDER BY score DESC, chunk_id;
結果としては以下のように、レコード数が絞られて出力されました。VECTOR_COSINE_SIMILARITYで対象とするレコード数を事前に絞り込みたい場合は、適切なラベル付けが有効と言えそうです。
最後に
dbt Projects on Snowflake上でdbt_context_engineeringを使い、日本語の問い合わせ・レビューを「chunk → embed → vector_search」で検索し、classifyのラベルで検索対象を絞り込むところまで試しました。
チャンク化・ベクトル化・検索・分類が、ref()でつながる通常のdbtモデルとして書けるため、SnowflakeのAI_EMBEDやAI_CLASSIFYを使った処理もdbtで管理できるのが便利だと感じました!
一方で、2026年11月16日時点ではバージョンが0.x台で、Beta機能も含まれているためご注意ください。まずは小規模なデータで試してみるのがおすすめです。