[レポート]dbt State で、runs を最適化 ~コンピュートの削減、データの鮮度向上、そしてより速い iterationを実現~ #dbtWTTokyo
dbt World Tour Tokyo 2026のセッションレポート。9月にGA となったdbt Stateについて、ライブデモを交えながら仕組みと設定、活用方法を詳しく解説します。

2026.10.21
かわばたです。
2026年10月20日に、アンダーズ 東京で「dbt World Tour Tokyo 2026」が開催されました。
本記事はセッション「dbt State で、runs を最適化」のレポートブログとなります。キーノートでも紹介された、9 月に GA となった dbt State について、ライブデモを交えて仕組みと設定を解説するセッションでした。
詳細は下記をご確認ください。
※本記事は筆者のメモをもとに要約しています。
※dbt State は 2026年9月16日に GA となり、30 日間のトライアルがあります。設定名は公式ドキュメントの表記に合わせています。
登壇者
- 三角 勇貴 氏
- dbt Labs Partner Solutions Architect
アジェンダ
モデルの再ビルドとジョブの複雑化
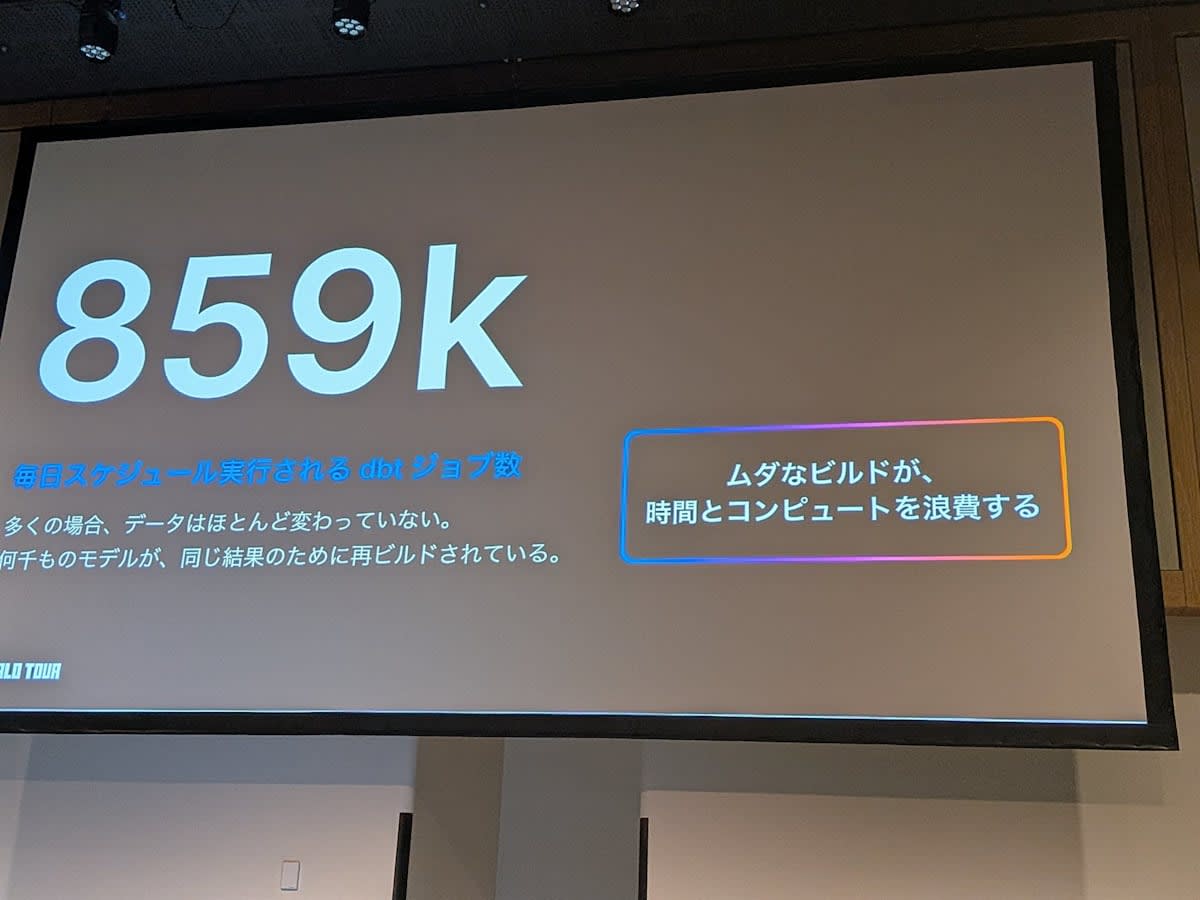
- 現実には、変更のない多くのモデルを毎回再ビルドしている。結果として compute コストと時間を浪費している
- これまでの対処法は、ジョブを複雑にすることだった
- 毎時・日次・週次など、鮮度の異なるモデルごとにジョブを作る
- 実行時のセレクターを複雑にして、最適なモデル実行を実現しようとする
- defer のために manifest ファイルを管理する
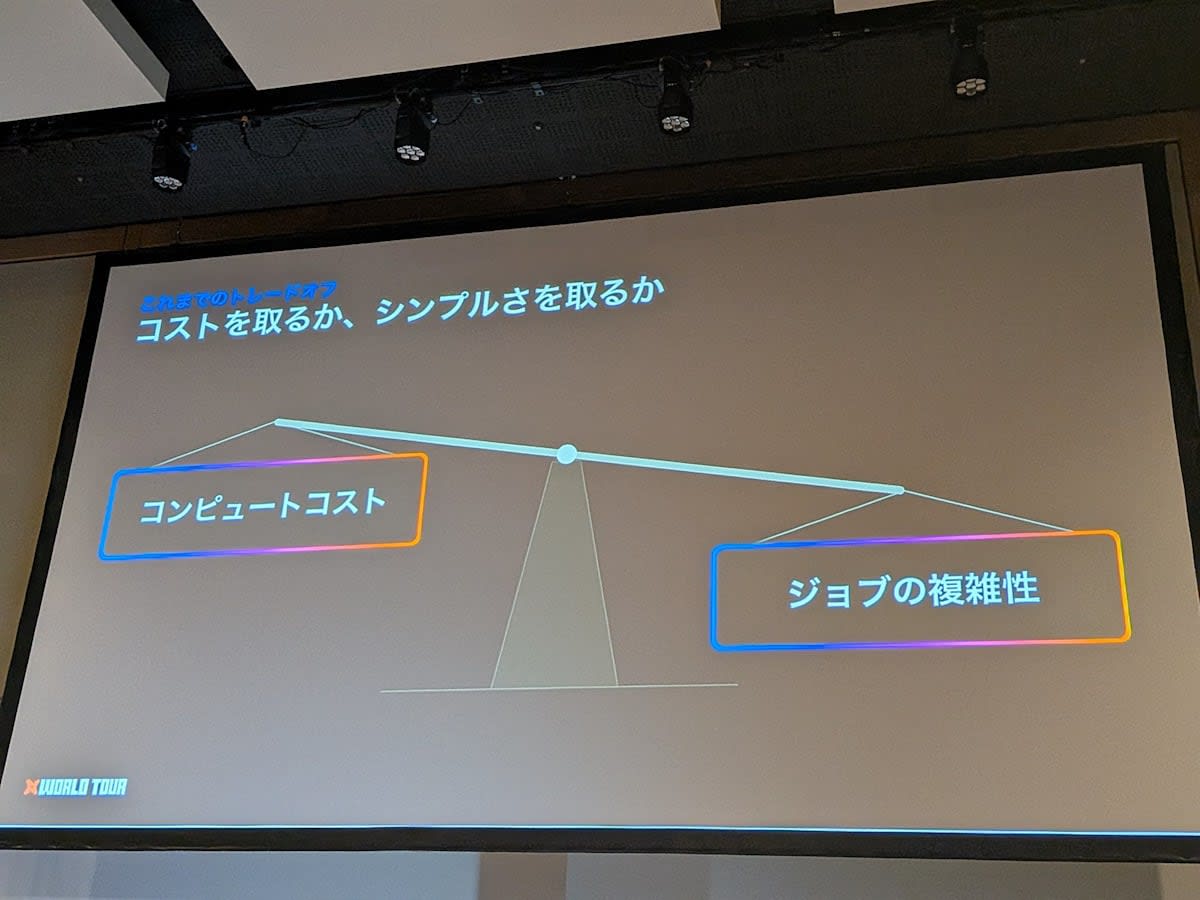
- ジョブの複雑性と compute コストの両方を抑えることは、これまで難しかった
- このトレードオフを解消するのが dbt State
dbt State とは
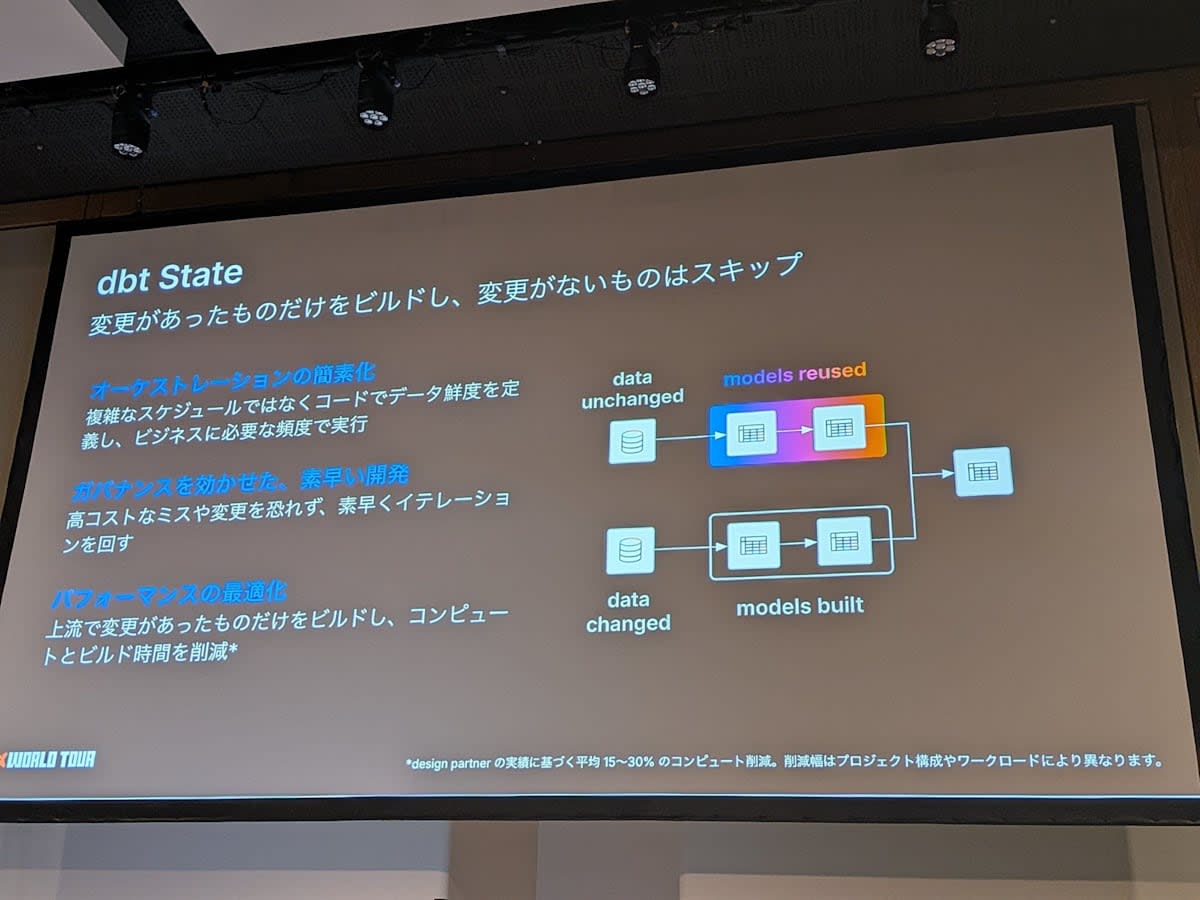
- モデルの変更を自動で検知し、変更のないモデルのビルドをスキップするサービス
dbt buildだけで最適なモデル実行ができる。複雑なジョブ設計や manifest の管理は不要になる- compute コストと実行時間の削減はもちろん、オーケストレーションの簡素化とガバナンスの効いた素早い開発環境の構築が可能になる点を強調したい
オーケストレーションの簡素化
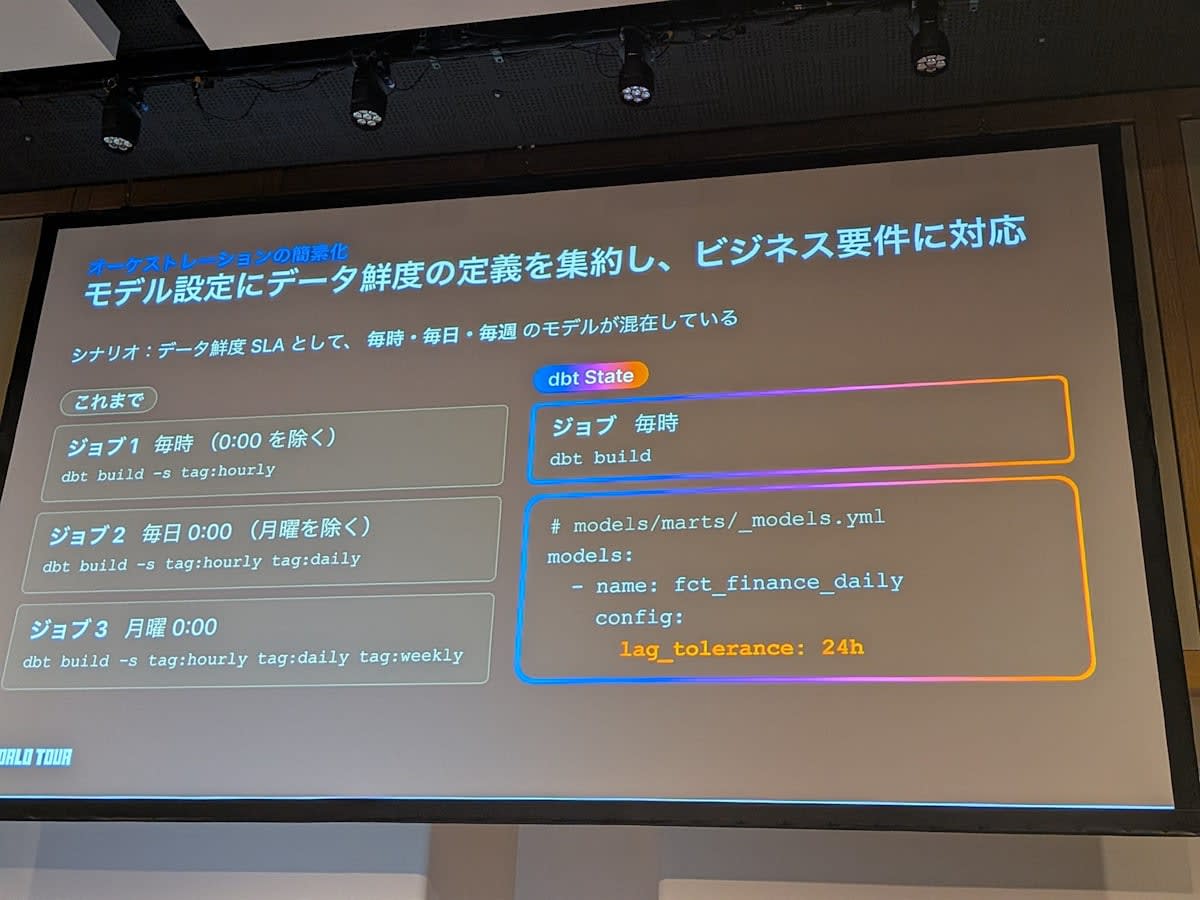
- dbt State では、データ鮮度の定義をモデルの設定に集約し、宣言的にビジネス要件に応えられる
- シナリオ:毎時・毎日・毎週の鮮度要件を持つモデルが混在している
- 従来は、鮮度要件ごとにジョブを定義していた。ジョブ 1 は毎時、ジョブ 2 は毎日、といった形
- 話すとシンプルに聞こえるが、実装には落とし穴がある。例えば毎時ジョブと日次ジョブが同時刻に走らないよう、実行時刻をずらす必要がある
- dbt State なら、ジョブは 1 つでよい。毎時
dbt buildを実行するだけ - 代わりに、モデルの YAML config で鮮度を定義する
- 例:
fct_finance_dailyモデルにlag_toleranceを 24 時間で設定する - 前回ビルドから 24 時間は、上流データが変わっても再ビルドしない
- 24 時間を超え、かつ上流データが変わっていれば再ビルドする
- 例:
- ジョブの複雑性を下げながら、compute コストも鮮度要件に必要な最低限に抑えられる
ガバナンスの効いた素早い開発環境
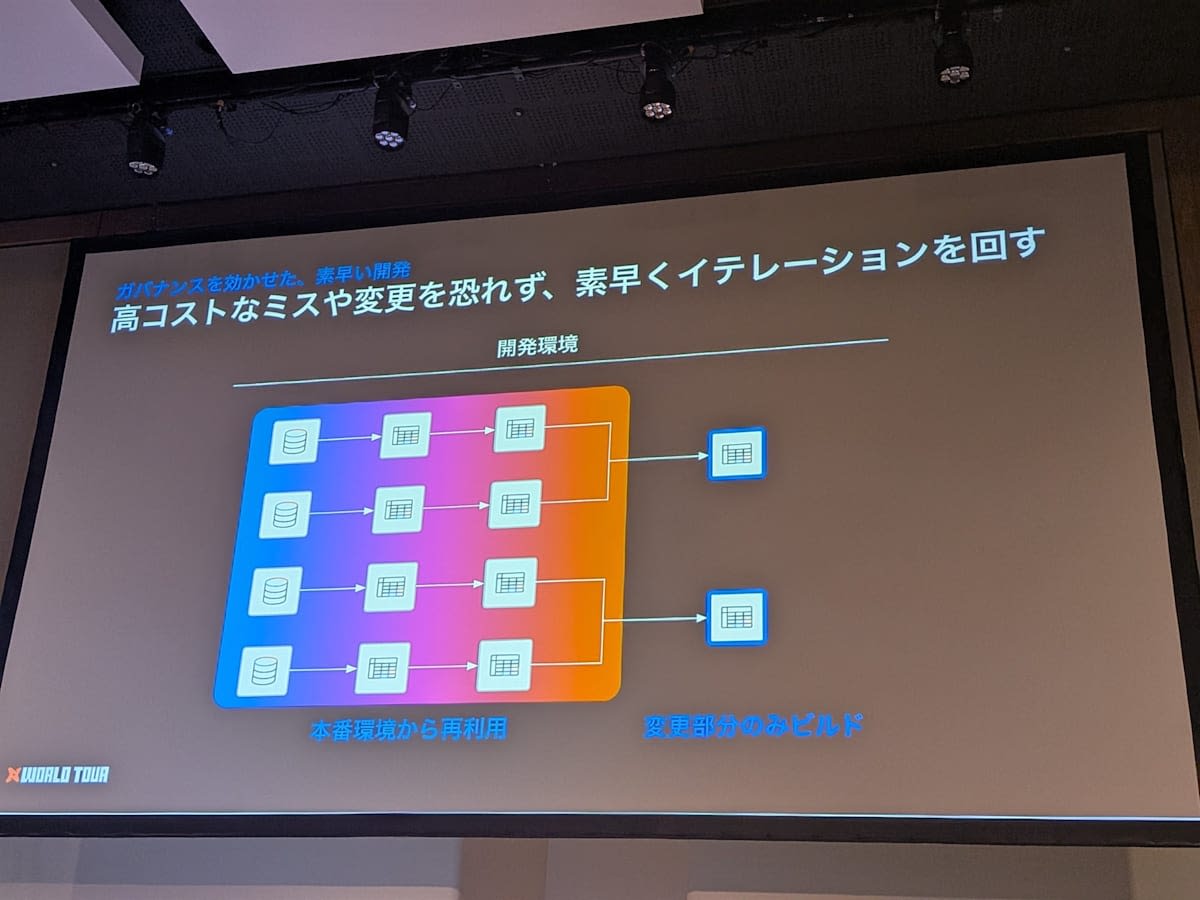
- dbt State はモデルをスキップするだけでなく、他の環境からデータをクローンできる
- 例:開発環境で新しいモデルを 2 つ作った場合
- 従来は、上流のモデルをすべてビルドするか、手動でクローンするか、manifest を管理して defer していた
- dbt State では特別な設定なしに、本番環境のデータを参照して上流のモデルを自動でクローンする
- これにより、誰でも低コストでガバナンスの効いた開発環境を構築できる
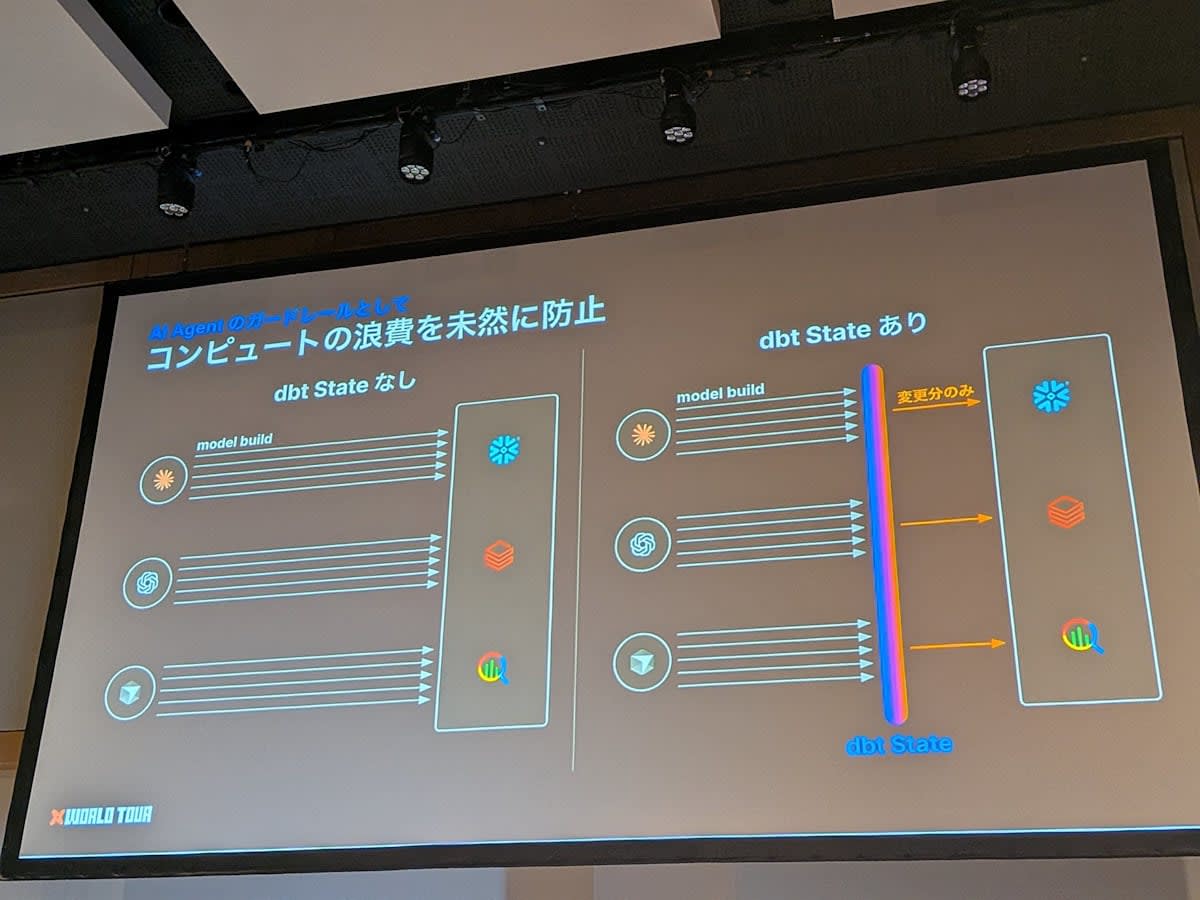
- 「誰でも」には AI エージェントも含まれる。dbt State は AI エージェントのガードレールとしても重要
- dbt State がないと、エージェントの確率的な挙動の中で大量のモデルをビルドしてしまうことがある
- dbt State を設定していれば、エージェントが大規模なビルドを試みても、変更部分だけがウェアハウスに送られる
事例
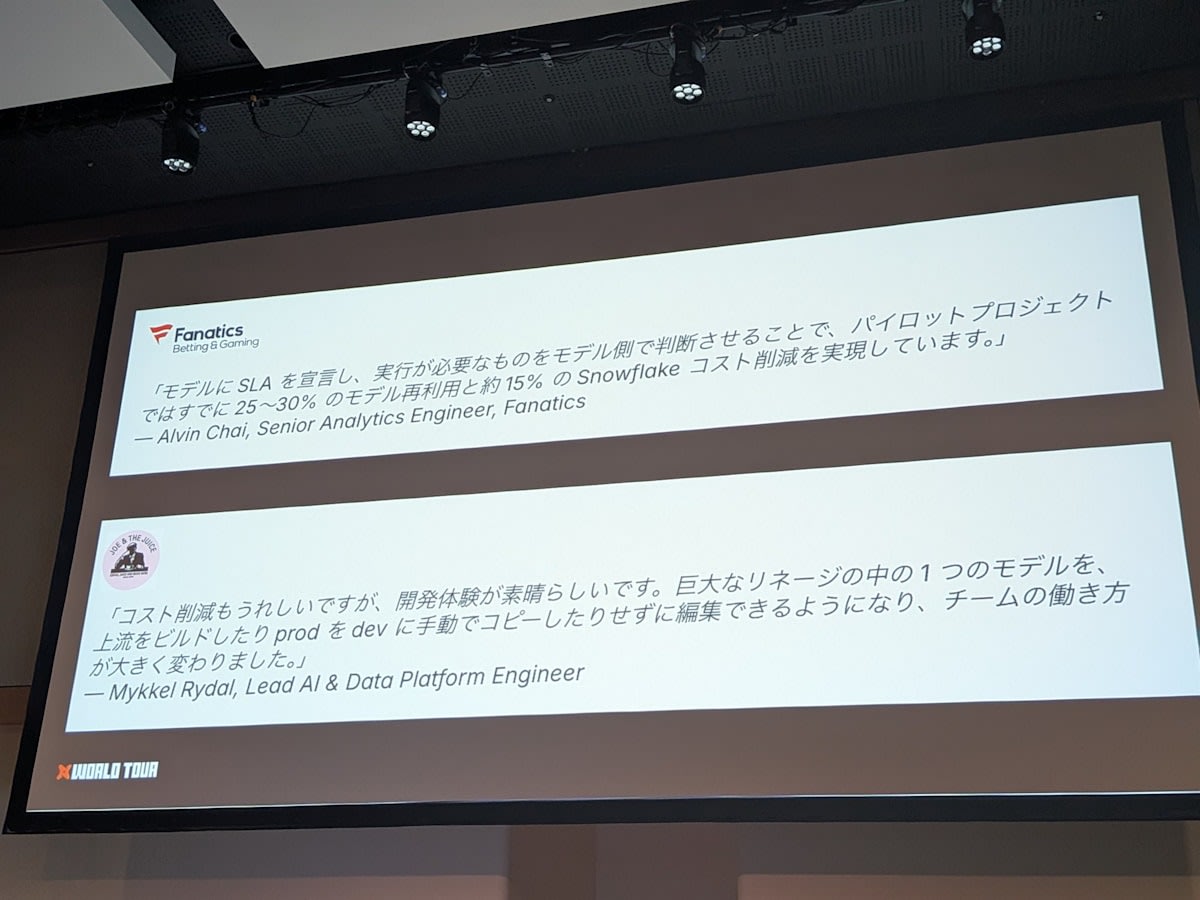
デモ
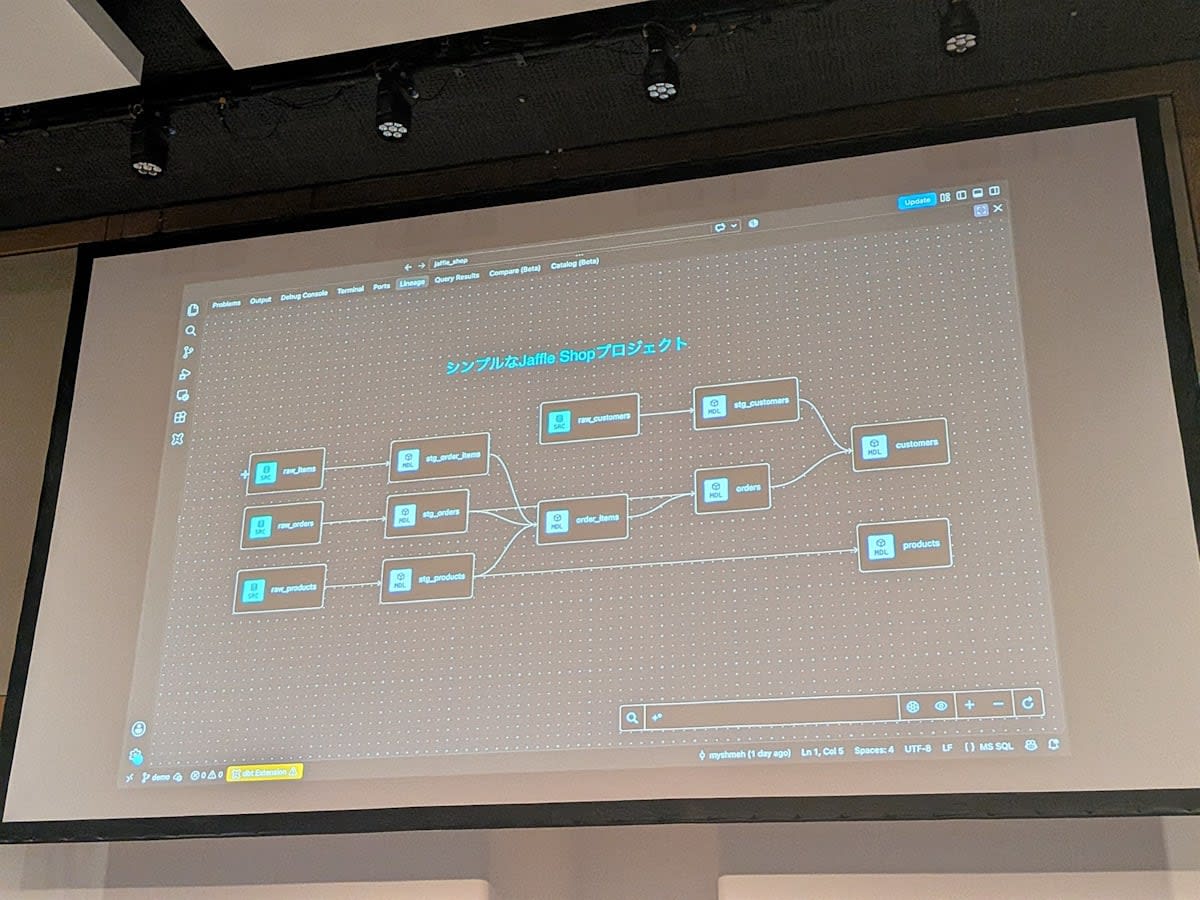
デモは jaffle_shop プロジェクトを dbt v2 で動かすもので、本番スキーマと開発スキーマの両方にデータがない状態から始まりました。
ビルドと再利用
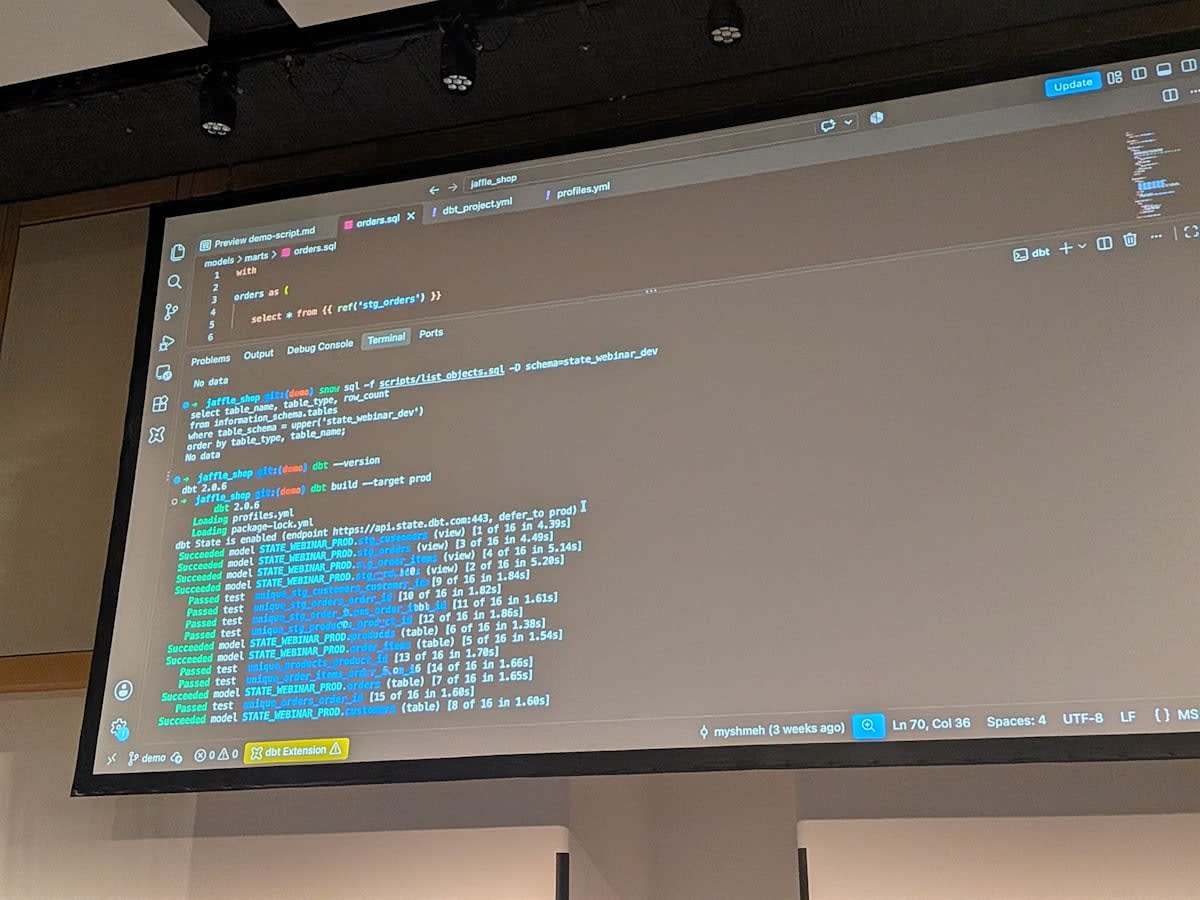
- 本番に対して
dbt buildを実行すると、データがないため当然すべてのモデルがビルドされる - dbt State を有効にしていると、ログに dbt State による判定結果が表示される
- 同じコマンドをもう一度実行すると、すべてのモデルが reused になる。コードもデータも変わっていないため
- 注目点は、テストの実行もスキップされること。大量のテストを定義していても効率的にビルドできる
結果に影響しない変更と影響する変更
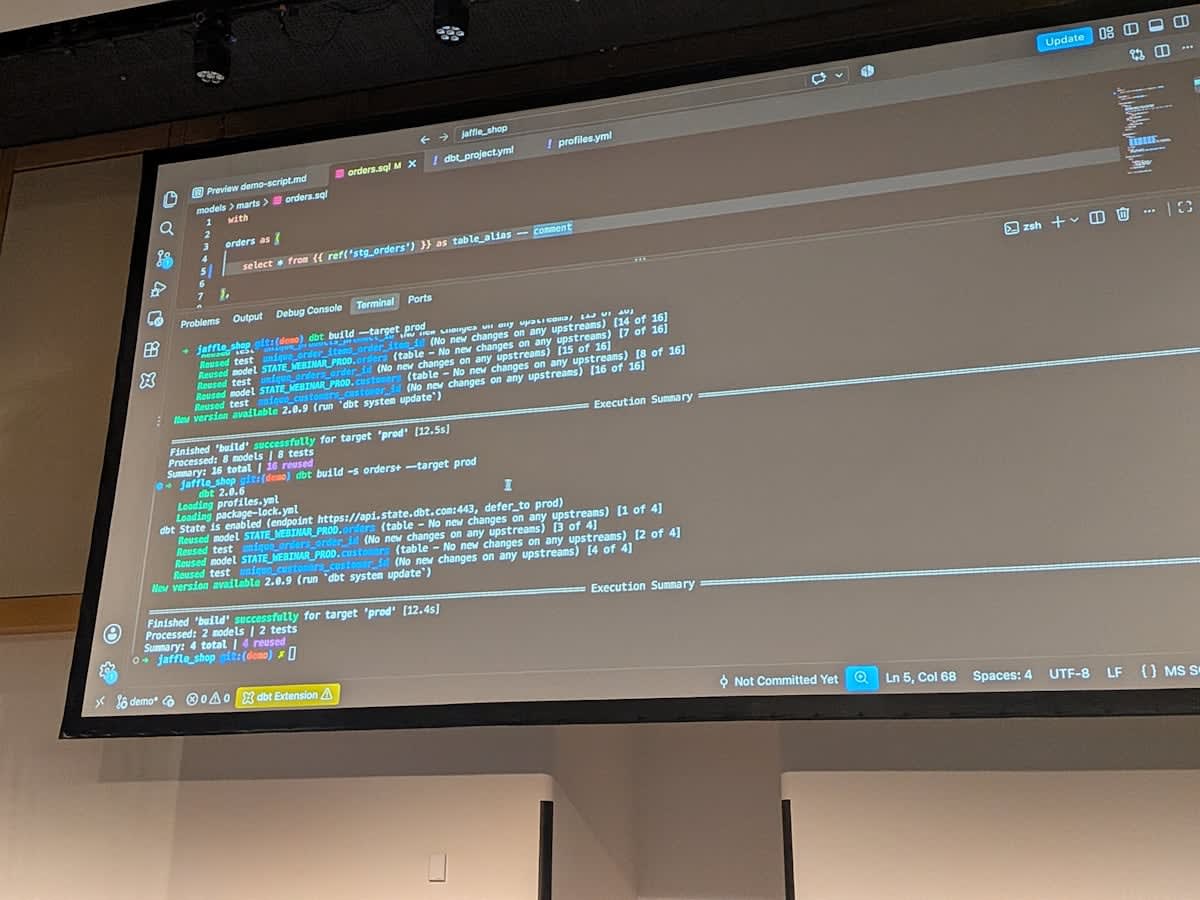
ordersモデルのコードに、テーブルのエイリアスとコメントを追加してdbt buildを実行- コードは変わったが、結果は reused のまま。エイリアスやコメントは結果データに影響しないため、dbt State は変更とみなさない
- 次に
is_large_orderカラムを追加して実行すると、結果データが変わるためordersを再ビルドし、下流のモデルも再ビルドした
lag_tolerance の挙動
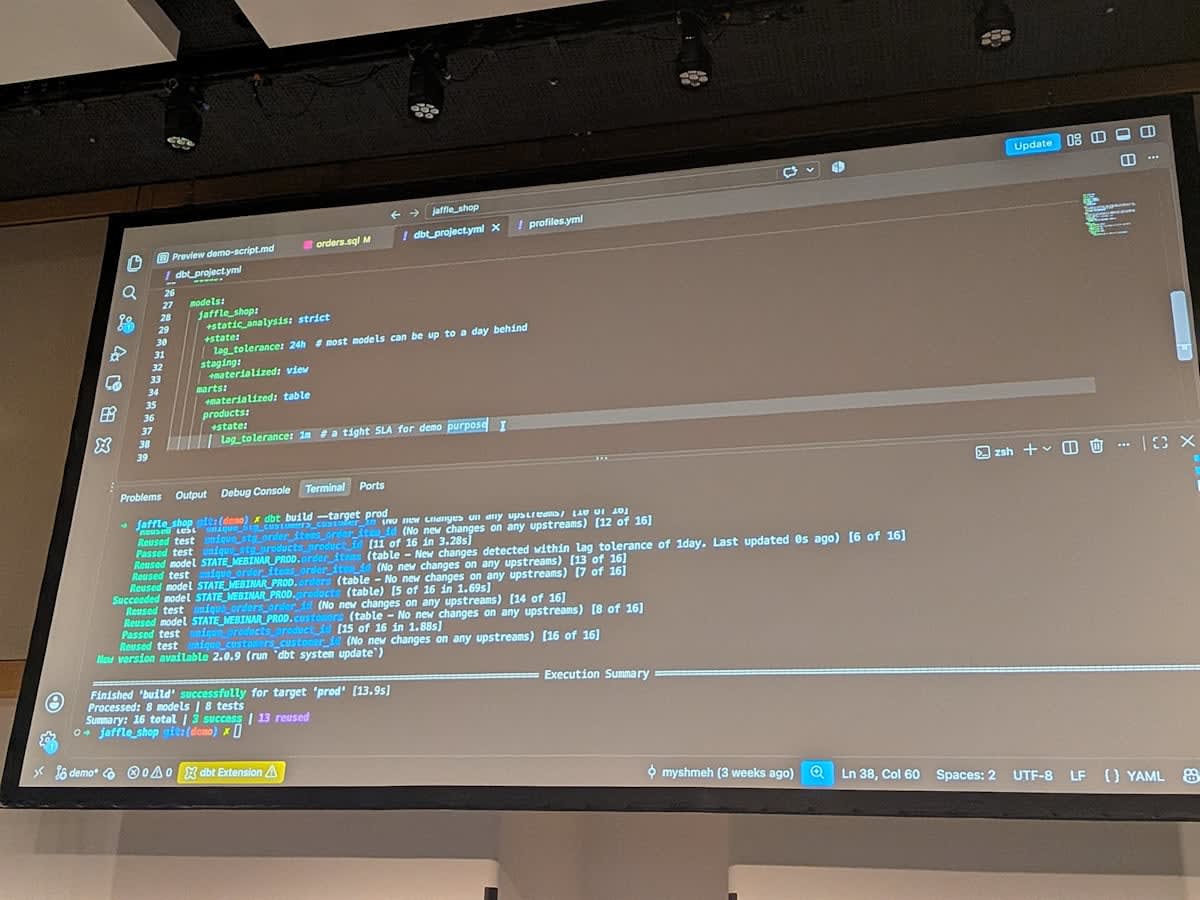
- ソーステーブル
raw_productsにレコードを 1 行追加し、本番に対してdbt buildを実行 - 単純に考えると、データが変わったので
stg_products・products・order_itemsなどが再ビルドされそうに見える - 実際はほとんどが reused で、
productsだけが再ビルドされた - 理由は dbt_project.yml の設定にある
models全体にlag_toleranceが 24 時間で設定されている。前回ビルドから 24 時間経っていないため、スキップされたproductsには個別に 1 分のlag_toleranceが設定されている。前回の実行から 1 分以上経っていたため、再ビルドされた
- モデルごとに鮮度を宣言的に定義し、ジョブは一定のリズムで実行し続けるだけでよい
dbt state explain
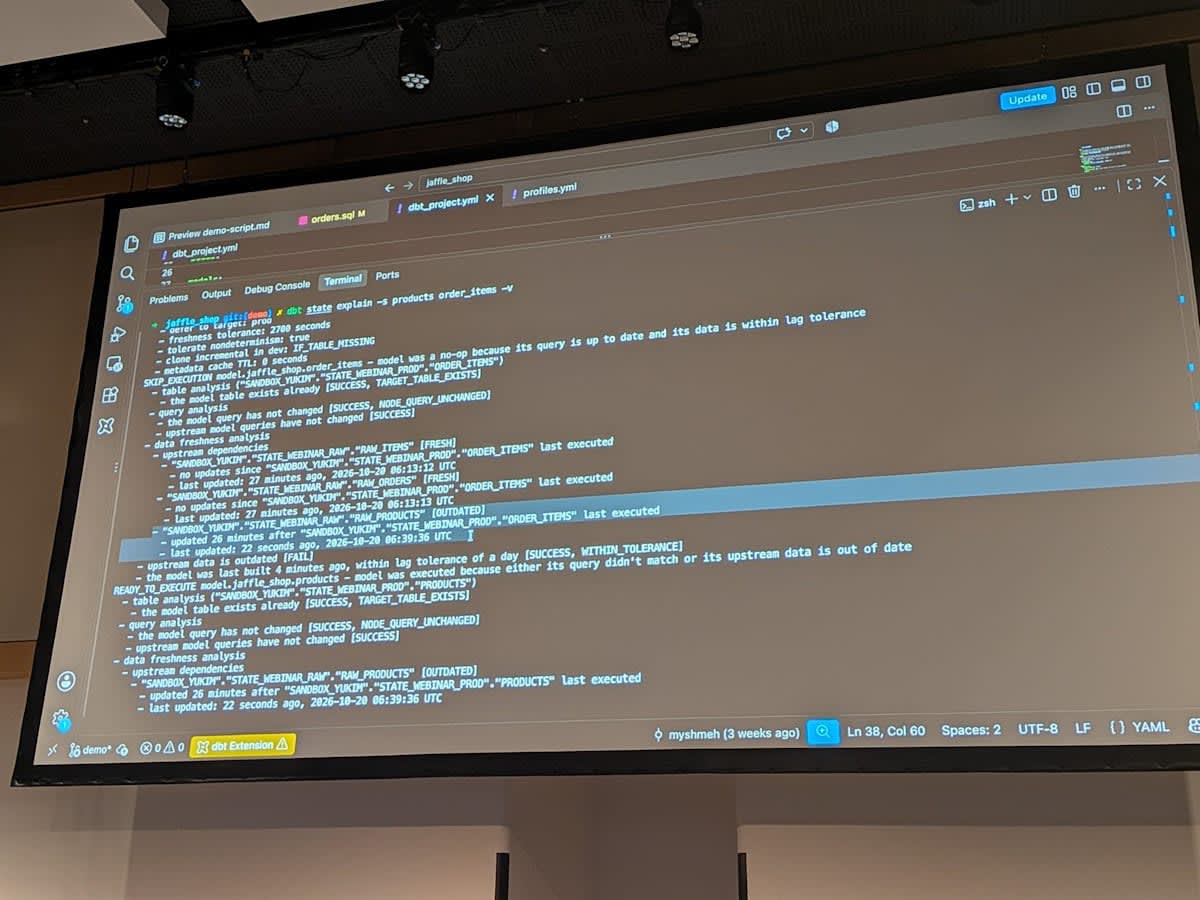
- dbt State が本当にその理由で判断したのかは、
dbt state explainで確認できる - モデルごとに、なぜ再ビルドしたのか、なぜスキップしたのかが表示される
order_itemsの例- 判定結果は skip
- dbt State は Table analysis・Query analysis・Data freshness analysis の 3 つの分析を行っている
- Data freshness analysis では、
raw_productsが out of date と表示される。データの変更は検知している - ただし、前回ビルドから 24 時間の
lag_toleranceが経過していないため、スキップしたと書かれている
productsの例- 判定結果は rebuild
- Data freshness analysis に「lag_tolerance の範囲内」という記述がない
- 1 分の設定に対し、前回の実行から 1 分以上経っているため
- dbt State の判断の根拠を、後から確認できる
開発環境の構築
- ここまでは本番環境に対して実行してきたため、開発スキーマにはデータがなく、本番にはすべてのモデルのテーブルがある
- この状態で開発スキーマに対して
dbt buildを実行する - すべてのモデルを開発環境で作り直す代わりに、本番環境からすべてのモデルをクローンした
- モデルとテストに reused のログが出て、テーブルは別環境からクローンされたことが分かる
- ステージング層はビューなので、クローンではなく再利用される。ビューはデータを持たず、構築するコードだけが登録されたオブジェクトのため
dbt state explainでcustomersモデルを見ると、本番からクローンしたことが Table analysis に表示される- dbt State は compute の削減だけでなく、宣言的な鮮度の定義と、安全で効率的な開発環境の構築を可能にする
dbt platform の dbt State 画面
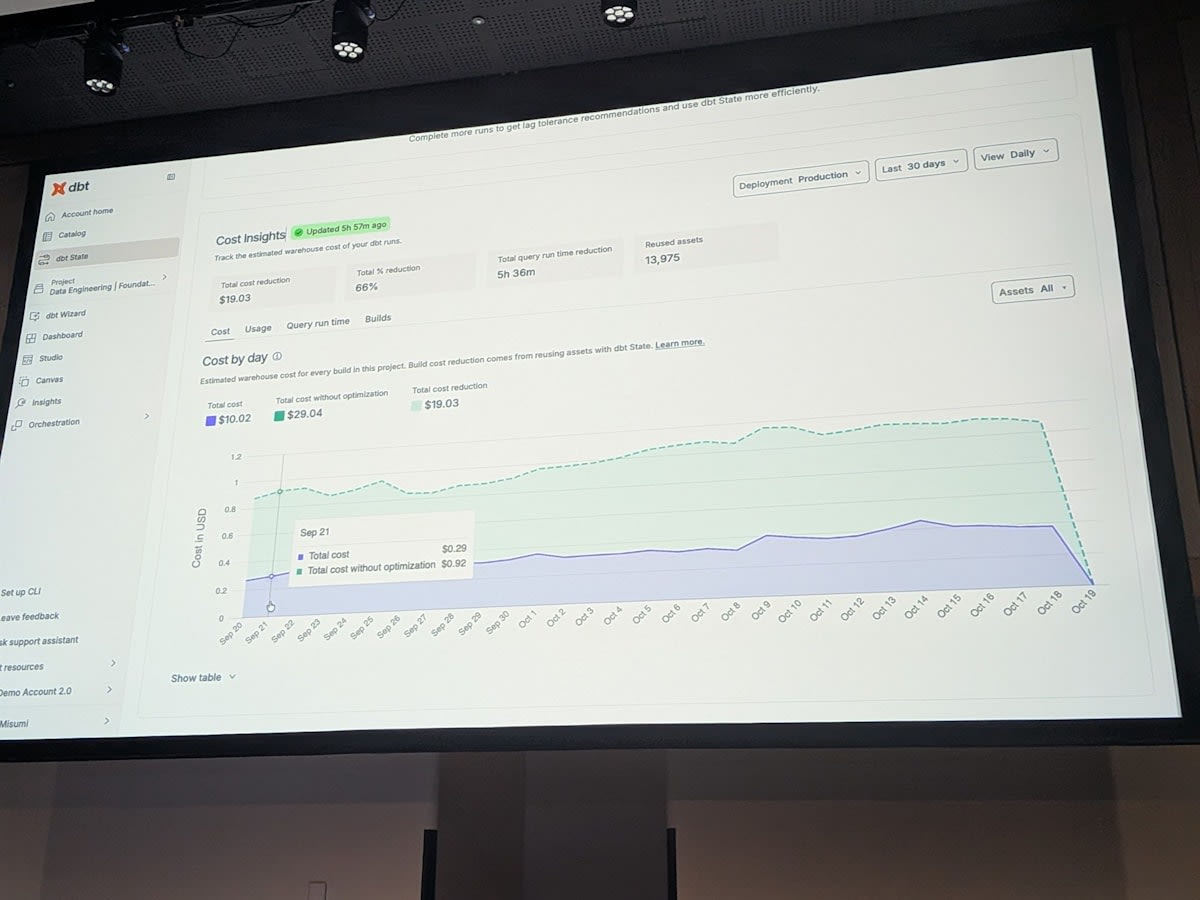
- dbt platform に最近 dbt State のタブが追加され、コストの insights を見られる
- 日ごとに dbt State でどれだけ消費したか、dbt State を使っていなかったらどれくらいかかっていたかをグラフで表示する
- 日々のモニタリングにも、dbt State を本格導入するかどうかの判断基準にも使える
公式ドキュメントによると、この画面は Account settings の Billing & Usage > Usage-based features にある State タブです。再利用したモデル数・ビルド削減率・クエリ実行時間の削減を確認できます。
dbt State の仕組み
アーキテクチャ
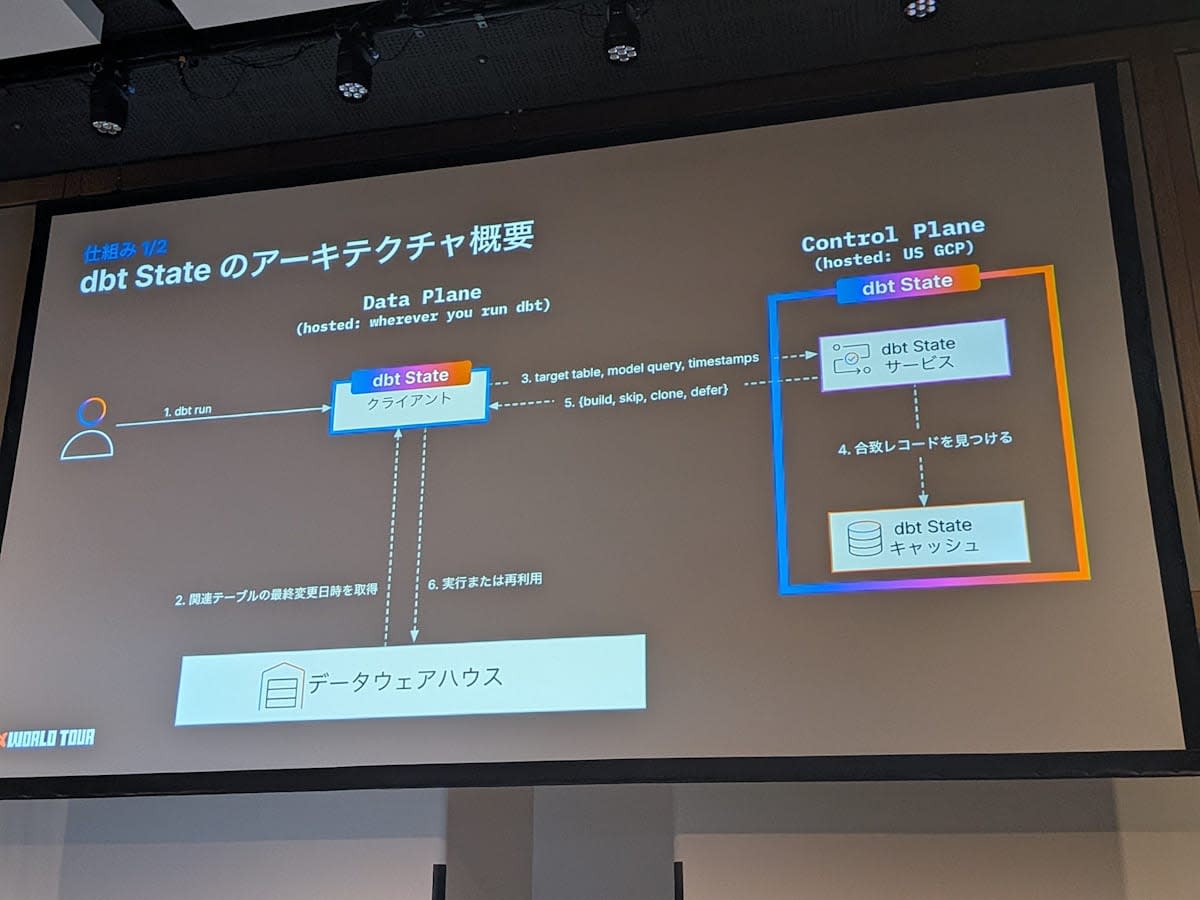
- dbt State は、通常の dbt プログラムの外部に dbt State のサーバーを持つ
- 現状は US の GCP インスタンスで稼働しており、モデルをスキップすべきか再ビルドすべきかを判断する
- 流れ
- ユーザーが
dbt runやdbt buildを実行する - dbt がデータウェアハウスから、関連テーブルの最終更新日時を取得する
- 対象テーブルの名前とクエリの情報を、dbt State のサービスに送る
- サービスが過去の実行実績と照らし合わせ、再ビルドかスキップかを dbt クライアントに返す
- ユーザーが
判定ロジック
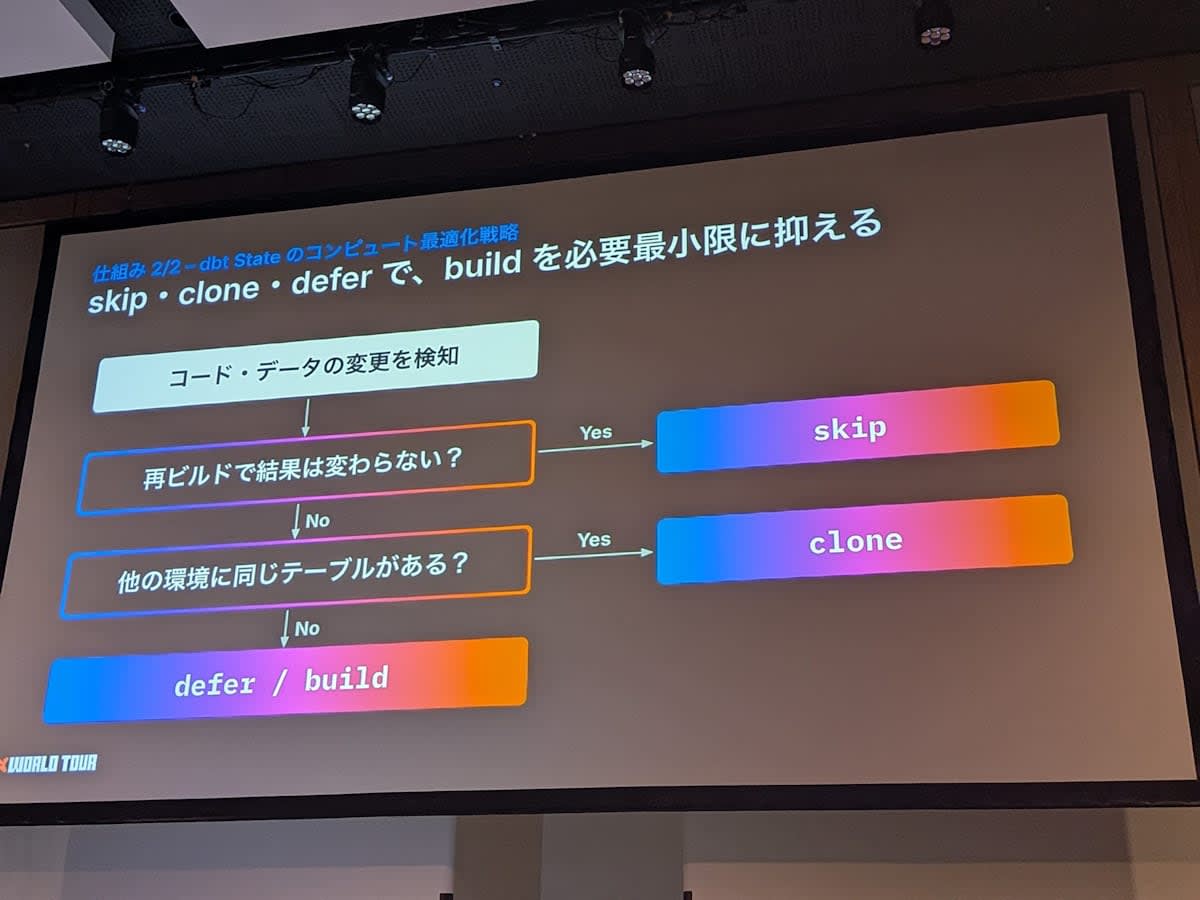
- まず、モデルのコードと上流データの変更があるかを確かめる
- コードもデータも変わっていない、またはコードが変わらずデータの変更が
lag_toleranceの範囲内なら、スキップする - コードが変わった、または新しいデータが来たなら、他の環境に同じテーブルが最新の状態であるかを確認する
- デモの場合は本番環境にあったので、開発環境へクローンした
- 他の環境にもなければ、上流のテーブルを他の環境から defer できるかを確認する
- それも無理なら、通常のビルドを行う
- このように複数の戦略に基づいて、ビルドを最適化している
主要な設定
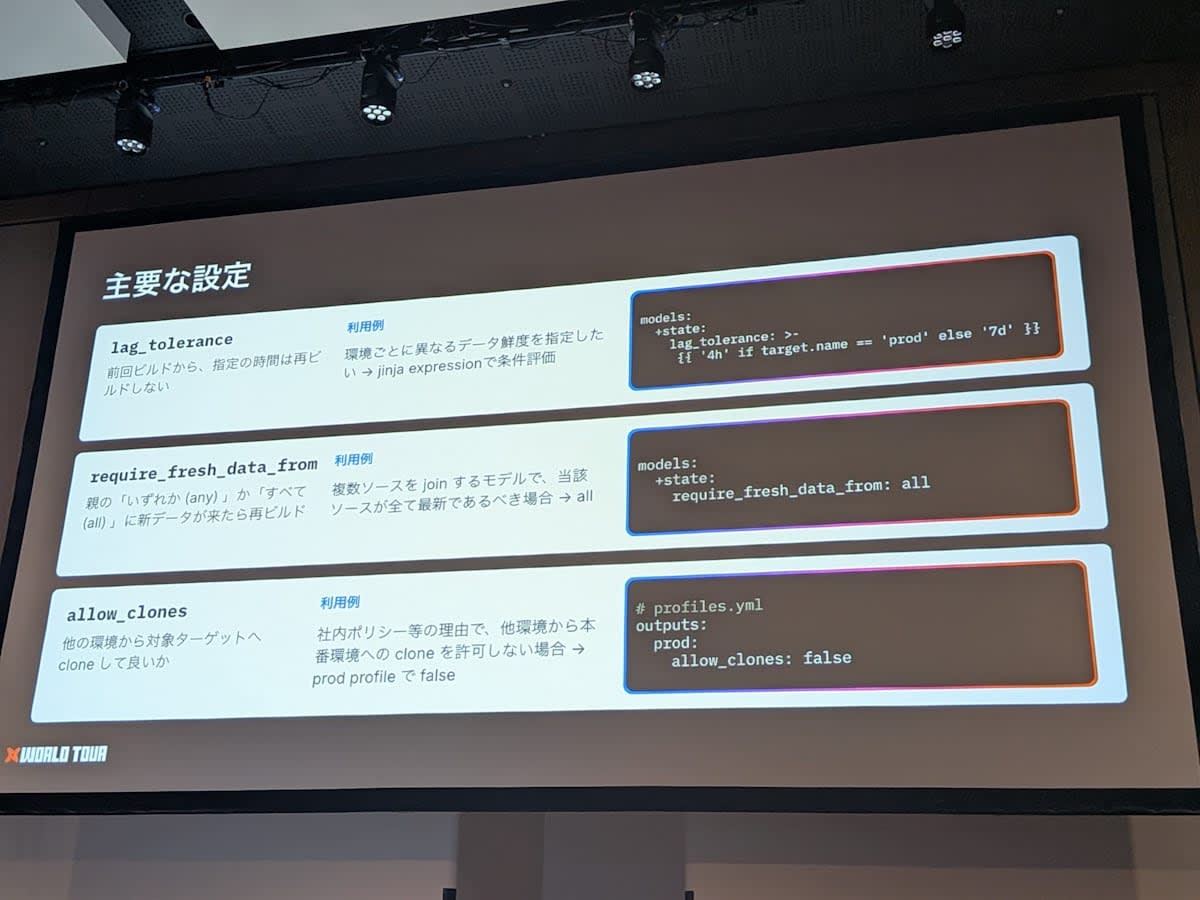
| 設定 | 内容 |
|---|---|
lag_tolerance |
前回ビルドから指定の時間は、上流データが変わっても再ビルドしない。他のプロパティと同様に Jinja が使えるため、本番は 24 時間、それ以外は別の値、といった振る舞いを持たせられる |
require_fresh_data_from |
上流モデルのいずれか(any)または全部(all)に新データが来たら再ビルドするか。複数の上流を結合するモデルで、どちらも最新である必要があるなら all を選ぶ |
allow_clones |
他の環境から対象ターゲットへクローンしてよいか。profiles.yml でターゲットごとに設定する |
allow_clonesの利用例- 既定では、本番から開発へのクローンだけでなく、開発から本番へのクローンもできる
- 社内ポリシーで本番環境に他の環境のデータを持ち込ませたくない場合は、本番ターゲットで
allow_clones: falseにする - 本番にはどの環境からもクローンされなくなる
設定の一覧は公式ドキュメントに記載されています。
今後の展望
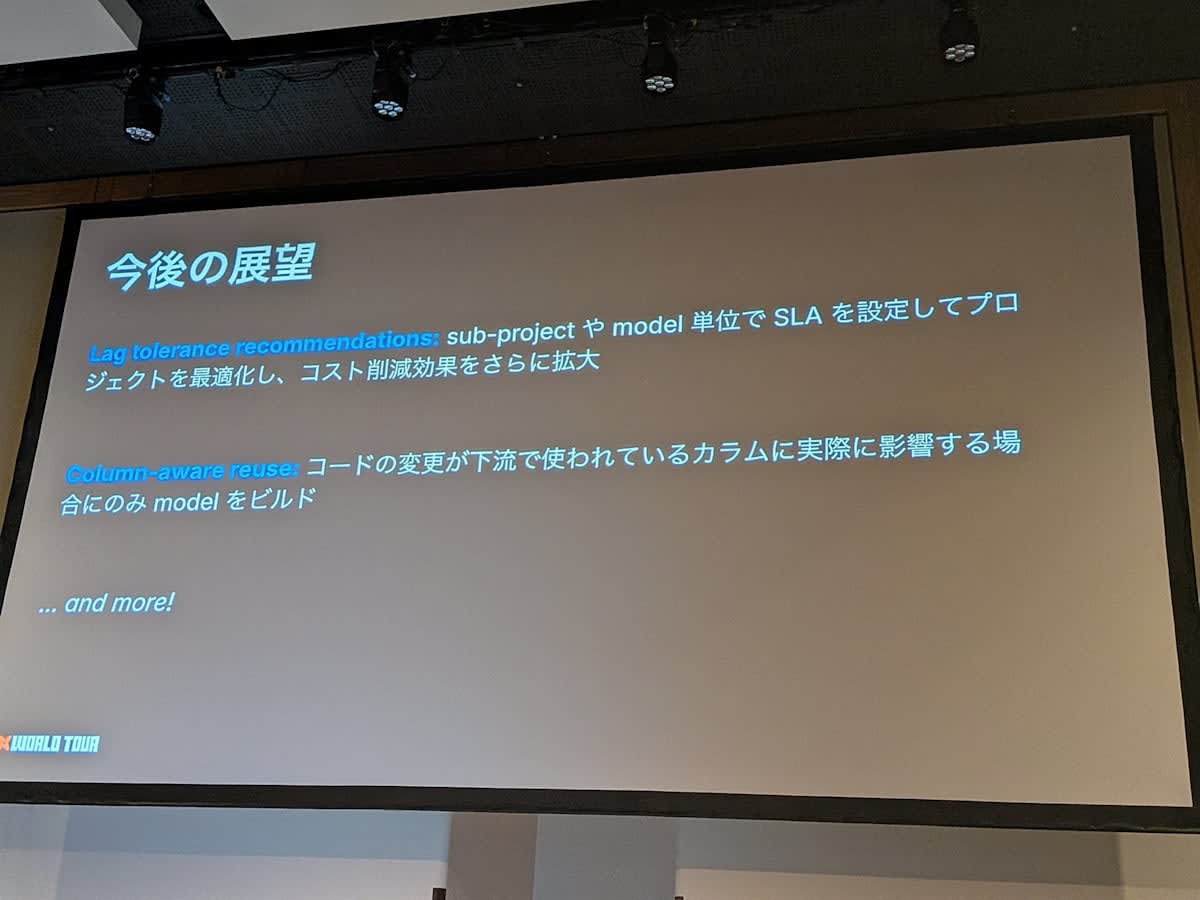
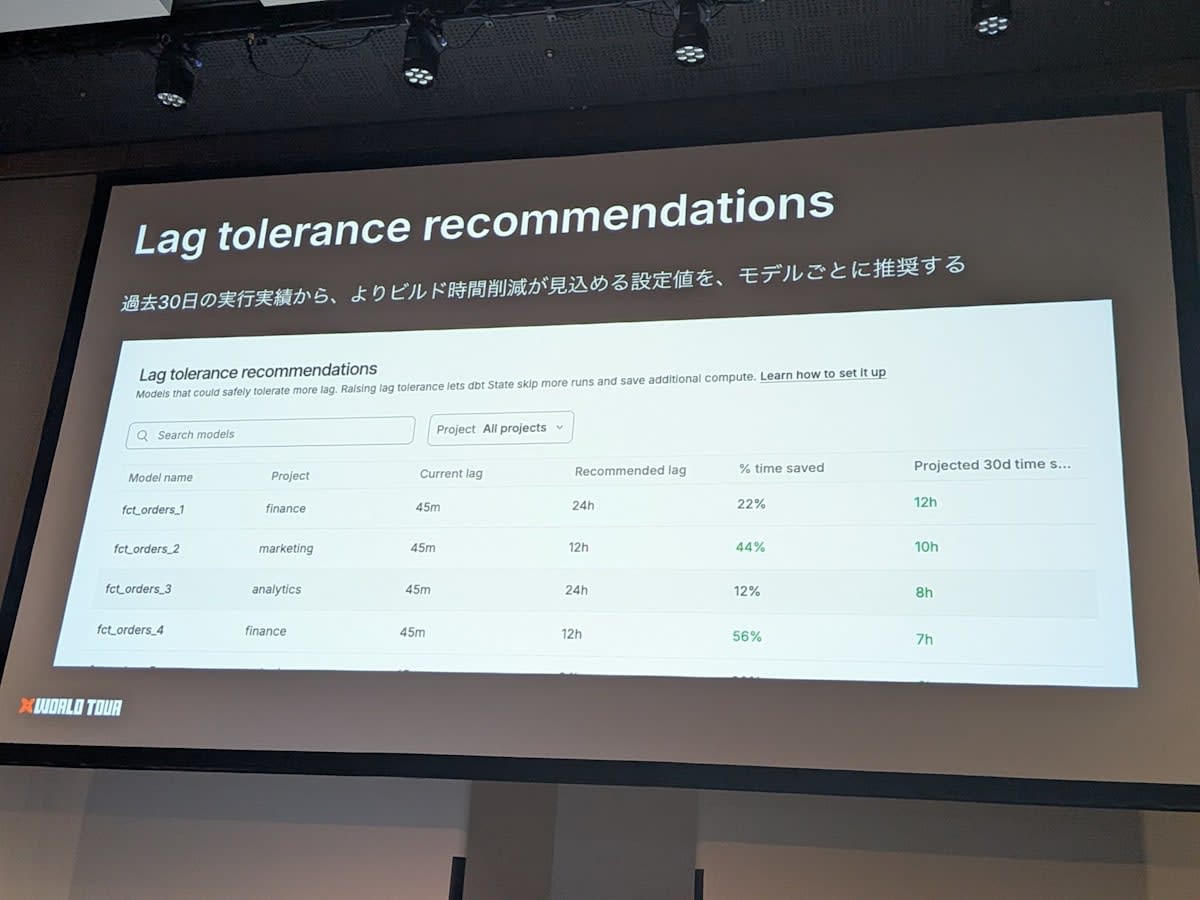
- Lag tolerance recommendations
- 過去 30 日の実行実績から、ビルド時間の削減が見込める
lag_toleranceの値をモデルごとに推奨する機能 - すでに使える状態。30 日ほど dbt State を使うと、dbt platform の dbt State 画面で確認できる
- 例:
ordersモデルは 45 分の設定だが、実績上は 24 時間のラグでも最新のデータを返せる - 変更すると 1 か月で約 12 時間の実行時間を削減できる、と提示される
- 過去 30 日の実行実績から、ビルド時間の削減が見込める
- Column-aware reuse(検討中)
- 現状は、コードとデータのどちらかが変われば再ビルドする
- コードが変わっても、変更したカラムが下流で使われていなければ、下流のビルドをスキップする振る舞いを検討している
30 日間トライアル
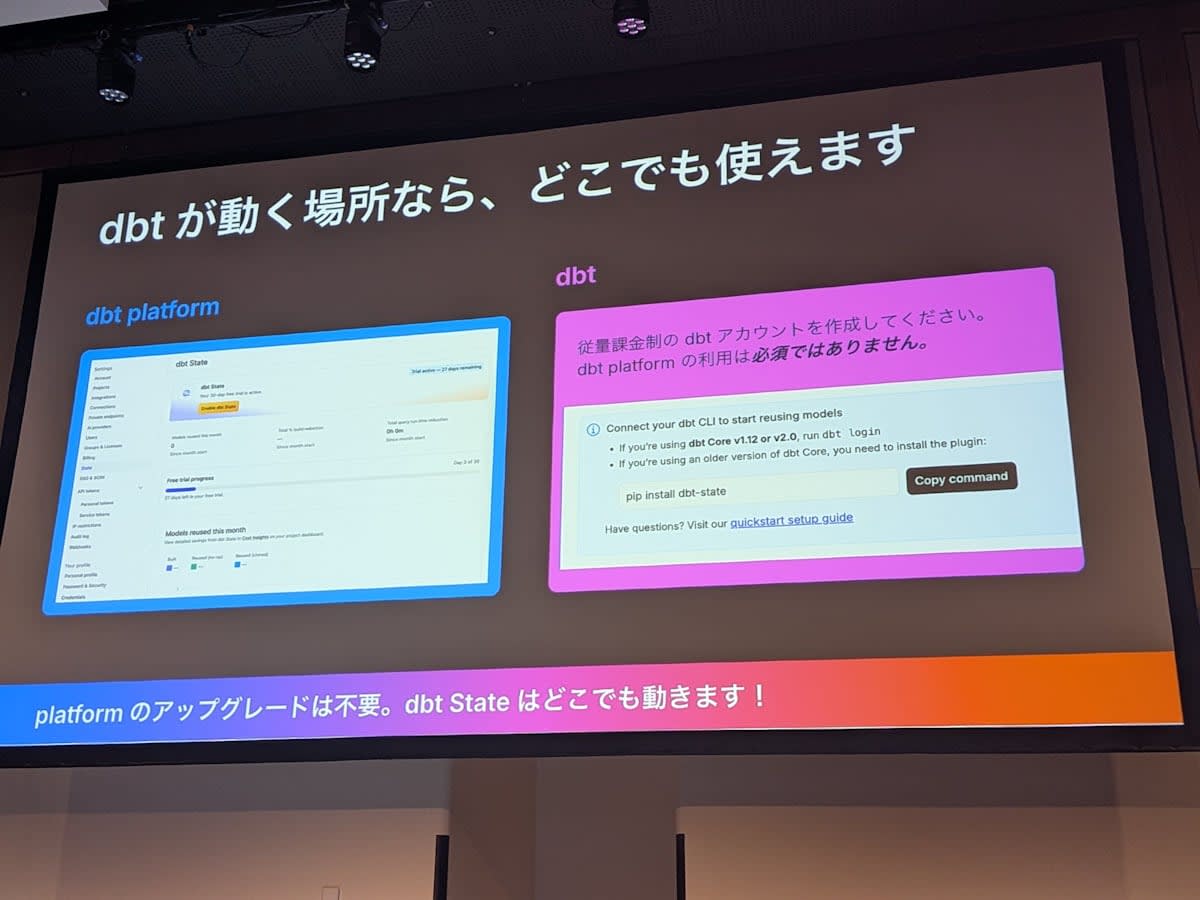
- dbt State は 30 日間のトライアルを提供している
- dbt platform のユーザーだけでなく、セルフマネージド(dbt Core)のユーザーも試せる
- 30 日間でどれだけウェアハウスのコスト削減とパイプラインの簡素化に貢献できるか、確かめてほしい
関連リンク
所感
dbt World Tour Tokyo 2026 のセッション「dbt State で、runs を最適化」に参加しました。
個人的にはデータの鮮度を SLA として宣言的に定義できるのは良いなと感じました。
また、AI エージェントのガードレールとしても機能するという観点は自分にはなかったので学びになりました。
この記事が何かの参考になれば幸いです!