GrafanaのアラートからDevOps Agentの調査を自動で起動して、結果をSlackに通知してみた

こんにちは、ゲームソリューション部のsoraです。
今回は、ECS FargateでセルフホストしたGrafanaのアラートから、AWS DevOps Agentの調査を自動で起動して、結果をSlackに通知してみたことについて書いていきます。
先に結論
- 公式ドキュメントの通知テンプレートのままで、Grafanaのアラートから調査が自動で始まり、結果がSlackのスレッドに投稿された
- 調査に渡ったのはアラートの名前と
summaryだけだったが、AgentはGrafana経由でLokiのログを読み、原因のエンドポイントまで特定した summaryにAMPのメトリクス名を書いたアラートでは、AgentがAMPのメトリクスも読んだ- アラートが一度収まったあとに同じアラートがもう一度発火すると、新しい調査にはならず、前回の調査が再開されて「既知の再発」としてまとめられた
構成
今回構築したのは以下の構成です。
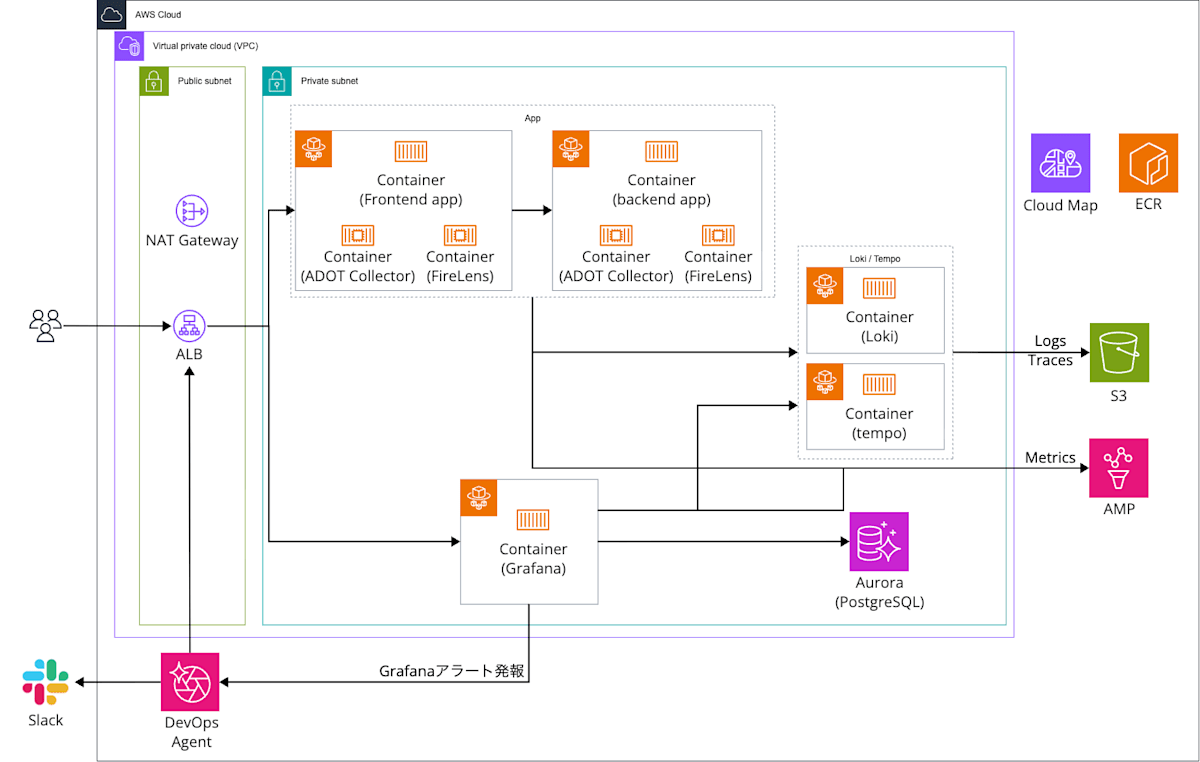
以下の記事で作った環境(ECS FargateのGrafana / Loki / Tempoと、Goのサンプルアプリ)を、そのまま使っています。
この環境に、GrafanaのアラートをDevOps AgentのWebhookに送る経路と、調査の結果をSlackに投稿する経路を追加しました。
あわせて、GrafanaとADOT CollectorからAMPへの通信は、AMPのインターフェイスVPCエンドポイントを通すようにしています。
GrafanaはOSS版をセルフホストしています。
Amazon Managed GrafanaはアラートのContact pointでWebhookに対応していないため、Amazon Managed GrafanaからDevOps Agentに直接Webhookを送れない、と公式ドキュメントに書かれています。
Amazon Managed GrafanaのGrafana 13向けのドキュメントでも、対応しているContact pointはAmazon SNS / PagerDuty / Slack / VictorOpsで、Webhookはありません。
主なコンポーネント
| 役割 | コンポーネント |
|---|---|
| 障害調査 | AWS DevOps Agent(東京リージョン、Agent Space × 1) |
| 可視化・アラート | Grafana OSS(ECS Fargate、grafana/grafana:13.3.0) |
| Grafanaの設定DB | Aurora Serverless v2(PostgreSQL 18.6) |
| 入口 | ALB + ACM + Route 53 |
| サンプルアプリ | Go製のfrontend / backend(ECS Fargate) |
| テレメトリ収集 | ADOT Collector v0.50.0 / Fluent Bit 3.4.15(サイドカー) |
| ログ | Loki 3.7.7 |
| トレース | Tempo 3.0.3 |
| メトリクス | AMP(インターフェイスVPCエンドポイント経由) |
| 通知 | Slack(DevOps AgentのSlack連携) |
Agent Spaceは1つで、summaryの書き方を変えた2つのアラートを順番に試します。
構築
今回もTerraformで構築しました。
土台の環境は構成で紹介した記事と同じなので、アラートから調査を起動するところだけ解説します。
Grafanaの中身(通知テンプレート・Contact point・通知ポリシー・アラートルール)は、grafana providerで設定しています。
Grafana用のWebhook
構成で紹介した記事と同じようにGrafanaをAgent Spaceに関連付けると、機能タブの「機能ウェブフック」にGrafana用のWebhookが表示されます。
認証タイプは「APIキー」です。
Terraformでは、Webhookのリソースは定義していません。
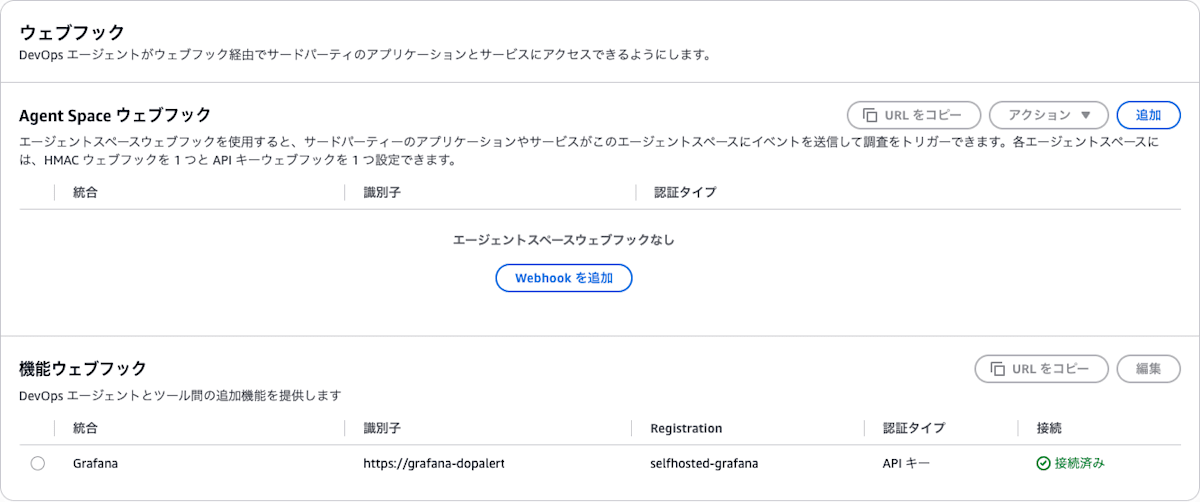
API keyはWebhookを作ったときに一度だけ表示されるもので、関連付けで作られたWebhookのAPI keyは受け取っていません。
そこで、Webhookをローテーションして新しいAPI keyを取得しました。
機能ウェブフックの行を選んで「編集」から、ローテーションの画面に進みます。
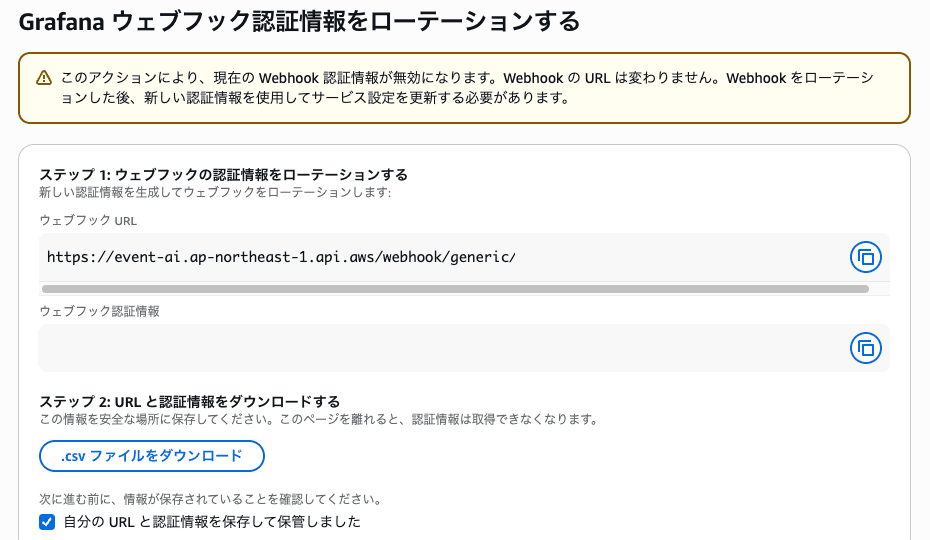
「.csvファイルをダウンロード」で、URLとAPI keyをCSVで保存できます。
WebhookのURLは、汎用Webhookと同じhttps://event-ai.ap-northeast-1.api.aws/webhook/generic/<ID>の形です。
Slackの連携
Slackは、Agent Spaceの機能タブの「コミュニケーション」から、ワークスペースの登録とチャンネルの関連付けをしました。
Slackの登録はOAuthの画面操作が必要なので、コンソールで行っています。
今回はDevOps AgentからSlackに投稿するだけの一方向の通知で、双方向のチャットは使っていません。
プライベートのチャンネルに投稿させるために、チャンネルで/invite @AWS DevOps Agent - AP (Tokyo)を実行してアプリを招待しています。
通知テンプレート
ここからはGrafana側の設定です。
公式ドキュメントのStep 1〜3(通知テンプレート、Contact point、通知ポリシー)の順に設定します。
通知テンプレートは、公式ドキュメントに載っているもの(devops-agent-payload)をそのまま使いました。
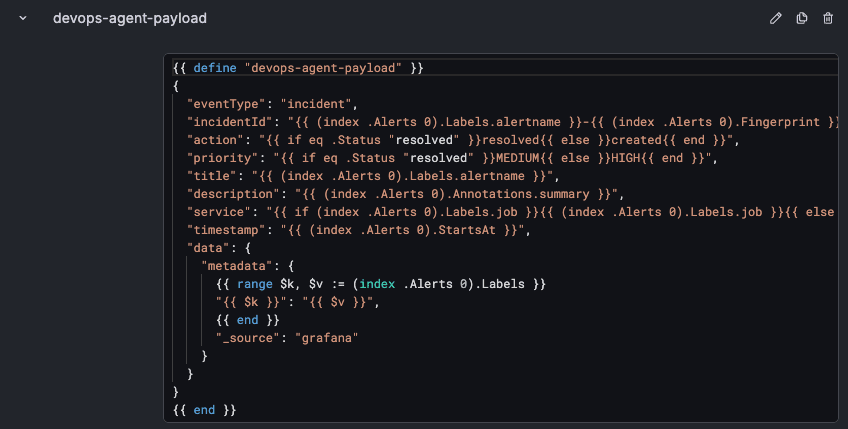
titleにアラートルールの名前(alertname)、descriptionにアノテーションのsummaryが入ります。
Contact point
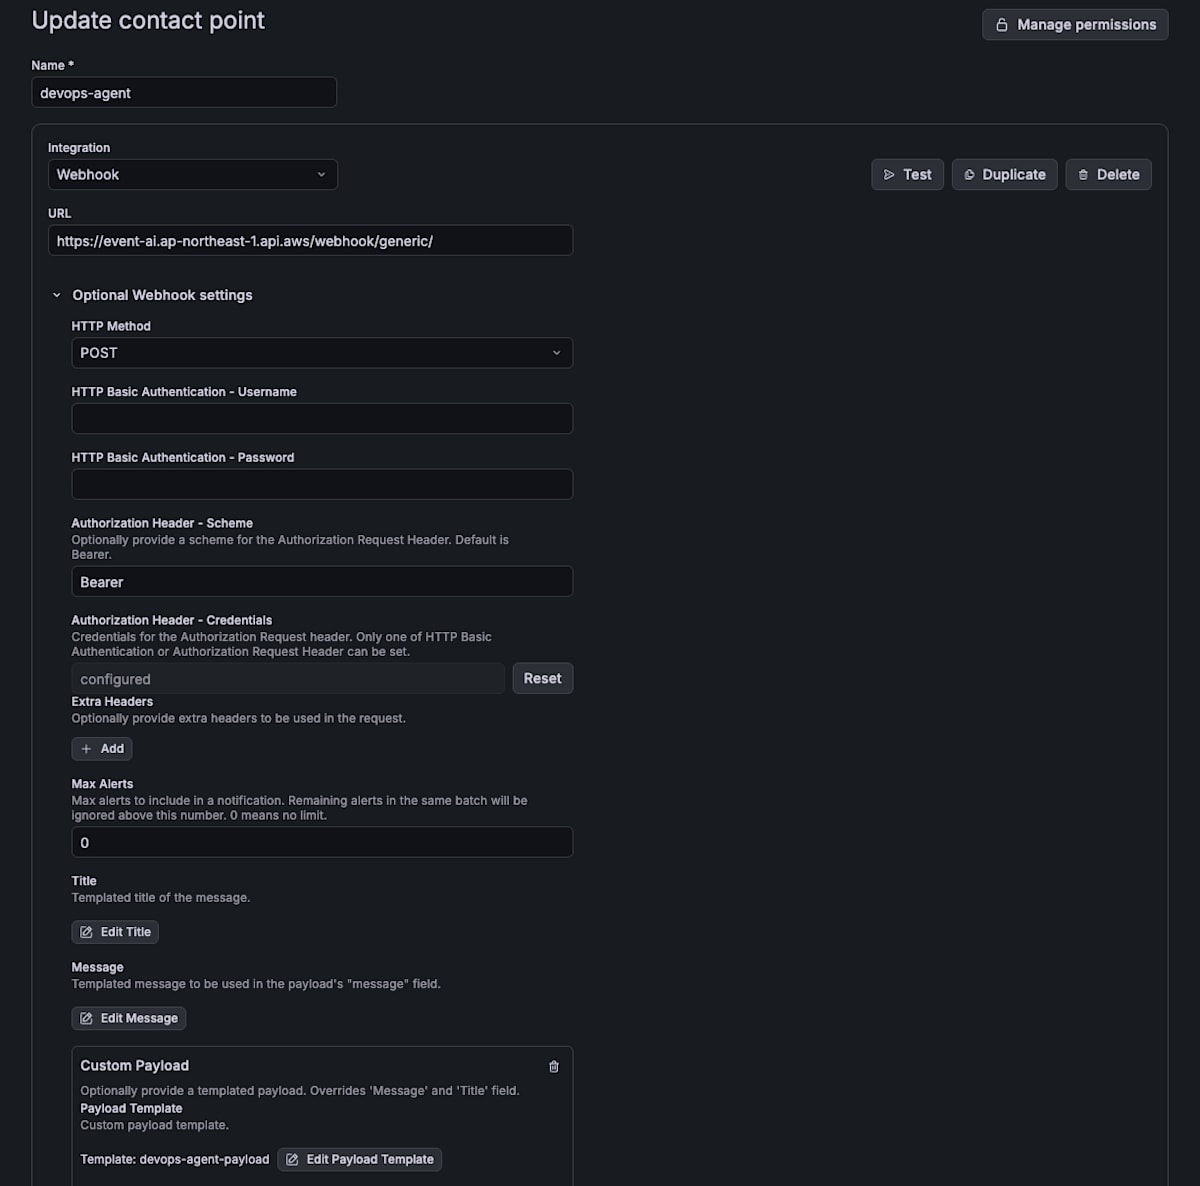
Contact pointはWebhookで作成し、URLにGrafana用のWebhookのURL、Authorization HeaderのSchemeにBearer、CredentialsにAPI keyを設定します。
Custom Payloadには、通知テンプレートを呼び出す{{ template "devops-agent-payload" . }}を指定します。
resource "grafana_message_template" "official" {
  name     = "devops-agent-payload"
  template = file("${path.module}/templates/devops-agent-payload.tmpl")
}

resource "grafana_contact_point" "devops_agent" {
  name = "devops-agent"

  webhook {
    url                       = var.devops_agent_webhook_url
    http_method               = "POST"
    authorization_scheme      = "Bearer"
    authorization_credentials = var.devops_agent_api_key # ローテーションで取得したAPI key

    payload {
      template = "{{ template \"devops-agent-payload\" . }}"
    }
  }
}
Grafanaの画面では、以下のようになります。
通知ポリシー
通知ポリシーは、ルートの送り先をDevOps AgentのContact pointにせず、ラベルdevops_agent = trueが付いたアラートだけをDevOps Agentに送る子ポリシーを作りました。
ラベルの付いていないアラートで調査が始まらないようにするためです。
group_byは、公式ドキュメントのとおりalertnameにしています。
resource "grafana_notification_policy" "this" {
  contact_point = grafana_contact_point.fallback.name
  group_by      = ["alertname"]

  policy {
    contact_point = grafana_contact_point.devops_agent.name
    group_by      = ["alertname"]

    matcher {
      label = "devops_agent"
      match = "="
      value = "true"
    }
  }
}
アラートルール
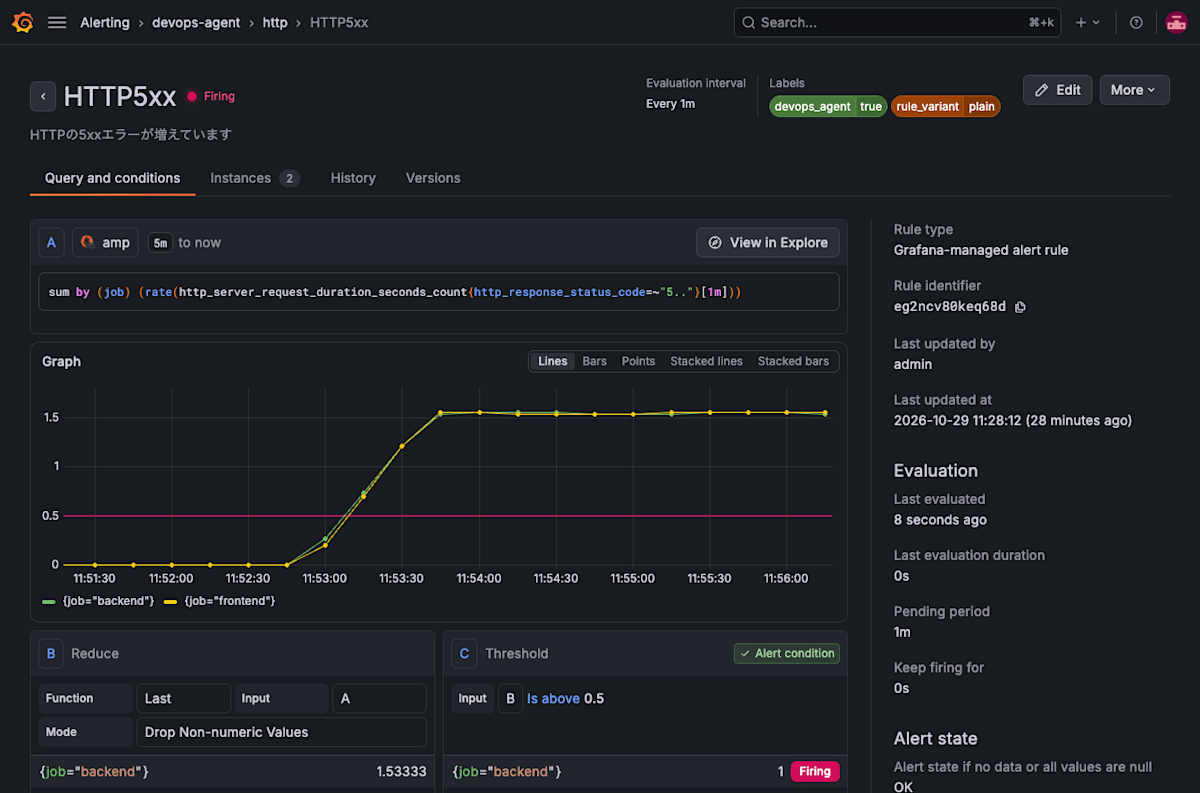
アラートルールは、AMPのメトリクスでjobごとの5xxの件数/秒を見て、0.5件/秒を超えたら発火するようにしました。
| 項目 | 値 |
|---|---|
| データソース | AMP |
| クエリ | sum by (job) (rate(http_server_request_duration_seconds_count{http_response_status_code=~"5.."}[1m])) |
| 条件 | Reduce(Last)→ Threshold(0.5より大きい) |
| 評価間隔 / Pending period | 1分 / 1分 |
| ラベル | devops_agent = true(通知ポリシーの振り分け)、rule_variant(summaryの書き方ごとに別の値) |
jobごとに1つの系列なので、frontendとbackendの両方で5xxが出ると、2つのアラートが発火します。
アラートルールには、アノテーションとしてsummary(アラートの概要)を設定する項目があります。
公式テンプレートはこのsummaryをdescriptionとして送るので、Agentに届くアラートの説明は、ここに書いた内容だけです。
今回は、このアラートルールのsummaryの書き方だけを変えて、2回試します。
どちらの書き方でも、公式テンプレートがエスケープしないので"と改行は含めていません。
動作確認
Contact pointのテスト送信
障害を起こす前に、Contact pointのテスト送信で調査が始まるかを確認しました。
テスト用のアラートのalertnameはTestAlert-integration、summaryは「Grafanaのテスト通知(Contact pointのTest)」にしています。
テスト送信でも、DevOps Agentの調査が始まりました。
ただ、Agentはテスト通知だと判断し、何も調べずに約1分で調査を終えています。
調査の記録(aws devops-agent list-journal-records)を見ると、Agentへの入力は以下の1行だけでした。
TITLE: TestAlert-integration, REFERENCE_URL: , DESCRIPTION: Grafanaのテスト通知(Contact pointのTest)
テンプレートで送っているservice・timestamp・data.metadata(ラベル)は、入力に含まれていません。
公式ドキュメントにも、調査に届くのはtitle・description・priorityとインシデントの参照だけで、調査に必要なものはsummaryに書く、と書かれています。
Agentは調査しない理由の1つとして「インシデント時間枠がない」を挙げ、「調査の起点となる発生時刻やアラート発火時刻がありません」と書いていました。
テンプレートのtimestampにはアラートの発火時刻を設定して送っていますが、Agentには届いていません。
公式テンプレートのtimestampは2026-10-29 02:39:57.xxx +0000 UTCのようなGoの既定の文字列表現になり、Grafanaはx-amzn-event-timestampヘッダーも送りません。
それでも、Webhookは受け付けられています。
同じテスト送信を、「Agent Spaceウェブフック」の表から作った汎用Webhook(API key)にも送りました。
公式テンプレートのままで受け付けられ、Webアプリのインシデントレスポンスの一覧では「以下によってトリガーされます」の列が「Event Channel」になりました。
Grafana用のWebhookに送ったものは「Grafana」です。
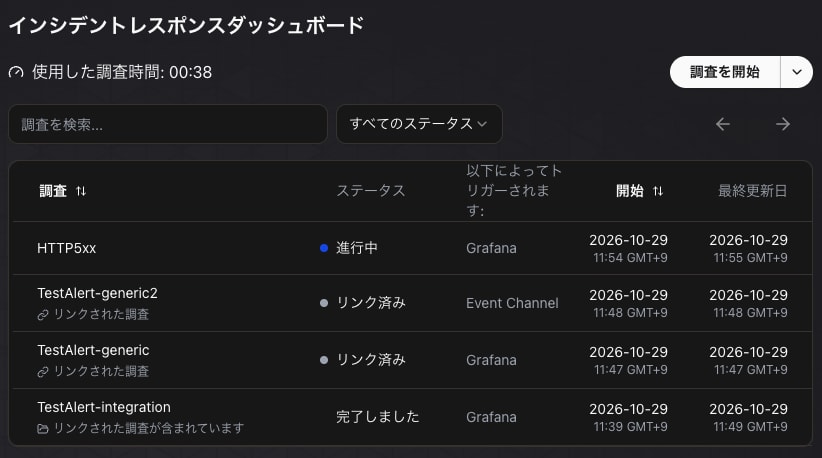
TestAlert-genericは、Contact pointの送り先を汎用Webhookに切り替える前に送ったので、Grafana用のWebhookに届いています。
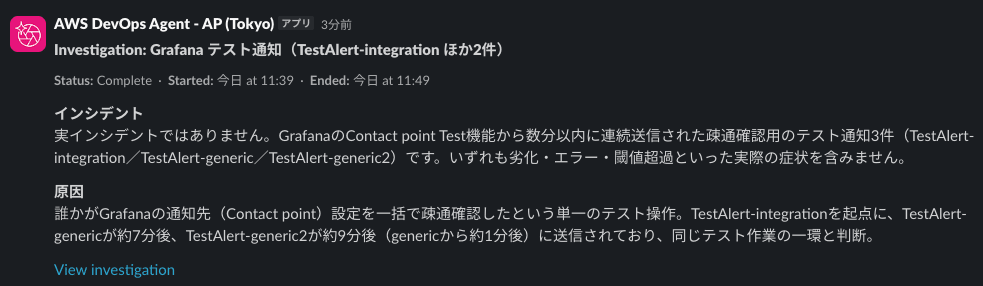
2回目以降のテスト送信は、新しい調査にならず「リンク済み」になりました。
完了していた最初のテストの調査にリンクされています。
Slackには、リンクされた3件をまとめた1つの投稿が届きました。
障害の起こし方
frontendの/errorは、backendの/failに中継され、backendがintentional failureで500を返します。
平常のトラフィック(frontendの/に1秒間隔)を流した状態で、/errorに0.5秒間隔で10分間アクセスしました。
END=$(( $(date +%s) + 600 ))
( while [ $(date +%s) -lt $END ]; do curl -s -o /dev/null $APP/error; sleep 0.5; done ) &
アクセスを始めて2分ほどで、frontendとbackendの両方のアラートが発火しました。
summaryを1行だけにしたアラートと、summaryにサービス名やデータの場所まで書いたアラートを、同じAgent Spaceで順番に試しています。
2つのアラートはsummaryとラベルだけが違い、ラベルが違うのでincidentIdも別になります。
1回目の調査にはフィードバックを付けていません。
2回目の前にWebアプリのナレッジの「メモリ」を確認し、この障害についての記憶が無いことを確認してから実施しました。
summaryを1行だけにしたアラートの調査
1回目は、アラートルールのsummaryを「HTTPの5xxエラーが増えています」の1行だけにしました。
上のアラートルールの画面で、ルール名の下に表示されているのがsummaryです。
どのサービス(job)で5xxが出ているかはラベルにしか含まれておらず、ラベルは調査に渡りません。
アラートが発火すると、DevOps Agentが通知を受け取り、調査が始まりました。
Agentへの入力は、テストのときと同じく1行だけです。
TITLE: HTTP5xx, REFERENCE_URL: , DESCRIPTION: HTTPの5xxエラーが増えています
調査は約18分で終わりました。
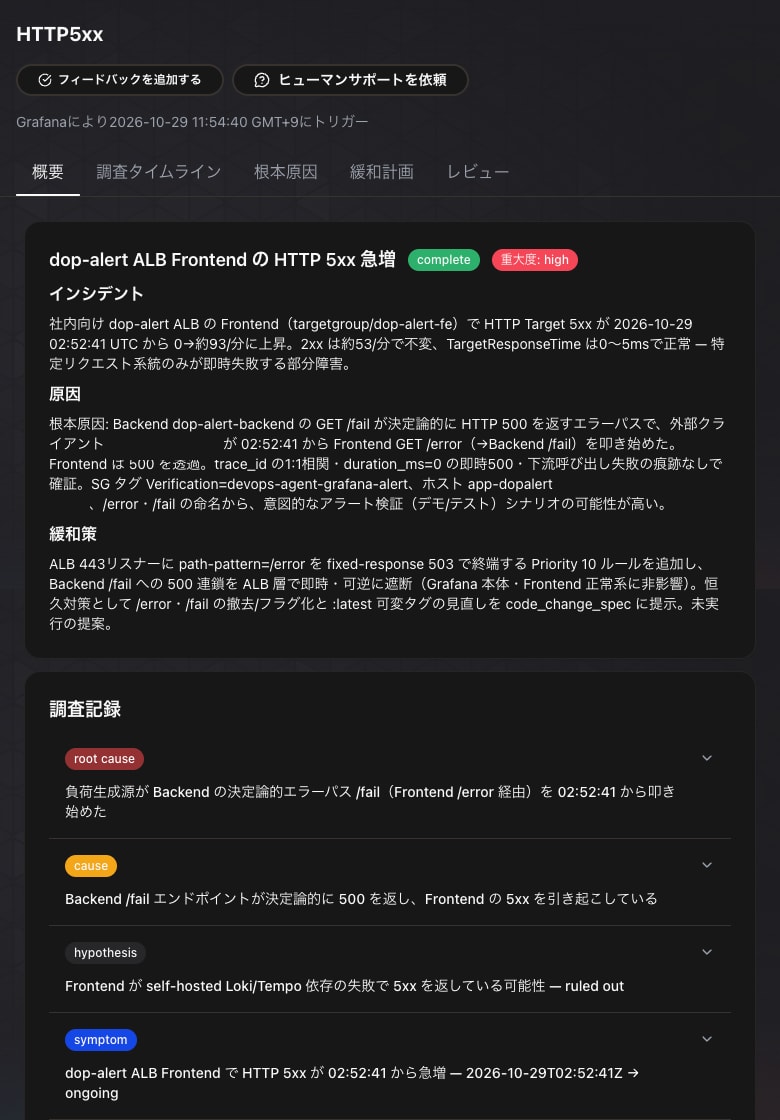
根本原因は、02:52:41(UTC)に外部からfrontendの/errorへのアクセスが始まり、そこから呼ばれるbackendの/failが必ず500を返している、というものでした。
/errorへのアクセスを始めた時刻も、秒単位で一致しています。
調査の記録を見ると、Agentは最初にCloudWatchのALBのメトリクスから、frontendのターゲットで5xxが多発していることを特定していました。
途中でLokiのラベルを{app="app"}と誤って指定し、「アプリのログがLokiに無い」と判断していましたが、あとでservice_name="app"で受信があることに気づいています。
そのうえで、frontendとbackendのログを同じtrace_idで突き合わせて、/error → /failのつながりを確認していました。
送信元についても、ALBのリスナールールの送信元IPの条件から、自分のIPだと特定していました。
また、SGのタグVerificationから、検証用の環境である可能性が高いとも記載していました。
Slackへの投稿
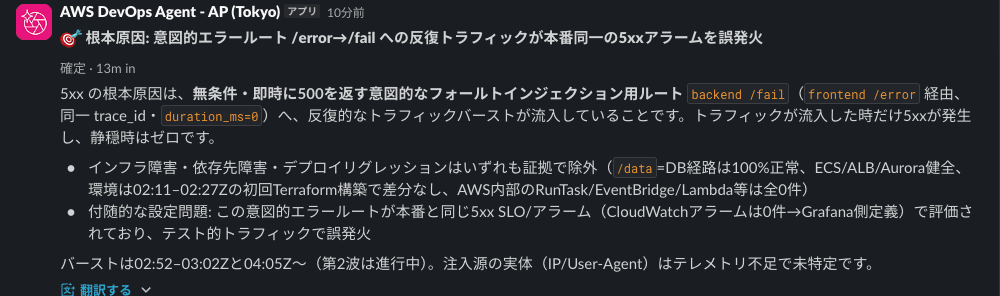
調査の結果は、Slackのチャンネルに「AWS DevOps Agent - AP (Tokyo)」のアプリから投稿されました。
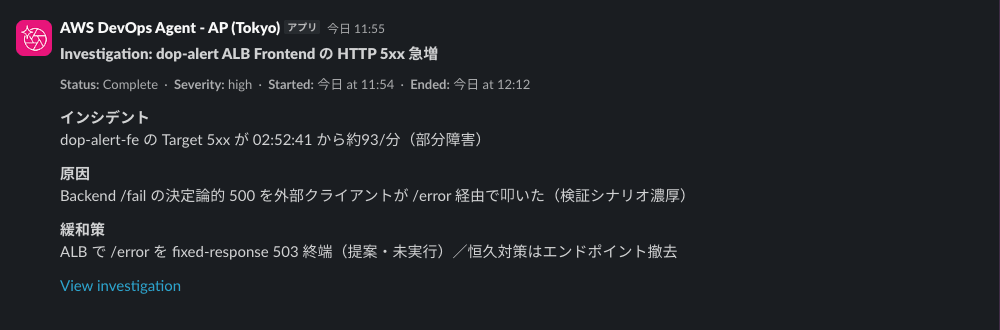
親の投稿にインシデント・原因・緩和策のまとめと、Webアプリの調査へのリンクが付きます。
スレッドには、調査の途中経過が「症状 → 調査中 → 原因 → 根本原因 → 緩和策 → 完了」の順に返信されていました。
緩和策の返信には、ALBのリスナーに/errorを503で返すルールを追加するAWS CLIのコマンドと、元に戻すときのコマンドが含まれています。
summaryにサービス名やデータの場所を書いたアラートの調査
2回目は、同じアラートルールのsummaryを、サービス名・URL・5xxの件数・メトリクス名・ログとトレースの場所まで書いたものに書き換えました。
アラートに通常記載する事実(何が・どこで・どれだけ・データがどこにあるか)だけにして、原因のヒント(/errorが疑わしい、など)は含めていません。
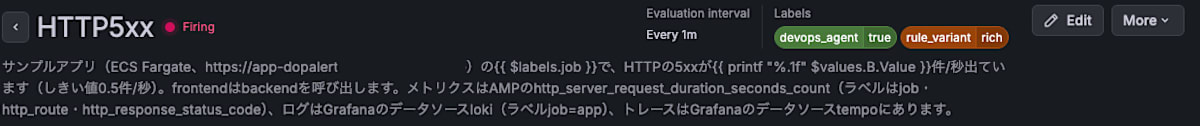
{{ $labels.job }}と{{ $values.B.Value }}は、通知のときにjobの名前と5xxの件数に置き換わります。
Agentへの入力は以下でした。
frontendとbackendの2つのアラートが1つの通知にまとまり、公式テンプレートは先頭の1件(backend)のsummaryを送っています。
TITLE: HTTP5xx, REFERENCE_URL: , DESCRIPTION: サンプルアプリ(ECS Fargate、https://app-dopalert.<ドメイン>)のbackendで、HTTPの5xxが1.6件/秒出ています(しきい値0.5件/秒)。frontendはbackendを呼び出します。メトリクスはAMPのhttp_server_request_duration_seconds_count(ラベルはjob・http_route・http_response_status_code)、ログはGrafanaのデータソースloki(ラベルjob=app)、トレースはGrafanaのデータソースtempoにあります。
調査は約15分で終わりました。
原因は、backendの/failが必ず500を返し、それがfrontendの/errorを通って5xxになっている、というもので、1回目と同じく/error → /failまで特定しています。
1回目の障害(約1時間前)の5xxもデータから検出しており、根本原因には「反復的なトラフィックバースト」と記載していました。
一方で、送信元は特定できず、ALBのアクセスログが無効になっていることをgapに挙げていました。
Grafanaのログ(router_logging)を見ると、2回目はAgentがGrafana経由でAMPのメトリクスも参照していました。
1回目はLokiのログだけを参照し、AMPへの問い合わせはありませんでした。
どちらの調査でも、AgentがGrafanaのアラートルールを参照してsummaryやラベルを補うことはありませんでした。
アラートの解消と再発火
/errorへのアクセスを止めて、アラートが2件ともNormalに戻ったあと、同じincidentIdの通知がもう一度DevOps Agentに届いていました(Agent Spaceのログ)。
このとき新しい調査は作成されず、進行中の調査もそのまま続きました。
2回目の調査が終わったあとに、もう一度/errorへのアクセスを発生させて、同じアラートを再発火させました。
ラベルが同じなので、incidentIdも前回と同じです。
再発火の通知では新しいタスクが作成されましたが、すぐに「リンク済み」になりました。
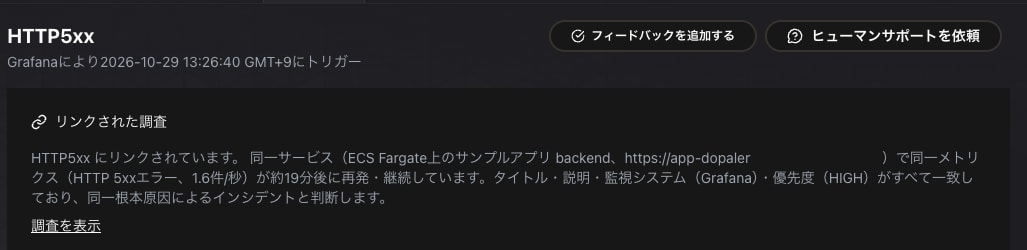
リンクした理由には「タイトル・説明・監視システム(Grafana)・優先度(HIGH)がすべて一致しており、同一根本原因によるインシデントと判断します」とあります。
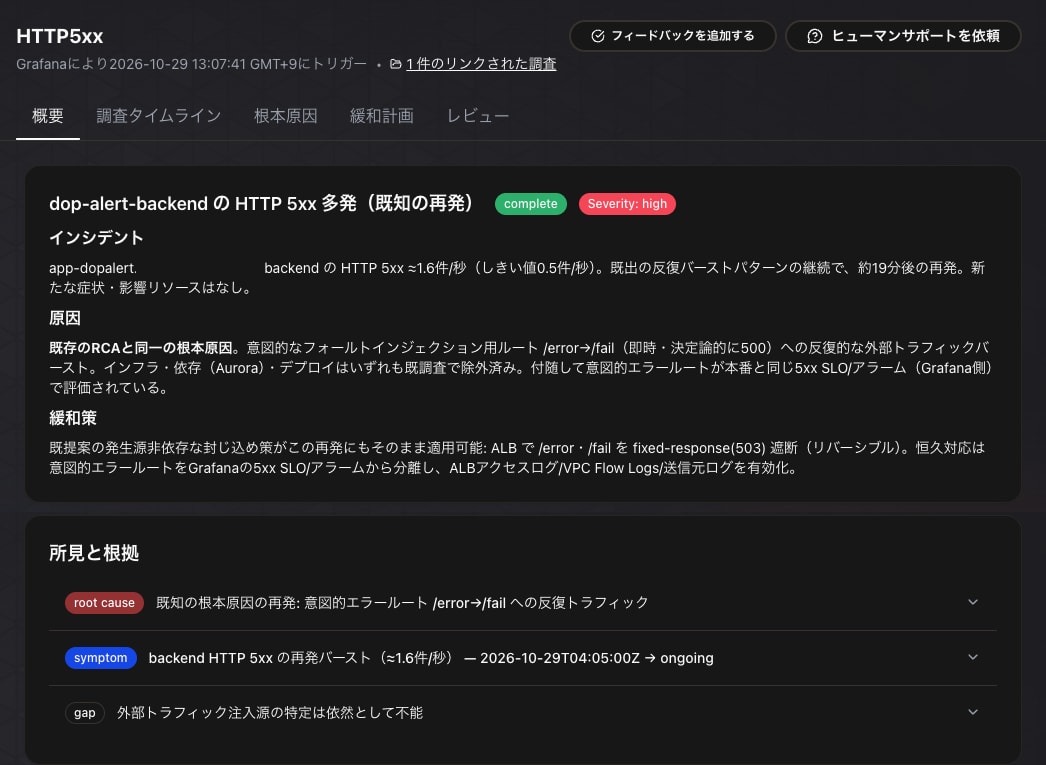
リンク先の前回の調査は「再開」され、2分ほどで「既知の再発」としてまとめ直されました。
ツールで調べ直すのではなく、前回の結論と照らし合わせて終えています。
Slackでも、前回の調査のスレッドに「再開」と「完了: 既知の根本原因の再発、新たな原因なし」が追記され、親の投稿のタイトルも「(既知の再発)」に書き換わりました。
jobごとの通知
公式ドキュメントの推奨どおりgroup_byをalertnameにすると、frontendとbackendの2つのアラートが1つの通知にまとまります。
公式テンプレートはグループの先頭の1件を送る仕様なので、上の2回の調査では、どちらもbackendのアラートのsummaryが送られていました。
再発火のアラートが発火している間に、group_byを[alertname, job]に変更しました。
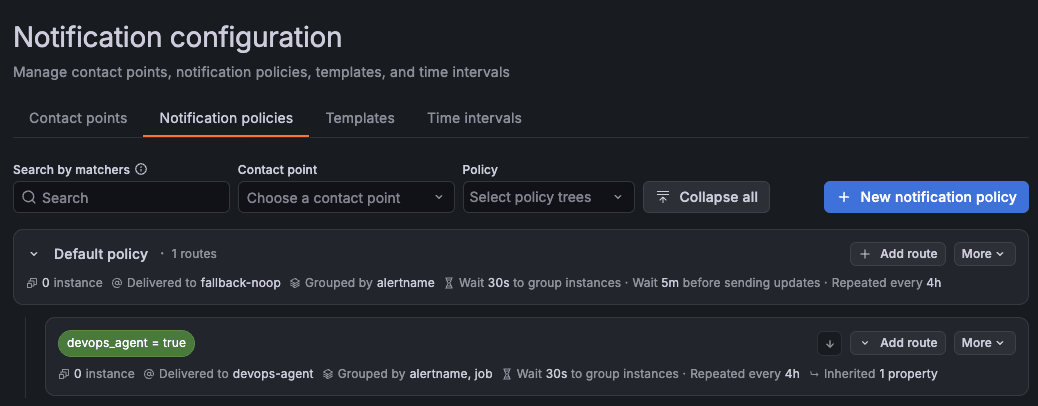
変更した直後に、frontendとbackendのアラートが別々の通知として送られ、incidentIdもjobごとに分かれました。
frontendの通知は、同じ時間帯を調べていた調査にはリンクされず、新しい調査になりました。
backendの通知は、直前の再発火と同じincidentIdだったので、新しいタスクは作成されませんでした。
frontendの調査は約17分で、原因は1回目・2回目と同じく、backendの/failが必ず500を返し、それがfrontendの/errorに伝わっている、というものでした。
HMACの汎用Webhookへの送信
公式ドキュメントでは、汎用Webhookのように強いセキュリティの保証が必要な場面ではHMACが推奨されています。
GrafanaのContact pointにもHMAC署名の設定があるので、HMACの汎用Webhookに送信できるかを確認しました。
ただし、DevOps Agentのドキュメントのサンプルと、GrafanaのHMAC署名では、署名のエンコードとタイムスタンプの形式が異なります。
署名の対象(<タイムスタンプ>:<ペイロード>)とアルゴリズム(HMAC-SHA256)は同じです。
| DevOps Agent(ドキュメントのサンプル) | Grafana | |
|---|---|---|
| 署名のエンコード | base64 | hex |
| タイムスタンプ | ISO 8601(+%Y-%m-%dT%H:%M:%S.000Z) |
Unixタイムスタンプ |
この違いがあっても、Grafanaの形式のままでDevOps Agentに受け付けられるかを確認します。
「Agent Spaceウェブフック」の表で、認証タイプをHMACにした汎用Webhookを作成しました。
1つのAgent Spaceには、HMACとAPI keyのWebhookを1つずつ作成できます。
GrafanaのContact pointでは、HMAC SignatureのHeaderにx-amzn-event-signature、Timestamp headerにx-amzn-event-timestampを設定しています。
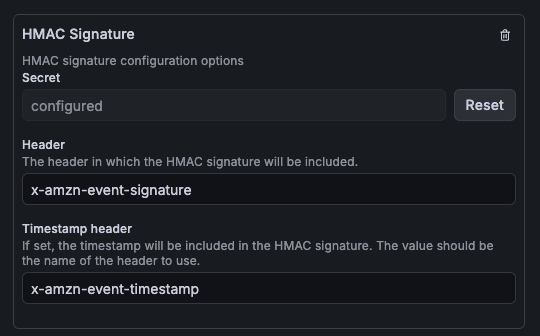
Custom Payloadは、Bearerで送るContact pointと同じく公式テンプレート(devops-agent-payload)のままです。
公式テンプレートのまま、GrafanaのHMAC署名でHMACの汎用Webhookに送信できました。
Contact pointのテスト送信はDevOps Agentに受け付けられ、調査が始まりました。
「以下によってトリガーされます」は「Event Channel」でした。
ドキュメントのサンプルとは署名のエンコードとタイムスタンプの形式が異なりますが、Grafanaの形式のままで受け付けられています。
どちらの形式を受け付けるかは、ドキュメントには書かれていません。
最後に
今回は、ECS FargateでセルフホストしたGrafanaのアラートから、公式の通知テンプレートでAWS DevOps Agentの調査を自動で起動し、結果をSlackに通知してみました。
この記事がどなたかの参考になれば幸いです。