DevOps AgentにセルフホストのGrafanaを連携して、Loki / Tempo / AMPのどこまで読めるか確認してみた

こんにちは、ゲームソリューション部のsoraです。
今回は、ECS FargateでセルフホストしたGrafana(Loki / Tempo / AMP)をAWS DevOps Agentに連携して、どこまで読めるかと、障害調査でどう使われるかを確認してみたことについて書いていきます。
先に結論
- GrafanaはViewerのサービスアカウントのトークンで、Terraform(awscc)から登録・関連付けまでできた
- Grafana経由でLokiのログとAMPのメトリクスは読めたが、Tempoのトレースは読めなかった
- Tempoを読めないかわりに、Lokiのログの
trace_idからトレースを組み立てて答えた - Lokiのログを見ないと原因が分からない障害で、AgentがGrafana経由でLokiのログを読みに行き、原因のエンドポイントまで特定できた
構成
今回構築したのは以下の構成です。
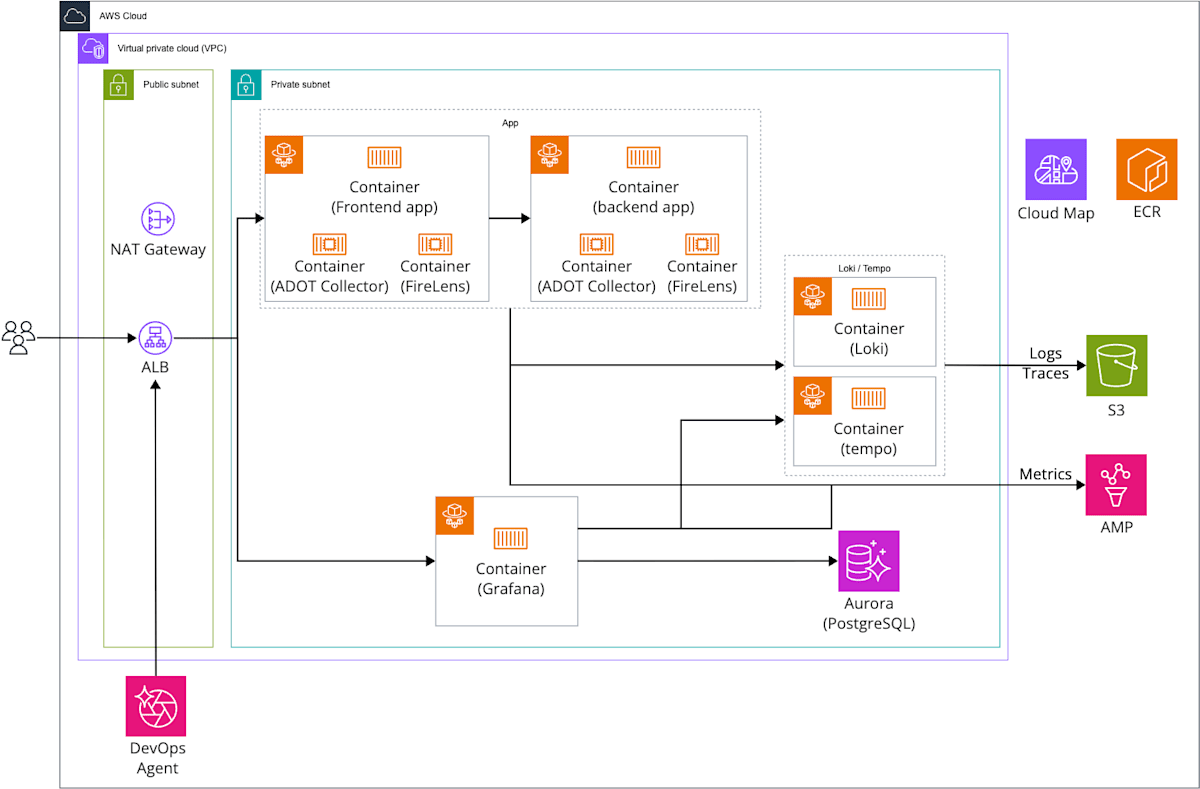
ECS FargateでGrafana / Loki / Tempoと、Goのサンプルアプリ(frontend → backend)を動かし、GrafanaをAWS DevOps Agentに登録する構成です。
アプリのログはFireLensがLokiへ、トレースとメトリクスはADOT CollectorがTempoとAMPへ送ります。
DevOps AgentはVPCの外から公開ALBを通ってGrafanaにつなぎ、AWSのデータ(CloudWatch / ECS / CloudTrailなど)はIAMロールでAPIを呼んで読みます。
Loki / Tempoの構成は、以下の記事で作ったものを土台にしています。
Agent SpaceのIAMロールには、マネージドポリシーのAIDevOpsAgentAccessPolicyを付けています。
このポリシーには、X-Rayのトレースを読む権限はありますが、AMPのメトリクスを問い合わせる権限(aps:QueryMetrics)はありません。
AMPを読む権限は足さず、X-Rayにもトレースを送らないようにして、アプリのログ・トレース・メトリクスはGrafana経由でしか読めないようにしています。
主なコンポーネント
| 役割 | コンポーネント |
|---|---|
| 障害調査 | AWS DevOps Agent(東京リージョン、Agent Space × 2) |
| 可視化 | Grafana OSS(ECS Fargate、grafana/grafana:13.2.1) |
| Grafanaの設定DB | Aurora Serverless v2(PostgreSQL 18.4) |
| 入口 | ALB + ACM + Route 53 |
| サンプルアプリ | Go製のfrontend / backend(ECS Fargate) |
| テレメトリ収集 | ADOT Collector v0.50.0 / Fluent Bit 3.4.15(サイドカー) |
| ログ | Loki 3.7.7 |
| トレース | Tempo 3.0.3 |
| メトリクス | AMP |
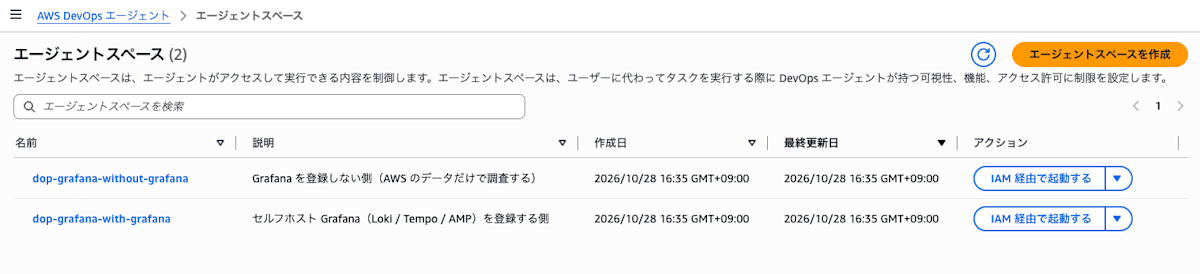
Agent Spaceは2つ作り、片方にだけGrafanaを関連付けました。
1つのAgent SpaceでGrafanaを付け外しして調査すると、1回目の調査で残った記憶が2回目に影響しうるためです。
2つのAgent Spaceに同じ障害を同時に調べさせて、Grafanaの有無で調査の結果がどう変わるかを見ます。
構築
今回はTerraformで構築しました。
Grafana / Loki / Tempoまわりは土台にした記事と同じなので、DevOps Agentに関わるところだけ解説します。
DevOps Agentの送信元IPの許可
Grafanaの登録では、DevOps AgentがGrafanaのURLに到達できるかが確かめられます。
GrafanaのALBは送信元IPで絞っているので、DevOps Agentの送信元IPを許可しました。
送信元IPはリージョンごとに公式ドキュメントに載っていて、東京リージョンは以下の6つです。
- 13.192.12.233
- 35.74.181.230
- 57.183.50.158
- 13.114.228.89
- 54.150.140.28
- 46.51.224.121
このIPは利用者ごとに分かれているものではないので、Grafana側はサービスアカウントのトークンで認証しています。
公式ドキュメントには、VPC Latticeを使うPrivate connectionで、インターネットに出していないGrafanaにつなぐ方法も載っています。
今回は使っていません。
Agent Spaceの作成
Agent Spaceは、awsプロバイダのaws_devopsagent_agent_spaceでも作れます。
ただ、Grafanaの登録と関連付けに使うリソースはawsccプロバイダにしか無いので、今回はすべてawsccで書きました。
resource "awscc_devopsagent_agent_space" "this" {
  for_each = local.agent_spaces # without-grafana / with-grafana

  name   = "${local.name}-${each.key}"
  locale = "ja"

  operator_app = {
    iam = {
      operator_app_role_arn = aws_iam_role.devops_operator.arn
    }
  }
}

resource "awscc_devopsagent_association" "aws" {
  for_each = awscc_devopsagent_agent_space.this

  agent_space_id = each.value.agent_space_id
  service_id     = "aws"

  configuration = {
    aws = {
      assumable_role_arn = aws_iam_role.devops_agentspace.arn # AIDevOpsAgentAccessPolicyを付けたロール
      account_id         = data.aws_caller_identity.current.account_id
      account_type       = "monitor"
    }
  }
}
locale = "ja"で、Webアプリの回答が日本語になります。
公式サンプルではconfiguration.awsにresources = []が書かれていますが、今回は書いていません。
書くと、planのたびにresourcesのin-placeの差分が出続けました。
Grafanaのサービスアカウント
公式ドキュメントの手順どおり、GrafanaにViewerのサービスアカウントを作り、トークンを発行します。
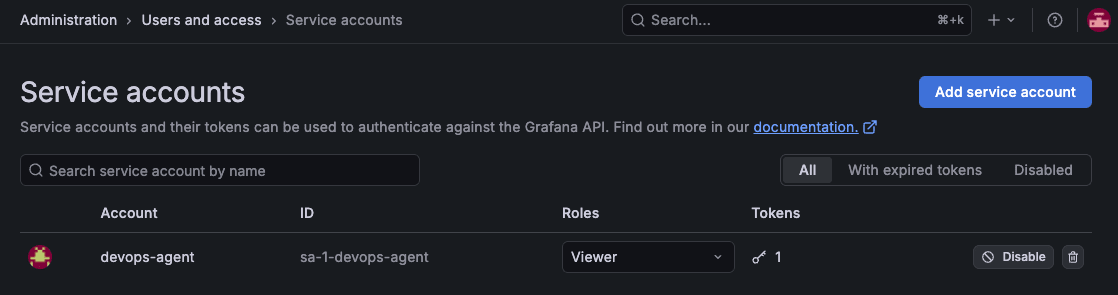
Viewerのトークンでも、データソースの一覧(GET /api/datasources)とLoki / AMPへのクエリはできました。
Grafanaの登録
Grafanaは、AWSアカウント単位で登録してから、Agent Spaceごとに関連付ける2段階になっています。
登録はawscc_devopsagent_serviceで、endpointにGrafanaのURLを入れます。
resource "awscc_devopsagent_service" "grafana" {
  service_type = "mcpservergrafana"
  name         = "selfhosted-grafana"

  service_details = {
    mcp_server_grafana = {
      name     = "selfhosted-grafana"
      endpoint = "https://${local.fqdn}" # GrafanaのURL
      authorization_config = {
        bearer_token = {
          token_name  = "grafana-sa-devops-agent"
          token_value = var.grafana_service_account_token # Viewerのトークン(glsa_〜)
        }
      }
    }
  }
}
登録の時点で到達性のチェックが入るので、Grafanaが起動していて、ALBのSGに送信元IPが入っている状態でapplyします。
トークンはstateに平文で残ります。
Agent Spaceへの関連付け
Agent SpaceへのGrafanaの関連付けはawscc_devopsagent_associationで書きます。
ここでtoolsに、使わせるツールのカテゴリを入れます。
resource "awscc_devopsagent_association" "grafana" {
  agent_space_id = awscc_devopsagent_agent_space.this["with-grafana"].agent_space_id
  service_id     = awscc_devopsagent_service.grafana.service_id

  configuration = {
    mcp_server_grafana = {
      endpoint = "https://${local.fqdn}"
      tools = [
        "alerting", "annotations", "asserts", "cloudwatch", "dashboard",
        "datasource", "elasticsearch", "examples", "incident", "loki",
        "navigation", "oncall", "prometheus", "pyroscope", "rendering",
        "runpanelquery", "search", "searchlogs", "sift",
      ]
    }
  }
}
toolsは省略しても関連付けはできますが、その場合はGrafanaのツールが1つも使えません。
省略したときにWebアプリのチャットで聞くと、「tools: []のためツールが利用できない」という趣旨の答えが返ってきました。
toolsに入れる値は、公式ドキュメントにもAPIリファレンスにも一覧がありません。
コンソールでAgent SpaceにGrafanaを関連付けるときの「ツールの選択」に出る19個のカテゴリを、そのまま入れています。
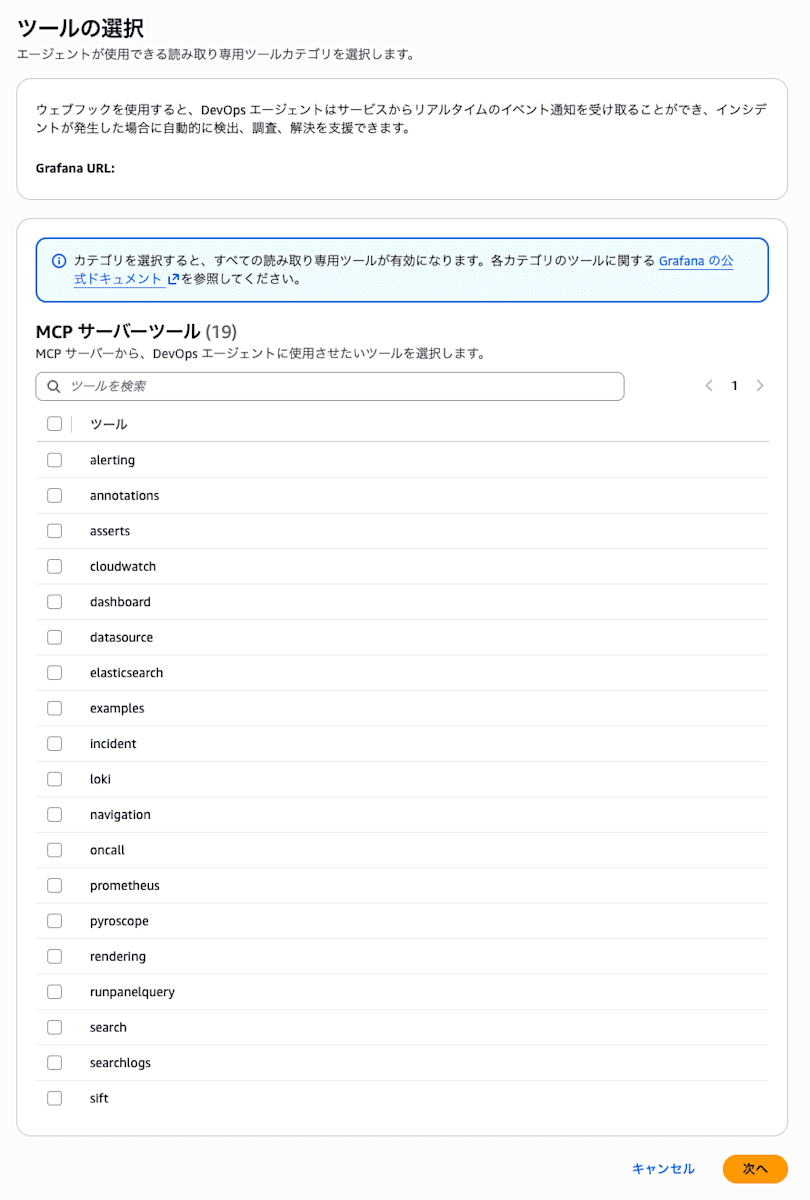
画面の説明には「カテゴリを選択すると、すべての読み取り専用ツールが有効になります」とあります。
一覧にlokiとprometheusはありますが、tempoはありません。
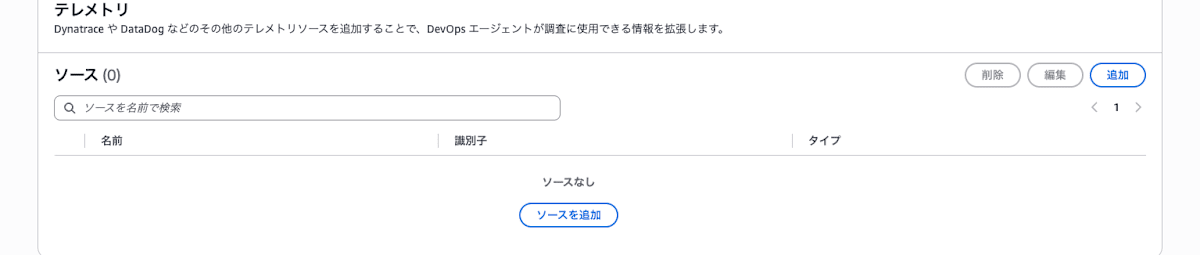
関連付けると、Agent Spaceの機能タブのテレメトリにGrafanaが出ます。
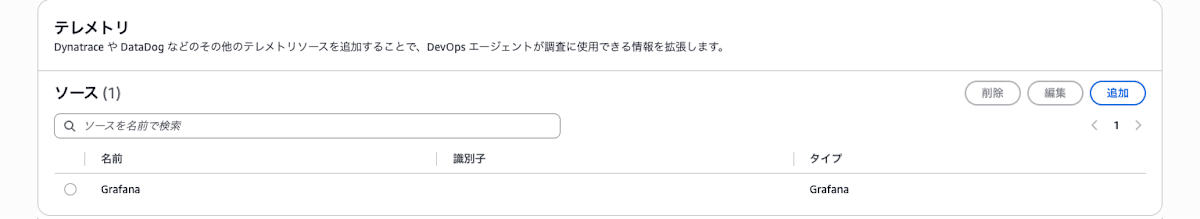
Grafanaを関連付けていないAgent Spaceでは、テレメトリのソースは0件です。
ちなみに、コンソールの「Grafanaを関連付け」の次のステップ(エージェントアクション)では、create_annotationやcreate_alert_ruleなどの書き込み系のツールが7つ選べました。
チャットでの確認
障害を起こす前に、Grafanaを関連付けたAgent SpaceのWebアプリのチャットで、Loki / AMP / Tempoをそれぞれ読めるか聞いてみました。
Loki
「Lokiで {job="app"} の直近15分のログを5行見せてください。」と聞くと、アプリのアクセスログが返ってきました。
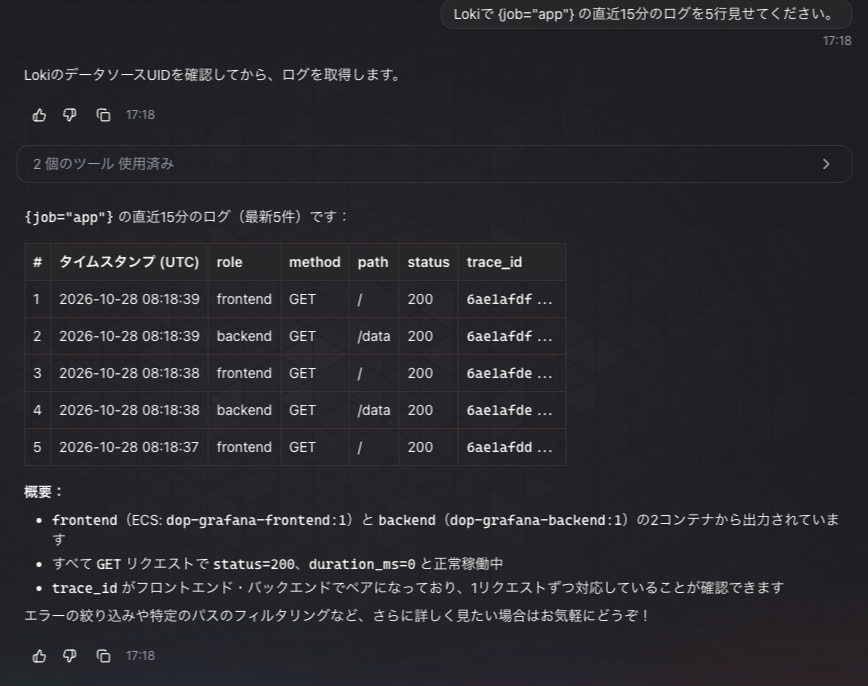
Grafanaのログ(router_logging)では、DevOps Agentのサービスアカウントから、データソースの一覧と、Lokiのquery_rangeへのリクエストが出ていました。
AMP
「AMPで直近15分のfrontendのリクエスト数を見せてください。」と聞くと、AMPのhttp_server_request_duration_seconds_count{job="frontend"}で答えました。
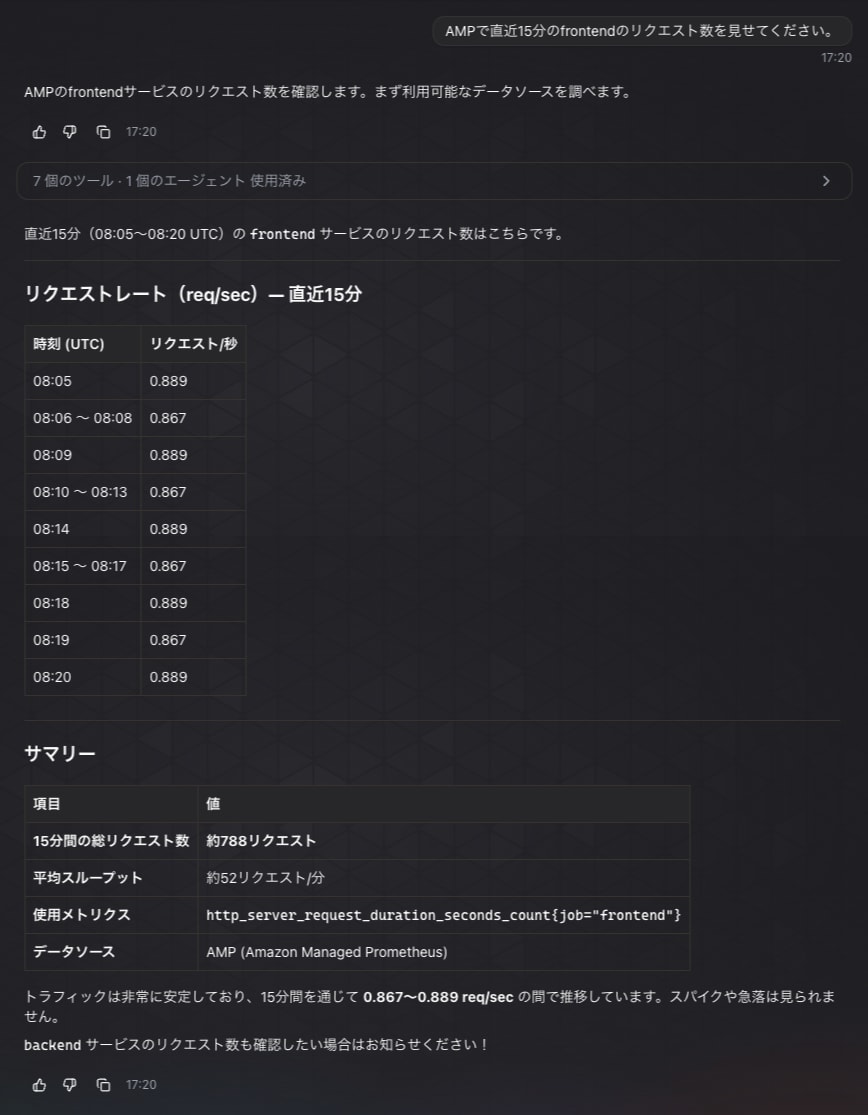
AMPはGrafanaではgrafana-amazonprometheus-datasource(プラグイン)のデータソースですが、Prometheus用のツールで読めていました。
toolsが使えていなかったときは、同じ質問にALBのCloudWatchメトリクスで答えていたので、Grafanaのツールが使えるかどうかで答え方が変わっています。
Tempo
「Tempoで service.name=frontend の直近15分のトレースを1件見せてください。」と聞くと、トレースらしきものは返ってきましたが、Tempoからは読めていませんでした。
使ったツールの一覧を開くと、Tempoのツールは無く、Lokiのログからtrace_idを探して組み立てていました。
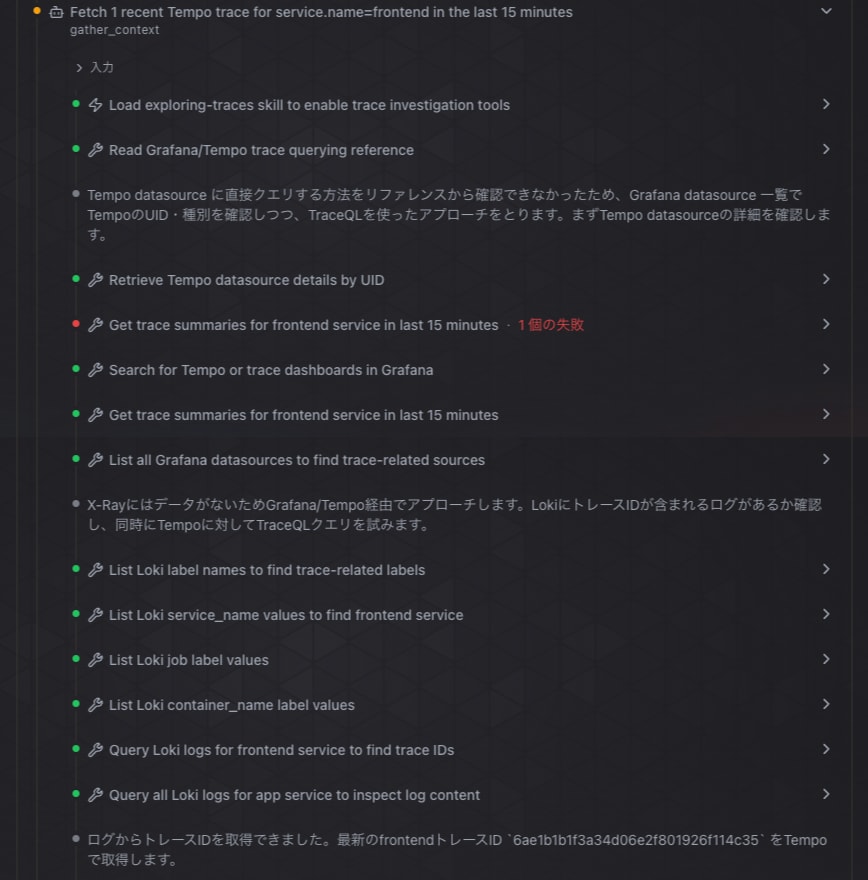
組み立てたトレースはLokiのアクセスログの行の数だけのスパンで、durationは0msでした。
Tempoを読めるようにするために、以下を試しました。
| 試したこと | 結果 |
|---|---|
| TempoのMCPサーバーの有効化 | GrafanaからTempoのMCPサーバーへの接続は成功したが、Agentのツールには出てこなかった |
exploring-tracesスキルのget_trace_by_id |
中身はX-RayのBatchGetTracesで、incorrect id formatのエラー |
Tempoのパネルを入れたダッシュボードとgrafana_run_panel_query |
datasource type 'tempo' is not supported by run_panel_queryのエラー |
Grafanaのログを見ると、DevOps AgentはGrafanaのデータソースのプロキシを通して、TempoのMCPサーバー(/api/mcp)につなごうとしていました。
最初はDELETE /api/datasources/proxy/uid/tempo/api/mcpが404になっていたので、TempoのMCPサーバーを有効にしてみました。
query_frontend:
  mcp_server:
    enabled: true
有効にしたあとは200 / 202に変わり、接続はできるようになりました。
ただ、Agentが使えるツールは関連付けの19個のカテゴリの中だけで、Tempoのツールは出てきませんでした。
Agentに「Grafana経由でTempoを読む方法はあるか」と聞くと、exploring-tracesスキルとgrafana_run_panel_queryの2つを挙げたので、それぞれ試しました。
get_trace_by_idは、AWSアカウントIDとリージョンを入力に取るX-Ray用のツールでした。
Error: InvalidRequestException - BatchGetTraces: Invalid trace id 6ae1b2d225d7ff6a065043f371546187: incorrect id format
grafana_run_panel_queryは、ダッシュボードの検索とパネルの確認まではできましたが、実行はMCPサーバーの中で断られていました。
Grafanaのログに/api/ds/queryは出ていないので、Grafanaまで届いていません。
"errors": {"2": "datasource type 'tempo' is not supported by run_panel_query; use the native query tool (e.g. query_promet…"}
Agentのまとめでは、grafana_run_panel_queryが対応しているのはPrometheus / Loki / ClickHouse / CloudWatchだけ、とされていました。
障害調査の比較
障害の起こし方
frontendの/errorは、backendの/failに中継され、backendがintentional failureで500を返します。
平常のトラフィック(frontendの/に1秒間隔)を流したまま、/errorに0.5秒間隔で10分間アクセスしました。
END=$(( $(date +%s) + 600 ))
( while [ $(date +%s) -lt $END ]; do curl -s -o /dev/null $APP/error; sleep 0.5; done ) &
ALBのメトリクスとCloudWatchアラームには「frontendで5xxが増えた」という症状しか出ません。
どのエンドポイントがなぜ500を返したかは、Loki / Tempo / AMPを見ないと分からない障害です。
アラームdop-grafana-frontend-5xxがALARMになったあと、2つのAgent SpaceのWebアプリで、同じ文面の調査を続けて開始しました。
https://app-dop.<ドメイン>/ のfrontendで5xxが増えています。
CloudWatchアラーム dop-grafana-frontend-5xx が発火しました。
発生時刻は 2026-10-28 08:44 UTC(17:44 JST)ごろからです。
原因を調べてください。
Grafana / Loki / Tempoという言葉は入れず、Agentが自分でGrafanaを使うかを見ています。
調査を開始するダイアログには、調査の詳細・名前・優先度の欄だけがあり、発生時刻の欄は無かったので、文面に発生時刻を入れました。
調査の途中でチャットから誘導はしていません。
Grafanaを関連付けていないAgent Spaceの調査結果
Grafanaを関連付けていないAgent Spaceの調査は、約22分23秒かかりました。
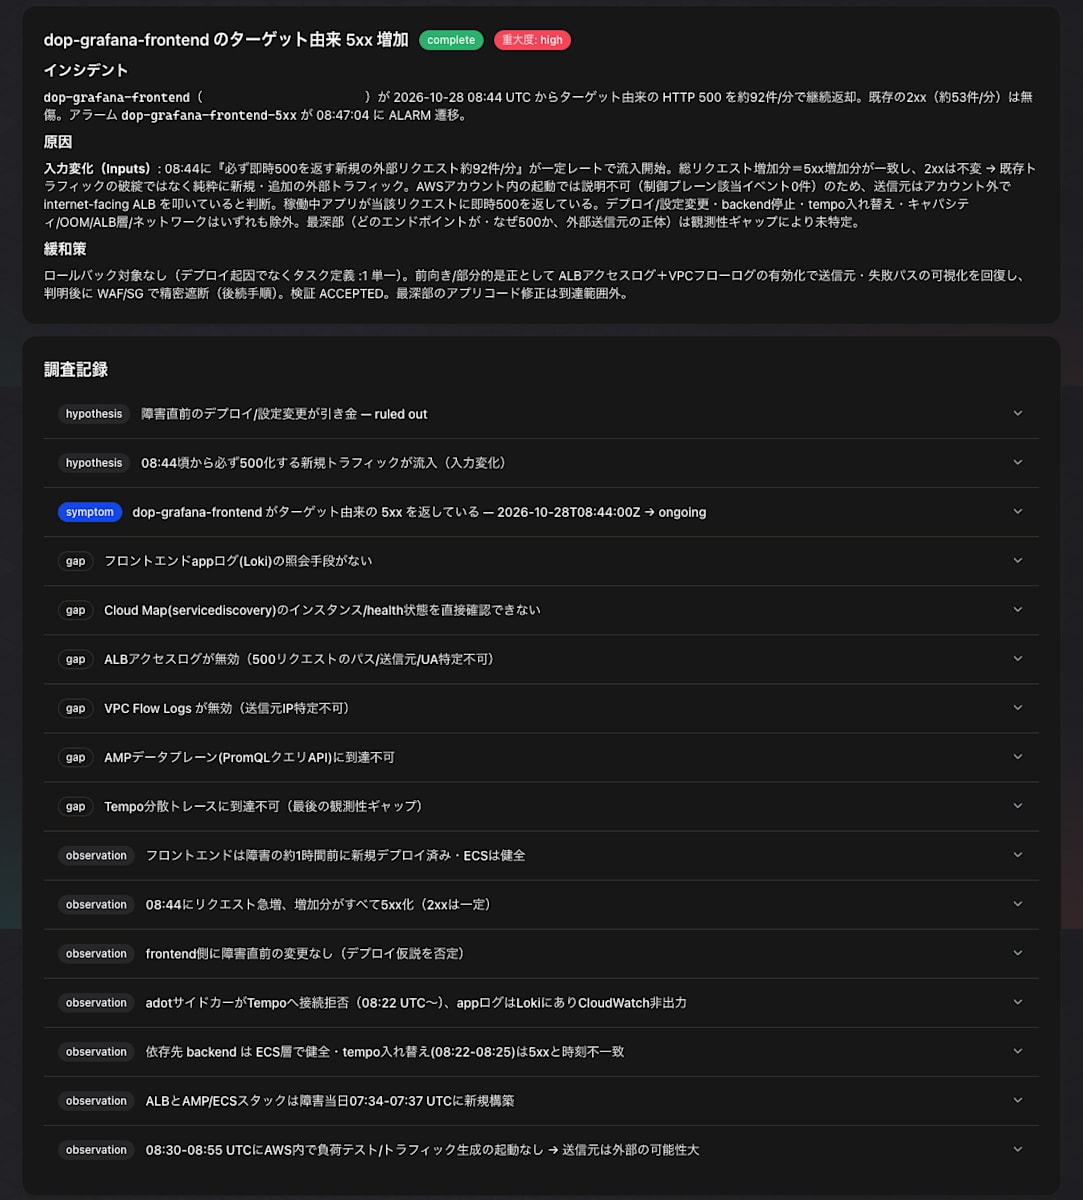
原因は「08:44に、必ず即時500を返す新規の外部リクエスト(約92件/分)が一定のレートで流入した」です。
デプロイや設定変更、backendの停止、キャパシティ、ALB、ネットワークは除外していて、ここまでは合っています。
ただ、「どのエンドポイントが・なぜ500か」は、観測性のギャップで未特定となりました。
※ドメインはマスクしています
調査記録のgapには、「フロントエンドappログ(Loki)の照会手段がない」「AMPデータプレーン(PromQLクエリAPI)に到達不可」「Tempo分散トレースに到達不可」が並んでいます。
CloudWatch Logsのサイドカーのログから、アプリのログがLokiにあること自体には気づいていましたが、読む手段がありませんでした。
Grafanaを関連付けたAgent Spaceの調査結果
Grafanaを関連付けたAgent Spaceの調査は、約12分46秒で終わりました。
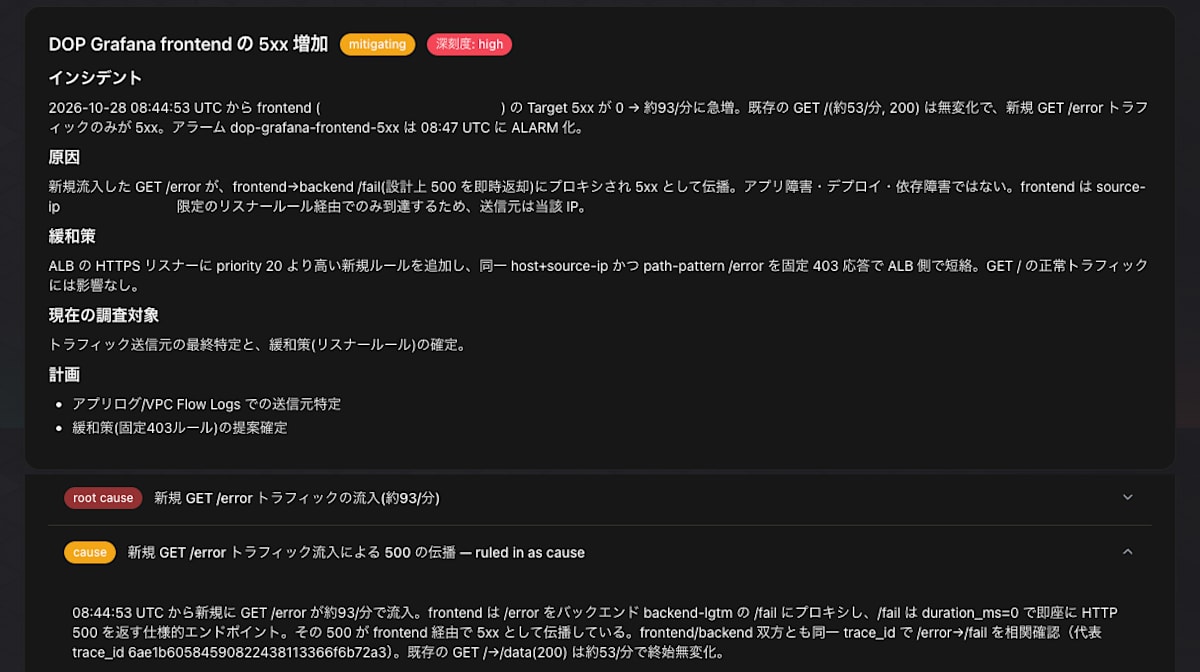
原因は「新規流入したGET /errorが、frontend → backendの/fail(設計上500を即時返却)にプロキシされ、5xxとして伝播」です。
frontendとbackendのログを同じtrace_idで突き合わせて、/error → /failのつながりを確かめていました。
障害の時間帯の/errorの件数(930件、すべて500)も、実際にアクセスした回数と一致しています。
※ドメインと送信元IPはマスクしています
調査のタイムラインを見ると、アプリのログがLokiにあると気づいたところで、Loki・Tempo・ALBのアクセスログ・インフラの変更を調べるサブエージェントを並べて起動していました。
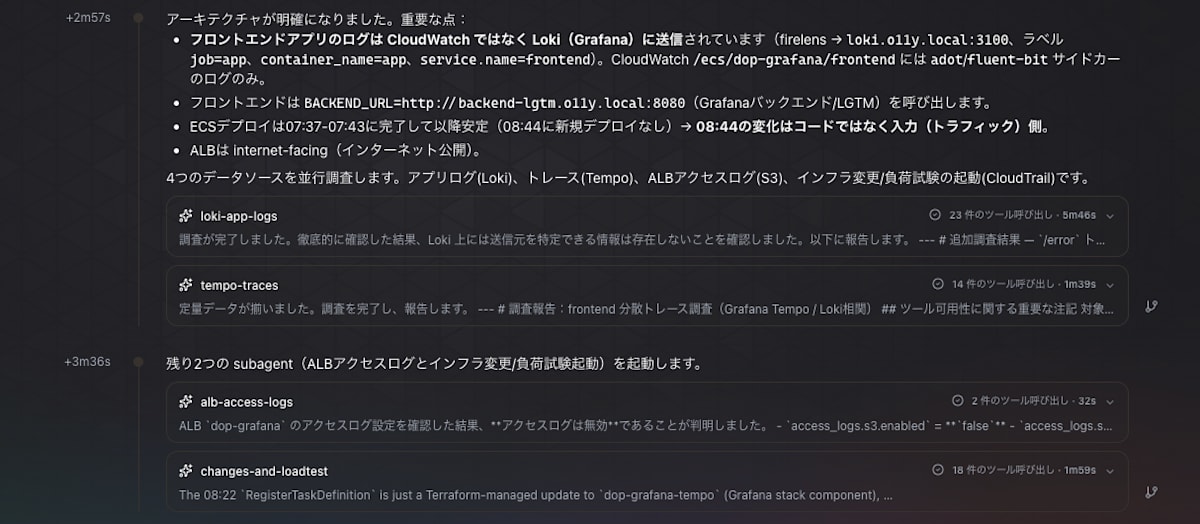
tempo-tracesという名前のサブエージェントもありますが、ここでもTempoは読めておらず、Lokiのログで代わりにしていました。
gapとして残ったのは、送信元のIPとUser-Agentだけです。
ALBのアクセスログを無効にしているためで、送信元はリスナールールの条件とCloudTrailの記録から推測していました。
Grafanaのログ(router_logging)を見ると、調査中のDevOps Agentからのリクエストは68件で、すべてLokiに関するものでした。
AMPへの問い合わせはありませんでした。
最後に
今回は、ECS FargateでセルフホストしたGrafanaをAWS DevOps Agentに連携して、どこまで読めるかと、障害調査でどう使われるかを確認してみました。
この記事がどなたかの参考になれば幸いです。