[SO-ARM101] 模倣学習のデータセット(LeRobot Dataset v3.0 / v2.1)の中身を実データで確認してみました

1 はじめに
製造ビジネステクノロジー部の平内(SIN)です。
模倣学習では、人間がロボットを操作した動作がそのまま教師データになります。報酬関数を設計する強化学習と違い、データセットが持っている情報がすべての元になります。
しかし、そのデータセットの中が、どうなっているのかは、学習を回しているだけではあまり見えてきません。
手元に、同じ「アヒルを掴んでかごに入れる」タスクを、LeRobot Dataset の v3.0 と v2.1 の 2 つの形式で収録したデータセットがありました。そこで今回は、この 2 つを 1 ファイルずつ開いて、中身を確認してみました。
先に結論を述べると、模倣学習のデータセットの実体は、どちらの形式でも「動画 + 関節角の時系列」だけでした。それ以上のものは入っていません。2 つの形式で違うのは、その置き方です。
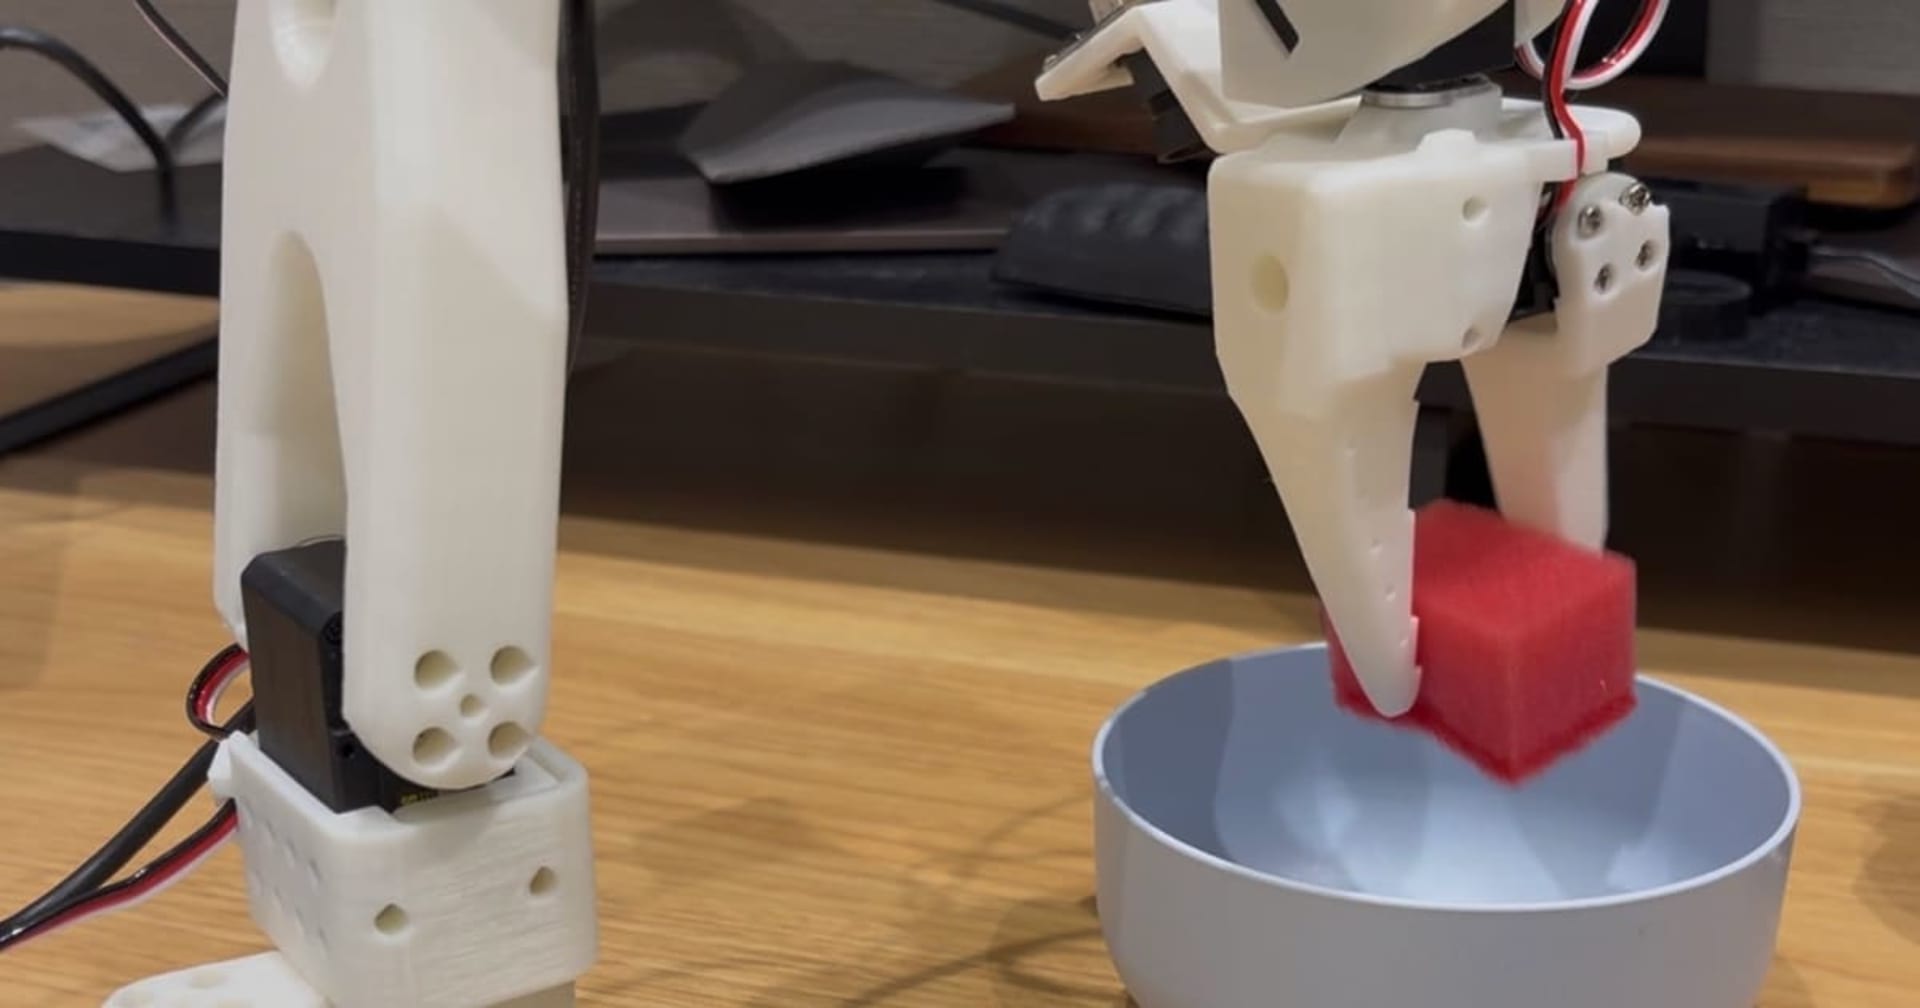
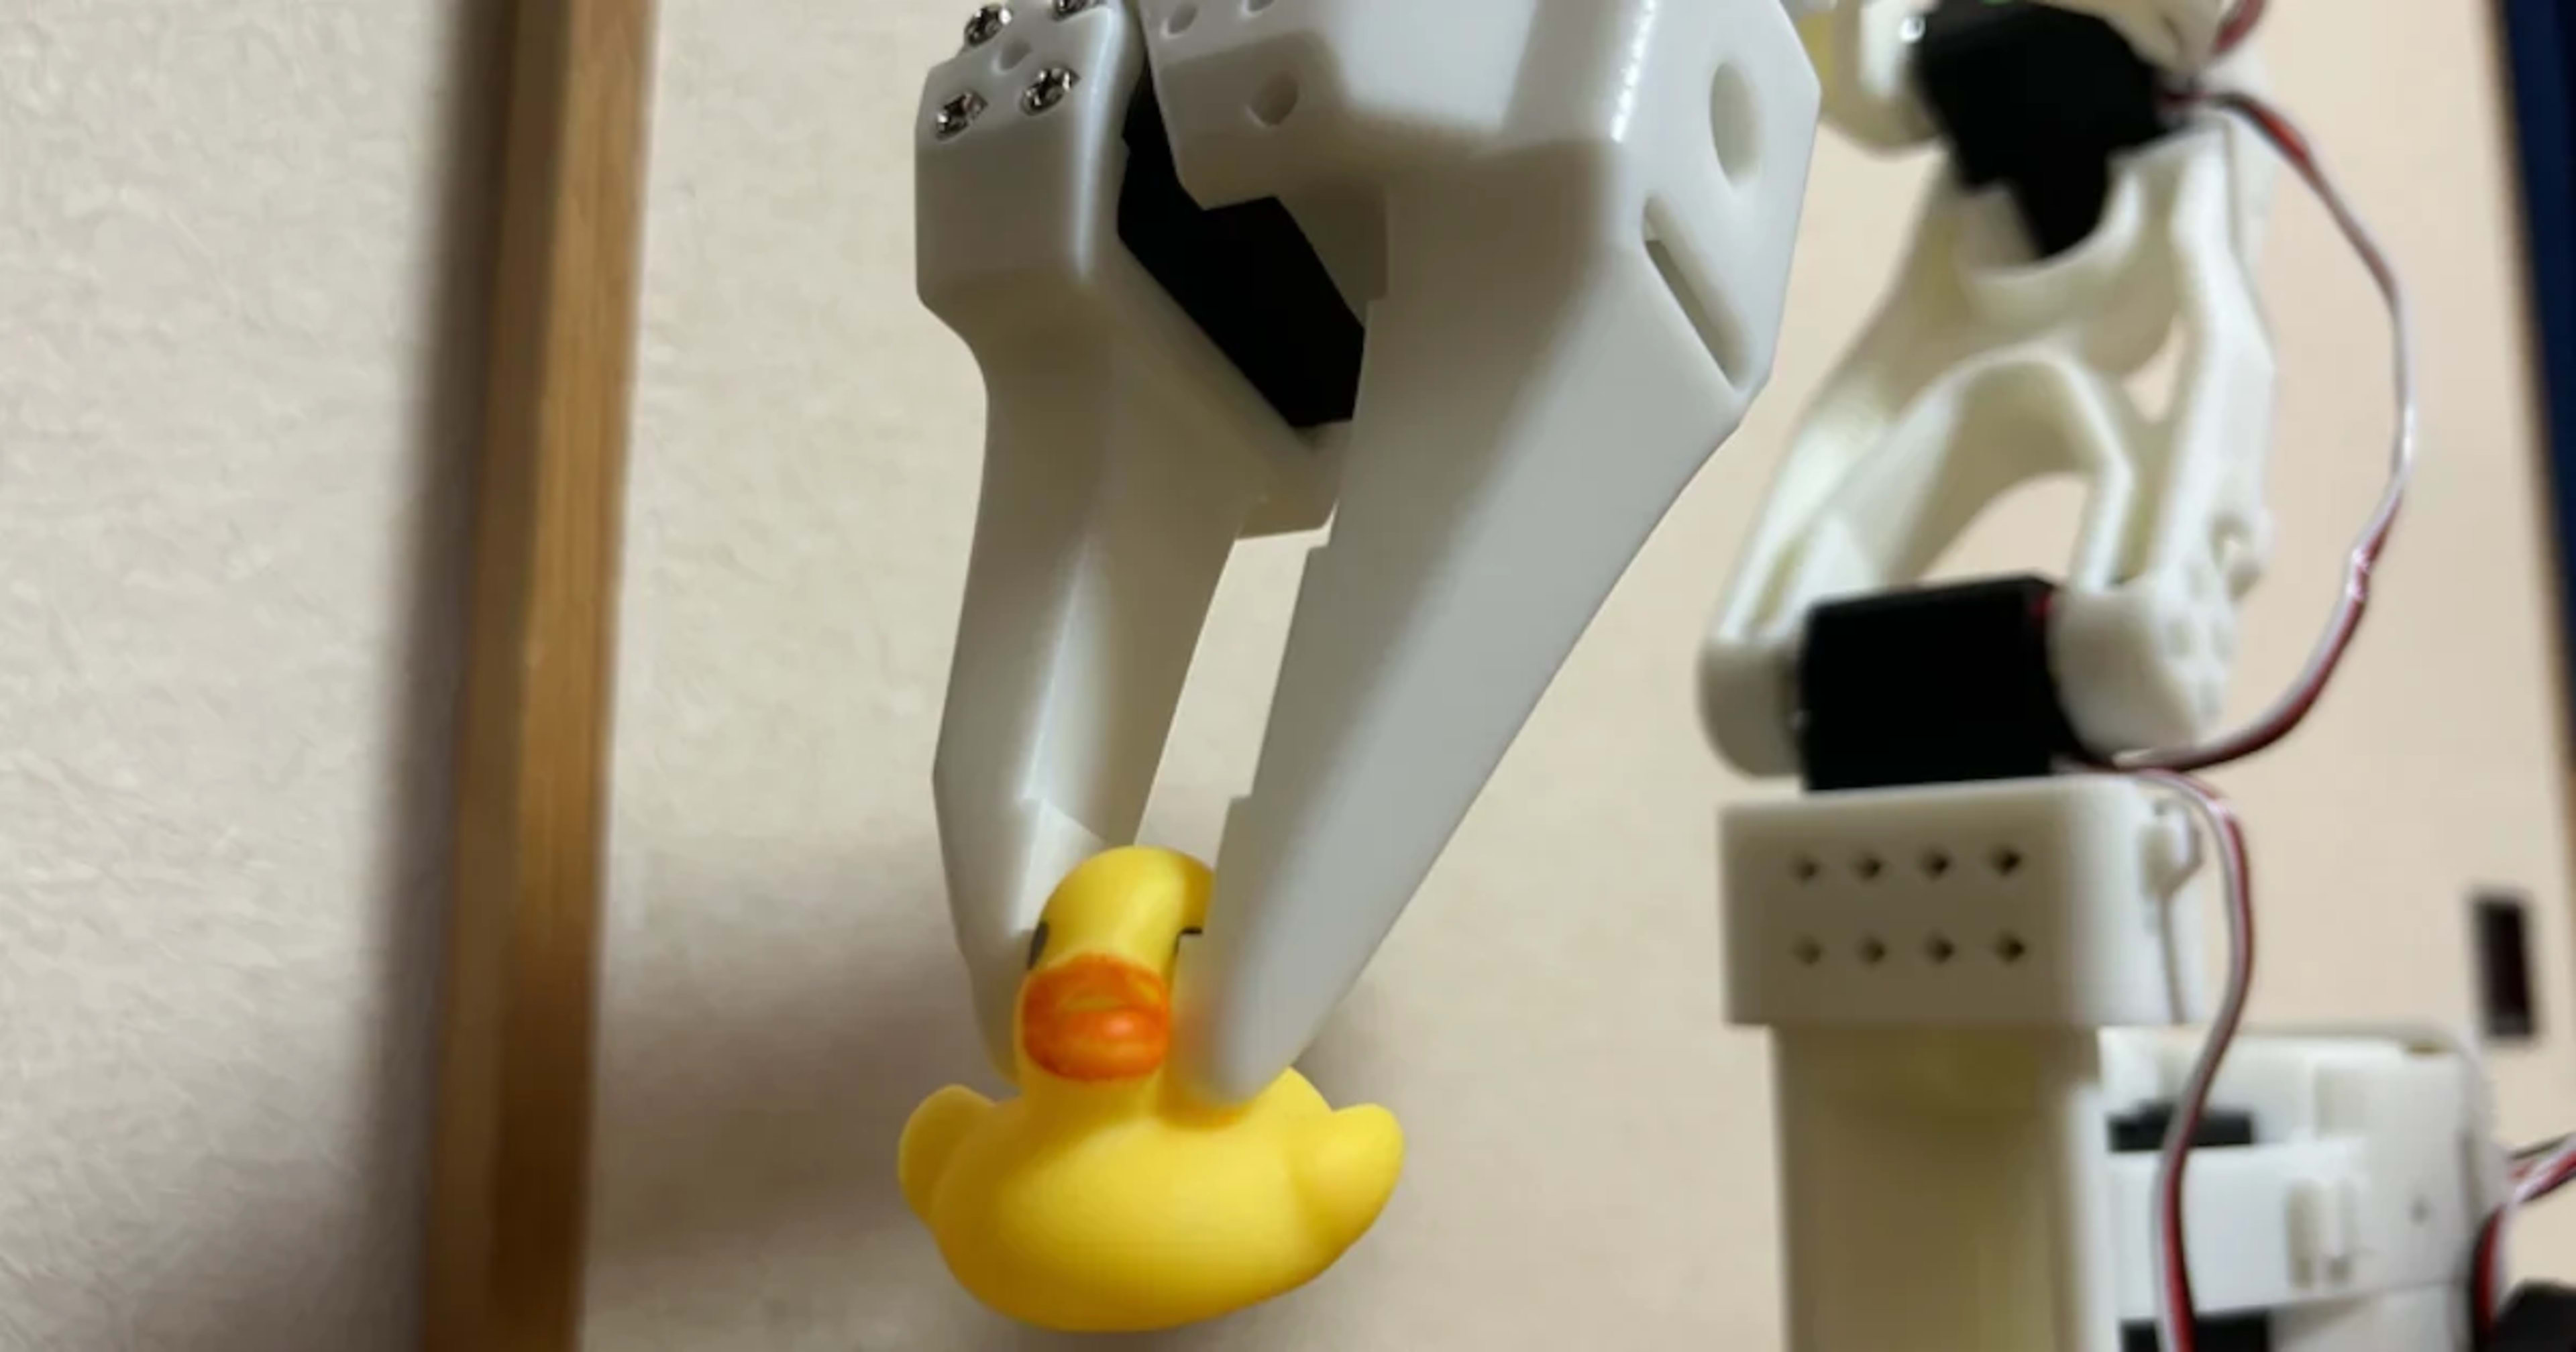
以下は、v3.0 のデータセットで学習したモデルが実機で動いている様子です。
データセットの収録と学習そのものについては、以下の記事で紹介させていただいています。
2 対象データセットと全体像
(1) フォーマットバージョン
LeRobot Dataset には v2.1 と v3.0 があり、lerobot v0.4.0(2025-10-23)以降 v3.0 となっています。
ただし、推論環境の lerobot のバージョンに合わせる場合など、今でも v2.1 のデータセットを作ることがあります。今回の v2.1 のデータセットも、推論環境に合わせて収録したものです(8 章で説明します)。どちらの形式を手にしても読めるように、本記事では 2 つを並べて確認します。
| v3.0 | v2.1 | |
|---|---|---|
| データセット | duck_pickup_v1 | duck-pickplace-real-20260814 |
| 収録環境 | Mac(Apple Silicon M2) | Jetson Orin |
| 収録時期 | 2026 年 5 月 | 2026 年 8 月 |
| エピソード / フレーム | 30 / 6,977 | 50 / 9,995 |
| エピソード長(中央値) | 230 フレーム(15.4 秒) | 190 フレーム(12.7 秒) |
| カメラ | front の 1 台 | front / wrist の 2 台 |
| 言語指示 | Pick up the yellow duck and put it in the basket | Grab the duck and place it into the basket |
(2) 検証環境
収録側と解析側でバージョンが異なるため、分けて記載します。
| 区分 | 項目 | 値 |
|---|---|---|
| v3.0 収録側 | lerobot / ホスト | 0.5.1 / Mac(Apple Silicon M2) |
| v2.1 収録側 | lerobot / ホスト | 0.3.3 / Jetson Orin(L4T R36.4.4)、Python 3.10.12 |
| 解析側 | Python | 3.10.13 |
| 解析側 | pyarrow / PyAV / numpy | 24.0.0 / 14.4.0 / 2.2.6 |
解析は lerobot 本体を使用せず、pyarrow と PyAV で parquet と mp4 を直接読んでいます。
lerobot には LeRobotDataset という読み込み用のクラスがあり、通常はこれを使います。しかし、このクラスはファイルの実体を隠蔽してしまいます。インデックスを指定すると、parquet の該当行を読み、mp4 の該当フレームをデコードし、指示文を引いた結果が、1 つの辞書にまとまって返ってきます。画像も関節角も同じ辞書に入っているため、両者が別のファイルに置かれていることは、API 越しには見えません。
今回は、データの実体が主題なので、API を通さずにファイルを直接開くことにしました。ちなみに、v0.4.0 以降の lerobot は v2.1 をそのまま読み込むことはできません。
確認に使ったスクリプトは GitHub に、今回確認した 2 つのデータセットは Hugging Face Hub に置きました。
- スクリプト:furuya02/lerobot-dataset-anatomy
- v3.0 のデータセット:furuya02/so101-duck-pickup-v30
- v2.1 のデータセット:furuya02/so101-duck-pickplace-v21
(3) ディレクトリ階層
どちらも meta/ data/ videos/ の 3 つに分かれています。ただし、中身のファイル数が大きく違います。
v3.0 は 7 ファイルです。
duck_pickup_v1/
├── meta/
│   ├── info.json                        # 仕様一式(fps・features・パス規約)
│   ├── stats.json                       # データセット全体の統計
│   ├── tasks.parquet                    # 言語指示の文字列
│   └── episodes/chunk-000/file-000.parquet   # 各エピソードの境界と統計
├── data/chunk-000/
│   └── file-000.parquet                 # 6,977 行(30 エピソード分が 1 ファイル)
└── videos/observation.images.front/chunk-000/
    ├── file-000.mp4                     # 198 MB(ep 0〜22)
    └── file-001.mp4                     #  45 MB(ep 23〜29)
v2.1 は 154 ファイルです。
duck_pickplace_real_20260814/
├── meta/
│   ├── info.json                        # 仕様一式
│   ├── episodes.jsonl                   # 各エピソードの長さ
│   ├── episodes_stats.jsonl             # エピソードごとの統計
│   └── tasks.jsonl                      # 言語指示の文字列
├── data/chunk-000/
│   ├── episode_000000.parquet           # 1 エピソード = 1 ファイル
│   └── ...(50 ファイル)
└── videos/chunk-000/
    ├── observation.images.front/episode_000000.mp4 ...(50 ファイル)
    └── observation.images.wrist/episode_000000.mp4 ...(50 ファイル)
ファイルの実数と容量です。
| ディレクトリ | v3.0 | v2.1 |
|---|---|---|
| meta/ | 4 ファイル / 0.1 MB | 4 ファイル / 0.1 MB |
| data/ | 1 ファイル / 0.4 MB | 50 ファイル / 0.7 MB |
| videos/ | 2 ファイル / 243.3 MB | 100 ファイル / 182.1 MB |
| 合計 | 7 ファイル / 243.9 MB | 154 ファイル / 182.9 MB |
容量のほぼすべてが videos/ です(v3.0 は 99.8%、v2.1 は 99.6%)。関節角は、v3.0 の 6,977 フレーム分で 0.4 MB、v2.1 の 9,995 フレーム分で 0.7 MB しかありません。
(4) 1 フレームの構成
v3.0 を例に、構造を 1 枚にまとめると以下のようになります。
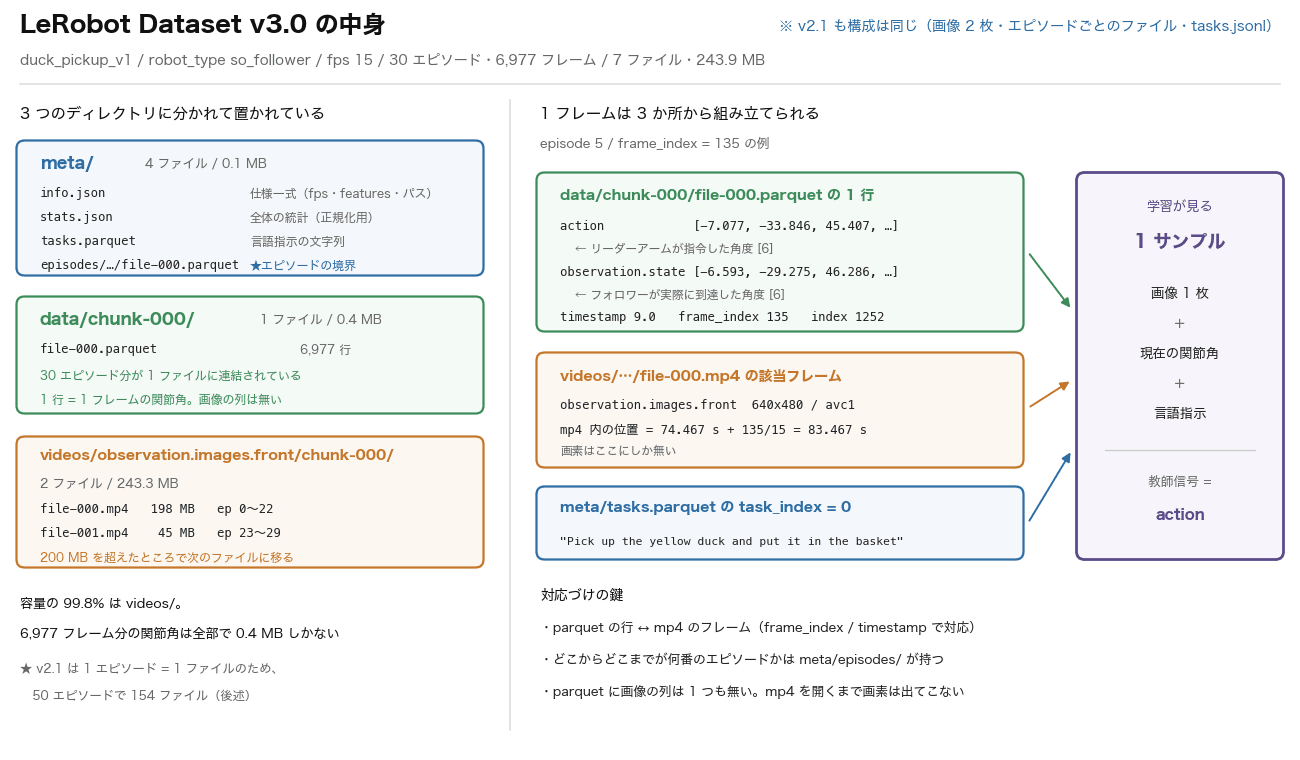
学習が 1 サンプルとして見るのは「画像 + そのときの関節角 + 言語指示」で、これが videos/ の mp4、data/ の parquet、meta/ の tasks ファイルの 3 か所に分かれて置かれています。1 か所にまとまったレコードは存在しません。v2.1 も考え方は同じで、カメラが 2 台なので画像が 2 枚になり、ファイルがエピソードごとに分かれている点だけが違います。
3 meta/info.json
(1) 主要なキー
info.json はデータセットの仕様書にあたるファイルです。主要な値を並べます。
| キー | v3.0 | v2.1 |
|---|---|---|
| codebase_version | v3.0 | v2.1 |
| robot_type | so_follower | so101_follower |
| total_episodes / total_frames | 30 / 6977 | 50 / 9995 |
| fps | 15 | 15 |
| chunks_size | 1000 | 1000 |
| data_files_size_in_mb | 100 | (キーなし) |
| video_files_size_in_mb | 200 | (キーなし) |
| total_videos / total_chunks | (キーなし) | 100 / 1 |
最初に見るべきは codebase_version と fps だと思います。codebase_version はフォーマットバージョンを表し、これが違うとファイルの置き方が変わります。fps は timestamp の刻み・動画のフレームレート・学習時の時間解像度のすべての基準になります。
data_files_size_in_mb と video_files_size_in_mb は v3.0 で増えたキーです。1 ファイルあたりの上限サイズで、これを超えると次のファイルに移ります。今回の v3.0 のデータセットでは、実際に動画が 198 MB と 45 MB の 2 ファイルに分かれていました。なお、この既定値はバージョンで変わっており、動画の上限は v0.4.0 では 500 MB、v0.6.1 では 200 MB でした。
chunks_size は同じ 1000 ですが、意味が違います。v2.1 では 1 チャンクあたりのエピソード数、v3.0 では 1 チャンクあたりのファイル数の上限です。
(2) features と実体の置き場所
features には、このデータセットが持つ特徴量が宣言されています。重要なのは、宣言はされているが実体は別ファイルにあるものが混ざっている点です。この部分は 2 つの形式で共通でした。
| 特徴量 | dtype | shape | 実体の置き場所 |
|---|---|---|---|
| action | float32 | [6] | data/*.parquet |
| observation.state | float32 | [6] | data/*.parquet |
| observation.images.front | video | [480, 640, 3] | videos/*.mp4 |
| observation.images.wrist(v2.1 のみ) | video | [480, 640, 3] | videos/*.mp4 |
| timestamp | float32 | [1] | data/*.parquet |
| frame_index | int64 | [1] | data/*.parquet |
| episode_index | int64 | [1] | data/*.parquet |
| index | int64 | [1] | data/*.parquet |
| task_index | int64 | [1] | data/*.parquet |
dtype が video のものだけが mp4 側です。timestamp / frame_index / episode_index / index / task_index の 5 つは lerobot が必ず付与する既定の特徴量です。
(3) パスのテンプレート
data_path と video_path はフォーマット文字列になっているので、パスはここから組み立てます。ここは 2 つの形式で置換するキーの名前が違うため、決め打ちにすると両対応できません。
| v3.0 | v2.1 | |
|---|---|---|
| data_path | data/chunk-{chunk_index:03d}/file-{file_index:03d}.parquet | data/chunk-{episode_chunk:03d}/episode_{episode_index:06d}.parquet |
| 変数の意味 | ファイル番号(エピソード番号ではない) | エピソード番号がそのままファイル名 |
Github scripts/anatomy.py
def video_keys(info):
    # dtype が video のものが mp4 側の特徴量
    return [k for k, v in info["features"].items() if v["dtype"] == "video"]
video_keys() のように「dtype が video のものを拾う」書き方にしておくと、カメラの台数に依存しません。今回も、カメラ 1 台の v3.0 と 2 台の v2.1 を同じコードで読めています。カメラ名は収録時のオプションで決まるため、front や wrist を決め打ちにしない方が安全です。
4 data/*.parquet
(1) 列の構成
最初に正直に書いておきますが、確認を始める前は、parquet の中に画像も一緒に入っていると考えていました。実際に開いてみると、列は以下の 7 つだけでした。2 つの形式で完全に同じです。
=== 列の構成 ===
column                   arrow type                           info.json の dtype
action                   fixed_size_list<element: float>[6]   float32
observation.state        fixed_size_list<element: float>[6]   float32
timestamp                float                                float32
frame_index              int64                                int64
episode_index            int64                                int64
index                    int64                                int64
task_index               int64                                int64

画像らしき列: なし ← 画像は mp4 に別置き
observation.images.front は列として存在しません。info.json の features には宣言されているのに、parquet 側には無いわけです。
この持ち方だからこそ、画像が mp4 に収まっています。試しに mp4 から 1 フレームを PNG で書き出すと 1 枚あたり 0.27〜0.40 MB(平均 0.33 MB)でしたので、全フレームを PNG で持つと、v3.0 で約 2.2 GB、カメラ 2 台の v2.1 で約 6.4 GB になる計算です。実際の mp4 はそれぞれ 243.3 MB と 182.1 MB でした。動画コーデックの圧縮が効くことが、この形式の前提になっていると思います。
(2) エピソードの境界
2 つの形式で一番違うのはここです。v2.1 では 1 エピソードが 1 ファイルで、episode_000005.parquet のようにファイル名を見ればエピソード番号が分かります。v3.0 では、複数のエピソードが 1 つのファイルに連結されています。
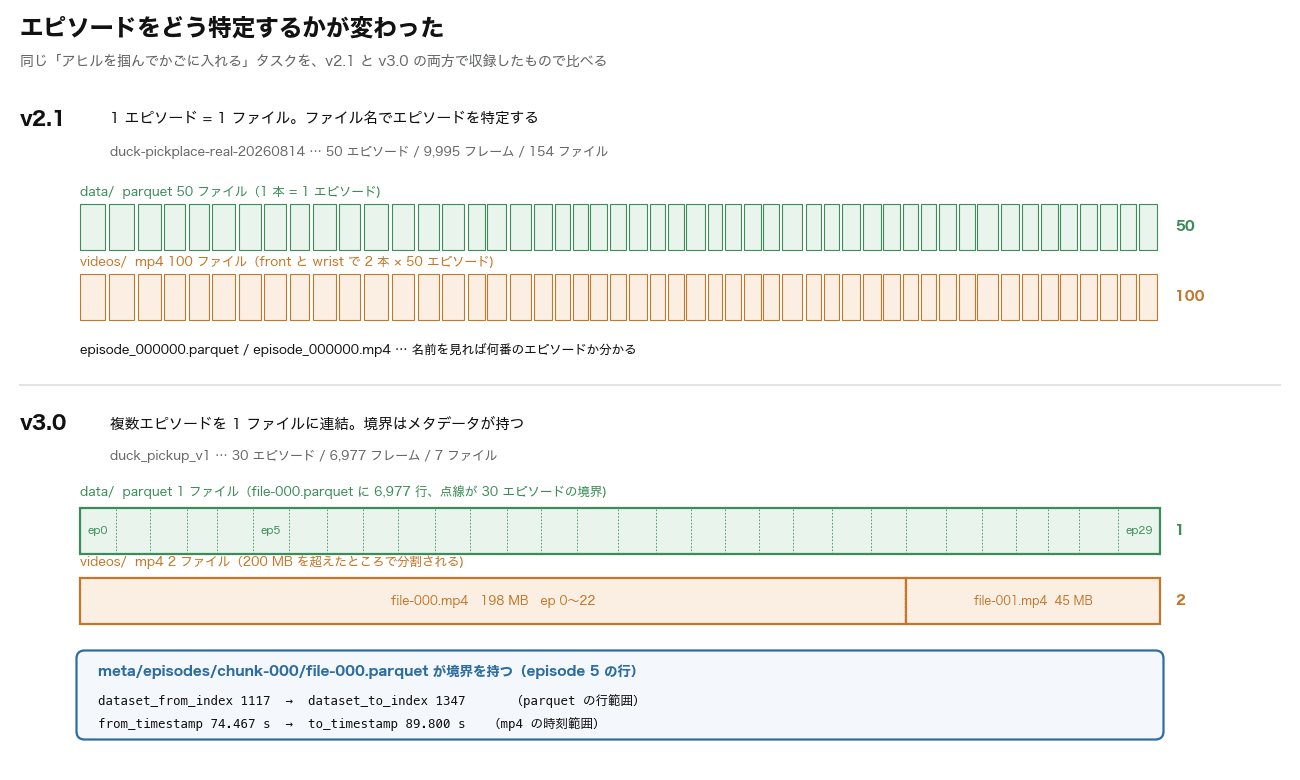
v3.0 の file-000.parquet は 6,977 行あり、その中に 30 エピソードが順に並んでいます。どこからどこまでが何番のエピソードかは、meta/episodes/ の parquet が持っています。
 ep  length    data file  from_index  to_index   video file   from_ts     to_ts
  0     235     file-000           0       235     file-000     0.000    15.667
  1     216     file-000         235       451     file-000    15.667    30.067
  2     241     file-000         451       692     file-000    30.067    46.133
 28     249     file-000        6456      6705     file-001    74.733    91.333
 29     272     file-000        6705      6977     file-001    91.333   109.467
エピソード 5 を読みたければ、dataset_from_index と dataset_to_index で行を切り出すか、episode_index 列で絞ります。動画側は from_timestamp から to_timestamp までが該当区間です。
なお、ep 28 と ep 29 は file-001.mp4 側にあり、タイムスタンプがファイルの先頭から振り直されています。動画ファイルをまたぐときは、ファイル番号も一緒に見る必要があります。
一方、v2.1 の meta/episodes.jsonl が持っているのは、エピソードごとの長さと指示文だけです。ファイル名がそのまま境界になっているので、境界の情報を別に持つ必要がありません。
{"episode_index": 0, "tasks": ["Grab the duck and place it into the basket"], "length": 270}
{"episode_index": 1, "tasks": ["Grab the duck and place it into the basket"], "length": 264}
v3.0 がこの形になっているのは、公式ドキュメントに "Fewer, larger files" と書かれているように、小さいファイルを大量に作らないためのようです。
(3) timestamp の刻み
timestamp は fps から計算されるので等間隔のはずですが、実測すると微妙にばらつきます。
fps=15 → 期待される間隔 0.066667 s
v3.0  実際の間隔 min=0.066667 max=0.066668
v2.1  実際の間隔 min=0.066666 max=0.066668
どちらも timestamp の dtype が float32 であるためです。値そのものは実用上まったく問題ありませんが、timestamp を厳密一致で検索すると外します。特定の時刻のフレームを引きたい場合は、frame_index を使うか、round(timestamp * fps) で整数に直してから比較するのが確実です。
(4) 行数の突き合わせ
parquet の行数を合計すると、どちらも info.json の total_frames と一致しました。
v3.0  parquet  1 ファイルの合計 6977 行  /  info.json total_frames = 6977  → 一致
v2.1  parquet 50 ファイルの合計 9995 行  /  info.json total_frames = 9995  → 一致
学習を回す前にここを見ておくと、途中で収録が切れていた場合に気づけそうです。
5 action と observation.state
(1) 指令と実測
action と observation.state は、次元も名前も同じ [6] ですが、意味が違います。これも 2 つの形式で共通です。
| 特徴量 | 中身 |
|---|---|
| action | リーダーアームが指令した角度。テレオペで人間が動かした側 |
| observation.state | フォロワーアームが実際に到達した角度。実機が動いた結果 |
模倣学習では、observation.state と画像を入力に、action を出力するように学習します。つまり action が教師信号です。この 2 つを取り違えると、学習の入出力を誤解することになります。
単位はどちらも度です。v2.1 側は収録時に --robot.use_degrees=true を指定しており、v3.0 側は指定していませんが、lerobot 0.5.1 の SOFollowerConfig は use_degrees の既定が True でした。
(2) 差の 2 つの意味
グリッパーの開き(gripper.pos)について、v3.0 のエピソード 1 本分の推移です。
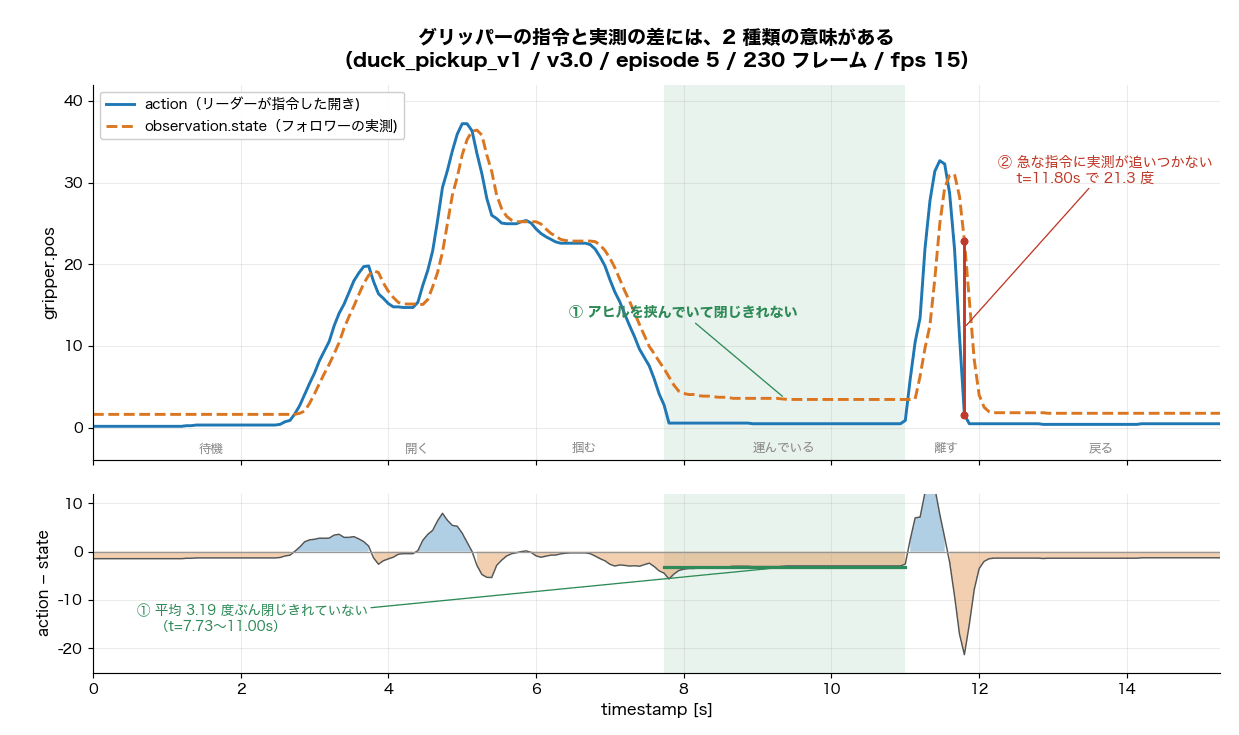
差が大きくなる箇所は 2 つありますが、意味が違います。
① アヒルを挟んでいて閉じきれない(t=7.73〜11.00s)
閉じる指令(action はほぼ 0)が 3 秒以上続いているのに、実測は平均 3.19 度だけ開いたままです。これはアヒルを掴んでいて、物の厚みのぶん閉じきれていない状態と考えられます。力覚センサーを持たないアームでも、物を掴んでいることが指令と実測の差として記録されています。
② 急な指令に実測が追いつかない(t=11.80s で 21.3 度)
差の絶対値が最大になるのはこちらですが、これはアヒルを離した直後、急に閉じる指令に実測が追従している途中です。前後を見ると分かります。
t=11.60s  action=28.7  state=30.9     ← 開いている
t=11.67s  action=21.9  state=31.0     ← 閉じる指令が出る
t=11.73s  action=11.3  state=28.3
t=11.80s  action= 1.6  state=22.9     ← 差が最大(21.3 度)
t=11.87s  action= 0.5  state=15.5
t=12.00s  action= 0.5  state= 4.0     ← 追いついた
単なる追従遅れであって、物を掴んでいることとは関係ありません。実は当初、この最大差の瞬間を「アヒルを掴んで閉じきれていない瞬間」と解釈していたのですが、前後の値を並べてみて誤りに気づきました。物を掴んだ証拠になるのは、差が大きい瞬間ではなく、一定値で張り付いている区間の方でした。
同じ処理を v2.1 のデータセットにも当てると、ほぼ同じ結果になりました。機体も収録環境も違いますが、2 種類の差がどちらにも現れています。
| v3.0(episode 5) | v2.1(episode 0) | |
|---|---|---|
| ① 把持中の差 | t=7.73〜11.00s、平均 3.19 度 | t=7.47〜10.60s、平均 3.31 度 |
| ② 最大差(追従遅れ) | t=11.80s、21.3 度 | t=11.67s、21.9 度 |
(3) 追従の遅れ
指令に対して実機が追従する以上、observation.state は action より遅れるはずです。action を k フレームずらして平均絶対差を取ってみました。
Github scripts/anatomy.py
a = np.stack(df["action"].to_numpy())             # [T, 6] リーダーが指令した角度
s = np.stack(df["observation.state"].to_numpy())  # [T, 6] フォロワーが実際に到達した角度

for k in range(0, 5):
    err = np.abs(a[:len(a)-k] - s[k:]).mean()
    print(f"  {k} フレーム遅らせる → 平均絶対差 {err:.3f}")
結果は以下のとおりです。
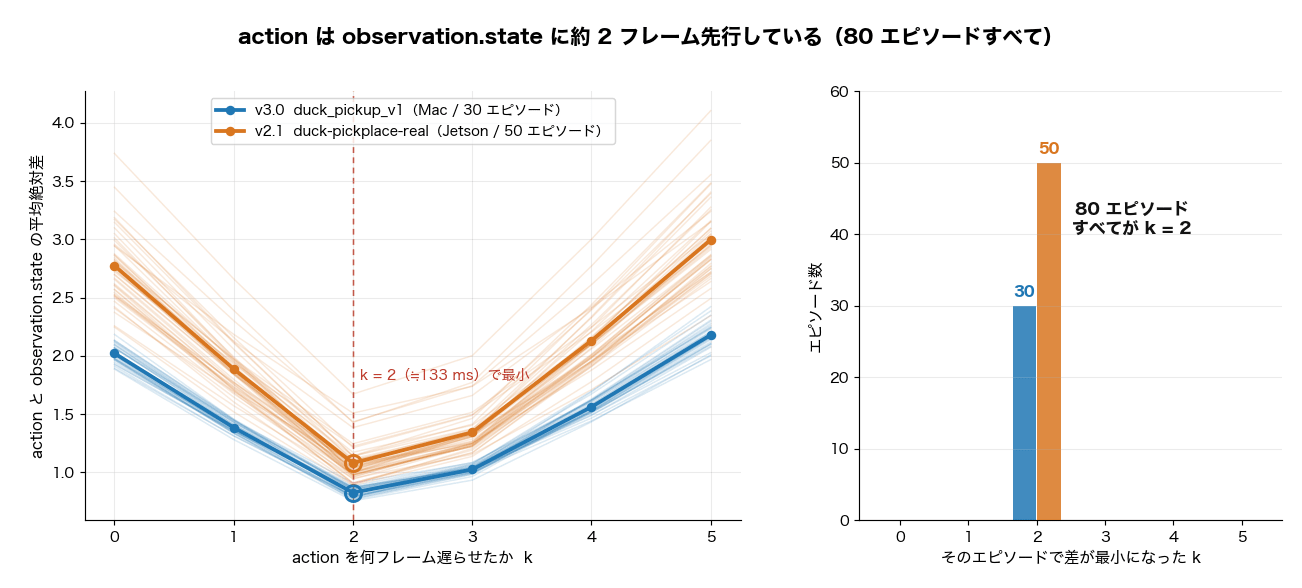
v3.0 の 30 エピソードと v2.1 の 50 エピソード、合計 80 本すべてで、k = 2 のときに差が最小になりました。fps 15 なので約 133 ms です。1 本のエピソードをたまたま見た結果ではなく、機体も収録時期も違う 2 つのデータセットで同じ値が出ています。
この遅れは、収録時のテレオペの追従性がそのまま記録されたものです。遅れごと学習されると考えられるため、サーボの電源不足や、収録ループの周期の乱れなどで追従が悪くなった状態で収録したデータは、その特性を含んだ教師データになりそうです。
6 videos/*.mp4
(1) フレームの対応
parquet の行と mp4 のフレームは、同じ番号で対応します。以下は v3.0 の例です。
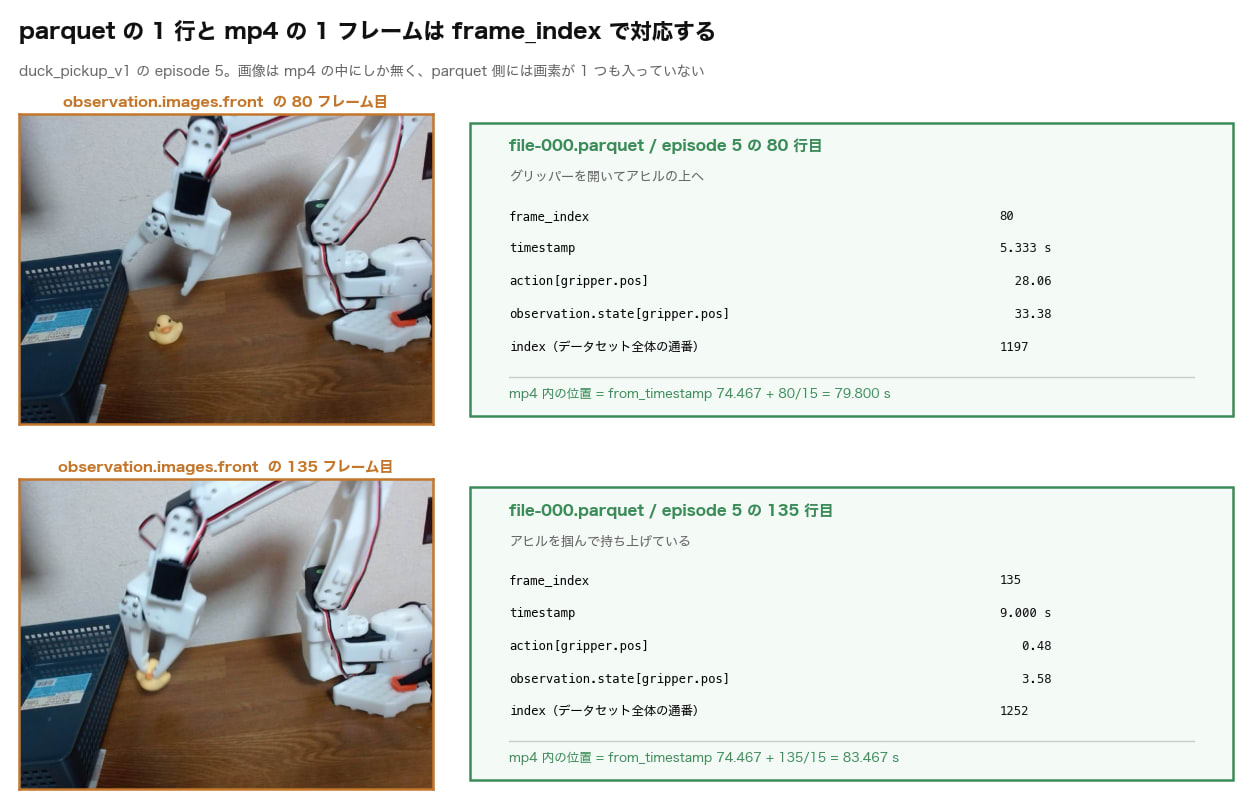
v2.1 は mp4 がエピソードごとに分かれているので、parquet の n 行目がそのまま mp4 の n フレーム目です。v3.0 は動画にも複数エピソードが連結されているので、mp4 の中での位置は、エピソードの from_timestamp に frame_index / fps を足して求めます。
v3.0 mp4 内の位置 = from_timestamp 74.467 + 135/15 = 83.467 s
対応がとれているかは、行数とフレーム数を突き合わせれば確認できます。
v2.1  この mp4 は episode 0 専用
      parquet 270 行 / mp4 270 フレーム → 一致

v3.0  この mp4 には複数エピソードが連結されている
      episode 29 の区間  91.333 s 〜 109.467 s  = 272 フレーム相当
      parquet 272 行 / 区間 272 フレーム → 一致(mp4 全体は 1642 フレーム)
ここがズレているデータセットは、学習時に画像と関節角が食い違うことになります。
(2) コーデック
info.json に書かれている値と、mp4 の実体を並べたものです。2 つのデータセットで結果が違いました。
| 項目 | v3.0(Mac) | v2.1(Jetson) |
|---|---|---|
| info.json の video.codec | h264 | av1 |
| mp4 の codec_tag(実体) | avc1 | av01 |
| PyAV の codec_context.name | h264 | libdav1d |
| 収録時の指定 | --dataset.vcodec=h264_videotoolbox | 指定なし |
Mac 側は h264_videotoolbox を明示指定していました。Apple Silicon のハードウェアエンコーダを使うための指定です。一方 Jetson 側は無指定だったため、lerobot の既定である libsvtav1 が使われて AV1 になりました。
コーデックは形式ではなく、収録時の指定で決まります。info.json に書かれている値と mp4 の実体を、その都度確認するのが確実です。
(3) PyAV の codec_context.name
1 点、読み違えやすい箇所があります。PyAV の codec_context.name は「選ばれたデコーダの名前」を返します。v2.1 の AV1 の mp4 を開くと libdav1d と出るため、info.json の av1 と一致せず、info.json と実際のファイルが食い違っているように見えてしまいます。
ファイルに書かれているコーデックの実体は codec_tag の方で、こちらは av01 でした。突き合わせに使うのは codec_tag です。
with av.open(str(path)) as c:
    v = c.streams.video[0]
    # codec_context.name はデコーダ名(AV1 なら libdav1d)。
    # ファイルに書かれているコーデックは codec_tag(av01 / avc1)で見る。
    print(v.codec_context.codec_tag, v.codec_context.name)
なお、キーフレームの間隔も実際の mp4 で確認しました。どちらのデータセットも 2 フレームに 1 回キーフレームが入っており、v2.1 の episode 0 は 270 フレーム中 135 フレーム、v3.0 の file-000.mp4 は 5,373 フレーム中 2,691 フレームがキーフレームでした。v2.1 の収録に使った lerobot 0.3.3 のソースでも、動画書き出しの既定値は libsvtav1 / yuv420p / g=2 / crf=30 になっています(video_utils.py)。
7 meta/ のその他のファイル
(1) 統計
meta/ には、各特徴量の最小値・最大値・平均・標準偏差といった値が入っていますが、これは、学習時に、正規化するために使われていると思われます。
| v3.0 | v2.1 | |
|---|---|---|
| データセット全体の統計 | meta/stats.json | なし |
| エピソードごとの統計 | meta/episodes/*.parquet | meta/episodes_stats.jsonl |
また、v3.0 の統計には、最小値・最大値などに加えて分位数(値を小さい順に並べたときの 1%・10%・50%・90%・99% の位置の値)も入っていました。たとえば gripper.pos の中央値(50% の位置の値)は 0.29 で、エピソードの大半でグリッパーが閉じていることが、統計からも読み取れます。
(2) 言語指示
言語指示は、v3.0 は meta/tasks.parquet、v2.1 は meta/tasks.jsonl に入っています。どちらも、指示文とそれに振った番号(task_index)の対応表で、今回は 1 行だけでした。
v3.0  tasks.parquet
                                                  task_index
task
Pick up the yellow duck and put it in the basket           0

v2.1  tasks.jsonl
{"task_index": 0, "task": "Grab the duck and place it into the basket"}
v3.0 の出力は見出しが 2 段に見えますが、指示文が行の見出し、番号が値の列として保存されているためで、中身は「この指示文の番号は 0」という 1 行です。
フレーム側は task_index を持つだけで、文字列そのものは持ちません。v3.0 の 6,977 フレーム、v2.1 の 9,995 フレームのすべてが task_index: 0 で、この 1 行を参照しています。
指示文は収録時に --dataset.single_task で与えた文字列がそのまま入ります。推論時に与える指示文が 1 文字でも違うと、学習時と同じ条件にならないので、注意が必要です。
8 v2.1 と v3.0 の違いと移行
(1) lerobot 0.3.3 を使った理由
2 つのデータセットの収録環境は、以下のとおりです。
| v3.0 の duck_pickup_v1 | v2.1 の duck-pickplace-real | |
|---|---|---|
| 収録時期 | 2026 年 5 月 | 2026 年 8 月 |
| 収録環境 | Mac(Apple Silicon M2) | Jetson Orin |
| lerobot | 通常どおりインストールした版(0.5.1) | ==0.3.3 を明示指定 |
Jetson 側では、lerobot のバージョンを 0.3.3 に指定していました。
pip install --no-deps -c constraints.txt "lerobot[smolvla,feetech]==0.3.3"
0.3.3 を指定したのは、推論環境で使っている lerobot のバージョンに合わせるためです。v0.4.0 以降に上げると v2.1 形式のデータセットを読み込めなくなるので、0.3.3 に留めていました。そのため、収録したデータセットも v2.1 形式になっています。
(2) v3.0 への変換
v0.4.0 以降で v2.1 のデータセットを読むと、BackwardCompatibilityError となり、変換コマンドを案内して停止します。自動変換はされません。
python -m lerobot.scripts.convert_dataset_v21_to_v30 --repo-id=<repo_id>
変換で何が起きるかは、公式ドキュメントの Migrate v2.1 → v3.0 に整理されています。エピソードごとの parquet と mp4 をそれぞれ集約し、meta/episodes/ に各エピソードの長さとオフセットを書き直す、という内容です。本記事で見てきた「ファイル名で特定する形」から「メタデータで特定する形」への移行がここで行われます。
(3) v2.1 と v3.0 の比較
2 つを並べてみると、変わったのは置き方で、持っているものは同じでした。
| 違い | |
|---|---|
| 画像が parquet に入らず mp4 に別置き | 同じ |
| action(指令)と observation.state(実測)の意味 | 同じ |
| 言語指示は別ファイルに文字列、フレーム側は task_index 参照 | 同じ(jsonl → parquet) |
| エピソードの特定方法 | 違う(ファイル名 → メタデータ) |
| ファイル数 | 違う(1 エピソード 1 ファイル → 連結) |
| 全体の統計と分位数 | v3.0 で増えた(stats.json・分位数) |
どちらの形式を手にしても、読み方の基本は共通です。
9 最後に
今回は、v3.0 と v2.1 で収録した 2 つのデータセットで、その内容を確認してみました。
分かったことをまとめると以下になります。
- 画像は、parquet には入らず、mp4 として別に持つ(frame_index と timestamp で対応づけている)。
- action は observation.state より約 2 フレーム(133 ms)先行していた。
- action と observation.state により、状態が分かる(一定値で張り付いている区間:物を掴んでいる、急に大きくなる瞬間:単なる追従遅れ)。
- 2 つの形式で違うのは、エピソードの特定方法だった(v2.1 はファイル名、v3.0 は meta/episodes/ のメタデータ)。
学習を回す前に meta/info.json を読み、parquet の行数と mp4 のフレーム数を突き合わせておくだけでも、後から原因を追いにくい問題はかなり減らせると感じました。特に codebase_version と fps は、そのデータセットをどう読むかを決める値なので、最初に確認しておく価値があると思います。
本稿は、カメラ 1〜2 台・単一タスクという構成での一例です。カメラ台数やタスク数が変わる点にご注意ください。また、本記事で見ているのは「ファイルに何が書かれているか」であって、「学習時にモデルへ何が渡されるか」ではありません。正規化や時間窓の切り出しは LeRobotDataset 側の処理なので、今回の確認によって解析できるものではないことにご注意ください。