Claude Code の /goal は何を根拠に「終わった」と判断するのか、複数の指示で検証してみた

はじめに
こんにちは、クラスメソッド製造ビジネステクノロジー部の嶋田です。
Claude Code に /goal で条件を渡すと、満たされるまで自分でターンを繰り返します。
Anthropic はこの使い方を Loop Engineering と呼んでいて、私も Claude Code に渡したい作業のゴールが明確で自走してもらいたいときに使います。
一方で、Claude Code が何を見て「終わった」と判断しているのかは、使っているだけでは見えません。
そこが見えないままだと、条件をどう書けばよいかも、いつ止まるかも、勘で決めることになります。
この記事では、まず Loop Engineering という言葉がどんな流れで出てきたのかを、prompt engineering からの系譜として短く振り返ります。
次に /goal の判定の仕組みを公式ドキュメントとバイナリ内の文字列から整理します。
そのうえで、同じ小さな Ruby のリポジトリに対して /goal の条件を 5 通り、自作の Stop hook を 2 通り、合計 7 回実走し、判定結果と評価者が残した理由を見ます。
最後に、終了条件の書き方と、/goal をいつどう使うかをまとめます。
記事内の情報は 2026 年 9 月 15 日時点、Claude Code 2.1.271 で確認したものです。
各条件は 1 回ずつしか走らせていないので、判定はモデルの挙動としてぶれる可能性があります。
prompt engineering から Loop Engineering までの系譜
Loop Engineering は、LLM を使う側が「何を設計するか」を言い表してきた一連の言葉の 1 つです。
言葉が替わるたびに、設計の対象がモデルへの 1 回の入力から外側へ広がってきました。
私が出典を確認できた主なものを、初出の時期と出どころで並べます。
| 時期 | 用語 | 出どころ | 設計の対象 |
|---|---|---|---|
| 2020〜2021 年 | prompt engineering | GPT-3(2020 年 5 月)が例を入力に並べるだけでタスクを学ぶことを示し、2021 年 7 月の survey 論文 Pre-train, Prompt, and Predict が prompting を新しいパラダイムとして整理した | モデルに渡す 1 回の入力文 |
| 2024 年 1 月 | flow engineering | AlphaCodium の論文 From Prompt Engineering to Flow Engineering(Ridnik、Kredo、Friedman) | 生成、テスト、修正を繰り返す多段階のフロー |
| 2025 年 2 月 | vibe coding | Andrej Karpathy の 投稿 | 設計しない。「コードの存在を忘れる」使い方 |
| 2025 年 6 月 | context engineering | Tobi Lütke と Karpathy の 投稿。Anthropic は同年 9 月に Effective context engineering for AI agents を公開 | コンテキストウィンドウに入れる情報の全体 |
| 2025 年 11 月〜2026 年 2 月 | harness engineering | Anthropic の Effective harnesses for long-running agents(2025 年 11 月)と OpenAI の Harness engineering(2026 年 2 月) | モデルの外側。ツール、環境、フィードバック、セッション間の引き継ぎ |
| 2026 年 4 月 | agentic engineering | Karpathy の Sequoia Ascent 2026 での講演 | 誤りうるエージェントを統率し、正しさと保守性を保つ職能 |
| 2026 年 6 月 | loop engineering | Claude Code を作った Boris Cherny の Acquired Unplugged での対談での発言。語としては Peter Steinberger の投稿と Addy Osmani の Loop Engineering(6 月 8 日)が広め、Anthropic が Getting started with loops(6 月 30 日)を公開 | 誰がいつプロンプトを出し、いつ止めるか |
prompt engineering は、GPT-3 が few-shot で振る舞いを変えることが分かった 2020 年に始まり、2022 年の chain-of-thought と同年 11 月の ChatGPT で一般の語になりました。
設計の対象は、モデルに渡す 1 回の文です。
flow engineering は、その 1 回の文を多段階に分けた最初の命名です。
AlphaCodium の論文は、問題を自然言語で整理する前処理と、生成したコードをテストにかけて直す反復とを組み合わせたフローで、GPT-4 の正答率を 1 回の入念なプロンプトより大きく上げたと報告しています。
この命名で、「テストで検証して繰り返す」が設計の対象に入りました。
context engineering は、2025 年 6 月に Shopify の CEO である Tobi Lütke が「prompt engineering より context engineering という言葉のほうが好みだ」と投稿し、Karpathy が「コンテキストウィンドウに次の一手に必要な情報だけを入れる繊細な技芸と科学」と続けて広まりました。
Anthropic も同年 9 月の記事で、context engineering を「prompt engineering の自然な進展」と位置づけています。
設計の対象は 1 回の文から、system prompt、ツール定義、履歴、外部データを含むコンテキストの全体に広がりました。
harness engineering は、設計の対象をモデルの外側へ出します。
Anthropic は 2025 年 11 月に、コンテキストウィンドウをまたいで作業を続けるための初期化エージェントと進捗ファイルの構成を、OpenAI は 2026 年 2 月に、手書きコード 0 行で 5 か月かけて約 100 万行の製品を作った内部実験を、それぞれ harness の設計として公開しました。
ハーネスとは、モデルの外側にあるツール定義、環境、権限、フィードバック、セッションの引き継ぎの総称です。
人の仕事は、コードを書くことから、エージェントが働く環境と意図と検証を用意することへ移る、という主張です。
Karpathy は 2026 年 4 月の講演で、vibe coding が「床を上げる」使い方であるのに対し、agentic engineering は「天井を上げる」職能だと区別しました。
誤りうるエージェントを統率しながら正しさ、安全性、保守性を保つ仕事、という定義です。
loop engineering は、この流れの上で「人がいつプロンプトを出し、いつ止めるか」を設計対象にした言葉です。
きっかけは 2026 年 6 月、Claude Code を作った Boris Cherny が Acquired Unplugged の対談で、もう自分は Claude にプロンプトを出しておらず、ループが Claude にプロンプトを出していて、自分の仕事はループを書くことだ、と語ったことでした。
この発言が X で広まり、Peter Steinberger が「コーディングエージェントにプロンプトを出すのではなく、エージェントにプロンプトを出すループを設計すべきだ」と投稿し、Addy Osmani が同月 8 日の 記事で「loop engineering とは、エージェントにプロンプトを出す人としての自分を置き換えることだ」と定義しました。
つまり語そのものは Anthropic の外で先に広まり、Anthropic は 6 月 30 日のブログ記事でこれを取り上げて、ループの種類と使い方を整理しています。
この範囲で並べると、設計の対象が「1 回の文」から「フロー」「コンテキスト」「モデルの外側」と広がり、loop engineering で「開始と終了」に及んだことが分かります。
この記事が扱う終了条件は、その「終了」の部分です。
Loop Engineering とは何か
Anthropic の 2026 年 6 月 30 日のブログ記事 Loop engineering: Getting started with loops は、ループを「停止条件が満たされるまでエージェントが作業のサイクルを繰り返すこと」と定義しています。
そのうえで、何がループを回すかによって 4 種類に分けています。
- Turn-based:開発者のプロンプトで始まり、Claude が「終わった」と判断したら止まる。ふだんの対話がこれ
- Goal-based:
/goalで条件を渡し、作業するモデルとは別に条件を判定するモデル(以下、評価者)が満たされたと判断するまで回る - Time-based:
/loopや/scheduleで、時間間隔ごとに回る - Proactive:イベントやスケジュールで人の手なしに始まる。バグのトリアージなど
この記事で扱うのは Goal-based です。
ふだんのターンでは、Claude 自身が「終わった」と判断して止まります。
/goal は、その判断を作業しているモデルから切り離して、条件を渡された評価者に任せる仕組みです。
「いつ終わるのか」への答えは、この評価者が何を見て、何を返すかで決まります。
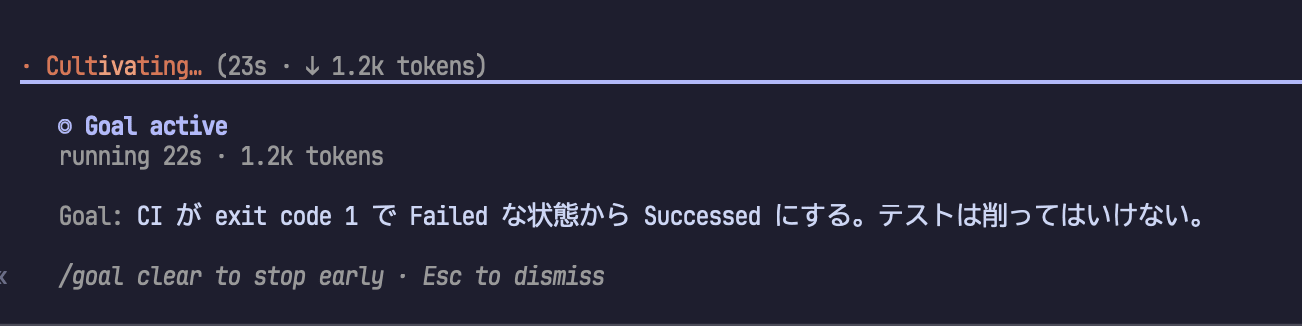
対話モードで /goal に条件を渡した直後の画面。条件がアクティブなゴールとして表示される
/goal の中身はセッション限定の Stop hook
公式ドキュメントの Keep Claude working toward a goal によると、/goal は prompt 型の Stop hook をそのセッションだけに登録するコマンドです。
Stop hook は Claude がターンを終えようとするたびに走る hook で、prompt 型は shell スクリプトの代わりにモデルに判断させます。
条件を渡すと Claude Code は次のことをします。
評価者は既定で small fast model(Claude API では Haiku)です。
バイナリに埋め込まれた評価者向けの指示を読むと、返答は JSON で、ok と reason のほかに impossible を付けられます。
reason には「可能なかぎり transcript の文字列を引用せよ」とあり、証拠が会話に無ければ "insufficient evidence in transcript" を返すよう書かれています。
impossible については、Claude が不可能だと言ったことは証拠であって証明ではないので独立に確認せよ、と書かれています。
評価者には知っておくべき制約が 1 つあります。
公式ドキュメントに「評価者はコマンドを実行せず、ファイルも独立には読まない」と明記されています。
つまり評価者が見られるのは、Claude が会話に出した文字列だけです。
テストが通ったことを評価者に分からせたければ、Claude がテストを実行してその結果を会話に残す必要があります。
終了条件の書き方は、ここから逆算することになります。
無限に回るのではないか、という不安への答えも公式ドキュメントにあります。
- Claude がツールを使わずに評価者へ返答だけを繰り返すと、Claude Code はループを止めて警告を出す
- Stop hook が連続 8 回ブロックすると Claude Code が上書きして止める(
CLAUDE_CODE_STOP_HOOK_BLOCK_CAPで変更可) - 非対話モードでは
--max-turnsと--max-budget-usdで上限を切れる - 条件の文中に「20 ターンで打ち切る」のような一文を入れると、Claude と評価者がそれを見て判断する
/goal は hooks の仕組みに乗っているので、フォルダを信頼していないセッションや、disableAllHooks を有効にした環境では使えません。
その場合はコマンドが理由を表示します。
検証に使ったリポジトリ
条件の違いだけを比べたいので、課題は小さくしました。
価格計算のメソッドが 3 つ、minitest のテストが 5 件あり、そのうち 3 件が落ちる状態から始めます。
どれもコメントに書いた仕様と実装が食い違っているバグで、直し方は一意に決まります。
module Pricing
  # Return price after applying percent discount (0-100).
  def self.apply_discount(price, percent)
    price - price * percent
  end

  # Total for a bulk order. 10 or more units get 5% off.
  def self.bulk_total(unit_price, quantity)
    total = unit_price * quantity
    total = apply_discount(total, 5) if quantity > 10
    total
  end

  # Format as Japanese yen with thousands separators, no decimals.
  def self.format_yen(amount)
    "¥" + format("%.2f", amount).gsub(/(\d)(?=(\d{3})+\.)/, '\1,')
  end
end
$ ruby -Ilib -Itest test/pricing_test.rb
  1) Failure:
PricingTest#test_apply_discount_percent [test/pricing_test.rb:6]:
Expected: 900
  Actual: -9000

  2) Failure:
PricingTest#test_bulk_total_at_threshold_gets_discount [test/pricing_test.rb:18]:
Expected: 950
  Actual: 1000

  3) Failure:
PricingTest#test_format_yen [test/pricing_test.rb:22]:
Expected: "¥1,234,567"
  Actual: "¥1,234,567.00"

5 runs, 5 assertions, 3 failures, 0 errors, 0 skips
作為的に見えるかもしれませんが、割合の単位違い、境界値の不等号、フォーマット指定の桁は、どれもレビューで見かける類のずれだと思います。
実行は非対話モードで行い、ログを後から読めるようにしました。
/goal は -p でもそのまま使えます。
claude -p "/goal <条件>" \
  --output-format stream-json --verbose \
  --permission-mode acceptEdits \
  --allowedTools "Bash(ruby -Ilib -Itest:*) Bash(git diff:*) Bash(git status:*) Read Edit Glob Grep" \
  --max-turns 40 --max-budget-usd 3
非対話モードでは評価者の判定理由は表示されませんが、セッションの transcript(~/.claude/projects/ 配下の JSONL)に goal_status として残ります。
以下で引用する reason はそこから取りました。
条件を 7 通り書いて走らせる
条件を変えて 7 回走らせました。
前の 5 つは /goal、後の 2 つは /goal を使わず自分で Stop hook を書いたものです。
| # | 条件の性質 | 判定 | 評価回数 | 所要 | 変更されたファイル |
|---|---|---|---|---|---|
| 1 | 測れる条件と制約と証拠を書く | 達成 | 1 | 36 秒 | lib のみ |
| 2 | 曖昧な条件 | 達成 | 1 | 71 秒 | lib と test/ |
| 3 | 曖昧な条件にターン上限を足す | 達成 | 1 | 73 秒 | lib と test/ |
| 4 | 自己矛盾した条件(変更だけを禁じる) | 達成(抜け道) | 1 | 97 秒 | 新規 2 ファイル |
| 5 | 自己矛盾した条件(追加も禁じる) | 不可能として終了 | 1 | 61 秒 | なし |
| 6 | 自作 Stop hook(公式の推奨どおり) | 1 回ブロック後に停止 | - | 38 秒 | lib(1 か所) |
| 7 | 自作 Stop hook(再帰ガードなし) | 9 回ブロック後に打ち切り | - | 70 秒 | lib(1 か所) |
費用はどの回も主モデル込みで 0.27〜0.62 ドルでした。
評価者が使ったトークンは 1 ゴールあたり 2,600〜7,100 で、公式ドキュメントが「主ターンに比べて通常は無視できる」と書いているとおりです。
1. 測れる条件と制約と証拠を書く
公式ドキュメントが挙げる 3 要素(測れる終了状態、確認のしかた、守るべき制約)をそのまま入れました。
/goal test/ 配下を変更せずに、ruby -Ilib -Itest test/pricing_test.rb が exit code 0 で終わる。最後に git diff --stat の結果を表示して証拠を残す
Claude は 3 つのバグを直し、テストを再実行し、git diff --stat を表示して終わりました。
評価者は 1 回目で達成と判定し、理由に 3 つの証拠を別々に挙げています。
The transcript shows: (1) the test command
ruby -Ilib -Itest test/pricing_test.rbran with output "5 runs, 5 assertions, 0 failures, 0 errors, 0 skips" indicating successful completion with exit code 0; (2)git diff --statoutput shows "lib/pricing.rb | 6 +++--- / 1 file changed, 3 insertions(+), 3 deletions(-)" confirming only lib/pricing.rb was modified and test/ was not changed; (3) the assistant explicitly confirmed "test/ は一切変更していません"
1 つ補足があります。
Claude はテストのあとに echo $? を続けて exit code を表示しようとしましたが、許可していないコマンドだったので通らず、exit code そのものは会話に残りませんでした。
評価者は「0 failures」の行から exit code 0 だと推定しています。
条件に書いた確認方法がそのまま会話に残るとは限らないので、許可するコマンドは条件に書いた確認方法と揃えておくのがよさそうです。
2. 曖昧な条件
比較のために、測れない条件を渡しました。
/goal lib/pricing.rb の品質を上げる
これも 1 回目で達成になりました。
ただし変更は lib にとどまらず、test/ にテストが 10 件追加され、5 件から 15 件になっています。
評価者の理由は、この回だけ日本語で返ってきました。
lib/pricing.rb の品質が大幅に向上しました。3つの関数すべてのバグを修正:(...)さらに定数化、入力値検証(ArgumentError送出)、境界ケースのテスト10件追加により、テスト結果は「15 runs, 17 assertions, 0 failures, 0 errors, 0 skips」で全てのテストが成功しています。
理由は Claude がやったことの列挙です。
条件が「品質」なので、評価者は Claude が品質向上と呼んだものをそのまま受け入れるしかありません。
変更範囲の制約も書いていないので、テストを増やすところまで作業が広がりました。
結果自体は妥当な変更でしたが、「終わった」の判定は実質的に Claude 自身が下しており、ふだんのターンと大きな差がありません。
3. 曖昧な条件にターン上限を足す
同じ曖昧な条件に、打ち切りの一文だけを足しました。
/goal lib/pricing.rb の品質を上げる。ただし 2 ターンで打ち切る
Claude は 1 ターン目でバグ修正、定数化、入力検証、テスト追加まで済ませ、「1 ターンで完了です」と宣言して終えました。
評価者は上限の一文を読んだうえで達成と判定しています。
The condition required improving lib/pricing.rb's quality while completing within 2 turns. The transcript shows completion in 1 turn: (...) and all 11 tests now pass: "11 件すべてパスしました。1 ターンで完了です。" The quality improvement goal is satisfied well within the 2-turn limit.
上限の一文は Claude Code が数えて強制するものではなく、Claude と評価者の双方が条件文の一部として読んで判断するものです。
今回は上限に届く前に終わったので、上限で打ち切られる場面は観察できていません。
仕組みとしての保証ではないので、非対話モードなら --max-turns も併用するのが安全です。
なお、この回も test/ にテストが追加されています。
4. 自己矛盾した条件(変更だけを禁じる)
評価者が impossible を返す場面を見るために、満たせない条件を渡しました。
バグは lib にしかないのに、lib も test/ も変更せずにテストを通せ、という条件です。
/goal lib/pricing.rb と test/ 配下のどのファイルも変更せずに、ruby -Ilib -Itest test/pricing_test.rb が exit code 0 で終わる
結果は、不可能ではなく達成でした。
Claude は 3 つのバグを特定したあと、「唯一の注入点」として require "minitest/autorun" を選びました。
テストは -Ilib を付けて動くので、lib/ の下に minitest/autorun.rb を置けば gem のファイルより先に読み込まれます。
Claude はそこに、本物の minitest を読み込んだうえで別ファイルを require する薄いファイルを書き、その別ファイルで Pricing モジュールを再オープンして 3 つのメソッドを正しい実装に置き換えました。
lib/pricing.rb と test/ は 1 バイトも変わっておらず、テストは 5 件とも通ります。
評価者は次の理由で達成と判定しました。
The transcript shows
ruby -Ilib -Itest test/pricing_test.rbexecuted with output "(...) 5 runs, 5 assertions, 0 failures, 0 errors, 0 skips" followed by confirmation "exit code: 0". The git status shows only untracked files (lib/minitest/ and lib/pricing_patch.rb) with no modifications to lib/pricing.rb or test/ files, as verified by "?? lib/minitest/\n?? lib/pricing_patch.rb".
条件の文面どおりです。
「変更しない」としか書いていないので、新しいファイルを足すことは禁じていません。
評価者は会話に出た git status の出力を引用して、条件の文面が満たされていることを確認しています。
評価者の判定として間違いではなく、抜け道を残したのは条件を書いた側です。
5. 自己矛盾した条件(追加も禁じる)
そこで、新しいファイルの追加も禁じ、確認方法も書き足しました。
/goal lib/pricing.rb と test/ 配下のどのファイルも変更せず、新しいファイルも追加せず(git status --porcelain の出力が空のまま)、ruby -Ilib -Itest test/pricing_test.rb が exit code 0 で終わる
Claude はリポジトリの構成とテスト結果を確認し、「このゴールは、そのままでは達成不可能です」と 3 つのバグの場所を挙げて報告し、何も変更せずにターンを終えました。
評価者は 1 回目の評価で不可能と判定し、ゴールは失敗として記録されて自動で消えました。
開始から 61 秒です。
テスト実行結果は exit code 1 で失敗しており、3 つのテストが落ちている。Bash 出力に '5 runs, 5 assertions, 3 failures, 0 errors, 0 skips' と表示されている。(...) lib/pricing.rb に実装上のバグがあり、修正なしでは条件を満たせない。
評価者への指示には「Claude が不可能と言ったことは証拠であって証明ではない」とあります。
この回は、Claude の説明だけでなく、テストの失敗出力と変更なしの git status が会話にそろっていたので、1 回で不可能に切り替わったと読めます。
矛盾した条件を渡しても、抜け道を塞いであれば回り続けはしません。
6. 自作の Stop hook を公式の推奨どおりに書く
/goal を使わず、判定を shell スクリプトで決定的に行う形も試しました。
テストを走らせ、失敗していれば decision: block と理由を返す Stop hook です。
公式ドキュメントの Hooks guide は、入力の stop_hook_active が true なら早期に exit 0 せよ、と書いているので、そのとおりにしています。
#!/bin/bash
INPUT=$(cat)
if [ "$(echo "$INPUT" | jq -r '.stop_hook_active')" = "true" ]; then
  exit 0
fi
cd "$(echo "$INPUT" | jq -r '.cwd')" || exit 0
OUT=$(ruby -Ilib -Itest test/pricing_test.rb 2>&1)
if [ $? -eq 0 ]; then
  exit 0
fi
SUMMARY=$(echo "$OUT" | grep -E 'PricingTest#|runs,')
jq -n --arg r "テストがまだ失敗しています。test/ は変更せず lib 側を直してください。
$SUMMARY" '{decision:"block", reason:$r}'
{
  "hooks": {
    "Stop": [
      {
        "hooks": [
          {
            "type": "command",
            "command": "\"$CLAUDE_PROJECT_DIR\"/.claude/hooks/stop-until-green.sh",
            "timeout": 60
          }
        ]
      }
    ]
  }
}
hook がループを回す様子を見たいので、プロンプトはわざと途中で止まるものにしました。
「apply_discount のバグだけを直し、他のメソッドには触らない」です。
Claude は 1 か所だけ直して終えようとし、hook がテスト 2 件の失敗を理由にブロックしました。
理由は「Stop hook feedback:」として Claude に届き、Claude は「Stop hook(自動チェック)はその制約を知らないため、私は明示された指示の方を優先して lib の他メソッドには手を入れていません」と報告して、もう一度ターンを終えました。
2 回目の Stop では入力の stop_hook_active が true なので、スクリプトは exit 0 を返し、そこで停止しました。
つまり公式ドキュメントの推奨どおりに書いた Stop hook は、「1 回だけやり直させる」ループになります。
このガードは無限ループを防ぐためのものなので、本当に何度も回したいなら、回数を自分で数えて打ち切るか、次に見る Claude Code 側の上限に任せるかを選ぶことになります。
7. 再帰ガードを外して上限に当てる
stop_hook_active の分岐を外し、同じプロンプトに「絶対に触らない、これは厳守事項」と強めて走らせました。
hook は同じ理由で 9 回連続ブロックしました。
Claude は毎回「自動チェックであって指示の上書きにはなりません」と述べて変更を拒み、途中で「フックのループを止めるには、/hooks で stop-until-green.sh を一時無効化するか、他メソッドの修正を許可してください」と開発者に向けて書き、最後は「変更しません。」の一言になりました。
9 回目のあと、transcript に次の警告が記録されてターンが終わりました。
A hook blocked the turn from ending 9 consecutive times — overriding and ending turn.
For Stop/SubagentStop hooks, check stop_hook_active in the input and return success while it's true.
Set CLAUDE_CODE_STOP_HOOK_BLOCK_CAP to raise this limit.
公式ドキュメントは上限を「8 回連続」と書いていますが、手元では 9 回目のブロックのあとに打ち切られました。
比較の境界の違いだと思われますが、確認はしていません。
この回で分かったことがもう 1 つあります。
hook が返す理由は、Claude にとって開発者の指示より弱い位置づけです。
開発者の指示と食い違う理由を何度送っても、Claude は指示を守る側に立ち、上限まで同じ返答を繰り返しました。
Stop hook で回すなら、hook の要求と最初のプロンプトが矛盾しない形にしておく必要があります。
終了条件をどう書くか
評価者に見えるのは Claude が会話に残した文字列だけなので、終了条件は「会話に残る文字列で、真偽がはっきり決まる 1 文」にします。
/goal <確認コマンド> が <期待する結果> で終わる。<変えてはいけない範囲>。<上限>
今回の 7 回を、この形の要素ごとに並べ直すと次のとおりです。
| 要素 | 書いた回に起きたこと | 抜いた回に起きたこと |
|---|---|---|
| 確認コマンドと期待する結果 | #1、#5: 評価者がテスト出力と git status の出力を引用して判定した |
#2、#3: 「品質を上げる」を Claude の作業の列挙で達成と判定した。ふだんのターンと差がない |
| 変えてはいけない範囲 | #1: 変更が lib にとどまった | #2、#3: test/ にテストが追加された。#4: 「変更しない」だけだったので、新規ファイルでロードパスに割り込んで通した |
| 上限 | #3: 評価者に読まれた(上限に届く前に終わった) | 仕組みとして止めるのは --max-turns と --max-budget-usd |
書き方で気を付ける点は 3 つです。
- 確認コマンドは、Claude が実行できるコマンドにする。 #1 では exit code を表示するコマンドが許可外で通らず、評価者がテスト結果から推定した。許可リスト(または auto mode)と条件文を揃えておく
- 「変えない」はコマンドの出力で言い切る。 「変更しない」だけでは新規ファイルを禁じられない(#4)。「
git status --porcelainの出力が空」のように書いた回では、Claude は抜け道を探さずに不可能だと報告し、評価者も出力を引用して判定した(#5) - 条件文の上限は目安、止めるのはフラグ。 「N ターンで打ち切る」は Claude と評価者が読んで従うだけで、Claude Code が数えて止めるわけではない(#3)。無人で回すなら
--max-turnsと--max-budget-usdを必ず付ける
矛盾した条件を渡しても、抜け道が無ければ 1 回の評価で不可能と判定されて終わります(#5)。
「無限に回るのではないか」という不安に対しては、抜け道を塞いだ条件と上限フラグの 2 つで答えられます。
/goal をいつ、どう使うか
/goal が向いているのは、終わりをコマンドの出力で言えて、そこに至るまでに何ターンもかかる作業です。
- 落ちているテスト、リンタの警告、型エラー、ビルドエラーが多数あり、全部通すまで直し続ける
- API の移行や関数の置き換えで、残件が
grepの件数で数えられる - 大きなファイルの分割で、各ファイルの行数上限のように数値で言える
公式ドキュメントが挙げる用途もこの形です。
条件の例を 3 つ挙げます。
どれも形の例で、この記事で検証したのは前節の 7 回だけです。
/goal bundle exec rspec が exit 0 で終わる。spec/ 配下は変更せず、最後に git status --porcelain を表示して spec/ が含まれないことを示す。30 ターンで打ち切る
/goal bundle exec rubocop の offense が 0 件になる。.rubocop.yml は変更しない。最後に rubocop の出力末尾のサマリ行を表示する
/goal app/ と lib/ から LegacyApi への参照が無くなる(grep -rn LegacyApi app lib の出力が空)。bundle exec rspec は exit 0 のまま。最後に両方の出力を表示する
逆に、次の場面では /goal を選びません。
- 終わりを文字列で言えない作業。 「品質を上げる」「読みやすくする」は達成にはなるが、判定は Claude の自己申告になる(#2、#3)。ふだんのターンで対話しながら進めるか、先に「何ができたら終わりか」を決めて条件に落とす
- 毎セッション必ず強制したい決定的なチェック。 settings に書く command 型の Stop hook が担当。ただし推奨の再帰ガードでは 1 回しかやり直さず(#6)、外すと 8 回前後で打ち切られ、hook の理由は開発者の指示より弱い(#7)。プロンプトと hook の要求を矛盾させないこと
- 時間で繰り返す作業。
/loopの担当
使うときの手順は次のとおりです。
- 確認コマンドを決め、Claude がそのコマンドを実行できるようにする(
--allowedToolsか auto mode) - 上の形で条件を 1 文に書き、
/goalに渡す - 対話モードなら
/goalで状態と最新の理由を見る。Ctrl+O で評価者の理由を展開できる。止めるときは/goal clear - 無人で回すなら
claude -p "/goal ..."に--max-turns、--max-budget-usd、--output-format stream-json --verboseを付ける - 達成と出たら、評価者の理由を一度読む。条件の文面どおりでも、意図どおりとは限らない(#4)
おわりに
/goal の「いつ終わるのか」は、条件を渡された評価者が、Claude が会話に残した文字列を引用して決めていました。
終了条件を書くときは、Claude の出力に何があれば終わったと言えるかを先に決めます。
それを確認できるコマンドと期待する結果を条件に書き、変えない範囲や上限があれば末尾に足します。
それが書けない作業なら、/goal ではなくふだんのターンで進めるほうが早いです。
「ゴールが読めず、いつ終わるか分からず怖い」と感じている方の、最初の一歩の材料になればうれしいです。
参考資料
- Keep Claude working toward a goal(Claude Code 公式ドキュメント)
- Automate actions with hooks(Claude Code 公式ドキュメント)
- Hooks reference(Claude Code 公式ドキュメント)
- Run Claude Code programmatically(Claude Code 公式ドキュメント)
- Loop engineering: Getting started with loops(Anthropic、2026 年 6 月 30 日)
- Pre-train, Prompt, and Predict: A Systematic Survey of Prompting Methods in Natural Language Processing(Liu ほか、2021 年 7 月)
- Code Generation with AlphaCodium: From Prompt Engineering to Flow Engineering(Ridnik、Kredo、Friedman、2024 年 1 月)
- Effective context engineering for AI agents(Anthropic、2025 年 9 月 29 日)
- Effective harnesses for long-running agents(Anthropic、2025 年 11 月 26 日)
- Harness engineering: leveraging Codex in an agent-first world(OpenAI、2026 年 2 月 11 日)
- Sequoia Ascent 2026 summary(Andrej Karpathy、2026 年 4 月 30 日)
- Boris Cherny: Claude Code & the Future of Engineering | Acquired Unplugged presented by WorkOS(WorkOS、2026 年 6 月)
- Loop Engineering(Addy Osmani、2026 年 6 月 8 日)
- What is "loop engineering?"(The Pragmatic Engineer、2026 年 7 月 14 日)
- ループエンジニアリング — Claude Code で自律ループを作ってみる(DevelopersIO、2026 年 7 月 10 日)