Snowflakeの外部テーブル・Task・Snowpipeの処理時間とコストを実測してみた

はじめに
データ事業本部のkasamaです。
S3のデータをSnowflakeで使う方法にはいくつかのパターンがあるので、今回はそれぞれの処理時間とコストを比較検証してみたいと思います。
前提
想定する使い方
この記事は、bronze/silver/gold構成のbronze層(生データの取り込み層)を想定しています。bronzeテーブルは、後続のdbtモデルが日次バッチで参照します。
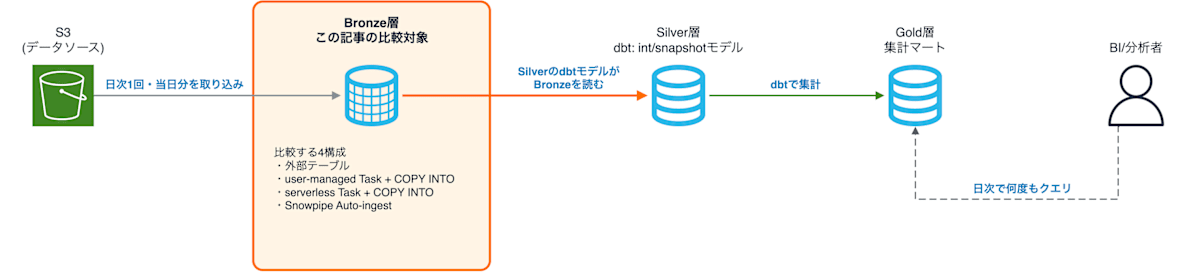
bronzeテーブルを1日に参照する回数は、後続のモデルの数とsourceに書いたテストの数の合計です。この記事では、参照回数が1回・5回・20回/日の場合の月額を計算します。
4つの構成
| 構成 | S3のデータの扱い | 取り込みの計算資源と課金 | 計測したテーブル |
|---|---|---|---|
| 外部テーブル | Snowflakeのテーブルにロードしない。参照のたびにS3のファイルを読む | なし | EXTERNAL_ORDERS_* |
| user-managed Task | TaskのCOPY INTOで、S3のファイルをSnowflakeのテーブルにロードする | 利用者が作成したWarehouse。起動するたびに最低60秒分を課金 | USER_MANAGED_ORDERS_* |
| serverless Task | TaskのCOPY INTOで、S3のファイルをSnowflakeのテーブルにロードする | Snowflakeが用意する計算資源。使った分だけ秒単位で課金 | SERVERLESS_ORDERS_* |
| Snowpipe | S3のイベント通知を受けて、Snowpipeが同じようにロードする | Snowflakeが用意する計算資源。取り込んだデータ量で課金 | SNOWPIPE_ORDERS_* |
2つのTaskは同じCOPY INTOを実行します。違いは課金のしかたで、serverless Taskには60秒の最低課金がありません。
実装
実装コードはGitHubに格納しています。
.
├── terraform/
│   ├── versions.tf
│   ├── providers.tf
│   ├── variables.tf
│   ├── s3.tf
│   ├── iam.tf
│   ├── database.tf
│   ├── stage.tf
│   ├── warehouse.tf
│   ├── table.tf
│   ├── task.tf
│   ├── pipe.tf
│   └── outputs.tf
├── scripts/
│   └── generate_data.py
└── sql/
    ├── 01_refresh_external.sql
    ├── 02_run_tasks.sql
    ├── 03_reset_snowpipe.sql
    ├── 04_reference.sql
    ├── 05_measure.sql
    └── check.sql
環境はTerraformで作り、Snowflakeの操作はすべてSQLファイルで行います。Pythonはテストデータの生成だけに使います。
Terraform
iam.tfでは、SnowflakeがS3を読むためのIAMロールを作ります。信頼ポリシーには、Storage Integrationのdescribe_outputから取得したIAMユーザーARNとExternal IDを設定します。権限はcost-bench/配下の読み取りだけです。Storage IntegrationはIAMロールのARNを使い、IAMロールはStorage Integrationの値を使うので、互いを参照します。そのため、Storage Integrationに渡すロールのARNは、variables.tfでアカウントIDとロール名から文字列で組み立てています。この方法で、AWSとSnowflakeのリソースを1回のapplyで作れます。
stage.tfでは、Storage Integration・CSVのファイル形式・外部ステージを作ります。ステージはIAMロールとポリシーができてから作るようにdepends_onを指定しています。
s3.tfでは、テストデータを置くS3バケットと、Snowpipe用のイベント通知を作ります。通知はcost-bench/snowpipe/<サイズ>/のプレフィックスごとに、そのサイズのPipeが持つSQSキューへ送ります。
warehouse.tfでは、Gen2 XSのWarehouseを4つ作ります。参照用の1つと、user-managed Task用のサイズごとの3つです。user-managed TaskのWarehouseをサイズごとに分けたのは、サイズごとの課金をWAREHOUSE_METERING_HISTORYで分けて取得するためです。
table.tfでは、外部テーブルと取り込み先のテーブルを作ります。外部テーブルは、CSVの1〜9列目(value:c1〜value:c9)を型変換して列にします。
refresh_on_create = falseにしたのは、作成時点ではS3にデータがなく、IAMロールの設定も反映されていない場合があるためです。ファイル一覧は、テストデータを置いたあとに01_refresh_external.sqlで読み込みます。
task.tfでは、user-managed Taskとserverless Taskを作ります。2つのTaskは同じCOPY INTOを実行し、違いは計算資源の指定だけです。user-managed TaskはwarehouseにWarehouseを指定し、serverless Taskは計算資源のサイズの範囲(XSMALL〜SMALL)を指定します。
COPY INTOにはFORCE = TRUEを付けています。COPY INTOは一度取り込んだファイルを読み飛ばすので、同じファイルで3回計測するために指定しました。Taskは02_run_tasks.sqlのEXECUTE TASKで手動実行します。
pipe.tfでは、AUTO_INGESTを有効にしたPipeをサイズごとに作ります。Pipeはsnowpipe/<サイズ>/配下に置かれたファイルを、SNOWPIPE_ORDERS_<サイズ>に取り込みます。
versions.tf・providers.tf・variables.tf・database.tf・outputs.tfは、プロバイダーの設定・変数・データベース・バケット名の出力だけなので解説を省略します。stateはローカルのterraform.tfstateに置きます。
Python
generate_data.pyは、9列のCSVを作ってS3に置きます。1ファイルが約200MBになるまで書いたらアップロードし、ローカルのファイルを消してから次のファイルを作ります。乱数のシードをサイズごとに固定しているので、何度実行しても同じデータになります。
SQL
01〜04のSQLファイルは、計測の手順ごとに分けています。02_run_tasks.sqlは取り込み先をTRUNCATEしてから、6つのTaskをEXECUTE TASKで実行します。04_reference.sqlは結果キャッシュを無効にしてから、12個のテーブルをCTASで読みます。
05_measure.sqlは、Snowflakeの履歴から結果の表を作ります。最初に、集計を始める時刻としてデータベースの作成時刻を変数BENCH_STARTに保存します。
Warehouseの課金履歴は1時間単位で、Warehouseを削除しても名前で残ります。そのため、同じ名前で作り直したWarehouseの過去の課金が混ざらないように、この時刻以降の履歴だけを集計します。
続けて、参照秒(REFERENCE_SEC)・Taskの取り込み秒(TASK_SEC)・Snowpipeの取り込み秒(SNOWPIPE_SEC)・取り込みCredits(INGEST_CREDITS)を一時テーブルに集計し、RESULTで構成とサイズごとに結合します。最後の2つのSELECTはRESULTから結果の表と月額の表を出すので、ファイル全体を同じセッションで実行します。
PIPE_USAGE_HISTORYは、引数のPIPE_NAMEを指定しないとPipe名が空で返ります。そのため、Snowpipeの課金はPipeごとに関数を呼んで取得しています。
デプロイ
以降のコマンドは71_snowflake_ingestion_cost_benchディレクトリで実行します。
1. 環境を作る
export AWS_PROFILE='<your-profile>'
export SNOWFLAKE_ORGANIZATION_NAME='<your-organization-name>'
export SNOWFLAKE_ACCOUNT_NAME='<your-account-name>'
export SNOWFLAKE_USER='<your-user>'
export SNOWFLAKE_AUTHENTICATOR='PROGRAMMATIC_ACCESS_TOKEN'
export SNOWFLAKE_TOKEN='<your-pat>'

terraform -chdir=terraform init
terraform -chdir=terraform apply
初回のapplyでは、IAMロールの設定が反映される前にPipeを作るため、Pipeの作成が失敗することがあります。その場合は30秒ほど待ってから、もう一度applyします。
2. テストデータを作る
AWS CloudShellにscripts/generate_data.pyをアップロードして実行します。CloudShellで実行すると、手元の回線を使わずにS3へアップロードできます。
python3 generate_data.py --bucket <bucket_name>
<bucket_name>はterraform -chdir=terraform output bucket_nameで確認できます。実行すると、次のように3サイズのCSVがs3://<bucket_name>/cost-bench/<サイズ>/に置かれます。
uploaded s3://<bucket_name>/cost-bench/10MB/orders_0000.csv (10,110,285 bytes)
10MB: 1 files, 10,110,285 bytes, 81,000 rows
uploaded s3://<bucket_name>/cost-bench/100MB/orders_0000.csv (100,029,855 bytes)
100MB: 1 files, 100,029,855 bytes, 795,000 rows
uploaded s3://<bucket_name>/cost-bench/1GB/orders_0000.csv (200,001,388 bytes)
uploaded s3://<bucket_name>/cost-bench/1GB/orders_0001.csv (200,102,463 bytes)
uploaded s3://<bucket_name>/cost-bench/1GB/orders_0002.csv (200,096,401 bytes)
uploaded s3://<bucket_name>/cost-bench/1GB/orders_0003.csv (200,104,362 bytes)
uploaded s3://<bucket_name>/cost-bench/1GB/orders_0004.csv (199,714,234 bytes)
1GB: 5 files, 1,000,018,848 bytes, 7,885,000 rows
計測
SQLファイルは、Snowsightのワークシートかsnow sql -fで実行します。
1. 外部テーブルにファイル一覧を読み込む
sql/01_refresh_external.sqlを実行します。外部テーブルは、この操作で読み込んだファイルだけを参照します。
2. Taskを3回実行する
sql/02_run_tasks.sqlを3回実行します。各回の間は2分半あけて、user-managed TaskのWarehouseが自動停止してから次の回を実行します。Taskの完了はsql/check.sqlで確認します。
3. Snowpipeで3回取り込む
sql/03_reset_snowpipe.sqlで取り込み先を空にしてから、テストデータをSnowpipe用のフォルダへS3の中でコピーします。
for SIZE in 10MB 100MB 1GB; do
  aws s3 cp --recursive \
    s3://<bucket_name>/cost-bench/${SIZE}/ \
    s3://<bucket_name>/cost-bench/snowpipe/${SIZE}/run1/
done
コピーしたファイルの通知を受けて、Snowpipeが取り込みを始めます。sql/check.sqlで行数がテストデータと一致したら、フォルダ名をrun2・run3に変えて同じ操作を繰り返します。
4. 参照を3回実行する
sql/04_reference.sqlを3回実行します。このSQLは、4構成のテーブルをdbtのtableモデルと同じCTAS(CREATE OR REPLACE TRANSIENT TABLE ... AS SELECT * FROM ...)で1回ずつ読みます。
最初のCTASにWarehouseの起動時間が入らないように、CTASの前にWarehouseを起動しています。
5. 結果を集計する
sql/05_measure.sqlを実行します。計測をやり直すときは、terraform destroyのあとにデプロイの手順1から実行します。
検証結果
検証条件
テストデータは9列の未圧縮CSVです。サイズは、1日に1テーブルへ取り込む量として3つ用意しました。
| サイズ | ファイル数 | 1ファイルあたり | 行数 |
|---|---|---|---|
| 10MB | 1 | 約10MB | 81,000 |
| 100MB | 1 | 約100MB | 795,000 |
| 1GB | 5 | 約200MB | 7,885,000 |
- Warehouse: すべてGen2 XS、
AUTO_SUSPENDは60秒 - user-managed Task: サイズごとに専用のWarehouseで実行
- serverless Task: 計算資源のサイズはXSMALL〜SMALL
- 実行回数: Taskの実行・Snowpipeの取り込み・参照のCTASを、構成とサイズの組み合わせごとに3回ずつ実行し、その平均を載せる
各項目は次の履歴から求めました。
| 項目 | 求め方 |
|---|---|
| Taskの取り込み秒 | TASK_HISTORYのSCHEDULED_TIMEからCOMPLETED_TIMEまで |
| Snowpipeの取り込み秒 | S3に最後のファイルを置いた時刻(LISTのlast_modified)から、最後のファイルの取り込みが終わった時刻(COPY_HISTORYのLAST_LOAD_TIME)まで |
| 参照秒 | QUERY_HISTORY_BY_WAREHOUSEのTOTAL_ELAPSED_TIME |
| 取り込みCredits | WAREHOUSE_METERING_HISTORY・SERVERLESS_TASK_HISTORY・PIPE_USAGE_HISTORYの3回分の合計を3で割った値 |
Snowpipeの取り込み秒には、S3からSnowpipeに通知が届くまでの時間も含まれます。
Creditsは、構成ごとに次のしくみで課金されます。
| 計算資源 | 使う構成 | 課金のしくみ |
|---|---|---|
| Warehouse | user-managed Task、参照 | 起動している間を秒単位で課金する。起動・再開のたびに最低60秒分を課金する。Gen2 XSは1.35クレジット/時 |
| serverless | serverless Task | 使った計算資源の時間を秒単位(1秒未満は切り上げ)で計算し、倍率0.9を掛ける。XSで動いた場合は0.9クレジット/時 |
| Snowpipe | Snowpipe | 取り込んだデータ量に、1GBあたり0.0037クレジットを掛ける |
単価の数値は、Snowflake Service Consumption Tableに記載されています。Gen2 XSの1.35クレジット/時はTable 1(b)、serverless Taskの倍率0.9とSnowpipeの0.0037クレジット/GBはTable 5にあります。
構成ごとの結果
sql/05_measure.sql全体を実行すると、最後から2つ目のSELECTが構成とサイズごとの取り込み秒・取り込みCredits・参照秒を出します。外部テーブルは取り込みをしないので、取り込み秒はnullになります。
SELECT
    DECODE(
        CONFIG, 'EXTERNAL', '外部テーブル', 'USER_MANAGED', 'user-managed Task',
        'SERVERLESS', 'serverless Task', 'SNOWPIPE', 'Snowpipe'
    ) AS "構成",
    SIZE AS "サイズ",
    INGEST_SEC AS "取り込み秒",
    ROUND(INGEST_CREDITS, 6) AS "取り込みCredits",
    REFERENCE_SEC AS "参照秒"
FROM RESULT
ORDER BY DECODE(SIZE, '10MB', 1, '100MB', 2, 3), DECODE(CONFIG, 'EXTERNAL', 1, 'USER_MANAGED', 2, 'SERVERLESS', 3, 4);
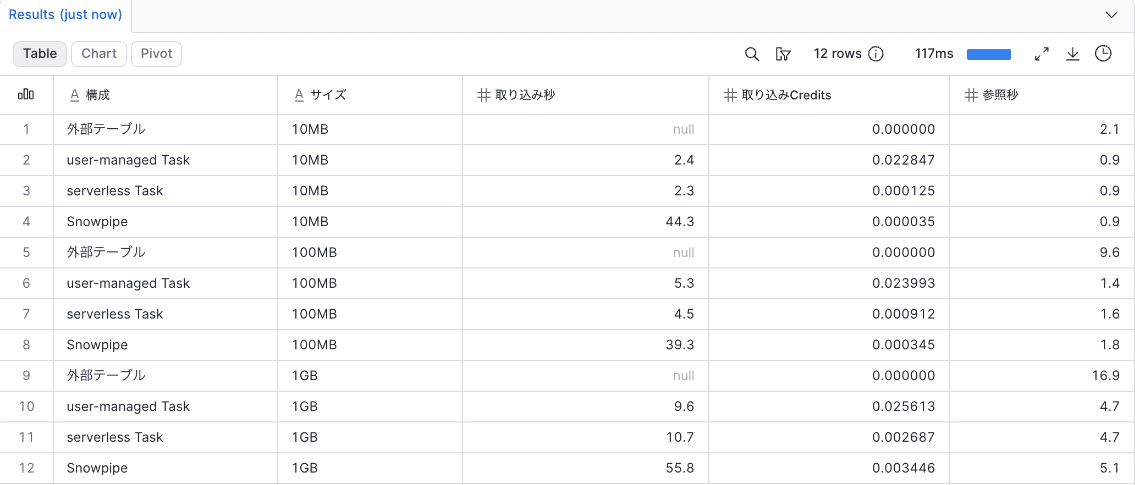
外部テーブルは、CTASの時間がSnowflakeのテーブルにロードした3構成の2倍以上でした。
user-managed Taskは、取り込み時間(2〜10秒)にかかわらず、約60〜70秒分のCreditsを消費しています。COPY INTOが終わったあとも、AUTO_SUSPENDの60秒間はWarehouseが起動していて課金されるためです。
Snowpipeの取り込み秒は、10MBでも約44秒でした。S3の通知が届いてから取り込みが始まるまでの時間が、データ量によらずかかるためと考えられます。
1テーブルあたりの月額
月額は次の式で計算しました。
参照Credits  = 参照秒 × 1.35 ÷ 3600   (Gen2 XSの1.35クレジット/時を秒あたりに換算)
1日のCredits = 取り込みCredits + 参照Credits × 参照回数
月額(円)     = 1日のCredits × 688円 × 30日
- 参照は、dbtのバッチで起動しているWarehouseで実行する前提です。そのため、参照の費用は実際にかかった秒数の分で計算します
- user-managed Taskの取り込みは、Taskのために専用のWarehouseを起動する前提です。60秒の待ち時間を含む実測値をそのまま使います
- 1クレジットは、Enterprise Edition(AWS東京)の$4.30を$1=160円で換算した688円です
- Snowflakeのストレージ代とCloud Servicesの費用は含みません
最後のSELECTは、構成とサイズごとの月額(円)を参照回数別に出します。
SELECT
    DECODE(
        CONFIG, 'EXTERNAL', '外部テーブル', 'USER_MANAGED', 'user-managed Task',
        'SERVERLESS', 'serverless Task', 'SNOWPIPE', 'Snowpipe'
    ) AS "構成",
    SIZE AS "サイズ",
    ROUND((INGEST_CREDITS + 1 * REFERENCE_SEC * 1.35 / 3600) * 688 * 30) AS "月額(参照1回/日)",
    ROUND((INGEST_CREDITS + 5 * REFERENCE_SEC * 1.35 / 3600) * 688 * 30) AS "月額(参照5回/日)",
    ROUND((INGEST_CREDITS + 20 * REFERENCE_SEC * 1.35 / 3600) * 688 * 30) AS "月額(参照20回/日)"
FROM RESULT
ORDER BY DECODE(SIZE, '10MB', 1, '100MB', 2, 3), DECODE(CONFIG, 'EXTERNAL', 1, 'USER_MANAGED', 2, 'SERVERLESS', 3, 4);
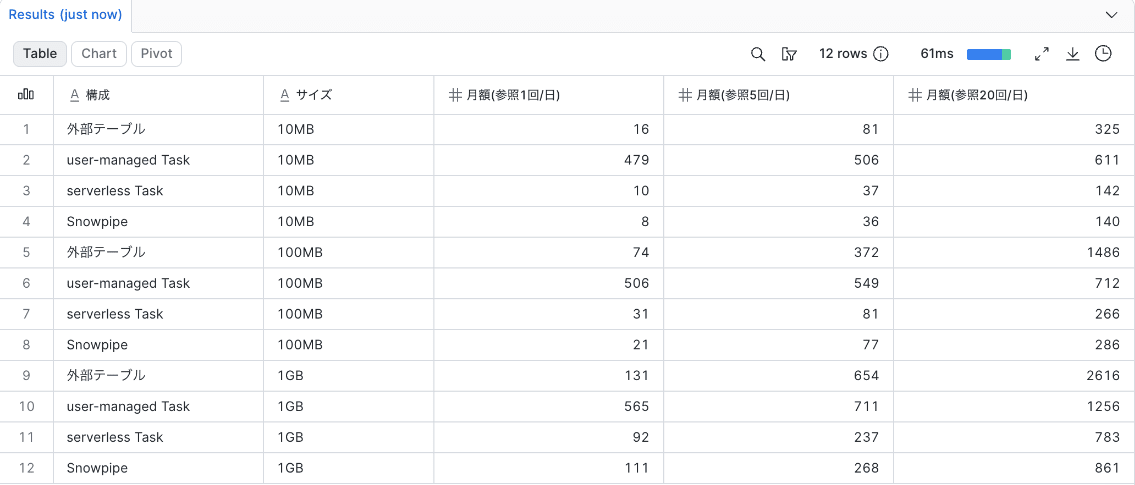
外部テーブルとserverless Taskの月額の差は、参照回数とサイズが大きいほど広がります。参照20回/日では、外部テーブルとserverless Taskの月額は、10MBで325円と142円、100MBで1,486円と266円、1GBで2,616円と783円です。差が出る原因は、参照1回の処理時間です。参照は4構成とも同じWarehouse(Gen2 XS)で実行するので、参照の費用は参照秒に比例します。1GBでは参照秒が16.9秒と4.7秒で、参照1回の金額は約4.36円と約1.21円になります。
serverless TaskとSnowpipeの差は、どの条件でも月に数十円以内でした。user-managed Taskは、専用のWarehouseを起動する前提では、どのサイズでも月約480円以上かかります。
結論
4つの構成の特性は次のとおりです。月額は1テーブルあたりの値で、10MB〜1GB・参照1〜20回/日の範囲を示します。
| 構成 | 取り込みにかかる時間 | 参照(CTAS)の時間 10MB / 100MB / 1GB | 月額 | Snowflakeへのデータのコピー | Dynamic Tableのソース |
|---|---|---|---|---|---|
| 外部テーブル | 取り込まない | 2.1 / 9.6 / 16.9秒 | 16〜2,616円 | 持たない | 使えない |
| user-managed Task | 2.4〜9.6秒 | 0.9 / 1.4 / 4.7秒 | 479〜1,256円 | 持つ | 使える |
| serverless Task | 2.3〜10.7秒 | 0.9 / 1.6 / 4.7秒 | 10〜783円 | 持つ | 使える |
| Snowpipe | 39.3〜55.8秒 | 0.9 / 1.8 / 5.1秒 | 8〜861円 | 持つ | 使える |
この表から、構成は次のように選びます。
- 取り込む場合は、決まった時刻に取り込むならserverless Task、ファイルが届いたらすぐに使いたいならSnowpipeを選びます。
- 外部テーブルは、どの条件でも最も安い構成になりませんでした。選ぶのは、Snowflakeにデータのコピーを持たず、S3だけで管理したい場合です。参照1回の処理時間がほかの構成の2倍以上かかるので、参照回数とサイズが大きいほど月額はほかの構成より高くなります
- user-managed Taskが向くのは、ほかの処理のためにWarehouseがずっと起動していて、そこで複数のTaskを同時に実行できる場合です。Warehouseの料金はもともとかかっているので、Taskを足しても費用はほとんど増えません。
Dynamic Tableは外部テーブルをソースにできません。silver層以降でDynamic Tableを使う場合は、取り込む構成を選びます。
最後に
今回の結果は1テーブルで簡易的に検証したもので、どの環境にもそのまま当てはまるわけではありません。実際に選ぶ構成はデータ基盤の要件や規模によって変わるので、この記事の結果だけで決めず、判断材料の1つとして扱ってください。どなたかの参考になれば幸いです。