[レポート]AI-Ready なデータ基盤の最新形 - Iceberg で拓くマルチエンジン相互運用 #SWTTokyo26
Apache Iceberg の普及に伴い、複数エンジン間でのデータ相互運用と統一ガバナンスが企業データ基盤の課題となっています。本セッションでは Snowflake Managed Iceberg、Apache Polaris、Horizon Catalog、Iceberg V3 (Variant / Row Lineage / Deletion Vector) を中心に、データ複製を排除しつつ AI エージェントや外部エンジンから同一データに安全にアクセスする「AI-Ready なマルチエンジン・レイクハウス」の最新像を、Snowflake Summit 2026 の発表内容とともにお届けします。
※SNOWFLAKE WORLD TOUR 2026 イベントサイトより抜粋

2026.09.17
かわばたです。
2026年9月10日~2026年9月11日に、「SNOWFLAKE WORLD TOUR 2026 - TOKYO」が開催されました。
本記事はセッション
【AI-Ready なデータ基盤の最新形 - Iceberg で拓くマルチエンジン相互運用】
のレポートブログとなります。
※一部機能はプレビューまたは将来のロードマップに関するものを含みます。利用可能状況は最新の公式ドキュメントをご確認ください。
※登壇者の発言は筆者のメモをもとに要約しています。
登壇者
- 久保 和隆 氏
- Snowflake ソリューションエンジニアリング統括本部 ソリューションエンジニア
なぜデータのコピーは増えるのか
- 分析用、機械学習用、お客様に渡す用など、気づくと同じデータのコピーが増えていないか、という問いかけからスタート
- セッションでは、テスト・開発環境に限っても半数以上の企業が多数のコピーを作っている、という調査結果が紹介された
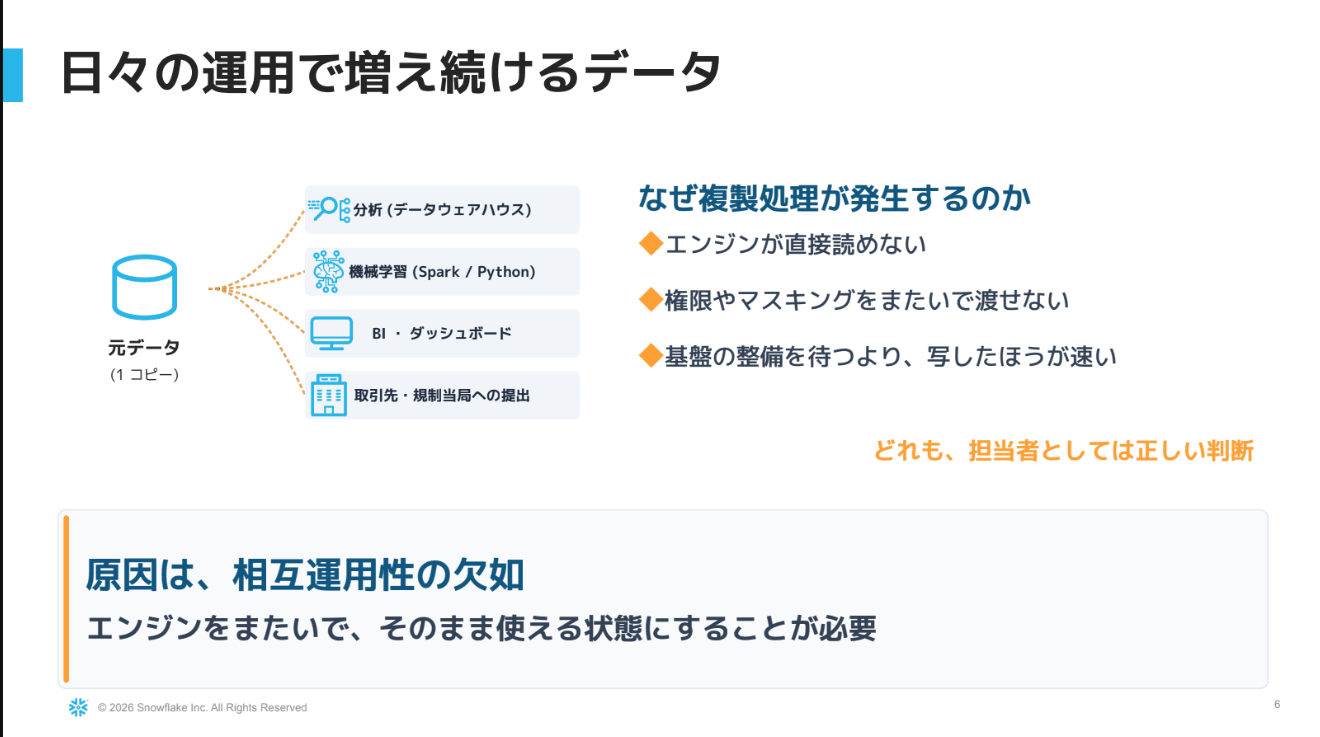
- コピーが生まれる原因は主に3つ
- エンジンが直接読めないので、BI や Python などツールに合わせてコピーする
- 権限管理はしているが、他の人に使わせるにはマスキング済みのデータを渡すしかない
- 権限は付けられるが、本番適用まで1か月かかるので、担当者がコピーして渡す
- 担当者の行動が問題なのではない。データのある場所へそのままアクセスできない「相互運用性の欠如」が問題
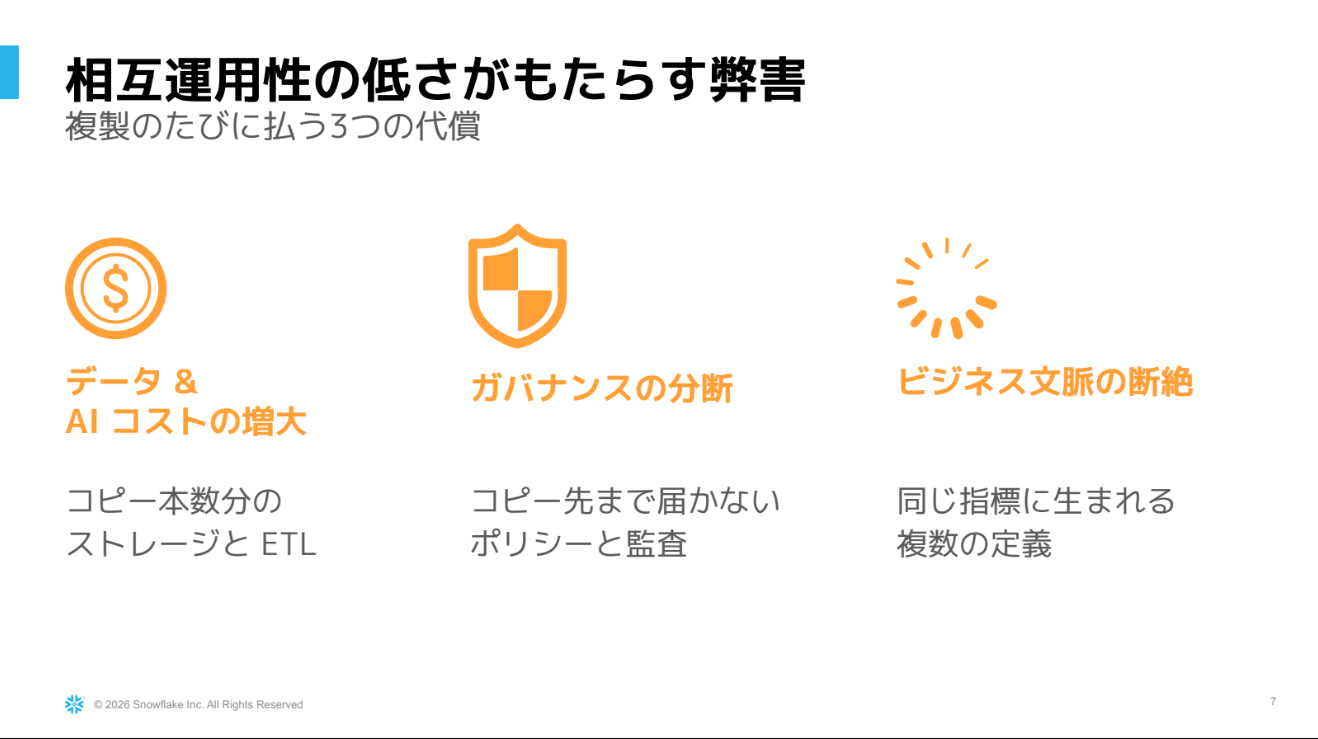
- コピーが増えると3つの問題が起きる
- コスト: ストレージ料金に加え、ETL パイプラインのコンピュート費用がかかる
- ガバナンスの分断: すべてのコピーに統制が効いているかを管理しきれず、情報漏えいのリスクが高まる
- ビジネス文脈の断絶: チームごとに「売上」の定義がずれ、AI に聞いても答えがバラバラになる
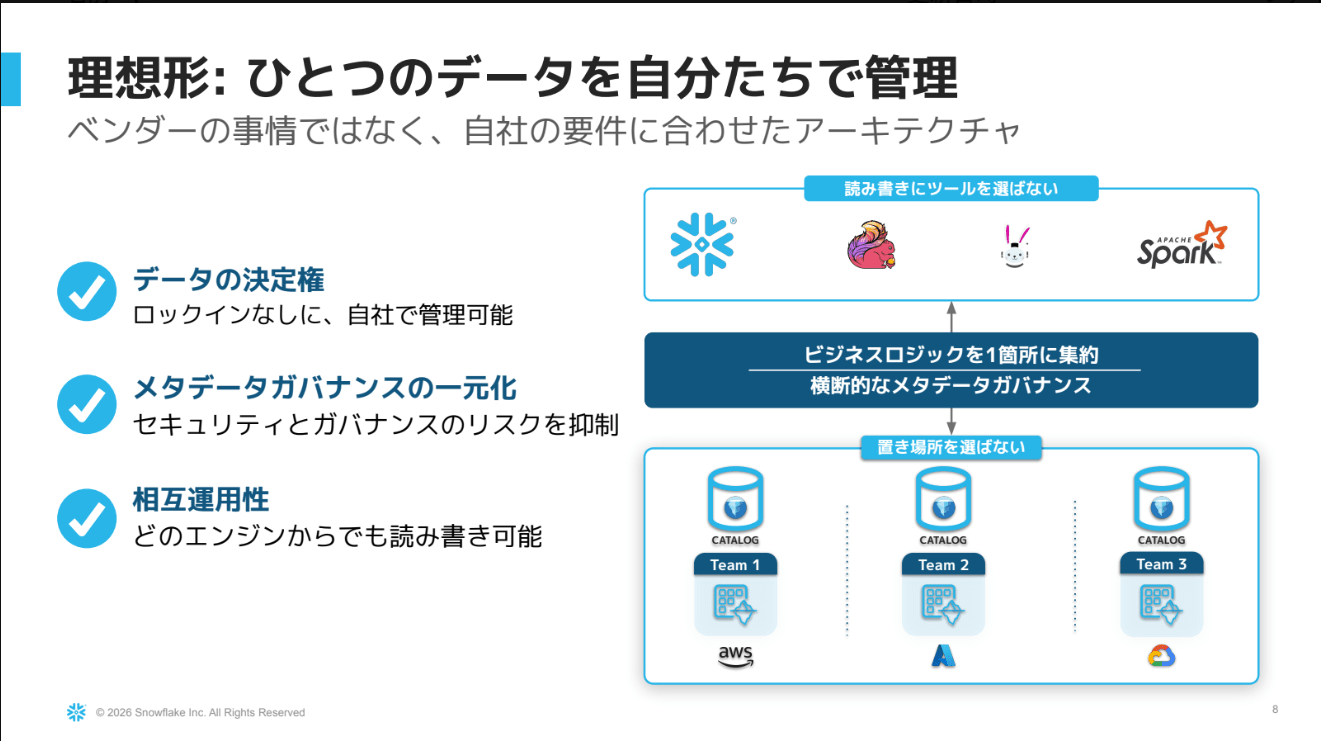
- 解決には次の3つが必要で、Snowflake なら今はこれを満たせる
- データの決定権: どこに、どの形式で置くかを自分たちで決める
- メタデータ・ガバナンスの一元化: 1か所でかけた統制がすべてに適用される
- 統制の効いたデータに、好きなエンジンで接続できる
データをどこに、どの形式で置くか
Iceberg ならデータの置き場所に依存しにくい
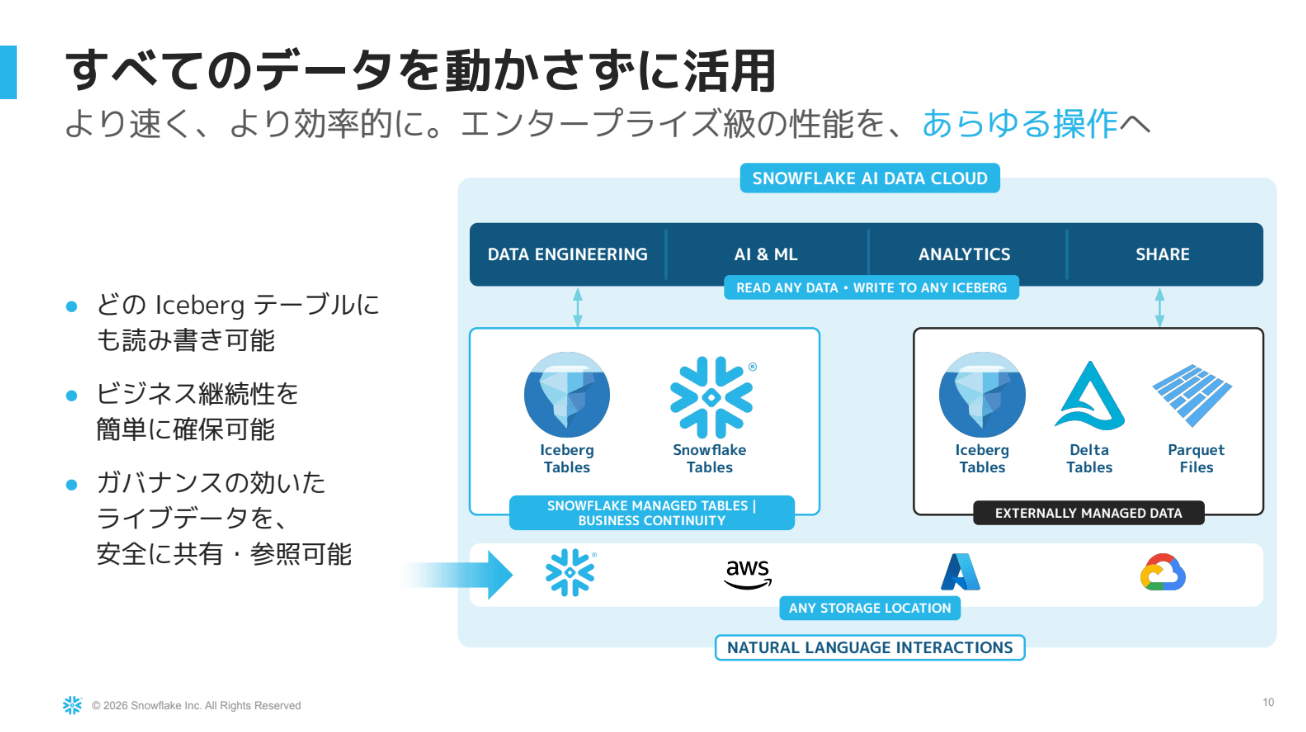
- 冒頭で「データを Snowflake に置いてください、という話ではない」と強調
- Snowflake が管理するテーブルにも、外部で管理するテーブルにも Iceberg が登場する
- Iceberg 形式で持ち、対応するカタログとエンジンを使えば、置き場所を問わず読み書きできる
Iceberg v3 で解消された運用上のギャップ
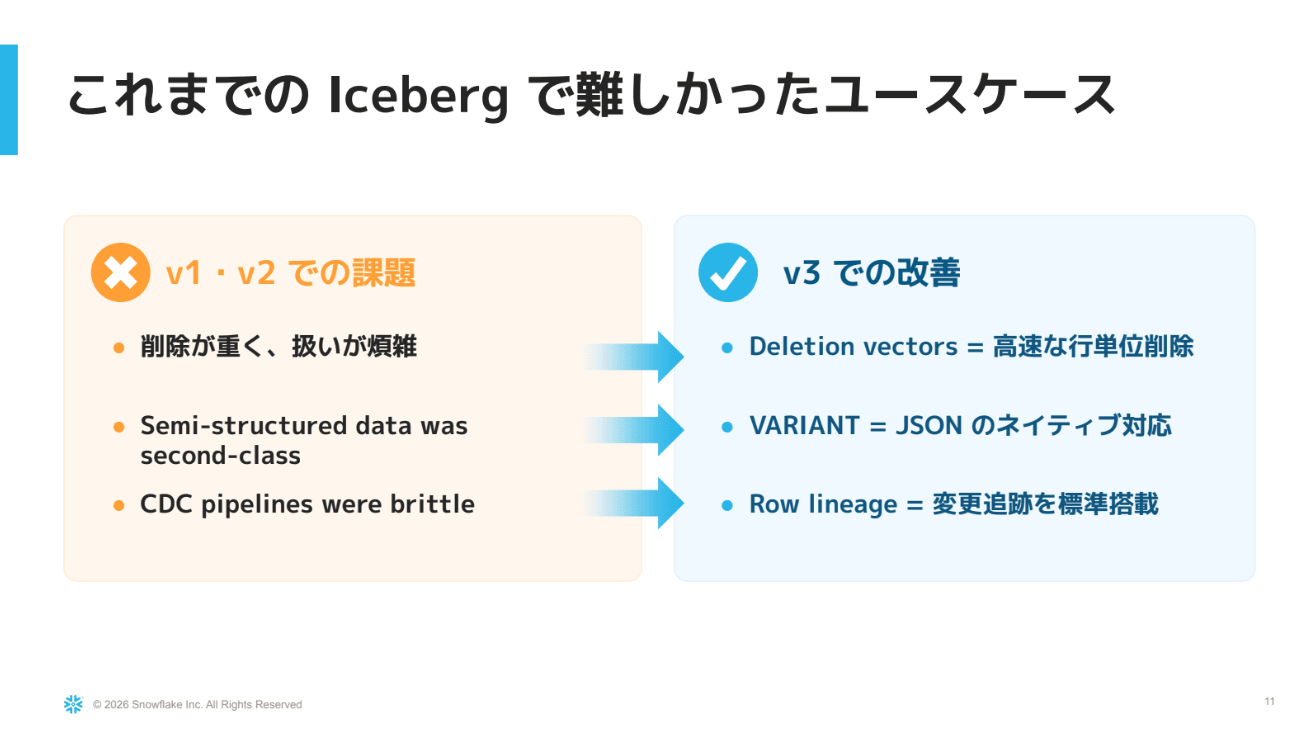
- Iceberg は数年前からあるが、すべてを Iceberg で持つ状況にはなっていない
- v1/v2 に運用上の重大なギャップがあったため、というのが登壇者の見立て
- v3 では、そのギャップに1対1で対応する機能が入った
| v1/v2 の課題 | v3 の機能 |
|---|---|
| 削除が重い。1行消すだけで削除ファイルが積み上がる | deletion vectors |
| 半構造化データを扱えない | VARIANT 型 |
| CDC パイプラインが壊れやすい。変更追跡の仕組みがフォーマットにない | row lineage |
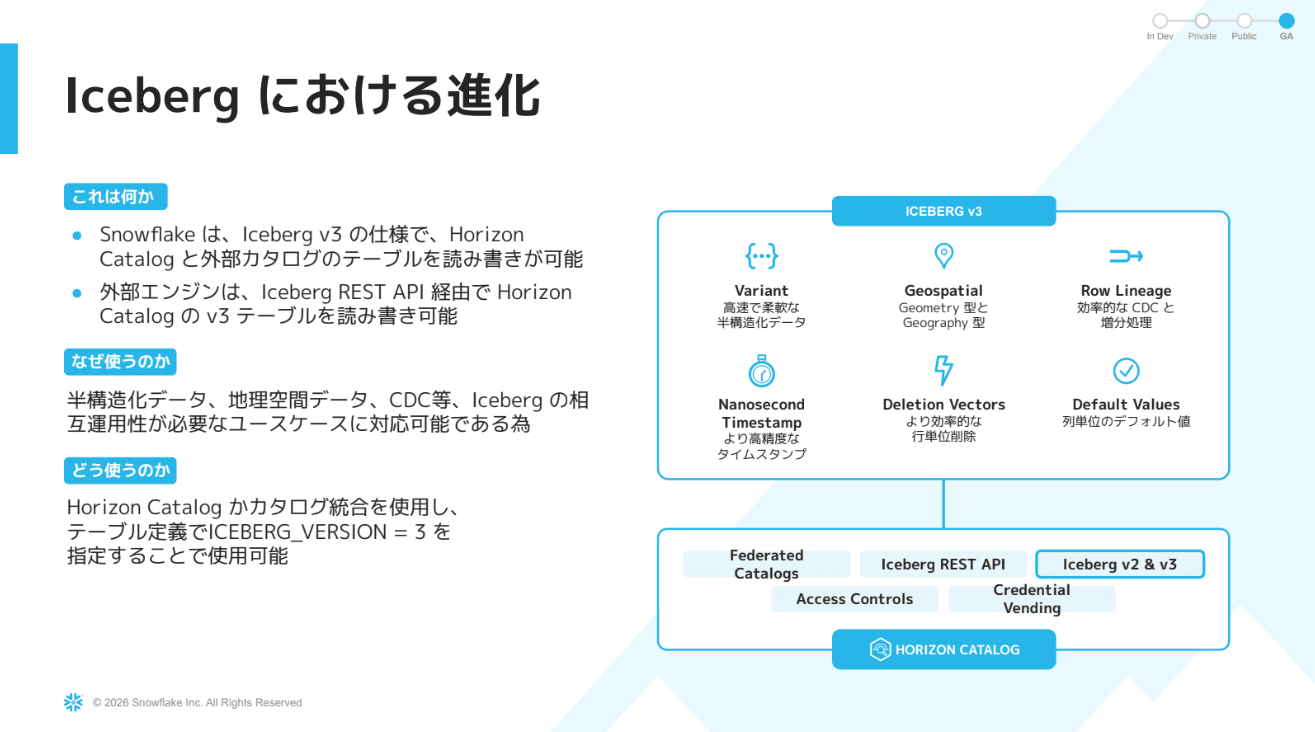
- ほかにも geometry 型・geography 型、ナノ秒精度のタイムスタンプ、列のデフォルト値が追加されている
- Snowflake も v3 に対応済み。2026年5月7日に一般提供(GA)となった
- テーブル定義で
ICEBERG_VERSION = 3と指定するだけで使える
- テーブル定義で
- Iceberg REST Catalog(IRC)API に対応した外部エンジンからも、Snowflake 管理の v2/v3 テーブルを読み書きできる
- 外部エンジンからの書き込みは、2026年5月26日に GA
自前バケット運用の「氷山」と Snowflake マネージドストレージ
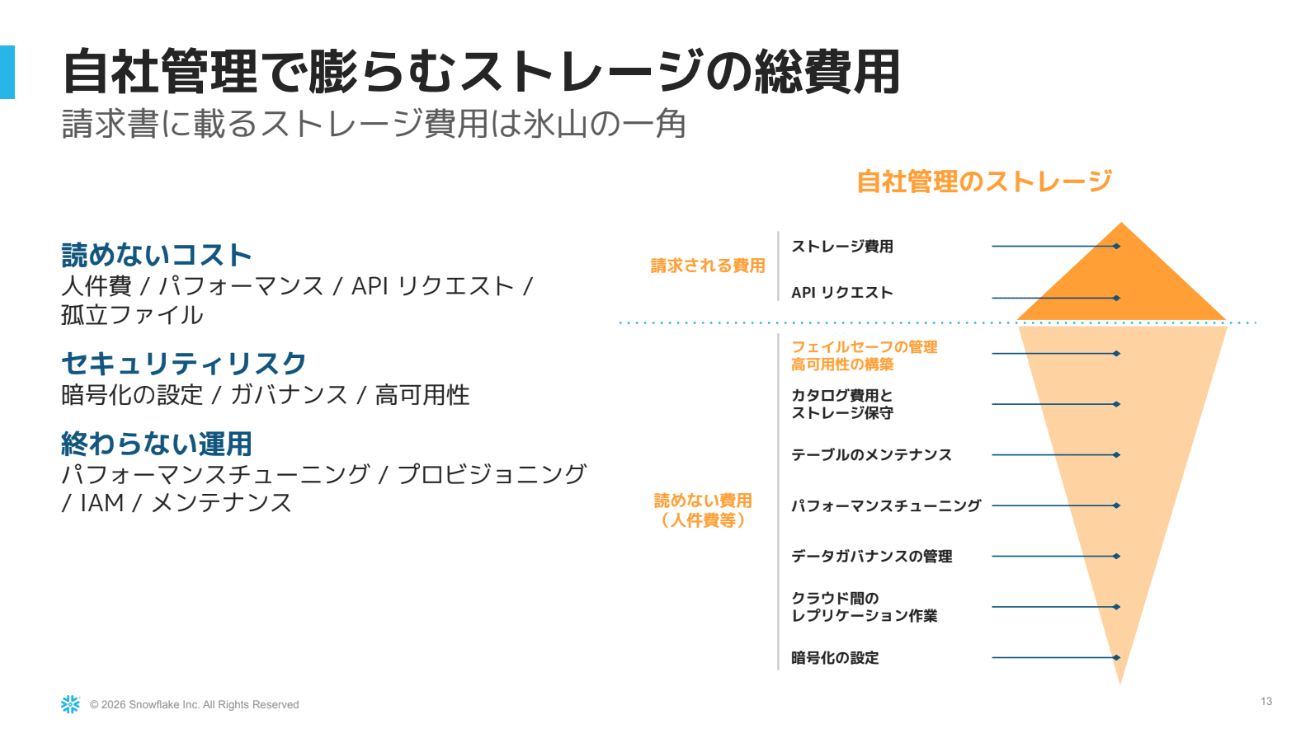
- Iceberg を検討したお客様からは「従来の Snowflake のテーブルと同じように管理したい」という声が多い
- 自分でバケットを管理すると、ストレージ以外にも運用の手間がかかることに気づくため
- 見えるコストはストレージ費用と API リクエスト費用。実際は見えないコストが大きい
- フェイルオーバー、暗号化、それらの設計と運用にかかる費用
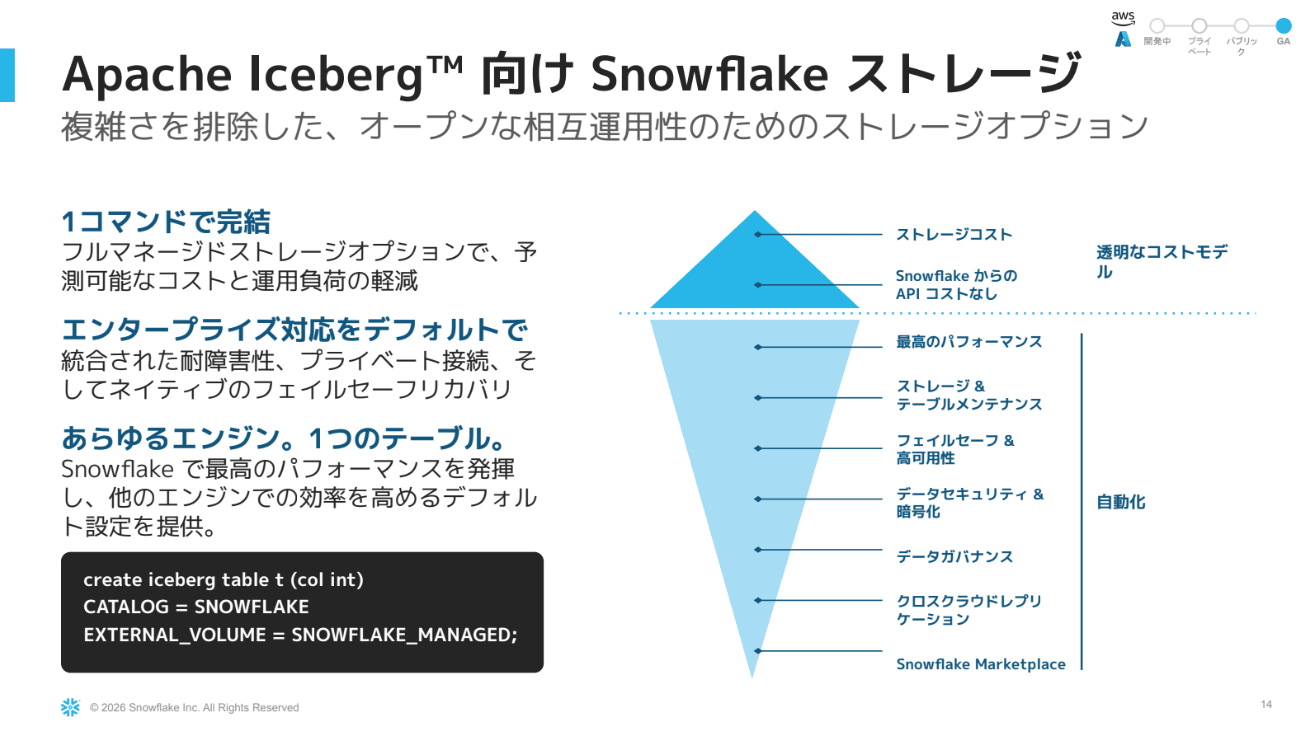
- そこで Snowflake は、Iceberg テーブル向けに Snowflake 管理のストレージを提供するようになった
- 公式名称は Snowflake storage for Apache Iceberg tables。2026年6月に GA
- AWS と Azure に対応し、東京リージョンでも使えるとのこと
- Fail-safe、高可用性、暗号化、ストレージのメンテナンスまで Snowflake 側に任せられる
- 使い方は、テーブル作成時に
EXTERNAL_VOLUME = 'SNOWFLAKE_MANAGED'を指定するだけ- バケットの設計も IAM の設定も不要で、従来のテーブルと同じ体験で Iceberg を使える
※公式ドキュメントでは、Snowflake 管理ストレージの暗号化はサーバーサイド暗号化(SSE)のみで、顧客管理キー(CMK)には非対応とされています。
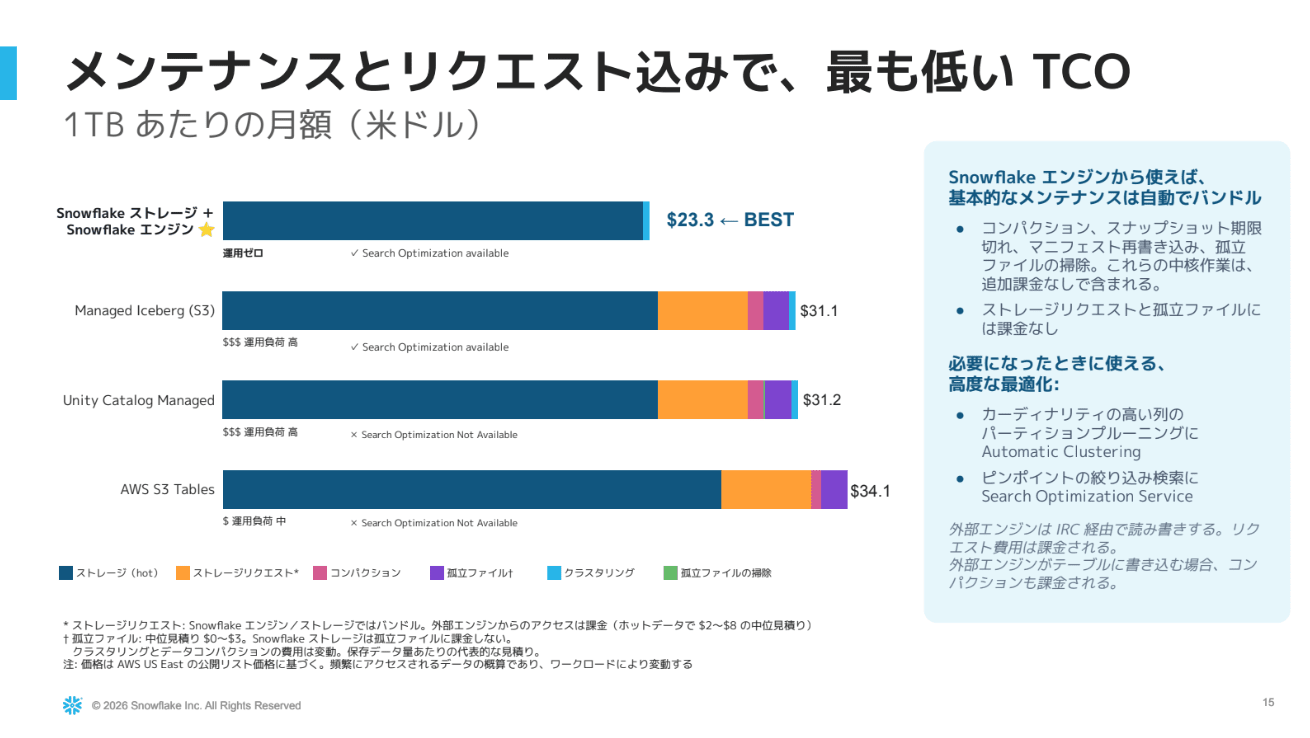
- 料金面でも有利とのこと(AWS US East の公開リスト価格に基づく、1TB あたり月額の比較)
- コンパクション、スナップショットの期限切れ処理、マニフェストの整理などのメンテナンスを任せられる
- Snowflake のエンジンから使う場合は、ストレージのリクエスト費用がかからない
- 差が出るのは「Iceberg 対応の有無」ではなく、運用と課金まで含めた部分だという主張
- 置き場所はどこでもよい。そのうえで選択肢が1つ増えた、という位置づけ
Snowflake Horizon Catalog
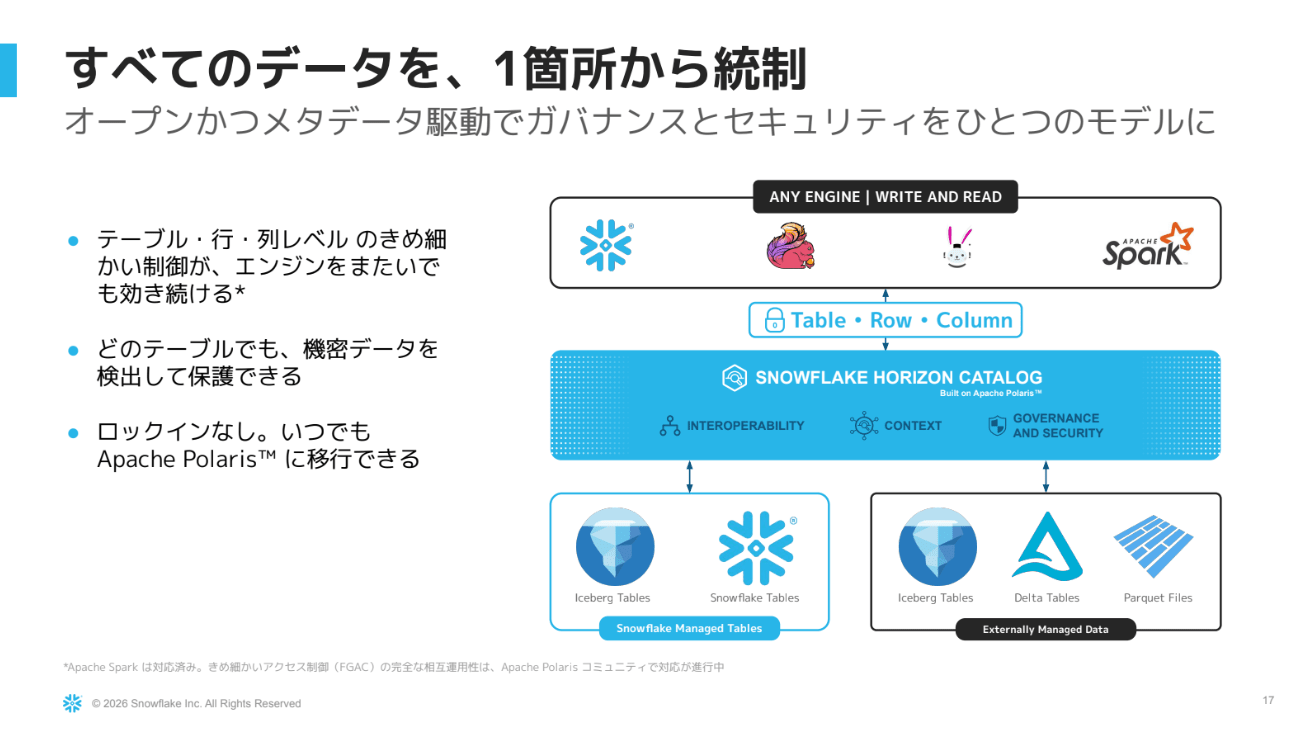
- Horizon Catalog は Snowflake のカタログで、相互運用レイヤーは Apache Polaris 上に構築されている
- Snowflake 管理のテーブルも外部カタログのテーブルも、ここを通して読み書きできる
- 3つの柱は、ガバナンスとセキュリティ、コンテキスト、相互運用性
ポリシーを外部エンジンにも効かせる
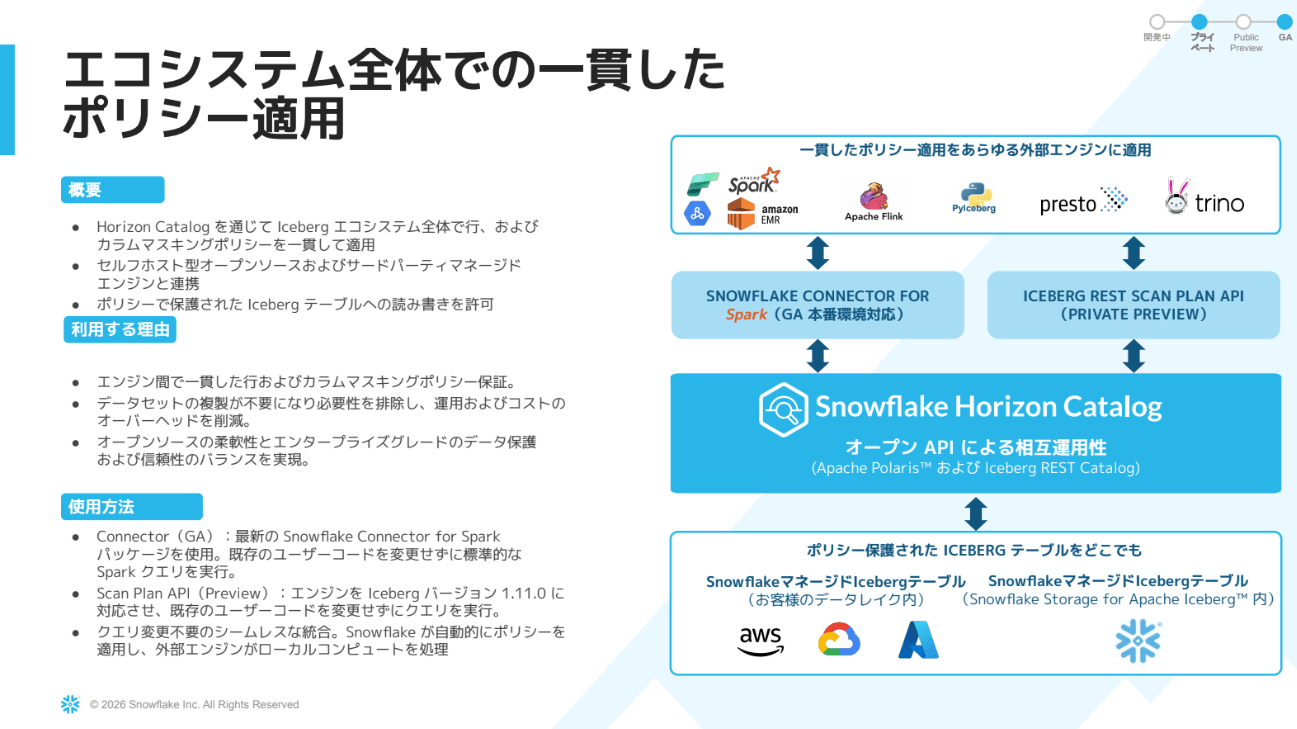
- Snowflake のガバナンスは行・列レベルで効く強力なもの。ただ、外部エンジンから使うときはコピーして渡しがちだった
- Horizon Catalog なら、IRC API 経由のアクセスにも Snowflake のポリシーを適用できる
- 経路は2つ
- Snowflake Connector for Spark: GA。既存の Spark コードをほとんど変えずに使える
- Iceberg Scan Plan API: Spark 以外のエンジンにもポリシーを効かせる仕組み。2026年9月10日に Public Preview
- 対応する経路を使えば、Snowflake で一度定義したマスキングポリシーや行アクセスポリシーを、外部エンジンにも適用できる
セマンティックビュー
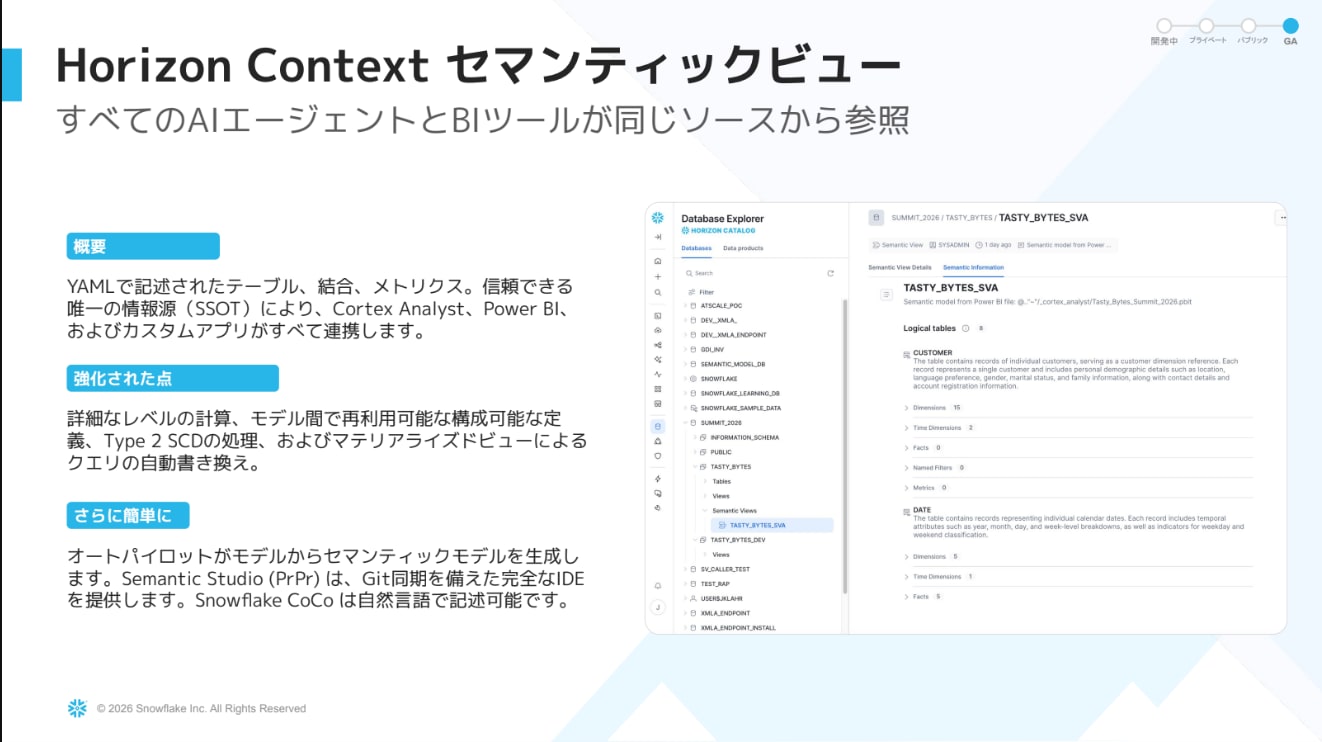
- 部署が違うと、同じ質問でも違う答えが返る。原因の多くは「売上」などの定義のずれ
- セマンティックビュー(Semantic View)で、テーブルの結合やメトリクスを YAML で定義し、信頼できる唯一の情報源を作る
- Cortex Analyst も、Power BI などの外部 BI も、自社アプリも、同じ定義を参照する
- ゼロから書く必要はない。Semantic View Autopilot で、既存の Power BI ファイルなどから自動生成できる
- AI モデルに追加学習させる話ではない。データに意味を定義し、AI が正しく解釈できる状態にする話
標準 API で読み書きする
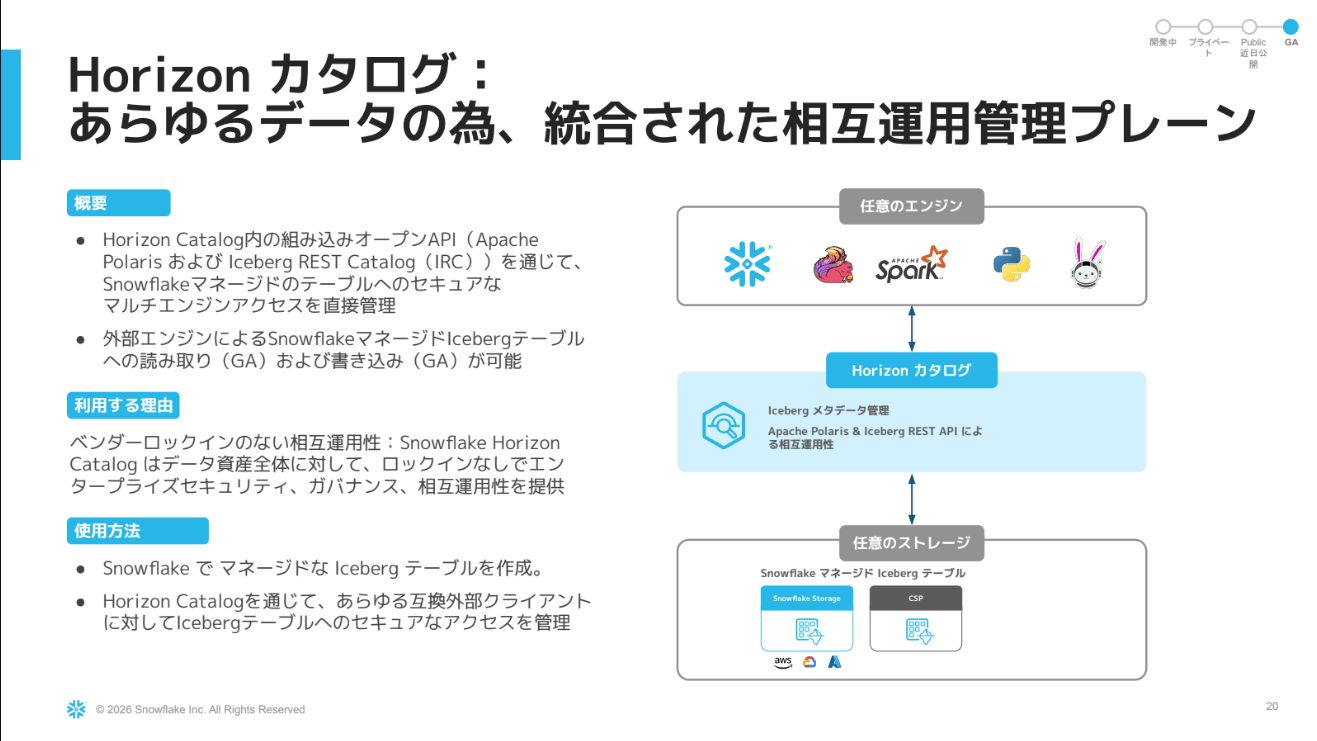
- Horizon Catalog は Apache Polaris と Iceberg REST Catalog の標準 API を持つ
- Spark 系のサービスや Trino など、標準 API に対応したエンジンから接続できる
- 読み込みだけでなく、書き込みもできる
- ストレージも、Snowflake のストレージでもクラウドのストレージでも構わない
- エンジンごとに立てていたカタログを1つにまとめられ、アーキテクチャがシンプルになる
catalog-linked database で外部カタログもまとめる
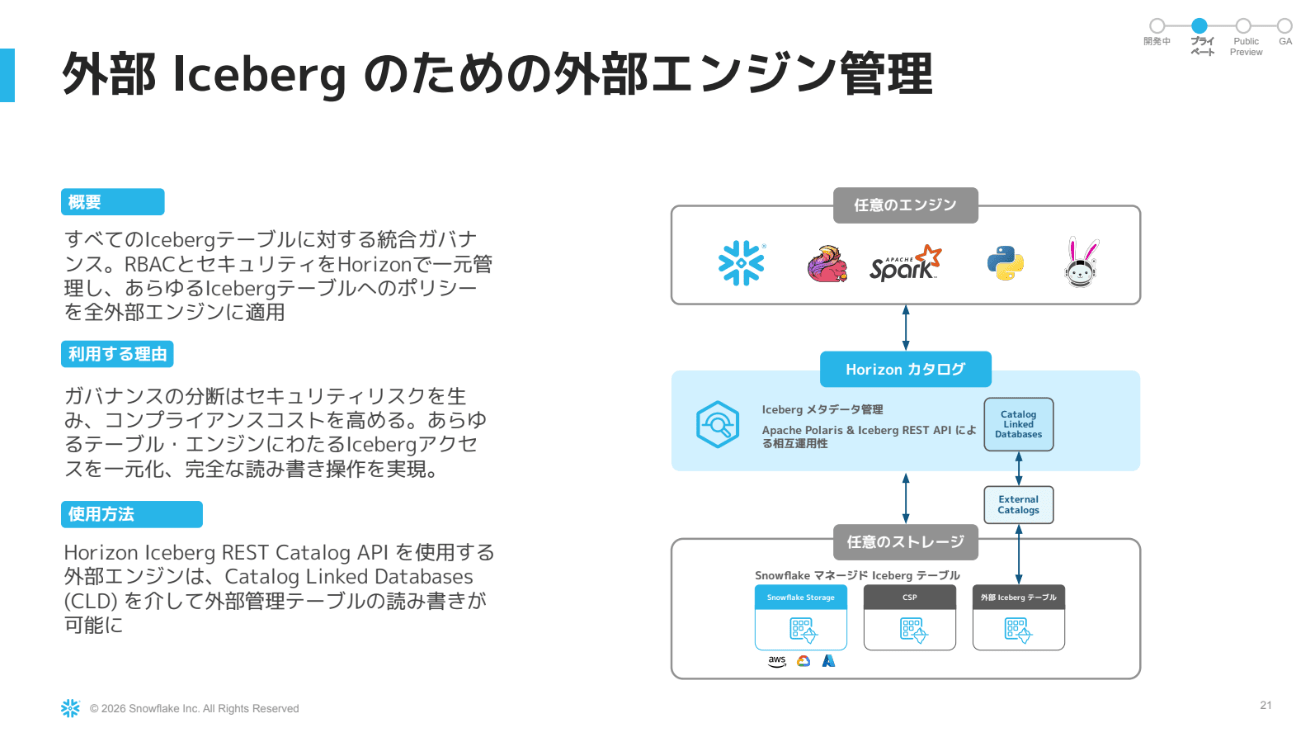
- catalog-linked database(CLD)は、外部カタログを Snowflake にリンクする仕組み
- Apache Polaris、Unity Catalog、AWS Glue のカタログなどをリンクできる
- リンクすると外部の Iceberg テーブルを自動検出し、相手側の追加・変更も自動で追跡する
- リンクしたテーブルにも Snowflake 側でポリシーを設定でき、Horizon 側と相手側の二重管理を減らせるとの説明
- ただし公式ドキュメントでは、外部エンジンがテーブルファイルを直接読む経路ではポリシーを評価できない
- ポリシーで保護したテーブルを外部エンジンから読むには、Snowflake Connector for Spark などの経路が必要
ACCESS_HISTORY に一本化する
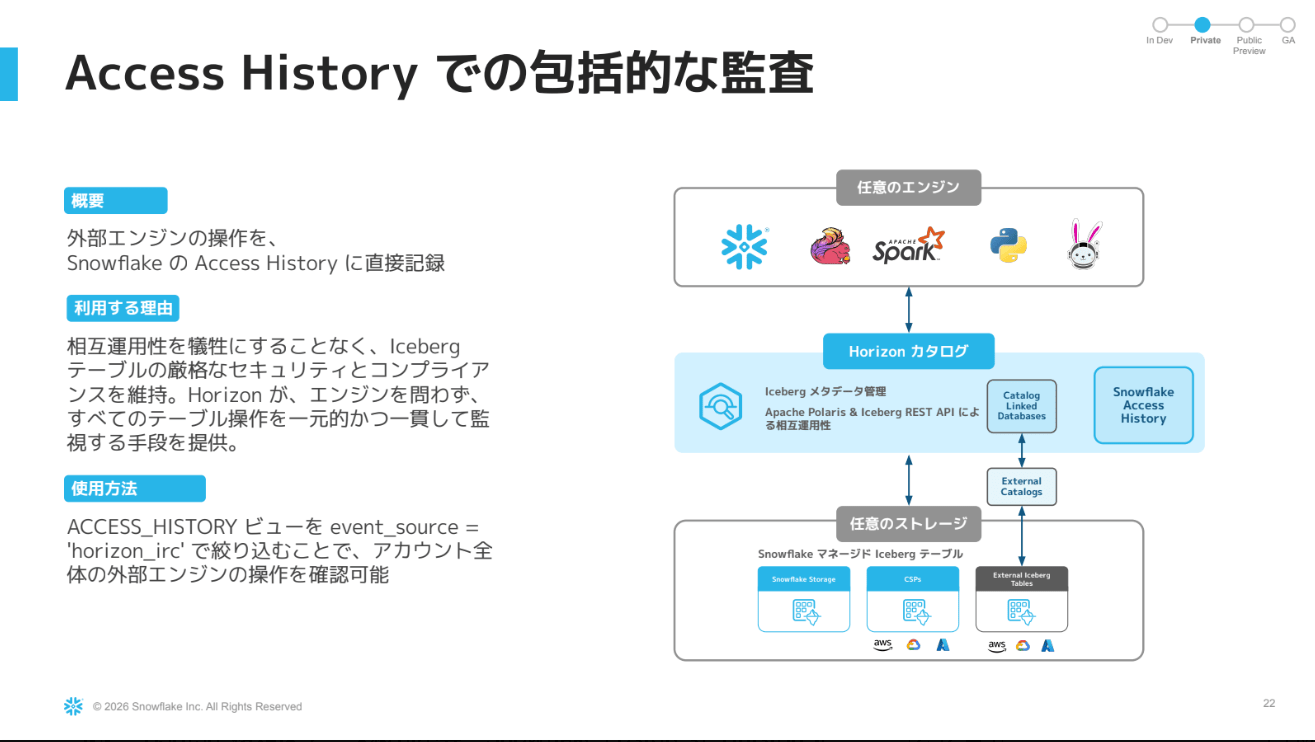
- どのエンジンからでも接続できるようになると、監査が難しくなる
- 外部エンジンからの操作も ACCESS_HISTORY に記録される
- 「Horizon IRC」の条件で絞れば、外部エンジン経由の操作を確認できる
- ポリシーも監査も1か所に集まり、統制を1か所にまとめられる
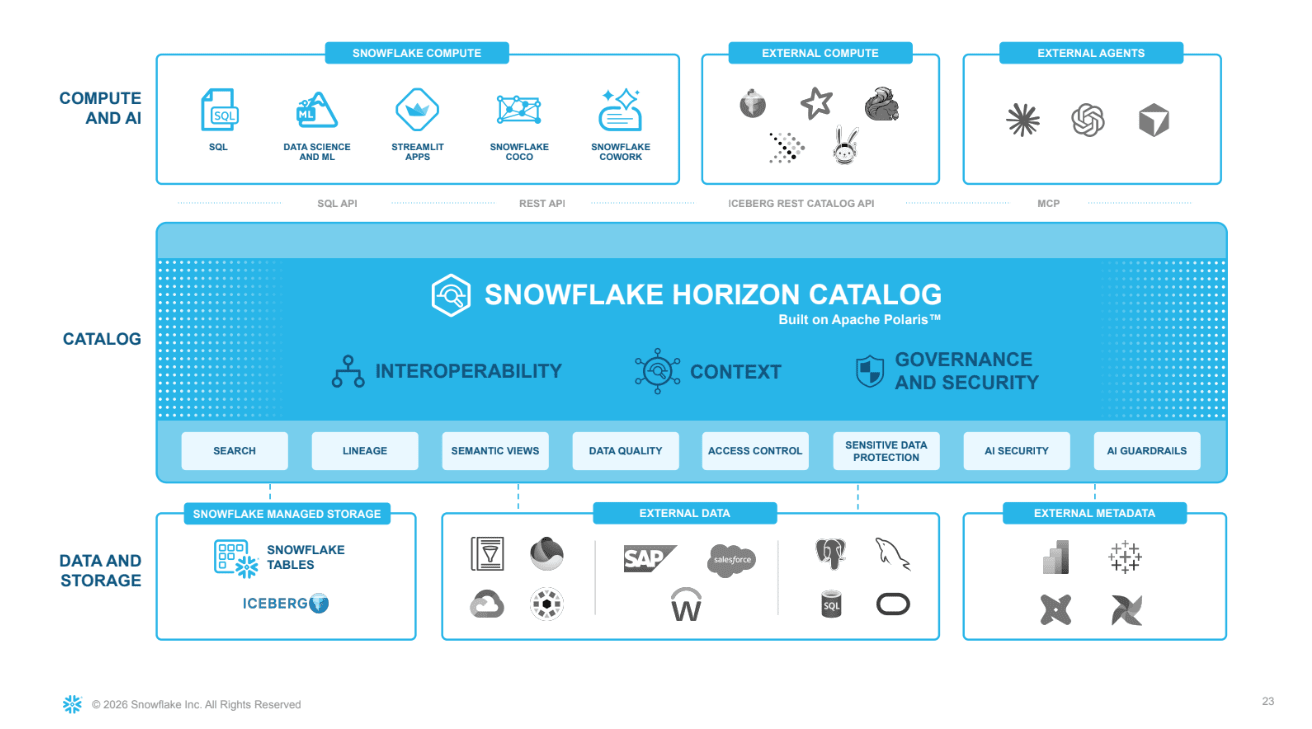
- Horizon Catalog の API 群には MCP も並ぶ。AI エージェントがここを通ってデータにアクセスする前提の設計
デモ:AWS Glue から Snowflake のガバナンスを効かせて読み書きする
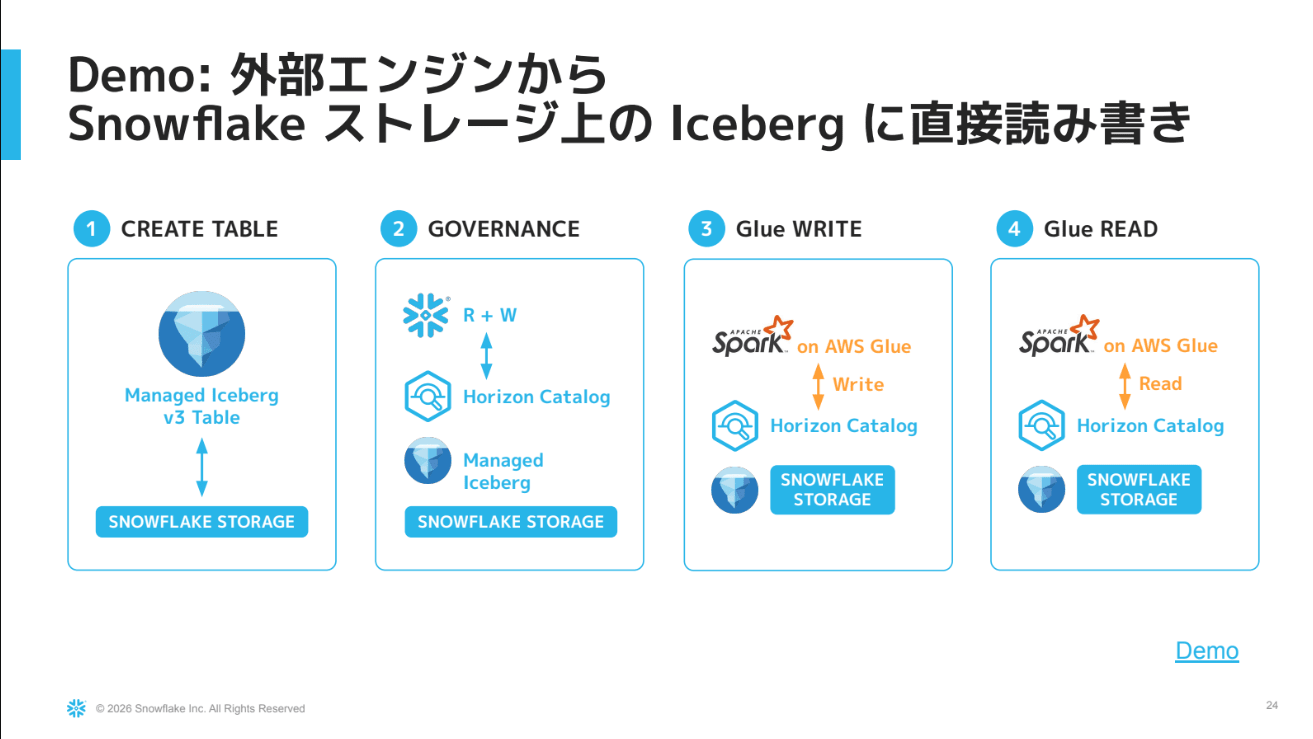
- AWS Glue。Snowflake の外にある、他社のマネージドサービス
- Snowflake 側で、
EXTERNAL_VOLUME = 'SNOWFLAKE_MANAGED'を指定して Iceberg テーブルを2つ作成- ポリシーなしのテーブルと、ポリシーありのテーブル
- ポリシーありのテーブルには、2つのポリシーを適用
- 顧客名のマスキングポリシーと、担当リージョンだけが見える行アクセスポリシー
- Snowflake 上で動作を確認
- ACCOUNTADMIN では全件がマスキングなしで見える
- Glue 用のロールでは、東京リージョンの行だけが見え、顧客名はマスキングされる
- Glue ジョブ(Spark)から INSERT を1行実行すると、1分ほどで完了。Snowflake 側でその行を確認できた
- Snowflake のウェアハウスを使わず、Glue から Horizon Catalog 経由で Snowflake 管理ストレージ上のテーブルへ書き込めた
- Glue ノートブックからの読み込みでは、シークレットを使わず Glue の IAM ロールで認証
- SELECT の結果は、東京リージョンの行だけ、顧客名はマスキング済み
- 外部エンジン(Glue の Spark)からのアクセスにも、Snowflake のポリシーが適用されることが示された
ロックインへの回答
オープン標準へのコミット
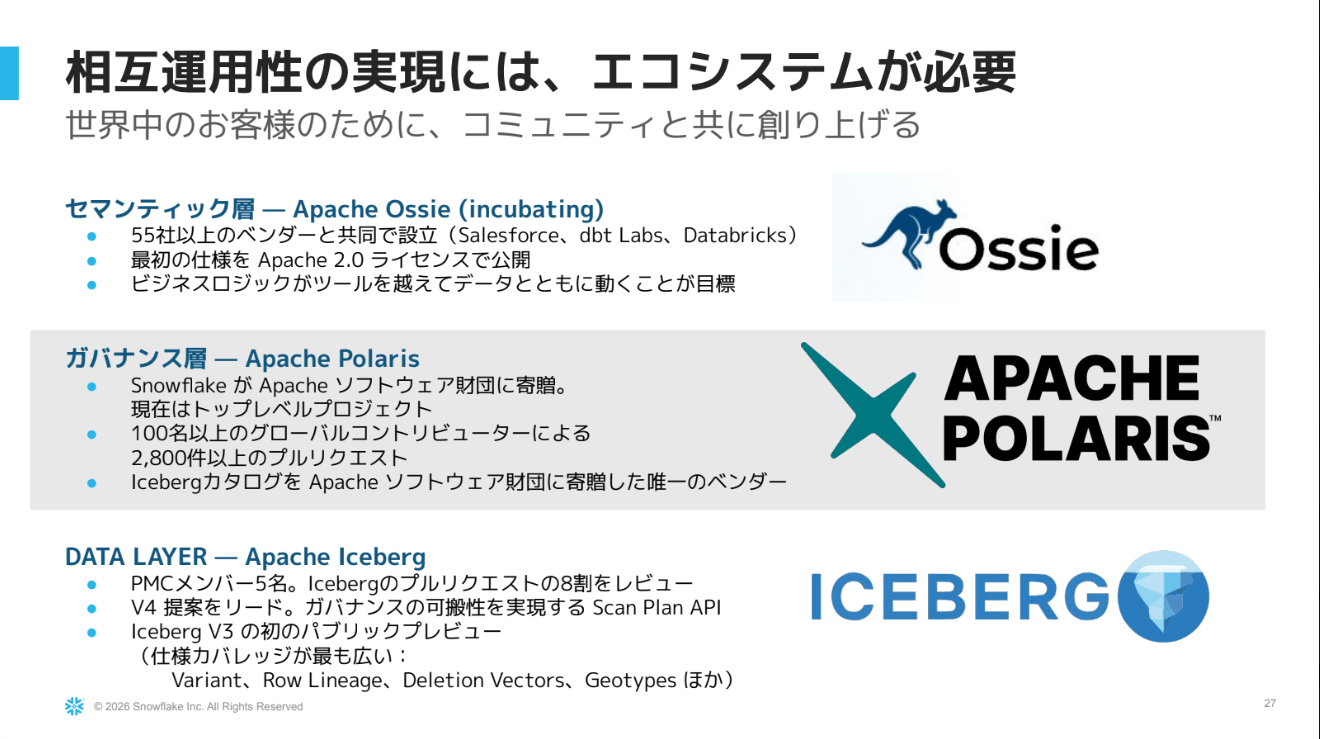
- 「よくできているが、Snowflake にロックインされるのでは」という懸念への回答
- エンジンをまたいで同じデータを扱うには、仕様が共通である必要がある。標準はコミュニティと一緒に作る
- Apache Iceberg: Snowflake から PMC メンバーが5名。プルリクエストの8割をレビューしているとのこと
- Apache Polaris: 2024年8月に Apache Software Foundation へ寄贈。2026年2月にトップレベルプロジェクトへ昇格
- Apache Ossie(Incubating、旧称 Open Semantic Interchange): セマンティック層の標準
- Apache Ossie は、55社以上のベンダーと共同で立ち上げた取り組みとして紹介された
- 競合も参加しており、囲い込みではないことの証拠だとのこと
Snowflake 以外へのデータ共有
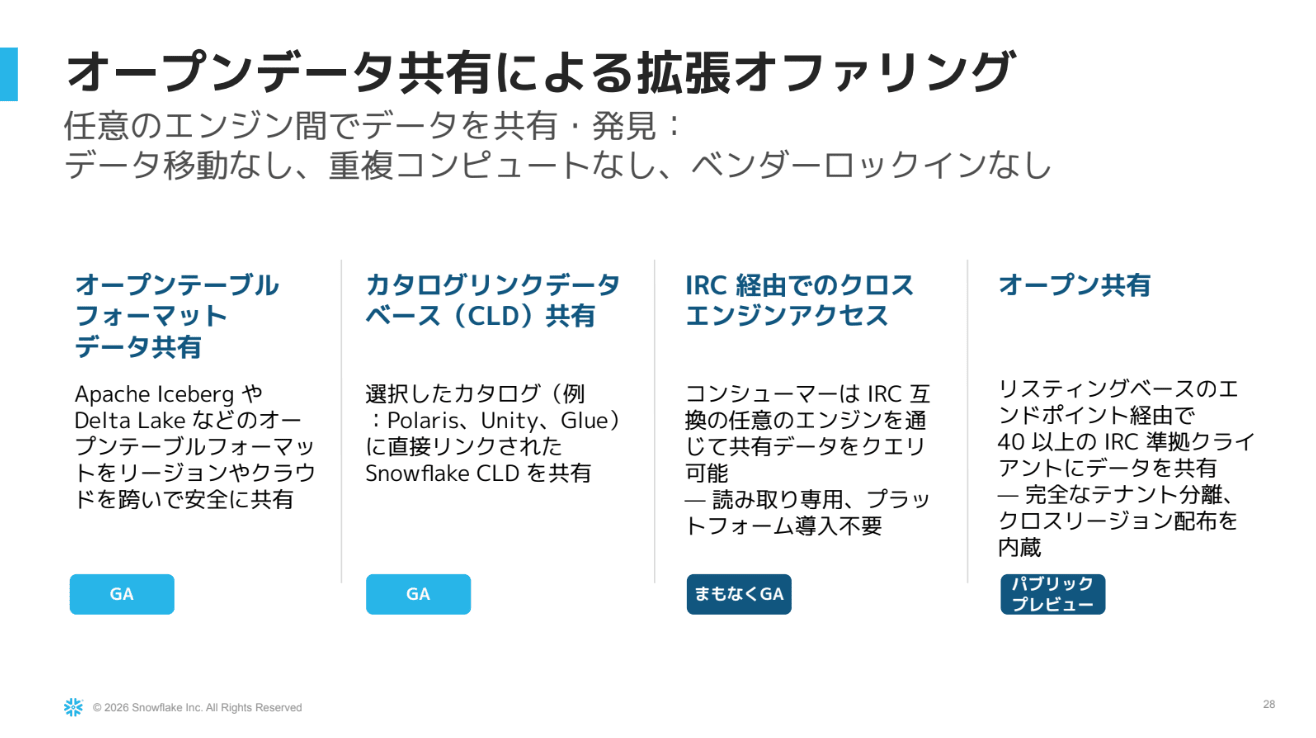
- 共有相手が Snowflake でなくても共有できる手段を用意している
- オープンテーブルフォーマットの共有、CLD の共有、IRC 経由のクロスエンジンアクセス、オープン共有
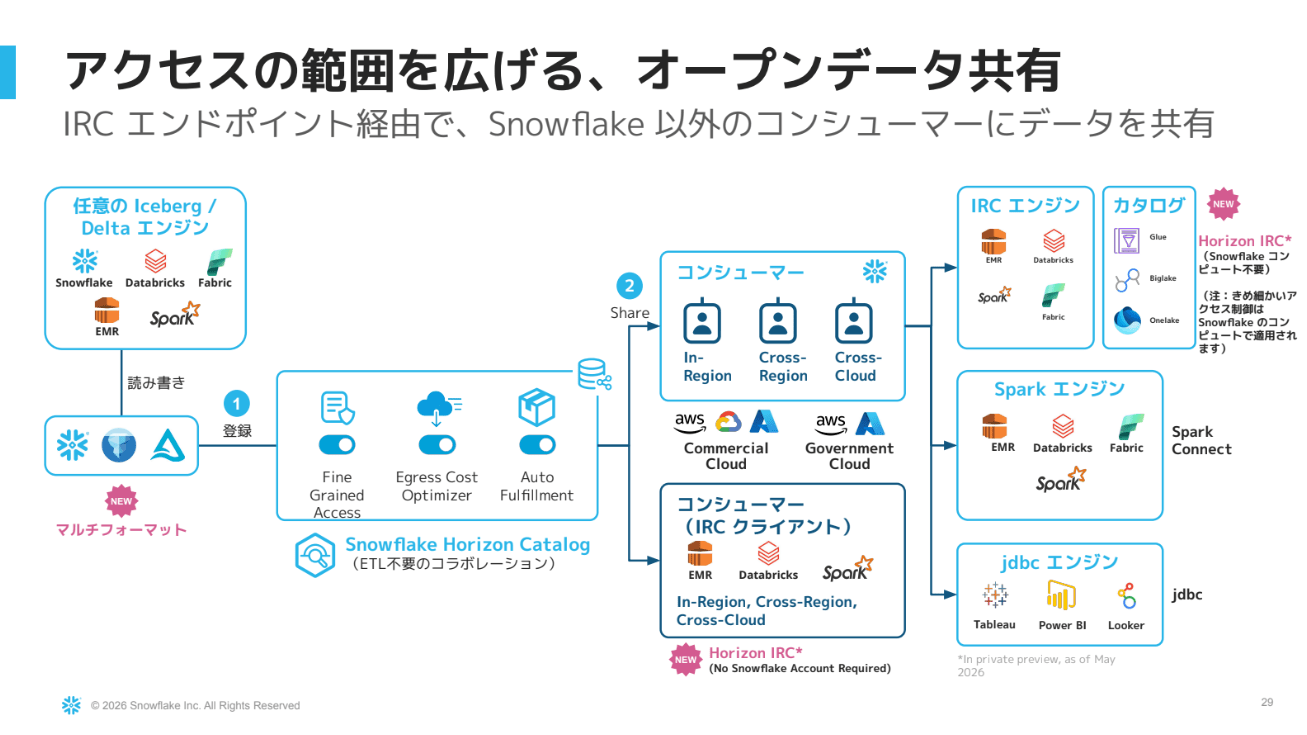
- オープン共有(Open Data Sharing、Public Preview)は、リスティング経由で40以上の IRC 対応クライアントにデータを渡せる
- external consumer という外部接続用のユーザーを作り、トークンを発行する
- 相手には URL とトークンを渡すだけ。Snowflake のアカウントは不要
- IRC 対応エンジンのほか、Spark や JDBC からも接続できる
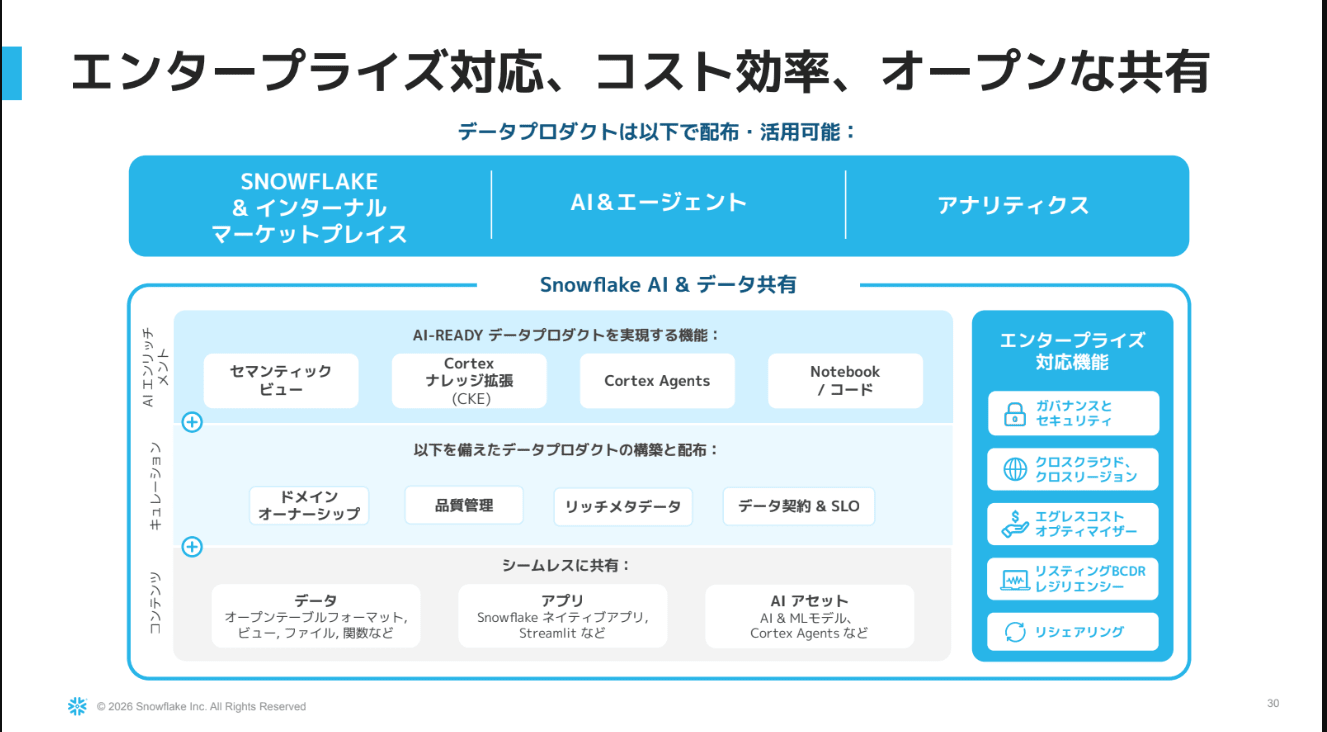
- データだけでなく、アプリケーションや AI アセットも共有できる
- ビジネスロジックを付けたまま、データプロダクトとして配れる
- ロックインへの答えは3点
- データはオープンな仕様のまま
- カタログは自社の管理下から手放した
- 共有先にも Snowflake を求めない
セッションのまとめ
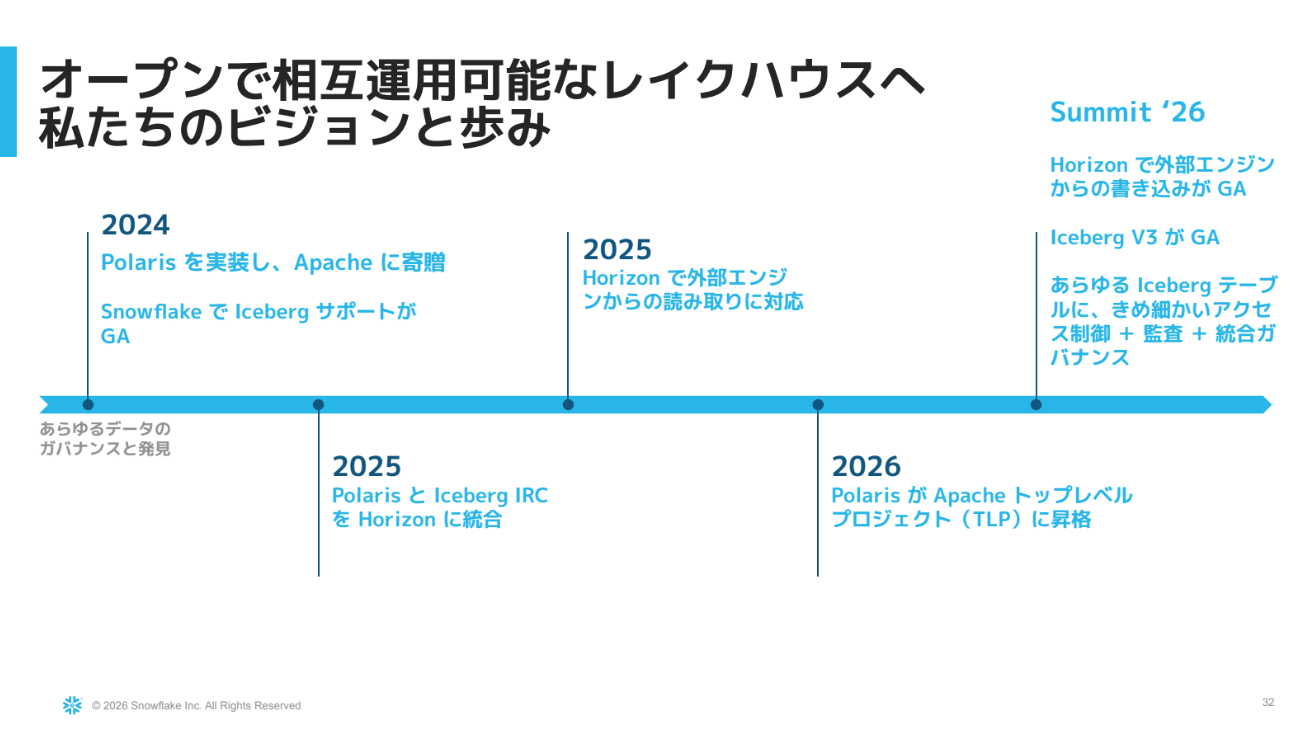
- 紹介したアップデートの狙いは1つで、「あらゆるデータのガバナンスと発見」。2年間一貫して取り組んできた
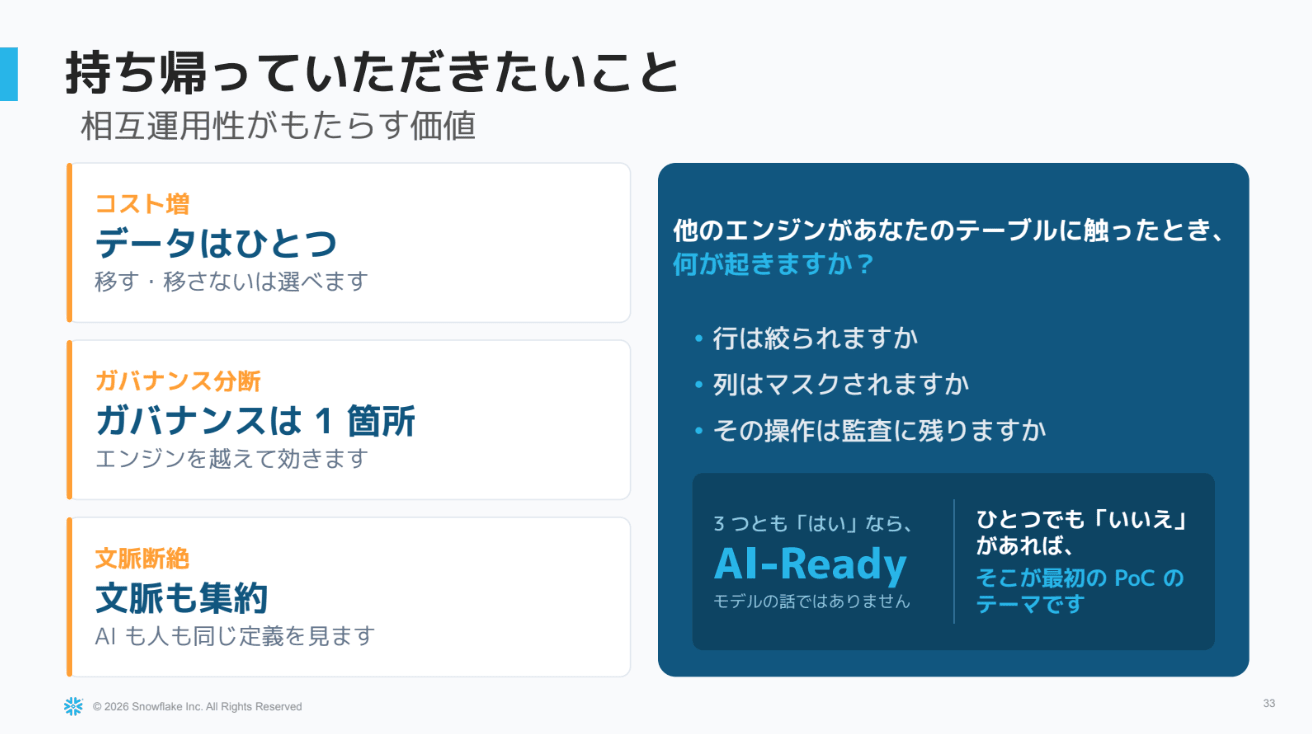
- 持ち帰ってほしい問いは「他のエンジンが自分のテーブルに触ったとき、何が起きるか」
- 行は絞られるか
- 列はマスキングされるか
- 操作は監査に残るか
- すべて「はい」なら AI-ready な環境。1つでも「いいえ」があれば、そこから PoC を始めるのがよい
関連記事
Day1 KEYNOTE のレポートはこちらです。
セッションで紹介された機能の公式ドキュメントはこちらです。
所感
Snowflake World Tour Tokyo 2026 Day2 のセッション「AI-Ready なデータ基盤の最新形 - Iceberg で拓くマルチエンジン相互運用」に参加しました。「保管・統制・共有」という3つの観点から、Iceberg を軸にした Snowflake のオープン戦略を一気通貫で理解できるセッションでした。
私自身、Iceberg 周りの全体像を十分に把握できていなかったので、今回のセッションで整理できてよかったです。
実際に検証しながら、Iceberg を利活用できるケースを模索していきます。
この記事が何かの参考になれば幸いです!