[レポート]複雑なデータ移動不要!Snowflake PostgresとUnistoreによるリアルタイムデータのAI活用 #SWTTokyo26

かわばたです。
2026年9月10日~2026年9月11日に、「SNOWFLAKE WORLD TOUR 2026 - TOKYO」が開催されました。
本記事はセッション
【複雑なデータ移動不要!Snowflake PostgresとUnistoreによるリアルタイムデータのAI活用】
のレポートブログとなります。
※セッションで紹介された機能には、開発中またはプレビュー段階のものを含みます。利用可能状況は最新の公式ドキュメントをご確認ください。
登壇者
- 榎園 健 氏
- Snowflake 第五ソリューションエンジニアリング本部 シニアソリューションエンジニア
OLTPとOLAPの間にある「レイテンシのギャップ」
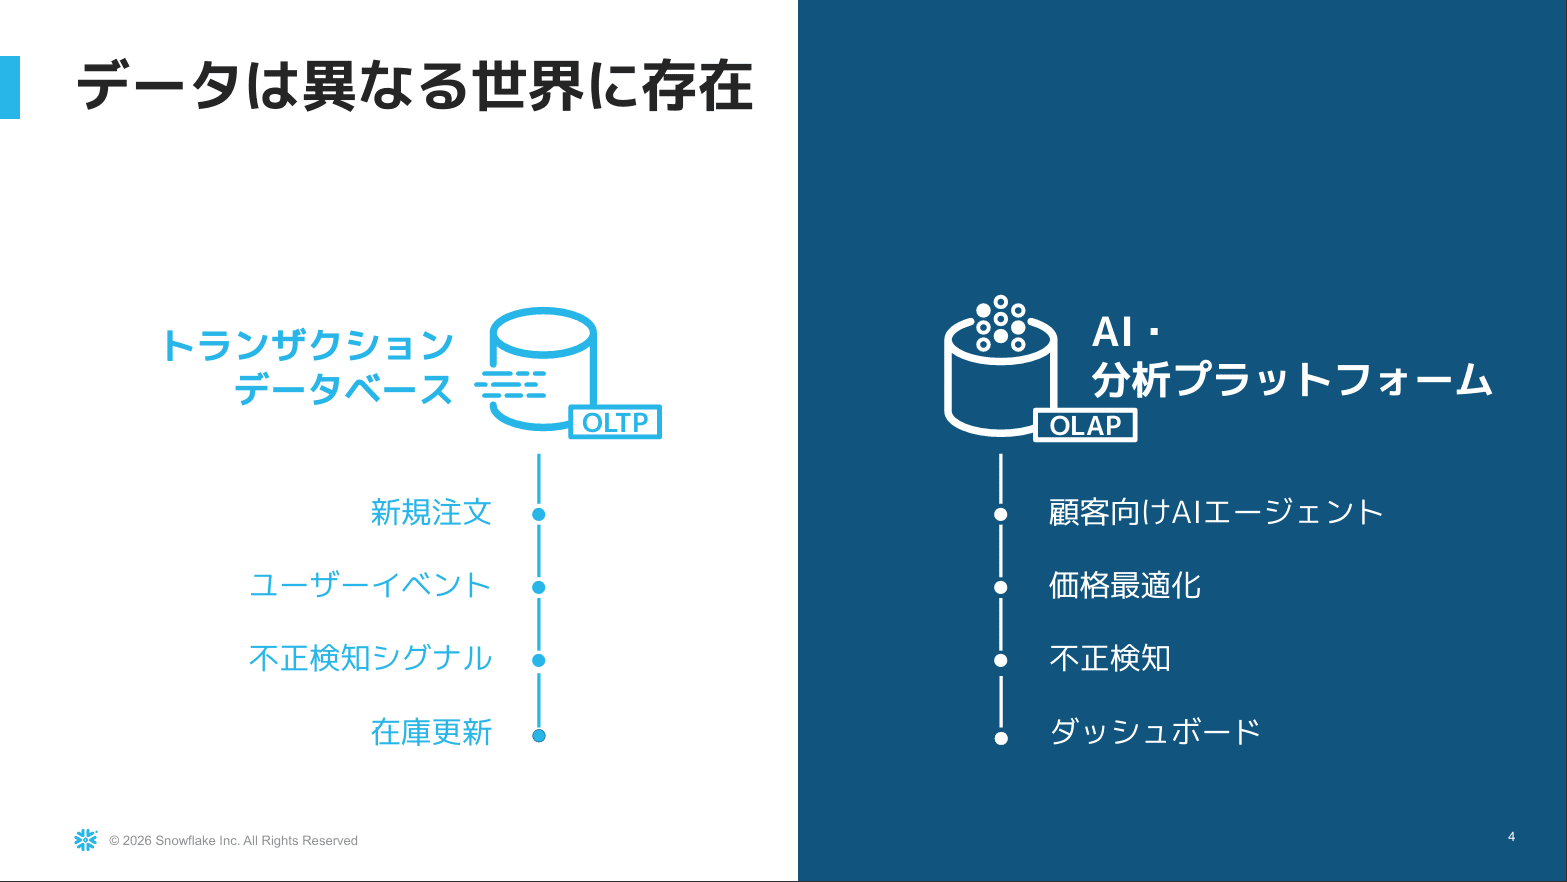
- データは OLTP(トランザクション)の世界と OLAP(分析)の世界という、異なる世界に存在している
- OLTP: 新規注文やユーザーのイベントなど、業務が動いた瞬間に流れてくるデータ。書き込みが中心
- OLAP: 書き込みは多くなく、AI や人間が落ち着いて分析していく環境
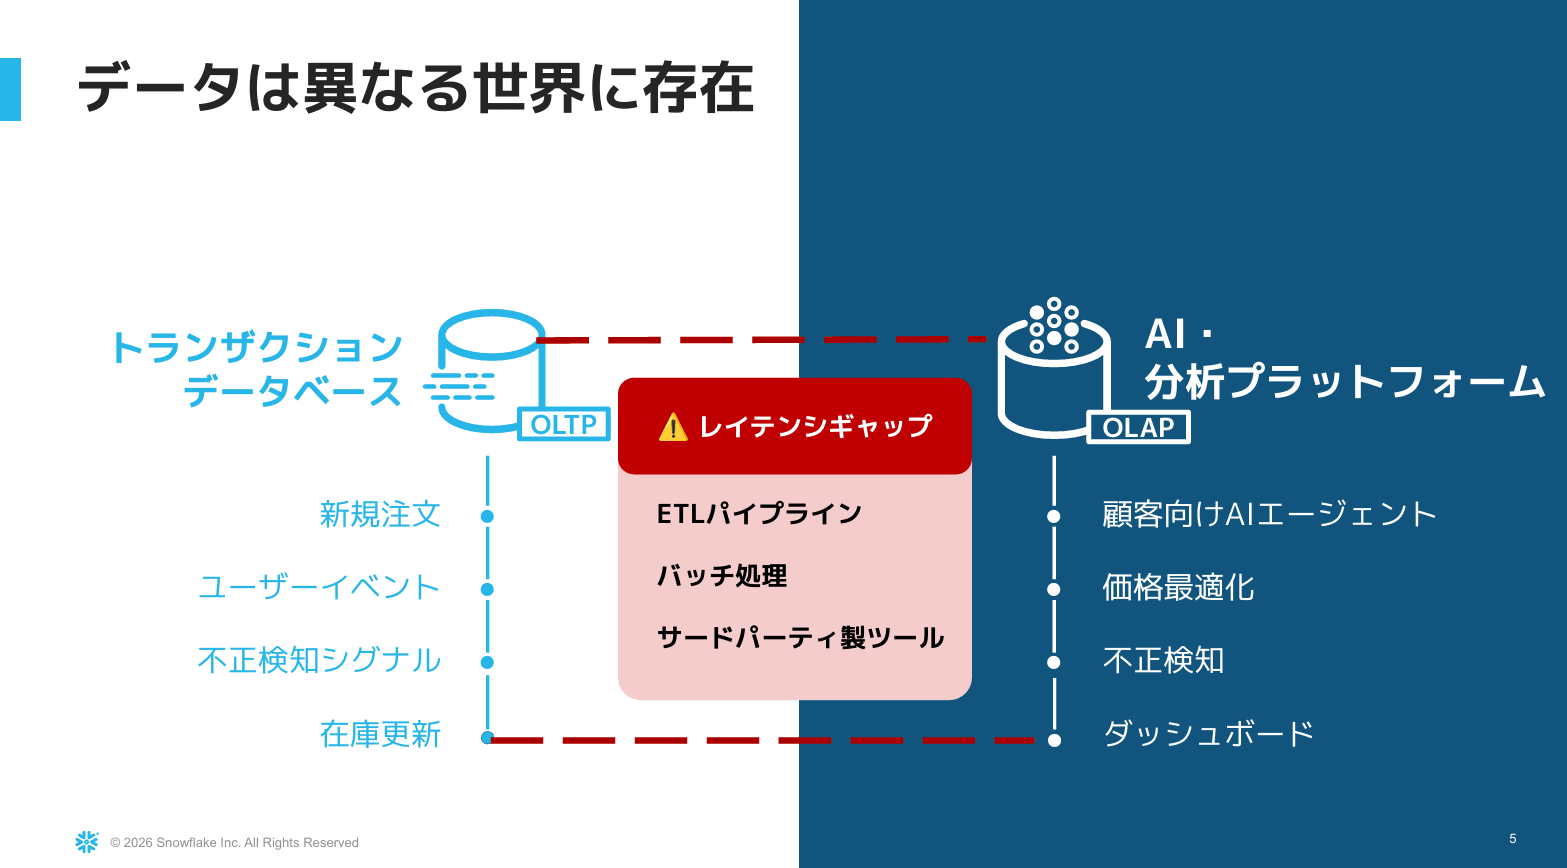
- 両者の間にはレイテンシのギャップがある
- OLTP から OLAP へデータを移すには、ETL や、1日1回・数時間に1回のバッチ処理、別のツールが必要になる
- どこで失敗したかの解析や、どうリカバリするかの検討など、運用負荷がつきまとう
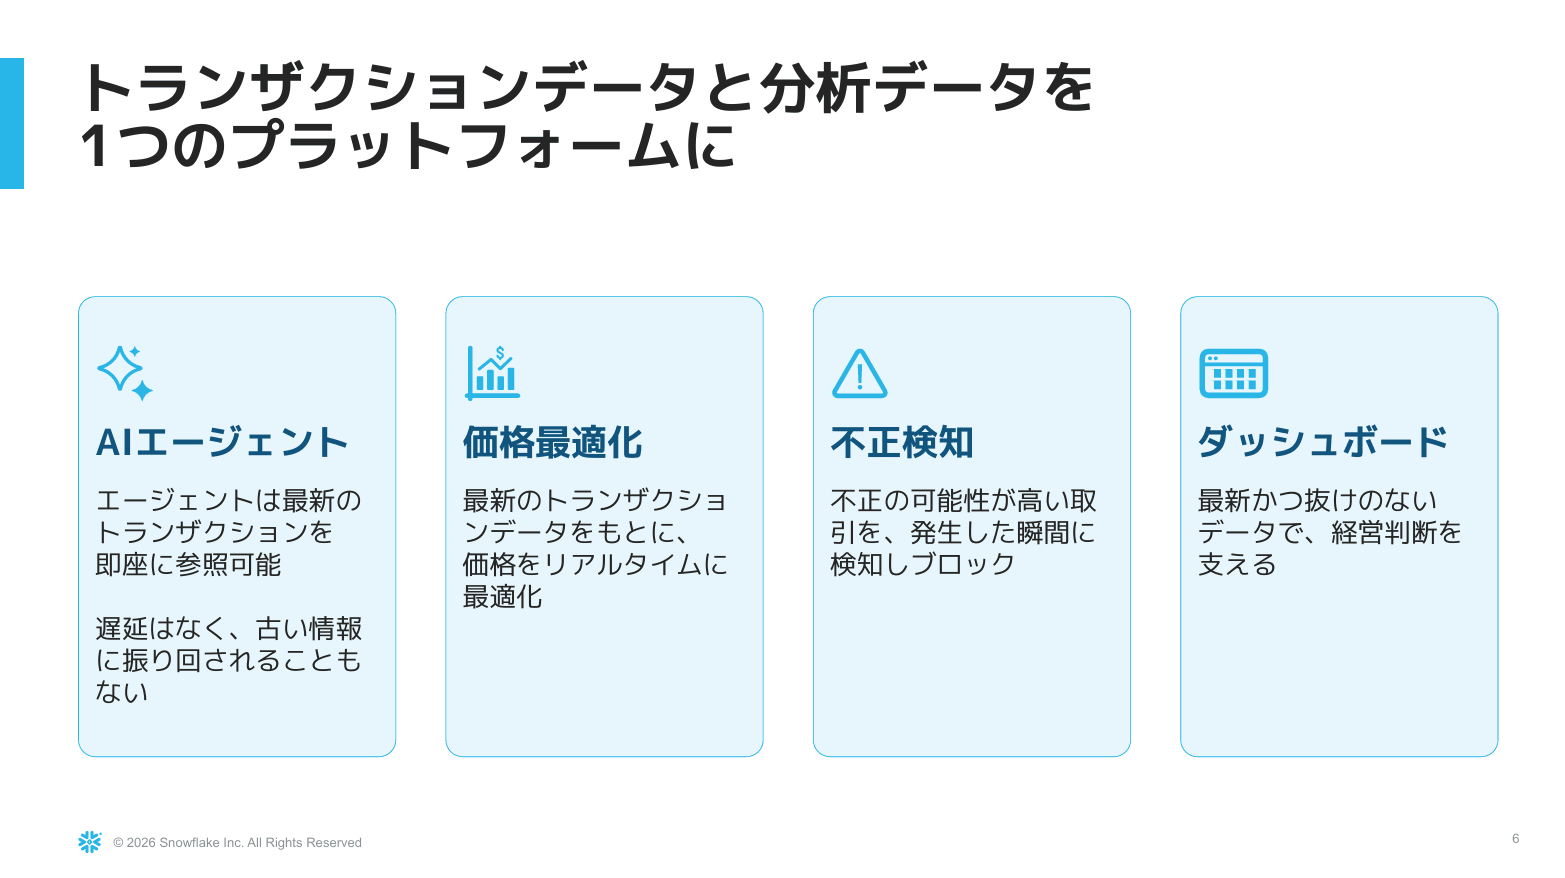
- Snowflake の考え方は、このギャップを取り払い、1つのプラットフォームで実現すること
- 時間差がなくなると、次のことができるようになる
- AI エージェントが最新の取引データを参照して、ユーザーの質問に回答する
- 価格の最適化などをリアルタイムなデータで行う
- ダッシュボードで最新に近いデータを確認しながら、正しい経営判断を下す
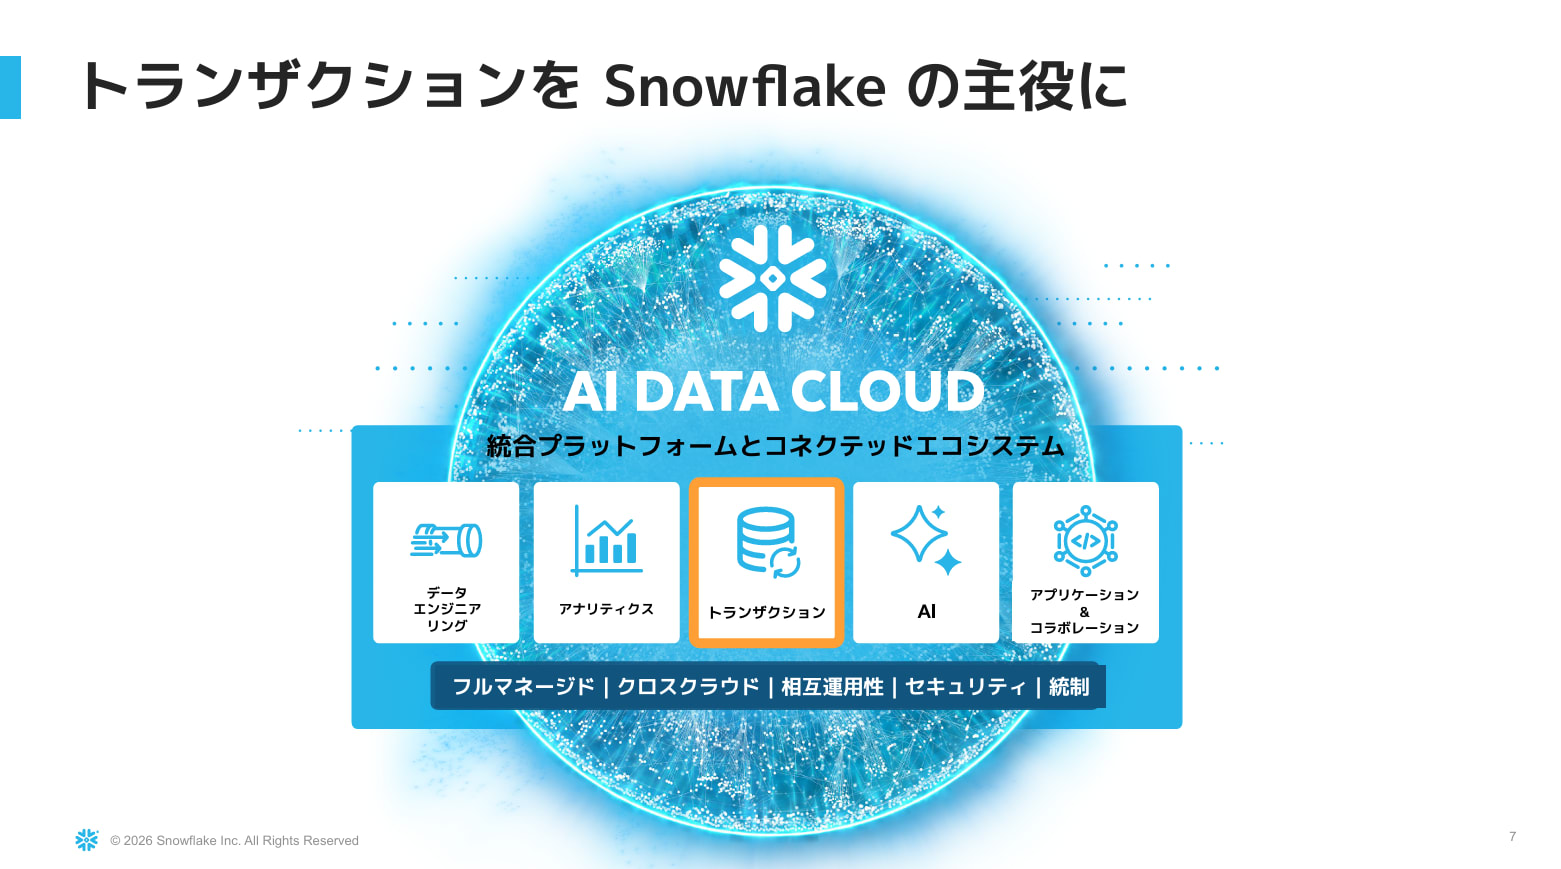
- Snowflake はトランザクションを大きな柱の1つと位置づけており、AI Data Cloud の5つの柱の1つに入っている
トランザクションを扱う2つの道
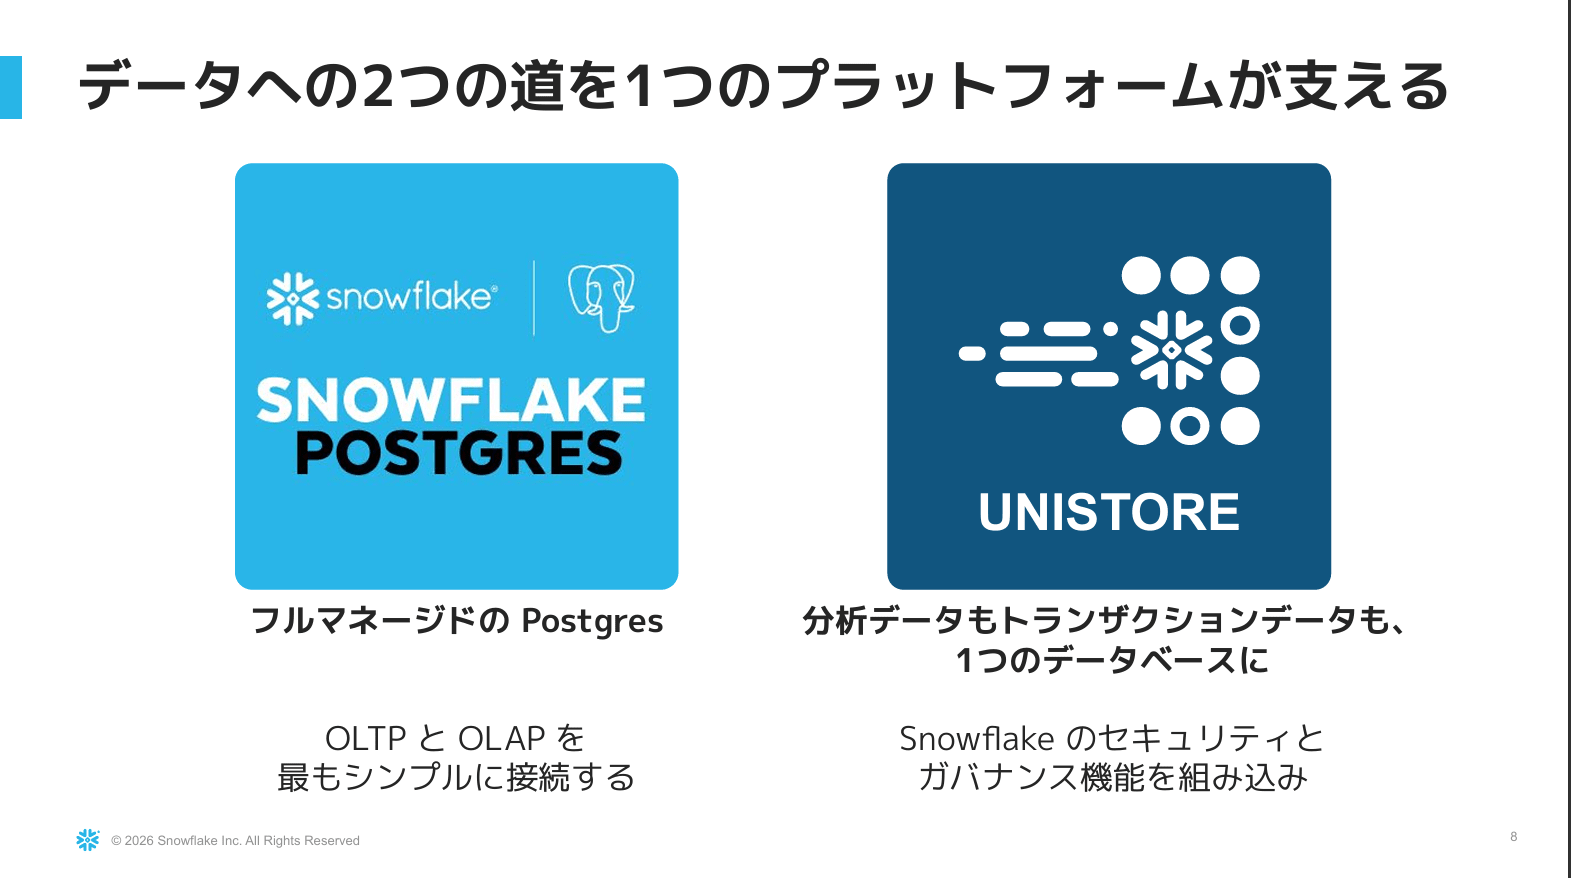
Snowflake でトランザクションを扱う選択肢として、次の2つが示されました。
| Snowflake Postgres | Unistore(ハイブリッドテーブル) | |
|---|---|---|
| 位置づけ | Snowflake がフルマネージドで運用する Postgres | Snowflake ネイティブのテーブル |
| データの持ち方 | トランザクションは Postgres 側。分析用に Snowflake へ連携する | トランザクションと分析を1つのテーブルで管理する |
| ポイント | Snowflake の分析の世界とどう繋ぐか(データミラーリング、pg_lake) | Snowflake のセキュリティ・ガバナンス機能がそのまま組み込まれている |
セッションの前半は Snowflake Postgres、後半は Unistore の紹介でした。
Snowflake Postgres
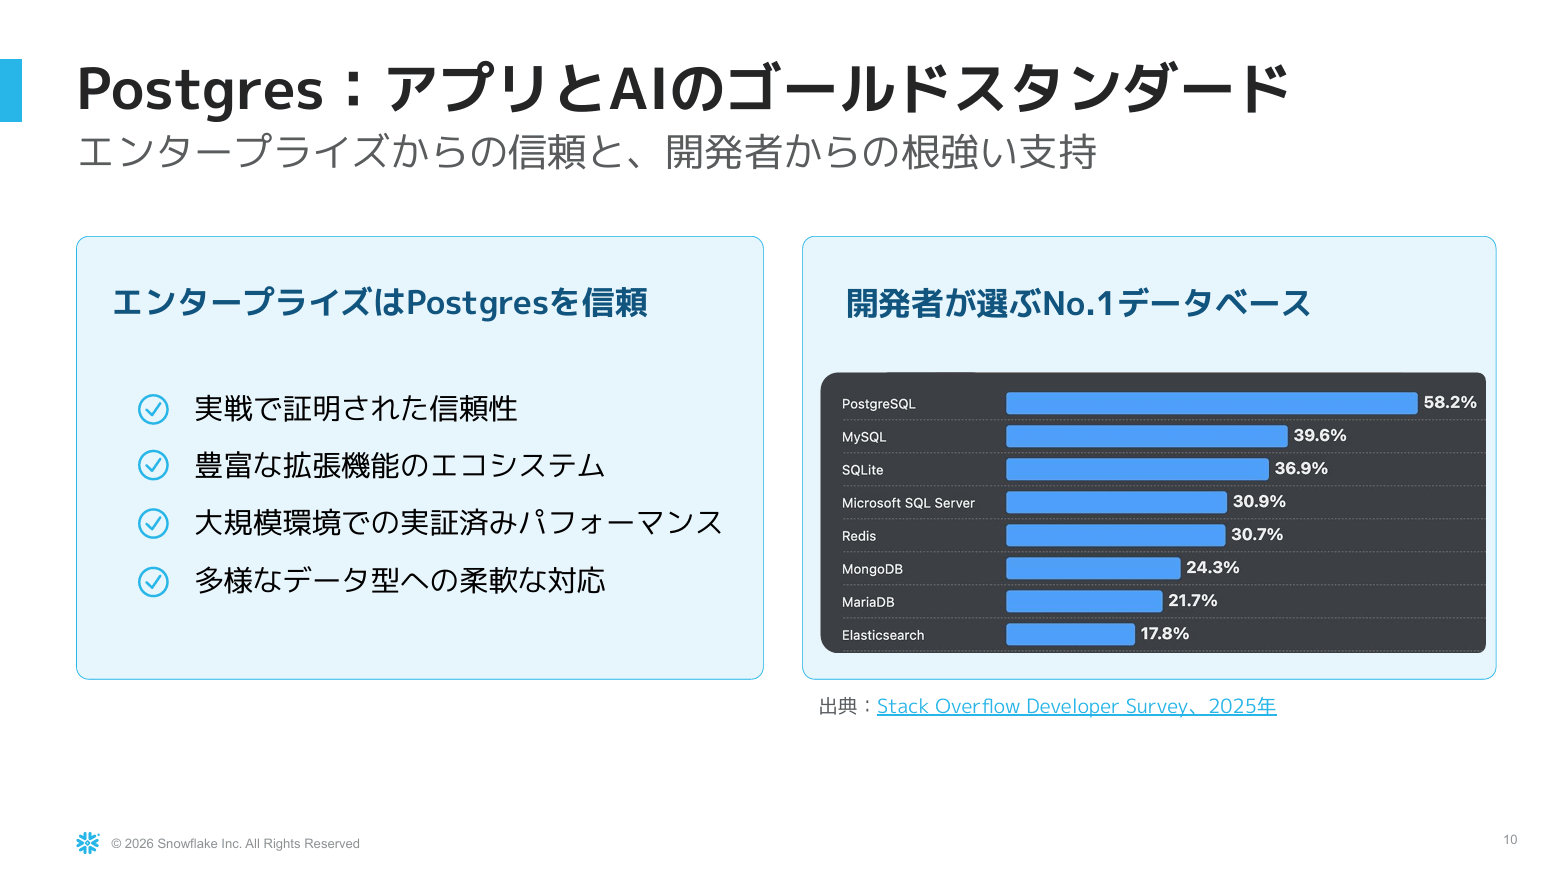
- Postgres は今もエンタープライズ企業や開発者から圧倒的に高い評価を得ているスタンダード
- 2025年の Stack Overflow Developer Survey でも、開発者に選ばれ続けている
- 2025年に Postgres に強い Crunchy Data を買収したことをきっかけに、Snowflake Postgres が登場した
- 2026年2月24日に一般提供(GA)を開始
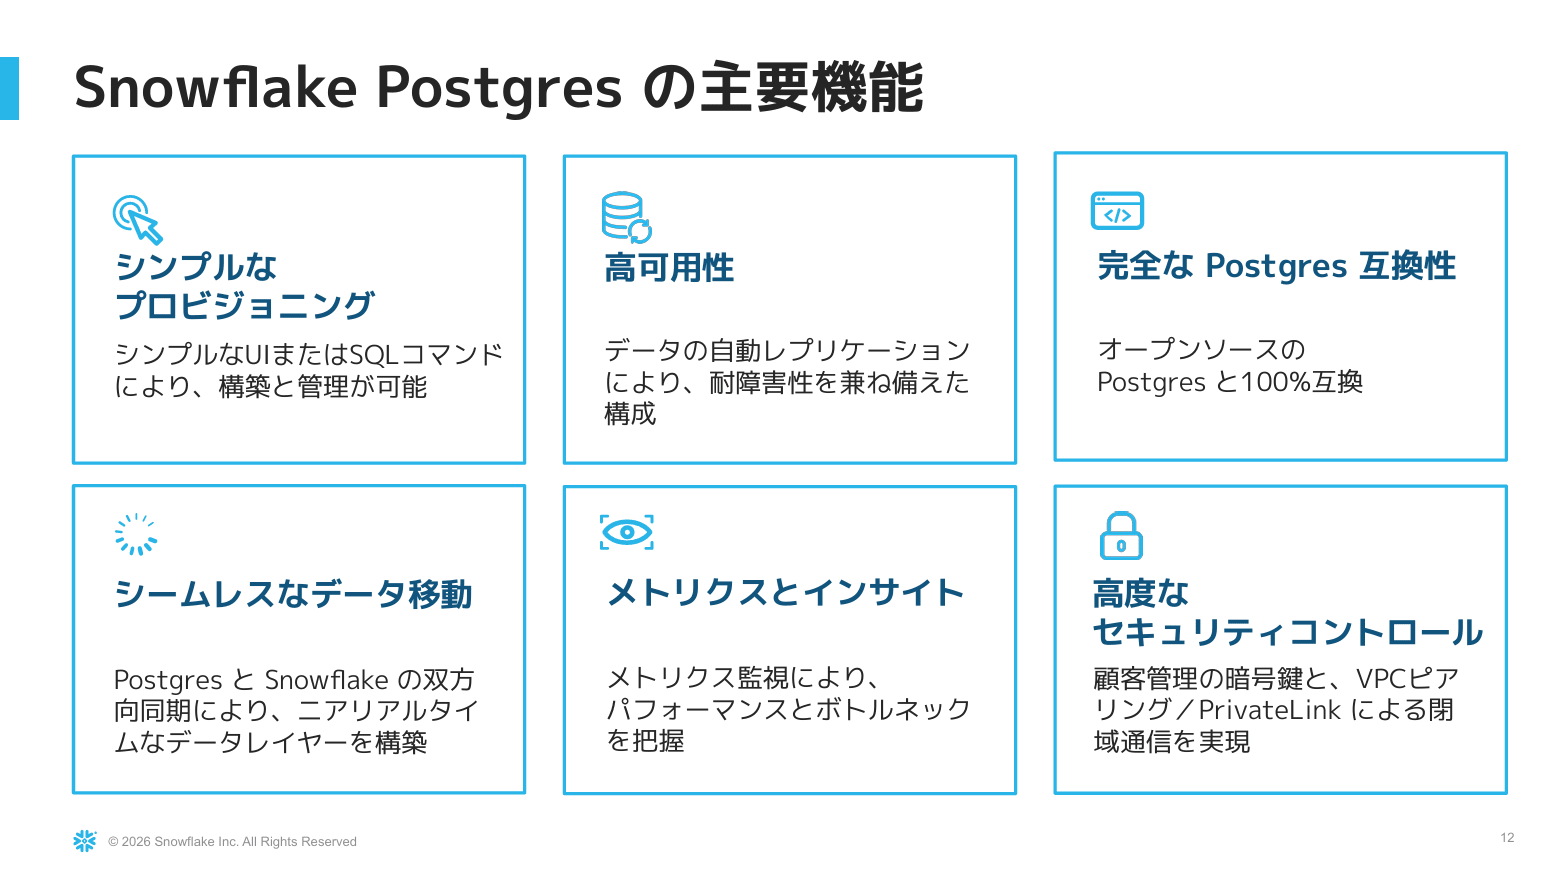
- 主要機能として次の6つが紹介された
- シンプルなプロビジョニング: UI で設定を入れていくだけでインスタンスを作成できる
- 高可用性
- 完全な Postgres 互換性
- シームレスなデータ移動: Postgres から Snowflake ネイティブの分析の世界へデータを持ってくる
- メトリクス監視によるパフォーマンスボトルネックの把握
- Snowflake の特徴を活かした高度なセキュリティコントロール
データミラーリング
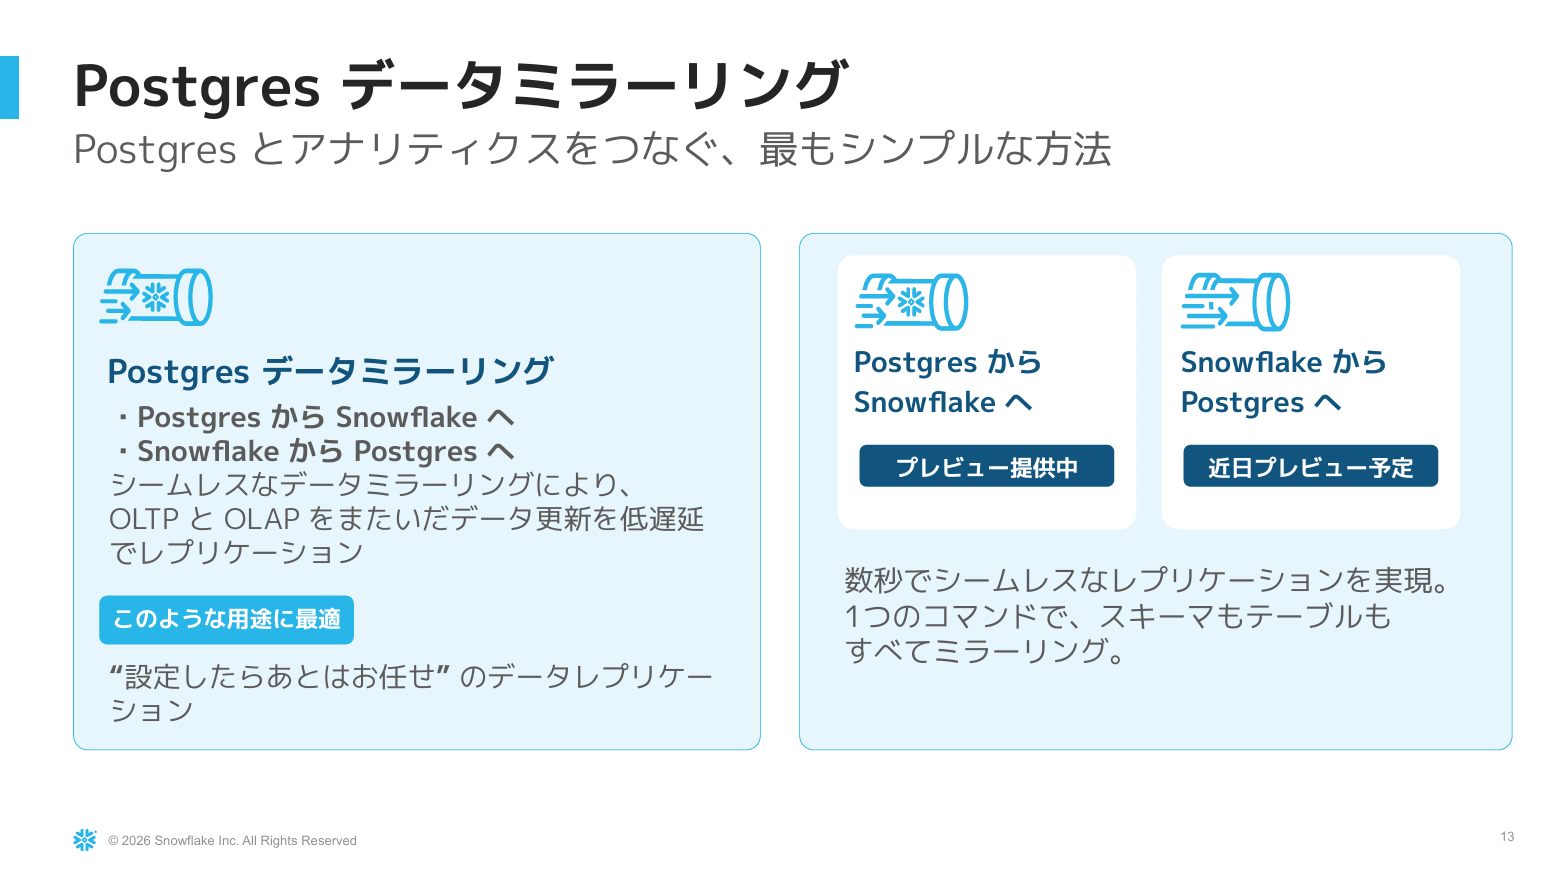
- Postgres のデータを Snowflake の分析環境に繋ぐ、最もシンプルな方法。現在はプレビュー機能
- Snowflake から Postgres への逆方向のミラーリングは、近日プレビュー予定
- 想定する使い分けは、日々の登録や業務処理は Postgres で行い、その最新状態を Snowflake に連携して BI・AI・SQL で分析する形
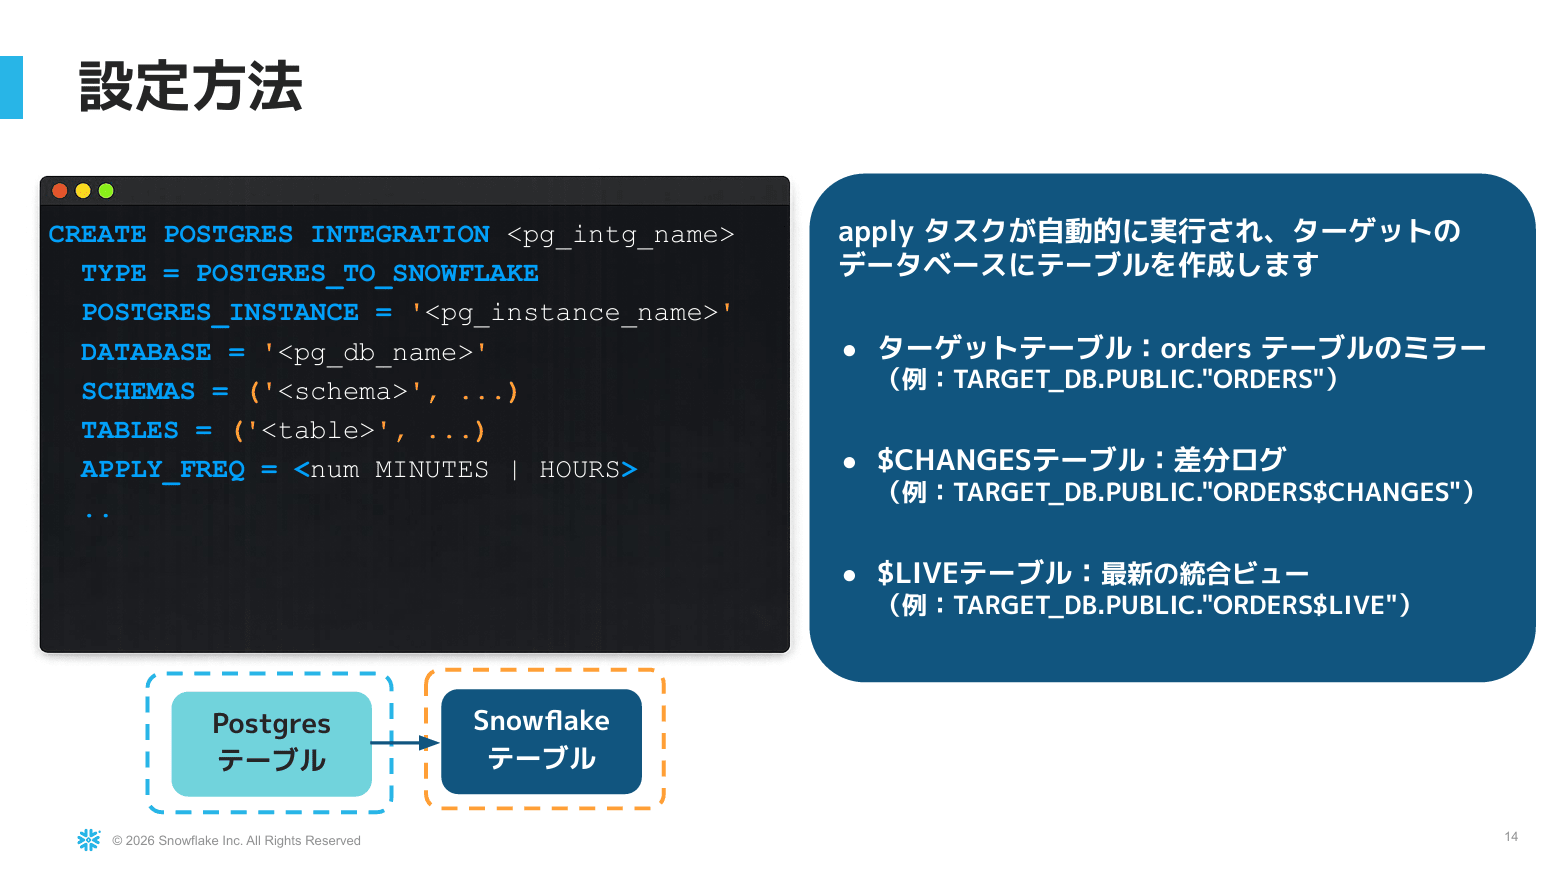
- 設定は Snowsight の GUI からも SQL からも作成できる。Postgres のどのインスタンスのどのデータベースをミラーリングするかを指定する
ミラーリングを設定すると、Snowflake 側に3種類のオブジェクトが作られます。
| オブジェクト | 内容 |
|---|---|
| ターゲットテーブル | 実際にデータがミラーリングされて書き込まれるテーブル |
$changes テーブル |
データそのものではなく、テーブルに対する変更履歴(差分ログ)を保持する |
$live ビュー |
ターゲットテーブルと未反映の変更を統合した最新ビュー。ターゲットテーブルより先に更新される |
より最新の状態を見たい場合は $live ビューを、ミラーリングが確定した後のデータを見たい場合はターゲットテーブルを参照する、という使い分けになります。
デモ:ミラーリングしたデータをSnowflake CoWorkで分析
デモは動画ベースで、登壇者のデモ環境を使って進められました。
-
Snowsight の Postgres に ORDERS・ORDER_ITEMS・CUSTOMERS を構築し、GUI でデータミラーリングを設定
-
ミラーリングデータを Snowflake のセマンティックビュー経由で Cortex Agent/CoWork から自然言語分析
-
Postgres に追加した注文データは同期後すぐ分析へ反映され、最新日付やカテゴリ別売上ランキングも更新
-
分析の出口は AI エージェントに限らず、BI ダッシュボードや SQL でも同様に最新データを参照できる
pg_lake
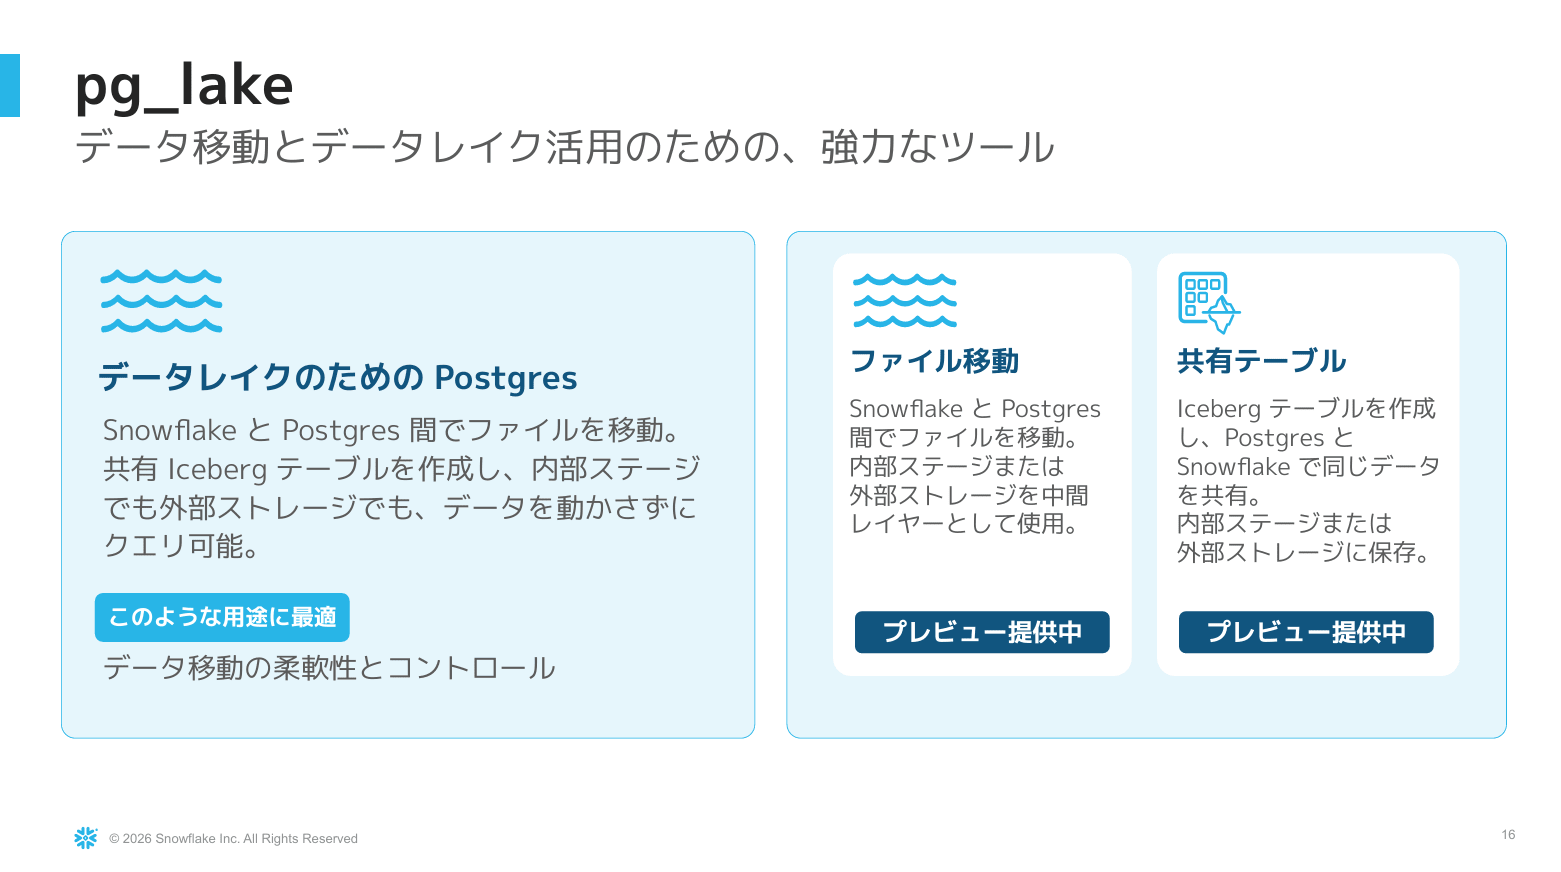
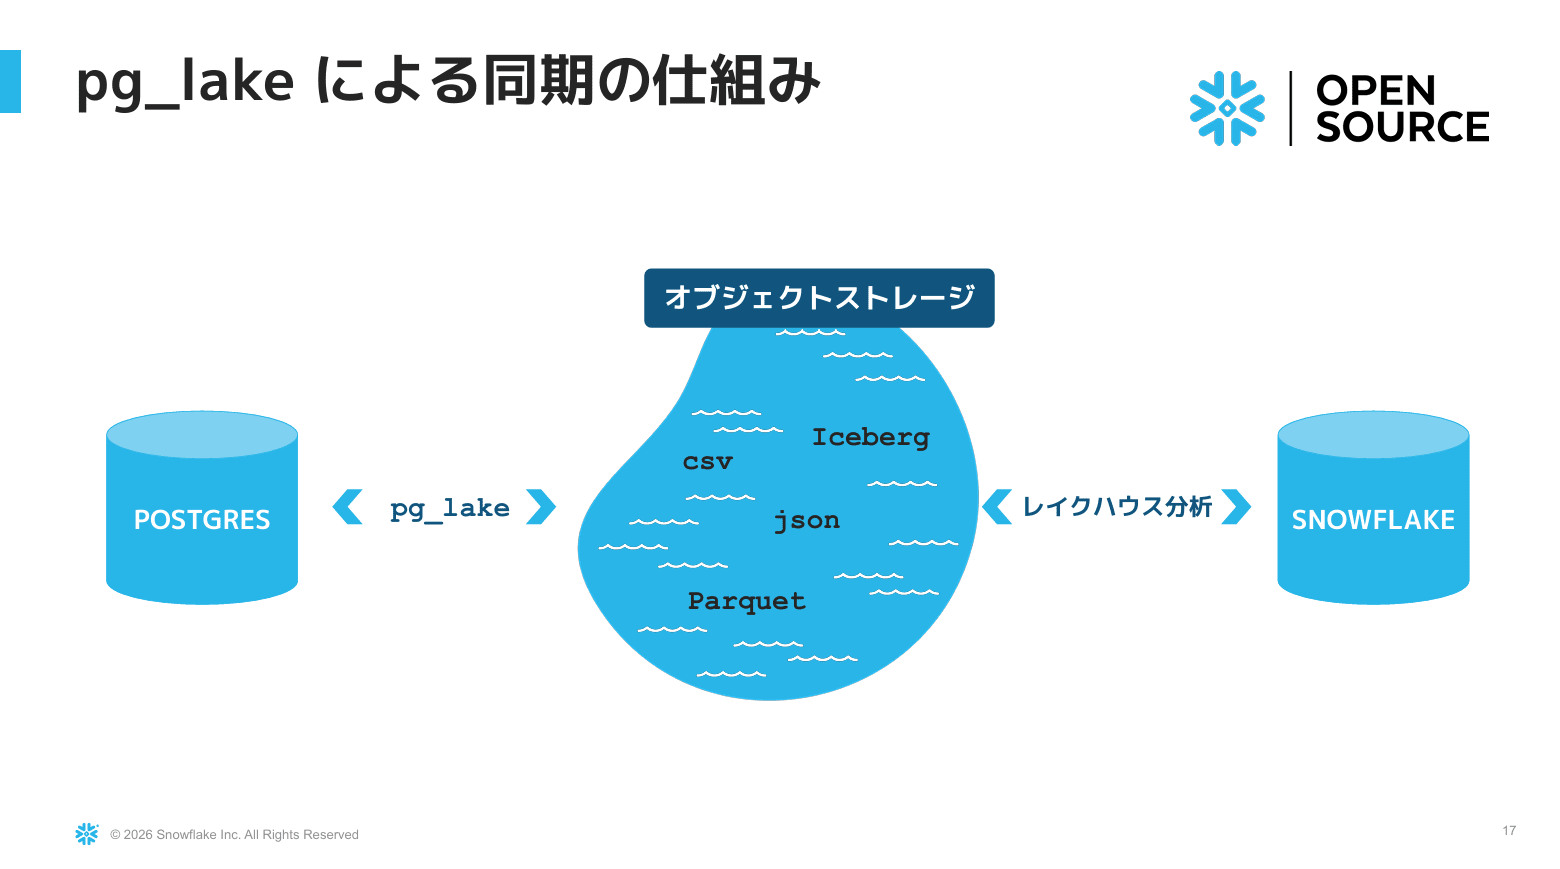
- pg_lake は「データレイクのための Postgres」と紹介された。Postgres と Snowflake の連携方法は2つ
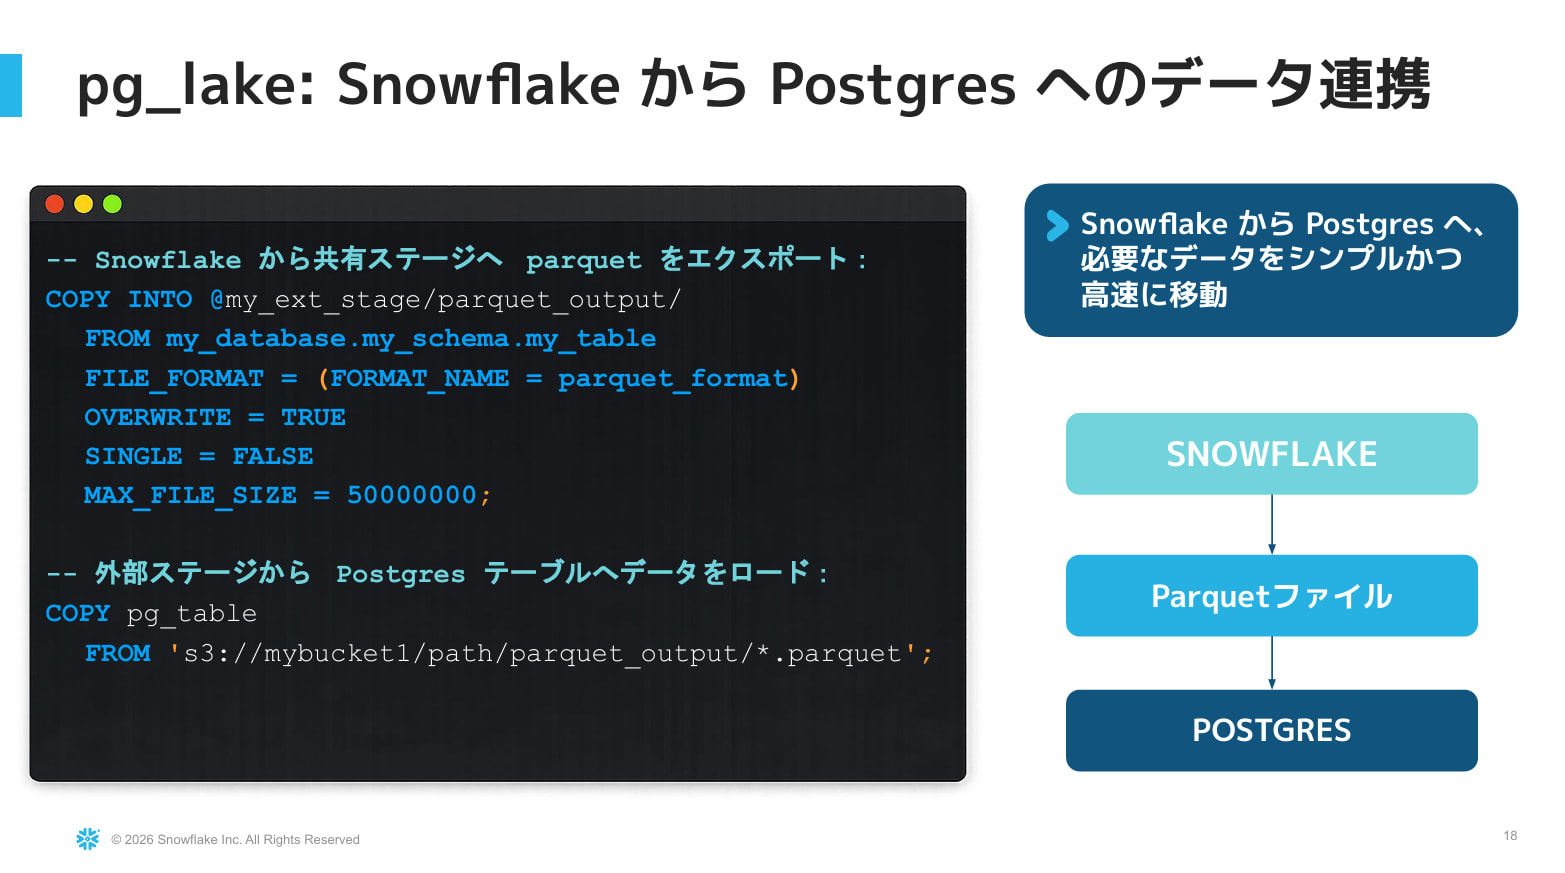
- パターン1: ファイル経由
- Postgres から pg_lake を使って、オブジェクトストレージへ CSV や Parquet を書き出す
- Snowflake 側では、そのままテーブルにロードするか、Iceberg テーブルとして参照する
- この経路を使うと、Snowflake から Postgres へのデータ連携も現時点で可能。ミラーリングの逆方向が提供されるまでの選択肢になる
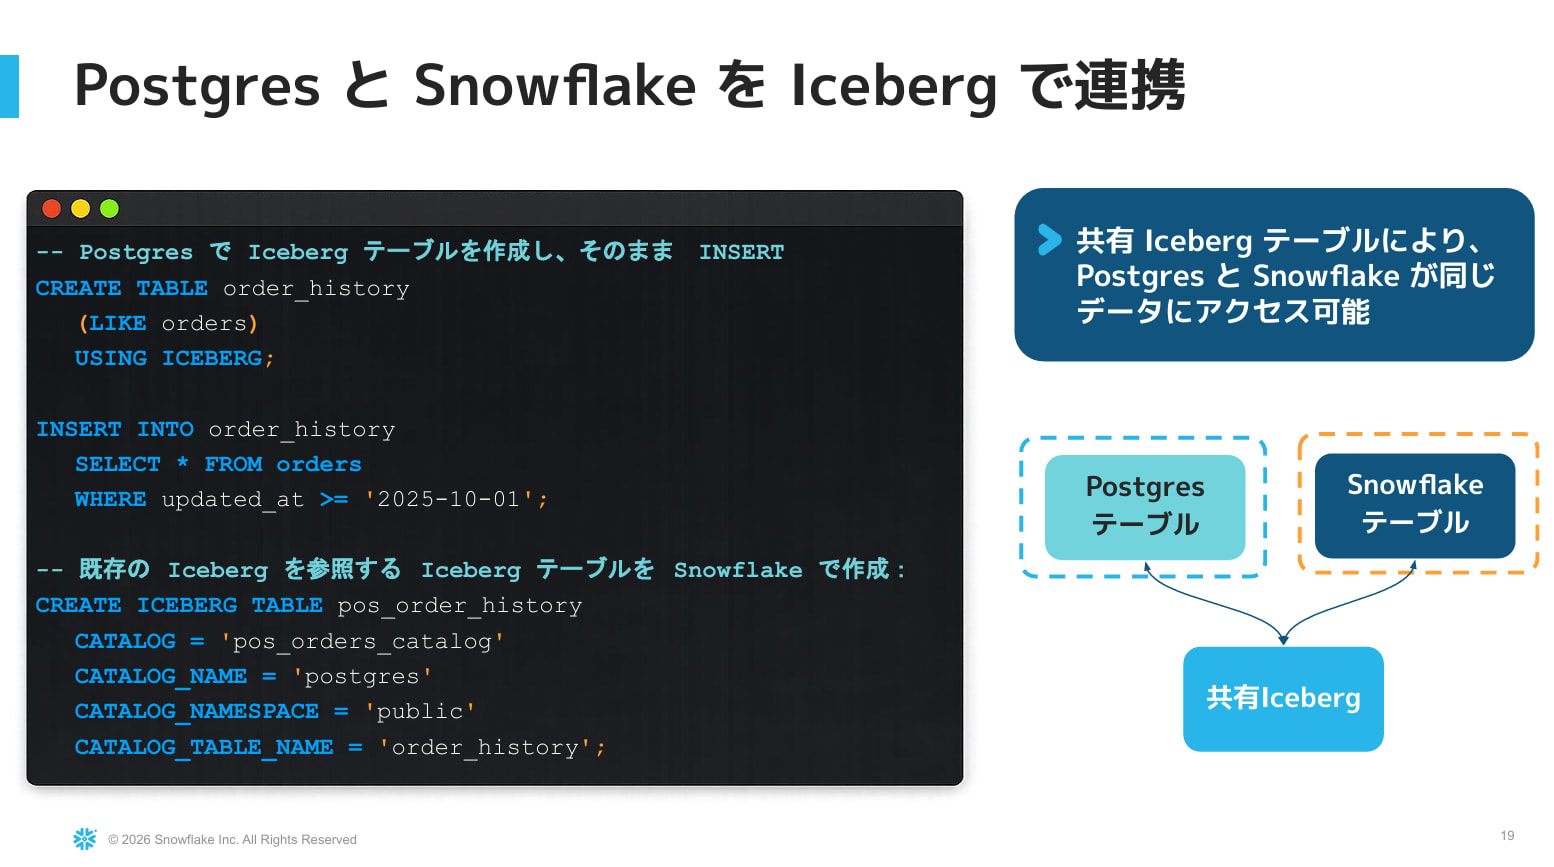
- パターン2: Iceberg テーブルの共有
- Postgres 側で
CREATE TABLE ... USING icebergで Iceberg テーブルを作り、必要なデータを INSERT する - Snowflake 側では
CREATE ICEBERG TABLEでカタログとカタログテーブル名を指定して参照する - メタデータと実データはオブジェクトストレージ上にあり、データを複製せずに Postgres と Snowflake の両方から同じテーブルを扱える
- Postgres 側で
Unistore(ハイブリッドテーブル)
概要
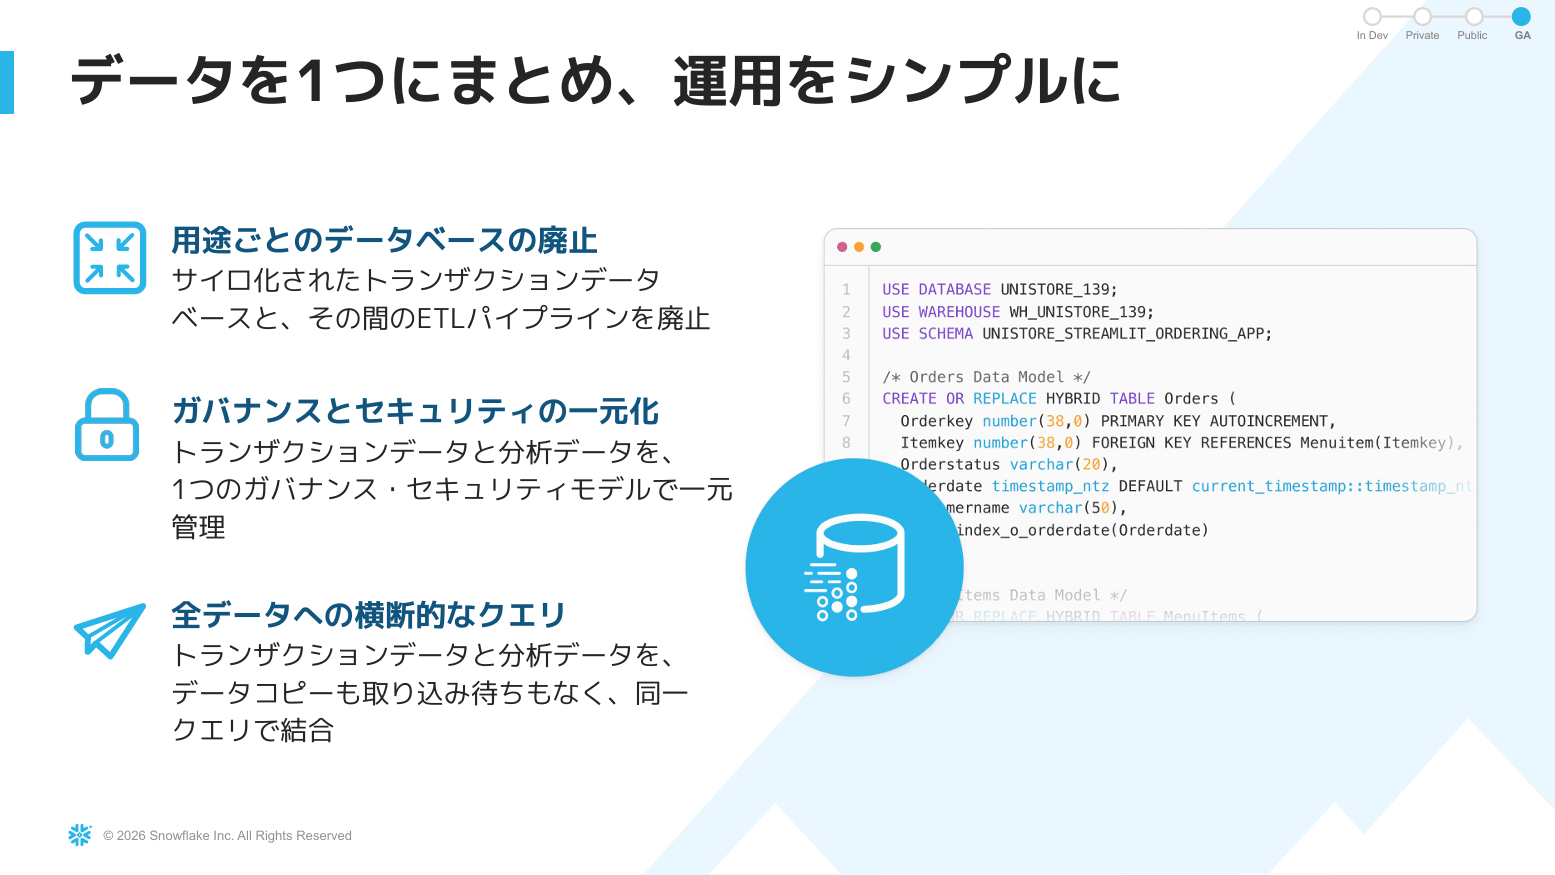
- 2つの道の右側。データベースや ETL を増やさず、ガバナンスを一元管理し、トランザクションと分析のデータを同じ SQL で扱う
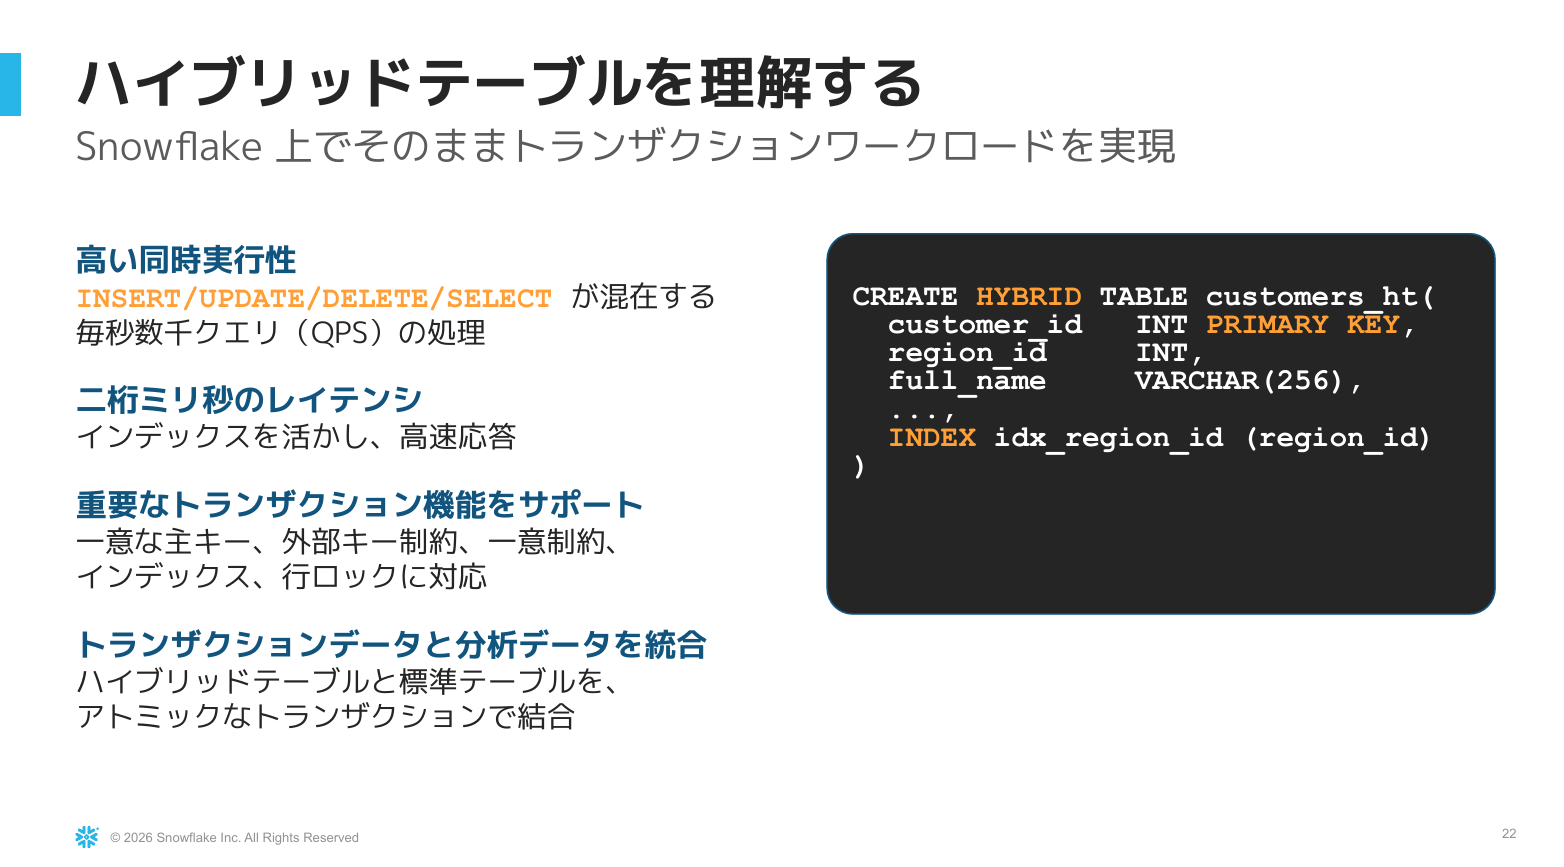
CREATE HYBRID TABLEで主キーなどを指定して作成する- INSERT・UPDATE・DELETE・MERGEなどのDMLとSELECTを組み合わせた処理を高速に実行できる
- ACID トランザクションをサポートし、標準テーブルとの統合(JOIN など)が可能
- セッションでは、世界で数千社が本番環境で利用していると紹介された
直近の進化
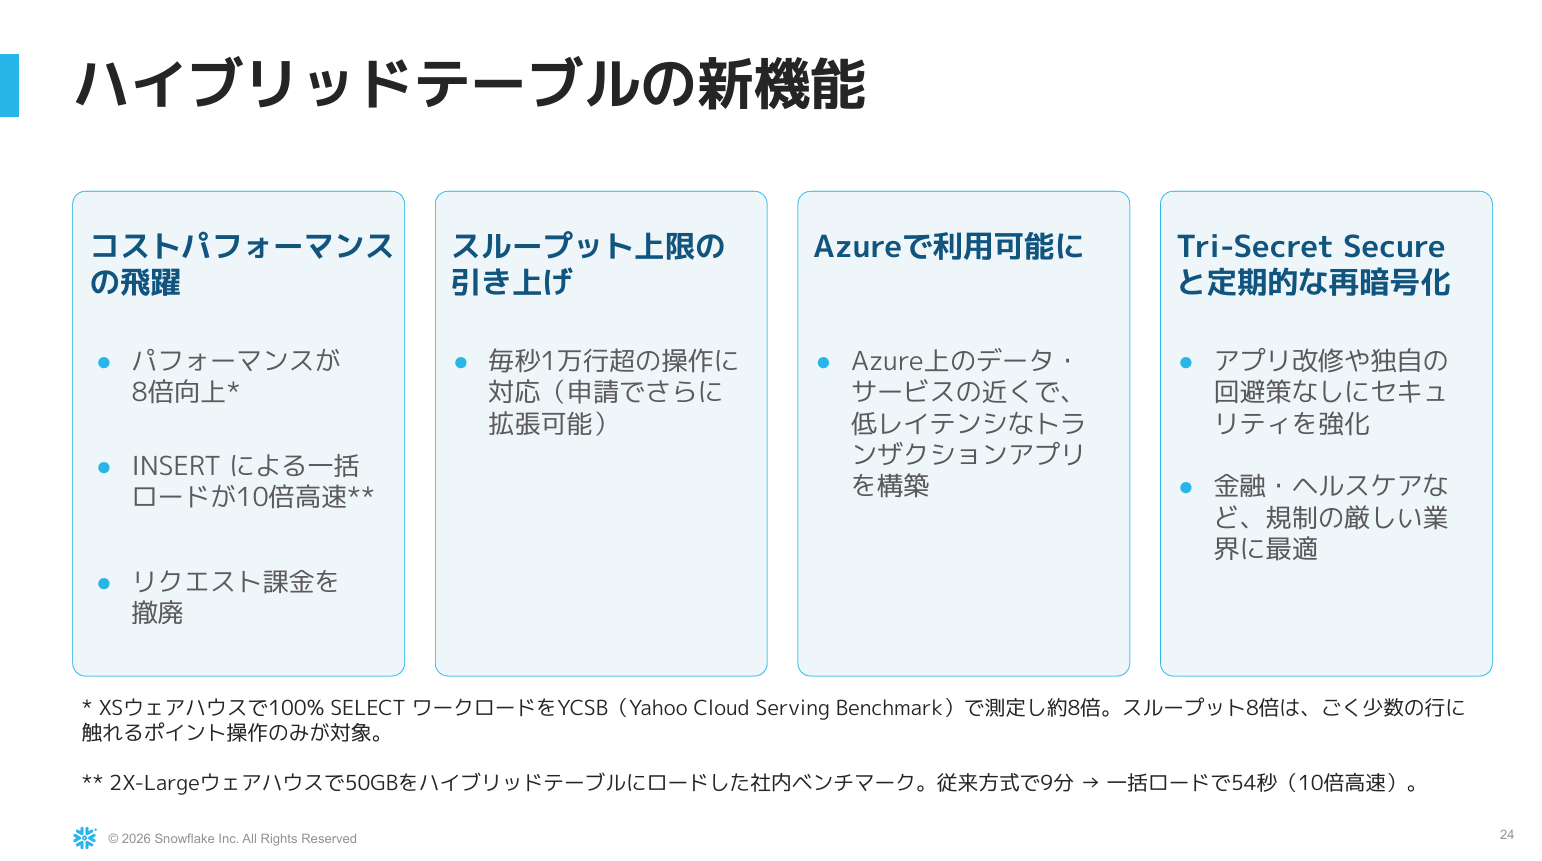
- コストパフォーマンスの飛躍
- ポイント操作のパフォーマンスが最大8倍向上(後述)
- INSERT によるバルクロードも高速化
- Azure でも利用可能になった
- Tri-Secret Secure 暗号化に対応
- Snowflake が用意する鍵だけでなく、顧客が持つ鍵も使ってテーブルを暗号化する
- ハイブリッドテーブルで使うには、専用のストレージモード(Hybrid Tables Dedicated Storage Mode)が必要
- 既存テーブルにはすぐ適用できず、作り直しが必要になる
ポイントルックアップの高速化(プレビュー)
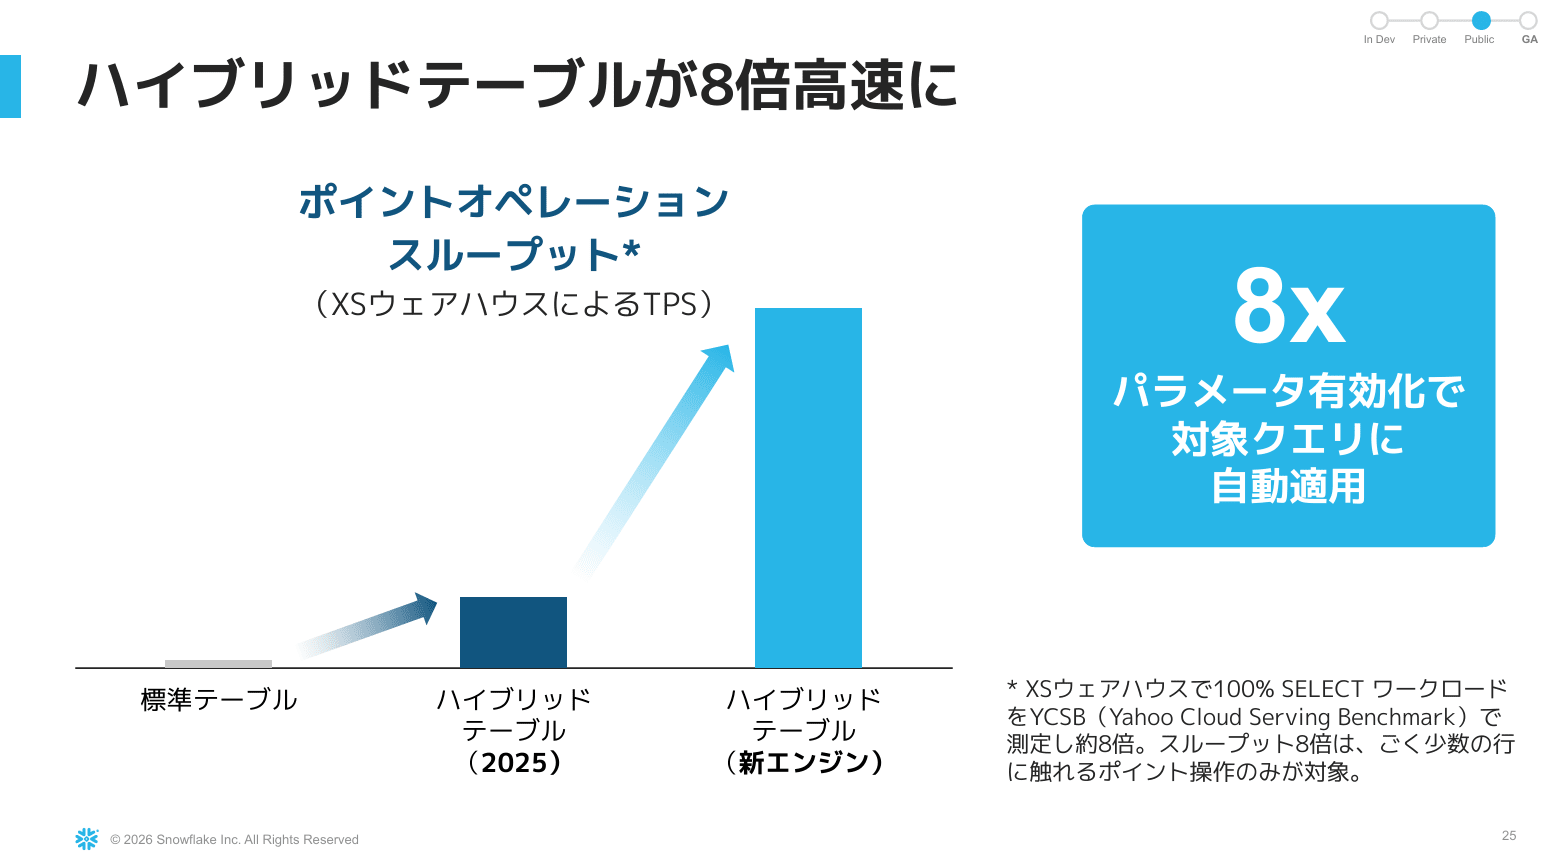
- ごく少数の行に触れるポイント操作のクエリが対象。大量レコードの中から特定日付の特定の売上だけを探すような検索
- パラメーターを有効化すると自動的に最適なプランが適用され、最大8倍ほど高速になると実測されている
- まだプレビュー段階。GA になれば有効化された状態で使える
リクエストクレジット課金の廃止
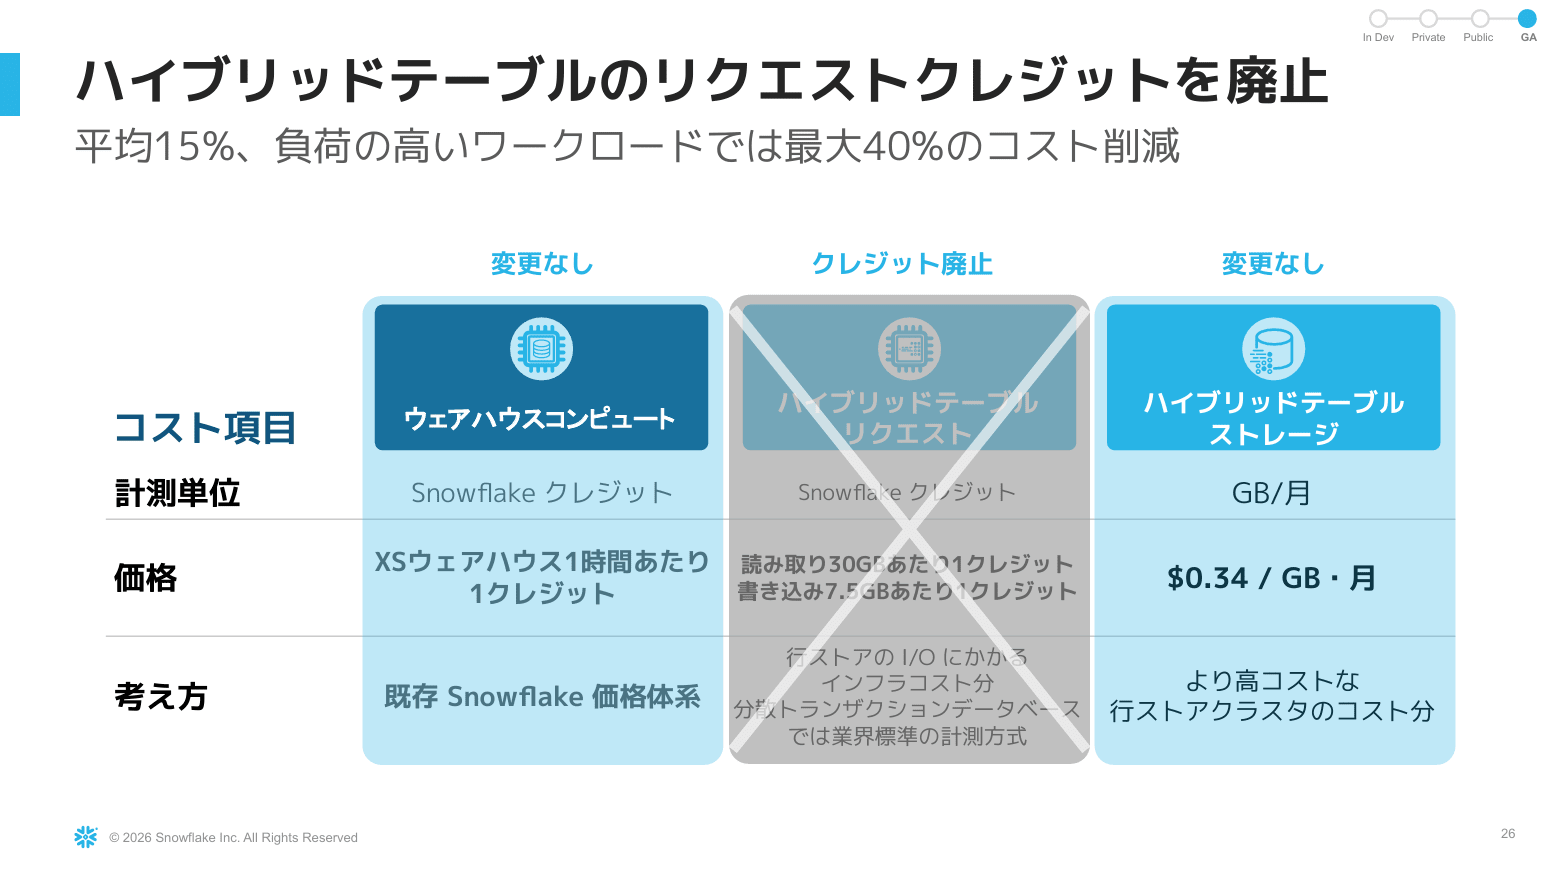
- ハイブリッドテーブルのコストは3つの要素から成り、そのうち「リクエストクレジット」の課金を廃止した
- ウェアハウスのコンピュートクレジットと、ハイブリッドテーブルのストレージコストはこれまで通りかかる
- リクエストクレジットは、行ストレージへの読み取り・書き込みの IO に対して課金されていたもの
- セッションでは、読み取り30GB、書き込み7.5GBごとに1クレジットを消費する料金体系として説明されていた
- IO にかかるインフラコストを顧客に負担させるべきではないという考えから、Snowflake 側で負担する形に今年変更された
- 負荷の高いワークロードでは、最大40%のコスト削減につながった顧客実績がある
主要ワークロード
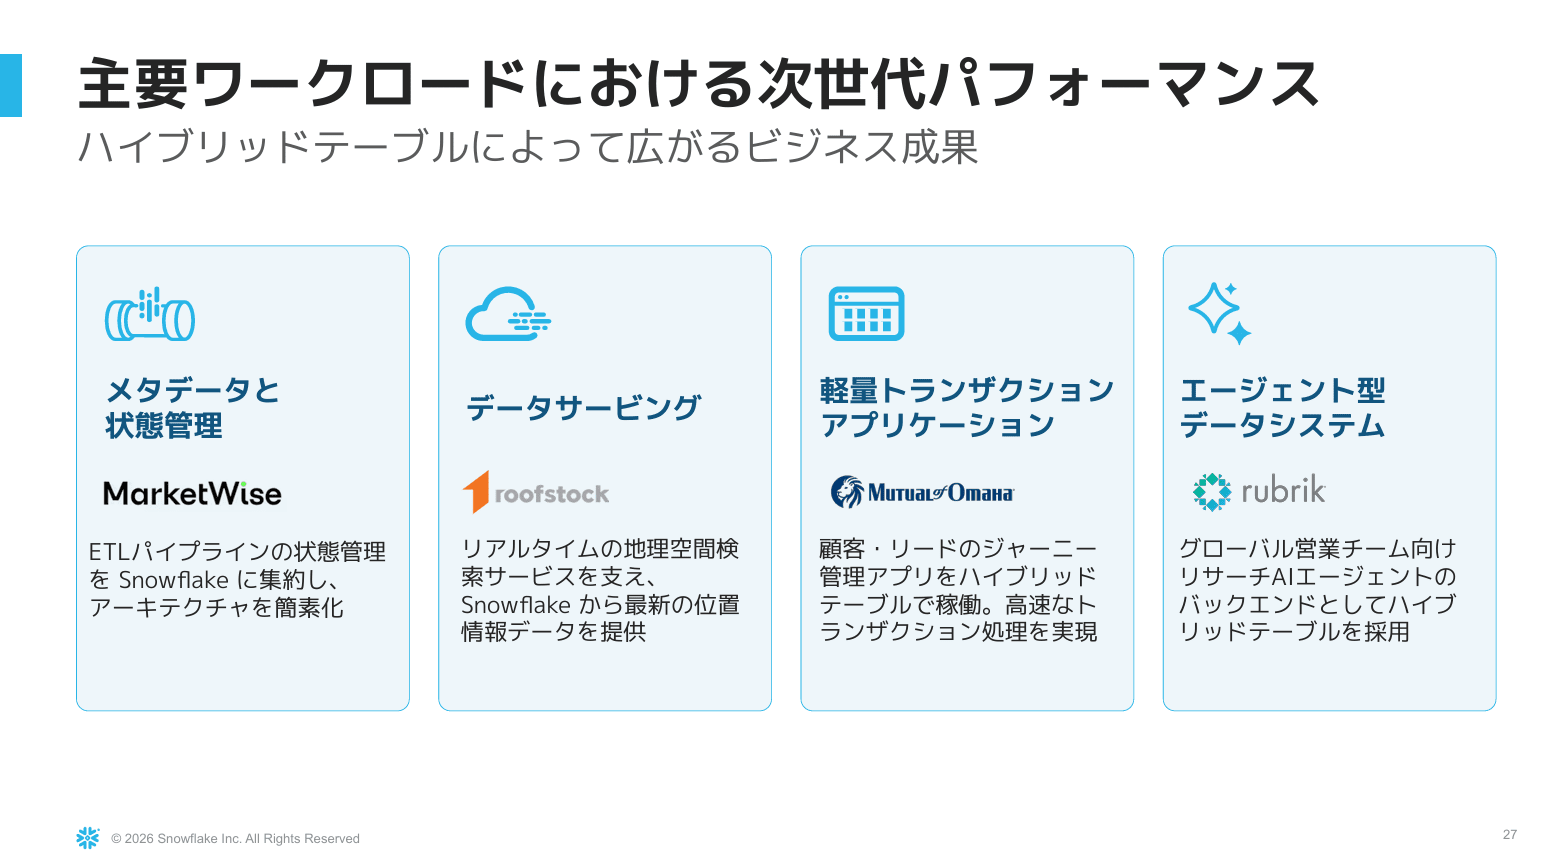
- ETL パイプラインの状態管理と集約。アーキテクチャをシンプルにした事例
- データサービング
- 軽量なトランザクションアプリケーション。裏側でハイブリッドテーブルを使い、高速なトランザクション処理を実現
- AI エージェントの裏側のテーブル。グローバル営業チーム向けのリサーチ AI エージェントに活用
セッションのまとめ
- トランザクションの世界と分析の世界をつなぐ2つの道として、Snowflake Postgres と Unistore が紹介された
- Snowflake Postgres は、データミラーリングにより分析の世界へのデータ連携をシンプルにしている
- ハイブリッドテーブルは、リクエストクレジット課金の廃止やパフォーマンス向上により、幅広く使えるよう進化を続けている
- どちらも入門ガイドが公開されているので、手元で試してほしいとのこと
【Snowflake Postgres 入門】
【ハイブリッドテーブル クイックスタートガイド】
参考リンク
セッション内容の裏取りに使った公式ドキュメント・公式ブログです。
所感
Day1 の朝一番のセッションでしたが、OLTP と OLAP の「レイテンシのギャップ」を Snowflake がプラットフォームとして活用できることが実感できるセッションでした。
特に印象的だったのは、Postgres に INSERT した1行が、パイプラインを組むことなく1分もかからずに Snowflake CoWork の回答に反映されたデモはユースケースとして多くありそうなものだったので、より活用の幅が広がると感じました。
この記事が何かの参考になれば幸いです!