[レポート]dbt World Tour Tokyo 2026 オープニングキーノート「LEVEL UP」 #dbtWTTokyo

かわばたです。
2026年10月20日に、アンダーズ 東京で「dbt World Tour Tokyo 2026」が開催されました。昨年の Coalesce on the Road Tokyo に続く、dbt Labs の東京イベントです。
本記事はオープニングキーノート「LEVEL UP」のレポートブログとなります。
キーノートに続く Elias DeFaria 氏のライブデモも、同じ流れで進んだため本記事に含めています。
※講演は英語で行われました。本記事は筆者のメモをもとに要約しています。
※提供ステータスは講演時点の内容と、2026年9月16日公開の dbt Summit 2026 公式ブログに基づきます。最新の状況は公式ドキュメントをご確認ください。
登壇者
- Alexis Jones 氏
- dbt Labs
- VP, Product Marketing
-
Nina Anderson 氏
- dbt Labs
- Senior Manager, Partner Solutions Architecture
-
Elias DeFaria 氏
- dbt Labs
- Director of Product Management
AI がデータの世界を変える
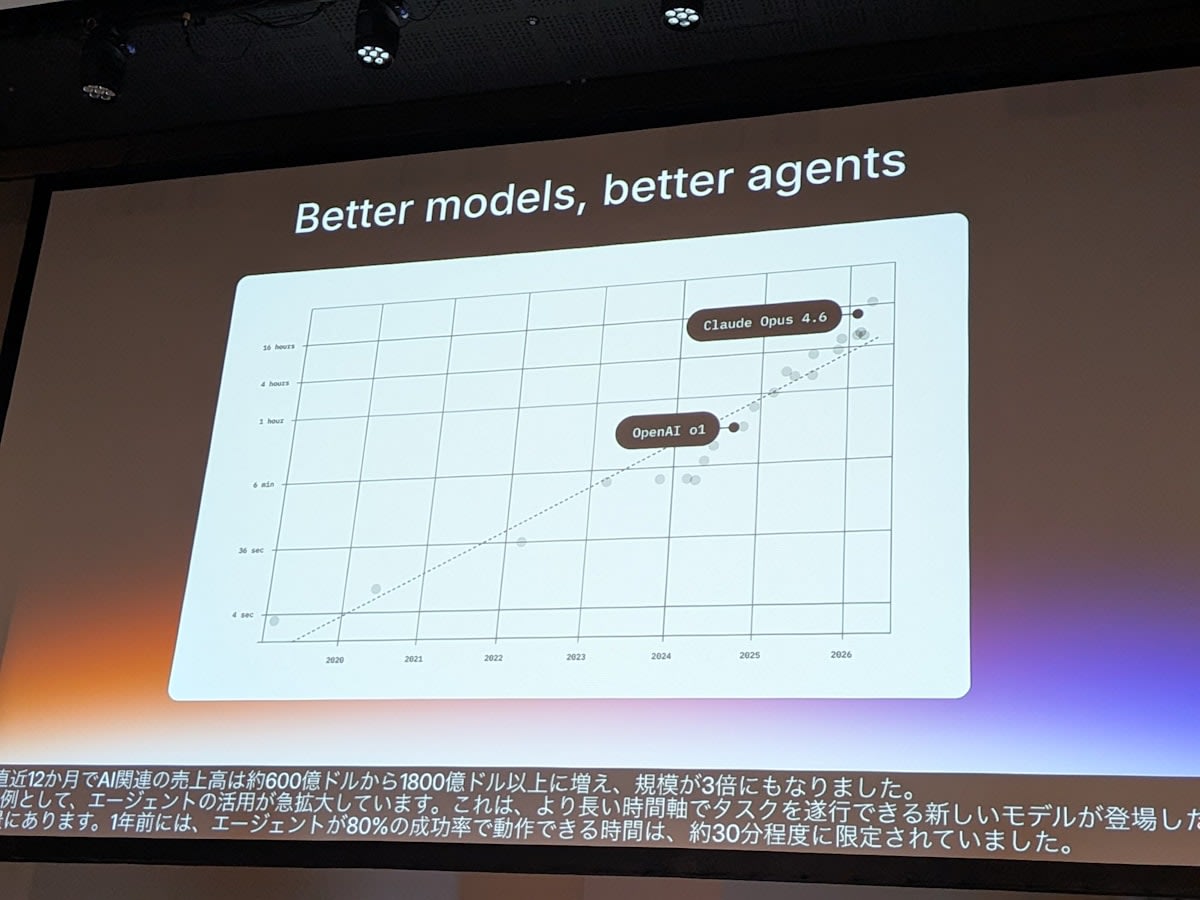
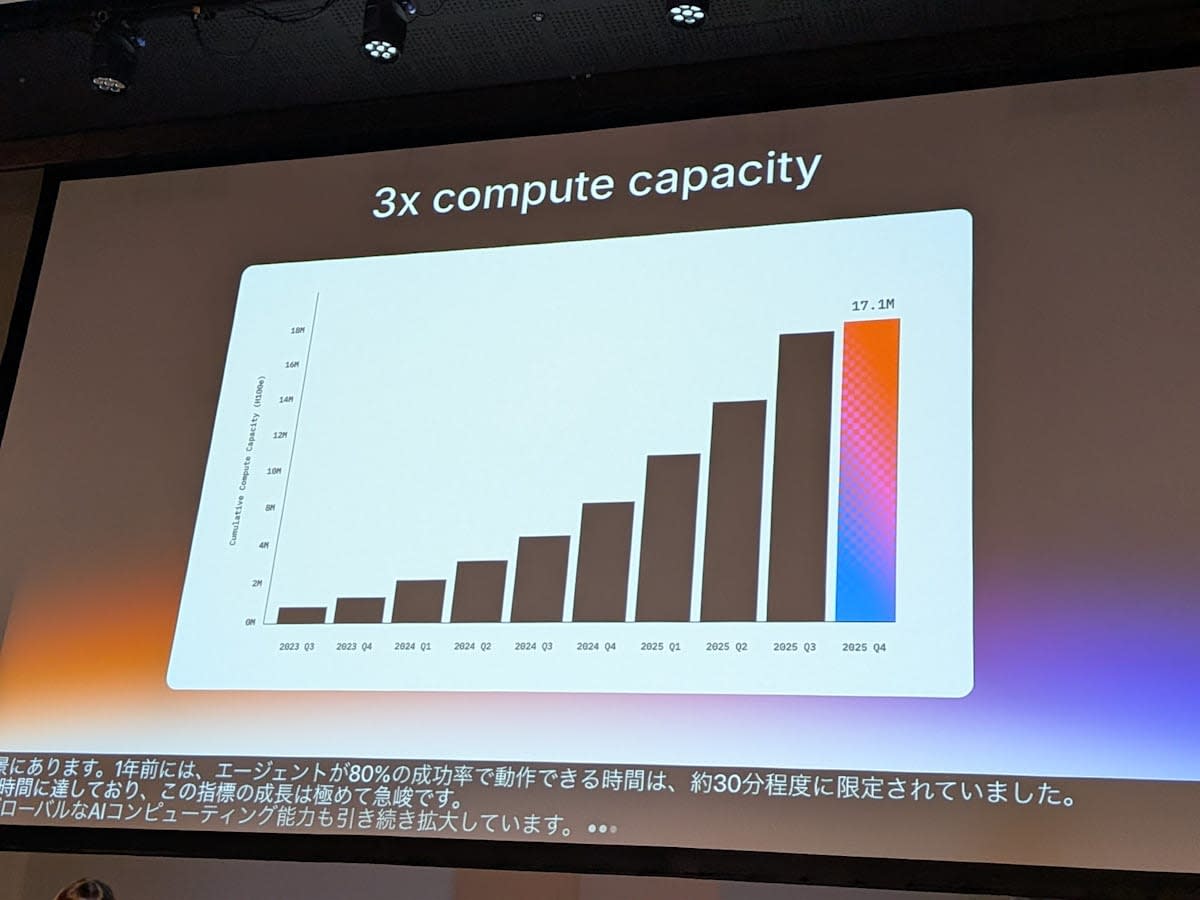
- 直近 12 か月で、業界とデータの仕事に大きな変革があった。その証拠として 3 つの数字を提示
- AI 関連の売上は約 600 億ドルから 1,800 億ドル以上へ、3 倍に成長した
- エージェントが 80% の成功率で遂行できるタスクの長さは、1 年前の約 30 分から 3 時間になった
- 世界の AI 計算能力は前年比 3 倍で拡大し、H100 換算で 1,710 万基に達した
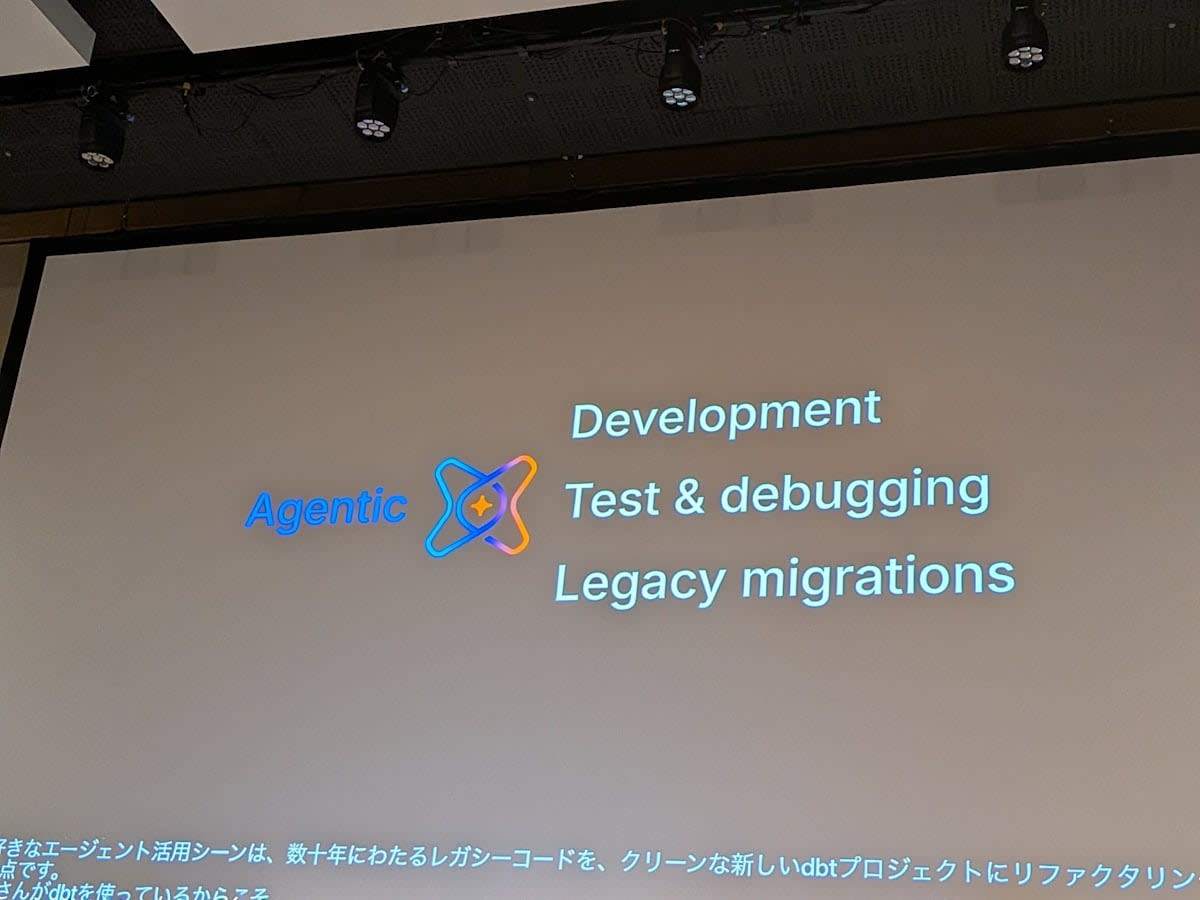
- これは会場の誰もが経験する中で、最大のテクノロジーの波になる
- Excel をメールで送り合い、SQL をローカルに散らばせていた時代から見れば、dbt を使う今の姿はその進化の証
- 今はエージェントがコードを書き、パイプラインの障害を調べてデバッグする
- Alexis 氏のお気に入りは、数十年のレガシーコードをクリーンな dbt プロジェクトにリファクタリングする使い方
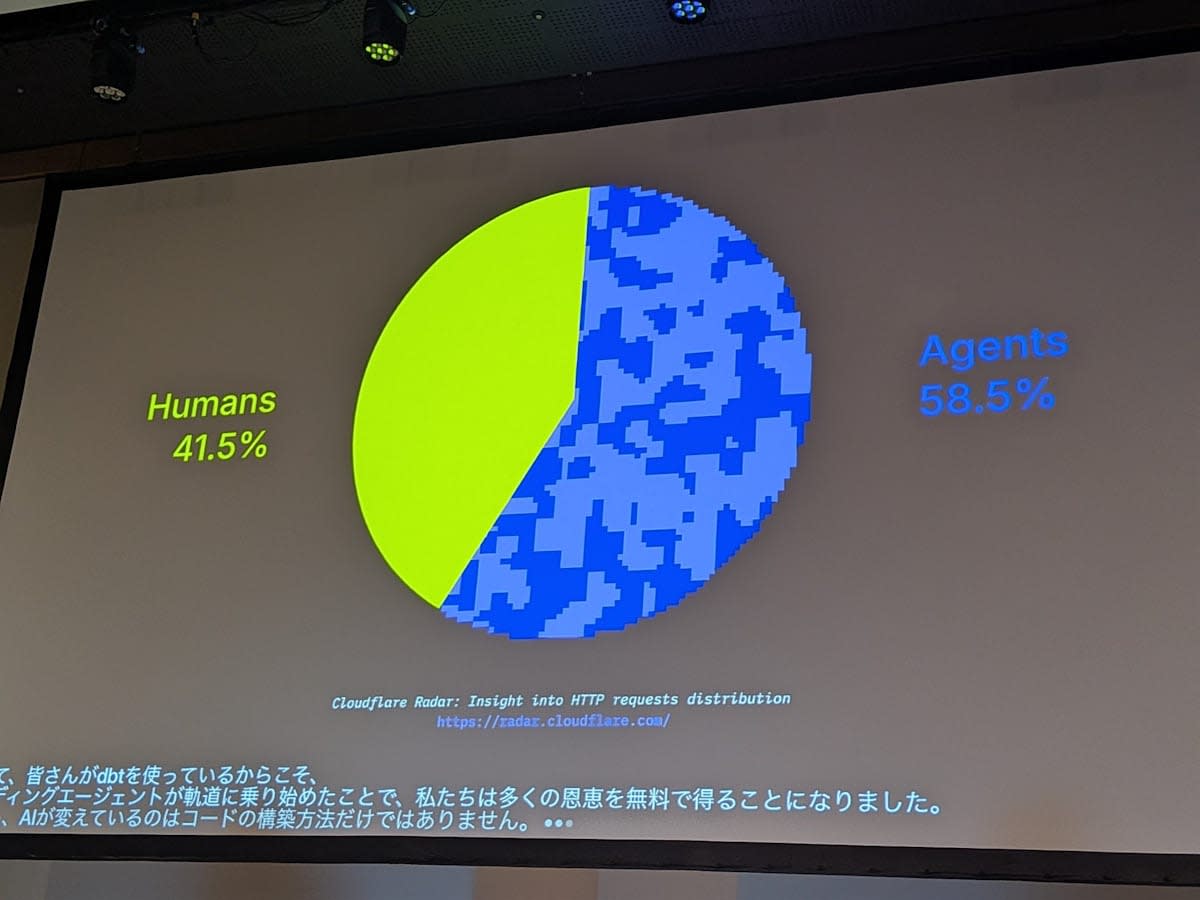
- AI はパイプラインの作り方だけでなく、データの使われ方も変える
- Cloudflare は、インターネットトラフィックの過半数が人間以外になったと発表した
- データにも同じ転換点が訪れ、エージェントがメトリクス・テーブル・メタデータの主要なコンシューマーになる
- 組織はもともと、活用できる量より多くの情報を生み出してきた。作ったモデルが一度も使われない経験は誰にでもある
- 人間が問いを投げてエージェントが調べる段階を経て、エージェント自身が問いを立てて行動する時代になる
- この技術は、会場の皆さんが日々扱うデータの価値をかつてないほど高める
- 今年のテーマは「LEVEL UP」。業界・リーダー・技術エコシステムの急速な変化に向き合うため、dbt もレベルアップする
- プラットフォーム・プロダクト・パートナーシップの 3 つの面で、人間とエージェントの両方に信頼できるデータを届ける
エンジン
dbt v2(dbt Core 2.0)
- dbt Core 2.0 が正式リリースされた。2016 年の初リリース以来、dbt 最大のアップデート
- Rust で全面的に書き直し、大規模プロジェクトでの大幅な高速化と AI 対応を実現した
- 統合までの経緯
- 過去 2 年間、リアルタイムフィードバック・AI 対応メタデータ・高速なパースと実行を目指して Fusion エンジンを構築してきた
- Fusion は dbt Core と別のコードベースで、2 つを維持することはエンジニアリングチームとユーザーの双方に負担だった
- v2 では Fusion のコードベースを dbt の標準に統合し、2 つのエンジンが並存する時代が終わる
- 今後は 1 つのエンジン、1 つの言語仕様になる
-
ブランドも「dbt」に統一し、「Fusion」と「dbt Core」のブランド名は終了する
-
中核部分は引き続き Apache 2.0 ライセンスで提供する
-
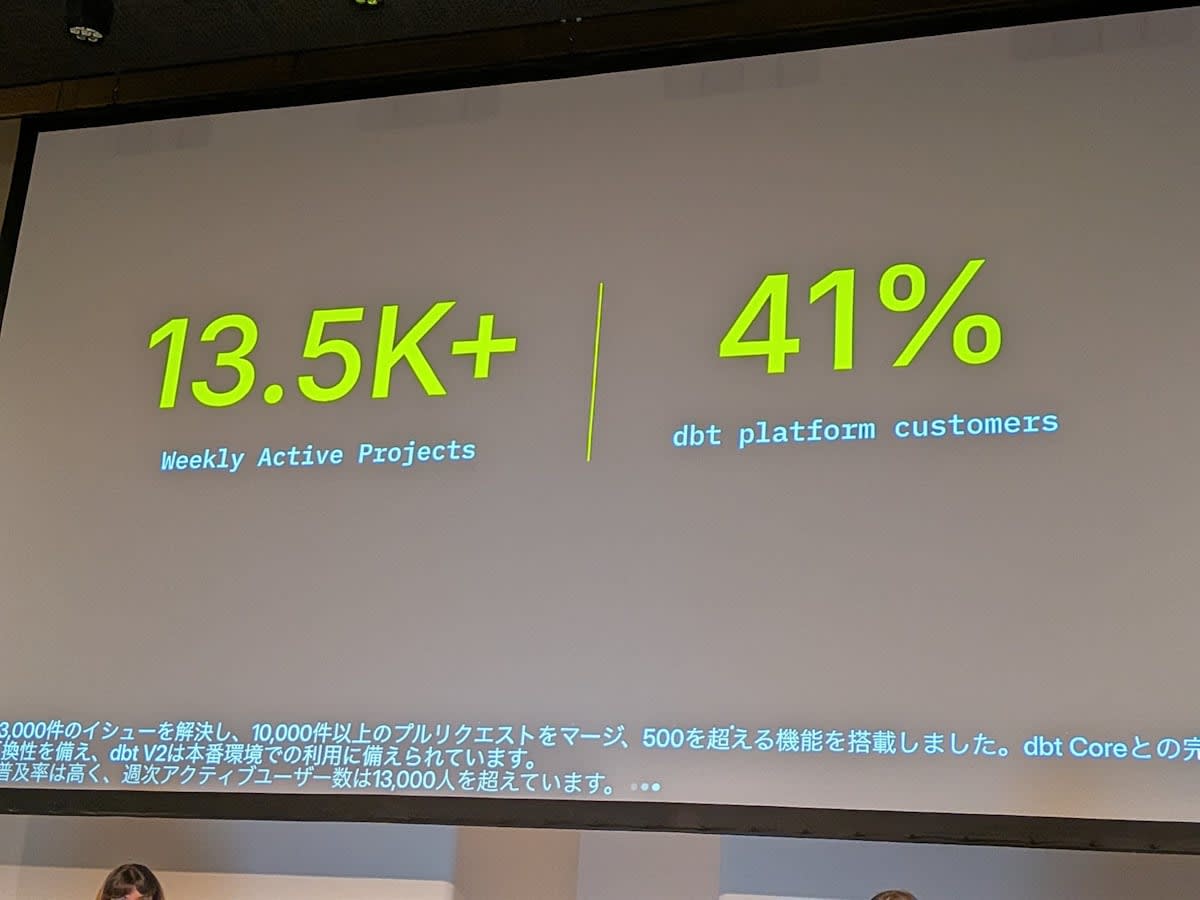
約 2 年で約 3,000 件の issue を解決し、10,000 件以上の pull request をマージし、500 を超える機能を搭載した
-
dbt Core(v1)と完全な機能互換性があり、本番環境で利用できる
-
普及状況
- 週に 13,000 を超えるプロジェクトが、ローカルまたは dbt platform で v2 を実行している
- dbt platform の顧客の 40% 以上が、dbt ワークロードを v2 で実行している
-
アダプター対応状況
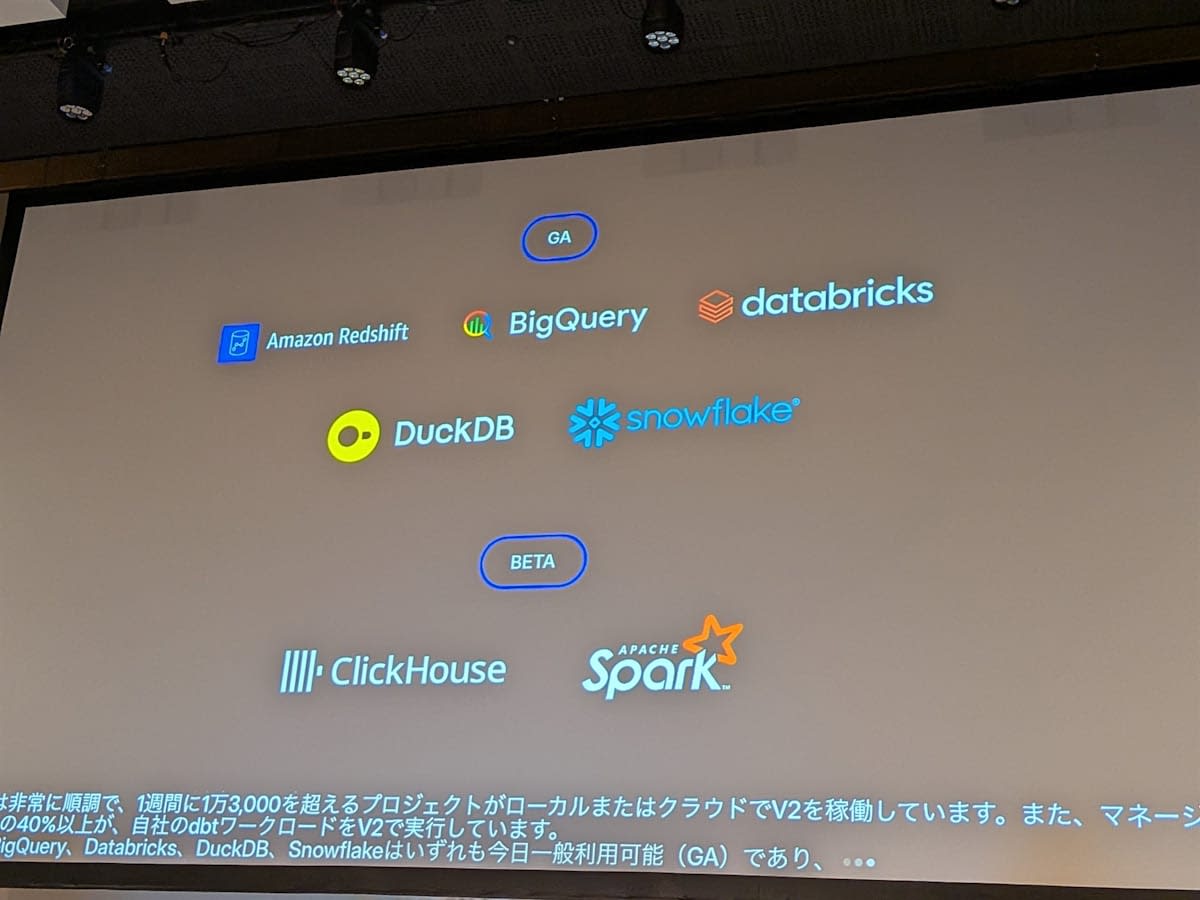
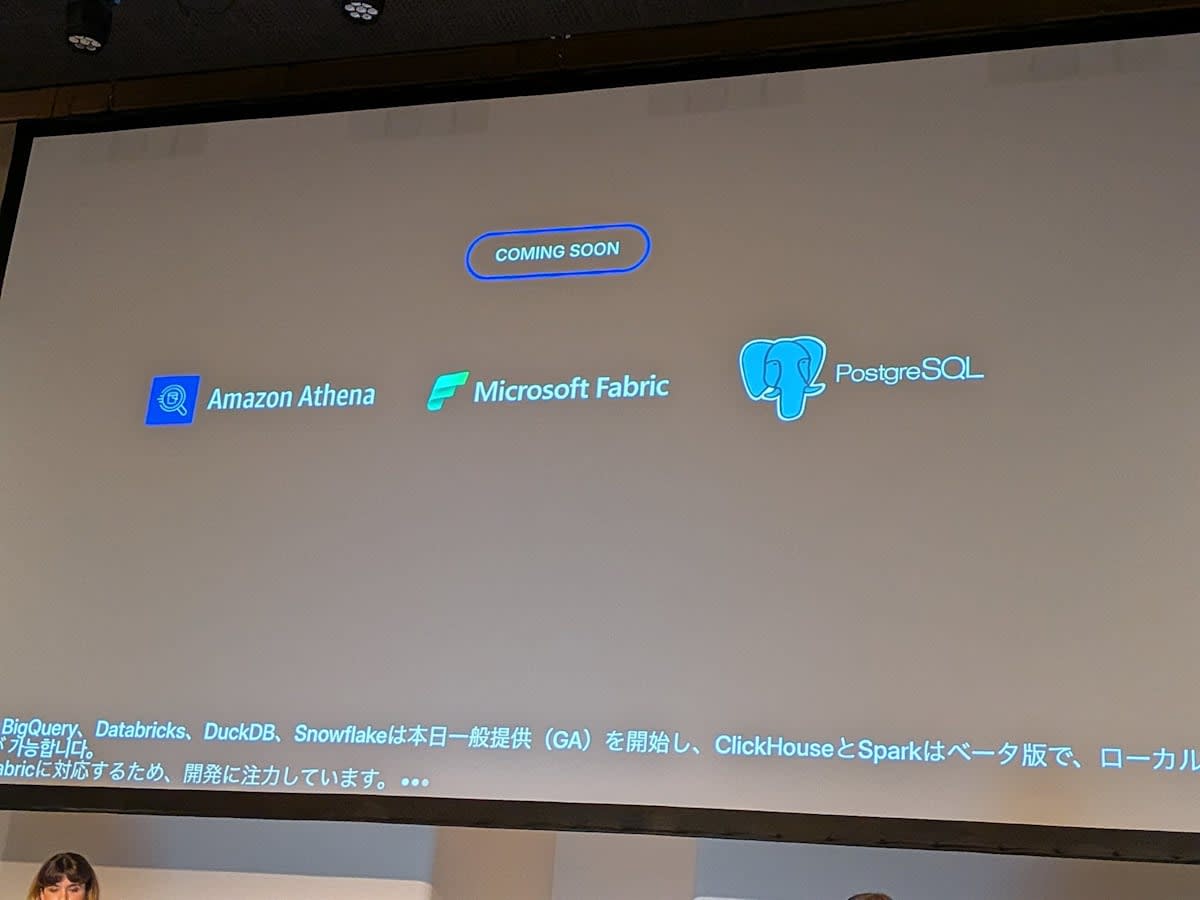
| ステータス | アダプター |
|---|---|
| GA | Redshift、BigQuery、Databricks、DuckDB、Snowflake |
| Beta | ClickHouse、Spark |
| 開発中 | Athena、Fabric、Postgres |
dbt State
- dbt におけるジョブオーケストレーションの新しいパラダイム
- 上流のコードやデータに変更がない場合、モデルの実行をスキップする
- compute コストを 15〜30% 削減でき、開発効率とパフォーマンスも向上する
- すでに GA で、dbt の実行方法を問わず利用できる
- dbt platform 上の v1 / v2
- Airflow などの外部オーケストレーター
- Snowflake のネイティブ統合経由で dbt プロジェクトを実行する場合
- 詳細は午後のセッション「dbt State で、runs を最適化」で解説
弊社検証記事
AI のためのレベルアップ
アナリティクスエンジニアの役割
- 定義、コントラクト、テスト、セマンティックレイヤー。データの信頼性を確保する仕事は消えない。変わるのはその賭け金
- エージェントがデータプロダクトの主要な利用者になれば、この仕事の価値はさらに高まる
- 役割はモデルを作ることから、組織全体とエージェントが依存するコンテキストをエンジニアリングすることにレベルアップする
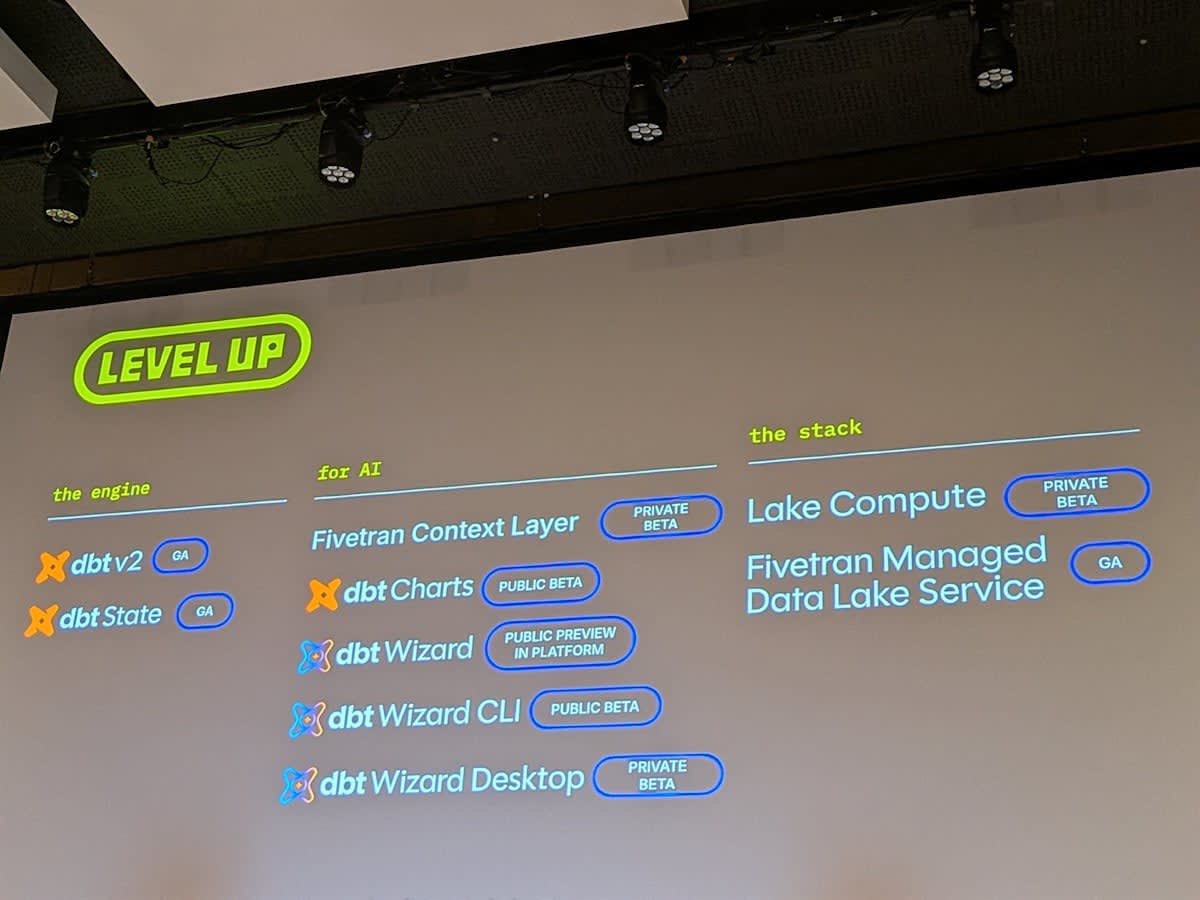
Fivetran Context Layer(Private Beta)
- エージェントはガバナンスされたモデルだけでなく、Wiki・サポートチケット・Slack スレッドのような非構造化の知識も必要とする
- コンテキストを見つけられないエージェントは、答えを捏造する傾向がある
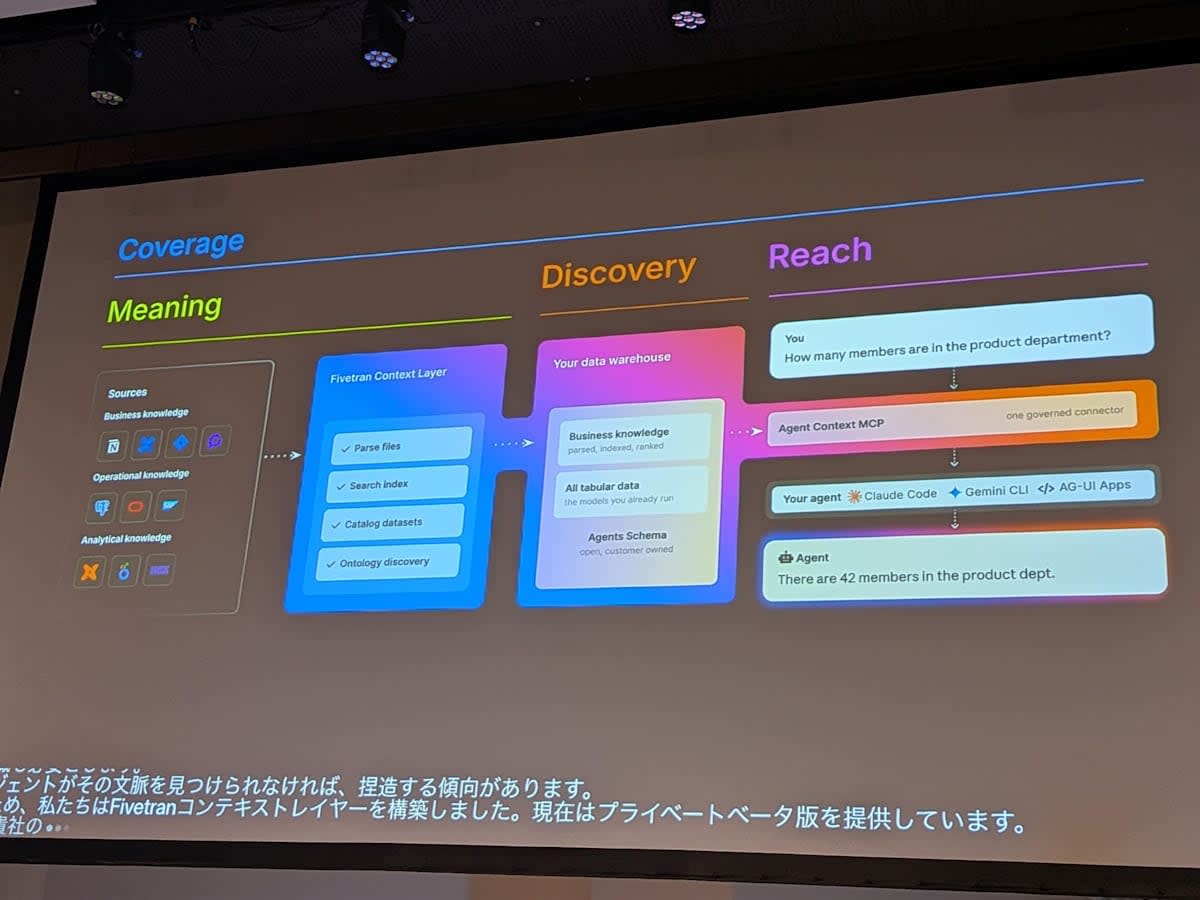
- Fivetran Context Layer はマネージドサービスで、dbt や構造化ソースからメタデータを取得する
- 非構造化ソースは、エージェントが検索できるベクトルに変換する
- すべてオープン規格のテーブルとしてウェアハウスに保存する。SQL アクセスと MCP を備えたあらゆるエージェントが利用できる
- コンテキストは一度定義すれば中央で発見でき、必要に応じてどこへでも拡張できる
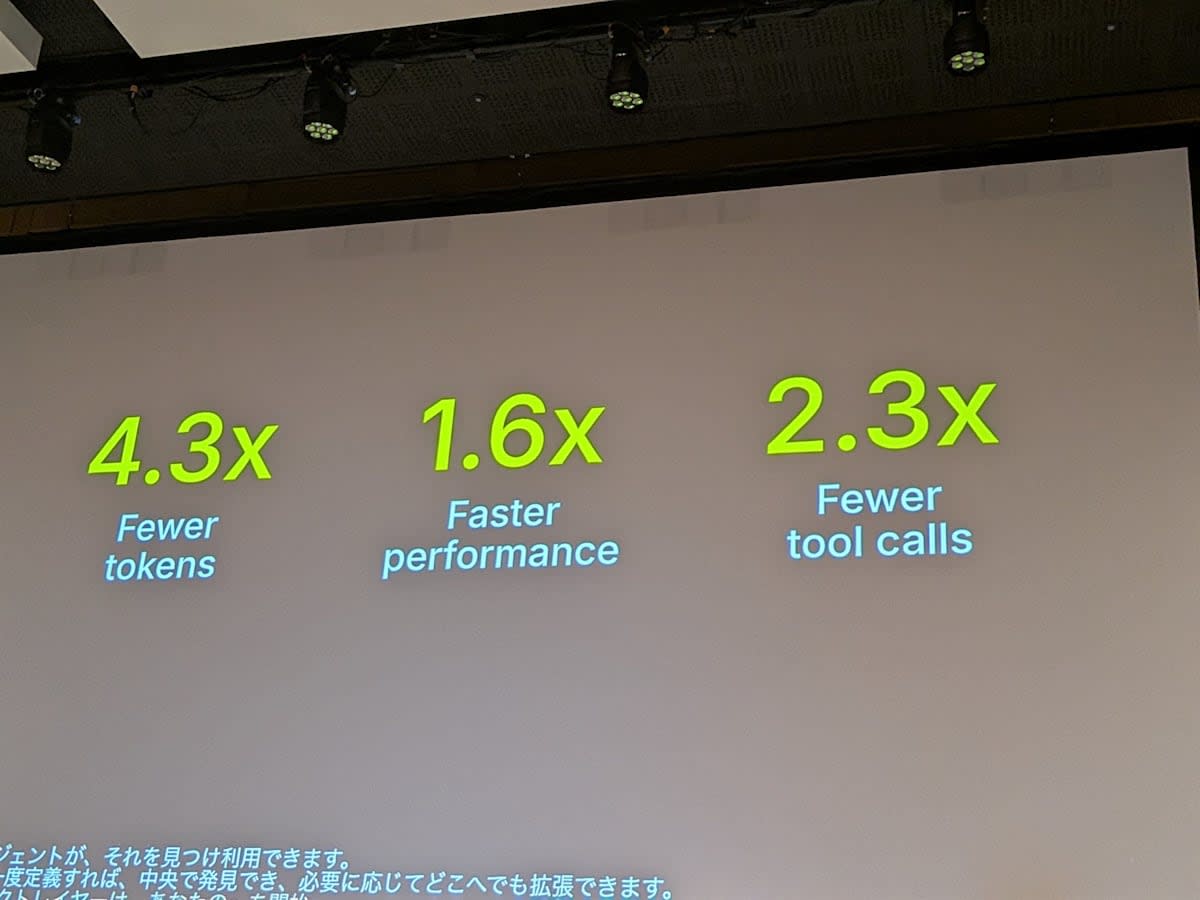
- 初期段階の実測では、標準の MCP と比べてトークン消費が少なく、レスポンスが速く、呼び出し回数も少ない
- 現在はデザインパートナーと共同開発中
dbt Charts(Public Beta)
- 人が意思決定に使うダッシュボードが、それを生成したコードから切り離されている問題を解決する
- YAML でチャートやダッシュボードを定義するオープンな仕様。依存するモデルのすぐ近くに配置できる
- 同じリポジトリ、同じ pull request、同じ CI で、SQL と一貫性を保てる
弊社検証記事
dbt Wizard(Public Preview)
- アナリティクスエンジニアリングに特化したエージェント
- モデル・リネージ・コントラクト・テスト・セマンティックレイヤーを横断し、調査から検証までを引き受ける
- dbt platform 上の dbt Wizard は、全チームを対象に Public Preview になった。既存の dbt プランなら追加料金なし
- Explore Mode:ビジネスユーザーが自然言語で質問し、実際の dbt プロジェクトに基づいた回答を得られる
- Explore Mode では、ロジックの別コピーを同期する必要がない
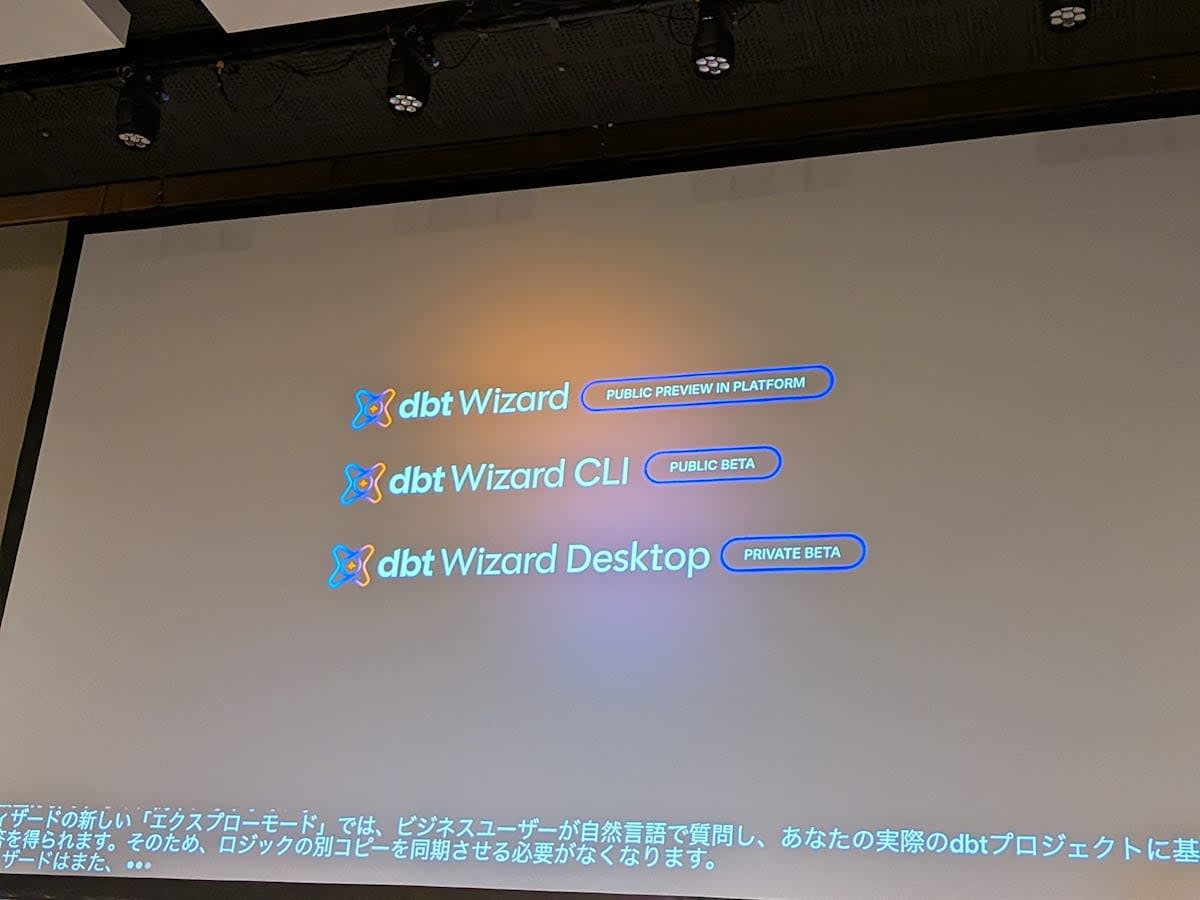
- CLI 経由のローカル開発にも対応する。デスクトップアプリは Private Beta
弊社検証記事
オープンなデータスタック
- AI を支える基盤は、高速なエンジン・豊富なメタデータ・ガバナンスされたコンテキストに加え、オープンで標準に準拠し将来性があるべき
-
変化が速いほど、柔軟性とユーザーの制御が重要になる。不適切な技術選定やベンダーロックインの影響は、かつてなく大きい
-
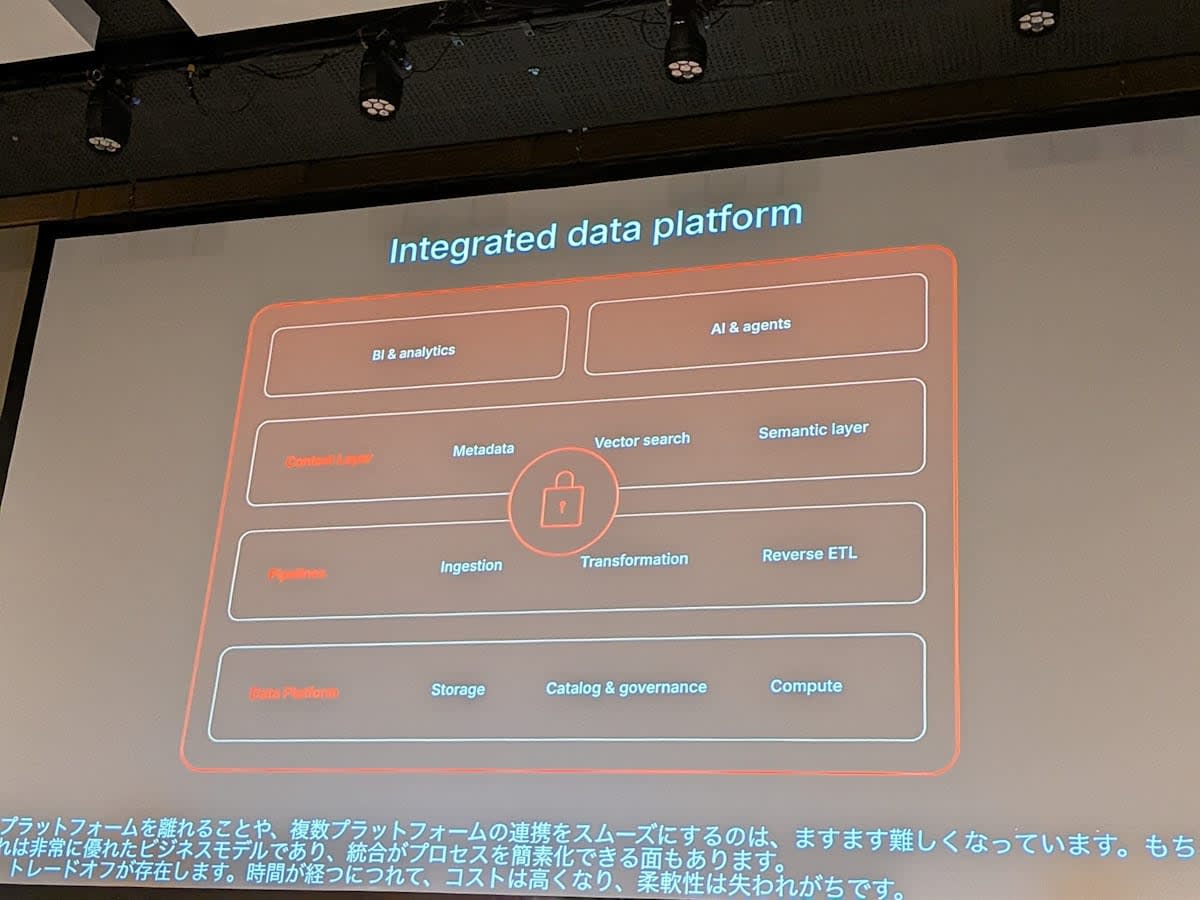
成功しているデータプラットフォームほど垂直統合を強め、ストレージ・コンピュート・メタデータ・エージェントまでエンドツーエンドで担おうとしている
- 優れたビジネスモデルであり、統合がプロセスを簡素化する面もある
- 一方で、時間とともにコストは高くなり、柔軟性は失われがち。中央集権型で変化への対応も遅い
-
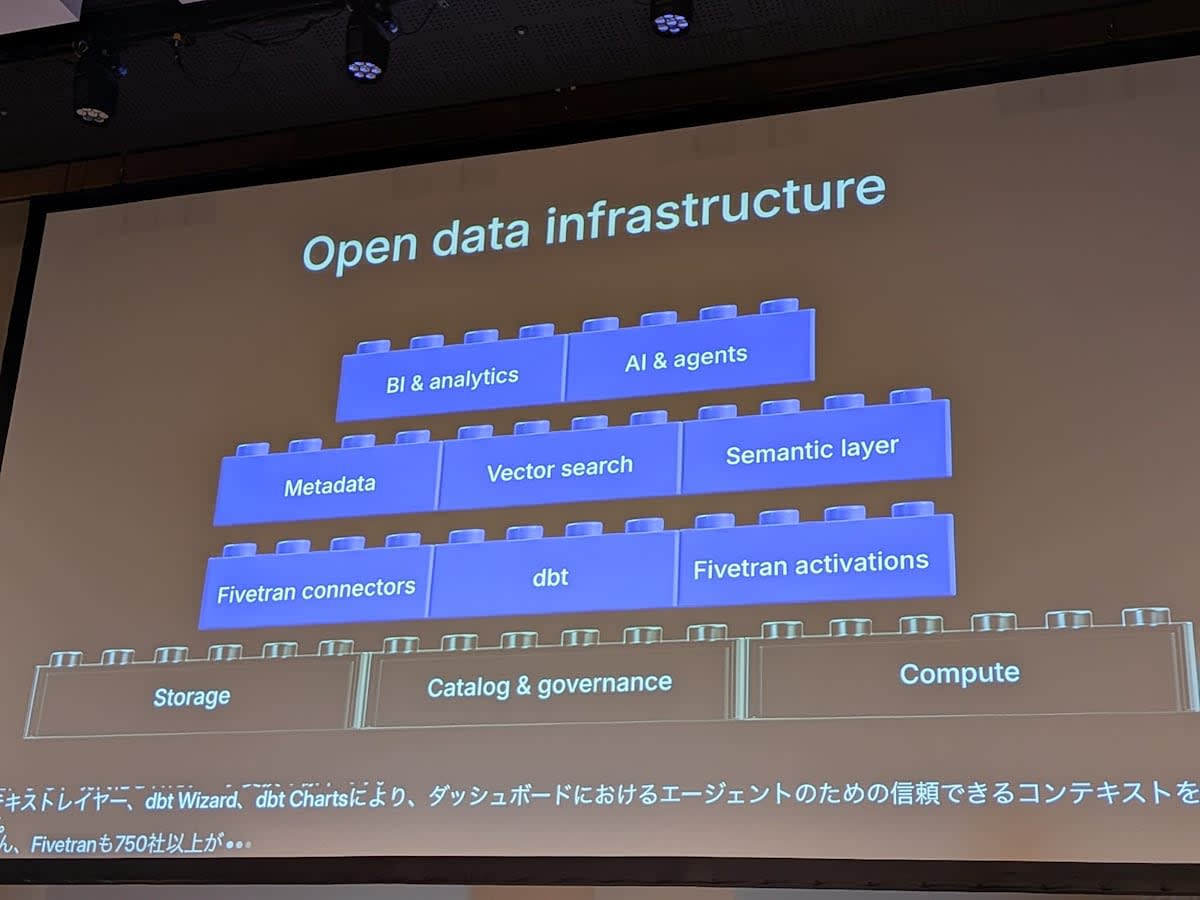
dbt と Fivetran はデータテクノロジーを LEGO ブロックのように捉える。簡単に接続し、簡単に分離できる
-
あらゆるデータプラットフォーム・ソース・モデルプロバイダーで体験を揃えることは、両社が毎日解いている最も難しい課題の 1 つ
-
すぐに使える統合ソリューションも、真にオープンなインターフェースと OSS で独自に組む選択も、顧客が自由に選べるべき
-
本日の発表は、プラグイン可能で相互運用性のあるデータスタックのブロックになる
- dbt v2:モダナイズされたデータ変換の標準
- Fivetran Context Layer、dbt Wizard、dbt Charts:エージェントとダッシュボードのための信頼できるコンテキスト
- 750 を超える Fivetran コネクタ:データがどこにあっても必要な場所へ確実に移動する
-
オープンなストレージ:Iceberg はオールインワンベンダーの実用的な代替になった
-
Fivetran Managed Data Lake は、オープンな Iceberg 形式でのデータのロードを容易にする
- オープンなコンピュート:新サービス Lake Compute を発表(Private Beta)
- DuckDB をベースにした軽量でポータブルなエンジン
- Iceberg をサポートするあらゆるデータプラットフォームと併せてデプロイできる
- dbt モデル 1 つ単位で、タスクに最適なコンピュートを選べる
- 目指すのは、自分で管理し環境に合わせて調整できる完全なデータプラットフォームを、最高品質の LEGO ブロックで組むこと
- この 10 年愛されてきた垂直統合型プラットフォームの補完であり、同時に代替案でもある
Elias 氏によるライブデモ
dbt v1 と v2 の位置づけ
-
オープンネスを差別化の軸に選んだのは、dbt Labs の歴史がオープンな姿勢で定義されてきたから。dbt はデータ変換のオープンソース標準
-
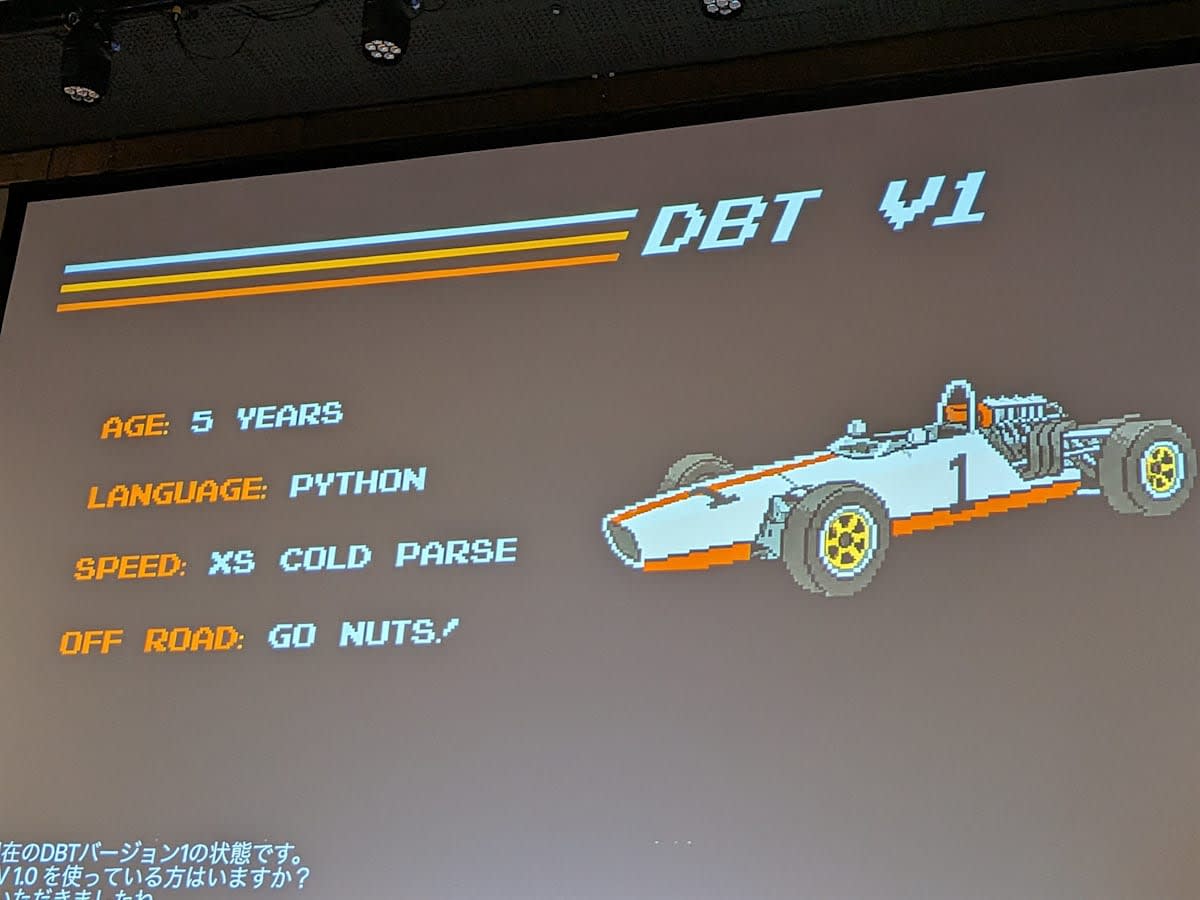
v1:Python 製。v2 より遅いが非常に安定しており、dbt を定義した存在
- 新機能は今後 v1 に実装しない。イノベーションと投資は v2 に集中する
- 移行が完了するまで、バグ修正とセキュリティパッチを 3〜5 年間提供する
-
v2:新しいエンジン。全チームが既定で v2 から始めることを推奨する
-
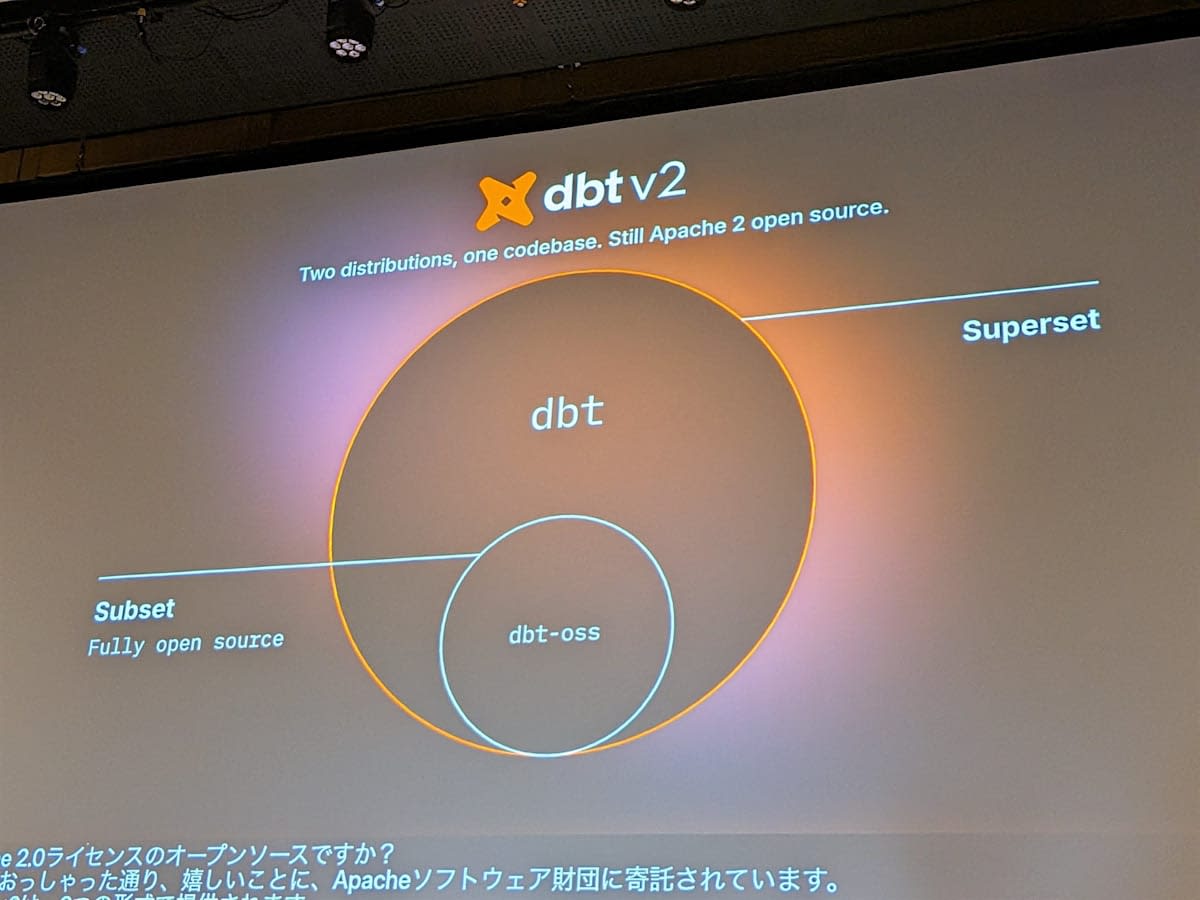
v2 は 2 つの形式で提供される
| ディストリビューション | 内容 |
|---|---|
| dbt OSS | Apache 2.0 ライセンスのオープンソースコードのみ。v1 と完全な機能互換で、Rust 化により高速 |
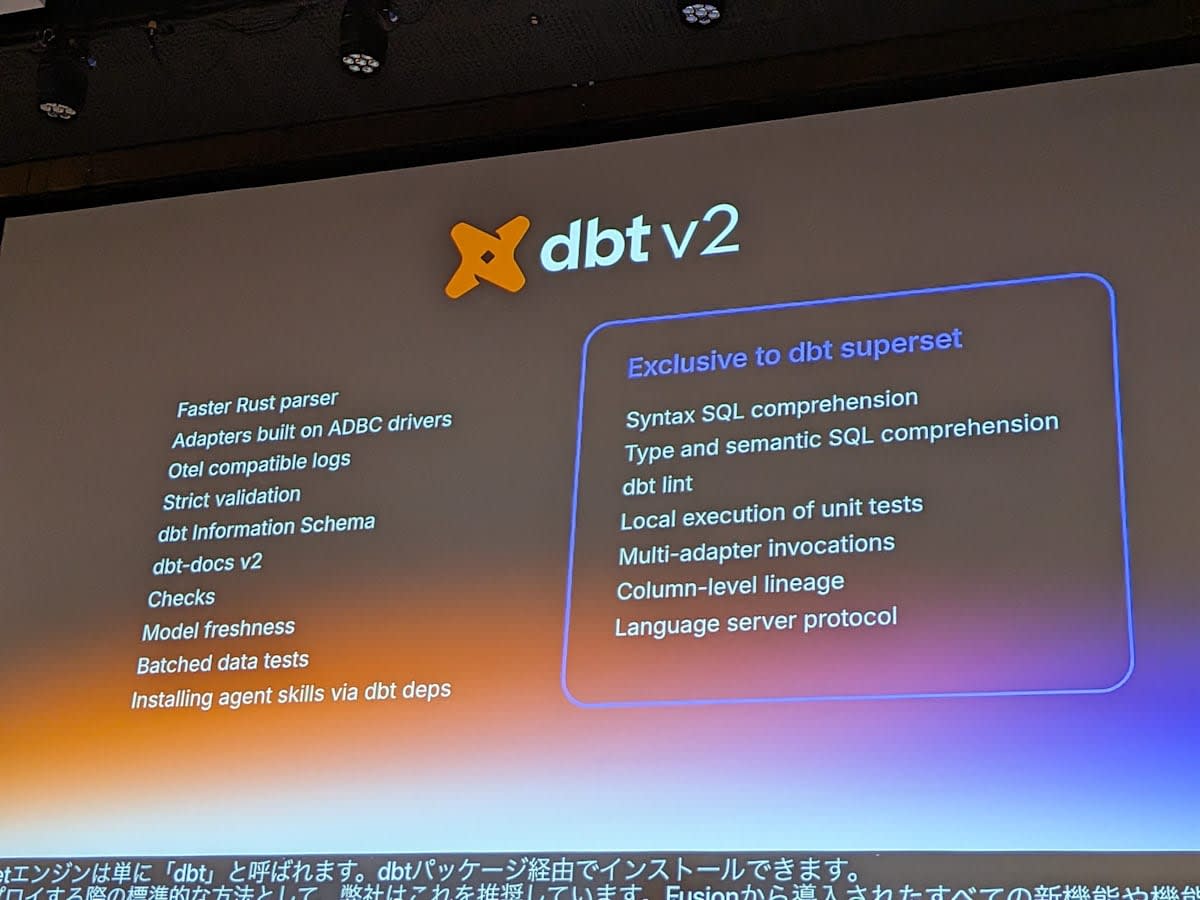
| dbt | OSS を含むスーパーセット。Fusion 由来の新機能をすべて含み、チームの標準デプロイとして推奨 |
デモ環境
- VS Code 上で、架空のゲームスタジオ「Jaffle Games」の dbt プロジェクトを使用
- ローカルに dbt v2(表示は 2.0.8)をインストール。接続先は Snowflake
- v2 の高速化の恩恵が最も大きいのは parse。桁違いに速くなり、すべての dbt 操作の実行時間が短くなる
dbt lint
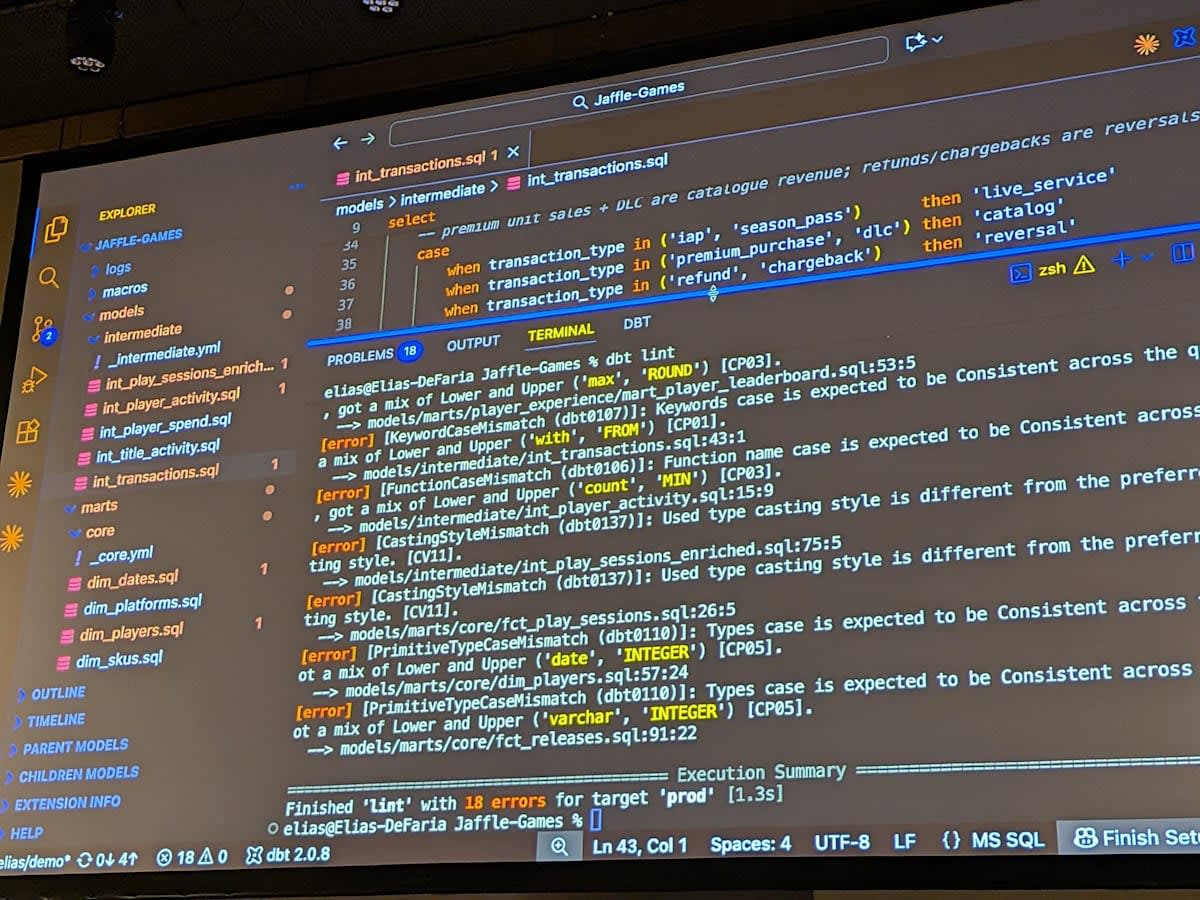
- v2 にネイティブで組み込まれた高速な SQL リンター。
dbt lintでコードの改善点を即座に返す - VS Code 拡張では行単位で問題を表示する。dbt Wizard ともネイティブに統合されている
- エージェントはコード生成を安価にするが、コード品質は保証しない。変更のたびに実行できる決定論的なガードレールが必要
dbt lint --fixで、ベストプラクティスを保ったまま自動修正できる- 既存の SQLFluff の設定ファイルとルールセットをそのまま使える
- 違いは dbt 固有の 5 ルール。例として 2 つを紹介
join_condition_or:JOIN 条件の OR を検出する。ハッシュジョインが使えなくなり、実行時間が 10 倍遅くなることもある- ハードコードされた参照:
ref()やsource()を使い忘れた箇所を検出する
dbt check
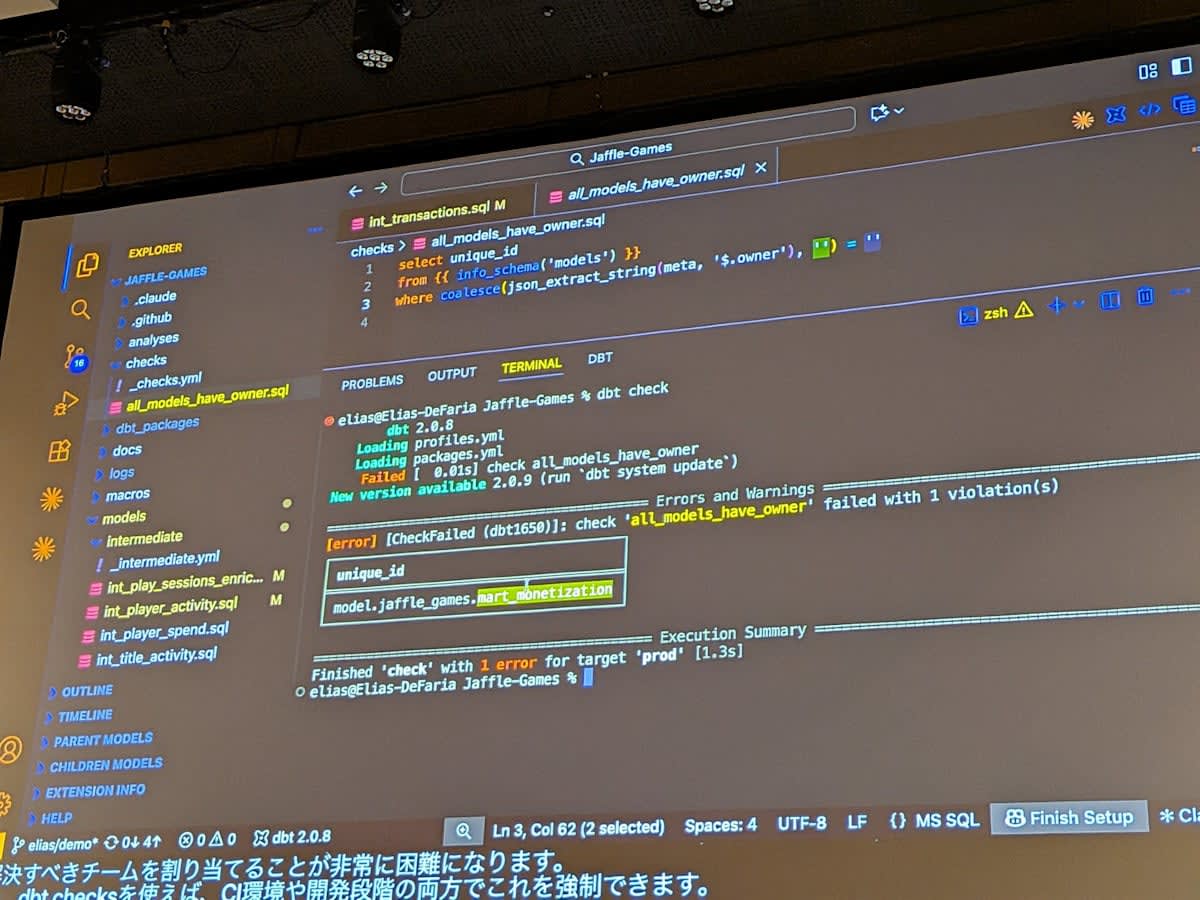
- dbt プロジェクトのメタデータに対して SQL でアサーションを書く新機能。開発中と CI の両方で強制できる
- 例は「すべてのモデルに owner が設定されている」というチェック
- owner は問題発生時にデバッグを担当するチーム。設定漏れがあると担当チームの特定が難しくなる
dbt checkを実行すると、owner 未設定のmart_monetizationで失敗した- 仕組みは、dbt の information schema の models テーブルから owner が空のモデルを探す SQL
- finance.yml に owner を追加して再実行すると成功した
dbt information schema と Docs v2
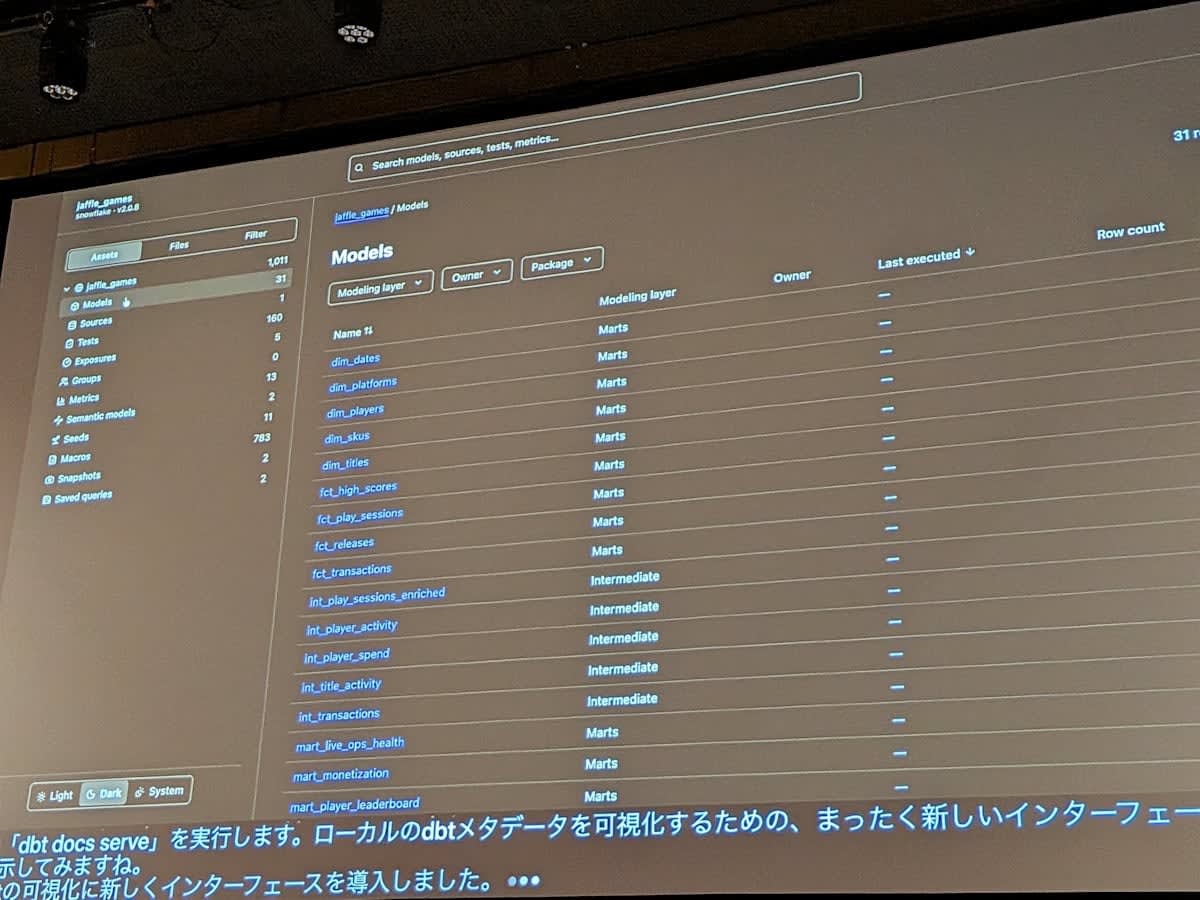
dbt compile --generate-info-schemaを実行すると、target 配下にinfo_schemaフォルダが生成される- manifest.json や run_results.json に加え、プロジェクトのメタデータが Parquet 形式で格納される
- Parquet のメタデータは DuckDB でローカルにクエリできる
- カラムレベルのリネージなど、従来より豊富なメタデータを含む
dbt docs serveで起動する Docs v2 は、ローカルのメタデータを表示する新しい UI- モデル・テスト・エクスポージャー・セマンティックモデルを一覧できる
- リネージはカラム単位まで掘り下げられる
batched tests
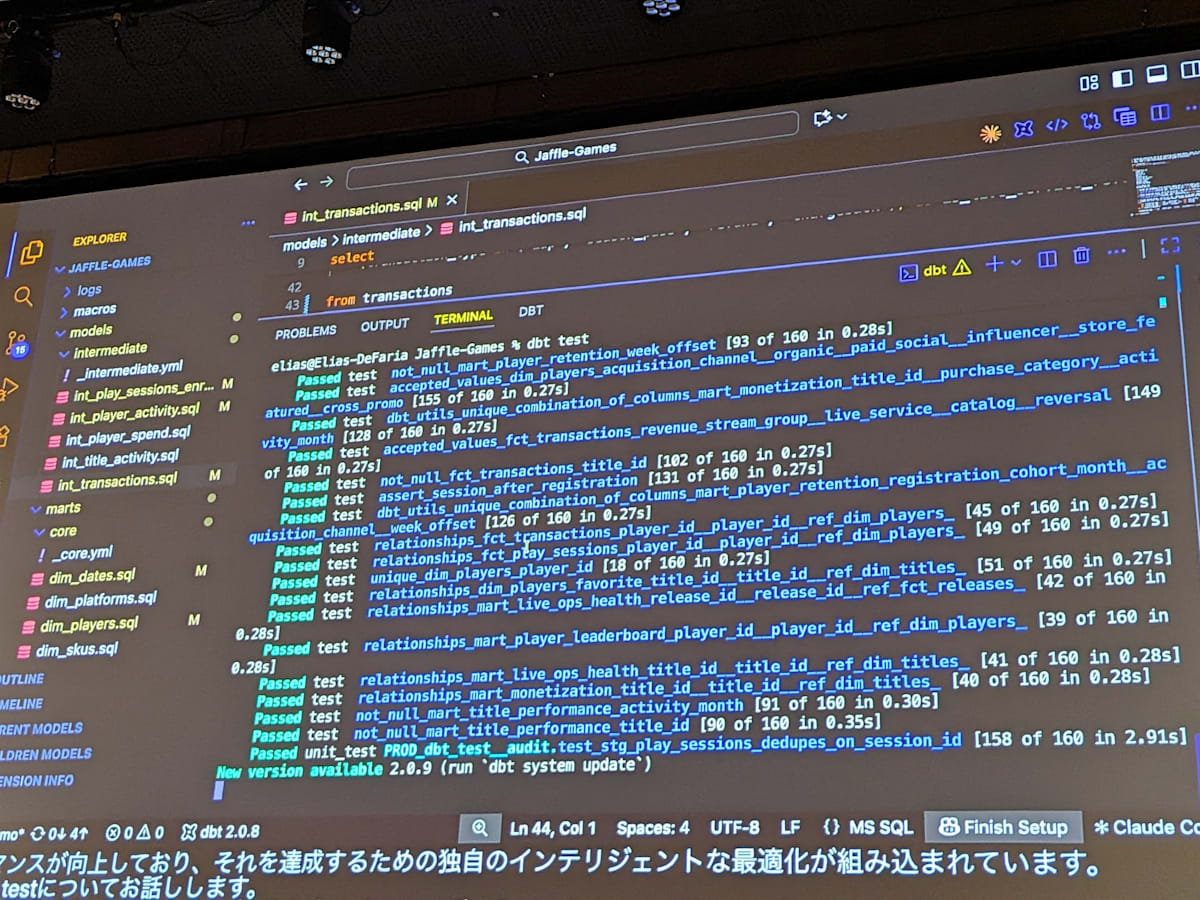
- 従来の
dbt testはデータテストごとにウェアハウスへクエリを 1 回発行する。デモのプロジェクトでは 156 クエリ - batched tests のフラグを付けると、同じモデルに対する複数のテストを 1 つのクエリに統合し、スキャンを 1 回にする
- 例として、1 つのモデルに 5 つの not null テストがあれば 1 クエリにまとまる
- デモでは対象 65 テストを 21 クエリに集約し、実行時間を 30% 以上短縮した
ユニットテストのローカル実行
- ログ上、ある unit test は 1.22 秒、別の unit test は 0.08 秒で完了していた
- 速い方の unit test には、設定に
compute: localが付いている - Snowflake の SQL を DuckDB の SQL に変換し、ローカルマシンで実行する。ウェアハウスへクエリを送らない
- 開発の inner loop でコストとパフォーマンスを大きく改善できる
dbt State
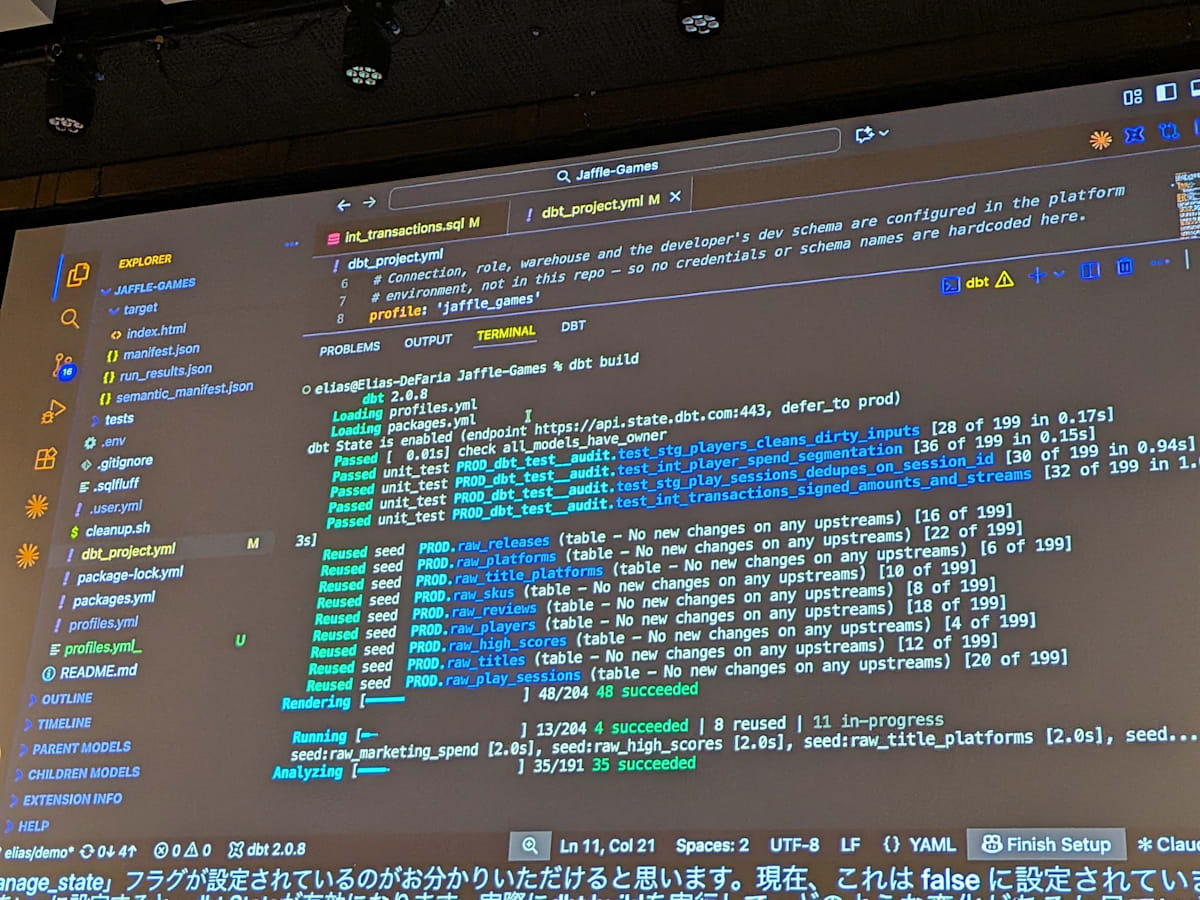
- dbt_project.yml の
manage_stateフラグを true にすると有効になる dbt buildを実行すると、ステータスが「succeeded」ではなく「reused」と表示された- 前回のビルド以降、上流のソースデータとコードに変更がないと判断し、すべてのモデルとテストをスキップした
- ローカルの実行でも、dbt platform 上の state サービスに接続してスキップ可否を判断する
- 開発体験への効果
- 新しい開発スキーマで
dim_platformsを変更してビルドすると、上流のstg_platformsへの参照は prod に解決された - 従来の defer は本番の manifest.json を取得して渡す必要があった。dbt State では設定だけで自動的に defer される
+dim_platformsで上流を含めて実行しても、stg_platformsは「reused」になった- 別環境に最新状態のモデルがあれば、再ビルドせず自動でクローンして開発スキーマへ持ってくるため
- 新しい開発スキーマで
Lake Compute
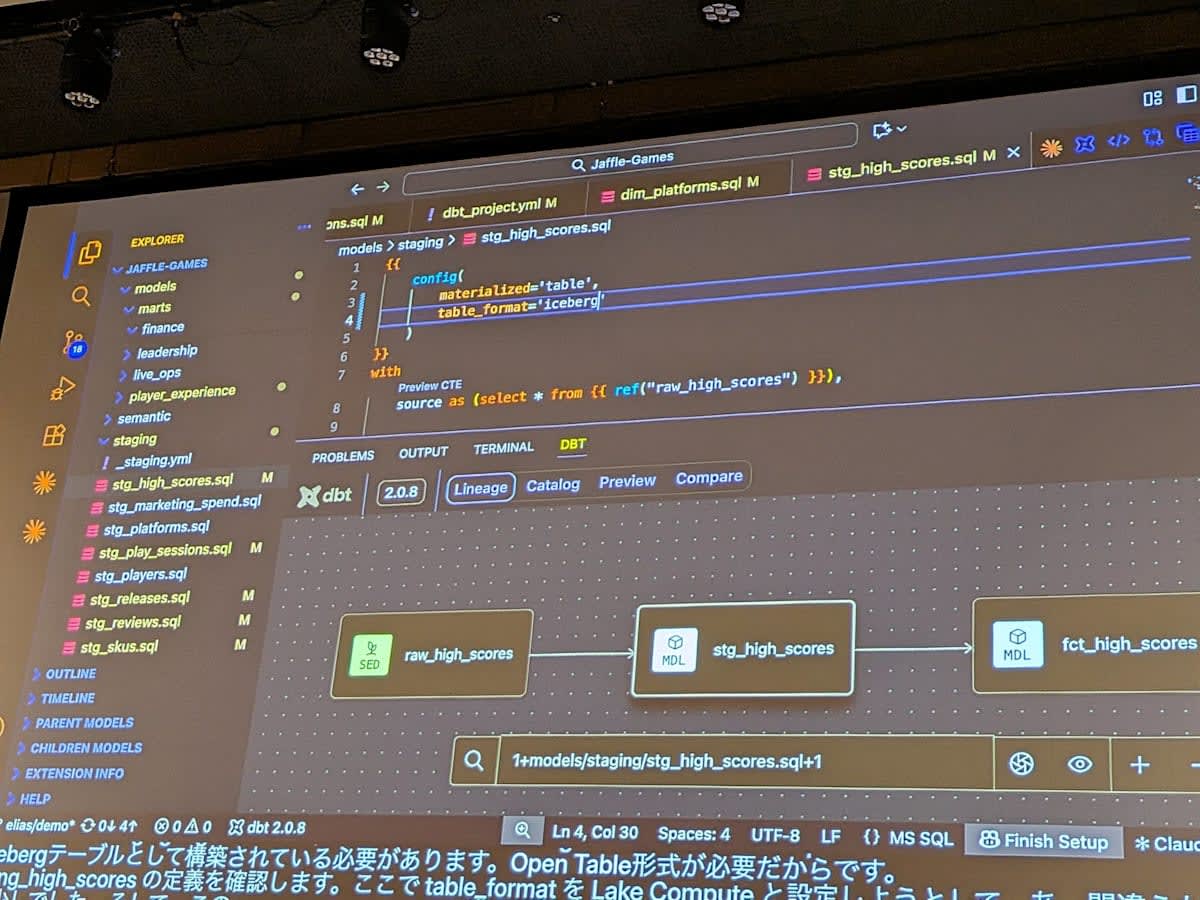
- 題材は、毎日大量のデータを処理する高コストな fact テーブル
fct_high_scores - コスト削減の選択肢はウェアハウスの移行やモデルのリファクタリングだが、いずれも労力が大きく成功の保証もない
- Lake Compute なら、このモデルだけを DuckDB で実行し、プロジェクトの残りは Snowflake のままにできる
- 上流の
stg_high_scoresにtable_format: icebergを設定し、Iceberg テーブルとして構築する dbt run -s +fct_high_scores+の実行結果stg_high_scoresが Snowflake 上で Iceberg テーブルとして再構築されたfct_high_scoresはクラウド上のオートスケールする DuckDB インスタンスへ送られ、Iceberg 経由で上流データを読み取って変換した- 結果は Snowflake の Iceberg カタログに書き戻された
- 下流の
mart_player_leaderboardは、その結果をもとに Snowflake 上で実行された
- 1 つの DAG の中でモデル単位にアダプターを切り替える、dbt のマルチアダプター実行が実現した
関連リンク
所感
dbt World Tour Tokyo 2026 のオープニングキーノートに参加しました。
先月開催された dbt Summit 2026 の発表を振り返りつつ、アップデートを網羅した内容でした。
個人的にはLake ComputeやFivetran Context Layerが印象に残っています。dbtは変換ツールとしての立ち位置から大きく転換していくフェーズなのかなと感じました。
利用したい機能が盛りだくさんで悩ましいですね!
この記事が何かの参考になれば幸いです!