Amazon EMR 8.2で対応したS3条件付き書き込みによるDelta Lakeの同時書き込みを検証してみた

データ事業本部のueharaです。
2026年11月17日に Amazon EMR 8.2 がリリースされました。
このバージョンでは Apache Spark 4.1.3 と Delta Lake 4.2.0 がサポートされ、Amazon S3 の条件付き書き込み(Conditional Writes)を利用して、DynamoDB を用意せずに複数の Spark クラスターやジョブから同一の Delta Lake テーブルへ安全に同時書き込みできるようになっています。
これまで Amazon S3 上の Delta Lake テーブルへ複数クラスターから同時に書き込む場合、_delta_log/ のコミット番号が競合するのを防ぐために DynamoDB ベースの LogStore(S3DynamoDBLogStore)を構築して運用する必要がありました。
EMR 8.2 では S3 の If-None-Match: * を用いた条件付き PutObject により、S3 単体でコミットファイルの排他制御が成立します。
今回は2つの独立した Amazon EMR Serverless アプリケーション(リリースラベル emr-spark-8.2.0)を立ち上げ、DynamoDB も DynamoDB 用の IAM 権限も一切用意しない構成で同一の Delta Lake テーブルへ同時 INSERT と同時 MERGE を実行しました。
あわせて、書き込み結果のデータ整合性を Amazon EMR Studio のノートブックから確認しています。
全体構成
検証環境の全体構成は次のとおりです。
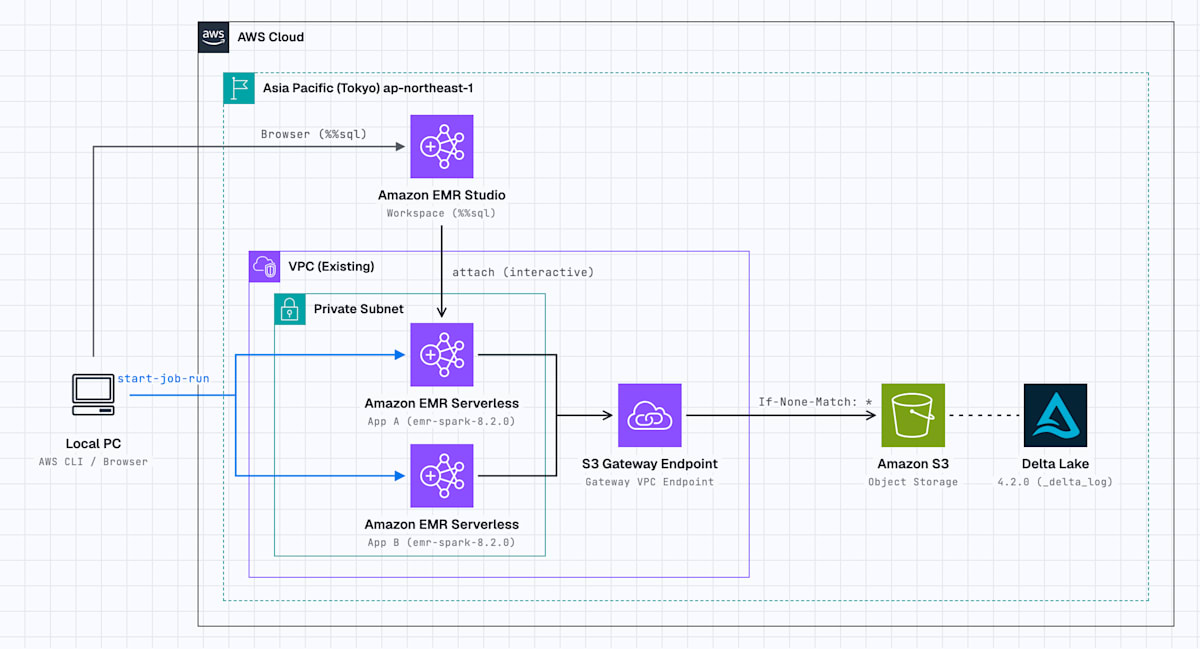
今回の構成のポイントは次の3点です。
- 2つの独立した EMR Serverless アプリケーション(App A・App B)を既存 VPC 内のプライベートサブネットで起動し、別クラスターからの同時書き込みを再現する
- プライベートサブネットから Amazon S3 へは S3 Gateway VPC Endpoint 経由で接続する
- EMR Serverless のジョブ実行ロールには対象 S3 バケットへのアクセス権限のみを付与し、DynamoDB のテーブルや権限設定は一切用意しない
書き込み結果の確認には Amazon EMR Studio の Workspace を使用し、App A にアタッチした PySpark カーネルのノートブックから %%sql で S3 上の Delta Lake テーブルを直接参照しています(EMR Studio 自体の初期設定手順は割愛します)。
前提条件とファイル構成
前提条件
検証にあたって事前に必要な環境は次のとおりです。
- 既存の VPC とプライベートサブネット
- プライベートサブネットのルートテーブルに紐づいた S3 Gateway VPC Endpoint
- AWS CLI が実行できるローカル環境
- 結果確認用の Amazon EMR Studio Workspace(作成済みであること)
ファイル構成
検証用にローカルへ用意したファイルは次の構成です。
.
├── template.yaml                  # CloudFormation テンプレート
├── run_test.sh                    # アップロード・初期化・同時書き込み実行スクリプト
├── runner/
│   └── run_sql.py                 # S3 上の .sql ファイルを Spark SQL で実行する汎用ランナー
└── sql/
    ├── 01_init_table.sql          # 検証用 Delta テーブル初期化 SQL
    ├── 02_concurrent_append.sql   # 検証1: 同時 INSERT (APPEND) 用 SQL
    └── 03_concurrent_merge.sql    # 検証2: 別パーティション同時 MERGE 用 SQL
EMR Serverless の sparkSubmit は .sql ファイルを直接 entryPoint に渡せないため、S3 上の SQL ファイルを読み込んで spark.sql() で実行する汎用ランナー(runner/run_sql.py)を用意しています。
検証用コードの準備
CloudFormation テンプレート(template.yaml)
S3 バケット、セキュリティグループ、IAM ロール、2つの EMR Serverless アプリケーションの計5リソースを作成するテンプレートです。
template.yaml
AWSTemplateFormatVersion: "2010-09-09"
Description: >-
  Verification environment for concurrent Delta Lake writes on Amazon S3
  using Amazon EMR Serverless (emr-spark-8.2.0) with S3 conditional writes
  (no DynamoDB log store required).

Parameters:
  ProjectPrefix:
    Type: String
    Default: emr-delta-test
    Description: Prefix for resource names (lowercase alphanumeric characters and hyphens only)
    AllowedPattern: "^[a-z0-9-]+$"

  VpcId:
    Type: AWS::EC2::VPC::Id
    Description: Existing VPC ID

  SubnetIds:
    Type: List<AWS::EC2::Subnet::Id>
    Description: >-
      Existing subnet IDs (comma-separated). Subnets must have a route to
      Amazon S3 via an S3 Gateway VPC Endpoint or a NAT Gateway.

  EmrReleaseLabel:
    Type: String
    Default: emr-spark-8.2.0
    Description: >-
      Amazon EMR release label. Use emr-spark-8.2.0 or later for concurrent
      Delta Lake writes using S3 conditional writes.

  Architecture:
    Type: String
    Default: X86_64
    AllowedValues:
      - X86_64
      - ARM64
    Description: CPU architecture for EMR Serverless workers

Resources:
  DeltaTestBucket:
    Type: AWS::S3::Bucket
    Properties:
      BucketName: !Sub "${ProjectPrefix}-${AWS::Region}"
      BucketEncryption:
        ServerSideEncryptionConfiguration:
          - ServerSideEncryptionByDefault:
              SSEAlgorithm: AES256
      PublicAccessBlockConfiguration:
        BlockPublicAcls: true
        BlockPublicPolicy: true
        IgnorePublicAcls: true
        RestrictPublicBuckets: true
      Tags:
        - Key: Project
          Value: !Ref ProjectPrefix

  EmrServerlessSecurityGroup:
    Type: AWS::EC2::SecurityGroup
    Properties:
      GroupDescription: Security group for EMR Serverless Delta Lake concurrent write test
      VpcId: !Ref VpcId
      SecurityGroupEgress:
        - IpProtocol: tcp
          FromPort: 443
          ToPort: 443
          CidrIp: 0.0.0.0/0
          Description: Allow HTTPS outbound to AWS services (S3, etc.)
      Tags:
        - Key: Name
          Value: !Sub "${ProjectPrefix}-emr-sg"
        - Key: Project
          Value: !Ref ProjectPrefix

  EmrServerlessJobRole:
    Type: AWS::IAM::Role
    Properties:
      RoleName: !Sub "${ProjectPrefix}-job-role-${AWS::Region}"
      AssumeRolePolicyDocument:
        Version: "2010-10-17"
        Statement:
          - Effect: Allow
            Principal:
              Service: emr-serverless.amazonaws.com
            Action: sts:AssumeRole
            Condition:
              StringEquals:
                aws:SourceAccount: !Ref AWS::AccountId
      Policies:
        - PolicyName: DeltaTestBucketAccess
          PolicyDocument:
            Version: "2010-10-17"
            Statement:
              - Sid: AllowBucketList
                Effect: Allow
                Action:
                  - s3:ListBucket
                  - s3:GetBucketLocation
                Resource: !GetAtt DeltaTestBucket.Arn
              - Sid: AllowObjectReadWriteDelete
                Effect: Allow
                Action:
                  - s3:GetObject
                  - s3:PutObject
                  - s3:DeleteObject
                Resource: !Sub "${DeltaTestBucket.Arn}/*"
      Tags:
        - Key: Project
          Value: !Ref ProjectPrefix

  EmrServerlessAppA:
    Type: AWS::EMRServerless::Application
    Properties:
      Name: !Sub "${ProjectPrefix}-app-a"
      ReleaseLabel: !Ref EmrReleaseLabel
      Type: SPARK
      Architecture: !Ref Architecture
      AutoStartConfiguration:
        Enabled: true
      AutoStopConfiguration:
        Enabled: true
        IdleTimeoutMinutes: 15
      InteractiveConfiguration:
        StudioEnabled: true
      MaximumCapacity:
        Cpu: 16 vCPU
        Memory: 64 GB
        Disk: 100 GB
      NetworkConfiguration:
        SubnetIds: !Ref SubnetIds
        SecurityGroupIds:
          - !Ref EmrServerlessSecurityGroup
      RuntimeConfiguration:
        - Classification: spark-defaults
          Properties:
            spark.jars: /usr/share/aws/delta/lib/delta-spark.jar,/usr/share/aws/delta/lib/delta-storage.jar
            spark.sql.extensions: io.delta.sql.DeltaSparkSessionExtension
            spark.sql.catalog.spark_catalog: org.apache.spark.sql.delta.catalog.DeltaCatalog
      MonitoringConfiguration:
        ManagedPersistenceMonitoringConfiguration:
          Enabled: true
        S3MonitoringConfiguration:
          LogUri: !Sub "s3://${DeltaTestBucket}/emr-logs/app-a/"
      Tags:
        - Key: Project
          Value: !Ref ProjectPrefix
        - Key: Role
          Value: writer-a

  EmrServerlessAppB:
    Type: AWS::EMRServerless::Application
    Properties:
      Name: !Sub "${ProjectPrefix}-app-b"
      ReleaseLabel: !Ref EmrReleaseLabel
      Type: SPARK
      Architecture: !Ref Architecture
      AutoStartConfiguration:
        Enabled: true
      AutoStopConfiguration:
        Enabled: true
        IdleTimeoutMinutes: 15
      InteractiveConfiguration:
        StudioEnabled: true
      MaximumCapacity:
        Cpu: 16 vCPU
        Memory: 64 GB
        Disk: 100 GB
      NetworkConfiguration:
        SubnetIds: !Ref SubnetIds
        SecurityGroupIds:
          - !Ref EmrServerlessSecurityGroup
      RuntimeConfiguration:
        - Classification: spark-defaults
          Properties:
            spark.jars: /usr/share/aws/delta/lib/delta-spark.jar,/usr/share/aws/delta/lib/delta-storage.jar
            spark.sql.extensions: io.delta.sql.DeltaSparkSessionExtension
            spark.sql.catalog.spark_catalog: org.apache.spark.sql.delta.catalog.DeltaCatalog
      MonitoringConfiguration:
        ManagedPersistenceMonitoringConfiguration:
          Enabled: true
        S3MonitoringConfiguration:
          LogUri: !Sub "s3://${DeltaTestBucket}/emr-logs/app-b/"
      Tags:
        - Key: Project
          Value: !Ref ProjectPrefix
        - Key: Role
          Value: writer-b

Outputs:
  BucketName:
    Description: S3 bucket name for Delta Lake tables, scripts, and EMR logs
    Value: !Ref DeltaTestBucket

  JobRoleArn:
    Description: IAM role ARN for EMR Serverless job execution
    Value: !GetAtt EmrServerlessJobRole.Arn

  AppAId:
    Description: EMR Serverless Application A ID
    Value: !Ref EmrServerlessAppA

  AppBId:
    Description: EMR Serverless Application B ID
    Value: !Ref EmrServerlessAppB

  SecurityGroupId:
    Description: Security Group ID created for EMR Serverless
    Value: !Ref EmrServerlessSecurityGroup

  EmrReleaseLabel:
    Description: Amazon EMR release label configured on the applications
    Value: !Ref EmrReleaseLabel
EmrServerlessAppA と EmrServerlessAppB の RuntimeConfiguration には Delta Lake を有効化するための最小限の spark-defaults(spark.jars、spark.sql.extensions、spark.sql.catalog.spark_catalog)だけを指定しています。
また、InteractiveConfiguration.StudioEnabled: true を設定しておくことで、EMR Studio のノートブックからそのままアタッチして結果を確認できます。
汎用 SQL ランナー(runner/run_sql.py)
App A と App B の書き込み開始タイミングを確実に重ねるため、共通の UNIX 時刻(--start-epoch)を受け取って待機してから SQL を繰り返し実行する仕組みを入れています。
run_sql.py
"""
S3 上の .sql ファイルを読み込んで Spark SQL で実行する汎用ランナー。
このラッパー経由で sql/*.sql を実行します。
"""

import argparse
import time
from pyspark.sql import SparkSession

def parse_args():
    parser = argparse.ArgumentParser()
    parser.add_argument("--sql-file", required=True, help="実行する .sql ファイルの S3 パス")
    parser.add_argument("--repeat", type=int, default=1, help="SQL ファイルの繰り返し実行回数")
    parser.add_argument("--start-epoch", type=int, default=0, help="同時開始用の UNIX 時刻(秒)")
    parser.add_argument(
        "--var",
        action="append",
        default=[],
        help="SQL 内の ${KEY} を置換する変数 (KEY=VALUE 形式、複数指定可)",
    )
    return parser.parse_args()

def read_s3_text(spark: SparkSession, s3_path: str) -> str:
    """Spark (Hadoop FileSystem) 経由で S3 上の SQL ファイルを読み込む。"""
    rows = spark.read.text(s3_path, wholetext=True).collect()
    return rows[0][0]

def split_statements(sql_text: str):
    """コメント行を除いてセミコロン区切りで SQL 文に分割する。"""
    cleaned_lines = [
        line for line in sql_text.splitlines() if not line.lstrip().startswith("--")
    ]
    return [stmt.strip() for stmt in "\n".join(cleaned_lines).split(";") if stmt.strip()]

def render(sql_text: str, variables: dict) -> str:
    rendered = sql_text
    for k, v in variables.items():
        rendered = rendered.replace(f"${{{k}}}", str(v))
    return rendered

def wait_until_barrier(start_epoch: int):
    if start_epoch <= 0:
        return
    wait_sec = start_epoch - time.time()
    if wait_sec > 0:
        print(f"[runner] Barrier wait: sleeping {wait_sec:.2f}s until epoch={start_epoch}")
        time.sleep(wait_sec)
    else:
        print(f"[runner] Barrier already passed by {-wait_sec:.2f}s. Starting immediately.")

def main():
    args = parse_args()
    variables = dict(item.split("=", 1) for item in args.var)

    spark = SparkSession.builder.appName("SqlRunner").getOrCreate()
    print(f"[runner] Spark Version: {spark.version}")
    print(f"[runner] SQL File     : {args.sql_file}")

    raw_sql = read_s3_text(spark, args.sql_file)

    # バリア待機前に Spark セッションをウォームアップ
    if args.start_epoch > 0:
        spark.sql("SELECT 1").collect()
        wait_until_barrier(args.start_epoch)

    t_all = time.time()
    for i in range(1, args.repeat + 1):
        t0 = time.time()
        iter_vars = {**variables, "ITERATION": str(i)}
        statements = split_statements(render(raw_sql, iter_vars))

        for stmt in statements:
            df = spark.sql(stmt)
            if df.columns:
                df.show(50, truncate=False)

        if args.repeat > 1:
            print(f"[runner] iter={i:02d}/{args.repeat} done in {time.time() - t0:.2f}s")

    print(f"[runner] ALL DONE in {time.time() - t_all:.2f}s")
    spark.stop()

if __name__ == "__main__":
    main()
検証用 SQL(sql/ 配下の3ファイル)
テーブル初期化用の sql/01_init_table.sql では同時 INSERT 用の空テーブル events_append テーブルと、同時 MERGE 用に part='A'(id 1〜100)と part='B'(id 101〜200)の計 200 行を持つパーティションテーブル events_merge テーブルを作成します。
01_init_table.sql
-- sql/01_init_table.sql
CREATE OR REPLACE TABLE delta.`${BASE_PATH}/events_append` (
    writer_id  STRING,
    iteration  INT,
    row_num    INT,
    record_key STRING,
    written_at TIMESTAMP
)
USING DELTA;

CREATE OR REPLACE TABLE delta.`${BASE_PATH}/events_merge`
USING DELTA
PARTITIONED BY (part)
AS
SELECT
    'A'                 AS part,
    CAST(id AS INT)     AS id,
    0                   AS version_count,
    'init'              AS last_writer,
    current_timestamp() AS updated_at
FROM range(1, 101)
UNION ALL
SELECT
    'B'                 AS part,
    CAST(id AS INT)     AS id,
    0                   AS version_count,
    'init'              AS last_writer,
    current_timestamp() AS updated_at
FROM range(101, 201);

SELECT part, COUNT(*) AS cnt
FROM delta.`${BASE_PATH}/events_merge`
GROUP BY part
ORDER BY part;
同時 INSERT 用の sql/02_concurrent_append.sql では1イテレーションあたり 100 行を events_append テーブルへ追記します。
02_concurrent_append.sql
-- sql/02_concurrent_append.sql
INSERT INTO delta.`${BASE_PATH}/events_append`
SELECT
    '${WRITER_ID}'     AS writer_id,
    ${ITERATION}       AS iteration,
    CAST(id AS INT)    AS row_num,
    concat(
        '${WRITER_ID}-',
        lpad('${ITERATION}', 3, '0'), '-',
        lpad(CAST(id AS STRING), 4, '0')
    )                  AS record_key,
    current_timestamp() AS written_at
FROM range(1, ${ROWS_PER_ITER} + 1);
別パーティション同時 MERGE 用の sql/03_concurrent_merge.sql では対象パーティション(App A は A、App B は B)の 100 行に対して version_count を 1 ずつ加算します。
03_concurrent_merge.sql
-- sql/03_concurrent_merge.sql
MERGE INTO delta.`${BASE_PATH}/events_merge` AS t
USING (
    SELECT
        '${TARGET_PART}' AS part,
        CAST(id AS INT)  AS id,
        '${WRITER_ID}'   AS writer_id
    FROM range(${ID_START}, ${ID_END} + 1)
) AS s
ON t.part = s.part
   AND t.id = s.id
   AND t.part = '${TARGET_PART}'
WHEN MATCHED THEN
    UPDATE SET
        t.version_count = t.version_count + 1,
        t.last_writer   = s.writer_id,
        t.updated_at    = current_timestamp();
実行用シェルスクリプト(run_test.sh)
CloudFormation スタック emr-delta-test の出力からバケット名やアプリケーション ID を取得し、アップロード・初期化・同時書き込みのジョブ投入とログ表示を行うスクリプトです。
同時書き込みの前に ensure_both_apps_started で両アプリケーションが STARTED になるまで待機する形にしています。
run_test.sh
#!/usr/bin/env bash
set -euo pipefail

STACK_NAME="${STACK_NAME:-emr-delta-test}"
AWS_REGION="${AWS_REGION:-ap-northeast-1}"
BARRIER_DELAY_SEC="${BARRIER_DELAY_SEC:-90}"
APPEND_ITERATIONS="${APPEND_ITERATIONS:-15}"
APPEND_ROWS_PER_ITER="${APPEND_ROWS_PER_ITER:-100}"
MERGE_ITERATIONS="${MERGE_ITERATIONS:-5}"

SCRIPT_DIR="$(cd "$(dirname "${BASH_SOURCE[0]}")" && pwd)"

get_output() {
  local key="$1"
  aws cloudformation describe-stacks \
    --region "$AWS_REGION" \
    --stack-name "$STACK_NAME" \
    --query "Stacks[0].Outputs[?OutputKey=='${key}'].OutputValue" \
    --output text
}

load_stack_outputs() {
  BUCKET_NAME="$(get_output BucketName)"
  JOB_ROLE_ARN="$(get_output JobRoleArn)"
  APP_A_ID="$(get_output AppAId)"
  APP_B_ID="$(get_output AppBId)"

  if [[ -z "$BUCKET_NAME" || "$BUCKET_NAME" == "None" ]]; then
    echo "[ERROR] CloudFormation stack '${STACK_NAME}' (${AWS_REGION}) の Output を取得できませんでした。" >&2
    exit 1
  fi

  BASE_DELTA_PATH="s3://${BUCKET_NAME}/delta-tables"
  RUNNER_S3_PATH="s3://${BUCKET_NAME}/runner/run_sql.py"
  SQL_S3_PREFIX="s3://${BUCKET_NAME}/sql"
}

submit_sql_job() {
  local app_id="$1"
  local job_name="$2"
  local entry_args_json="$3"

  aws emr-serverless start-job-run \
    --region "$AWS_REGION" \
    --application-id "$app_id" \
    --execution-role-arn "$JOB_ROLE_ARN" \
    --name "$job_name" \
    --job-driver "{
      \"sparkSubmit\": {
        \"entryPoint\": \"${RUNNER_S3_PATH}\",
        \"entryPointArguments\": ${entry_args_json},
        \"sparkSubmitParameters\": \"--conf spark.driver.cores=1 --conf spark.driver.memory=2g --conf spark.executor.cores=1 --conf spark.executor.memory=2g --conf spark.executor.instances=1 --conf spark.dynamicAllocation.initialExecutors=1 --conf spark.dynamicAllocation.maxExecutors=2\"
      }
    }" \
    --query "jobRunId" \
    --output text
}

wait_job() {
  local app_id="$1"
  local job_id="$2"
  local label="$3"

  while true; do
    local state
    state="$(aws emr-serverless get-job-run \
      --region "$AWS_REGION" \
      --application-id "$app_id" \
      --job-run-id "$job_id" \
      --query "jobRun.state" \
      --output text)"
    echo "[$(date '+%H:%M:%S')] ${label} (${job_id}): ${state}"
    case "$state" in
      SUCCESS)
        return 0
        ;;
      FAILED|CANCELLED)
        local detail
        detail="$(aws emr-serverless get-job-run \
          --region "$AWS_REGION" \
          --application-id "$app_id" \
          --job-run-id "$job_id" \
          --query "jobRun.stateDetails" \
          --output text)"
        echo "[WARN] ${label} (${job_id}) ended with ${state}: ${detail}"
        return 1
        ;;
      *)
        sleep 10
        ;;
    esac
  done
}

ensure_app_started() {
  local app_id="$1"
  local label="$2"

  while true; do
    local state
    state="$(aws emr-serverless get-application \
      --region "$AWS_REGION" \
      --application-id "$app_id" \
      --query "application.state" \
      --output text)"
    echo "[$(date '+%H:%M:%S')] ${label} (${app_id}) app state: ${state}"

    case "$state" in
      STARTED)
        return 0
        ;;
      CREATED|STOPPED)
        echo "[$(date '+%H:%M:%S')] Starting ${label} (${app_id})..."
        aws emr-serverless start-application \
          --region "$AWS_REGION" \
          --application-id "$app_id"
        sleep 5
        ;;
      CREATING|STARTING|STOPPING)
        sleep 5
        ;;
      *)
        echo "[ERROR] ${label} (${app_id}) is in unexpected state: ${state}" >&2
        return 1
        ;;
    esac
  done
}

ensure_both_apps_started() {
  echo "=== App A / App B の事前起動確認 (STARTED まで待機) ==="
  ensure_app_started "$APP_A_ID" "AppA" &
  local pid_a=$!
  ensure_app_started "$APP_B_ID" "AppB" &
  local pid_b=$!

  local rc_a=0 rc_b=0
  wait "$pid_a" || rc_a=$?
  wait "$pid_b" || rc_b=$?
  if [[ "$rc_a" -ne 0 || "$rc_b" -ne 0 ]]; then
    echo "[ERROR] アプリケーションの起動に失敗しました (AppA=${rc_a}, AppB=${rc_b})" >&2
    exit 1
  fi
  echo "[OK] App A / App B ともに STARTED 状態です。"
}

show_driver_stdout() {
  local app_label="$1"
  local app_id="$2"
  local job_id="$3"

  local s3_stdout="s3://${BUCKET_NAME}/emr-logs/${app_label}/applications/${app_id}/jobs/${job_id}/SPARK_DRIVER/stdout.gz"
  echo "----- Driver stdout (${app_label} / ${job_id}) -----"
  for _ in 1 2 3 4 5 6; do
    if aws s3 ls "$s3_stdout" --region "$AWS_REGION" >/dev/null 2>&1; then
      aws s3 cp "$s3_stdout" - --region "$AWS_REGION" | gunzip
      echo "---------------------------------------------------"
      return 0
    fi
    sleep 5
  done
  echo "(stdout.gz がまだ見つかりません: ${s3_stdout})"
}

cmd="${1:-}"
if [[ -z "$cmd" ]]; then
  echo "Usage: $0 {upload|init|append|merge|logs}"
  exit 1
fi

load_stack_outputs

case "$cmd" in
  upload)
    echo "Uploading runner/ and sql/ to s3://${BUCKET_NAME}/ ..."
    aws s3 sync "${SCRIPT_DIR}/runner/" "s3://${BUCKET_NAME}/runner/" --region "$AWS_REGION"
    aws s3 sync "${SCRIPT_DIR}/sql/"    "${SQL_S3_PREFIX}/"          --region "$AWS_REGION"
    echo "[OK] Upload completed."
    ;;

  init)
    echo "Submitting sql/01_init_table.sql to App A (${APP_A_ID})..."
    job_id="$(submit_sql_job "$APP_A_ID" "delta-init-tables" \
      "[\"--sql-file\", \"${SQL_S3_PREFIX}/01_init_table.sql\", \"--var\", \"BASE_PATH=${BASE_DELTA_PATH}\"]")"
    echo "JobRunId: ${job_id}"
    wait_job "$APP_A_ID" "$job_id" "AppA-init"
    show_driver_stdout "app-a" "$APP_A_ID" "$job_id"
    ;;

  append)
    ensure_both_apps_started
    start_epoch="$(( $(date +%s) + BARRIER_DELAY_SEC ))"
    echo "=== 検証ケース1: 同時 INSERT (sql/02_concurrent_append.sql) ==="
    echo "Target table : ${BASE_DELTA_PATH}/events_append"
    echo "Barrier epoch: ${start_epoch} (+${BARRIER_DELAY_SEC}s)"

    job_a="$(submit_sql_job "$APP_A_ID" "delta-append-A" \
      "[\"--sql-file\", \"${SQL_S3_PREFIX}/02_concurrent_append.sql\", \"--repeat\", \"${APPEND_ITERATIONS}\", \"--start-epoch\", \"${start_epoch}\", \"--var\", \"BASE_PATH=${BASE_DELTA_PATH}\", \"--var\", \"WRITER_ID=writer_A\", \"--var\", \"ROWS_PER_ITER=${APPEND_ROWS_PER_ITER}\"]")"
    job_b="$(submit_sql_job "$APP_B_ID" "delta-append-B" \
      "[\"--sql-file\", \"${SQL_S3_PREFIX}/02_concurrent_append.sql\", \"--repeat\", \"${APPEND_ITERATIONS}\", \"--start-epoch\", \"${start_epoch}\", \"--var\", \"BASE_PATH=${BASE_DELTA_PATH}\", \"--var\", \"WRITER_ID=writer_B\", \"--var\", \"ROWS_PER_ITER=${APPEND_ROWS_PER_ITER}\"]")"

    echo "Submitted App A job: ${job_a}"
    echo "Submitted App B job: ${job_b}"

    wait_job "$APP_A_ID" "$job_a" "AppA-append" &
    pid_a=$!
    wait_job "$APP_B_ID" "$job_b" "AppB-append" &
    pid_b=$!

    rc_a=0; rc_b=0
    wait "$pid_a" || rc_a=$?
    wait "$pid_b" || rc_b=$?

    show_driver_stdout "app-a" "$APP_A_ID" "$job_a"
    show_driver_stdout "app-b" "$APP_B_ID" "$job_b"

    if [[ "$rc_a" -ne 0 || "$rc_b" -ne 0 ]]; then
      echo "[NG] 一方または両方のジョブが失敗しました (AppA=${rc_a}, AppB=${rc_b})"
      exit 1
    fi
    echo "[OK] 両ジョブ正常完了。EMR Studio で結果を確認してください。"
    ;;

  merge)
    ensure_both_apps_started
    start_epoch="$(( $(date +%s) + BARRIER_DELAY_SEC ))"
    echo "=== 検証ケース2: 別パーティション同時 MERGE (sql/03_concurrent_merge.sql) ==="
    echo "Target table : ${BASE_DELTA_PATH}/events_merge"
    echo "Barrier epoch: ${start_epoch} (+${BARRIER_DELAY_SEC}s)"

    job_a="$(submit_sql_job "$APP_A_ID" "delta-merge-A" \
      "[\"--sql-file\", \"${SQL_S3_PREFIX}/03_concurrent_merge.sql\", \"--repeat\", \"${MERGE_ITERATIONS}\", \"--start-epoch\", \"${start_epoch}\", \"--var\", \"BASE_PATH=${BASE_DELTA_PATH}\", \"--var\", \"WRITER_ID=writer_A\", \"--var\", \"TARGET_PART=A\", \"--var\", \"ID_START=1\", \"--var\", \"ID_END=100\"]")"
    job_b="$(submit_sql_job "$APP_B_ID" "delta-merge-B" \
      "[\"--sql-file\", \"${SQL_S3_PREFIX}/03_concurrent_merge.sql\", \"--repeat\", \"${MERGE_ITERATIONS}\", \"--start-epoch\", \"${start_epoch}\", \"--var\", \"BASE_PATH=${BASE_DELTA_PATH}\", \"--var\", \"WRITER_ID=writer_B\", \"--var\", \"TARGET_PART=B\", \"--var\", \"ID_START=101\", \"--var\", \"ID_END=200\"]")"

    echo "Submitted App A job: ${job_a}"
    echo "Submitted App B job: ${job_b}"

    wait_job "$APP_A_ID" "$job_a" "AppA-merge" &
    pid_a=$!
    wait_job "$APP_B_ID" "$job_b" "AppB-merge" &
    pid_b=$!

    rc_a=0; rc_b=0
    wait "$pid_a" || rc_a=$?
    wait "$pid_b" || rc_b=$?

    show_driver_stdout "app-a" "$APP_A_ID" "$job_a"
    show_driver_stdout "app-b" "$APP_B_ID" "$job_b"

    if [[ "$rc_a" -ne 0 || "$rc_b" -ne 0 ]]; then
      echo "[NG] 一方または両方のジョブが失敗しました (AppA=${rc_a}, AppB=${rc_b})"
      exit 1
    fi
    echo "[OK] 別パーティション同時 MERGE が両方成功しました。"
    ;;

  logs)
    app_arg="${2:-}"
    job_id="${3:-}"
    if [[ -z "$app_arg" || -z "$job_id" ]]; then
      echo "Usage: $0 logs <app-a|app-b> <job-run-id>"
      exit 1
    fi
    if [[ "$app_arg" == "app-a" ]]; then
      show_driver_stdout "app-a" "$APP_A_ID" "$job_id"
    elif [[ "$app_arg" == "app-b" ]]; then
      show_driver_stdout "app-b" "$APP_B_ID" "$job_id"
    else
      echo "app must be 'app-a' or 'app-b'"
      exit 1
    fi
    ;;

  *)
    echo "Unknown command: $cmd"
    exit 1
    ;;
esac
環境のデプロイと初期化
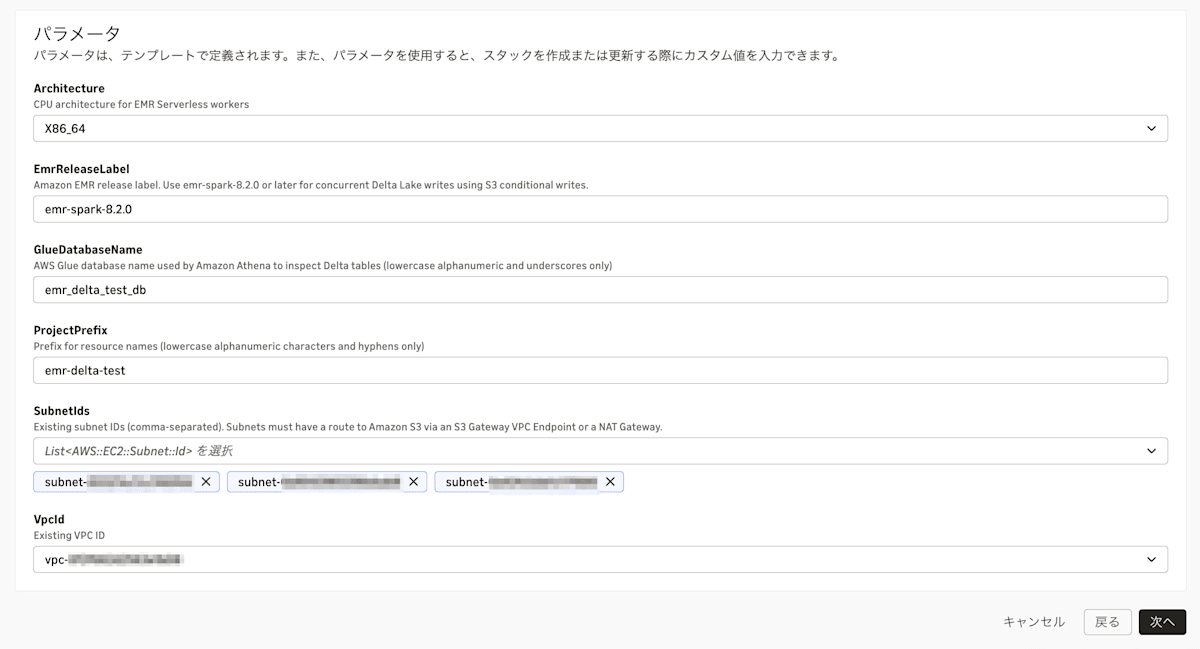
1. CloudFormation スタックの作成
東京リージョン(ap-northeast-1)でスタック名を emr-delta-test として template.yaml をデプロイします。
パラメータには既存の VPC ID と、S3 Gateway VPC Endpoint への経路を持つプライベートサブネット ID を指定します。
2. スクリプトのアップロードとテーブル初期化
続いて、ランナーと SQL ファイルを S3 バケットへアップロードし、Delta Lake テーブルを初期化します。
$ chmod +x run_test.sh
$ ./run_test.sh upload
$ ./run_test.sh init
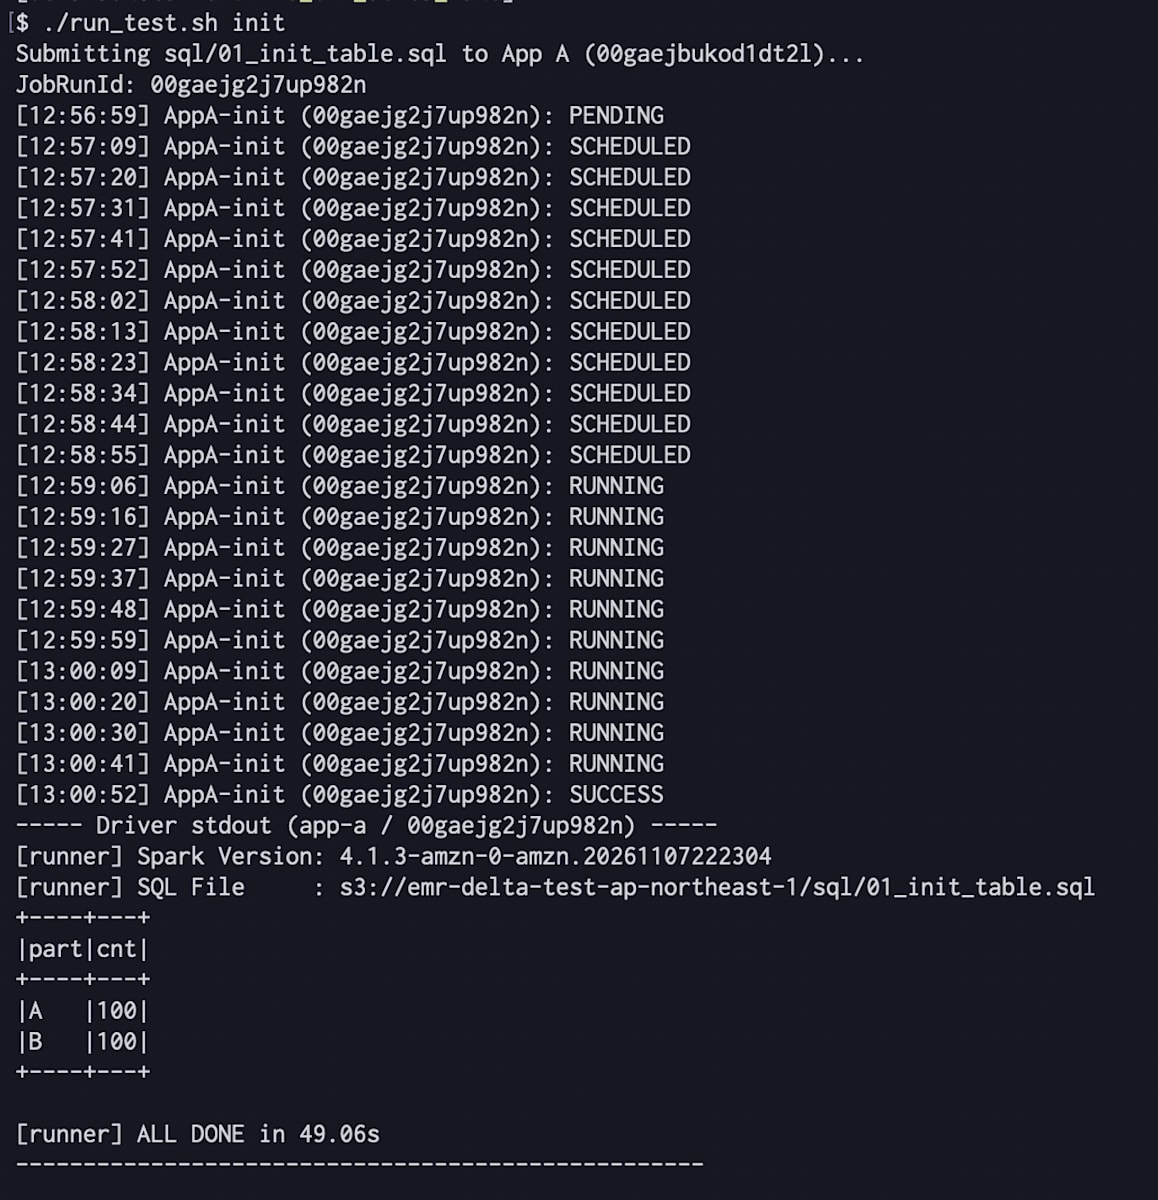
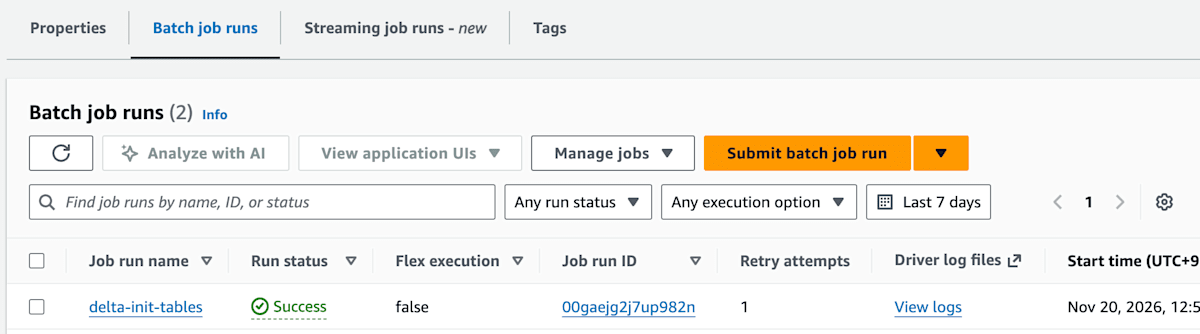
./run_test.sh init を実行すると、EMR Serverless App A 上で delta-init-tables ジョブが走ります。
Driver の標準出力から、Spark バージョンが 4.1.3-amzn-0-amzn.20261107222304 であることと、events_merge テーブルに part='A' と part='B' が 100 行ずつ投入されたことを確認できました。
EMR Serverless のコンソールでも、delta-init-tables が Success になっていることを確認できます。
検証1:2つの EMR Serverless アプリケーションからの同時 INSERT(APPEND)
まず、App A(writer_A)と App B(writer_B)の2つの独立したアプリケーションから、同一の Delta Lake テーブル(events_append)へ同時に INSERT を実行しました。
1回の実行で各アプリケーションが 15 イテレーション × 100 行 = 1,500 行を書き込むため、両方あわせて 3,000 行が追加されます。
今回は次のコマンドを2回連続で実行したため、最終的な総件数は 3,000 行 × 2 回 = 6,000 行(App A・App B それぞれ 3,000 行)になります。
$ ./run_test.sh append
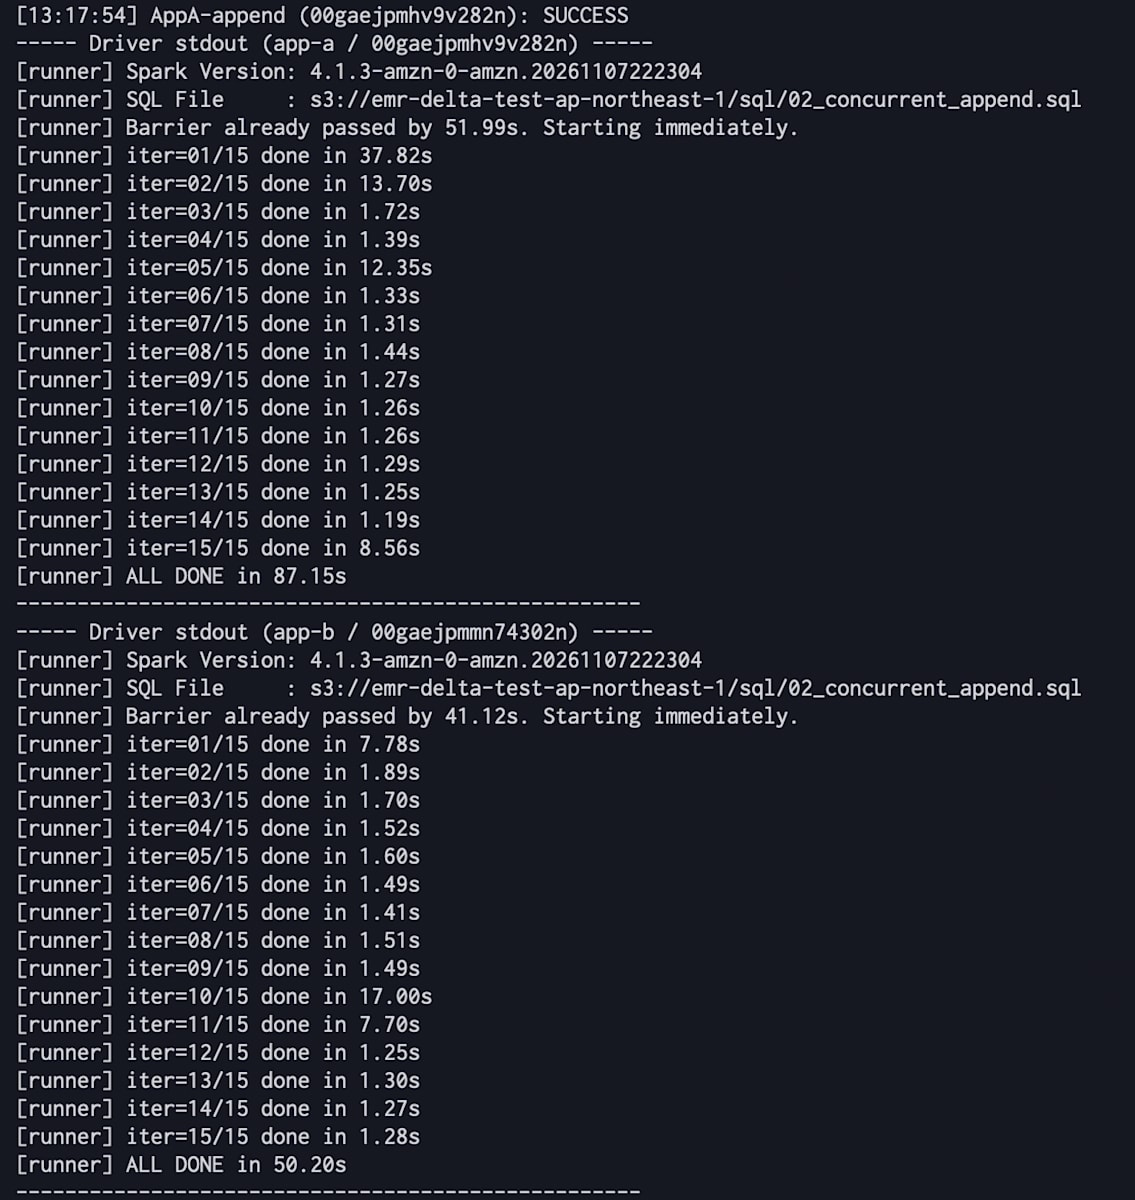
スクリプトを実行すると、両アプリケーションが STARTED になったのを確認したあと、ジョブが並列に投入されて同時に RUNNING 状態へ遷移しました。
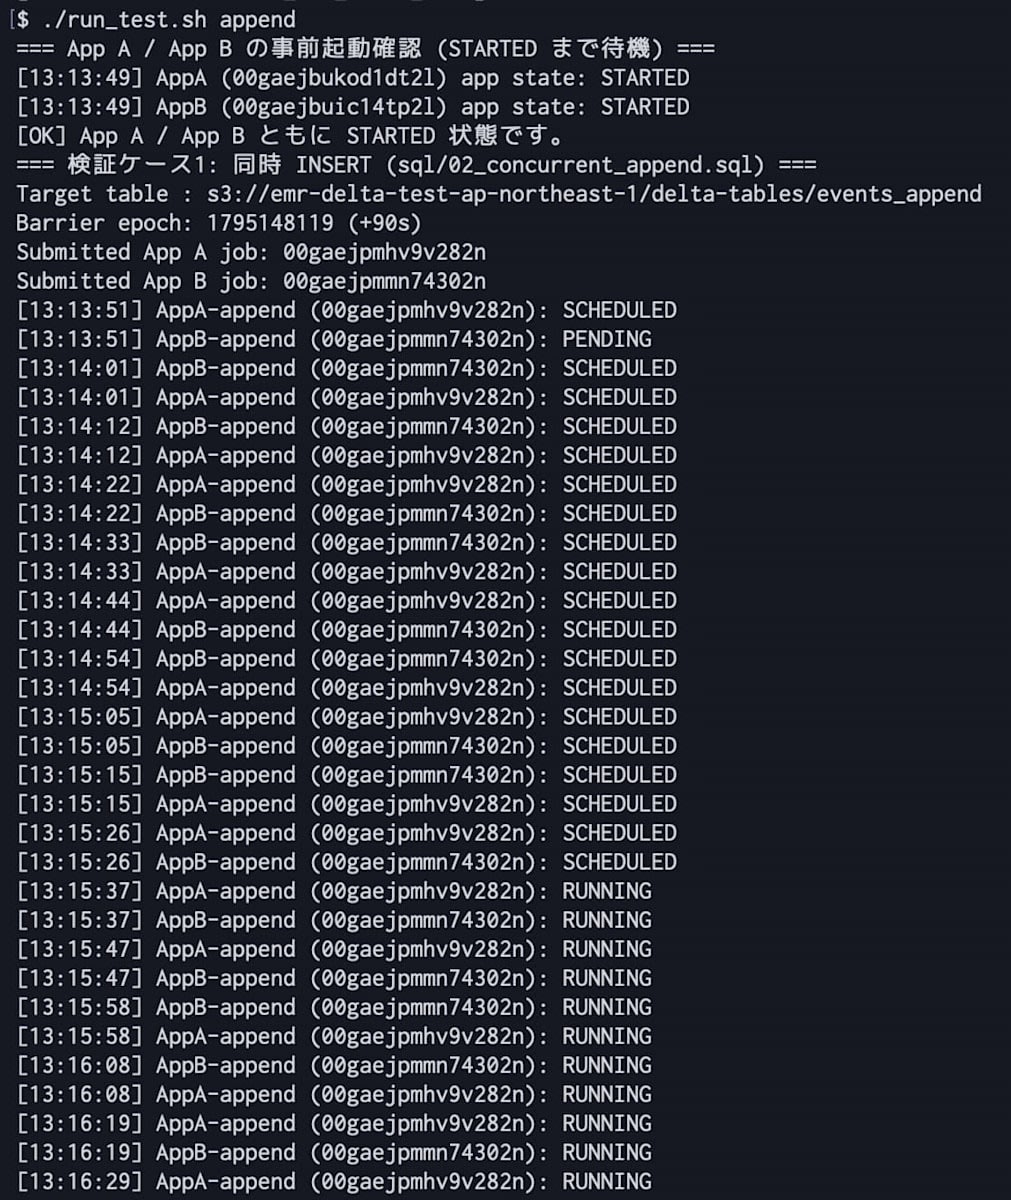
完了後に表示された Driver の標準出力を見ると、App A、App B でそれぞれ 15 イテレーションすべてをエラーなしで完了しています。
Amazon EMR Studio での結果確認
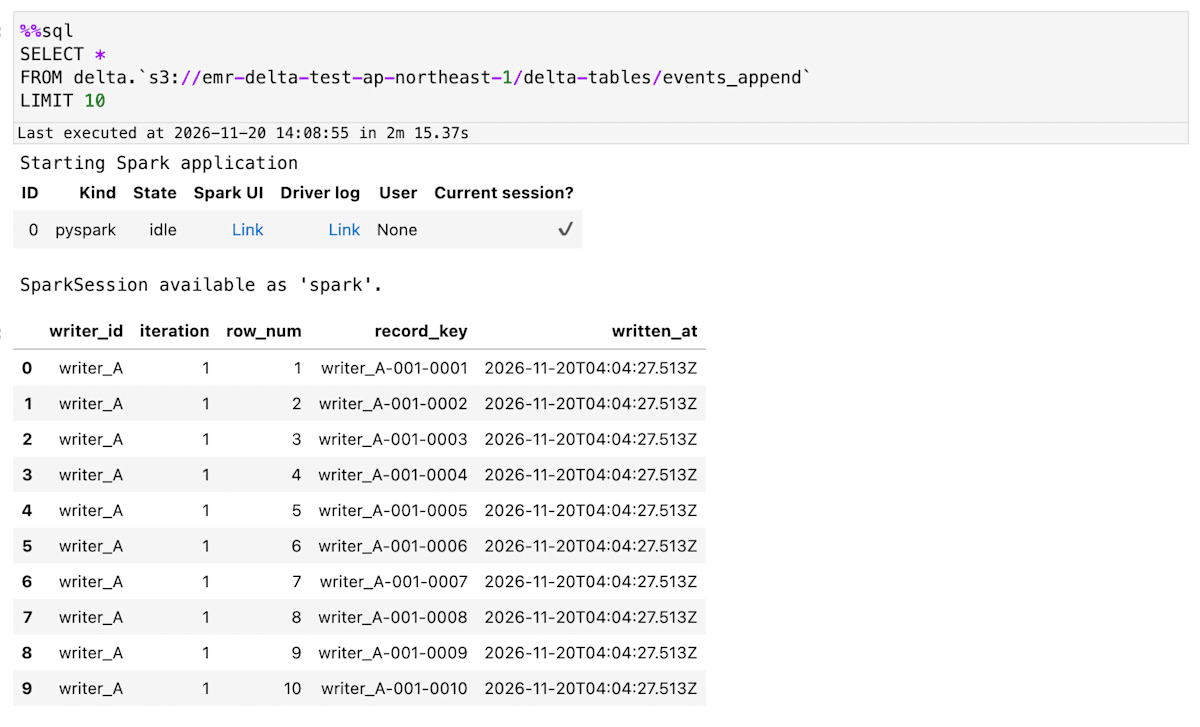
続いて、EMR Studio の Workspace に emr-delta-test-app-a をアタッチし、PySpark カーネルのノートブックから %%sql で events_append テーブルの中身を確認しました。
前述のとおり ./run_test.sh append を2回実行しているため、期待される総件数は 6,000 行です。
まず先頭 10 行を取得し、Delta テーブルからレコードを読み取れることを確認しました。
%%sql
SELECT *
FROM delta.`s3://emr-delta-test-ap-northeast-1/delta-tables/events_append`
LIMIT 10
次に、総件数と一意キー数を確認するクエリを実行しました。
%%sql
SELECT
  COUNT(*) AS total_rows,
  COUNT(DISTINCT record_key) AS distinct_keys,
  COUNT(*) - COUNT(DISTINCT record_key) AS duplicate_rows
FROM delta.`s3://emr-delta-test-ap-northeast-1/delta-tables/events_append`
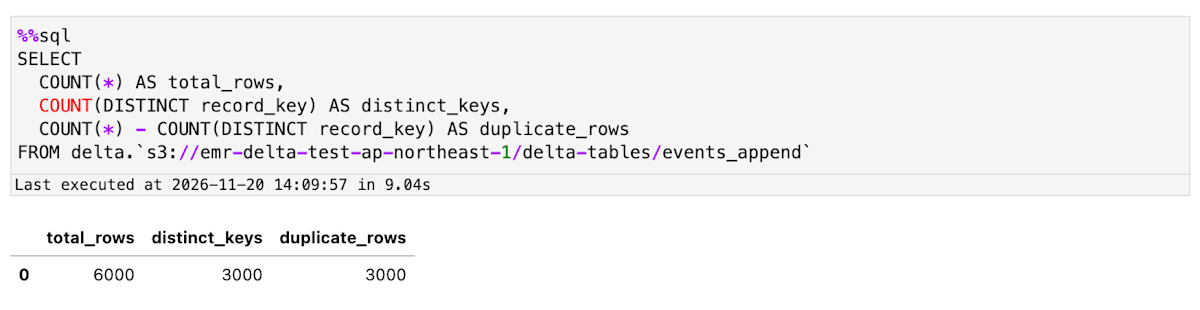
total_rows が 6000 となり、2回分の同時書き込みで 1 行の欠損もなく記録されていることを確認できました。
同じ record_key 生成ロジックで 2 回実行しているため、distinct_keys は 3000、duplicate_rows は 3000 になっています。
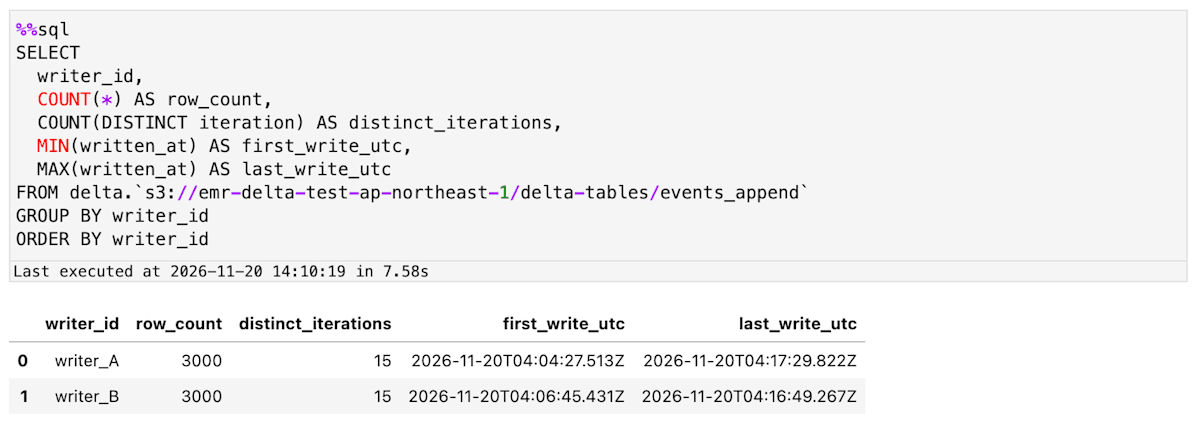
さらに、writer_id ごとの件数と書き込み時間帯を集計しました。
%%sql
SELECT
  writer_id,
  COUNT(*) AS row_count,
  COUNT(DISTINCT iteration) AS distinct_iterations,
  MIN(written_at) AS first_write_utc,
  MAX(written_at) AS last_write_utc
FROM delta.`s3://emr-delta-test-ap-northeast-1/delta-tables/events_append`
GROUP BY writer_id
ORDER BY writer_id
| writer_id | row_count | distinct_iterations | first_write_utc | last_write_utc |
|---|---|---|---|---|
writer_A |
3000 | 15 | 2026-11-20T04:04:27.513Z | 2026-11-20T04:17:29.822Z |
writer_B |
3000 | 15 | 2026-11-20T04:06:45.431Z | 2026-11-20T04:16:49.267Z |
両アプリケーションの書き込み時間帯が重なっているにもかかわらず、writer_A と writer_B のどちらも 3,000 行(1回あたり 1,500 行 × 2 回)すべてが欠損なく保存されています。
検証2:別パーティションへの同時 MERGE
次に、より実運用に近い更新パターンとして、同一テーブル(events_merge)の異なるパーティションに対する同時 MERGE を検証しました。
App A(writer_A)が part='A' の 100 行、App B(writer_B)が part='B' の 100 行に対して、それぞれ 5 回ずつ同時に MERGE INTO を実行し、version_count をインクリメントします。
./run_test.sh merge
同時 INSERT と同様に、両アプリケーションが同時に RUNNING になり処理が進みました。
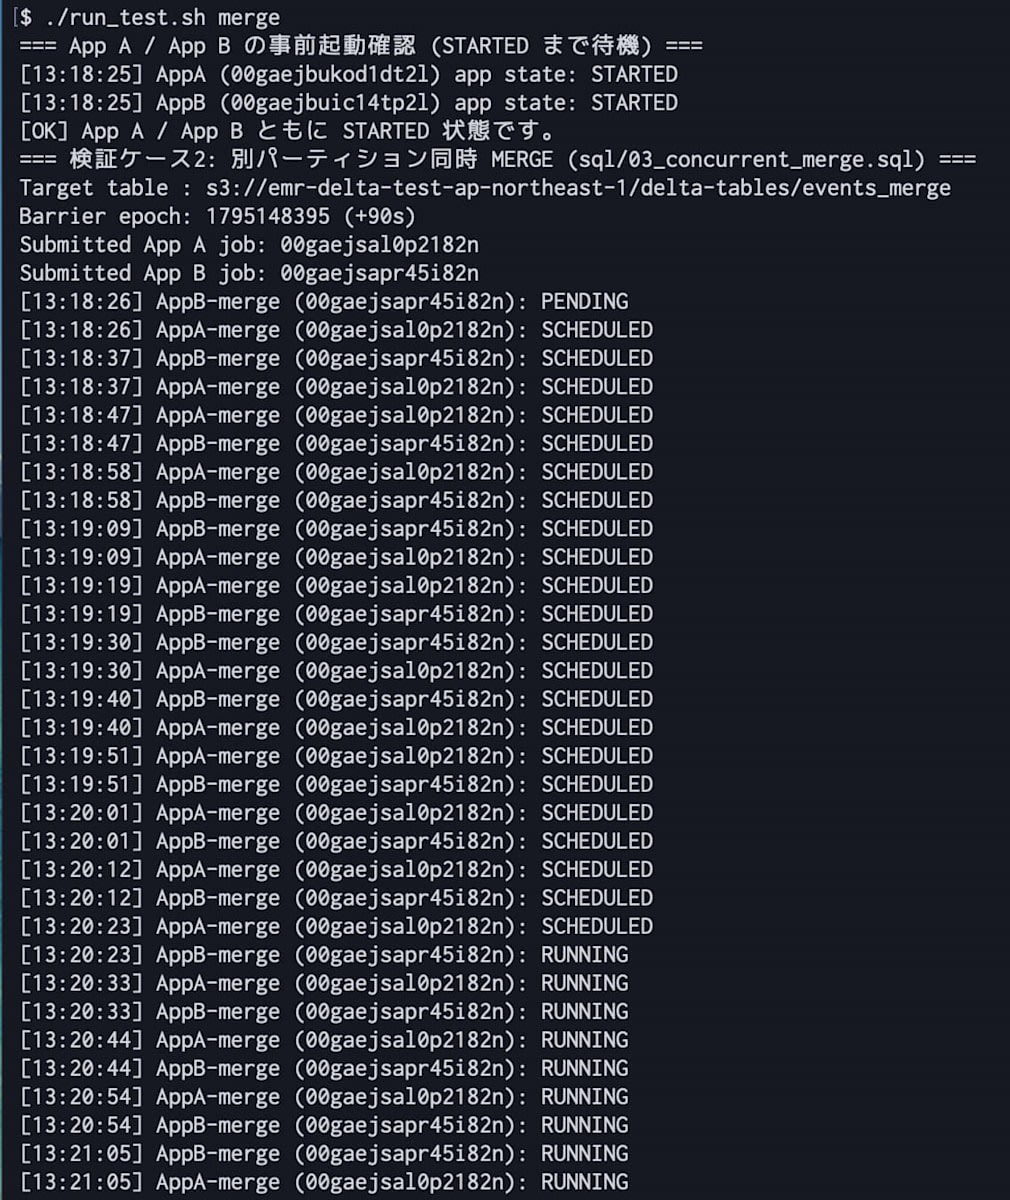
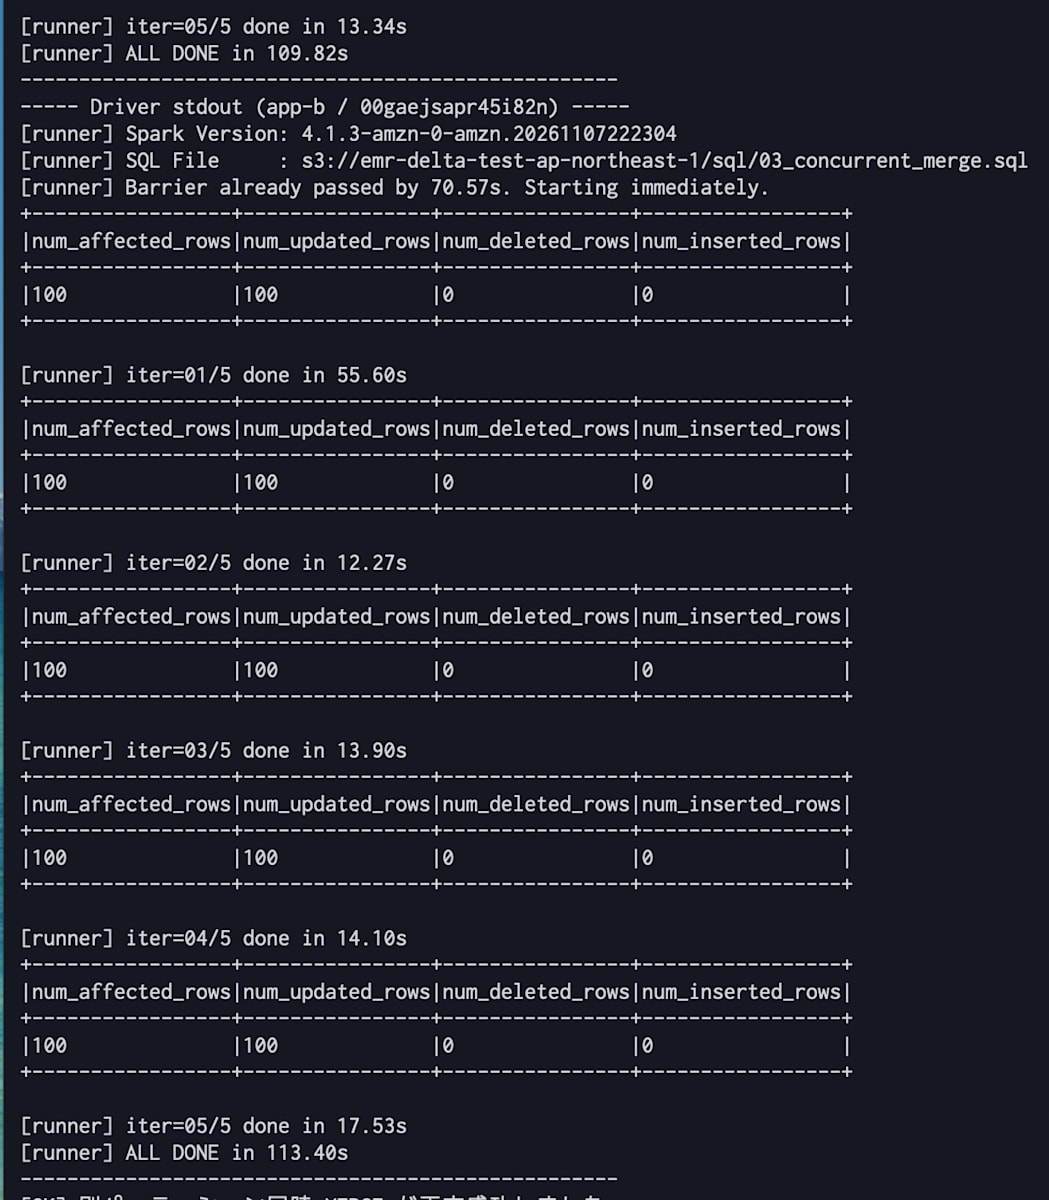
Driver の標準出力では、App A、App B でそれぞれ 5 イテレーションすべてを完了しました。
各イテレーションで num_affected_rows=100、num_updated_rows=100 が出力されており、エラーは発生していません。
Amazon EMR Studio での結果確認
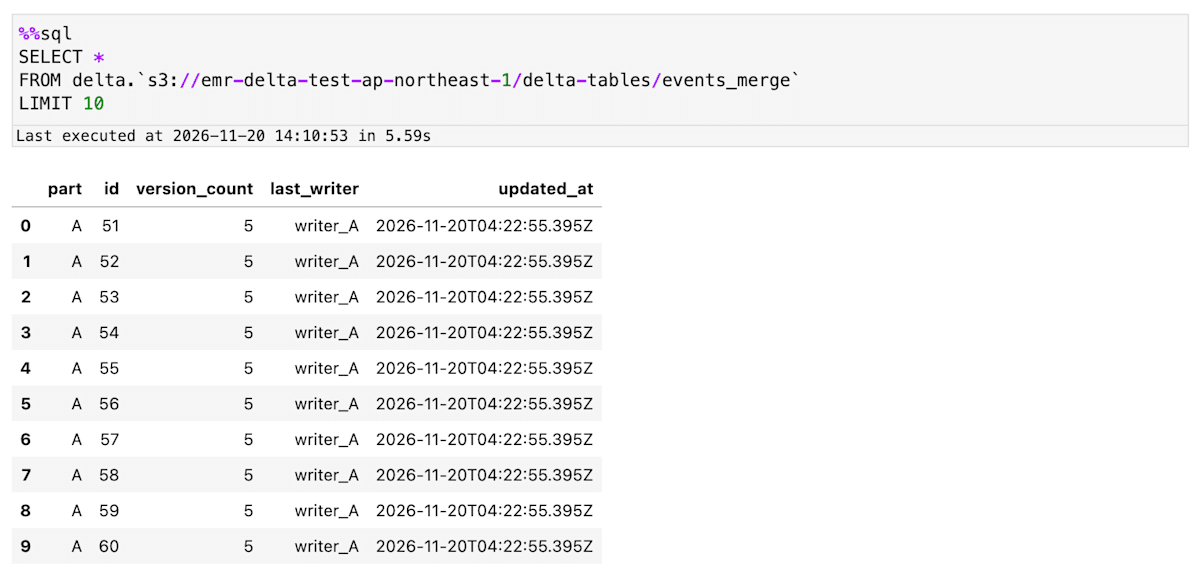
EMR Studio のノートブックで events_merge テーブルの先頭 10 行を取得すると、version_count が 5 に更新されていることを確認できました。
%%sql
SELECT *
FROM delta.`s3://emr-delta-test-ap-northeast-1/delta-tables/events_merge`
LIMIT 10
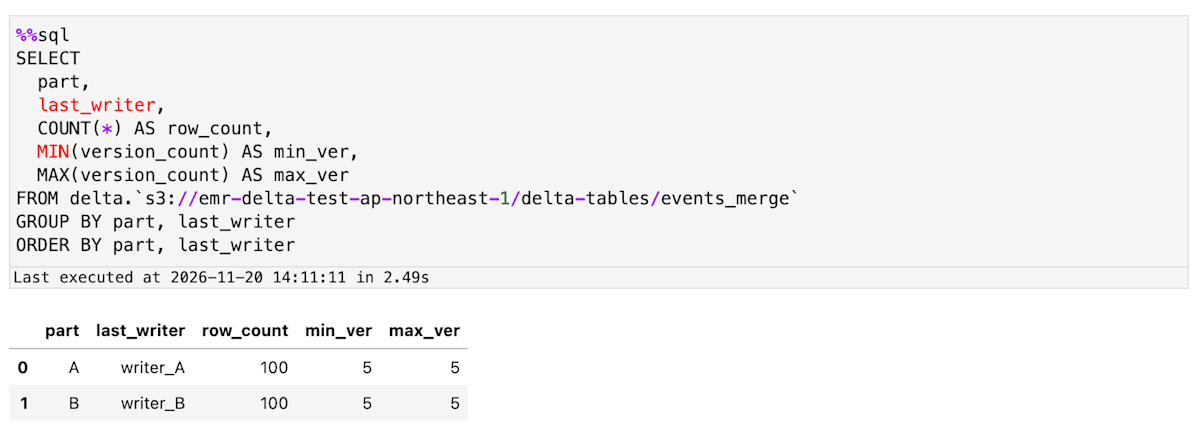
続いてパーティション別に件数と version_count の最小値・最大値を集計しました。
%%sql
SELECT
  part,
  last_writer,
  COUNT(*) AS row_count,
  MIN(version_count) AS min_ver,
  MAX(version_count) AS max_ver
FROM delta.`s3://emr-delta-test-ap-northeast-1/delta-tables/events_merge`
GROUP BY part, last_writer
ORDER BY part, last_writer
| part | last_writer | row_count | min_ver | max_ver |
|---|---|---|---|---|
A |
writer_A |
100 | 5 | 5 |
B |
writer_B |
100 | 5 | 5 |
App A と App B が合計 10 回の MERGE コミットを同時実行した結果、更新の取りこぼし(ロストアップデート)は一切なく、全 200 行で version_count が 5 になっていることを確認できました。
なお、Delta Lake の同時実行制御は楽観的同時実行制御(Optimistic Concurrency Control)に基づいているため、同一データファイルや同一パーティションの行を複数ジョブから同時に書き換えるような競合パターンでは、仕様どおり例外(ConcurrentAppendException など)で失敗します。
今回の S3 条件付き書き込みによって解消されるのは、_delta_log のコミットファイル作成における S3 上の排他制御(従来 DynamoDB が担っていた役割)となります。
最後に
Amazon EMR 8.2(emr-spark-8.2.0)の EMR Serverless を使い、DynamoDB ログストアなしで S3 上の Delta Lake テーブルへ複数アプリケーションから同時書き込みできることを実機で確認しました。
従来はマルチクラスター構成で Delta Lake を運用するたびに DynamoDB テーブルの作成や IAM 権限、Spark 側の LogStore 設定を管理する必要がありましたが、EMR 8.2 からは特別な追加設定なしで S3 の条件付き書き込みが有効になり、構成が大幅にシンプルになります。
参考になりましたら幸いです。