NVIDIAの時系列モデルKumo-TS(旧NV-Tesseract)v1.0.1の異常の説明機能と欠損対応予測を試してみた

こんちには。製造ビジネステクノロジー部の中村(@nokomoro3)です。
2026年11月10日に、NVIDIAの時系列分析ライブラリ「Kumo-TS」のv1.0.1が公開されました。
Kumo-TSは、これまで「NV-Tesseract」と呼ばれていたライブラリの新しい名前となっています。
時系列の予測では、AmazonのChronosやGoogleのTimesFMのように、大量のデータで事前学習しておき、そのまま予測に使う(ゼロショット)時系列基盤モデルがよく知られています。
Kumo-TSは、時系列基盤モデル(MOMENT)を土台に、自分のデータでファインチューニングして使う作りで、予測の解釈や欠損への対応、異常検知までを1つのライブラリにまとめている点が異なります。
今回のリリース(v1.0.1)ではNV-Tesseract時代になかった以下が追加されています。
- 異常を検知したときに「どのセンサーが、どんな形で異常判定に効いたのか」を説明する機能
- 欠損を含むデータのまま予測する機能
本記事では、この2つの新機能を手元のMac(Apple M4)で動かし、実際にどこまで使えるのかを確かめました。
結論
- Kumo-TSの構成
- 予測のKumo-Forecastと異常検知のKumo-Anomalyの2つのパッケージから構成(この構成はNV-Tesseract時代と同じ)
- ライブラリもモデルの重みもApache 2.0で公開
- 2つのパッケージは同じ名前のモジュール(
sdk)を持つため、別々の仮想環境に入れる必要あり
- 動作環境
- 公式の動作確認環境はA100とH100だが、Apple M4(メモリ16GB)のMacでもMPS(AppleのGPU)で動作可能
- Kumo-Anomalyは推論が重く、公式サンプル(3センサー、500行)でも約145秒必要
- 異常の種類の診断まで有効にすると推論が5回走るため、5センサー800行で約16〜19分必要
- 異常の説明機能(Kumo-Anomaly)
- 5センサーの合成データに、センサーと種類(レベルシフト、トレンド変化、スパイク、分散の増大)を変えて4つの異常を注入し、説明機能がそれを言い当てられるかを検証
- 結果、どのセンサーが異常判定に効いたかは、おおむね正しく示すことを確認
- 一方で異常の種類の推定は、スパイクは当てたが一定時間続く異常は判定できなかったり、誤ったりした
- 異常検出自体は、ゆっくり周期変動するようなデータでは、異常スコアがその周期変動に引きずられ、4つの異常のうち3つを見逃した
- 周期変動のないデータでは4つの異常すべてで一部の行を検出できたため、周期成分を取り除く前処理で改善できる可能性がある(今回は未検証)
- 欠損対応の予測(Kumo-Forecast)
- 公開データセット(ETTh1)の変圧器の油温を24時間先まで予測するタスクで、入力に欠損を入れたときに、予測区間の誤差(MAE)がどう変わるかを比較
- デフォルト設定(
handle_missingness=False)では入力の欠損が0で埋められ、欠損率50%で誤差が欠損なしの約3倍に悪化 handle_missingness=Trueにすることで欠損対応の別モデルに切り替わり、悪化を抑えられた- ただし今回のデータでは、欠損を線形補間で埋めてからデフォルト設定で予測するほうが、平均では誤差が小さかった
検証用コード
検証に使用したスクリプトは以下のリポジトリにあります。
Kumo-TSとは
Kumo-TSは、多変量の時系列データを対象に、予測と異常検知を行うライブラリです。
Kumo-TSの構成
Kumo-TSは、予測のKumo-Forecastと、異常検知のKumo-Anomalyの2つのパッケージからなります。
どちらもpandasのDataFrameを渡して結果をDataFrameで受け取るAPIになっており、事前学習済みの重みはHugging Faceから自動でダウンロードされます。
| パッケージ | 旧称 | 手法 | パラメータ数 | モデル |
|---|---|---|---|---|
| Kumo-Forecast | NV-Tesseract Forecasting | 事前学習済みのTransformerに予測ヘッドを付けたもの | 約340M(エンコーダ部分) | nvidia/Kumo-Forecast |
| Kumo-Anomaly | NV-Tesseract AD-Diffusion | 拡散モデルによる再構成と、適応的なしきい値処理 | 約8M(モデルカードの値) | nvidia/Kumo-Anomaly |
Kumo-Forecastのバックボーンは、時系列の基盤モデルであるMOMENT-1-largeで、エンコーダが約340M(0.34B)パラメータです。
MOMENT-1-largeのエンコーダは凍結し、予測ヘッドだけを学習し直しています。
過去の類似パターンをk近傍法で検索して予測に組み合わせる「DARR(Domain-Aware Representation and Retrieval)」というモードや、どの過去時点と特徴量が予測に効いたかを出力する解釈機能も備えています。
Kumo-Anomalyは、拡散モデルで入力を再構成し、入力と再構成の差(MAE:Mean Absolute Error、平均絶対誤差)が大きい時点を異常候補とする方式です。
しきい値は固定値ではなく、系列を区間に分けて区間ごとに信頼区間を設定するSCS(Segmented Confidence Sequences)と、短期、中期、長期の複数の時間スケールを組み合わせるMACS(Multi-Scale Adaptive Confidence Segments)から選べます。
Kumo-AnomalyはKumo-Forecastとは別のモデルで、規模もずっと小さく、モデルカードではパラメータ数が約8Mとされていますが、公開されているチェックポイント final_model.pth の重みを実際に数えると約2.4Mとなっていました。
v1.0.1で追加された機能
v1.0.1では、Kumo-TSへの改名と同時に、以下の機能が追加されています。
- Kumo-Anomaly
- 異常の説明:検出した異常ごとに、再構成誤差への寄与が大きい特徴量とその割合を返す。CSVとPDFのレポートも出力できる
- 再構成の診断:異常の形を「レベルシフト」「トレンド変化」「一時的なスパイク」「分散の増大」の4つの型に当てはめて判定する
- 過去の帰属分析:異常の手前の観測を正常な履歴に置き換えたとき、再構成がどれだけ変わるかを測る
- Kumo-Forecast
- 欠損を考慮した予測:
handle_missingness=Trueで、NaNを含む入力を、ゼロ埋めではなく観測マスクで扱う別モデルに渡す
- 欠損を考慮した予測:
READMEには、説明と帰属分析は「モデルの振る舞いと感度を記述するもので、物理的な因果関係を示すものではない」と明記されています。
「異常がなぜ起きたか」の説明といっても、あくまでモデルの再構成誤差がどのセンサーから来ているか、という意味での説明となっている点は注意が必要です。
因果関係の分析は従来通り人間が考察する必要があります。
Kumo-Anomalyの3つの機能は、それぞれ別の設定で有効にします。
| 機能 | 答える問い | 有効にする設定 | 追加の推論 | 本記事での検証 |
|---|---|---|---|---|
| 異常の説明 | どのセンサーが異常スコアを押し上げたか | explain=True |
なし | あり |
| 再構成の診断 | 異常がどんな形をしているか | diagnose_reconstruction=True(explain=True が前提) |
4回 | あり |
| 過去の帰属分析 | 異常の手前のどの観測が異常に効いたか | historical_attribution 引数 |
あり | なし |
以下、それぞれの仕組みを説明します。
異常の説明の仕組み
異常の説明は、すでに計算済みの入力と再構成の値から求めるため、追加の推論はいりません。
異常と判定された行ごとに、特徴量ごとの再構成誤差の絶対値を求め、その行の誤差の合計で割った割合を「寄与」とします。
寄与の大きい上位の特徴量を TopContributors、その割合を ContributionShares として返します。
再構成の診断の仕組み
再構成の診断は、異常の形を、レベルシフト、トレンド変化、一時的なスパイク、分散の増大の4つの型に分け、どの型に最も当てはまるかを判定する機能です。
この4つの型はSDKのコード(sdk/reconstruction_failure.py)にあらかじめ固定で定義されています。
型ごとの修復のしかた(段差を差し引く、傾きを差し引くなど)も、ルールとしてコードに書かれており、設定で型を増やしたり変えたりする項目はありません。
モデル(拡散モデル)は、修復した入力の異常スコアを計算し直すためだけに使われます。
この判定には、反実仮想(「もし〜だったら」という仮定を立てて確かめる方法)を使います。
たとえば「この異常がレベルシフトなら、段差の分を差し引けば正常に戻り、異常スコアは下がるはずだ」と仮定し、実際に入力から段差を差し引いて(Kumo-TSではこれを「修復」と呼んでいます)もう一度推論します。
同じことを4つの型それぞれで行い、異常スコアが最も下がった型を LikelyReconstructionIssue として返します。
1位と2位の下がり幅の差から確信度(DiagnosticConfidence)を決め、どの型で修復してもスコアが下がらなければ「No supported repair」(どの型にも当てはまらない)を返します。
修復の対象は、検出した異常区間とその手前20行のうち、異常の説明で寄与が大きいとされた特徴量だけです。
4つの型ごとに推論が1回ずつ増えるため、処理時間は約5倍になります。
修復の基準となる「正常な値」には、入力を窓幅21行で移動中央値をとったものが使われています。
この設計が、後で見る診断の結果に影響していました。
過去の帰属分析の仕組み
過去の帰属分析は、異常の手前の一定区間(既定では20行)を正常な履歴に置き換えて再構成し直し、異常の時点の誤差がどれだけ減るかを測る機能です。
誤差が大きく減れば、置き換えた区間の観測がその異常に効いていた、と読み取れます。
置き換えに使う正常な履歴は、利用者が用意します。
入力と行と列がそろった検証済みの正常データを渡すか、正常な期間を宣言した履歴から、似た区間を検索させる必要があります。
本記事ではこの正常データを用意していないため、過去の帰属分析は試していません。
実行環境
検証には以下の環境を使いました。
- Apple M4(メモリ16GB)のMac
- Python 3.12、PyTorch 2.11.0(各パッケージの
uv.lockで固定されたもの) - Kumo-TS v1.0.1(コミット
ad45947)
公式の動作確認環境はA100とH100ですが、コードにはCUDAが使えない場合にMPS、さらにCPUへ切り替える処理が入っています。
セットアップ
リポジトリをクローンし、パッケージごとに仮想環境を作ります。
git clone https://github.com/NVIDIA/Kumo-TS.git
cd Kumo-TS/Kumo-Anomaly && uv sync --frozen --python 3.12
cd ../Kumo-Forecast && uv sync --frozen --python 3.12
2つのパッケージはどちらも sdk という名前のトップレベルモジュールを公開しているため、同じ環境には入れられません。
本記事のスクリプトは、uv run --project で対象のパッケージの環境を指定して実行します。
なお、チェックポイントはpickle形式で読み込まれるため、信頼できる提供元のファイルだけを使うよう注意書きがあります。
公式サンプルでの動作確認
まず、Kumo-Anomalyの公式サンプル(examples/quick_example.py)を実行しました。
3センサー500行の合成データに異常を入れ、検出結果を正解と比べるサンプルです。
uv run --project Kumo-TS/Kumo-Anomaly python Kumo-TS/Kumo-Anomaly/examples/quick_example.py
INFO - Total samples analyzed: 500
INFO - Anomalies detected: 24
INFO - Anomaly rate: 4.80%
INFO - Evaluation Metrics (vs Ground Truth):
INFO -   Precision: 1.000
INFO -   Recall:    0.195
INFO -   F1-Score:  0.327
推論の時間は、MPSで約145秒、CPUで約216秒でした。
窓長100の拡散モデルで、15回のサンプリング(nsample=15)を20ステップずつ回すため、行数のわりに時間がかかります。
また、拡散モデルのサンプリングは確率的なので、MPSとCPUで検出数が24と23に分かれたように、実行ごとに結果が少し変わります。
異常の説明機能を試す方法
合成データの設計
説明機能の正しさを確かめるには、異常の原因になったセンサーと異常の形が既知のデータが必要です。
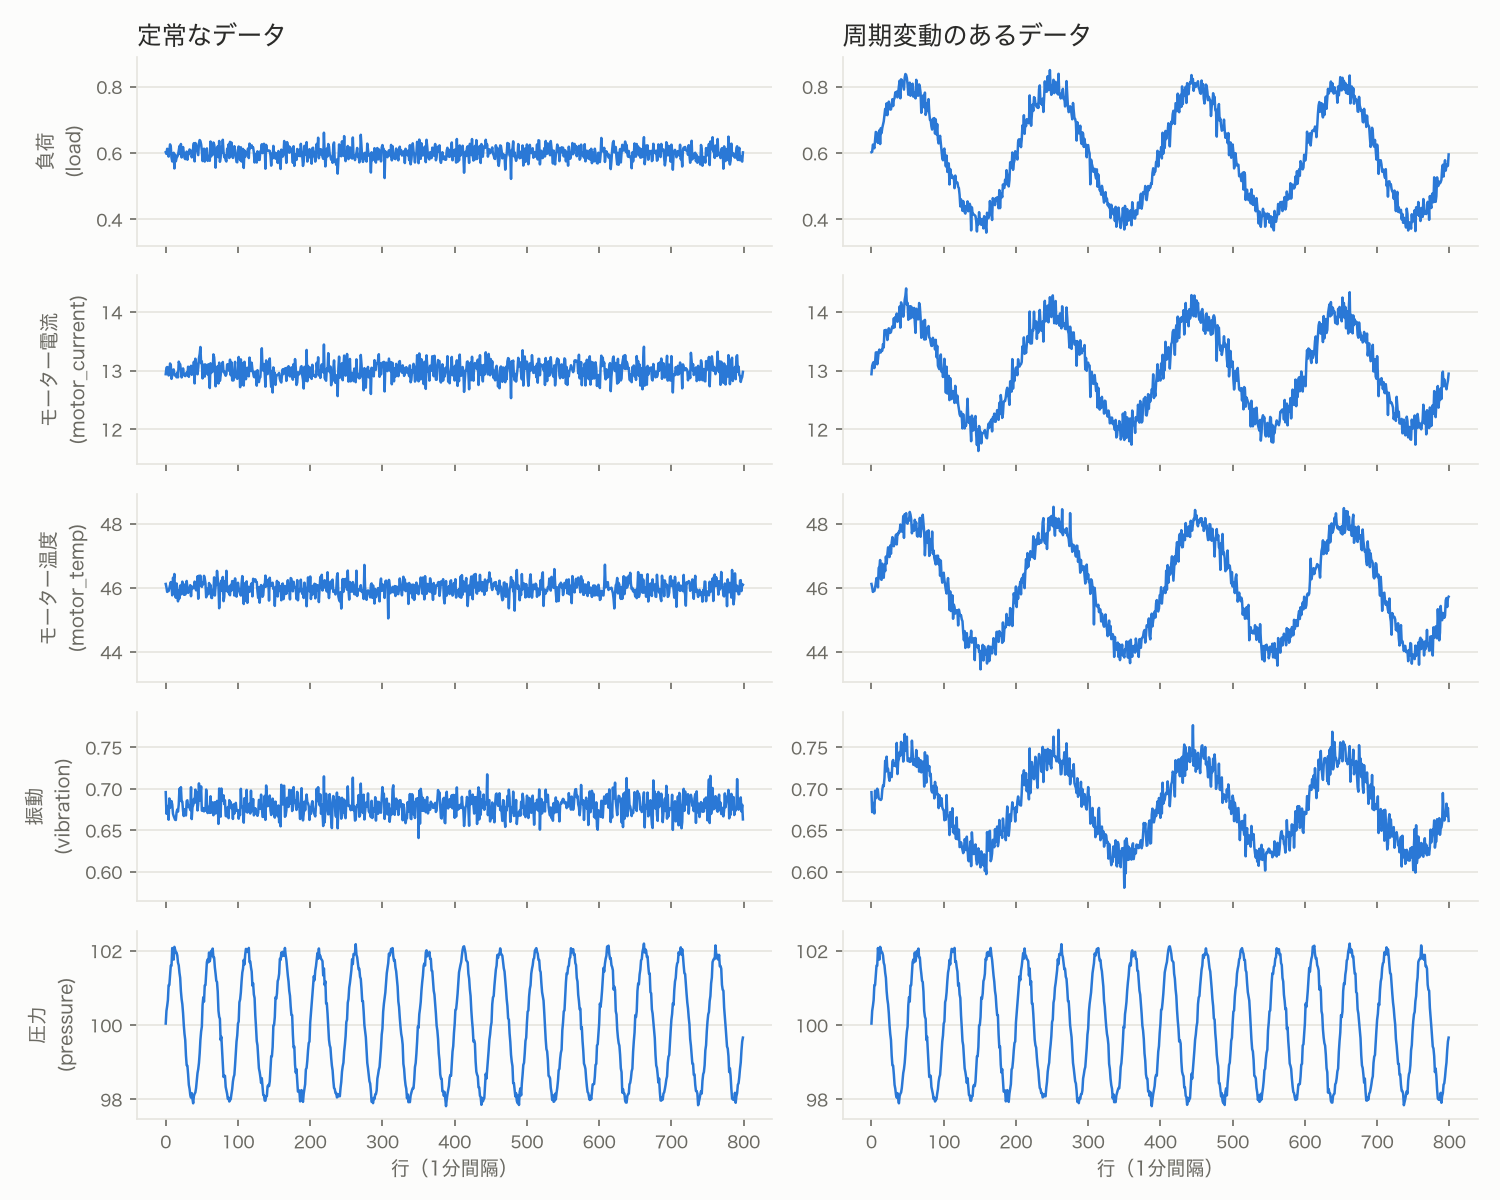
そこで、生産ラインを模した5センサー(負荷、モーター電流、モーター温度、振動、圧力)の合成データを1分間隔で800行作りました。
モーター電流、モーター温度、振動は負荷に連動させ、温度は負荷に5行遅れて追従するようにしています。
圧力だけは負荷と独立に、周期50行の正弦波にしました。
負荷の動きは、次の2種類を用意しました。
- 定常なデータ
- 負荷をほぼ一定(小さなノイズのみ)にする
- 説明機能そのものの正しさを確かめるために使う
- 周期変動のあるデータ
- 負荷を周期200行の正弦波でゆっくり上下させる
- 生産量が時間帯によって変わるような、より現実に近いラインを想定して、検出への影響を確かめるために使う
異常を注入する前の5つのセンサーは、それぞれ以下のとおりです(縦軸は2つのデータでそろえています)。
センサーの値を作っている部分のコードは以下です(load_amp が負荷の周期変動の振れ幅で、定常なデータでは0にしています)。
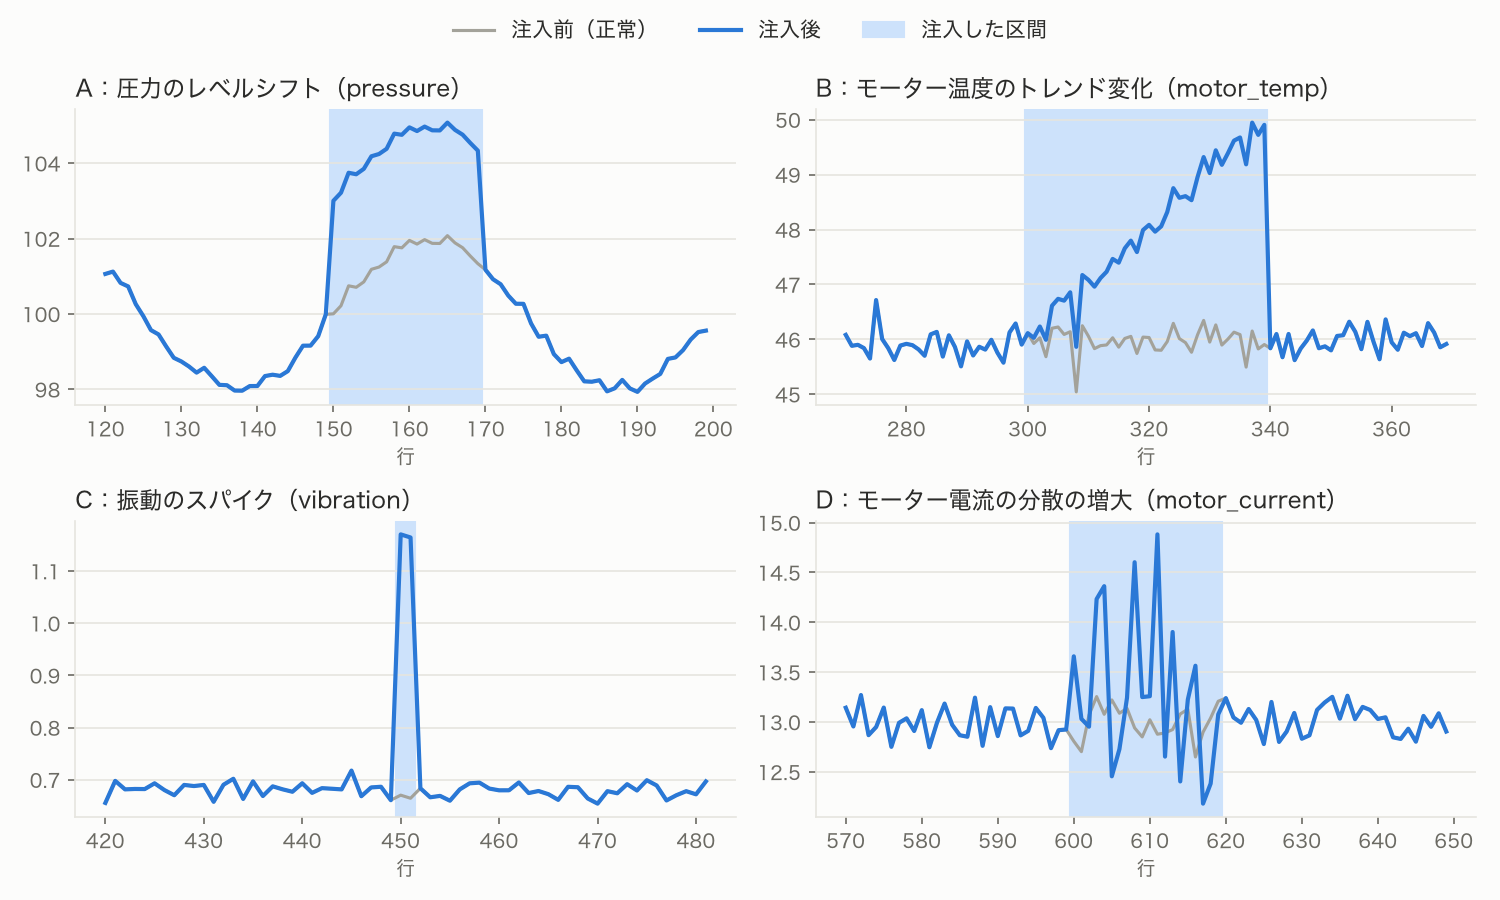
そこに以下の4つの異常を注入しました。
注入する位置と大きさは、どちらのデータでも同じです。
| 異常のパターン | 異常発生の行 | 異常のセンサー | 注入した異常 |
|---|---|---|---|
| A | 150〜169 | 圧力(pressure) | +3のレベルシフト |
| B | 300〜339 | モーター温度(motor_temp) | 0から+4まで直線的に上がるトレンド |
| C | 450〜451 | 振動(vibration) | +0.5のスパイク |
| D | 600〜619 | モーター電流(motor_current) | 標準偏差1.0のノイズ(分散の増大) |
定常なデータについて、注入した異常を注入前の信号と重ねると以下のようになります。
異常を注入している部分のコードは以下です。
上の2つの図は、以下のスクリプトで描いています。
推論処理
推論では、説明と診断を有効にし、PDFレポートも出力しました。
タイムスタンプと正解ラベルの列も含めて渡し、SDKの設定で列名を指定しています。
以下がそのコードです。
入力データは、上で作ったDataFrame injected(タイムスタンプ、5つのセンサー、正解ラベル GT の列を持つ)をそのまま渡しています。
モデルの重み(final_model.pth)と設定(curriculum_medium.yaml)は、初回の実行時にHugging Faceからカレントディレクトリにダウンロードされ、2回目以降はそのファイルが使われます。
上のコードではファイル名を明示していますが、model_path と model_config_path を省略した場合も同じ動作です。
(Hugging Faceのキャッシュ(~/.cache/huggingface)ではないため、実行するディレクトリを変えると再びダウンロードされます。)
なお、v1.0.1には、事前学習モデルで推論するとき、レポートか帰属分析を有効にした場合にしかタイムスタンプや正解ラベルの列が除外されないという既知の問題があります。
たとえば、次のようにレポートを無効にしたまま正解ラベルの列を含めて渡したとします。
# レポートを無効にしたまま、正解ラベル(GT、0か1)の列を含めて渡す
perform_anomaly_analysis_with_diffusion(
    df=injected[["load", "motor_current", "motor_temp", "vibration", "pressure", "GT"]],
    threshold_strategy="scs",
)
READMEによると、この場合はGTの列も6つ目のセンサーとしてモデルに入り、異常スコアや検出結果が変わってしまいます。
UNIX時間のような数値のタイムスタンプ列も同様です。
レポートを使わない場合は、センサーの列だけを渡すのが確実です。
定常なデータでの結果
まず、説明機能そのものの正しさを確かめるため、負荷をほぼ一定にした定常なデータで実験しました。
結果は、検出、どのセンサーか(寄与)、どの型か(診断)、誤検知の中身の順に見ていきます。
検出の結果
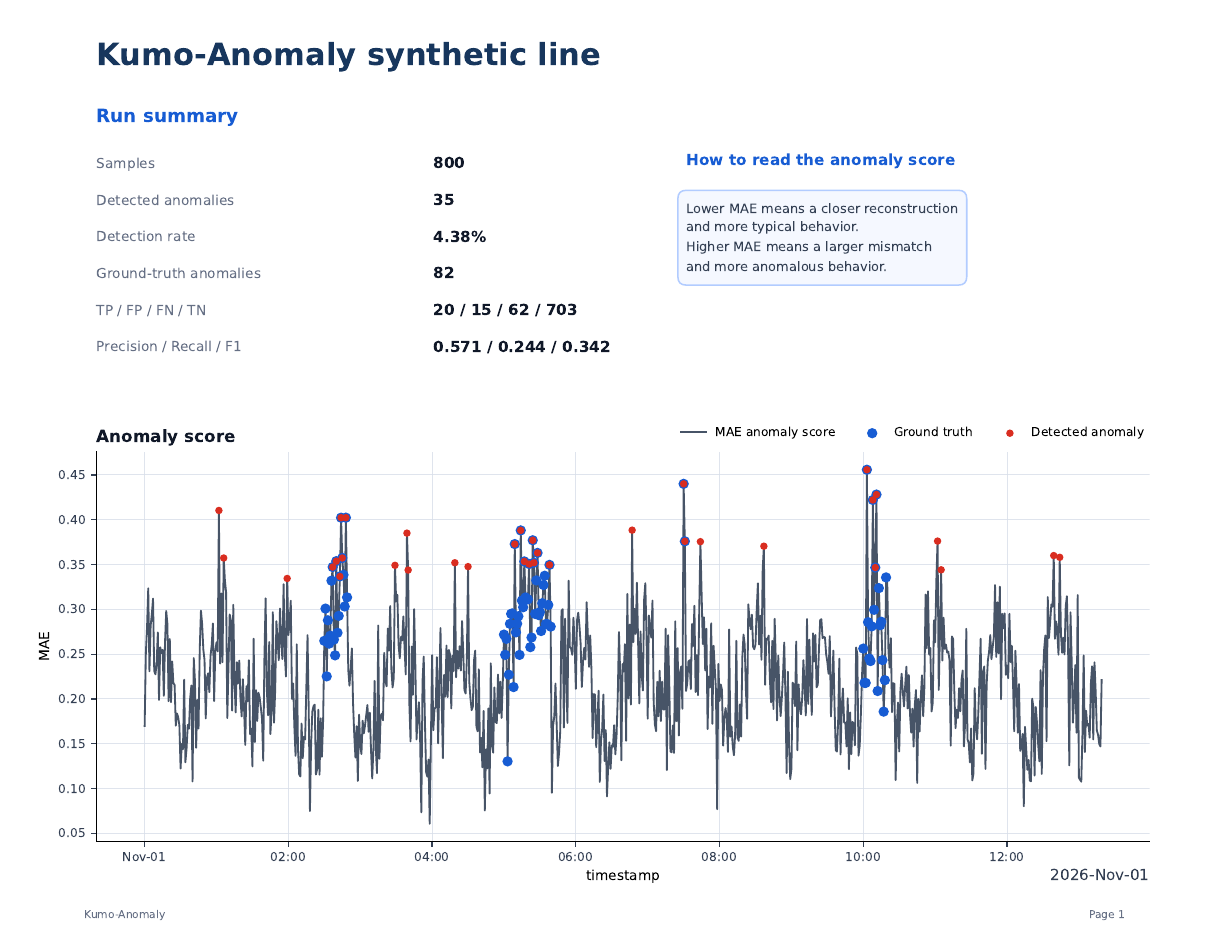
4つの異常(A〜D)のどれについても、注入した区間のうち少なくとも1行は異常と判定されました。
ただし、行単位で見ると、異常と判定できたのは区間の一部だけです。
| 異常のパターン | 注入した異常 | 注入した区間の行数 | 異常と判定された行数 |
|---|---|---|---|
| A | 圧力のレベルシフト | 20 | 6 |
| B | 温度のトレンド変化 | 40 | 8 |
| C | 振動のスパイク | 2 | 2 |
| D | 電流の分散の増大 | 20 | 4 |
全体では35行が異常と判定され、そのうち注入した区間に入っていたのは20行でした(Precision 0.571)。
注入した区間は合計82行あるので、区間全体のうち検出できたのは約4分の1です(Recall 0.244)。
異常の区間をまるごと正しく切り出せたわけではなく、異常が起きたことと、その付近の数行を捉えた、という精度です。
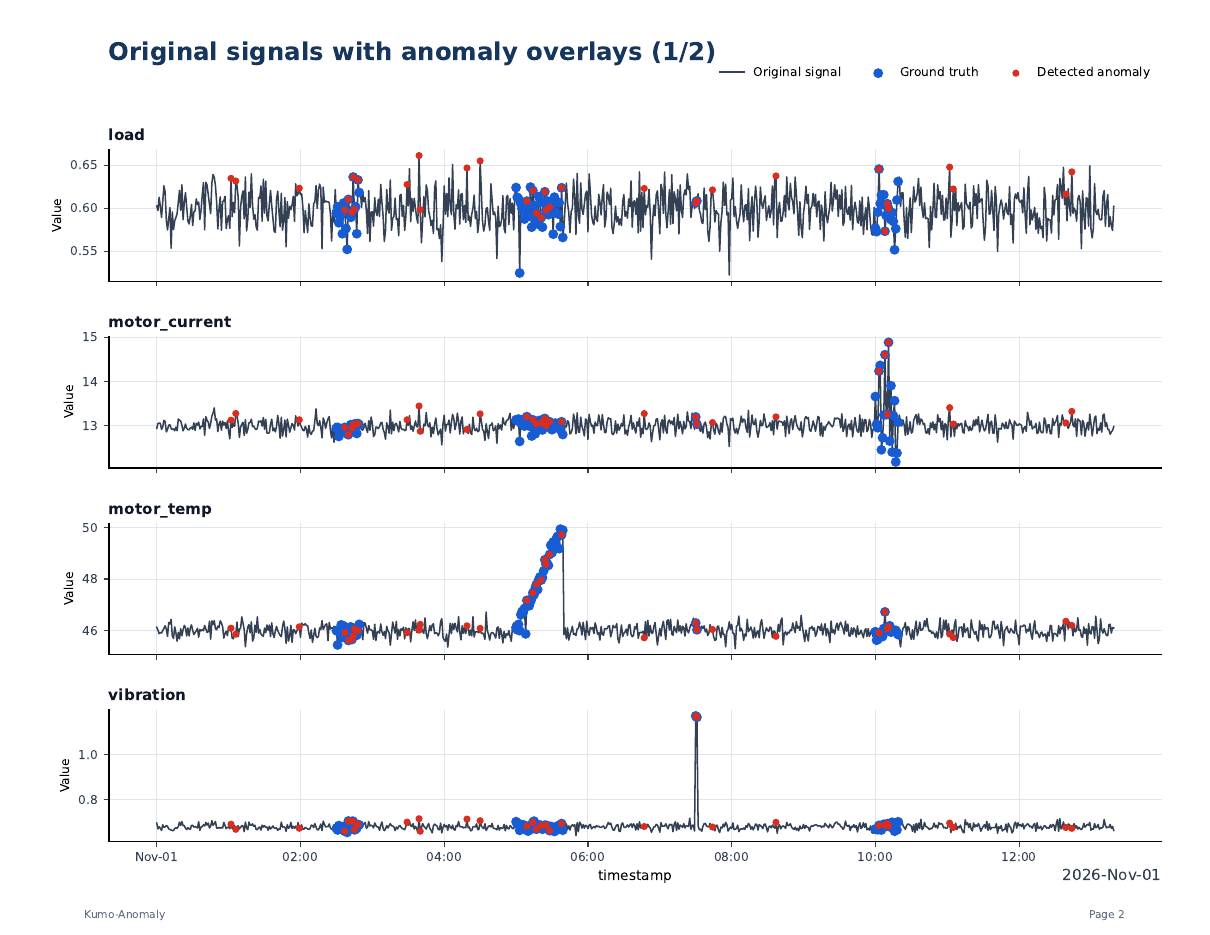
本記事の目的は説明機能の検証なので、以降はこの「異常と判定された行」を対象に、説明の出力が注入した内容と合っているかを確かめます。
どのセンサーが効いたか
検出できた行について、寄与の1位(TopContributors の先頭)が、異常を注入したセンサーと一致したかを数えました。
| 異常のパターン | 注入した異常 | 検出行数 | 寄与の1位が実際に注入したセンサーと一致した行数 |
|---|---|---|---|
| A | 圧力のレベルシフト | 6 | 6 |
| B | 温度のトレンド変化 | 8 | 4 |
| C | 振動のスパイク | 2 | 2 |
| D | 電流の分散の増大 | 4 | 2 |
圧力と振動では全行で、温度と電流でも半数の行で、注入したセンサーが1位に挙がりました。
1位を外した6行のうち5行でも、注入したセンサーは上位3つに入っていました。
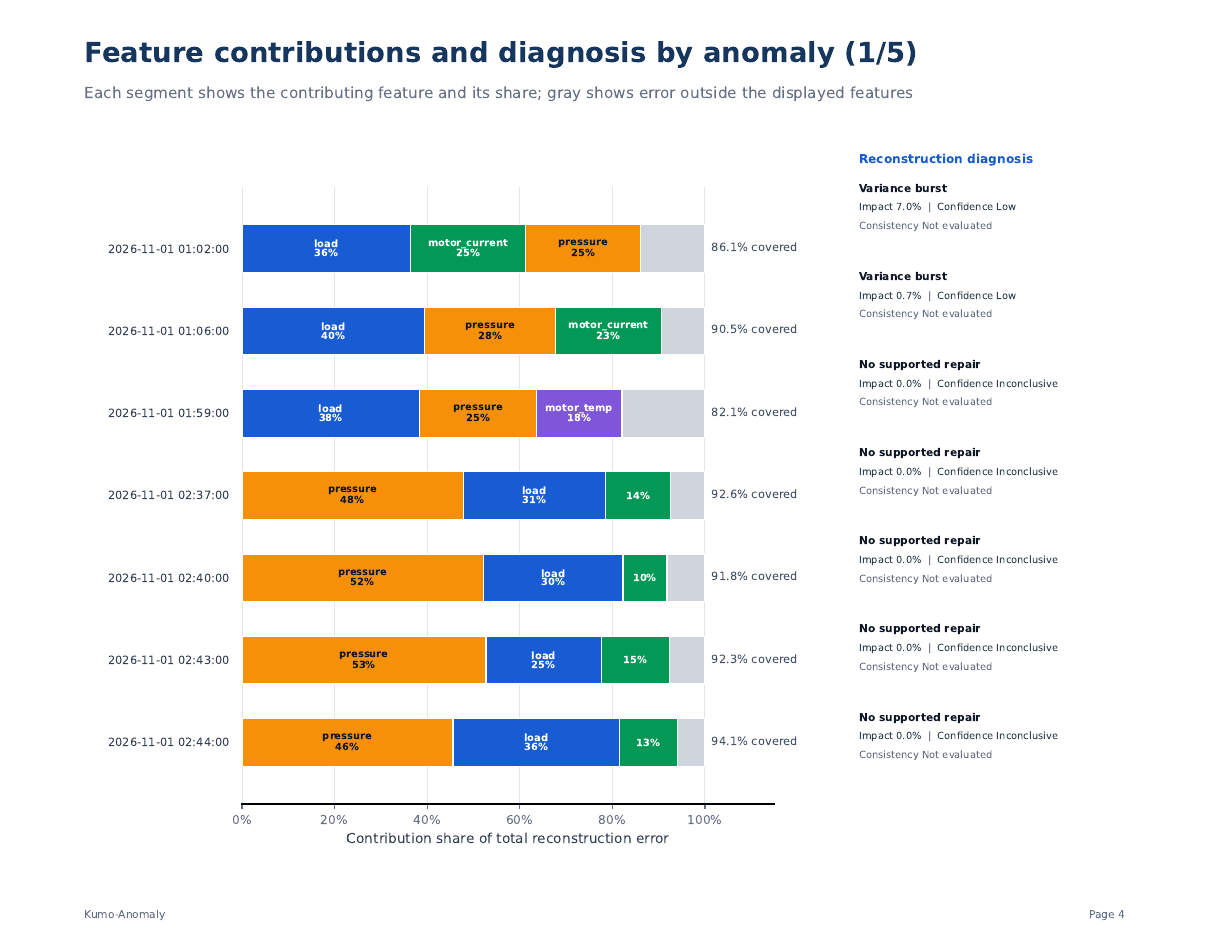
PDFレポートには、検出した行ごとに寄与の割合が帯グラフで描かれ、右側に診断の結果が並びます。
どの型の異常か
同じ行について、診断(LikelyReconstructionIssue)が注入した異常の型と一致したかを数えました。
| 異常のパターン | 注入した異常 | 検出行数 | 診断が一致した行 | 診断の内訳 |
|---|---|---|---|---|
| A | 圧力のレベルシフト | 6 | 0 | どの型にも当てはまらない6 |
| B | 温度のトレンド変化 | 8 | 1 | レベルシフト6、トレンド変化1、どの型にも当てはまらない1 |
| C | 振動のスパイク | 2 | 2 | スパイク2 |
| D | 電流の分散の増大 | 4 | 2 | 分散の増大2、レベルシフト1、スパイク1 |
当たったのは、スパイクと分散の増大の一部だけでした。
圧力のレベルシフトは6行すべてが「どの型にも当てはまらない」で、温度のトレンド変化はほとんどがレベルシフトと判定されています。
確信度も、ほとんどの行が「Low」か「Inconclusive」でした。
診断が外れた理由の考察
診断が当たる型と外れる型の差がどこから来るのかを確かめるため、SDKと同じ手順で修復後の入力を作り、修復によって入力がどれだけ動いたかを計算しました。
修復後の入力を作る処理(build_repair_variants)はSDKの関数をそのまま使い、もう一度推論することはしていません。
以下は、注入したセンサーについて、注入した区間の行で平均した値です。
| 異常のパターン | 注入した量 | 入力と修復の基準の差 | 修復による入力の変化(レベルシフト) | (トレンド変化) | (スパイク) | (分散の増大) |
|---|---|---|---|---|---|---|
| A 圧力のレベルシフト | 3.000 | 0.173 | 0.121 | 0.153 | 0.141 | 0.057 |
| B 温度のトレンド変化 | 2.000 | 0.221 | 0.076 | 0.111 | 0.139 | 0.142 |
| C 振動のスパイク | 0.500 | 0.485 | 0.000 | 0.115 | 0.485 | 0.236 |
| D 電流の分散の増大 | 0.675 | 0.590 | 0.020 | 0.134 | 0.249 | 0.381 |
「注入した量」は、注入前の値と注入後の値の差(絶対値)です。
修復が異常をきちんと取り除けるなら、「修復による入力の変化」は、正解の型の列で「注入した量」に近くなるはずです。
CとDでは、そのとおりになっています。
入力と基準の差(0.485、0.590)が注入した量(0.500、0.675)に近く、正解の型の修復で入力が最も大きく動いています。
2行だけのスパイクや、平均がほぼ変わらない分散の増大では、移動中央値の基準がほとんど影響を受けないためです。
一方、AとBでは、入力と基準の差(0.173、0.221)が注入した量(3.000、2.000)よりはるかに小さくなっています。
20行続く段差や40行続くトレンドでは、窓幅21行の移動中央値の大半が異常な値になり、基準のほうが異常に追従してしまうためです。
そのため、どの型で修復しても入力はほとんど動かず(最大でも0.15程度)、異常スコアも下がりません。
Aの「どの型にも当てはまらない」はこの結果です。
Bで「レベルシフト」が選ばれた行も、修復による下がり幅(RepairImpact)は0.2〜3%程度しかなく、わずかな差で決まったものと考えられます。
この集計に使ったスクリプトは以下です。
誤検知の中身
誤検知の15行では、すべて負荷(load)が寄与の1位でした。
定常なデータの負荷は、ほぼ一定値に小さなノイズが乗っただけの信号なので、スケーリング後にノイズが相対的に大きくなり、再構成誤差が出やすいのだと考えられます。
説明機能があれば、こうした誤検知が「負荷のセンサーのノイズによるもの」と読み取れるので、しきい値やセンサーの選び方を見直す手がかりになります。
周期変動のあるデータでの結果
次に、負荷を周期200行の正弦波でゆっくり上下させたデータで、同じ4つの異常を注入して実験しました。
生産量が時間帯によって変わるようなラインを想定しています。
検出の結果
定常なデータでは4つの異常すべてで一部の行を検出できていたのに対し、こちらでは4つのうち3つを見逃しました。
| 異常のパターン | 注入した異常 | 注入した区間の行数 | 異常と判定された行数 |
|---|---|---|---|
| A | 圧力のレベルシフト | 20 | 0 |
| B | 温度のトレンド変化 | 40 | 0 |
| C | 振動のスパイク | 2 | 2 |
| D | 電流の分散の増大 | 20 | 0 |
800行のうち16行が異常と判定されましたが、注入した区間に当たったのは振動のスパイク(C)の2行だけで、残りの14行は誤検知です(Precision 0.125、Recall 0.024)。
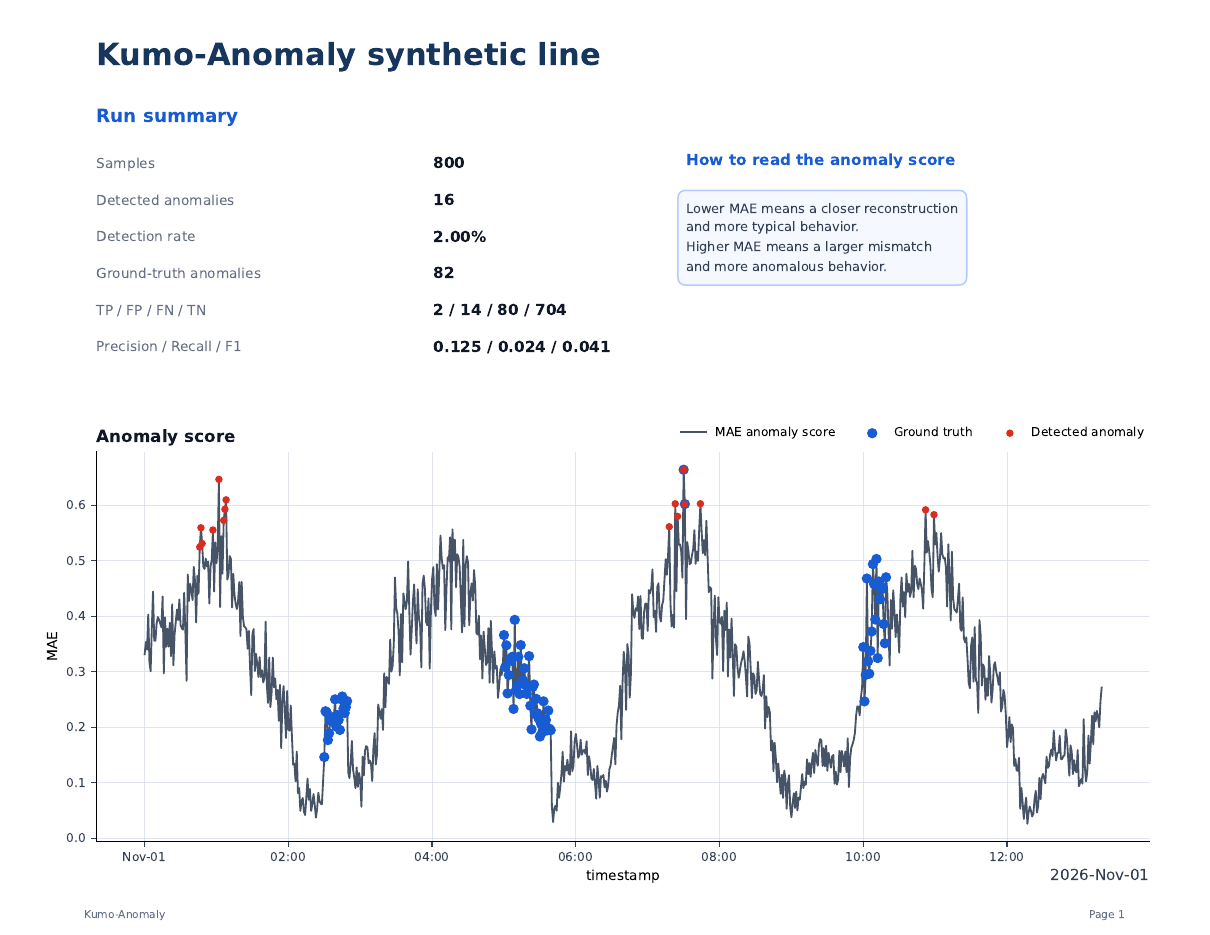
見逃しの原因は、異常スコア(MAE)が負荷の周期とほぼ同じ形で上下していることです。
異常と判定された行のMAEは最小でも0.52で、負荷の時間帯ごとに整理すると以下のようになります。
| 負荷の時間帯 | 正常な区間のMAE(中央値) | その時間帯にあった異常 | 異常区間のMAEの最大値 | 結果 |
|---|---|---|---|---|
| 高い | 0.48 | C(振動のスパイク) | 0.66 | 検出(誤検知の14行もすべてこの時間帯) |
| 中程度 | 0.29 | D(電流の分散の増大) | 0.50 | 見逃し |
| 低い | 0.11 | A(圧力のレベルシフト)、B(温度のトレンド) | 0.26、0.39 | 見逃し |
負荷の低い時間帯にあったAとBは、異常によってMAEが上がってはいます(Aは直前の0.07から最大0.26)。
しかし、もともとのMAEが低いため、負荷の高い時間帯の正常なMAE(中央値0.48)にすら届きませんでした。
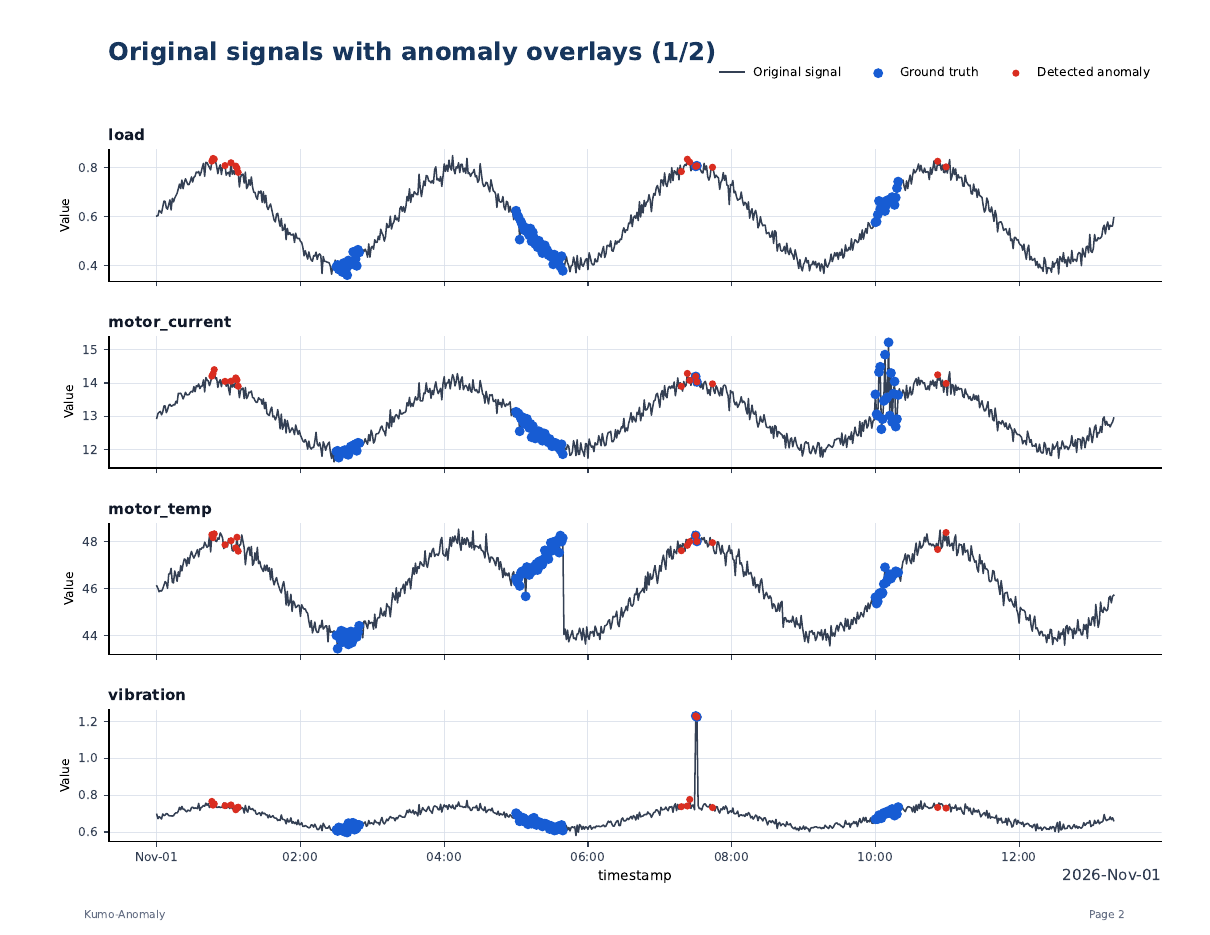
事前学習モデルのMAEが信号のレベルに引きずられる理由までは確認できていません。
どのセンサーが効いたか
検出できたのはCの2行だけなので、比べられるのもこの2行です。
| 異常のパターン | 注入した異常 | 検出行数 | 寄与の1位が実際に注入したセンサーと一致した行数 |
|---|---|---|---|
| C | 振動のスパイク | 2 | 1 |
451行目では振動が1位でしたが、450行目では負荷が1位で、振動は3位でした。
定常なデータではCの2行とも振動が1位だったので、負荷の周期変動による再構成誤差が、注入したセンサーの寄与を押し下げた可能性があります。
どの型の異常か
| 異常のパターン | 注入した異常 | 検出行数 | 診断が一致した行 | 診断の内訳 |
|---|---|---|---|---|
| C | 振動のスパイク | 2 | 1 | スパイク1、分散の増大1 |
寄与の1位が振動だった451行目はスパイクと正しく判定され、負荷が1位だった450行目は分散の増大と判定されました。
修復の対象は寄与の大きい特徴量なので、寄与の順位がずれると、診断もずれやすくなります。
誤検知の中身
誤検知の14行は、すべて負荷のピーク付近にあり、寄与の1位は負荷が7行、モーター温度が6行、モーター電流が1行でした。
どれも負荷と、負荷に連動するセンサーです。
説明機能の出力からも、誤検知の原因が負荷の周期変動にあることを読み取れます。
周期変動への対策
対策としては、2つが考えられます。
1つ目は前処理です。
定常なデータでは4つの異常すべてで一部の行を検出できていたので、周期成分を取り除いて定常なデータに近づければ、検出を改善できる可能性があります(今回は試していません)。
2つ目はファインチューニングです。
公式ブログでも、事前学習モデルのままではAveragePrecisionが0.016で、正常データ5万件でファインチューニングすると0.201に上がったとされており、実運用ではファインチューニングも必要になると考えたほうがよさそうです。
異常検知の実験の実行回数と処理時間
定常なデータと周期変動のあるデータの実験は、どちらも1回ずつの実行です。
拡散モデルのサンプリングは確率的なため、数値は実行ごとに多少変わります。
処理時間は、推論5回分(通常の推論と、4つの型の修復)で約16〜19分、1回あたり約190〜200秒でした。
欠損対応の予測を試す方法
デフォルト設定と欠損対応モデルの違い
Hugging Faceの nvidia/Kumo-Forecast には、予測モデルのチェックポイントが2つ置かれています。
v1.0.1のSDKは、handle_missingness の値によって、このどちらを使うかを選びます。
handle_missingness=False(デフォルト):v1.0.0からある通常の予測モデル(run8_best_model_cr.pt)を使う。入力の欠損は0で埋められ、警告が出るだけhandle_missingness=True:v1.0.1で追加された欠損対応モデル(kumo-forecast-1.2.0、約1.3GB)を使う
なお、kumo-forecast-1.2.0 の 1.2.0 はモデルの版で、SDKの版(v1.0.1)とは別に付けられています(リリースノートにも、SDKの版とは独立と書かれています)。
欠損対応モデルは、欠損の位置を表すマスクと、入力の欠損率を受け取り、欠損率が50%を超えると正規化の方法を切り替える作りになっています。
2つのモデルの違いをまとめると、以下のとおりです。
| 項目 | デフォルト設定(通常の予測モデル) | handle_missingness=True(欠損対応モデル) |
|---|---|---|
| 入力長 | 512 | 96 |
| ネイティブな予測長 | 72 | 24 |
| 欠損の扱い | 0で埋める | マスクで欠損位置を渡す |
| 学習データ | Monashの30データセット | ETTと推定(変圧器の油温と負荷の公開データセット。次の節で説明) |
欠損対応モデルの学習データは、モデルカードには書かれていません。
ただし、SDKのREADMEでは公開されている欠損対応モデルが「ETTのチェックポイント」と呼ばれており、チェックポイントの設定ファイルに記録された学習時の列名(OT、HUFL、HULL、LUFL、LULL、MUFL、MULL)もETTの7列と一致するため、ETTで学習されたと考えられます。
ETTのどのファイルを、どの期間で学習に使ったかは公開されていません。
欠損対応モデルは、学習時には7行(目的変数1つと補助の列6つ)の配列を入力としていました。
SDKは、DataFrameのどの列を配列の何行目に入れるかを決めてから、モデルに渡します。
デフォルト(impute_channel_alignment="name")では、列名を見て学習時と同じ行に入れるため、学習時の列名にない列があるとエラーになります。
列名が異なるデータでは、impute_channel_alignment="positional" を指定して、列の並び順で行に入れる必要があります。
この場合、たとえば気温の列が、学習時に高圧側の有効負荷(HUFL)が入っていた行で扱われるため、モデルが行ごとに学習した傾向は、自分のデータの列の意味とは対応しません。
また、モデルは列ごとに学習済みの目印を足して列を区別していますが、目印は学習時の列数と同じ7つしかありません。
8列目以降を渡すと、7列目以降の列にはすべて同じ目印が付くため、モデルはそれらの列を目印では区別できなくなります。
これらが精度にどの程度影響するかは確かめていません。
なお、欠損対応モデルは、DARRや解釈機能とはまだ併用できません。
実験の準備
使用するデータセット
実験には、ETT(Electricity Transformer Temperature)を使いました。
ETTは、中国のある省の2つの地域で、変圧器の油温(OT)と6種類の負荷(HUFL、HULL、MUFL、MULL、LUFL、LULL)を約2年間(2016年7月〜2018年7月)記録した公開データセットです。
- zhouhaoyi/ETDataset(GitHub)(ライセンスはCC BY-ND 4.0)
このうち、1時間間隔で記録されたETTh1(7列、約17,000行)を使い、油温(OT)の24時間先までを予測します。
ETTは欠損対応モデルの学習データと考えられ、列名もそのまま一致するため、欠損対応モデルにとって条件のよい評価になっている点には注意が必要です(後の「注意点」で触れます)。
予測の起点と区間
予測は、「起点」と呼ぶ時刻を決めて行います。
起点より前のデータを入力として渡し、起点から先の24時間を予測して、実際の値(真値)との誤差を測ります。
- 起点:一般的なETTh1の分割(学習12か月、検証4か月、テスト4か月)でテスト期間にあたる範囲から、等間隔に20か所を選ぶ
- 入力区間:各起点の直前1,024時間(7列すべて)
- 予測区間:起点から24時間
ある起点について、入力区間と予測区間の関係を図にすると以下のようになります。
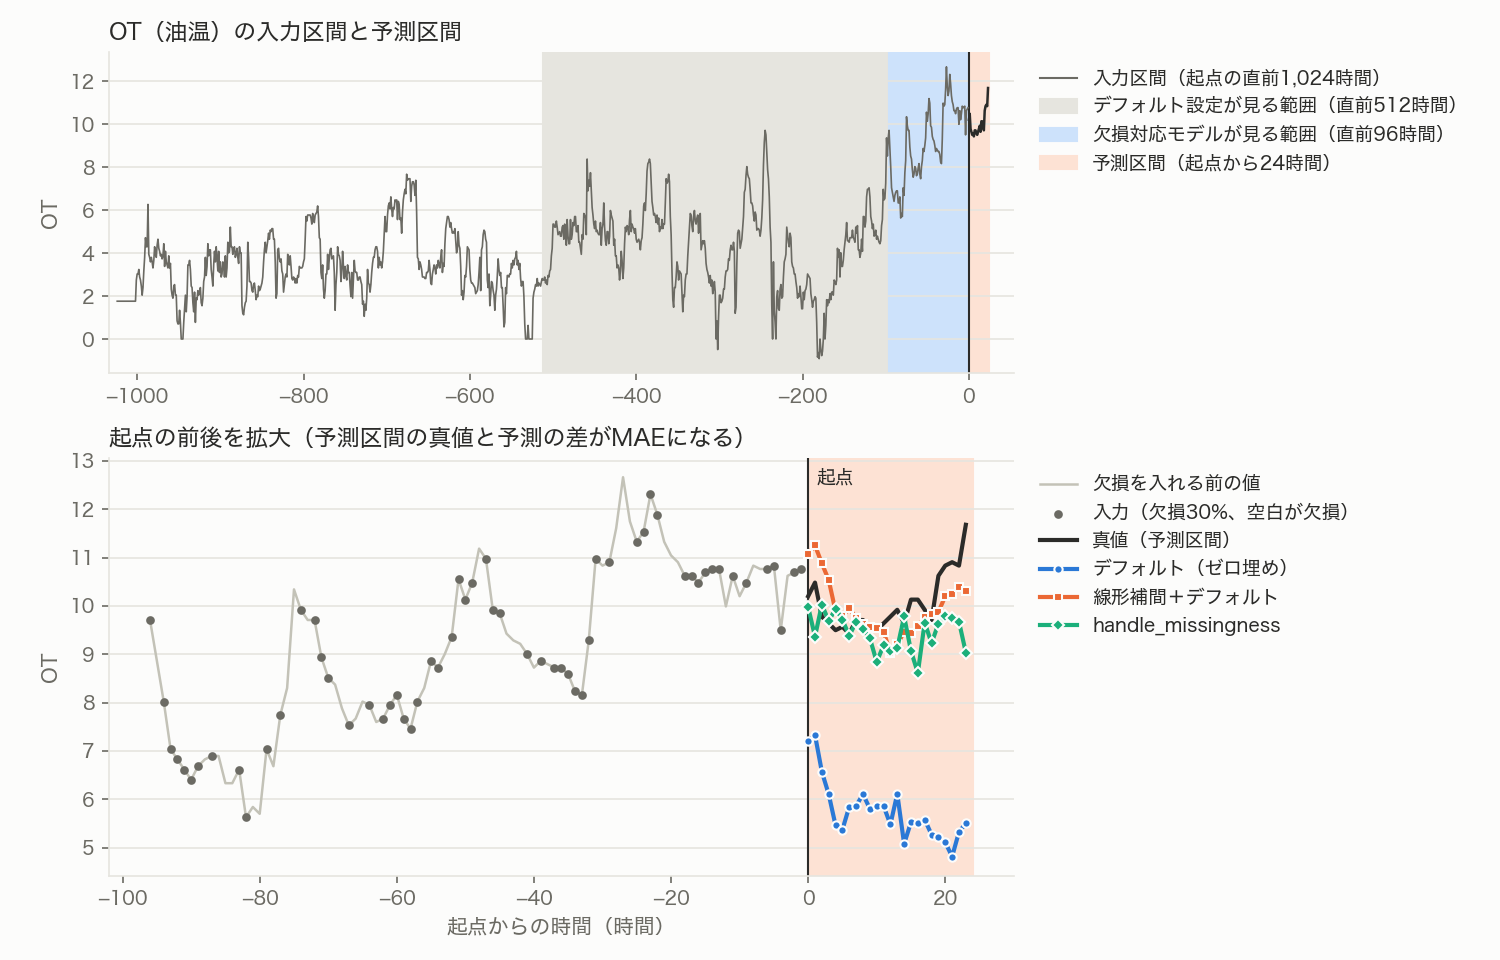
上段のとおり、入力区間として1,024時間を渡しても、モデルが予測に使うのは直前の一部です(デフォルト設定は512時間、欠損対応モデルは96時間)。
1,024時間を渡しているのは、欠損対応モデルが、入力全体の観測値から正規化の統計量を求める(入力長96の2倍未満しか渡さないと警告が出る)ためです。
下段は起点の前後を拡大したもので、点が欠損を入れた後の入力、黒い線が予測区間の真値、色のついた線が3つの方法の予測です。
予測区間での真値と予測の差の平均(MAE)を、起点ごとに求めて平均します。
欠損の入れ方
欠損の入れ方は、以下の2通りです。
- ランダム:セルごとに独立に、指定した割合を欠損させる
- 連続:列ごとに、24時間分の連続した区間を、欠損の割合が指定値に達するまで抜く(センサーの停止を想定)
ただし、どちらの場合も、入力区間の最後の行(起点の直前の時刻)のOTだけは欠損させずに残しています。
欠損対応モデルは、入力区間に目的変数(OT)の観測値が1つもないと予測できない仕様で、公式のサンプル(examples/missingness_quickstart.py)も同じように最後の値を残しているため、それに合わせました。
比較する手法
比較する手法は以下です。
- デフォルト(ゼロ埋め):NaNを含むまま、デフォルト設定で予測する
- 線形補間+デフォルト:pandasの
interpolateで埋めてから、デフォルト設定で予測する - handle_missingness:NaNを含むまま、欠損対応モデルに渡す
3つの方法には、起点と欠損率ごとに同じ欠損のパターンを使い、欠損を入れる前の真値とのMAEを比べました。
3つの方法を切り替えて予測している部分のコードは以下です(handle_missingness=True のときは、hf://nvidia/Kumo-Forecast/kumo-forecast-1.2.0 の欠損対応モデルが使われます)。
結果
20起点の平均MAEは以下のとおりです。
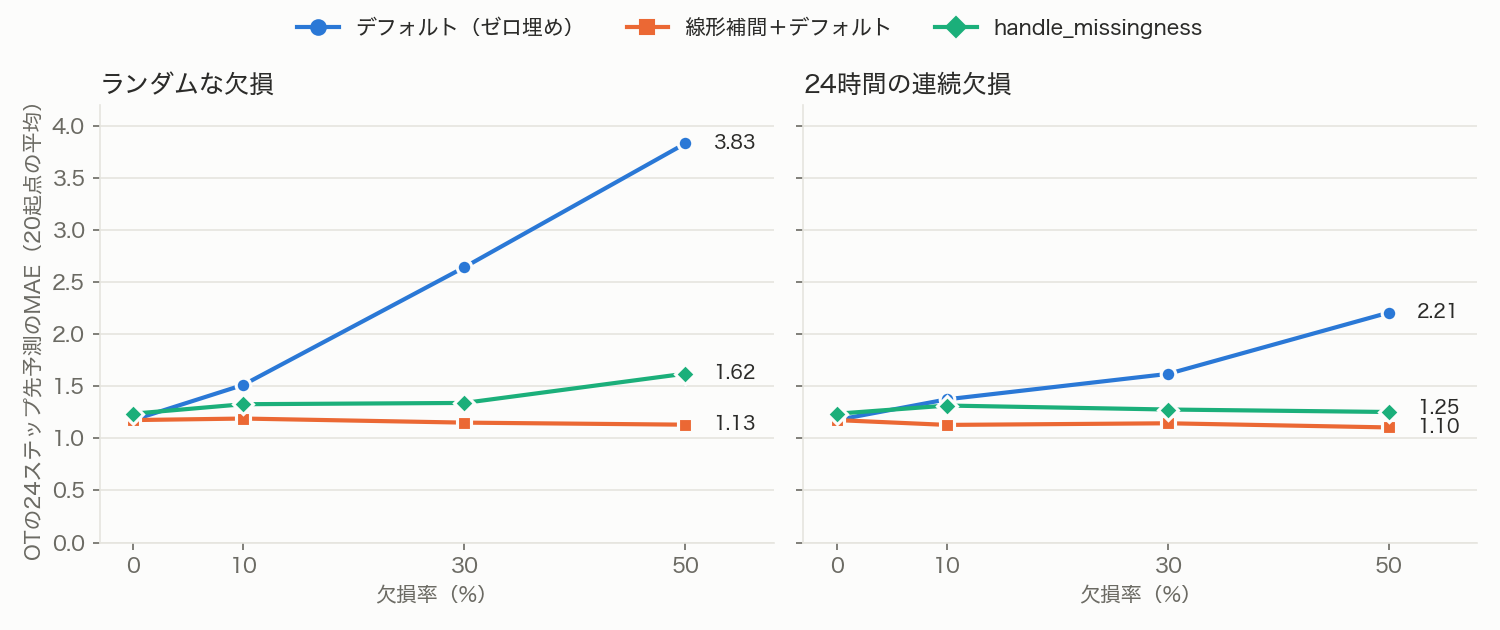
| 欠損の入れ方 | 欠損率 | デフォルト(ゼロ埋め) | 線形補間+デフォルト | handle_missingness |
|---|---|---|---|---|
| なし | 0% | 1.176 | (同左) | 1.236 |
| ランダム | 10% | 1.514 | 1.190 | 1.328 |
| ランダム | 30% | 2.642 | 1.151 | 1.340 |
| ランダム | 50% | 3.830 | 1.131 | 1.621 |
| 連続 | 10% | 1.375 | 1.129 | 1.315 |
| 連続 | 30% | 1.619 | 1.145 | 1.277 |
| 連続 | 50% | 2.208 | 1.105 | 1.253 |
デフォルト設定のゼロ埋めは、欠損率が上がるほど大きく悪化し、ランダムな欠損50%では欠損なしの約3倍の誤差になりました。
テスト期間のOTは平均7前後で、ほかの列も0から離れた値をとるため、0で埋めると実際の値から急に落ち込んだ点が入力に混ざるためです。
handle_missingness=True では、欠損率が上がっても誤差の増え方は小さく、連続欠損では50%でも欠損なしとほぼ同じでした(ランダムな欠損50%では欠損なしの約1.3倍)。
起点ごとにゼロ埋めと比べると、ランダムな欠損50%では20起点中16起点で誤差が小さくなっています。
ただし、線形補間で埋めてからデフォルト設定で予測する方法が、どの条件でも平均では最も誤差が小さい結果でした。
起点ごとに比べても、handle_missingness=True が線形補間に勝ったのは35〜50%の起点にとどまります。
ETTh1は1時間間隔の滑らかなデータなので、単純な補間でも欠損をうまく埋められたのだと思います。
注意点
この比較には、条件がそろっていない点がいくつかあります。
- デフォルト設定の予測モデルは直前512時間を見ているのに対し、欠損対応モデルは直前96時間しか見ていない
- 欠損対応モデルはETTで学習されたと考えられるため、ETTh1は学習データに近い条件になっている(ETTのどのファイルのどの期間を学習に使ったかは公開されておらず、評価に使った期間が学習に含まれている可能性もある)
- 欠損率は入力の1,024行全体に対する割合なので、欠損対応モデルが見る直前96行の欠損率は、起点によってずれる
実際のデータで使う場合は、補間で埋める方法と handle_missingness=True の両方を同じ期間で比べてから選ぶのがよいと思います。
少なくとも、NaNを含むデータをデフォルト設定のまま渡すのは避けたほうがよさそうです。
まとめ
Kumo-TS(旧NV-Tesseract)v1.0.1で追加された、異常の説明機能と欠損対応の予測を、手元のMacで試しました。
異常の説明機能は、検出できた異常については、どのセンサーが効いているかをおおむね正しく示してくれました。
誤検知の原因がどのセンサーにあるかを読み取れるのも、運用では役に立ちそうです。
一方で、異常の種類の診断は、移動中央値を基準にした修復の設計上、レベルシフトのように一定時間続く異常には弱いようです。
また、事前学習モデルのままでは検出そのものが周期変動に引きずられたため、実際のデータで使うには、周期成分を取り除く前処理(今回は未検証)やファインチューニングが必要になりそうです。
欠損対応の予測は、ゼロ埋めによる大きな劣化を防いでくれます。
ただし、今回のデータでは線形補間でも十分だったため、補間とどちらがよいかはデータごとに確認が必要です。
本記事がご参考になれば幸いです。
参考リンク
- NVIDIA/Kumo-TS(GitHub)
- Kumo-TS v1.0.1 リリースノート(GitHub)
- nvidia/Kumo-Forecast(Hugging Face)
- nvidia/Kumo-Anomaly(Hugging Face)
- NVIDIA Kumo Forecast(Hugging Face Blog)
- NVIDIA Kumo Anomaly Brings Diffusion-Based Anomaly Detection to Multivariate Time Series(Hugging Face Blog)
- MOMENT: A Family of Open Time-series Foundation Models(arXiv)
- amazon/chronos-2(Hugging Face)
- google-research/timesfm(GitHub)
- ETDataset(GitHub)