【登壇資料】 「Snowflake Horizon Catalog と Apache Iceberg で作る オープンなデータ基盤」 というタイトルでDevelopersIO 2026 Osakaに登壇しました #devio2026

こんにちは、データ事業本部のキタガワです。
DevelopersIO 2026 Osaka にて登壇したのでブログにも残しておきます。
スライド
以下かいつまんで紹介します。
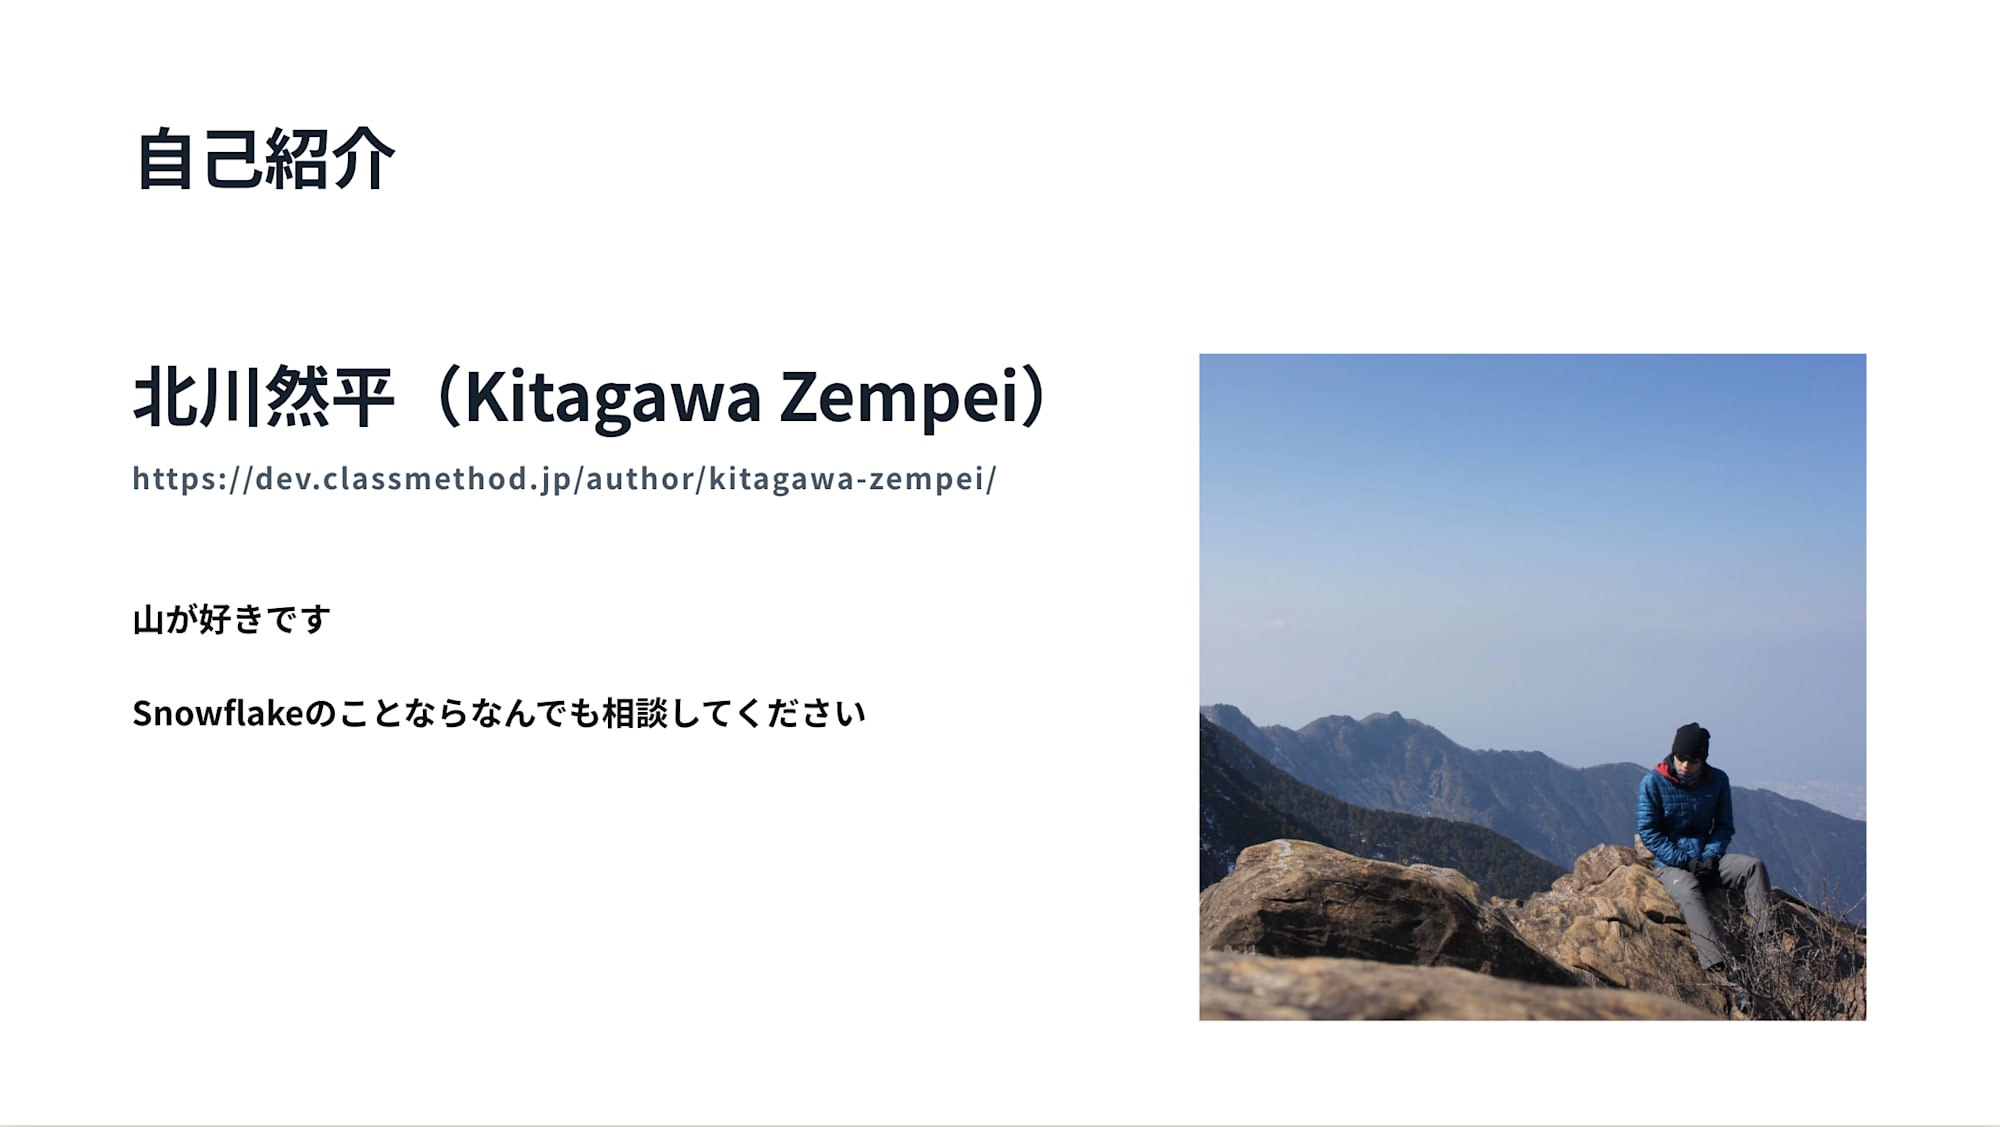
登壇時は「山登りが好きです」にしていましたが、しっくりこなかったので「山が好きです」に変更しました。
Snowflakeの「なんでも相談してください」の時に「なんでもは答えられませんが、知っていることは答えます」を言い損ねたのが今日一番の後悔です。
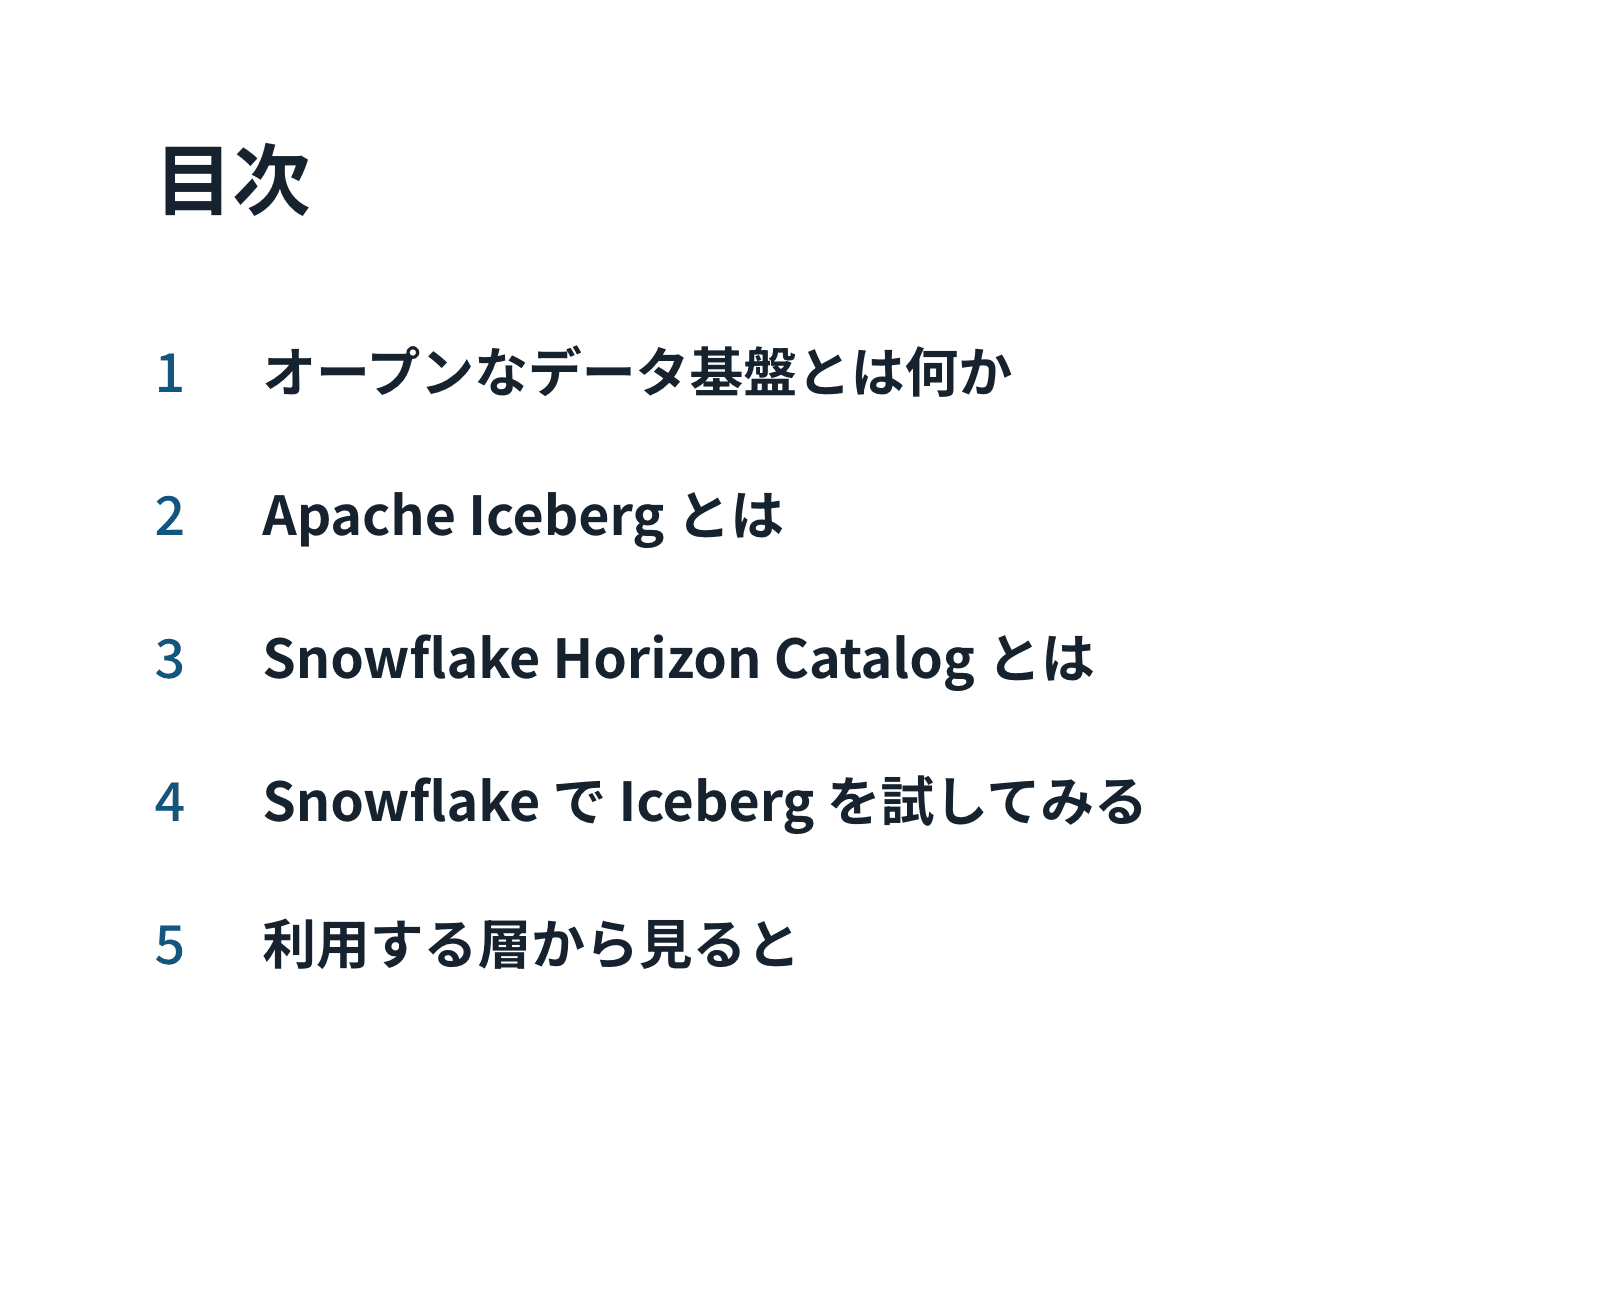
ターゲットとしては Snowflake はちょっと使ってるけど Iceberg までは手が出せてないくらいの層をイメージしています。大仰なことを書いていますが、データ基盤構築そのものについてはそんなに語っていないです。Iceberg テーブルが複数エンジンから読み書きできることと、そのデモをお見せしました。
オープンなデータ基盤とは
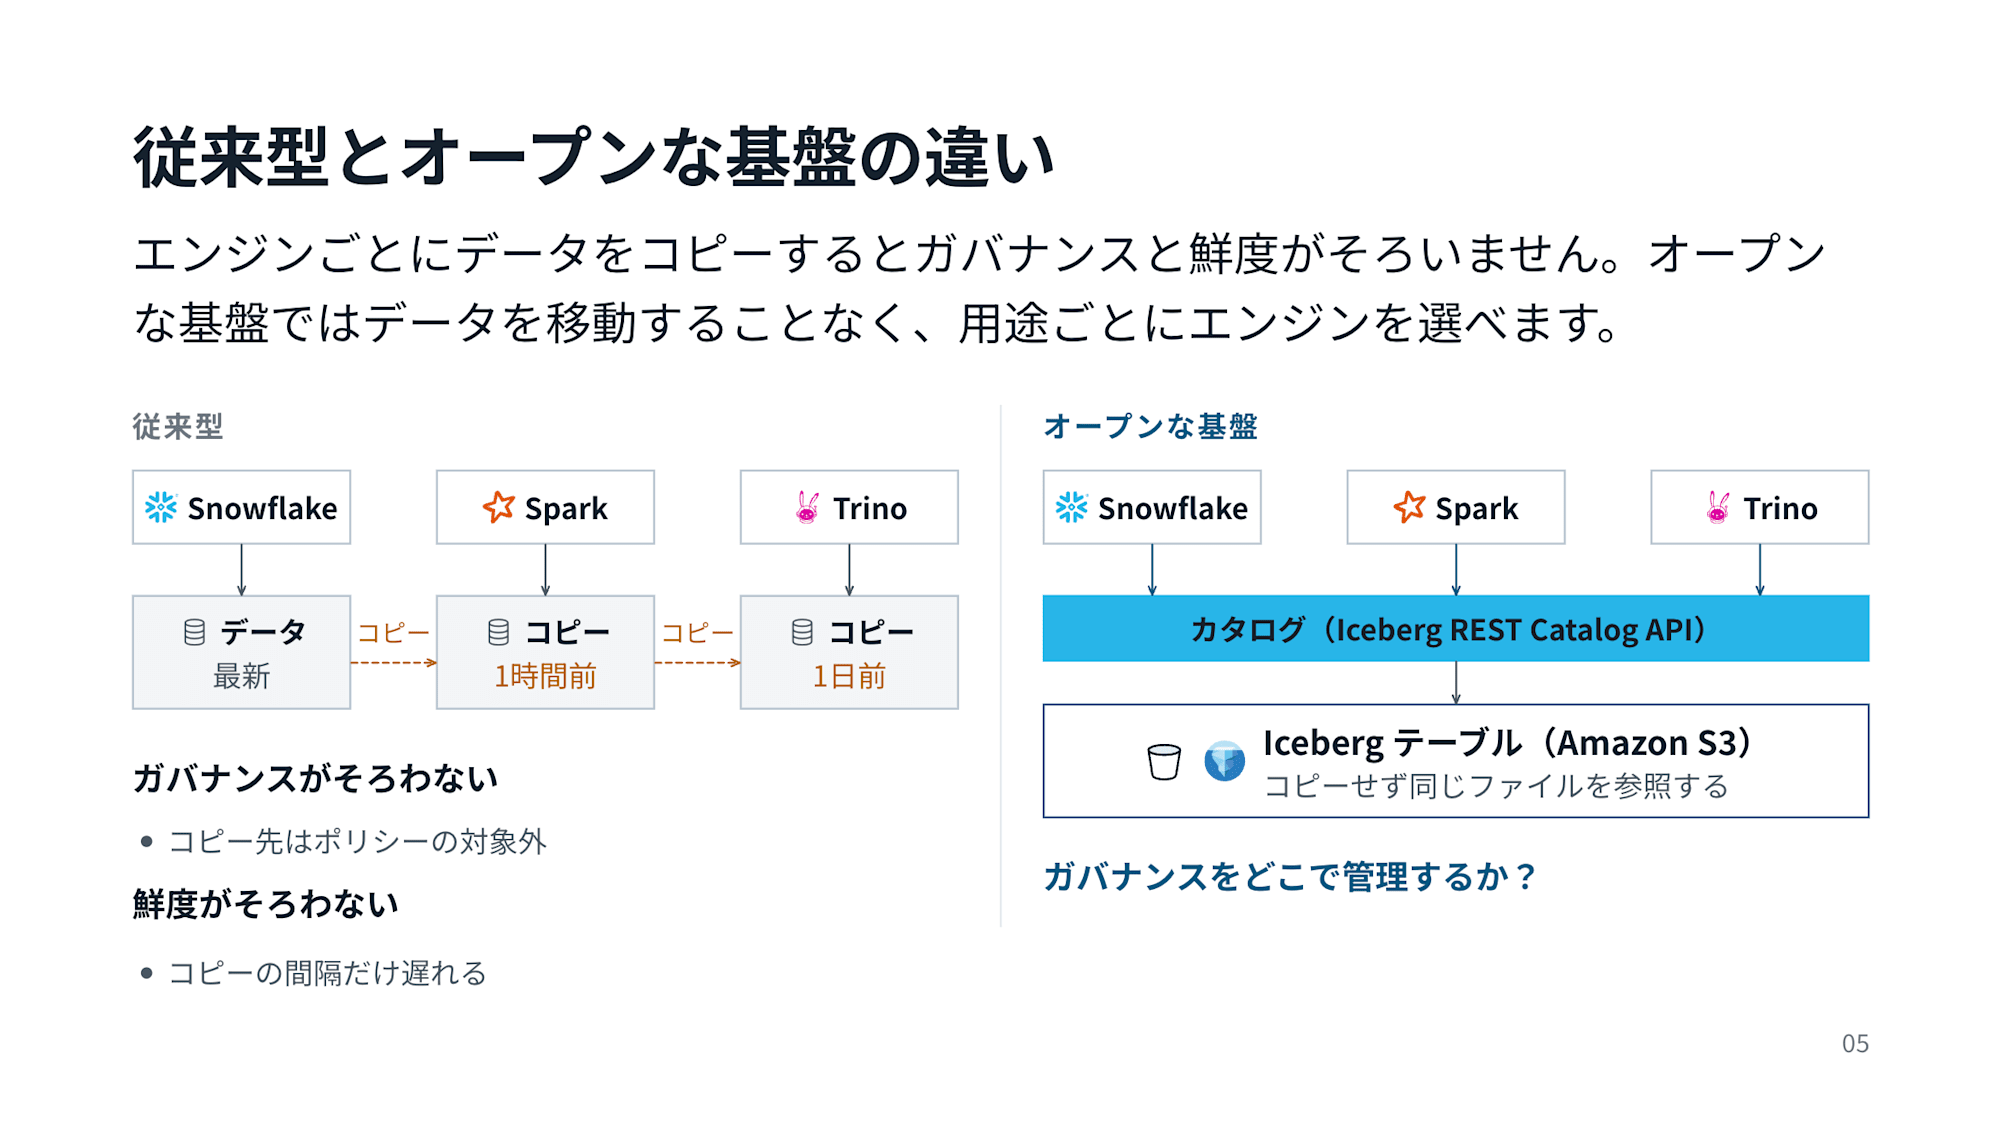
従来だと例えば Snowflake に蓄えられたデータを Spark や Trino で使いたい場合は、データを S3 等にアンロードして対応していました。これだとデータの鮮度やガバナンスに問題があります。オープンなデータ基盤では同じデータファイルをさまざまなクエリエンジンから参照することができます。
Horizon Catalog と Iceberg を使うとこの辺りの課題が解決できます。
Apache Iceberg とは
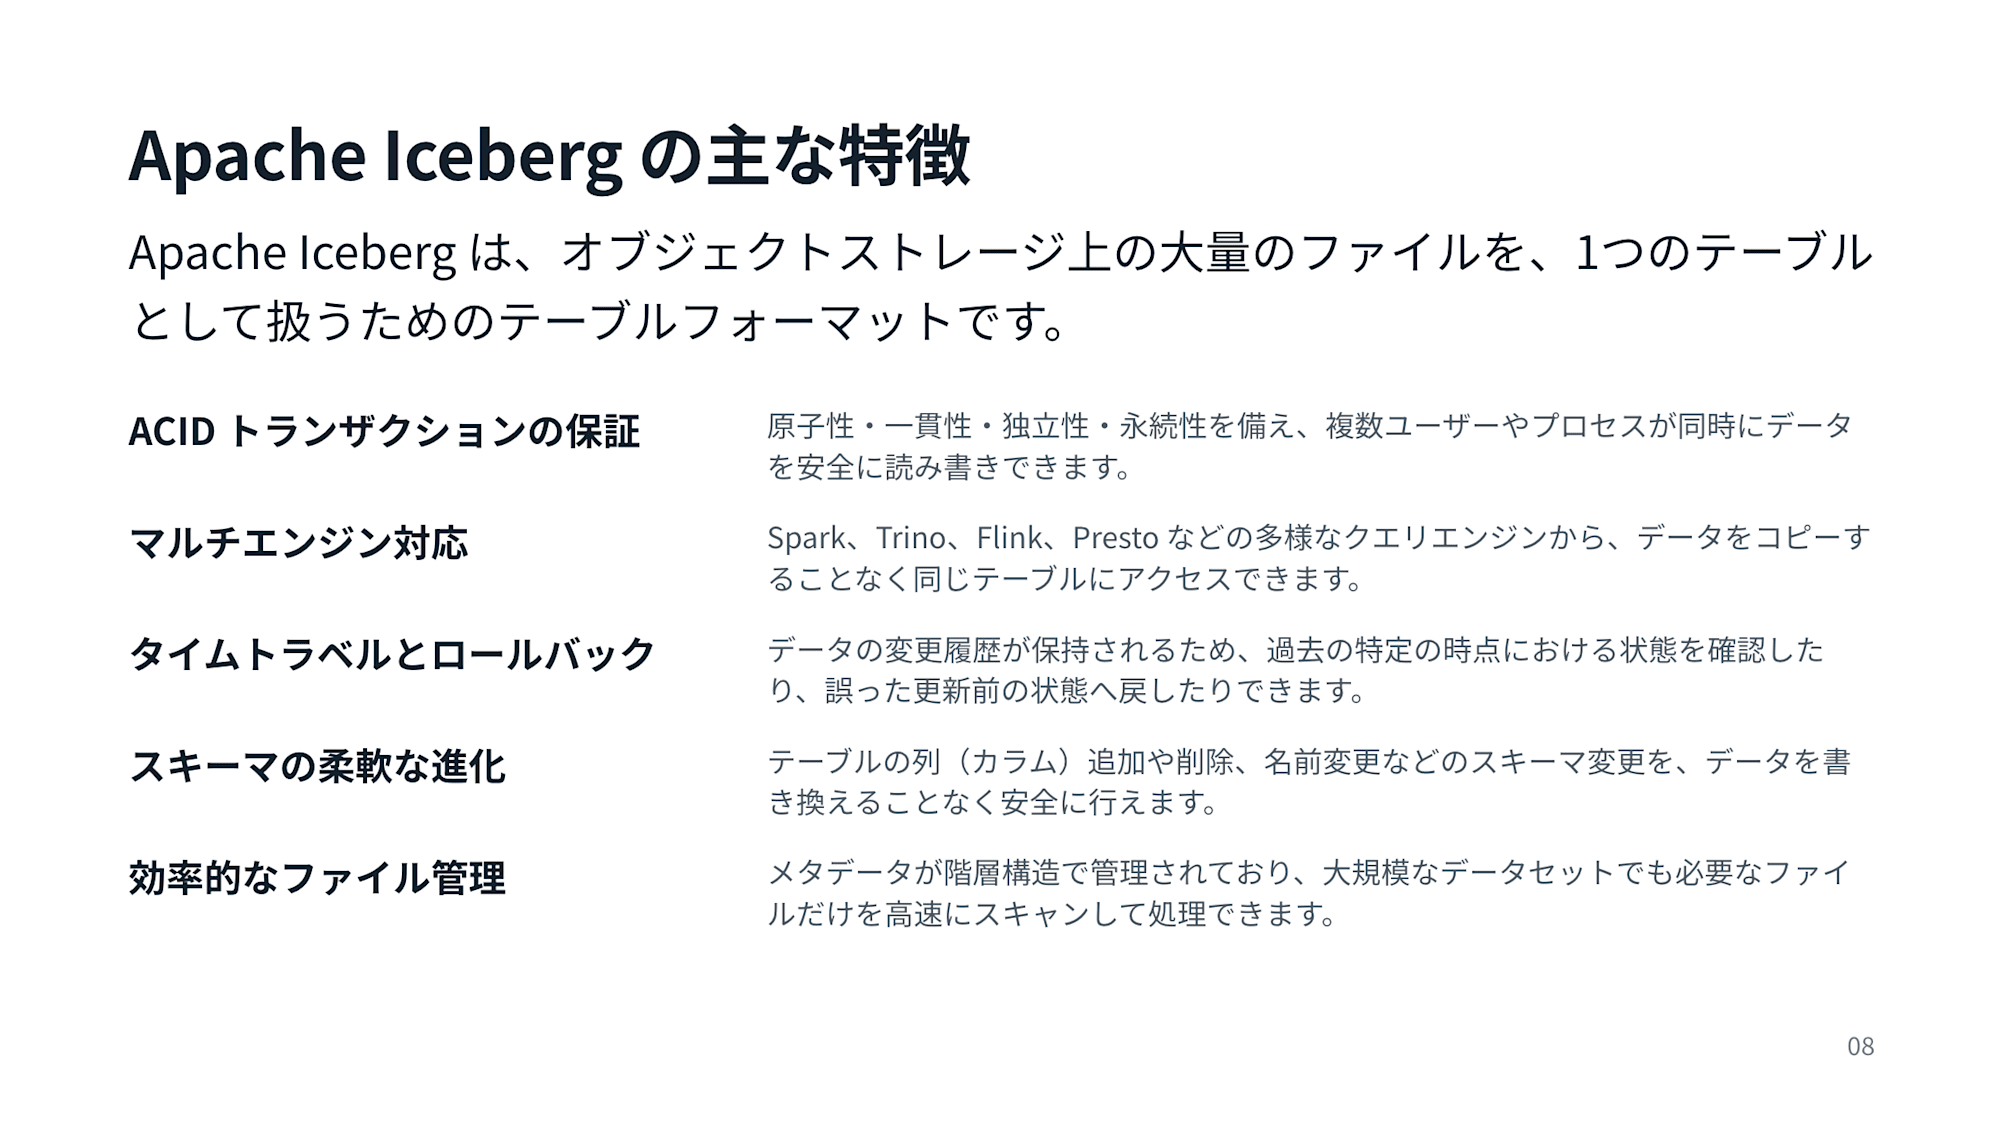
Iceberg はテーブルフォーマットです。S3 などのオブジェクトストレージ上にファイルを持ちながら、ACIDトランザクションや非常に高速なクエリが実行できます。他にもいろいろな機能があります。
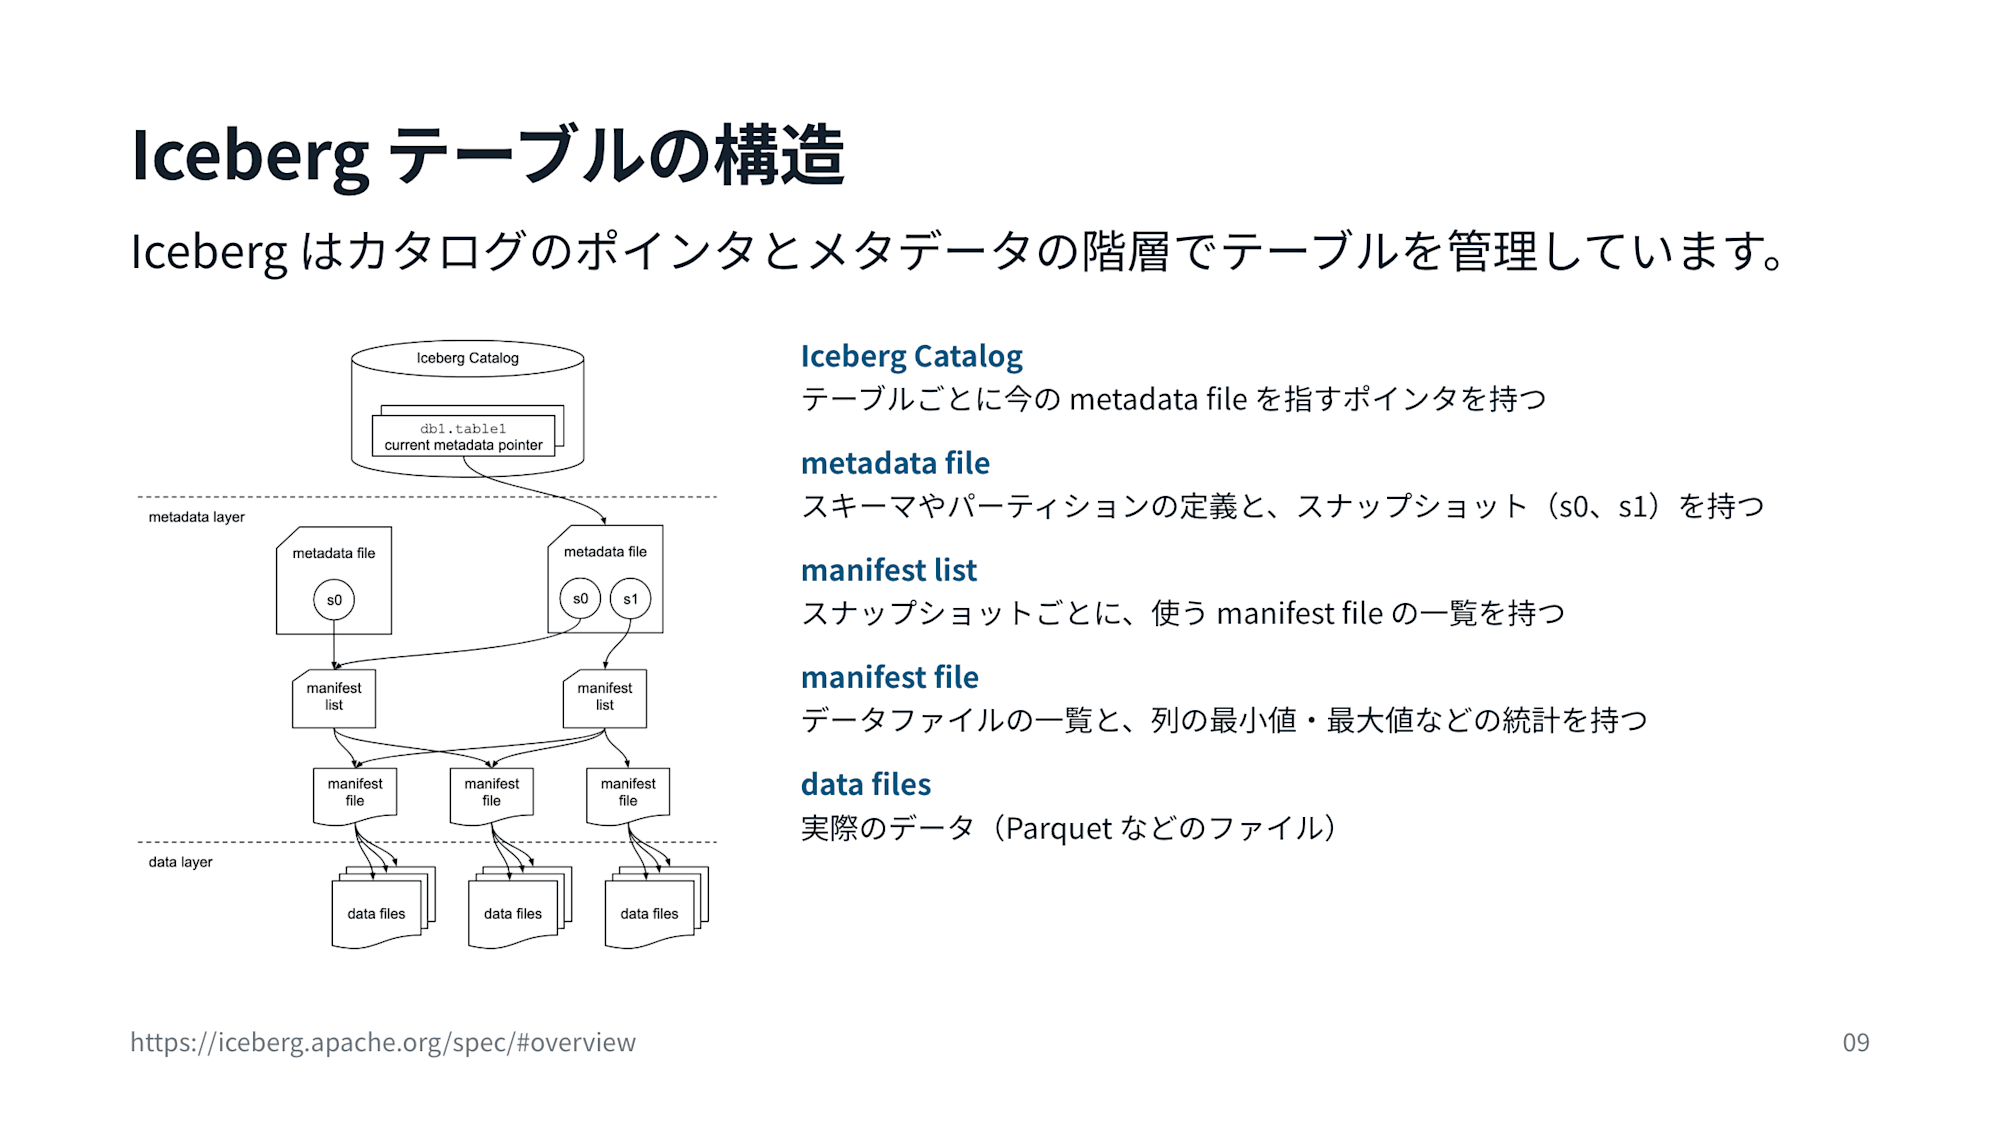
階層構造を持たせたメタデータレイヤーによって前述の機能が実現されています。
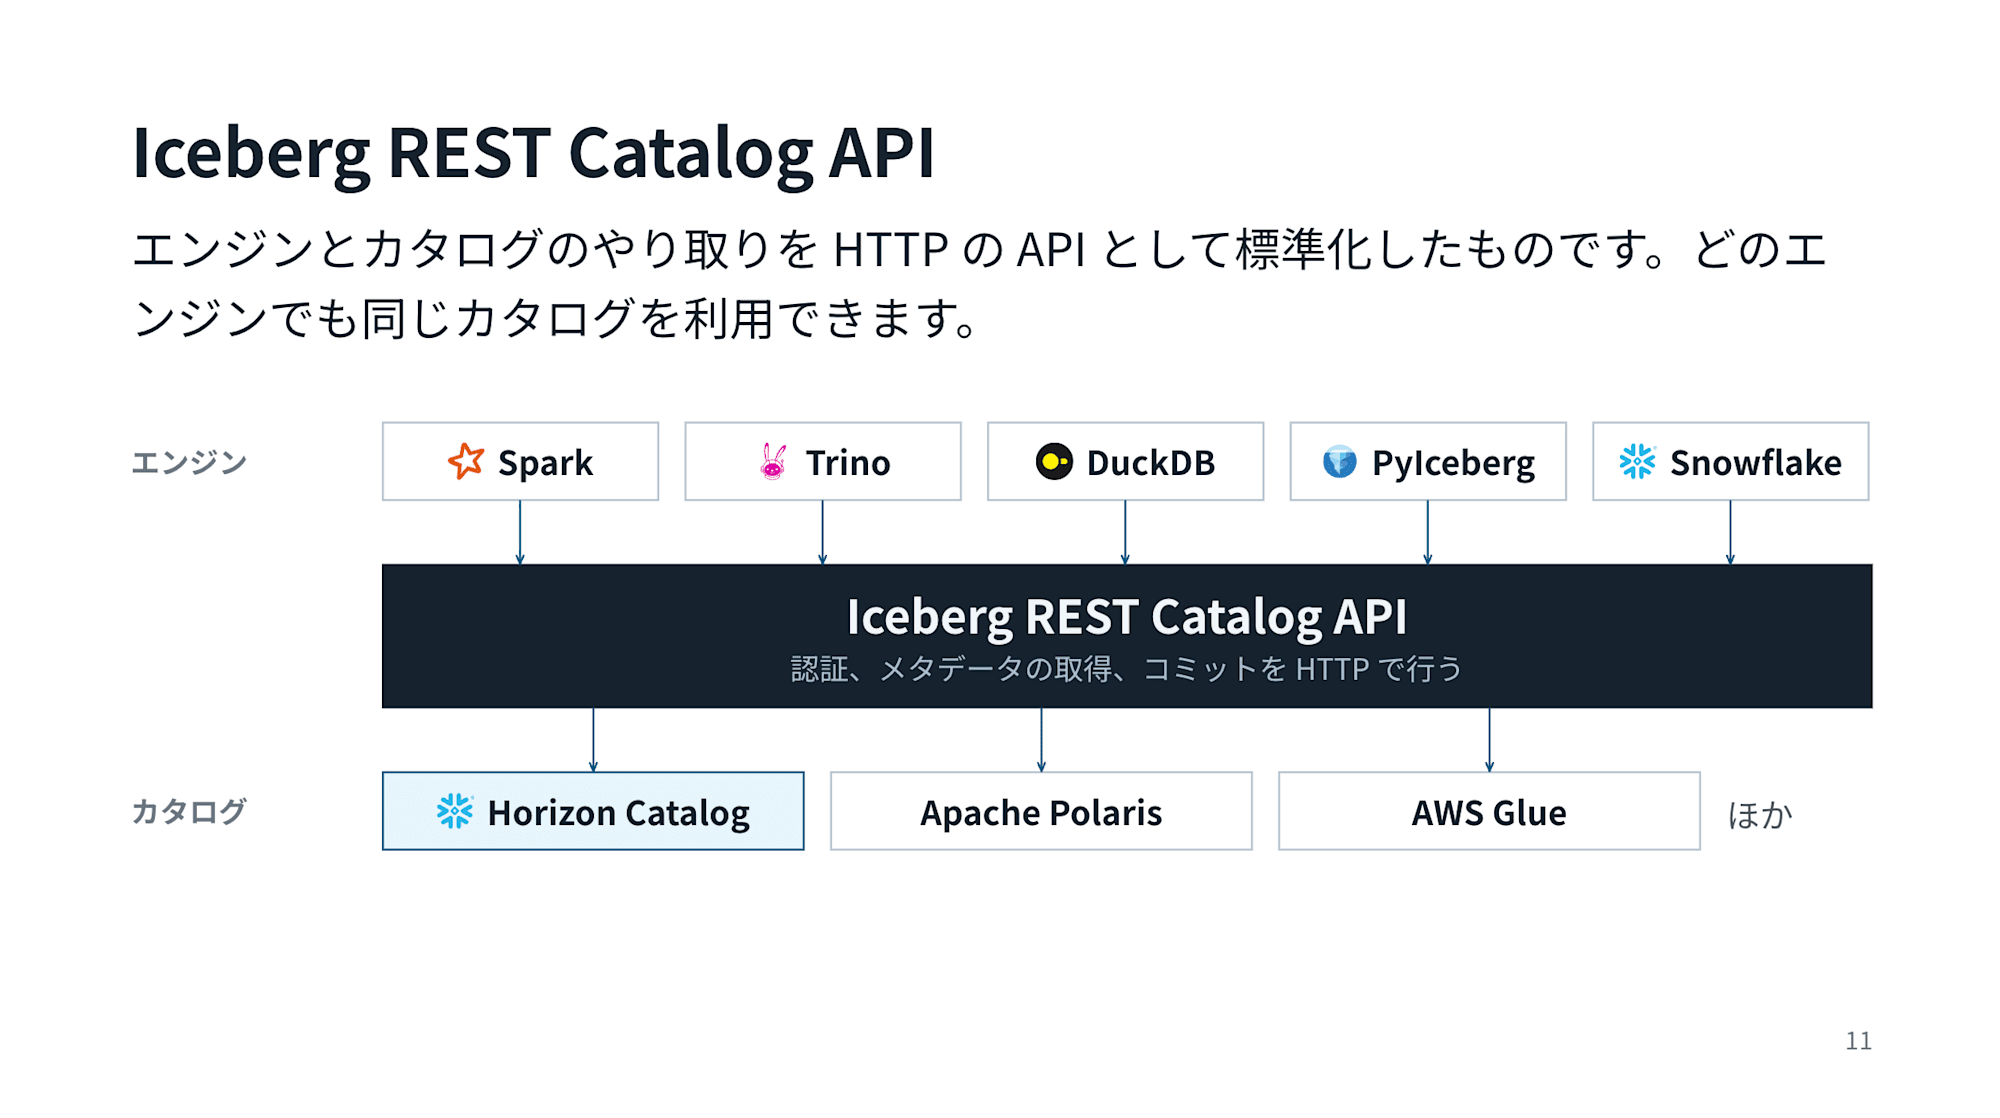
また Iceberg REST Catalog API が標準化されていることにより、クエリエンジン側はサービスを問わずデータにアクセスできるようになっています。
Snowflake Horizon Catalog とは
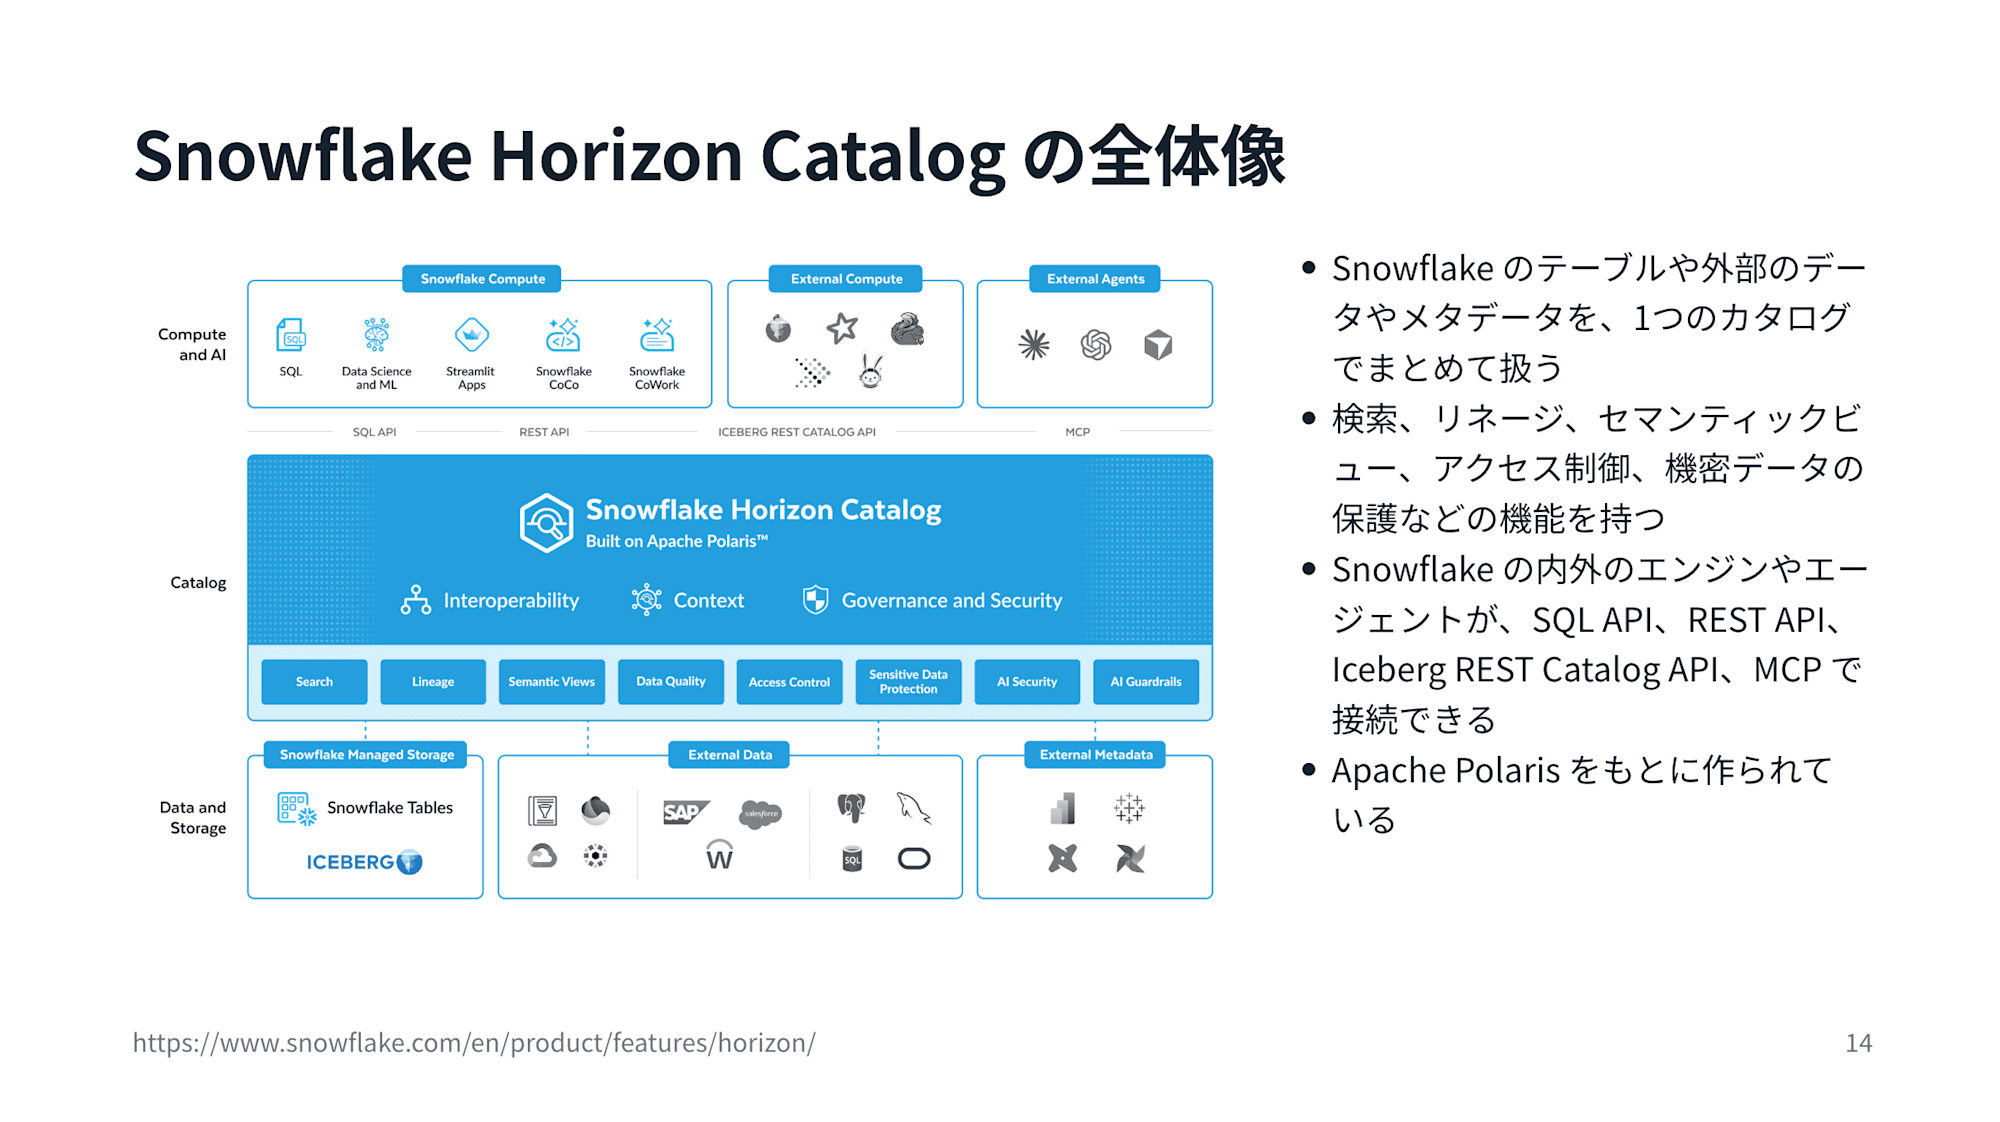
Horizon Catalog は Snowflake 内外のデータを統制・保護し、コンピュートリソースやAIモデルをデータにつなぐ統合カタログです。Apache Polaris を元に作られています。
Horizon Catalog を介することで外部エンジンからのクエリにもロールやポリシーを適用できます。
また Iceberg の vended credentials により、外部エンジンにS3などへのアクセス権限を持たせることなく、データの利用を許可できます。
Snowflake で Iceberg を試してみる
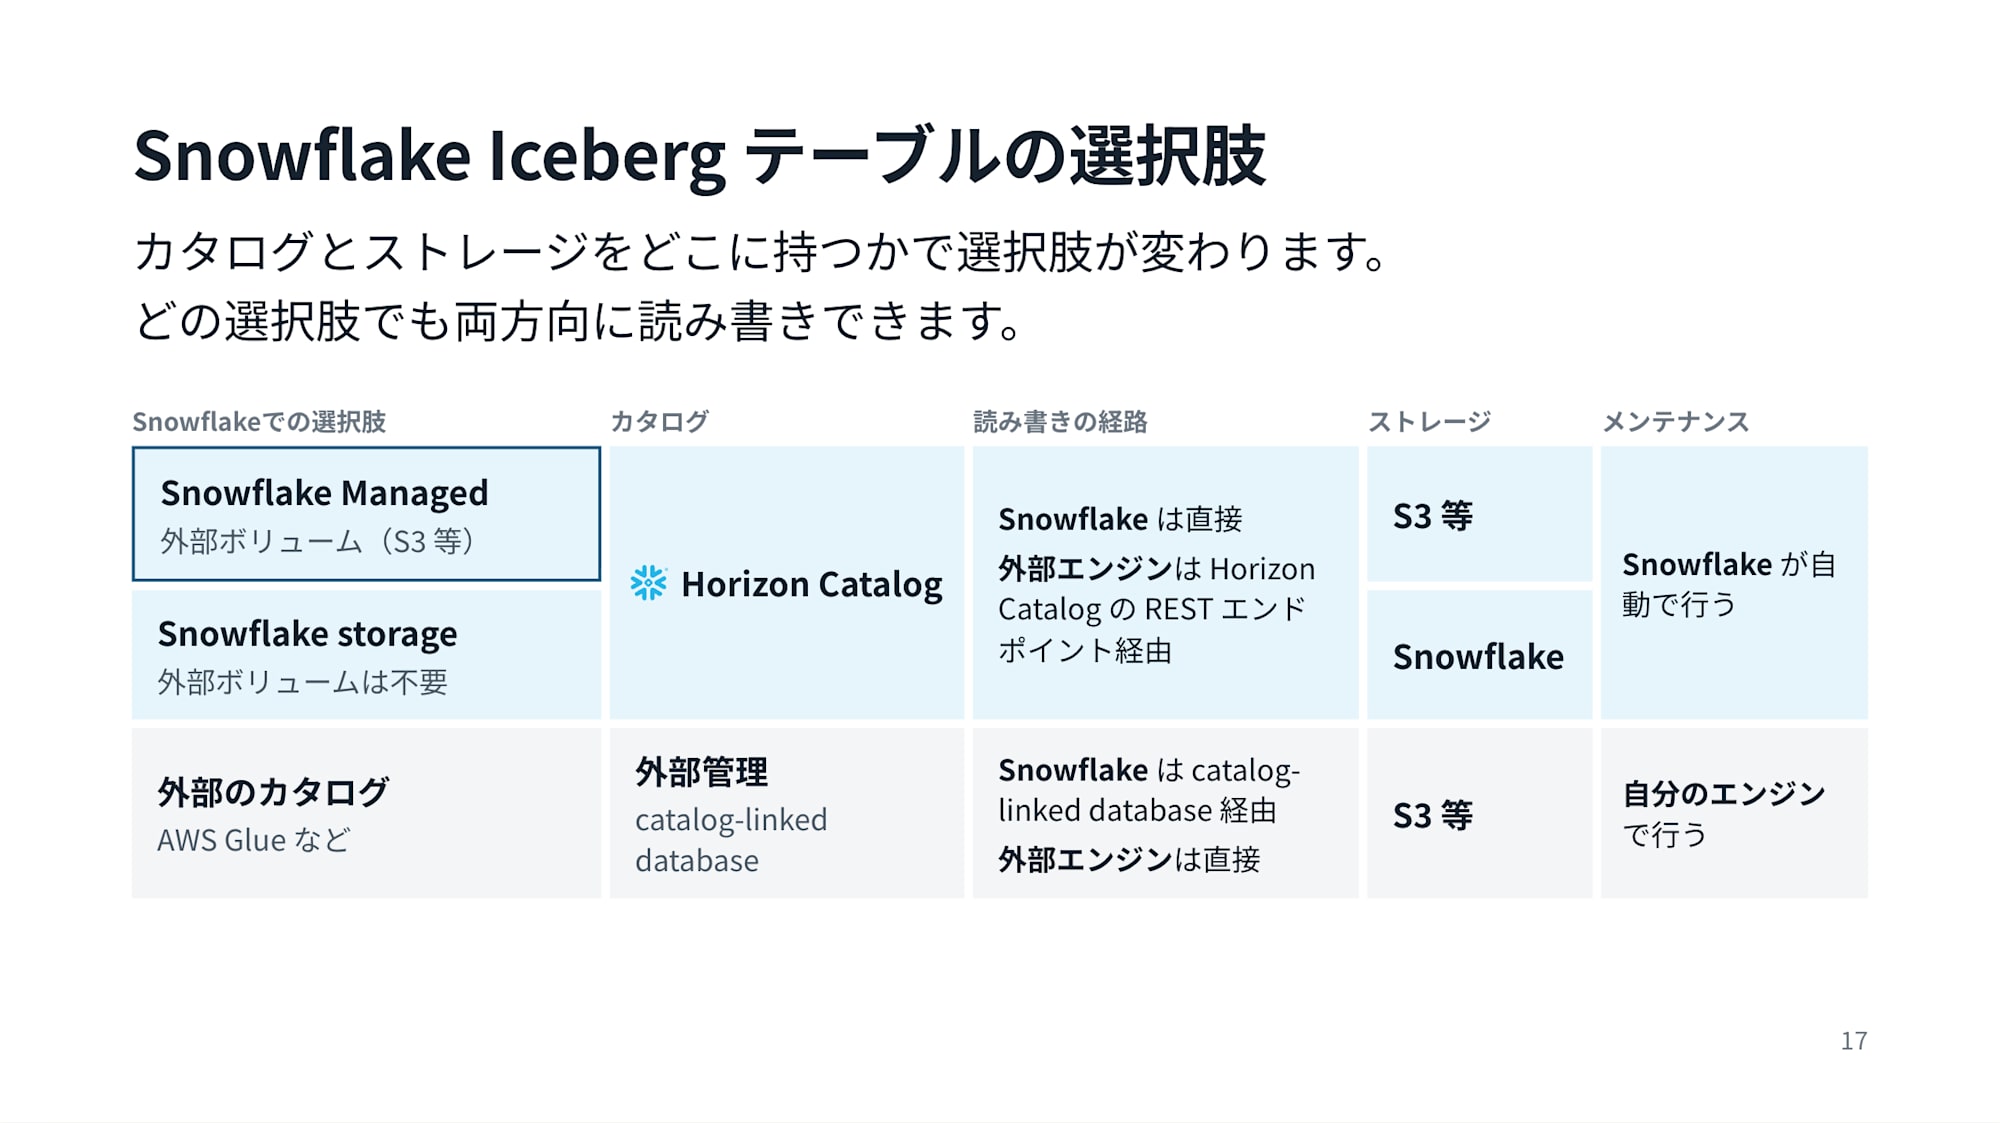
現在 Snowflake で Iceberg テーブルを利用するときは、大きく3つの方法があります。
- Snowflake Horizon Catalog を利用し、ストレージを Snowflake 外部に持つ
- Snowflake Horizon Catalog を利用し、ストレージを Snowflake 内部に持つ
- 外部のカタログを利用する
どの方法でも Snowflake と外部エンジンの相互利用は可能です。Snowflake Horizon Catlog を利用するとコンパクションなどの Iceberg テーブルのメンテナンスを Snowflake が行ってくれるという利点があります。
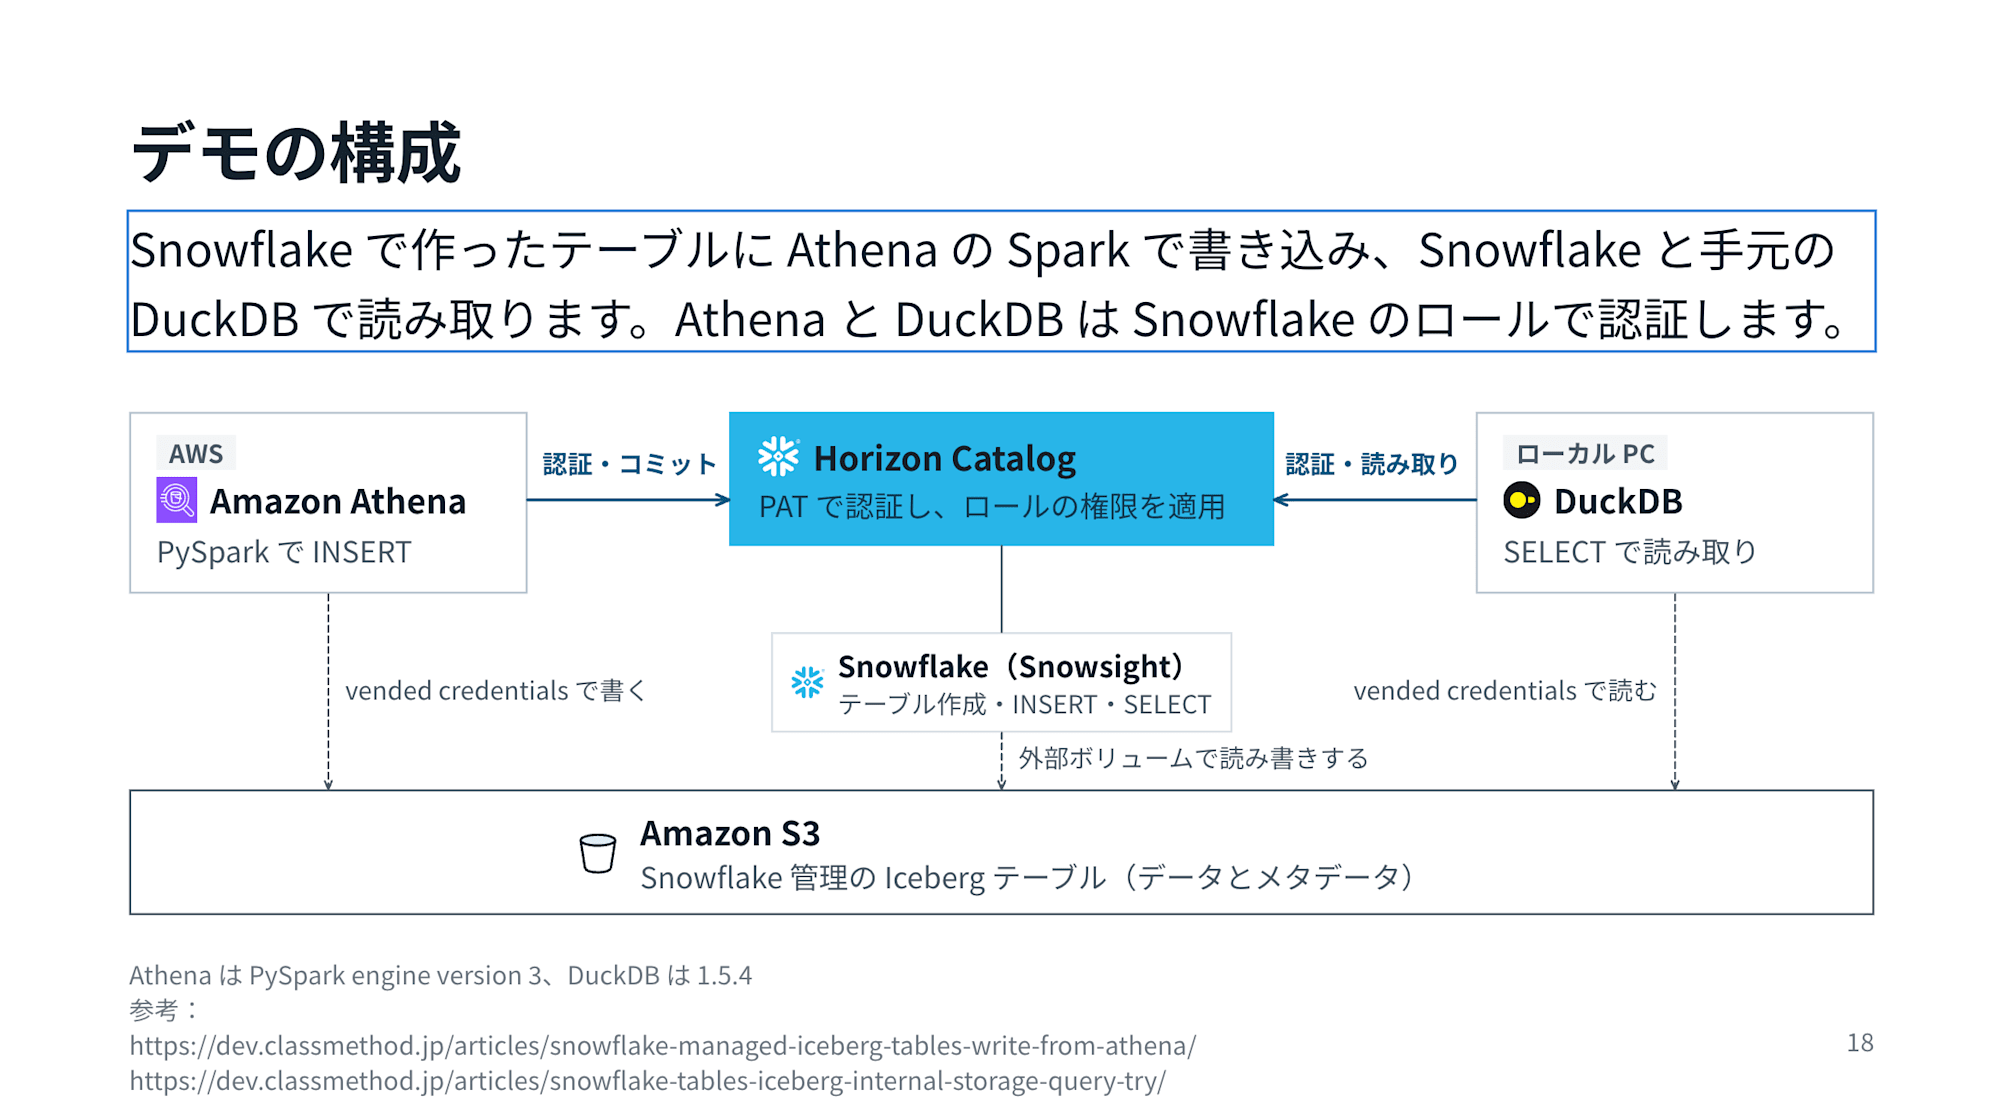
デモでは Snowflake で Iceberg テーブルを作り、 Amazon Athena の PySpark エンジンで書き込み、DuckDB で参照するという一連の流れを確かめました。
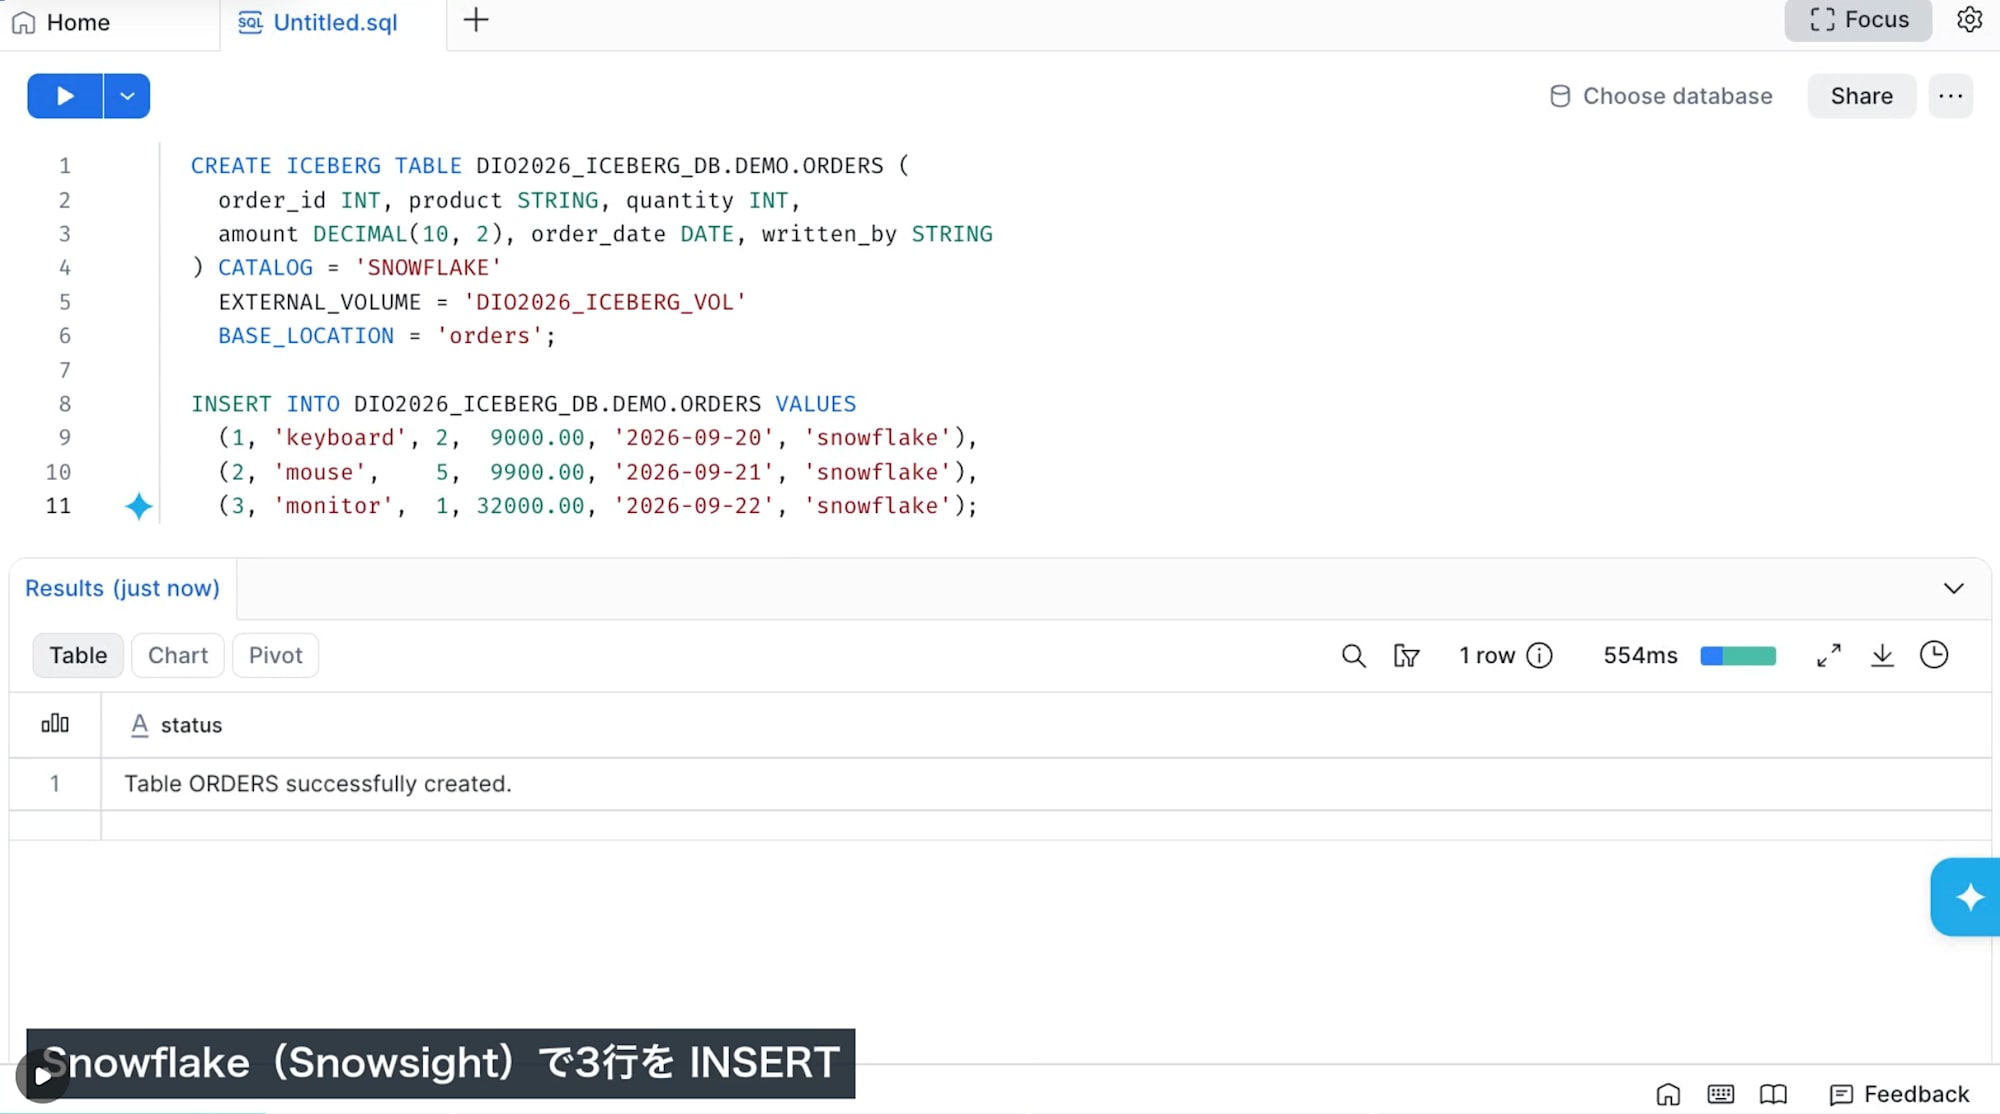
Snowflake でテーブル作成
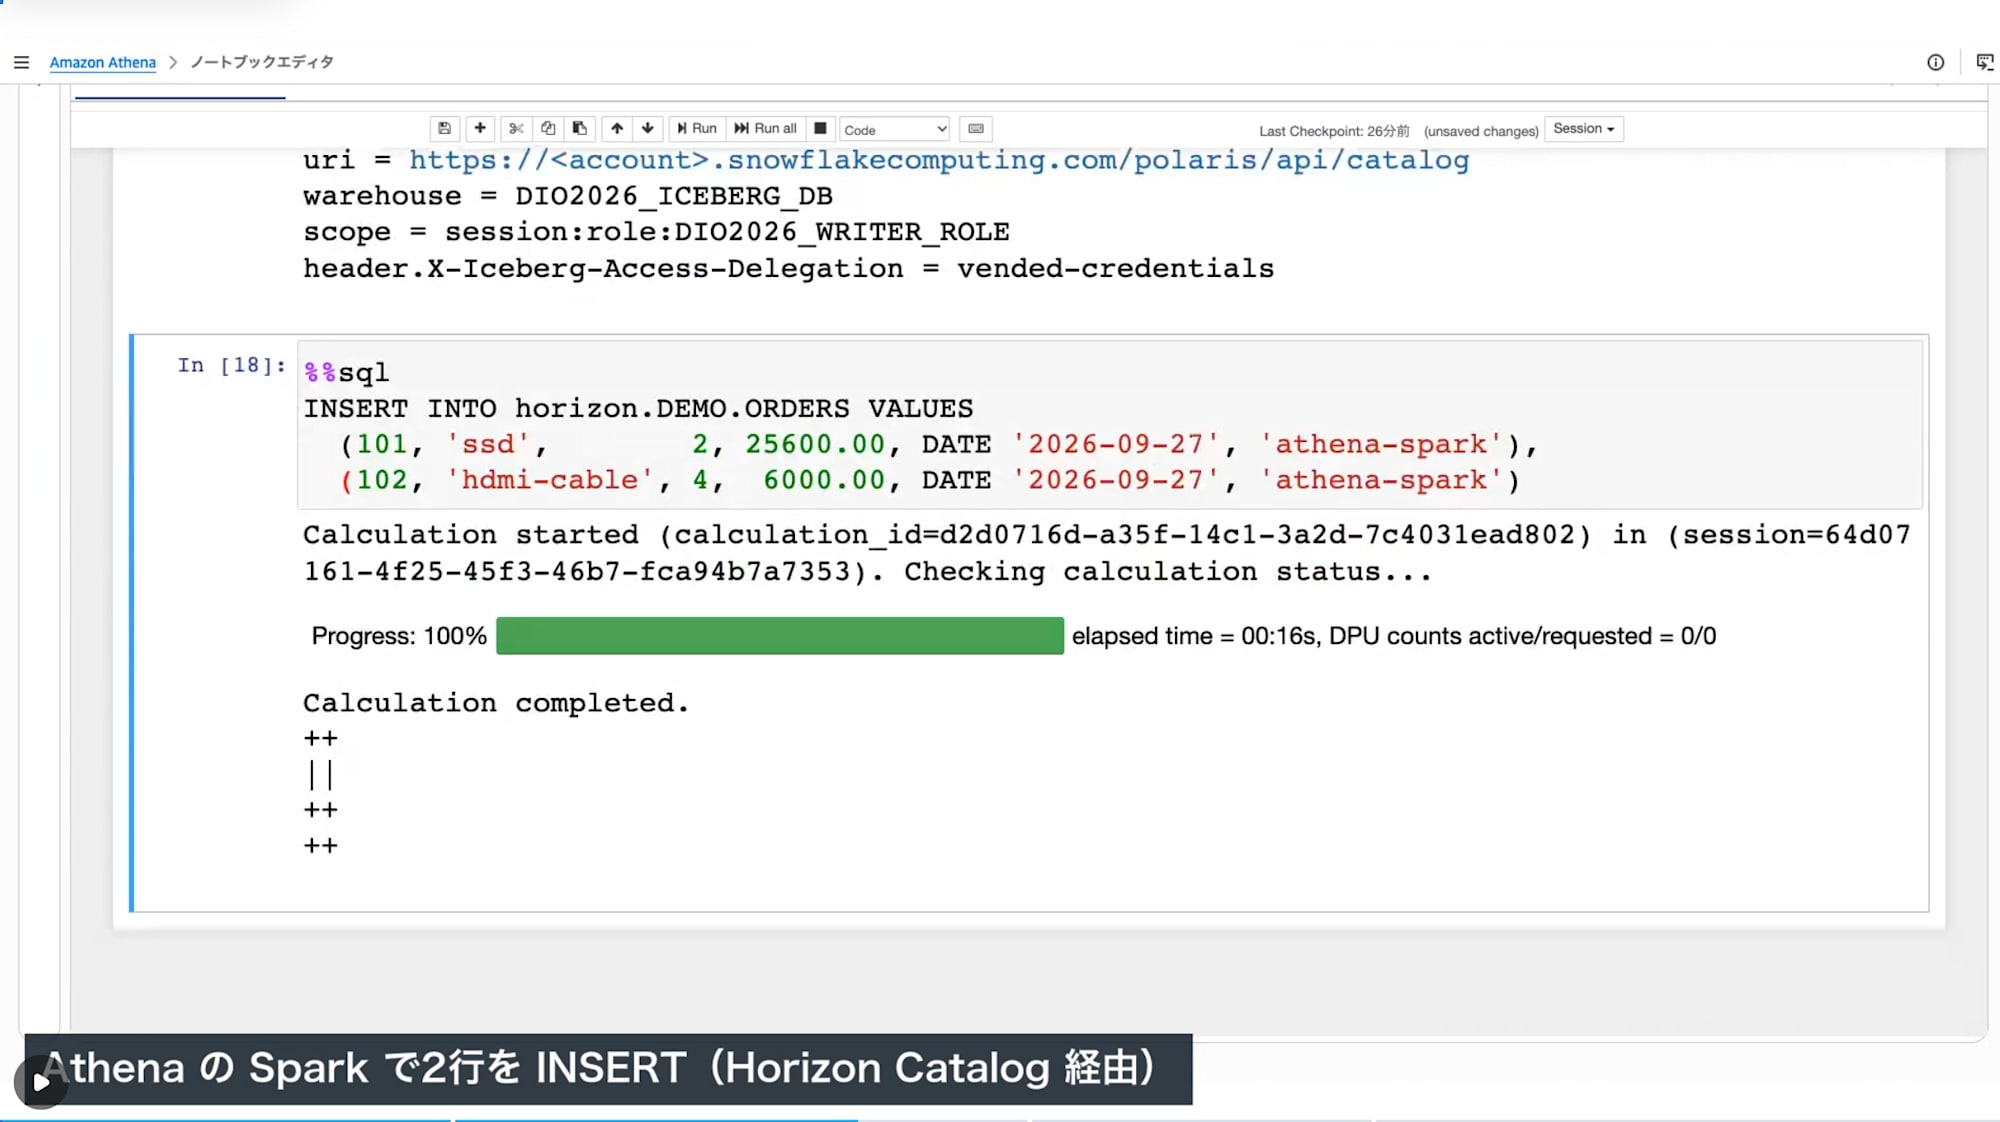
Amazon Athena で Insert
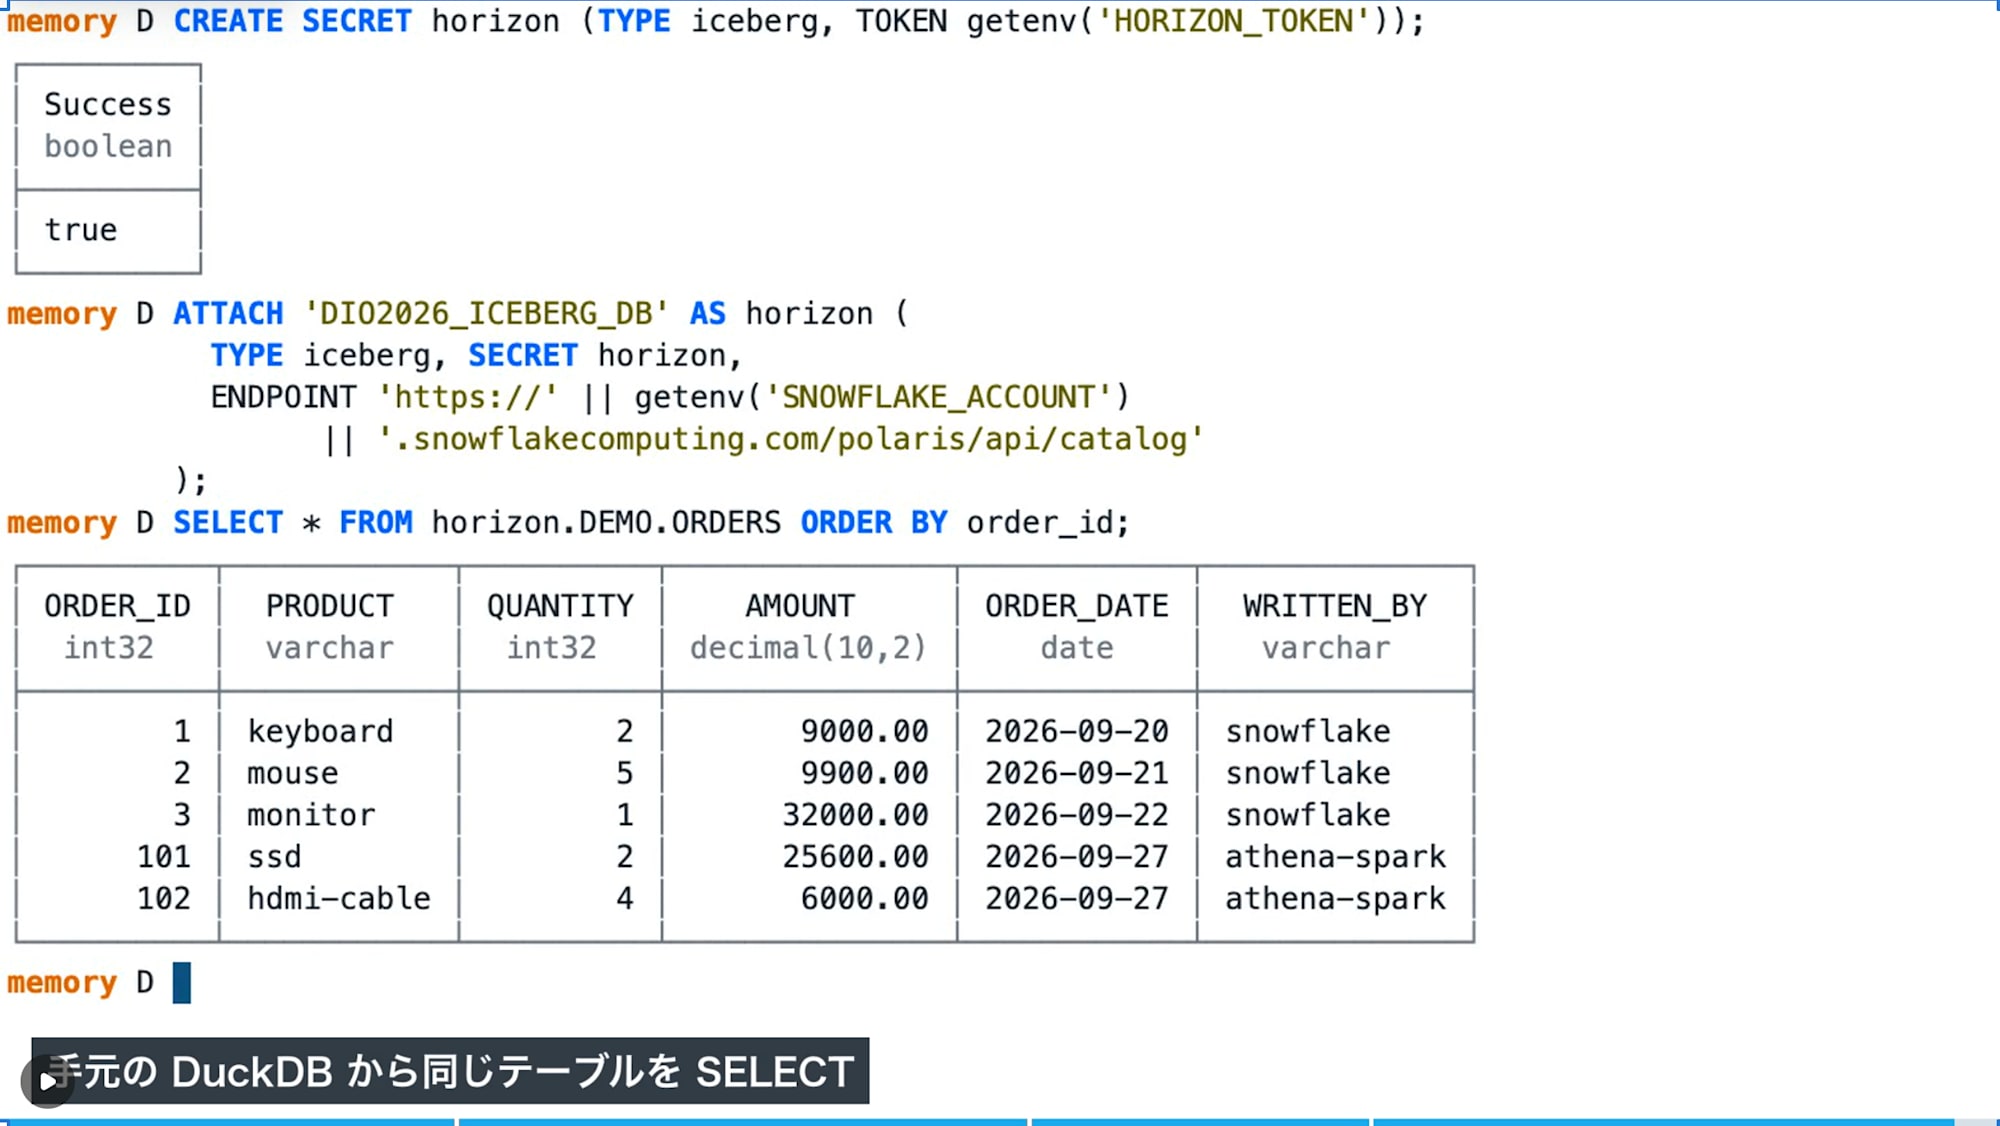
DuckDB で SELECT
Amazon Athena や DuckDB は専用のサービスユーザーを用意し、PAT で認証しています。無事に複数エンジンからの参照を検証できました。
参考ブログ
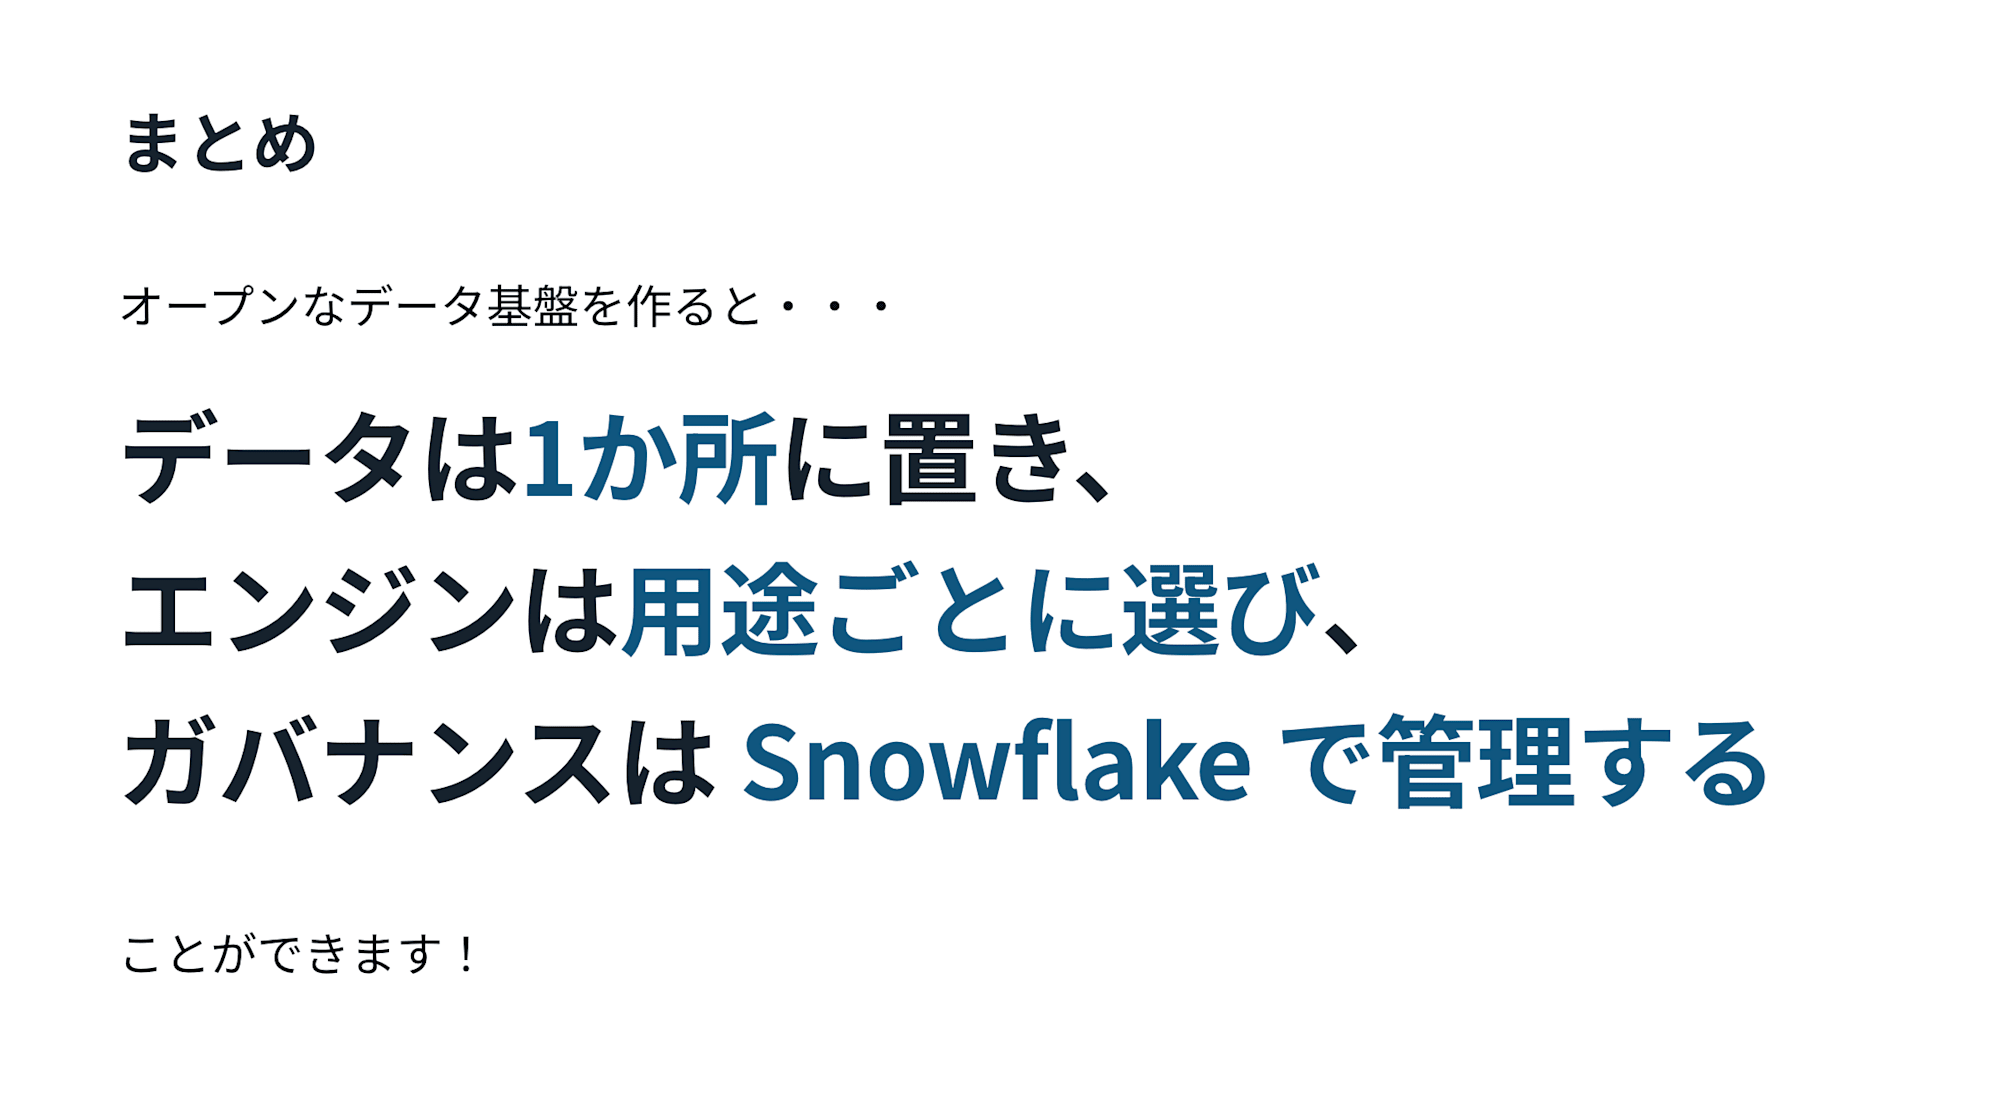
まとめ
登壇を終えて
Snowflakeのことなら何でも相談してください。お待ちしております。