[ハンズオン] サクッと AWS CloudShell で dbt v2(dbt-oss)+ DuckDB のビルド・テスト・リネージまで体験する15分ハンズオン!

クラウド事業統括本部の石川です。最新の dbt v2 に DuckDB アダプタが標準搭載されたことが DuckDB の公式ブログで紹介されました。そこで、オープンソース版の dbt-oss を AWS CloudShell にインストールし、サクッと15分程度で体験できるハンズオンを作成しました。CloudShell を起動して、「コマンド:」の部分をひたすらコピー&ペーストすれば最後まで実行できるはずです!
dbt v1 で DuckDB を使うには、Python パッケージの dbt-duckdb を別途インストールする必要がありました。dbt v2 は Rust ベースの Fusion エンジン上で動作し、**DuckDB アダプタが本体に組み込まれています。**DuckDB のドライバは初回実行時に自動でダウンロード・キャッシュされるため、dbt をインストールした後に追加でインストールするものはありません。
なお、実行環境の依存もなく、CloudShell もより便利になっているので、今回のハンズオンも滞りなく進めるはずです!
待望の dbt v2 (Fusion エンジン)の正式リリース
2026年9月14日にリリースされた dbt 2.0.0 では、CLI の名称が dbt(プロプライエタリ)と dbt-oss(オープンソース)に変わりました。どちらも同じエンジンで動作し、ローカルへのインストールは無料です。
本記事では Apache 2.0 ライセンスの dbt-oss を使い、AWS CloudShell 上で「CSV の取り込み → モデルのビルド → テスト → メタデータのクエリ → リネージの確認」までを通して試します。ハンズオンで使うファイルは、すべてコピー&ペーストで作成できるようにしています。
dbt と dbt-oss の違い
dbt v2 の配布形態は次の2種類です。dbt-oss には、SQL を解析する静的解析エンジンなどが含まれていません。
| 項目 | dbt | dbt-oss |
|---|---|---|
| インストール方法 | pip / Homebrew / curl / winget など | pip(pip install dbt-oss) |
| ライセンス | dbt product license | Apache 2.0 |
| 標準コマンド(run、build、test、compile、parse など) | ○ | ○ |
| SQL comprehension と静的解析 | ○ | × |
| LSP 機能(補完、ホバー情報、インラインエラー) | ○ | × |
dbt lint とエラー診断 |
○ | × |
| dbt VS Code 拡張との連携 | ○ | × |
列レベルのリネージは静的解析(--static-analysis strict)で生成されるため、dbt-oss で確認できるのはモデル単位のリネージです。
ハンズオンの全体像
ハンズオンでは、CSV(seed)2つから staging の view を2つ、marts の table を1つ作成し、8件のデータテストを実行します。
最後のリネージ確認では、CloudShell で作成した Web ページ(リネージなどをブラウザで確認できる HTML などのファイル一式)を zip にまとめてダウンロードし、ローカル PC のブラウザで開きます。
ハンズオン
前提条件
- ローカル PC に Python 3 と Web ブラウザがあり、インターネット(cdn.jsdelivr.net)に接続できること(手順9のリネージの確認で使用。本記事では macOS で確認)
- 検証環境
- リージョン: アジアパシフィック(東京) ap-northeast-1
- AWS CloudShell(Amazon Linux 2023、x86_64、Python 3.13.15)
- dbt-oss 2.0.5(2026年9月18日に PyPI で公開)
- DuckDB v1.5.4(dbt が自動でダウンロードしたドライバ)
AWS CloudShell は、ホームディレクトリ($HOME)にリージョンごとに 1GB の永続ストレージが追加料金なしで用意されています。$HOME 以外の場所は、シェルセッションの終了後にリサイクルされます。
0. CloudShellを起動する
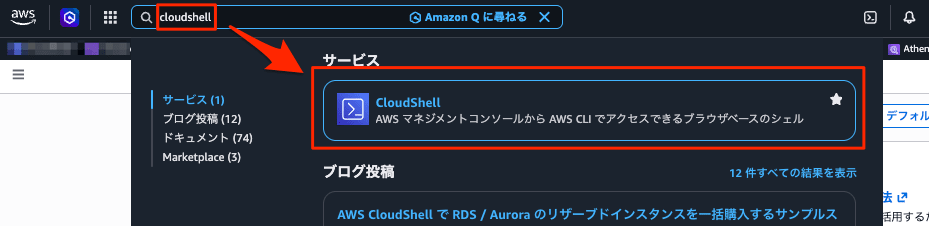
マネジメントコンソール上部の「検索」で「cloudshell」と入力して、サービスから「CloudShell」を選択して起動します。少し待つと起動してコマンドプロンプトが入力できるようになります。
1. CloudShell の Python のバージョンを確認する
AWS マネジメントコンソールで CloudShell を起動し、Python のバージョンを確認します。dbt-oss 2.0.5 は Python 3.11 以上が必要です。
コマンド:
python3 --version
出力結果:
Python 3.13.15
CloudShell の python3 は /usr/local/python3.13/bin/python3(RPM パッケージ python3.13)を指していました。/usr/bin/python3 は 3.9.25 のまま残っていますが、PATH で優先される python3 は 3.13 です。3.11 未満が表示された場合は、手順2の代わりに「考察」に記載した dnf を使う手順を実行してください。
2. dbt-oss をインストールする
venv を作成し、dbt-oss をインストールします。記事執筆時点の最新版 2.0.5 にバージョンを固定しています。
コマンド:
python3 -m venv ~/dbt-venv
source ~/dbt-venv/bin/activate
pip install dbt-oss==2.0.5
dbt --version
出力結果:
Collecting dbt-oss==2.0.5
  Downloading dbt_oss-2.0.5.tar.gz (5.1 kB)
  Installing build dependencies ... done
  Getting requirements to build wheel ... done
  Preparing metadata (pyproject.toml) ... done
...
Building wheels for collected packages: dbt-oss
  Building wheel for dbt-oss (pyproject.toml) ... done
  Created wheel for dbt-oss: filename=dbt_oss-2.0.5-cp311-abi3-manylinux_2_28_x86_64.whl size=69112585 sha256=6b4670ead375faf470e7a84841ae796c7bd2a0d2ef6b8c5e4315c34b56affd3a
...
Successfully built dbt-oss
Installing collected packages: typing_extensions, msgpack, mashumaro, dbt-oss
Successfully installed dbt-oss-2.0.5 mashumaro-3.22 msgpack-1.2.2 typing_extensions-4.16.0
dbt-oss 2.0.5
PyPI の dbt-oss は約5KB のソース配布物(sdist)で、ビルド時にプラットフォームに合った wheel(今回は x86_64 用で約69MB)を GitHub Releases からダウンロードし、sha256 を照合する仕組みになっています。インストールは約4.6秒で完了しました。
3. プロジェクトのファイルを作成する
ホームディレクトリで、以下をまとめてコピー&ペーストします。dbt のプロジェクト設定(dbt_project.yml)、接続設定(profiles.yml)、seed の CSV、モデルの SQL、テスト定義(schema.yml)を作成します。
コマンド:
cd ~

mkdir -p duckdb_handson/seeds duckdb_handson/models/staging duckdb_handson/models/marts

cat > duckdb_handson/dbt_project.yml <<'DUCKDBTV2'
name: duckdb_handson
version: "1.0.0"
profile: duckdb_handson

seed-paths: ["seeds"]
model-paths: ["models"]

models:
  duckdb_handson:
    staging:
      +materialized: view
    marts:
      +materialized: table
DUCKDBTV2

cat > duckdb_handson/profiles.yml <<'DUCKDBTV2'
duckdb_handson:
  target: dev
  outputs:
    dev:
      type: duckdb
      path: ./warehouse.duckdb
      schema: main
      threads: 4
DUCKDBTV2

cat > duckdb_handson/seeds/raw_customers.csv <<'DUCKDBTV2'
customer_id,customer_name,prefecture
1,佐藤,東京都
2,鈴木,大阪府
3,高橋,福岡県
4,田中,北海道
DUCKDBTV2

cat > duckdb_handson/seeds/raw_orders.csv <<'DUCKDBTV2'
order_id,customer_id,order_date,status,amount
101,1,2026-09-01,completed,1200
102,1,2026-09-03,completed,800
103,2,2026-09-05,returned,1500
104,3,2026-09-10,completed,3000
105,3,2026-09-12,placed,450
106,1,2026-09-15,completed,2200
DUCKDBTV2

cat > duckdb_handson/models/staging/stg_customers.sql <<'DUCKDBTV2'
select
    customer_id,
    customer_name,
    prefecture
from {{ ref('raw_customers') }}
DUCKDBTV2

cat > duckdb_handson/models/staging/stg_orders.sql <<'DUCKDBTV2'
select
    order_id,
    customer_id,
    cast(order_date as date) as order_date,
    status,
    amount
from {{ ref('raw_orders') }}
DUCKDBTV2

cat > duckdb_handson/models/marts/customer_summary.sql <<'DUCKDBTV2'
with completed_orders as (
    select *
    from {{ ref('stg_orders') }}
    where status = 'completed'
)

select
    c.customer_id,
    c.customer_name,
    c.prefecture,
    count(o.order_id)          as order_count,
    coalesce(sum(o.amount), 0) as total_amount,
    max(o.order_date)          as last_order_date
from {{ ref('stg_customers') }} as c
left join completed_orders as o
    on c.customer_id = o.customer_id
group by all
DUCKDBTV2

cat > duckdb_handson/models/schema.yml <<'DUCKDBTV2'
models:
  - name: stg_customers
    columns:
      - name: customer_id
        data_tests:
          - unique
          - not_null

  - name: stg_orders
    columns:
      - name: order_id
        data_tests:
          - unique
          - not_null
      - name: customer_id
        data_tests:
          - relationships:
              arguments:
                to: ref('stg_customers')
                field: customer_id
      - name: status
        data_tests:
          - accepted_values:
              arguments:
                values: ['placed', 'completed', 'returned']

  - name: customer_summary
    columns:
      - name: customer_id
        data_tests:
          - unique
          - not_null
DUCKDBTV2
最後の DUCKDBTV2 の後で改行されずにプロンプトに残った場合は、Enter キーを押してください。作成したファイルを確認します。
コマンド:
find duckdb_handson -type f | sort
出力結果:
duckdb_handson/dbt_project.yml
duckdb_handson/models/marts/customer_summary.sql
duckdb_handson/models/schema.yml
duckdb_handson/models/staging/stg_customers.sql
duckdb_handson/models/staging/stg_orders.sql
duckdb_handson/profiles.yml
duckdb_handson/seeds/raw_customers.csv
duckdb_handson/seeds/raw_orders.csv
profiles.yml の type: duckdb が DuckDB アダプタの指定で、path で指定したファイル(warehouse.duckdb)にテーブルやビューが作成されます。今回は profiles.yml を ~/.dbt/ ではなくプロジェクト直下に置き、次の dbt debug で読み込まれることを確認しました。
4. 接続を確認する(dbt debug)
プロジェクトのディレクトリに移動し、接続を確認します。手順4以降は、venv を有効化した状態で ~/duckdb_handson から実行します。(途中で CloudShell を開き直した場合は、先に source ~/dbt-venv/bin/activate を実行してから cd ~/duckdb_handson してください。)
dbt debug は、dbt のコマンドを実行する前に、設定と接続に問題がないかをまとめて確認するコマンドです。公式ドキュメントでは、データベースへの接続、dbt_project.yml などのプロジェクトの設定、OS や dbt のバージョン、git などの依存ツール、アダプタの情報を確認すると説明されています。
このハンズオンでは、次の2点を確かめるために実行します。
- 手順3で作成した
dbt_project.ymlとprofiles.ymlを dbt が読み込めること - アダプタを別途インストールしていない状態で、DuckDB に接続できること
先にここで確認しておくと、手順5の dbt build が失敗した場合に、原因が設定や接続にあるのか、モデルの SQL にあるのかを切り分けやすくなります。
コマンド:
cd ~/duckdb_handson
dbt debug
出力結果:
   dbt-oss 2.0.5
   Loading profiles.yml
 Debugging profile: dev
 Debugging dbt version: 2.0.5
 Debugging platform: linux x86_64 (unix)
 Debugging adapter type: duckdb (remote)
 Debugging dependencies:
  git: OK
 Debugging connection:
  "path": "./warehouse.duckdb",
  "schema": "main"
 Debugging connection test: OK (1.2s)
  Debugged All checks passed!

==================== Execution Summary =====================
Finished 'debug' successfully for target 'dev' [1.3s]
出力の主な行の意味は次のとおりです。
| 出力 | 意味 |
|---|---|
Loading profiles.yml |
プロジェクト直下の profiles.yml を読み込んだ |
Debugging profile: dev |
profiles.yml の target: dev の設定を使っている |
Debugging dbt version / Debugging platform |
dbt のバージョン(2.0.5)と実行環境(Linux の x86_64) |
Debugging adapter type: duckdb |
profiles.yml の type: duckdb のアダプタを使っている |
git: OK |
依存ツールの git を使える(パッケージを取得する dbt deps で使用) |
Debugging connection |
接続先の path(./warehouse.duckdb)と schema(main) |
Debugging connection test: OK |
DuckDB への接続テストが成功した |
All checks passed! |
すべての確認項目が成功した |
最後に All checks passed! と表示されれば、次の手順に進めます。エラーが表示された場合は、カレントディレクトリが ~/duckdb_handson になっているか、手順3の profiles.yml と dbt_project.yml の内容を確認してください。
アダプタを追加でインストールしていませんが、adapter type: duckdb で接続テストが成功しました。ハンズオン後に確認すると、~/.cache/com.getdbt/adbc/ に DuckDB の ADBC ドライバ libadbc_driver_duckdb-1.5.4.so(約70MB)が保存されていました。ファイルの時刻は、dbt debug と最初の dbt build を実行した 08:09(UTC)でした。
5. ビルドする(dbt build)
seed の取り込み、モデルの作成、テストをまとめて実行します。
dbt build は、seed の取り込み(dbt seed)、モデルの作成(dbt run)、データテスト(dbt test)などを、モデル間の依存関係(DAG)の順にまとめて実行するコマンドです。上流のモデルのテストが失敗すると、そのモデルに依存する下流のモデルは実行されずにスキップされます。
このハンズオンでは、次の3つを行うために実行します。
- 手順3で作成した CSV 2つを、DuckDB のテーブルとして取り込む(seed)
- staging の view 2つと marts の table 1つを作成する(model)
schema.ymlに定義した8件のデータテストを実行する(test)
テストが失敗したときのスキップの動きは、手順7で確認します。
コマンド:
dbt build
出力結果:
   dbt-oss 2.0.5
   Loading profiles.yml
 Succeeded seed  main.raw_customers (table) [2 of 13 in 0.05s]
 Succeeded seed  main.raw_orders (table) [1 of 13 in 0.06s]
 Succeeded model main.stg_customers (view) [3 of 13 in 0.03s]
 Succeeded model main.stg_orders (view) [4 of 13 in 0.03s]
    Passed test  not_null_stg_customers_customer_id [5 of 13 in 0.01s]
    Passed test  unique_stg_customers_customer_id [6 of 13 in 0.02s]
    Passed test  not_null_stg_orders_order_id [9 of 13 in 0.05s]
    Passed test  relationships_stg_orders_customer_id__customer_id__ref_stg_customers_ [11 of 13 in 0.05s]
    Passed test  unique_stg_orders_order_id [8 of 13 in 0.05s]
    Passed test  accepted_values_stg_orders_status__placed__completed__returned [7 of 13 in 0.05s]
 Succeeded model main.customer_summary (table) [10 of 13 in 0.03s]
    Passed test  not_null_customer_summary_customer_id [12 of 13 in 0.01s]
    Passed test  unique_customer_summary_customer_id [13 of 13 in 0.01s]

==================== Execution Summary =====================
Finished 'build' successfully for target 'dev' [1.1s]
Processed: 3 models | 8 tests | 2 seeds
Summary: 13 total | 13 success
出力の主な行の意味は次のとおりです。
| 出力 | 意味 |
|---|---|
Succeeded seed main.raw_customers (table) |
CSV を main スキーマの raw_customers テーブルとして取り込んだ |
Succeeded model main.stg_customers (view) |
staging のモデルを view として作成した(dbt_project.yml の +materialized: view) |
Passed test not_null_stg_customers_customer_id |
データテストが成功した。テスト名には、テストの種類(not_null)、モデル名、列名が含まれる |
Succeeded model main.customer_summary (table) |
marts のモデルを table として作成した(+materialized: table) |
Processed: 3 models | 8 tests | 2 seeds |
処理したモデル、テスト、seed の件数 |
Summary: 13 total | 13 success |
13件すべて成功した |
出力を見ると、customer_summary の作成は、stg_customers と stg_orders のテスト6件がすべて成功した後に行われています。上流のテストの結果を確認してから下流のモデルを作成する、DAG 順の実行になっていることがわかります。
seed 2件、モデル3件、テスト8件の計13件がすべて成功しました。threads: 4 で並列に実行されるため、表示順と [N of 13] の番号は一致していません。
6. 結果を確認する(dbt show)
dbt show で、marts の customer_summary の中身を表示します。並び順を固定するため、--inline で order by を指定しています。
コマンド:
dbt show --inline "select * from {{ ref('customer_summary') }} order by customer_id"
出力結果:
   dbt-oss 2.0.5
   Loading profiles.yml
Query show_sql_operation_inline
┌─────────────┬───────────────┬────────────┬─────────────┬──────────────┬─────────────────┐
│ customer_id ┆ customer_name ┆ prefecture ┆ order_count ┆ total_amount ┆ last_order_date │
╞═════════════╪═══════════════╪════════════╪═════════════╪══════════════╪═════════════════╡
│ 1           ┆ 佐藤          ┆ 東京都     ┆ 3           ┆ 4200         ┆ 2026-09-15      │
│ 2           ┆ 鈴木          ┆ 大阪府     ┆ 0           ┆ 0            ┆                 │
│ 3           ┆ 高橋          ┆ 福岡県     ┆ 1           ┆ 3000         ┆ 2026-09-10      │
│ 4           ┆ 田中          ┆ 北海道     ┆ 0           ┆ 0            ┆                 │
└─────────────┴───────────────┴────────────┴─────────────┴──────────────┴─────────────────┘
4 rows.
 Succeeded model main.inline (ephemeral) [1 of 1 in 0.03s]

==================== Execution Summary =====================
Finished 'show' successfully for target 'dev' [496ms]
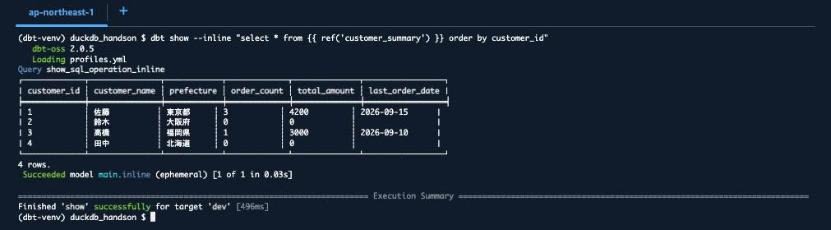
status = 'completed' の注文だけを集計しているため、返品(returned)のみの鈴木さんと注文のない田中さんは 0 件、高橋さんは placed の注文を除いた 1 件になりました。
7. テストを失敗させてみる
データテストが失敗したときの動きを確認します。存在しない顧客 ID(9)と、許可していないステータス(shipped)を持つ注文を1行追加します。
コマンド:
cat >> seeds/raw_orders.csv <<'DUCKDBTV2'
107,9,2026-09-20,shipped,999
DUCKDBTV2

dbt build
出力結果:
   dbt-oss 2.0.5
   Loading profiles.yml
 Succeeded seed  main.raw_customers (table) [2 of 13 in 0.06s]
 Succeeded seed  main.raw_orders (table) [1 of 13 in 0.06s]
 Succeeded model main.stg_customers (view) [3 of 13 in 0.04s]
 Succeeded model main.stg_orders (view) [4 of 13 in 0.04s]
    Failed test  accepted_values_stg_orders_status__placed__completed__returned (models/schema.yml:23:13) [9 of 13 in 0.03s]
    Passed test  unique_stg_customers_customer_id [5 of 13 in 0.04s]
    Passed test  not_null_stg_customers_customer_id [6 of 13 in 0.04s]
    Passed test  not_null_stg_orders_order_id [10 of 13 in 0.04s]
    Passed test  unique_stg_orders_order_id [7 of 13 in 0.04s]
    Failed test  relationships_stg_orders_customer_id__customer_id__ref_stg_customers_ (models/schema.yml:17:13) [8 of 13 in 0.04s]
   Skipped model main.customer_summary (table) [11 of 13]
   Skipped test 'not_null_customer_summary_customer_id', 'unique_customer_summary_customer_id'

==================== Test Failures =====================
Test failed (1 failed row(s)): accepted_values_stg_orders_status__placed__completed__returned
Test failed (1 failed row(s)): relationships_stg_orders_customer_id__customer_id__ref_stg_customers_

==================== Execution Summary =====================
Finished 'build' with 2 errors for target 'dev' [946ms]
Processed: 3 models | 8 tests | 2 seeds
Summary: 13 total | 8 success | 2 error | 3 skipped
accepted_values(ステータスの値チェック)と relationships(顧客 ID の参照整合性チェック)の2件が失敗し、失敗したテストの定義位置(models/schema.yml:23:13 など)が表示されました。dbt build はテストが失敗したモデルの下流を実行しないため、customer_summary とそのテスト2件はスキップされています。seed の raw_orders と view の stg_orders には不正な行が入りましたが、customer_summary は再作成されず、手順5で作成したテーブルのまま残ります。
確認できたら、CSV を元の内容に戻します。この時点では CSV を戻しただけなので、DuckDB 上の raw_orders にはまだ不正な行が残っています。次の手順8の dbt build で、戻した CSV の内容が反映されます。
コマンド:
cat > seeds/raw_orders.csv <<'DUCKDBTV2'
order_id,customer_id,order_date,status,amount
101,1,2026-09-01,completed,1200
102,1,2026-09-03,completed,800
103,2,2026-09-05,returned,1500
104,3,2026-09-10,completed,3000
105,3,2026-09-12,placed,450
106,1,2026-09-15,completed,2200
DUCKDBTV2
8. メタデータを Parquet で出力してクエリする
dbt v2 は、プロジェクトのメタデータを Parquet ファイルとして出力できます。dbt ではこれを Information Schema と呼んでいます。--generate-info-schema を付けて dbt build を実行します。
コマンド:
dbt build --generate-info-schema
出力結果:
   dbt-oss 2.0.5
   Loading profiles.yml
 Succeeded seed  main.raw_orders (table) [1 of 13 in 0.08s]
...
    Passed test  unique_customer_summary_customer_id [12 of 13 in 0.01s]

==================== Execution Summary =====================
Finished 'build' successfully for target 'dev' [1.3s]
Processed: 3 models | 8 tests | 2 seeds
Summary: 13 total | 13 success
CSV を戻したので、13件すべて成功しました。target/info_schema/v1/ に出力されたファイルを確認します。
コマンド:
ls target/info_schema/v1/ | wc -l
ls target/info_schema/v1/ | grep -E 'models|edges|run_results|views'
出力結果:
39

dbt.edges.parquet
dbt.models.parquet
dbt_rt.run_results.parquet
dbt.semantic_models.parquet
views.sql
Parquet ファイル38個と views.sql が出力されました。公式ドキュメントによると、parse で基本的なメタデータ、compile で列の型と列レベルのリネージ(--static-analysis strict が必要)、run や build で実行結果が追加されます。
dbt show --inline から DuckDB の read_parquet() で直接クエリできます。まず、モデルの一覧とマテリアライズの種類を取得します。
コマンド:
dbt show --inline "select name, materialized, schema_name from read_parquet('target/info_schema/v1/dbt.models.parquet') order by name"
出力結果:
   dbt-oss 2.0.5
   Loading profiles.yml
Query show_sql_operation_inline
┌──────────────────┬──────────────┬─────────────┐
│ name             ┆ materialized ┆ schema_name │
╞══════════════════╪══════════════╪═════════════╡
│ customer_summary ┆ table        ┆ main        │
│ stg_customers    ┆ view         ┆ main        │
│ stg_orders       ┆ view         ┆ main        │
└──────────────────┴──────────────┴─────────────┘
3 rows.
 Succeeded model main.inline (ephemeral) [1 of 1 in 0.03s]

==================== Execution Summary =====================
Finished 'show' successfully for target 'dev' [583ms]
次に、dbt.edges.parquet からモデル間の依存関係を取得します。マクロやテストの行を除き、子がモデルの行に絞っています。
コマンド:
dbt show --inline "select parent_unique_id, child_unique_id from read_parquet('target/info_schema/v1/dbt.edges.parquet') where parent_unique_id not like 'macro.%' and child_unique_id like 'model.%' order by all"
出力結果:
   dbt-oss 2.0.5
   Loading profiles.yml
Query show_sql_operation_inline
┌────────────────────────────────────┬───────────────────────────────────────┐
│ parent_unique_id                   ┆ child_unique_id                       │
╞════════════════════════════════════╪═══════════════════════════════════════╡
│ model.duckdb_handson.stg_customers ┆ model.duckdb_handson.customer_summary │
│ model.duckdb_handson.stg_orders    ┆ model.duckdb_handson.customer_summary │
│ seed.duckdb_handson.raw_customers  ┆ model.duckdb_handson.stg_customers    │
│ seed.duckdb_handson.raw_orders     ┆ model.duckdb_handson.stg_orders       │
└────────────────────────────────────┴───────────────────────────────────────┘
4 rows.
 Succeeded model main.inline (ephemeral) [1 of 1 in 0.03s]

==================== Execution Summary =====================
Finished 'show' successfully for target 'dev' [609ms]
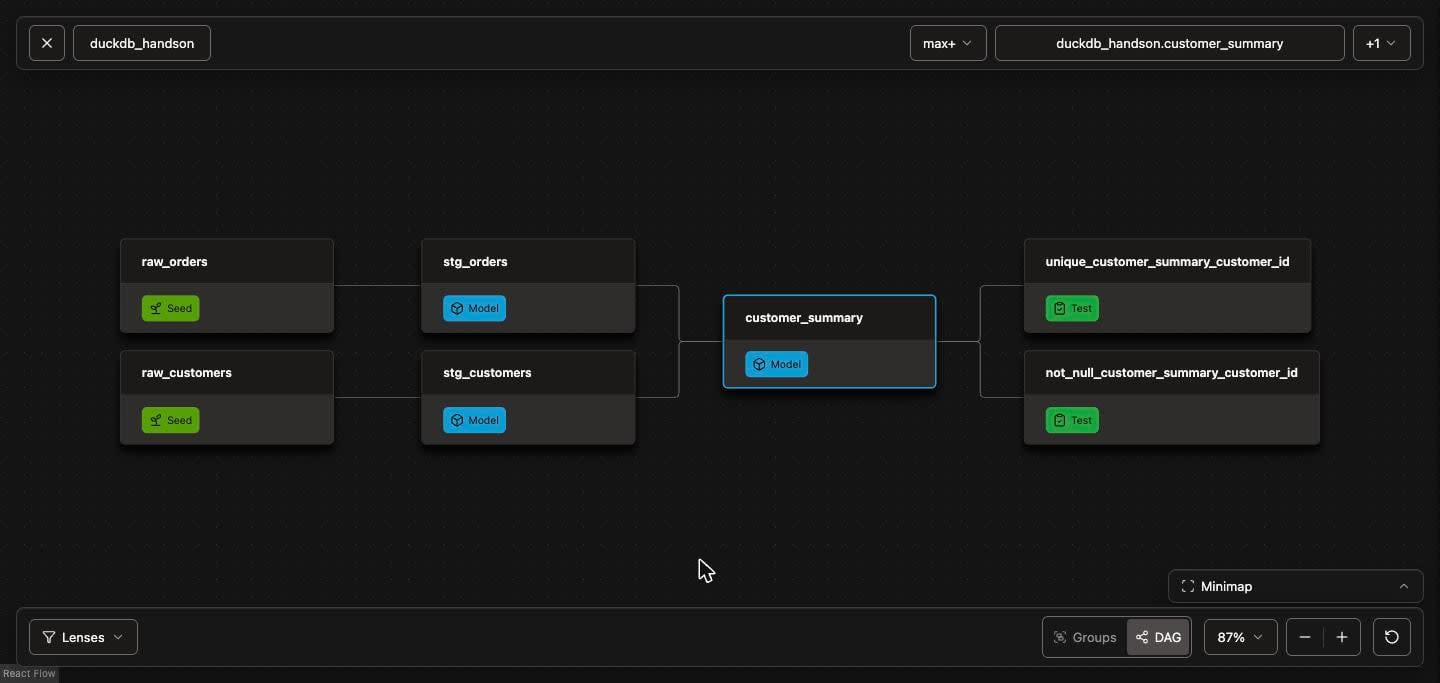
「全体像」の図と同じ依存関係が取得できました。
最後に、dbt_rt.run_results.parquet から、失敗またはスキップしたノードを取得します。
コマンド:
dbt show --inline "select split_part(unique_id, '.', 3) as node_name, status, failures from read_parquet('target/info_schema/v1/dbt_rt.run_results.parquet') where status in ('fail', 'skipped') order by node_name"
出力結果:
   dbt-oss 2.0.5
   Loading profiles.yml
Query show_sql_operation_inline
┌───────────────────────────────────────────────────────────────────────┬─────────┬──────────┐
│ node_name                                                             ┆ status  ┆ failures │
╞═══════════════════════════════════════════════════════════════════════╪═════════╪══════════╡
│ accepted_values_stg_orders_status__placed__completed__returned        ┆ fail    ┆ 1        │
│ customer_summary                                                      ┆ skipped ┆          │
│ not_null_customer_summary_customer_id                                 ┆ skipped ┆          │
│ relationships_stg_orders_customer_id__customer_id__ref_stg_customers_ ┆ fail    ┆ 1        │
│ unique_customer_summary_customer_id                                   ┆ skipped ┆          │
└───────────────────────────────────────────────────────────────────────┴─────────┴──────────┘
5 rows.
 Succeeded model main.inline (ephemeral) [1 of 1 in 0.03s]

==================== Execution Summary =====================
Finished 'show' successfully for target 'dev' [588ms]
直前の dbt build はすべて成功していますが、手順7で失敗した回の結果が含まれています。このファイルの件数を数えたところ39行(13ノード × 3回分の dbt build)あり、--generate-info-schema を付けずに実行した手順5と手順7の結果も入っていました。
なお、公式ドキュメントで案内されている {{ info_schema() }} マクロでも同じ結果を取得できました。こちらはプロファイルを読み込まずに実行されます。
コマンド:
dbt show --inline "select name, materialized, schema_name from {{ info_schema('models') }} order by name"
出力結果:
   dbt-oss 2.0.5
Query info_schema_inline
┌──────────────────┬──────────────┬─────────────┐
│ name             ┆ materialized ┆ schema_name │
╞══════════════════╪══════════════╪═════════════╡
│ customer_summary ┆ table        ┆ main        │
│ stg_customers    ┆ view         ┆ main        │
│ stg_orders       ┆ view         ┆ main        │
└──────────────────┴──────────────┴─────────────┘
3 rows.

==================== Execution Summary =====================
Finished 'show' successfully [501ms]
9. リネージを作成してダウンロードし、ローカルPCで確認する
dbt docs generate は、dbt プロジェクトのモデルの説明、列の情報、モデル間の依存関係(リネージ)をブラウザで確認できる Web ページ(HTML などのファイル一式)を作成するコマンドです。dbt v2 では、Web ページのファイルと一緒に Parquet 形式のメタデータを出力し、ブラウザ上の DuckDB-Wasm でその Parquet を読み込んで表示します。表示のためのサーバープログラムは不要で、公式ドキュメントでは S3 や GitHub Pages などにファイルを置いて公開できると説明されています。
このハンズオンでは、手順8で SQL を使って確認したモデル間の依存関係を、図として確認するために実行します。--output-dir で出力先のディレクトリ(docs_site)を指定し、ローカル PC にダウンロードできるよう zip にまとめます。
コマンド:
dbt docs generate --output-dir docs_site
zip -rq docs_site.zip docs_site
ls -lh docs_site.zip
出力結果:
Running compile; pass `--no-compile` to export the existing index instead.
   dbt-oss 2.0.5
 Succeeded seed  main.raw_orders (table) [11 of 13 in 0.00s]
...
 Generated docs_site (39 artifacts copied) — no column lineage; rerun with `--static-analysis strict` to include it
Host the contents of docs_site on any static file server.

==================== Execution Summary =====================
Finished 'docs' successfully [2.2s]
-rw-r--r--. 1 cloudshell-user cloudshell-user 2.6M Sep 25 08:12 docs_site.zip
出力の主な行の意味は次のとおりです。
| 出力 | 意味 |
|---|---|
Running compile; pass --no-compile ... |
Web ページを作る前に compile を実行した(--no-compile を付けると、既存の結果から作成する) |
Succeeded seed ... などの行 |
compile の対象になったノード |
Generated docs_site (39 artifacts copied) |
docs_site ディレクトリに Web ページを出力し、Parquet ファイルなど39個のファイルをコピーした |
no column lineage; ... |
列レベルのリネージは含まれていない |
Host the contents of docs_site on any static file server. |
docs_site の中身を Web サーバーから配信するよう案内している |
-rw-r--r--. ... docs_site.zip |
zip のサイズは 2.6MB |
docs_site には、index.html、JavaScript などが入った assets/、Parquet ファイルが入った info_schema/v1/ が含まれています。
メッセージのとおり、列レベルのリネージは含まれていません。メッセージでは --static-analysis strict を付けた再実行が案内されていますが、dbt-oss では静的解析が実行されないため、列レベルのリネージは生成されません(「考察」を参照)。また、docs_site の中身を Web サーバーから配信するよう案内されています。
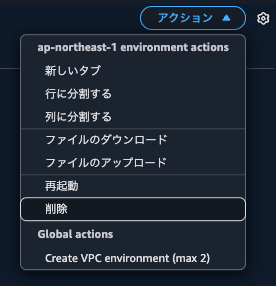
CloudShell 画面右上の「アクション」から「ファイルのダウンロード」を選び、次のパスを入力して「ダウンロード」を押します。
/home/cloudshell-user/duckdb_handson/docs_site.zip
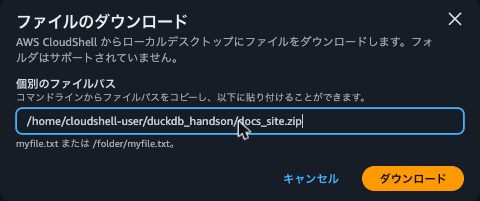
ダイアログに「フォルダはサポートされていません」と表示されるとおり、フォルダのままではダウンロードできないため、zip にまとめています。
ローカル PC のターミナルで zip を展開し、Python の HTTP サーバーで配信します。以下は macOS で確認した手順です。
コマンド:
cd ~/Downloads
unzip -q docs_site.zip
python3 -m http.server 8000 --directory docs_site
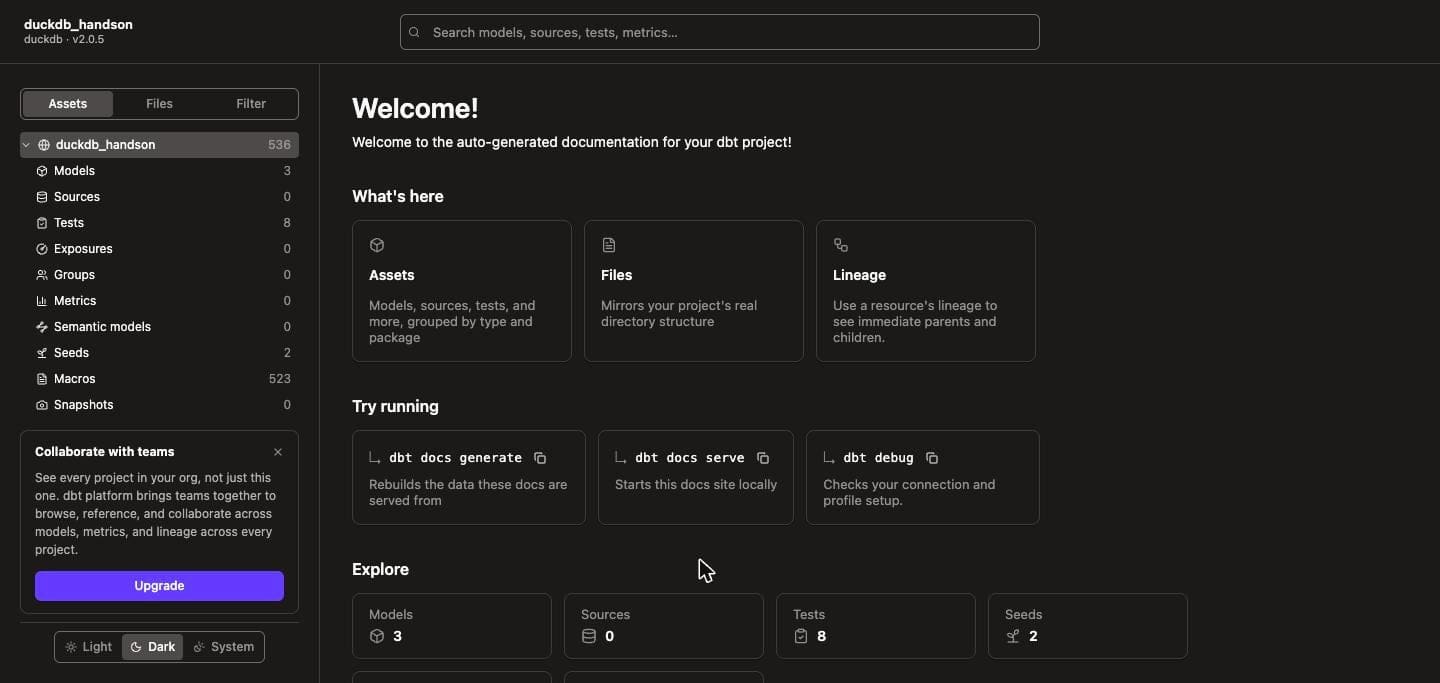
ブラウザで http://localhost:8000/ を開くと、dbt docs v2 のトップ画面が表示されます。モデル3件、テスト8件、seed 2件が表示されています。
左のメニューの「Models」から customer_summary を選び、「Lineage」の「Expand」を押します。上流の深さ(初期値は 1+)を max+ に変えると、seed から marts、テストまでのリネージが表示されました。
この Web ページは info_schema/v1/ の Parquet ファイルを読み込んで表示しています。index.html には DuckDB-Wasm の配信元として jsDelivr(duckdb_cdn_base)が指定されており、dbt docs generate --help にも Wasm は Web ページのファイルに含まれないと説明されています。そのため、ローカル PC にもインターネット接続が必要です。確認が終わったら、ターミナルで Ctrl+C を押して HTTP サーバーを停止してください。
10. ClaudShell の環境をクリーンアップ
CloudShell 画面右上の「アクション」から「削除」を選び、「ap-noetheast-1 CloudShell 環境を削除」ダイアログに「delete」を入力して「削除」を押します。
考察
CloudShell の Python は 3.11 以上になっていた
dbt-oss 2.0.5 は Python 3.11 以上が必要です(PyPI の Requires-Python: >=3.11)。AWS のドキュメントの Amazon Linux 2023 移行ページには CloudShell の Python は 3.9 と記載されているため事前に対策を検討していましたが、検証日時点の CloudShell の python3 は 3.13.15 で、そのまま venv を作成できました。
python3 --version が 3.11 未満だった場合は、Amazon Linux 2023 のパッケージを dnf でインストールし、そのバージョンで venv を作成します。この手順は、Amazon Linux 2023 のコンテナ(root ユーザー)で dbt-oss 2.0.5 のインストールまで動作を確認しています。
コマンド:
sudo dnf install -y python3.11 python3.11-pip
python3.11 -m venv ~/dbt-venv
source ~/dbt-venv/bin/activate
pip install dbt-oss==2.0.5
dbt --version
ただし、dnf でインストールしたパッケージは $HOME の外に入るため、シェルセッションの終了後に消えます。その場合、~/dbt-venv が残っていても使えないので、dnf のインストールからやり直してください。
ホームディレクトリの容量
ハンズオン完了時点で、ホームディレクトリの使用量は 974MB 中 466MB(52%)でした。
| パス | サイズ | 内容 |
|---|---|---|
~/dbt-venv |
224MB | dbt-oss をインストールした venv |
~/.cache/com.getdbt |
156MB | DuckDB の ADBC ドライバ(2ファイル) |
~/.cache/pip |
68MB | pip がビルドした dbt-oss の wheel のキャッシュ |
~/duckdb_handson |
19MB | プロジェクト(target/、docs_site/、zip を含む) |
~/.cache/com.getdbt/adbc/ には、libadbc_driver_duckdb-1.5.4.so(約70MB、08:09)に加えて、libadbc_driver_duckdb_extended-0.21.0.dev+dbt0.0.31.so(約92MB、08:12)が保存されていました。CloudShell の永続ストレージは 1GB なので、他の用途で使う場合は残り容量に注意してください。
CloudShell のファイルのダウンロードの制約
複数のファイルを zip にまとめてダウンロードする方法は、AWS のドキュメントでも案内されています。なお、VPC 環境の CloudShell と、コンソールツールバーから起動した CloudShell では、ファイルのダウンロードは利用できません。その場合は、手順9のリネージ確認を別の方法で行う必要があります。
同梱の DuckDB ドライバは拡張機能をロードできない
公式ドキュメントによると、dbt v2 に同梱される DuckDB ドライバは、httpfs、parquet、spatial などの DuckDB 拡張機能のロードに対応していません。拡張機能を使う場合は、dbc で DuckDB ドライバをインストールします。dbt v2 はシステムにインストールされたドライバを先に探し、見つからなければ同梱ドライバを使います。
今回の read_parquet() によるローカルファイルの読み込みは、同梱ドライバのままで動作しました。一方、CloudShell から S3 上のファイルを DuckDB で直接読む場合は httpfs 拡張が必要になるため、追加の手順が必要になると考えられます。
dbt-oss で確認できるのはモデル単位のリネージ
dbt-oss には静的解析エンジンが含まれていないため、dbt docs generate で作成した Web ページには列レベルのリネージが含まれませんでした。事前に Amazon Linux 2023 のコンテナで dbt compile --generate-info-schema --static-analysis strict を実行した際も、「dbt OSS には静的解析エンジンが含まれていない」という警告が出て、静的解析は実行されませんでした。DuckDB のブログで紹介されている列レベルのリネージ(dbt.column_lineage)を試したい場合は、dbt-oss ではなく dbt(pip install dbt)を使います。
最後に
dbt v2 の dbt-oss を AWS CloudShell にインストールし、DuckDB アダプタを追加インストールせずに、seed、モデル、テスト、Parquet 形式のメタデータ、リネージまでを確認しました。必要な作業は venv の作成と pip install dbt-oss だけで、profiles.yml の書き方も v1 の dbt-duckdb と同じでした。今回、CloudShell 上で Python の確認から zip の作成までコマンドを実行した時間は約10分でした。ファイルの内容を読みながら進める場合の目安は15分程度です。
Parquet 形式のメタデータは、dbt show --inline と read_parquet() で SQL を書いて問い合わせられます。モデルのマテリアライズの種類やテストの失敗履歴を SQL で確認できました。DuckDB のブログでは、CI のチェックや監査スクリプトでの活用が挙げられています。
CloudShell を使えば、ローカル PC に dbt をインストールしなくても dbt v2 を試せます(リネージの表示にはローカルの Python を使いました)。dbt v2 と DuckDB の組み合わせを試す際の参考にしてください。
参考リンク