AWS DevOps Agent に作業ミスが原因の障害を調べさせたら、「なぜ間違えたか」まで仮説を出してくれた

こんにちは。運用イノベーション部の小形です。
AWS DevOps Agent に、作業ミスが原因の障害を調べさせてみました。
AWS DevOps Agent は、アラームを起点に、メトリクスやログ、CloudTrail を読んで、障害の原因を調べてくれるエージェントです。
ディスクが逼迫して、作業者が「消してよさそう」と判断したファイルを削除します。その結果、別のアラームが鳴る二次障害が起きる、というシナリオを想定して調査しました。
ファイルの名前は、わざと一時ファイルに見える tmp_index にしてみました。
結果、「いつ、誰が、何をしたか」の作業の事実だけでなく、「tmp_index という名前から、消してよいファイルと判断した可能性」まで、指摘してきました。
結論
- 作業ミスの時刻、操作した人、実行したコマンドまで特定しました
- さらに寄与要因として、「
tmp_indexという名前から、削除してよい一時ファイルと判断された可能性」を、仮説として挙げました - 再発防止の提案は「作業者が気をつける」ではなく、名前の変更やファイルの保護といった仕組みの変更でした
検証の内容
今回作った検証の構成はこちらです。
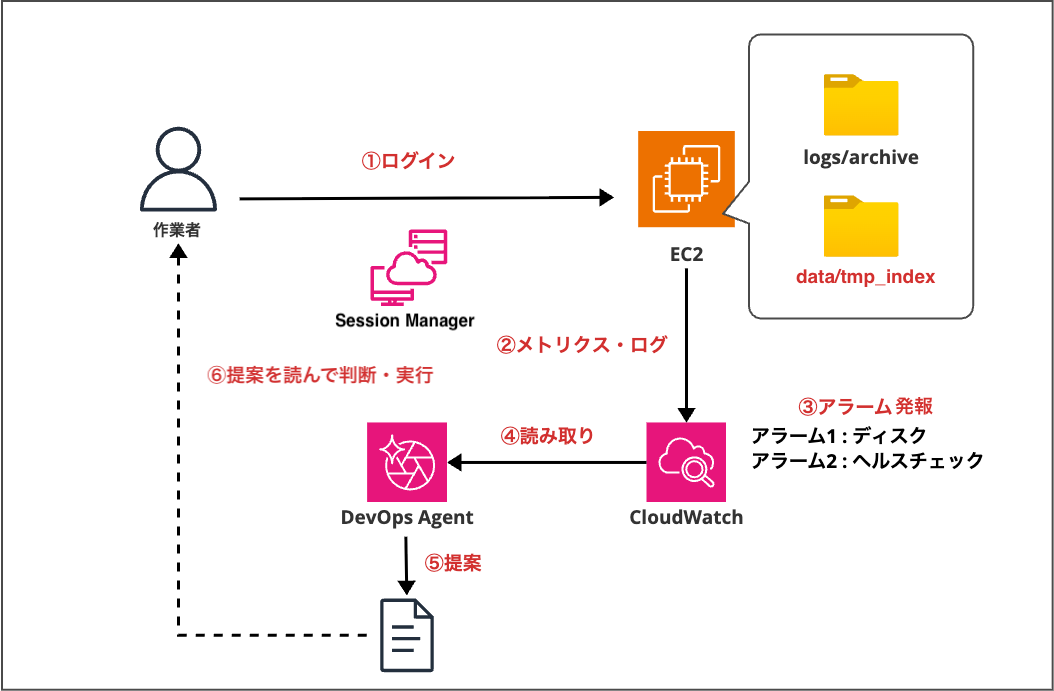
- EC2(Amazon Linux 2023)に、データ用のボリューム(2 GiB)を
/srv/appとして付けました /srv/app/logs/archive/には、ログが1分ごとに溜まっていきます。ログのローテーションに見せた、ダミーの仕掛けです。ここは消してよいファイルです/srv/app/data/tmp_index/には、アプリが使う索引ファイル(約 600MB)を置きました。ここを消すと、アプリのヘルスチェックが失敗します。名前の頭にtmpを付けて、うっかり消してしまいそうなファイルに見せています- アラームは2つです。ディスクの使用率(80% 以上)と、アプリのヘルスチェックの失敗です
- 作業者は Session Manager で EC2 に入ります。セッションログ(打ったコマンドと出力)は、CloudWatch Logs に送ります
- DevOps Agent(東京リージョン)は、読み取り専用の権限で、CloudWatch と CloudTrail を調べます
検証の流れ
今回の検証の流れは下記です。番号は構成図に記載の番号に対応しています。
- ディスク逼迫を解消するため、作業者が EC2 にログインし、空き容量を作るために、削除してはいけない
data/tmp_indexを削除する - CloudWatchがメトリクスを収集
- アプリのヘルスチェックアラーム発報
- DevOps Agentで障害調査
- 障害調査の結果、緩和策を提案
- 人間が提案を読んで判断と実行
前提として、次の3つを決めました。
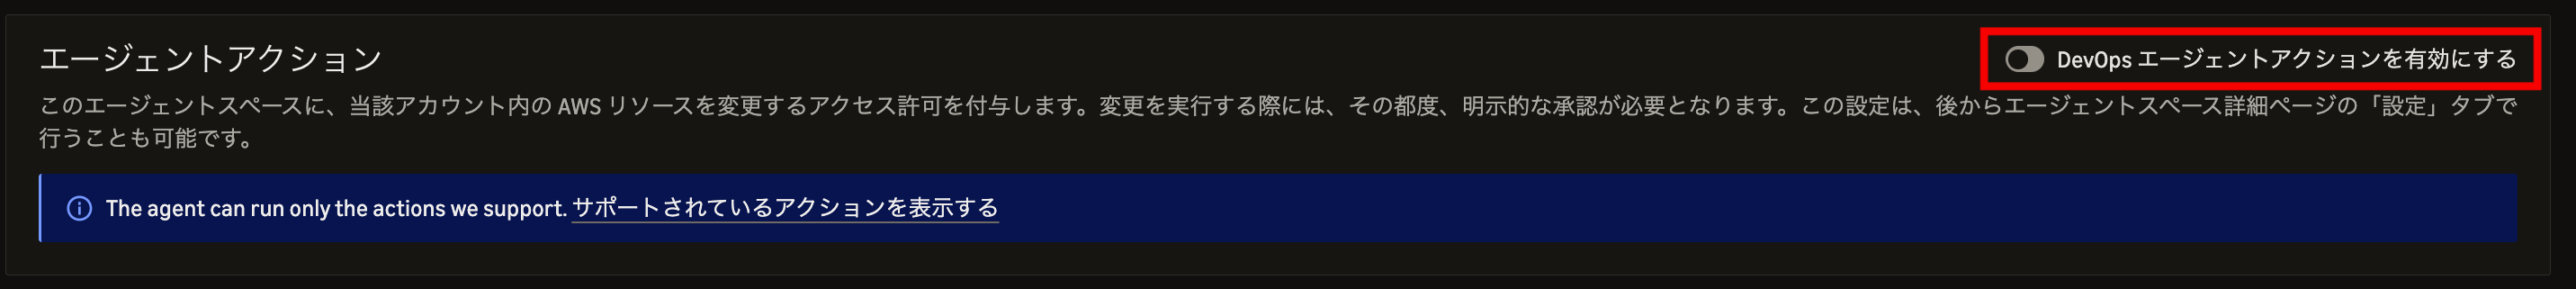
- DevOps Agent が作業を実行する機能(エージェントアクション)はオフにしました。DevOps Agent は提案までで、作業と責任は人が持ちます
- ユーザーデータに検証の設計が書いてあるため、EC2 のユーザーデータは、IAM で読めないようにしました
- 調査は、調査の詳細にアラーム名を書いて手動で依頼しました
作業ミスを再現する
ディスクの使用率が 80% を超えたあと、作業者として、Session Manager で次のコマンドを打ちました。「容量を空けるためにサイズの大きいものを探したら、頭にtmp と付いていたので、消してよいと判断した」という想定です。
df -h /srv/app
sudo du -sh /srv/app/data/* /srv/app/logs/*
ls -lh /srv/app/data/tmp_index
sudo rm -rf /srv/app/data/tmp_index
df -h /srv/app
下の画像はduコマンドの実行結果です。
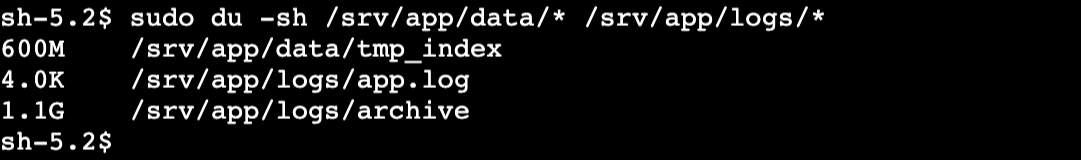
使用率は 88% から 57% に下がり、ディスクのアラームは OK に戻りました。しかし、数分後にアプリのヘルスチェックのアラームが発報してしまいました。
DevOps Agent が特定したこと
ヘルスチェックのアラームを起点に、調査を開始しました。調査は5分程度で完了しました。
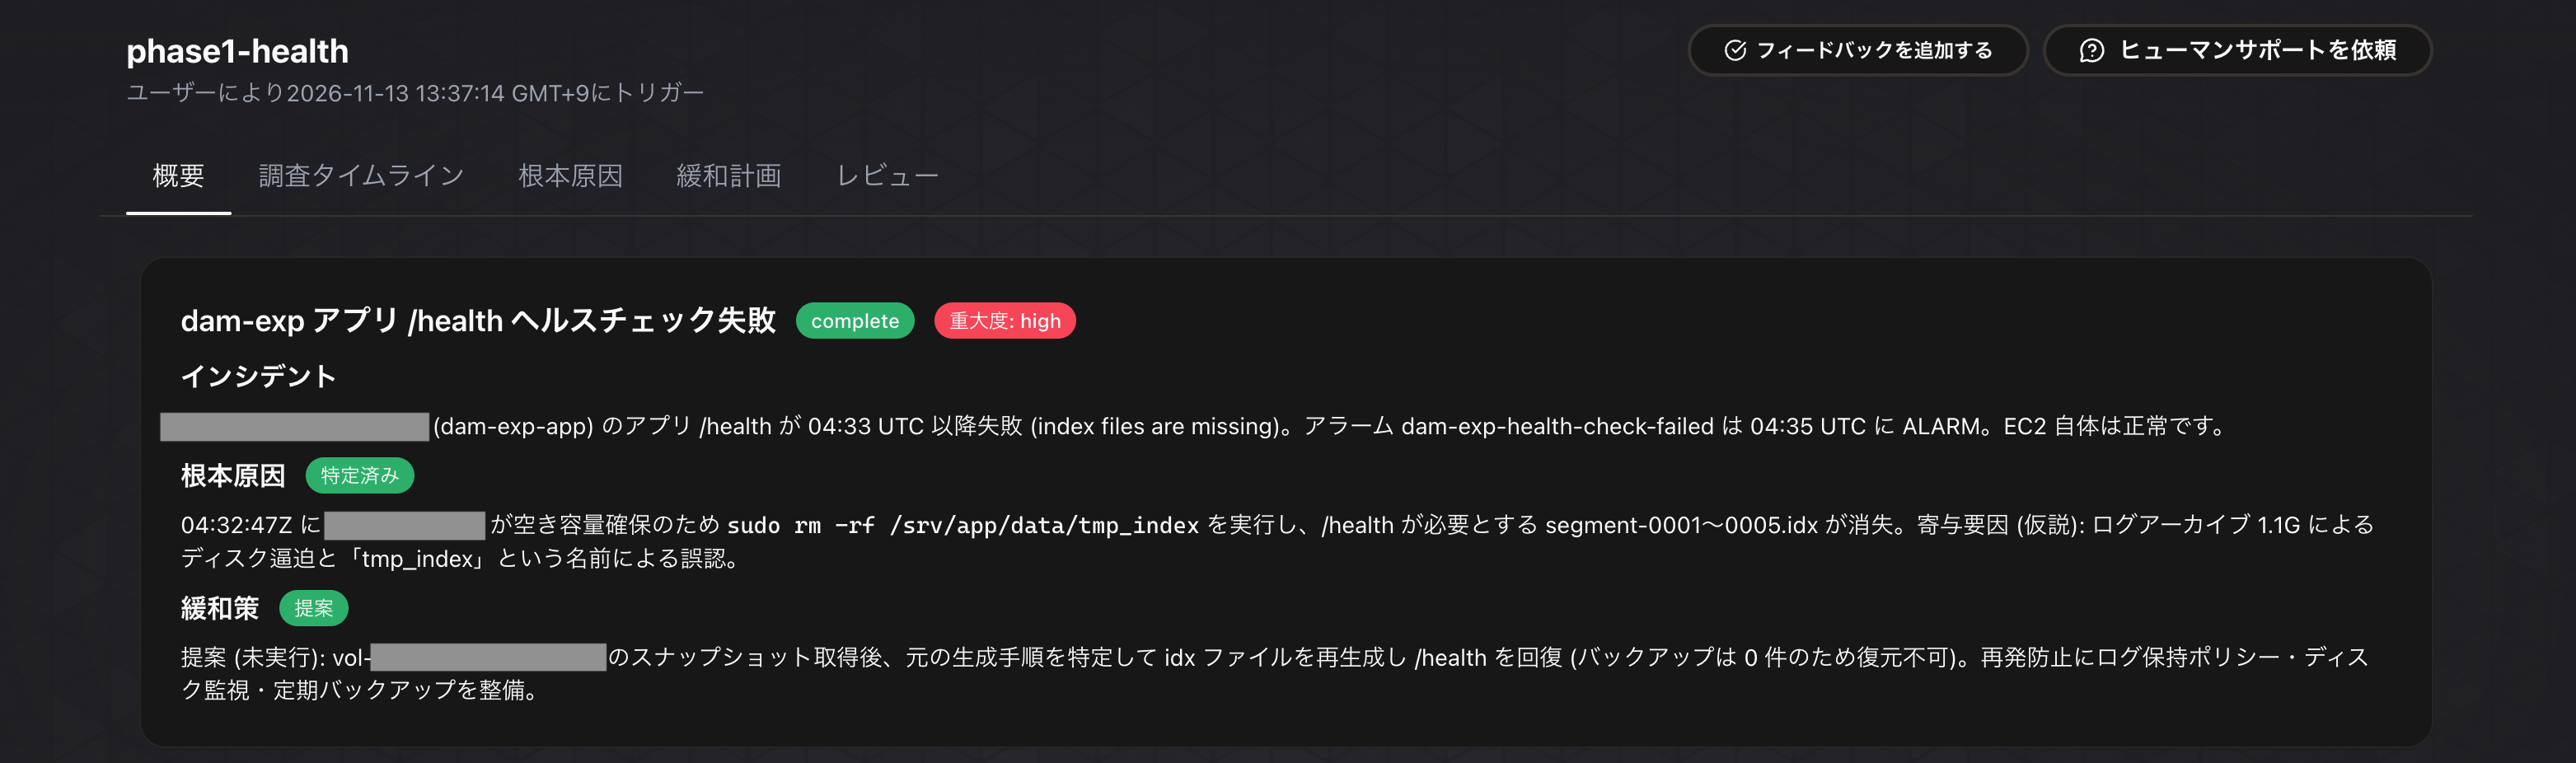
いつ、誰が、何をしたか
根本原因として、作業者が空き容量を確保するために sudo rm -rf /srv/app/data/tmp_index を実行し、/health が必要とする索引ファイル(segment-0001〜0005.idx)が削除されたことを特定しました。時刻と操作した人まで書かれていました。
根拠として挙げられていたのは、次の4つです。
- Session Manager のセッションログ(打ったコマンドと時刻)
- CloudTrail(セッションの開始)
- アプリのログ(
FileNotFoundErrorとhealth check failed) - ヘルスチェックのメトリクス
なぜ間違えたか
ここが一番面白かったところです。寄与要因として、次の2つを仮説(未確定)として挙げてくれました。
- ログのアーカイブ(1.1G)によるディスク逼迫が、手動で削除する動機になった
- 「
tmp_index」という名前から、削除してよい一時ファイルと判断された可能性
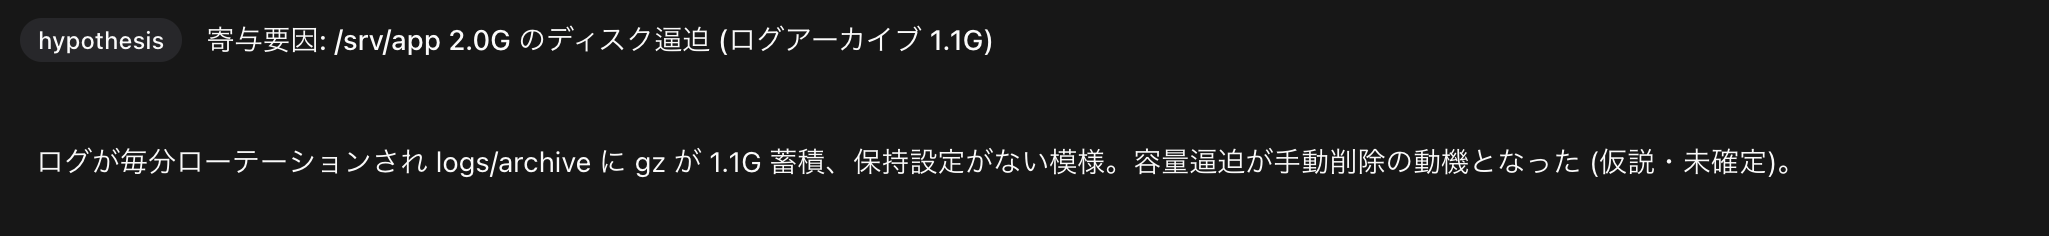
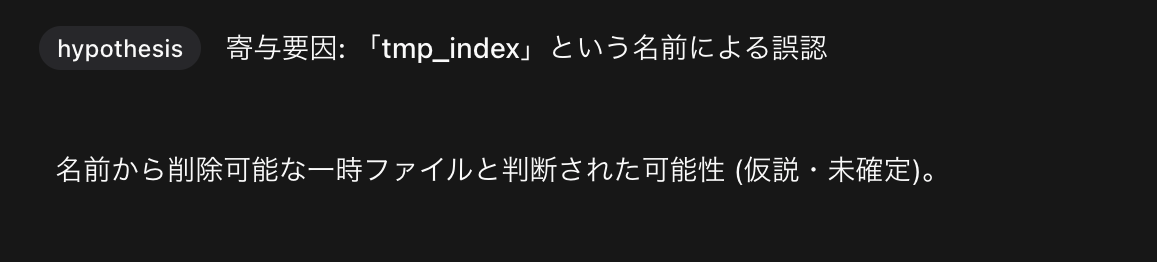
先ほど書いたとおり、ユーザーデータは読めない状態にしています。「tmp_index が実は大事なファイルで、名前はわざと紛らわしくした」という設計は、DevOps Agent には伝わっていません。それでも、仕掛けた意図と同じ仮説を出してくれました。
再発防止の提案
提案された再発防止は、次の5つでした。
- 索引ファイルを、アプリの起動時に自動で作り直す(消しても、再起動で戻る)
tmp_indexをindexなどに改名し、削除禁止の README を置く。必要に応じてchattr +iで保護する- ログのアーカイブに保持期間を設ける
- ディスク使用率の通知と、バックアップを整える
- sudo 削除前の runbook 確認を必須化するか、削除の対象を
logs/archiveに限った、クリーンアップ用の SSM Automation を用意する
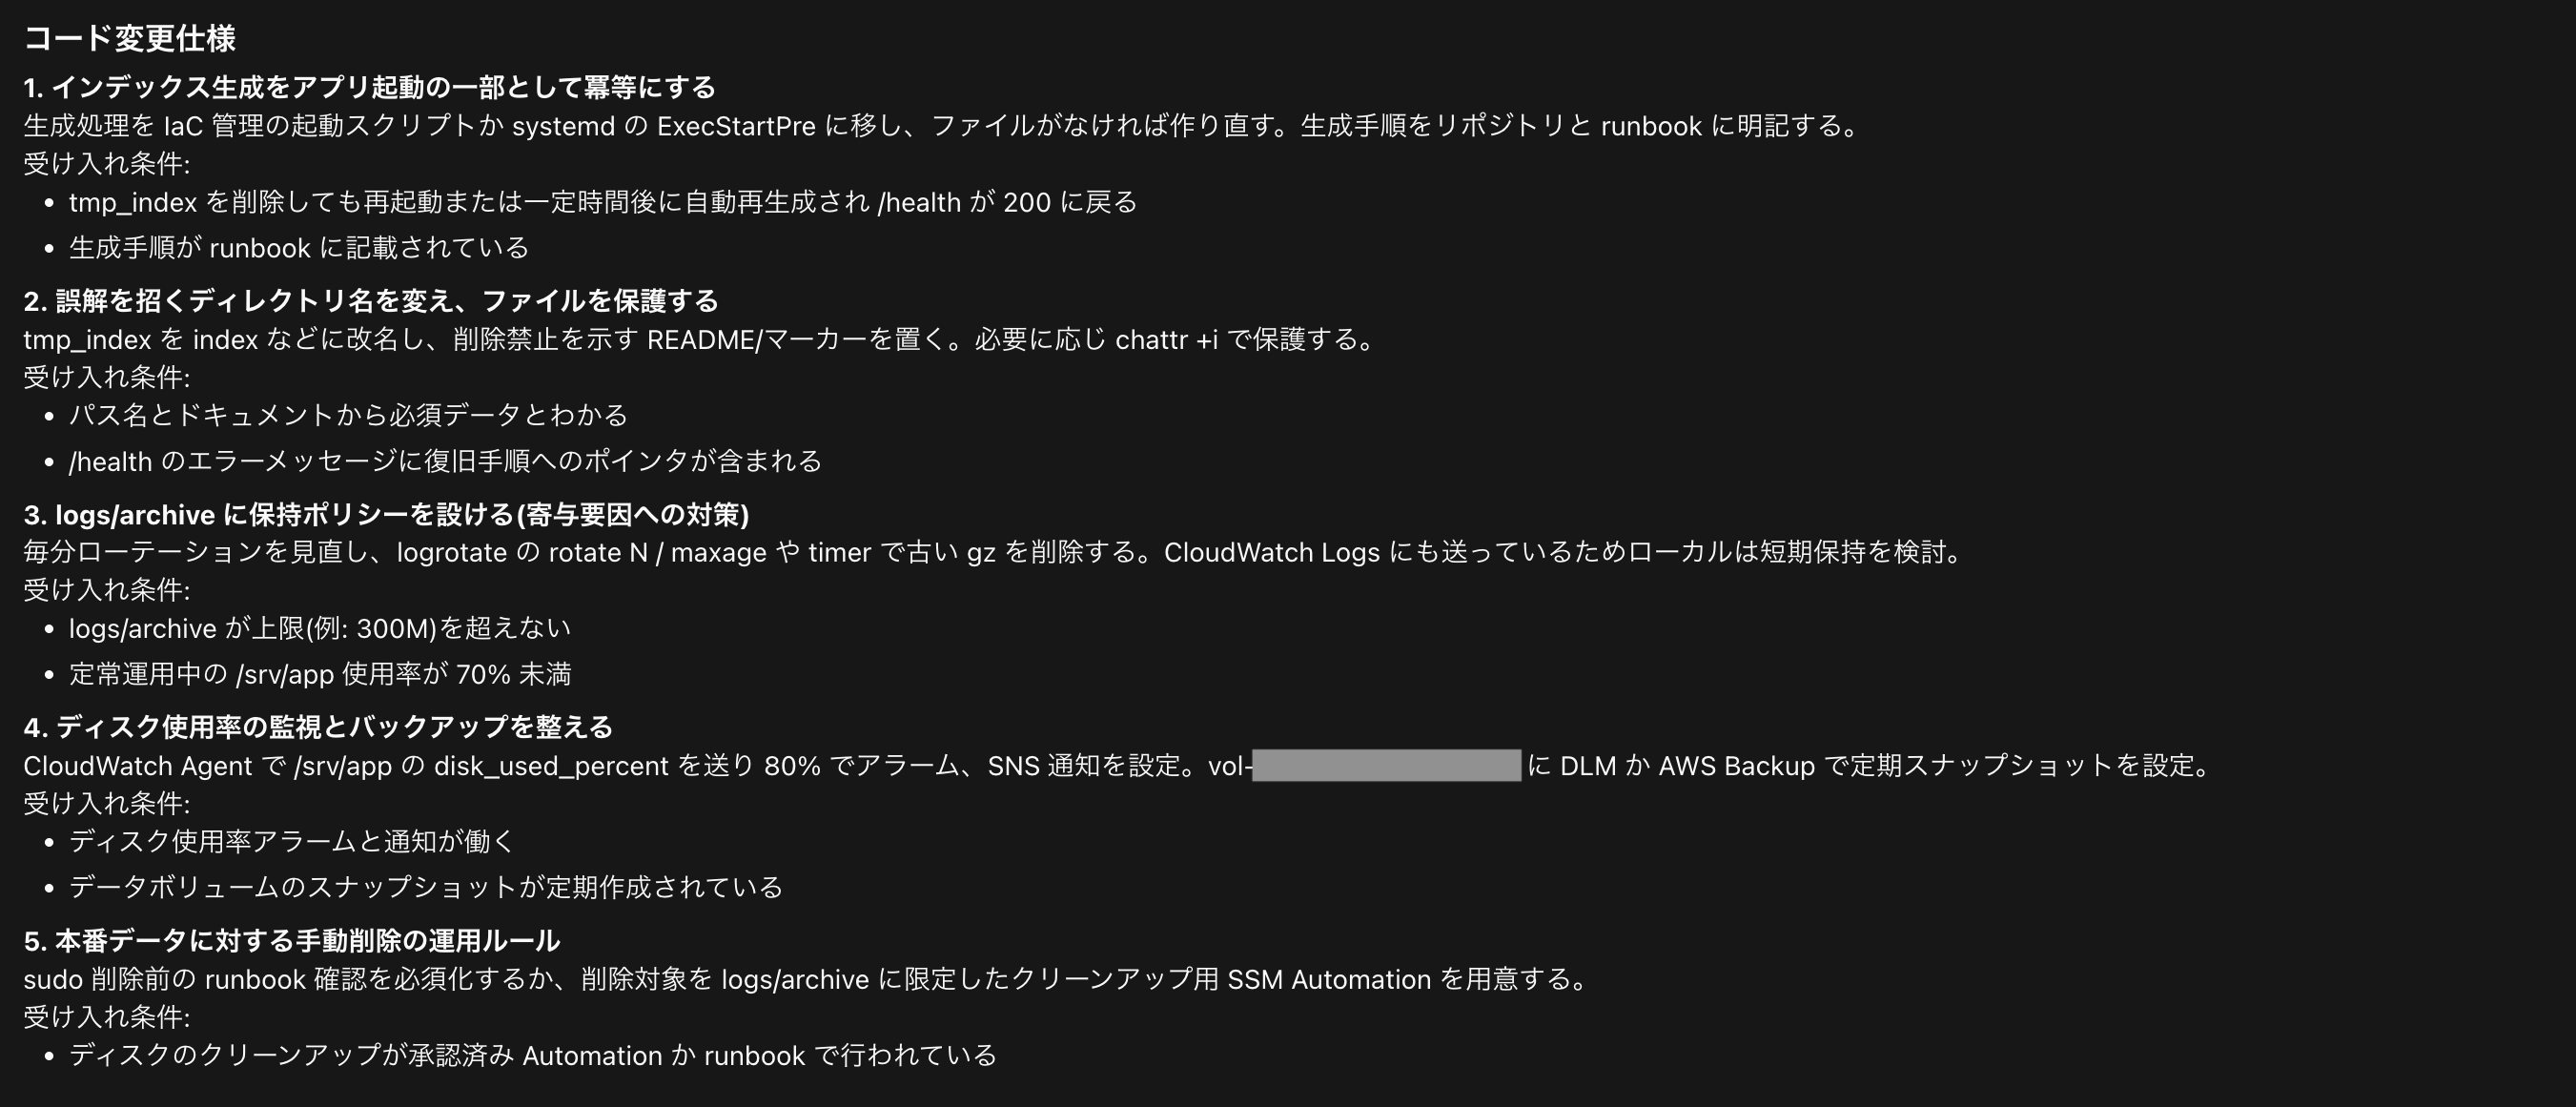
「気をつける」だけで終わる提案はなく、名前の変更やファイルの保護といった仕組みの変更が中心でした。
名前だけで、なぜそこまで言えたのか
名前だけで決めたわけではなさそうです。証拠を見ると、次の状況がそろっていました。
- ディスクが逼迫している最中だった
- 削除の直前に、
dfでディスクが 88% であることを確認していた - 消したフォルダの名前に
tmpが付いていた - 削除の直後から、アプリが
FileNotFoundErrorを出し始めた
これらがセッションログとアプリのログに、時刻つきで残っていました。作業の経緯が順番に追えたので、「なぜそう判断したか」まで推測できたのだと思います(私の仮説です)。
ポストモーテムでは「なぜ」の下書きとして使い、本人に確かめる使い方がよさそうです。人を責める材料ではなく、仕組みを直すきっかけとして使えそうです。
まとめ
- DevOps Agent は、作業ミスの時刻・人・コマンドに加えて、「なぜ間違えたか」まで仮説を立ててくれました
- 根拠は、セッションログとアプリのログに残った作業の順番でした
- 再発防止の提案は、仕組みの変更でした。ポストモーテムの下書きとして使えそうです