DGX Spark 上でリアルタイムに文字起こしや翻訳、話者分離する議事録用 Chrome 拡張機能を作る

はじめに
こんにちは、クラスメソッド製造ビジネステクノロジー部の嶋田です。
Google Meet や Zoom などの会議ツールには、デフォルトで文字起こしや話者分離、要約などの機能が備わっています。
ただし多くの場合はクラウド上で処理するので、録音内容をクラウドに出せない現場では使えません。
NVIDIA が公開しているオープンウェイトの音声モデルを DGX Spark で動かせば、同じことを手元の環境でできるのではないかと考え、会議の書記役をする Chrome 拡張機能を作ってみました。
会議のタブで録音を始めると、話者ごとの文字起こしと翻訳がサイドパネルに流れ、終わったら議事録を Backlog の Wiki に残せます。
実際に社内会議で検証したところ、文字起こしは話している最中から約 0.7 秒ごとに更新されました。
発話は話者が替わるか 0.6 秒の無音で確定し、確定した発話は約 1 秒後に LLM で清書した文に置き換わります。
Backlog の Wiki に残した議事録は、以前の記事で作った NemoHermes の Backlog の skill を使って、Slack のチームアシスタントから検索して引けるようにする仕組みも用意しました。
作ったもの
Chrome 拡張機能の名前は shoki としました。
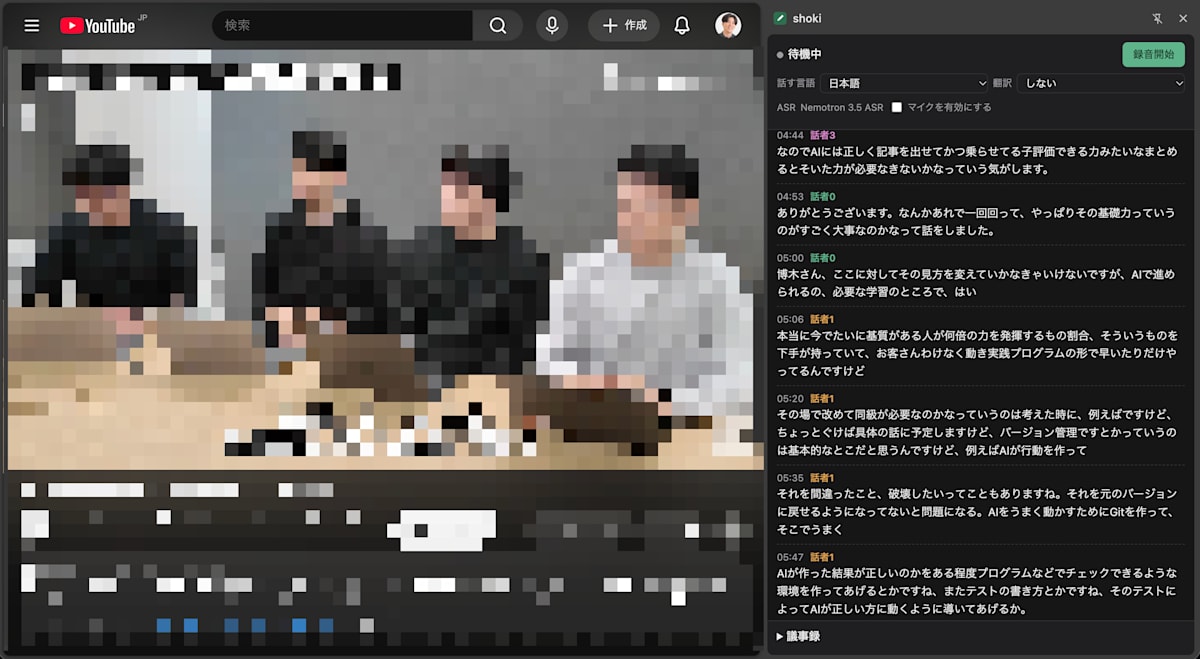
座談会形式の動画で shoki の録音をテストした様子。動画の進行に合わせてリアルタイムに文字起こしし、話者分離している
できることは次のとおりです。
- 会議のタブの音声とマイクを取り込み、話者つきでリアルタイムに文字起こしする
- 確定した発話を LLM で清書してから出す
- 話者に名前を付ける(議事録にもその名前を使う)
- 発話ごとに翻訳する(日本語から英語、英語から日本語)
- 録音を止めたあと、話者名つきの文字起こしから議事録の下書きを作る
- 議事録を Backlog の Wiki ページとして残す
ブラウザ側は Chrome 拡張機能で、認識はすべて DGX Spark の上のサーバーで行います。
全体の構成
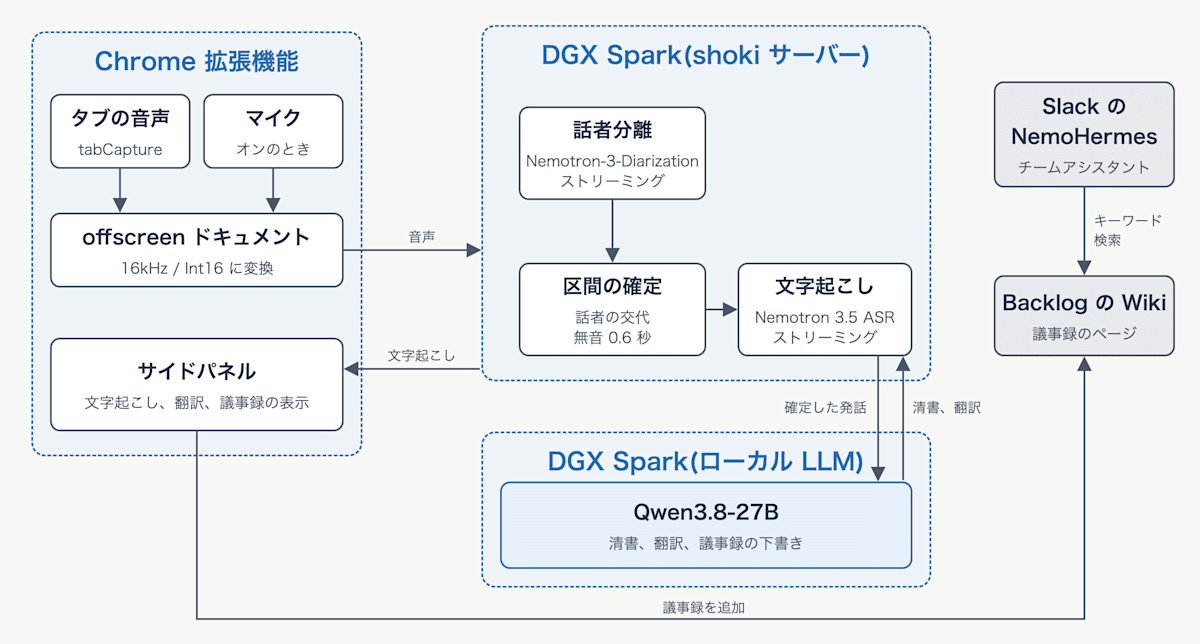
音声の認識は shoki の DGX Spark、清書と翻訳はローカル LLM の DGX Spark で行い、生成した議事録を必要に応じて Backlog の Wiki に追加する
使ったモデルは次のとおりです。
| 役割 | モデル | パラメータ数 |
|---|---|---|
| 話者分離 | nvidia/Nemotron-3-Diarization | 100M |
| 文字起こし(既定) | nvidia/nemotron-3.5-asr-streaming-0.6b をチームの用語でファインチューニングしたもの | 0.6B |
| 清書、翻訳、議事録 | RadixArk/Qwen3.8-27B-NVFP4(チームの別の DGX Spark の vLLM) | 27B |
shoki を動かしている DGX Spark には、Slack のチームアシスタントの判定用モデルなども常駐しています。
話者分離(ピーク 0.5GiB)と文字起こし(元のモデルでピーク 3GiB 弱)を足しても、メモリは十分に足りました。
サーバーは FastAPI で書き、モデルの推論は Transformers と NeMo で行っています。
サーバーは社内ネットワークに開き、拡張機能から直接つなぎます。
API と WebSocket には共有トークンの認証を付け、トークンなしでは接続を断るようにしました。
Chrome 拡張機能でタブの音声を取る
使い方は、会議のタブでツールバーの shoki のアイコンを押してサイドパネルを開き、「録音開始」を押すだけです。
同じボタンが「停止」に変わり、もう一度押すと録音が止まります。
録音の前に、サイドパネルの上部で話す言語、翻訳の向き、マイクを使うかを選べます。
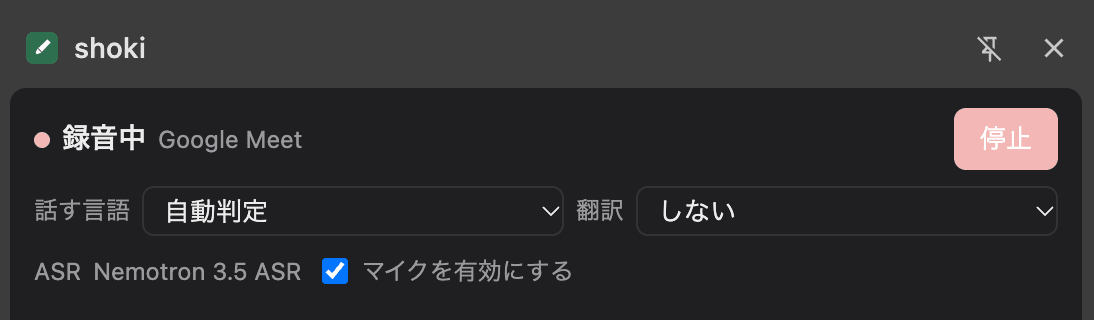
録音中は、録音しているタブの名前と「停止」ボタンが出る。ASR は使っているモデル名を表示するだけで、選ぶ欄はない
タブの音声は chrome.tabCapture で取ります。
getMediaStreamId でそのタブのストリーム ID をもらい、offscreen ドキュメントで getUserMedia に渡すと、タブの音声がストリームとして取れます。
const [tab] = await chrome.tabs.query({ active: true, currentWindow: true });
const streamId = await chrome.tabCapture.getMediaStreamId({ targetTabId: tab.id });
const tab = await navigator.mediaDevices.getUserMedia({
  audio: { mandatory: { chromeMediaSource: "tab", chromeMediaSourceId: streamId } },
});
録音と WebSocket は、サイドパネルではなく offscreen ドキュメントに持たせました。
サイドパネルを閉じても録音は続き、開き直すとそれまでの文字起こしを表示し直します。
話者分離と文字起こし
サーバーは、受け取った音声に話者分離をかけ、その結果で音声を区間に分けます。
話者が替わるか、誰も 0.6 秒話さないか、15 秒を超えたところで 1 つの区間として確定し、その区間の文字起こしを確定させます。
話者分離のストリーミング
Nemotron-3-Diarization は、音声のフレームごとに「最大 8 人のうち誰が話しているか」の確率を返すモデルです。
Transformers の実装にはストリーミングのモードがあり、shoki では録音全体で 1 本のストリームを持って、音声が届くたびに進めています。
self.diar_p.set_streaming_mode("very_low_latency")  # 遅延 0.64 秒
...
x = p(chunk, sampling_rate=SR, is_streaming=True, **kw).to(self.diar_m.device, dtype=self.diar_m.dtype)
out = self.diar_m(**x, speaker_cache=st.cache)
st.cache = out.speaker_cache  # 前のチャンクまでの話者の情報を引き継ぐ
st.logits.append(out.logits)
チャンクごとに speaker_cache を受け渡すと、それまでの話者の情報が引き継がれ、チャンクをまたいでも同じ人には同じ番号が付きます。
遅延は 0.32 秒、0.64 秒、1.04 秒から選べます。
区間の確定は話者分離の出力を待つので、この遅延はそのまま確定までの遅れに乗ります。
shoki では、中間の 0.64 秒にしました。
区間ごとの話者は、区間と最も長く重なった話者にします。
最初は、区間を確定するたびに録音の頭からかけ直していました。
21 分の録画全体で約 1 秒と軽いのですが、会議が長くなるほど 1 回の処理が伸びます。
ストリーミングにしてからは、確定の時点で話者分離はほぼ終わっているので、確定時の処理は数 ms になりました。
社内会議で検証してみると、発表者は最初から最後まで同じ番号のままで、参加者 3 名はそれぞれ別の番号で表示されました。
モデルカードで学習データの言語として名前が挙がっているのは英語、中国語、インドの諸言語などで、日本語は挙がっていませんが、実際に目視で確かめた範囲では、この会議の話者はほぼ正しく分かれていました。
文字起こしのストリーミング
Nemotron 3.5 ASR は cache-aware なストリーミング推論に対応しています。
shoki では、区間が始まったらストリームを作り、音声が届くたびに、溜まった分のチャンクだけをモデルに流して途中経過を出します。
区間が確定したら、残りを流し切って確定させます。
チャンクの長さは att_context_size の先読みの量で決まり、80ms、320ms、560ms、1,120ms から選べます。
短いほど途中経過が細かく出ますが、精度は下がります。
shoki では 560ms にしました。
(st.pred_out, texts, c0, c1, c2, st.hyp) = self.m.conformer_stream_step(
    processed_signal=x, processed_signal_length=length,
    cache_last_channel=st.cache[0], cache_last_time=st.cache[1], cache_last_channel_len=st.cache[2],
    keep_all_outputs=last, previous_hypotheses=st.hyp, previous_pred_out=st.pred_out,
    drop_extra_pre_encoded=0 if first else self.cfg.drop_extra_pre_encoded,
    return_transcription=True,
)
チャンクの切り方は、NeMo の推論スクリプト(speech_to_text_cache_aware_streaming_infer.py)と同じにしました。
ライブの音声に合わせて変えたのは、特徴量を区間の音声が届くたびに作り直す点だけです。
このモデルは特徴量を正規化しない設定なので、作り直しても、前に流した部分の値は変わりません。
社内の勉強会の録画の冒頭 3 分を実時間で流すと、途中経過は 258 回更新されました(約 0.7 秒ごと)。
区間の終わりから確定までの遅れは、中央値で 1.4 秒です。
話者分離の出力と 0.6 秒の無音を待ってから確定するためですが、話している間は途中経過が出ているので、画面ではあまり気になりません。
区間の切り方
「作ったもの」のスクショと同じ座談会の動画(4 人の掛け合い)で試すと、音量で切っていた頃は、1〜2 秒ごとに行が切れていました。
1 人がひと続きに話している場面でも、次のように細切れになります。
01:48 話者2  キャパなくなる。
01:48 話者2  ティカナとは
01:50 話者2  なるほどね。
01:51 話者2  なのである程度もやりたいことが見えてきます。
01:53 話者2  けば、それを支持して行動書くのは
01:55 話者2  マイアイ
01:57 話者2  でまあ、ちょっと修正したいとかもvlを通して
文の途中で切れるので、ASR は前後の文脈なしに短い音声を認識することになり、「マイアイ」のような意味の取れない行も出ていました。
原因は、音量のしきい値の決め方でした。
shoki は直近 30 秒の音量の下位 20% を雑音とみなし、その 2.5 倍をしきい値にしていました。
掛け合いの続く会話では下位 20% にも人の声が入るので、しきい値が話し声の中央値に近くなり、語尾の小さな声が無音と判定されていました。
しきい値を下げると、今度は部屋の雑音を声と判定し、区間の 6 割が上限の 15 秒で切れました。
音量だけで調整するのは無理があります。
そこで、話者分離の出力で区間を切ることにしました。
話者分離は、10ms ごとに誰が話しているかを返すので、声の有無と話者の交代が同時に分かります。
次のいずれかで区間を確定します。
- 話者が替わったとき。ただし 1.2 秒未満の他の人の発話は相づちとみなし、今の区間に含める
- 誰も 0.6 秒話さなかったとき
- 15 秒を超えたとき。同じ人の発話の中の短い間で切る
同じ動画の冒頭 10 分で比べると、次のようになりました。
| 切り方 | 区間の数 | 長さの中央値 | 2 秒未満の区間 |
|---|---|---|---|
| 音量(0.7 秒の無音) | 159 | 2.0 秒 | 50% |
| 話者分離(話者の交代と 0.6 秒の無音) | 69 | 8.7 秒 | 12% |
話者分離の判定では、この 10 分の中で誰も 0.6 秒以上話さなかった箇所は 6 回しかありませんでした。
掛け合いの会話の区切りは、ほとんどが話者の交代です。
区間と話者がそろうので、1 つの行に 2 人の発言が混ざることも少なくなりました。
今の切り方では、上の場面の後半(01:51 以降)は次の 1 行になります(清書したあとの文です)。
01:49 話者2 なのである程度もやりたいことが見えてきたら、それを指示してコードを書くのはAIになると。で、まあちょっと修正したいとかもAIを通して修正依頼すれば確実に直してくれるっていうところがありますね。
この切り方では、区間の終わりが決まるのは話者分離の出力を待ったあとです。
途中経過の文字起こしは届いた音声の最後まで読んでいるので、確定の時点で次の区間の頭まで読んでいることがあります。
最初はそのまま確定させてしまい、同じ文が前後の 2 行に出ました。
今は、区間の終わりより先まで読んでいたら、確定のときに区間の中だけを読み直しています。
雑音の区間の扱い
音量で区間を切っていた頃は、マイクの環境音やタイピングの音まで区間になっていました。
それを Whisper に渡したところ、誰も話していない区間が「はい」や「ありがとうございました」で埋まりました。
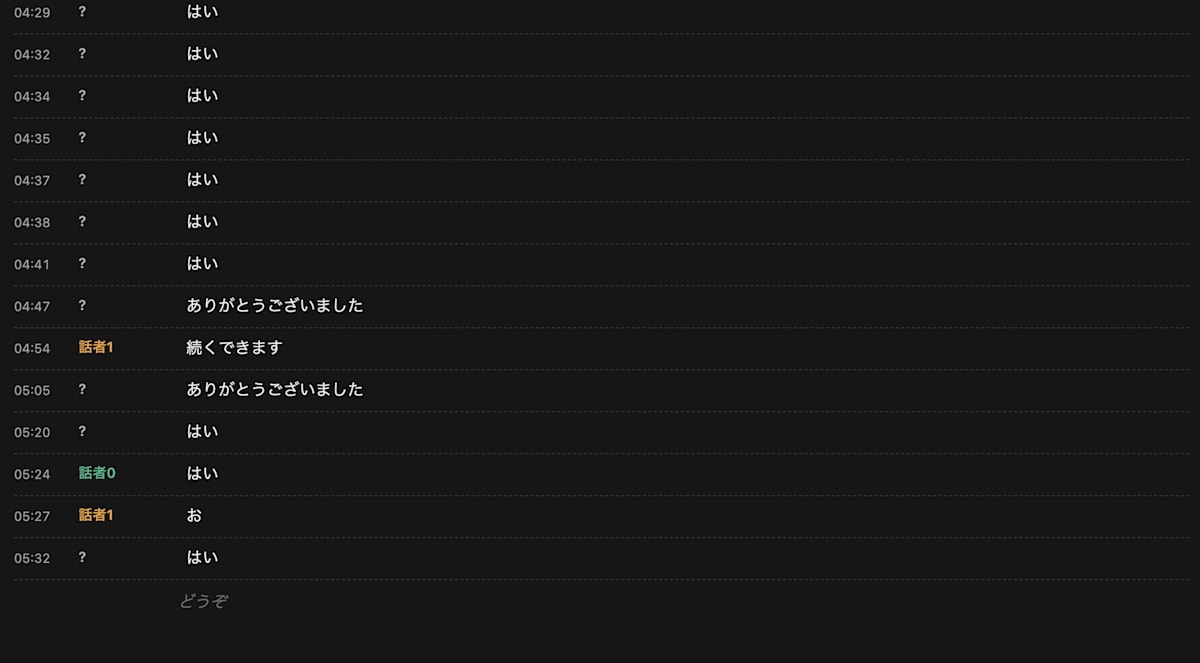
雑音の区間を Whisper に渡したときの画面。話者が「?」の行は、話者分離が発話を見つけなかった区間
この問題には、話者分離の結果を「声があるか」の判定に使って対処しました。
区間のうち、話者分離が誰かの発話とみなした時間が 3 割未満なら、その区間は確定させずに捨てます。
# 区間を確定させる処理の中
ok, segs, t_diar = await self.has_voice(c)  # 発話とみなされた時間の割合が 0.3 以上か
if not ok:
    continue  # 文字起こしを確定させずに捨てる
録画の前後に雑音だけの 20 秒をつないで流すと、雑音の区間からは何も出なくなり、会議の部分は変わらず取れました。
今は区間を話者分離で切っているので、雑音だけの区間はほとんどできません。
それでも Nemotron 3.5 は雑音に短い語を出すことがあるので、この判定は残しています。
日本語の ASR の比較
文字起こしに使う音声認識のモデル(ASR)のうち、元の Nemotron 3.5 ASR は、日本語の話し言葉で誤認識が目立ちました。
そこで、同じ部署の中村さんが L40S で比べていたモデルを中心に、5 つを DGX Spark で同じ条件で比べました。
CER(文字誤り率)は FLEURS 日本語の dev から 100 文で、処理時間は社内の勉強会の録画を話者分離で区切った 80 区間で測りました。
推論はすべて DGX Spark の上で、1 区間ずつまとめて行っています(ストリーミングではありません)。
Nemotron 3.5 は、ファインチューニングする前の元のモデルの値です。
| モデル | CER | 1 区間の処理時間 | ピークメモリ |
|---|---|---|---|
| nvidia/nemotron-3.5-asr-streaming-0.6b | 14.3% | 142ms | 2.6GiB |
| openai/whisper-large-v3 | 3.8% | 930ms | 3.1GiB |
| openai/whisper-large-v3-turbo | 3.9% | 295ms | 1.6GiB |
| kotoba-tech/kotoba-whisper-v2.2 | 5.7% | 205ms | 1.5GiB |
| nvidia/parakeet-tdt_ctc-0.6b-ja | 5.3% | 64ms | 4.8GiB |
精度は Whisper large-v3 と turbo がほぼ並び、turbo は 3 倍速く動きました。
Parakeet は最も速く、精度も Whisper に近い値でした。
Nemotron 3.5 は CER が 14.3% で、ほかのモデルの 2.5〜3.8 倍でした。
誤り方にも違いがあります。
Nemotron 3.5 は「科学者」を「化学者」、「羽毛」を「武門」とするような同音異義語の誤りが多く、英字の略語は小文字になりがちでした。
精度だけなら Whisper large-v3-turbo が上ですが、shoki では Nemotron 3.5 ASR だけを使うことにしました。
ストリーミングで話している最中から文字を出せるのは、比べた中で Nemotron 3.5 だけだからです。
日本語の精度は、ファインチューニングと、次に書く LLM による清書で補っています。
使っている Nemotron 3.5 は、チームでよく使う用語(製品名やサービス名)を私の声で読み上げた 48 文でファインチューニングした版です。
LLM による清書
話している間は、ASR の途中経過が斜体で流れます。
区間が確定すると、その発話を灰色で表示して「清書中」と付け、その発話と直前の 6 発話を Qwen3.8-27B(NVFP4)に渡して清書させます。
清書が返ってきたら、灰色の文を清書した文で置き換えます。
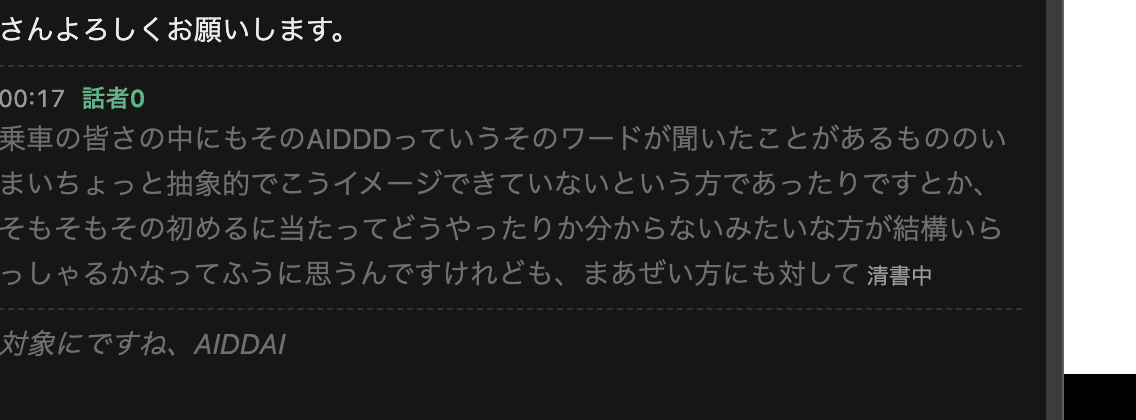
灰色の行が清書を待っている発話。最後の斜体の行は、まだ確定していない途中経過
Qwen3.8-27B は、チームの別の DGX Spark で vLLM が配信しているモデルで、クラウドの API は使っていません。
確定から清書が出るまでは、中央値で約 1.1〜1.3 秒でした。
清書前の文は、画面で会話文にマウスカーソルをホバーすることで見られます。
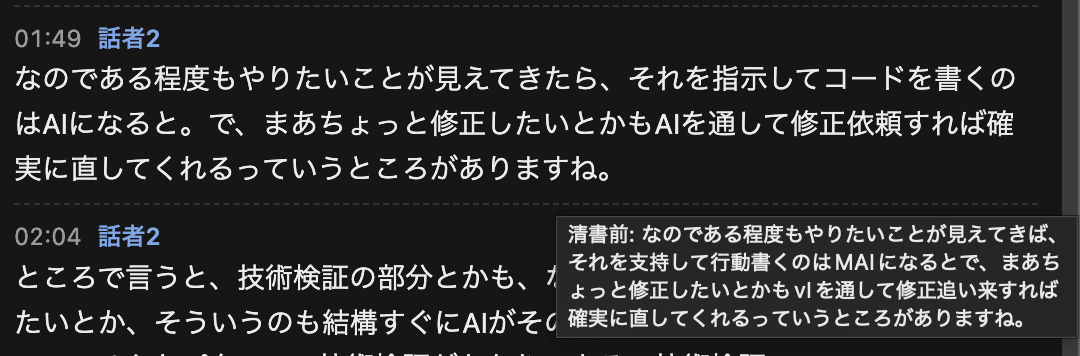
清書で「支持して行動書く」が「指示してコードを書く」に、「修正追い来」が「修正依頼」に直っている
清書のプロンプトでは、誤認識だけを直させ、言い換えや要約はさせないようにしました。
- 音声認識の誤り(同音異義語、聞き間違い)を、前後の発話から判断して直す
- 英字の製品名、サービス名、略語は英字のまま残す。カタカナに書き換えない
- 用語集にある語は、用語集の表記にそろえる(聞き間違えたと判断できるときだけ置き換える)
- 言い換え、要約、敬語の調整、内容の追加はしない。話し言葉の言い回しはそのまま残す
最初のプロンプトには、英字の扱いと用語集の 2 行がありませんでした。
正解のある文を shoki のサーバーと同じ ASR に通して測ると、清書が英字の製品名をカタカナに書き換え(Nemotron が「ネモトロン」になるなど)、かえって精度が下がっていました。
| データ(文脈なしの 1 文ずつ) | ASR だけ | 最初のプロンプト | 今のプロンプト |
|---|---|---|---|
| 私の読み上げ 24 文の CER | 8.9% | 10.2% | 8.9% |
| 同、用語の正解 | 14/16 | 13/16 | 14/16 |
| FLEURS の 55 文の CER | 24.7% | 23.8% | 24.6% |
文脈のない 1 文ずつでは、清書の効果は小さく出ます。
会議では直前の発話を手がかりにできるので、同音異義語の誤りがよく直りました。
一方で、ありそうな語で埋めて、かえって意味が変わってしまう例もありました。
清書前の文を残しているのは、このためです。
今後は、会議の参加者名をシステムプロンプトに入れるなどして、清書の精度を上げていきたいと考えています。
翻訳と議事録の下書き
翻訳と議事録にも、同じ Qwen3.8-27B を使っています。
翻訳は、清書した発話ごとに、直前の 6 発話を文脈として渡して頼みます。
1 文で測ると、約 0.7 秒で返ってきました。
議事録は、録音を止めたあとに「議事録を作る」を押すと、清書した話者名つきの文字起こし全体から作ります。
話者名は、サイドパネルで話者の表示をクリックすると、その場で入力して付けられます。
出力の形は次のテンプレートで指定しました。
## 概要
## 決定事項
## ネクストアクション
- [担当] 内容
## 論点・メモ
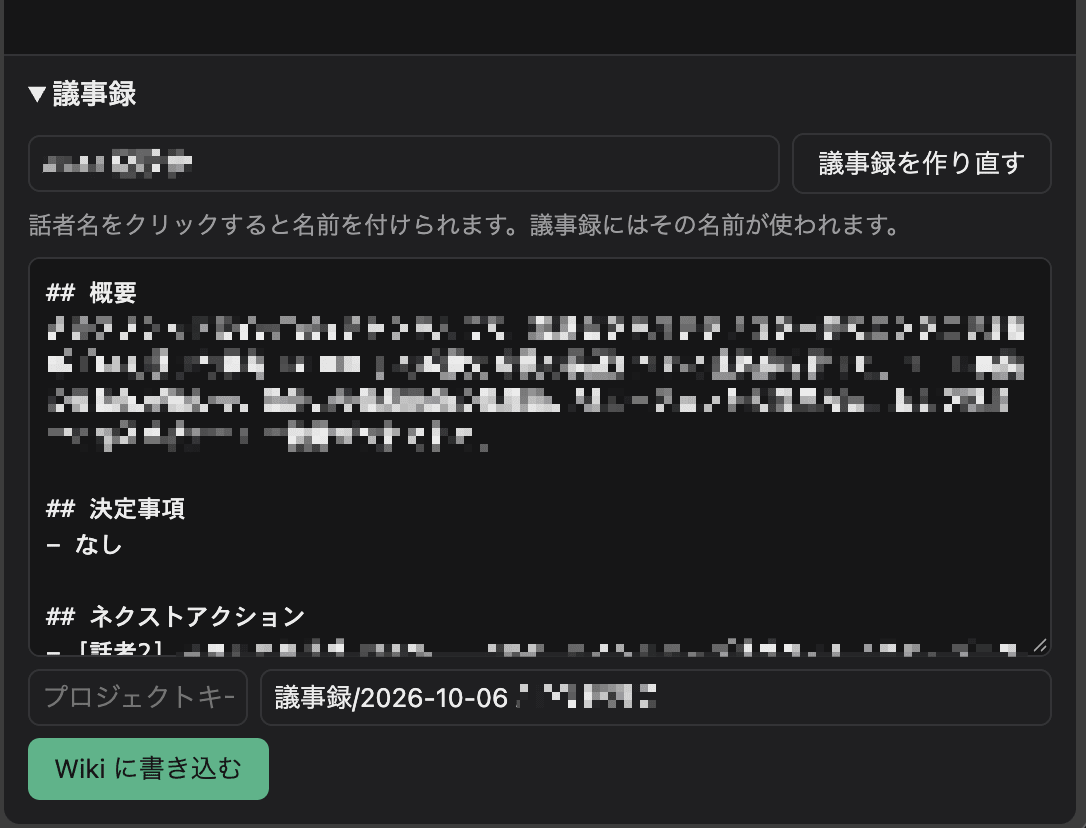
議事録の下書きはテンプレートの見出しに沿って出力され、その場で編集してから Wiki に書き込める
議事録を Backlog の Wiki に残す
議事録の下書きは、編集してから Backlog の Wiki ページとして残せます。
ページ名は「議事録/2026-10-05 定例」のように、日付と会議名を入れた形を初期値にしました。
Backlog の Wiki はページ名の「/」で階層になるので、議事録が 1 か所にまとまります。
shoki のサーバーは、Backlog API の「Wiki ページの追加」(POST /api/v2/wikis)を呼びます。
同じ名前のページがあると追加できないので、そのときはページ名の末尾に時刻を足して作り直します。
置き場所には、課題やファイル(共有ファイル)などの機能も考えましたが、共有ファイルは API に追加の口がなく、書き込みには WebDAV とパスワードが要ります。
API で中身をキーワード検索することもできません。
Wiki なら API キーだけで書けて、一覧の API(GET /api/v2/wikis)の keyword で検索できるので、あとで引く用途に合っていると考えました。
NemoHermes からの議事録の検索
Slack で動いているチームアシスタント(NemoHermes)には、Backlog の課題を検索して読む skill を以前の記事で持たせています。
この skill は Backlog API の GET をどれでも呼べるので、Wiki の検索と本文の取得には手を入れずに使えます。
足したのは、skill の説明の 1 節だけです。
過去の会議について聞かれたら、まず 議事録/ の Wiki を検索し、ページ名と URL を添えて答えるように書きました。
## Meeting minutes (Wiki)

Meeting minutes are recorded ... as Wiki pages named `議事録/YYYY-MM-DD <meeting name>`.
When someone asks what was said or decided in a past meeting, search these pages first.
運用に乗れば、Slack で「先週の定例で決まったことは?」のように聞くと、NemoHermes が議事録を探して答える想定です。
ベクトル検索の仕組みを別に用意しなくても、Backlog の検索をそのまま議事録の検索に使えるはずです。
実際の会議の議事録を Wiki に残し、Slack から引いて使うのは、これから試すところです。
おわりに
NVIDIA のオープンウェイトの音声モデルを組み合わせて、クラウドに音声を出さない会議の書記役を、Chrome 拡張機能と DGX Spark で作りました。
文字起こしと話者分離はどちらもストリーミングで動き、話している最中から文字が流れ、確定した発話は LLM が清書します。
いちばん大きな課題は、日本語の文字起こしの精度です。
ファインチューニングで用語は取れるようになり、清書で同音異義語の誤りも減りましたが、ほかの人の声の一般的な文では、まだ CER が 20% を超えます。
清書は文脈からありそうな語で埋めるので、元の誤りがひどいと、もっともらしい別の意味の文になることもあります。
この 2 点は、まだ改善の余地があります。
議事録を Backlog の Wiki に残し、Slack のチームアシスタントから過去の会議のことを聞く仕組みも用意したので、次はこれを実際のチーム運用に乗せていきます。
参考資料
- nvidia/Nemotron-3-Diarization(Hugging Face)
- nvidia/nemotron-3.5-asr-streaming-0.6b(Hugging Face)
- nvidia/parakeet-tdt_ctc-0.6b-ja(Hugging Face)
- NVIDIA L40Sで日本語対応ASRモデルを比較してみた(NVIDIA社のParakeetがかなり良い結果に)(DevelopersIO)
- Nemotron 3.5 ASRを日本語音声でファインチューニングしてみた(DevelopersIO)
- Nemotron-3-Diarizationで手元のMacでローカル話者分離してみたら、約27分の会議データでも6秒で話者分離できた(DevelopersIO)
- chrome.tabCapture(Chrome for Developers)
- chrome.offscreen(Chrome for Developers)
- chrome.sidePanel(Chrome for Developers)
- google/fleurs(Hugging Face)
- Backlog API Wiki ページの追加(Nulab)
- Backlog API Wiki ページ一覧の取得(Nulab)