サクッと画像生成AIモデルを作ってみた【GAN】

こんにちは。AI事業本部 生成AIインテグレーション部の児玉です。
普段は生成AIコンサルタントとして、お客様へのLLM・生成AI活用の提案や伴走支援(コンサルティング)、PM業務をしています。
私は、前職ではML系(機械学習)エンジニアとしてディープラーニング周りの開発を行っていた経験があります。
今でこそAIコーディングが主流となりつつある印象ですが、昔は一からアルゴリズムを設計したりして、手作業でプログラミングをしていたものです。
そのおかげもあってか、昨今の目まぐるしい生成系AI技術(主にLLM)の進化を隅々まで追わずともキャッチアップコストが低く済んでいると思います。
逆に言えば、機械学習の基礎を知らない人にとってみれば最近の技術は「ブラックボックス」そのものに見えるでしょう。
そこで、本記事では昨今の生成AI技術の糧にもなったであろう“画像生成AI”を、古典的な手法である『GAN』で開発し、「生成AIとはどういうものなのか」について知るきっかけを作れればなと思います。
※現代で主流となっているアプローチとは異なる概念を採用している点に注意してご覧ください。
※本記事の最後に参考文献を添付しております。参考までにご覧ください。
はじめに
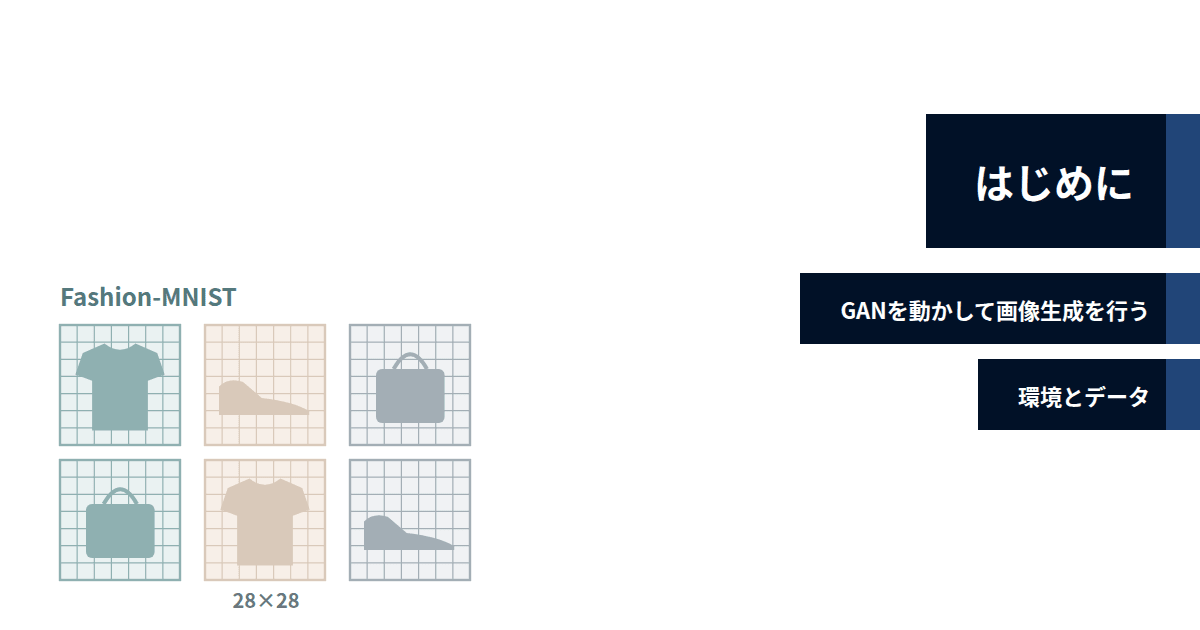
今回は、生成AIの仕組みを超基礎から説明するために、GAN(敵対的生成ネットワーク、英: generative adversarial networks)というAIアルゴリズムを使用し、簡単に画像生成AIを作っていきます。
また、AIの学習用データセットには『Fashion-MNIST(Tシャツやブーツなどファッション商品(写真)の画像データセット)』というものを使用します。
これはラベルが0から9までつけられた10種類の「ファッション商品」写真の画像データセットのことで、ディープラーニング/機械学習の研究や初心者向けチュートリアルで使われることが多いです。
このデータセットを使い、GANで「実在しない服」の画像を生成するモデルを作ってみました。
GANを動かして画像生成を行う
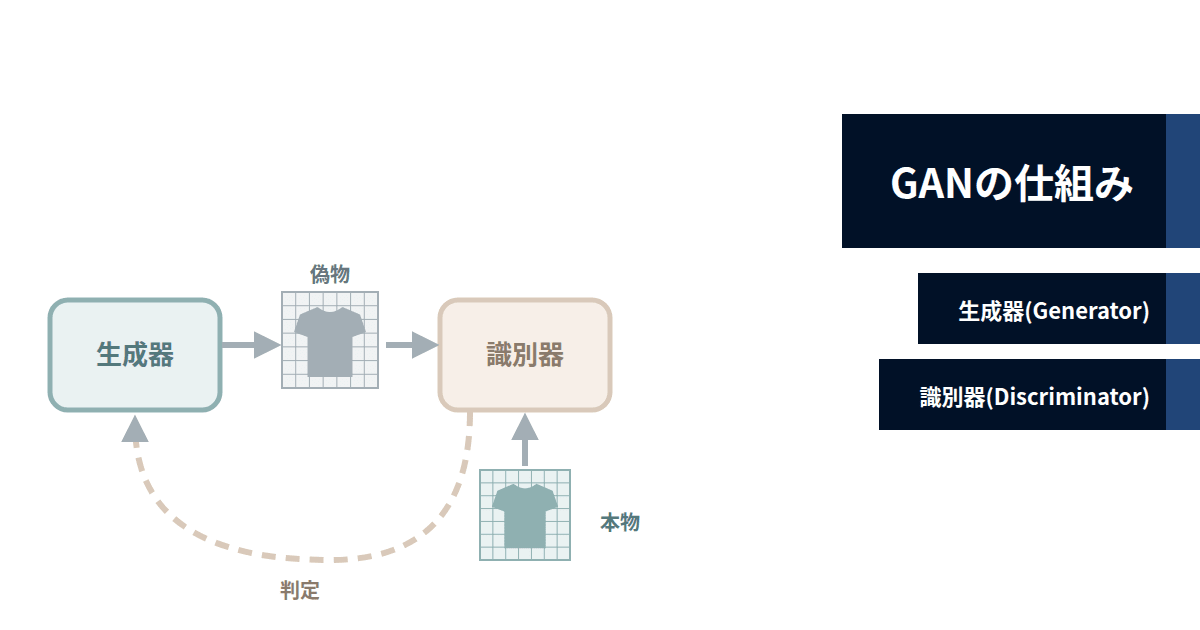
GAN(Generative Adversarial Networks、敵対的生成ネットワーク)は、画像を作る「生成器」と、画像が本物か偽物かを判定する「識別器」の2つのモデルを競わせて学習する手法のことを言います。
なんのことを言っているかわからない人のために、よく言われる例えがあります。
偽札を作る人(生成器)と見破る警察(識別器)が互いに腕を上げるうちに、本物そっくりの偽札ができあがる
というようなもの。後ほど仕組みについては画像付きで解説もしているので、詳しく知りたい方はご覧ください。
実は、GANは2022年あたりにStable Diffusionが公開されるぐらいまでは割と画像生成界隈では主流のアプローチだったのです。
今の画像生成AIの土台を作った技術の一つと言っても過言ではないでしょう。
また、GANを題材に選んだのは、構成がシンプルだからです。今回実装したPythonコードも、途中保存の仕組みまで含めて250行ほどに収まります。
一方、今の画像生成AIとは大きく2つの点で違います。
- 生成のトリガーの違い
- GANは乱数だけが入力なので何の服が出るかを指示できない
- 逆に今の画像生成AIは文章で内容を指定できる
- アプローチそのものの違い
- GANは生成器に1回通すだけで画像を出す
- 今の画像生成AIはノイズを少しずつ取り除く処理を何回も繰り返す
あくまでも今回扱う手法は『画像生成AIの基礎を知る』という名目で登場すると思ってください。
環境とデータ
今回は、学習データにFashion-MNIST、プログラミング言語にPython、機械学習ライブラリはTensorFlowを使います。
Fashion-MNISTとは、ファッション通販企業Zalandoの研究チームが公開したMITライセンスのデータセットです。
Tシャツ、ズボン、スニーカー、バッグなど10種類の服や靴の画像が7万枚(学習用6万枚、テスト用1万枚)入っていて、すべて28×28ピクセルの白黒画像になっています。
白黒画像かつピクセル数も超少ない粗画像データセットなので、RGBを考慮する必要がなくデータの次元が小さくて済む=すなわち短時間で学習できる=チュートリアルにもってこいということになります。
TensorFlowは知ってる方も多いと思いますが、これはGoogleが開発しているオープンソースの機械学習ライブラリです。
付属のKerasというAPIを使うことで、複雑なニューロン層をコードで表現することが容易になるので、感覚的にニューラルネットワーク処理を定義することが可能になります。
ということで環境は以下の通りです。
| 項目 | バージョン・内容 |
|---|---|
| 言語 | Python3.14 |
| 主なライブラリ | TensorFlow2.21、matplotlib3.11(結果を描画したいので) |
| 実行マシン | MacBook 16GB Apple M5(GPUは使わずCPUのみで学習) |
| その他 | Claude Code |
GANの仕組み
ここではGANの仕組みについて詳しく画像つきで解説していきたいかと思います。
GANの学習は、次の図の3ステップを何度もくり返して進みます。
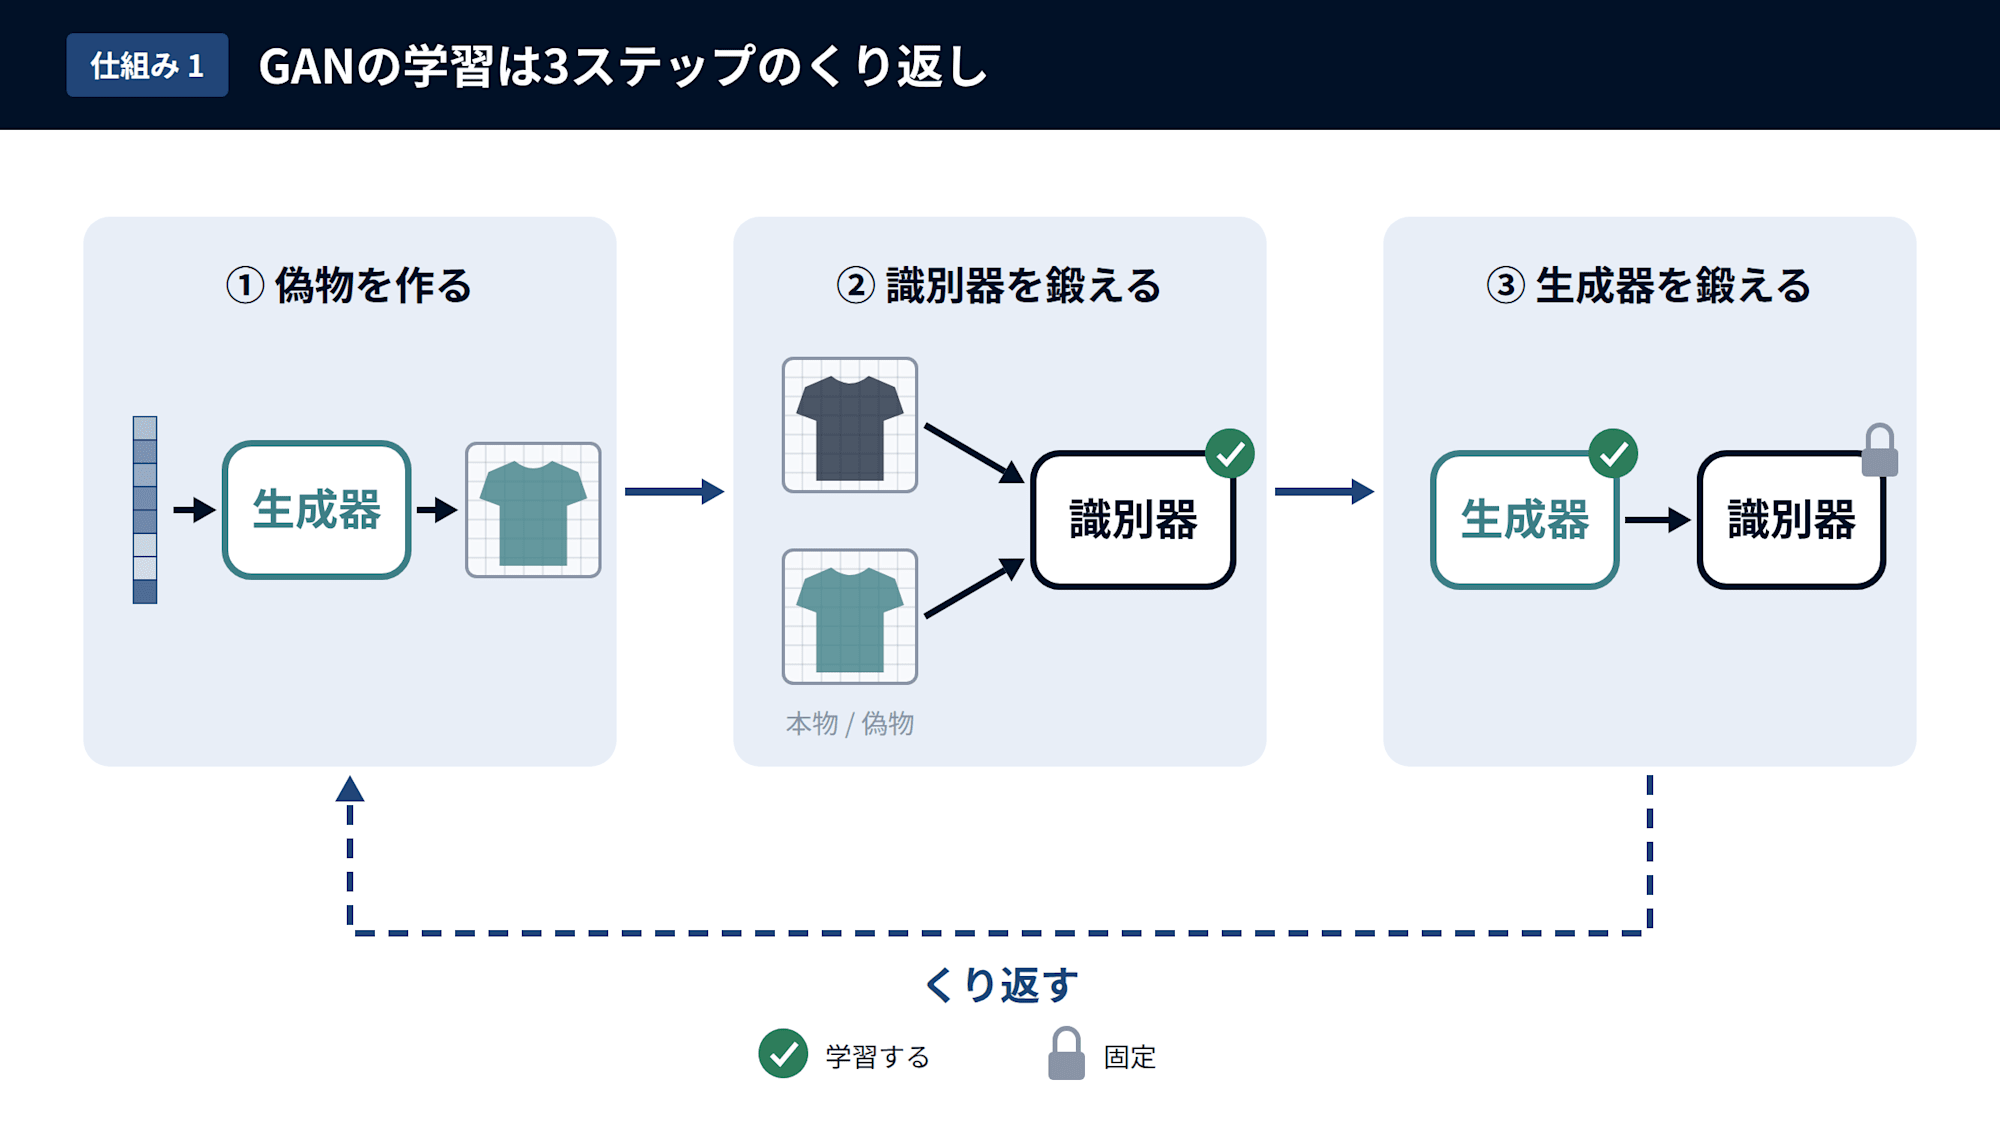
トレーニングの対象は『生成器』と『識別器』の2つの機構です。
まず『生成器』と呼ばれる機構が乱数から偽物の画像を作る工程から始まります。学習前の生成器が作るのは文字通りランダムなノイズのような画像なので、この時点では何かを意識した画像は生成されません。
その次に、本物と偽物の画像を見分ける『識別器』という機構を用意し、この識別器に先ほどのノイズのような画像を見せます。(実際には見ていないけどデータを受け取るという意味で)
そしてこの識別器が“受け取った画像”と“本物の画像”を見分けられるようにトレーニングを行います。最後に、識別器に「本物」と判定されるように生成器を鍛えます。この一連の流れを何度も繰り返すことが、GANのアプローチです。
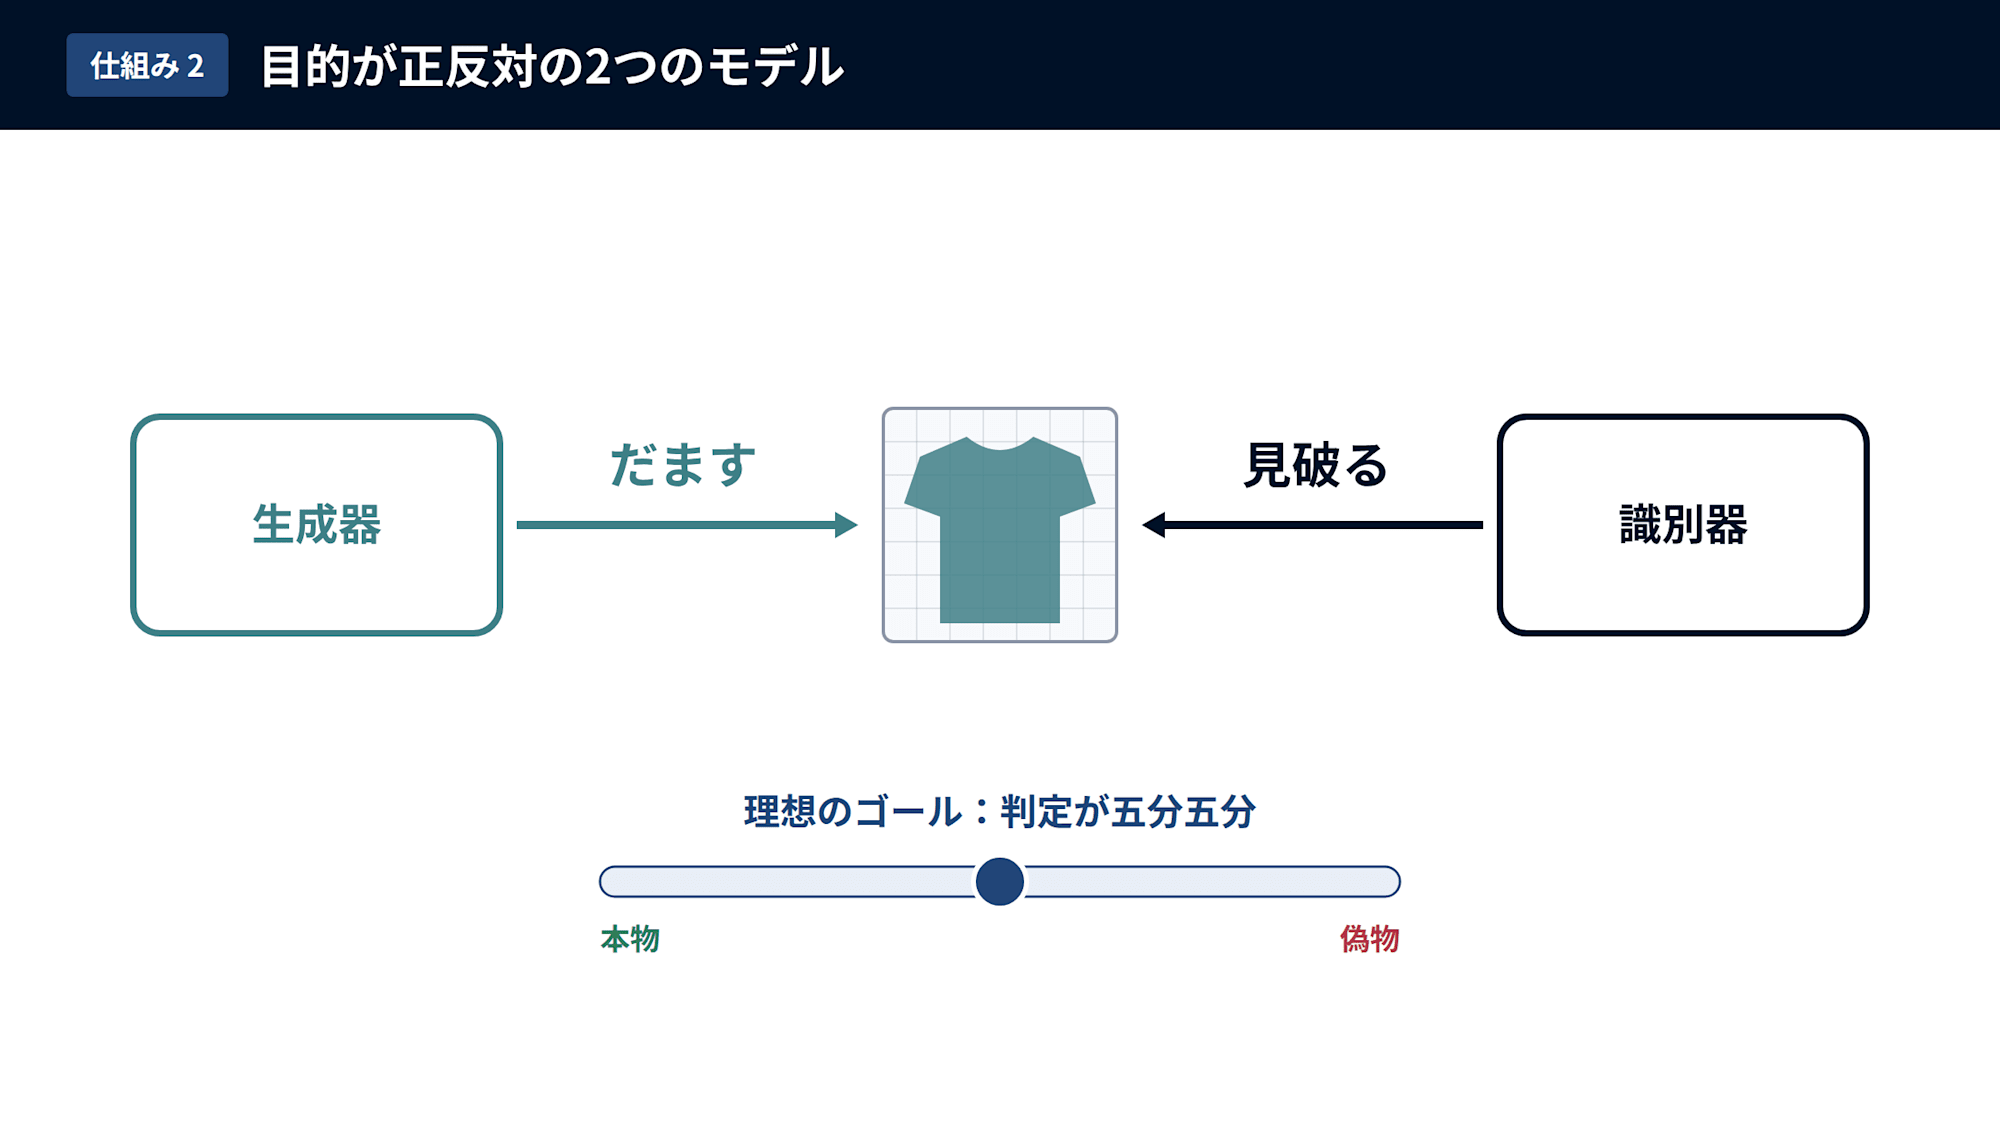
GANは直訳すると『敵対的生成ネットワーク』と呼ばれるのですが、その理由は生成器と識別器の役割が正反対であることに由来します。
- 生成器
- 識別器をだまそうとする
- 識別器
- 偽物を見破ろうとする
この2つのモデルの目的が正反対なので「敵対的」と呼ばれるのです。理想的には、生成器の画像が本物と区別できなくなり、識別器の判定が五分五分になったところで学習が落ち着きます。
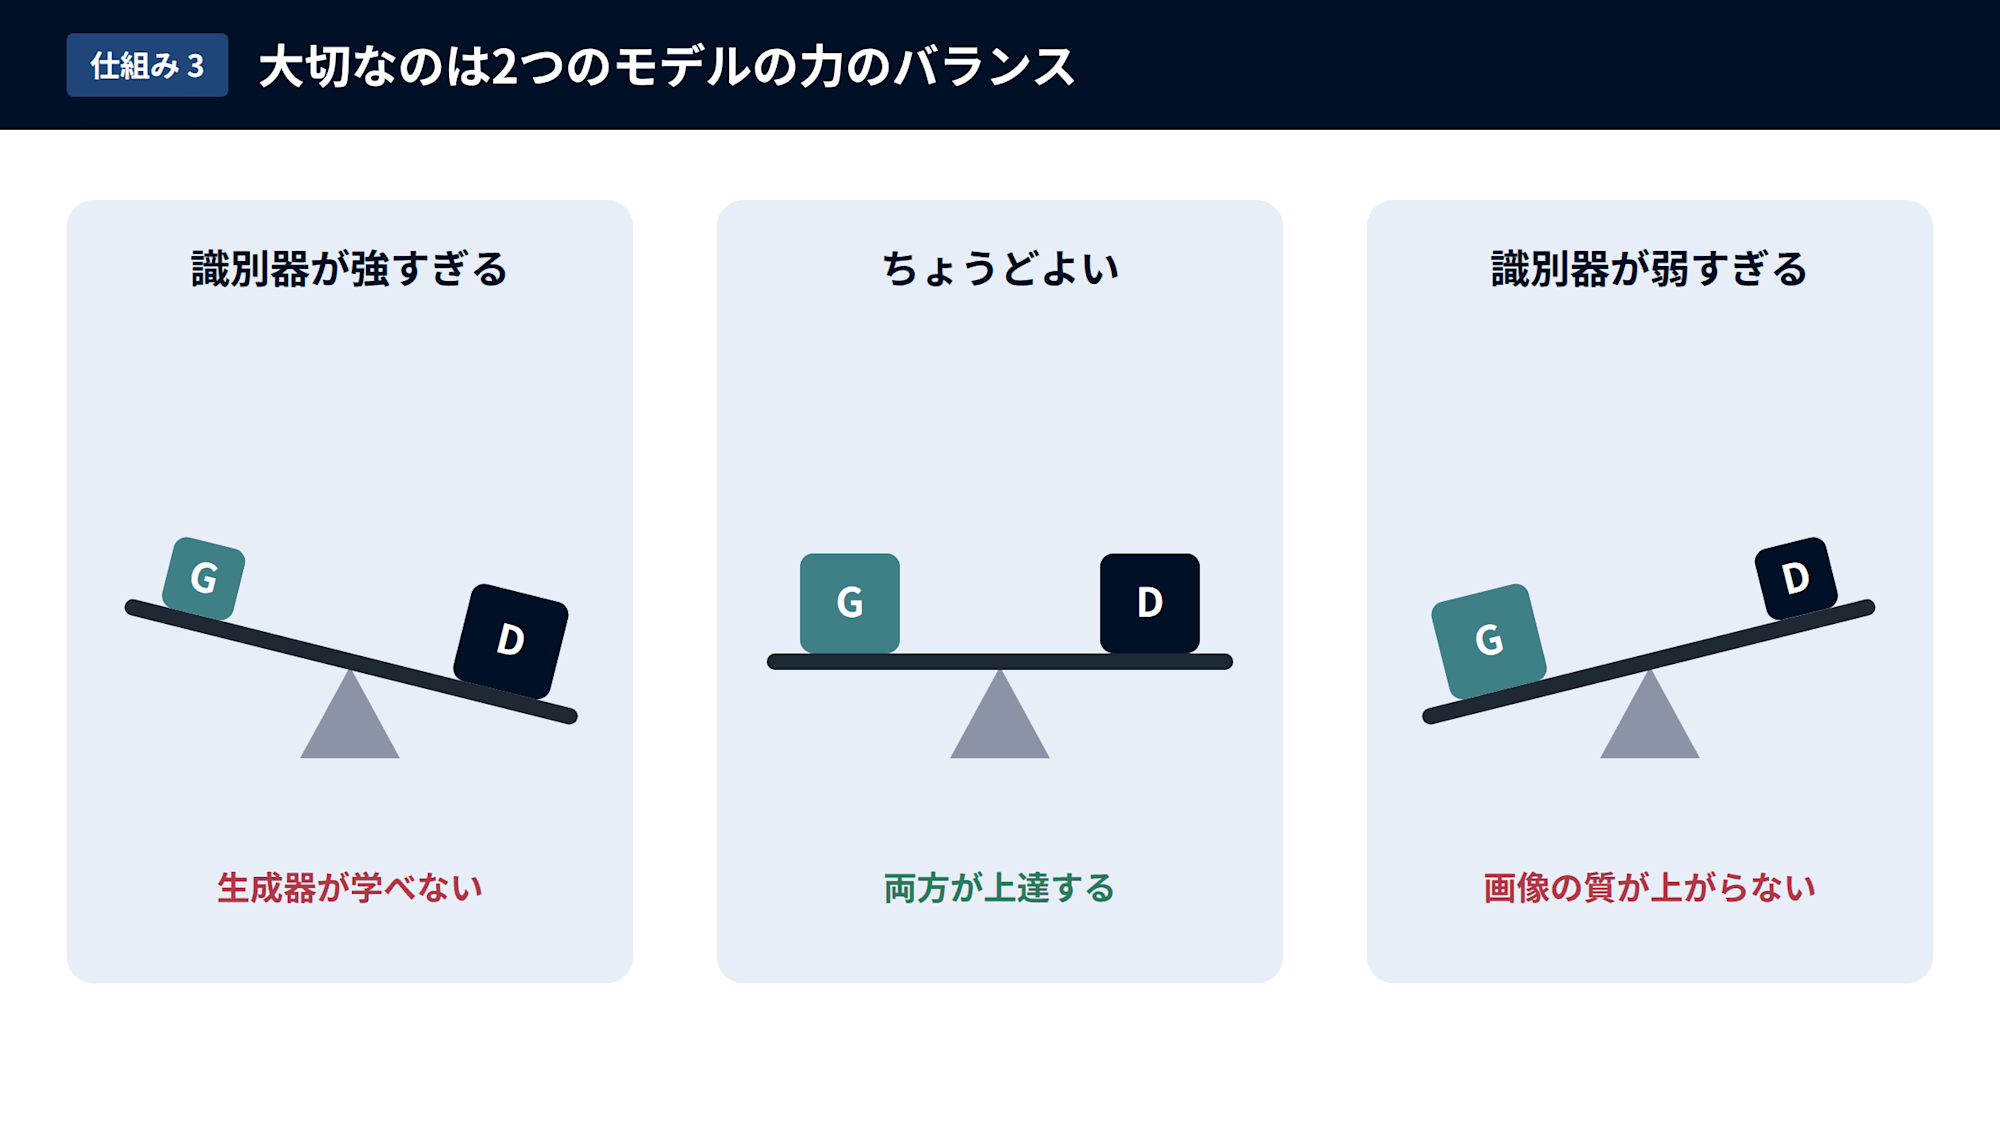
GANを動かすうえで大切なのが、2つのモデルのパワーバランスです。
例えば識別器が強すぎると、生成器の画像はすべて簡単に見破られてしまいます。逆に識別器が弱すぎると、質の低い画像でもだませてしまうので、画像の質が上がりません。
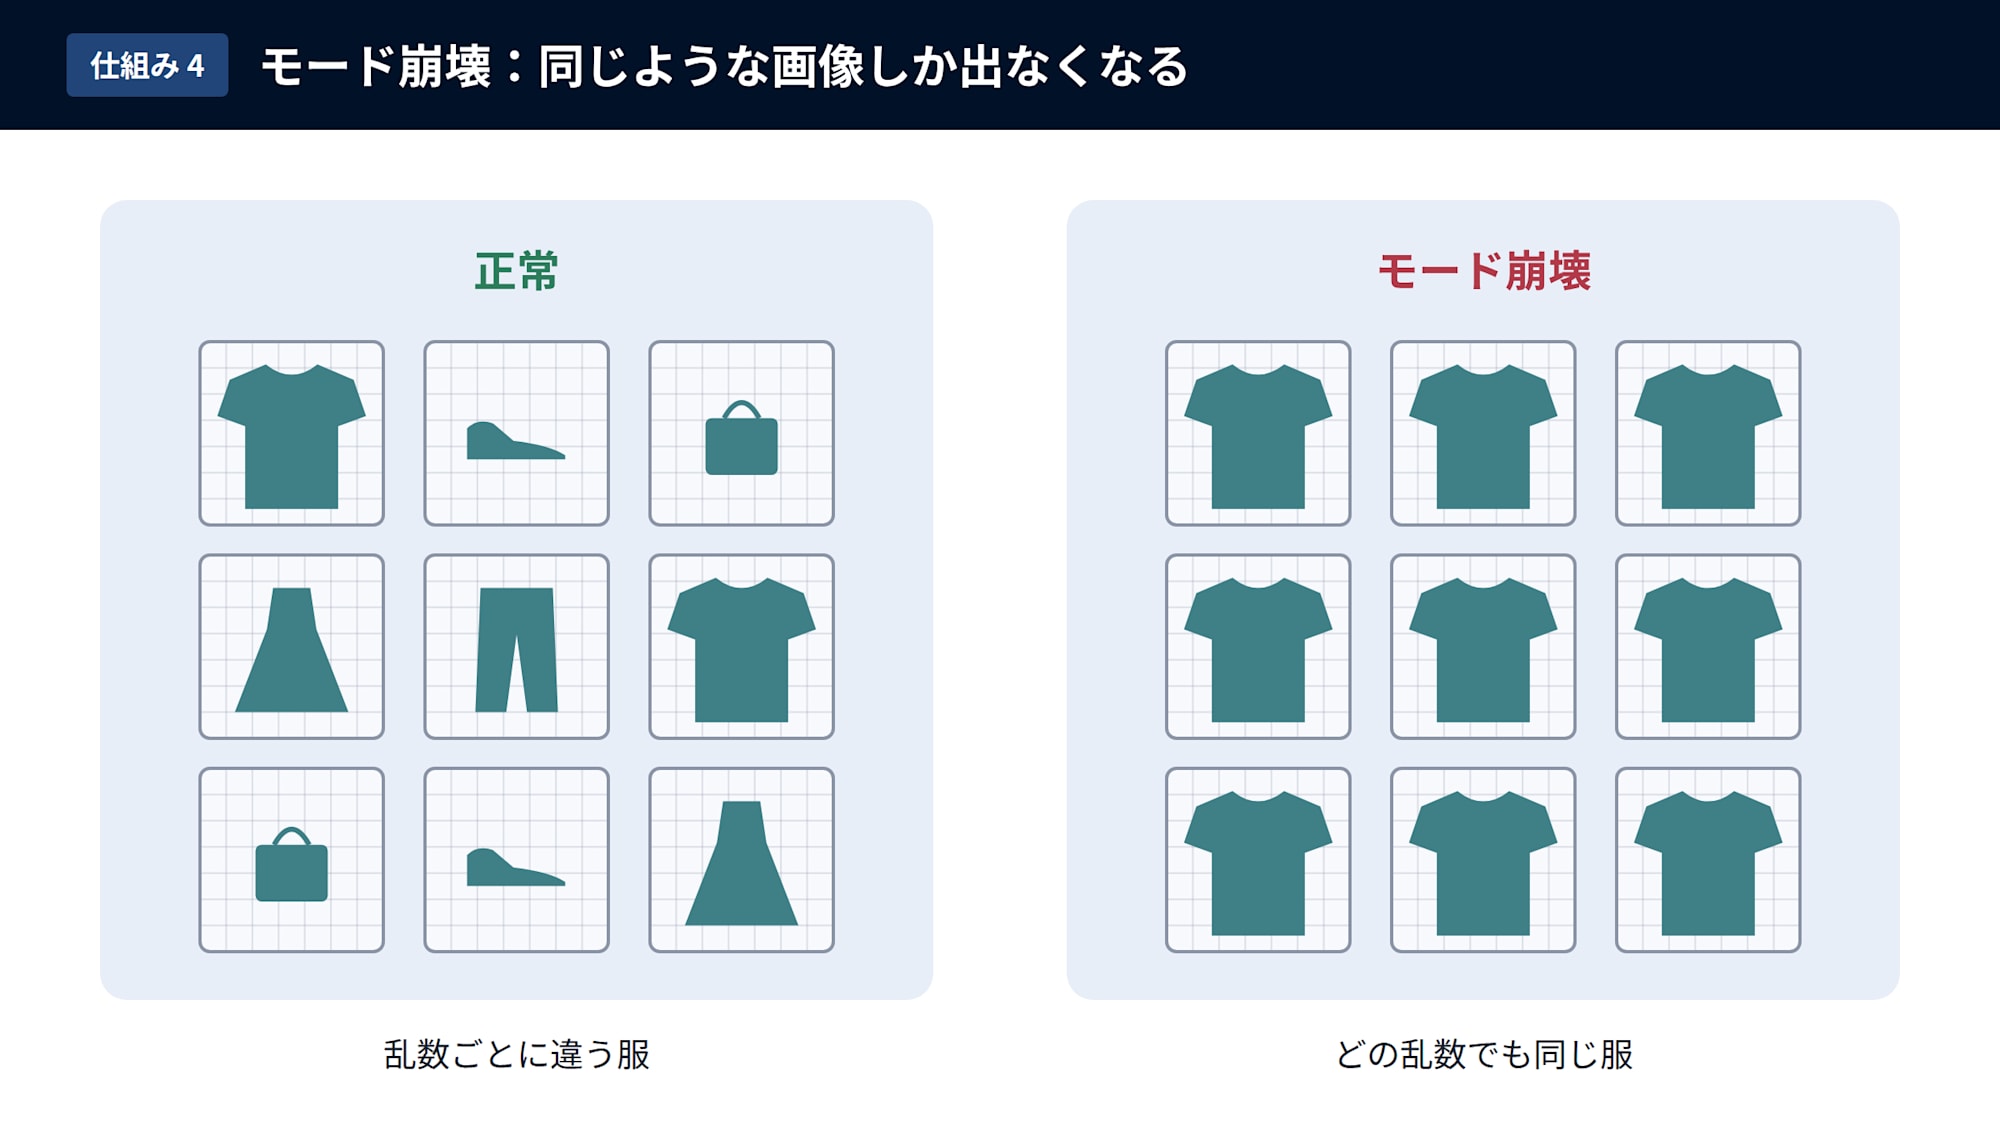
また、生成器が識別器をだましやすい画像ばかりを作るようになることもあります。正常に進めば乱数ごとに違う服が出てきますが、この状態になると、どの乱数を入れても同じような服しか出てこなくなります。これを「モード崩壊」と呼びます。
生成AIモデルの学習には、こうした問題を防ぐ工夫が必要なのです。
生成器(Generator)
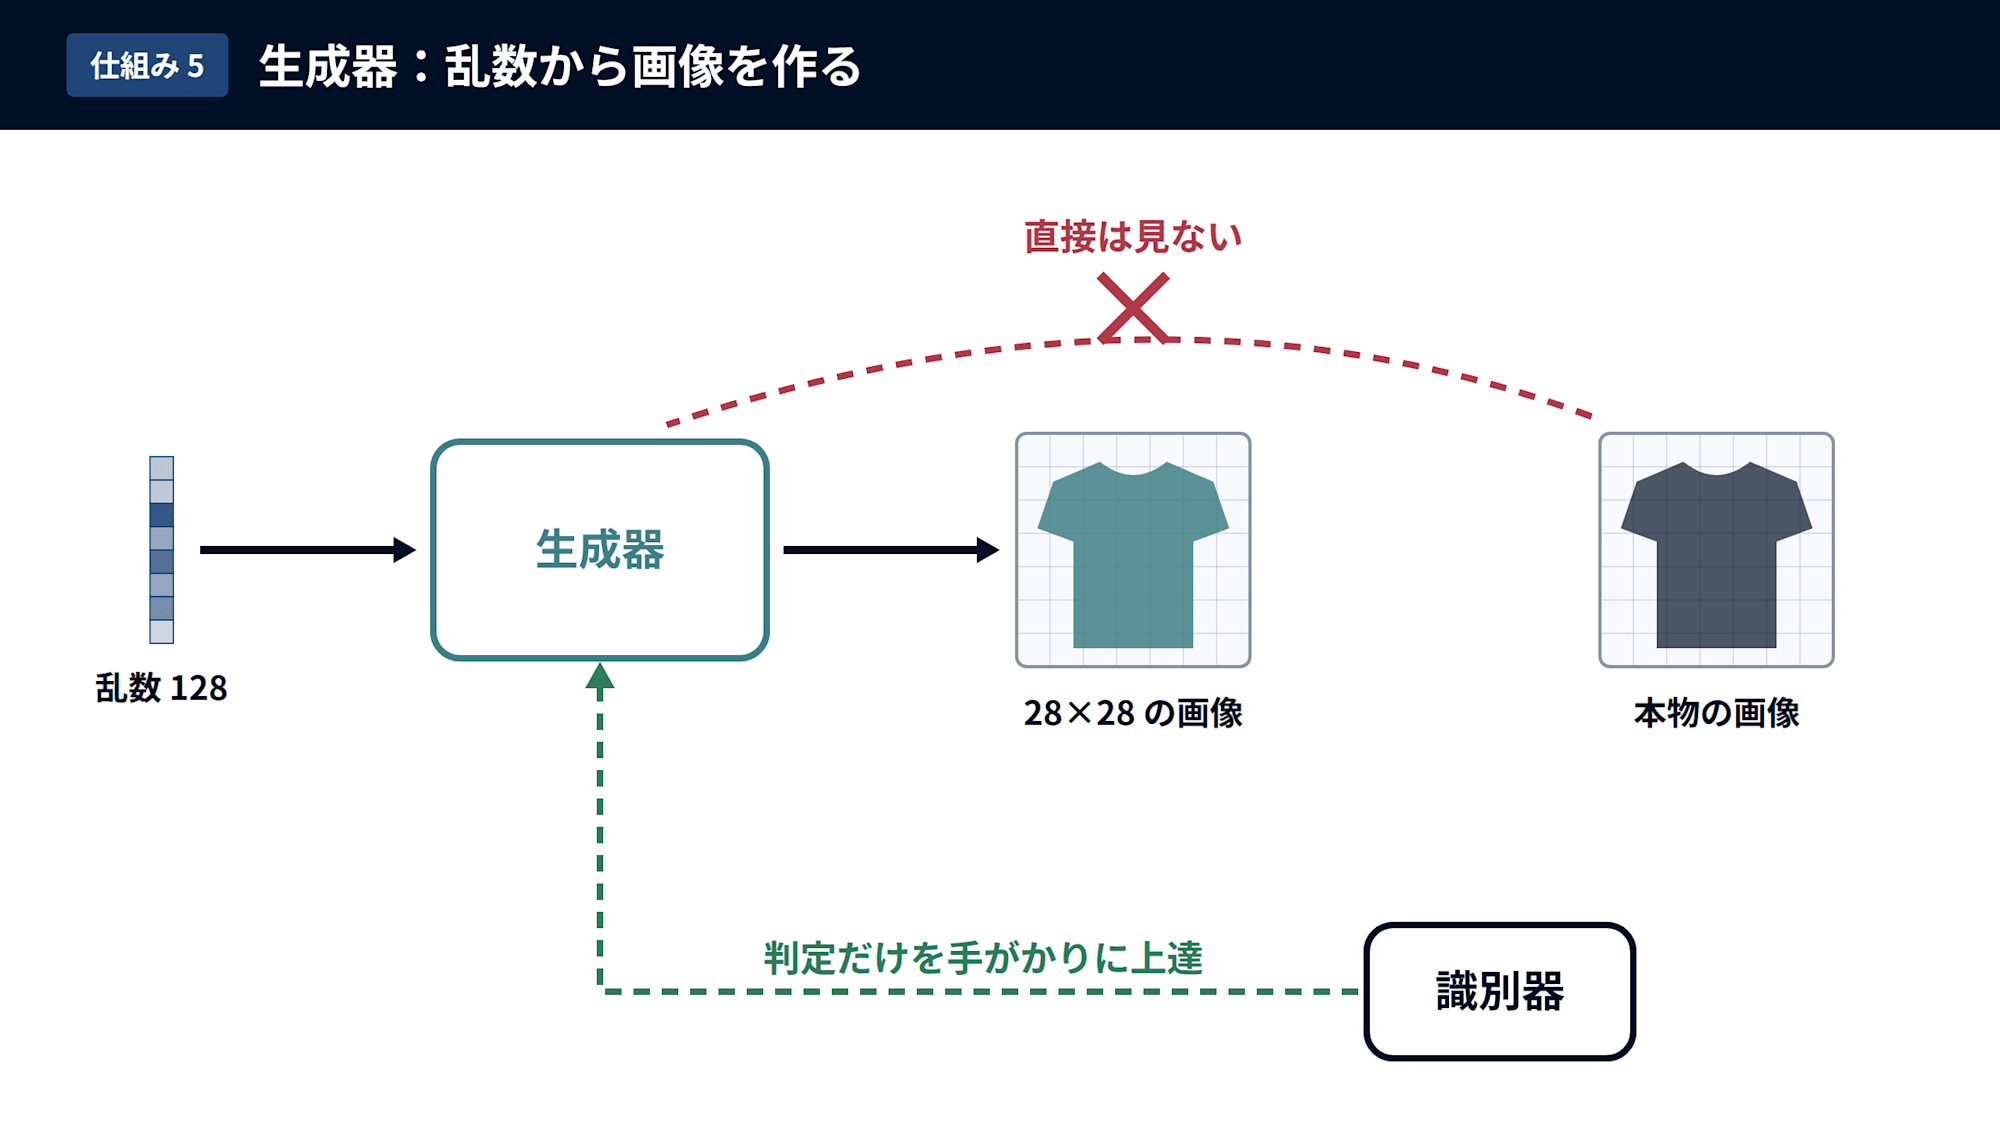
生成器を改めて解説します。GANにおける生成器を一言で表すと、「乱数を受け取って画像を出力するモデル」です。
学習前はノイズしか出せませんが、学習が進むと乱数に応じてさまざまな服の画像を出すようになります。
今回は128個の数値が並んだ乱数から、28×28ピクセルの白黒画像を作ります。
この乱数は、今回の服のバリエーションを表すのに十分な数があれば多少増減しても結果はほとんど変わりません。数十個から数百個程度なら問題なく動くと考えられ、128はその範囲から選んだ切りのいい数です。
高解像度の顔画像を生成するStyleGANでは512が使われることが多い印象があります。
とにかく、上記の図のとおり、生成器は本物の画像を直接見ることはありません。識別器の判定をもとに少しずつ上達していきます。
識別器(Discriminator)
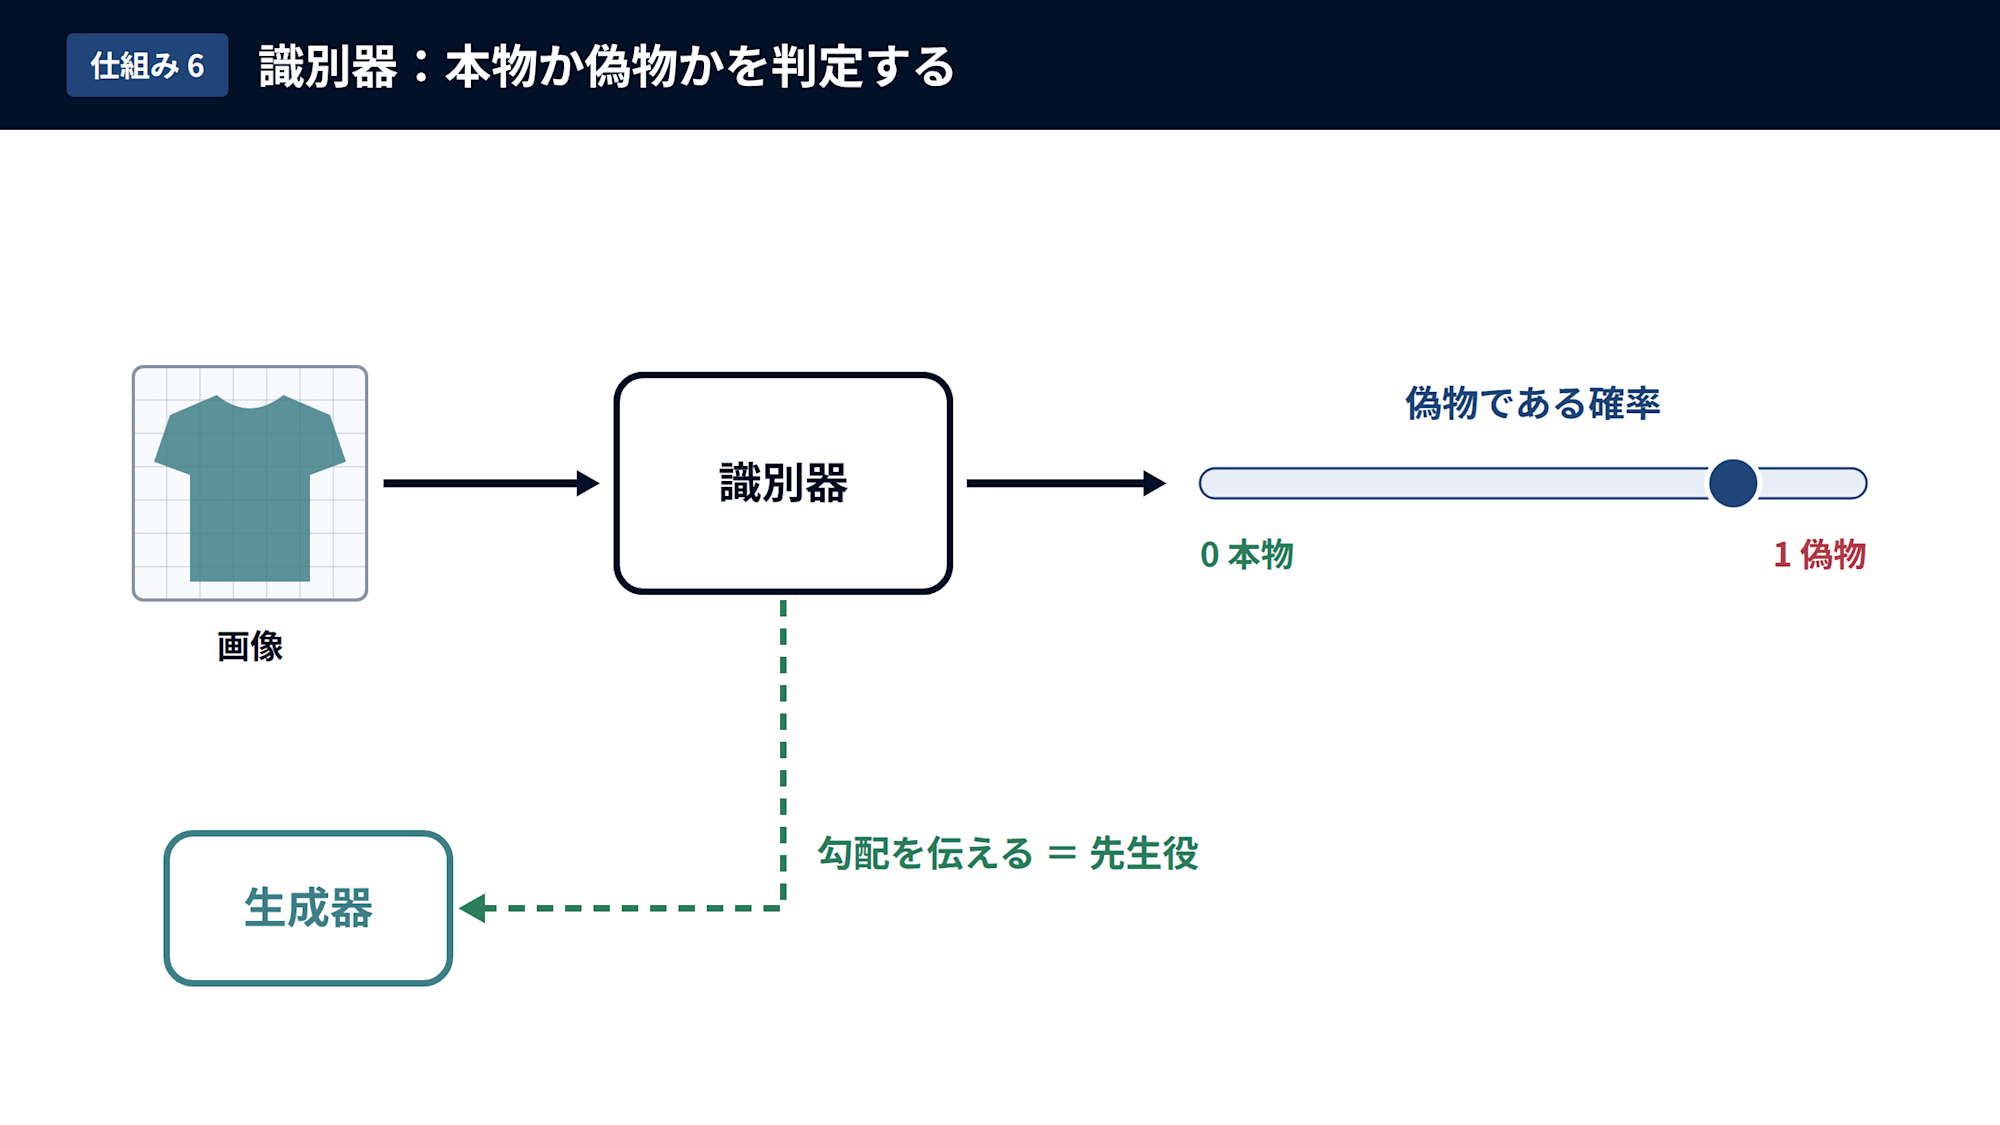
次に識別器の解説もしたいと思います。これも一言で表すなら、「画像を受け取って本物か偽物かを判定するモデル」になります。
識別器は、画像が偽物である確率を0〜1の数値で出力します。0に近いほど本物、1に近いほど偽物という判定です。
実際に値を0〜1の範囲に収めているのは、ニューロン層の活性化関数である『sigmoid関数(シグモイド関数)』で、その値が「偽物らしさ」を表すのは、本物を0、偽物を1として識別器全体を学習させているからです。
※GANの解説では1を本物とすることが多いのですが、今回のコードでは逆に0を本物としている点に注意してください。
ちなみに活性化関数の解説をわかりやすくしているZennの記事を見つけたので、参考程度にご覧ください。
識別器には、生成器の先生役という役割もあります。
識別器の判定結果から計算した勾配(どう直せば判定が変わるかを表す値)が生成器に伝わり、生成器の学習に使われます。
つまり、識別器が良い先生でなければ生成器も上達しない、という依存関係にあるのです。
GANで存在しない服画像を生成してみよう
言葉での解説は以上として、ここからは実際に実行できるコードを見ていきましょう。
Fashion-MNISTの学習用画像6万枚でDCGANを学習させ、**エポック(学習データを1周すること=世代ともいう)**ごとに生成画像を保存していきます。
コードはfashion_gan.pyの1ファイルで、コマンドライン引数にエポック数を指定できるようにしてあります。
CPUだけで学習すると時間がかかるので、途中で止まっても同じコマンドをもう一度実行すれば続きから再開できるようにしています。
※基本的にClaude Codeで記述し、手で少し修正加えてます
python fashion_gan.py          # デフォルトは20エポック
python fashion_gan.py 50       # エポック数を指定
本節では重要なfunctionごとに見ていきましょう。
基本設定とデータセットの準備
"""
fashion_gan.py — Fashion-MNIST を学習した DCGAN で「存在しない服」の画像を生成する。
途中で止まっても、同じコマンドをもう一度実行すれば続きから再開する。

    python fashion_gan.py          # 20 エポック(動作確認用)
    python fashion_gan.py 50       # エポック数を指定

出力(output/ 配下):
    ckpt/            途中保存(直近 3 世代)
    loss.csv         エポックごとの損失(エポック平均、追記)
    epoch_XXXX.png   各エポック終了時の生成画像グリッド(毎回同じ乱数から生成)
    loss.png         損失推移
    result.png       学習後の生成画像 4x4
    generator.keras / discriminator.keras

最初からやり直す場合は output/ フォルダを削除(または名前を変更)してから実行する。
"""

import csv
import os
import signal
import sys

import tensorflow as tf
from matplotlib import pyplot as plt
from tensorflow.keras import Model, Sequential, callbacks, layers, losses, metrics, optimizers

# ---------------------------------------------------------------- 設定
NOISE_DIM = 128          # 生成器に入れる乱数の個数
BATCH_SIZE = 128         # 一度に学習する画像の枚数
EPOCHS = int(sys.argv[1]) if len(sys.argv) > 1 else 20
OUT = "output"           # Colab なら Google Drive 上のパスにする(例: /content/drive/MyDrive/fashion_gan/output)
SAVE_EVERY_STEPS = 50    # 何ステップごとに途中保存するか
os.makedirs(OUT, exist_ok=True)

for gpu in tf.config.list_physical_devices("GPU"):
    tf.config.experimental.set_memory_growth(gpu, True)

# ---------------------------------------------------------------- データ
def load_dataset() -> tf.data.Dataset:
    """Fashion-MNIST を -1〜1 に正規化し、学習用パイプラインとして返す。"""
    (x, _), _ = tf.keras.datasets.fashion_mnist.load_data()
    x = (x[..., None].astype("float32") - 127.5) / 127.5  # (60000, 28, 28, 1)、値は -1〜1
    return (
        tf.data.Dataset.from_tensor_slices(x)
        .shuffle(len(x))
        .batch(BATCH_SIZE, drop_remainder=True)
        .prefetch(tf.data.AUTOTUNE)
    )
まず初めにtensorflowパッケージから必要なクラスと関数を読み込みます。
設定パートでは、生成器に入れる乱数の個数(NOISE_DIM)、一度に学習する画像の枚数(BATCH_SIZE)、エポック数(EPOCHS)などを決めています。
SAVE_EVERY_STEPSは途中保存の間隔で、50ステップ(画像6,400枚分)学習するたびに、その時点のモデルを保存します。
load_dataset関数は、Fashion-MNISTの学習用画像を読み込むものになっています。
tf.keras.datasets.fashion_mnist.load_data()の中身を言い換えると以下になります。
((学習用画像, 学習用ラベル), (テスト用画像, テスト用ラベル))
それぞれの中身はこんな感じです。
| 中身 | 形 |
|---|---|
| 学習用画像 | (60000, 28, 28) |
| 学習用ラベル(服の種類を表す0〜9の番号) | (60000,) |
| テスト用画像とテスト用ラベル | (10000, 28, 28) と (10000,) |
つまり、60000件の28×28ピクセル数画像とそれに対応するラベルが『学習用』と『テスト用』で分かれているということですね。
今回使うのは学習用画像だけなので、それをxで受け取り、使わないラベルとテスト用データは_で捨てています。
なぜ学習用とテストデータが分かれているのかについては、また勉強になるZenn記事を見つけたので、ご覧ください。
x[..., None]部分は、畳み込み層が受け取れるようにチャンネルの次元を追加し、画像の形を (60000, 28, 28, 1) にする処理です。
その後の(x - 127.5) / 127.5は、0〜255の画素値を-1〜1の範囲にそろえる正規化の工程です。
(0は-1、127.5は0、255は1になります)
0〜1ではなく-1〜1にしているのは、後で出てくる生成器の出力が-1〜1の範囲になるからです。
生成器の準備
# ---------------------------------------------------------------- モデル
def build_generator() -> Sequential:
    """乱数ベクトル → 28x28x1 画像(-1〜1)。7x7 から 2 回アップサンプリングして 28x28 へ。"""
    return Sequential(
        [
            layers.Input((NOISE_DIM,)),
            # 128 → 7x7x128(BatchNormalization の直前の層は bias 不要)
            layers.Dense(7 * 7 * 128, use_bias=False),
            layers.BatchNormalization(),
            layers.LeakyReLU(0.2),
            layers.Reshape((7, 7, 128)),
            # 7x7x128 → 14x14x128
            layers.UpSampling2D(),
            layers.Conv2D(128, 5, padding="same", use_bias=False),
            layers.BatchNormalization(),
            layers.LeakyReLU(0.2),
            # 14x14x128 → 28x28x64
            layers.UpSampling2D(),
            layers.Conv2D(64, 5, padding="same", use_bias=False),
            layers.BatchNormalization(),
            layers.LeakyReLU(0.2),
            # 28x28x64 → 28x28x1(tanh で画素値を -1〜1 に)
            layers.Conv2D(1, 5, padding="same", activation="tanh"),
        ],
        name="generator",
    )
今回の生成器は、128個の乱数から 28×28の白黒画像を作るモデルです。全体の流れは次の図の通りで、小さな特徴マップを2回拡大して画像の大きさまで持っていきます。
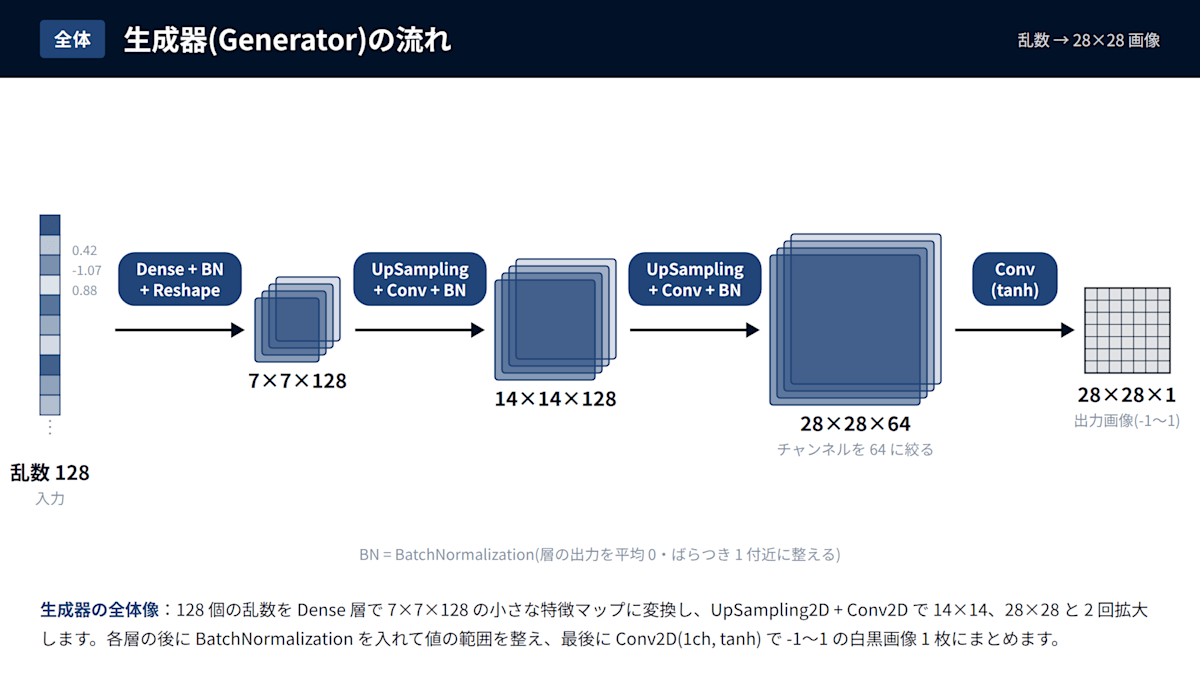
この『アップサンプリング(UpSampling)』がなにをしているのかというと、画像(特徴マップ)の縦横のサイズを大きくする処理をしています。
こちらについてはこの後のStep2で解説していますので後ほどご覧ください。
もう1つ、各層の後に入っている『BatchNormalization(バッチ正規化)』は、層から出てくる値をバッチ(128枚)ごとに平均0・ばらつき1付近にそろえ直す処理だと思ってください。
GANは、学習中に値が極端に大きくなったり、全部が同じ値に張り付いたりして崩れやすいのですが、層ごとに値の範囲を整えておくことで学習が安定します。
上記の理由で、バッチノーマライズをちょくちょく入れておくことが肝要なのです。
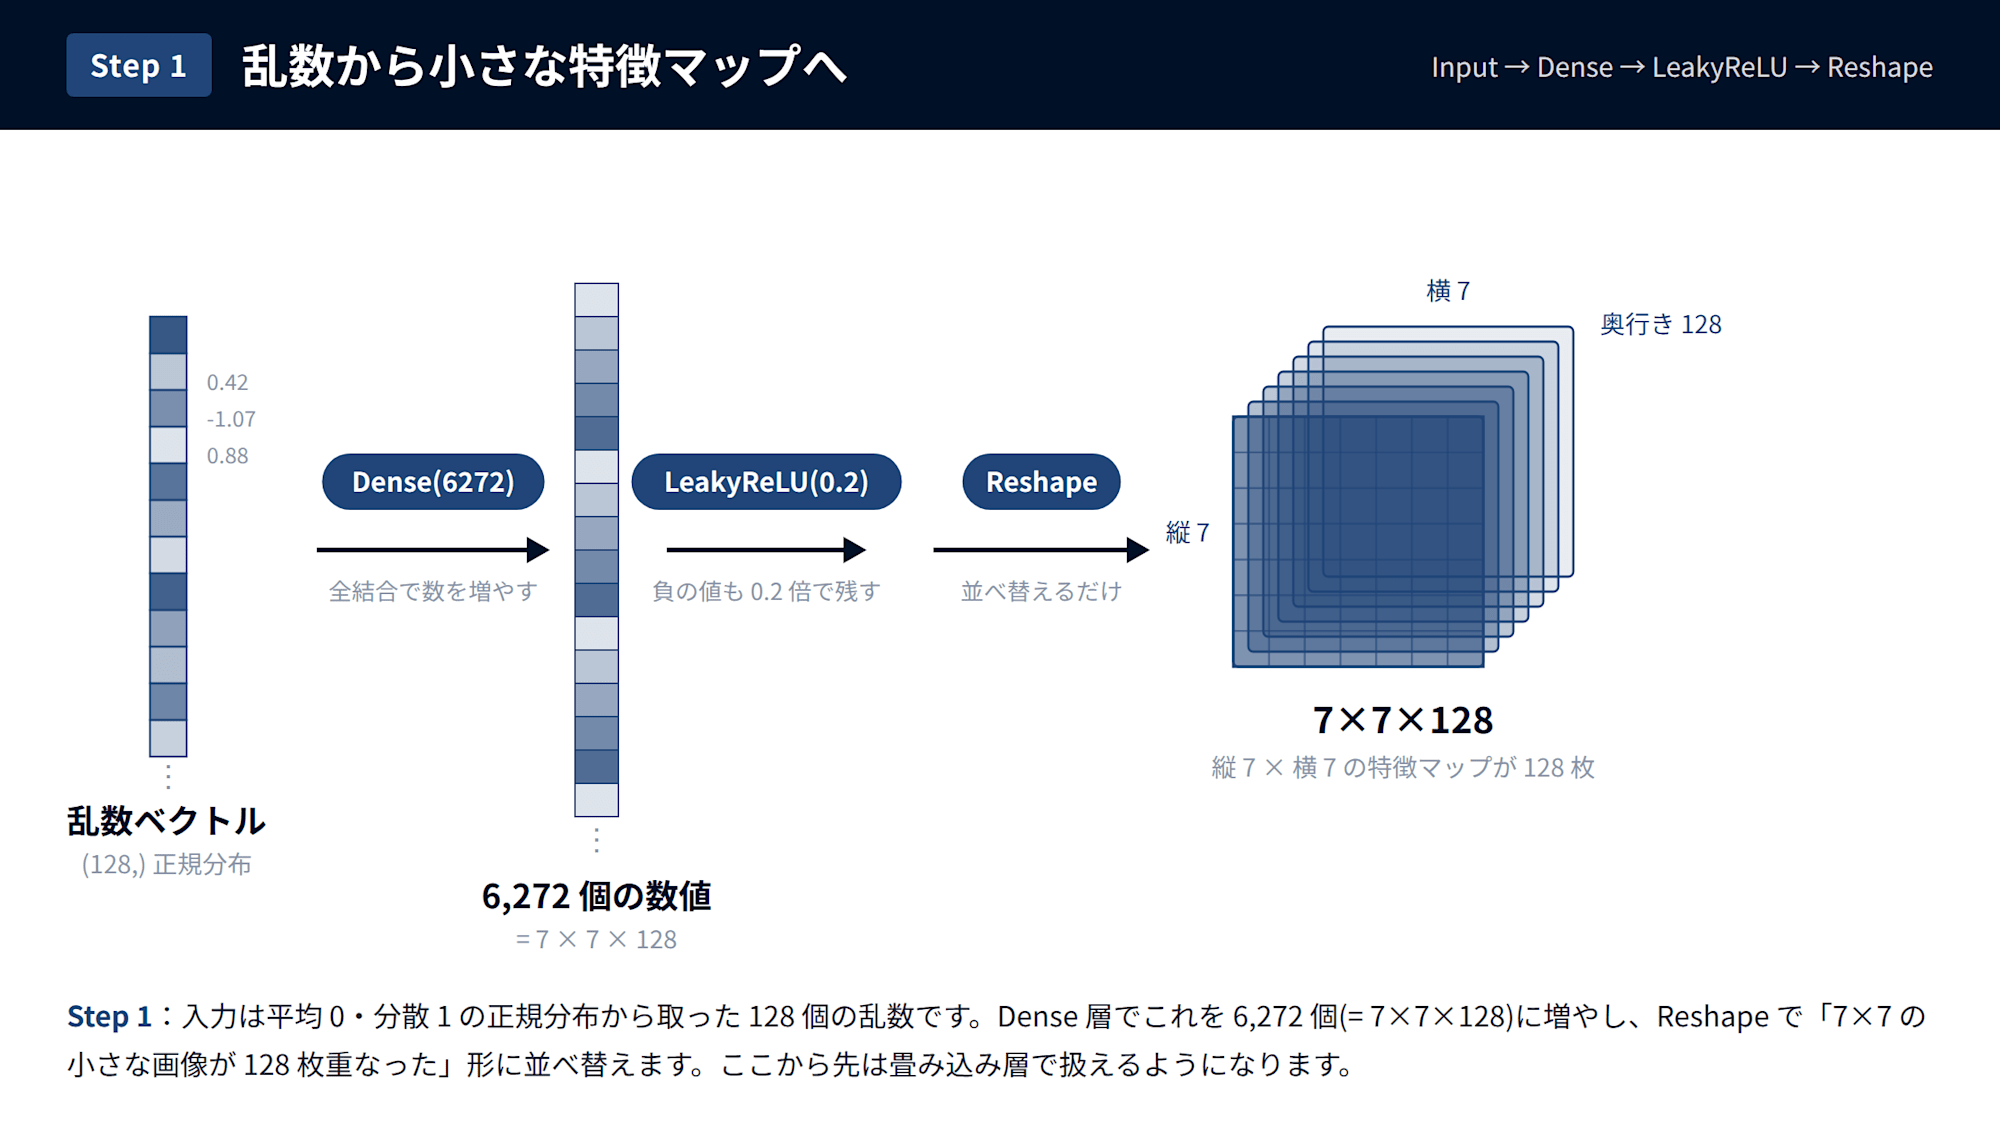
まず初めに、128個の乱数をDenseで 6,272 個(= 7×7×128)の数値に増やし、BatchNormalizationで値の範囲を整えてから、Reshapeで「7×7 の小さな画像が128枚重なった」形に並べ替えます。
この時点ではまだ画像と呼べるものではありませんが、縦・横・チャンネル(重なっている特徴マップの枚数)の3次元の形になったので、ここから先は畳み込み層で扱えます。
DenseやConv2Dに付いているuse_bias=Falseは、出力に一律の値を足す「バイアス」を使わない設定です。
直後のBatchNormalizationが平均を0にそろえ直すため、足した値が打ち消されてしまい、バイアスを持っていても意味がないからです。
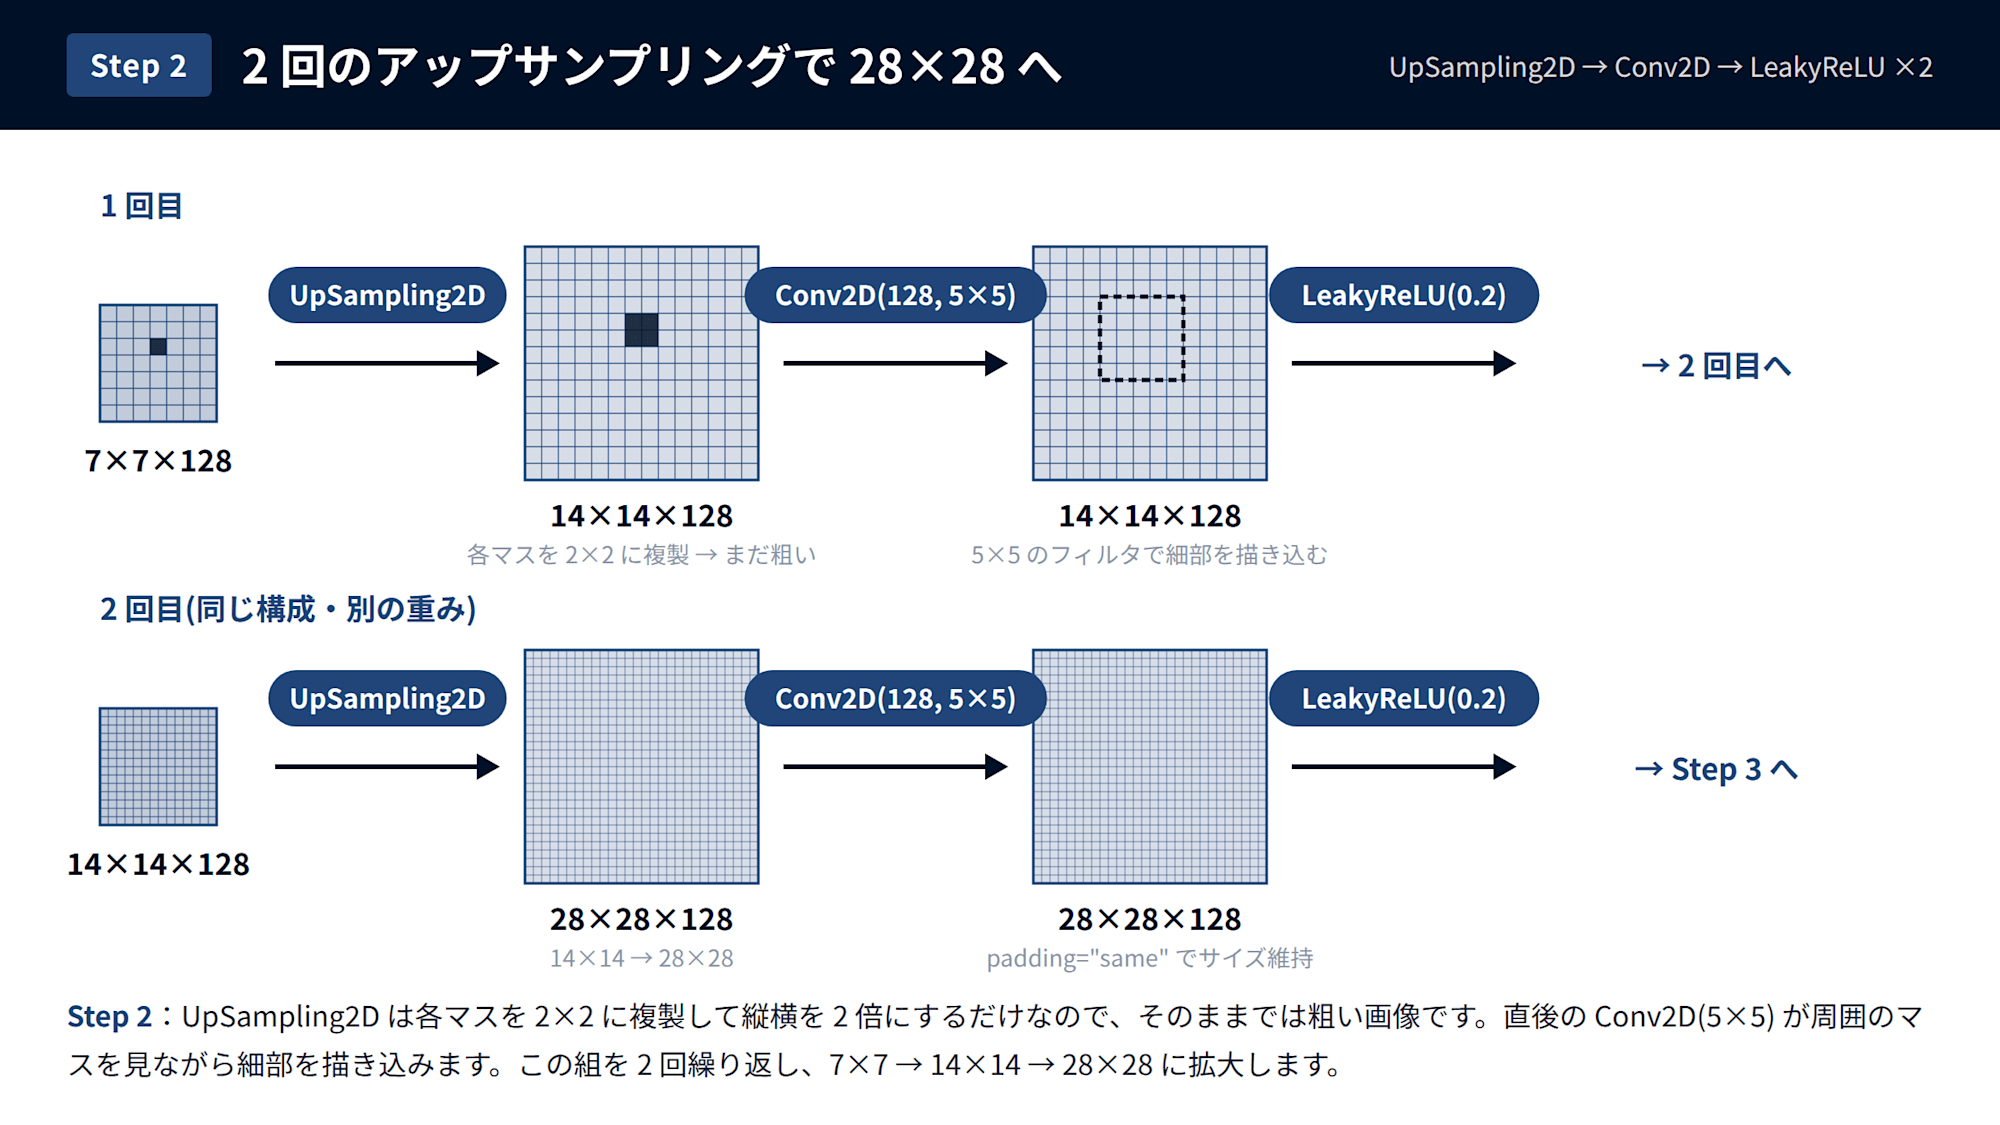
次に、UpSampling2Dという層で、各マスを 2×2 に複製して縦横を2倍にします。
アップサンプリングとは、このように画像の縦横のサイズを大きくする処理です。
ただし複製しただけでは粗い画像なので、直後のConv2Dで、図の点線範囲のように周囲のマスを見ながら細部を描き込みます。
この作業を2回繰り返すことで、7×7 → 14×14 → 28×28 と拡大していき、画像に対する解像度が上がるというわけです。
1回目は128チャンネル、2回目は64チャンネルと、解像度が上がるにつれて特徴マップの枚数を減らしています。サイズが大きくなるほど計算量が増えるので、その分チャンネル数を絞ってバランスを取っています。
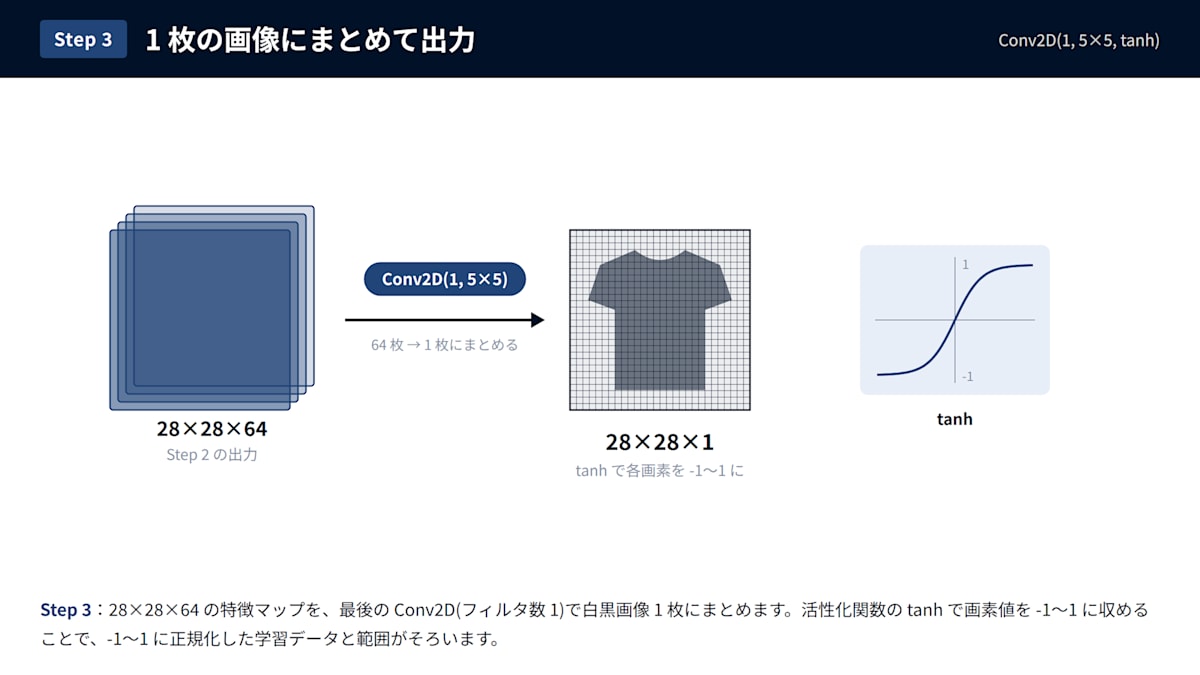
最後に、28×28×64の特徴マップを、最後のConv2Dでフィルタ数1の白黒画像1枚にまとめます。
活性化関数にはtanhを使っていて、画素値を-1〜1の範囲に収めます。これで、-1〜1に正規化した学習データと範囲がそろいます。
各ステップで使っている活性化関数のLeakyReLUは、マイナスの値にも0.2倍の傾きを残して勾配が途切れるのを防ぐもので、GANでよく使われています。
識別器の準備
def build_discriminator() -> Sequential:
    """28x28x1 画像 → 偽物である確率(0=本物, 1=偽物)。"""
    return Sequential(
        [
            layers.Input((28, 28, 1)),
            # 28x28x1 → 14x14x64(stride 2 で縦横を半分に)
            layers.Conv2D(64, 5, strides=2, padding="same"),
            layers.LeakyReLU(0.2),
            layers.Dropout(0.3),
            # 14x14x64 → 7x7x128
            layers.Conv2D(128, 5, strides=2, padding="same"),
            layers.LeakyReLU(0.2),
            layers.Dropout(0.3),
            # 7x7x128 → 6,272 → 1
            layers.Flatten(),
            layers.Dense(1, activation="sigmoid"),
        ],
        name="discriminator",
    )
今回の識別器は、28×28の画像を受け取って「偽物である確率」を1つ出力するモデルです。
全体の流れは次の図の通りで、生成器とはちょうど逆向きに、画像を縮めながら特徴を増やしていきます。
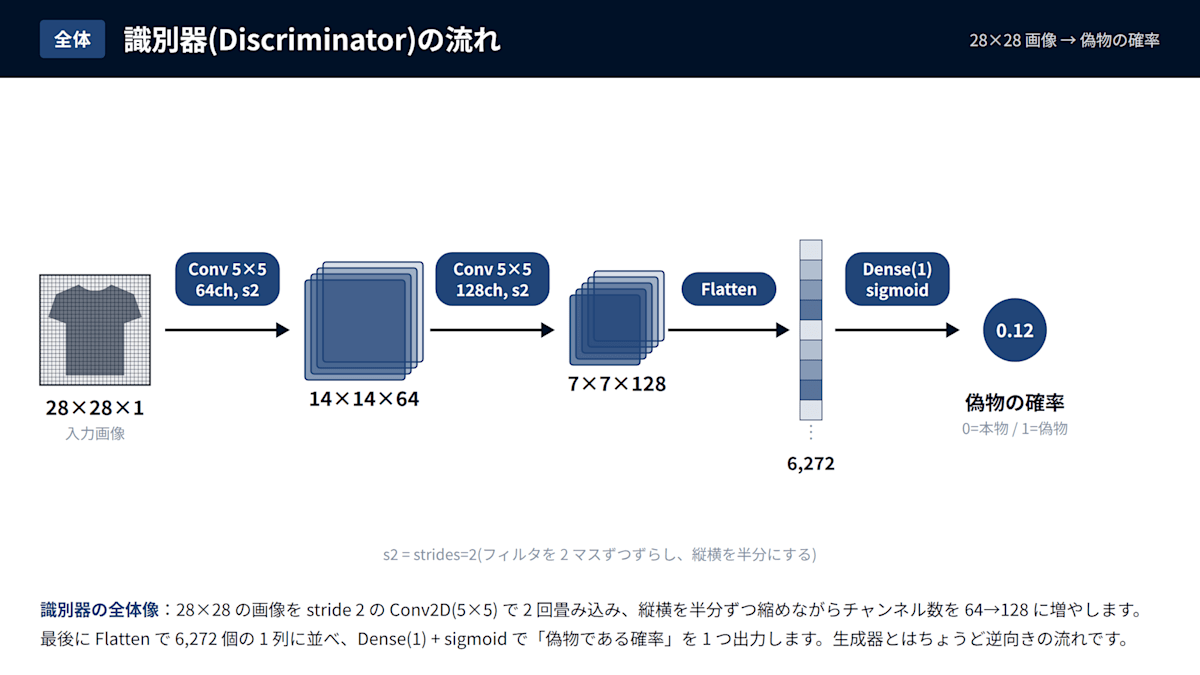
ここで中心になる『畳み込み(Conv2D)』がなにをしているのかというと、小さな窓(フィルタ)を画像の上で少しずつずらしながら、線や角などの特徴を拾い出す処理をしています。
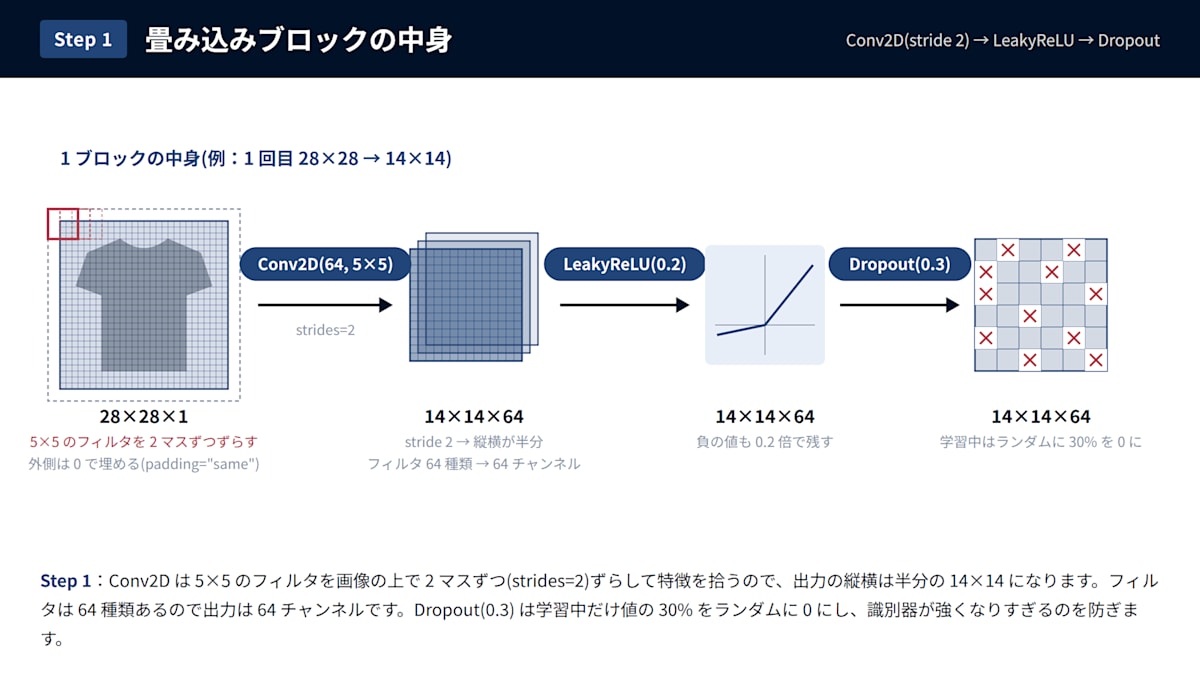
まず、Conv2D、LeakyReLU、Dropoutの3つを1ブロックとして、その中で何が起きているかを見ていきます。
Conv2Dは、5×5のフィルタを画像の上で滑らせて特徴を拾います。
コード上ではstrides(幅)を2、つまりフィルタを1マスずつではなく2マスずつずらしながら計算するようにしていて、そのため出力の縦横は28×28から14×14になります。
Dropoutは、層の出力する値のうちランダムに選んだx%を0にする(ドロップアウトする)仕組みです。
冒頭に「GANを動かすうえで大切なのは2つのモデルのパワーバランス」と言ったように、識別器が学習データを丸暗記して強くなりすぎると生成器が学べなくなるので、こういう仕組みが必要となります。
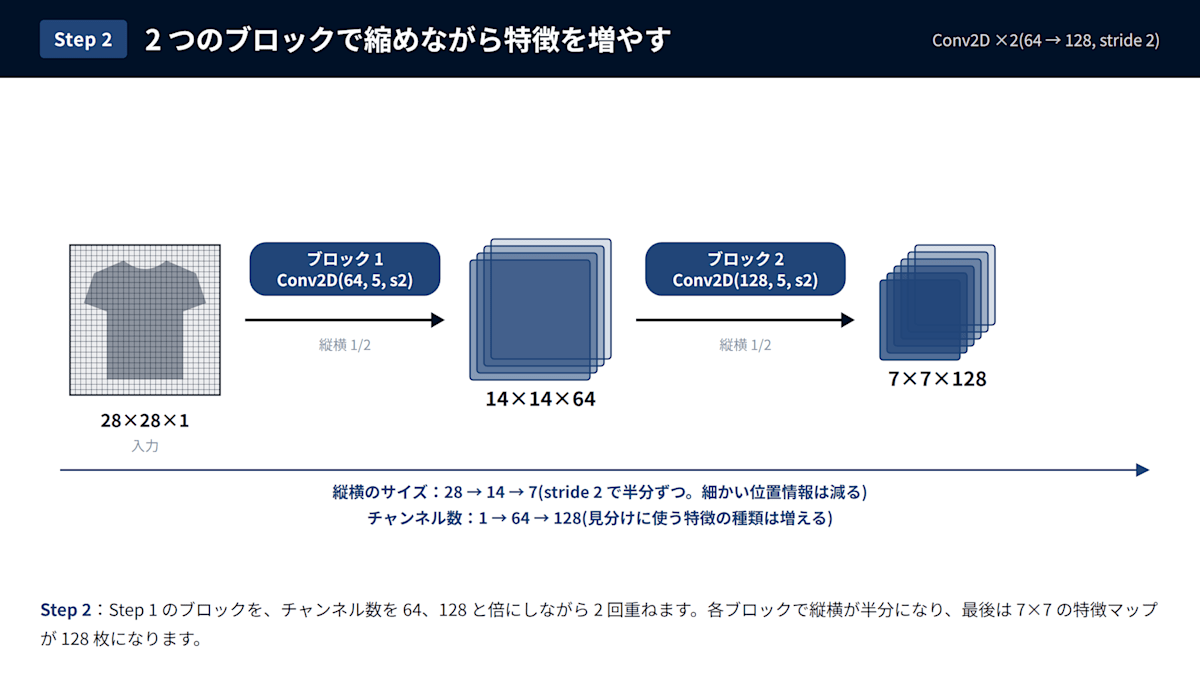
次に、先ほど構築したブロックを、チャンネル数を64、128と倍にしながら2回重ねます。
縦横のサイズは28→14→7と半分ずつ縮む一方で、チャンネル数は1→64→128に増えていきます。
縦横を半分にするとマスの数は4分の1に減るので、その分チャンネル数を増やして、見分けに使う特徴の種類を増やしている、というわけです。
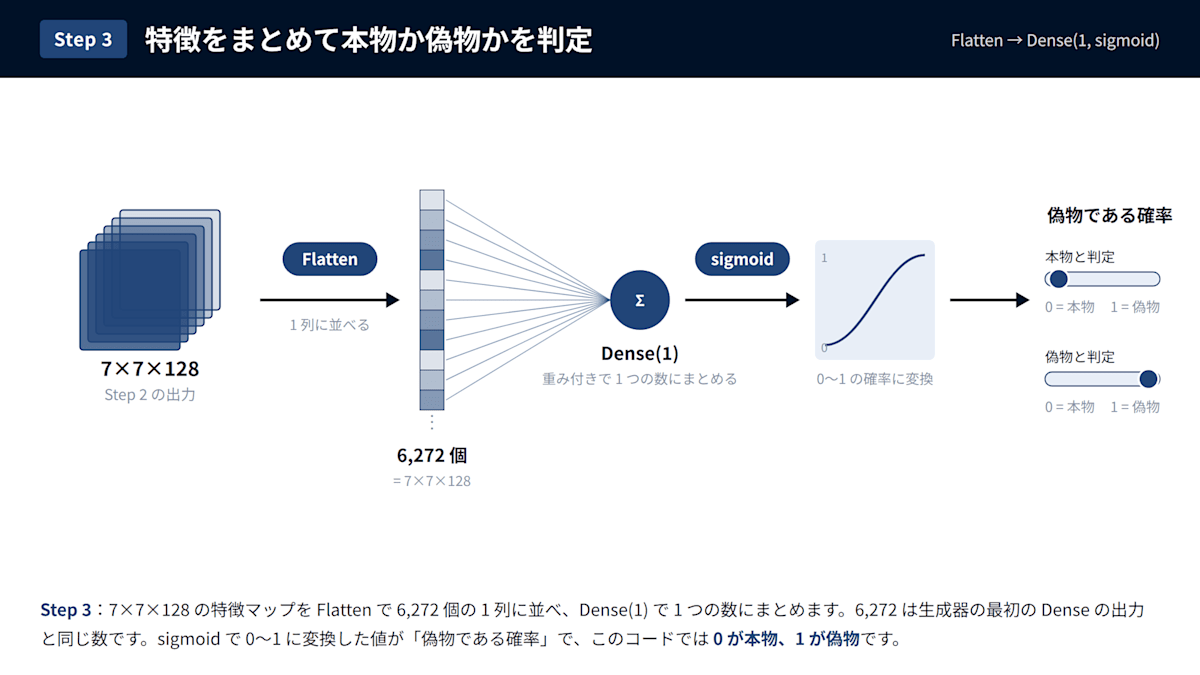
最後に、ここまでで集めた特徴りょうをまとめて最終的な判定を出します。
Flattenは、7×7×128の特徴マップを6,272個の数値の1列に並べ替える層です。
次のDenseはで、1列に並んだ数値にそれぞれ重みをかけて足し合わせる層なので、ベクトル計算ができない状態になります(縦・横・チャンネルの3次元の形では重みを受け取れない)
そこで、計算はせずに並べ方だけを変えて、Denseに渡せる形にするのがFlatten層です。生成器のReshapeとは逆の操作ですが、生成器の最初の6,272個と同じになっています。
その後、Denseで6,272個の数値に重みをかけて足し合わせ、1つの数値にまとめます。
最後のsigmoidで0〜1の範囲に収めて出てくる数値が「画像が偽物である確率」を表すようになっています。
シグモイド関数は0か1の2択ではなく、0.12や0.87のような中間の値も出す非線形な層なので、「どれくらい偽物らしいか」という度合いをグラデーションで表すことができます。
学習ステップの準備
# ---------------------------------------------------------------- GAN
class GAN(Model):
    """生成器と識別器を交互に学習させる。ラベルは 0=本物, 1=偽物。"""

    def __init__(self, generator, discriminator):
        super().__init__()
        self.g, self.d = generator, discriminator
        self.g_opt = optimizers.Adam(2e-4, beta_1=0.5)
        self.d_opt = optimizers.Adam(2e-4, beta_1=0.5)
        self.bce = losses.BinaryCrossentropy()
        # 損失をエポック内で平均するための入れ物(エポックの頭で自動リセットされる)
        self.d_loss_tracker = metrics.Mean(name="d_loss")
        self.g_loss_tracker = metrics.Mean(name="g_loss")
        self.compile()

        # 途中保存の対象: 重み、Adam の内部状態、終わったエポック数
        self.epoch = tf.Variable(0, dtype=tf.int64)
        self.ckpt = tf.train.Checkpoint(
            g=self.g, d=self.d, g_opt=self.g_opt, d_opt=self.d_opt, epoch=self.epoch
        )
        self.ckpt_manager = tf.train.CheckpointManager(self.ckpt, f"{OUT}/ckpt", max_to_keep=3)

    @property
    def metrics(self):
        return [self.d_loss_tracker, self.g_loss_tracker]

    def save_ckpt(self):
        self.ckpt_manager.save()

    def restore(self) -> int:
        """新しい保存から順に読み込みを試し、終わったエポック数を返す。保存がなければ 0。"""
        for path in reversed(self.ckpt_manager.checkpoints):
            try:
                self.ckpt.restore(path).expect_partial()
                print(f"resumed from {path} (epoch {int(self.epoch)} done)")
                return int(self.epoch)
            except Exception as e:  # 書き込み途中で落ちて壊れた保存は飛ばす
                print(f"skip broken checkpoint {path}: {e}")
        self.epoch.assign(0)
        return 0

    def train_step(self, real):
        n = tf.shape(real)[0]
        noise = lambda: tf.random.normal((n, NOISE_DIM))

        # 識別器: 本物→0, 偽物→1 と判定できるように
        # 本物のラベルだけ 0〜0.1 にずらし、識別器の自信過剰を抑える(片側ラベルスムージング)
        # 生成器は BatchNormalization を学習時と同じ動きにするため training=True で呼ぶ(重みは更新しない)
        fake = self.g(noise(), training=True)
        with tf.GradientTape() as tape:
            pred = tf.concat([self.d(real, training=True), self.d(fake, training=True)], 0)
            label = tf.concat([0.1 * tf.random.uniform((n, 1)), tf.ones((n, 1))], 0)
            d_loss = self.bce(label, pred)
        self.d_opt.apply_gradients(zip(tape.gradient(d_loss, self.d.trainable_variables), self.d.trainable_variables))

        # 生成器: 自分の画像を識別器に「本物(0)」と誤判定させるように
        with tf.GradientTape() as tape:
            pred = self.d(self.g(noise(), training=True), training=False)
            g_loss = self.bce(tf.zeros_like(pred), pred)
        self.g_opt.apply_gradients(zip(tape.gradient(g_loss, self.g.trainable_variables), self.g.trainable_variables))

        self.d_loss_tracker.update_state(d_loss)
        self.g_loss_tracker.update_state(g_loss)
        return {"d_loss": self.d_loss_tracker.result(), "g_loss": self.g_loss_tracker.result()}
GANクラスは、生成器と識別器をまとめて、Kerasのfit関数で学習できるようにしたくて作りました。
KerasのModelクラスを継承し、train_stepをオーバーライドしているので、fit()を呼ぶだけで、バッチごとにGAN独自の学習が実行されます。全体の流れは次の図の通りです。
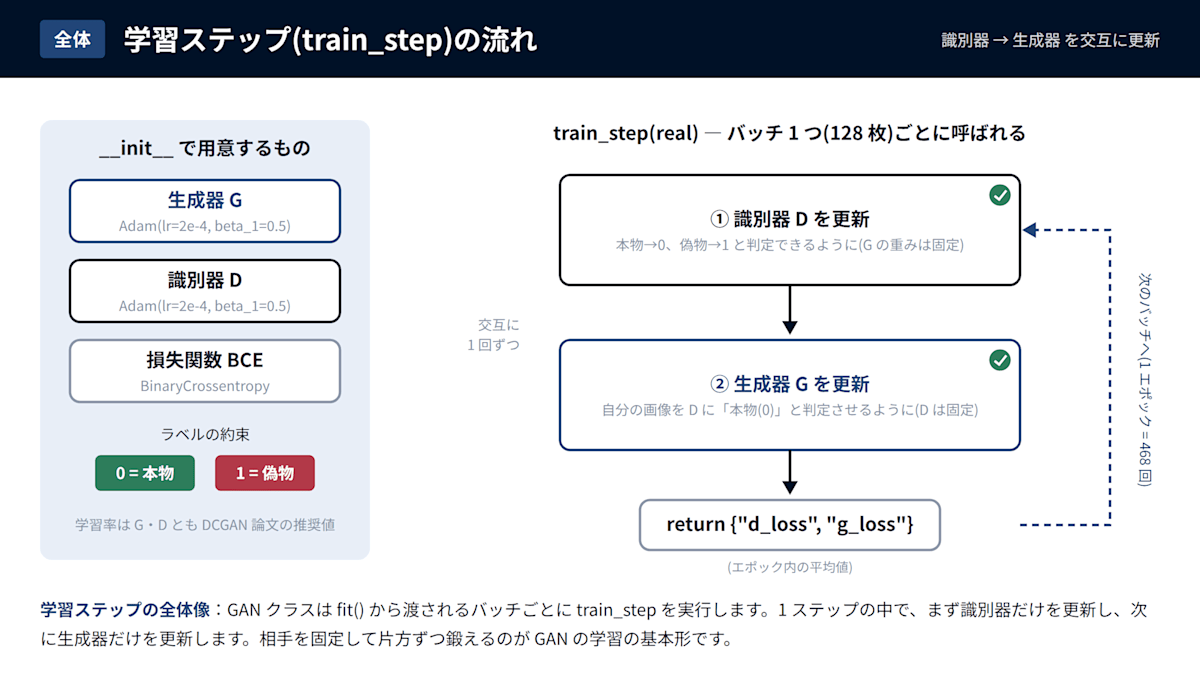
ここでの『損失(loss)』がなにをしているのかというと、「モデルの答えが正解からどれくらいずれているか」を1つの数値で表しています。
AIモデルにおける学習とは、すなわちこの損失が小さくなる方向へ重みを少しずつ動かすことです。
まず図の左の__init__では、学習に使う道具を用意しています。
生成器と識別器にそれぞれ別の最適化手法(Adam)を用意し、学習率はどちらも2e-4(0.0002)です。
beta_1=0.5は、Adamが「過去の勾配の向きをどれくらい引きずるか」を決める値で、標準の0.9より小さくしています。GANでは相手のモデルが毎回少しずつ変わるので、過去の向きに引っ張られすぎず、今の状況に素早く合わせられるようにするためです。
損失関数は、2つに分類する問題でよく使うバイナリクロスエントロピー(BCE)です。ラベルは0が本物、1が偽物という約束で進めます。
d_loss_trackerとg_loss_trackerは、損失をエポック内で平均するための入れ物です。1バッチごとの損失は上下に揺れやすいので、エポック全体の平均で推移を見られるようにしています。
図の右がtrain_stepの中身で、1つのバッチ(128枚)に対して「識別器の更新」と「生成器の更新」を1回ずつ、この順番で行います。
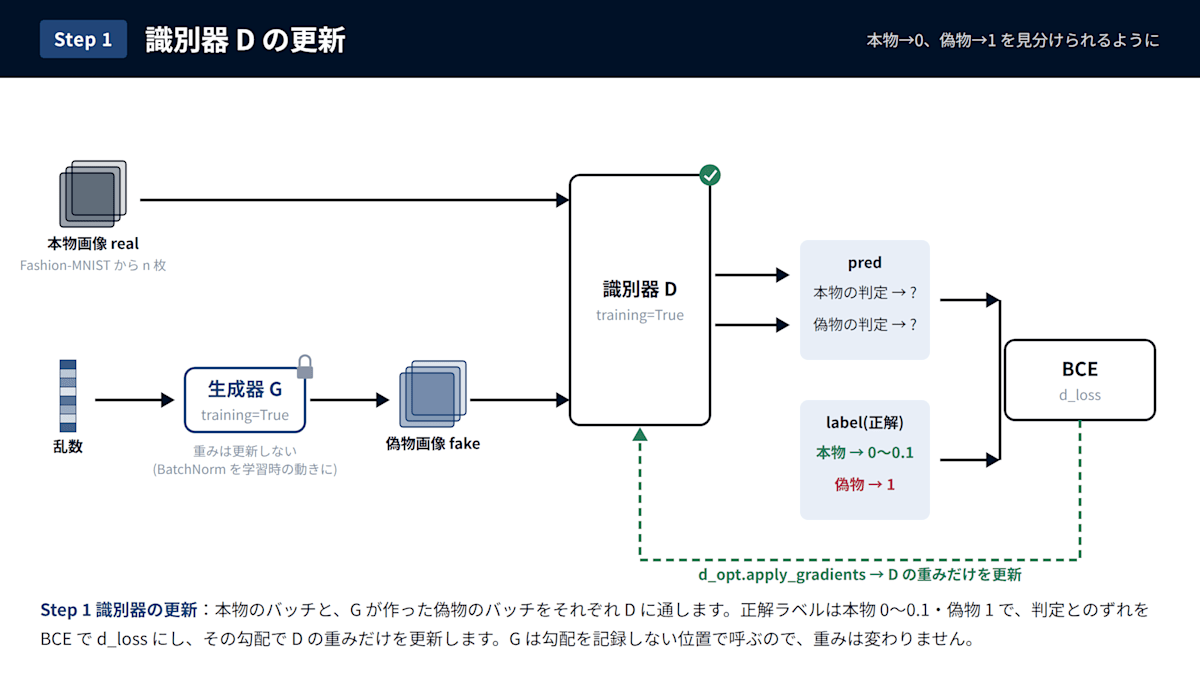
学習ステップの最初に、識別器を更新します。
図の上段が本物画像、下段が偽物画像の流れで、どちらも識別器に通して判定(pred)を出させます。
偽物画像を作る生成器は、勾配を記録するtapeの外で呼んでいるので、この段階では生成器の重みは一切変わりません。
training=Trueで呼んでいるのは、生成器の中のBatchNormalizationを学習時と同じ動き(今のバッチの平均とばらつきで値を整える動き)にするためです。
正解ラベルは本物が0、偽物が1としています。
そのうえで、本物のラベルだけを0〜0.1の範囲にランダムにずらしています。識別器が「絶対に本物」と断定しすぎないようにするためで、専門用語ではラベルスムージング(Label Smoothing)と呼ばれる工夫になります。
判定と正解ラベルのずれをBCEで数値にしたものがd_lossです。
tape.gradientで「どの重みをどちらに動かせばd_lossが減るか」を求め、図の緑の破線のように識別器の重みだけを更新します。
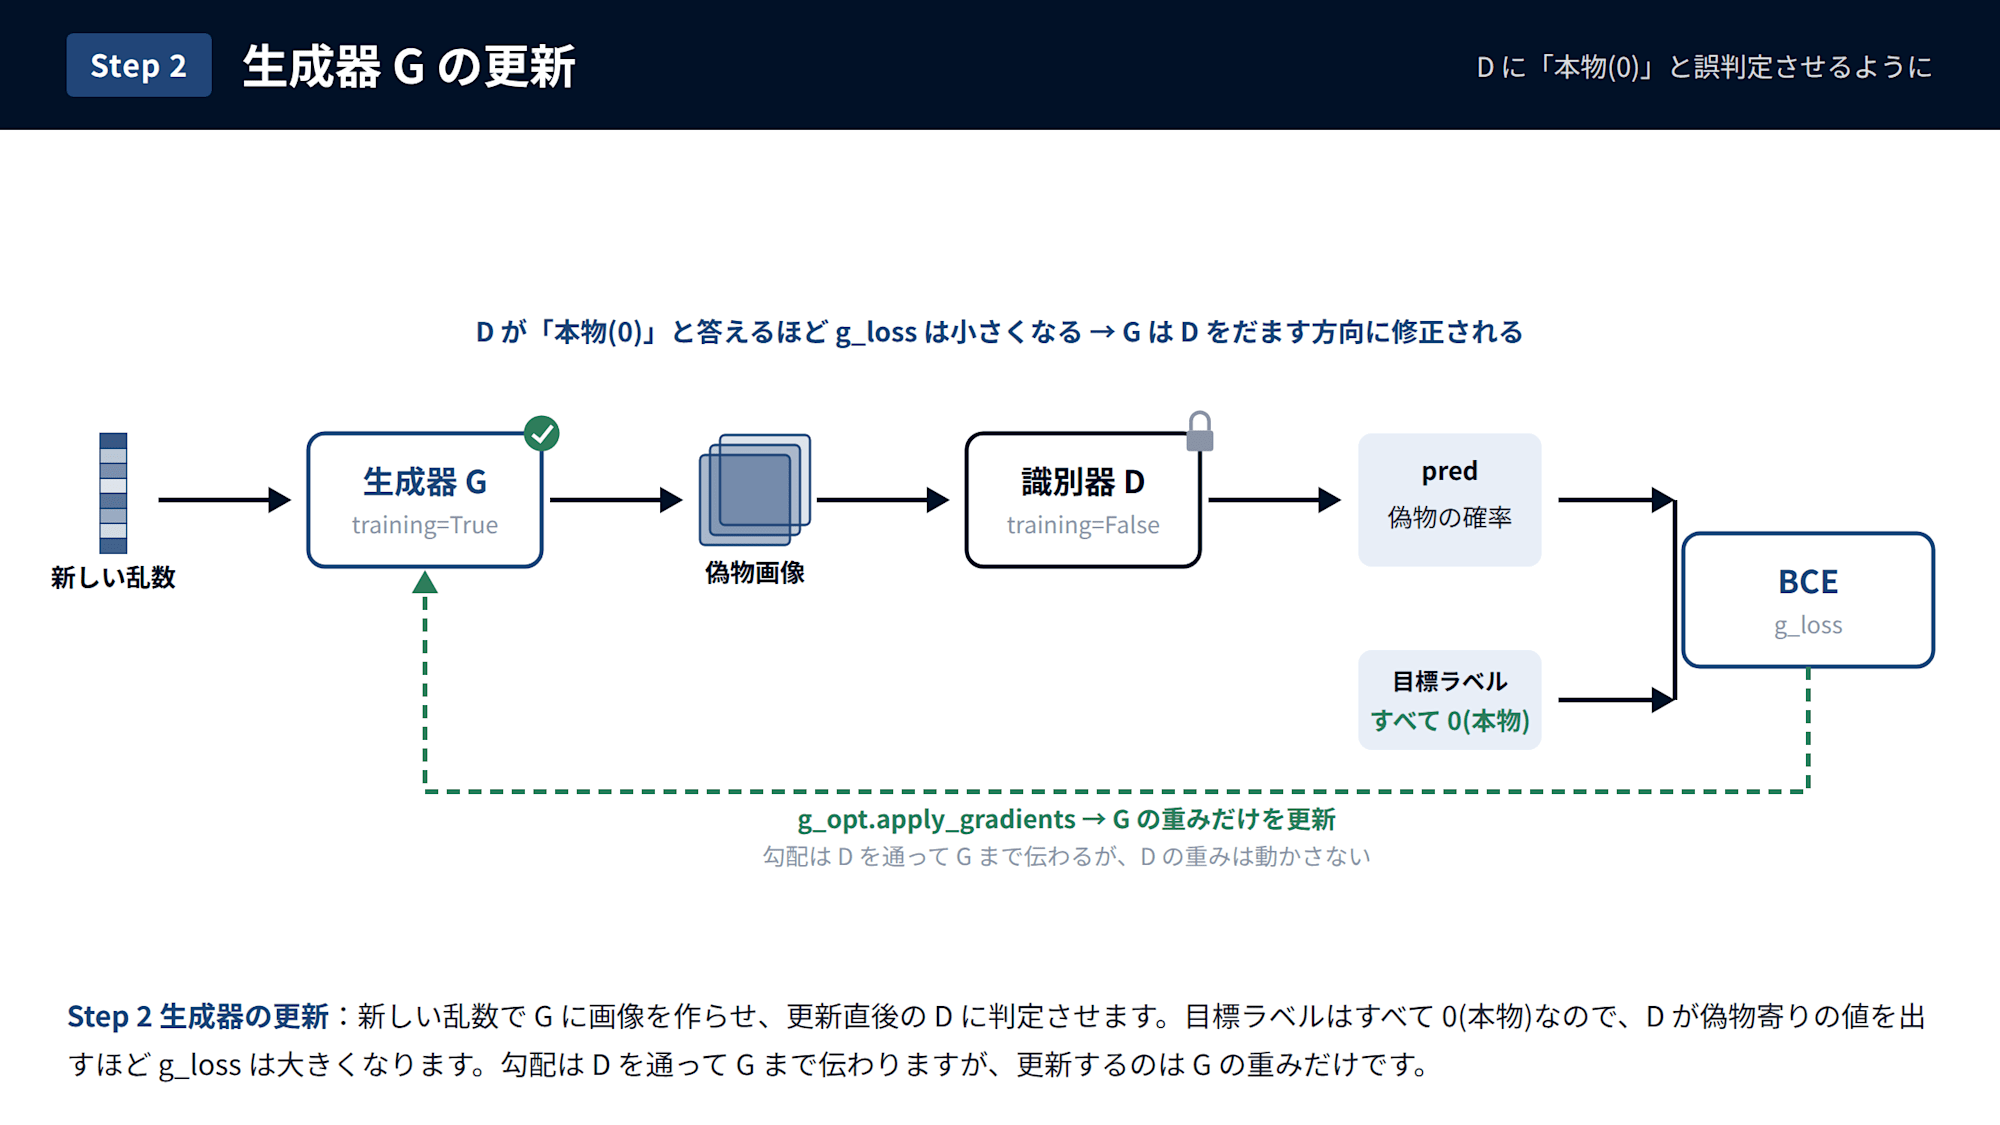
識別器の次は、生成器を更新します。
新しい乱数で生成器に画像を作らせ、Step1で更新した直後の識別器に判定させます。
今度は識別器の方をtraining=Falseで呼ぶので、識別器のDropoutも無効になります。
目標ラベルは「すべて0(本物)」になります。
識別器が偽物寄りの値を出すほどg_lossは大きくなるので、生成器は識別器をだます方向に修正されます。
図の緑の破線のように、勾配は識別器を通って生成器まで伝わりますが、更新するのは生成器の重みだけになります。
ここで思い出してほしいのですが、生成器は本物の服の画像を一度も見ていないというのは覚えていますか?
それにもかかわらず生成器が服らしい画像を生成できるようになるのは、本物を見て学んだ識別器の判定を手がかりに重みを直しているからです。
例えるなら、手本の絵を見られるのは先生(識別器)だけで、生徒(生成器)は先生の赤ペンだけを頼りに絵を上達させていくようなものです。
先生の腕が上達しなければ赤ペン採点も的外れになり、生徒は上達しません。逆に先生が厳しすぎて何を描いても全部バツだと、生徒はどこを直せばいいのか分からなくなります。
冒頭で「GANを動かすうえで大切なのは2つのモデルのパワーバランス」とお話ししたのは、まさにこの関係があるからです。
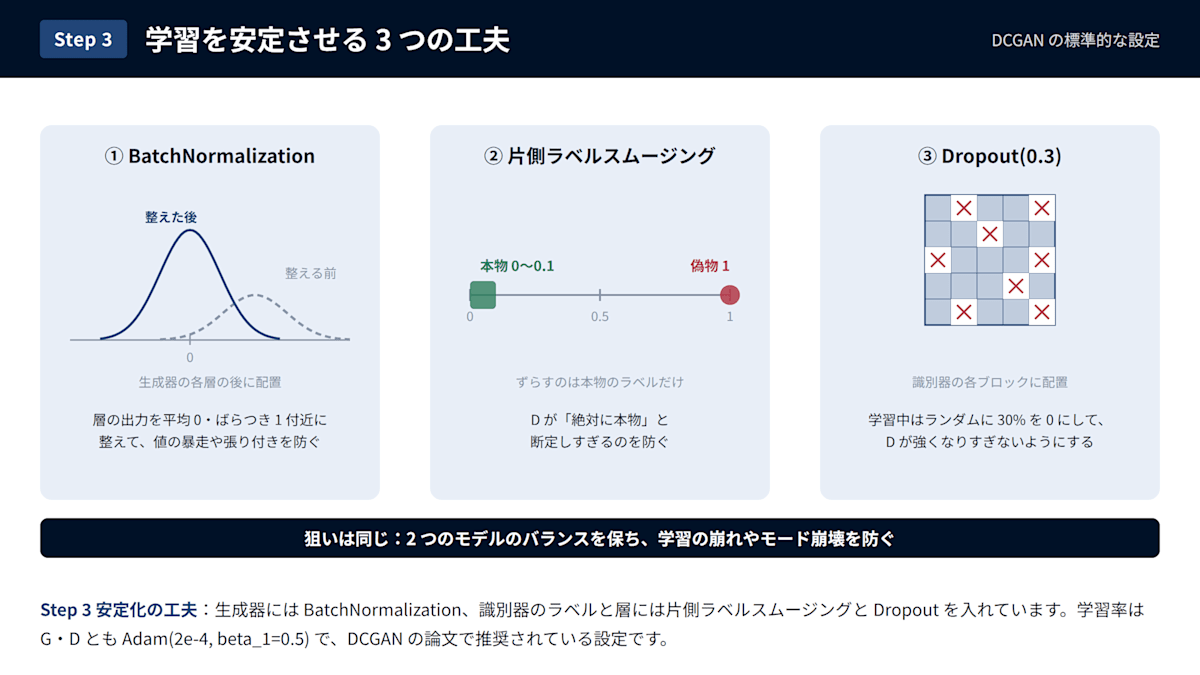
ここまでに出てきた学習を安定させるための工夫をまとめておきます。
- 生成器の各層に
BatchNormalizationを入れて、値の範囲を整えること - 本物のラベルだけを少しずらす、ラベルスムージング
- 識別器に
Dropoutを入れて、識別器が強くなりすぎないようにすること
実行
# ---------------------------------------------------------------- 可視化・保存
# 経過観察用の乱数。毎回同じ値なので、エポックごとに「同じ服」がどう育つかを追える
FIXED_NOISE = tf.random.Generator.from_seed(0).normal((16, NOISE_DIM))

def save_grid(generator, path, noise=None, rows=4, cols=4):
    """生成画像を rows x cols のグリッドにして保存。noise を省略すると毎回ランダム。"""
    if noise is None:
        noise = tf.random.normal((rows * cols, NOISE_DIM))
    imgs = generator(noise, training=False)
    fig, axes = plt.subplots(rows, cols, figsize=(cols * 2, rows * 2))
    for ax, img in zip(axes.flat, imgs):
        # 明るさの範囲を -1〜1 に固定(自動調整だと、崩れた画像でも模様があるように見えてしまう)
        ax.imshow(img[..., 0], cmap="gray", vmin=-1, vmax=1)
        ax.axis("off")
    fig.savefig(path, bbox_inches="tight")
    plt.close(fig)

class Saver(callbacks.Callback):
    """数十ステップごとと、エポック終了時に途中保存する。損失は CSV に追記する。"""

    def on_train_batch_end(self, batch, logs=None):
        if (batch + 1) % SAVE_EVERY_STEPS == 0:
            self.model.save_ckpt()

    def on_epoch_end(self, epoch, logs=None):
        save_grid(self.model.g, f"{OUT}/epoch_{epoch + 1:04d}.png", noise=FIXED_NOISE)
        with open(f"{OUT}/loss.csv", "a", newline="") as f:
            csv.writer(f).writerow([epoch + 1, float(logs["d_loss"]), float(logs["g_loss"])])
        self.model.epoch.assign(epoch + 1)
        self.model.save_ckpt()

def plot_loss():
    """loss.csv 全体からグラフを描く(再開をまたいでも途切れない)。"""
    if not os.path.exists(f"{OUT}/loss.csv"):
        return
    with open(f"{OUT}/loss.csv") as f:
        rows = [list(map(float, r)) for r in csv.reader(f) if r]
    plt.figure()
    plt.plot([r[0] for r in rows], [r[1] for r in rows], label="d_loss")
    plt.plot([r[0] for r in rows], [r[2] for r in rows], label="g_loss")
    plt.xlabel("epoch")
    plt.legend()
    plt.savefig(f"{OUT}/loss.png")
    plt.close()

# ---------------------------------------------------------------- 実行
if __name__ == "__main__":
    gan = GAN(build_generator(), build_discriminator())
    start = gan.restore()

    # Ctrl+C や通常の終了シグナルが来たら、保存してから止める(Ctrl+C は 1 回押して数秒待つ)
    def on_signal(signum, frame):
        print(f"\nsignal {signum}: saving checkpoint...")
        gan.save_ckpt()
        sys.exit(0)

    signal.signal(signal.SIGINT, on_signal)
    signal.signal(signal.SIGTERM, on_signal)

    if start < EPOCHS:
        gan.fit(load_dataset(), initial_epoch=start, epochs=EPOCHS, shuffle=False, callbacks=[Saver()])
    else:
        print(f"already trained {start} epochs")

    plot_loss()
    save_grid(gan.g, f"{OUT}/result.png")
    gan.g.save(f"{OUT}/generator.keras")
    gan.d.save(f"{OUT}/discriminator.keras")
    print(f"done → {OUT}/")
いよいよ実行です。
※ここでは学習そのものに加えて、途中経過を目で見られるようにする仕組みと、途中保存の仕組みを用意しています。PCを閉じてしまってもRUNしつづけられる仕組みが欲しかったので。
学習が終わったら、損失の推移グラフ(loss.png)、最終的な生成画像(result.png)、生成器と識別器のモデル(.keras)をoutputフォルダに保存します。
実行結果
Mac(CPUのみ)で20エポック学習させたところ、1エポックあたり約4.5分、全体で約1時間35分かかりました。
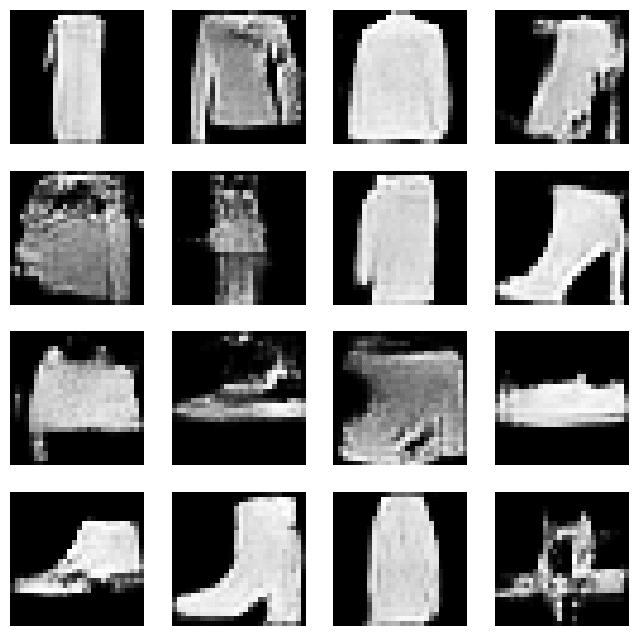
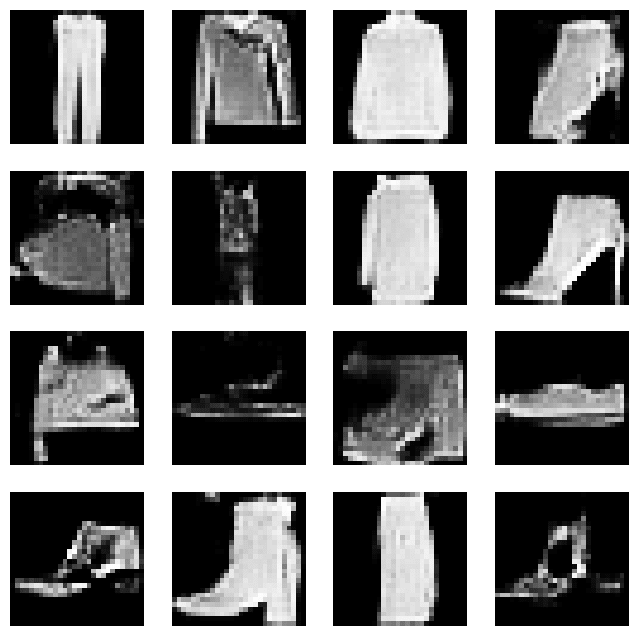
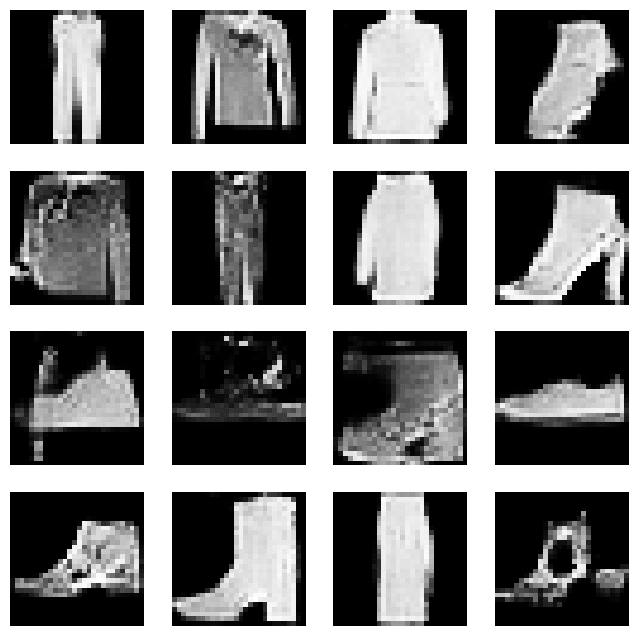
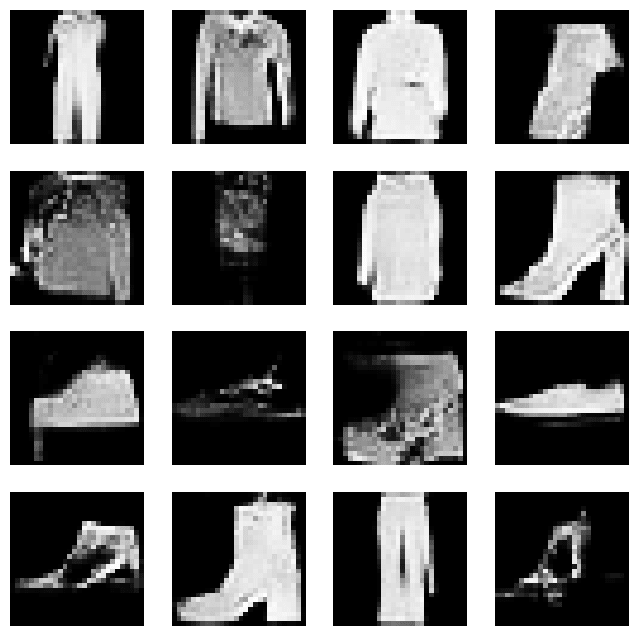
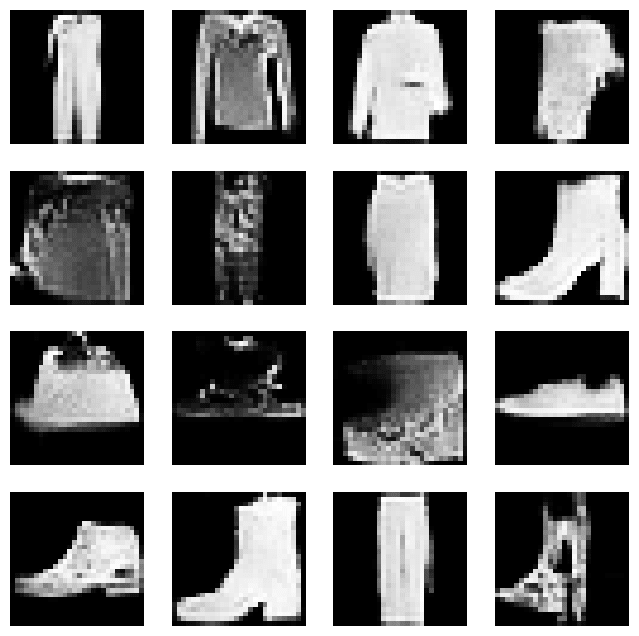
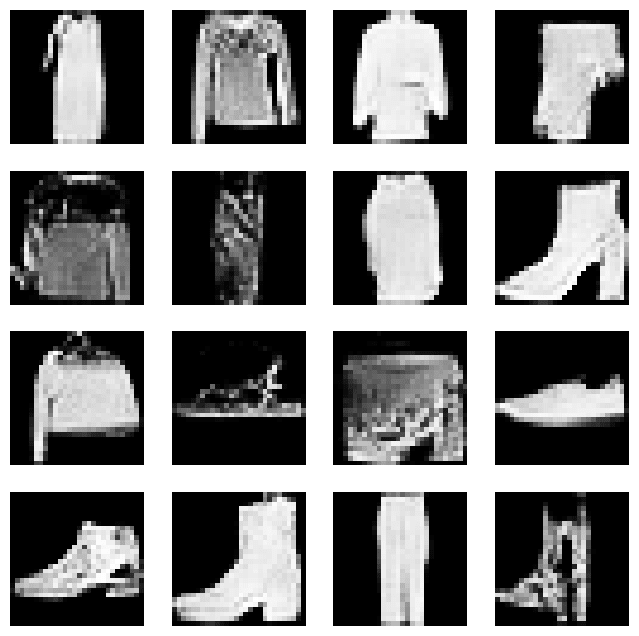
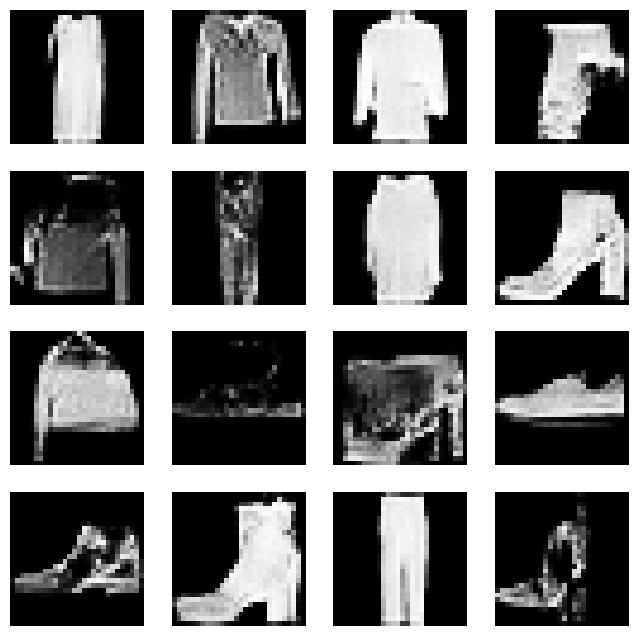
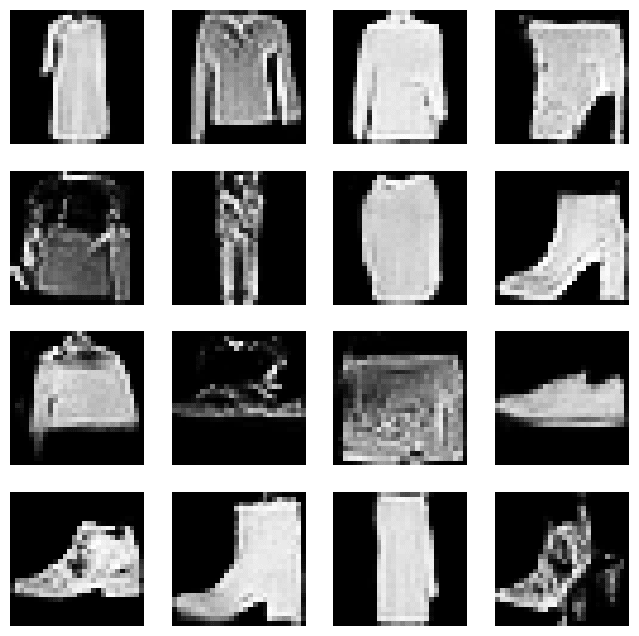
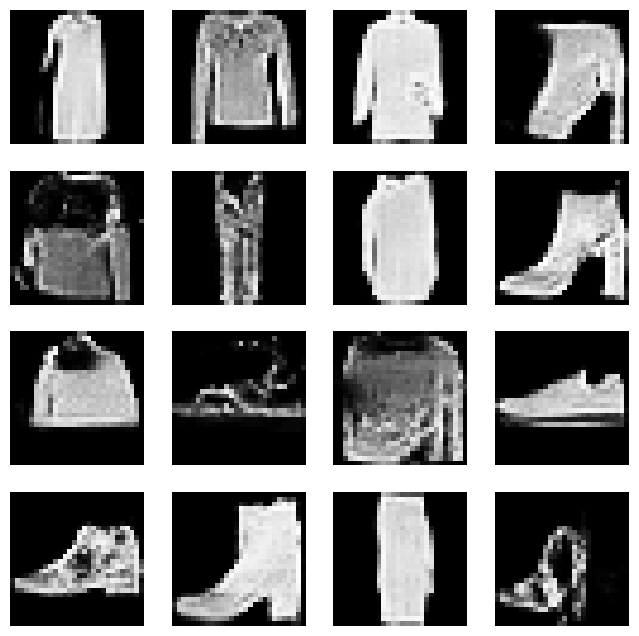
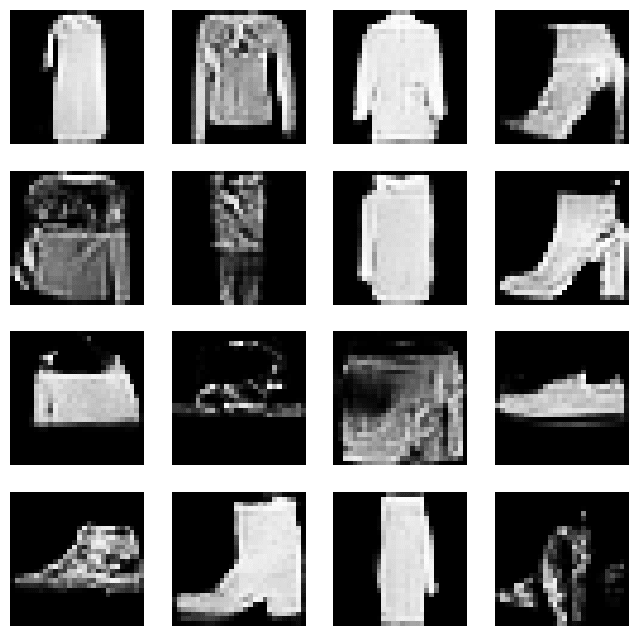
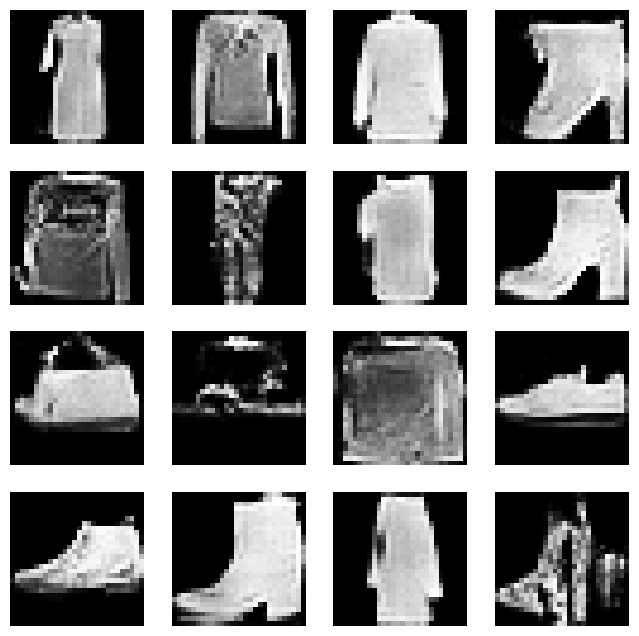
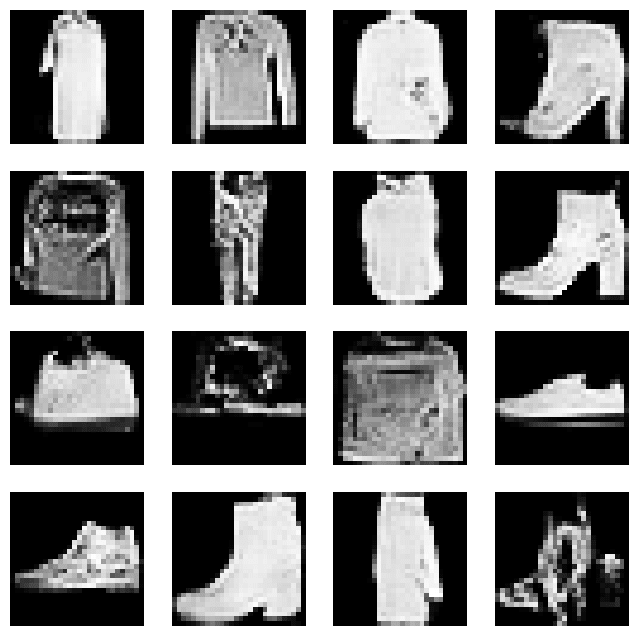
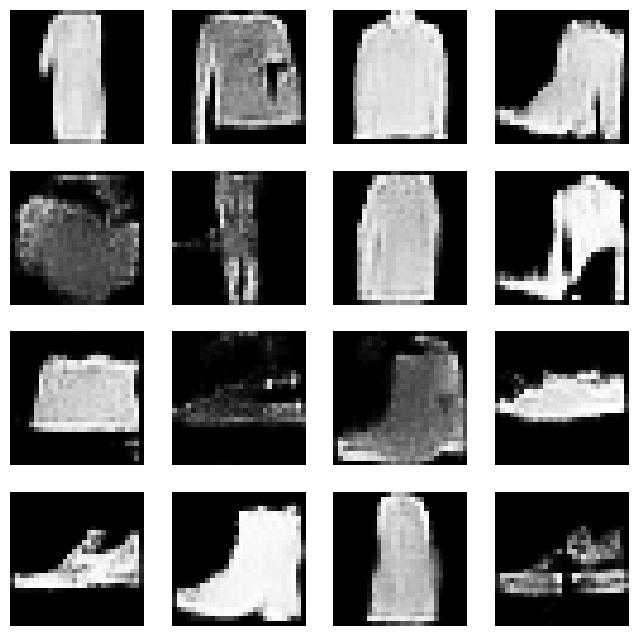
まずは、同じ16個の乱数から生成した画像が、エポックごとにどう変わったかを見てみます。
1エポック目はぼんやりした白い塊で、なんか気持ち悪いですね。
ただ、16枚がそれぞれ違う形をしていて、この時点ですでに乱数ごとに違うものを作ろうとしているのがわかります。
3エポック目ですでに服だと分かるようになりました。ズボン、長袖シャツ、スニーカー、ブーツ、ハイヒール、バッグ、ワンピースなどが見分けられます。
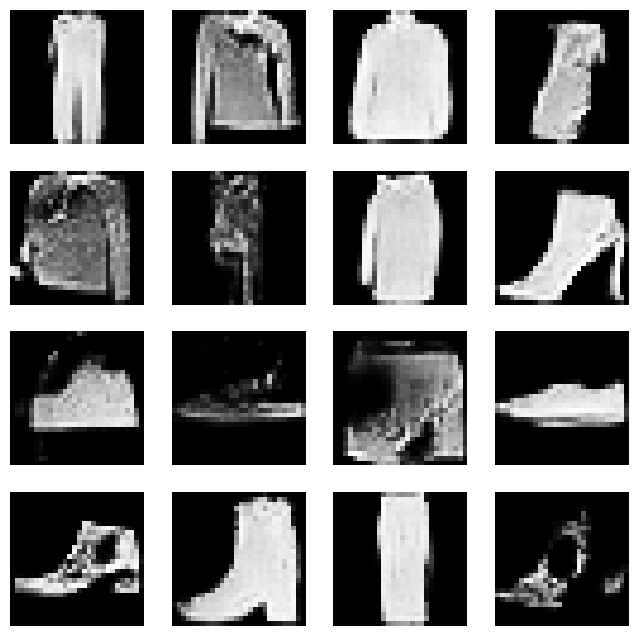
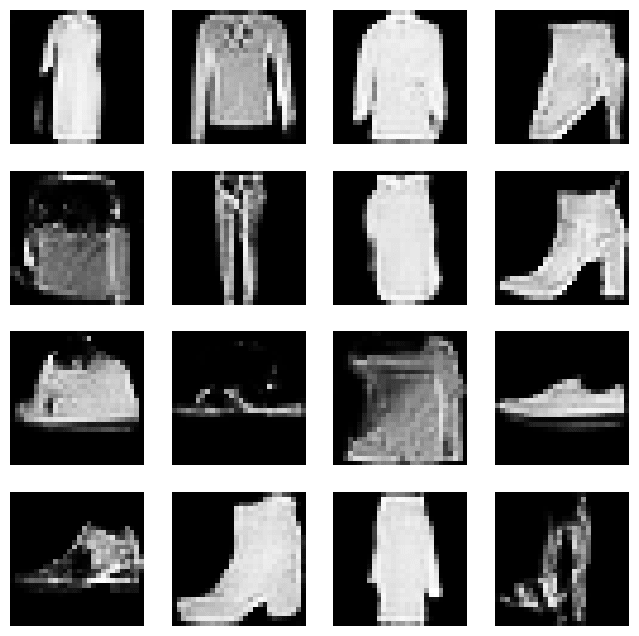
9エポック目以降は、服の種類はほぼ変わらず、細部が整っていく段階に入ったようですね。
そして最後の20エポック目では、ズボンの2本の脚がはっきり分かれ、ブーツのかかとやスニーカーの輪郭もくっきりしました。
最後に、下記の画像が学習後のモデルに毎回ランダムな乱数を入れて生成した画像です。
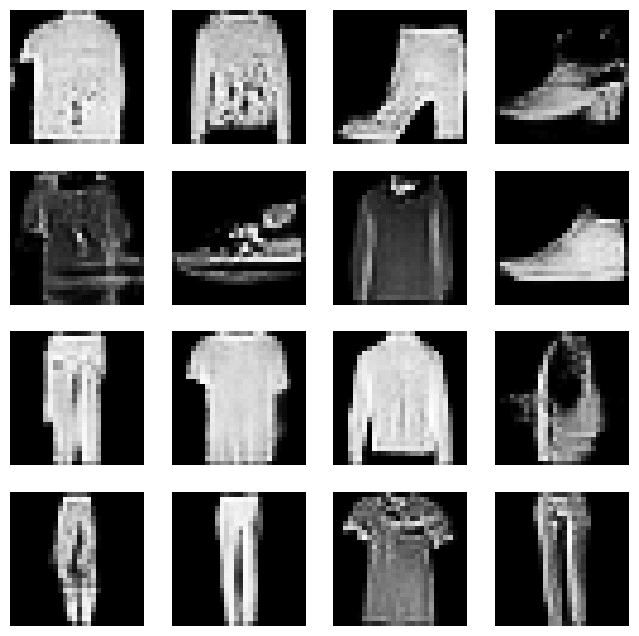
さまざまな種類の服が混ざって出てきています。「モード崩壊」もなし。
一方で、、、サンダルのように細かい形の画像はまだノイズっぽく、28×28の小さなモデルの限界も垣間見えますね。
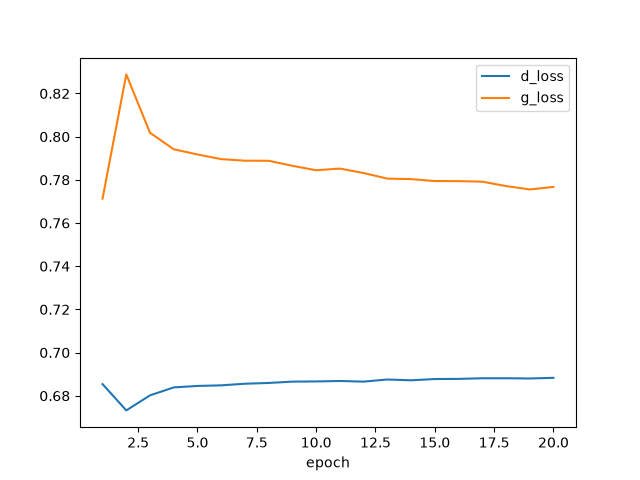
損失の推移は最初の2〜3エポックで少し揺れた後、とても安定しているように見えます。
つまり、識別器が本物と偽物をほとんど見分けられない**、GANが理想とする状態に近づいていること**がグラフからも読み取れます。
GANは2つのモデルが競い合うので、一般的な機械学習のように損失が0に向かって下がり続けることはありません。
逆に、画像分類や認識機能を作りたい場合はこのlossをできるだけ低くするアプローチが望ましいでしょう。
まとめ
今回は、GANを使って実在しない服の画像を生成するモデルを作りました。
結果としては、GPUを使わないMacでも20エポック・約1時間半で、服の種類が見分けられる画像を生成できました。
今の画像生成AIは拡散モデルが主流で規模も今回とは大きく違いますが、それでも、乱数から画像を作り、学習データを手本にそれらしい画像を作るという考え方は共通しています。
小さなモデルを一度動かしておくと、大きな画像生成AIの仕組みを学ぶときの足がかりになると思います。
参考文献
- Generative Adversarial Networks(Goodfellow et al., 2014)
- Unsupervised Representation Learning with Deep Convolutional Generative Adversarial Networks(Radford et al., 2015)
- zalandoresearch/fashion-mnist - GitHub
- 深層畳み込み敵対的生成ネットワーク(DCGAN) - TensorFlow Core
APPENDIX
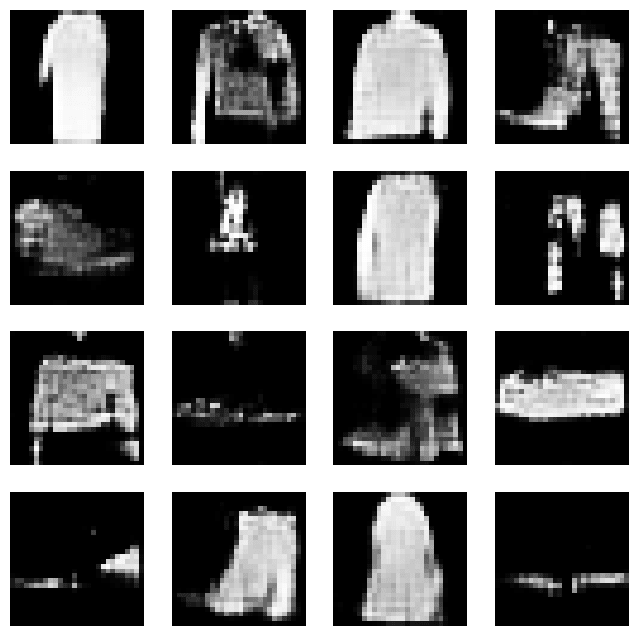
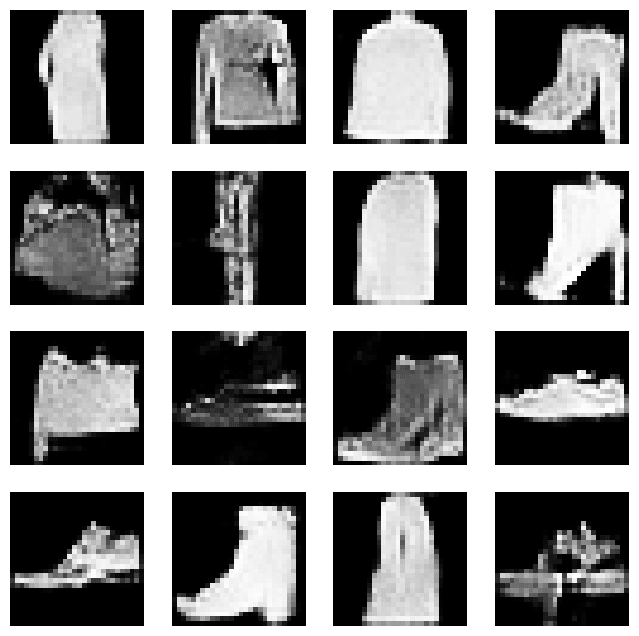
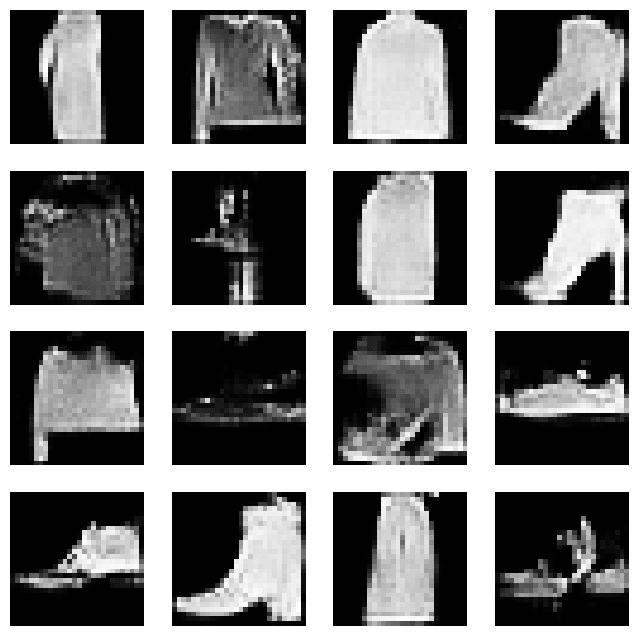
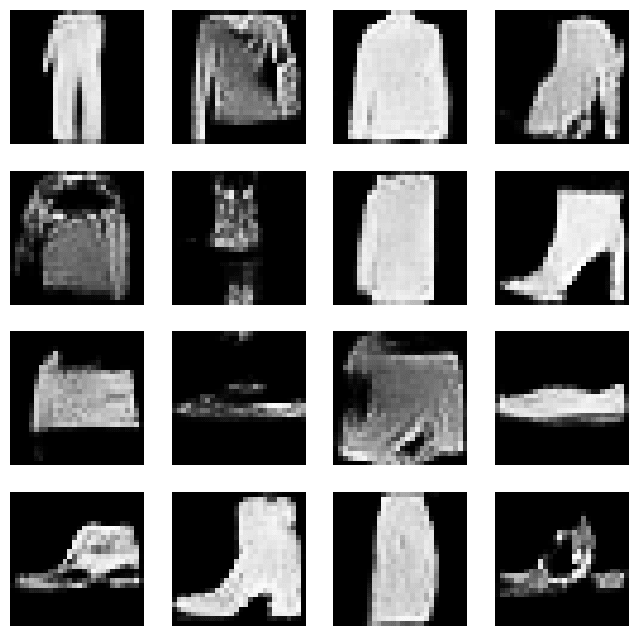
今回の学習したモデルの20エポックごとの全ての結果画像を、エポック順に添付します。
こうしてみると、徐々にただのぼんやりした乱数からファッションの画像に進化していってるのが見て取れて面白いですね!