AWS Parallel Computing Service がノードライフサイクルアクションをサポートしたので試してみた

はじめに
AWS Parallel Computing Service(AWS PCS)は、Slurm の HPC クラスターのマネージドサービスです。2026 年 7 月のアップデートでノードライフサイクルアクションが追加されました。ノードライフサイクルアクションは、コンピュートノードの起動途中に S3 などに置いたスクリプトを実行できる機能で、ParallelCluster ユーザー向けに説明するとカスタムブートストラップアクションが使えるようになりました。
なにが嬉しいのか
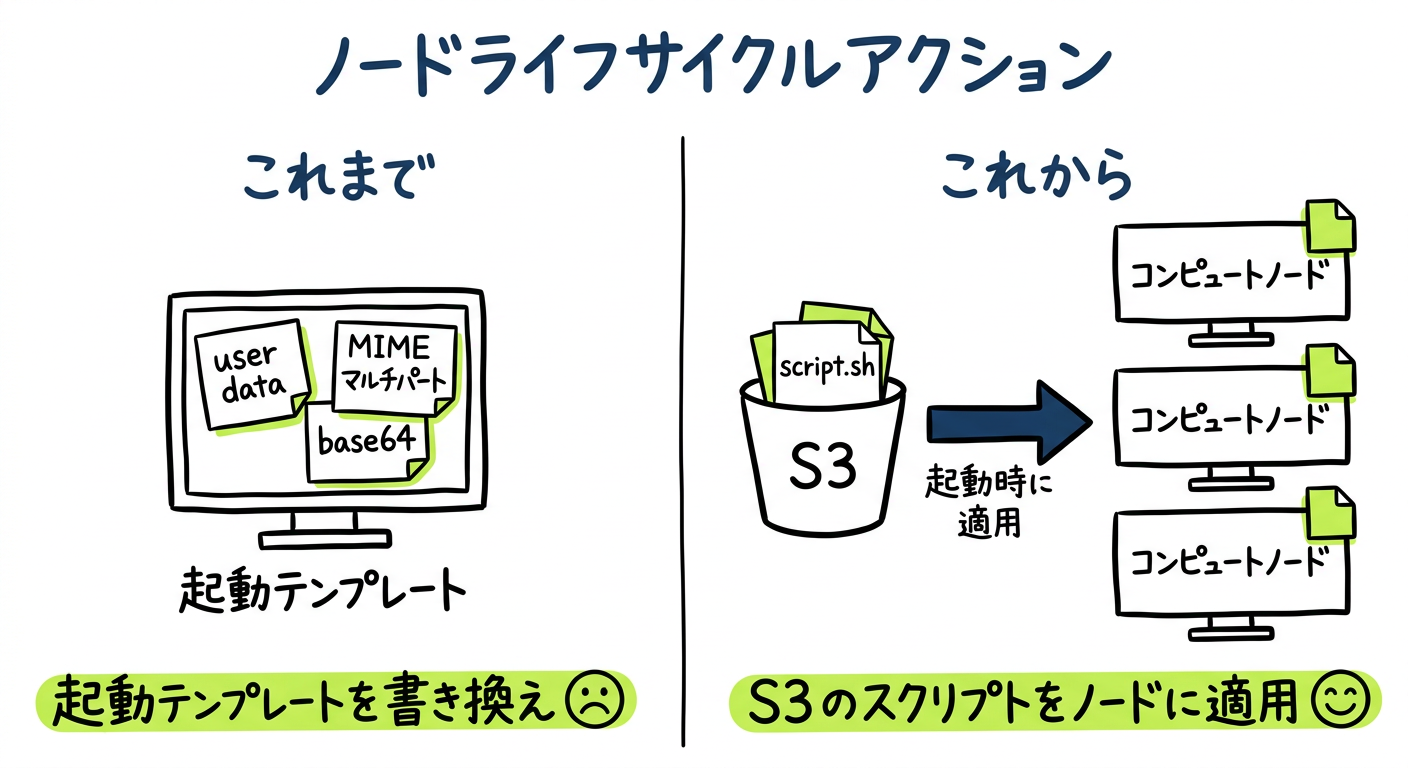
AWS PCS では、同じ設定の EC2 インスタンスをコンピュートノードグループとしてまとめ、キューに関連付けてジョブを受け付けます。各ノードでは PCS エージェントが動き、ノードをクラスターに参加させます。これまでノードの起動時に設定の追加や、アプリケーションのインストールしたい場合は起動テンプレートの user data を使っていました。
ParallelCluster のブートストラップスクリプト的な機能
ライフサイクルアクションは、AWS ParallelCluster のカスタムブートストラップアクション(CustomActions)に当たる機能です。v2 時代からの ParallelCluster ユーザー向けに説明するなら pre_install と post_install ことです。
公式ドキュメントには次の対応表が載っていました。
| AWS ParallelCluster | AWS PCS |
|---|---|
OnNodeStart |
nodeBootstrapped |
OnNodeConfigured |
nodeReady |
OnNodeUpdated |
相当なし |
既存のブートストラップスクリプトの多くはそのまま使えるとされています。ただしデフォルトの実行タイミングが違います。ParallelCluster は毎回のブートで実行しますが、PCS は初回のみです。ParallelCluster と同じ動きにするには executionPolicy に EVERY_BOOT を指定します。
起動テンプレートを触らなくて済む
user data は PCS 側の user data とマージされます。そのため MIME マルチパート形式で書く必要があります。CLI や SDK から渡すなら base64 エンコードも必要です。
再起動時とエラー時の扱いをスクリプトごとに選べる
user data では、再起動時に再実行するかと失敗したときの動作をスクリプト単位で指定できません。ライフサイクルアクションでは、この 2 つをスクリプトごとに指定できます。
公式ドキュメントでも、ほとんどの設定にはライフサイクルアクションを推奨していました。 user data を使うのは、PCS エージェントの起動前に必要な処理だけです。
For most node configuration tasks, we recommend node lifecycle actions. They provide reusable, API-native configuration with per-script error handling and reboot control. Use launch template user data for tasks that must run before the AWS PCS agent starts.
出典: https://docs.aws.amazon.com/pcs/latest/userguide/working-with_ec2-user-data.html
ライフサイクルアクションの仕組み
ライフサイクルアクションはコンピュートノードグループ単位で設定します。スクリプトは root で実行され、実行するステージを 2 つから選びます。
| ステージ | 実行タイミング | Slurm コマンド |
|---|---|---|
nodeBootstrapped |
PCS のノード設定の後、slurmd の起動前 | 使えない |
nodeReady |
slurmd がコントローラーに登録された後 | 使える |
nodeReady は slurmd の起動後に走るため、スクリプトの完了前でもジョブは割り当てられます。
スクリプトごとに指定する主な設定は次の 2 つです。
| 設定 | 値 | 動作 | 使いどころ |
|---|---|---|---|
executionPolicy |
FIRST_BOOT_ONLY(既定) |
初回の起動時だけ実行 | パッケージの導入など 1 回きりの設定 |
EVERY_BOOT |
再起動のたびに実行 | 再起動後にやり直す設定 | |
onError |
TERMINATE(既定) |
ノードを失敗扱いにして終了 | 共有ストレージのマウントなど必須の設定 |
STOP_SEQUENCE |
同じステージの後続を実行せずノードを残す | スクリプトのデバッグ | |
CONTINUE |
失敗を記録して次のスクリプトへ | 失敗してもよい任意の処理 |
どういった場合にどれを選べばいいのかはドキュメントに載っていますので最新情報を確認してください。
検証環境
クラスターとログイン用のコンピュートノードグループは作成済みの状態から始めます。インスタンスロールには、スクリプトを置いた S3 バケットへの s3:GetObject を付けています。ライフサイクルアクションには PCS エージェント 1.5.0-1 以上が必要です。クラスターの構築手順自体は省略します。PCS クラスターの作り方は次の記事を参考にしてください。
| 項目 | 値 |
|---|---|
| リージョン | ap-northeast-1 |
| Slurm | 26.05.4 |
| PCS エージェント | 1.5.1-1 |
| AMI | PCS のサンプル AMI(aws-pcs-sample_ami-al2023-x86_64-2026-10-14) |
| インスタンスタイプ | c7i.large |
| AWS CLI | 2.37.3 |
検証に使ったスクリプト
S3 バケットの scripts/ 配下に 3 つのスクリプトを置きました。
record-boot.sh は第 1 引数をラベルにして、環境変数の値と一緒に 1 行追記します。追記先は /var/lib/lca-boot-record.log です。再起動の前後で何回実行されたかを数えるためのファイルです。
#!/bin/bash
set -euo pipefail
LABEL="${1:-unknown}"
echo "$(date -u +%Y-%m-%dT%H:%M:%SZ) label=${LABEL} first_boot=${PCS_IS_FIRST_BOOT:-unset} node=${PCS_NODE_ID:-unset} cng=${PCS_COMPUTE_NODE_GROUP_NAME:-unset}" >> /var/lib/lca-boot-record.log
echo "recorded ${LABEL}"
ready-check.sh は nodeReady で使い、slurmd の状態と scontrol show node の結果を出力します。Slurm のノード名(lca-static-1)はホスト名(ip-10-0-1-82)と異なります。そのため PCS_NODE_ID でノードを指定しています。
#!/bin/bash
set -uo pipefail
echo "slurmd: $(systemctl is-active slurmd 2>/dev/null || echo unknown)"
SLURM_BIN=$(ls -d /opt/aws/pcs/scheduler/slurm-*/bin 2>/dev/null | sort | tail -1)
"${SLURM_BIN}/scontrol" show node "${PCS_NODE_ID:-$(hostname -s)}" 2>&1 | head -5 || true
fail.sh は常に終了コード 1 で失敗します。onError の確認に使います。
#!/bin/bash
echo "intentional failure for verification" >&2
exit 1
ライフサイクルアクションを設定したコンピュートノードグループを作成する
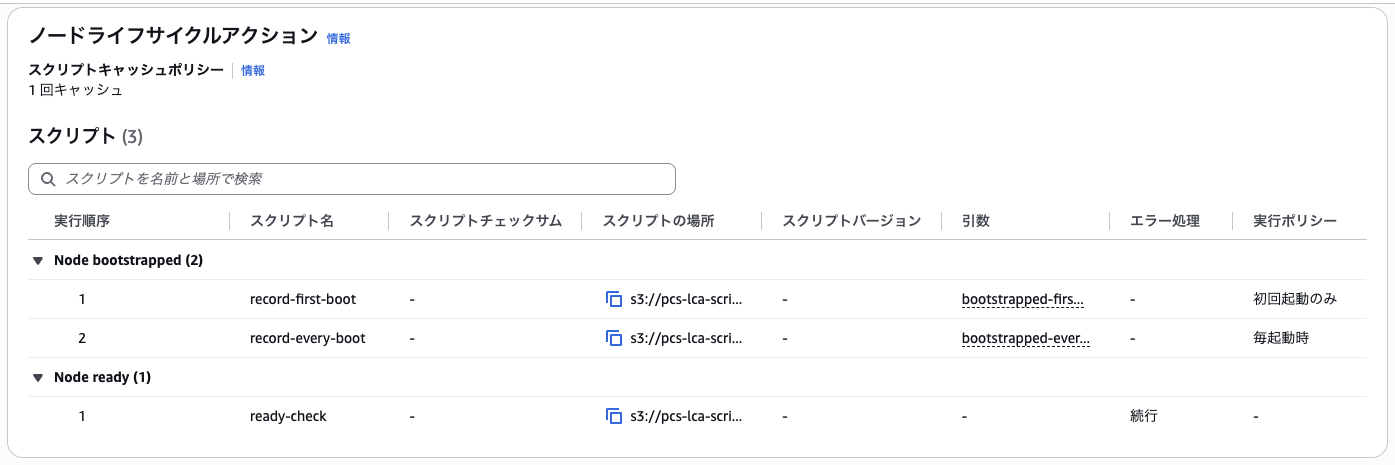
nodeBootstrapped には record-boot.sh を引数違いで 2 つ登録しました。片方は FIRST_BOOT_ONLY、もう片方は EVERY_BOOT です。nodeReady の ready-check は executionPolicy を省略し、失敗してもノードを残すよう onError を CONTINUE にしています。
{
  "stages": {
    "nodeBootstrapped": [
      {
        "name": "record-first-boot",
        "scriptSource": { "scriptLocation": "s3://<バケット名>/scripts/record-boot.sh" },
        "arguments": ["bootstrapped-first-boot-only"],
        "executionPolicy": "FIRST_BOOT_ONLY"
      },
      {
        "name": "record-every-boot",
        "scriptSource": { "scriptLocation": "s3://<バケット名>/scripts/record-boot.sh" },
        "arguments": ["bootstrapped-every-boot"],
        "executionPolicy": "EVERY_BOOT"
      }
    ],
    "nodeReady": [
      {
        "name": "ready-check",
        "scriptSource": { "scriptLocation": "s3://<バケット名>/scripts/ready-check.sh" },
        "onError": "CONTINUE"
      }
    ]
  }
}
この JSON を file:// で --node-lifecycle-actions に渡します。
aws pcs create-compute-node-group --region ap-northeast-1 \
  --cluster-identifier <クラスター ID> \
  --compute-node-group-name lca-static \
  --subnet-ids <サブネット ID> \
  --custom-launch-template id=<起動テンプレート ID>,version=1 \
  --iam-instance-profile-arn <インスタンスプロファイル ARN> \
  --ami-id <サンプル AMI の ID> \
  --scaling-configuration minInstanceCount=1,maxInstanceCount=1 \
  --instance-configs instanceType=c7i.large \
  --node-lifecycle-actions file://<JSON ファイルのパス>
約 3 分で ACTIVE になったので、キュー lca-queue を作成して関連付けました。
コンソールでは、登録したスクリプトがステージごとに表示されます。省略したエラー処理と実行ポリシーは「-」でした。
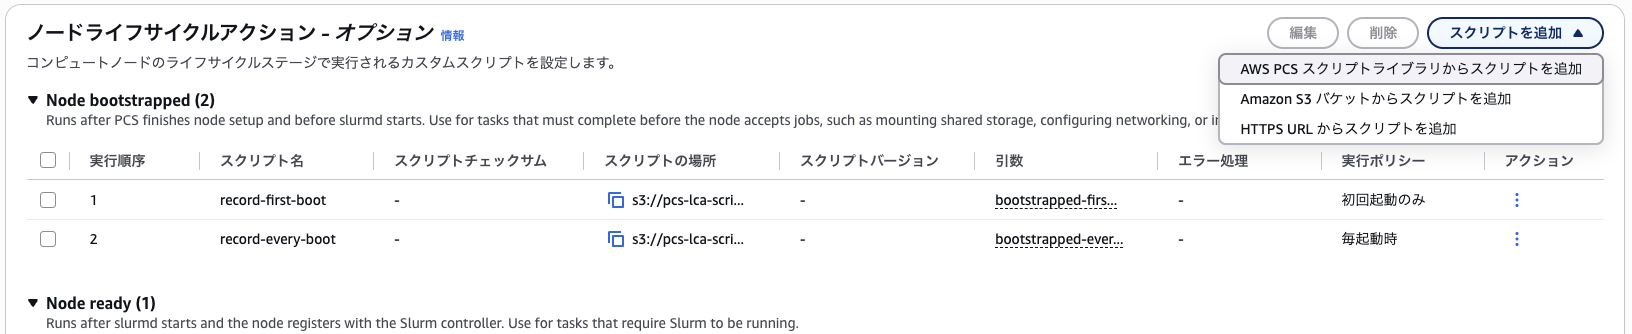
コンソールの「スクリプトを追加」からは、スクリプトライブラリ、S3、HTTPS URL のどれかを選んで追加できます。
初回起動のログはステージごとのディレクトリに保存される
ノードが idle になってから、Systems Manager の Run Command でノード上のログを確認しました。ステージ名のディレクトリの中に、スクリプト名のログファイルができていました。
/var/log/amazon/pcs/lifecycle/actions/:
-rw-r--r-- 1 root root 4334 2026-10-21 00:48:00.140915114 +0000 executor.log
drwxr-x--- 2 root root   64 2026-10-21 00:47:39.549764603 +0000 nodeBootstrapped
drwxr-x--- 2 root root   29 2026-10-21 00:48:00.070915040 +0000 nodeReady

/var/log/amazon/pcs/lifecycle/actions/nodeBootstrapped/:
-rw-r----- 1 root root 149 2026-10-21 00:47:39.551852990 +0000 record-every-boot.log
-rw-r----- 1 root root 159 2026-10-21 00:47:39.549764603 +0000 record-first-boot.log

/var/log/amazon/pcs/lifecycle/actions/nodeReady/:
-rw-r----- 1 root root 122 2026-10-21 00:48:00.140915114 +0000 ready-check.log
再起動では EVERY_BOOT のスクリプトだけがキャッシュから再実行された
scontrol reboot で、インスタンスを置き換えずに再起動しました。
Run Command からログインノードで実行したため、Slurm コマンドはフルパスで指定しています。
#!/bin/bash
/opt/aws/pcs/scheduler/slurm-26.05/bin/scontrol reboot ASAP nextstate=RESUME lca-static-1
実行から約 45 秒後に EVERY_BOOT のスクリプトが再実行されました。インスタンス ID は変わっていません。lca-boot-record.log に増えたのは bootstrapped-every-boot の 1 行だけで、first_boot は 0 でした。
 2026-10-21T00:47:39Z label=bootstrapped-first-boot-only first_boot=1 node=lca-static-1 cng=lca-static
 2026-10-21T00:47:39Z label=bootstrapped-every-boot first_boot=1 node=lca-static-1 cng=lca-static
+2026-10-21T00:49:33Z label=bootstrapped-every-boot first_boot=0 node=lca-static-1 cng=lca-static
スクリプトのログには 2 回分が追記されていました。executor.log の Reusing cached script (CACHE_ONCE) は、S3 から取り直さずキャッシュを使っていました。
== /var/log/amazon/pcs/lifecycle/actions/nodeBootstrapped/record-every-boot.log
[start record-every-boot args=["bootstrapped-every-boot"] @ 1792543659]
recorded bootstrapped-every-boot
[end record-every-boot exit=0 @ 1792543659]
[start record-every-boot args=["bootstrapped-every-boot"] @ 1792543773]
recorded bootstrapped-every-boot
[end record-every-boot exit=0 @ 1792543773]
== executor.log (after 00:48:30)
{"timestamp":"2026-10-21T00:49:33.129571Z","level":"INFO","message":"Reusing cached script (CACHE_ONCE)","script":"record-every-boot","stage":"nodeBootstrapped",...}
{"timestamp":"2026-10-21T00:49:33.148413Z","level":"INFO","message":"script completed","stage":"nodeBootstrapped","script":"record-every-boot",...}
スクリプトのログの時刻は UNIX 秒で、2 回目の 1792543773 が executor.log の行と同じ時刻です。キャッシュは /etc/amazon/pcs/lifecycle/actions/config/scripts/ の下に置かれていました。
executionPolicy を省略した ready-check は再実行されず、ログの更新時刻は再起動前のままでした。
/var/log/amazon/pcs/lifecycle/actions/nodeReady/:
-rw-r----- 1 root root 122 2026-10-21 00:48:00.140915114 +0000 ready-check.log
省略時は FIRST_BOOT_ONLY 扱いなので、再起動のたびに実行したいスクリプトには EVERY_BOOT の明示が必要です。
onError を STOP_SEQUENCE にしたノードは Slurm に参加してジョブも動いた
nodeBootstrapped の先頭に、必ず失敗する fail.sh を STOP_SEQUENCE で設定しました。後続には record-boot.sh を設定しています。
{
  "stages": {
    "nodeBootstrapped": [
      {
        "name": "fail-stop-sequence",
        "scriptSource": { "scriptLocation": "s3://<バケット名>/scripts/fail.sh" },
        "onError": "STOP_SEQUENCE"
      },
      {
        "name": "record-after-fail",
        "scriptSource": { "scriptLocation": "s3://<バケット名>/scripts/record-boot.sh" },
        "arguments": ["after-fail"]
      }
    ],
    "nodeReady": [
      {
        "name": "ready-check",
        "scriptSource": { "scriptLocation": "s3://<バケット名>/scripts/ready-check.sh" },
        "onError": "CONTINUE"
      }
    ]
  }
}
更新は次のコマンドです。
aws pcs update-compute-node-group --region ap-northeast-1 \
  --cluster-identifier <クラスター ID> \
  --compute-node-group-identifier lca-static \
  --node-lifecycle-actions file://<JSON ファイルのパス>
既存ノードはドレインされ、更新から約 7 分で新しいインスタンスが idle になりました。新しいインスタンスでは、fail-stop-sequence.log が exit=1 で終わっていました。後続が書き込む lca-boot-record.log はできていません。nodeReady の ready-check は実行され、slurmd は active でした。
 ls: cannot access '/var/lib/lca-boot-record.log': No such file or directory
 /var/log/amazon/pcs/lifecycle/actions/nodeBootstrapped/:
 -rw-r----- 1 root root 130 2026-10-21 00:57:27.862315978 +0000 fail-stop-sequence.log
 /var/log/amazon/pcs/lifecycle/actions/nodeReady/:
 -rw-r----- 1 root root 269 2026-10-21 00:57:54.192609490 +0000 ready-check.log
 == fail-stop-sequence.log
 [start fail-stop-sequence args=[] @ 1792544247]
 intentional failure for verification
+[end fail-stop-sequence exit=1 @ 1792544247]
 == ready-check.log
 [start ready-check args=[] @ 1792544274]
+slurmd: active
 NodeName=lca-static-1 Arch=x86_64 CoresPerSocket=1
 [end ready-check exit=0 @ 1792544274]
 == executor.log
 {"timestamp":"2026-10-21T00:57:27.868622Z","level":"ERROR","message":"lifecycle script failed; stopping remaining scripts","stage":"nodeBootstrapped","script":"fail-stop-sequence","on_error":"StopSequence","error":"script 'fail-stop-sequence' failed with exit status ExitStatus(unix_wait_status(256))",...}
 == bootstrap.log
 [2026-10-21T00:57:27.869+00:00] - /opt/aws/pcs/bin/pcs_bootstrap_finalize.sh: WARN: Lifecycle execute completed with exit 3 for stage nodeBootstrapped
実行されなかったのは同じステージ内の後続スクリプトだけで、次のステージ nodeReady のスクリプトは実行されました。
スクリプトが失敗したこのノードでジョブが動くかも確認しました。ログインノードから srun -p lca-queue hostname を実行すると、終了コード 0 で完了しています。scontrol show node の状態も IDLE+CLOUD で、ジョブを受け付ける状態でした。
State=IDLE+CLOUD ThreadsPerCore=1 TmpDisk=0 Weight=1 Owner=N/A MCS_label=N/A
ip-10-0-1-118.ap-northeast-1.compute.internal
srun exit=0
PCS のスケーリングログでも、このノードは成功として記録されました。スケーリングログは、ノードの状態遷移を CloudWatch Logs などに配信する機能です。
主な項目を抜き出すと、記録されていたのは BOOTSTRAP_SUCCESS で、失敗のイベントはありませんでした。
00:55:45 lca-static-1 LAUNCHED MAINTAIN_MIN_CAPACITY i-046cb3897e5a0a6a3
00:57:03 lca-static-1 REGISTERED REGISTER_SUCCESS i-046cb3897e5a0a6a3
00:57:52 lca-static-1 ACTIVE BOOTSTRAP_SUCCESS i-046cb3897e5a0a6a3
スケーリングログ、Slurm のノード状態、コンピュートノードグループの状態には失敗が現れませんでした。失敗が記録されていたのは、ノード上の fail-stop-sequence.log、executor.log、bootstrap.log だけです。STOP_SEQUENCE はノードを残して調べたいときに使えます。ドキュメントにも使い時はデバッグ用と書いてあるのでそのとおりでした。
onError を TERMINATE にしてみると
前節の JSON で onError を TERMINATE に変え、スクリプト名を fail-terminate にして更新しました。スケーリングログでは、置き換え後のインスタンスが 2 台続けて BOOTSTRAP_FAILED で終了しています。3 台目の起動中に失敗スクリプトのない構成へ戻したため、3 台目はその更新で置き換わりました。
| インスタンス | 起動 | 登録 | 終了 |
|---|---|---|---|
| 1 台目 | 01:04:45 | 01:06:03 | 01:06:42 BOOTSTRAP_FAILED |
| 2 台目 | 01:09:44 | 01:11:17 | 01:12:42 BOOTSTRAP_FAILED |
| 3 台目 | 01:15:45 | なし | 01:18:26 REPLACEMENT_REQUESTED |
この間、ノードは記号の付かない idle(ジョブを受け付ける状態)に一度もなりませんでした。sinfo では idle#(起動中)、idle%(電源断の処理中)、idle~(電源断)を繰り返し、Reason に失敗したインスタンス ID が表示されました。
01:04:45 SINFO=lca-static-1 lca-queue idle# none
01:06:50 SINFO=lca-static-1 lca-queue idle# none
01:07:08 SINFO=lca-static-1 lca-queue idle% Backing Instance Failed To Bootstrap: i-059b4b99b4f2e9739 : Not responding
01:08:19 SINFO=lca-static-1 lca-queue idle~ Backing Instance Failed To Bootstrap: i-059b4b99b4f2e9739 : Not responding
01:09:12 SINFO=lca-static-1 lca-queue idle# none
01:13:04 SINFO=lca-static-1 lca-queue idle% Backing Instance Failed To Bootstrap: i-06644f6e5a2b001c9
01:14:15 SINFO=lca-static-1 lca-queue idle~ Backing Instance Failed To Bootstrap: i-06644f6e5a2b001c9
01:15:08 SINFO=lca-static-1 lca-queue idle# none
1 サイクルは約 5〜6 分でした。TERMINATE は onError の既定値で、設定を戻すまで置き換えが続きました。ノード上のログもインスタンスとともに消えます。
TERMINATE は、共有ストレージのマウントのように失敗するとノードが使えない設定に向いています。前節の STOP_SEQUENCE と違い、失敗したノードはジョブを受け付ける状態になりません。ただしスクリプトが失敗し続けると置き換えが止まらないので、スクリプト作成時の試行錯誤中は STOP_SEQUENCE で試した方が良さそうです。公式ドキュメントでも、デバッグ中は一時的に STOP_SEQUENCE にする方法と、ログを CloudWatch Logs へ転送する方法が挙げられています。
構成を戻してから約 7 分で、ノードは idle に戻りました。
まとめ
ノードライフサイクルアクションで、コンピュートノードの起動途中に S3 などに置いたスクリプトを実行できるようになりました。user data を MIME マルチパート形式で書かずに済み、再起動時の再実行と失敗時の動作もスクリプトごとに選べます。ParallelCluster のブートストラップスクリプトも持ってこれます。公式ドキュメントでも、ほとんどの設定にはライフサイクルアクションが推奨されていました。
おわりに
私の様な ParallelCluster ユーザーには馴染みのある方法で大変ありがたい。