[レポート]Snowflakeでゼロから構築する、 信頼性の高いセマンティックレイヤー #SWTTokyo26
企業が保有するデータをガバナンスの効いた実用的なインサイトへ変換する手法をご紹介します。データクラウドからAIエージェントやBIツールへビジネスロジックが連携する様子をライブデモを交えてご紹介します。
※SNOWFLAKE WORLD TOUR 2026 イベントサイトより抜粋

2026.09.19
かわばたです。
2026年9月10日~2026年9月11日に、「SNOWFLAKE WORLD TOUR 2026 - TOKYO」が開催されました。
本記事はセッション
【Snowflakeでゼロから構築する、 信頼性の高いセマンティックレイヤー】
のレポートブログとなります。
※本記事には、プレビュー機能や将来のロードマップに関する内容が含まれます。機能の提供状況や利用条件は、最新の公式ドキュメントをご確認ください。
※登壇者の発言は筆者のメモをもとに要約しています。
登壇者
- 河上 伸一 氏
- Snowflake Senior Solution Engineer
セマンティックレイヤーは新しい概念ではない
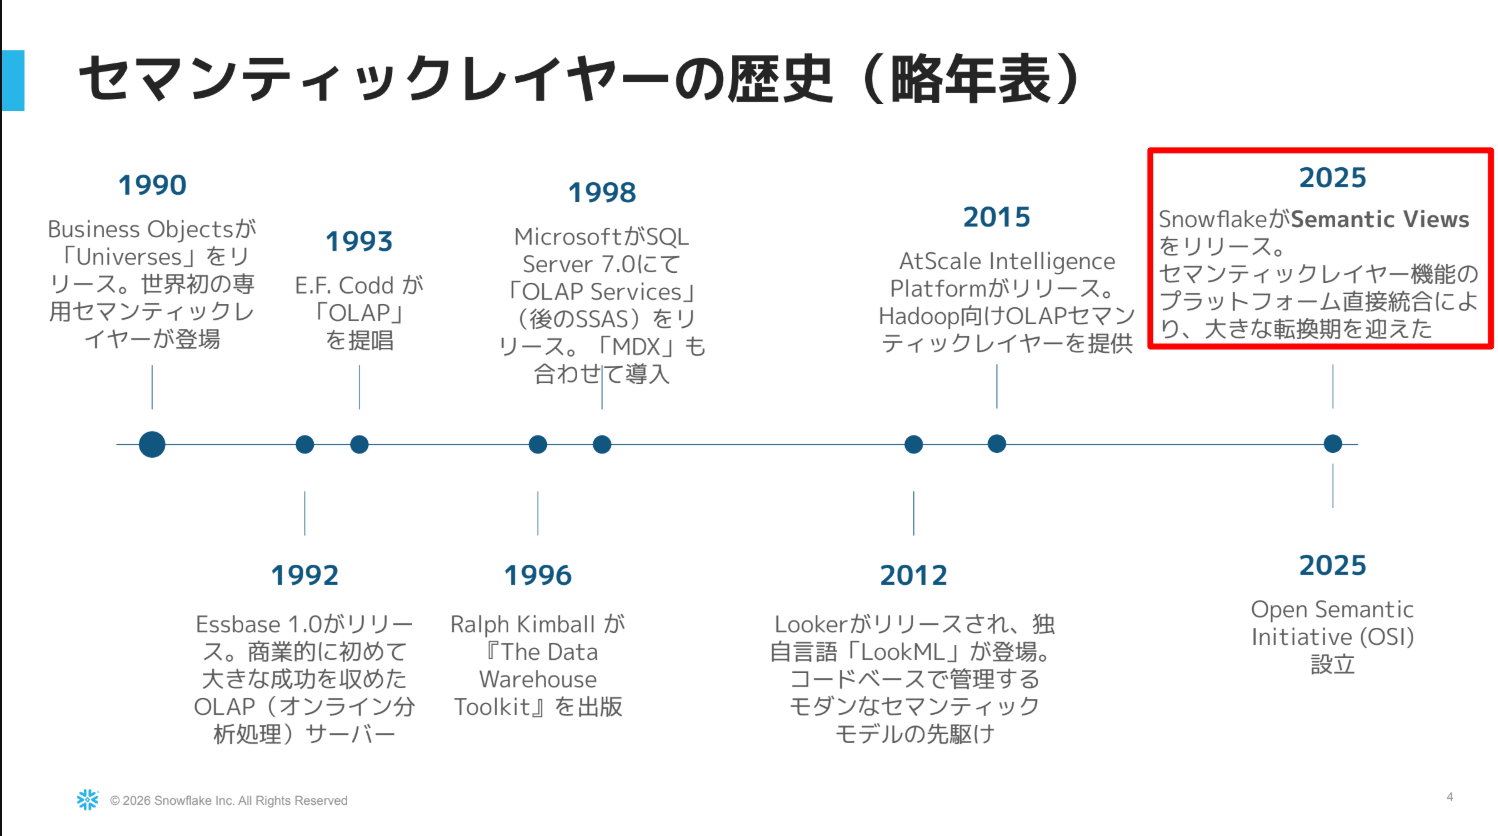
- セマンティックレイヤーは1990年代からある概念
- BusinessObjects の Universe、Essbase、Kimball のデータウェアハウス理論、Looker の LookML と続いてきた
- LookML により、物理データベースとビジネスユーザーの橋渡しをコードで管理できるようになった
- 30年以上、複雑なデータ構造とビジネスの言葉をどう繋ぐかという問題に業界は挑み続けてきた
- 従来のセマンティックレイヤーの課題は、データウェアハウスの外側にある独立したツールの機能だったこと
- その結果、ツールごとに定義が分断されていた
- 2025〜2026年は歴史的な転換期だという見立て
- Snowflake が、プラットフォームにネイティブ統合されたセマンティックビューを提供した
- セマンティックレイヤーは「ツール」から「データプラットフォームそのものの機能」へ進化した
コンテキストギャップとコンテキストの一元化
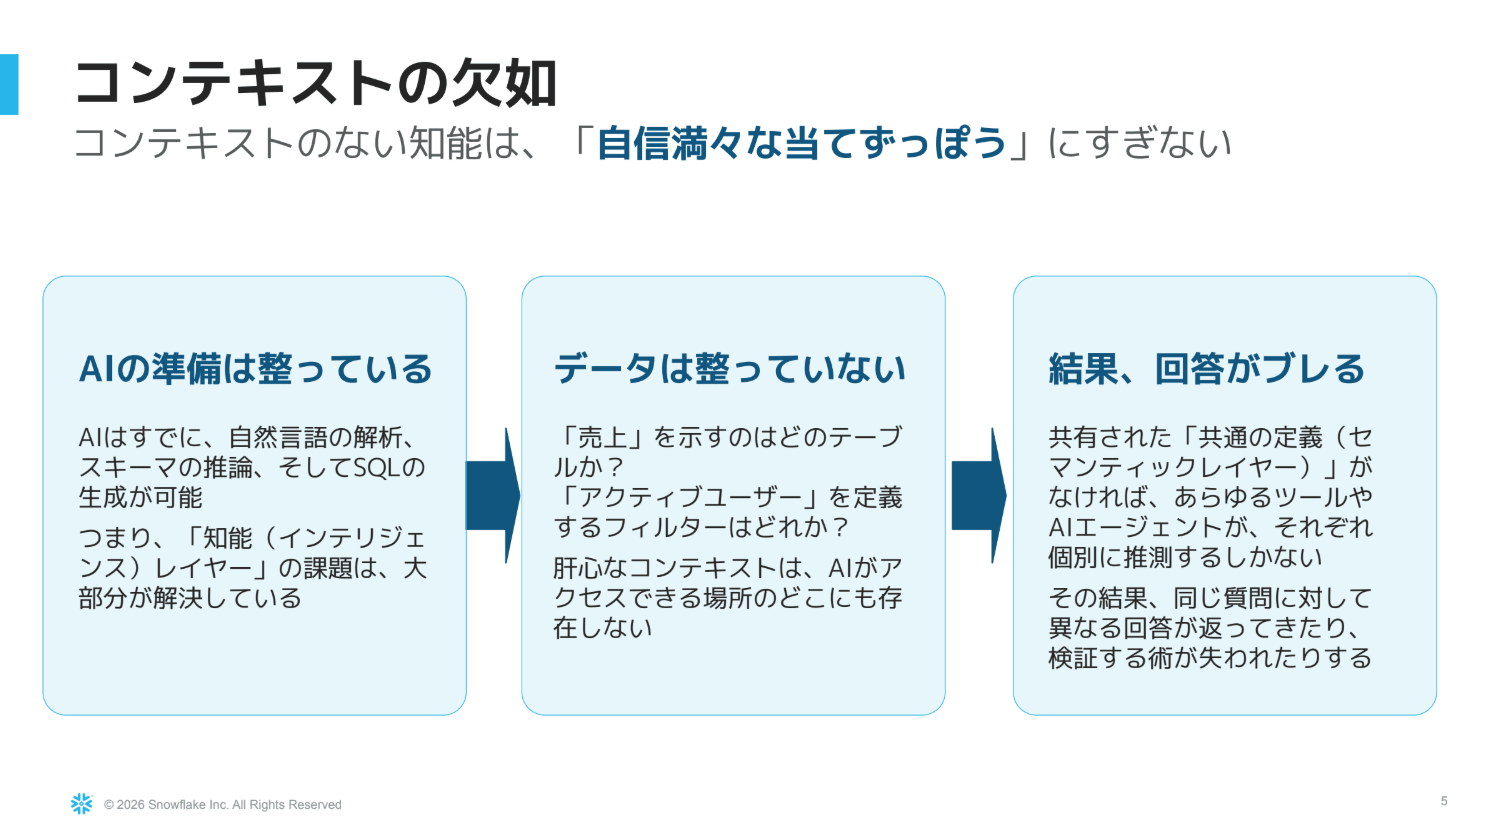
- なぜ今セマンティックレイヤーが叫ばれるのか。コンテキストギャップが存在するから
- 現代の AI は自然言語から SQL を生成できる。しかしデータ側にビジネスのコンテキストがない
- どのテーブルが本当の売上なのか、アクティブユーザーはどうフィルターすればよいのか
- 共有された定義がなければ、AI エージェントも BI ツールもそれぞれ勝手に推測するしかない
- 同じ質問なのに、ツールやエージェントごとに違う答えが返ってくる
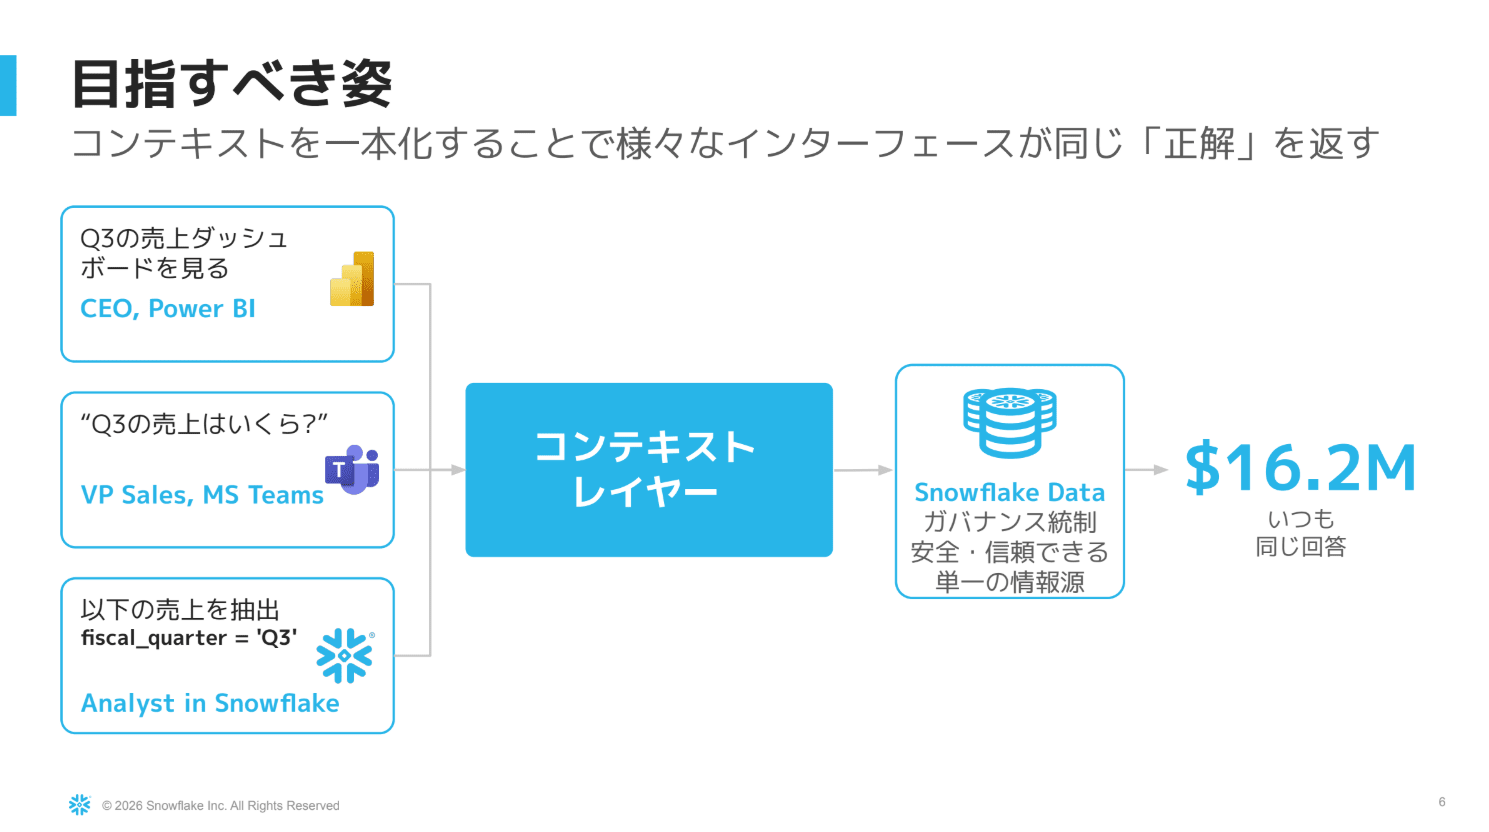
- 目指す姿はコンテキストの一元化
- CEO が Power BI で、営業部長がチャットで、アナリストが SQL で第3四半期の売上を見る
- 統一されたコンテキストレイヤーを通じて、全員が同じ「16.2 million(1,620万)」という答えを得る
- これが AI 時代の single source of truth だという主張
Snowflake Horizon Context とセマンティックビュー
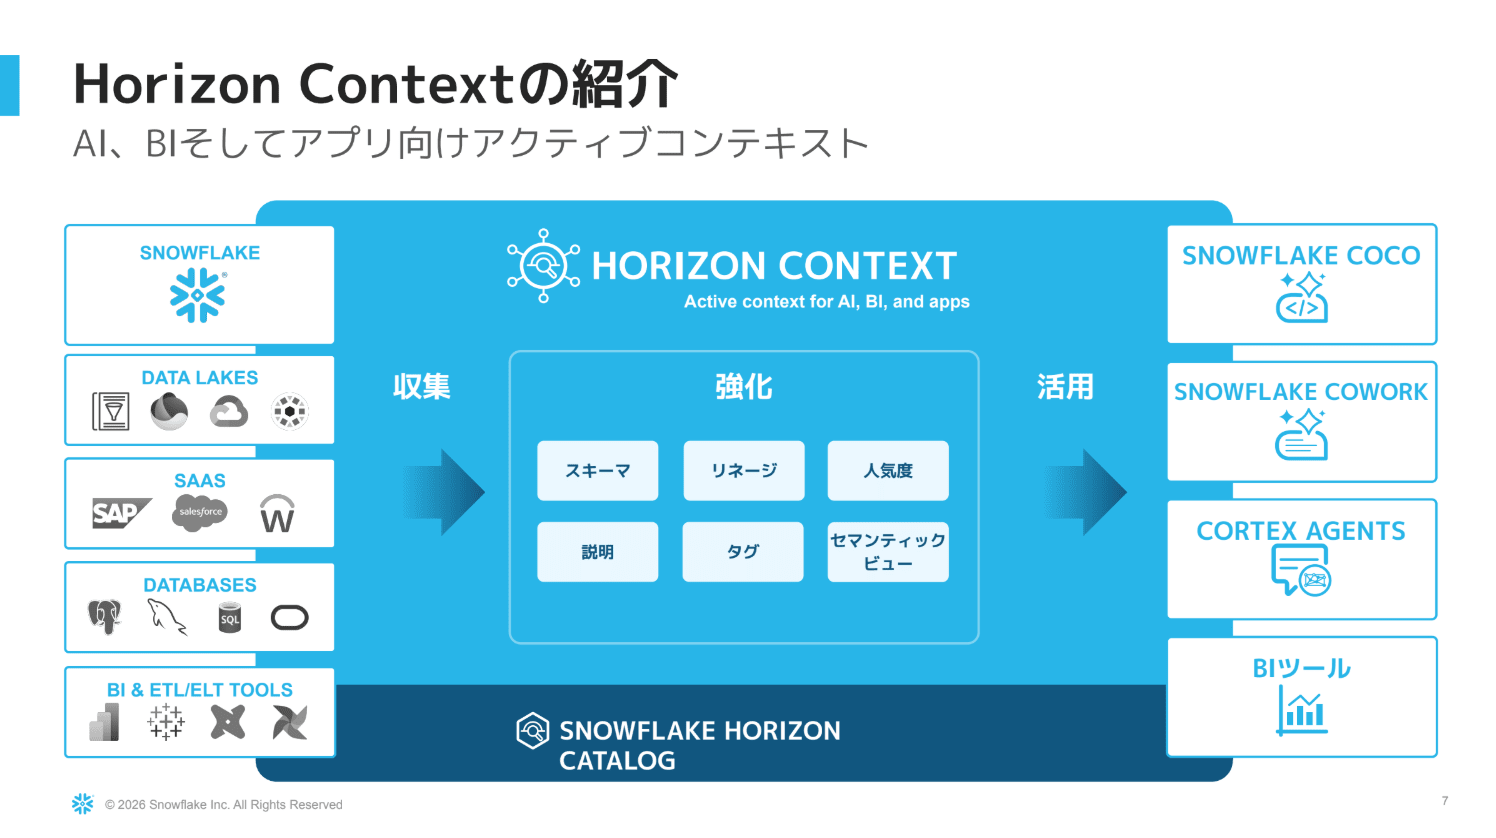
- この理想を実現するために Snowflake が提供を始めるのが Snowflake Horizon Context
- Horizon Catalog を中心に、外部データベース、SaaS、データレイクなどからコンテキストを収集する
- ビジネス用語、リネージ、セマンティックビューでコンテキストを強化する
- Snowflake CoWork、Snowflake CoCo、各種 BI ツールへ提供する
- 単なるデータの保管庫から、AI や BI が即座に理解できるアクティブコンテキスト基盤へ進化させる
Horizon Context がもたらす価値
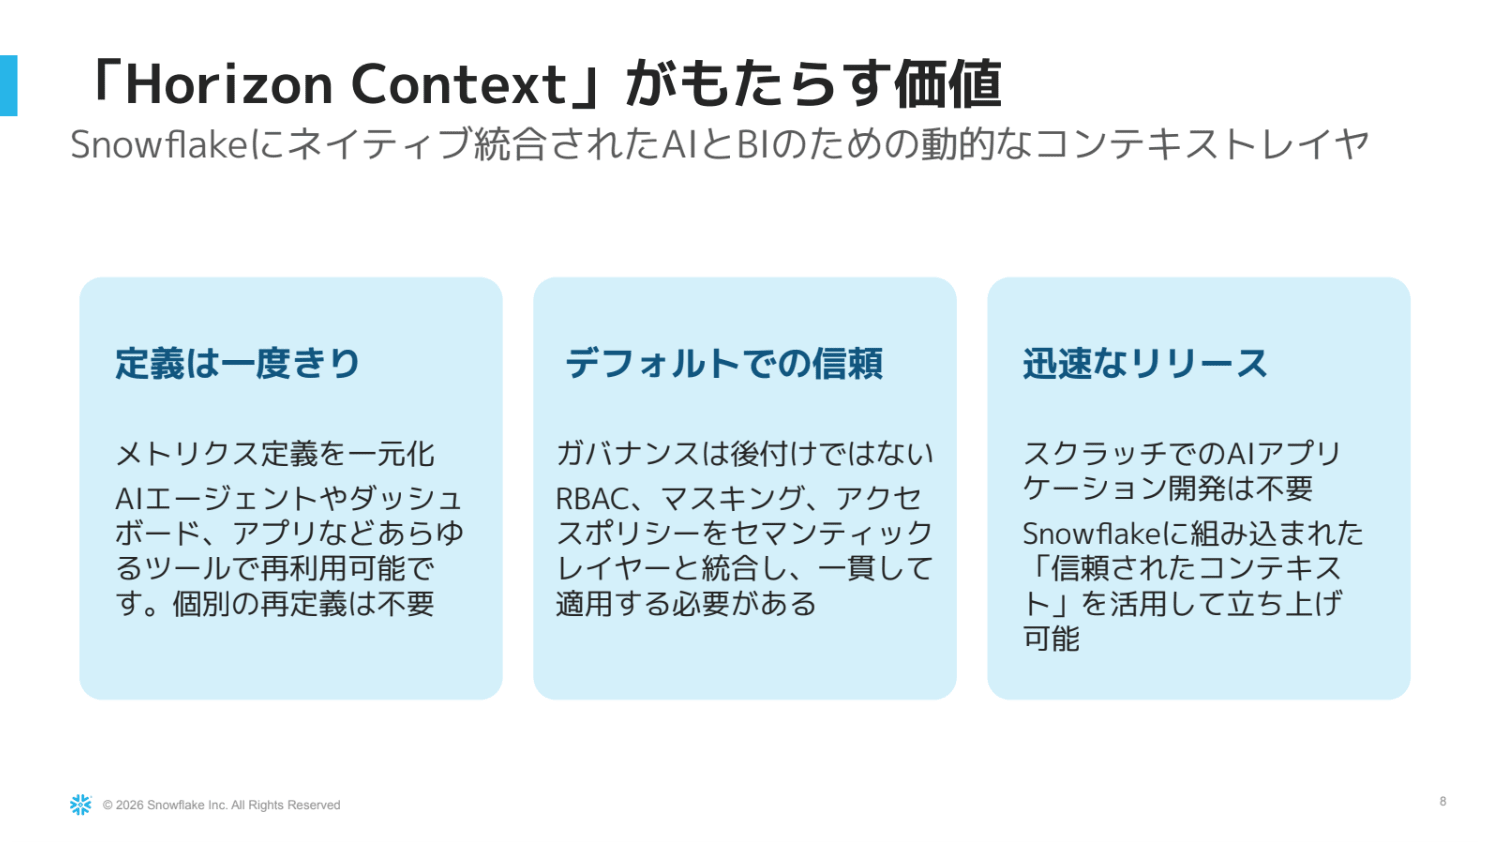
- 定義は一度きり: メトリクスや計算ロジックを1か所で定義すれば、AI でも BI でもアプリでも再利用できる
- デフォルトでの信頼: RBAC、行アクセスポリシー、マスキングポリシーなど既存のガバナンスが、BI や AI エージェントなど呼び出し元にかかわらず適用される
- ツールごとにガバナンスを重複して設定する必要性を減らせる
- 迅速な展開: 新しい AI アプリケーションを作るとき、プロンプトやロジックをゼロから作り込まず、信頼されたコンテキストをすぐ使える
セマンティックビューの役割
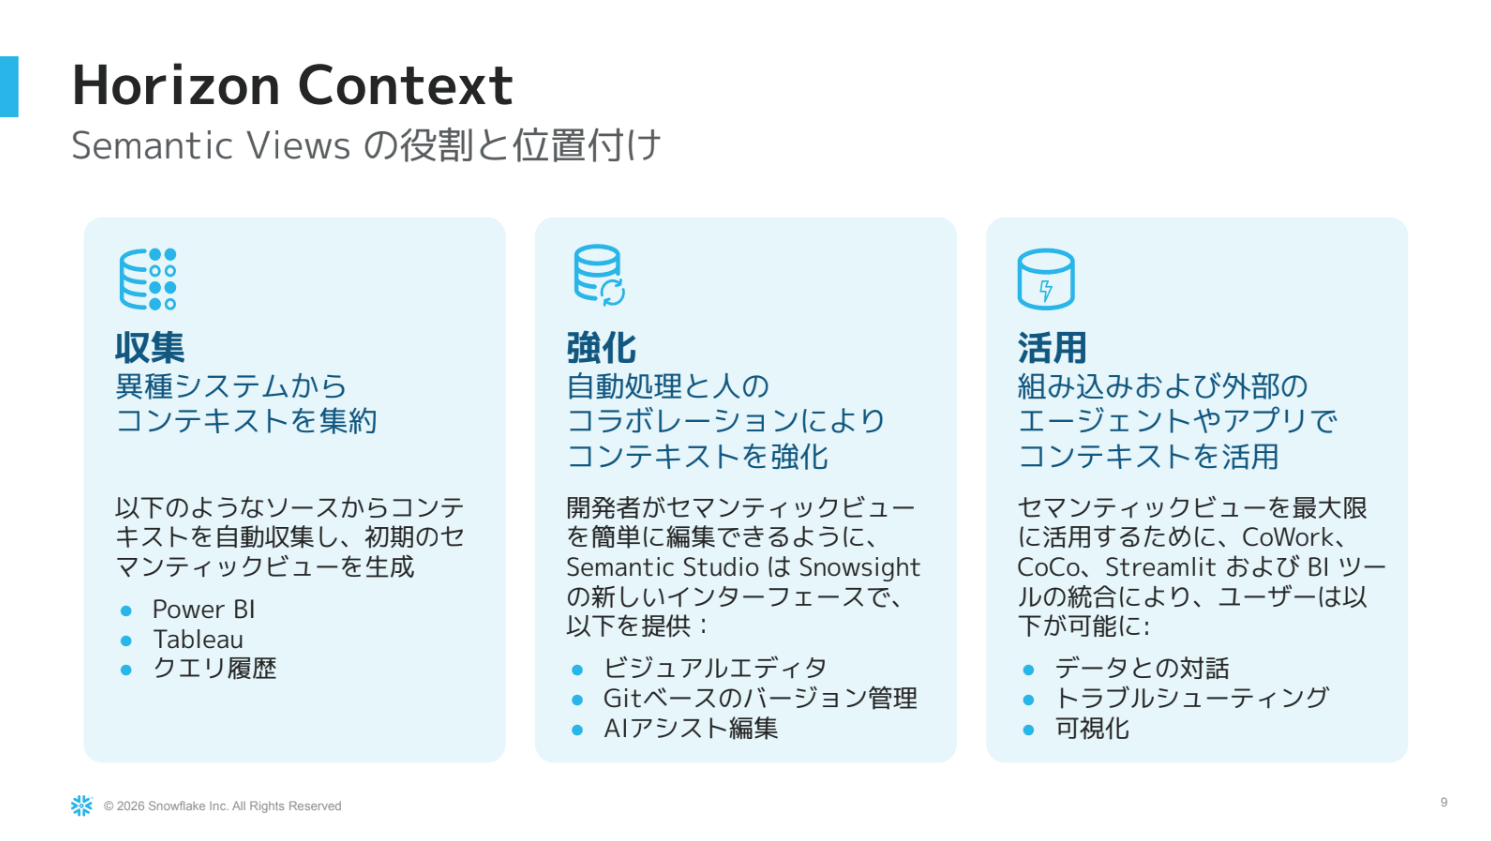
- Horizon Context の中で最もコアとなるのがセマンティックビュー(Semantic View)
- 収集: Power BI や過去のクエリ履歴から既存の定義を集約する
- 強化: Semantic Studio でビジュアル編集やリネージ追跡を行う
- 活用: AI エージェントや BI ツールからのクエリにリアルタイムでコンテキストを注入する
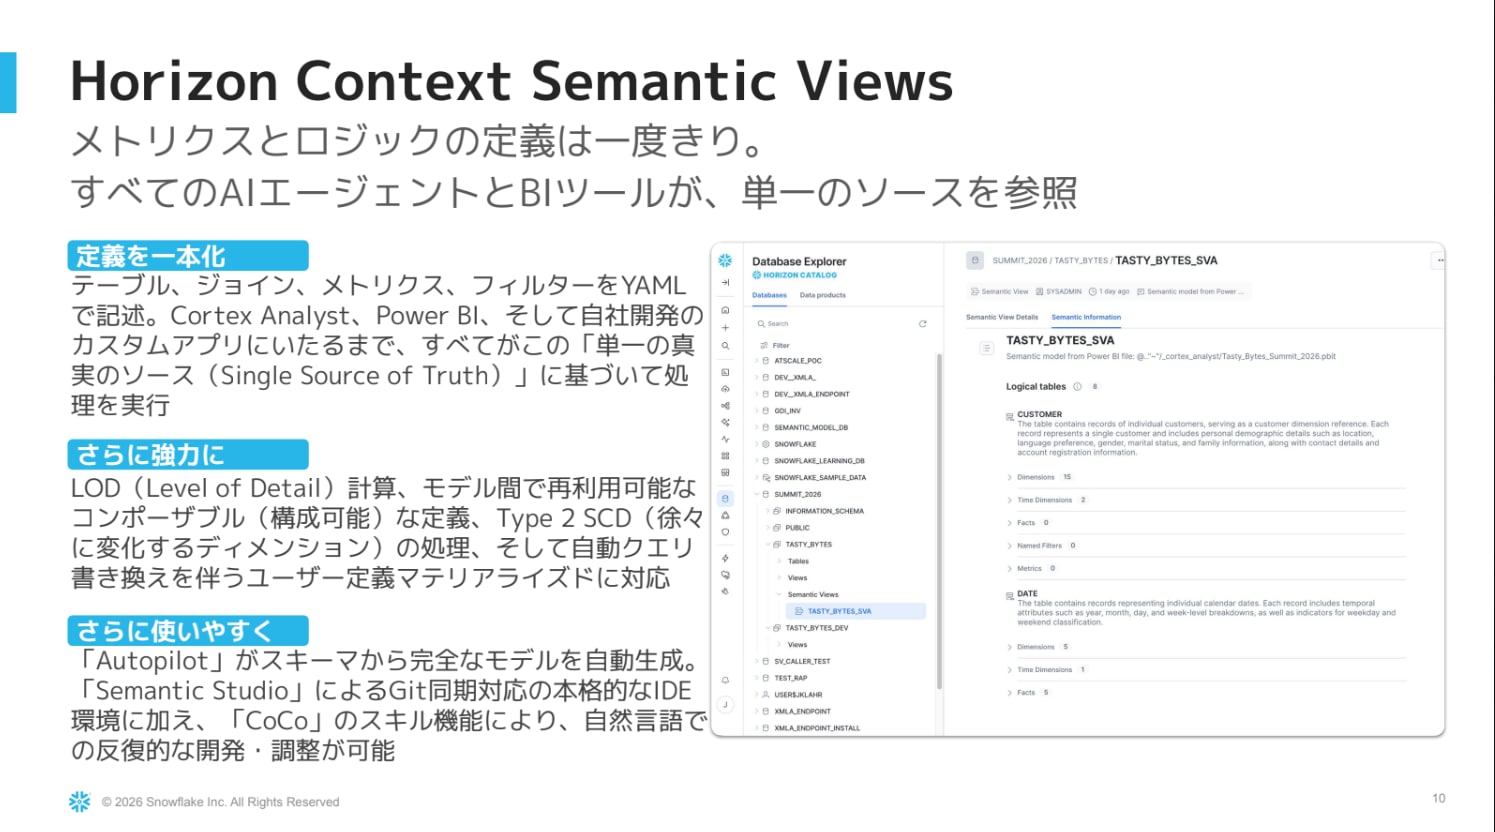
- 定義は一度、YAML で整理される。エンタープライズ級の高度な計算に耐えるパワフルさと、AI による自動生成や Git 同期ができる使いやすさを兼ね備える
- LookML など従来のセマンティックレイヤーが提供していたのは、ファクト、ディメンション、リレーションシップ、事前計算
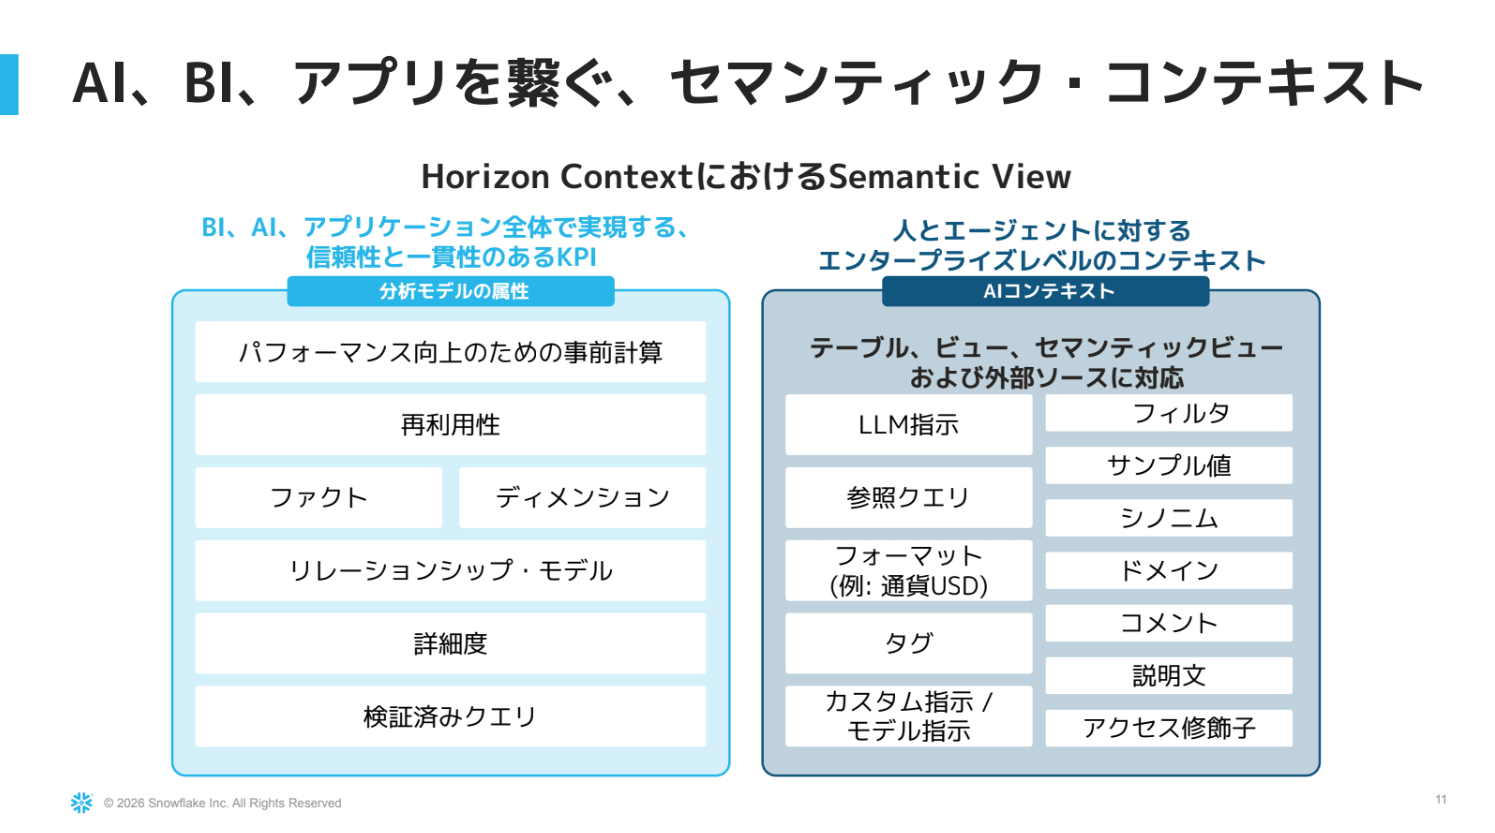
- AI 時代ではこれだけでは足りない。必要な要素を1つのパッケージにまとめることで、人間にも AI にも正確で信頼できるデータソースになる
構築現場の4つの壁
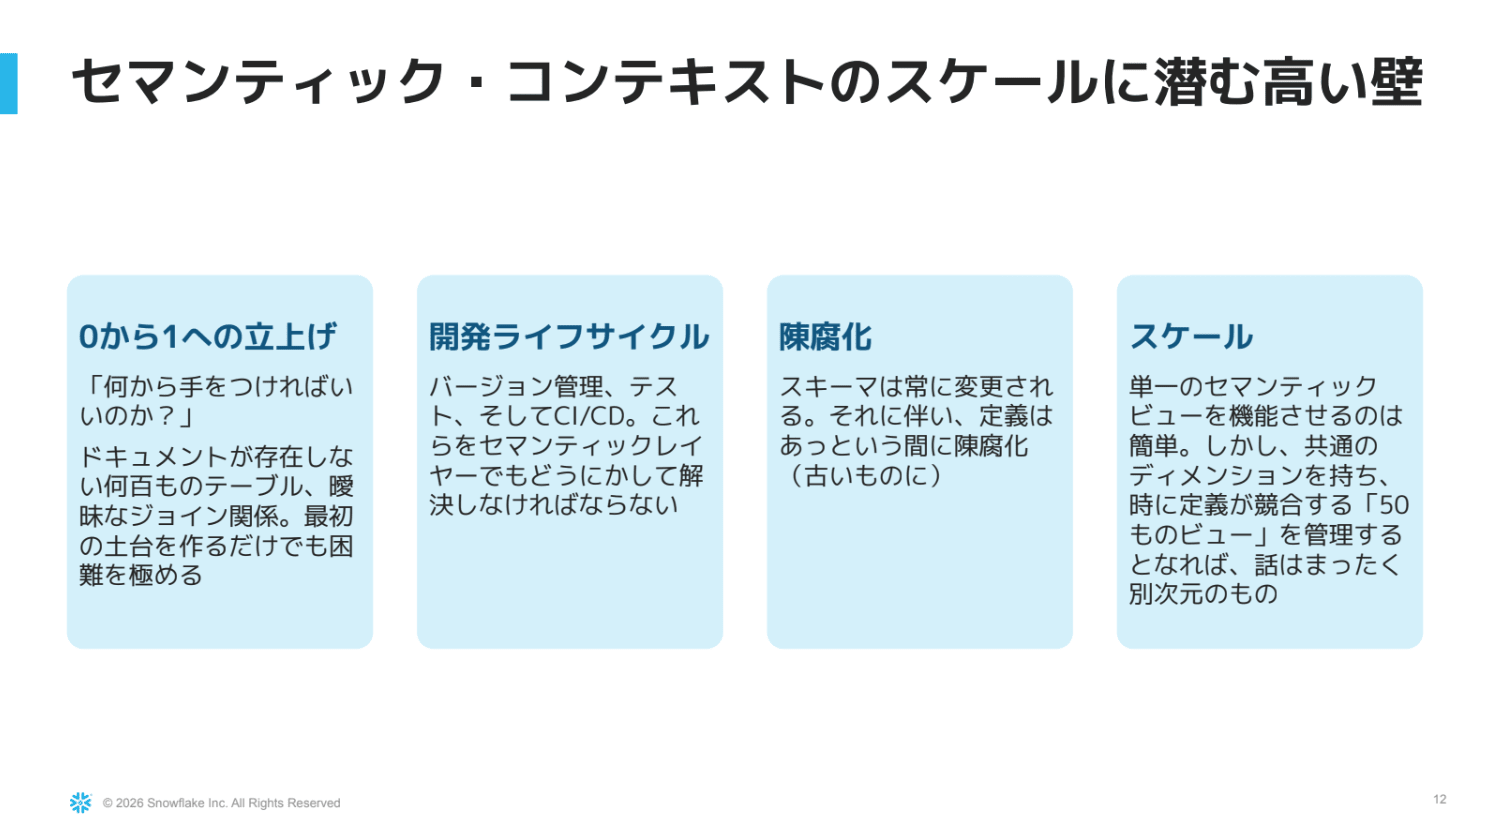
理想はそうでも、実際に構築しようとすると現場には泥臭い壁がある、として4つが挙げられました。
| 壁 | 内容 |
|---|---|
| ゼロからの立ち上げ | ドキュメントがなく、何百ものテーブルからどうセマンティックモデルを作るか |
| 開発ライフサイクル | テスト、バージョン管理、CI/CD をどう組み込むか |
| 陳腐化 | スキーマは変わり続けるのに、モデルが追いつかない |
| スケール | 部署ごとに定義が異なり、50個・100個のセマンティックビューをどう一元管理するか |
Semantic View Autopilot
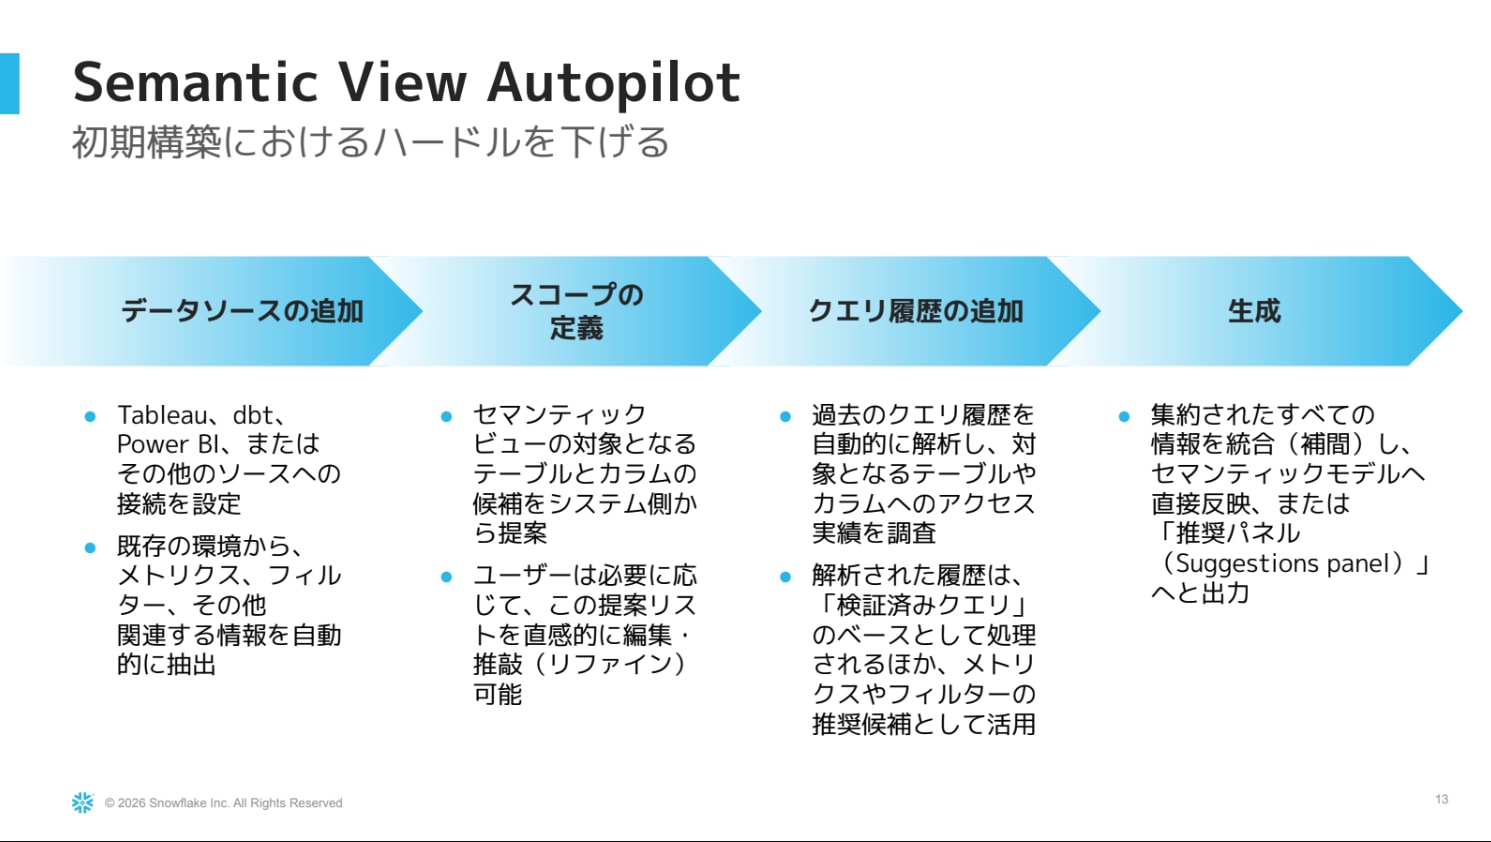
- Semantic View Autopilot は GA 済み(2026年2月のプレスリリースで GA を発表)
- Power BI ファイルの取り込みは、2026年8月18日に GA
- 設計の原則は「利用者の視点を基準にする」こと
- システムに登録されたデータベースからではなく、ユーザーが何を見たいかから始める
- 多くの企業はすでに Tableau や Power BI でダッシュボードを作っている。その資産を使う
- BI ツールの定義からテーブルとリレーションシップの情報を抽出する
- さらに Snowflake の過去のクエリ履歴を AI が解析する
- アクセスの多いテーブル、カラムの組み合わせ、よく使われる計算ロジックを抽出し、推奨モデルのベースとして提案する
- 手動で数か月かかっていたかもしれない作業を、数分に短縮できる
Power BI ファイルから初版を生成する
- 題材はクイックスタート「Zero to Snowflake」でおなじみの Tasty Bytes のデータで作った Power BI ダッシュボード
- Power BI ファイルにはテーブル同士のリレーションシップも定義されている
- Workspaces に組み込まれた画面から Power BI ファイルをインポートし、名前と配置先のデータベース・スキーマを指定
- 「展開」を押すと、ファイルの解析とクエリ履歴の収集が走り、土台となるセマンティックビューが生成された
- どのカラムを持ってくるか、リレーションシップをどう定義するか、という最初の作業を既存資産から始められる
- ディメンションやファクトも取り込まれていた
フィードバックループと Semantic Studio
使うほど育つフィードバックループ
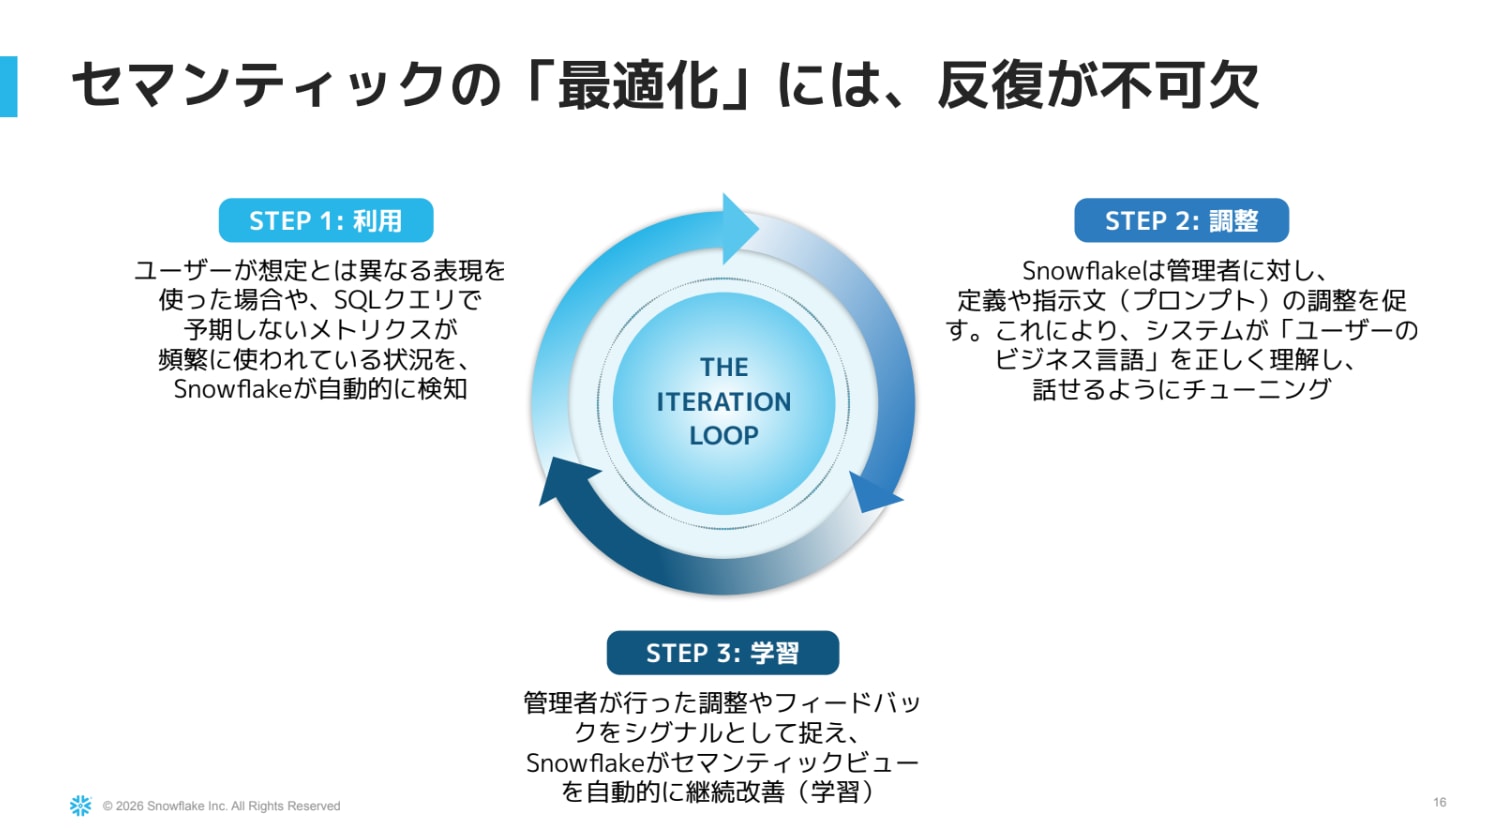
- モデルは1度作って終わりではなく、利用状況に合わせて継続的に育てる必要がある
- Snowflake では、改善候補の提案をレビューして採用する形で、このループを回せる
- ユーザーがデータを使うと、クエリのパターンや自然言語の表記揺れを検知する
- 「このクエリパターンを検証済みクエリとして追加しませんか」「このメトリクスを追加しませんか」と提案する
- 組み込んだ内容を含めてシステムが学習し、モデルを更新する
- 使えば使うほど、組織のビジネス言語に馴染んだセマンティックビューへ進化していく
Snowflake Semantic Studio
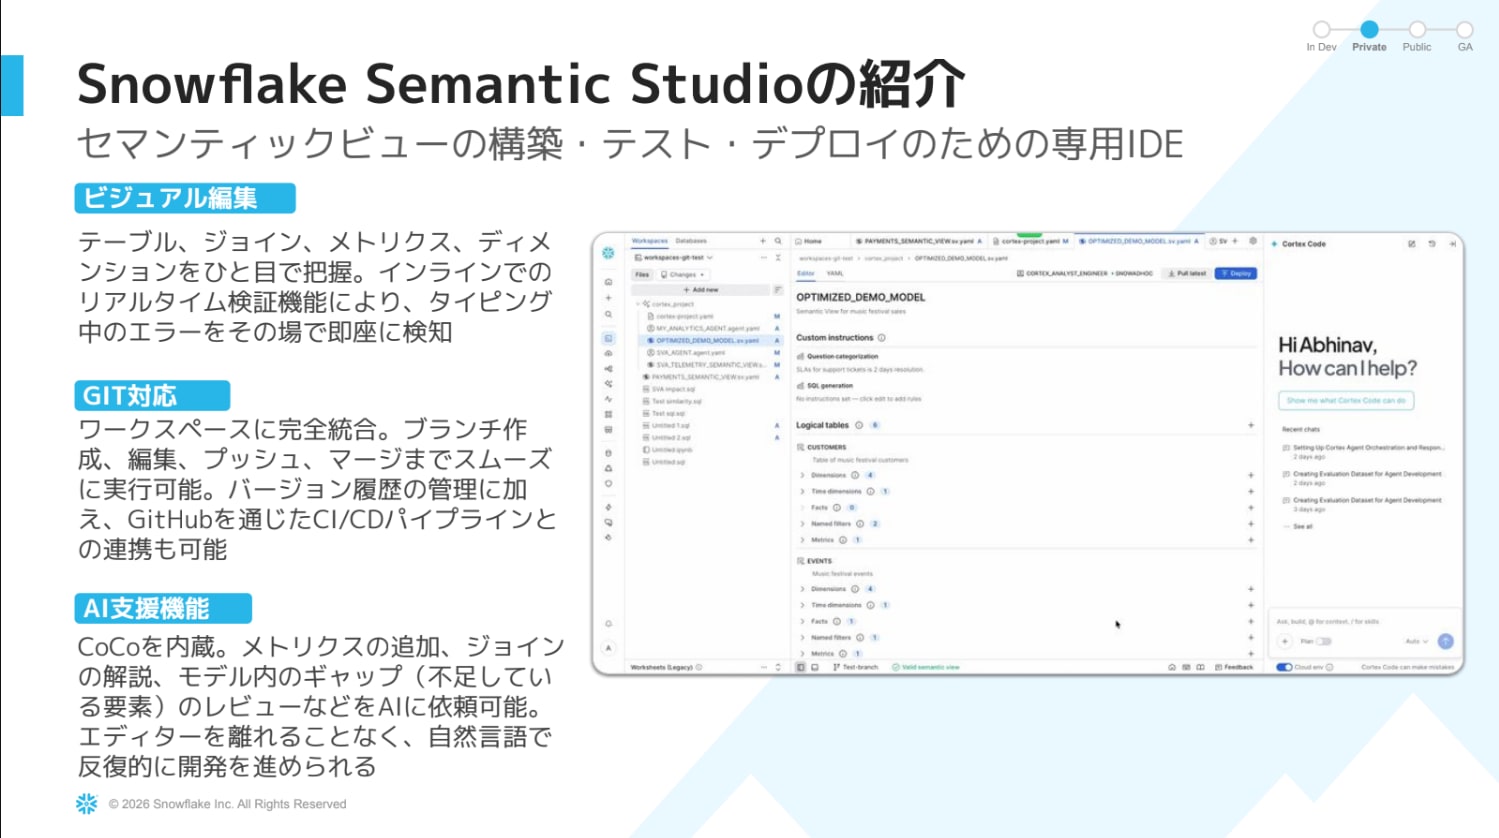
- この開発・運用ループの中心になるのが、新しく提供された Snowflake Semantic Studio(2026年8月26日にパブリックプレビュー)
- 直感的なエディターを備えつつ、Git リポジトリと連携してブランチ作成やコミットを行える
- Git を中心としたレビューや CI/CD のワークフローにも組み込める
- Snowflake CoCo が最初から組み込まれており、自然言語で「新しいメトリクスを追加して」と依頼できる
エンタープライズ要件と Composable Views
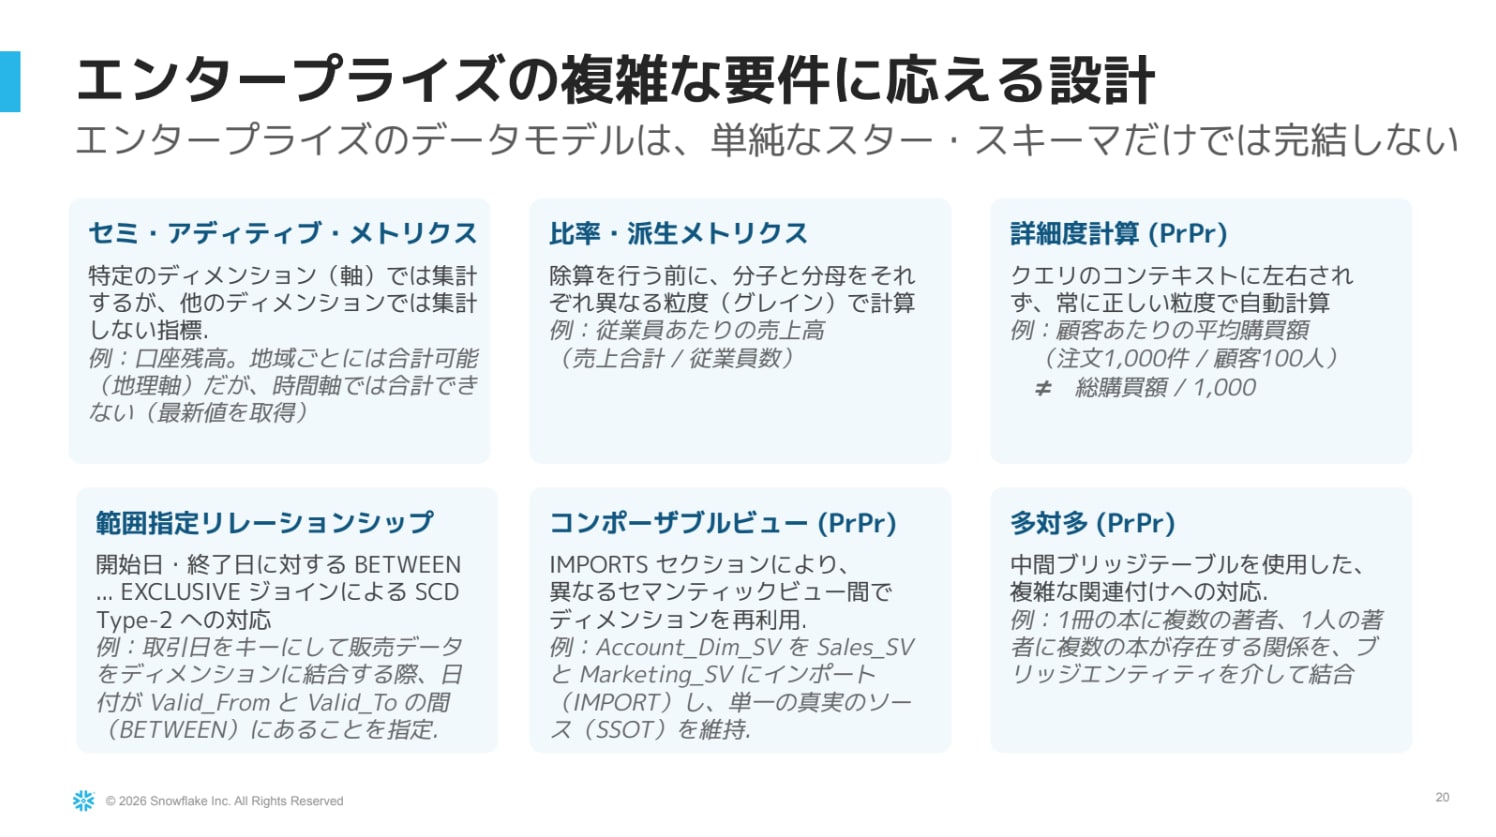
- 実際のデータモデルは単純なスタースキーマでは完結しない。セマンティックビューは複雑な要件に対応するよう進化している
- 銀行の口座残高のように、地域では合計できるが時間では合計できないセミ・アディティブ・メトリクス
- 分子と分母で粒度が異なる比率のメトリクス
- 開始日と終了日を使った、キーだけでは表せない結合
- 推奨される構成ではないものの、ブリッジテーブルを利用した多対多のリレーション
Composable Views
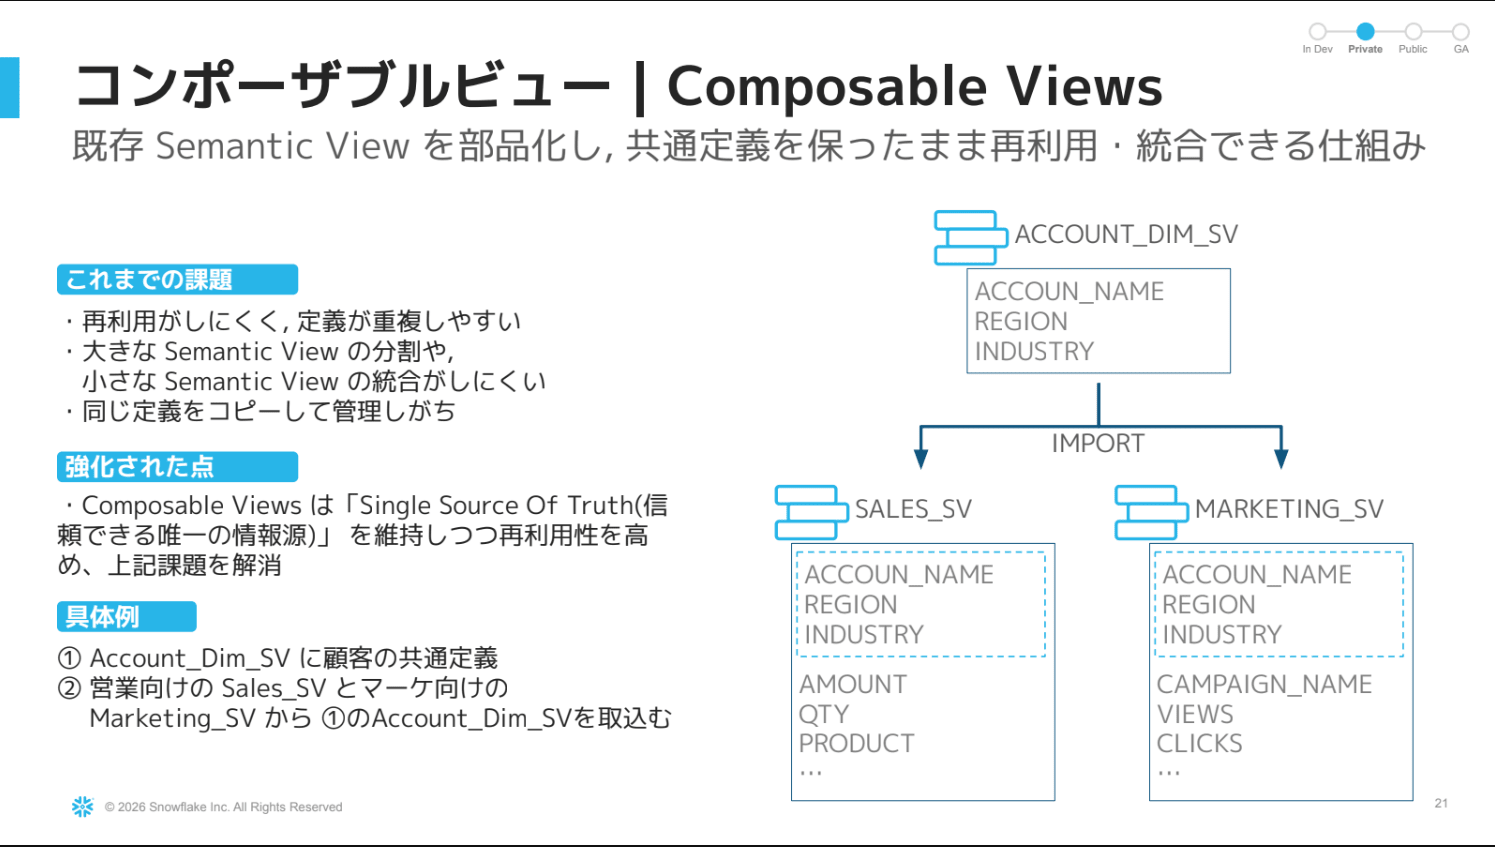
- 登壇者が特に強力だと考えているのが Composable Views
- これまでは共通の定義をコピー&ペーストして使い回すため、定義がぶれたり同じ定義が散在したりしていた
- 顧客のセマンティックビューを共通モジュールとして1度作れば、営業用やマーケティング用のセマンティックビューからインポートして再利用できる
- 車輪の再発明をせず、定義を統一したままシンプルに作っていける
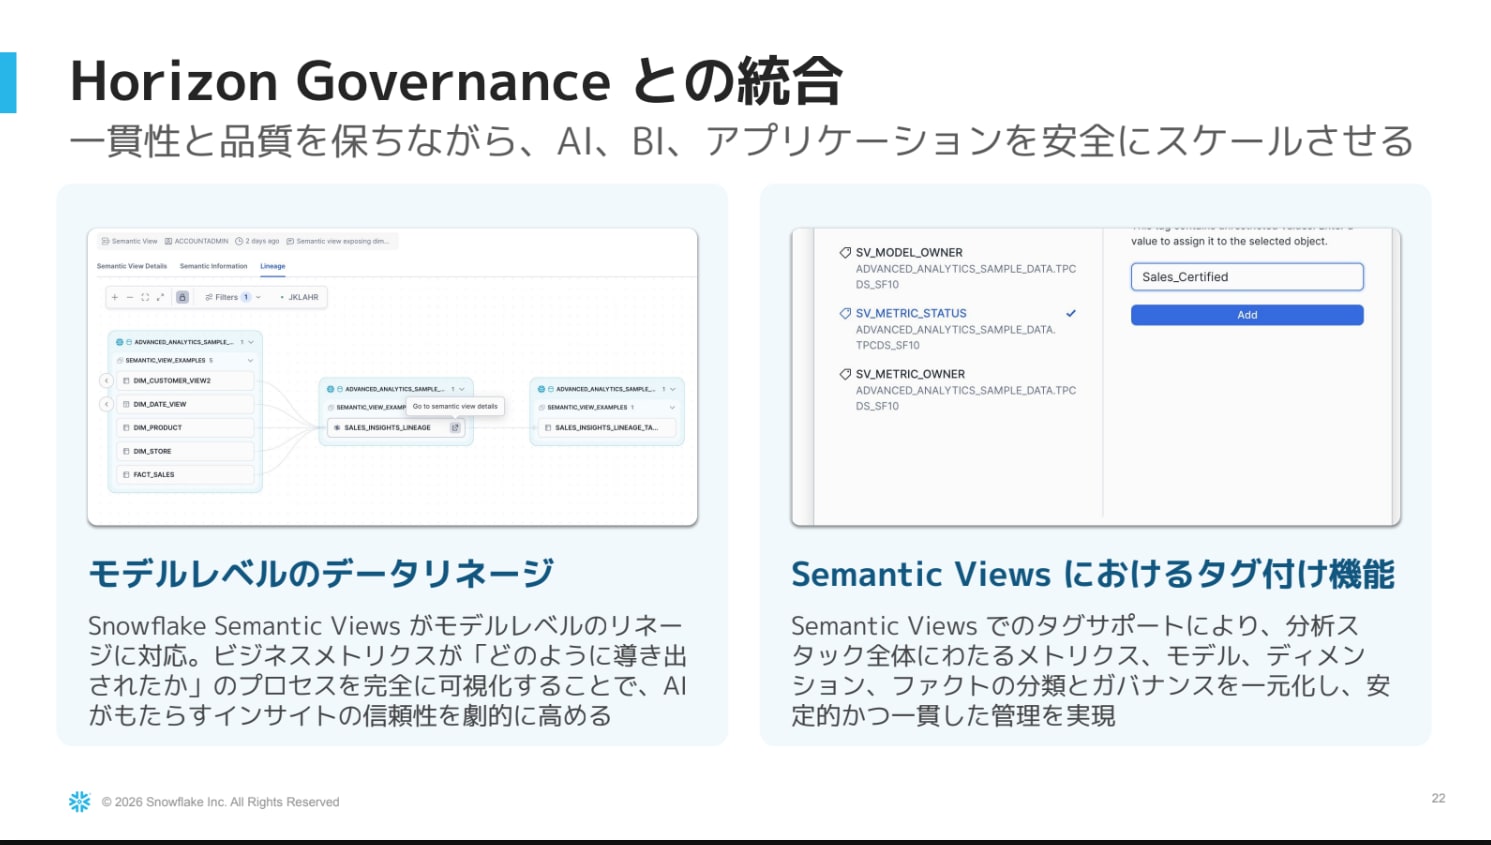
- ガバナンスにも対応。モデルレベルのリネージで、どのデータソースをもとに、どのように作成されたかを追跡できる
- タグ付けによる分類やアクセス制御もできる
エコシステムとオープン標準
XMLA エンドポイント
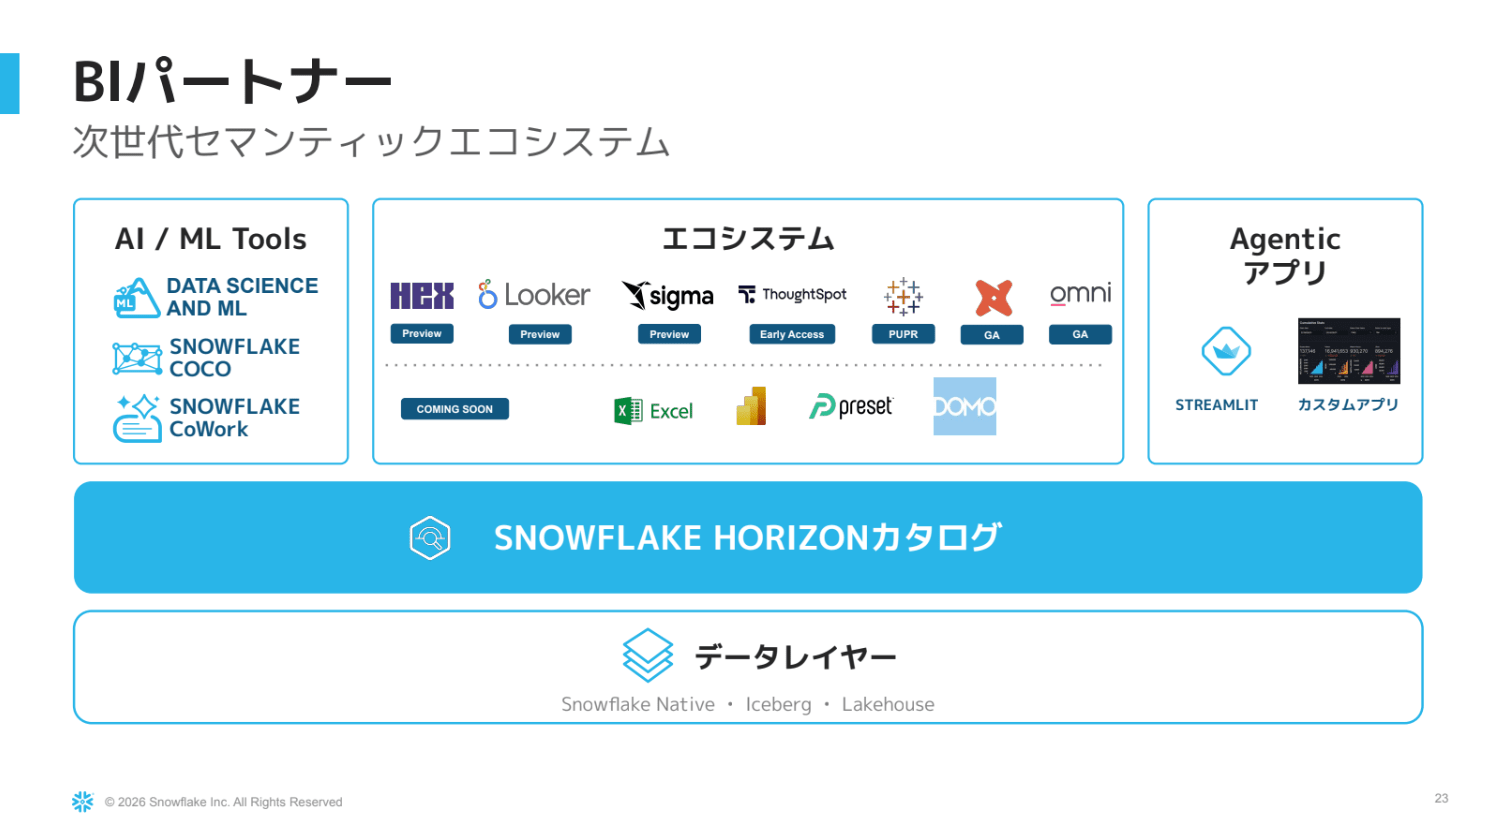
- セマンティックビューは Snowflake の中に閉じない
- Streamlit や CoWork はもちろん、他の BI ツール、AI/ML ツール、カスタムアプリとも連携できる
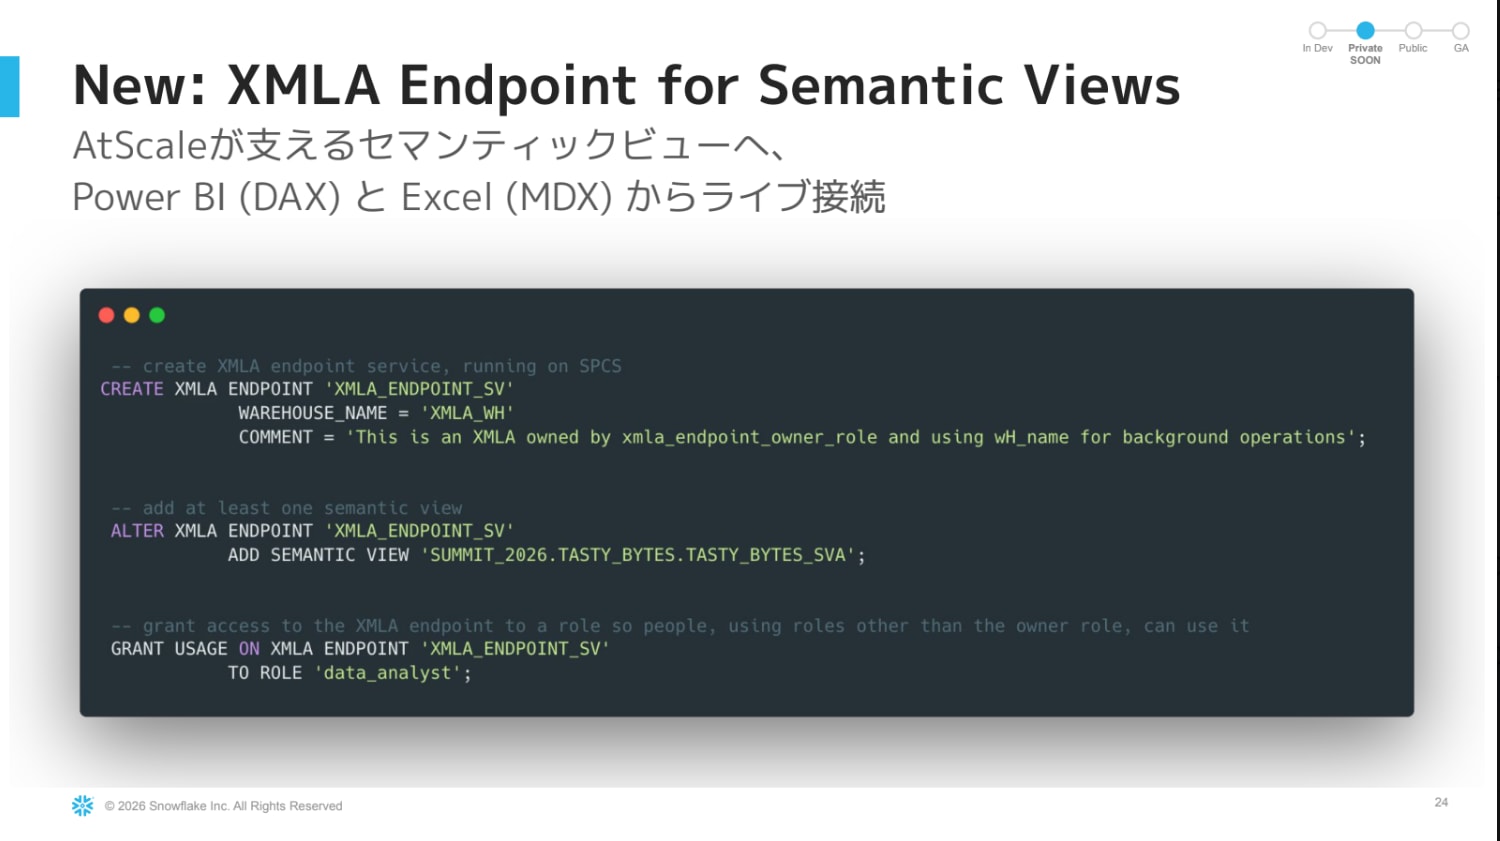
- 新しく紹介されたのが XMLA エンドポイント
- Power BI からは DAX、Excel からは MDX で、セマンティックビューに直接ライブ接続してクエリする構想
- 現場のユーザーが使い慣れた Excel からセマンティックビューを参照できるようになる
- ユーザーがテーブルを推測して使い、人によって数字が異なる、という状態を防げる
※XMLA エンドポイントは、公式ブログでは AtScale との提携により提供される Private Preview の機能として案内されています。執筆時点では利用条件や対応範囲の詳細が公開されていないため、最新の公式情報をご確認ください。
シフトレフトと Apache Ossie
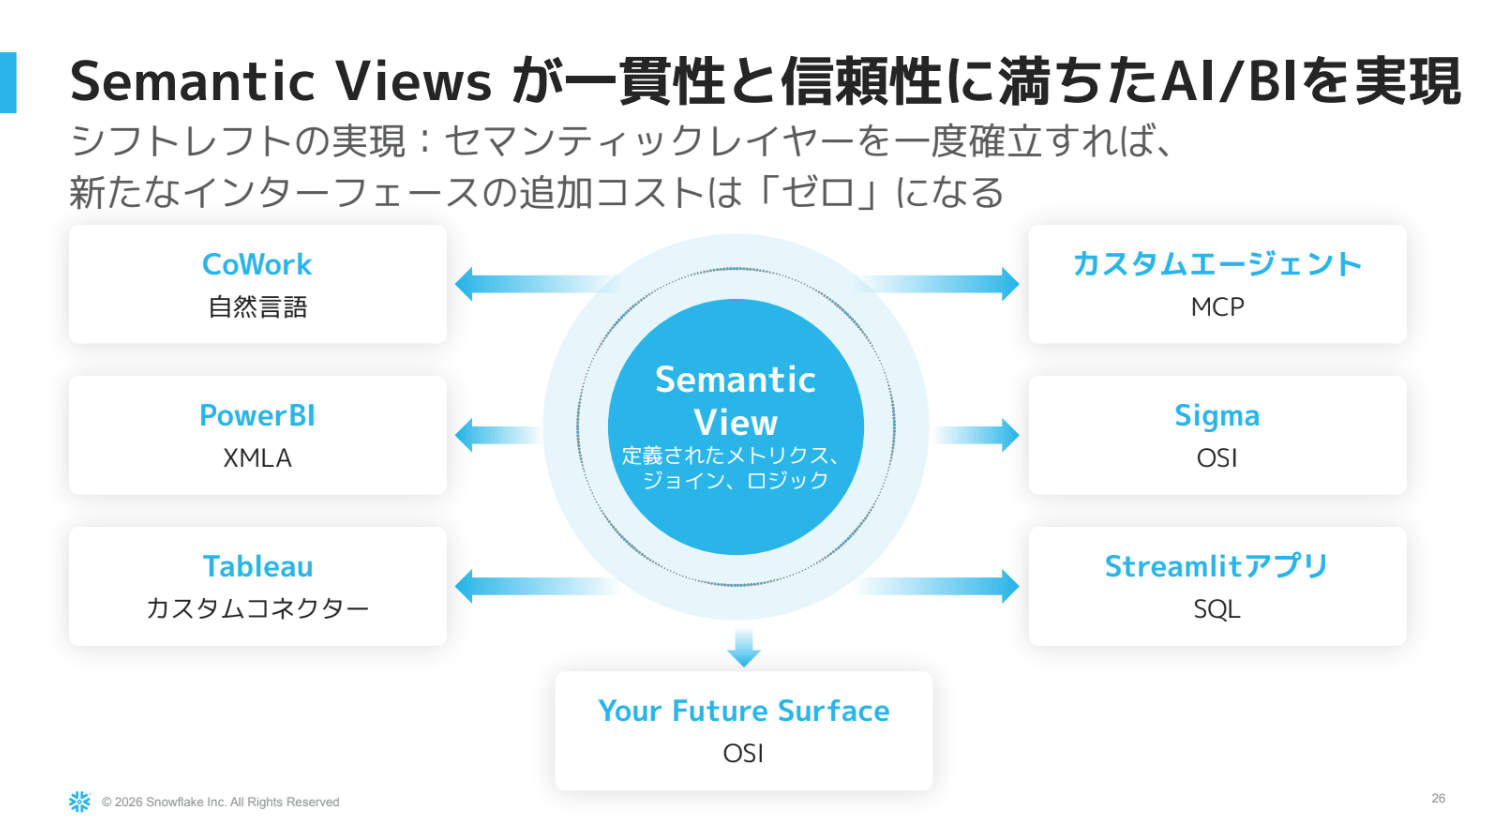
- 目指しているのはシフトレフト
- セマンティックレイヤーを Snowflake 上に集約しておけば、新しい AI エージェントや BI ツールが登場しても定義し直す必要がない
- 最初から信頼できるデータをすぐに使える状態にしておく
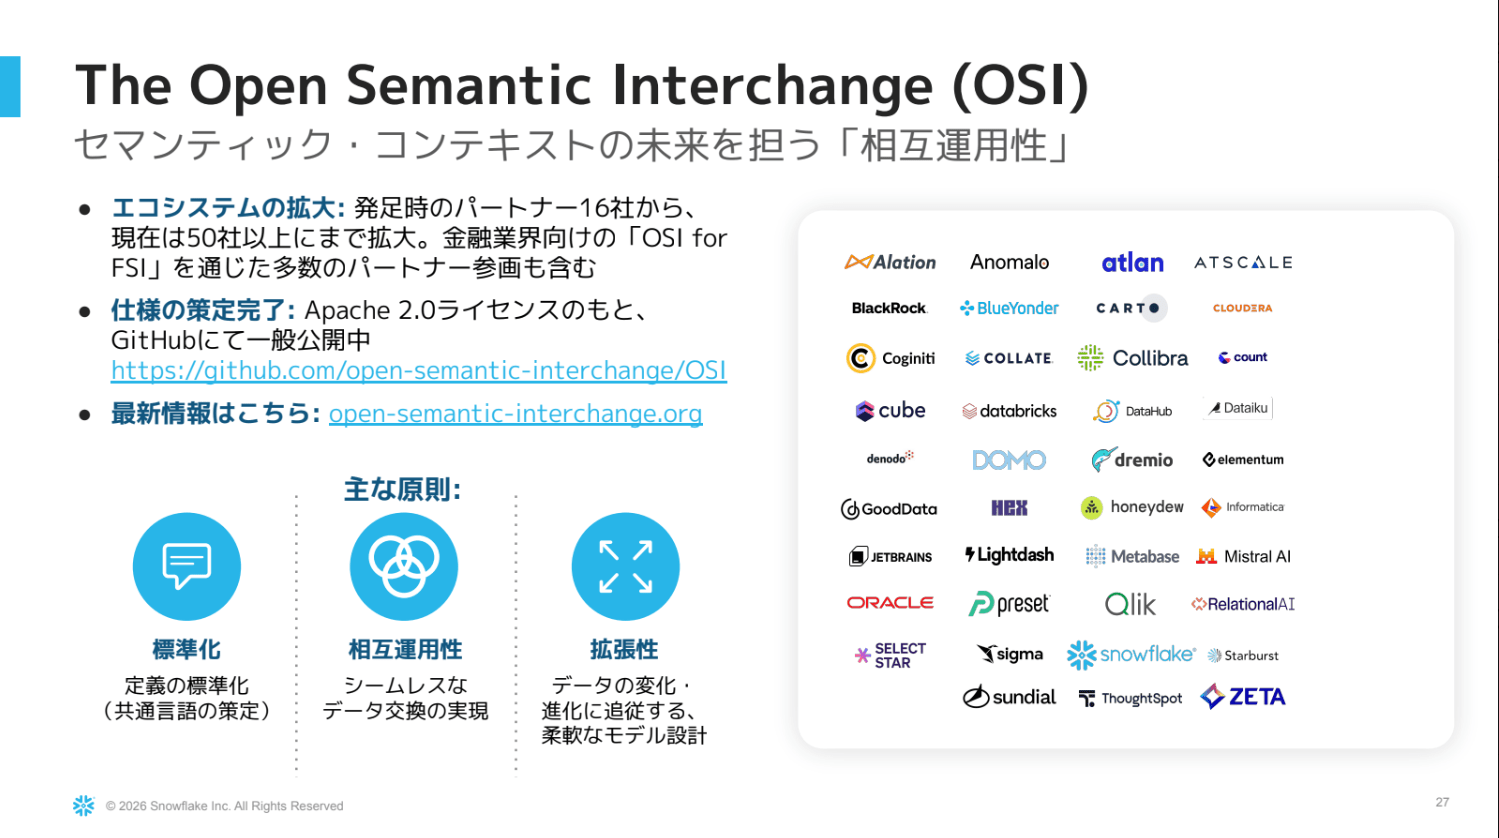
- そのため Snowflake はセマンティックビューへの取り組みをオープンに進めている
- 業界全体で相互運用できるよう、オープン標準規格 Open Semantic Interchange(OSI)を推進してきた
- 登壇では、最初は16社ほどのパートナーから始まり、現在は80社以上に増えたと説明された。規格は GitHub で公開されている
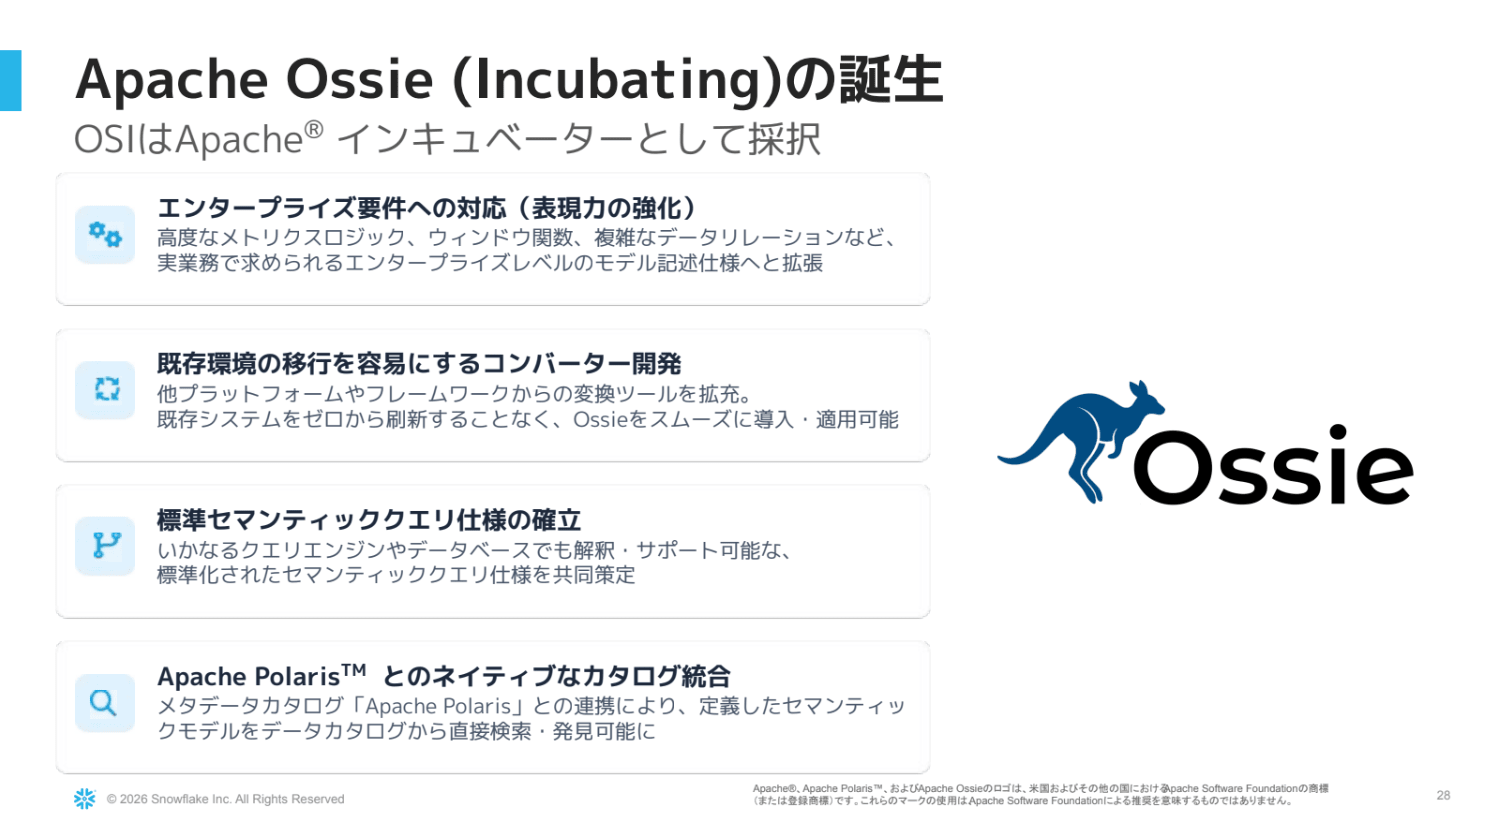
- OSI は Apache Incubator に採択され、現在は Apache Ossie(incubating)として進められている
- ベンダーロックインを排除し、セマンティックモデルを自由に交換・活用できる未来をパートナーと築いていきたい、とのこと
関連記事
Day1 KEYNOTE のレポートはこちらです。
セッションで紹介された機能の公式ドキュメントはこちらです。
所感
SNOWFLAKE WORLD TOUR TOKYO 2026 Day1 のセッション「Snowflakeでゼロから構築する、信頼性の高いセマンティックレイヤー」に参加しました。セマンティックレイヤーの30年の歴史から始まり、スケールに潜む高い壁を Snowflake がどう答えるかを示すセッションでした。
Snowflakeのセマンティックレイヤーの全体像から、今後リリース予定の機能まで幅広く理解することができました。
Snowflake Cortex Senseもリリース前ですが、合わせて活用していきたいですね。
この記事が何かの参考になれば幸いです!